بخش تخصصی (۶): RBD — درون rbd-mirror: journal در برابر snapshot
حوصله ندارم این فصل در چند خط
- با فعال بودن journaling، librbd هر تغییر را پیش از اعمال روی image در یک journal روی RADOS مینویسد.
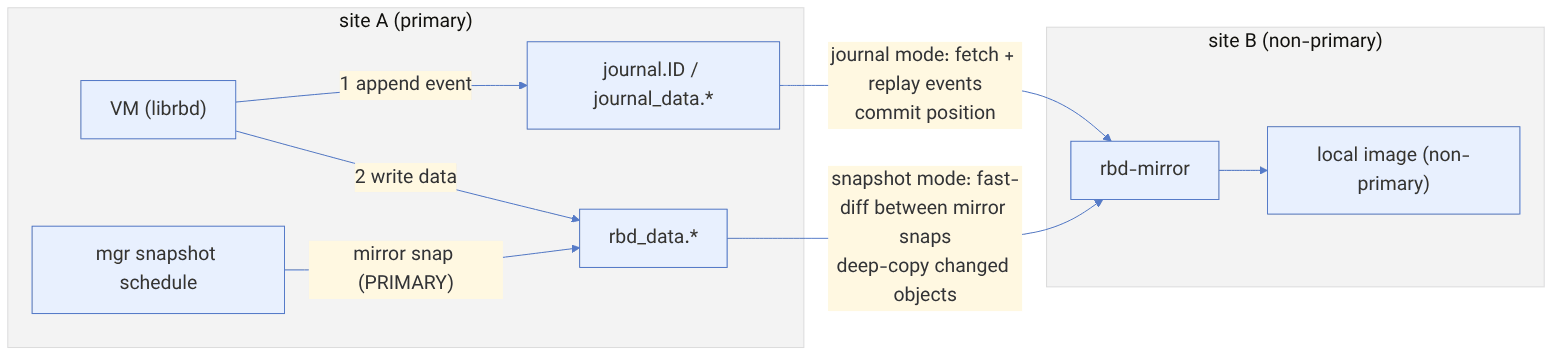
- در حالت journal، rbd-mirror بهعنوان کلاینت journal در مبدأ ثبت میشود و رویدادها را در مقصد replay میکند.
- در حالت snapshot، snapshotهای زمانبندیشدهی mirror روی image اصلی گرفته میشوند و rbd-mirror تفاوت دو snapshot پیاپی را کپی میکند.
- چند daemon از rbd-mirror با یک leader و از راه watch/notify imageها را میان خود تقسیم میکنند؛ فاصلهی timestampهای snapshot همان RPO فعلی است.
۳۹-۱ پیش از شروع#
فصل ۲ نشان داد mirroring چگونه پیکربندی و برای failover و failback استفاده میشود. این فصل به درون آن میرود: journal یک image روی RADOS چه شکلی دارد و هر رویداد بایت به بایت چگونه نوشته میشود، librbd چه ترتیبی میان journal و داده نگه میدارد، rbd-mirror در حالت journal چگونه رویدادها را replay و commit میکند، حالت snapshot چه snapshotهایی میسازد و چگونه فقط تفاوتها را کپی میکند، و چند daemon rbd-mirror کار را چگونه میان خود تقسیم میکنند. نامها و پیشفرضها با شاخهی main مخزن ceph/ceph (نوامبر ۲۰۲۶) تطبیق داده شدهاند.
۳۹-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
- journal یک image در کدام اشیا ذخیره میشود و یک رویداد چه قالبی دارد؟
- چرا هر نوشتن با journaling دو بار نوشته میشود و ترتیب آن دو چیست؟
- commit position چیست و journal چه زمانی کوتاه میشود؟
- rbd-mirror در حالت snapshot از کجا میداند کدام اشیا را کپی کند؟
- snapshotهای mirror چه حالتهایی دارند و demote و promote چگونه با آنها نشان داده میشوند؟
- چند rbd-mirror چگونه leader انتخاب و imageها را تقسیم میکنند؟
- کدام حالت را برای کدام بار انتخاب کنیم؟
۳۹-۱-۲ پیشنیاز#
فصل ۲ (mirroring)، فصل ۳۷ (header، object map و fast-diff)، فصل ۳۸ (لایههای dispatch و exclusive-lock).
۳۹-۲ journal روی RADOS#
۳۹-۲-۱ اشیای journal#
با فعال شدن ویژگی journaling، librbd یک journal برای image میسازد (کتابخانهی عمومی src/journal و کلاس cls_journal):
| شیء | محتوا |
|---|---|
journal.<image-id> | header در omap: order، splay_width، pool_id، minimum_set، active_set، next_tag_tid، next_tag_class، client_<id> (هر مصرفکننده و commit position آن)، tag_<tid> |
journal_data.<pool-id>.<image-id>.<n> | دادهی journal؛ n شمارهی شیء |
journal مثل یک image striped کار میکند: splay_width شیء (پیشفرض rbd_journal_splay_width = ۴) یک object set میسازند و هر شیء تا 2^order بایت (rbd_journal_order = ۲۴، یعنی ۱۶ MiB) رشد میکند. وقتی اشیای set فعال پر شوند، active_set یکی بالا میرود. rbd_journal_pool اجازه میدهد journal در pool دیگری (مثلاً SSD) باشد.
منبع در کد: src/journal/JournalRecorder.cc :: JournalRecorder::append، get_object؛ src/journal/Entry.cc :: Entry::encode
پیچیدگی: O(۱) برای هر رویداد؛ نوشتنها در هر شیء دستهبندی میشوند
pseudocode
append(tag_tid, payload):
entry_tid = next entry tid for this tag
splay_offset = entry_tid % splay_width
object_number = active_set * splay_width + splay_offset
bytes = Entry{preamble 0x3141592653589793, version 1, entry_tid, tag_tid, data}.encode() + crc32c
ObjectRecorder[splay_offset].append(bytes) # دستهای با flush interval/bytes/age
if object reaches 2^order: close set ; active_set++ (update header)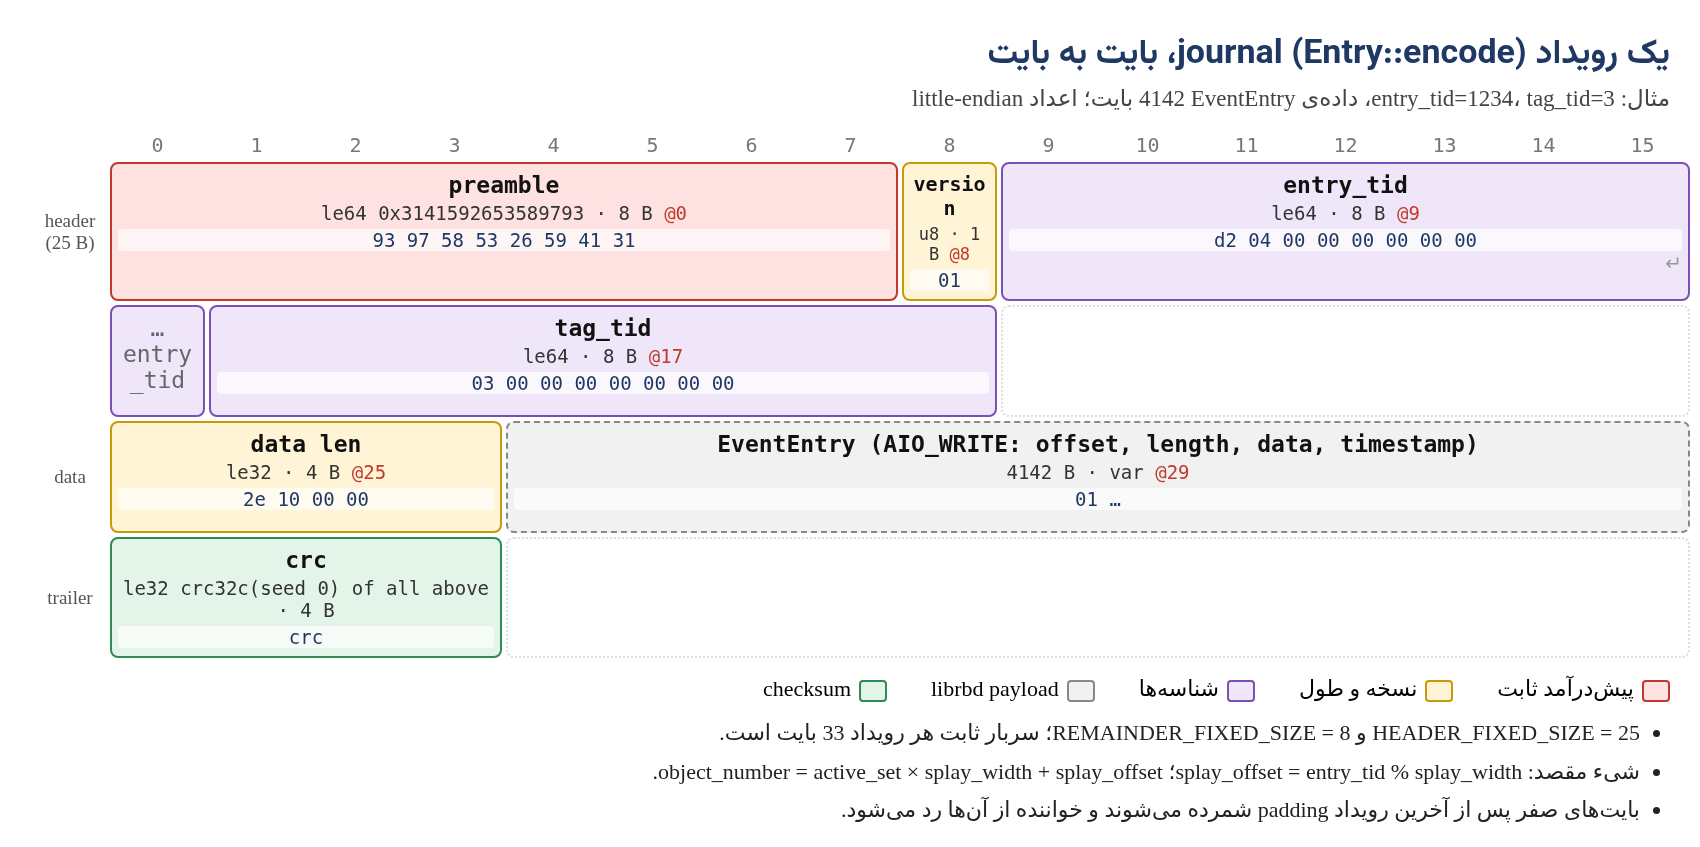
HEADER_FIXED_SIZE ۲۵ بایت (preamble، version، entry tid و tag tid) و REMAINDER_FIXED_SIZE ۸ بایت (طول داده و crc) است، پس هر رویداد ۳۳ بایت سربار دارد. پیشدرآمد ثابت به خواننده اجازه میدهد در صورت خرابی یا padding صفر، شروع رویداد بعدی را پیدا کند.
۳۹-۲-۲ رویدادهای librbd#
دادهی هر رویداد یک EventEntry است با یکی از انواع EVENT_TYPE_*: AIO_WRITE (۱)، AIO_DISCARD (۰)، AIO_FLUSH (۲)، AIO_WRITESAME (۱۸)، AIO_COMPARE_AND_WRITE (۱۹)، و رویدادهای عملیاتی مثل SNAP_CREATE (۴)، RESIZE (۱۱)، FLATTEN (۱۲)، DEMOTE_PROMOTE (۱۳)، UPDATE_FEATURES (۱۵) و OP_FINISH (۳). رویداد نوشتن دادهی کامل نوشتن را دارد. نوشتنهای بزرگتر از rbd_journal_max_payload_bytes (پیشفرض ۱۶ KiB) به چند رویداد شکسته میشوند.
۳۹-۲-۳ ترتیب journal و داده#
منبع در کد: src/librbd/Journal.cc :: append_write_event، append_io_event، commit_io_event؛ src/librbd/journal/ObjectDispatch.cc
پیچیدگی: دو نوشتن RADOS برای هر نوشتن کاربر؛ تأخیر = journal append + data write
pseudocode
image write (JOURNAL image layer):
tid = journal.append_io_event(AIO_WRITE{offset, length, data})
pass request down with journal_tid = tid
object write (JOURNAL object layer):
wait until event tid is SAFE (persisted in journal_data objects)
send data write to rbd_data object
on data write complete:
journal.commit_io_event(tid) # پس از آن رویداد قابل trim است (از دید مصرفکنندهی محلی)
client registration:
master client "" (local librbd) and one client per mirror peer (mirror uuid)
each client commit_position = last committed (tag_tid, entry_tid) per splay offset
trim: objects of sets < min(commit sets of all clients) are removed ; minimum_set advancesپیامد عملی: با journaling هر نوشتن دو بار نوشته میشود، یک بار در journal و یک بار در داده، و تأخیر هر دو پشتسرهم است. اگر peer از دسترس خارج شود، journal تا جایی که commit position آن peer عقب است trim نمیشود و رشد میکند. rbd_journal_max_concurrent_object_sets (پیشفرض ۰ یعنی بیسقف) میتواند یک peer عقبمانده را disconnect کند تا journal بینهایت رشد نکند؛ peer جداشده باید دوباره کامل همگام شود.
# مثال: بررسی journal یک image
rbd journal info --pool rbd --image vm01
rbd journal status --pool rbd --image vm01مثال (خروجی):
rbd journal '5f3a2b8c1d4e':
header_oid: journal.5f3a2b8c1d4e
object_oid_prefix: journal_data.3.5f3a2b8c1d4e.
order: 24 (16 MiB objects)
splay_width: 4
minimum_set: 7
active_set: 9
registered clients:
[id=, commit_position=[positions=[[object_number=36, tag_tid=3, entry_tid=91421], ...]], state=connected]
[id=b6e4…remote-uuid, commit_position=[positions=[[object_number=30, tag_tid=3, entry_tid=88310], ...]], state=connected]client دوم (peer) شیء ۳۰ (در set ۷) را commit کرده و client محلی شیء ۳۶ (set ۹) را؛ پس setهای ۷ و ۸ به خاطر peer نگه داشته شدهاند.
۳۹-۳ replay در حالت journal#
rbd-mirror در کلاستر مقصد اجرا میشود، بهعنوان یک client در journal image مبدأ ثبت میشود و رویدادها را میخواند.
منبع در کد: src/tools/rbd_mirror/image_replayer/journal/Replayer.cc؛ EventPreprocessor.cc؛ src/librbd/journal/Replay.cc
پیچیدگی: O(E) برای E رویداد؛ پهنای باند ≈ نرخ نوشتن مبدأ + سربار رویدادها
pseudocode
bootstrap: if local image missing or client state = disconnected → full image sync (deep copy)
loop:
    entries = remote_journaler.fetch(rbd_mirror_journal_max_fetch_bytes)
    for e in entries:
        if e.tag changes owner (promote/demote): handle tag, maybe stop
        ev = decode EventEntry ; EventPreprocessor.map_snap_ids(ev)   # snap id محلی ≠ مبدأ
        librbd::journal::Replay.process(ev) on local image             # local image is non-primary
        on safe: remote_journaler.committed(e) → periodically update commit_position
status: entries_behind_primary, bytes_per_second, seconds_until_syncedimage مقصد ویژگی non-primary دارد و فقط rbd-mirror حق نوشتن در آن را دارد. ترتیب رویدادها و نقاط flush حفظ میشود، پس مقصد همیشه crash-consistent است: در هر لحظه، همان حالتی را دارد که مبدأ در یک نقطهی زمانی گذشته داشته است.
۳۹-۴ حالت snapshot#
در این حالت journal وجود ندارد. librbd یا زمانبند mgr (rbd mirror snapshot schedule) روی image اصلی یک snapshot از namespace mirror میسازد و rbd-mirror تفاوت میان دو snapshot متوالی را کپی میکند.
۳۹-۴-۱ namespace snapshot mirror#
فیلد MirrorSnapshotNamespace | معنی |
|---|---|
state | PRIMARY (۰)، PRIMARY_DEMOTED (۱)، NON_PRIMARY (۲)، NON_PRIMARY_DEMOTED (۳) |
complete | روی مقصد: کپی این snapshot تمام شده است |
mirror_peer_uuids | peerهایی که هنوز به این snapshot نیاز دارند |
primary_mirror_uuid، primary_snap_id | روی مقصد: snapshot متناظر در مبدأ |
last_copied_object_number | پیشرفت کپی برای ادامه پس از قطع |
snap_seqs | نگاشت snap idهای مبدأ به مقصد |
demote یک snapshot با حالت PRIMARY_DEMOTED میسازد و promote در طرف دیگر پس از رسیدن آن، تصویر را primary میکند. به همین دلیل failover برنامهریزیشده بدون از دست رفتن داده است: demote آخرین تغییرات را در یک snapshot میگذارد و promote منتظر کامل شدن آن میماند. rbd_mirroring_max_mirroring_snapshots (پیشفرض ۵) تعداد snapshotهای mirror نگهداشتهشده را محدود میکند.
منبع در کد: src/tools/rbd_mirror/image_replayer/snapshot/Replayer.cc :: scan_local_mirror_snapshots، scan_remote_mirror_snapshots، copy_snapshots، create_non_primary_snapshot، copy_image، update_non_primary_snapshot، unlink_peer
پیچیدگی: O(تغییرات میان دو snapshot)؛ فهرست اشیا با fast-diff، بدون خواندن کل image
pseudocode
on image update notify (or periodic check):
    refresh local and remote images
    local_last = newest local NON_PRIMARY mirror snap (complete or in-progress)
    remote_start = its primary_snap_id ; remote_end = next remote PRIMARY mirror snap after start
    if none: idle
    copy_snapshots: user snapshots between start and end → create locally (snap_seqs)
    get remote image state (size, features, metadata) at remote_end
    create local NON_PRIMARY snapshot (complete=false, primary_snap_id = remote_end)
    request sync slot (rbd_mirror_concurrent_image_syncs)
    copy_image: deep-copy objects changed between remote_start..remote_end
                (object map diff → only DATA_UPDATED / HOLE_UPDATED objects)
                progress → last_copied_object_number
    apply image state ; mark local snapshot complete
    unlink_peer(remote_start): remove our uuid from remote snap's mirror_peer_uuids
    prune older local mirror snapshots
مثال عددی. image ۲ TiB (۵۲۴۲۸۸ شیء ۴ MiB) با زمانبند هر ۱۵ دقیقه. اگر در ۱۵ دقیقه ۳۰۰۰ شیء تغییر کنند، fast-diff همین ۳۰۰۰ شیء را پیدا میکند و rbd-mirror حدود ۱۲ GiB منتقل میکند، حتی اگر روی هر شیء صدها نوشتن کوچک انجام شده باشد. در حالت journal همان بار، اگر ۲۰۰ MiB/s نوشتن کوچک باشد، حدود ۱۸۰ GB در ۱۵ دقیقه رویداد تولید میکند. برعکس، اگر در ۱۵ دقیقه فقط یک بایت در هر یک از ۳۰۰۰ شیء نوشته شود، حالت snapshot باز هم ۱۲ GiB میفرستد. پس انتخاب حالت به الگوی نوشتن و RPO بستگی دارد.
| journal | snapshot | |
|---|---|---|
| RPO | ثانیهها | فاصلهی زمانبند (دقیقهها) |
| سربار نوشتن در مبدأ | دو برابر نوشتن و تأخیر بیشتر | تقریباً صفر (فقط snapshot و clone اشیا) |
| کلاینتها | فقط librbd (krbd پشتیبانی نمیکند) | librbd و krbd |
| پهنای باند | متناسب با حجم نوشتن | متناسب با تعداد اشیای تغییرکرده |
| ریسک | رشد journal اگر peer عقب بماند | snapshotهای زیاد و clone در RADOS |
۳۹-۵ daemonها: leader، instance و تقسیم imageها#
چند daemon rbd-mirror میتوانند برای یک pool اجرا شوند (active-active). هماهنگی با watch/notify روی اشیای همان pool انجام میشود.
منبع در کد: src/tools/rbd_mirror/LeaderWatcher.cc، InstanceWatcher.cc، ImageMap.cc، image_map/SimplePolicy.cc
پیچیدگی: O(I) برای I image در هر بازتخصیص
pseudocode
each daemon: register instance_<id> in rbd_mirroring ; watch rbd_mirror_leader
leader election: try cls_lock exclusive on rbd_mirror_leader
    leader sends heartbeat every rbd_mirror_leader_heartbeat_interval (5 s)
    if rbd_mirror_leader_max_missed_heartbeats (2) missed → others break lock (with blocklist) and retry
leader: ImageMap with policy rbd_mirror_image_policy_type (simple)
    simple: spread images evenly; persist in rbd_mirroring image_map_<global id>
    on instance add/remove: rebalance and send acquire/release image to instances
instance: InstanceReplayer starts/stops ImageReplayer per assigned image
مثال عددی. با سه daemon و ۳۰۰ image، هر daemon حدود ۱۰۰ image میگیرد. اگر یکی از کار بیفتد، leader پس از دو heartbeat از دسترفته (حدود ۱۰ ثانیه، بهعلاوهی زمان watch timeout) آن را حذف و ۱۰۰ image را میان دو daemon باقیمانده پخش میکند. هر image تا آن زمان همگام نمیشود؛ در حالت journal یعنی journal مبدأ به همین اندازه رشد میکند.
۳۹-۶ مرجع دستورها#
| دستور | کاربرد |
|---|---|
rbd mirror pool enable P {image,pool} [--site-name N] / disable | روشن کردن mirroring در pool |
rbd mirror pool peer bootstrap create P / bootstrap import P TOKEN [--direction {rx-only,rx-tx}] | پیوند دو کلاستر |
rbd mirror pool peer {add,remove,set} | مدیریت دستی peer |
rbd mirror pool info P / status P [--verbose] | پیکربندی و وضعیت همهی imageها |
rbd mirror image enable P/I {journal,snapshot} / disable | روشن کردن برای یک image |
rbd mirror image {promote [--force],demote,resync} P/I | failover، failback و همگامسازی دوباره |
rbd mirror image status P/I | وضعیت دقیق یک image |
rbd mirror image snapshot P/I | snapshot دستی mirror |
rbd mirror snapshot schedule {add,ls,status,remove} [--pool P] [--image I] INTERVAL [START] | زمانبند snapshot |
rbd journal {info,status,inspect,export,import,reset} | journal یک image |
ceph orch apply rbd-mirror --placement=N | استقرار daemonها با cephadm |
ceph daemon /var/run/ceph/ceph-client.rbd-mirror.*.asok rbd mirror status | وضعیت داخلی daemon |
مثال (rbd mirror image status rbd/vm01 در حالت snapshot):
vm01:
  global_id:   8c1e0a7d-3b52-4f0e-9d2a-6f1b3c4d5e6f
  state:       up+replaying
  description: replaying, {"bytes_per_second":41943040.0,"bytes_per_snapshot":12884901888.0,
               "local_snapshot_timestamp":1794801600,"remote_snapshot_timestamp":1794802500,
               "replay_state":"syncing","syncing_percent":37,"syncing_snapshot_timestamp":1794802500}
  service:     mirror.b on host-b2
last_update: 2026-11-15 10:56:31فاصلهی remote_snapshot_timestamp و local_snapshot_timestamp (۹۰۰ ثانیه) همان تأخیر فعلی مقصد، یعنی RPO واقعی در این لحظه است.
۳۹-۷ تنظیم و عیبیابی#
-
up+stopped در مقصد: معمولاً یعنی image در مقصد primary است یا دو طرف primary شدهاند (split-brain). rbd mirror image status و rbd info (پرچم mirroring primary) را در هر دو طرف ببینید؛ طرف نادرست را demote و سپس resync کنید. - journal مبدأ بزرگ میشود:
rbd journal status را ببینید؛ اگر peer عقب است، rbd-mirror کند است یا قطع شده است. پهنای باند، rbd_mirror_memory_target و تعداد daemonها را بررسی کنید. - همگامسازی کامل طولانی:
rbd_mirror_concurrent_image_syncs (پیشفرض ۵) را با احتیاط افزایش دهید؛ هر sync خواندن سنگینی روی مبدأ دارد. - snapshotهای mirror انباشته میشوند: peer قدیمی حذفنشده هنوز در
mirror_peer_uuids است. rbd mirror pool info را بررسی و peer مرده را حذف کنید. - RPO حالت snapshot زیاد است: فاصلهی زمانبند را کم کنید، ولی نه کمتر از زمانی که هر دور کپی واقعاً طول میکشد (
syncing_percent را دنبال کنید).
۳۹-۸ تکمیلی و بهروز#
- mirroring گروههای consistency (چند image با snapshot همزمان) در شاخهی main در حال توسعه است؛ پیش از استفاده بررسی کنید نسخهی شما آن را دارد.
- پیامهای وضعیت در
status_global_<gid> و remote_status_global_<gid> در rbd_mirroring نگه داشته میشوند تا هر طرف وضعیت طرف دیگر را هم ببیند. - از Octopus، حالت snapshot در دسترس است و برای بیشتر کاربردها پیشنهاد میشود؛ حالت journal برای RPO بسیار کم با کلاینت librbd باقی مانده است.
۳۹-۹ تمرین عملی#
- ۱. روی یک image آزمایشی journaling را فعال کنید، با
rbd bench بنویسید و رشد journal_data.* را با rados ls دنبال کنید. سپس rbd journal inspect --verbose چند رویداد را نشان دهد. - ۲. یک شیء journal را با
rados get بخوانید و با xxd پیشدرآمد 93 97 58 53 26 59 41 31 و فیلدهای پس از آن را پیدا کنید. - ۳. در حالت snapshot زمانبند ۵ دقیقهای بگذارید، بار نوشتن تصادفی و ترتیبی را جداگانه اجرا کنید و
bytes_per_snapshot را مقایسه کنید. - ۴. یکی از دو daemon rbd-mirror را متوقف و زمان انتقال imageهای آن به daemon دیگر را اندازه بگیرید.
۳۹-۱۰ پرسشهای مرور#
- ۱. نام اشیای header و دادهی journal چیست؟
- ۲. رویداد با entry_tid ۱۲۳۴ در journal با splay_width ۴ و active_set ۹ در کدام شیء نوشته میشود؟
- ۳. سربار ثابت هر رویداد journal چند بایت است و از چه فیلدهایی تشکیل میشود؟
- ۴. چرا نوشتن داده باید منتظر SAFE شدن رویداد بماند؟
- ۵. چه چیزی جلوی trim شدن journal را میگیرد؟
- ۶. چرا مقصد در حالت journal همیشه crash-consistent است؟
- ۷. چهار حالت snapshot mirror کداماند؟
- ۸. rbd-mirror در حالت snapshot چگونه اشیای تغییرکرده را پیدا میکند؟
- ۹. چه زمانی حالت snapshot پهنای باند بیشتری از حالت journal مصرف میکند؟
- ۱۰. leader در rbd-mirror چگونه انتخاب میشود و پس از چه مدتی جایگزین میشود؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۹-۱۱ منابع این فصل#
- کتابخانهی journal (Entry.cc، JournalRecorder.cc، Journaler.cc
https://github.com/ceph/ceph/tree/main/src/journal - cls_journal.cc
https://github.com/ceph/ceph/blob/main/src/cls/journal/cls_journal.cc - librbd/journal و Types.h
https://github.com/ceph/ceph/tree/main/src/librbd/journal - rbd-mirror
https://github.com/ceph/ceph/tree/main/src/tools/rbd_mirror - cls_rbd_types.h (MirrorSnapshotNamespace
https://github.com/ceph/ceph/blob/main/src/cls/rbd/cls_rbd_types.h - مستند mirroring
https://docs.ceph.com/en/latest/rbd/rbd-mirroring/ - گزینههای rbd-mirror
https://docs.ceph.com/en/latest/rbd/rbd-config-ref/