لایههای پایینی (۷): کلاینتهای هستهی لینوکس، libceph، krbd و ceph.ko
حوصله ندارم این فصل در چند خط
- کلاینتهای هستهی Linux عبارتاند از libceph (پیامرسان و کلاینت MON و OSD)، krbd برای دستگاه بلوکی و ceph.ko برای CephFS.
-
ceph_osdc درخواستها را میسازد، OSD مقصد را از روی نقشهها محاسبه میکند و پس از تغییر نقشه دوباره میفرستد. - striper مشترک، offset در دستگاه یا فایل را به یک شیء و offset درون آن نگاشت میکند.
- krbd روی
rbd_header یک watch و قفل انحصاری دارد؛ ceph.ko تأخیر و آمار فایلها را از دید کلاینت در debugfs نشان میدهد.
۲۹-۱ مقدمه: Ceph درون هسته#
همهی کلاینتهای فصلهای قبل، یعنی librados، librbd، ceph-fuse و RGW، در فضای کاربر اجرا میشوند و از کد C++ مشترک Ceph (Objecter و AsyncMessenger) استفاده میکنند. هستهی لینوکس اما پیادهسازی کاملاً مستقلی به زبان C دارد: ماژول libceph (پوشهی net/ceph/) که messenger، کلاینت mon و OSD، CRUSH و cephx را پیاده میکند. دو مصرفکنندهی آن rbd.ko (فایل drivers/block/rbd.c) و ceph.ko (پوشهی fs/ceph/) هستند. این فصل هر سه را بررسی میکند. منبع، شاخهی master در مخزن torvalds/linux است و کد هسته GPL-2.0 دارد. در این فصل فقط نام توابع و ثابتها را آوردهایم و منطق را به زبان خود توضیح دادهایم.
-
libceph شامل این بخشهاست: messenger.c بههمراه messenger_v1.c و messenger_v2.c، osd_client.c، mon_client.c، osdmap.c، crush/ (همان mapper.c و hash.c مربوط به Ceph)، auth_x.c (cephx) و striper.c. - krbd هر درخواست blk-mq را به یک
rbd_img_request و سپس به چند rbd_obj_request (یکی برای هر شیء ۴M) تبدیل میکند. هرکدام یک ceph_osd_request با opهایی مثل WRITE، WRITEFULL، ZERO یا DELETE است. - ویژگیهای پشتیبانیشدهی krbd شامل layering، striping v2، exclusive-lock، object-map، fast-diff، deep-flatten، data-pool و operations است. journaling پشتیبانی نمیشود.
- از هستهی ۵٫۱۱، msgr2.1 با گزینهی
ms_mode پشتیبانی میشود. حالت secure از gcm(aes) در crypto API هسته استفاده میکند. - ceph.ko هماهنگی کش را با caps مربوط به MDS انجام میدهد. caps تعیین میکنند چه چیزی را میتوان کش، بافر یا مستقیم خواند و نوشت.
۲۹-۲ libceph: ساختار#
| فایل | نقش | معادل در فضای کاربر |
|---|---|---|
ceph_common.c | ceph_client، تجزیهی گزینهها (mon_addr، name، secret، ms_mode) | CephContext + librados::Rados |
messenger.c / _v1.c / _v2.c | ceph_connection، ماشین وضعیت، banner و frameها | AsyncConnection + ProtocolV1/V2 |
mon_client.c | اشتراک نقشهها، hunting بین monها با backoff، احراز هویت | MonClient |
osd_client.c | ceph_osd_request، calc_target، send_request، linger (watch/notify)، timeout | Objecter |
osdmap.c + crush/ | decode کردن OSDMap و اجرای CRUSH در هسته | OSDMap + CrushWrapper |
auth_x.c | cephx (ticket، authorizer) | auth/cephx |
striper.c | نگاشت بازهی فایل یا تصویر به اشیا | Striper |
net/ceph/crush/mapper.c و hash.c در هسته در اصل همان فایلهای src/crush/ در Ceph هستند. شرطهای #ifdef __KERNEL__ در ابتدای hash.c در Ceph (فصل ۲۸) برای همین اشتراکاند. نتیجه این است که کلاینت هسته دقیقاً همان PG→OSD را محاسبه میکند که librados. ولی پشتیبانی از tunableها و قابلیتهای جدید CRUSH به نسخهی هسته بستگی دارد. اگر خوشه قابلیتی را لازم کند که هسته نمیشناسد، mount یا map با خطای feature mismatch شکست میخورد و در dmesg پیام missing required protocol features دیده میشود.
۲۹-۲-۱ osd_client: مسیر یک درخواست#
- ۱. ساخت:
ceph_osdc_alloc_request و توابع osd_req_op_*_init (مثلاً extent، cls یا watch) opها را میسازند. داده بهصورت ceph_osd_data (فهرست bio، bvec یا صفحهها) بدون کپی متصل میشود. - ۲. هدفیابی:
calc_target با OSDMap فعلی شیء را به PG و سپس به primary نگاشت میکند (با upmap و pg_temp). اگر نقشه تغییر کند، درخواستهای در جریان دوباره هدفیابی و ارسال میشوند. - ۳. ارسال:
send_request بررسیهایی انجام میدهد: اگر پرچم PAUSEWR در نقشه باشد یا pool پر باشد (pool_full) و درخواست نوشتن بدون CEPH_OSD_FLAG_FULL_TRY باشد، درخواست نگه داشته میشود تا نقشهی بعدی برسد. سپس پیام MOSDOp روی ceph_connection مربوط به آن OSD صف میشود. - ۴. پاسخ:
handle_reply نتیجه را با tid پیدا و callback (مثلاً rbd_osd_req_callback) را صدا میزند. - ۵. linger: watchهای RBD (برای header و exclusive lock) بهصورت
ceph_osd_linger_request نگه داشته و پس از هر تغییر نقشه یا بازاتصال دوباره ثبت میشوند.
رفتار پیشفرض کلاینت هسته در برابر pool پر یا خوشهی متوقف، انتظار نامحدود است، نه خطا. برنامهای که روی /dev/rbd0 یا CephFS هستهای مینویسد، در وضعیت D (uninterruptible) گیر میکند. گزینهی osd_request_timeout (در rbd map -o یا mount) این را محدود میکند، ولی پیامد آن خطای I/O برای فایلسیستم بالایی است. پیش از تنظیم آن، اثرش را بسنجید.
۲۹-۳ krbd: از blk-mq تا شیء#
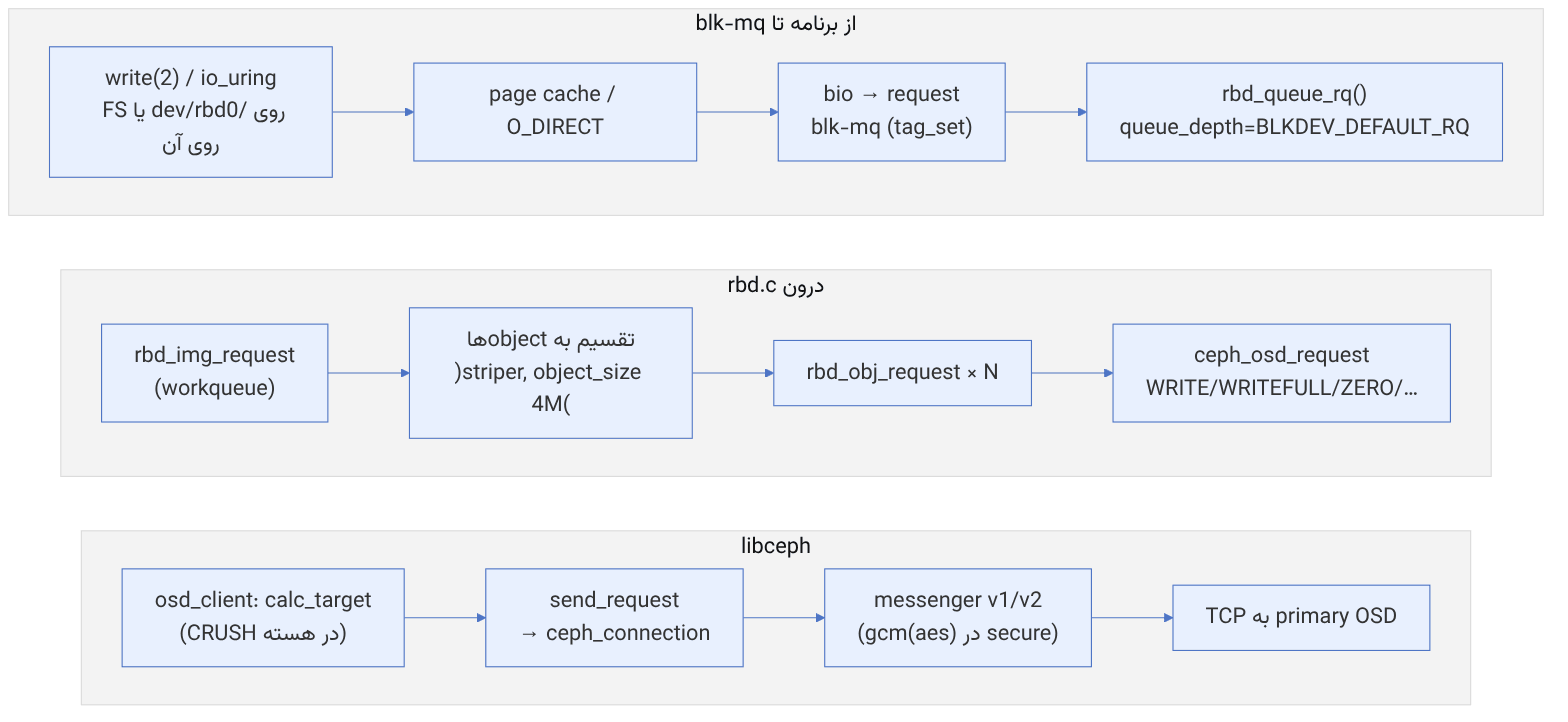
محدودیتهای صف که rbd.c تنظیم میکند، مستقیم از ساختار تصویر میآیند: io_opt برابر اندازهی یک object set (object_size × stripe_count) است، io_min برابر alloc_size (پیشفرض ۶۴K، RBD_ALLOC_SIZE_DEFAULT) و discard_granularity هم برابر alloc_size. فایلسیستمهایی مثل XFS این مقادیر را در mkfs میخوانند تا همترازی را تنظیم کنند.
| نوع I/O در blk-mq | op روی OSD (در __rbd_osd_setup_write_ops و مشابه) |
|---|---|
| read | CEPH_OSD_OP_READ (یا sparse-read) |
| write که کل شیء را بپوشاند | CEPH_OSD_OP_WRITEFULL |
| write جزئی | CEPH_OSD_OP_WRITE (پس از SETALLOCHINT با اندازهی شیء) |
| discard یا write-zeroes در انتهای شیء | CEPH_OSD_OP_TRUNCATE |
| discard یا write-zeroes در میانه | CEPH_OSD_OP_ZERO |
| discard کل شیء (بدون parent) | CEPH_OSD_OP_DELETE |
۲۹-۴ krbd در عمل#
rbd map rbd/img1 -o ms_mode=prefer-crc,queue_depth=256,alloc_size=65536
rbd showmapped
cat /sys/block/rbd0/queue/{optimal_io_size,minimum_io_size,discard_granularity,nr_requests}
cat /sys/bus/rbd/devices/0/{pool,name,image_id,features,current_snap}
# درخواستهای در جریان libceph (debugfs):
mount -t debugfs none /sys/kernel/debug 2>/dev/null
cat /sys/kernel/debug/ceph/*/osdc # tid، osd، pg، شیء، op
cat /sys/kernel/debug/ceph/*/monc # نقشهها و mon جاری
cat /sys/kernel/debug/ceph/*/client_optionsخروجی osdc مهمترین ابزار تشخیص «گیر کردن» کلاینت هسته است. اگر یک tid برای مدت طولانی روی یک OSD باقی بماند، با ceph daemon osd.N dump_ops_in_flight روی همان OSD ادامهی ماجرا را پیدا کنید (فصل ۲۲). اگر همهی درخواستها روی osd-1 (بدون هدف) باشند، کلاینت نقشهی معتبری ندارد. در این صورت monc و ارتباط با monها را بررسی کنید.
گزینهی rbd map -o | پیشفرض (طبق کد master) | نکته |
|---|---|---|
queue_depth | BLKDEV_DEFAULT_RQ | عمق صف blk-mq |
alloc_size | ۶۵۵۳۶ | io_min و discard_granularity |
lock_timeout | ۰ (بدون timeout) | انتظار برای exclusive lock |
read_only / ro | false | — |
ms_mode | legacy (msgr۱) | crc، secure، prefer-crc یا prefer-secure از ۵٫۱۱ |
exclusive | خاموش | قفل را رها نکن (برای fencing) |
notrim | خاموش | discard را نادیده بگیر (برای thick provisioning) |
پیشفرض ms_mode را در مستند هسته (Documentation/filesystems/ceph.rst برای CephFS و man page مربوط به rbd برای krbd) بررسی کنید. در کد master مربوط به net/ceph/ceph_common.c، مقدار اولیهی con_modes برابر CEPH_CON_MODE_UNKNOWN است که بهمعنای استفاده از msgr1 (legacy) است. بنابراین اگر monها فقط روی v2 گوش دهند، باید ms_mode را صراحتاً تنظیم کنید.
۲۹-۵ ceph.ko و caps#
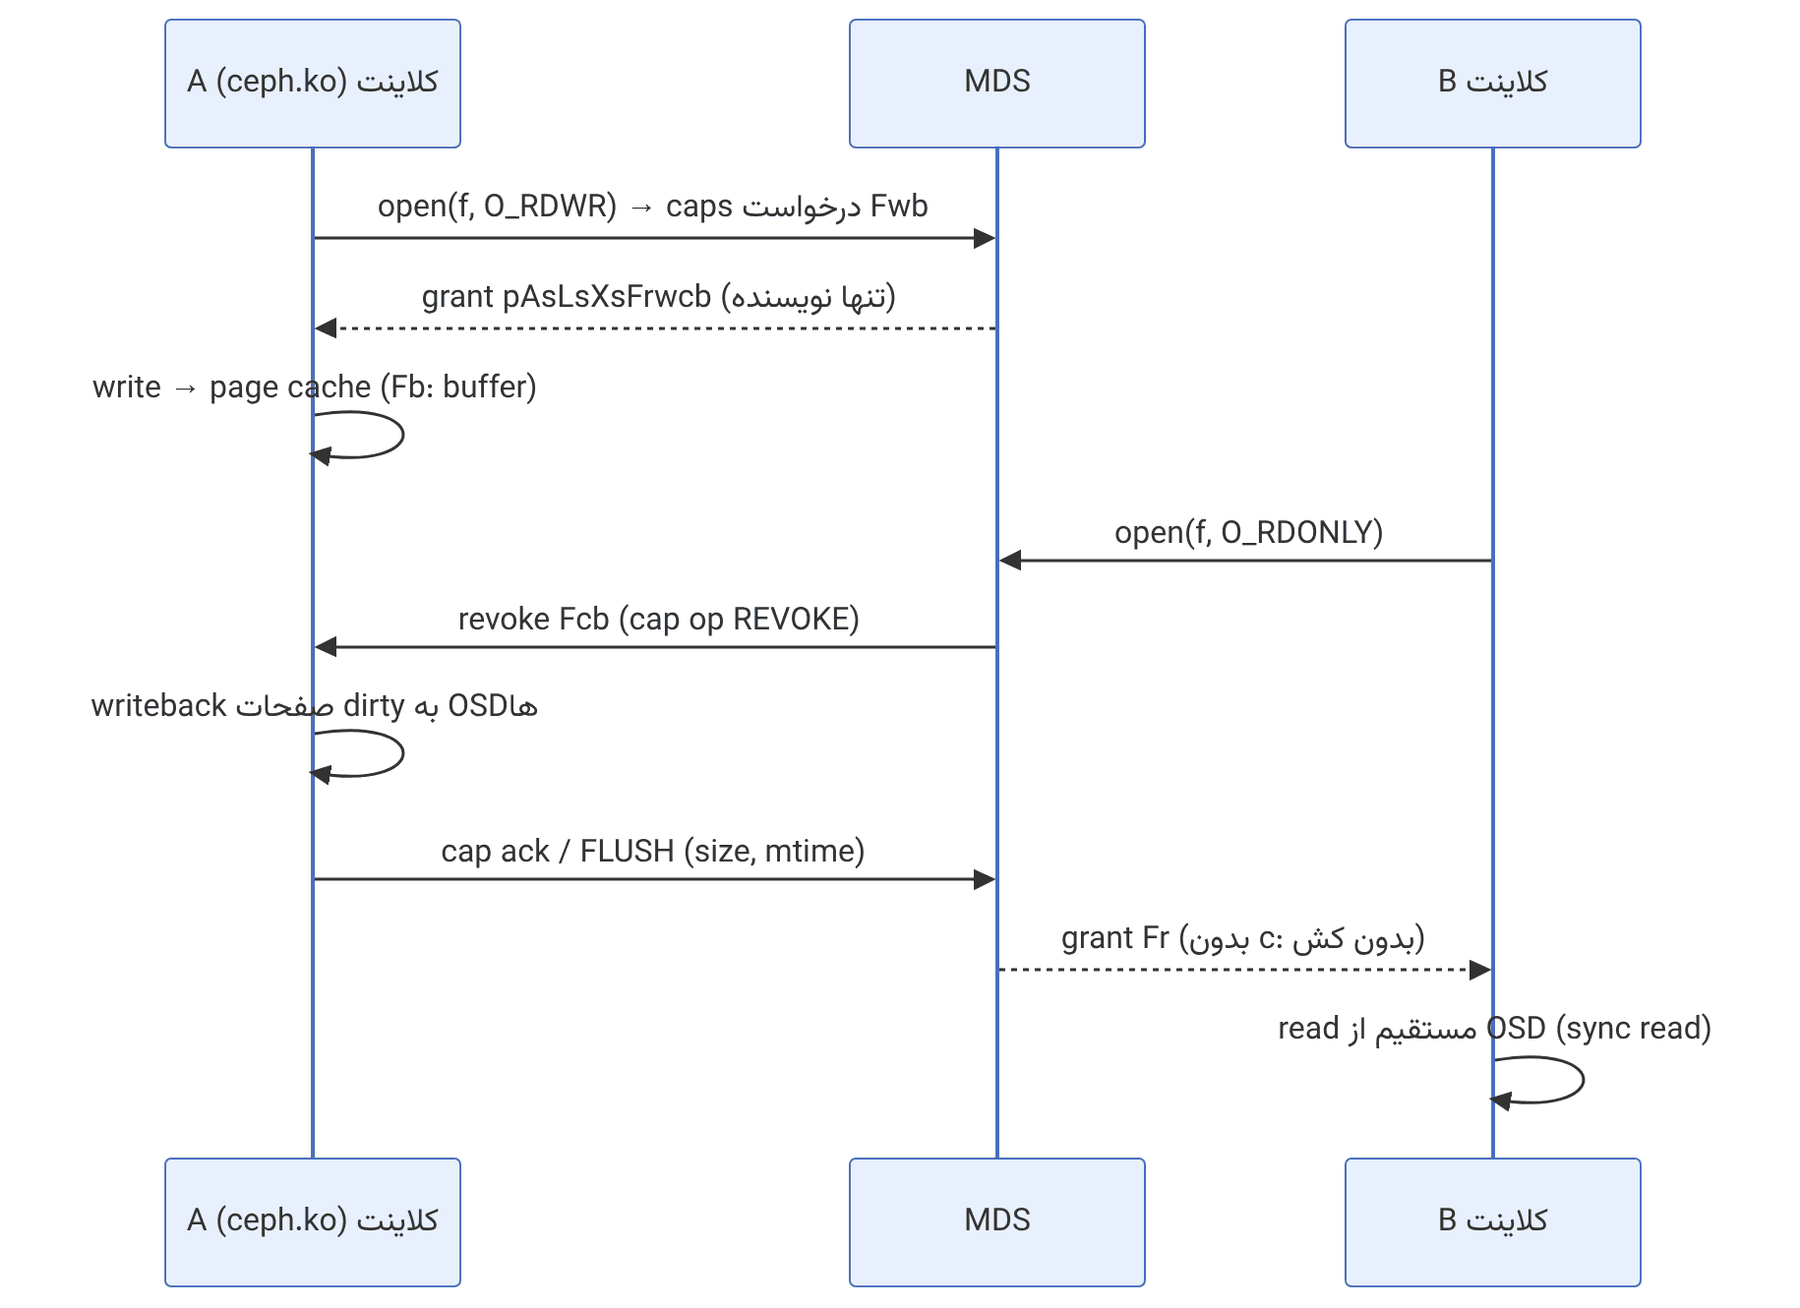
caps یک بیتماسکاند که با «زیرسیستم» جابهجا (shift) میشوند. بیتهای عمومی (include/linux/ceph/ceph_fs.h و معادل آن در Ceph) اینها هستند:
| بیت | نام | معنی برای زیرسیستم File |
|---|---|---|
| ۱ | GSHARED (s) | خواندن ویژگیها |
| ۲ | GEXCL (x) | خواندن و تغییر انحصاری |
| ۴ | GCACHE (c) | کش کردن خواندن (page cache معتبر) |
| ۸ | GRD (r) | خواندن |
| ۱۶ | GWR (w) | نوشتن |
| ۳۲ | GBUFFER (b) | بافر کردن نوشتن (writeback) |
| ۶۴ | GWREXTEND (a) | گسترش EOF |
| ۱۲۸ | GLAZYIO (l) | lazy I/O |
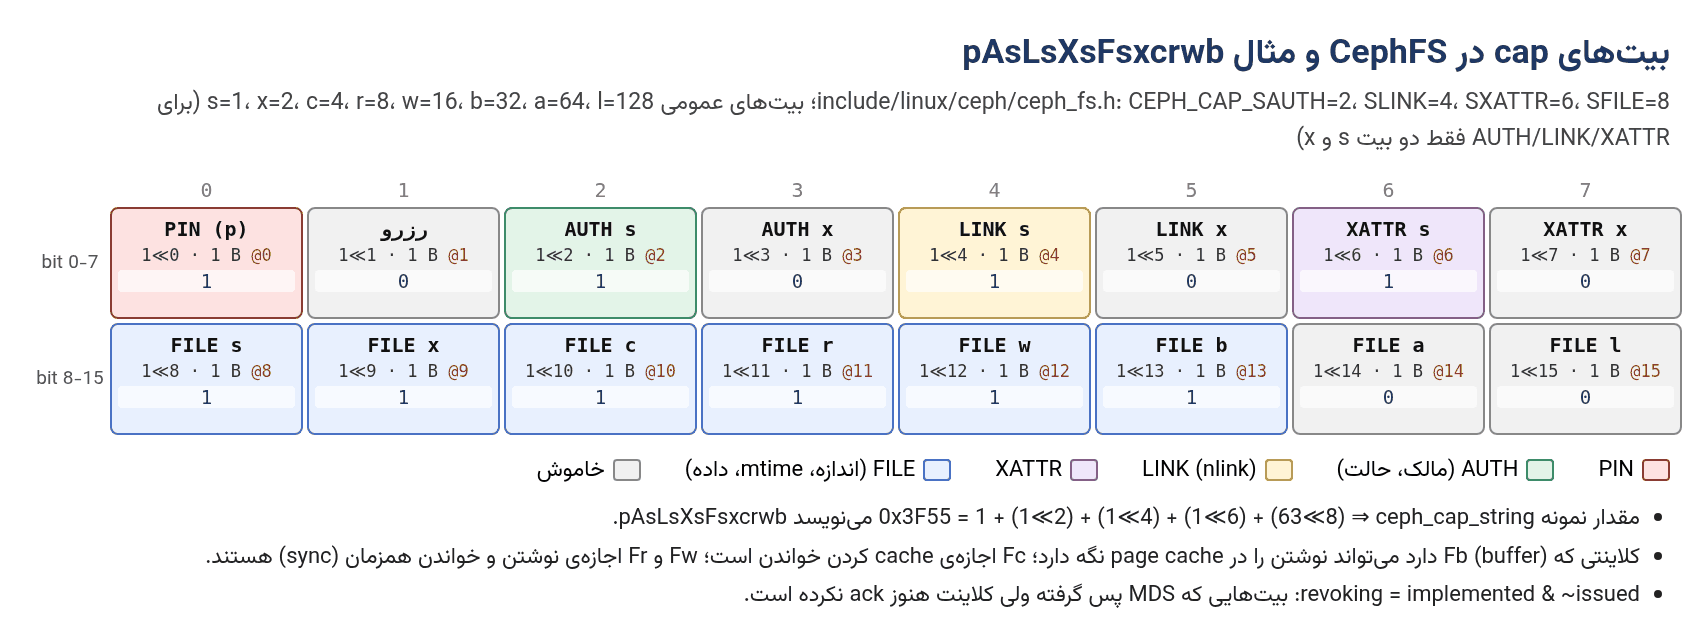
shiftها عبارتاند از SAUTH=2 (A: مالک و mode)، SLINK=4 (L: تعداد link)، SXATTR=6 (X: xattrها) و SFILE=8 (F: داده و اندازه). به همین دلیل رشتهای مثل pAsLsXsFrwcb در ceph tell mds.0 session ls یا debugfs یعنی: pin، Auth shared، Link shared، Xattr shared و File read/write/cache/buffer.
pseudocode: نوشتن در ceph.ko (خلاصهی این کتاب از منطق fs/ceph/file.c و caps.c)
ceph_write_iter:
need = Fw (+ Fb اگر بافرشده)، want = Fb
ceph_get_caps(need, want) # اگر نیست → درخواست به MDS و انتظار
if have Fb: generic_perform_write → page cache (writeback بعداً)
else: ceph_sync_write → osd_client مستقیم (بدون کش)
ceph_put_cap_refs
MDS revoke(Fb):
writeback همهی صفحات dirty → OSD
ceph_check_caps → cap ack همراه size و mtimeاگر کلاینت هستهای پاسخ revoke را ندهد (مثلاً چون OSDها کند هستند یا خود کلاینت گیر کرده است)، MDS هشدار سلامت با کد MDS_HEALTH_CLIENT_LATE_RELEASE و پیام «Client … failing to respond to capability release» میدهد (در mds/Beacon.cc) و کلاینتهای دیگر منتظر میمانند. پس از mds_session_blocklist_on_timeout و timeoutهای session، MDS کلاینت را evict و blocklist میکند. سپس کلاینت هستهای تا remount خطای I/O میگیرد، مگر آنکه recover_session=clean تنظیم شده باشد.
۲۹-۶ هسته در برابر فضای کاربر#
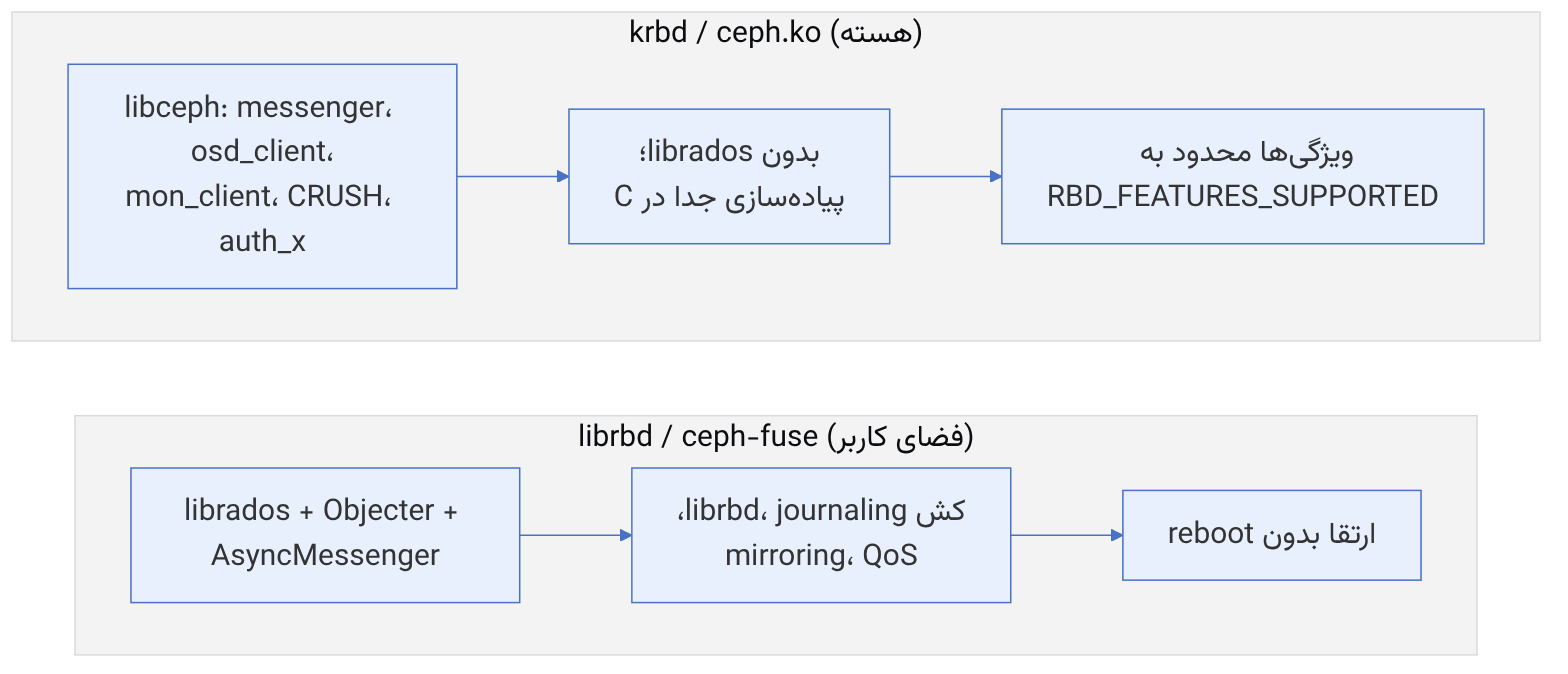
| جنبه | krbd / ceph.ko | librbd (qemu، rbd-nbd) / ceph-fuse |
|---|---|---|
| عملکرد | کمترین سربار؛ بدون context switch اضافه | یک لایهی بیشتر (nbd یا fuse)، ولی librbd در qemu بسیار کاراست |
| ویژگیها | محدود به RBD_FEATURES_SUPPORTED؛ بدون journaling | همهی ویژگیها |
| ارتقا | نیازمند هستهی جدید و reboot یا بارگذاری دوبارهی ماژول | ارتقای بسته |
| خرابی | panic یا hang در هسته، فرایندهای گیرکرده در وضعیت D | فقط فرایند کاربر |
| کش | page cache هسته (و caps در CephFS) | کش librbd و client_oc در ceph-fuse |
۲۹-۷ لایهی پایینتر: از آفست فایل تا OSD در هسته#
۲۹-۷-۱ نگاشت آفست به شیء (striper)#
هر دو کلاینت هسته، krbd و ceph.ko، برای تبدیل «آفست در دستگاه یا فایل» به «شیء و آفست درون شیء» از یک تابع مشترک در net/ceph/striper.c استفاده میکنند: ceph_calc_file_object_mapping و نسخهی چندبخشی آن ceph_file_to_extents. ورودی یک layout با سه عدد است: stripe_unit (su)، stripe_count (sc) و object_size (os).
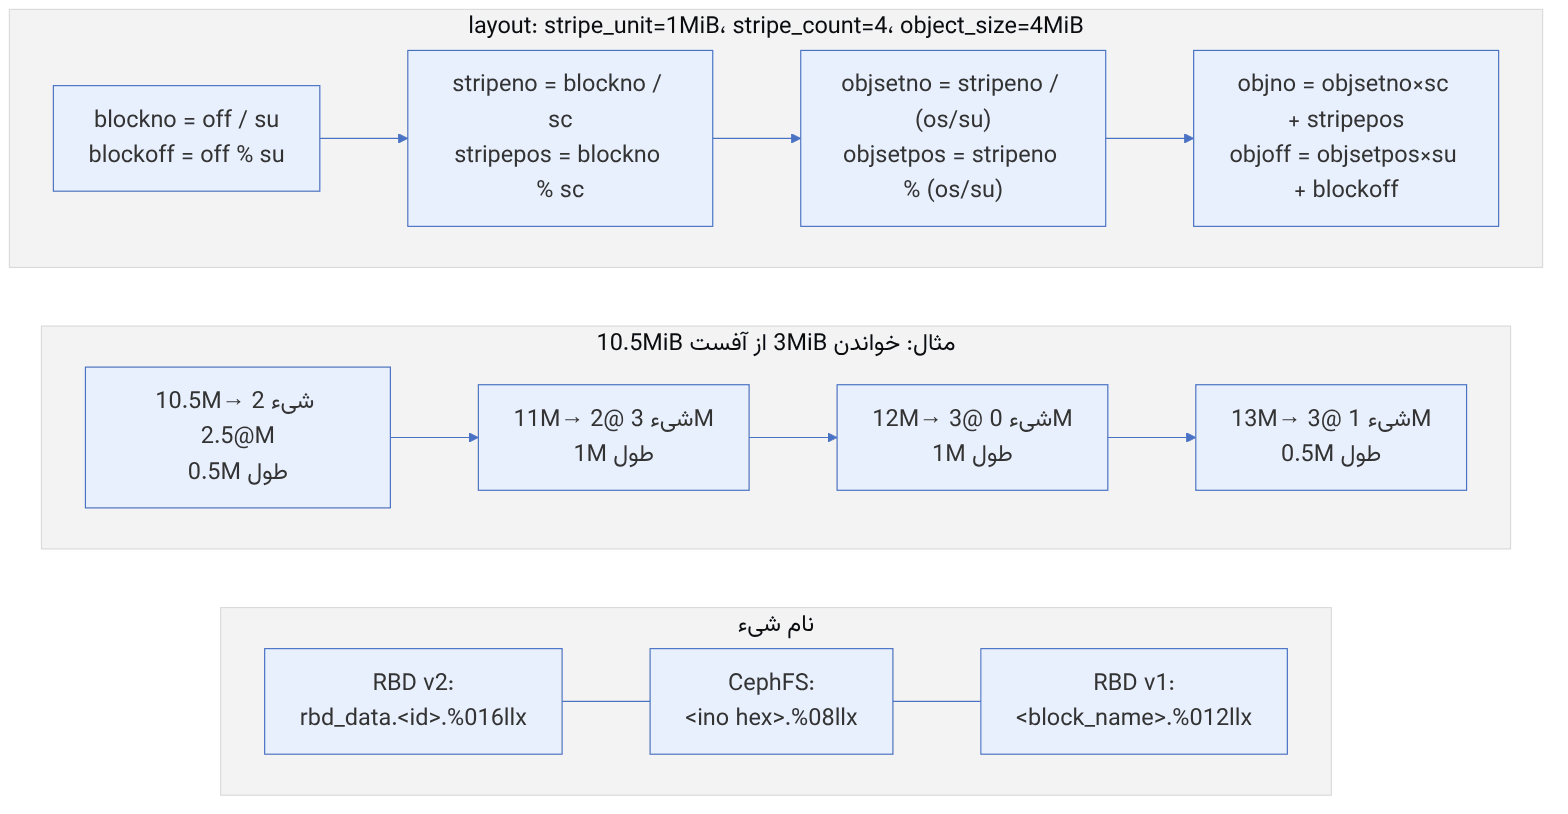
pseudocode: نگاشت یک آفست (بازنویسی این کتاب)
  stripes_per_object = os / su
  blockno,  blockoff  = divmod(off, su)
  stripeno, stripepos = divmod(blockno, sc)
  objset,   setpos    = divmod(stripeno, stripes_per_object)
  objno  = objset * sc + stripepos
  objoff = setpos * su + blockoff
len_in_this_object = min(len, su - blockoff)| تکه | آفست منطقی | blockno | stripeno / pos | شیء | آفست در شیء | طول |
|---|---|---|---|---|---|---|
| ۱ | ۱۰.۵ MiB | ۱۰ | ۲ / ۲ | ۲ | ۲.۵ MiB | ۰.۵ MiB |
| ۲ | ۱۱ MiB | ۱۱ | ۲ / ۳ | ۳ | ۲ MiB | ۱ MiB |
| ۳ | ۱۲ MiB | ۱۲ | ۳ / ۰ | ۰ | ۳ MiB | ۱ MiB |
| ۴ | ۱۳ MiB | ۱۳ | ۳ / ۱ | ۱ | ۳ MiB | ۰.۵ MiB |
این جدول را با یک پیادهسازی مستقل از همین فرمول محاسبه کردهایم. برای layout پیشفرض RBD (su=os=۴MiB، sc=1) فرمول ساده میشود: objno = off / ۴MiB. مثلاً آفست ۱۰MiB به شیء ۲ با آفست ۲MiB میرود. krbd وقتی su با os برابر نباشد (ویژگی STRIPINGV2 که در RBD_FEATURES_ALL هسته هست) مسیر کپیدار rbd_img_fill_request را بهجای مسیر بدون کپی (rbd_img_fill_request_nocopy) انتخاب میکند، چون bioها باید بین چند شیء بریده شوند. striping «فانتزی» در krbd کار میکند، اما هزینهی CPU بیشتری دارد.
نام شیء#
| کلاینت | قالب | مثال |
|---|---|---|
| RBD v2 | RBD_V2_DATA_FORMAT = "%s.%016llx" روی object_prefix | rbd_data.10ab2c3d4e5f.0000000000000002 |
| RBD v1 (منسوخ) | "%s.%012llx" | rb.0.1234.000000000002 |
| CephFS | "%llx.%08llx" (inode، شمارهی شیء) | 10000000000.00000002 |
نام شیء ورودی مرحلهی بعد است. همانطور که فصل ۲۸ با نام rbd_data.10ab2c3d4e5f.0000000000000000 نشان داد، hash نام به PG و CRUSH به OSD میرسد. هسته همین زنجیره را با کد C خودش (کپی همنسخهی crush/ و ceph_hash.c) دوباره پیاده میکند. اگر نتیجه حتی یک بیت با سمت کاربر فرق کند، کلاینت هسته به OSD اشتباه میرود. به همین دلیل ویژگیهای CRUSH (tunables، straw2، MSR) فقط پس از پشتیبانی هسته قابل استفادهاند (فصل ۲۲، require-min-compat-client).
۲۹-۷-۲ calc_target: انتخاب OSD#
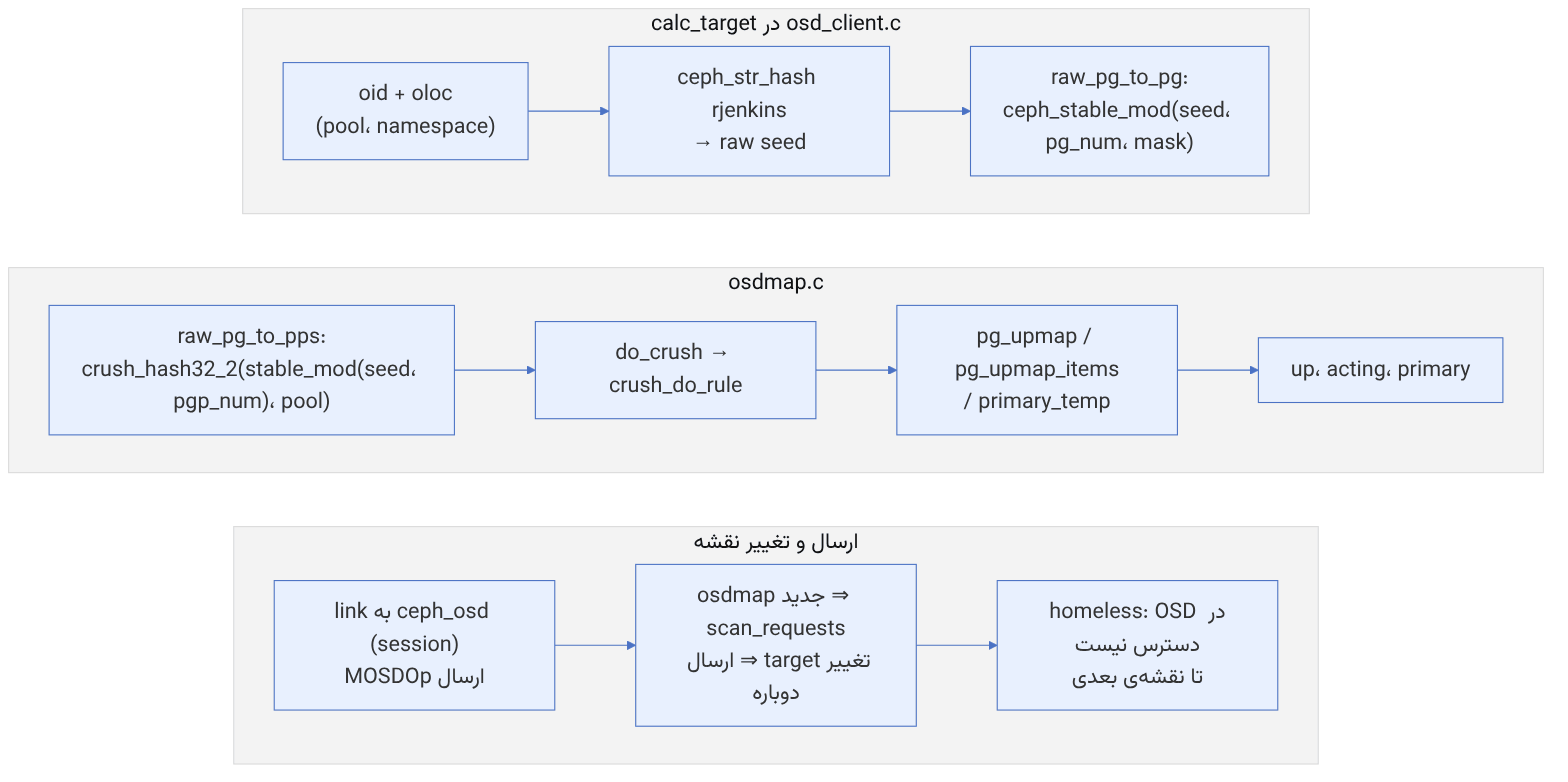
مراحل در net/ceph/osd_client.c و net/ceph/osdmap.c عبارتاند از:
- ۱.
__ceph_object_locator_to_pg: ابتدا ceph_str_hash(pool->object_hash, name) (rjenkins) روی نام شیء (و در صورت وجود، namespace) اعمال و seed خام ساخته میشود. - ۲.
raw_pg_to_pg: با ceph_stable_mod(seed, pg_num, pg_num_mask) شمارهی PG به دست میآید. stable_mod باعث میشود با دو برابر شدن pg_num فقط نیمی از اشیا جابهجا شوند (فصل ۲۸). - ۳.
raw_pg_to_pps: اگر پرچم HASHPSPOOL روشن باشد (پیشفرض poolهای امروزی)، crush_hash32_2(stable_mod(seed, pgp_num), pool_id) محاسبه میشود تا PGهای poolهای مختلف روی هم نیفتند. در حالت قدیمی، شناسهی pool با ps جمع میشد و PG 0.5 و ۱.۴ هممکان میشدند. - ۴.
do_crush و سپس اعمال pg_upmap، pg_upmap_items و primary_temp در ceph_pg_to_up_acting_osds. - ۵.
link_request درخواست را به session همان OSD (struct ceph_osd) وصل میکند. اگر OSD هدف down باشد، درخواست به homeless_osd پیوند میخورد و هیچ پیامی ارسال نمیشود تا نقشهی بعدی برسد.
چرا درخواستها «گیر» میکنند؟ در /sys/kernel/debug/ceph/<fsid>.client<id>/osdc، ستون اول شمارهی OSD هدف است. درخواستی که در آن عدد OSD نیست (homeless) یا مدتها روی یک OSD مانده، یعنی یا کلاینت نقشهی جدید را نگرفته (فایل osdmap را با epoch در ceph osd dump مقایسه کنید) یا PG هدف active نیست. در حالت دوم مشکل در سمت کلاستر است و باید ceph pg <pgid> query را بررسی کرد (فصل ۲۲)، نه کلاینت.
۲۹-۷-۳ watch و exclusive lock در krbd#
krbd روی شیء rbd_header.<id> یک linger request (watch) ثبت میکند. rbd_watch_cb اعلانها را دریافت میکند: HEADER_UPDATE (تغییر اندازه یا snapshot) و پیامهای قفل (ACQUIRED_LOCK، RELEASED_LOCK، REQUEST_LOCK). وقتی exclusive-lock فعال است و کلاینت دیگری (مثلاً librbd یک VM) قفل را دارد، krbd پیش از اولین نوشتن REQUEST_LOCK میفرستد و منتظر آزاد شدن قفل میماند. گزینهی نگاشت exclusive این رفتار را سختگیرانه میکند، یعنی قفل گرفته و پس داده نمیشود. linger requestها هم مثل درخواستهای عادی با هر osdmap دوباره ارزیابی میشوند و پس از قطع اتصال، watch دوباره ثبت میشود (reconnect watch). اگر این کار شکست بخورد، تصویر تغییرات اندازه را نمیبیند تا watch برگردد.
۲۹-۷-۴ اعداد CephFS در debugfs#
ceph.ko شاخهی metrics/ را در debugfs دارد. فایل latency تأخیر خواندن، نوشتن و metadata را از دید کلاینت میدهد و فایل file آمار باز و بسته شدن فایلها را. همین دادهها با پیام metrics به MDS فرستاده میشوند و در ceph fs top (ماژول mgr به نام stats) دیده میشوند. فایلهای caps، mdsc و mds_sessions بهترتیب شمار caps، درخواستهای MDS در جریان و وضعیت sessionها را نشان میدهند.
D=/sys/kernel/debug/ceph/*.client*
cat $D/osdc # درخواستهای OSD در جریان (tid، osd، pgid، oid)
cat $D/osdmap | head -3 # epoch نقشه از دید هسته
cat $D/metrics/latency # فقط ceph.ko
cat $D/caps | head
rbd showmapped; cat /sys/bus/rbd/devices/0/featuresdebugfs اطلاعات داخلی (نام اشیا، شناسهی inodeها و ...) را نشان میدهد و فقط برای root است. خروجی آن را بدون پاک کردن نامهای حساس در تیکتها کپی نکنید.
۲۹-۸ الگوریتمهای کلاینت هسته در سطح کد#
بخشهای پیشین مسیر را در سطح مفهوم نشان دادند. این بخش پنج الگوریتم کلیدی net/ceph و drivers/block/rbd.c و fs/ceph را با کد شاخهی اصلی هستهی لینوکس و مثال عددی بررسی میکند. شمارهی نسخهی هستهای که هر رفتار در آن آمده، اینجا ادعا نمیشود. برای هستهی توزیع خود، همان توابع را در درخت منبع همان نسخه بررسی کنید.
۲۹-۸-۱ تبدیل یک درخواست به extentهای شیء#
منبع در کد: net/ceph/striper.c :: ceph_file_to_extents، ceph_calc_file_object_mapping، lookup_last
پیچیدگی: O(L/su) گام برای درخواست L بایتی؛ lookup_last از انتهای فهرست مرتب جستوجو میکند، پس در الگوی ترتیبی O(۱) است
pseudocode
while len > 0:
(objno, objoff, xlen) = calc_file_object_mapping(off, len) # حداکثر تا پایان su
last = lookup_last(list, objno) # آخرین extent همان شیء
if last and last.off + last.len == objoff: last.len += xlen # ادغام پیوسته
else: extent تازه در جای مرتب
action_fn(ex, xlen) # krbd: ثبت bio_vec این تکه برای همان extent
off += xlen ; len −= xlen
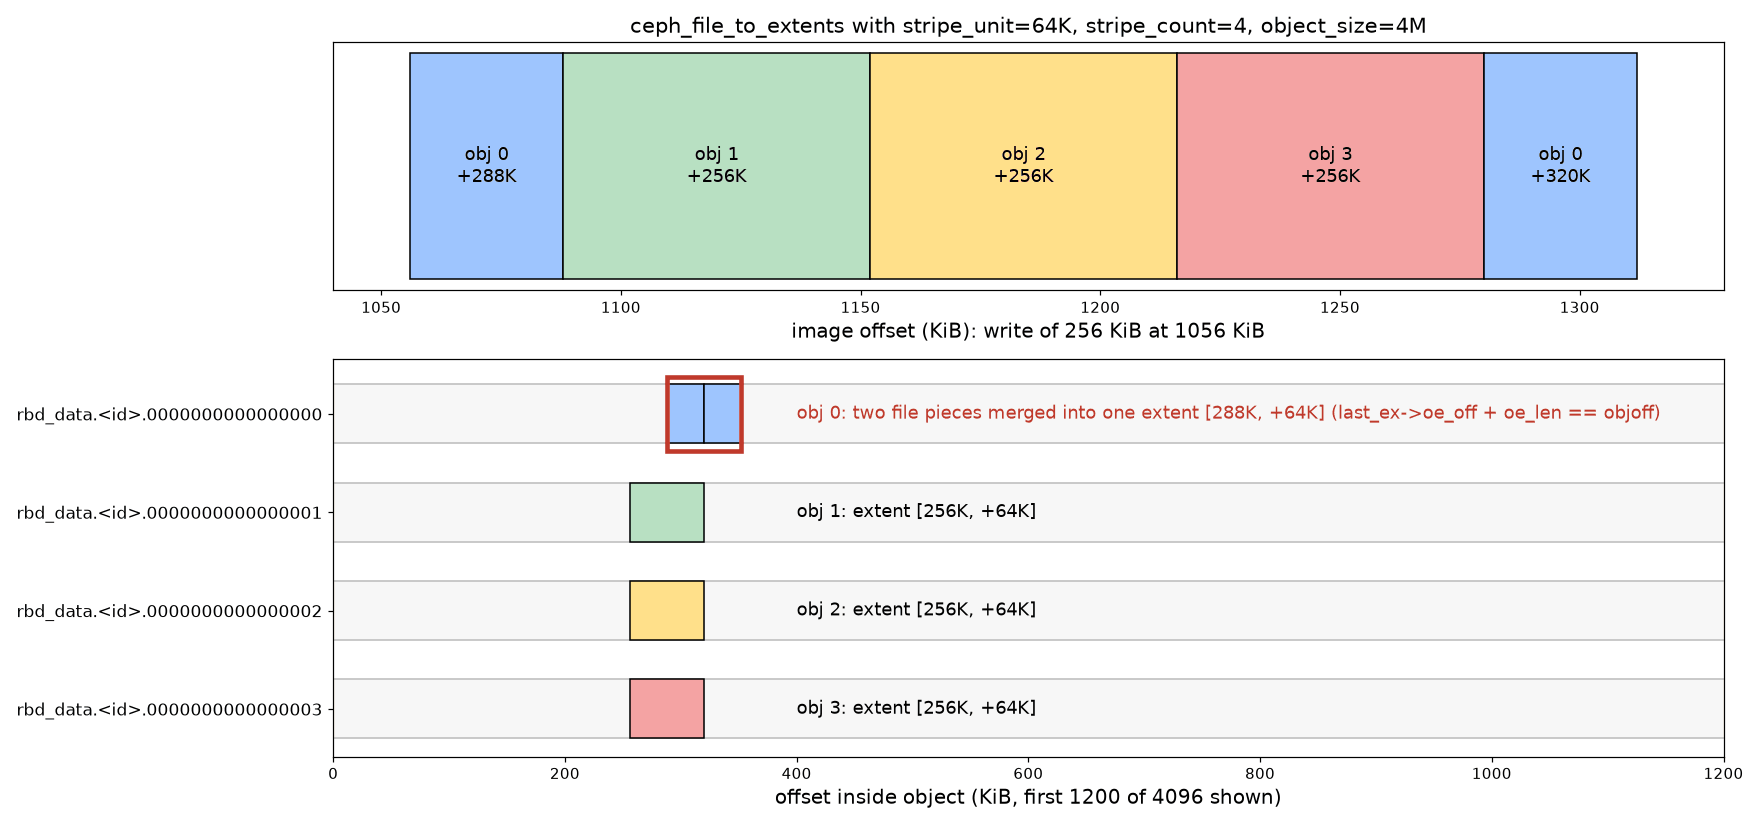
بررسی نهایی: فهرست بر حسب (objno, off) مرتب و بدون همپوشانی باشدمثال عددی. layout با stripe_unit = ۶۴K، stripe_count = ۴ و object_size = ۴M. یک نوشتن ۲۵۶K در آفست ۱۰۵۶K (یعنی ۱ MiB + ۳۲K) به پنج تکه شکسته میشود:
- ۳۲K به شیء ۰ در آفست ۲۸۸K؛
- ۶۴K به شیء ۱، ۶۴K به شیء ۲ و ۶۴K به شیء ۳، هرکدام در آفست ۲۵۶K؛
- ۳۲K پایانی دوباره به شیء ۰، در آفست ۳۲۰K.
تکهی پنجم دقیقاً پس از تکهی اول در شیء ۰ مینشیند (۲۸۸K + ۳۲K = ۳۲۰K)، پس lookup_last آن را ادغام میکند. نتیجه چهار درخواست OSD است، هرکدام ۶۴K، نه پنج. با layout پیشفرض RBD (su = os = ۴M، sc = ۱)، نوشتن ۴M در آفست ۳M دو extent میدهد: شیء ۰ [۳M، +۱M] و شیء ۱ [۰، +۳M].
۲۹-۸-۲ تصمیم بازفرستادن پس از نقشهی تازه#
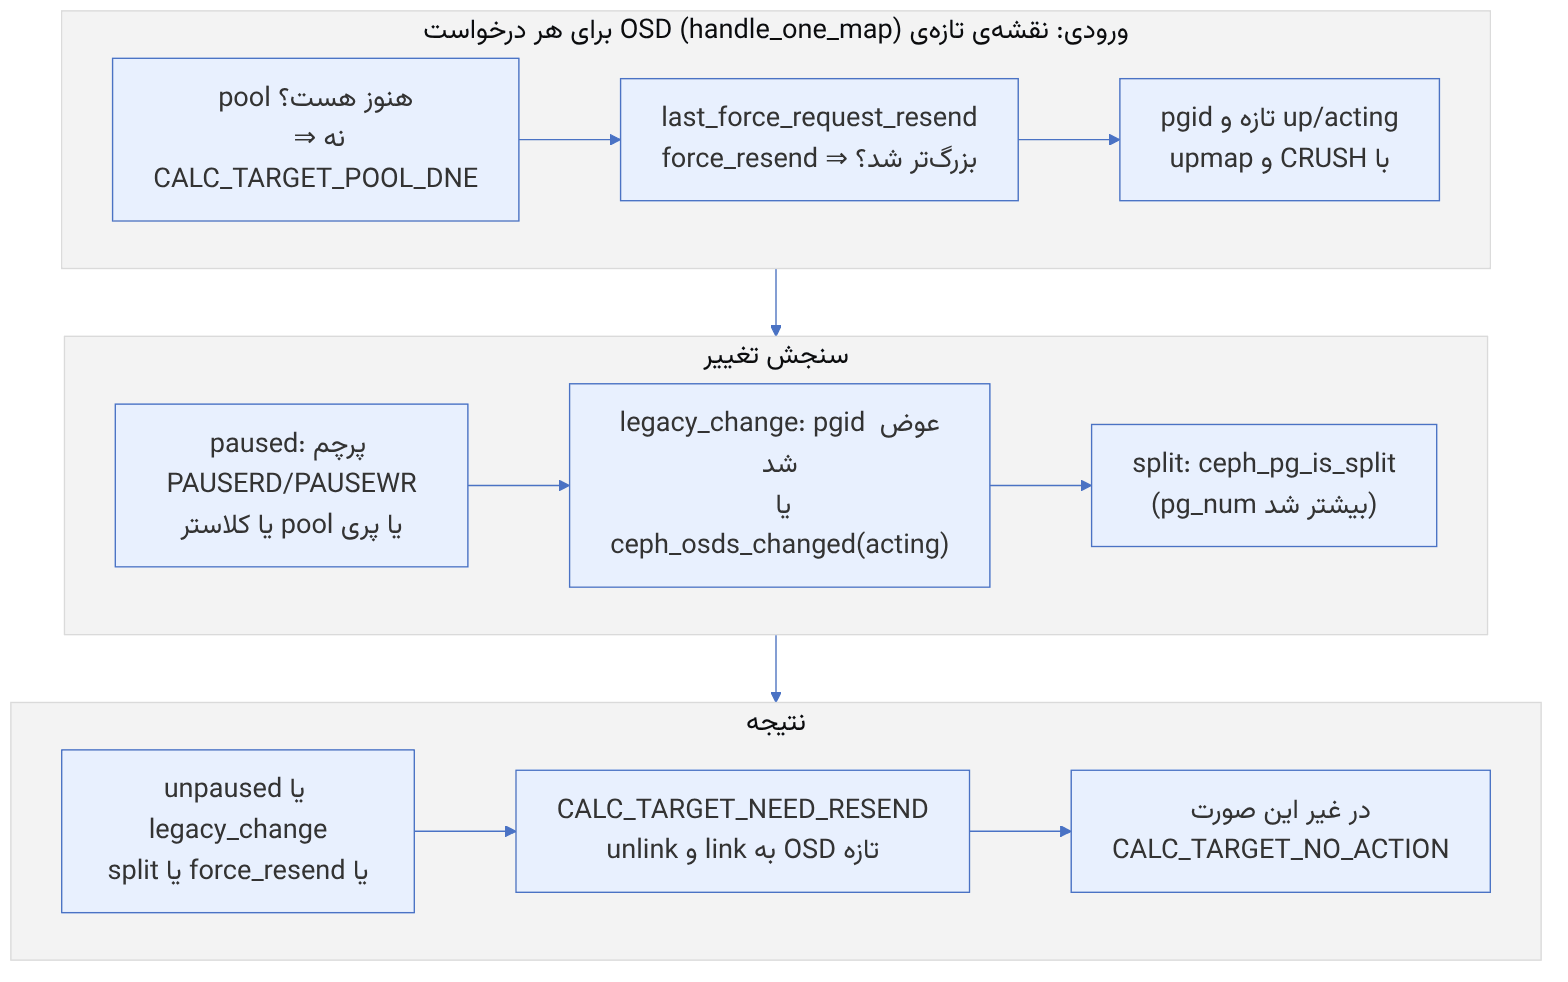
منبع در کد: net/ceph/osd_client.c :: calc_target، target_should_be_paused، ceph_osds_changed؛ net/ceph/osdmap.c :: ceph_pg_is_split
پیچیدگی: O(اندازهی acting + هزینهی CRUSH) برای هر درخواست در هر epoch تازه
pseudocode
pi = pool(t.base_oloc) ; if not pi: return POOL_DNE
if t.last_force_resend < pi.last_force_request_resend: force_resend = true
pgid = object_locator_to_pg(t.target_oid) ; (up, acting) = pg_to_up_acting_osds(pgid)
should_pause = PAUSERD/PAUSEWR یا pool/کلاستر پر (برای نوشتن)
unpaused = t.paused and not should_pause
legacy_change = pgid عوض شد or osds_changed(t.acting, acting)
split = t.pg_num and pg_is_split(last_pgid, t.pg_num, pi.pg_num)
return (unpaused or legacy_change or force_resend or split) ? NEED_RESEND : NO_ACTION
مثال عددی. یک درخواست در PG 3.1a (pg_num = ۶۴، acting = [۷، ۲، ۱۱]) منتظر است و epoch تازه میرسد:
- osd.11 مرده: acting به [۷، ۲، ۵] تغییر میکند. ceph_osds_changed true است، پس NEED_RESEND. اما primary همان osd.7 است و درخواست دوباره به همان session فرستاده میشود.
- pg_num از ۶۴ به ۱۲۸: شیء ممکن است به PG 3.5a برود. split برقرار است، پس درخواست دوباره هدفگیری و فرستاده میشود.
- فقط یک OSD بیربط عوض شده: NO_ACTION، و درخواست دست نمیخورد.
اگر پرچم pausewr روی کلاستر باشد، درخواستهای نوشتن paused میشوند. با برداشتن پرچم، unpaused همه را دوباره میفرستد. این همان موجی از ارسال است که پس از ceph osd unpause در debugfs (فایل osdc) دیده میشود.
۲۹-۸-۳ تشخیص کندی و نگهداری sessionها#
منبع در کد: net/ceph/osd_client.c :: handle_timeout، handle_osds_timeout، send_linger_ping؛ include/linux/ceph/libceph.h (پیشفرضها)
پیچیدگی: O(تعداد درخواستها و lingerها) در هر دور پنجثانیهای؛ O(تعداد session در LRU) در هر دور پانزدهثانیهای
pseudocode
handle_timeout (هر osd_keepalive_timeout = 5 s):
cutoff = now − 5 s
for each osd, each req: if req.r_stamp < cutoff: osd را در slow_osds بگذار # laggy
for each linger (watch) committed: send_linger_ping
if osd_request_timeout > 0: درخواستهای قدیمیتر از آن ⇒ abort با ETIMEDOUT
for osd in slow_osds: ceph_con_keepalive(osd.o_con)
handle_osds_timeout (هر osd_idle_ttl/4 = 15 s):
for osd in LRU: if now > osd.lru_ttl (= زمان بیکار شدن + 60 s): close_osdمثال عددی. درخواست B در t = ۳ s به osd.7 فرستاده شده و هنوز پاسخ نگرفته است. در دور t = ۱۰ s، cutoff = ۵ s و r_stamp = ۳ کمتر است. پس osd.7 کند شمرده میشود و یک KEEPALIVE روی اتصالش میرود. اگر اتصال واقعاً مرده باشد، شکست keepalive باعث fault و بازاتصال میشود و درخواست دوباره فرستاده میشود. با پیشفرض osd_request_timeout = 0، درخواست هرگز با خطا برنمیگردد. برای همین یک krbd روی کلاستر ناسالم «گیر» میکند، نه اینکه خطای I/O بدهد. session osd.3 که آخرین درخواستش در ۲.۲ s تمام شد، lru_ttl = ۶۲.۲ s دارد و در نخستین دور handle_osds_timeout پس از آن (حداکثر حدود ۱۵ ثانیه بعد) بسته میشود.
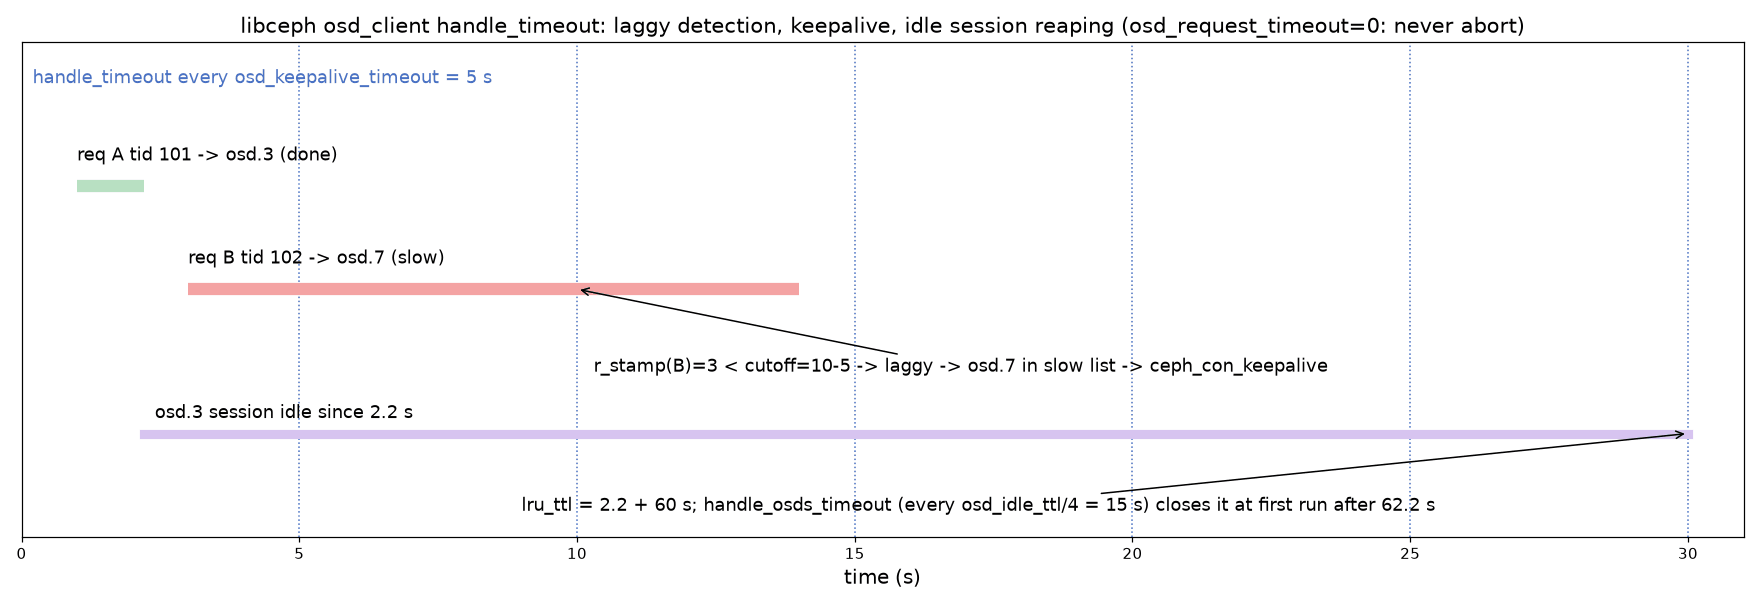
برای اینکه krbd به جای گیر کردن خطا بدهد (مثلاً در کلاستر آزمایشی یا وقتی یک لایهی بالاتر failover دارد)، گزینهی osd_request_timeout=<ثانیه> را در rbd map -o بدهید. در تولید با احتیاط استفاده کنید: خطای I/O روی فایلسیستم بالای آن ممکن است به حالت read-only برود.
۲۹-۸-۴ گرفتن exclusive lock در krbd#
منبع در کد: drivers/block/rbd.c :: rbd_acquire_lock، rbd_try_acquire_lock، rbd_try_lock، find_watcher، rbd_request_lock
پیچیدگی: O(تعداد watcherها) برای هر تلاش؛ در بدترین حالت چند دور با فاصلهی ۲ × RBD_NOTIFY_TIMEOUT = ۱۰ s
pseudocode
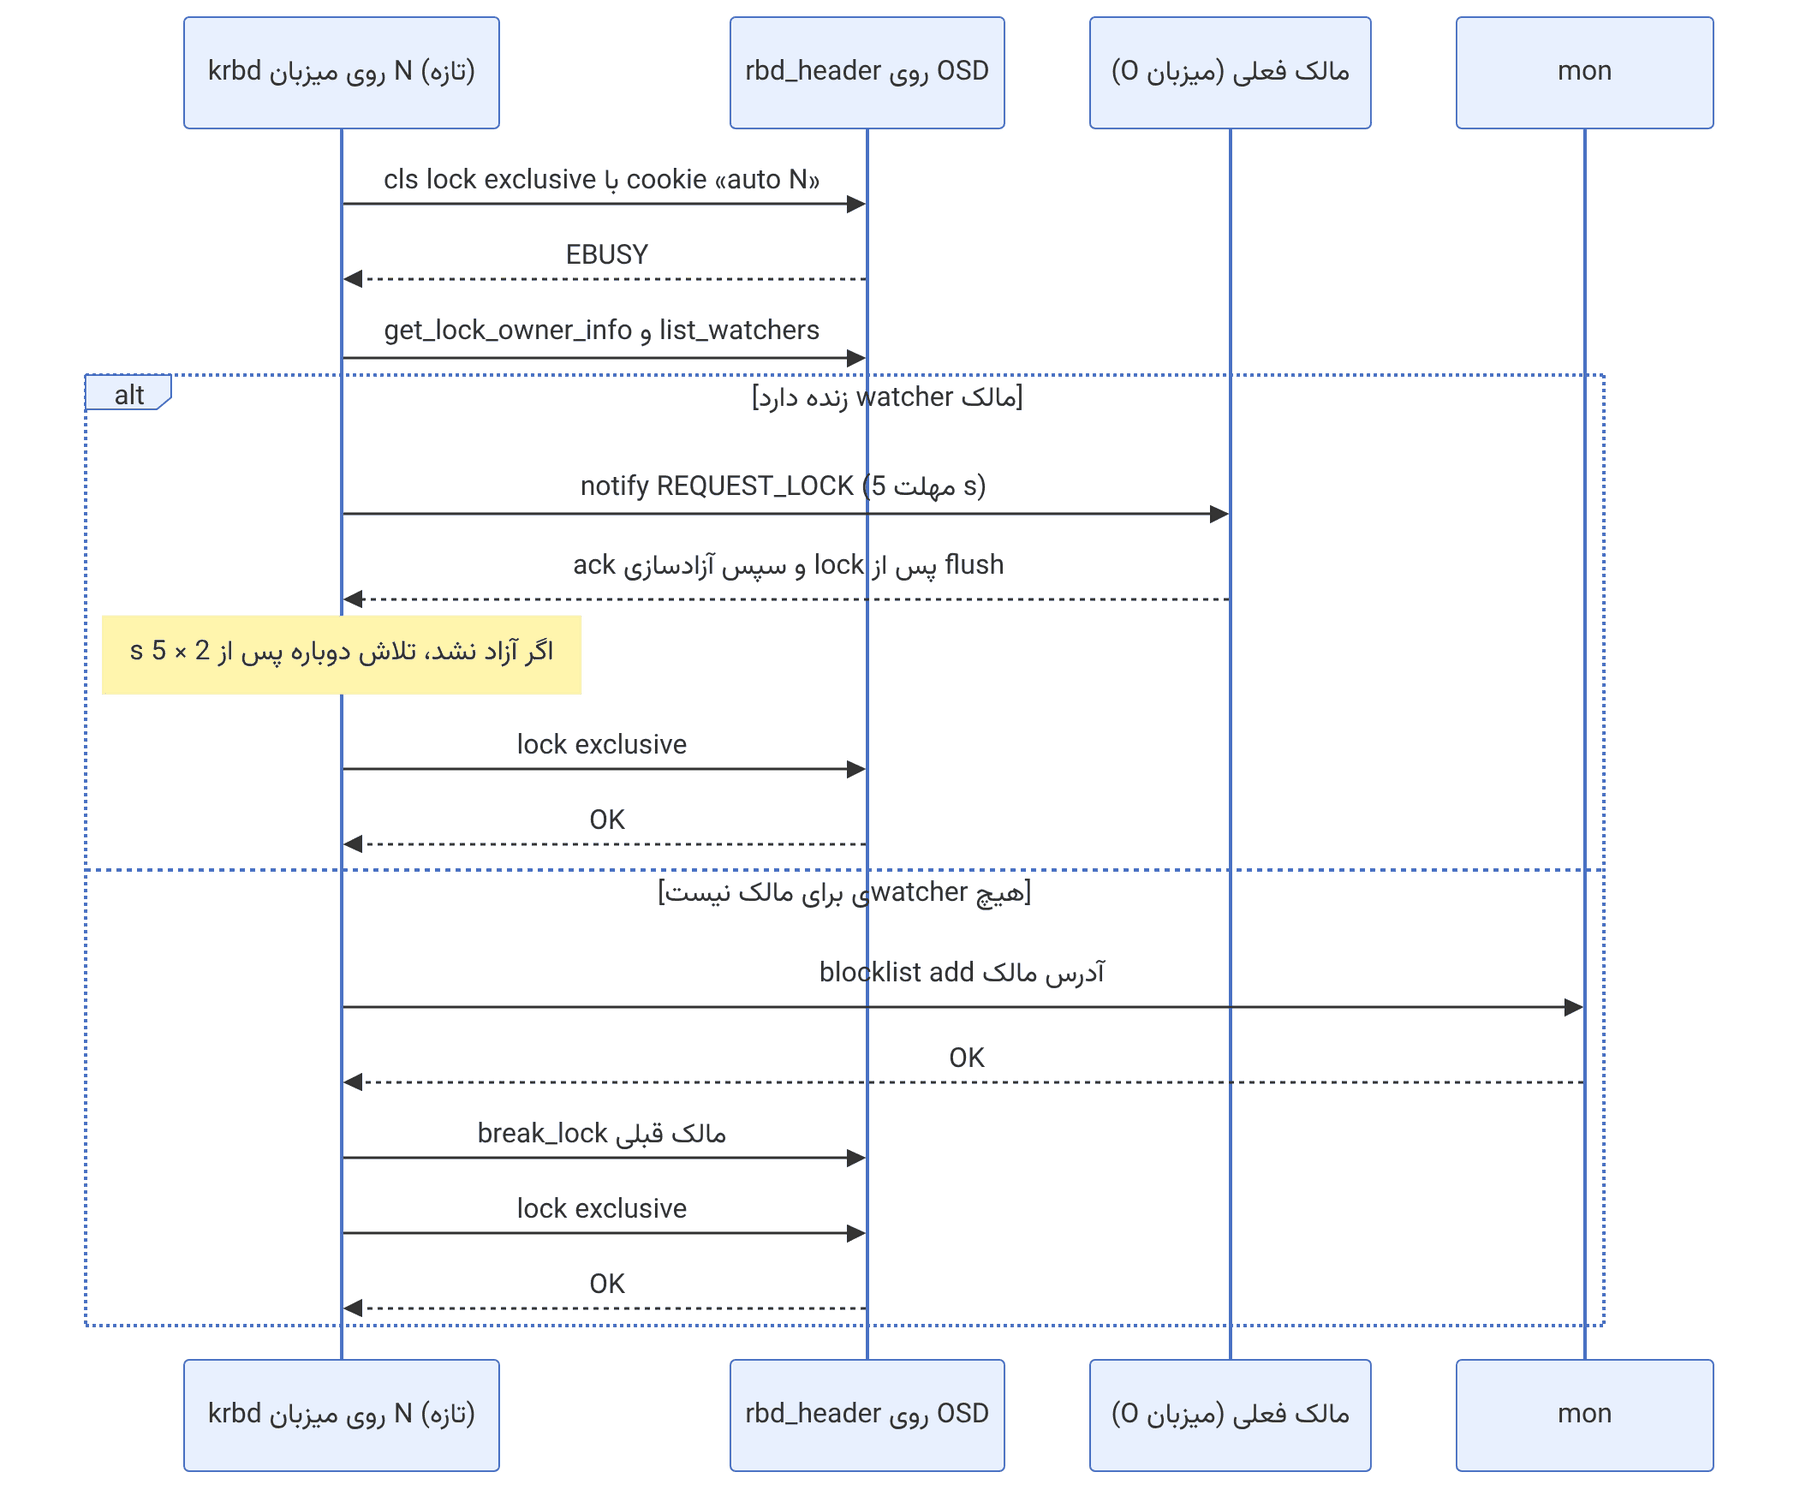
rbd_try_lock:
again: r = cls_lock(header, EXCLUSIVE, cookie) ; if r != −EBUSY: return r
owner = get_lock_owner_info() ; if none: goto again
if find_watcher(owner): return 1 # مالک زنده است ⇒ درخواست کن
if owner عوض شد: goto again
ceph_monc_blocklist_add(owner.addr) ; cls_break_lock(owner) ; goto again
rbd_acquire_lock (work):
r = rbd_try_acquire_lock ; if r ≤ 0: done
r = rbd_request_lock (notify REQUEST_LOCK، مهلت 5 s)
ETIMEDOUT ⇒ مالک را مرده فرض کن، دوباره ; EROFS ⇒ مالک رها نمیکند
ack ⇒ دوباره پس از 10 s اگر آزاد نشد ; خطای دیگر ⇒ دوباره پس از RBD_RETRY_DELAY = 1 sمثال عددی. میزبان O که مالک قفل بود، بیخبر خاموش شده است. watch آن پس از مهلت watch (osd_client_watch_timeout، پیشفرض ۳۰ ثانیه) از فهرست watcherها حذف میشود. اگر میزبان N در ثانیهی ۱۰ map کند، find_watcher هنوز watcher O را میبیند، پس REQUEST_LOCK میفرستد. پس از ۵ ثانیه ETIMEDOUT میگیرد و دوباره تلاش میکند. این چرخه تا حدود ثانیهی ۳۰ ادامه دارد. پس از آن watcher ناپدید میشود، N آدرس O را blocklist میکند، قفل را میشکند و میگیرد. اولین نوشتن روی N میتواند تا حدود ۳۰ ثانیه منتظر بماند. lock_timeout در rbd map (پیشفرض ۰، یعنی بینهایت) سقف این انتظار را تعیین میکند.
۲۹-۸-۵ بیتهای cap و رشتهی آنها#
منبع در کد: fs/ceph/caps.c :: ceph_cap_string، gcap_string؛ include/linux/ceph/ceph_fs.h (CEPH_CAP_S*، CEPH_CAP_G*)
پیچیدگی: O(۱): حداکثر ۱۶ بیت
pseudocode
s = "" ; if caps & PIN: s += "p"
for (letter, shift) in (A,2) (L,4) (X,6): c = (caps ≫ shift) & 3 ; if c: s += letter + gcap(c)
c = caps ≫ 8 ; if c: s += "F" + gcap(c)
gcap(c): برای بیتهای 1,2,4,…,128 به ترتیب حروف s x c r w b a l
revoking = implemented & ~issued # در __ceph_check_caps و handle_cap_grantمثال عددی. مقدار ۰x3F55 = ۱ + ۴ + ۱۶ + ۶۴ + (۶۳ ≪ ۸) به رشتهی pAsLsXsFsxcrwb تبدیل میشود. اگر MDS بیت Fb را پس بگیرد (issued جدید = ۰x1F55)، revoking = ۰x3F55 & ~۰x1F55 = ۰x2000، یعنی ۱ ≪ ۱۳ = FILE b. کلاینت باید صفحههای کثیف را flush کند و سپس ack بفرستد. تا وقتی ack نرسد، MDS کلاینت دیگری را که Fw خواسته منتظر نگه میدارد. همین منشأ پیامهای «client X failing to respond to capability release» در ceph health detail است.
۲۹-۹ تکمیلی و بهروز#
- پشتیبانی msgr2.1 در کلاینت هسته از نسخهی ۵٫۱۱ است (طبق
Documentation/filesystems/ceph.rst). -
RBD_FEATURES_ALL در rbd.c مربوط به master شامل layering، striping v2، exclusive-lock، object-map، fast-diff، deep-flatten، data-pool و operations است. journaling (بیت ۶) در آن نیست. پس تصویرهای دارای journaling برای rbd-mirror در حالت journal، با krbd map نمیشوند. - کدهای نقلشده یا نامبرده در این فصل از شاخهی master هسته در تاریخ نگارش است. توزیعهای سازمانی (RHEL، Ubuntu LTS) ممکن است backportهای متفاوتی داشته باشند. همیشه
modinfo rbd و uname -r را با changelog توزیع خود بسنجید.
۲۹-۱۰ تمرین عملی#
- ۱. یک تصویر را با
rbd map وصل و با fio --direct=1 --rw=randwrite --bs=4k --iodepth=64 تست کنید. همزمان cat /sys/kernel/debug/ceph/*/osdc را چند بار بخوانید و تعداد درخواستهای در جریان را با iodepth مقایسه کنید. - ۲. همان تست را با
rbd-nbd و librbd اجرا و تأخیر را مقایسه کنید. - ۳. یک فایل CephFS را از دو کلاینت هستهای باز کنید (یکی نویسنده و دیگری خواننده) و تغییر caps را در
/sys/kernel/debug/ceph/*/caps ببینید. - ۴. روی یک خوشهی آزمایشی،
ceph osd pause را اجرا کنید، رفتار کلاینت هسته را با و بدون osd_request_timeout=30 مقایسه کنید و سپس ceph osd unpause کنید.
۲۹-۱۱ پرسشهای مرور#
- ۱. libceph از چه بخشهایی تشکیل شده است و چرا CRUSH در هسته هم هست؟
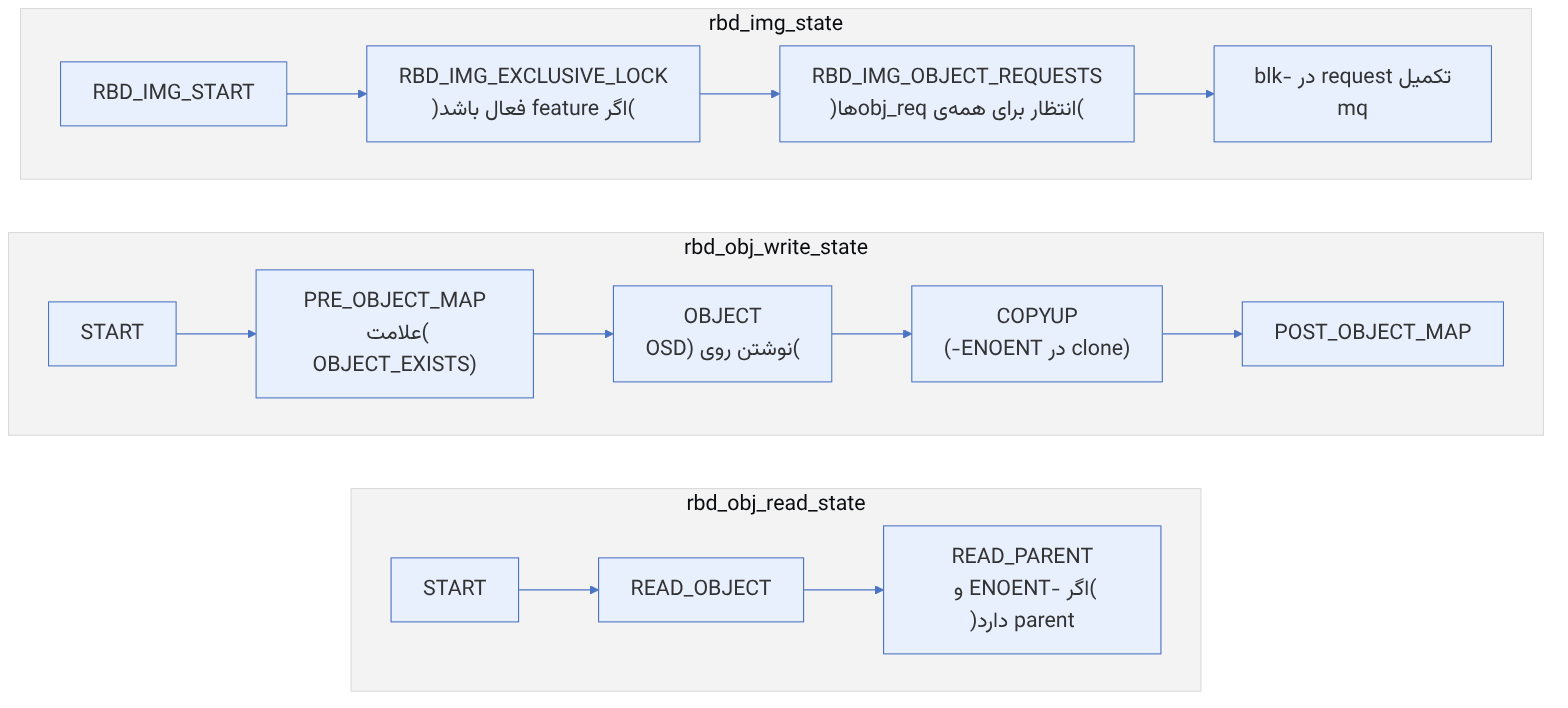
- ۲. یک request در blk-mq چگونه به obj_requestها تقسیم میشود؟
- ۳. چه زمانی krbd بهجای WRITE از WRITEFULL، ZERO، TRUNCATE یا DELETE استفاده میکند؟
- ۴. copyup در krbd چه زمانی رخ میدهد؟
- ۵. چرا کلاینت هسته در برابر pool پر گیر میکند و چگونه میتوان آن را محدود کرد؟
- ۶. مقادیر io_opt و io_min در krbd از کجا میآیند؟
- ۷. رشتهی caps به شکل
pAsLsXsFrwcb را تفسیر کنید. - ۸. چرا خوانندهی دوم یک فایل در حال نوشتن، Fc نمیگیرد؟
- ۹. هشدار MDS_HEALTH_CLIENT_LATE_RELEASE چه معنایی دارد؟
- ۱۰. دو مزیت و دو عیب krbd نسبت به librbd را بگویید.
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۹-۱۲ منابع این فصل#
- net/ceph در هسته
https://github.com/torvalds/linux/tree/master/net/ceph - drivers/block/rbd.c
https://github.com/torvalds/linux/blob/master/drivers/block/rbd.c - fs/ceph
https://github.com/torvalds/linux/tree/master/fs/ceph - مستند CephFS در هسته
https://docs.kernel.org/filesystems/ceph.html - rbd (man
https://docs.ceph.com/en/latest/man/8/rbd/ - krbd در مستندات Ceph
https://docs.ceph.com/en/latest/rbd/rbd-ko/ - caps در CephFS
https://docs.ceph.com/en/latest/cephfs/capabilities/ - کلاینت هستهی CephFS
https://docs.ceph.com/en/latest/cephfs/mount-using-kernel-driver/