بخش تخصصی (۱): RADOS — هویت شیء، فراداده و مسیر op درون OSD
حوصله ندارم این فصل در چند خط
- OSD شیء را با
hobject_t میشناسد: pool، hash، namespace، key، نام و snap؛ کلید bitwise آن ترتیب مرتبسازی را تعیین میکند. - هر شیء داده، xattr (درون onode) و omap (کلیدهای جداگانه در RocksDB) دارد.
- op در یک shard از OSD صف میشود و پیش از اجرا از دروازههای do_op (نقشه، peering، اشیای گمشده و قفلها) میگذرد.
-
execute_ctx opها را به یک تراکنش تبدیل میکند، نسخه را تعیین میکند و مدخل pg log را مینویسد که در omap شیء pgmeta نگه داشته میشود.
۳۴-۱ پیش از شروع#
فصل ۸ نشان داد یک شیء چگونه با CRUSH به OSD میرسد و فصل ۲۲ مسیر یک نوشتن را از librados تا ack در یک نگاه دنبال کرد. این فصل همان مسیر را درون OSD با جزئیات باز میکند: یک شیء RADOS دقیقاً با چه کلیدی شناخته و مرتب میشود، فرادادهاش (object_info_t و SnapSet) کجا مینشیند، op در کدام shard صف میشود، از چه دروازههایی رد میشود تا اجرا شود، نسخهها چگونه شماره میخورند و pg log روی دیسک چه شکلی دارد. همهی نامها با شاخهی main مخزن ceph/ceph (نوامبر ۲۰۲۶) تطبیق داده شدهاند.
۳۴-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
- یک شیء RADOS با چه فیلدهایی شناخته میشود و چرا ترتیب مرتبسازی آن بیتهای hash را برعکس میکند؟
-
object_info_t و SnapSet چه فیلدهایی دارند و در کدام xattr ذخیره میشوند؟ - op کلاینت در کدام shard و thread اجرا میشود؟
-
do_op به ترتیب چه چیزهایی را بررسی میکند و op را در کدام صف انتظار میگذارد؟ - درخواست تکراری (مثلاً پس از بازاتصال) چگونه تشخیص داده میشود؟
-
version و user_version چه فرقی دارند و چگونه افزایش مییابند؟ - pg log و pg info در کدام شیء و با چه کلیدهایی ذخیره میشوند؟
۳۴-۱-۲ پیشنیاز#
فصل ۸ (CRUSH و PG)، فصل ۱۴ (librados و MOSDOp)، فصل ۲۲ (معماری کد) و فصل ۲۴ (کلیدهای BlueStore). آشنایی با خواندن C++ کمک میکند ولی لازم نیست.
۳۴-۲ هویت یک شیء RADOS#
۳۴-۲-۱ از نام تا hobject_t#
کلاینت شیء را با نام میشناسد، ولی OSD با hobject_t کار میکند (src/common/hobject.h). فیلدهای اصلی:
| فیلد | معنی |
|---|---|
oid | نام شیء که کلاینت داده است |
key | کلید مکانیابی (locator key)؛ اگر خالی نباشد، hash بهجای نام از این کلید حساب میشود |
nspace | فضای نام درون pool؛ اشیای همنام در دو namespace دو شیء جدا هستند |
pool | شناسهی pool |
hash | hash نام (یا key) با تابع hash پیشفرض pool، یعنی rjenkins |
snap | شمارهی snapshot؛ برای نسخهی جاری مقدار ویژهی CEPH_NOSNAP (head) است |
max | پرچم «بزرگترین شیء ممکن» که در پیمایشها بهعنوان نگهبان پایان به کار میرود |
ghobject_t یک لایه روی آن است و shard_id (برای EC) و generation را اضافه میکند. همین ghobject_t است که در فصل ۲۴ به کلید O در RocksDB تبدیل شد.
key (locator) کاربرد کمی دارد ولی مهم است: اشیایی که key یکسان دارند hash یکسان میگیرند و همیشه در یک PG میمانند. برنامهای که بخواهد چند شیء مرتبط همیشه هممکان باشند (مثلاً برای اینکه یک فراخوانی کلاس بتواند هر دو را در همان OSD ببیند) میتواند به همهی آنها key یکسان بدهد؛ بهای آن، توزیع ناهموار داده است.
۳۴-۲-۲ ترتیب مرتبسازی: hash برعکسشده#
پیمایش اشیا (listing، scrub، backfill) همه به ترتیب hobject_t تکیه دارند. تابع cmp(const hobject_t&, const hobject_t&) در hobject.cc به این ترتیب مقایسه میکند: max، سپس pool، سپس کلید بیتی (get_bitwise_key، یعنی hash با بیتهای برعکسشده)، سپس nspace، سپس key مؤثر، سپس oid و در پایان snap.
منبع در کد: src/common/hobject.cc :: cmp(const hobject_t&, const hobject_t&); src/common/hobject.h :: hobject_t::_reverse_bits, get_bitwise_key_u32
پیچیدگی: O(۱) برای فیلدهای عددی و O(L) برای مقایسهی رشتهها
pseudocode
cmp(l, r):
compare l.max, r.max
compare l.pool, r.pool
compare reverse_bits(l.hash), reverse_bits(r.hash) # hash_reverse_bits از پیش حساب شده است
compare l.nspace, r.nspace
if l.key or r.key: compare effective_key(l), effective_key(r)
compare l.oid, r.oid
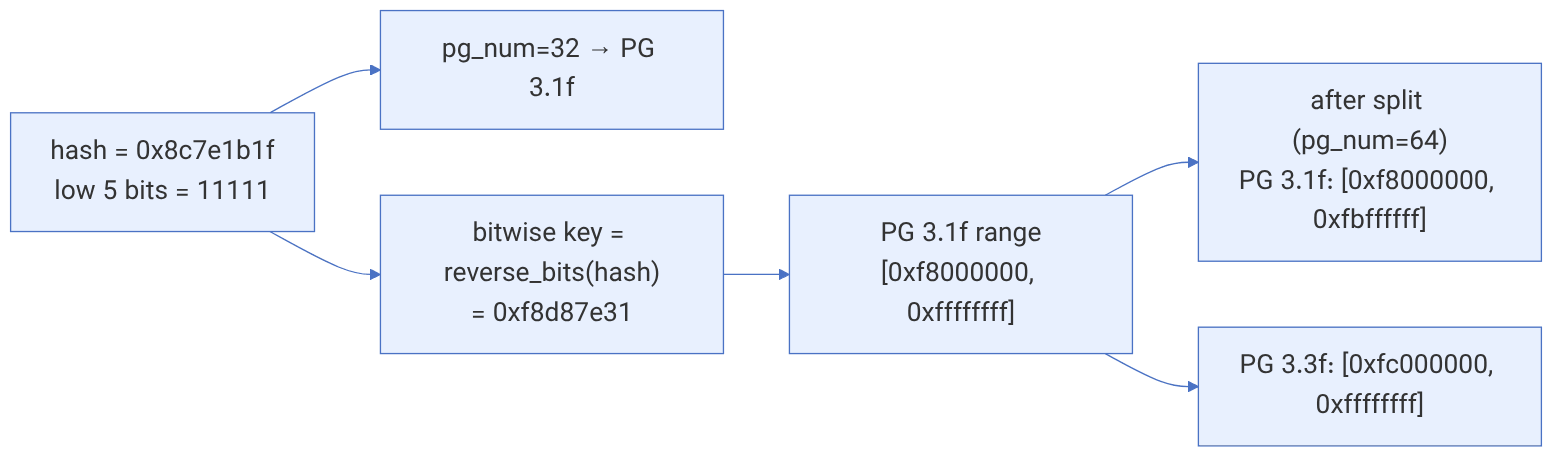
compare l.snap, r.snap # head (NOSNAP) بزرگترین snap استچرا برعکس؟ شمارهی PG از بیتهای پایین hash به دست میآید (ceph_stable_mod). اگر hash برعکس شود، همان بیتهای پایین به بالای عدد میروند و همهی اشیای یک PG در یک بازهی پیوسته از کلید بیتی قرار میگیرند. پس هر PG یک بازه است و پیمایش آن یک اسکن بازهای در RocksDB است.
مثال عددی. شیئی با hash برابر 0x8c7e1b1f را در poolی با pg_num=32 در نظر بگیرید. شمارهی PG برابر 0x8c7e1b1f & 31 = 0x1f است. کلید بیتی آن 0xf8d87e31 است. همهی اشیای PG 0x1f پنج بیت پایین 11111 دارند، پس کلید بیتیشان با 11111 آغاز میشود و در بازهی [0xf8000000, 0xffffffff] است. اگر pg_num به ۶۴ برسد، این PG به 0x1f و 0x3f تقسیم میشود. بیت ششم hash در کلید بیتی بیت ششم از بالاست، پس دو PG تازه دو نیمهی پیوستهی همان بازهاند: [0xf8000000, 0xfbffffff] و [0xfc000000, 0xffffffff]. به همین دلیل split فقط مرز بازه را جابهجا میکند و به بازنویسی کلیدها نیازی ندارد.
۳۴-۳ فرادادهی هر شیء#
۳۴-۳-۱ سه جای ذخیره: داده، xattr و omap#
هر شیء RADOS سه بخش دارد: داده (بایتهای پیوسته)، xattrها (جفتهای کلید و مقدار کوچک) و omap (یک نگاشت مرتب کلید به مقدار که میتواند میلیونها کلید داشته باشد). در BlueStore xattrها درون خود onode ذخیره میشوند و omap در کلیدهای جداگانهی RocksDB با پیشوندهای M، m، p و P (فصل ۲۴). OSD دو xattr ویژه را برای خودش نگه میدارد:
| xattr | ثابت در کد | محتوا |
|---|---|---|
_ | OI_ATTR | object_info_t کدگذاریشده |
snapset | SS_ATTR | SnapSet فقط روی head (فصل ۳۶) |
_<name> | — | xattr کاربر؛ OSD هنگام ذخیره یک _ به ابتدای نام اضافه میکند تا با xattrهای داخلی تداخل نکند |
۳۴-۳-۲ object_info_t#
فیلدهای مهم object_info_t در src/osd/osd_types.h:
| فیلد | معنی |
|---|---|
soid | همان hobject_t |
version، prior_version | نسخهی آخرین تغییر و نسخهی پیش از آن (از نوع eversion_t، یعنی epoch و شماره) |
user_version | نسخهای که کلاینت میبیند (rados stat و ver در librados) |
last_reqid | شناسهی آخرین درخواست تغییردهنده |
size، mtime، local_mtime | اندازه، زمان تغییر از دید کلاینت و زمان محلی OSD |
flags | پرچمها، از جمله whiteout، dirty، omap، data_digest، omap_digest، manifest |
data_digest، omap_digest | crc32c داده و omap، اگر معتبر باشند (برای scrub) |
watchers | فهرست watchهای فعال (فصل ۱۴) |
truncate_seq، truncate_size | برای ترتیب truncate در CephFS |
manifest | برای اشیای redirect یا chunked (dedup) |
# مثال: خواندن object_info_t یک شیء و رمزگشایی آن
rados -p rbd getxattr rbd_header.5f3a2b8c1d4e _ > /tmp/oi.bin
ceph-dencoder type object_info_t import /tmp/oi.bin decode dump_jsonمثال (خروجی کوتاهشده):
{
"oid": { "oid": "rbd_header.5f3a2b8c1d4e", "key": "", "snapid": -2,
"hash": 2356083487, "max": 0, "pool": 3, "namespace": "" },
"version": "1462'93",
"prior_version": "1462'92",
"last_reqid": "client.24183.0:118",
"user_version": 93,
"size": 0,
"flags": [ "dirty", "omap", "data_digest" ],
"data_digest": "0xffffffff",
"watchers": { "client.24183": { "cookie": 94823571521536 } }
}snapid: -2 همان CEPH_NOSNAP یعنی head است. نسخهی 1462'93 یعنی epoch ۱۴۶۲ و شمارهی ۹۳ در pg log.
۳۴-۴ صفبندی op: shard و thread#
OSD::ms_fast_dispatch پیام MOSDOp را مستقیم از thread messenger میگیرد، یک OpRequest میسازد و با enqueue_op در صف شاردشدهی op_shardedwq میگذارد. هر shard یک OSDShard با قفل، زمانبند (mClock بهطور پیشفرض، فصل ۲۱) و چند thread است.
منبع در کد: src/osd/OSD.cc :: OSD::enqueue_op، OSD::ShardedOpWQ::_enqueue؛ src/osd/osd_types.h :: spg_t::hash_to_shard
پیچیدگی: O(۱)؛ هزینهی واقعی در زمانبند mClock همان shard است
pseudocode
num_shards = osd_op_num_shards  or  (rotational ? osd_op_num_shards_hdd : osd_op_num_shards_ssd)
threads    = osd_op_num_threads_per_shard or (rotational ? _hdd : _ssd)
shard_index = pgid.ps() % num_shards                 # spg_t::hash_to_shard
shards[shard_index].scheduler.enqueue(OpSchedulerItem(pg, op, cost, priority, owner))
worker thread t of that shard: dequeue → lock PG → PG::do_request → PrimaryLogPG::do_op| گزینه | پیشفرض main | توضیح |
|---|---|---|
osd_op_num_shards_ssd | ۸ | تعداد shard روی SSD/NVMe |
osd_op_num_threads_per_shard_ssd | ۲ | thread در هر shard روی SSD |
osd_op_num_shards_hdd | ۱ | روی HDD یک shard |
osd_op_num_threads_per_shard_hdd | ۵ | با پنج thread |
مثال عددی. روی یک OSD با NVMe، ۸ shard و در هر shard دو thread داریم، یعنی ۱۶ thread اجرای op. PGهای ۳.۰ تا ۳.۱f با ps=0..31 بهترتیب به shardهای ۰ تا ۷ میروند و هر shard چهار PG از این pool میگیرد. چون هر PG همیشه در یک shard است، ترتیب opهای یک PG حفظ میشود. ولی اگر یک PG بسیار داغ باشد (مثلاً شیء rbd_header پرتکرار یا یک shard ایندکس RGW)، فقط دو thread همان shard را مشغول میکند و افزودن shard کمکی نمیکند.
۳۴-۵ دروازههای do_op#
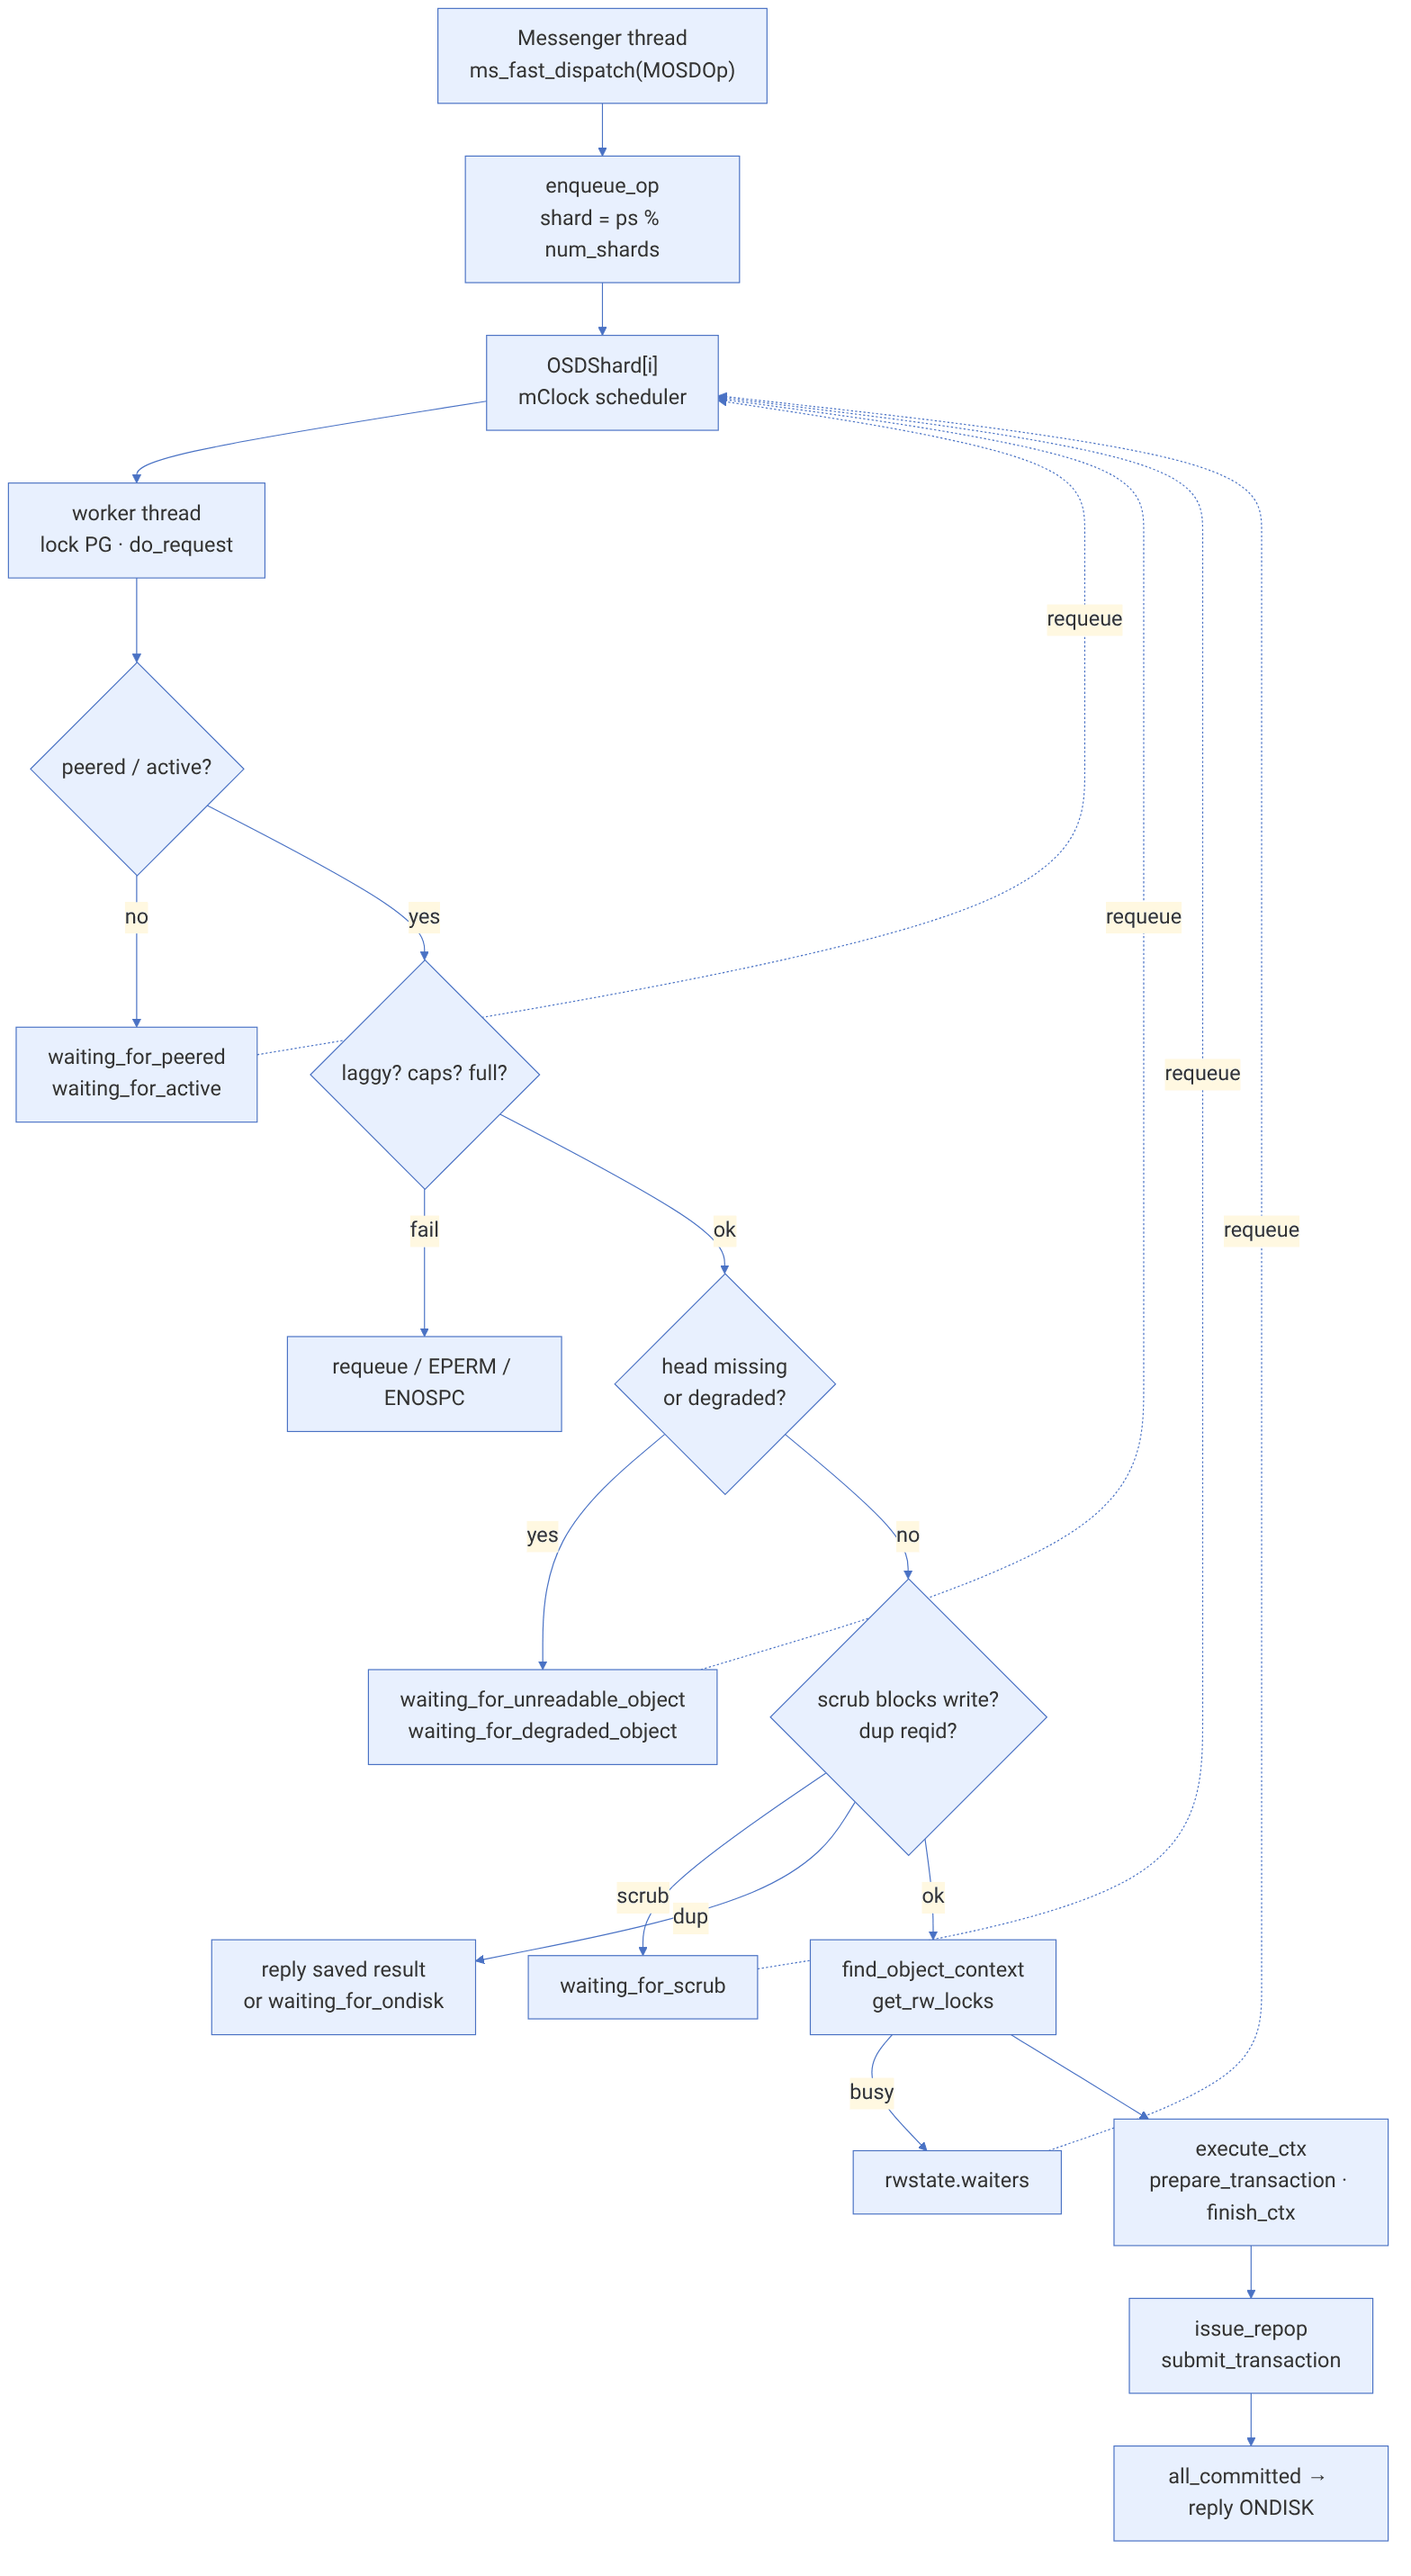
پیش از اینکه op اجرا شود، PrimaryLogPG::do_op و do_op_impl آن را از چند دروازه عبور میدهند. اگر شرطی برقرار نباشد، op در یکی از صفهای انتظار PG مینشیند و پس از رفع شرط دوباره صف میشود. op->mark_delayed("...") متن همان را در dump_ops_in_flight نشان میدهد.
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::do_request، do_op_impl
پیچیدگی: O(۱) برای هر دروازه، بهجز find_object_context که ممکن است به خواندن onode از دیسک برسد
pseudocode (ترتیب مهم است)
do_request: if not peered → waiting_for_peered ; if flushes pending → waiting_for_flush
if not active (و op نیاز دارد) → waiting_for_active
do_op_impl(op):
check_laggy(op) # lease/readable_until؛ در غیر این صورت صبر
op_has_sufficient_caps(op) # cephx caps؛ در غیر این صورت EPERM
write_ordered = op.rwordered()
if write_ordered and failsafe full → reply ENOSPC (یا drop)
if is_unreadable_object(head) → wait_for_unreadable_object # missing روی primary
if write_ordered:
if is_degraded_or_backfilling_object(head) → wait_for_degraded_object
if scrub write_blocked(head) → waiting_for_scrub
if write_ordered and check_in_progress_op(reqid) → دوبارهکاری: پاسخ قبلی یا waiting_for_ondisk
if maybe_await_blocked_head(oid) → wait_for_blocked_object # مثلاً promote یا flush
find_object_context(oid) → اگر نسخهی snap missing است: wait_for_unreadable_object
get_rw_locks(ctx) # RWState: read, write, excl
execute_ctx(ctx)| متن در dump_ops_in_flight | صف | معنی عملی |
|---|---|---|
waiting for peered / waiting for active | waiting_for_peered / waiting_for_active | PG هنوز peering را تمام نکرده است (فصل ۳۵) |
waiting for missing object | waiting_for_unreadable_object | شیء روی primary missing است و باید اول بازیابی شود |
waiting for degraded object | waiting_for_degraded_object | نوشتن روی شیئی که یکی از replicaها ندارد؛ اول recovery |
waiting for scrub | waiting_for_scrub | chunk در حال scrub شامل این شیء است |
waiting for ondisk | waiting_for_ondisk | درخواست تکراری است و نسخهی اصلی هنوز commit نشده |
waiting for rw locks | ObjectContext::rwstate.waiters | op دیگری قفل ناسازگار روی همین شیء دارد |
وقتی کلاینتی «گیر» میکند، ceph daemon osd.N dump_ops_in_flight را روی primary همان PG بگیرید و فیلد flag_point و رویدادهای events را بخوانید. اگر بیشتر opها waiting for degraded object هستند، مشکل I/O نیست؛ recovery کند است یا متوقف شده (فصل ۳۲). اگر waiting for rw locks است، معمولاً یک op طولانی (مثلاً یک فراخوانی کلاس سنگین) روی همان شیء نشسته است.
۳۴-۵-۱ قفلهای شیء: RWState#
هر ObjectContext (کش فرادادهی شیء در حافظهی PG) یک RWState دارد با حالتهای none، read، write و excl و یک شمارنده. چند reader یا چند writer میتوانند همزمان قفل بگیرند (writerها چون ترتیبشان را خود pg log تضمین میکند)، ولی read و write با هم سازگار نیستند و excl با همه ناسازگار است. opهایی که هم میخوانند و هم وابسته به نتیجه مینویسند (مثل فراخوانی کلاس با CLASS_WRITE) قفل write میگیرند. op منتظر در waiters میماند و هنگام آزاد شدن قفل دوباره صف میشود.
۳۴-۵-۲ درخواست تکراری#
اگر کلاینت پاسخ یک نوشتن را دریافت نکند (مثلاً اتصال قطع شود یا primary عوض شود)، همان op را با همان reqid (شامل entity، incarnation و tid) دوباره میفرستد. OSD نباید آن را دو بار اجرا کند، چون عملیاتی مثل append یا افزایش شمارنده idempotent نیستند.
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::check_in_progress_op؛ src/osd/PGLog.h :: IndexedLog::get_request
پیچیدگی: O(۱) با جدول hash روی reqidها (caller_ops، extra_caller_ops و dup_index)
pseudocode
check_in_progress_op(reqid):
if reqid in pg_log.caller_ops or extra_caller_ops: # ورودیهای فعلی log
found (version, user_version, return_code)
elif reqid in pg_log.dup_index: # ورودیهای trimشده که فقط dup ماندهاند
found (version, user_version, return_code)
else: return not found
if found:
if already_complete(version): reply with saved user_version and return_code
else: waiting_for_ondisk[version] += op # پاسخ پس از commit نسخهی اصلیdups ورودیهای سبکی هستند (pg_log_dup_t: reqid، version، user_version، return_code) که پس از trim شدن ورودیهای اصلی log نگه داشته میشوند. تعدادشان با osd_pg_log_dups_tracked محدود میشود و در فصل ۳۳ دیدیم همین dups چگونه حافظهی pglog را رشد میدهند.
۳۴-۶ اجرای op و شمارهگذاری نسخه#
execute_ctx یک PGTransaction خالی میسازد و prepare_transaction را صدا میزند. این تابع ابتدا do_osd_ops را اجرا میکند که یکایک opهای درون پیام (مثلاً CEPH_OSD_OP_WRITE، SETXATTR، OMAPSETVALS یا CALL) را به عملیات روی تراکنش تبدیل میکند. سپس بررسی full بودن pool، make_writeable (برای snapshot، فصل ۳۶) و در پایان finish_ctx میآید.
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::execute_ctx، prepare_transaction، finish_ctx
پیچیدگی: O(۱) بهازای هر شیء تغییرکرده؛ کدگذاری object_info_t و SnapSet به اندازهی آنها
pseudocode
execute_ctx: ctx.at_version = get_next_version()   # (epoch جاری, info.last_update.version + 1)
finish_ctx(ctx, log_op_type):
    ctx.user_at_version = max(info.last_user_version, new_oi.user_version) + 1
    if ctx.at_version.version > ctx.user_at_version: ctx.user_at_version = at_version.version
    new_oi.version = at_version ; new_oi.prior_version = old_oi.version
    new_oi.user_version = user_at_version ; new_oi.last_reqid = reqid ; mtime ...
    attrs["_"] = encode(new_oi) ; if head: attrs["snapset"] = encode(new_snapset)
    op_t.setattrs(soid, attrs)
    log_entries.push(pg_log_entry_t(type, soid, at_version, prior_version,
                                    user_at_version, reqid, mtime, return_code))
مثال عددی. PG ۳.۱f در epoch ۱۴۶۲ است و last_update = 1462'92 و last_user_version = 93. یک نوشتن روی شیء A (که user_versionش ۴۰ است) میرسد. at_version برابر 1462'93 میشود. user_at_version برابر max(۹۳, ۴۰) + ۱ = ۹۴ است و چون ۹۳ بزرگتر از ۹۴ نیست، همان ۹۴ میماند. پس A پس از نوشتن version = 1462'93 و user_version = 94 دارد. نکته: user_version در سطح PG یکنواخت است، نه در سطح شیء؛ پس یک شیء ممکن است بین دو تغییر خودش از ۴۰ به ۹۴ بپرد. برنامهای که با assert_version الگوی compare-and-swap میسازد (فصل ۱۴) فقط به یکتایی و افزایشی بودن آن تکیه میکند، نه به پیوستگیاش.
۳۴-۶-۱ تکثیر و commit#
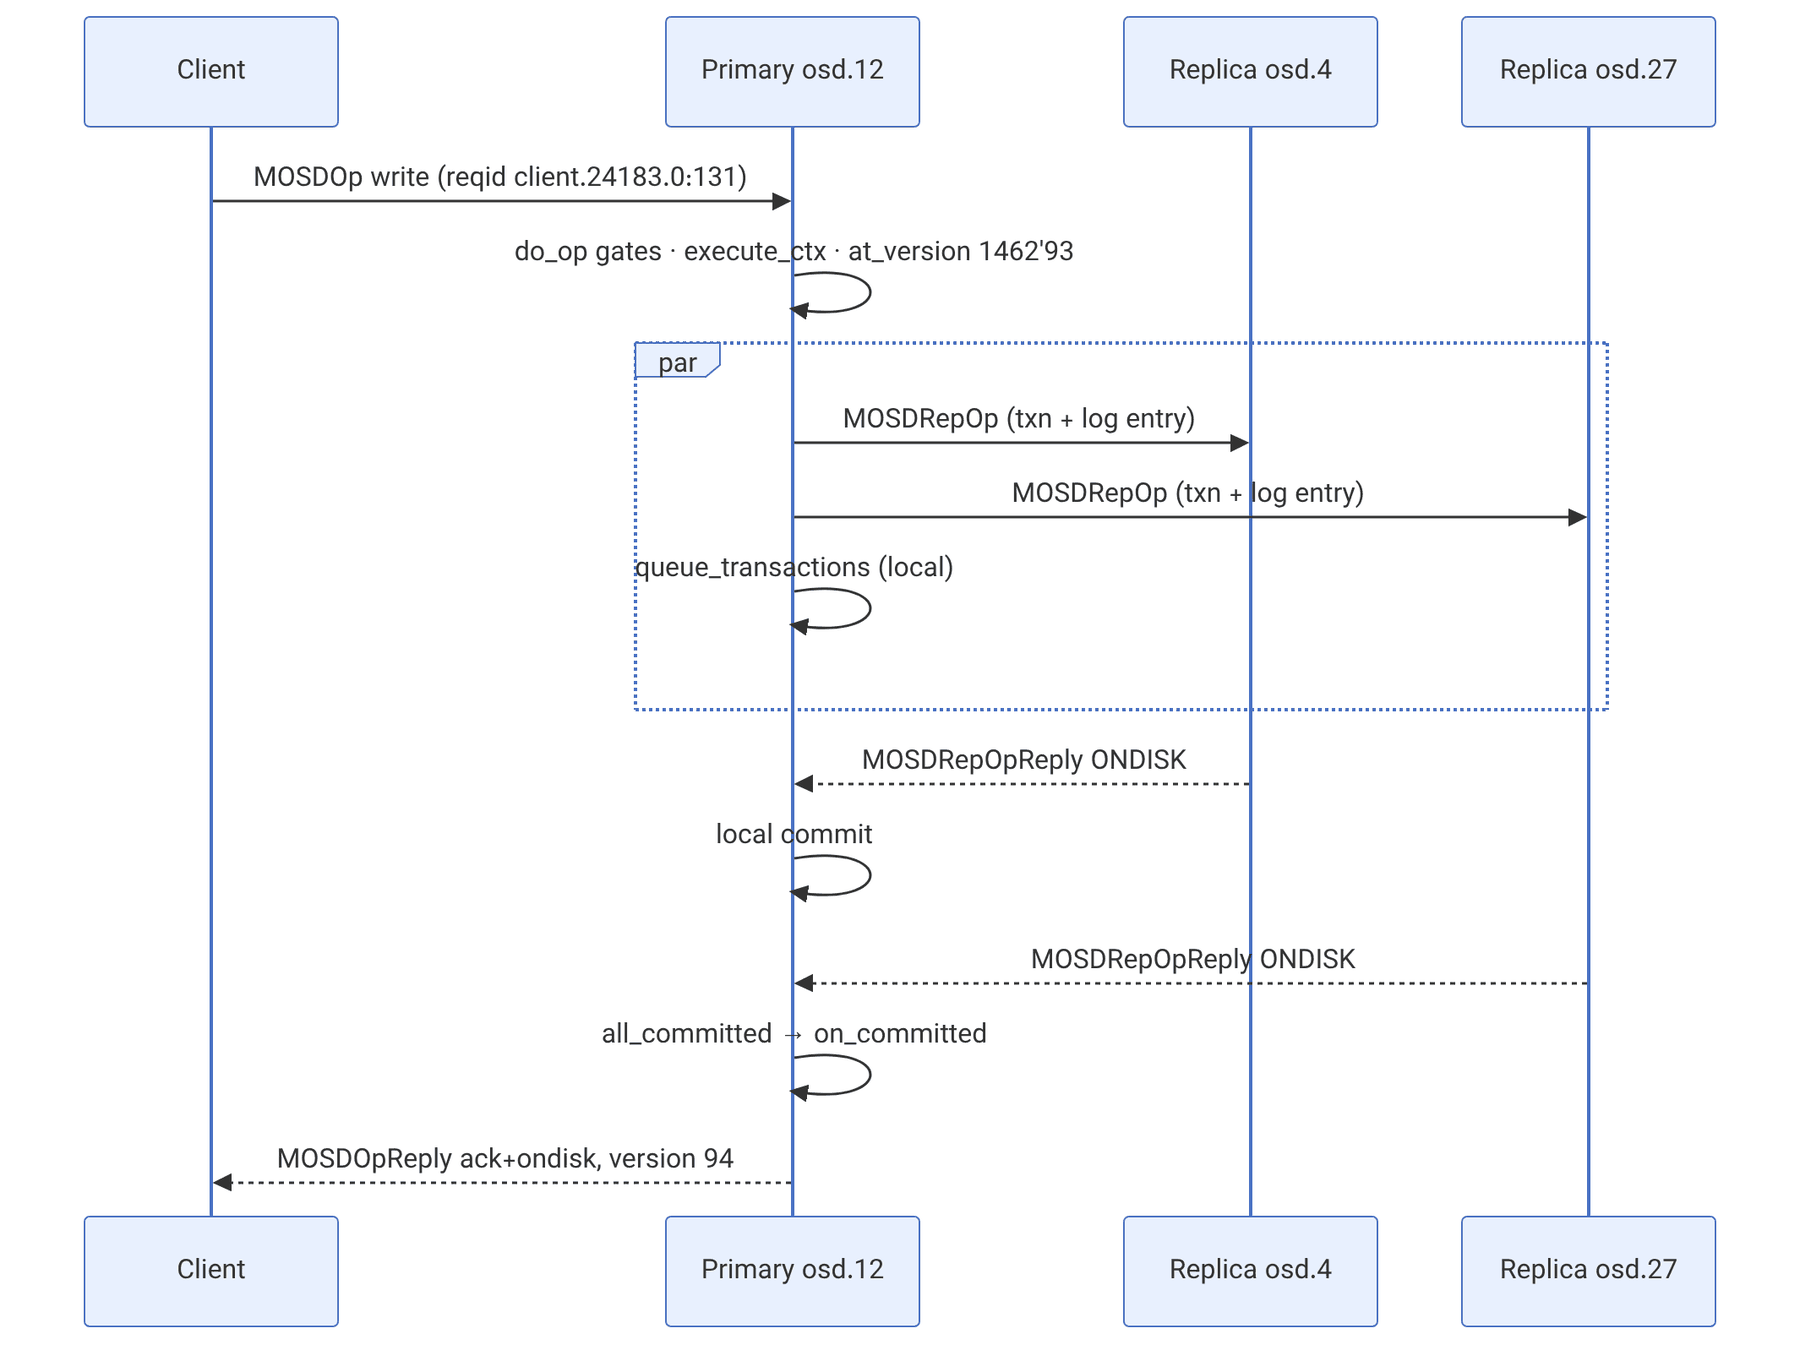
issue_repop یک RepGather میسازد و pgbackend->submit_transaction را صدا میزند. در ReplicatedBackend تراکنش برای هر replica در یک MOSDRepOp فرستاده و همزمان روی primary به ObjectStore سپرده میشود. هر replica پس از commit محلی MOSDRepOpReply با پرچم ONDISK برمیگرداند. وقتی همهی اعضای acting (نه فقط min_size) commit کردند، all_committed درست میشود، on_committedها اجرا و پاسخ به کلاینت فرستاده میشود. در EC همین نقش را backend مربوط به EC با تکهها و تراکنشهای جدا برای هر shard بازی میکند (فصل ۲۷).
۳۴-۷ pg log و pg info روی دیسک#
هر PG یک شیء ویژه به نام pgmeta دارد (spg_t::make_pgmeta_oid) که داده ندارد و همهچیز در omap آن است. ورودیهای log، dups و info بهصورت کلیدهای omap همین شیء ذخیره میشوند و در BlueStore به پیشوند P (omap مخصوص pgmeta) میروند.
| کلید omap در pgmeta | محتوا |
|---|---|
_infover، _epoch | نسخهی قالب و epoch |
_info | pg_info_t کامل (نسخهی قدیمی) |
_biginfo | past_intervals و purged_snaps که کم تغییر میکنند |
_fastinfo | pg_fast_info_t: فقط last_update و چند آمار؛ برای نوشتنهای پشتسرهم |
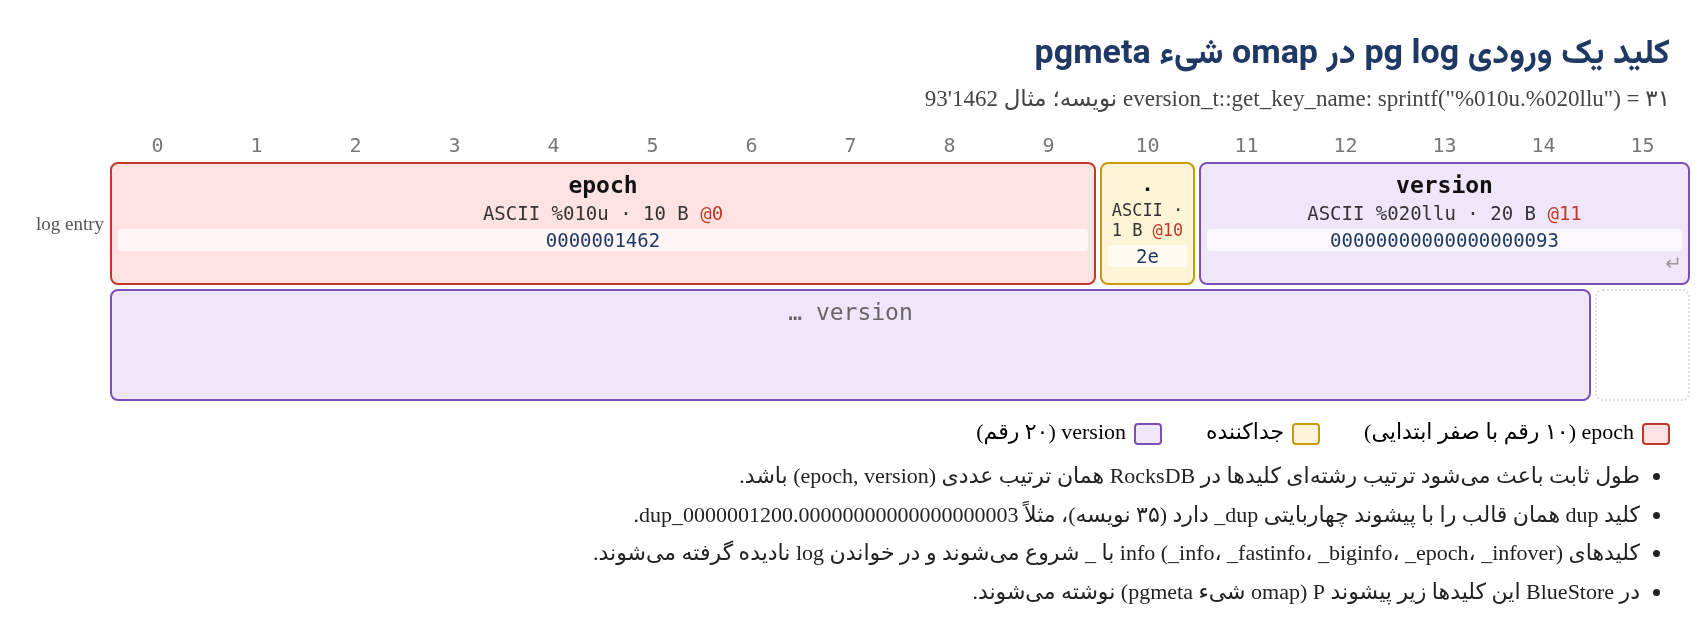
0000001462.00000000000000000093 | یک pg_log_entry_t |
dup_0000001200.00000000000000000003 | یک pg_log_dup_t |
منبع در کد: src/osd/osd_types.cc :: eversion_t::get_key_name، pg_log_dup_t::get_key_name؛ src/osd/osd_types.h :: infover_key، fastinfo_key
پیچیدگی: O(۱)؛ کلید ثابت ۳۱ (یا ۳۵) بایتی
pseudocode
eversion_t::get_key_name(): sprintf("%010u.%020llu", epoch, version) # 31 نویسه
pg_log_dup_t::get_key_name(): "dup_" + eversion.get_key_name() # 35 نویسه
# کلیدهای info با "_" شروع میشوند تا read_log_and_missing بتواند آنها را رد کندچون epoch و version با صفرهای ابتدایی و طول ثابت نوشته میشوند، ترتیب رشتهای کلیدها همان ترتیب عددی نسخههاست و خواندن log یک اسکن مرتب ساده روی omap است. trim کردن log هم حذف یک بازهی پیوسته از ابتدای همین کلیدهاست.
_fastinfo یک بهینهسازی است: در بیشتر نوشتنها فقط last_update، last_complete و چند آمار تغییر میکند. تابع prepare_info_keymap (در osd_types.cc) اگر بتواند تغییر را در pg_fast_info_t بگنجاند، فقط همین کلید کوچک را مینویسد و _info کامل را دست نمیزند (شمارندههای osd_pg_fastinfo و osd_pg_biginfo در perf dump تعداد هر حالت را نشان میدهند).
۳۴-۸ دستورها و ابزارها#
۳۴-۸-۱ مرجع دستورهای این فصل#
| دستور | کاربرد |
|---|---|
ceph osd map <pool> <obj> [<nspace>] | محاسبهی PG و up/acting یک شیء بدون دسترسی به آن |
rados -p <pool> stat <obj> | اندازه و mtime (از object_info_t) |
rados -p <pool> listxattr <obj> / getxattr <obj> <name> | xattrهای کاربر (بدون پیشوند _ داخلی) |
rados -p <pool> listomapkeys <obj> / listomapvals | کلیدها و مقادیر omap |
ceph-dencoder type object_info_t import <file> decode dump_json | رمزگشایی xattr _ |
ceph pg <pgid> query | info، peer_info و وضعیت peering |
ceph pg <pgid> list_unfound | اشیای unfound |
ceph daemon osd.N dump_ops_in_flight / dump_historic_ops / dump_blocked_ops | opهای جاری، کند و مسدود |
ceph daemon osd.N dump_op_pq_state | وضعیت صفهای shard |
ceph-objectstore-tool --data-path <path> --pgid <pgid> --op log | pg log و missing یک PG روی OSD خاموش |
ceph-objectstore-tool --data-path <path> --op list <obj> | فهرست ghobject_tهای یک شیء (head و cloneها) |
# مثال: یک شیء از ابتدا تا انتها
ceph osd map rbd rbd_header.5f3a2b8c1d4e
rados -p rbd stat rbd_header.5f3a2b8c1d4e
ceph daemon osd.12 dump_ops_in_flight | jq '.ops[] | {description, age, flag_point}'مثال (خروجی):
osdmap e1462 pool 'rbd' (3) object 'rbd_header.5f3a2b8c1d4e' -> pg 3.8c7e1b1f (3.1f) -> up ([12,4,27], p12) acting ([12,4,27], p12)
rbd/rbd_header.5f3a2b8c1d4e mtime 2026-11-15T09:41:07.000000+0330, size 0
{ "description": "osd_op(client.24183.0:131 3.1f 3:f8d87e31:::rbd_header.5f3a2b8c1d4e:head [watch ping cookie 94823571521536] snapc 0=[] ondisk+write+known_if_redirected e1462)",
"age": 0.0021, "flag_point": "waiting for sub ops" }در توصیف op، رشتهی 3:f8d87e31:::rbd_header...:head همان hobject_t است: pool ۳، کلید بیتی f8d87e31 (نه hash خام)، سپس namespace و key خالی، نام و snap.
۳۴-۸-۲ تنظیم و عیبیابی#
- PG داغ: اگر
dump_historic_ops نشان دهد بیشتر opهای کند روی یک PG هستند، افزایش shard یا thread کمکی نمیکند. شیء داغ را پیدا کنید (مثلاً rbd_header با watch زیاد یا یک shard ایندکس RGW) و آن را پخش کنید (shard بیشتر برای ایندکس، pg_num بیشتر برای pool). - op کند در
waiting for sub ops: یکی از replicaها کند است. با ceph osd perf و dump_historic_ops روی همان replica علت را بیابید. - رشد
osd_pglog در mempool: طول log (osd_min_pg_log_entries، osd_max_pg_log_entries) و dups را بررسی کنید (فصل ۳۳). -
osd_op_num_shards: روی NVMe با هستهی زیاد افزایش shard فقط وقتی کمک میکند که PGهای زیادی همزمان فعال باشند. پیش از تغییر، توزیع PGها بر shardها را با dump_op_pq_state ببینید. تغییر آن به راهاندازی دوبارهی OSD نیاز دارد.
۳۴-۹ تکمیلی و بهروز#
- در Crimson (فصل ۳۰) مسیر op با Seastar و بدون thread pool اجرا میشود، ولی همان دروازهها (peered، active، missing، degraded) در
crimson/osd/pg.cc و ops_executer.cc دوباره پیاده شدهاند. - در شاخهی main، پرچمهای
CEPH_OSD_RMW_FLAG_EC_DIRECT_READ و EC_SYNC_READ برای مسیر بهینهی EC وجود دارند (فصل ۲۷)؛ پیش از تکیه بر آنها نسخهی خود را بررسی کنید. - مقادیر پیشفرض shard برای HDD در نسخههای اخیر یک shard با پنج thread است تا ترتیبدهی mClock دقیقتر شود. در نسخههای قدیمیتر مقدار دیگری بود؛ روی نسخهی خودتان با
ceph config help osd_op_num_shards_hdd بررسی کنید.
۳۴-۱۰ تمرین عملی#
- ۱. برای سه شیء دلخواه
ceph osd map بگیرید و کلید بیتی را از روی hash دستی حساب کنید. سپس با dump_ops_in_flight یا لاگ (debug_osd=20) درستی آن را ببینید. - ۲. xattr
_ یک شیء را با ceph-objectstore-tool ... get-attr _ (روی OSD خاموش آزمایشی) یا با rados getxattr بخوانید و با ceph-dencoder رمزگشایی کنید. پس از یک نوشتن، تغییر version و user_version را مقایسه کنید. - ۳. با
ceph-objectstore-tool --op log چند ورودی log یک PG را ببینید و کلیدهای آن را با قالب %010u.%020llu تطبیق دهید. - ۴. روی یک pool آزمایشی یک OSD را
noout و خاموش کنید، روی چند شیء بنویسید، OSD را برگردانید و در حین recovery از dump_ops_in_flight نمونهای از waiting for degraded object پیدا کنید.
۳۴-۱۱ پرسشهای مرور#
- ۱. hobject_t به چه ترتیبی مقایسه میشود؟
- ۲. چرا کلید بیتی hash را برعکس میکند؟
- ۳. پس از دوبرابر شدن pg_num، بازهی کلید بیتی PG
0x1f چگونه تقسیم میشود؟ - ۴. xattrهای
_ و snapset چه چیزی نگه میدارند؟ - ۵. shard یک op چگونه انتخاب میشود و پیشفرضها روی SSD چیست؟
- ۶. اگر شیء روی primary missing باشد، op در کدام صف میماند؟
- ۷. درخواست تکراری چگونه تشخیص داده میشود و dups چه نقشی دارند؟
- ۸. user_version چگونه محاسبه میشود و چرا ممکن است برای یک شیء پیوسته نباشد؟
- ۹. پاسخ نوشتن replicated چه زمانی به کلاینت فرستاده میشود؟
- ۱۰. کلید یک ورودی pg log چه قالبی دارد و چرا طول آن ثابت است؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۴-۱۲ منابع این فصل#
- hobject.h و hobject.cc
https://github.com/ceph/ceph/blob/main/src/common/hobject.h - osd_types.h (object_info_t، pg_log_entry_t، کلیدهای pgmeta
https://github.com/ceph/ceph/blob/main/src/osd/osd_types.h - PrimaryLogPG.cc (do_op، execute_ctx، finish_ctx
https://github.com/ceph/ceph/blob/main/src/osd/PrimaryLogPG.cc - OSD.cc (enqueue_op و صف شاردشده
https://github.com/ceph/ceph/blob/main/src/osd/OSD.cc - مستند توسعهدهنده دربارهی اجرای op
https://docs.ceph.com/en/latest/dev/osd_internals/ - گزینههای OSD
https://docs.ceph.com/en/latest/rados/configuration/osd-config-ref/