لایههای پایینی (۳): RocksDB درون BlueStore
حوصله ندارم این فصل در چند خط
- RocksDB درون BlueStore یک درخت LSM است: نوشتن به WAL و memtable (یک skiplist) میرود و سپس به فایلهای SST منتقل میشود.
- group commit چند نویسنده را در یک نوشتن WAL جمع میکند؛ قالب رکورد WAL رکوردهای بزرگ را به چند تکه میشکند.
- بلوکهای دادهی SST کلیدها را با تفاضل و نقطههای restart ذخیره میکنند؛ Bloom filterهای Ceph (
rocksdb_bloom_bits_per_key = 20) جلوی خواندنهای بیفایده را میگیرند. - امتیاز compaction و اندازهی پویای سطحها تعیین میکنند داده کی و کجا compact شود و همین write amplification را میسازد.
۲۵-۱ مقدمه: چرا RocksDB؟#
BlueStore دادهی اشیا را مستقیم روی دستگاه خام مینویسد، ولی همهی فرادادهاش، از onodeها و omapها تا freelist و deferred writeها، در RocksDB قرار دارد. RocksDB یک پایگاه دادهی کلید-مقدار مبتنی بر LSM-tree است: نوشتنها ابتدا در یک لاگ ترتیبی (WAL) و یک ساختار حافظهای (memtable) ثبت میشوند و بعدها در پسزمینه به فایلهای مرتب و تغییرناپذیر (SST) تبدیل و ادغام میشوند. این ساختار نوشتن کوچک را ارزان و ترتیبی میکند، که برای فرادادهی پرتکرار BlueStore ایدهآل است. هزینهی آن در compaction و write amplification پرداخت میشود. این فصل لایهبهلایه نشان میدهد Ceph چگونه RocksDB را پیکربندی و shard میکند و روی BlueFS مینشاند.
- Ceph نسخهی خودش از RocksDB را بهصورت submodule (
ceph/rocksdb) همراه کد دارد. رابط آن src/kv/RocksDBStore.cc است که KeyValueDB را پیاده میکند. - پیشفرضهای
bluestore_rocksdb_options شامل این موارد است: memtable ۱۶M، حداکثر ۶۴ memtable، ادغام دستکم ۶ memtable پیش از flush، L1 برابر ۱G، ضریب ۸ و فشردهسازی LZ4. - column family sharding (
bluestore_rocksdb_cfs) پیشوندهای m، p و O را به چند CF با hash نوع rjenkins روی بخشی از کلید تقسیم میکند. - BlueFS سطوح RocksDB را بر اساس سیاست
use_some_extra بین WAL، DB و دستگاه کند پخش میکند. سرریز به دستگاه کند هشدار BLUEFS_SPILLOVER میدهد.
۲۵-۲ از تراکنش BlueStore تا WriteBatch#
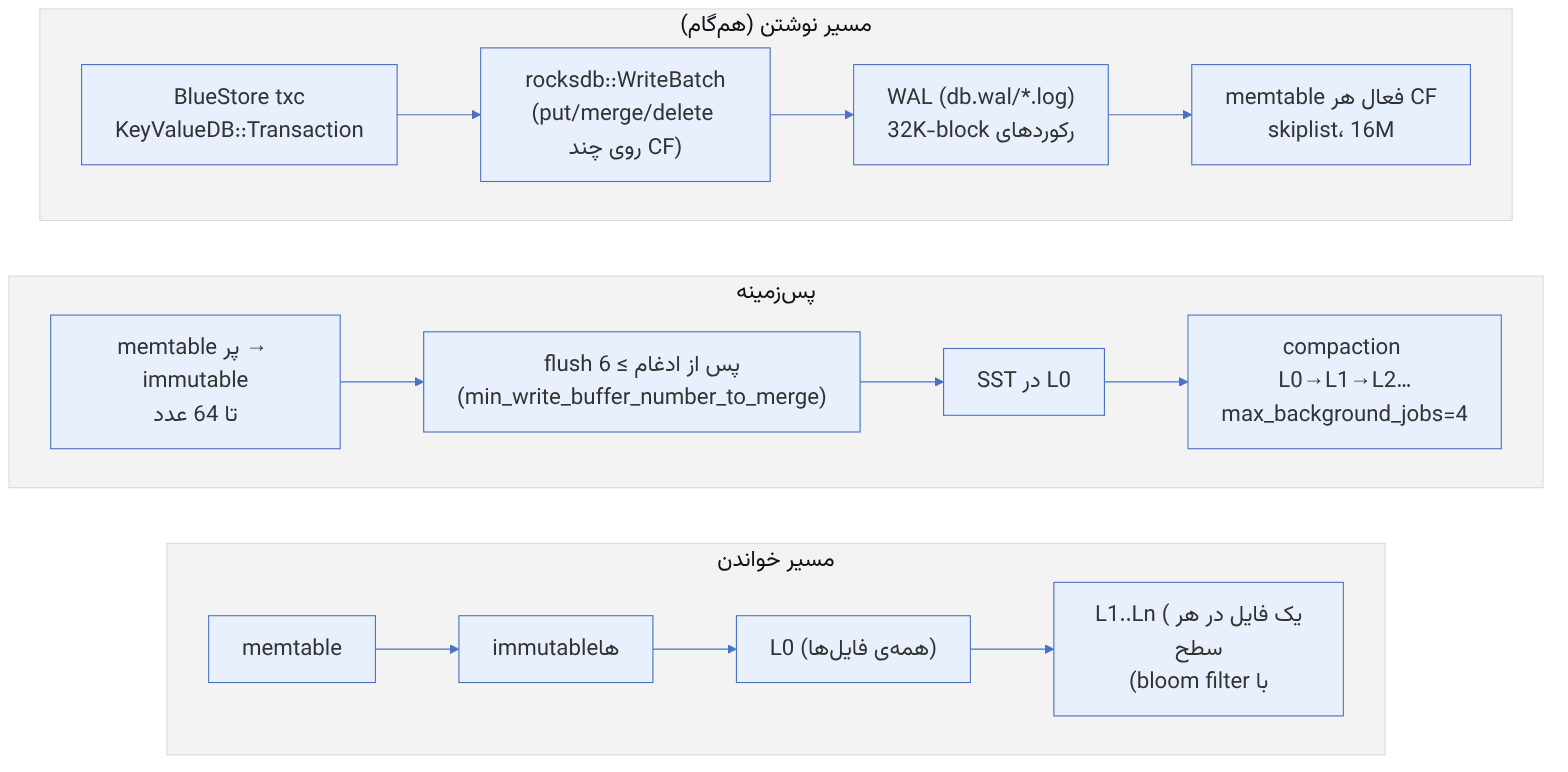
BlueStore::_txc_finalize_kv و _kv_sync_thread تراکنشهای آماده را جمع میکنند. هر KeyValueDB::Transaction در RocksDBStore یک rocksdb::WriteBatch است و submit_transaction_sync آن را با WriteOptions.sync = true به RocksDB میدهد. چند تراکنش BlueStore در یک دور _kv_sync_thread پشت سر هم ثبت میشوند، ولی فقط آخرین آنها همگام است. بنابراین چندین txc با یک fsync روی WAL پایدار میشوند (group commit).
| عملیات KeyValueDB | معادل RocksDB | کاربرد در BlueStore |
|---|---|---|
set(prefix, key, bl) | Put(cf, key, value) | onode، omap، deferred |
rmkey | Delete | حذف onode و omap |
rm_single_key | SingleDelete | کلیدهایی که دقیقاً یک بار نوشته شدهاند (مثل L)؛ tombstone زودتر حذف میشود |
rm_range_keys | DeleteRange (بالاتر از آستانه) | حذف omap کامل یک شیء؛ زیر rocksdb_delete_range_threshold=1M کلیدبهکلید حذف میشود |
merge | Merge با operator ثبتشده | bitwise_xor برای freelist و int64_array برای آمار |
۲۵-۳ WAL: قالب رکورد#
WAL مربوط به RocksDB (فایلهای *.log در دایرکتوری BlueFS به نام db.wal) به بلوکهای ثابت ۳۲ کیلوبایتی (kBlockSize = 32768) تقسیم میشود. هر رکورد یک سرآیند ۷ بایتی (kHeaderSize = 4 + 2 + 1) دارد: checksum از نوع crc32c ماسکشده (۴ بایت)، طول (۲ بایت) و نوع (۱ بایت). نوع یکی از اینهاست: kFullType=1 (رکورد کامل در همین بلوک)، kFirstType=2، kMiddleType=3 یا kLastType=4 (رکوردی که به چند بلوک شکسته شده است). در حالت recyclable، ۴ بایت شمارهی لاگ هم اضافه و سرآیند ۱۱ بایتی میشود.
WAL record (منطق از RocksDB db/log_format.h، Apache-2.0/GPL-2.0؛ نمایش از این کتاب)
 +--------+--------+------+---------------------------+
 | CRC(4) | Len(2) | T(1) |  payload: WriteBatch بخشی |
 +--------+--------+------+---------------------------+
WriteBatch = seq(8) | count(4) | {type, [cf id], key, value}*تعامل WAL و BlueFS: RocksDB برای هر commit همگام Sync() را روی فایل WAL صدا میزند و BlueRocksEnv آن را به BlueFS::fsync تبدیل میکند. BlueFS داده را flush میکند. اگر فایل بزرگتر شده باشد، باید fnode تازه را هم در لاگ BlueFS ثبت کند، که یعنی یک نوشتن همگام دوم. حالت envelope در Tentacle و بالاتر (فصل ۲۴) دقیقاً برای حذف همین نوشتن دوم طراحی شده است. همچنین max_total_wal_size=1G باعث میشود اگر WAL بیش از ۱ گیگابایت شود، memtableهای قدیمیتر زودتر flush شوند تا WAL بتواند کوتاه شود.
۲۵-۴ memtable و flush#
memtable بهطور پیشفرض یک skiplist است. با پیشفرضهای Ceph، هر memtable write_buffer_size=16M دارد و تا max_write_buffer_number=64 memtable (یعنی حداکثر ۱ گیگابایت) میتواند در حافظه باشد. min_write_buffer_number_to_merge=6 یعنی flush فقط وقتی انجام میشود که دستکم شش memtable تغییرناپذیر آماده باشند. سپس هر شش با هم ادغام میشوند و کلیدهایی که در این فاصله نوشته و پاک شدهاند (مثل deferred writeها و رکوردهای موقت pg log) هرگز به SST نمیرسند. برای CFهای L و P این عدد در bluestore_rocksdb_cfs به ۳۲ رسانده شده است، چون عمر کلیدهای آنها بسیار کوتاه است.
این طراحی توضیح میدهد چرا حذف یا کوتاه کردن min_write_buffer_number_to_merge در تنظیمات دستی معمولاً write amplification را چند برابر میکند. اگر bluestore_rocksdb_options را تغییر میدهید، فقط کلیدهای مورد نظر را در bluestore_rocksdb_options_annex اضافه کنید، نه کل رشته را.
۲۵-۵ SST: قالب فایل#
| بخش | محتوا | گزینهی Ceph |
|---|---|---|
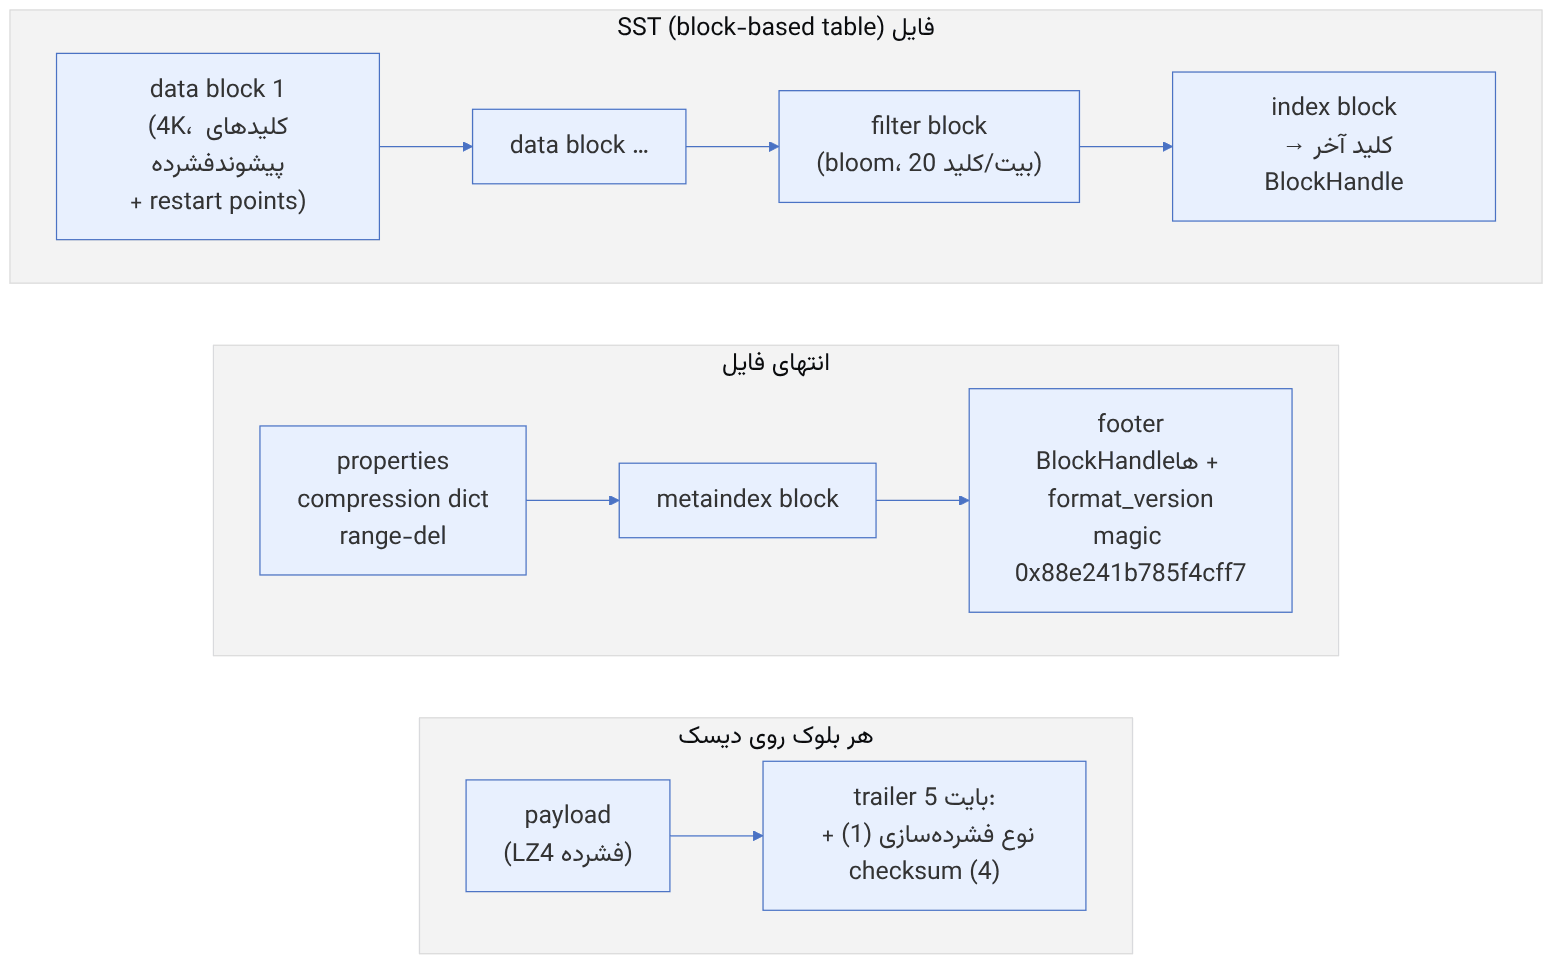
| data block | کلیدهای مرتب با پیشوند مشترک حذفشده؛ هر ۱۶ کلید یک restart point | rocksdb_block_size=4_K |
| filter | bloom filter کل فایل یا پارتیشنبندیشده | rocksdb_bloom_bits_per_key=20 (نرخ مثبت کاذب حدود ۰٫۰۱٪) |
| index | آخرین کلید هر بلوک → (offset، size) | rocksdb_metadata_block_size=4_K |
| کش | بلوکهای داده، index و filter در block cache | rocksdb_cache_size=512_M (با autotune متغیر)، rocksdb_cache_type=binned_lru، rocksdb_cache_index_and_filter_blocks=true |
| footer | BlockHandleها، format_version، magic | — |
نوع checksum بلوکها و format_version پیشفرض به نسخهی RocksDB همراه Ceph بستگی دارد. در RocksDB اصلی (شاخهی main) پیشفرضها kXXH3 و format_version=7 هستند. Ceph نسخهی خودش را از مخزن ceph/rocksdb میسازد، بنابراین برای دیدن مقدار دقیق، خروجی OPTIONS-* درون BlueFS را بررسی کنید (با bluefs-export).
۲۵-۶ compaction و سطوح#
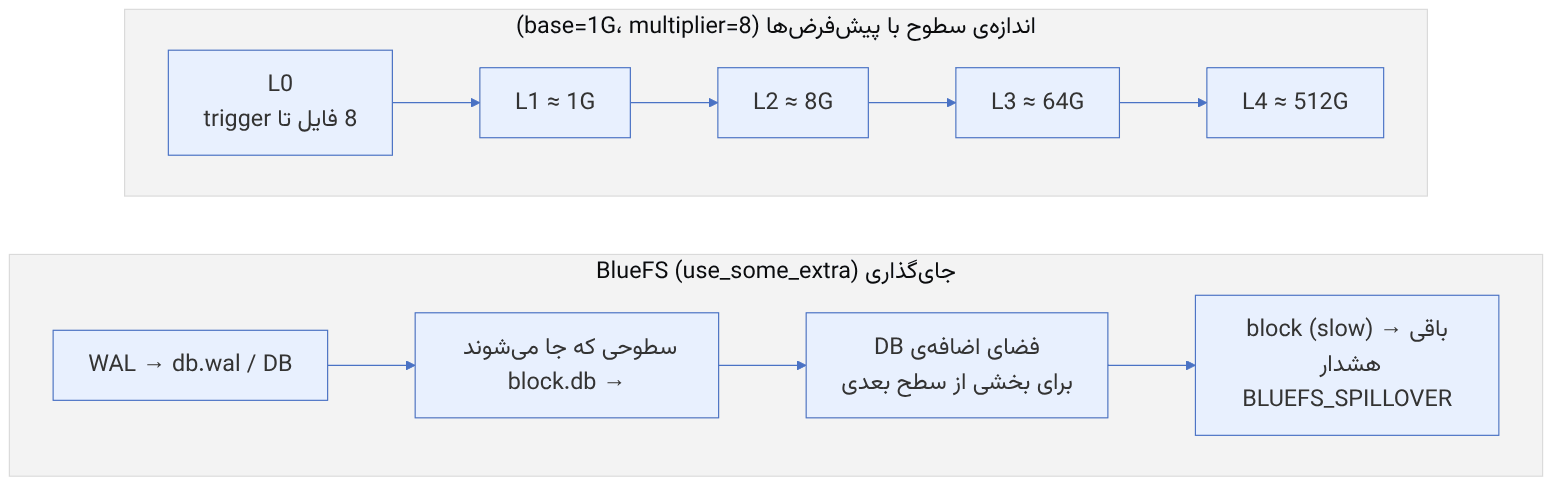
با compaction_style=kCompactionStyleLevel، هر سطح Ln (n ≥ ۱) مجموعهای از SSTهای بدون همپوشانی کلید است. وقتی تعداد فایلهای L0 به level0_file_num_compaction_trigger=8 برسد، compaction L0→L1 آغاز میشود. وقتی اندازهی یک سطح از هدفش بیشتر شود، بخشی از آن به سطح بعد ادغام میشود. پیشفرضهای Ceph عبارتاند از max_bytes_for_level_base=1G، max_bytes_for_level_multiplier=8 و max_background_jobs=4 (flush و compaction با هم).
مثال عددی اندازهی DB: OSDی با ۱۰ میلیون شیء ۴M (حدود ۴۰ ترابایت) و onodeهای حدود ۸۰۰ بایتی، فقط برای O حدود ۸ گیگابایت داده دارد. با omap و pg log ممکن است به ۲۰ تا ۳۰ گیگابایت برسد. با پیشفرضها، L1+L2+L3 = ۱ + ۸ + ۶۴ = ۷۳G روی DB لازم است تا کل دادهی سطح ۳ روی دستگاه سریع بماند. اگر block.db فقط ۳۰G باشد، سیاست use_some_extra بخشی از L3 را روی DB و بقیه را روی دستگاه کند قرار میدهد و BLUEFS_SPILLOVER گزارش میشود.
سیاست bluestore_volume_selection_policy | رفتار |
|---|---|
rocksdb_original | فقط سطوحی که کامل جا میشوند روی DB قرار میگیرند |
use_some_extra (پیشفرض) | فضای اضافهی DB برای بخشی از سطح بعدی استفاده میشود؛ bluestore_volume_selection_reserved_factor=2 |
use_some_extra_enforced | مانند قبلی، با اجبار سختگیرانهتر |
fit_to_fast | استفادهی ۱۰۰٪ از دستگاه سریع؛ امکان فعال کردن level_compaction_dynamic_level_bytes |
چرا ضریب ۸ و نه ۱۰؟ write amplification در compaction سطحی تقریباً با ضریب سطوح متناسب است (هر بایت در هر سطح حدوداً به اندازهی ضریب بار دیگر بازنویسی میشود)، و فضای اضافه برابر ۱/(multiplier−۱) است. ضریب ۸ در برابر ۱۰ کمی فضای بیشتری میگیرد ولی write amplification را کاهش میدهد و اندازهی سطوح را با اندازههای رایج دستگاههای DB همخوانتر میکند. این یک انتخاب طراحی در پیشفرضهای Ceph است. پیش از تغییر آن، تأثیرش را روی اندازهی DB خود محاسبه کنید.
۲۵-۷ column family sharding#
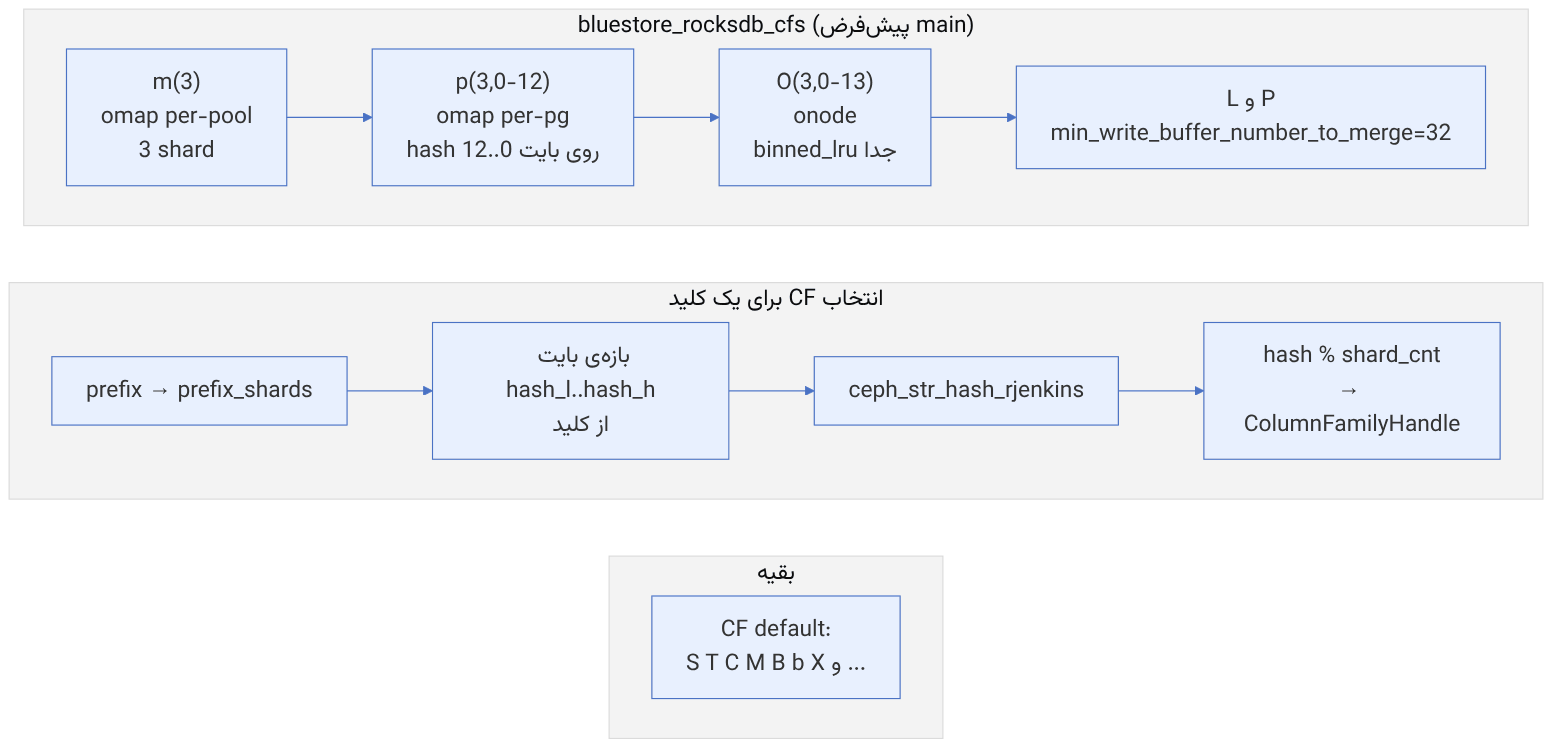
نحو تعریف به شکل <prefix>(<shards>[,<l>-<h>])[=<options>] است که parse_sharding_def در RocksDBStore.cc آن را تفسیر میکند. get_key_cf بخش [hash_l, hash_h) کلید را با ceph_str_hash_rjenkins هش میکند و hash % shards.handles.size() را برمیگرداند. در p(3,0-12)، بایتهای ۰ تا ۱۲ کلید (یعنی pool، hash PG و ابتدای nid) استفاده میشوند تا omapهای یک PG در یک shard بمانند و range scan روی یک CF انجام شود.
چرا shard؟ (۱) هر CF memtable و compaction جداگانه دارد. بنابراین دادههای پرتغییر (L و P) با onodeهای پایدار (O) در یک SST ادغام نمیشوند و write amplification کمتر میشود. (۲) compaction روی چند CF موازی میشود. (۳) کش جداگانه برای O (block_cache={type=binned_lru}) از رانده شدن onodeها توسط omap جلوگیری میکند.
# OSD متوقف:
ceph-bluestore-tool show-sharding --path /var/lib/ceph/osd/ceph-4
ceph-bluestore-tool reshard --path /var/lib/ceph/osd/ceph-4 \
    --sharding "m(3) p(3,0-12) O(3,0-13)=block_cache={type=binned_lru} L P"
ceph-kvstore-tool bluestore-kv /var/lib/ceph/osd/ceph-4 stats
# OSD در حال اجرا:
ceph tell osd.4 compact
ceph daemon osd.4 bluefs statsreshard روی OSD متوقف اجرا میشود و کل DB را بازنویسی میکند. پیش از آن OSD را noout کنید، فضای آزاد DB را بررسی کنید و ابتدا روی یک OSD آزمایش کنید. طبق مستندات، OSDهایی که پیش از Pacific ساخته شدهاند پس از ارتقا همچنان بدون shard میمانند (همهچیز در CF به نام default) و reshard روش رسمی تبدیل آنهاست.
۲۵-۸ tuning و تشخیص#
| نشانه | علت محتمل | اقدام |
|---|---|---|
تأخیر commit بالا (ceph daemon osd.N perf dump bluestore → kv_sync_lat) | WAL روی دستگاه کند یا WAL و DB رقیب داده | WAL و DB روی NVMe؛ بررسی bluefs stats |
BLUEFS_SPILLOVER | block.db کوچکتر از سطوح لازم | بزرگ کردن DB (bluefs-bdev-expand) یا مهاجرت (bluefs-bdev-migrate) |
| کندی پس از حذف انبوه (مثلاً حذف snapshot) | tombstoneهای زیاد در SSTها | rocksdb_cf_compact_on_deletion=true (پیشفرض) یا ceph tell osd.N compact |
| رشد حافظهی OSD | memtableها (تا ۱G) و block cache | osd_memory_target، بررسی dump_mempools و rocksdb در perf |
| L0 پر و stall نوشتن | compaction عقب افتاده | بررسی max_background_jobs و پهنای باند دستگاه DB |
ceph daemon osd.4 perf dump rocksdb | jq '.rocksdb | {get_latency, submit_latency, submit_sync_latency, compact, compact_running}'
ceph config set osd bluestore_rocksdb_options_annex "max_background_jobs=6" # فقط کلیدهای تغییرکرده۲۵-۹ یک WriteBatch در سطح بایت#
برای اینکه ببینیم یک تراکنش BlueStore روی WAL چه شکلی دارد، یک WriteBatch فرضی با دو عمل را دستی کدگذاری میکنیم: یک Put در CF با شناسهی ۳ (کلید Ok1o و مقدار hello) و یک SingleDelete در CF با شناسهی ۷ (کلید L42). شمارهی توالی ۱۲۳۴۵۶۷ است. ثابتهای نوع از db/dbformat.h در RocksDB آمدهاند: kTypeColumnFamilyValue=0x5 و kTypeColumnFamilySingleDeletion=0x8. کدگذار نوشتهی خود ماست.
| بایتها | معنی |
|---|---|
87 d6 12 00 00 00 00 00 | sequence = ۱۲۳۴۵۶۷ (u64 little-endian) |
02 00 00 00 | count = ۲ (u32) |
05 | نوع: Put در CF غیرپیشفرض |
03 | شناسهی CF (varint) |
04 4f 6b 31 6f | طول کلید ۴ + «Ok1o» |
05 68 65 6c 6c 6f | طول مقدار ۵ + «hello» |
08 07 | نوع SingleDelete در CF + شناسهی CF ۷ |
03 4c 34 32 | طول کلید ۳ + «L42» |
این ۳۲ بایت سپس بهعنوان payload یک رکورد WAL، با سرآیند ۷ بایتی (crc + طول + نوع kFullType)، در بلوک ۳۲K جاری نوشته میشود. اگر payload از انتهای بلوک بگذرد، به رکوردهای First/Middle/Last تقسیم میشود. اگر کمتر از ۷ بایت تا انتهای بلوک مانده باشد، آن چند بایت با صفر پر میشوند.
کلیدهای واقعی BlueStore: برای پیشوندهایی که CF جدا دارند، نخستین نویسهی پیشوند در کلید RocksDB تکرار نمیشود، چون خود CF پیشوند را مشخص میکند. در CF پیشفرض، کلید به شکل prefix + 0x00 + key ترکیب میشود (combine_strings). به همین دلیل وقتی با ldb مستقیم روی CF پیشفرض نگاه میکنید، کلیدهایی مثل S\0nid_max میبینید.
۲۵-۱۰ BlueRocksEnv: RocksDB بدون فایلسیستم هسته#
BlueRocksEnv از rocksdb::EnvWrapper ارث میبرد و فراخوانیهای فایل RocksDB را به BlueFS میفرستد:
| تابع Env در RocksDB | پیادهسازی در BlueFS |
|---|---|
NewWritableFile | BlueFS::open_for_write → FileWriter با بافر و append |
NewSequentialFile / NewRandomAccessFile | open_for_read → FileReader با prefetch |
Sync / Fsync | BlueFS::fsync: flush داده، و در صورت تغییر اندازه، ثبت fnode در لاگ |
RenameFile | op_dir_link + op_dir_unlink در یک تراکنش لاگ (اتمیک) |
GetChildren | فهرست dir_map |
LockFile | قفل درونفرایندی (BlueFS فقط یک کاربر دارد) |
دایرکتوریهای BlueFS بیانگر محل فیزیکیاند: db (دستگاه DB)، db.wal (دستگاه WAL) و db.slow (دستگاه اصلی). RocksDB از طریق گزینههای db_paths و wal_dir فایلها را در این دایرکتوریها میسازد و volume selector مربوط به BlueFS (بخش قبل) تصمیم نهایی را دربارهی دستگاه میگیرد.
pseudocode: fsync یک فایل WAL (خلاصهی این کتاب)
BlueFS::fsync(h):
_flush_F(h) # نوشتن بافر به extentها با aio
if h.file.fnode.size changed (یا allocated changed):
log.t.op_file_update_inc(h.file.fnode)
_flush_and_sync_log_LD() # نوشتن همگام دوم: لاگ BlueFS
else:
_flush_bdev(h) # فقط flush دستگاه۲۵-۱۱ الگوریتمهای درون RocksDB در سطح کد#
بخشهای پیشین گفتند RocksDB درون BlueStore چه میکند. این بخش هفت الگوریتم کلیدی را با کد RocksDB 9.11 بررسی میکند، یعنی همان نسخهای که submodule src/rocksdb در شاخهی main به آن اشاره میکند (مخزن ceph/rocksdb). نسخههای Reef و Squid به commitهای دیگری اشاره میکنند. پیشفرضهایی که در طول نسخهها عوض شدهاند، جداگانه مشخص شدهاند.
۲۵-۱۱-۱ skiplist در memtable#
memtable پیشفرض یک InlineSkipList است. Ceph کارخانهی memtable را عوض نمیکند، پس همین ساختار برای همهی column familyها بهکار میرود. سازندهی آن max_height = 12 و branching_factor = 4 دارد.
منبع در کد: rocksdb/memtable/inlineskiplist.h :: InlineSkipList::RandomHeight، FindGreaterOrEqual، Insert
پیچیدگی: جستوجو و درج با امید O(log_۴ n) سطح و حدود ۴ مقایسه در هر سطح، یعنی O(log n). حافظه بهطور میانگین ۴/۳ اشارهگر برای هر گره
pseudocode
RandomHeight(): h = 1
while h < 12 and rnd.Next() < 2^32/4: h++ # احتمال 1/4 برای هر سطح بالاتر
FindGreaterOrEqual(key):
x = head ; level = max_height − 1
loop: next = x.next[level]
cmp = (next == null) ? +1 : compare(next.key, key)
if cmp == 0 or (cmp > 0 and level == 0): return next
if cmp < 0: x = next # جلو برو
else: level −= 1 # پایین برو
Insert(key): ارتفاع h ؛ prev[] و next[] را از بالا تا پایین پیدا کن ؛
گره را با یک تخصیص از arena بساز (اشارهگرها پیش از کلید) ؛
از سطح 0 به بالا با CAS یا store-release پیوند بزنمثال عددی. با write_buffer_size = ۱۶ MiB (پیشفرض Ceph) و ورودیهای حدود ۱۰۰ بایتی، هر memtable حدود ۱۶۰۰۰۰ گره دارد. تعداد امید ریاضی گرههایی که ارتفاعشان دستکم h است، است: ۱۶۰۰۰۰، ۴۰۰۰۰، ۱۰۰۰۰، ۲۵۰۰، ۶۲۵، ۱۵۶، ۳۹، ۱۰، ۲.۴ برای h = ۱..۹. پس ارتفاع مؤثر حدود ۹ است و یک Seek حدود ۹ سطح را با ۱ تا ۳ قدم افقی در هر سطح طی میکند، یعنی کمتر از ۳۰ مقایسهی کلید. میانگین ارتفاع ۴/۳ است، پس هر گره بهطور میانگین ۸ × ۴/۳ ≈ ۱۰.۷ بایت اشارهگر دارد. یک شبیهسازی جداگانه با ۱۶۰۰۰۰ گره میانگین ۱.۳۳۵ را داد.
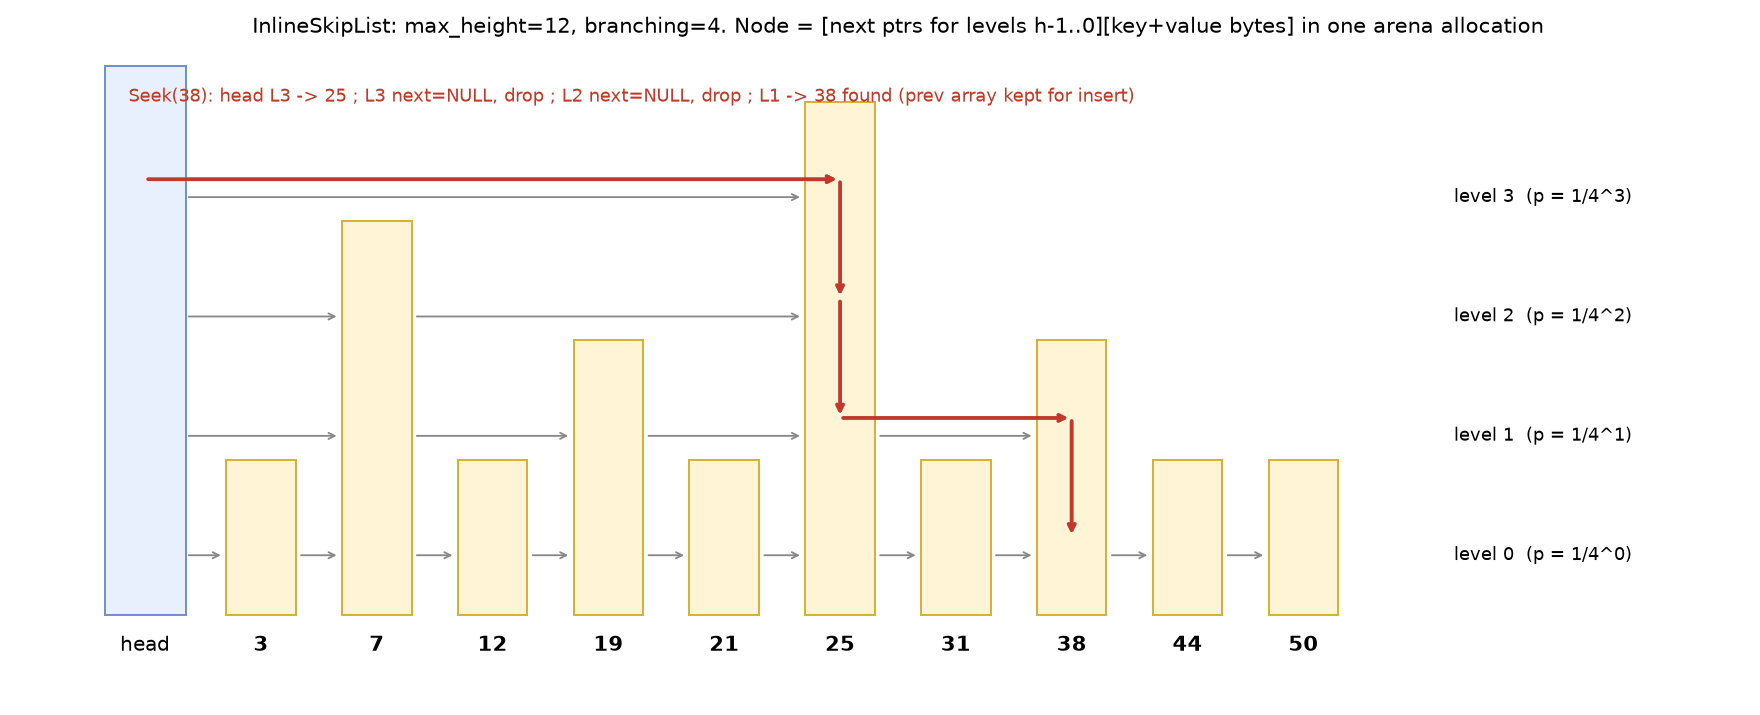
درج همزمان (allow_concurrent_memtable_write = true، پیشفرض RocksDB) از InsertConcurrently با CAS در هر سطح استفاده میکند. در BlueStore بیشتر نوشتنها از kv_sync_thread میآیند، پس رقابت روی skiplist کم است و هزینهی اصلی مقایسهی کلید و cache miss است.
۲۵-۱۱-۲ گروه نوشتن (group commit)#
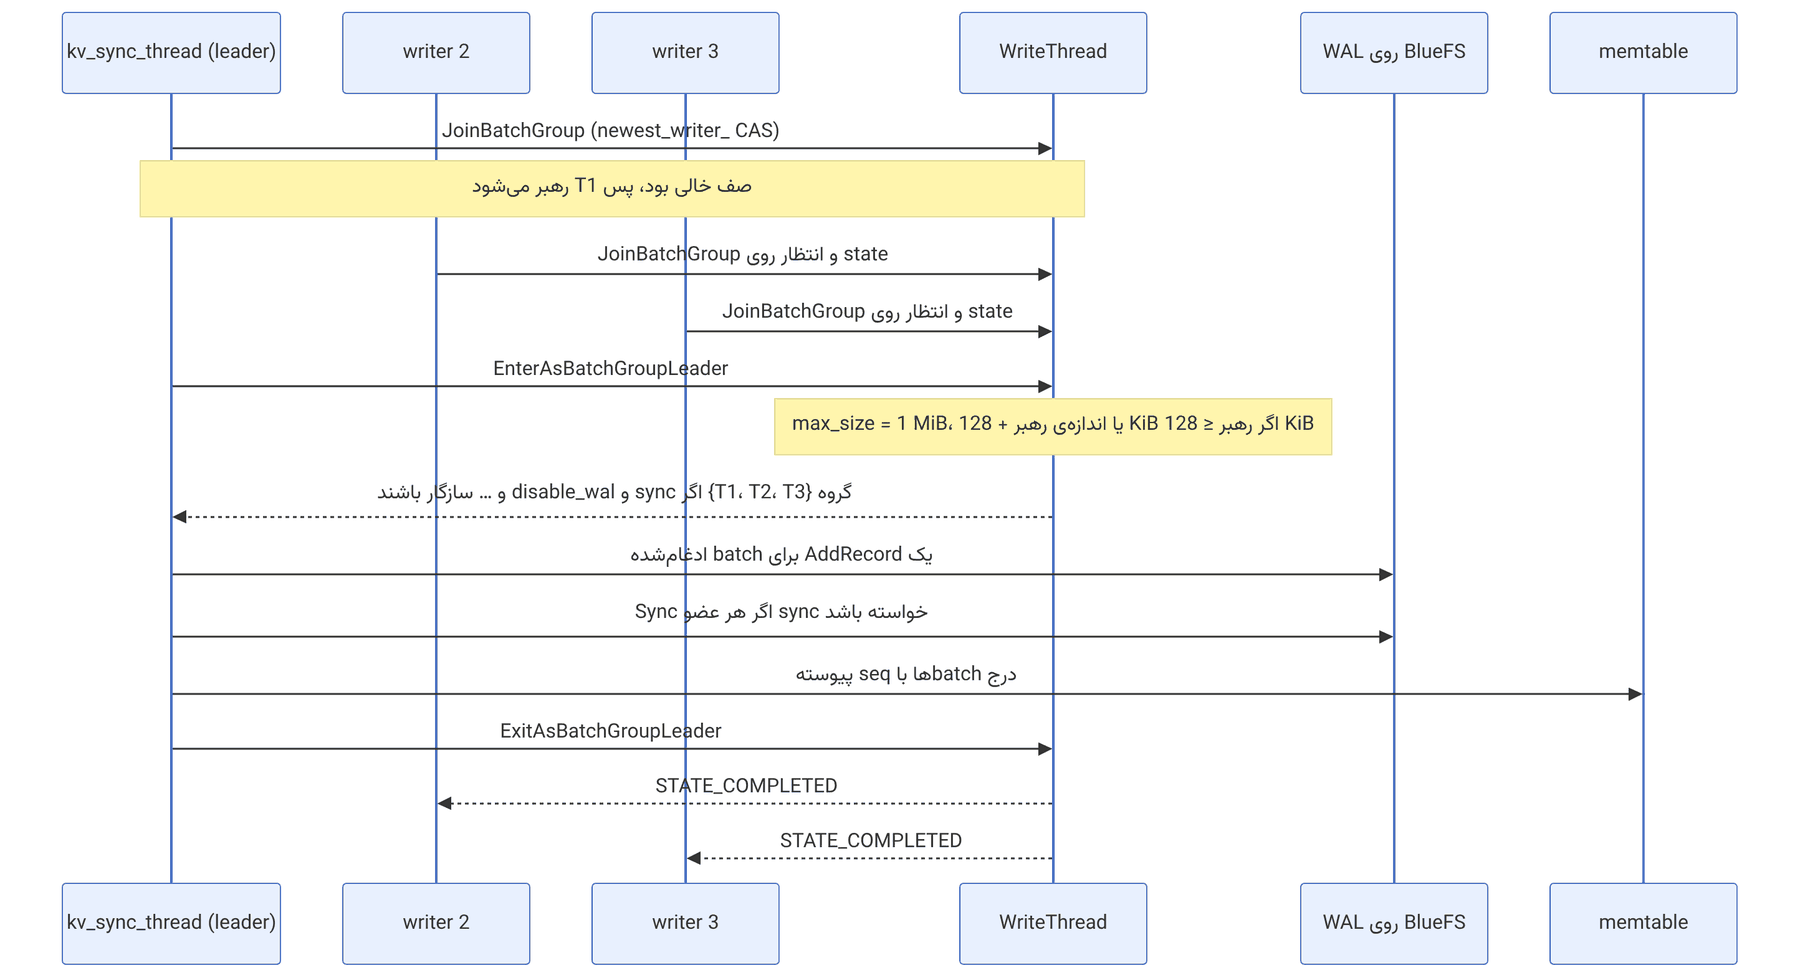
منبع در کد: rocksdb/db/write_thread.cc :: WriteThread::JoinBatchGroup، EnterAsBatchGroupLeader، ExitAsBatchGroupLeader
پیچیدگی: O(g) برای g نویسندهی گروه؛ یک AddRecord و حداکثر یک fsync برای کل گروه
pseudocode
JoinBatchGroup(w): newest_writer_ را با CAS به w تغییر بده
    if صف خالی بود: w رهبر است
    else: روی w.state منتظر بمان (spin کوتاه، سپس futex/condvar)
EnterAsBatchGroupLeader(leader):
    max = max_write_batch_group_size_bytes                # 1 MiB
    if size(leader) ≤ max/8: max = size(leader) + max/8   # 128 KiB
    for w از قدیمی به جدید:
        if (w.sync و not leader.sync) or w.disable_wal ≠ leader.disable_wal
           or w.no_slowdown ≠ … or size + size(w) > max: قطع کن
        else: w را به گروه اضافه کن
مثال عددی. رهبر یک batch شصت کیلوبایتی دارد. چون ۶۰K ≤ ۱۲۸K، سقف گروه ۶۰K + ۱۲۸K = ۱۸۸K میشود. سه نویسندهی بعدی ۴۰K، ۵۰K و ۷۰K دارند. ۶۰ + ۴۰ + ۵۰ = ۱۵۰K پذیرفته میشود، اما با ۷۰K جمع ۲۲۰K میشود و از ۱۸۸K بیشتر است، پس گروه همانجا قطع میشود. اگر رهبر sync=false باشد و نویسندهی دوم sync=true، گروه پیش از نویسندهی دوم قطع میشود، چون رهبرِ بیsync نمیتواند برای دیگری fsync را تضمین کند.
۲۵-۱۱-۳ قالب رکورد WAL و قطعهقطعه شدن#
منبع در کد: rocksdb/db/log_writer.cc :: log::Writer::AddRecord، EmitPhysicalRecord؛ db/log_format.h
پیچیدگی: O(L/۳۲K) قطعه برای رکورد L بایتی؛ سربار ۷ بایت در هر قطعه (۱۱ بایت در قالب recyclable)
pseudocode
left = len(record) ; begin = true
do:
leftover = 32768 − block_offset
if leftover < 7: صفر بنویس تا پایان بلوک ؛ block_offset = 0
avail = 32768 − block_offset − 7
frag = min(left, avail) ; end = (frag == left)
type = begin&&end ? FULL(1) : begin ? FIRST(2) : end ? LAST(4) : MIDDLE(3)
EmitPhysicalRecord(type, ptr, frag) # crc32c(type‖payload) ماسکشده، len (2B)، type (1B)
left −= frag ; begin = false
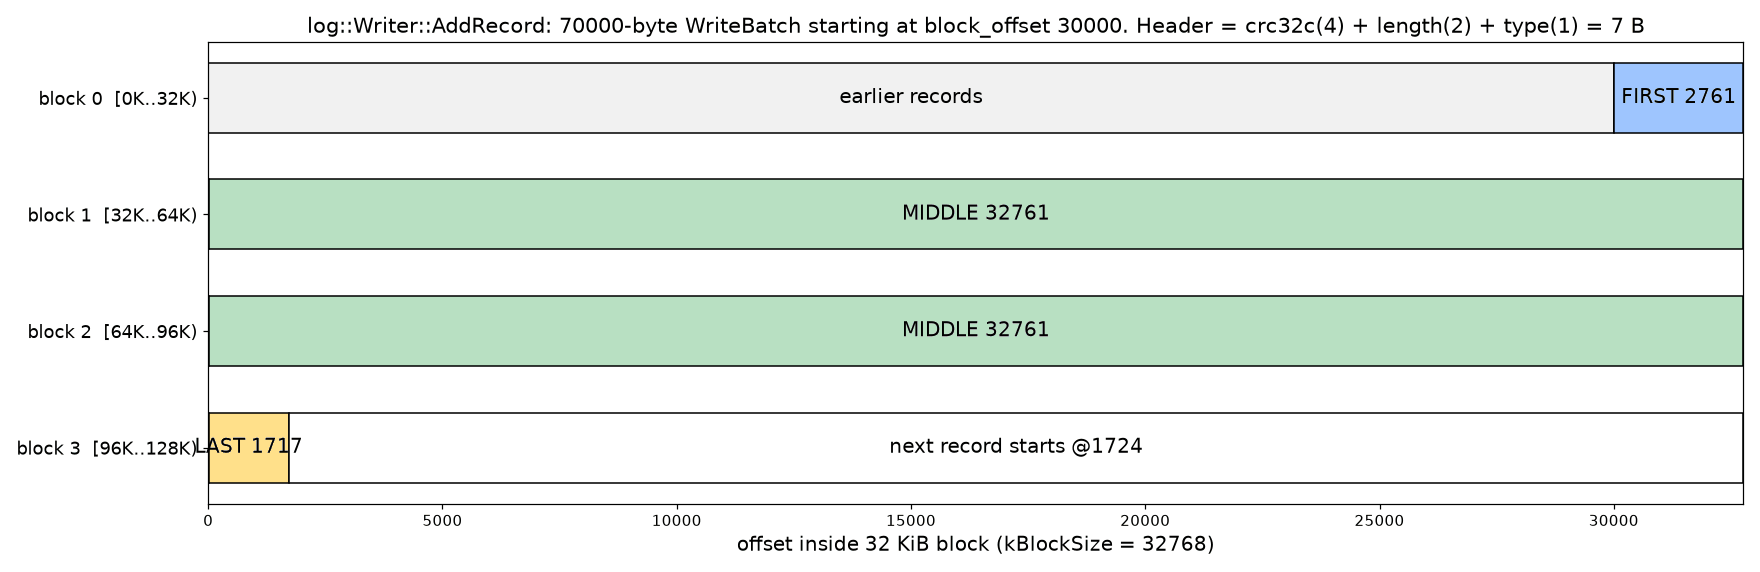
while left > 0مثال عددی. یک WriteBatch هفتادهزار بایتی در block_offset = ۳۰۰۰۰ شروع میشود:
- leftover = ۲۷۶۸ و avail = ۲۷۶۱، پس FIRST با ۲۷۶۱ بایت.
- بلوک بعدی: avail = ۳۲۷۶۱، پس MIDDLE.
- بلوک سوم: باز MIDDLE با ۳۲۷۶۱ بایت.
- باقیمانده ۷۰۰۰۰ − ۲۷۶۱ − ۲×۳۲۷۶۱ = ۱۷۱۷ بایت است، پس LAST در ابتدای بلوک چهارم.
block_offset بعدی ۷ + ۱۷۱۷ = ۱۷۲۴ است. سربار کل ۴ × ۷ = ۲۸ بایت است.
۲۵-۱۱-۴ بلوک دادهی SST: دلتای کلید و restart#
منبع در کد: rocksdb/table/block_based/block_builder.cc :: BlockBuilder::AddWithLastKeyImpl، Finish؛ table/block_based/block.cc :: DataBlockIter::SeekImpl (BinarySeek)؛ util/coding.h :: EncodeVarint32
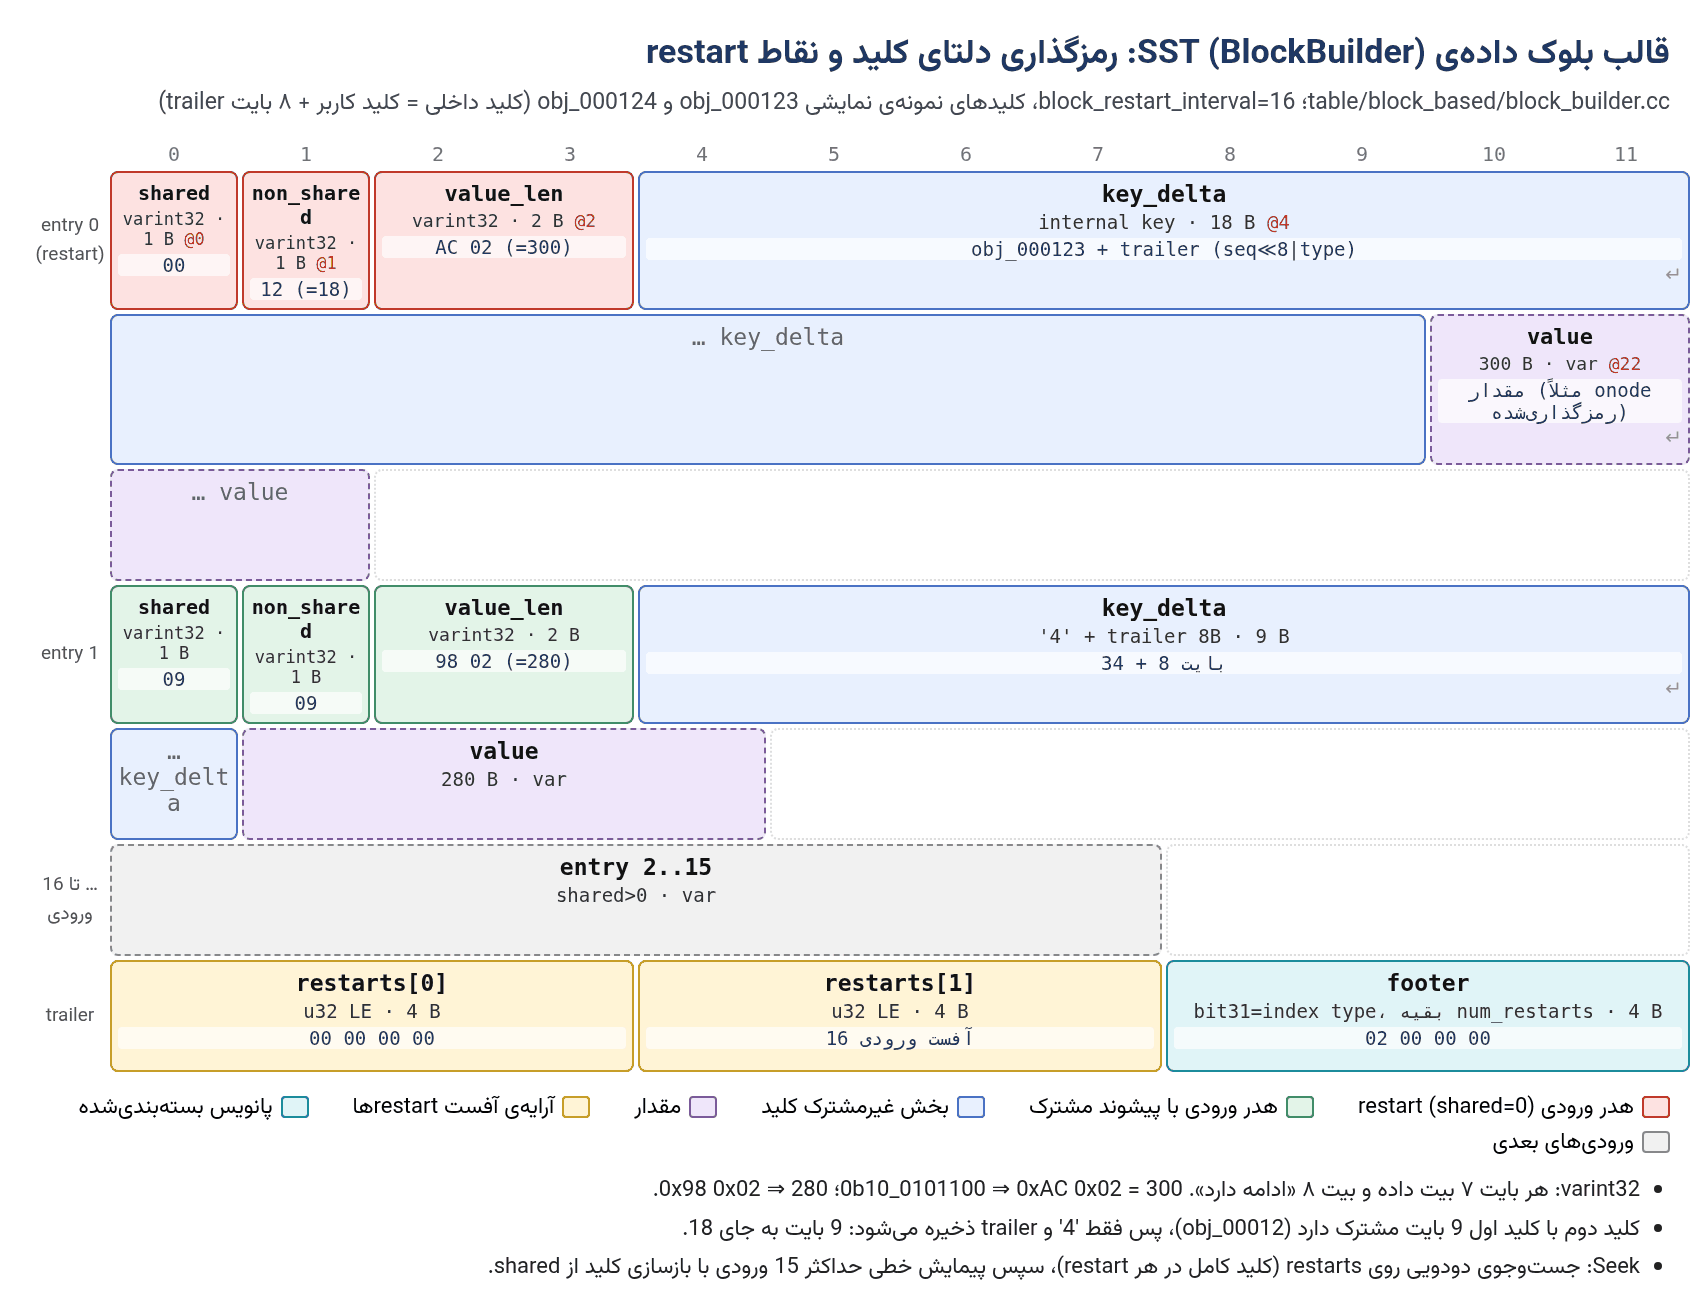
پیچیدگی: ساخت O(L)؛ Seek O(log R + I) با R restart و I = block_restart_interval = ۱۶
pseudocode
Add(key, value):
if counter == 16: restarts.push(buffer.size) ; shared = 0 ; counter = 0
else: shared = طول پیشوند مشترک با کلید قبلی
PutVarint32 ×3 (shared, len(key)−shared, len(value)) ; append key[shared:] ; append value
Finish(): append restarts[] as u32 ; append Pack(index_type, num_restarts) # bit31
Seek(target): جستوجوی دودویی روی restarts با مقایسهی کلید کامل هر restart
سپس پیمایش خطی و بازسازی کلید = prev[0:shared] + delta
EncodeVarint32(v): while v ≥ 128: emit (v & 127) | 128 ; v ≫= 7 ; emit vمثال عددی. با rocksdb_block_size = 4K (پیشفرض Ceph) و ورودیهای حدود ۳۰۰ بایتی، هر بلوک حدود ۱۳ ورودی دارد، یعنی کمتر از ۱۶، پس فقط یک restart. Seek درون بلوک عملاً خطی است، اما ۱۳ مقایسه روی دادهای که در cache است. در بلوکهای metadata که مقادیر کوچکاند (مثلاً ۱۰۰ کلید ۴۰ بایتی)، ۷ restart هست و جستوجوی دودویی ۳ مقایسه بهاضافهی حداکثر ۱۵ قدم خطی دارد. رمزگذاری varint عدد ۳۰۰ دو بایت AC 02 است و عدد ۱۸ یک بایت ۱۲.
۲۵-۱۱-۵ فیلتر Bloom محلی در cache line#
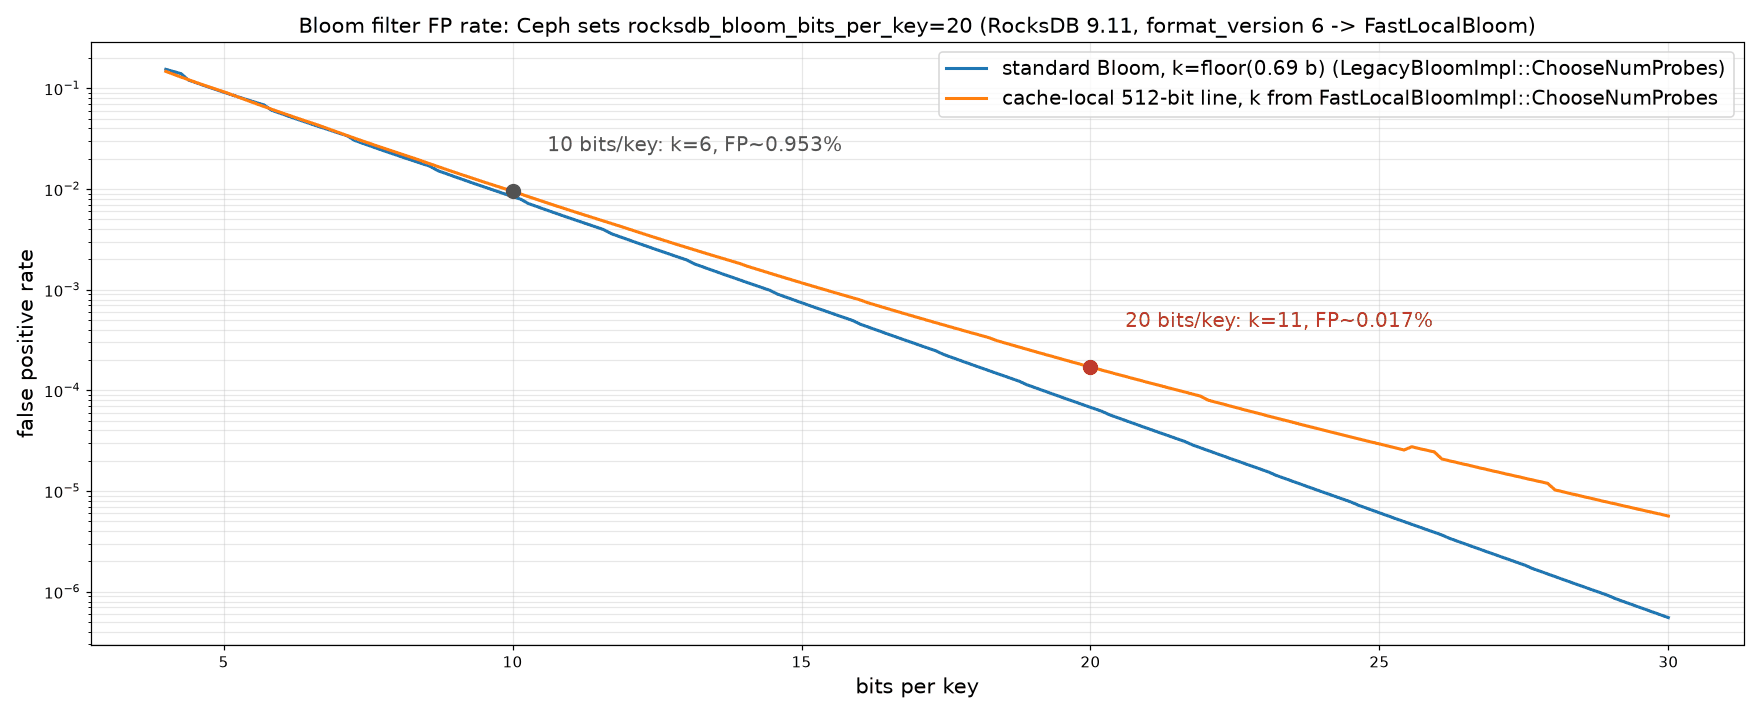
Ceph با rocksdb_bloom_bits_per_key = 20 تابع NewBloomFilterPolicy(20) را صدا میزند (RocksDBStore::load_rocksdb_options). در RocksDB 9.11 پیشفرض format_version = 6 است، پس پیادهسازی فیلتر FastLocalBloomImpl است: همهی probeهای یک کلید درون یک cache line پانصد و دوازده بیتی میافتند.
منبع در کد: rocksdb/util/bloom_impl.h :: FastLocalBloomImpl::ChooseNumProbes، AddHash، HashMayMatchPrepared؛ BloomMath::CacheLocalFpRate
پیچیدگی: O(k) بیتخوانی در یک cache line (با AVX2 تا ۸ probe همزمان)؛ حافظه b بیت برای هر کلید
pseudocode
k = ChooseNumProbes(1000·b) # جدول تجربی: 20000 میلیبیت ⇒ 11
AddHash(h1, h2): line = FastRange32(h1, len/64) · 64 # انتخاب cache line
h = h2
repeat k: bit = h ≫ 23 (۹ بیت بالا ⇒ 0..511) ; line[bit] = 1 ; h ×= 0x9e3779b9
MayMatch: همان مسیر ؛ اگر هر بیت صفر بود ⇒ «قطعاً نیست»
FP ≈ میانگین Bloom استاندارد برای (کلید در هر خط ± انحراف معیار)مثال عددی.
- b = ۲۰: k = ۱۱ و هر cache line بهطور میانگین ۵۱۲/۲۰ = ۲۵.۶ کلید دارد. انحراف معیار است، پس دو حالت شلوغ و خلوت ۳۰.۶۶ و ۲۰.۵۴ کلید در خط دارند. FP تخمینی حدود (۰.۰۱۷٪) است، در برابر برای Bloom استاندارد با همان حافظه.
- b = ۱۰: k = ۶ و FP حدود ۰.۹۵٪.
- حافظه: یک SST با ۱ میلیون کلید بیت، یعنی ۲.۵ MB فیلتر دارد.
بهای محلی بودن کمی FP بیشتر است. در عوض هر پرسوجو به جای ۱۱ cache miss فقط یک cache miss دارد.
۲۵-۱۱-۶ امتیاز compaction و اندازهی پویای سطوح#
منبع در کد: rocksdb/db/version_set.cc :: VersionStorageInfo::CalculateBaseBytes، ComputeCompactionScore، MaxInputLevel
پیچیدگی: O(تعداد فایلها) در هر تغییر Version
pseudocode
CalculateBaseBytes (dynamic):
max_level_size = بزرگترین سطح ؛ cur = max_level_size
for i = num_levels−2 down to first_non_empty: cur /= multiplier
base_level = first_non_empty
while base_level > 1 and cur > base_bytes_max: base_level−− ; cur /= multiplier
target[base_level] = max(cur, base_bytes_max) ; target[i+1] = target[i]·multiplier (کف base_bytes_max)
ComputeCompactionScore: for level in 0 .. num_levels−2:
L0: score = max(files/trigger, size/max_bytes_for_level_base …) و ×10 اگر > 1
L>0: score = bytes_not_compacting / target (یا / (target + ورودی در راه) ×10 اگر ≥ 1)
بیشترین امتیاز ⇒ نخستین compactionمثال عددی (پیشفرضهای Ceph: base = ۱ GiB، multiplier = ۸، هفت سطح). فرض کنید L6 دویست گیگابایت دارد. از بالا به پایین: L5 = ۲۵، L4 = ۳.۱۲۵ و L3 = ۰.۳۹ GiB. چون ۰.۳۹ از base_bytes_min = ۱/۸ GiB بزرگتر است، base_level = L3 و هدفها L3 = max(۰.۳۹, ۱) = ۱ GiB، L4 = ۳.۱۲۵، L5 = ۲۵ و L6 = ۲۰۰ هستند. با اندازههای واقعی ۰.۳۱، ۳.۰ و ۲۴ امتیازها ۰.۳۱، ۰.۹۶ و ۰.۹۶ میشوند. هیچکدام به ۱ نرسیده است. اگر L0 هشت فایل داشته باشد، امتیاز آن ۸/۸ = ۱ است و پس از ضرب در kScoreScale برابر ۱۰ میشود، پس L0→L3 اولویت دارد. L1 و L2 خالی میمانند: این همان رفتار dynamic level bytes است که داده را مستقیم به سطح پایه میبرد.
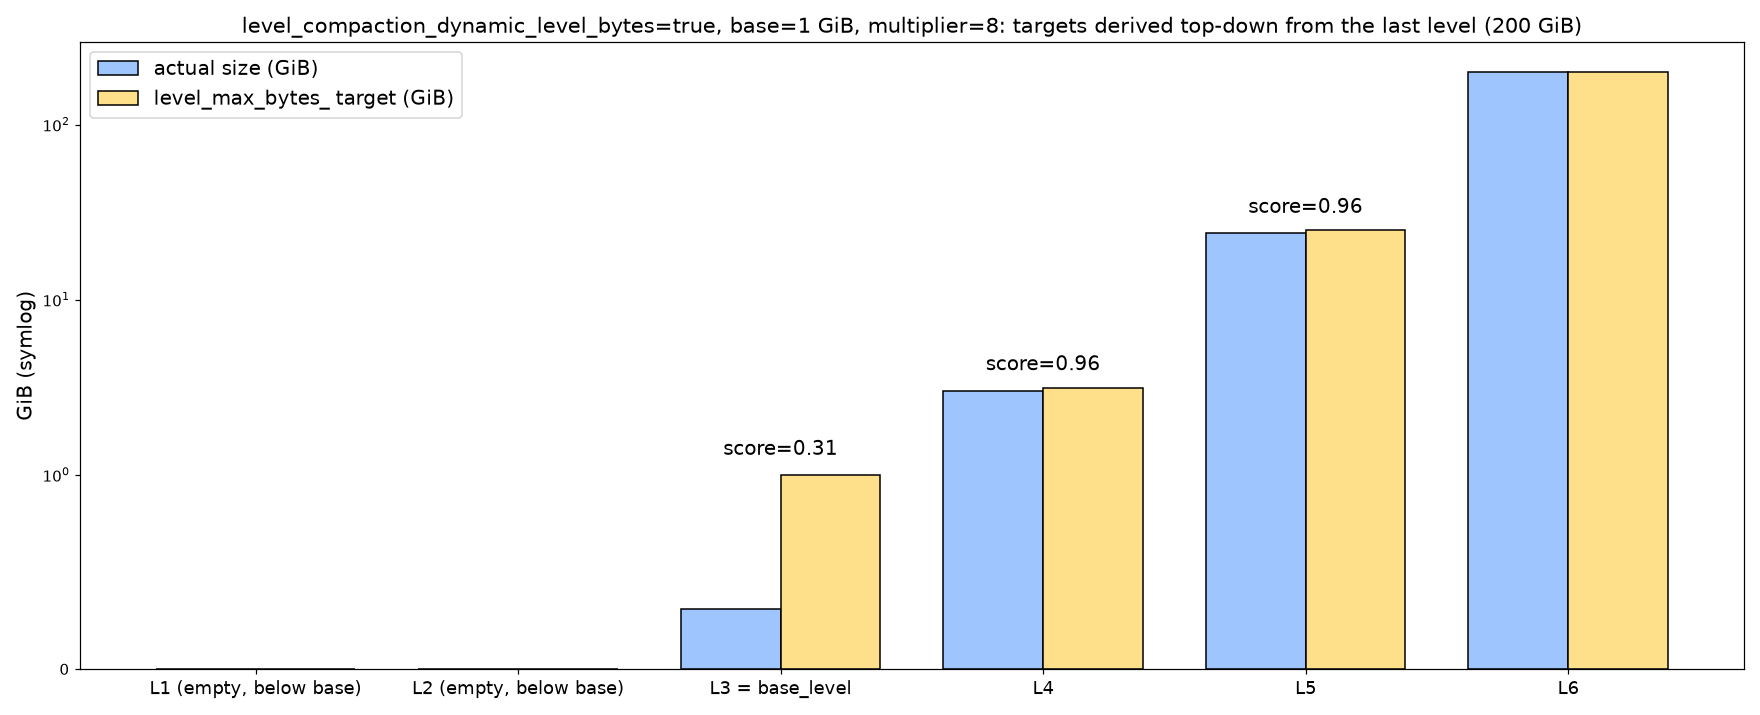
پیشفرض level_compaction_dynamic_level_bytes در RocksDB از نسخهی ۸.۴ به true تغییر کرد. رشتهی bluestore_rocksdb_options در Ceph این گزینه را صریحاً تنظیم نمیکند. پس رفتار سطوح به نسخهی RocksDB داخل هر انتشار Ceph بستگی دارد. برای اطمینان، خروجی ceph daemon osd.N config get bluestore_rocksdb_options و فایل OPTIONS-* درون BlueFS را (با ceph-bluestore-tool bluefs-export) بررسی کنید.
۲۵-۱۲ تکمیلی و بهروز#
- sharding از Pacific برای OSDهای تازه پیشفرض شده است. رشتهی پیشفرض main، یعنی
m(3) p(3,0-12) O(3,0-13)=block_cache={type=binned_lru} L=min_write_buffer_number_to_merge=32 P=min_write_buffer_number_to_merge=32، را با ceph config help bluestore_rocksdb_cfs روی نسخهی خود مقایسه کنید. -
bluefs_spillover_cleaner (در Tentacle و main موجود، پیشفرض false) یک thread پسزمینه است که فایلهای سرریزشده به دستگاه کند را، در صورت وجود فضا، به DB برمیگرداند. - طبق مستندات، Pacific پشتیبانی آزمایشی از
level_compaction_dynamic_level_bytes را آورد (همراه سیاست fit_to_fast).
۲۵-۱۳ تمرین عملی#
- ۱. با
ceph-bluestore-tool bluefs-export فایلهای RocksDB یک OSD آزمایشی را بیرون بکشید، با ldb --db=... list_column_families CFها را ببینید و با sst_dump --file=... --show_properties اندازهی data، index و filter را بخوانید. - ۲. ۸ بایت انتهای یک SST را با
tail -c 8 | xxd بخوانید و عدد جادویی را تأیید کنید (به ترتیب little-endian دقت کنید). - ۳. برای اندازهی DB خود (مثلاً ۶۰G) با پیشفرضها حساب کنید چه سطوحی جا میشوند. سپس
bluefs stats را بخوانید و با پیشبینی خود مقایسه کنید. - ۴.
submit_sync_latency را پیش و پس از انتقال WAL به NVMe مقایسه کنید.
۲۵-۱۴ پرسشهای مرور#
- ۱. group commit در
_kv_sync_thread چگونه تعداد fsyncها را کم میکند؟ - ۲. سرآیند رکورد WAL چند بایت است و چه فیلدهایی دارد؟
- ۳. چرا
min_write_buffer_number_to_merge=6 برای Ceph مهم است؟ - ۴. چرا برای CFهای
L و P این عدد ۳۲ است؟ - ۵. بلوک filter در SST چه نقشی در مسیر خواندن دارد؟
- ۶. با پیشفرضها اندازهی L3 چقدر است؟
- ۷.
use_some_extra چه تفاوتی با rocksdb_original دارد؟ - ۸. چگونه CF یک کلید omap per-pg انتخاب میشود؟
- ۹. چرا omap یک PG باید در یک shard بماند؟
- ۱۰. چرا تغییر کل رشتهی
bluestore_rocksdb_options خطرناک است و جایگزین آن چیست؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۵-۱۵ منابع این فصل#
- RocksDBStore
https://github.com/ceph/ceph/blob/main/src/kv/RocksDBStore.cc - پیکربندی BlueStore و sharding
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - قالب WAL مربوط به RocksDB
https://github.com/facebook/rocksdb/wiki/Write-Ahead-Log-File-Format - قالب block-based table
https://github.com/facebook/rocksdb/wiki/Rocksdb-BlockBasedTable-Format - compaction سطحی
https://github.com/facebook/rocksdb/wiki/Leveled-Compaction - column familyها
https://github.com/facebook/rocksdb/wiki/Column-Families - log_format.h
https://github.com/facebook/rocksdb/blob/main/db/log_format.h - LSM-tree (O'Neil و همکاران، ۱۹۹۶
https://www.cs.umb.edu/~poneil/lsmtree.pdf