لایههای پایینی (۹): SPDK و NVMe، از صفهای سختافزاری تا درگاه NVMe-oF
حوصله ندارم این فصل در چند خط
- NVMe با جفتصفهای submission و completion در حافظهی میزبان با آن حرف میزند؛ فصل فرمانها و completionها را بایتبهبایت میخواند.
- SPDK درایور NVMe را با polling در فضای کاربر اجرا میکند و
NVMEDevice در BlueStore وقتی مسیر دستگاه با spdk: شروع شود از آن استفاده میکند. - gateway از نوع NVMe-oF، imageهای RBD را روی NVMe/TCP صادر میکند؛ gatewayهای یک گروه برای failover وضعیت ANA را با هم شریکاند.
- اگر I/O میزبان پس از خرابی یک gateway متوقف ماند،
ceph nvme-gw show و blocklist در OSDها را بررسی کنید.
۳۱-۱ چرا این فصل؟#
در فصلهای قبل، پایینترین لایهای که دیدیم KernelDevice در BlueStore بود که با libaio یا io_uring درخواست را به هسته میدهد. این فصل یک لایه پایینتر میرود: خود صفهای سختافزاری NVMe، بایتهای یک فرمان و یک تکمیل، doorbellها و Phase Tag. سپس دو جایی را بررسی میکنیم که Ceph با SPDK (Storage Performance Development Kit) هسته را دور میزند:
- NVMEDevice در BlueStore (
src/blk/spdk/NVMEDevice.cc): درایور فضای کاربری برای دستگاه محلی یا هدف NVMe-oF. - درگاه NVMe-oF (پروژهی ceph-nvmeof): هدف NVMe/TCP مبتنی بر SPDK که تصاویر RBD را به میزبانها صادر میکند. بخش مدیریت آن در mon با
NVMeofGwMon و NVMeofGwMap پیاده شده است.
وضعیت. گزینههای bluestore_spdk_* در کد سطح dev دارند. پشتیبانی SPDK در BlueStore هنوز ابزاری برای آزمایش و پژوهش است و در استقرار cephadm مسیر معمول نیست. اما درگاه NVMe-oF با ceph orch apply nvmeof مستند و پشتیبانی میشود. همهی ارجاعهای کد این فصل به شاخهی main در زمان نگارش است.
۳۱-۲ NVMe از نگاه درایور#
۳۱-۲-۱ دو مسیر داده#
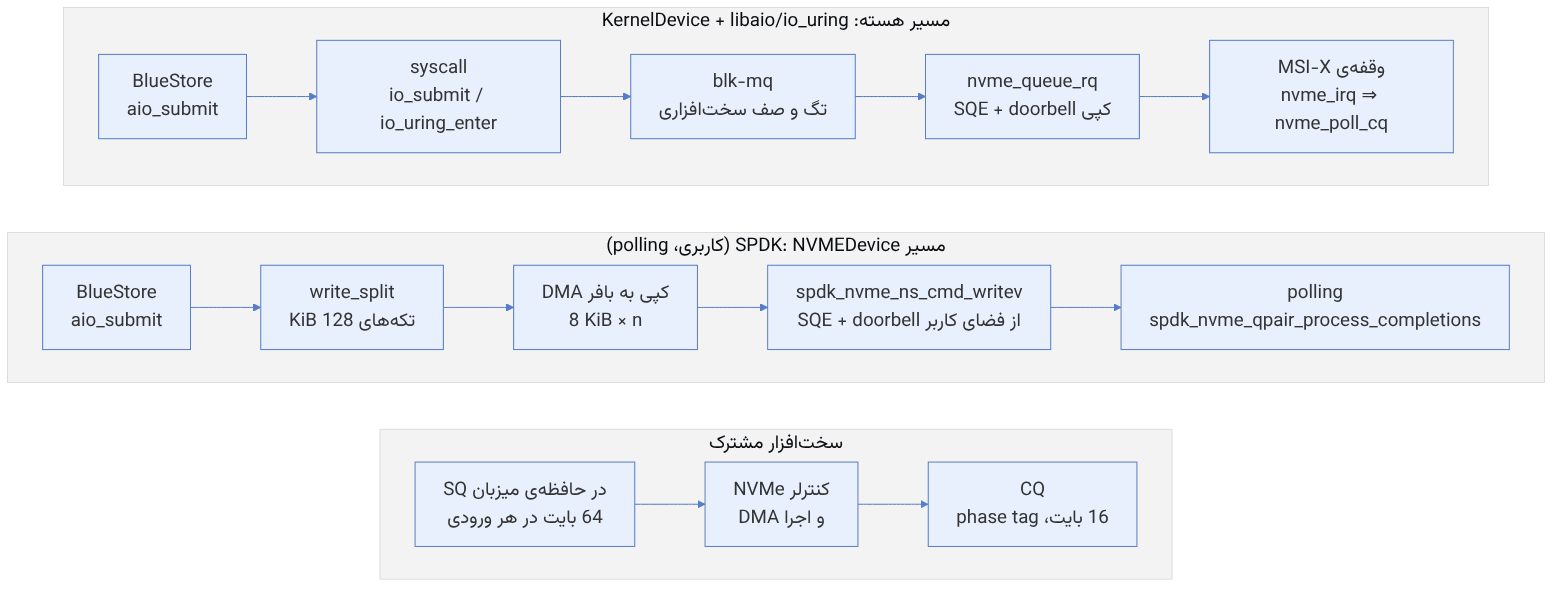
کنترلر NVMe با میزبان از راه جفت صف (queue pair) گفتوگو میکند: یک Submission Queue (SQ) که میزبان فرمانها را در آن مینویسد و یک Completion Queue (CQ) که کنترلر نتیجهها را در آن میگذارد. هر دو، آرایههای حلقوی در حافظهی میزباناند. درایور هستهی لینوکس معمولاً برای هر CPU یک جفت صف میسازد. به همین دلیل، دو هستهی CPU برای ارسال فرمان روی یک صف رقابت نمیکنند.
۳۱-۲-۲ بایتهای یک فرمان#
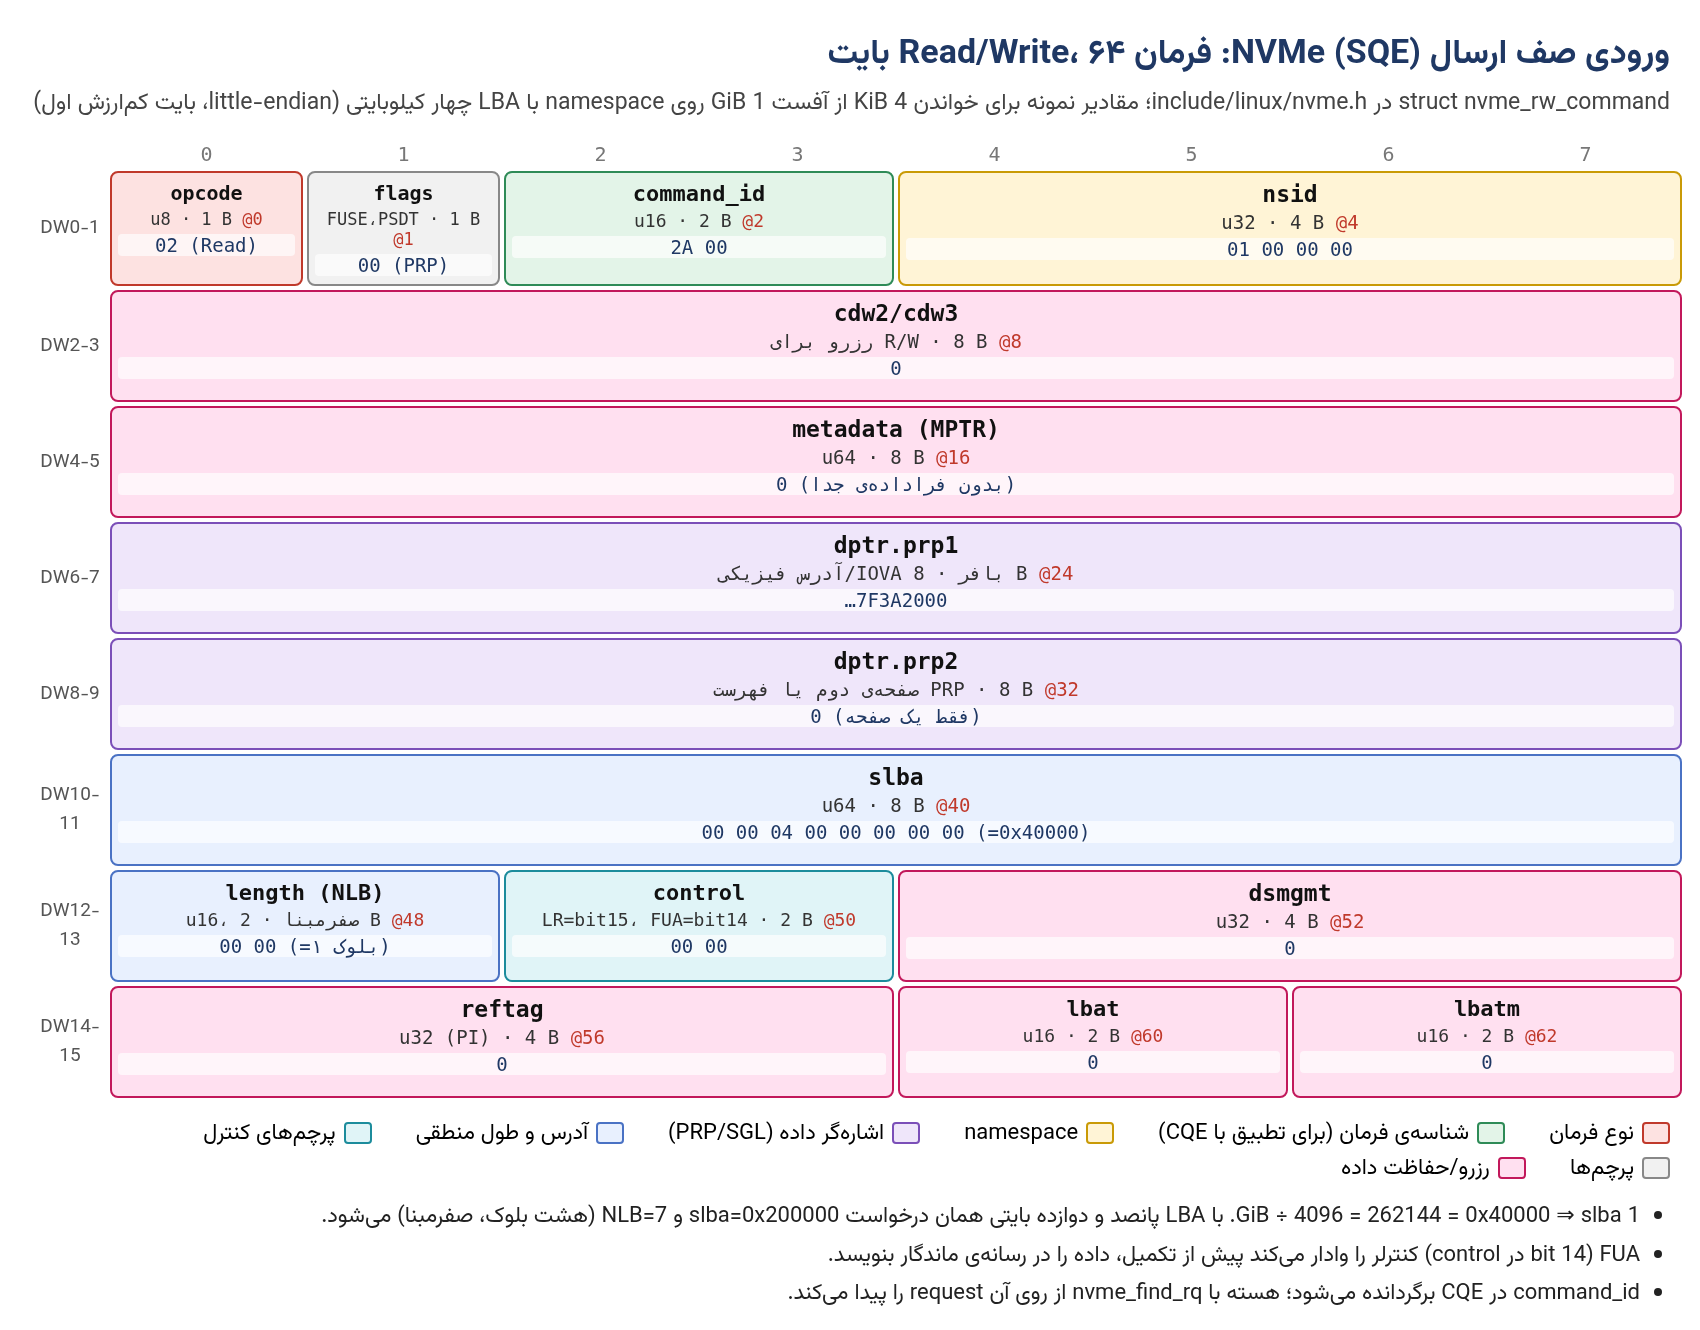
دو نکتهی سطح پایین در این ساختار مهم است:
- ۱. طول صفرمبنا. مقدار ۰ در
length یعنی یک بلوک. خطای off-by-one در درایورهای آزمایشی رایج است. - ۲. PRP و صفحهها. PRP1 به اولین صفحه اشاره میکند (میتواند آفست درون صفحه داشته باشد). اگر داده بیش از دو صفحه باشد، PRP2 به فهرست PRP اشاره میکند. هر ورودی ۸ بایت است، پس یک صفحهی ۴ KiB فهرستی از ۵۱۲ صفحه را نگه میدارد. برای یک I/O هشت کیلوبایتی همتراز، PRP1 صفحهی اول و PRP2 صفحهی دوم است و فهرستی لازم نیست. برای ۱۲۸ KiB (۳۲ صفحه)، PRP2 به فهرستی با ۳۱ ورودی اشاره میکند.
۳۱-۲-۳ بایتهای یک تکمیل#
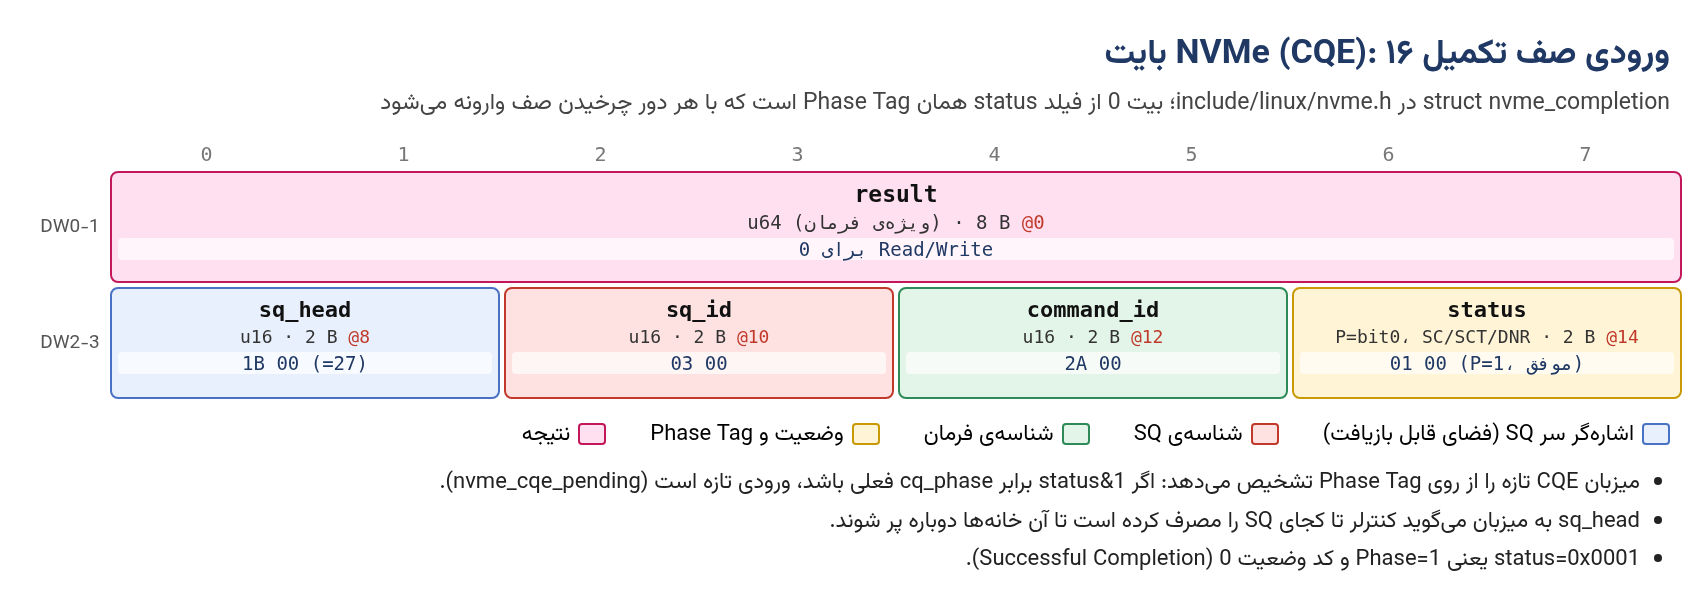
منبع در کد: linux: drivers/nvme/host/pci.c :: nvme_poll_cq، nvme_cqe_pending، nvme_update_cq_head
پیچیدگی: O(k) برای k تکمیل تازه؛ یک نوشتن MMIO در پایان
pseudocode (برگرفته از منطق nvme_poll_cq، بازنویسیشده)
found = false
while (cqes[cq_head].status & 1) == cq_phase: # ورودی تازه؟
found = true
dma_rmb() # بقیهی CQE را پس از phase بخوان
handle(cqes[cq_head]) # command_id ⇒ request ⇒ تکمیل
cq_head += 1
if cq_head == q_depth: cq_head = 0; cq_phase ^= 1
if found: writel(cq_head, CQ_HEAD_DOORBELL) # یک بار برای کل دستهچرا Phase Tag؟ CQ پیش از شروع با صفر پر شده است و cq_phase میزبان از ۱ شروع میشود. کنترلر در دور اول CQEها را با P=1 مینویسد، پس هر خانهای که P آن ۱ است تازه است. وقتی صف یک دور کامل میچرخد، خانههای قدیمی P=1 دارند و کنترلر این بار P=0 مینویسد. میزبان هم با وارونه کردن cq_phase معیار «تازه» را عوض میکند. بنابراین میزبان بدون خواندن هیچ ثبات (register) از دستگاه و فقط با خواندن حافظهی خودش میفهمد چه چیزی رسیده است. همین ویژگی است که polling را ارزان میکند: پیمایش خالی فقط یک خواندن از cache است.
مثال عددی. q_depth=4، cq_head=2، cq_phase=1. کنترلر سه فرمان را کامل میکند و در خانههای ۲ و ۳ با P=1 و در خانهی ۰ با P=0 (دور تازه) مینویسد. میزبان خانهی ۲ (P=1، تازه)، خانهی ۳ (تازه) را پردازش میکند و به انتهای صف میرسد: cq_head=0 و cq_phase=0. خانهی ۰ با P=0 تازه است و پردازش میشود. خانهی ۱ هنوز P=1 قدیمی دارد، پس حلقه میایستد و یک doorbell با مقدار ۱ نوشته میشود. سه تکمیل با یک نوشتن MMIO گزارش شدند.
۳۱-۲-۴ doorbellها و هزینهی MMIO#
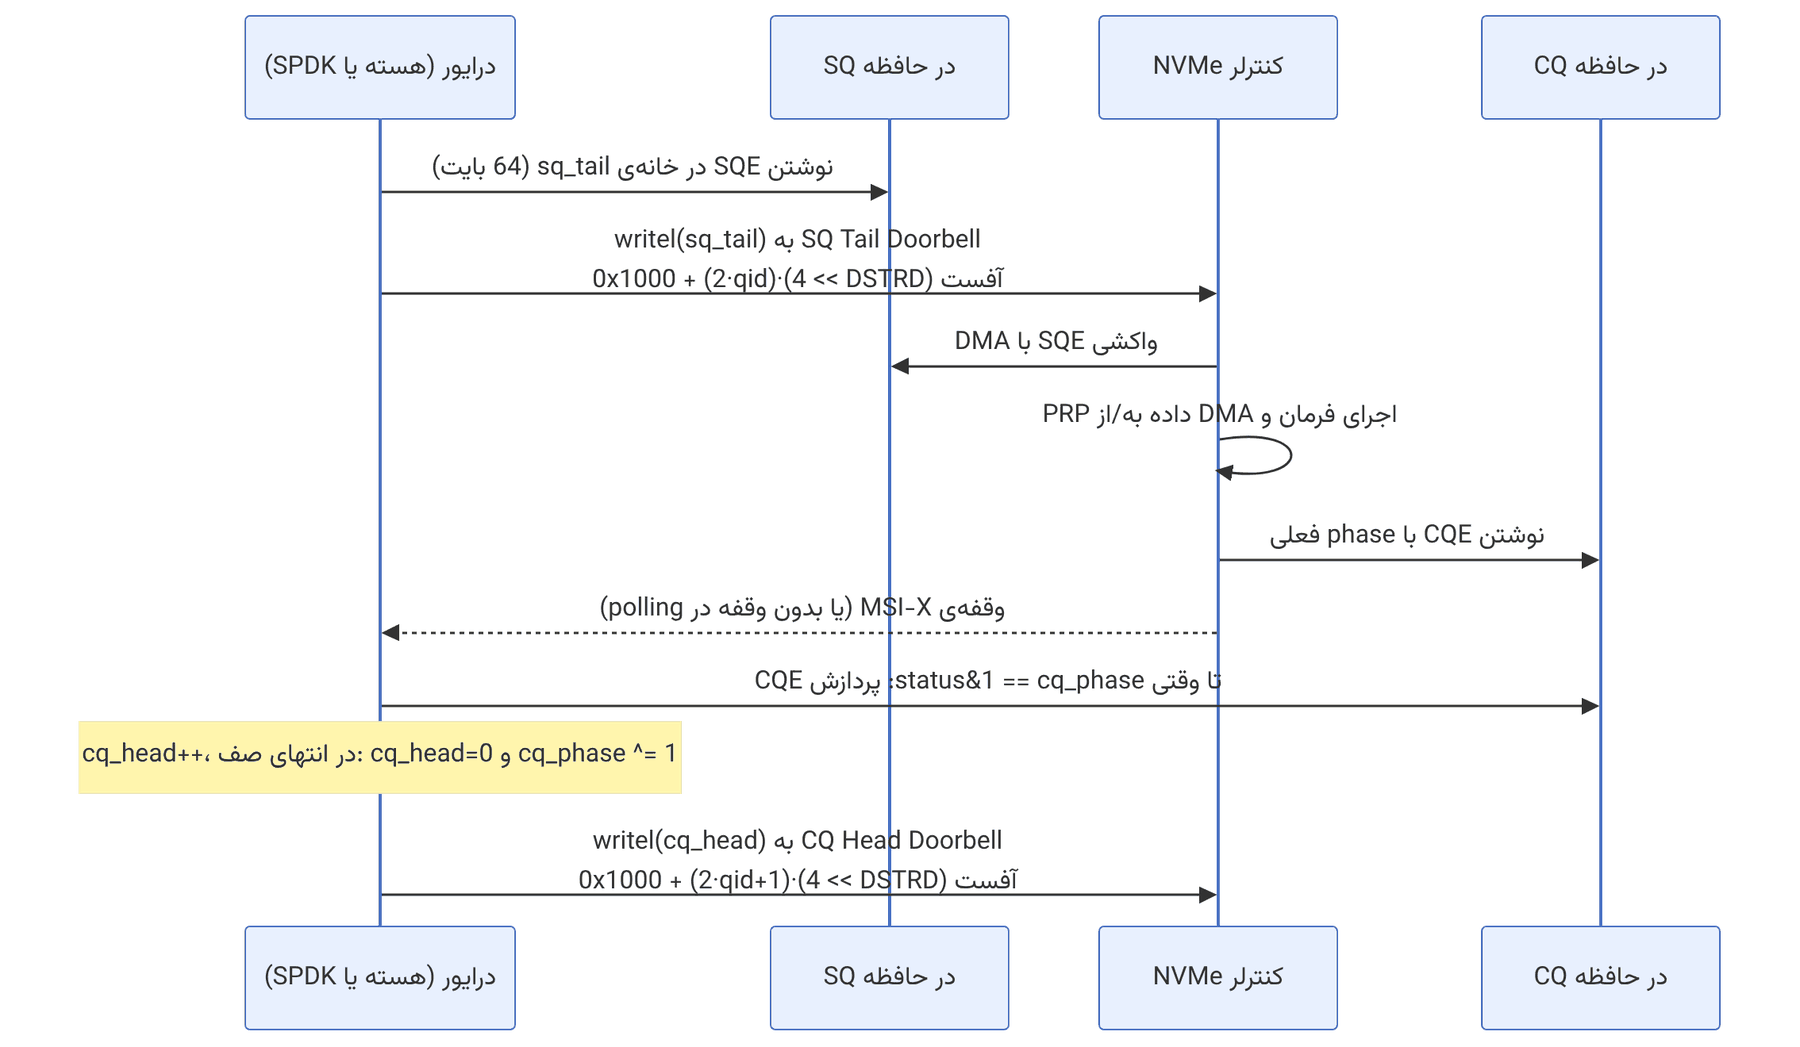
آفست doorbellها در فضای ثبات کنترلر (BAR0) از فرمول استاندارد NVMe به دست میآید: SQyTDBL = 0x1000 + (2y) × (4 << CAP.DSTRD) و CQyHDBL = 0x1000 + (2y+1) × (4 << CAP.DSTRD). برای صف ۳ با DSTRD=0، doorbell مربوط به SQ در ۰x1018 و doorbell مربوط به CQ در ۰x101C است. هر doorbell یک نوشتن MMIO غیرقابلcache است که از PCIe عبور میکند. به همین دلیل، هسته در nvme_write_sq_db نوشتن doorbell را تا آخرین درخواست یک دسته به تعویق میاندازد (پارامتر write_sq و last_sq_tail) و nvme_commit_rqs در پایان دسته آن را مینویسد. ویژگی Doorbell Buffer Config (در هسته nvme_dbbuf_update_and_check_event) در کنترلرهای مجازی حتی همین نوشتن را حذف میکند، اگر دستگاه اعلام کند که لازم نیست.
قفلها در مسیر هسته. nvme_sq_copy_cmd و nvme_write_sq_db با __must_hold(&nvmeq->sq_lock) علامت خوردهاند: کپی ۶۴ بایت و جلو بردن sq_tail زیر یک spinlock مخصوص همان صف انجام میشود. چون معمولاً هر CPU صف خودش را دارد، این قفل تقریباً هیچوقت رقابتی نیست. مسیر تکمیل هم در زمینهی وقفهی همان صف اجرا میشود و قفلی روی CQ نمیگیرد.
۳۱-۳ NVMEDevice: SPDK در BlueStore، تابع به تابع#
۳۱-۳-۱ پیکربندی و باز کردن#
BlueStore وقتی نام فایل دستگاه با spdk: شروع شود (SPDK_PREFIX در BlockDevice.h)، بهجای KernelDevice از NVMEDevice استفاده میکند. مستند BlueStore دو شکل را نشان میدهد:
bluestore_block_path = "spdk:trtype:PCIe traddr:0000:01:00.0"
bluestore_block_path = "spdk:trtype:TCP adrfam:IPv4 traddr:10.0.0.7 trsvcid:4420 subnqn:nqn.2019-02.io.spdk:cnode1"
# برای اینکه DB و WAL هم از SPDK بروند (هممکانی):
bluestore_block_db_path = ""
bluestore_block_wal_path = ""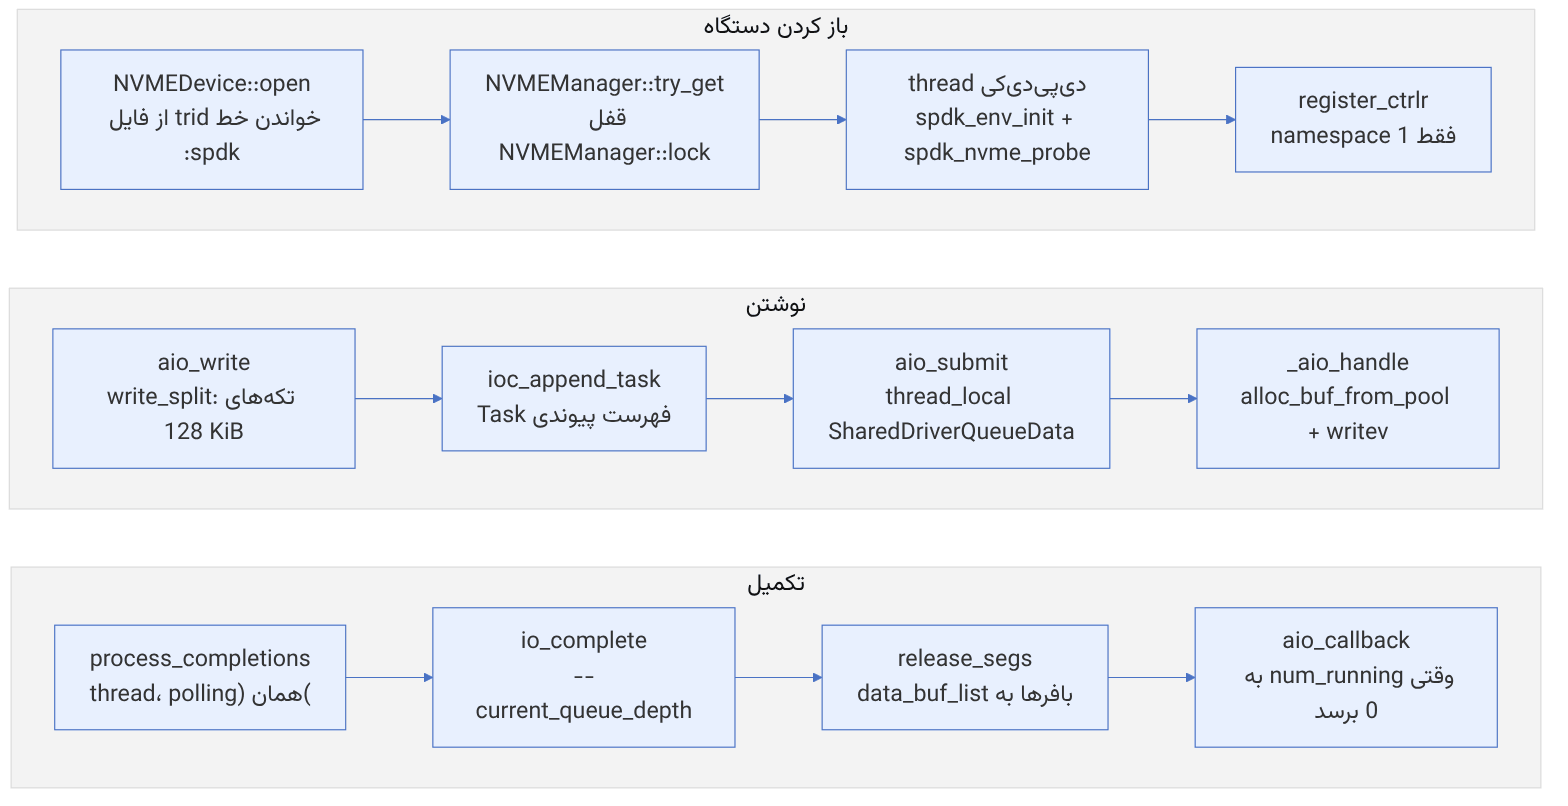
| تابع | کار | thread و قفل |
|---|---|---|
| NVMEDevice::open | خواندن خط trid، spdk_nvme_transport_id_parse، manager.try_get | thread بازکننده؛ قفل NVMEManager::lock |
| NVMEManager::try_get | اولین بار: ساخت dpdk_thread با spdk_env_init (coremask، mem_size)، صف probe | probe_queue_lock و probe_queue_cond |
| probe_cb / attach_cb | تطبیق trid، register_ctrlr | thread مربوط به DPDK |
| register_ctrlr | فقط namespace شمارهی ۱؛ «فعلاً فقط یک دستگاه برای هر OSD» (ceph_assert) | زیر NVMEManager::lock |
| SharedDriverData | برای transport غیر PCIe یک admin_thread که هر ۱ ثانیه admin completionها را پردازش میکند (keep-alive) | thread جدا |
| aio_write ⇒ write_split | تکههای ۱۳۱۰۷۲ بایتی، bl.splice به Task | thread فراخواننده |
| aio_submit | num_pending ⇒ num_running؛ thread_local SharedDriverQueueData | بدون قفل: qpair مخصوص همان thread |
| _aio_handle | ارسال Taskها و polling تا num_running صفر شود | همان thread، busy-poll |
| io_complete | کاهش عمق صف، release_segs، aio_callback | همان thread (داخل process_completions) |
۳۱-۳-۲ مخزن بافر DMA و تقسیم درخواست#
SPDK نمیتواند مستقیماً از حافظهی معمولی bufferlist استفاده کند. کنترلر با DMA به حافظهای نیاز دارد که pinned باشد و آدرس فیزیکی یا IOVA آن معلوم باشد (hugepageهای DPDK). بنابراین SharedDriverQueueData در سازندهاش ۱۰۲۴ بافر ۸ کیلوبایتی با spdk_dma_zmalloc میسازد (data_buffer_default_num و data_buffer_size). دادهی هر نوشتن در این بافرها کپی میشود. توضیح کد (TODO) خود میگوید اگر لایهی بالا حافظه با آدرس فیزیکی معلوم بدهد، این کپی حذفشدنی است.
منبع در کد: src/blk/spdk/NVMEDevice.cc :: write_split، make_read_tasks، SharedDriverQueueData::alloc_buf_from_pool
پیچیدگی: O(len/۸K) برای کپی و تخصیص؛ فضای ثابت ۸ MiB برای هر thread
pseudocode
write_split(off, bl):
while remaining > 0:
n = min(remaining, 128 KiB)
task = Task(WRITE, off+begin, n); bl.splice(0, n, task.bl); append(ioc, task)
alloc_buf_from_pool(task):
count = ceil(task.len / 8 KiB)
if count > free_buffers: return -ENOMEM # _aio_handle دوباره poll میکند (goto again)
segs = count ≤ 32 ? task.inline_segs : new void*[count]
pop count buffers; copy task.bl into them (write)
submit: spdk_nvme_ns_cmd_writev(ns, qpair, off/bs, len/bs, io_complete, task,
reset_sgl=data_buf_reset_sgl, next_sge=data_buf_next_sge)مثال عددی. نوشتن ۳۰۰ KiB (۳۰۷۲۰۰ بایت) با بلوک ۴۰۹۶ بایتی:
| Task | آفست نسبی | طول | lba_count | بافرهای ۸ KiB |
|---|---|---|---|---|
| ۱ | ۰ | ۱۳۱۰۷۲ | ۳۲ | ۱۶ |
| ۲ | ۱۳۱۰۷۲ | ۱۳۱۰۷۲ | ۳۲ | ۱۶ |
| ۳ | ۲۶۲۱۴۴ | ۴۵۰۵۶ | ۱۱ | ۶ (پنج کامل + یکی با ۴۰۹۶ بایت) |
در مجموع ۳ فرمان NVMe و ۳۸ بافر از ۱۰۲۴ بافر. چون هر Task حداکثر ۱۲۸ KiB است، شمار بافرها هیچوقت از ۱۶ بیشتر نمیشود و همیشه در ۳۲ خانهی inline_segs جا میگیرد. شاخهی extra_segs عملاً برای این اندازهی تقسیم استفاده نمیشود. SPDK فهرست scatter-gather را با دو callback از Task میگیرد: data_buf_next_sge بافر بعدی را با طول ۸۱۹۲ (یا باقیماندهی آخر، اینجا ۴۰۹۶) برمیگرداند و data_buf_reset_sgl برای بازپخش از یک آفست است. مخزن ۱۰۲۴ بافری یعنی حداکثر ۸ MiB دادهی در پرواز برای هر thread. یک batch بزرگتر از این، با -ENOMEM به حلقهی polling برمیگردد تا بافرها آزاد شوند.
۳۱-۳-۳ polling همزمان در thread فراخواننده#
مهمترین نکتهی رفتاری این درایور در _aio_handle است: حلقهی بیرونی while (ioc->num_running) تا وقتی همهی I/Oهای این IOContext کامل نشدهاند ادامه دارد. پس aio_submit در NVMEDevice برخلاف KernelDevice فقط ارسال نمیکند، بلکه thread را تا تکمیل نگه میدارد. اگر process_completions چیزی پیدا نکند، thread به اندازهی bluestore_spdk_io_sleep (پیشفرض ۵ میکروثانیه) با usleep میخوابد. bluestore_spdk_max_io_completion (پیشفرض ۰ یعنی تصمیم با SPDK) تعداد تکمیلهای هر بار poll را محدود میکند.
پیامد برای BlueStore. در KernelDevice، thread مربوط به aio جداگانه تکمیلها را جمع میکند و kv_sync_thread یا thread مربوط به op فقط ارسال میکند. در NVMEDevice، هر threadی که aio_submit را صدا میزند تا پایان I/O خودش منتظر میماند. با thread_local، هر thread یک qpair مخصوص دارد که رقابت را حذف میکند، اما هر thread تازهای که I/O میفرستد ۱۰۲۴ بافر DMA (۸ MiB) و یک qpair مصرف میکند. مجموع قابلمحاسبه است: اگر ۱۶ thread مختلف (shardهای op، kv_sync، BlueFS) I/O بفرستند، ۱۲۸ MiB از حافظهی DPDK، که با bluestore_spdk_mem=512 (MB) محدود است، فقط به این بافرها میرسد.
استدلال تأخیر. خواندن تصادفی ۴ KiB روی یک SSD نمونه با تأخیر داخلی ۸۰ میکروثانیه را در نظر بگیرید. در مسیر هسته، فرض کنید ۲ تا ۵ میکروثانیه هزینهی syscall، blk-mq، وقفه و بیدار کردن thread اضافه میشود. در SPDK بخش بزرگی از این حذف میشود، اما ۰ تا ۵ میکروثانیه usleep در هنگام بیکاری و کپی به بافر DMA اضافه میشود (برای ۴ KiB ناچیز، برای ۱۲۸ KiB چند میکروثانیه). سود SPDK بیشتر در CPU بهازای هر I/O است تا تأخیر. وقتی تأخیر دستگاه در حد دهها میکروثانیه است، چند میکروثانیهی نرمافزار در لایهی BlueStore در برابر هزینهی OSD (فصلهای ۲۲ و ۳۰) کوچک است.
منبع در کد: نتیجهی صفنگاری؛ در کد: max_queue_depth = io_queue_size − 1 در SharedDriverQueueData
پیچیدگی: O(۱)
QD_needed = target_IOPS × latencyبرای ۵۰۰K IOPS با تأخیر ۸۰ میکروثانیه: QD = 500000 × 0.00008 = 40 درخواست همزمان. اگر فقط یک thread با یک IOContext که همه را در یک دسته میفرستد I/O بدهد و منتظر تکمیل همه بماند، QD مؤثر به اندازهی همان دسته است. برای رسیدن به ۴۰، یا دستهها باید بزرگ باشند، یا چند thread همزمان کار کنند. همین محاسبه نشان میدهد چرا اجرای چند OSD روی یک NVMe سریع، یا shardهای بیشتر، گاهی بیش از تغییر درایور اثر دارد.
۳۱-۴ درگاه NVMe-oF#
۳۱-۴-۱ معماری#
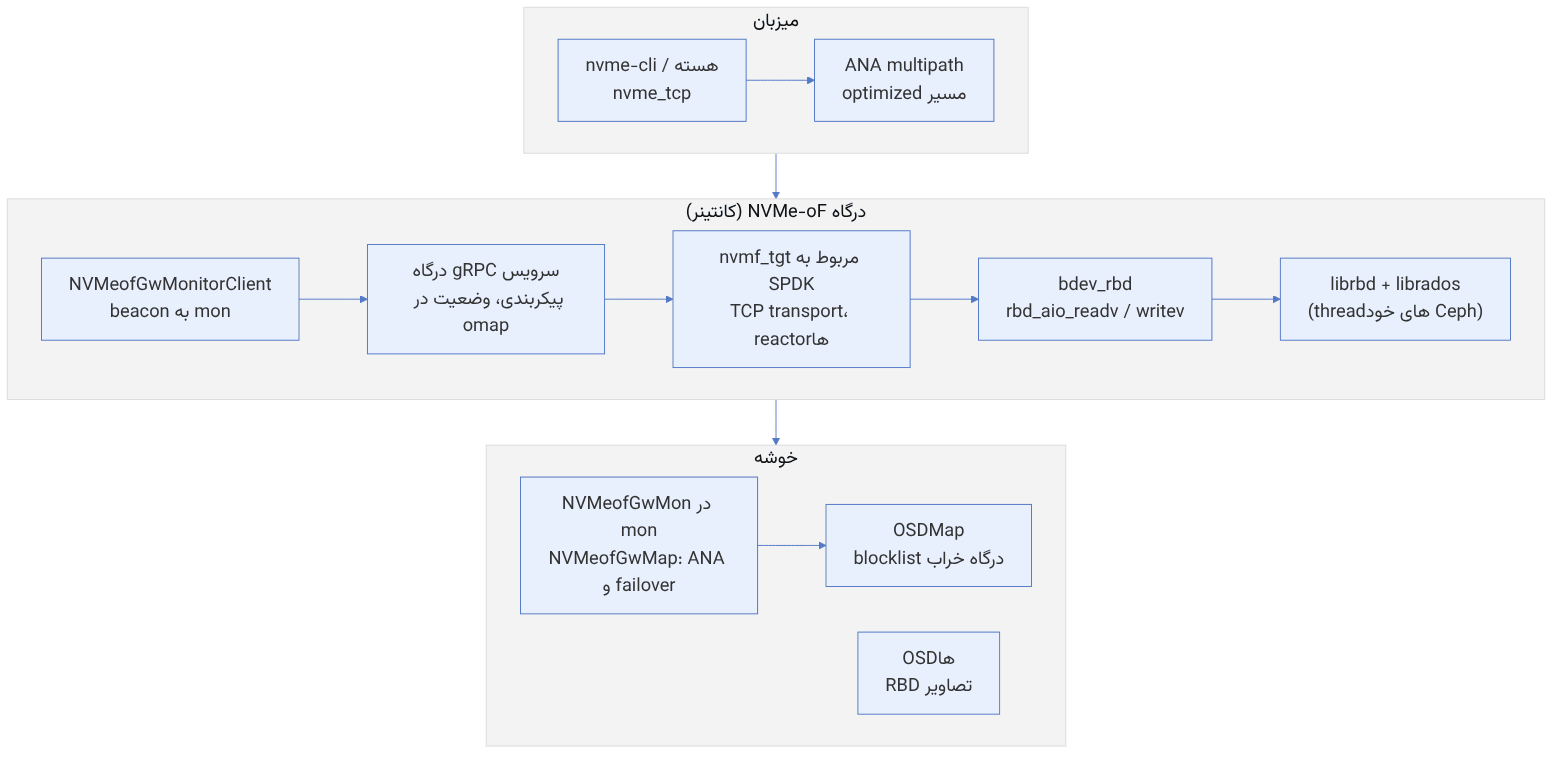
مستند Ceph درگاه را یک هدف NVMe/TCP توصیف میکند که تصاویر RBD را صادر میکند. هر درگاه همچنین یک Discovery Controller اجرا میکند. اعدادی که مستند main برای مقیاس اعلام میکند: تا ۴ گروه درگاه، ۸ درگاه در هر گروه، ۱۲۸ subsystem در هر گروه، ۳۲ میزبان در هر subsystem و ۱۰۲۴ namespace در هر گروه. حداقل منابع پیشنهادی ۸ GB حافظه و چهار thread پردازنده برای هر نمونهی درگاه است.
وابسته به نسخه. این سقفها از مستند main گرفته شدهاند. پیکربندی نمونهی شاخهی devel پروژهی ceph-nvmeof گزینههایی مثل max_subsystems = 128، max_namespaces = 4096 و max_gws_in_grp = 16 را نشان میدهد. پیش از برنامهریزی ظرفیت، مستند همان نسخهای را که نصب میکنید ببینید.
۳۱-۴-۲ مسیر یک نوشتن از میزبان تا OSD#
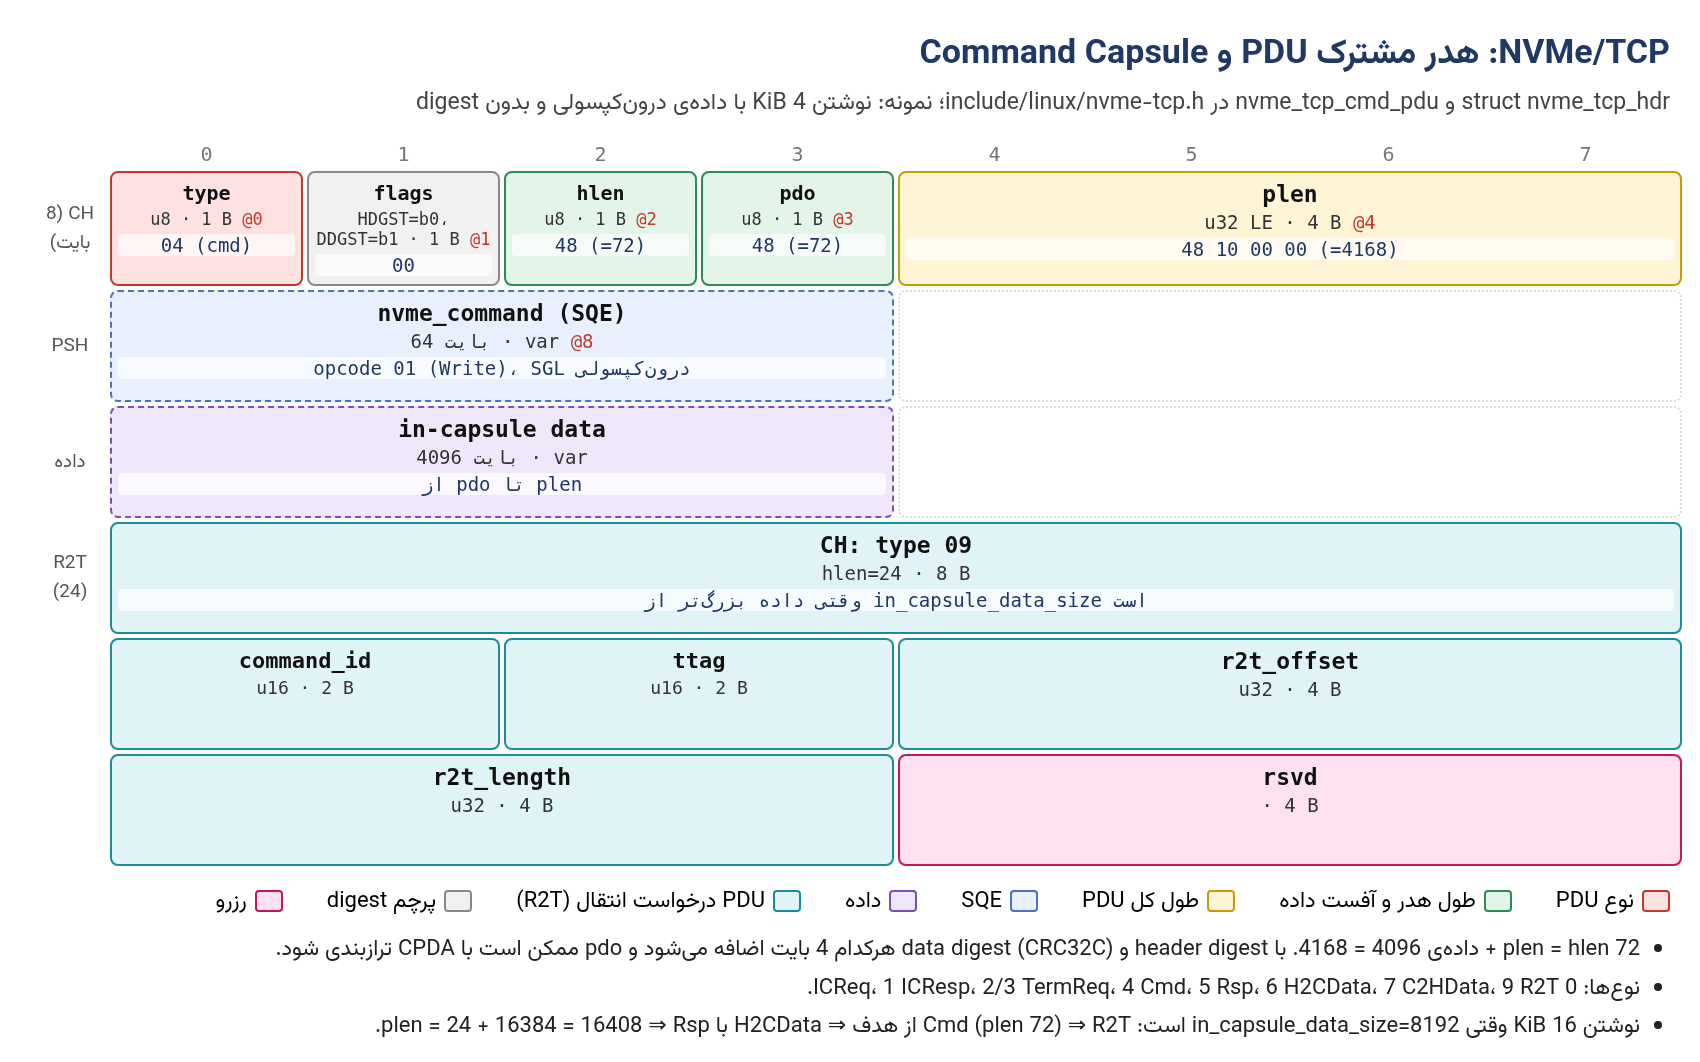
- ۱. میزبان (
nvme_tcp در هسته) یک Command Capsule با opcode Write میفرستد. پیکربندی نمونهی درگاه in_capsule_data_size را ۸۱۹۲ گذاشته است، پس نوشتن ۴ KiB در یک PDU با plen=4168 جا میگیرد. - ۲. reactor مربوط به SPDK روی socket آن qpair poll میکند، PDU را تجزیه و فرمان را به bdev میدهد.
- ۳.
bdev_rbd با rbd_aio_create_completion و rbd_aio_writev درخواست را به librbd میدهد. از اینجا مسیر همان مسیر librbd است (فصلهای ۲ و ۲۲): ObjectRequest، Objecter و MOSDOp. - ۴. callback مربوط به librbd در threadهای خود librbd اجرا میشود، نه در reactor مربوط به SPDK.
bdev_rbd_io_complete با spdk_thread_send_msg تکمیل را به thread ارسالکننده (submit_td) برمیگرداند تا مدل تکthreadی SPDK حفظ شود. - ۵. reactor یک Response Capsule برمیگرداند.
بودجهی تأخیر (نمونهی فرضی، ۴ KiB، شبکهی ۲۵ گیگابیتی). رفت و برگشت میزبان تا درگاه حدود ۲۰ تا ۴۰ میکروثانیه، پردازش SPDK چند میکروثانیه، دو گذر از مرز thread (librbd به reactor و برعکس) چند میکروثانیه، و مسیر librbd تا OSD و replicaها (که در خوشههای NVMe معمولاً ۰٫۵ تا ۲ میلیثانیه است). بنابراین درگاه NVMe-oF معمولاً یک رفت و برگشت شبکهی اضافه به مسیر krbd یا librbd مستقیم میافزاید. سود آن سازگاری با میزبانهای بدون کلاینت Ceph (مثلاً VMware) و multipath استاندارد است، نه کاهش تأخیر.
۳۱-۴-۳ ANA و failover در mon#
NVMe-oF برای HA از ANA (Asymmetric Namespace Access) استفاده میکند. هر namespace به یک گروه ANA (گروه توازن بار) تعلق دارد. در هر لحظه فقط یک درگاه برای آن گروه «optimized» است و بقیه «inaccessible» گزارش میشوند. multipath میزبان I/O را فقط به مسیر optimized میفرستد. شمار گروههای توازن بار برابر شمار درگاههای گروه است.
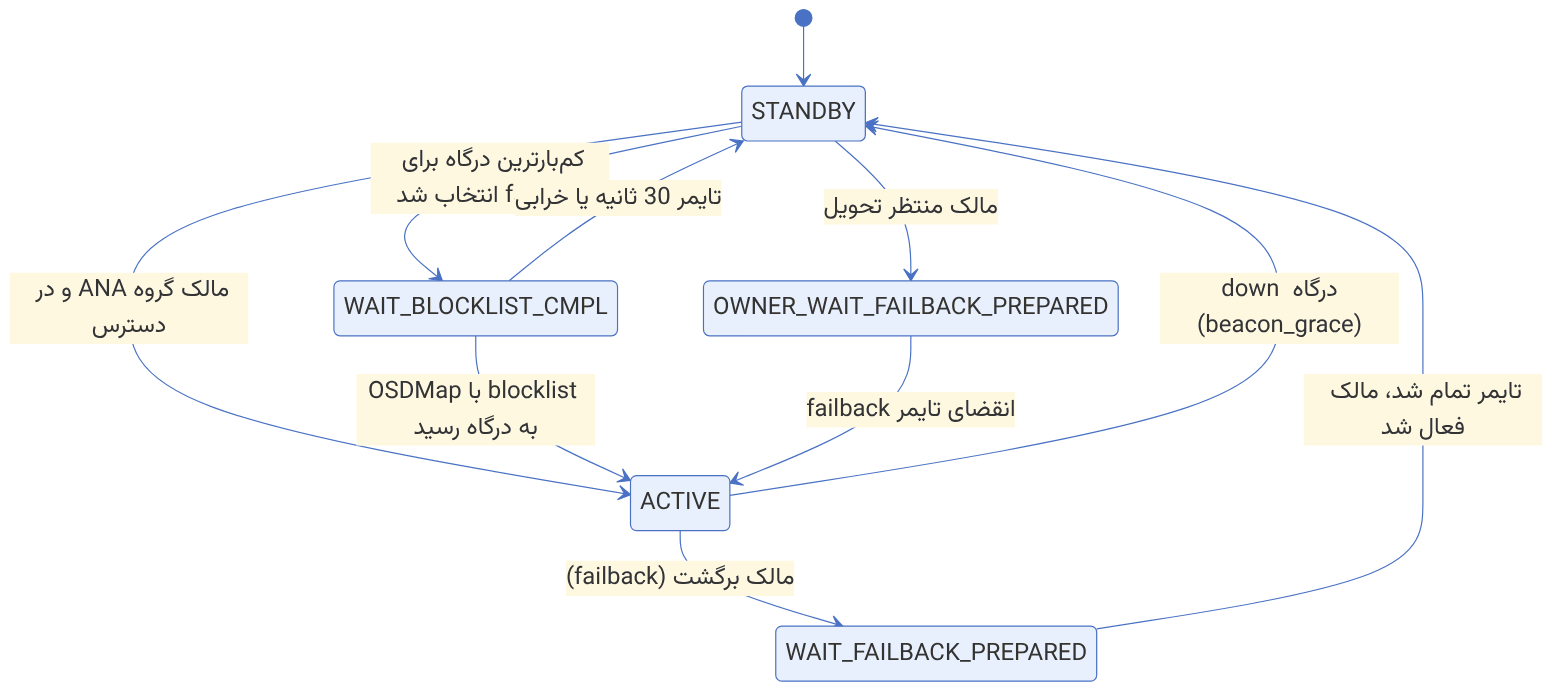
چرا WAIT_BLOCKLIST_CMPL؟ پیش از اینکه درگاه B گروه درگاه خراب A را بپذیرد، باید مطمئن شد A (اگر فقط از mon جدا شده و هنوز زنده است) دیگر نمیتواند روی تصاویر RBD بنویسد. وگرنه دو درگاه همزمان روی یک namespace مینویسند. set_failover_gw_for_ANA_group نشانیهای A را با blocklist_gw در OSDMap blocklist میکند و epoch آن را در blocklist_data[grp].osd_epoch نگه میدارد. B فقط وقتی ACTIVE میشود که beacon آن نشان دهد OSDMap با epoch مساوی یا بزرگتر را دیده است (fsm_handle_gw_alive). این همان الگوی fencing با blocklist است که در exclusive lock مربوط به RBD و rbd-mirror (فصلهای ۲ و ۱۸) دیدیم.
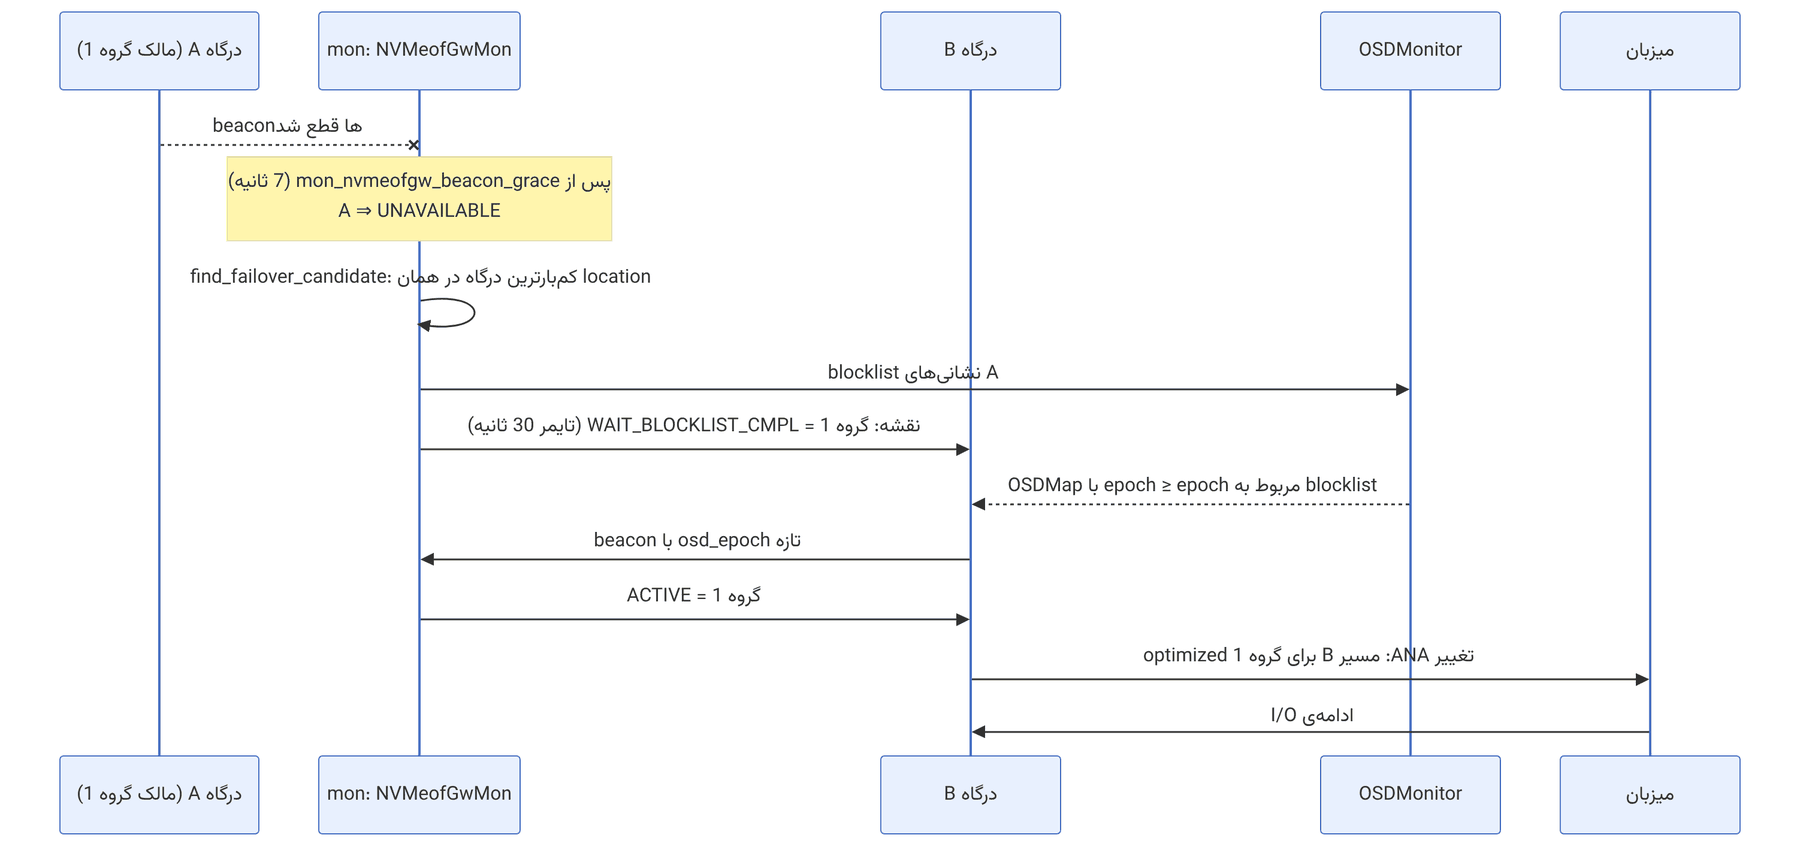
منبع در کد: src/mon/NVMeofGwMap.cc :: NVMeofGwMap::find_failover_candidate و find_failover_gw_logic
پیچیدگی: O(G × A) برای G درگاه و A گروه ANA
pseudocode
find_failover_gw_logic(gws, location, ignore_locations):
best = none; best_load = 0xFFF; busy = 0
for gw in gws (به ترتیب شناسه):
if not AVAILABLE or (not ignore_locations and gw.location ≠ location): continue
if location(gw) in disaster: continue
load = 0
for grp in gw.sm_state:
if state in {OWNER_WAIT_FAILBACK_PREPARED, WAIT_FAILBACK_PREPARED, WAIT_BLOCKLIST_CMPL}:
load = 0xFFFF; busy += 1; break # در حال گذار: کنار گذاشته میشود
if state == ACTIVE: load += 1
if load < best_load: best, best_load = gw, load
return best ? 0 : (busy ? -EBUSY : -ENOENT)
find_failover_candidate: اول با location همان گروه؛ اگر -ENOENT، با ignore_locations=trueمثال عددی. گروه درگاهی با چهار درگاه در دو location داریم: A و B در L1، و C و D در L2. گروههای ANA فعال: A={1}، B={2، ۵}، C={3}، D={4}. A از دست میرود و گروه ۱ در L1 است. در دور اول فقط B در L1 در دسترس است، با بار ۲، پس B انتخاب میشود، اگرچه C و D بار کمتری دارند. این تصمیم عمدی است: ترافیک در همان location میماند. اگر B در آن لحظه در WAIT_FAILBACK_PREPARED برای گروه دیگری بود، بار آن ۰xFFFF میشد و نتیجهی دور اول -EBUSY بود. چون -EBUSY با -ENOENT فرق دارد، دور دوم اجرا نمیشود و failover تا پایان گذار B به تعویق میافتد. اگر B هم خراب بود (-ENOENT)، دور دوم میان C و D (هر دو با بار ۱) اولی را به ترتیب شناسه، یعنی C، انتخاب میکرد، چون مقایسه اکید (>) است.
| گزینه (mon.yaml.in، main) | پیشفرض | معنا |
|---|---|---|
| mon_nvmeofgw_beacon_grace | ۷ ثانیه | بیخبری پس از آن درگاه خراب اعلام میشود |
| mon_nvmeofgw_skip_failovers_interval | ۱۶ ثانیه | دورهای که در آن هیچ failover در آن pool و گروه انجام نمیشود |
| mon_nvmeofgw_beacons_till_ack | ۱۵ | تعداد beacon از MonClient پیش از اینکه NVMeofGwMon نقشهی ack بفرستد |
| mon_nvmeofgw_max_down_gws | ۱ | فرمان ok-to-stop بررسی میکند بیش از این تعداد درگاه down نباشد (جلوگیری از توقف همه هنگام ارتقا) |
| mon_nvmeofgw_delete_grace | ۱۵ دقیقه | پس از این مدت، هشدار سلامت NVMEOF_GATEWAY_DELETING داده میشود |
| mon_nvmeofgw_failback_delay | ۰ | تأخیر failback پس از برگشت مالک |
محاسبهی زمان قطع I/O در failover. در بدترین حالت: ۷ ثانیه تا اعلام خرابی، به اضافهی زمان یک proposal مربوط به Paxos برای blocklist (معمولاً کمتر از یک ثانیه)، به اضافهی رسیدن OSDMap به B و beacon بعدی آن. پس میزبان باید چند ثانیه تا ده و چند ثانیه I/O معلق را تحمل کند. مستند توصیه میکند در nvme connect-all گزینهی -l 1800 (ctrl-loss-tmo برابر ۱۸۰۰ ثانیه) را بدهید تا میزبان در این فاصله مسیر را رها نکند.
۳۱-۵ فرمانهای عملی#
# درگاه (مستند main)
ceph orch apply nvmeof POOL GROUP --placement="host01, host02"
ceph nvmeof subsystem add --nqn nqn.2016-06.io.spdk:cnode1
ceph nvmeof listener add --nqn nqn.2016-06.io.spdk:cnode1 --host-name host01 --traddr 10.0.0.11 --trsvcid 4420
ceph nvmeof namespace add --nqn nqn.2016-06.io.spdk:cnode1 --rbd-pool rbd --rbd-image-name vol1
ceph nvme-gw show POOL GROUP # وضعیت ANA هر درگاه از دید mon
# میزبان
nvme discover -t tcp -a 10.0.0.11 -s 8009
nvme connect-all --traddr 10.0.0.11 --transport tcp -l 1800 -s 8009
nvme list-subsys # مسیرها و وضعیت ANA (optimized/inaccessible)
# دیدن فرمانهای NVMe در هسته
bpftrace -e 'tracepoint:nvme:nvme_setup_cmd { @op[args->opcode] = count(); }'اگر پس از خرابی یک درگاه، I/O میزبان بیش از چند ده ثانیه معلق ماند: (۱) با ceph nvme-gw show ببینید گروه ANA در WAIT_BLOCKLIST_CMPL مانده است یا نه؛ (۲) ceph osd blocklist ls را بررسی کنید که نشانی درگاه قدیمی blocklist شده باشد؛ (۳) مطمئن شوید OSDMonitor قابل نوشتن است. CMonRequestProposal تا writeable شدن OSDMonitor صبر میکند، پس مشکل quorum مستقیماً failover را متوقف میکند.
مستند هشدار میدهد ceph nvme-gw create و delete را روی خوشهی مدیریتشده با cephadm دستی اجرا نکنید: حذف درگاه بیدرنگ گروههای ANA آن را failover میکند. disable کردن همهی درگاههای یک گروه دسترسی NVMe-oF به namespaceها را قطع میکند.
۳۱-۶ تکمیلی و بهروز#
- فرمان
ceph nvme-gw listeners طبق مستند در Tentacle افزوده شده است. - در main، NVMeofGwMap مفهوم location و حالت disaster برای یک location دارد (
cfg_set_location، cfg_location_disaster_set). انتخاب جایگزین اول در همان location انجام میشود. این قابلیت را پیش از استفاده در نسخهی خود بررسی کنید. -
NVMeofGwBeaconConstants.h دو نسخهی beacon تعریف میکند: ۱ (قدیمی، بدون diff) و ۲ (با diff). گزینهی cfg_enable_disable_beacon_diff در mon آن را کنترل میکند. - در NVMEDevice،
register_ctrlr فقط namespace شمارهی ۱ را استفاده میکند و ceph_assert(shared_driver_datas.empty()) یعنی فقط یک دستگاه SPDK برای هر فرایند OSD.
۳۱-۷ تمرین عملی#
- ۱. برای q_depth=8 و DSTRD=2، آفست doorbellهای SQ و CQ صف ۵ را حساب کنید. (پاسخ: ۰x1000 + ۱۰×۱۶ = ۰x10A0 و ۰x10B0)
- ۲. SQE یک نوشتن ۶۴ KiB در آفست ۳ GiB با LBA پانصد و دوازده بایتی را بنویسید: slba، NLB و تعداد ورودیهای فهرست PRP.
- ۳. نوشتن ۱ MiB در NVMEDevice: تعداد Taskها، فرمانها و بافرهای DMA را حساب کنید.
- ۴. با bpftrace روی tracepointهای nvme_setup_cmd و nvme_complete_rq، توزیع تأخیر دستگاه را برای یک OSD در حین
rados bench بسازید. - ۵. در یک گروه سهدرگاهی، یکی را با
ceph orch daemon stop متوقف و تغییر حالت ANA را در nvme list-subsys و ceph nvme-gw show دنبال کنید.
۳۱-۸ پرسشهای مرور#
- ۱. SQ و CQ کجا قرار دارند و چه کسی در هرکدام مینویسد؟
- ۲. Phase Tag چگونه بدون خواندن ثبات دستگاه، CQE تازه را مشخص میکند؟
- ۳. چرا هسته نوشتن doorbell را تا پایان دسته به تعویق میاندازد؟
- ۴. فیلد length در فرمان Read چرا صفرمبناست و برای ۸ بلوک چه مقداری دارد؟
- ۵. چرا NVMEDevice داده را در بافرهای DMA کپی میکند؟
- ۶. thread_local SharedDriverQueueData چه سودی و چه هزینهای دارد؟
- ۷. aio_submit در NVMEDevice از نظر بلوکه شدن با KernelDevice چه تفاوتی دارد؟
- ۸. مسیر یک نوشتن از nvme_tcp میزبان تا OSD را با نام توابع bdev_rbd شرح دهید.
- ۹. چرا درگاه جایگزین پیش از ACTIVE شدن باید منتظر blocklist باشد؟
- ۱۰. الگوریتم انتخاب درگاه جایگزین چه زمانی -EBUSY و چه زمانی -ENOENT برمیگرداند؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۱-۹ منابع این فصل#
- درگاه NVMe-oF در مستند Ceph
https://docs.ceph.com/en/latest/rbd/nvmeof-overview/ - پیکربندی هدف NVMe-oF
https://docs.ceph.com/en/latest/rbd/nvmeof-target-configure/ - پیشنیازهای درگاه
https://docs.ceph.com/en/latest/rbd/nvmeof-requirements/ - استفاده از SPDK در BlueStore
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - کد NVMEDevice
https://github.com/ceph/ceph/blob/main/src/blk/spdk/NVMEDevice.cc - کد NVMeofGwMap
https://github.com/ceph/ceph/blob/main/src/mon/NVMeofGwMap.cc - پروژهی ceph-nvmeof
https://github.com/ceph/ceph-nvmeof - درایور NVMe هستهی لینوکس
https://github.com/torvalds/linux/blob/master/drivers/nvme/host/pci.c - ساختارهای NVMe و NVMe/TCP
https://github.com/torvalds/linux/blob/master/include/linux/nvme.h - ماژول bdev_rbd در SPDK
https://github.com/spdk/spdk/blob/master/module/bdev/rbd/bdev_rbd.c - مستند SPDK
https://spdk.io/doc/ - مشخصات NVMe
https://nvmexpress.org/specifications/