لایههای پایینی (۵): ریاضیات erasure coding، از GF(۲⁸) تا FastEC
حوصله ندارم این فصل در چند خط
- erasure coding در Ceph حساب در میدان GF(۲⁸) است: هر بایت یک عضو میدان است، جمع همان XOR است و ضرب با جدول لگاریتم انجام میشود.
- encode تکههای داده را در یک ماتریس مولد ضرب میکند؛ ماتریسهای Reed–Solomon تضمین میکنند هر k تکه برای decode کافی باشد (ویژگی MDS).
- decode پس از خرابی، سطرهای متناظر ماتریس را وارون میکند؛ بهروزرسانی parity-delta بدون خواندن کل stripe، parity را عوض میکند.
- FastEC در Tentacle همین را برای خواندن و نوشتن جزئی، پشت
allow_ec_optimizations، به کار میبرد.
۲۷-۱ مقدمه: از XOR تا Reed-Solomon#
در فصل ۱۳ دیدیم یک pool با erasure coding چگونه ساخته میشود و پروفایلها چه معنایی دارند. این فصل یک لایه پایینتر میرود: ریاضیات میدان متناهی ، ساخت ماتریس تولید Reed-Solomon (به روش Vandermonde و Cauchy)، پیادهسازی SIMD در ISA-L، و اینکه Ceph چگونه شیء را به stripe و chunk تقسیم میکند، نوشتن جزئی را با read-modify-write انجام میدهد و در Tentacle با EC بهینهشده (که معمولاً FastEC نامیده میشود) چه چیزی تغییر کرده است. یک مثال عددی کامل encode و decode هم با دست حل میکنیم.
- همهی پلاگینهای اصلی (isa، jerasure و پایهی clay) در کار میکنند. در این میدان جمع برابر XOR است و ضرب با جدول log/exp یا SIMD انجام میشود.
- پروفایل پیشفرض در Tentacle و main
plugin=isa technique=reed_sol_van k=2 m=2 است. در Squid پیشفرض plugin=jerasure بود. - در ISA-L، Vandermonde فقط برای m ≤ ۴ (و برای m=4 تنها با k ≤ ۲۱) MDS تضمینشده است. در غیر این صورت Ceph خودکار به
cauchy تغییر میدهد. -
stripe_unit پیشفرض ۴K است و برای poolهای با allow_ec_optimizations برابر ۱۶K میشود. - EC بهینه در Tentacle (
ECSwitch بین backend قدیمی و جدید) خواندن جزئی مستقیم و بهروزرسانی parity با delta را ممکن میکند. پس از فعال شدن، غیرفعالکردنی نیست.
۲۷-۲ GF(۲⁸): حساب بایتها#
erasure coding باید روی بایتها «ضرب و تقسیم» کند، بهطوری که هر عدد غیرصفر معکوس داشته باشد و نتیجه همیشه یک بایت بماند. میدان گالوا دقیقاً همین را فراهم میکند. عناصر آن ۲۵۶ بایتاند که بهصورت چندجملهایهایی از درجهی کمتر از ۸ با ضرایب ۰ و ۱ دیده میشوند.
- جمع و تفریق: هر دو XOR هستند، پس a + a = ۰.
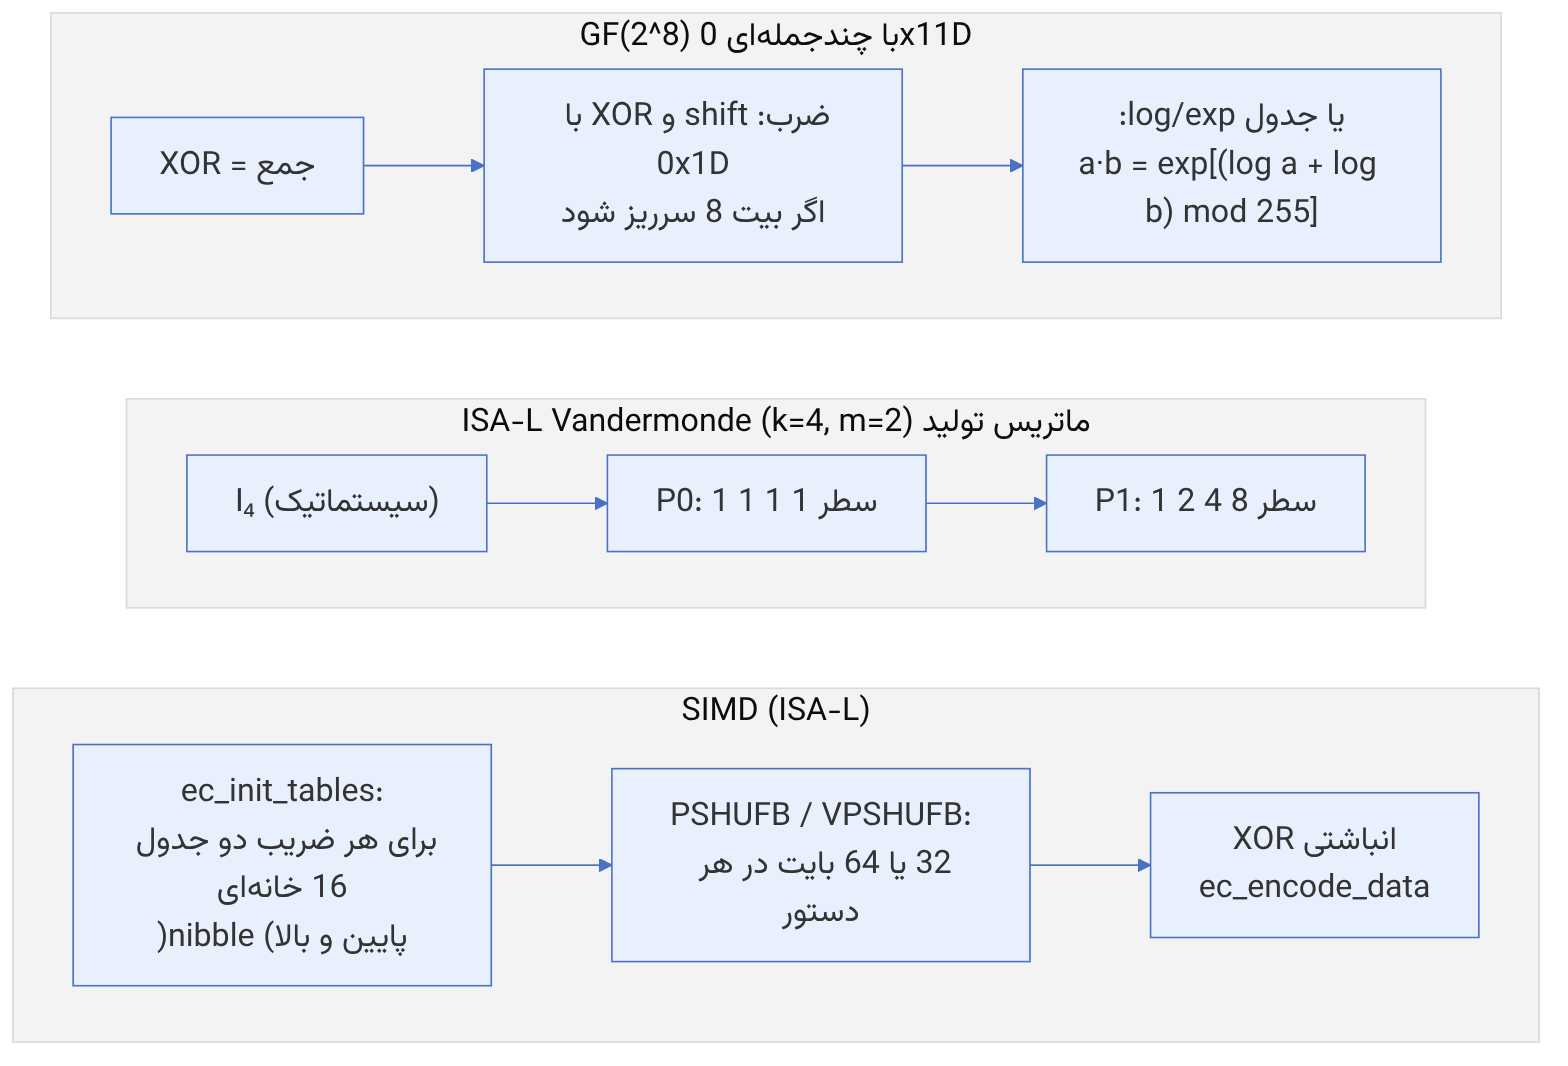
- ضرب: ضرب چندجملهایها و سپس باقیمانده بر یک چندجملهای تحویلناپذیر درجه ۸ گرفته میشود. ISA-L از ۰x11D (x⁸ + x⁴ + x³ + x² + ۱) استفاده میکند: در هر شیفت به چپ، اگر بیت ۸ روشن شد، با ۰x1D XOR میشود (در
ec_base.c همین الگو برای ضرب در ۲ دیده میشود). - جدول log/exp: چون عدد ۲ مولد گروه ضربی است، هر بایت غیرصفر برابر است. پس و .
| ضرب نمونه در با ۰x11D | نتیجه | شرح |
|---|---|---|
| ۰x02 × ۰x04 | ۰x08 | بدون سرریز؛ فقط شیفت |
| ۰x34 × ۰x02 | ۰x68 | ۰x34 << ۱ = ۰x68 |
| ۰x56 × ۰x04 | ۰x45 | ۰x56 << ۲ = ۰x158 → بیت ۸ روشن → ۰x58 ⊕ ۰x1D = ۰x45 |
| ۰x78 × ۰x08 | ۰xE7 | سه شیفت با دو سرریز |
۲۷-۳ Reed-Solomon سیستماتیک#
در یک کد سیستماتیک (k، m)، k chunk داده بدون تغییر ذخیره و m chunk parity از آنها محاسبه میشود. اگر D بردار داده باشد، chunkها از ضرب ماتریس تولید G با اندازهی (k+m)×k در D به دست میآیند: C = G · D. چهار سطر اول G همانیاند. کد MDS است، یعنی هر k chunk از k+m chunk برای بازسازی کافی است، به شرط اینکه هر زیرماتریس k×k از G معکوسپذیر باشد.
gf_gen_rs_matrix در ISA-L سطر i ام parity را با توانهای میسازد. این یک ماتریس «Vandermonde» ساده است که برای همهی (k، m)ها MDS نیست. به همین دلیل ErasureCodeIsa.cc اگر m > ۴ باشد یا m = ۴ و k > ۲۱، با پیامی در لاگ به gf_gen_cauchy1_matrix تغییر میدهد که درایههایش ۱/(i ⊕ j) هستند و همیشه MDSاند. سقف k هم MAX_K = 32 است.
| ماتریس parity برای k=4، m=2 | سطر P0 | سطر P1 |
|---|---|---|
| ISA-L reed_sol_van | ۱ ۱ ۱ ۱ | ۱ ۲ ۴ ۸ |
| ISA-L cauchy | ۰x47 0xA7 0x7A 0xBA | ۰xA7 0x47 0xBA 0x7A |
۲۷-۳-۱ مثال کامل: encode یک stripe کوچک#
فرض کنید هر chunk فقط یک بایت دارد و داده D = (۰x12, 0x34, 0x56, 0x78) است (در واقع همین محاسبه برای هر بایت از chunkهای ۴K تکرار میشود):
P0 = 1·12 ⊕ 1·34 ⊕ 1·56 ⊕ 1·78 = 12 ⊕ 34 ⊕ 56 ⊕ 78           = 0x08
P1 = 1·12 ⊕ 2·34 ⊕ 4·56 ⊕ 8·78 = 12 ⊕ 68 ⊕ 45 ⊕ E7           = 0xD8
chunks = [12, 34, 56, 78 | 08, D8]   (shard 0..5)
۲۷-۳-۲ decode: از دست رفتن دو shard#
فرض کنید OSDهای حاوی D1 و D3 از دست رفتهاند و shardهای سالم {D0، D2، P0، P1} هستند. سطرهای متناظر از G یک ماتریس ۴×۴ میسازند. معکوس آن در حساب میشود (ISA-L از gf_invert_matrix استفاده میکند) و سطرهای مربوط به دادههای گمشده با بایتهای سالم ضرب میشوند:
D1 = 7B·D0 ⊕ F5·D2 ⊕ A6·P0 ⊕ DD·P1 = 0x34   ✓
D3 = 7A·D0 ⊕ F4·D2 ⊕ A7·P0 ⊕ DD·P1 = 0x78 ✓همهی اعداد این دو بخش با یک پیادهسازی پایتونی مستقل از با ۰x11D و همان الگوریتم ساخت ماتریس ISA-L محاسبه و بررسی شدهاند. ضرایب decode فقط یک بار برای هر الگوی خرابی حساب میشوند و پلاگین isa آنها را در ErasureCodeIsaTableCache نگه میدارد، چون معکوس کردن ماتریس از encode گرانتر است.
چرا SIMD اینقدر سریع است؟ ضرب یک بایت x در ثابت c را میتوان به دو nibble شکست: c·x = c·(x_hi << ۴) ⊕ c·x_lo. هر کدام فقط ۱۶ حالت دارد، پس دو جدول ۱۶ بایتی کافی است. دستور PSHUFB (یا VPSHUFB در AVX2/AVX-512) میتواند ۱۶، ۳۲ یا ۶۴ جستوجوی همزمان در یک جدول ۱۶ بایتی انجام دهد. ISA-L این جدولها را با ec_init_tables برای همهی ضرایب میسازد و ec_encode_data برای هر بلوک ورودی، ضرب و XOR انباشتی را با این دستورها اجرا میکند. نتیجه، سرعت encode در حد چند گیگابایت در ثانیه در هر هسته است. jerasure (با gf-complete) از روش مشابهی استفاده میکند، ولی ISA-L روی x86 معمولاً سریعتر است. پلاگین isa روی Arm هم با کدهای NEON و SVE مربوط به ISA-L کار میکند.
۲۷-۴ stripe، chunk و چیدمان روی OSD#
| مفهوم | تعریف | پیشفرض |
|---|---|---|
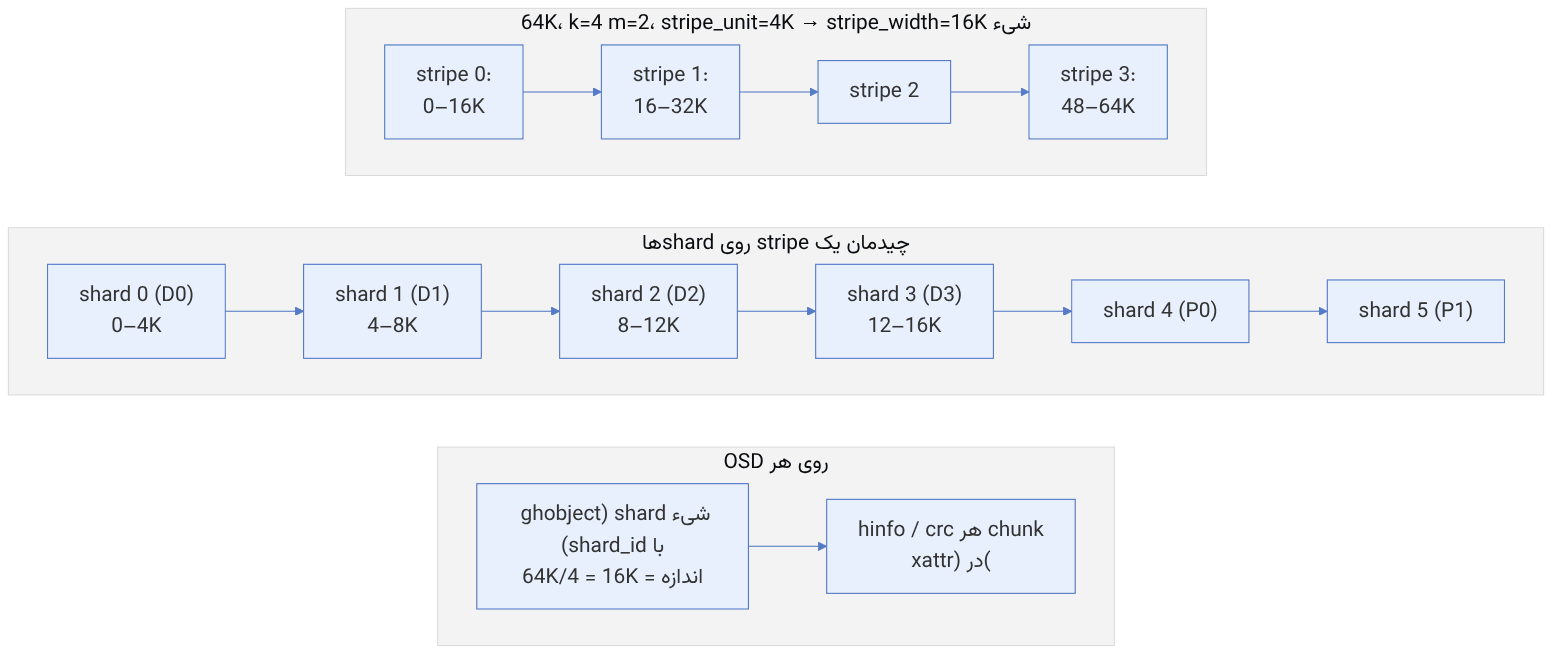
stripe_unit (chunk size) | بایتهای دادهی یک shard در یک stripe | ۰ در osd_pool_erasure_code_stripe_unit یعنی ۴K، یا ۱۶K اگر pool بهینه باشد و پلاگین پشتیبانی کند |
stripe_width | k × stripe_unit | برای k=4: 16K یا ۶۴K |
| شیء shard | ghobject_t با shard_id برابر ۰..k+m−۱ | روی OSD با کلید onode دارای shard + ۰x80 (فصل ۲۴) |
ceph osd pool create اگر stripe_unit مضرب ۴K نباشد، بدون --yes-i-really-mean-it پروفایل را رد میکند. انتخاب stripe_unit بزرگتر یعنی نوشتنهای کوچکتر از یک stripe بیشتر، ولی خواندن ترتیبی کارآمدتر. با EC بهینه این بدهبستان به سمت ۱۶K رفته است، چون نوشتن جزئی دیگر کل stripe را نمیخواند.
۲۷-۵ read-modify-write در EC قدیمی#
تا Squid، و در poolهای بدون بهینهسازی در نسخههای بعدی، backend مربوط به EC برای هر نوشتنی که کل stripe را نپوشاند و روی دادهی موجود باشد (allow_ec_overwrites=true، لازم برای RBD و CephFS) این کارها را انجام میدهد:
pseudocode: overwrite جزئی در ECBackend قدیمی (خلاصهی این کتاب)
extent = round_out(write, stripe_width) # گسترش به مرز stripe
if cache miss: read k chunks of extent from shards # چند رفتوبرگشت شبکه
merge new bytes into stripe buffer
encode → m parity chunks for whole stripe
send sub-writes to all k+m shards (هر shard، تراکنش خودش)
wait all commits → reply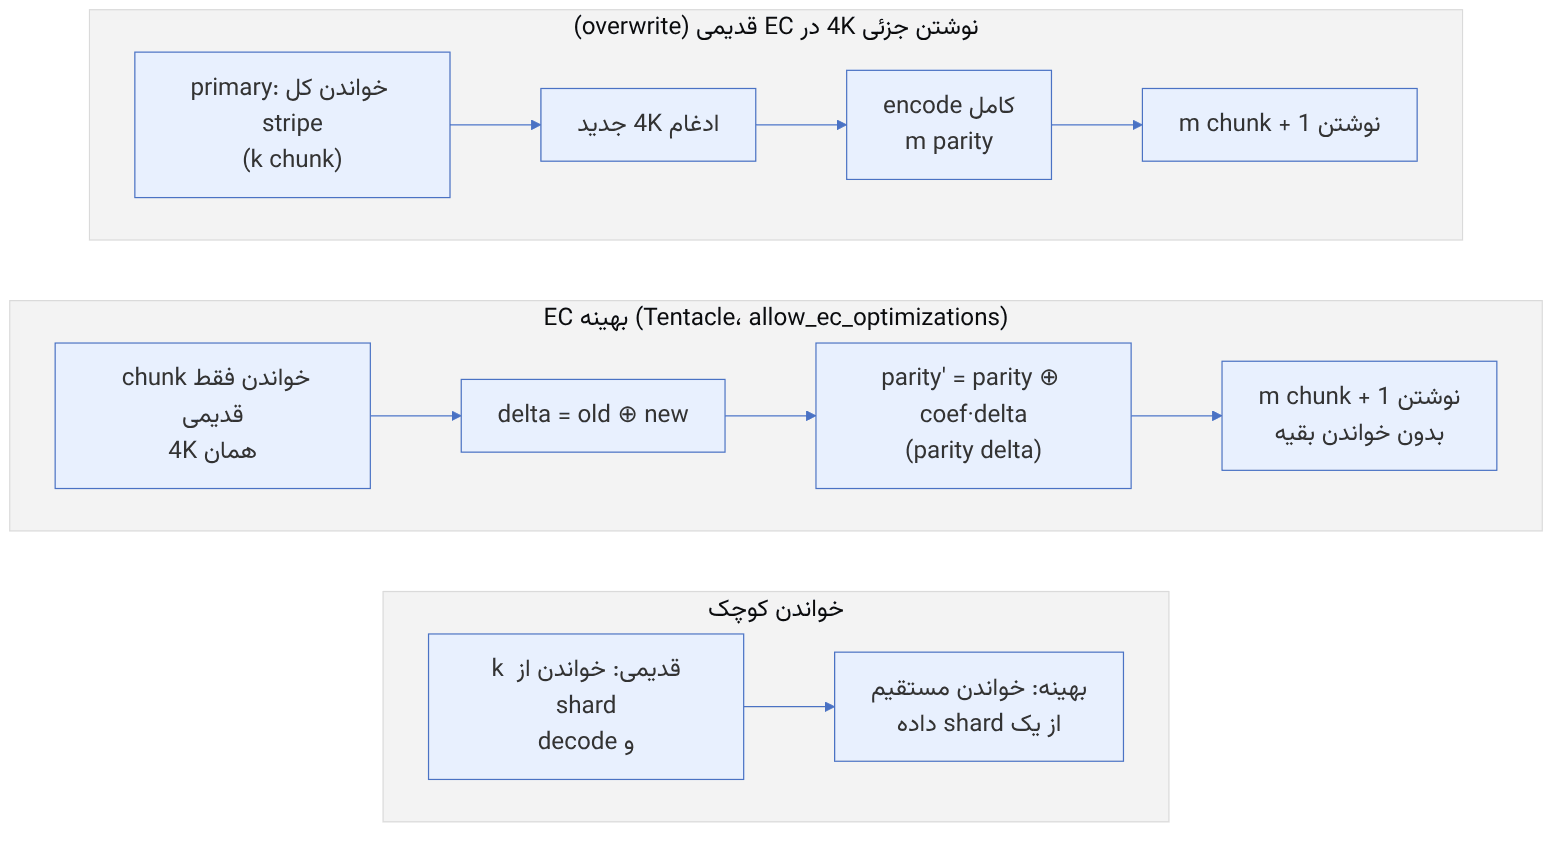
چرا parity delta درست است؟ چون کد خطی است: . اگر فقط به تغییر کند، . با مثال بخش قبل، اگر D1 از ۰x34 به ۰x35 تغییر کند، delta برابر ۰x01 است، پس P0′ = ۰x08 ⊕ ۱·۰x01 = ۰x09 و P1′ = ۰xD8 ⊕ ۲·۰x01 = ۰xDA. نیازی به خواندن D0، D2 و D3 نیست.
پرچم پلاگین (ErasureCodeInterface.h) | معنی |
|---|---|
FLAG_EC_PLUGIN_PARTIAL_READ_OPTIMIZATION | کد سیستماتیک است؛ خواندن کوچک مستقیم از shard داده |
FLAG_EC_PLUGIN_PARTIAL_WRITE_OPTIMIZATION | نوشتن کوچکتر از یک chunk فقط همان قطعه را از هر shard داده لازم دارد |
FLAG_EC_PLUGIN_ZERO_INPUT_ZERO_OUTPUT_OPTIMIZATION | دادهی تماماً صفر parity صفر میدهد (برای ناحیههای خالی) |
FLAG_EC_PLUGIN_ZERO_PADDING_OPTIMIZATION | بافرهای با طول صفر مجازند |
FLAG_EC_PLUGIN_PARITY_DELTA_OPTIMIZATION | بهروزرسانی parity با delta |
FLAG_EC_PLUGIN_REQUIRE_SUB_CHUNKS | پلاگین sub-chunk لازم دارد (CLAY) |
FLAG_EC_PLUGIN_OPTIMIZED_SUPPORTED | میتواند در pool بهینه استفاده شود: isa، و jerasure فقط با reed_sol_van |
# Tentacle و بالاتر:
ceph osd erasure-code-profile set ec42 plugin=isa technique=reed_sol_van k=4 m=2 crush-failure-domain=host
ceph osd pool create ecdata erasure ec42
ceph osd pool set ecdata allow_ec_overwrites true
ceph osd pool set ecdata allow_ec_optimizations true # برگشتناپذیر
ceph osd pool get ecdata all | grep -E 'ec_optim|stripe'FLAG_EC_OPTIMIZATIONS در osd_types.h با این توضیح تعریف شده است: «once enabled, cannot be disabled». پیش از فعال کردن آن روی pool تولیدی، مطمئن شوید همهی OSDها به نسخهای ارتقا یافتهاند که آن را پشتیبانی میکند. آن را ابتدا روی یک pool آزمایشی امتحان کنید. osd_pool_default_flag_ec_optimizations (پیشفرض false) فعال شدن خودکار آن را برای poolهای جدید کنترل میکند.
۲۷-۶ کدهای با پهنای باند ترمیم کمتر#
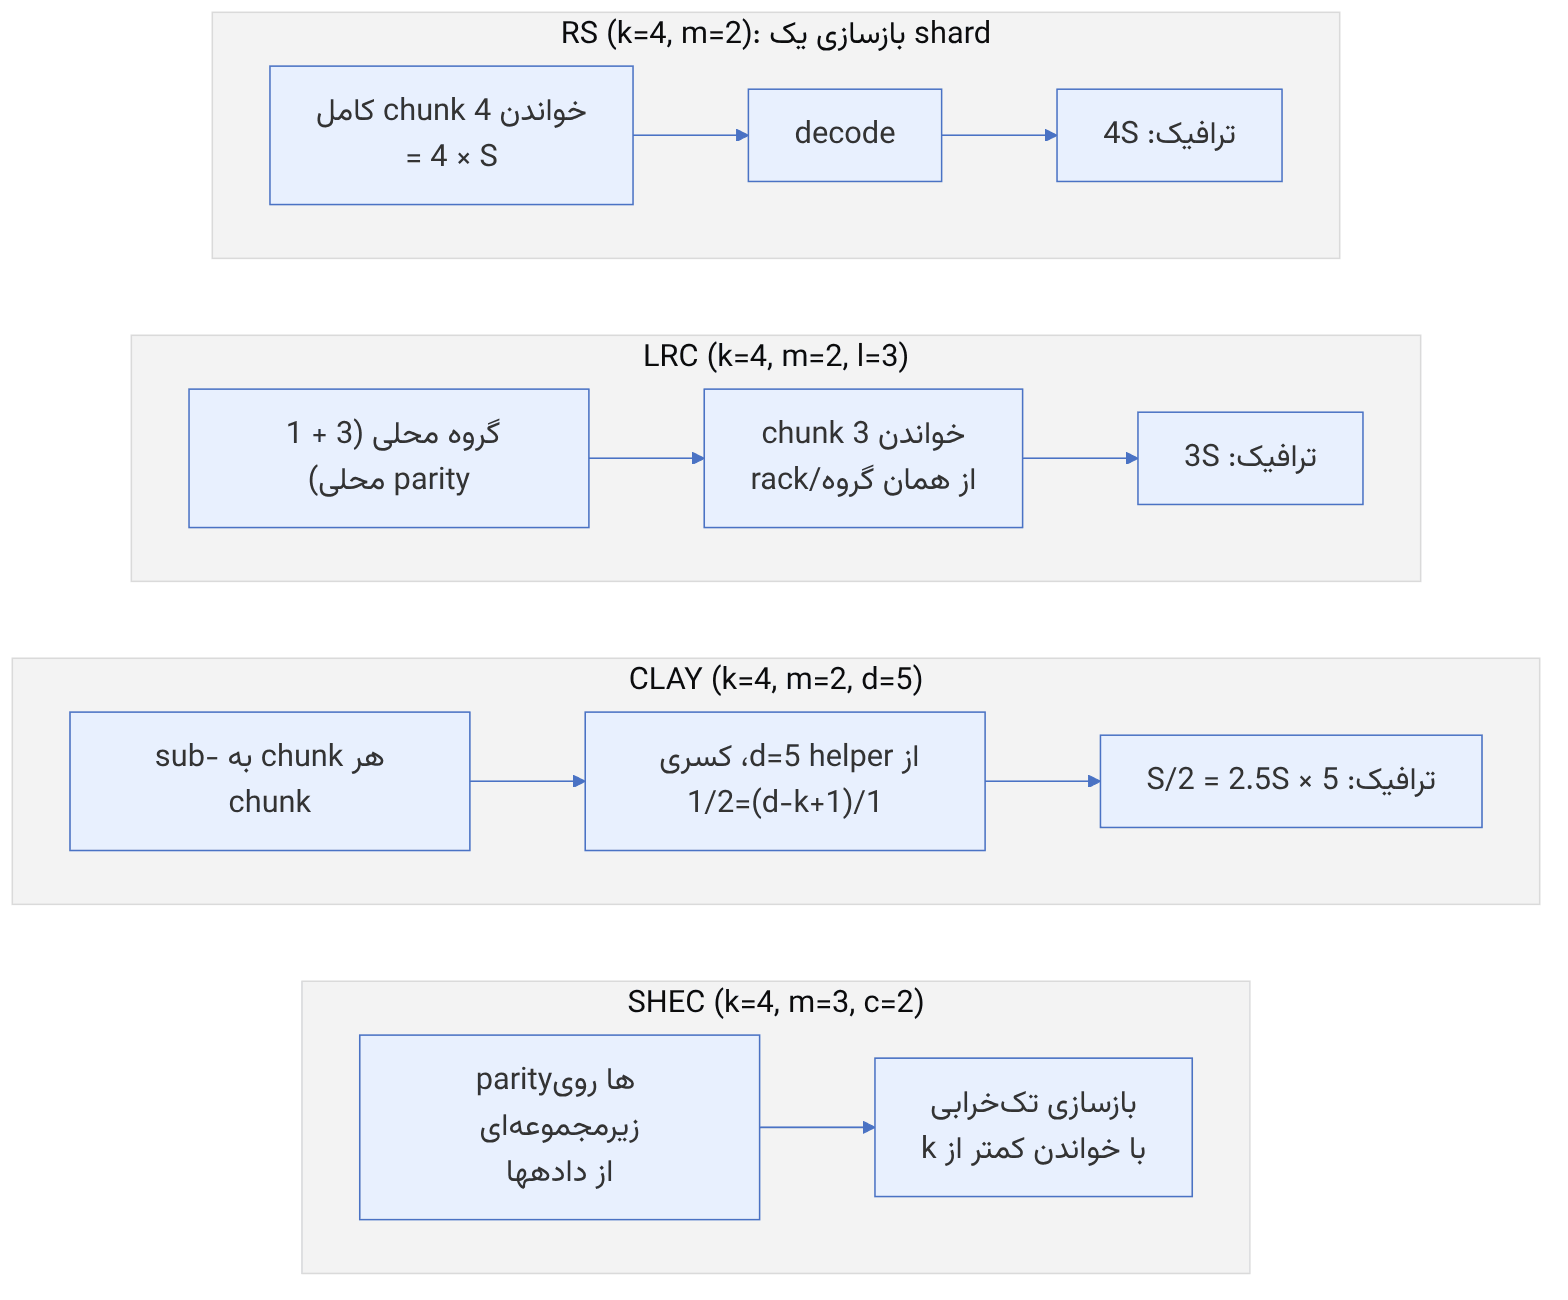
در RS، بازسازی یک shard گمشده به خواندن k chunk کامل نیاز دارد. برای k=8، این یعنی ۸ برابر دادهی از دست رفته از شبکه میگذرد. سه پلاگین Ceph این هزینه را به روشهای متفاوت کم میکنند:
| پلاگین | پارامترها (پیشفرض) | ایده | بدهبستان |
|---|---|---|---|
lrc | k، m، l | افزودن parity محلی برای هر l chunk؛ معمولاً هر گروه در یک rack | سربار فضای بیشتر: (k+m)/k + (k+m)/(l·k) |
clay | k=4، m=2، d=k+m−۱ (پیشفرض) | کد coupled-layer با sub-chunk: ترمیم با خواندن کسری از d helper | ترمیم کمینه (MSR)؛ تعداد sub-chunk برابر است که با k+m بهسرعت بزرگ میشود و خواندنها ریز میشوند |
shec | k=4، m=3، c=2 | هر parity فقط بخشی از داده را میپوشاند؛ c = تعداد خرابی تحملپذیر تضمینی | کارایی فضا بین RS و replication؛ ترمیم تکی ارزانتر |
مثال عددی CLAY: پهنای باند ترمیم برای یک shard به اندازهی S برابر است. با k=8، m=4 و d=11، این مقدار ۱۱S/4 = ۲.۷۵S است، در حالی که RS معادل ۸S میخواند (حدود ۶۶٪ صرفهجویی). ولی q = d − k + ۱ = ۴ و t = (k+m)/q = ۳، پس هر chunk به sub-chunk تقسیم میشود. با stripe_unit برابر ۴K، sub-chunkها ۶۴ بایتی میشوند و خواندن ترمیمی به دهها خواندن کوچک و پراکنده تبدیل میشود. برای همین CLAY با stripe_unit بزرگتر معنا پیدا میکند.
۲۷-۷ crc و یکپارچگی در EC#
در EC قدیمی، برای poolهای append-only (بدون overwrite)، hash هر shard (hinfo_key در xattr) نگه داشته میشد و scrub عمیق آن را بررسی میکرد. با allow_ec_overwrites، این hash دیگر بهروز نمیشود و یکپارچگی بر checksumهای BlueStore در هر shard (فصل ۲۳) تکیه دارد. scrub عمیق در EC هر shard را میخواند و سازگاری parity را با encode دوباره بررسی میکند. پرچم FLAG_EC_PLUGIN_CRC_ENCODE_DECODE_SUPPORT در main نشان میدهد پلاگین میتواند crc را از روی crc دادهها محاسبه کند، یعنی خاصیت خطی بودن crc را با کد ترکیب کند. این بخشی از کارهای در جریان روی scrub سریعتر است. پیش از تکیه بر آن، نسخهی خود را بررسی کنید.
ceph osd erasure-code-profile get default
ceph osd pool ls detail | grep -E 'erasure|stripe_width'
ceph pg <pgid> query | jq '.info.stats.stat_sum.num_objects_degraded'
ceph tell osd.4 config get osd_recovery_max_active_hdd۲۷-۸ حساب GF(۲⁸) در سطح دستور: جدولهای log/exp و ترفند نیمبایت#
بخشهای پیشین ضرب در را تعریف کردند. این بخش نشان میدهد ISA-L، که پلاگین isa در Ceph بر آن تکیه دارد، این ضرب را در حلقهی داغ چگونه انجام میدهد. چندجملهی کاهش در ISA-L همان ۰x11D (یعنی ) است. در کد این عدد به شکل 0x1d دیده میشود: هر بار که بیت ۷ پیش از شیفت روشن باشد، حاصل با ۰x1d XOR میشود.
منبع در کد: isa-l/erasure_code/ec_base.c :: gf_mul، gf_inv
پیچیدگی: O(۱): دو جستوجو، یک جمع و یک مقایسه؛ جدولها ۲۵۶ + ۲۵۶ بایت
pseudocode
# ساخت یکباره: exp[i] = 2^i و log[2^i] = i برای i در 0..254
x = 1
for i in 0..254: exp[i] = x; log[x] = i; x = x·2 (یعنی x≪1 و اگر سرریز شد ⊕ 0x11D)
gf_mul(a, b): if a == 0 or b == 0: return 0
i = log[a] + log[b]; if i > 254: i −= 255
return exp[i]
gf_inv(a): return exp[255 − log[a]]مثال عددی. exp[0..15] = ۰۱ ۰۲ ۰۴ ۰۸ ۱۰ ۲۰ ۴۰ ۸۰ ۱D 3A 74 E8 CD 87 13 26. پس است، یعنی همان سرریز اول. برای ۰x53 × ۰xCA داریم log[0x53] = ۲۰۶ و log[0xCA] = ۷۳. جمع آنها ۲۷۹ است و چون از ۲۵۴ بزرگتر است، ۲۷۹ − ۲۵۵ = ۲۴ و exp[24] = ۰x8F. وارون ۰x02 برابر exp[255 − ۱] = ۰x8E است. آزمون: ۰x8E × ۲ = ۰x11C و ۰x11C ⊕ ۰x11D = ۰x01.
این روش برای هر بایت دو دسترسی تصادفی به جدول و یک شاخه دارد و در حلقهی داغ کند است. برای همین ISA-L جدول دیگری میسازد که با دستورهای SIMD سازگار است.
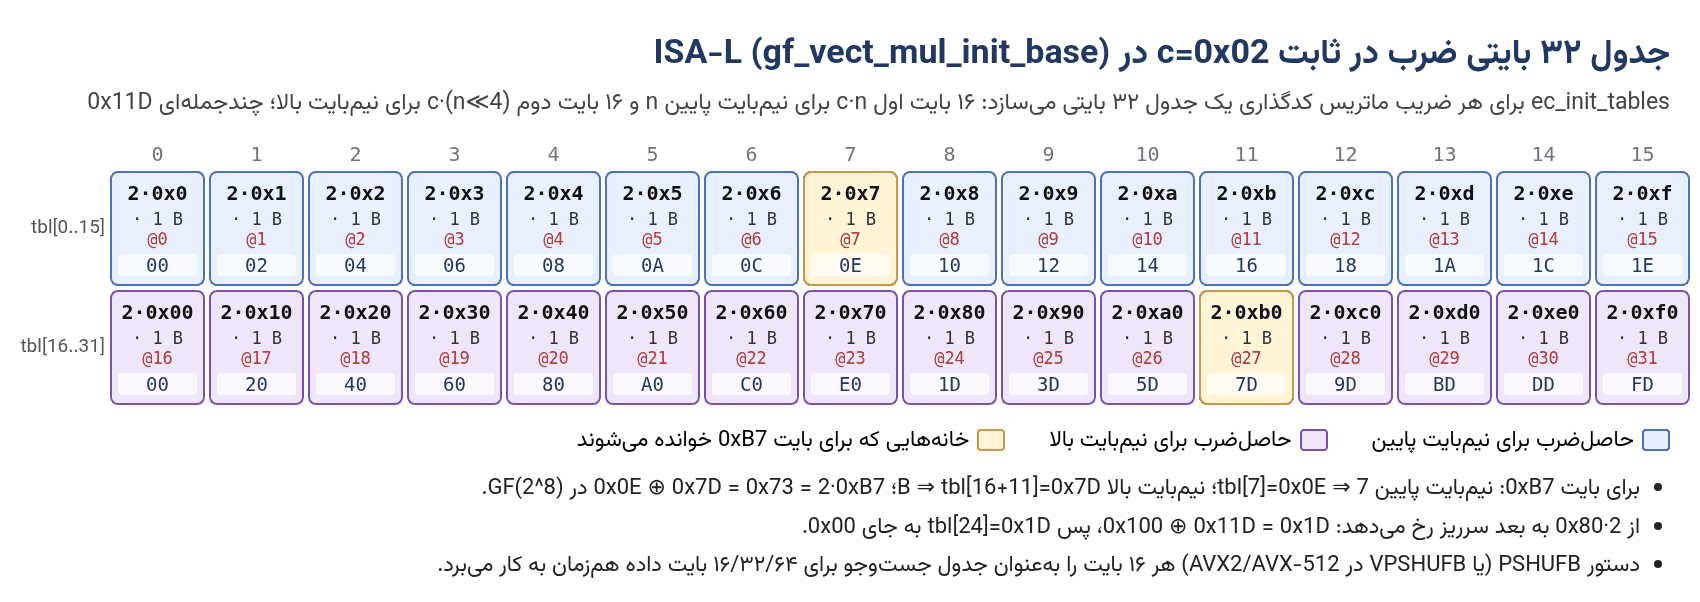
دلیل درستی ترفند این است که هر بایت d برابر (d AND 0xF0) ⊕ (d AND 0x0F) است و ضرب در c روی ⊕ پخش میشود. پس به جای جدول ۲۵۶ خانهای برای هر c، دو جدول ۱۶ خانهای کافی است. ۱۶ خانه دقیقاً اندازهی یک ثبات XMM است و دستور PSHUFB با همین اندازه کار میکند: هر بایت از ثبات دوم را شاخصی در ثبات اول میگیرد.
منبع در کد: isa-l/erasure_code/ec_base.c :: gf_vect_mul_init_base، ec_init_tables_base و نسخههای اسمبلی gf_*vect_dot_prod_avx2.asm
پیچیدگی: ساخت جدول O(۳۲) برای هر ضریب، یعنی ۳۲·k·m بایت برای کل ماتریس. کدگذاری O(k·m·L/W) دستور برای L بایت با پهنای ثبات W (۱۶/۳۲/۶۴)
pseudocode
init(c): for n in 0..15: tbl[n] = c·n ; tbl[16+n] = c·(n≪4)
encode_row(row r, data D0..Dk-1, length L):
    for off in 0, W, 2W, … < L:                 # W = 32 در AVX2
        acc = 0
        for j in 0..k-1:
            v  = load(Dj + off)
            lo = v AND 0x0F ; hi = (v ≫ 4) AND 0x0F
            acc ^= PSHUFB(tbl[r][j].lo, lo) ^ PSHUFB(tbl[r][j].hi, hi)
        store(P_r + off, acc)
مثال عددی. برای d = ۰xB7 و c = ۲: نیمبایت پایین ۷ به tbl[7] = ۰x0E میرسد و نیمبایت بالا B به tbl[27] = ۰x7D. 0x0E ⊕ ۰x7D = ۰x73، که با ۲·۰xB7 مستقیم (۰x16E ⊕ ۰x11D = ۰x73) یکی است. برای k=4، m=2، یعنی شش ضریب، ec_init_tables 6 × ۳۲ = ۱۹۲ بایت جدول میسازد. Ceph در ErasureCodeIsaDefault::prepare آرایهای به اندازهی k·(m+k)·۳۲ بایت میگیرد و جدولها را در ErasureCodeIsaTableCache نگه میدارد تا برای هر (k, m) فقط یکبار ساخته شوند. جدولهای decode هم در یک LRU به طول decoding_tables_lru_length نگه داشته میشوند، چون برای هر الگوی خرابی ماتریس متفاوتی لازم است.
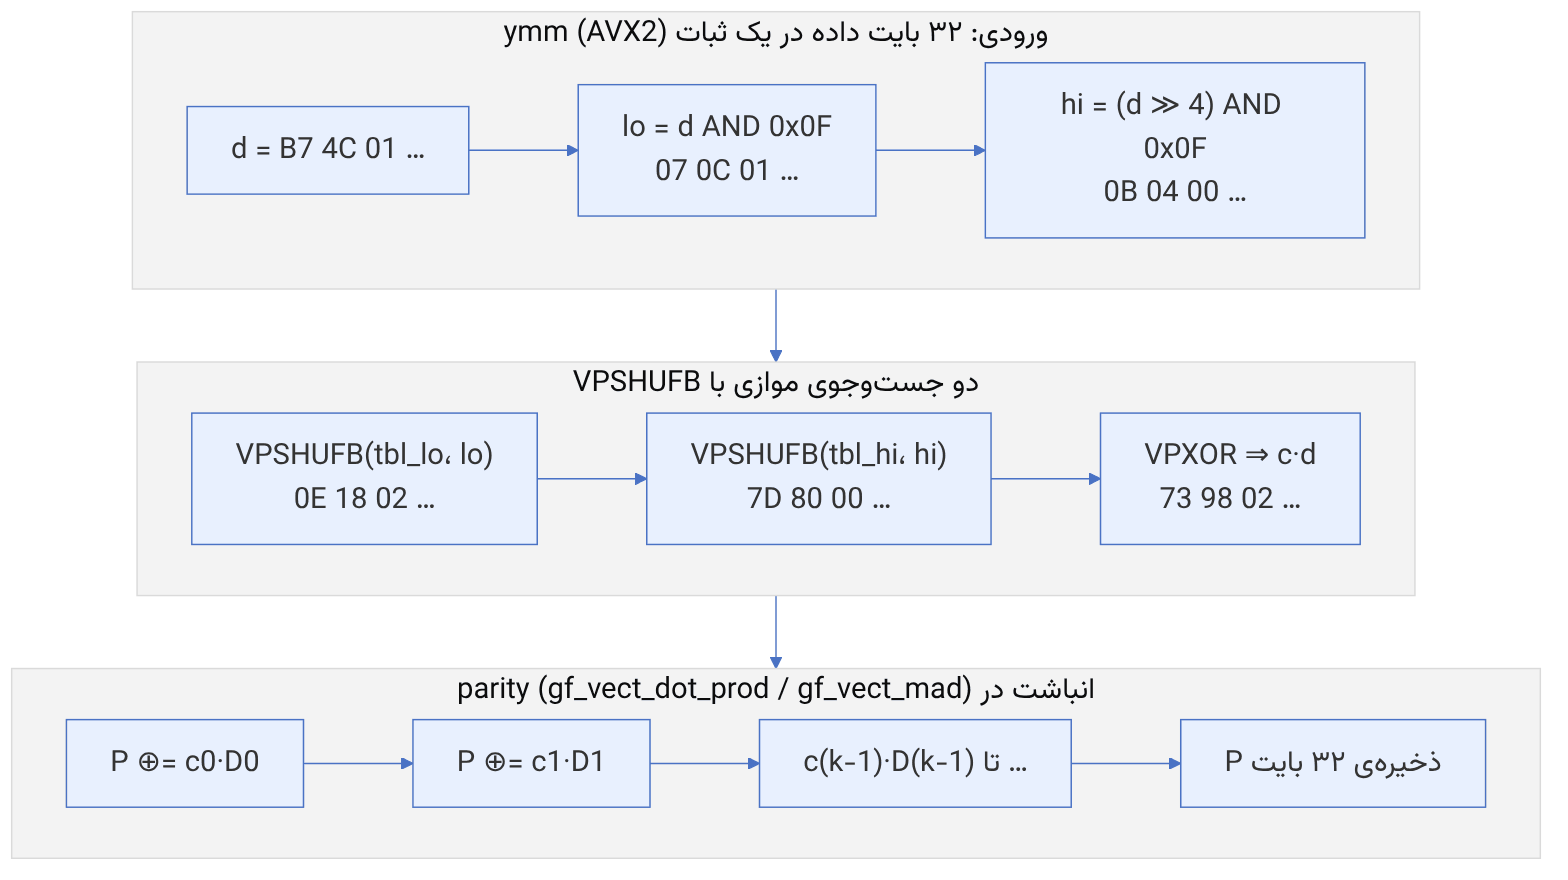
در پردازندههایی که GFNI دارند، ISA-L نسخههای *_gfni.asm را انتخاب میکند. دستور GF2P8AFFINEQB ضرب در یک ثابت را به شکل یک تبدیل affine روی هر بایت انجام میدهد و جدول نیمبایت را حذف میکند. انتخاب نسخه در زمان اجرا با dispatcher چندنسخهای (ec_multibinary.asm) و بر اساس CPUID انجام میشود، نه در زمان کامپایل Ceph.
۲۷-۹ ماتریسهای تولید: Vandermonde در برابر Cauchy#
پلاگین isa دو ماتریس میشناسد: technique=reed_sol_van (پیشفرض) که gf_gen_rs_matrix را صدا میزند و technique=cauchy که gf_gen_cauchy1_matrix را. هر دو ماتریس (k+m)×k با یک ماتریس همانی k×k در بالا میسازند، پس کد سیستماتیک است.
منبع در کد: isa-l/erasure_code/ec_base.c :: gf_gen_rs_matrix، gf_gen_cauchy1_matrix؛ src/erasure-code/isa/ErasureCodeIsa.cc :: ErasureCodeIsaDefault::parse، prepare
پیچیدگی: O(k·m) ضرب GF برای هر دو
pseudocode
gf_gen_rs_matrix(a, rows=k+m, k):
a = 0 ; for i < k: a[i][i] = 1
gen = 1
for i in k .. rows-1:
p = 1
for j < k: a[i][j] = p ; p = p·gen # سطر i: توانهای gen
gen = gen·2
gf_gen_cauchy1_matrix(a, rows, k):
همانی در بالا ; for i in k..rows-1, j < k: a[i][j] = gf_inv(i ⊕ j)مثال عددی (k=4، m=2). Vandermonde: سطر P برابر [۱ ۱ ۱ ۱] است (gen = ۱) و سطر Q برابر [۱ ۲ ۴ ۸] (gen = ۲). پس P همان XOR ساده است. Cauchy: سطر ۴ برابر [inv(4) inv(5) inv(6) inv(۷)] = [۴۷ A7 7A BA] و سطر ۵ برابر [inv(5) inv(4) inv(7) inv(۶)] = [A7 47 BA 7A]. برای دادهی D = [۳۷ ۵C A1 0F]، با Vandermonde P = ۰xC5 و Q = ۰x49، و با Cauchy P = ۰xD1 و Q = ۰x09.
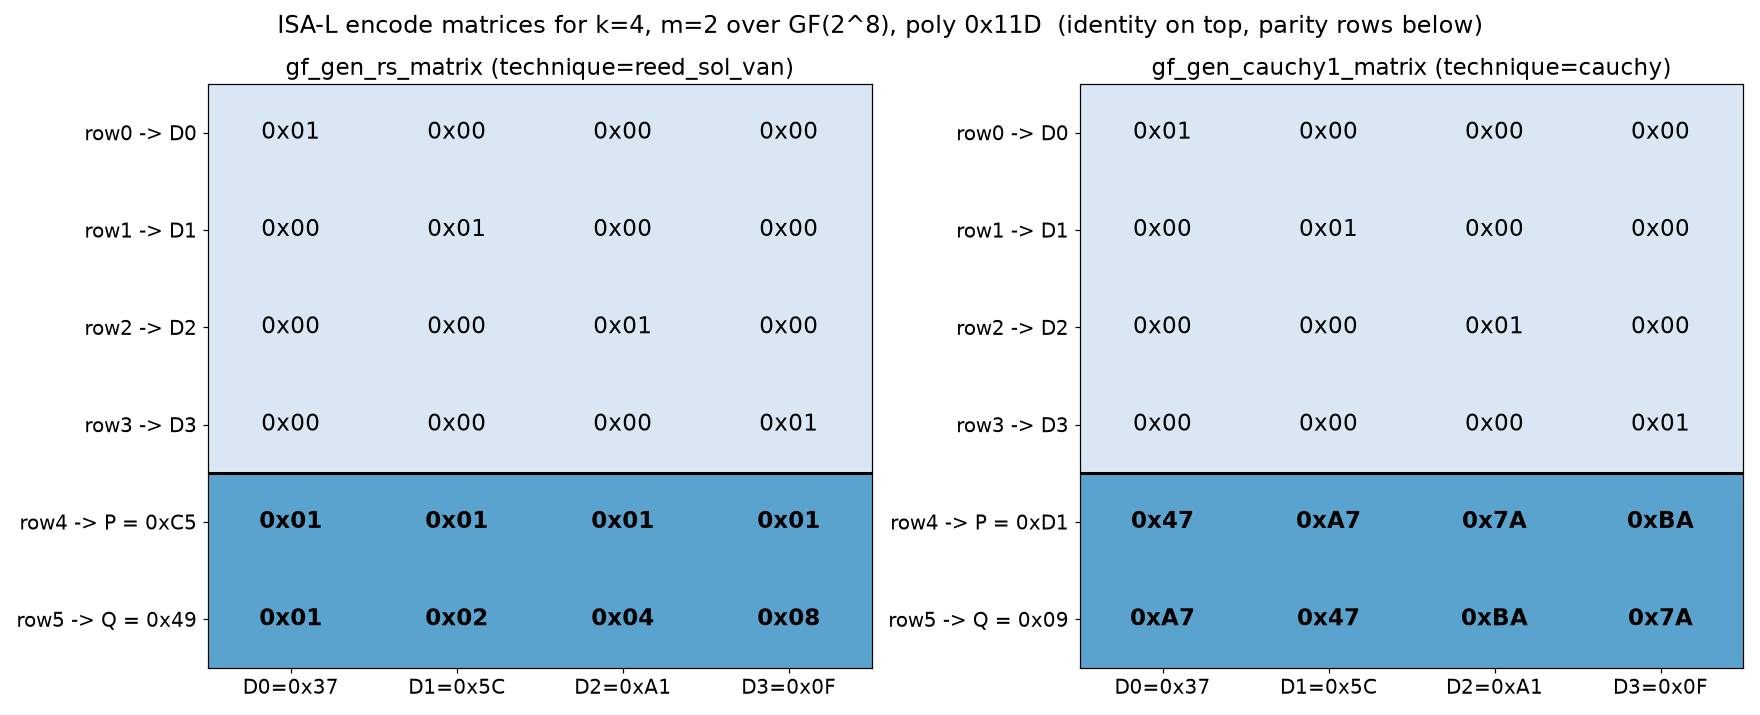
چرا Ceph محدودیت میگذارد. ماتریس gf_gen_rs_matrix یک Vandermonde «واقعی» نیست: سطرهای همانی روی آن گذاشته شدهاند و MDS بودنش برای همهی (k, m) تضمین نمیشود. خود ISA-L ابزار gen_rs_matrix_limits.c را برای یافتن حدها دارد. Ceph در ErasureCodeIsaDefault::parse این حدها را اعمال میکند: k ≤ ۳۲ و m ≤ ۳۲ (MAX_K و MAX_M). برای Vandermonde اگر m > ۴ باشد، یا m = ۴ و k > ۲۱، پیام هشدار میدهد و technique را خودکار به cauchy تغییر میدهد. یعنی پروفایل ذخیرهشده عوض میشود. با شبیهسازی جداگانه (حذف همهی ترکیبهای m سطری و آزمون وارونپذیری k×k باقیمانده) برای ۴+۲، ۶+۳، ۸+۳، ۸+۴، ۱۰+۴ و ۱۲+۴ هیچ زیرماتریس منفردی پیدا نشد (مثلاً ۱۰۰۱ ترکیب برای ۱۰+۴)، که با این حدها سازگار است.
۲۷-۱۰ decode با وارون ماتریس: یک مثال کامل بایتبهبایت#
منبع در کد: isa-l/erasure_code/ec_base.c :: gf_invert_matrix؛ src/erasure-code/isa/ErasureCodeIsa.cc :: ErasureCodeIsaDefault::isa_decode
پیچیدگی: وارون O(k³) ضرب GF برای هر الگوی خرابی (کش در LRU)، سپس O(k·e·L) برای e shard گمشده
pseudocode
B = سطرهای ماتریس تولید برای k shard سالم انتخابشده
Binv = gf_invert_matrix(B) # گاوس-جردن: محور، ضرب سطر در gf_inv، حذف با ⊕
for each lost data shard i: c_i = سطر i از Binv
for each lost parity shard p: c_p = (سطر p از ماتریس تولید) × Binv
ec_init_tables(k, e, c, decode_tbls) ; ec_encode_data(L, k, e, decode_tbls, survivors, outputs)مثال عددی. دادهی [۳۷ ۵C A1 0F] و parityهای Vandermonde P = C5 و Q = ۴۹ را داریم. D1 و D3 گم شدهاند و D0، D2، P و Q باقی ماندهاند. ابتدا سهم دادههای معلوم را کم میکنیم:
- P' = P ⊕ D0 ⊕ D2 = C5 ⊕ ۳۷ ⊕ A1 = ۰x53، که برابر D1 ⊕ D3 است.
- Q' = Q ⊕ D0 ⊕ ۴·D2 = ۴۹ ⊕ ۳۷ ⊕ BE = ۰xC0، که برابر ۲·D1 ⊕ ۸·D3 است.
با حذف D1: Q' ⊕ ۲·P' = (۸ ⊕ ۲)·D3 = ۰x0A·D3. داریم ۲·P' = ۰xA6 و Q' ⊕ ۰xA6 = ۰x66. پس D3 = ۰x66 · inv(۰x۰A) = ۰x66 · ۰xDD = ۰x0F و D1 = P' ⊕ D3 = ۰x5C. ماتریس وارونی که gf_invert_matrix برای سطرهای {۰, ۲, P, Q} میسازد، برای D3 سطر [۷A F4 A7 DD] و برای D1 سطر [۷B F5 A6 DD] دارد. ضرب آنها در [۳۷ A1 C5 49] همین دو عدد را میدهد.
۲۷-۱۱ بهروزرسانی parity با دلتا (Tentacle)#
در EC قدیمی، نوشتن جزئی کل stripe را میخواند (بخش read-modify-write). مسیر EC بهینه در Tentacle، برای پلاگینهایی که پرچم FLAG_EC_PLUGIN_PARITY_DELTA_OPTIMIZATION را اعلام میکنند، از خطی بودن کد استفاده میکند. تغییر یک shard داده فقط parityها را به اندازهی ضریبِ همان ستون ضرب در دلتا تغییر میدهد.
منبع در کد: src/erasure-code/isa/ErasureCodeIsa.cc :: ErasureCodeIsaDefault::encode_delta، apply_delta؛ isa-l :: ec_encode_data_update
پیچیدگی: O(m·L) به جای O(k·m·L)؛ خواندن ۱ + m بازه به جای k بازه
pseudocode
encode_delta(old, new):  Δ = old ⊕ new                    # isa_xor با دو بردار
apply_delta(in = {i: Δ_i, p: P_p}, out):
    for each data shard i با دلتا:
        for each parity p:
            if m == 1:  P_p ^= Δ_i                          # ستون همه 1
            else: ec_encode_data_update(L, k, 1, i, tbls + 32·k·(p−k), Δ_i, &P_p)
                  # P_p ^= a[p][i]·Δ_i
مثال عددی. D1 از ۰x5C به ۰xA5 تغییر میکند، پس Δ = ۰x5C ⊕ ۰xA5 = ۰xF9. در Vandermonde ضرایب ستون ۱ برای P و Q برابر ۱ و ۲ هستند: P_new = C5 ⊕ F9 = ۰x3C و Q_new = ۴۹ ⊕ ۲·F9 = ۴۹ ⊕ EF = ۰xA6. محاسبهی کامل از صفر با دادهی جدید هم دقیقاً ۳C و A6 میدهد. در Cauchy ضرایب ستون ۱ برابر A7 و ۴۷ هستند و نتیجه ۰x17 و ۰x70 میشود، که آن هم با محاسبهی کامل یکی است. برای نوشتن ۴K در ۸+۳، مسیر قدیمی ۸ خواندن ۴K (یا کل stripe) لازم داشت، اما مسیر دلتا ۱ + ۳ = ۴ خواندن و ۴ نوشتن دارد.
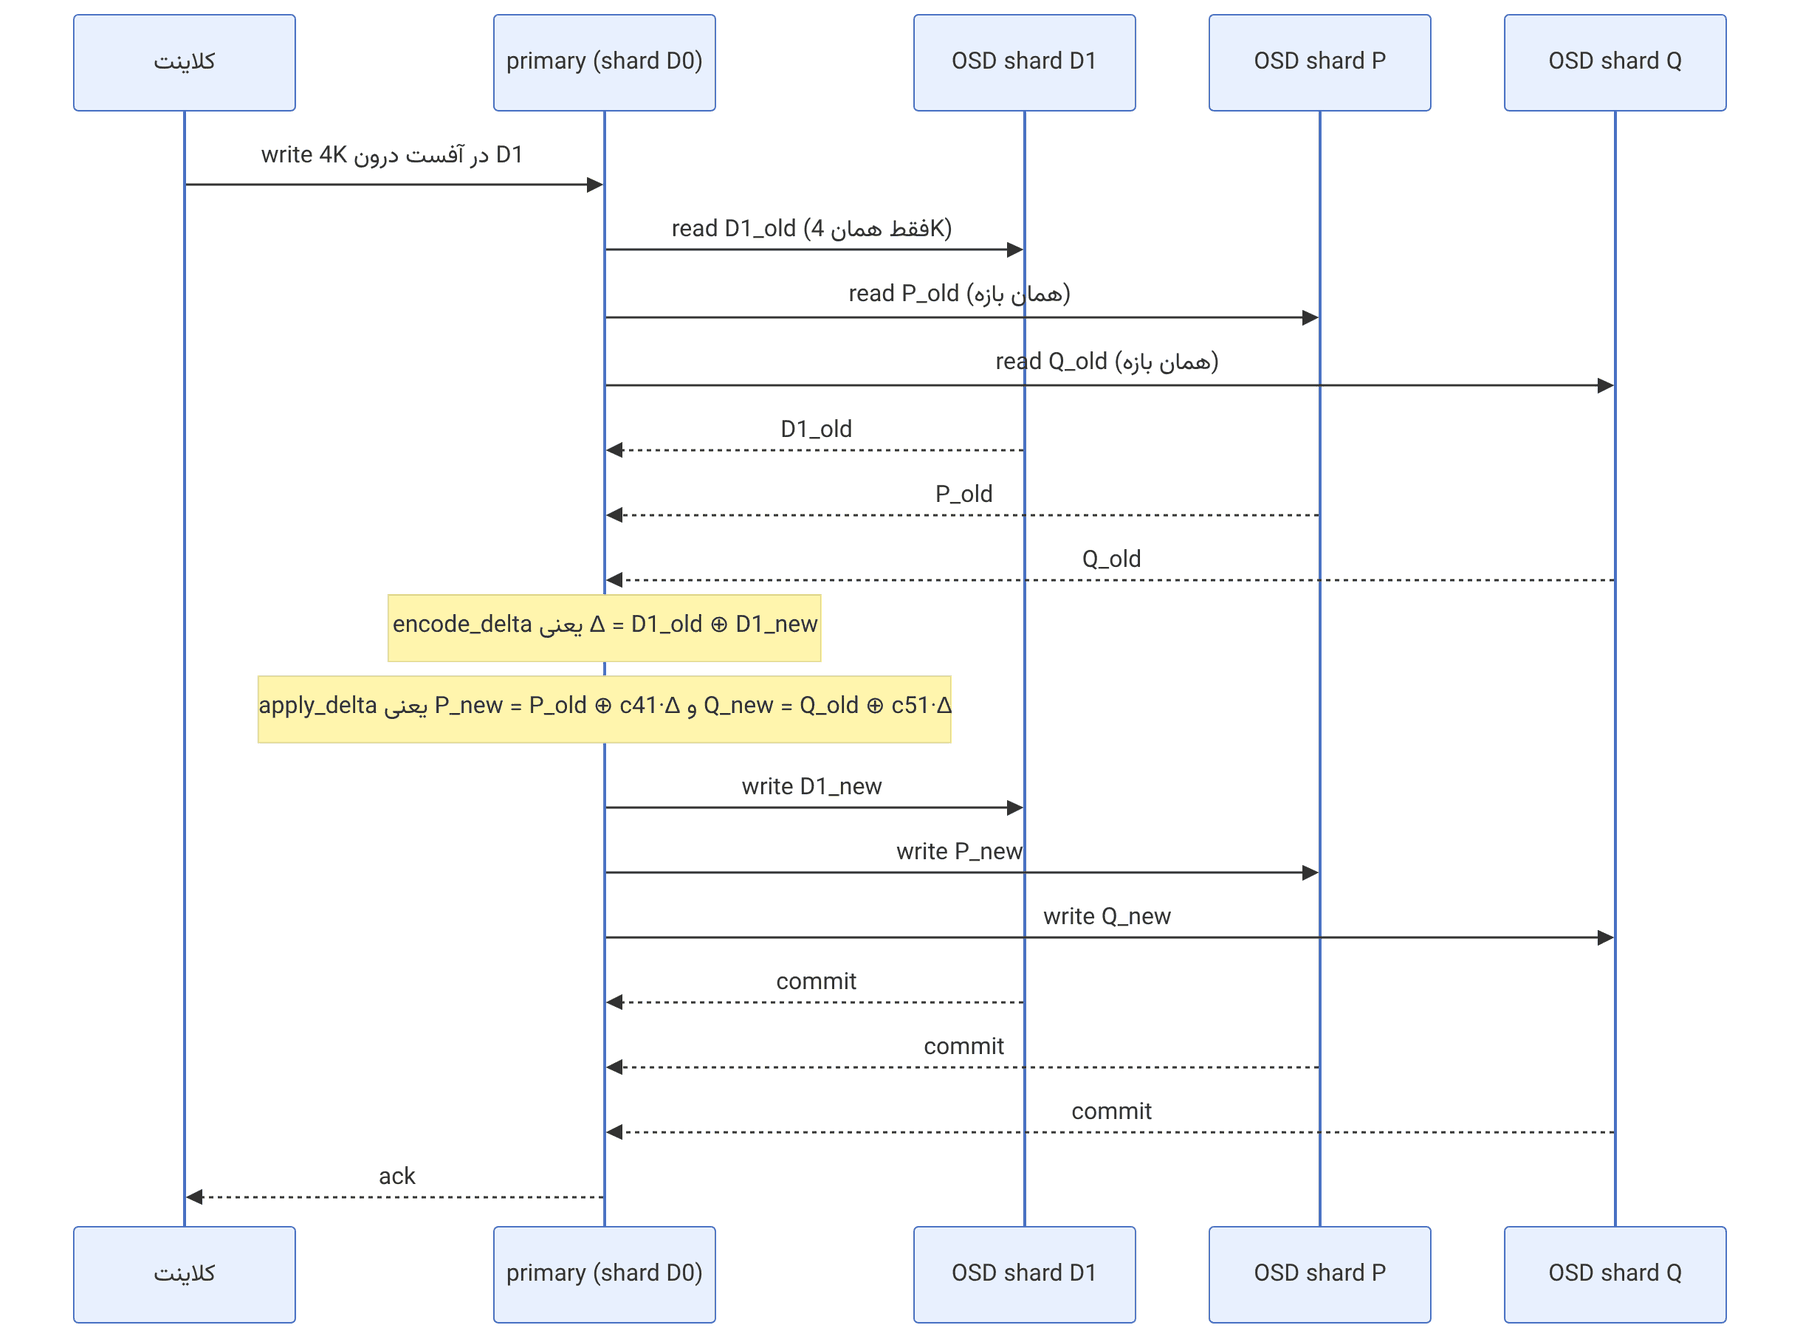
دلتا فقط وقتی درست است که مقدار قدیمی خواندهشده دقیقاً همان مقداری باشد که parity فعلی با آن ساخته شده است. اگر shard ناسازگار باشد (مثلاً پس از خطای نیمهکاره)، دلتا خطا را منتشر میکند. به همین دلیل scrub عمیق در poolهای EC (فصل ۳۲) و crc هر shard (بخش crc در همین فصل) اهمیت بیشتری پیدا میکنند.
۲۷-۱۲ LRC: از k، m و l تا رشتهی لایهها#
منبع در کد: src/erasure-code/lrc/ErasureCodeLrc.cc :: ErasureCodeLrc::parse_kml
پیچیدگی: O(k+m) برای ساخت رشتهها؛ ترمیم محلی l خواندن به جای k
pseudocode
require (k+m) % l == 0 ; g = (k+m)/l ; require k % g == 0 and m % g == 0
mapping = repeat g: 'D'×(k/g) + '_'×(m/g) + '_'
global  = repeat g: 'D'×(k/g) + 'c'×(m/g) + '_'
local_i = for j < g: (i==j) ? 'D'×l + 'c' : '_'×(l+1)
if crush-locality: steps = [choose g type locality, chooseleaf (l+1) type failure-domain]
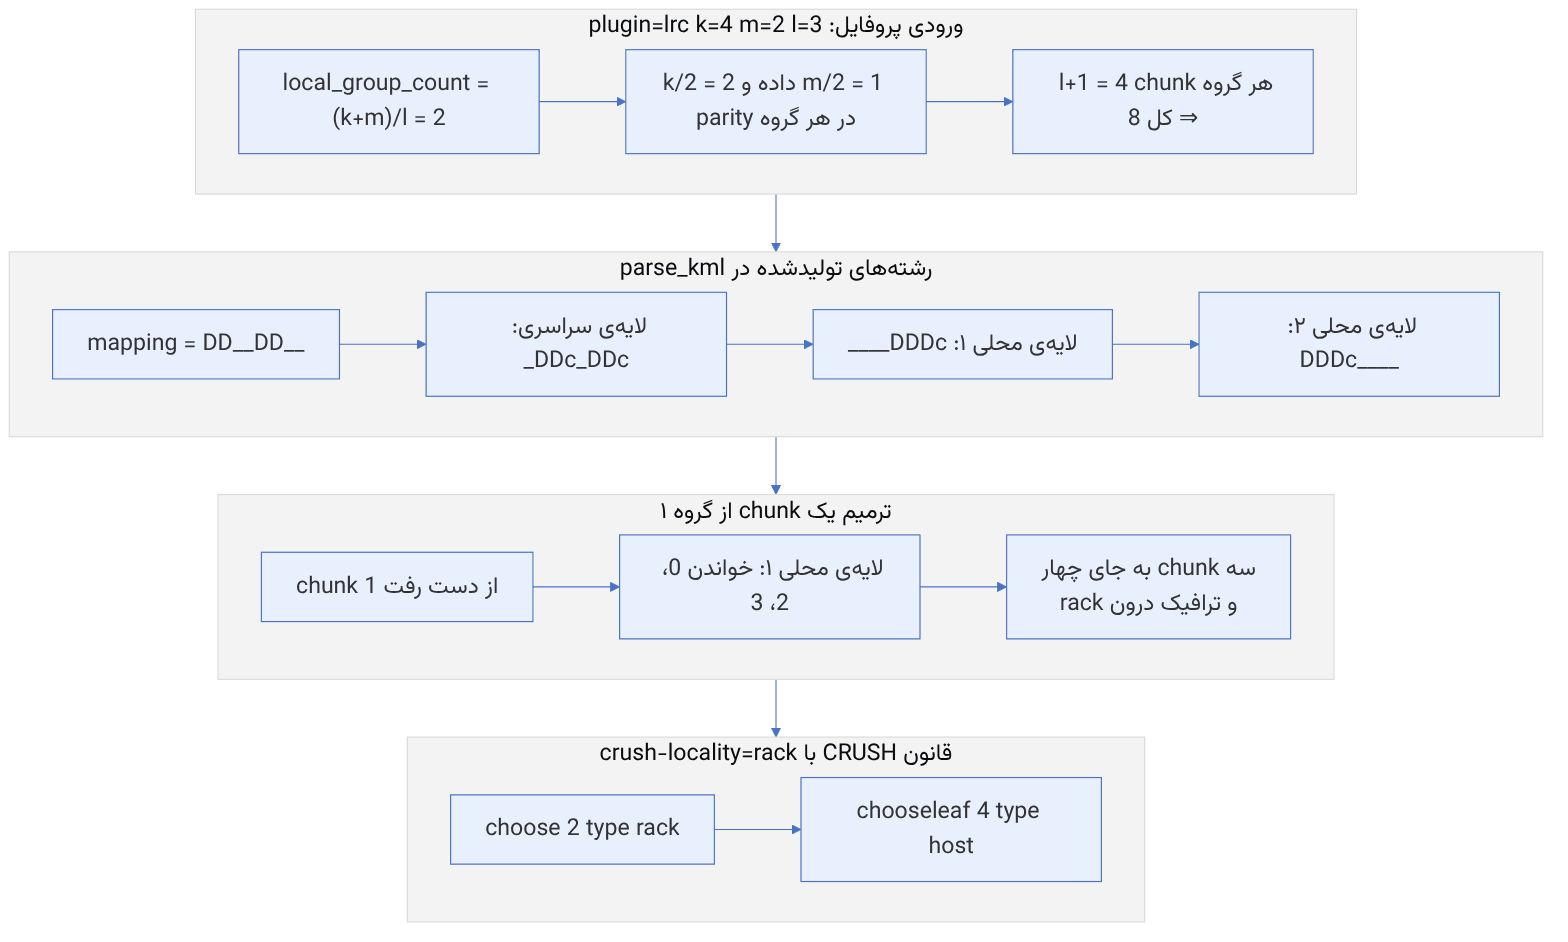
مثال عددی. با k=4، m=2 و l=3: g = ۶/۳ = ۲ و هر گروه ۲ داده، ۱ parity سراسری و ۱ parity محلی دارد. کل chunkها ۴ + ۲ + ۲ = ۸ است. نتیجه: mapping = DD__DD__، لایهی سراسری DDc_DDc_ و لایههای محلی DDDc____ و ____DDDc. سربار فضا ۸/۴ = ۲ برابر است (در برابر ۱.۵ برای ۴+۲ ساده). در مقابل، ترمیم یک chunk به جای ۴ خواندن فقط ۳ خواندن از همان گروه لازم دارد.
۲۷-۱۳ Clay: کدام sub-chunkها برای ترمیم خوانده میشوند#
منبع در کد: src/erasure-code/clay/ErasureCodeClay.cc :: ErasureCodeClay::parse، get_repair_subchunks، get_repair_sub_chunk_count
پیچیدگی: O(qʸ) بازه برای گره گمشده در سطر y؛ ترافیک d·(sub_chunk_no/q) sub-chunk
pseudocode
q = d − k + 1 ; nu = (k+m) % q ? q − (k+m) % q : 0
t = (k+m+nu)/q ; sub_chunk_no = q^t
get_repair_subchunks(lost):
    y = lost / q ; x = lost % q
    seq = q^(t−1−y) ; num = q^y ; idx = x·seq
    repeat num times: emit [idx, idx+seq) ; idx += q·seq
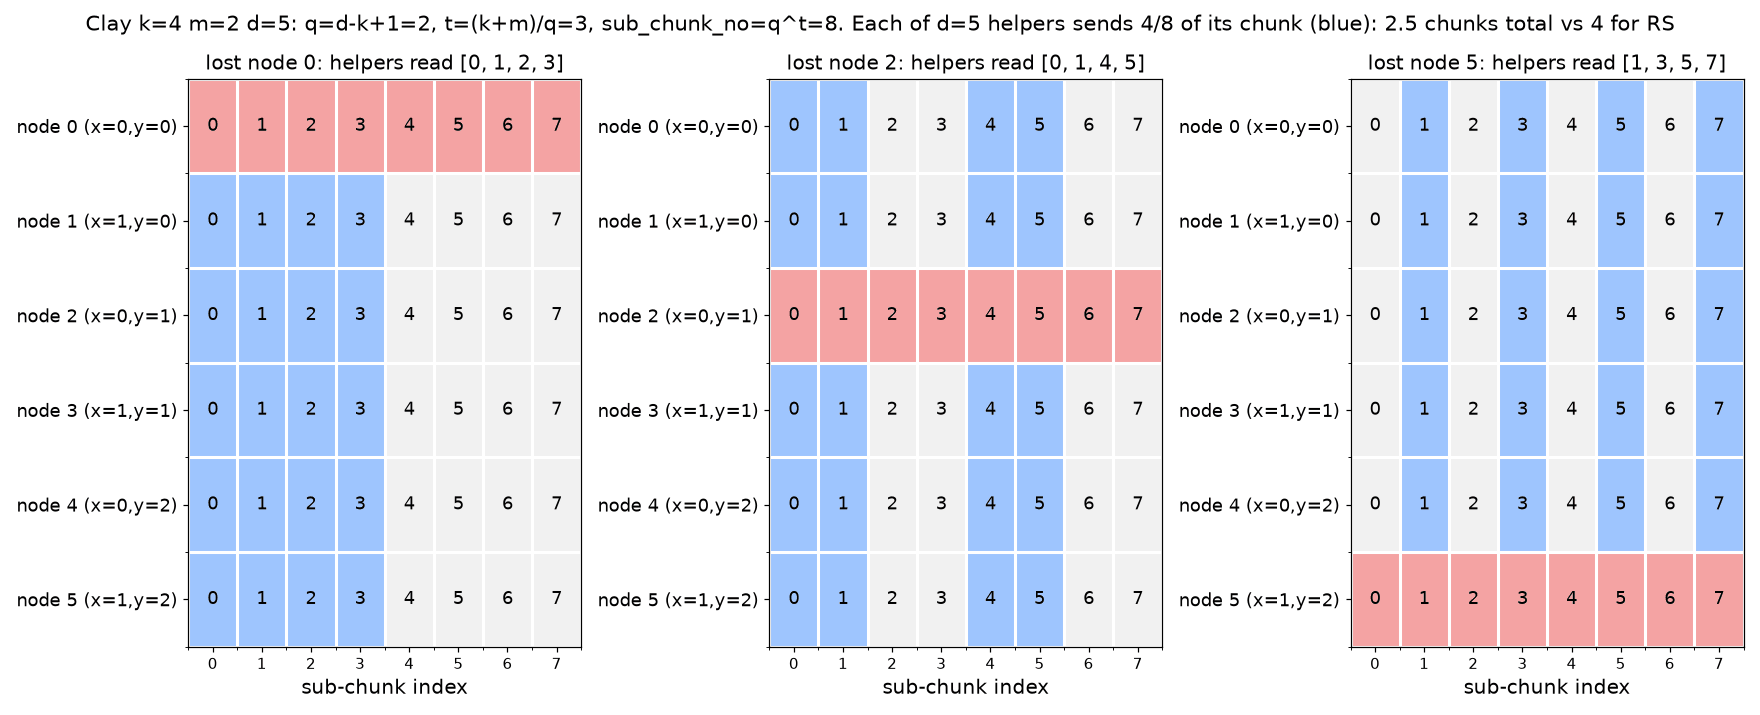
مثال عددی. k=4، m=2، d=5 ⇒ q = ۲، nu = ۰، t = ۳ و sub_chunk_no = ۸. برای گره ۰ (x=0، y=0): seq = ۴ و num = ۱، پس sub-chunkهای ۰ تا ۳. برای گره ۲ (x=0، y=1): seq = ۲ و num = ۲، پس {۰، ۱، ۴، ۵}. برای گره ۵ (x=1، y=2): seq = ۱ و num = ۴، پس {۱، ۳، ۵، ۷}. هر یک از ۵ helper نصف chunk خود را میفرستد، یعنی ۲.۵ chunk در برابر ۴ chunk در RS. یک chunk چهار مگابایتی با ۲.۵ × ۴ = ۱۰ MiB به جای ۱۶ MiB ترمیم میشود.
در Clay، چون خواندنها به بازههای کوچک (sub_chunk_no برابر) شکسته میشوند، اندازهی stripe_unit باید آنقدر بزرگ باشد که هر sub-chunk دستکم چند کیلوبایت شود. اگر chunk فقط ۴K باشد و sub_chunk_no = ۸، هر sub-chunk فقط ۵۱۲ بایت میشود (اندازهی واقعی chunk را get_chunk_size با همترازی sub_chunk_no·k گرد میکند).
۲۷-۱۴ تکمیلی و بهروز#
- پیشفرض پلاگین: در Squid
plugin=jerasure، و در Tentacle و main plugin=isa (هر دو با technique=reed_sol_van k=2 m=2). این تغییر را در کد global.yaml.in هر دو شاخه بررسی کردهایم. - EC بهینه: کد main کلاس
ECSwitch را دارد که بهعنوان «سوئیچ موقت» میان backend قدیمی (ECBackendL) و جدید (ECBackend) توصیف شده است. طبق توضیح خود کد، پس از اطمینان کامل، backend قدیمی حذف خواهد شد. - EC و stretch cluster: کارهای پشتیبانی EC در stretch mode در شاخهی main ادامه دارد. پیش از استفاده، یادداشتهای انتشار نسخهی هدف را بخوانید.
۲۷-۱۵ تمرین عملی#
- ۱. ضرب با ۰x11D را در پایتون پیاده کنید و جدول ضربهای این فصل را بازتولید کنید. سپس decode با دو خرابی را برای الگوی دیگری (مثلاً D0 و P1) حل کنید.
- ۲. با
ceph_erasure_code_benchmark (در بستهی تستها) سرعت encode پلاگینهای isa و jerasure را برای k=8 و m=3 روی سرور خود مقایسه کنید. - ۳. روی یک pool آزمایشی EC با و بدون
allow_ec_optimizations، fio با نوشتن تصادفی ۴K اجرا و IOPS و تأخیر را مقایسه کنید. - ۴. پهنای باند ترمیم CLAY را برای (k=6، m=3، d=8) محاسبه و با RS مقایسه کنید.
۲۷-۱۶ پرسشهای مرور#
- ۱. چرا جمع و تفریق در هر دو XOR هستند؟
- ۲. ۰x56 × ۰x04 در با ۰x11D چگونه محاسبه میشود؟
- ۳. کد MDS چیست و چرا Vandermonde سادهی ISA-L همیشه MDS نیست؟
- ۴. Ceph در چه شرایطی خودکار به cauchy تغییر میدهد؟
- ۵. در مثال این فصل، P0 و P1 چگونه به دست آمدند؟
- ۶. چرا ضرایب decode کش میشوند؟
- ۷. PSHUFB چگونه ضرب در ثابت را سریع میکند؟
- ۸. parity delta چیست و چرا درست است؟
- ۹. stripe_unit پیشفرض در pool بهینه چقدر است و چرا؟
- ۱۰. پهنای باند ترمیم CLAY با k=8، m=4 و d=11 چقدر است و هزینهی آن چیست؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۷-۱۷ منابع این فصل#
- مستندات erasure code
https://docs.ceph.com/en/latest/rados/operations/erasure-code/ - پروفایلها
https://docs.ceph.com/en/latest/rados/operations/erasure-code-profile/ - پلاگین CLAY
https://docs.ceph.com/en/latest/rados/operations/erasure-code-clay/ - پلاگین LRC
https://docs.ceph.com/en/latest/rados/operations/erasure-code-lrc/ - پلاگین SHEC
https://docs.ceph.com/en/latest/rados/operations/erasure-code-shec/ - ErasureCodeIsa.cc
https://github.com/ceph/ceph/blob/main/src/erasure-code/isa/ErasureCodeIsa.cc - ISA-L ec_base.c
https://github.com/intel/isa-l/blob/master/erasure_code/ec_base.c - مقالهی Clay codes (FAST ۲۰۱۸
https://www.usenix.org/conference/fast18/presentation/vajha - آموزش Reed-Solomon (Plank
https://web.eecs.utk.edu/~jplank/plank/papers/CS-96-332.html