تنظیم کارایی Ceph: از mClock تا هسته و شبکه
حوصله ندارم این فصل در چند خط
- اول پایهها را بررسی کنید: اشباع شبکه، دستگاه block.db و حالت صرفهجویی انرژی CPU بیشتر مشکلات کارایی را حل میکنند.
- OSD، PGها را میان shardها و threadها پخش میکند؛ mClock (زمانبند پیشفرض از Quincy) ظرفیت را میان I/O کلاینت، recovery و scrub تقسیم میکند.
-
osd_memory_target (بهطور پیشفرض ۴ گیگابایت) بودجهی حافظهی هر OSD است و تنظیم خودکار cache در BlueStore از آن پیروی میکند. - سیستمعامل، شبکه (MTU یکسان) و CPU را تنظیم کنید و همیشه صدکهای تأخیر (p99 و p99.9) را گزارش کنید، نه فقط میانگین را.
۲۱-۱ پیش از شروع#
۲۱-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
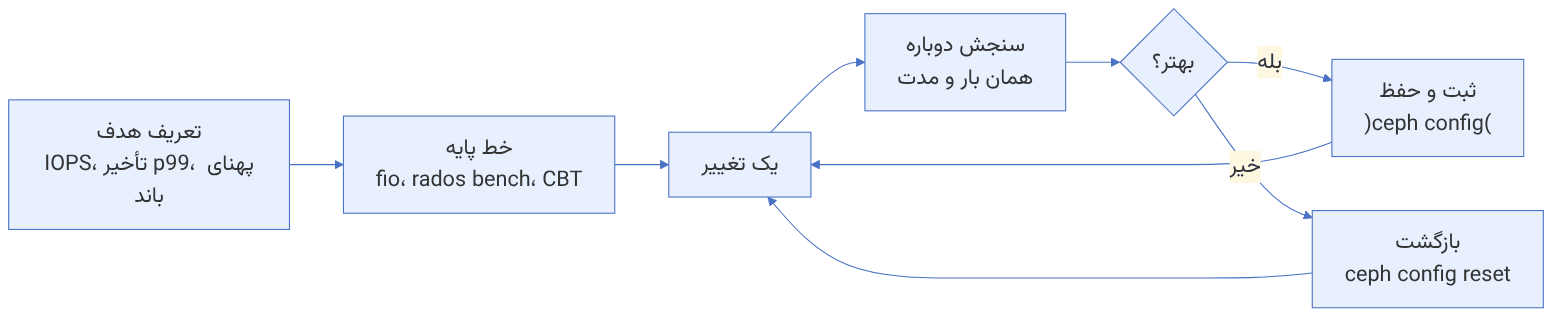
تنظیم کارایی در Ceph بیش از هر چیز یک روش است: هدف را تعریف کنید، خط پایه بگیرید، یک تغییر بدهید و دوباره بسنجید. بسیاری از «توصیههای تنظیم» رایج در اینترنت مربوط به FileStore، WPQ یا نسخههای پیش از Quincy هستند و امروز یا بیاثرند یا آسیب میزنند. این فصل بر سازوکارهای امروزی تمرکز دارد:
- لایههای کارایی کداماند و از کجا شروع کنیم؟
- OSD چگونه درخواستها را بین شاردها و threadها پخش میکند؟
- زمانبند mClock با چه الگوریتمی بین کلاینت و بازیابی تعادل برقرار میکند و پروفایلها چه میکنند؟
- حافظهی OSD و کش BlueStore را چگونه تنظیم کنیم؟
- تنظیمات سیستمعامل، شبکه و CPU کداماند؟
- چگونه با fio، rados bench و CBT اندازه بگیریم؟
۲۱-۲ روش و لایهها#
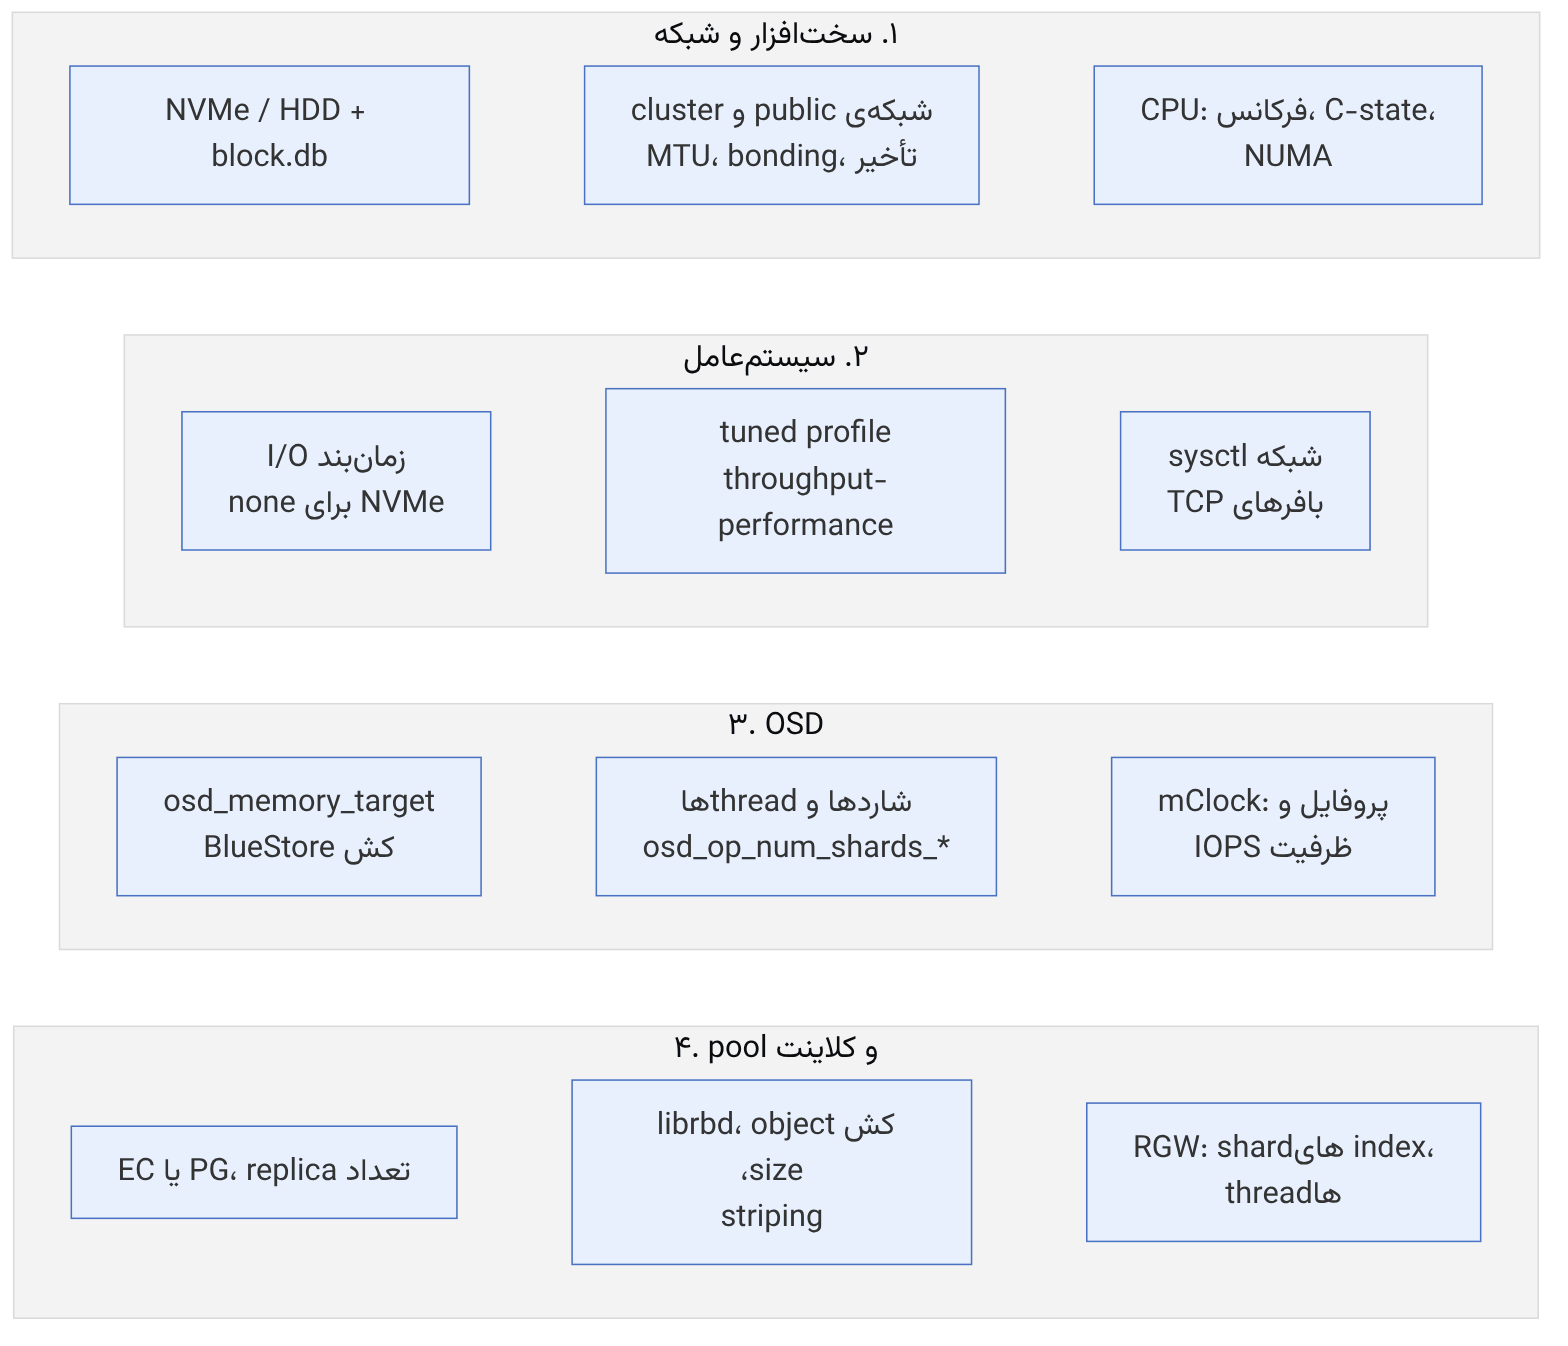
پیش از هر تنظیم نرمافزاری، سه پرسش را پاسخ دهید: آیا شبکهی cluster اشباع است؟ آیا دیسکها (بهویژه block.db) گلوگاهاند؟ آیا CPU در حالت ذخیرهی انرژی است؟ در تجربهی عملی، بیشتر مشکلات کارایی با پاسخ به همین سه پرسش حل میشوند.
۲۱-۳ از درون کد: شاردها و threadها#
۲۱-۳-۱ مسیر درخواست در OSD#
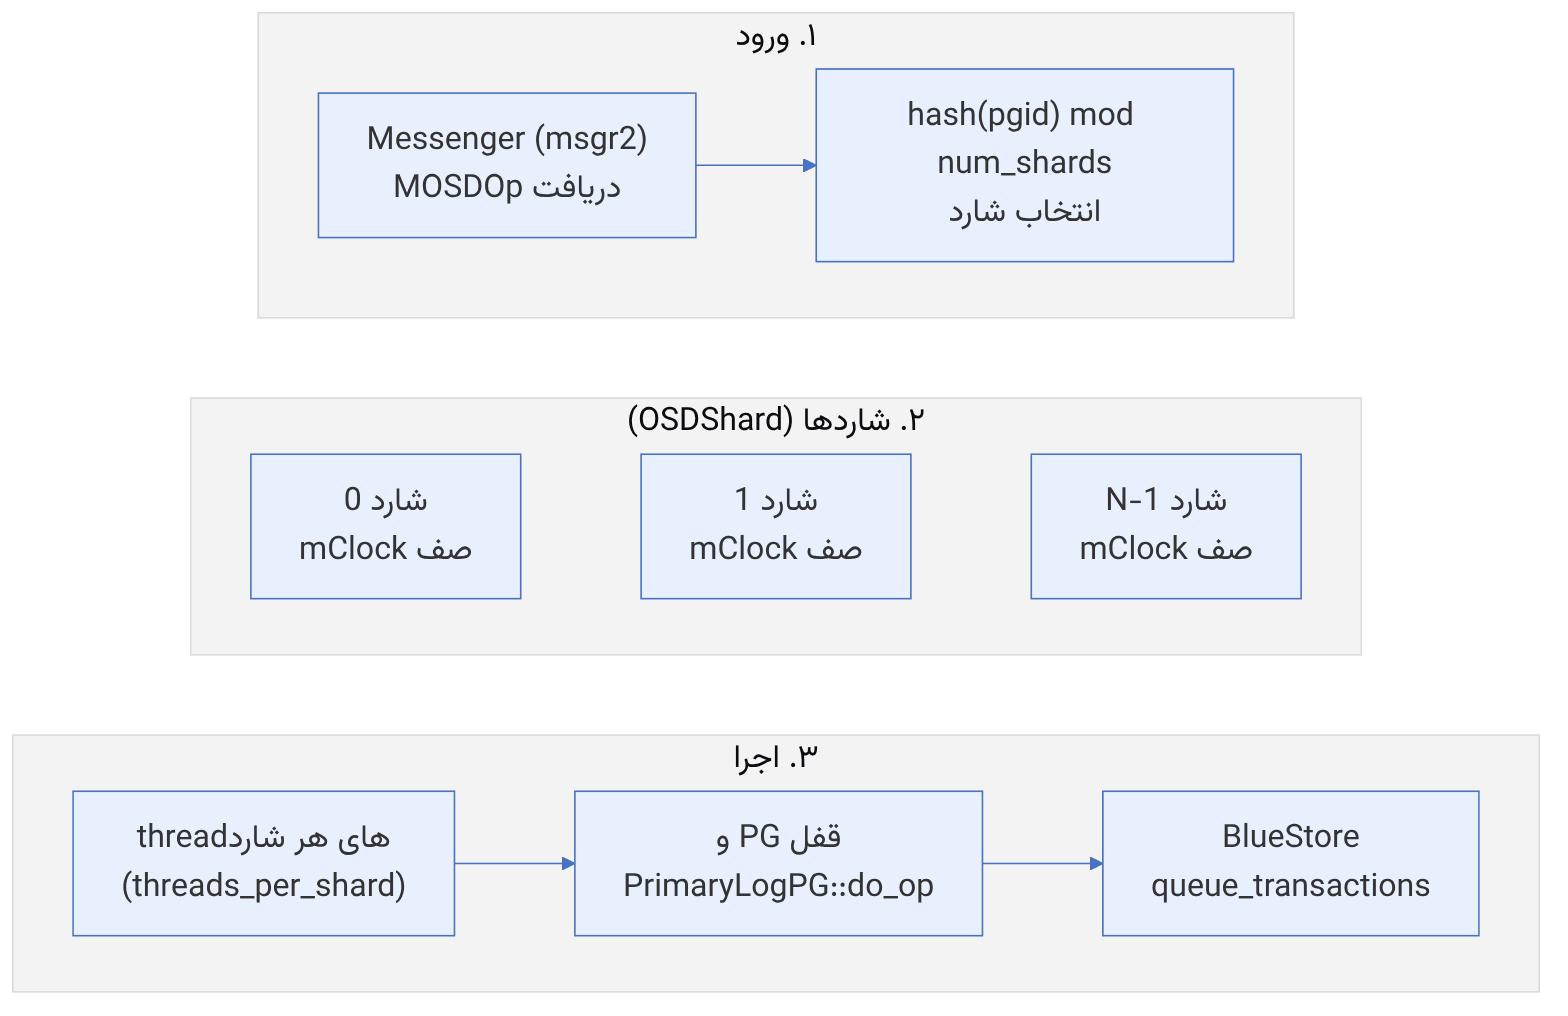
OSD درخواستها را بین چند شارد (struct OSDShard در src/osd/OSD.h) پخش میکند. شارد هر PG با pgid.hash_to_shard(num_shards) تعیین میشود؛ بنابراین همهی عملیات یک PG همیشه در یک شارد پردازش میشوند و ترتیب حفظ میشود. هر شارد صف زمانبندی خود و چند thread دارد.
| گزینه | پیشفرض از v19.2.1 (Squid) و در Tentacle و Umbrella | پیشفرض در v19.2.0 |
|---|---|---|
| osd_op_num_shards_hdd | ۱ | ۵ |
| osd_op_num_threads_per_shard_hdd | ۵ | ۱ |
| osd_op_num_shards_ssd | ۸ | ۸ |
| osd_op_num_threads_per_shard_ssd | ۲ | ۲ |
وابسته به نسخه. مقادیر جدول از src/common/options/osd.yaml.in در برچسبهای v19.2.0 تا v19.2.3، v20.2.0 و v21.2.0 خوانده شدهاند. برای HDD، یک شارد با پنج thread جایگزین پنج شارد تکthreadی شده است. این تغییر در نسخهی نقطهای v19.2.1 به Squid هم رسیده است، پس فقط v19.2.0 مقدار قدیمی را دارد. دلیل منطقی: با یک شارد، زمانبند mClock دید کامل از همهی درخواستهای آن OSD دارد و میتواند رزرو و سهم کلاینت و بازیابی را دقیقتر رعایت کند؛ با چند شارد، هر شارد فقط بخشی از ظرفیت را میبیند. این گزینهها فقط با راهاندازی دوبارهی OSD اعمال میشوند.
افزایش کورکورانهی شاردها یا threadها روی NVMe سریع، اغلب فقط مصرف CPU و رقابت قفل را بالا میبرد. اگر CPU اشباع نیست و دیسک هم نیست، گلوگاه احتمالاً جای دیگری است (شبکه، کلاینت، یا یک PG داغ).
۲۱-۴ از درون کد: mClock#
۲۱-۴-۱ الگوریتم dmClock#
از Quincy، زمانبند پیشفرض OSD mclock_scheduler است (osd_op_queue). این زمانبند بر پایهی کتابخانهی dmclock (src/dmclock/) است که الگوریتم mClock را پیاده میکند. هر کلاس سرویس سه پارامتر دارد:
- reservation: حداقل سهم تضمینشده (IOPS)،
- weight: سهم نسبی از ظرفیت اضافه،
- limit: سقف سهم.
هر درخواست سه برچسب زمانی (R، P، L) میگیرد. محاسبهی برچسب در dmclock:
// from ceph/ceph, LGPL — src/dmclock/src/dmclock_server.h, RequestTag::tag_calc (excerpt)
if (0.0 == increment) {
  return extreme_is_high ? max_tag : min_tag;
} else {
  double tag_increment = increment * (uint64_t(dist_req_val) + cost);
  return std::max(time, prev + tag_increment);
}increment معکوس پارامتر است (۱/reservation، ۱/weight یا ۱/limit) و cost هزینهی درخواست. بنابراین کلاسی با reservation بزرگتر، برچسبهای R نزدیکتر به هم میگیرد و درخواستهایش زودتر «سررسید» میشوند. max(time, ...) تضمین میکند کلاسی که مدتی بیکار بوده، با برچسبهای قدیمی «اعتبار انباشته» نداشته باشد.
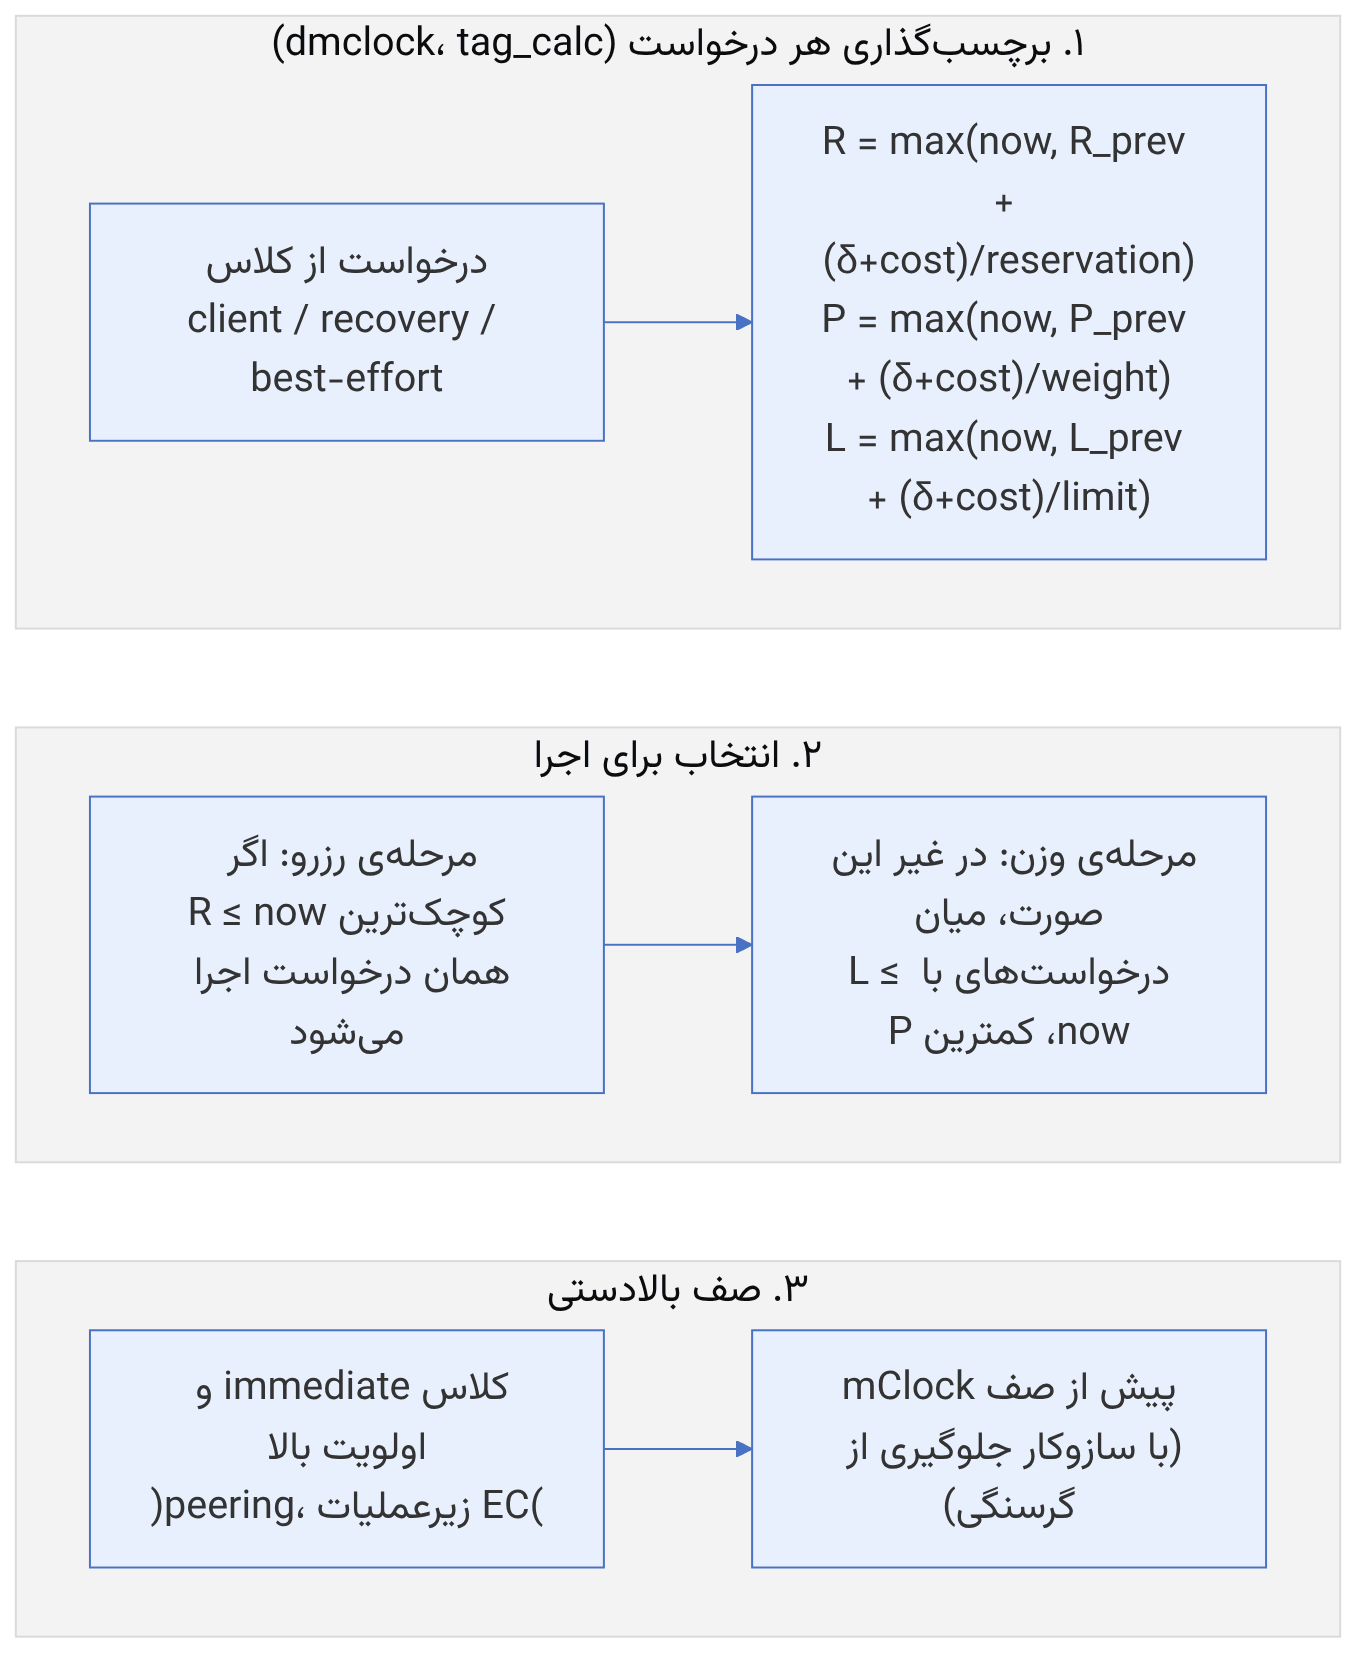
pseudocode: انتخاب درخواست بعدی (خلاصهی این کتاب از dmclock)
now = clock()
r = queue.min_by(R)
if r.R <= now: return r # مرحلهی رزرو: تضمین حداقلها
eligible = [q for q in queue if q.L <= now] # از سقف عبور نکردهاند
if eligible: return eligible.min_by(P) # تقسیم ظرفیت اضافه بر اساس وزن
return none # همه به سقف رسیدهاند → صبر تا سررسید۲۱-۴-۲ پروفایلها#
پروفایل mClock پارامترهای سه کلاس (client، background recovery، background best-effort) را بهصورت درصدی از ظرفیت OSD تنظیم میکند. مقادیر زیر از صفحهی mClock Config Reference مستندات latest است:
| پروفایل | client (R / W / L) | recovery (R / W / L) | best-effort (R / W / L) |
|---|---|---|---|
| balanced (پیشفرض) | ۵۰٪ / ۱ / MAX | ۵۰٪ / ۱ / MAX | ۵٪ / ۲ / ۹۰٪ |
| high_client_ops | ۶۰٪ / ۲ / MAX | ۴۰٪ / ۱ / MAX | ۵٪ / ۴ / ۷۰٪ |
| high_recovery_ops | ۳۰٪ / ۱ / MAX | ۷۰٪ / ۲ / MAX | ۵٪ / ۲ / MAX |
| custom | دستی | دستی | دستی |
ceph config get osd osd_mclock_profile
ceph config set osd osd_mclock_profile high_client_ops      # ساعات اوج
ceph config set osd osd_mclock_profile high_recovery_ops    # بازیابی سریع در شب
ceph config show osd.0 | grep -E "osd_mclock_max_capacity_iops|osd_mclock_scheduler"برای ظرفیت، mClock عدد IOPS هر OSD را لازم دارد. هنگام شروع OSD، اگر مقدار osd_mclock_max_capacity_iops_[hdd|ssd] پیشفرض باشد و osd_mclock_skip_benchmark خاموش باشد، OSD یک سنجش داخلی اجرا میکند (طبق توضیح کد در OSD.cc: نوشتن ۱۰۰ شیء ۴ مگابایتی با بلوک ۴ کیلوبایتی). اگر نتیجه بیرون از بازهی آستانهها باشد (برای HDD بین ۵۰ و ۵۰۰، برای SSD بین ۱۰۰۰ و ۸۰۰۰۰؛ گزینههای osd_mclock_iops_capacity_[low_]threshold_*)، نتیجه کنار گذاشته و مقدار پیشفرض (۳۱۵ برای HDD و ۲۱۵۰۰ برای SSD) به کار میرود.
در پروفایلهای داخلی، mClock تنظیمات بازیابی مانند osd_max_backfills و osd_recovery_max_active را خودش مدیریت میکند و تغییر مستقیم آنها نادیده گرفته میشود، مگر اینکه osd_mclock_override_recovery_settings را فعال کنید (پیشفرض false). همچنین طبق مستندات، با فعال بودن هر پروفایل mClock (حتی custom)، گزینههای sleep قدیمی مانند osd_recovery_sleep غیرفعال (صفر) میشوند. این یکی از رایجترین سردرگمیها پس از ارتقا از نسخههای WPQ است: «osd_max_backfills را بالا بردم ولی سرعت backfill تغییر نکرد.»
صف immediate: برخی درخواستها (مانند peering و زیرعملیات EC بین shardها) پیش از صف mClock و مستقل از پارامترهای آن پردازش میشوند. مستندات latest توضیح میدهد که زیر بار سنگین مداوم، این صف ممکن بود همیشه پر بماند و صف mClock هرگز نوبت نگیرد؛ در pool EC این به گرسنگی کامل کارهای best-effort مانند deep-scrub منجر میشد (tracker شمارهی ۶۹۰۷۸) و سازوکار جلوگیری از گرسنگی برای آن افزوده شده است. اگر روی نسخهی قدیمیتر هستید و deep scrub در pool EC پرکار عقب میافتد، این مسئله را در نظر داشته باشید.
۲۱-۵ حافظهی OSD#
osd_memory_target (پیشفرض ۴ گیگابایت) هدف مصرف حافظهی هر OSD است و BlueStore با bluestore_cache_autotune (پیشفرض true) کشهای onode، داده و RocksDB را درون این بودجه تنظیم میکند (فصل ۱۲). در cephadm، طبق مستندات OSD، osd_memory_target_autotune بهطور پیشفرض برای OSDهای جدید فعال میشود و cephadm هدف هر OSD را از حافظهی میزبان ضرب در mgr/cephadm/autotune_memory_target_ratio (پیشفرض ۰.۷ در کد cephadm)، منهای حافظهی سایر daemonها، تقسیم بر تعداد OSDها تعیین میکند.
ceph config get osd osd_memory_target
ceph orch host ls --detail # حافظهی میزبانها
ceph config set osd/host:stor-a1 osd_memory_target 8G
ceph daemon osd.3 dump_mempools | jq '.mempool.by_pool | to_entries | sort_by(-.value.bytes) | .[0:5]'برای OSDهای NVMe با بار متادیتای سنگین (RGW با اشیای کوچک، CephFS)، حافظهی بیشتر (۸ تا ۱۶ گیگابایت) اثر محسوسی دارد، چون onodeهای بیشتری در کش میمانند. برای HDD، معمولاً پیشفرض کافی است و گلوگاه خود دیسک است.
۲۱-۶ لایهی پایینتر: حلقهی کنترل حافظه و throttle در BlueStore#
دو حلقهی کنترل کمتر دیدهشده بخش بزرگی از رفتار کارایی یک OSD را تعیین میکنند. اولی حافظهی cacheها را با مصرف واقعی heap تطبیق میدهد. دومی تعیین میکند چند تراکنش همزمان میتواند وارد BlueStore شود. هر دو در کد چند خط سادهاند، ولی اثرشان در سطح خوشه بزرگ است.
۲۱-۶-۱ osd_memory_target چگونه اعمال میشود؟#
osd_memory_target سقف سخت نیست، هدف یک حلقهی کنترل است. thread حافظهی BlueStore (MempoolThread) ابتدا مرزهای بودجهی cache را حساب میکند (در BlueStore.cc) و سپس PriorityCache::Manager::tune_memory در هر دور بودجه را به سمت هدف هل میدهد.
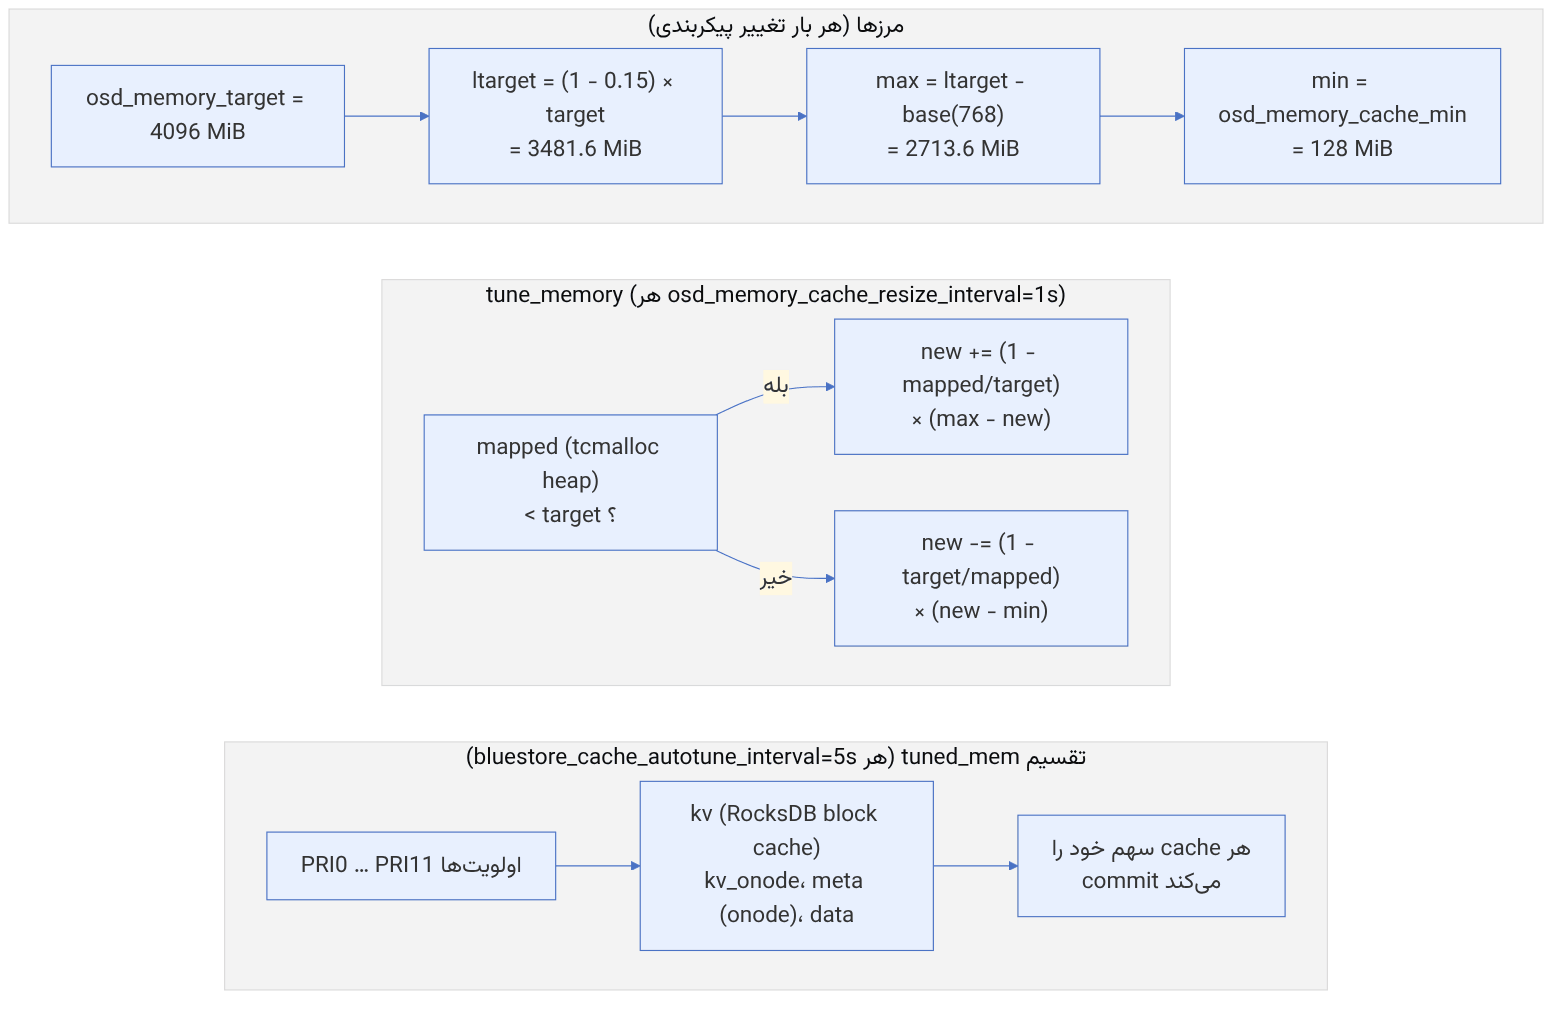
pseudocode: مرزها و یک گام tune_memory (بازنویسی این کتاب)
ltarget = (1 - expected_fragmentation) * target
min = cache_min
max = ltarget - base if ltarget > base + min else min
new = clamp(tuned, min, max)
if mapped < target: new += (1 - mapped/target) * (max - new) # رشد، کندتر وقتی به هدف نزدیک است
else: new -= (1 - target/mapped) * (new - min) # کوچک شدن متناسب با بیشمصرف
tuned = newمثال عددی با پیشفرضها#
با osd_memory_target=4G، osd_memory_base=768M، osd_memory_cache_min=128M و osd_memory_expected_fragmentation=0.15:
| گام | ورودی | محاسبه | نتیجه |
|---|---|---|---|
| مرز | target=4096 MiB | ۰.۸۵×۴۰۹۶ | ltarget=3481.6 MiB |
| مرز | base=768 | ۳۴۸۱.۶−۷۶۸ | max=2713.6 MiB و min=128 MiB |
| گام ۱ | tuned=1500، mapped=3000 | r=1−۳۰۰۰/۴۰۹۶=۰.۲۶۷۶؛ ۱۵۰۰+۰.۲۶۷۶×(۲۷۱۳.۶−۱۵۰۰) | ۱۸۲۴.۷ MiB |
| گام ۲ | mapped=4500 (بیشمصرف) | r=1−۴۰۹۶/۴۵۰۰=۰.۰۸۹۸؛ ۱۸۲۴.۷−۰.۰۸۹۸×(۱۸۲۴.۷−۱۲۸) | ۱۶۷۲.۴ MiB |
از این مثال سه نتیجهی عملی گرفته میشود:
- ۱. cache هرگز تمام target را نمیگیرد. حتی در بهترین حالت، حدود ۲.۷ GiB از ۴ GiB به cache میرسد. بقیه سهم base (حافظهی غیر cache مثل pg log، اتصالها و bufferها) و حاشیهی fragmentation است.
- ۲. واکنش به بیشمصرف تدریجی است. با ۱۰٪ بیشمصرف، بودجه فقط حدود ۹٪ از فاصلهی تا min کم میشود. اگر چیزی بیرون از cache (مثلاً pg log بسیار بلند در backfill) رشد کند، RSS میتواند مدتی از target بالاتر بماند. برای جلوگیری از OOM، حاشیهی حافظهی میزبان را بر این اساس برنامهریزی کنید.
- ۳.
mapped از tcmalloc خوانده میشود. اگر OSD با allocator دیگری ساخته شده باشد، این حلقه عملاً کار نمیکند و مقدار cache ثابت bluestore_cache_size_hdd/ssd (بهترتیب ۱G و ۳G) معنا پیدا میکند.
برای دیدن حلقه در عمل: ceph daemon osd.N dump_mempools حافظهی هر mempool را نشان میدهد (فصل ۲۳) و شمارندههای prioritycache در perf dump (مثل target_bytes، mapped_bytes و heap_bytes) وضعیت حلقه را. اگر mapped_bytes مدام بالاتر از target_bytes است، مشکل در cache نیست. دنبال مصرفکنندهی بیرون از cache باشید.
تقسیم بودجه بین cacheها اولویتبندیشده است (PRI0 تا PRI11 در PriorityCache.h). هر cache در هر اولویت درخواست میدهد و مدیر از بالاترین اولویت شروع به تخصیص میکند. نسبتهای bluestore_cache_kv_ratio=0.45، bluestore_cache_meta_ratio=0.45 و bluestore_cache_kv_onode_ratio=0.04 تنها نقطهی شروعاند. با bluestore_cache_autotune=true، سهم واقعی بر اساس درخواست هر cache جابهجا میشود. معمولاً onodeهای داغ و بلوکهای index و filter مربوط به RocksDB جلوتر از دادهی کاربر قرار میگیرند.
۲۱-۶-۲ throttle در ورودی BlueStore#
هر تراکنش (TransContext) پیش از ورود به BlueStore از throttle_bytes با سقف bluestore_throttle_bytes=64M «هزینه» برمیدارد. هزینه فقط حجم داده نیست. _txc_calc_cost هزینه را اینگونه حساب میکند:
ios  = 1 + (تعداد aioهای داده)        # یکی برای کامیت kv
cost = ios × throttle_cost_per_io + bytes
مقدار throttle_cost_per_io برای HDD برابر ۶۷۰۰۰۰ و برای SSD برابر ۴۰۰۰ است، مگر اینکه bluestore_throttle_cost_per_io صریحاً تنظیم شده باشد. این عدد در واقع «معادل بایتی» هزینهی یک seek است.
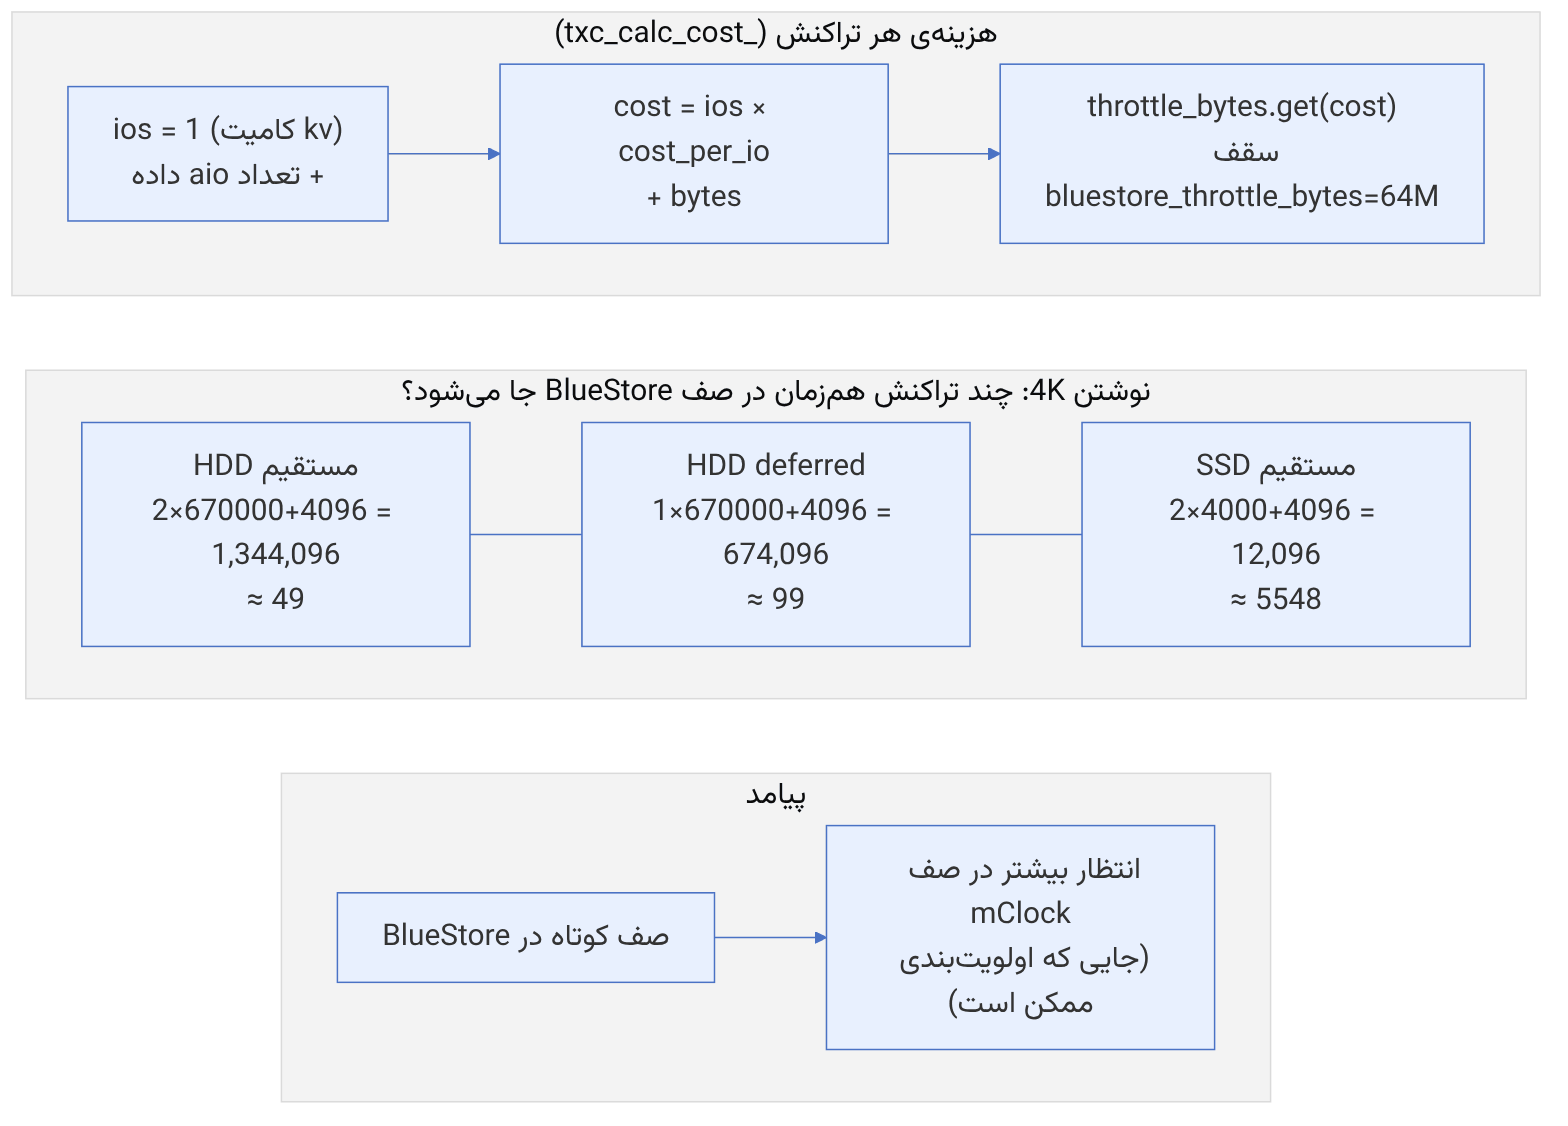
| سناریو (نوشتن ۴K) | ios | cost (بایت معادل) | تعداد همزمان در ۶۴MiB |
|---|---|---|---|
| HDD، نوشتن مستقیم | ۲ | ۲×۶۷۰۰۰۰+۴۰۹۶ = ۱,۳۴۴,۰۹۶ | ≈ ۴۹ |
| HDD، deferred (داده در WAL) | ۱ | ۶۷۰۰۰۰+۴۰۹۶ = ۶۷۴,۰۹۶ | ≈ ۹۹ |
| SSD، نوشتن مستقیم | ۲ | ۲×۴۰۰۰+۴۰۹۶ = ۱۲,۰۹۶ | ≈ ۵۵۴۸ |
چرا throttle را بزرگ نکنیم؟ وسوسهانگیز است که برای IOPS بیشتر bluestore_throttle_bytes را چند برابر کنید. ولی هر درخواستی که از throttle عبور کند از کنترل mClock خارج شده است. یک صف عمیق در BlueStore یعنی درخواست کلاینتی که دیرتر رسیده باید پشت دهها درخواست بازیابی منتظر بماند، بدون اینکه زمانبند بتواند کاری کند. پس throttle بزرگتر لزوماً تأخیر کلاینت را بهتر نمیکند و ممکن است آن را در زمان بازیابی بدتر کند. روش درست، اندازهگیری تأخیر کلاینت در زیر بار بازیابی پیش و پس از تغییر است. اگر مقدار را تغییر دادید، آن را همراه با bluestore_throttle_deferred_bytes=128M و هر دو را برای همهی OSDهای یک کلاس یکسان تنظیم کنید.
۲۱-۶-۳ Messenger و thread#
در هر daemon، ms_async_op_threads=3 thread اجرای رویداد (epoll) برای همهی اتصالها کار میکنند. هر اتصال به یکی از آنها چسبیده است. روی یک OSD NVMe با صدها کلاینت، این سه thread میتوانند پیش از دیسک اشباع شوند. نشانهاش این است که در top -H سه thread با نام msgr-worker-N نزدیک ۱۰۰٪ CPU کار میکنند. ms_tcp_nodelay=true (خاموش کردن Nagle) برای پیامهای کوچک لازم است. ms_tcp_rcvbuf=0 یعنی اندازهی بافر دریافت به autotuning هسته سپرده میشود (net.ipv4.tcp_rmem)، که معمولاً بهتر از هر عدد ثابت است.
ceph daemon osd.3 perf dump | jq '.prioritycache' # target/mapped/heap
ceph daemon osd.3 dump_mempools | jq '.mempool.total'
ceph daemon osd.3 perf dump | jq '.bluestore | {kv_flush_lat, kv_commit_lat, kv_sync_lat, state_kv_queued_lat}'
ceph config show osd.3 bluestore_throttle_cost_per_io # 0 ⇒ مقدار hdd/ssd استفاده میشود
top -H -p $(pgrep -f 'ceph-osd.*--id 3') -b -n1 | grep msgr-workerنام دقیق برخی شمارندههای BlueStore بین نسخهها تغییر کرده است. پیش از ساختن داشبورد، کلیدها را با perf schema روی نسخهی خودتان بررسی کنید.
۲۱-۷ تنظیم کارایی با عدد: شارد، حافظه، مسیر نوشتن و dmClock#
بخشهای قبل این فصل گفتند هر لایهی OSD چه پارامتری دارد. این بخش نشان میدهد چهار تصمیم مهم با عدد چگونه گرفته میشوند: کدام شارد صف یک PG را نگه میدارد، cephadm به هر OSD چقدر حافظه میدهد، BlueStore کدام نوشتن را deferred میکند و dmClock در هر لحظه کدام درخواست را جلو میاندازد. همهی ارجاعها به main در نوامبر ۲۰۲۶ است. پیشفرضهای mClock و شاردها در Reef و Squid تغییر کردهاند، پس ceph config show osd.N روی کلاستر خودتان معیار نهایی است. عددها با بازپیادهسازی پایتونی حساب شدهاند.
۲۱-۷-۱ نگاشت PG به شارد صف#
منبع در کد: src/osd/OSD.cc :: OSD::ShardedOpWQ::_enqueue، OSD::get_num_op_shards؛ src/osd/osd_types.h :: spg_t::hash_to_shard
پیچیدگی: O(۱)
pseudocode
num_shards = osd_op_num_shards اگر ≠ 0 وگرنه (rotational ? osd_op_num_shards_hdd = 1 : osd_op_num_shards_ssd = 8)
threads_per_shard = osd_op_num_threads_per_shard یا (hdd: 5 ، ssd: 2)
shard(item) = item.ordering_token.pgid.ps() mod num_shards # همهی درخواستهای یک PG در یک شارد
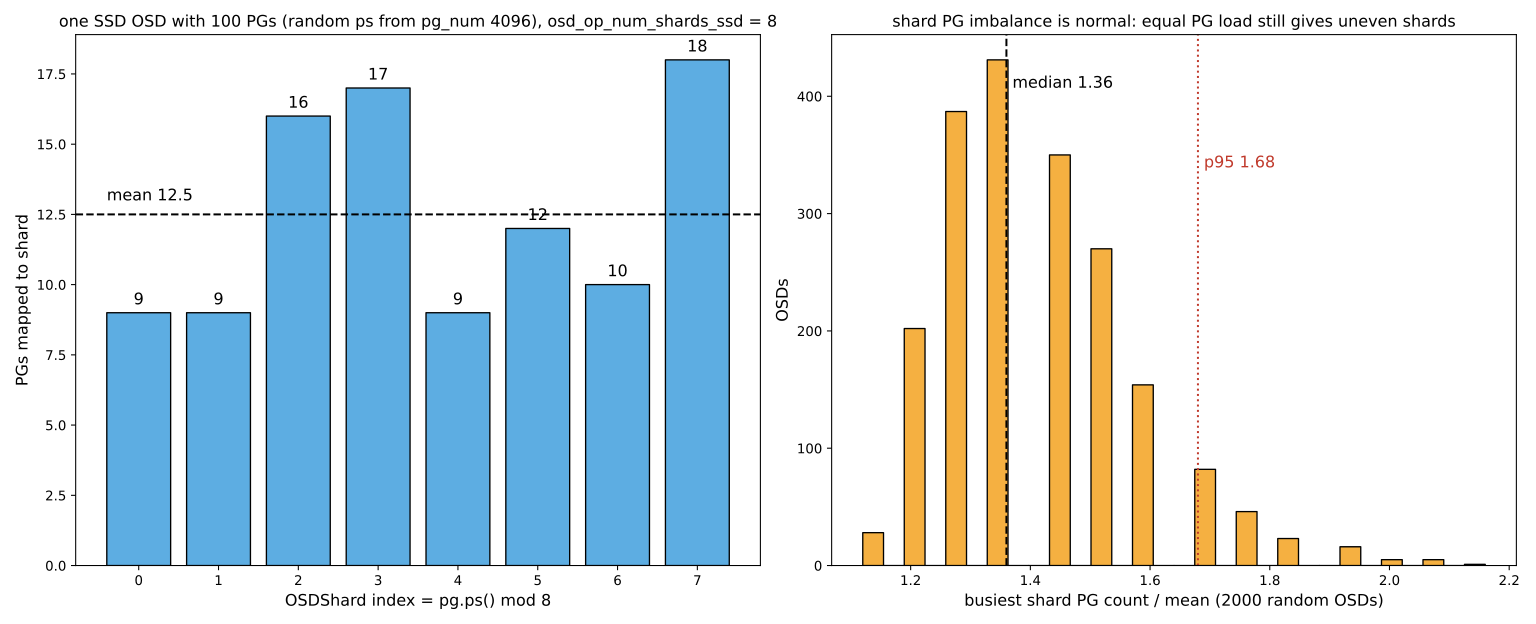
هر شارد: یک صف mClock جدا و threads_per_shard threadنتیجهی مستقیم: یک PG هرگز از بیش از یک شارد سرویس نمیگیرد. روی SSD با پیشفرض ۸ × ۲، یک PG بسیار داغ (مثلاً شیء سرصفحهی یک bucket یا یک image با بار سنگین روی چند شیء کم) حداکثر ۲ thread از ۱۶ thread را مشغول میکند. توزیع PGها میان شاردها هم یکنواخت نیست. شبیهسازی یک OSD با ۱۰۰ PG که شمارهی ps آنها تصادفی از pg_num ۴۰۹۶ انتخاب شده، تعداد PG هر شارد را ۹، ۹، ۱۶، ۱۷، ۹، ۱۲، ۱۰ و ۱۸ داد. میانگین ۱۲.۵ است، اما پرترین شارد ۴۴ درصد بیشتر از میانگین بار دارد. در ۲۰۰۰ OSD تصادفی، نسبت پرترین شارد به میانگین در میانه ۱.۳۶ و در صدک ۹۵ حدود ۱.۶۸ بود. این یکی از دلیلهای این است که روی NVMe بالا بردن تعداد PG هر OSD (و در نتیجه هموارتر شدن این توزیع) گاهی کارایی را بیشتر از تغییر تعداد thread بهبود میدهد. روی HDD با یک شارد این مسئله وجود ندارد: همهی PGها در یک صف mClock هستند و پنج thread آن را میکشند.
۲۱-۷-۲ سهم حافظهی هر OSD در cephadm#
منبع در کد: src/pybind/mgr/cephadm/autotune.py :: MemoryAutotuner.tune؛ src/pybind/mgr/cephadm/serve.py :: CephadmServe._autotune_host_memory
پیچیدگی: O(D) برای D daemon روی میزبان؛ هر autotune_interval (۶۰۰ ثانیه)
pseudocode
total = memory_total_kb × 1024 × autotune_memory_target_ratio (0.7)
for d in daemonهای میزبان:
mds: total −= mds_cache_memory_limit
OSD با osd_memory_target_autotune = false: total −= osd_memory_target آن
OSD دیگر: به فهرست tuned
هر نوع دیگر: total −= max(min_size_by_type[type] یا 1 GiB، memory_usage فعلی)
(mgr، mds و nvmeof: 4 GiB ؛ mon: 1 GiB ؛ crash، haproxy، keepalived: 128 MiB)
if total < 0 یا tuned خالی: کاری نکن
per = ⌊total / |tuned|⌋
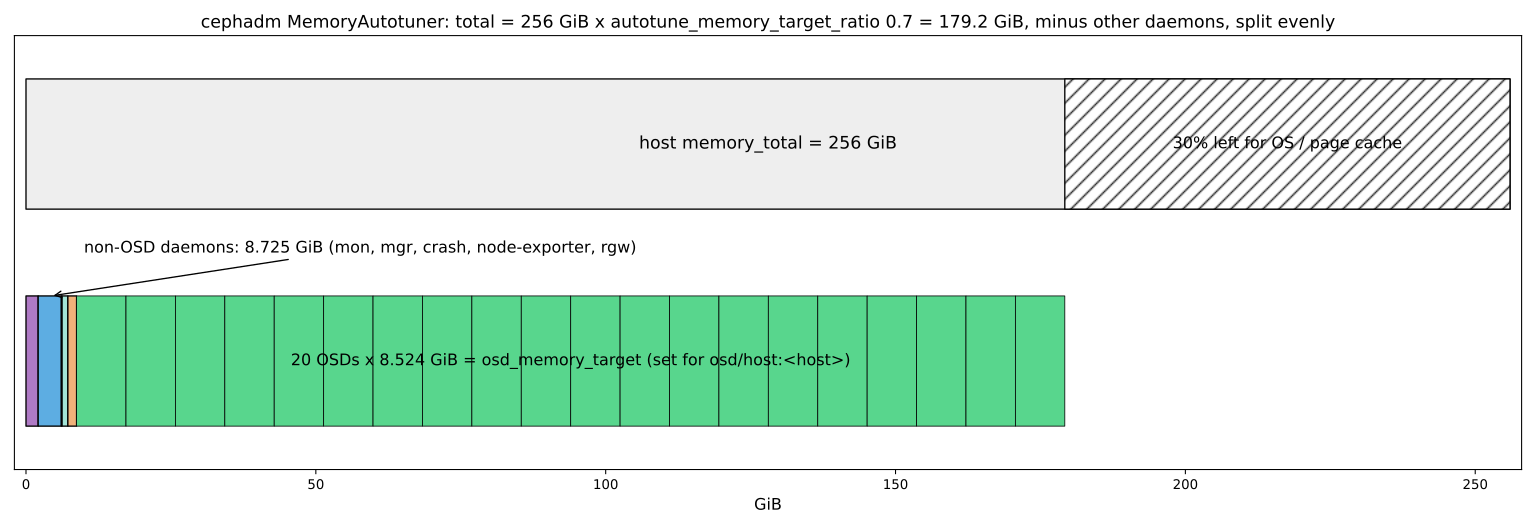
تنظیمهای per-OSD قبلی را پاک کن ؛ config set osd/host:<host> osd_memory_target perمثال عددی. میزبانی ۲۵۶ GiB حافظه، یک mon، یک mgr، crash، node-exporter، یک RGW و ۲۰ OSD دارد. total = ۲۵۶ × ۰.۷ = ۱۷۹.۲ GiB. فرض کنید مصرف فعلی mon ۲.۱ GiB و RGW ۱.۵ GiB باشد (عددهای مثال). mgr با مصرف ۳ GiB حداقل ۴ GiB حساب میشود، crash ۱۲۸ MiB و node-exporter (که در جدول نیست) ۱ GiB. جمع اینها ۸.۷۲۵ GiB است و برای OSDها ۱۷۰.۴۷۵ GiB میماند. هر OSD ⌊۱۷۰.۴۷۵ GiB / ۲۰⌋ = ۹۱۵۲۳۰۶۸۷۲ بایت، حدود ۸.۵۲ GiB، میگیرد. چون مقدار با ماسک osd/host:<host> نوشته میشود، همهی OSDهای یک میزبان یک عدد دارند. اگر یک OSD را با osd_memory_target_autotune = false و مقدار دستی از این محاسبه بیرون بگذارید، مقدار آن از کل کم میشود و بقیه بین OSDهای خودکار تقسیم میشود.
دو تله وجود دارد. اول، مصرف فعلی daemonها در محاسبه میآید، پس اگر RGW ناگهان ۱۰ GiB مصرف کند، ده دقیقه بعد سهم هر OSD حدود ۰.۴ GiB کم میشود. دوم، osd_memory_target یک هدف برای حافظهی نگاشتشدهی heap است، نه سقف RSS. توضیح خود گزینه میگوید RSS ممکن است تا حدود ۲۰ درصد بیشتر شود. سی درصدی که ratio کنار میگذارد برای همین، برای سیستمعامل و برای page cache است.
۲۱-۷-۳ مسیر نوشتن BlueStore: small، big و deferred#
منبع در کد: src/os/bluestore/BlueStore.cc :: BlueStore::_do_write_data، _do_write_big، _do_alloc_write
پیچیدگی: O(تعداد blobها) برای هر نوشتن
pseudocode
# bluestore_write_v2 = false (پیشفرض در main)
if offset و end−1 در یک بلوک min_alloc_size باشند و length ≠ min_alloc_size: _do_write_small(کل)
else:
head = [offset, p2roundup(offset, mas)) → _do_write_small
tail = [p2align(end, mas), end) → _do_write_small
middle = بقیه → _do_write_big (در صورت segment_size، تکهتکه)
_do_write_big: اگر l ≤ 2 × prefer_deferred_size: تلاش برای نوشتن در blobهای موجود بهصورت deferred
_do_alloc_write برای blob تازه: اگر data_size < prefer_deferred_size ⇒ deferred (ابتدا در WAL و RocksDB، بعد روی دستگاه)
وگرنه ⇒ نوشتن مستقیم روی دستگاه، سپس commit فراداده
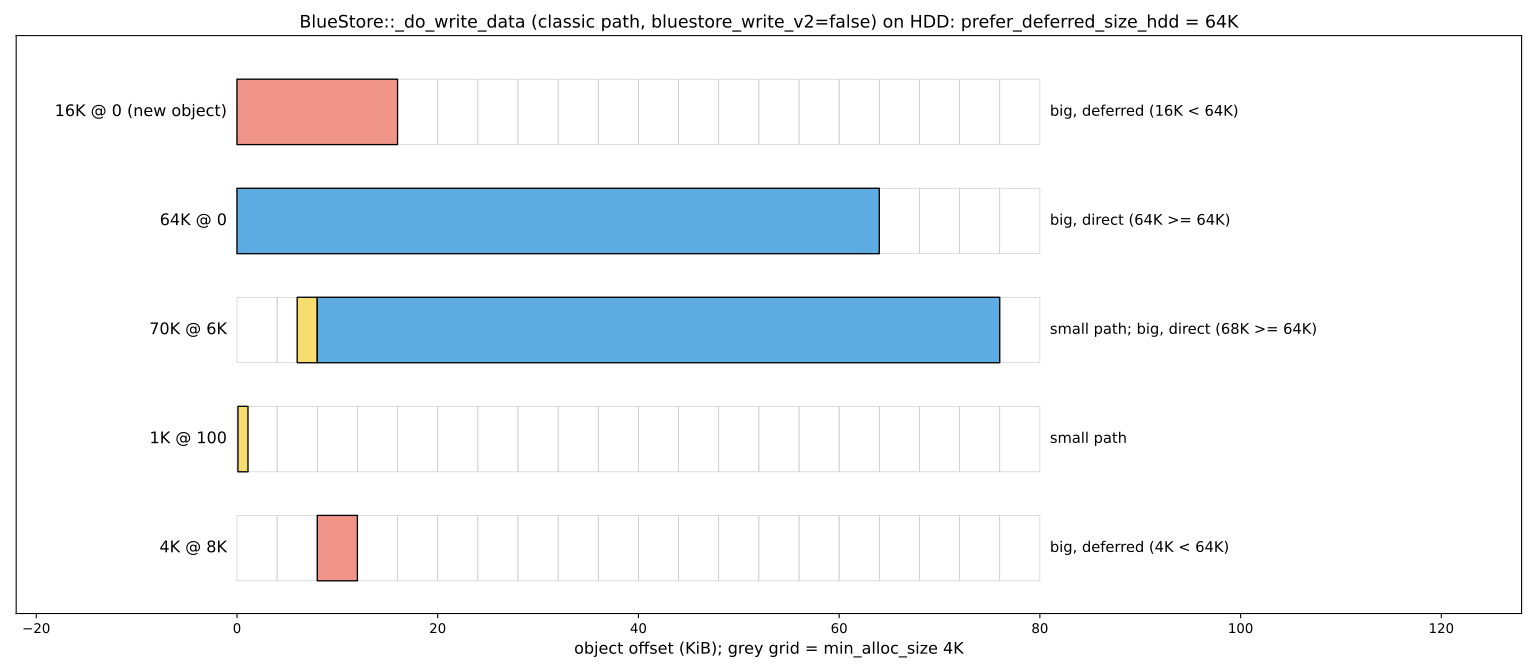
prefer_deferred_size = bluestore_prefer_deferred_size یا hdd: 64K ، ssd: 0مثال عددی. OSD روی HDD است، با min_alloc_size ۴ KiB (پیشفرض main برای hdd و ssd) و prefer_deferred_size ۶۴ KiB.
- ۱۶ KiB در offset صفر یک شیء تازه: offset و end − ۱ در بلوکهای ۰ و ۳ هستند، پس head و tail صفرند و کل ۱۶ KiB به مسیر big میرود. blob تازه است و ۱۶ KiB < ۶۴ KiB، پس deferred نوشته میشود: داده ابتدا در تراکنش RocksDB (روی دستگاه DB/WAL اگر جدا باشد) مینشیند و بعد روی HDD اعمال میشود.
- ۶۴ KiB در offset صفر: ۶۴ KiB < ۶۴ KiB برقرار نیست، پس مستقیم روی HDD نوشته میشود و فقط فراداده به RocksDB میرود.
- ۷۰ KiB در offset ۶ KiB: head ۲ KiB (۶ تا ۸ KiB) به مسیر small، و middle ۶۸ KiB (۸ تا ۷۶ KiB) به big و مستقیم میرود. چون end = ۷۶ KiB همتراز است، tail صفر است.
- ۱ KiB در offset ۱۰۰: درون یک بلوک است و به مسیر small میرود.
- ۴ KiB همتراز در offset ۸ KiB: درون یک بلوک است، اما چون length = min_alloc_size است، به شاخهی else و مسیر big میرود و deferred میشود.
روی SSD با prefer_deferred_size ۰، شرط data_size < 0 هرگز برقرار نیست و هیچ نوشتن big deferred نمیشود. HDD نمیتواند نوشتنهای کوچک تصادفی را سریع انجام دهد، پس BlueStore آنها را ابتدا ترتیبی در WAL مینویسد و بعد در پسزمینه اعمال میکند. هزینهی این کار دو بار نوشتن است. اگر DB/WAL روی NVMe باشد، این دو بار نوشتن عملاً تأخیر نوشتن کوچک را به تأخیر NVMe نزدیک میکند. مسیر small خودش منطق جداگانهای (خواندن-تغییر-نوشتن و deferred روی blob موجود) دارد که در فصلهای ۱۲ و ۲۴ آمده است. مسیر جدید bluestore_write_v2 در main وجود دارد، اما پیشفرض آن false است و این مثالها را پوشش نمیدهد.
۲۱-۷-۴ dmClock با عدد#
منبع در کد: src/dmclock/src/dmclock_server.h :: RequestTag::RequestTag، tag_calc، PriorityQueueBase::do_next_request، reduce_reservation_tags؛ src/osd/scheduler/mClockScheduler.h
پیچیدگی: O(log C) برای C کلاینت (سه heap)
pseudocode
tag_calc(t, prev, inv, extreme_high): inv == 0 ? (high ? max_tag : min_tag) : max(t, prev + inv × cost)
ورود یا رسیدن به سر صف (IsDelayed = true در OSD):
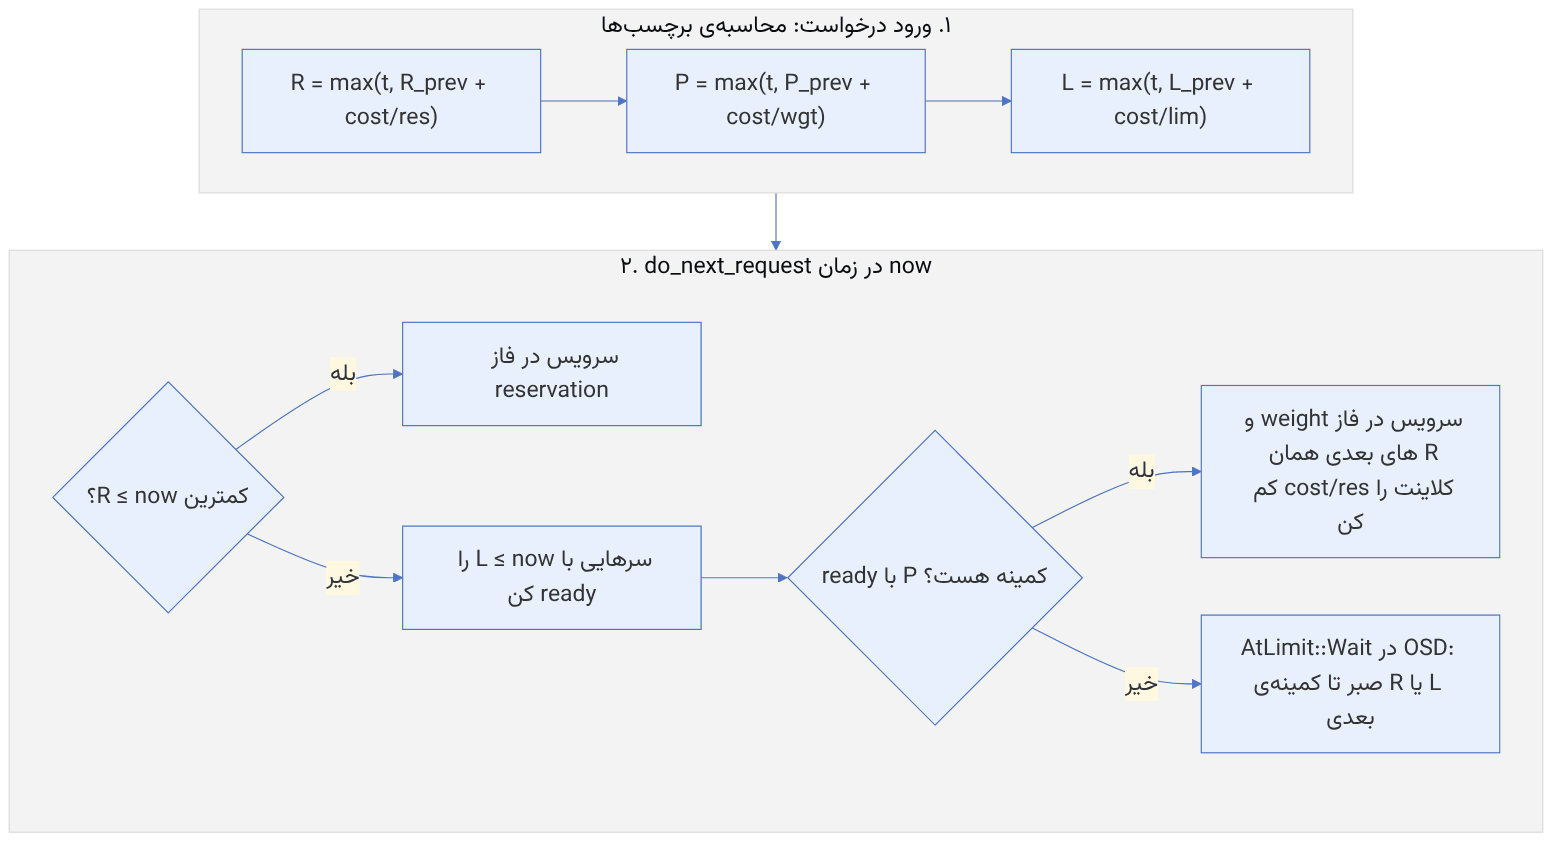
R = tag_calc(t, R_prev, 1/res, high) ; P = tag_calc(t, P_prev, 1/wgt, high) ; L = tag_calc(t, L_prev, 1/lim, low)
do_next_request(now):
if کمینهی R ≤ now: سرویس از فاز reservation
else: هر سری با L ≤ now را ready کن ; اگر ready با P کمینه هست: سرویس از فاز weight
و R سر صف همان کلاینت را 1/res × cost کم کن # سرویس weight جزو reservation حساب نشود
else (AtLimit::Wait در OSD): صبر تا کمینهی R یا L بعدیدر OSD، cost هر درخواست max(اندازه به بایت، osd_bandwidth_cost_per_io) است و رزرو و حد برحسب بایت در ثانیه بیان میشوند (فصل ۱۰). برای روشن شدن منطق، در این مثال cost هر درخواست را ۱ و واحدها را درخواست در ثانیه گرفتهایم.
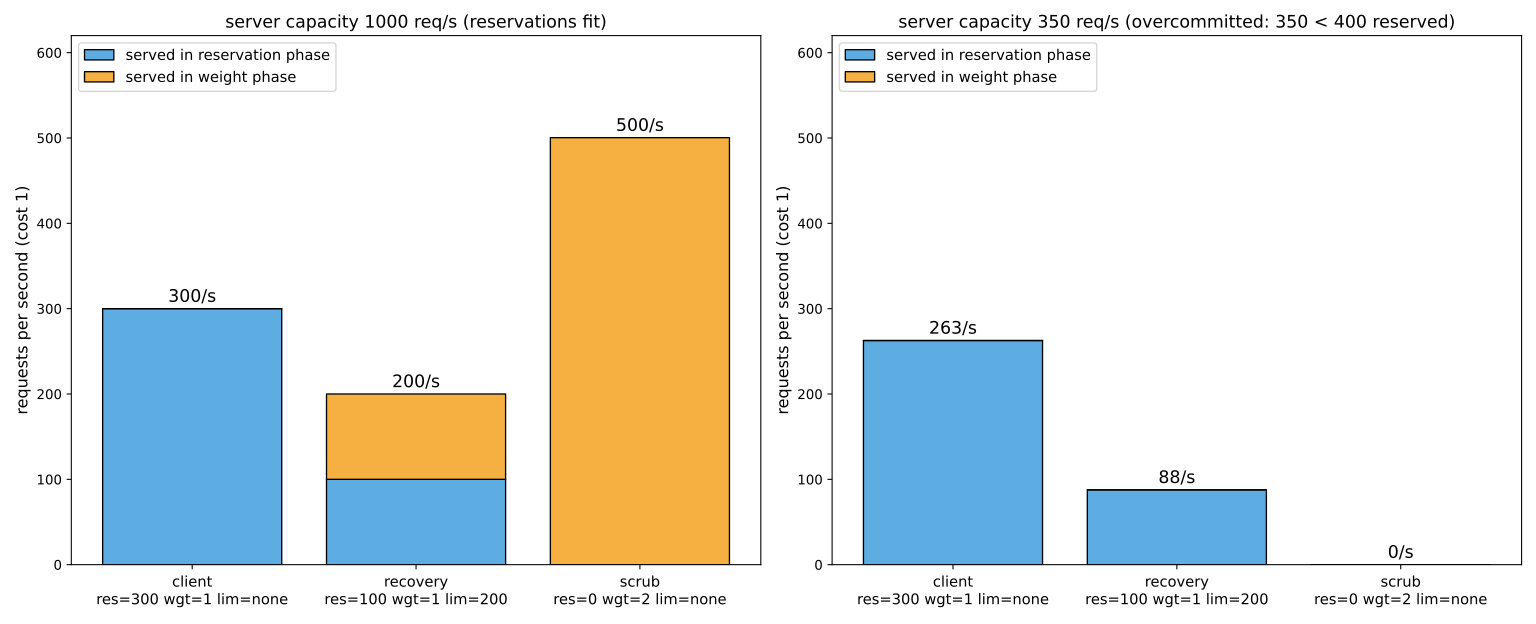
مثال عددی. سه کلاینت پیوسته درخواست میفرستند: client با res = ۳۰۰، wgt = ۱ و بدون حد؛ recovery با res = ۱۰۰، wgt = ۱ و lim = ۲۰۰؛ scrub با res = ۰ و wgt = ۲. شبیهسازی ما همین الگوریتم را با بازههای ۱ میلیثانیهای اجرا کرد.
- ظرفیت ۱۰۰۰ درخواست در ثانیه: client ۳۰۰ درخواست در ثانیه گرفت که همه در فاز reservation بود. recovery ۲۰۰ گرفت: ۱۰۰ از reservation و ۱۰۰ از weight، و حد ۲۰۰ آن را متوقف کرد. scrub بقیه، یعنی ۵۰۰، را در فاز weight گرفت. چرا client از فاز weight سهمی نگرفت؟ برچسب P هر کلاینت با هر درخواست سرویسشده جلو میرود، حتی در فاز reservation. 300 درخواست client برچسب P آن را ۳۰۰ ثانیه جلو برده است، در حالی که scrub با وزن ۲ هر درخواست فقط ۰.۵ جلو میرود. سهم وزنی client از ۸۰۰ درخواستی که برای client و scrub میماند ۸۰۰ / ۳ ≈ ۲۶۷ است و از رزرو ۳۰۰ کمتر است. پس client همان ۳۰۰ را میگیرد. این همان رفتار مورد انتظار mClock است: هر کلاینت تقریباً max(رزرو، سهم وزنی) را میگیرد.
- ظرفیت ۳۵۰ درخواست در ثانیه (کمتر از ۴۰۰ درخواست رزروشده): client حدود ۲۶۳ و recovery حدود ۸۸ گرفت، یعنی تقریباً نسبت ۳ به ۱ رزروها. scrub تقریباً هیچ نگرفت. اگر ظرفیت واقعی OSD از مجموع رزروها کمتر باشد، رزروها به نسبت کوچک میشوند و کلاینتهای بدون رزرو گرسنه میمانند. به همین دلیل
osd_mclock_max_capacity_iops_* اگر بیش از واقعیت تخمین زده شده باشد (فصل ۱۰)، تضمینهای پروفایل را بیمعنا میکند.
۲۱-۸ سیستمعامل، شبکه و CPU#
| حوزه | تنظیم پیشنهادی | چرا |
|---|---|---|
| CPU | tuned-adm profile throughput-performance یا latency-performance؛ غیرفعال کردن C-stateهای عمیق در BIOS برای NVMe | بیدار شدن هستهها از C-state عمیق دهها میکروثانیه تأخیر میافزاید |
| زمانبند I/O | none برای NVMe، mq-deadline برای HDD | زمانبند اضافه برای NVMe سربار است |
| شبکه | شبکهی cluster جدا یا پهنای باند کافی؛ MTU یکسان در کل مسیر | بازیابی و تکثیر از شبکهی cluster عبور میکنند |
| MTU | اگر jumbo frame (۹۰۰۰) به کار میرود، روی همهی سوئیچها و میزبانها | MTU ناهماهنگ باعث از دست رفتن بسته و heartbeat failure میشود |
| NUMA | نگه داشتن OSD نزدیک کارت شبکه و NVMe همان NUMA node | کاهش ترافیک بین سوکتها |
| swap | حداقل یا غیرفعال؛ پایش OOM | swap شدن OSD تأخیر را غیرقابل پیشبینی میکند |
# بررسی سریع روی هر میزبان
cat /sys/block/nvme0n1/queue/scheduler
tuned-adm active
ip -d link show bond0 | grep -E "mtu|bond"
ping -M do -s 8972 -c 3 10.20.0.12          # آزمون مسیر jumbo frame
ethtool -S ens1f0 | grep -iE "drop|err" | grep -v ": 0"هشدار ceph-mixin با نام CephNodeInconsistentMTU و CephNodeNetworkPacketDrops دقیقاً برای همین مسائل است. اگر OSDها «wrongly marked me down» گزارش میدهند و همهی میزبانها سالم به نظر میرسند، MTU و خطاهای کارت شبکه را اول بررسی کنید.
۲۱-۹ طراحی pool و کلاینت#
- تکثیری در مقابل EC: برای نوشتنهای کوچک تصادفی (پایگاه داده روی RBD)، تکثیری تأخیر کمتری دارد؛ EC برای دادهی بزرگ و ترتیبی. در Tentacle، FastEC فاصله را برای بارهای ترکیبی کم کرده است (فصل ۱۳).
- تعداد PG: PG کم یعنی موازیسازی کم در OSDهای سریع؛ autoscaler را با
bulk و target_size_ratio راهنمایی کنید (فصل ۱۹). - RBD: کش librbd برای ماشینهای مجازی،
rbd_cache_policy و در صورت نیاز کش persistent write-back؛ اندازهی شیء (پیشفرض ۴ مگابایت) و striping برای بارهای ترتیبی. - RGW: shardهای شاخص bucket (resharding پویا بهصورت پیشفرض فعال است)، تعداد threadهای frontend و جداسازی pool شاخص روی NVMe.
- CephFS: pin کردن زیردرختها به MDS rankها و چند MDS فعال برای بار متادیتای سنگین.
۲۱-۱۰ سنجش#
۲۱-۱۰-۱ ابزارها#
| ابزار | لایه | نمونه |
|---|---|---|
| rados bench | RADOS (بدون librbd) | rados bench -p bench 60 write -b 4M -t 16 --no-cleanup |
| ceph tell osd.N bench | یک OSD منفرد | ceph tell osd.3 bench 1073741824 4194304 |
| rbd bench | librbd | rbd bench --io-type write --io-size 4K --io-pattern rand vm-fast/test |
| fio با ioengine=rbd | librbd از دید برنامه | فایل job با ioengine=rbd |
| fio روی krbd یا VM | مسیر کامل کاربر | fio --rw=randwrite --bs=4k --iodepth=32 --direct=1 |
| CBT | سنجش خودکار و تکرارپذیر | github.com/ceph/cbt |
; fio-rbd.job — نمونهی این کتاب
[global]
ioengine=rbd
clientname=bench
pool=vm-fast
rbdname=fio-test
direct=1
time_based=1
runtime=300
ramp_time=30
group_reporting=1
[randwrite-4k]
rw=randwrite
bs=4k
iodepth=32
numjobs=4همیشه صدکها (p99، p99.9) را گزارش کنید، نه فقط میانگین. Ceph در میانگین ممکن است خوب باشد ولی دم توزیع تأخیر (مثلاً به دلیل deep scrub یا یک OSD کند) تجربهی کاربر را خراب کند. سنجش را دستکم چند دقیقه با ramp-up اجرا کنید تا کشها و BlueStore به حالت پایدار برسند.
سنجش روی کلاستر تولیدی بار واقعی کاربران را مختل میکند و rados bench با --no-cleanup داده باقی میگذارد. در pool جدا اجرا و پس از آن rados -p bench cleanup کنید. ceph tell osd.N bench روی همان دیسک OSD مینویسد.
- یک تغییر در هر زمان؛ هر تغییر را با
ceph config و قابل بازگشت ثبت کنید. - پیش از تنظیم نرمافزار، CPU، دیسک و شبکه را بررسی کنید.
- پروفایل mClock را بر اساس زمان روز تغییر دهید، نه osd_max_backfills را.
-
osd_mclock_max_capacity_iops_* را پس از سنجش واقعی، در صورت نادرست بودن سنجش خودکار، تنظیم کنید. - صدکها را بسنجید و گزارش کنید.
۲۱-۱۱ تکمیلی و بهروز#
- WPQ دیگر پیشفرض نیست؛ از Quincy، mClock زمانبند پیشفرض است و بیشتر راهنماهای تنظیم قدیمی (sleepهای بازیابی، osd_max_backfills) با آن کار نمیکنند.
- پیشفرض شاردهای HDD در نسخهی نقطهای ۱۹.۲.۱ از Squid از ۵×۱ به ۱×۵ تغییر کرد (issue 66289) و Tentacle و Umbrella هم همین را نگه داشتهاند.
- سازوکار جلوگیری از گرسنگی صف immediate در mClock (tracker ۶۹۰۷۸) در مستندات latest آمده است.
- FileStore در Reef پشتیبانی نمیشود؛ همهی تنظیمات این فصل برای BlueStore است.
- Crimson/SeaStore: بازنویسی OSD بر پایهی Seastar در حال توسعه است؛ وضعیت پشتیبانی آن را برای نسخهی خود در مستندات بررسی کنید و آن را در تولید بدون اطمینان از پشتیبانی رسمی به کار نبرید.
۲۱-۱۲ تمرین عملی#
- ۱. با
rados bench و rbd bench خط پایه بگیرید و نتایج را با صدکها ثبت کنید. - ۲. پروفایل mClock را بین balanced و high_client_ops تغییر دهید و تأخیر کلاینت را در حین backfill یک OSD مقایسه کنید.
- ۳.
osd_max_backfills را بدون override تغییر دهید و ببینید اثری ندارد؛ سپس با override آزمایش کنید و برگردانید. - ۴. مقدار
osd_mclock_max_capacity_iops_ssd تعیینشده برای هر OSD را با ceph config dump ببینید و با ceph tell osd.N bench مقایسه کنید. - ۵. روی یک میزبان MTU را ناهماهنگ کنید (در آزمایشگاه) و اثر را روی heartbeat و هشدارها ببینید.
- ۶. در
dmclock_server.h، تابع انتخاب درخواست بعدی را پیدا و با شبهکد این فصل مقایسه کنید.
۲۱-۱۳ پرسشهای مرور#
- ۱. چرا تنظیم کارایی باید با خط پایه و یک تغییر در هر زمان انجام شود؟
- ۲. شارد هر PG چگونه تعیین میشود و چرا همهی عملیات یک PG در یک شارد است؟
- ۳. Squid 19.2.1 چه تغییری در پیشفرض شاردهای HDD داد و چرا معقول است؟
- ۴. سه پارامتر mClock را تعریف کنید.
- ۵. برچسب R در dmclock چگونه محاسبه میشود و max(now, ...) چه نقشی دارد؟
- ۶. پروفایل high_client_ops چه تفاوتی با balanced دارد؟
- ۷. چرا تغییر osd_max_backfills در پروفایلهای داخلی اثری ندارد؟
- ۸. OSD ظرفیت IOPS خود را چگونه تعیین میکند و چه زمانی نتیجه را کنار میگذارد؟
- ۹. سه تنظیم سیستمعامل یا شبکه که بیشترین اثر را دارند نام ببرید.
- ۱۰. چرا باید صدکها را به جای میانگین گزارش کرد؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۱-۱۴ منابع این فصل#
- mClock config reference
https://docs.ceph.com/en/latest/rados/configuration/mclock-config-ref/ - OSD config reference
https://docs.ceph.com/en/latest/rados/configuration/osd-config-ref/ - BlueStore config reference
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - cephadm OSD service (memory autotune
https://docs.ceph.com/en/latest/cephadm/services/osd/ - Hardware recommendations
https://docs.ceph.com/en/latest/start/hardware-recommendations/ - Network config reference
https://docs.ceph.com/en/latest/rados/configuration/network-config-ref/ - CBT (Ceph Benchmarking Tool
https://github.com/ceph/cbt - Source: src/dmclock
https://github.com/ceph/ceph/tree/main/src/dmclock - Source: src/osd/scheduler/mClockScheduler.cc
https://github.com/ceph/ceph/blob/main/src/osd/scheduler/mClockScheduler.cc - Source: src/common/options/osd.yaml.in
https://github.com/ceph/ceph/blob/main/src/common/options/osd.yaml.in - Gulati, Merchant, Varman, "mClock: Handling Throughput Variability for Hypervisor IO Scheduling" (OSDI ۲۰۱۰
https://www.usenix.org/conference/osdi10/mclock-handling-throughput-variability-hypervisor-io-scheduling - tracker 69078
https://tracker.ceph.com/issues/69078