راهبری و نگهداری روزمره: ارتقا، جایگزینی دیسک، autoscaler و balancer
حوصله ندارم این فصل در چند خط
- ارتقای cephadm غلتان است: اول mgrها، سپس MONها یکییکی، بعد OSDها به شرط فعال ماندن PGها و در آخر بقیهی daemonها.
- دیسک را با
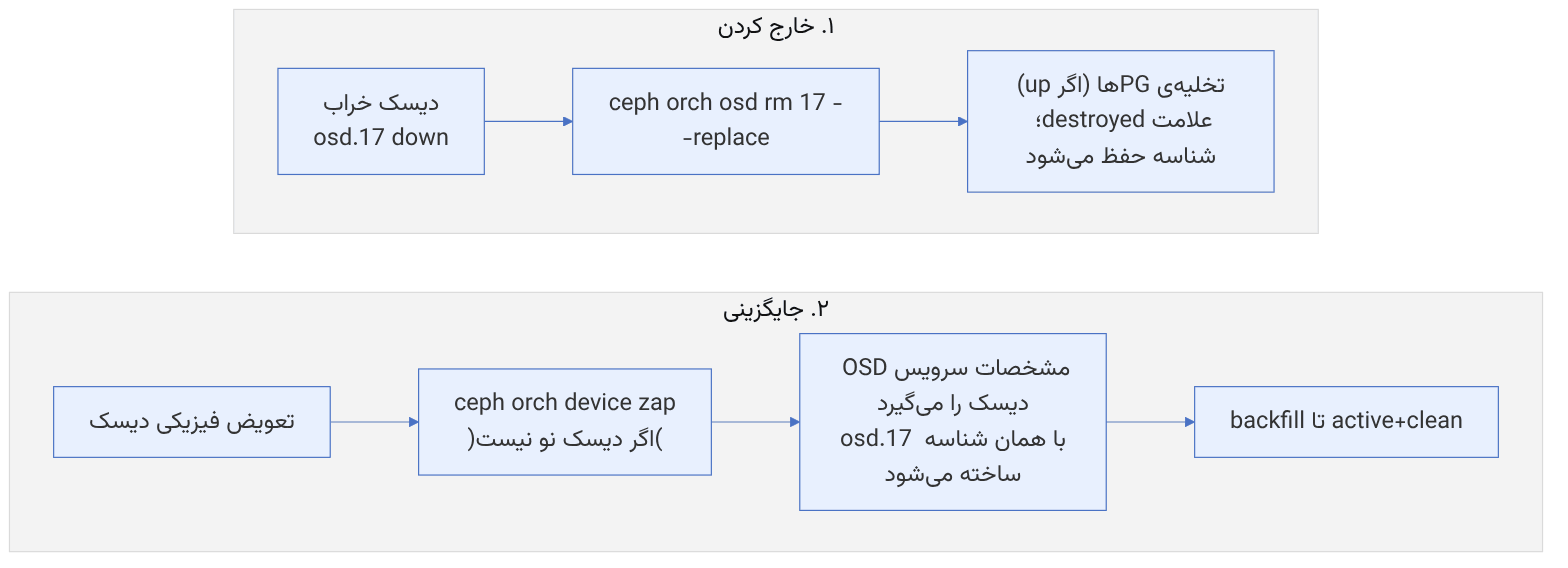
--replace عوض کنید تا شناسه و جای OSD در CRUSH بماند و فقط PGهای همان OSD backfill شوند. - حالت نگهداری میزبان بررسی میکند توقف میزبان امن است و
noout را فقط برای همان میزبان میگذارد. - pg_autoscaler تعداد PGهای هر pool را تنظیم میکند و balancer با upmap پخش PGها را یکنواخت میکند؛ سلامت دستگاهها و بررسیهای دورهای جزو کار روزمرهاند.
۱۹-۱ پیش از شروع#
۱۹-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
بیشتر عمر یک کلاستر Ceph را کارهای روزمره تشکیل میدهد: ارتقای نسخه، تعویض دیسک، افزودن و خارج کردن میزبان، تنظیم تعداد PGها و متوازن کردن داده. هر کدام از این کارها اگر درست انجام شود بیسروصداست و اگر نه، به حادثه تبدیل میشود. این فصل روالهای امروزی را با cephadm مرور میکند و سپس به درون دو ماژول مهم mgr میرود: pg_autoscaler و balancer.
- ارتقا با cephadm به چه ترتیبی انجام میشود و ارتقای مرحلهای چیست؟
- دیسک خراب را چگونه با حفظ شناسهی OSD جایگزین کنیم؟
- میزبان را چگونه برای نگهداری خارج یا برای همیشه حذف کنیم؟
- pg_autoscaler تعداد PG را با چه فرمولی محاسبه میکند و چه چیزی در Umbrella تغییر کرد؟
- balancer در حالت upmap چگونه تصمیم میگیرد کدام PG جابهجا شود؟
- کدام پرچمها و تنظیمات برای کارهای نگهداری لازماند؟
۱۹-۲ ارتقای نسخه#
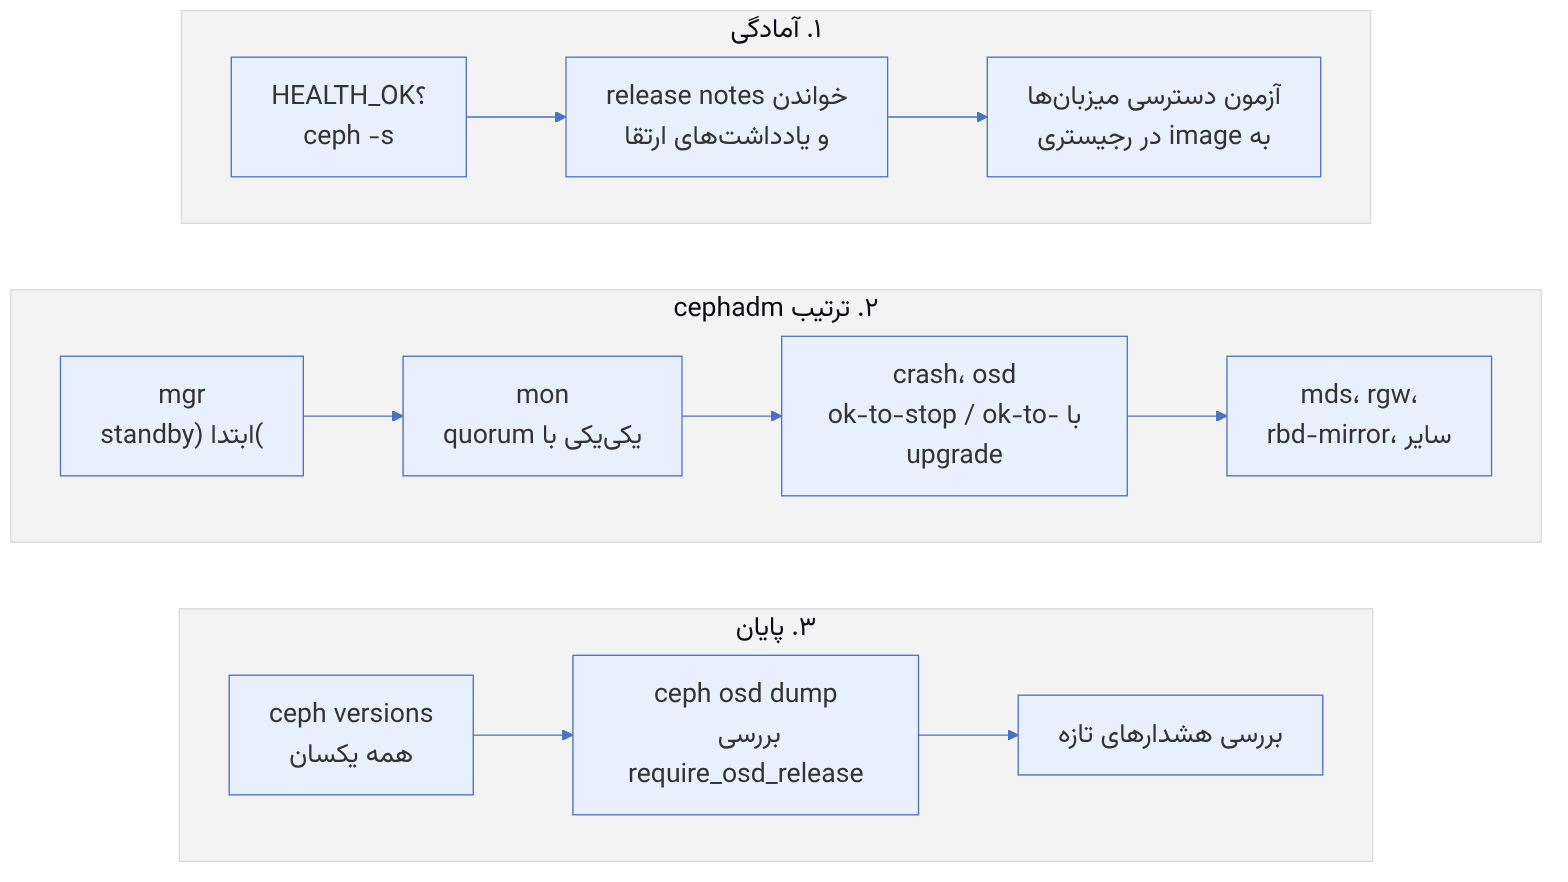
cephadm ارتقا را بهصورت rolling انجام میدهد: ابتدا mgrها (تا ماژول cephadm جدید کار را ادامه دهد)، سپس MONها یکییکی با حفظ quorum، سپس OSDها با بررسی اینکه توقف آنها PGها را غیرفعال نمیکند، و در پایان سایر سرویسها.
ceph -s
ceph versions
ceph orch upgrade start --ceph-version 20.2.5          # یا --image quay.io/ceph/ceph:v20.2.5
ceph orch upgrade status
ceph -W cephadm                                        # پیگیری زنده
ceph orch upgrade pause | resume | stopنسخههای ذکرشده در مثال (Tentacle 20.2.5) آخرین نسخهی نقطهای Tentacle در زمان نگارش است. پیش از ارتقا، فهرست رسمی انتشارها در docs.ceph.com/en/latest/releases را بررسی و یادداشتهای ارتقای همان نسخه را بخوانید؛ بعضی انتشارها پیشنیاز یا گام دستی دارند.
۱۹-۲-۱ ارتقای مرحلهای#
cephadm امکان ارتقای بخشی از daemonها را میدهد (staggered upgrade)؛ برای مثال فقط mgr و mon روی چند میزبان، یا فقط سرویسهای RGW مشخص با محدودیت تعداد:
ceph orch upgrade start --image quay.io/ceph/ceph:v20.2.5 --daemon-types mgr,mon --hosts mon1,mon2
ceph orch upgrade start --image quay.io/ceph/ceph:v20.2.5 --services rgw.s3main --limit 2در مستندات Umbrella، ارتقای OSDها میتواند بر اساس bucket CRUSH انجام شود: با --daemon-types osd --crush_bucket_type rack (و اختیاری --crush_bucket_name)، cephadm برای هر bucket فرمان MON ceph osd ok-to-upgrade را با سقف mgr/cephadm/max_parallel_osd_upgrades صدا میزند و OSDهای آن bucket را با هم ارتقا میدهد؛ اگر پارامترهای bucket داده نشود، به دروازهی پیشفرض ok-to-stop برمیگردد. انواع bucket پشتیبانیشده در مستندات: host، rack و chassis. این قابلیت زمان ارتقای کلاسترهای بزرگ را بهشدت کم میکند، چون بهجای یک OSD در هر زمان، یک دامنهی خرابی کامل همزمان ارتقا مییابد.
اگر میزبانی offline یا در حالت نگهداری باشد، ارتقا متوقف و منتظر میماند. پیش از شروع، ceph orch host ls را بررسی کنید. ارتقا را در زمان backfill سنگین یا وجود PGهای غیرفعال شروع نکنید.
۱۹-۳ جایگزینی دیسک#
ceph osd tree | grep -E "down|destroyed"
ceph orch osd rm 17 --replace # شناسه حفظ و OSD در CRUSH باقی میماند
ceph orch osd rm status
# پس از تعویض دیسک
ceph orch device ls stor-b3 --refresh
ceph orch device zap stor-b3 /dev/sdk --force # فقط اگر دیسک قبلاً استفاده شده
ceph orch ps --daemon-type osd | grep osd.17--replace باعث میشود OSD در وضعیت destroyed بماند، نه حذف کامل؛ بنابراین موقعیت CRUSH و شناسه حفظ میشود و پس از ساخت OSD جدید، فقط PGهای همان OSD backfill میشوند، نه یک بازتوزیع کلی. بدون --replace، حذف OSD و افزودن OSD جدید دو بار داده را جابهجا میکند.
ceph orch osd rm تأیید نمیخواهد و بلافاصله شروع میکند؛ مستندات این را صریحاً گوشزد میکند. شناسه را دوبار بررسی کنید. برای توقف: ceph orch osd rm stop <id>.
۱۹-۴ نگهداری و حذف میزبان#
ceph orch host maintenance enter stor-b3 # توقف همهی daemonهای Ceph میزبان
# ... بهروزرسانی هسته، تعمیر سختافزار، راهاندازی دوباره ...
ceph orch host maintenance exit stor-b3
# حذف دائمی
ceph orch host drain stor-b3 # برچسب _no_schedule و _no_conf_keyring؛ خروج daemonها
ceph orch osd rm status
ceph orch host rm stor-b3maintenance enter پیش از توقف، بررسی میکند توقف daemonهای میزبان ایمن است (مثلاً PGها فعال میمانند) و در صورت ناامنی امتناع میکند؛ طبق مستندات، --force از هشدارها (نه alertها) عبور میکند و --force --yes-i-really-mean-it همهی بررسیهای ایمنی را دور میزند و میتواند به از دست رفتن دسترسی داده یا quorum منجر شود. در کد cephadm (pybind/mgr/cephadm/module.py)، ورود به نگهداری با فرمان osd set-group پرچم noout را برای زیردرخت CRUSH همان میزبان تنظیم میکند تا داده بیدلیل بازتوزیع نشود، و خروج آن را برمیدارد.
۱۹-۵ از درون کد: pg_autoscaler#
۱۹-۵-۱ مسئله#
تعداد PG هر pool دو اثر متضاد دارد: PG کم یعنی توزیع ناهموار داده و موازیسازی کم؛ PG زیاد یعنی مصرف حافظه و CPU بیشتر در OSDها و peering سنگینتر. ماژول pg_autoscaler در mgr (src/pybind/mgr/pg_autoscaler/module.py) این تعادل را خودکار میکند. هدف آن این است که هر OSD حدود mon_target_pg_per_osd نسخهی PG میزبانی کند.
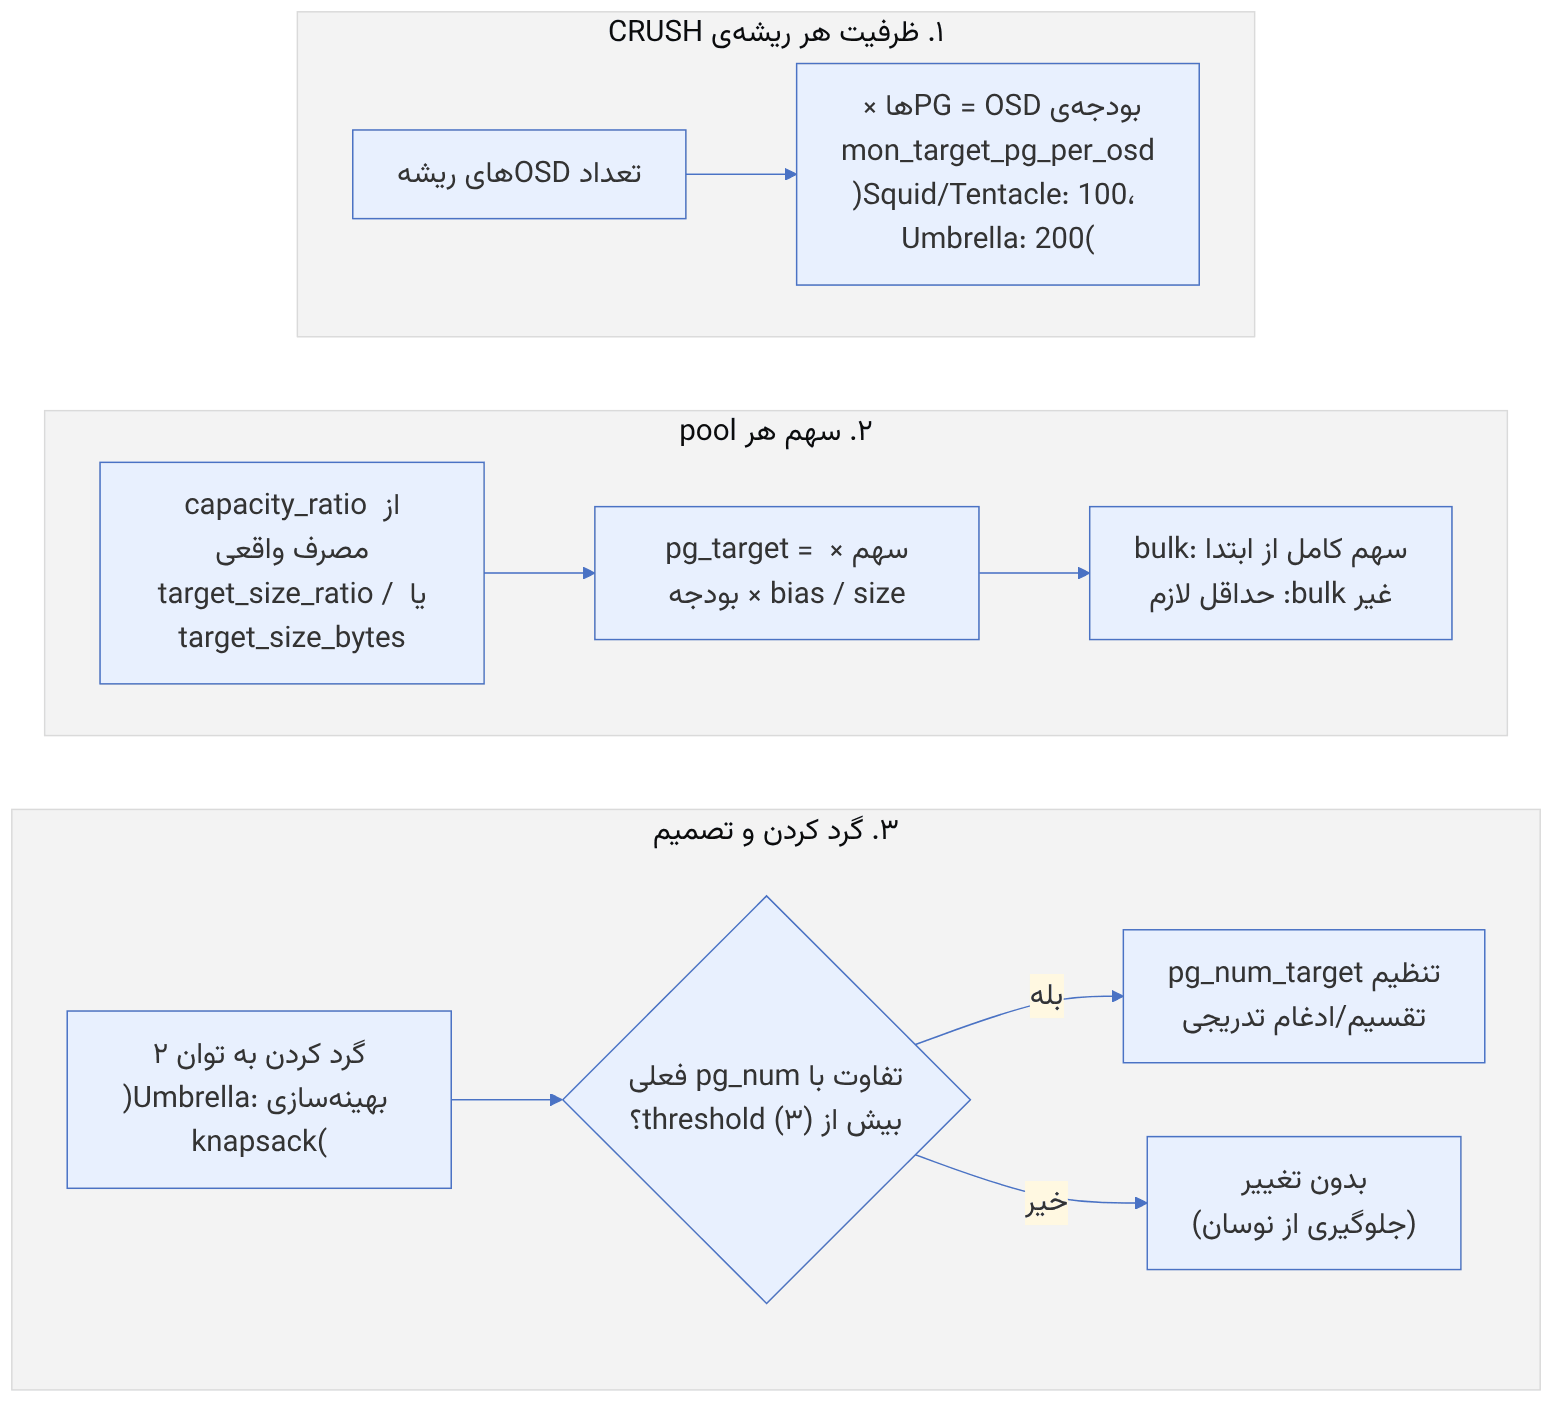
وابسته به نسخه. مقدار پیشفرض mon_target_pg_per_osd در src/common/options/mgr.yaml.in در برچسبهای v19.2.0 و v20.2.0 برابر ۱۰۰ و در v21.2.0 (Umbrella) برابر ۲۰۰ است. یعنی پس از ارتقا به Umbrella، autoscaler ممکن است برای poolهای موجود PG بیشتری پیشنهاد کند و تقسیم PG (و جابهجایی داده) آغاز شود. پیش از ارتقا ceph osd pool autoscale-status را ذخیره کنید و پس از ارتقا مقایسه کنید؛ در صورت لزوم مقدار قبلی را صریحاً با ceph config set global mon_target_pg_per_osd 100 تنظیم کنید.
۱۹-۵-۲ الگوریتم#
pseudocode: pg_autoscaler (بازنویسی این کتاب)
for root in crush_roots:
budget[root] = osds_in(root) * mon_target_pg_per_osd
for pool:
root = root_of(pool.crush_rule)
ratio = max(actual_used / root_capacity,
target_size_bytes / root_capacity,
normalized target_size_ratio) # نسبتها نرمال میشوند
pg_target = ratio * budget[root] * pool.bias / pool.size
if pool.bulk: start near full share
else: start small, grow with usage
pg_final = round_to_power_of_two(pg_target) # Umbrella: گرد کردن بهینه (knapsack)
pg_final = clamp(pg_final, pg_num_min, pg_num_max)
threshold = dynamic_threshold(pg_final) if scaling up else threshold # پیشفرض 3.0
if pg_final > pg_num_target * threshold or pg_final < pg_num_target / threshold:
if pool.mode == 'on': set pg_num_target = pg_final
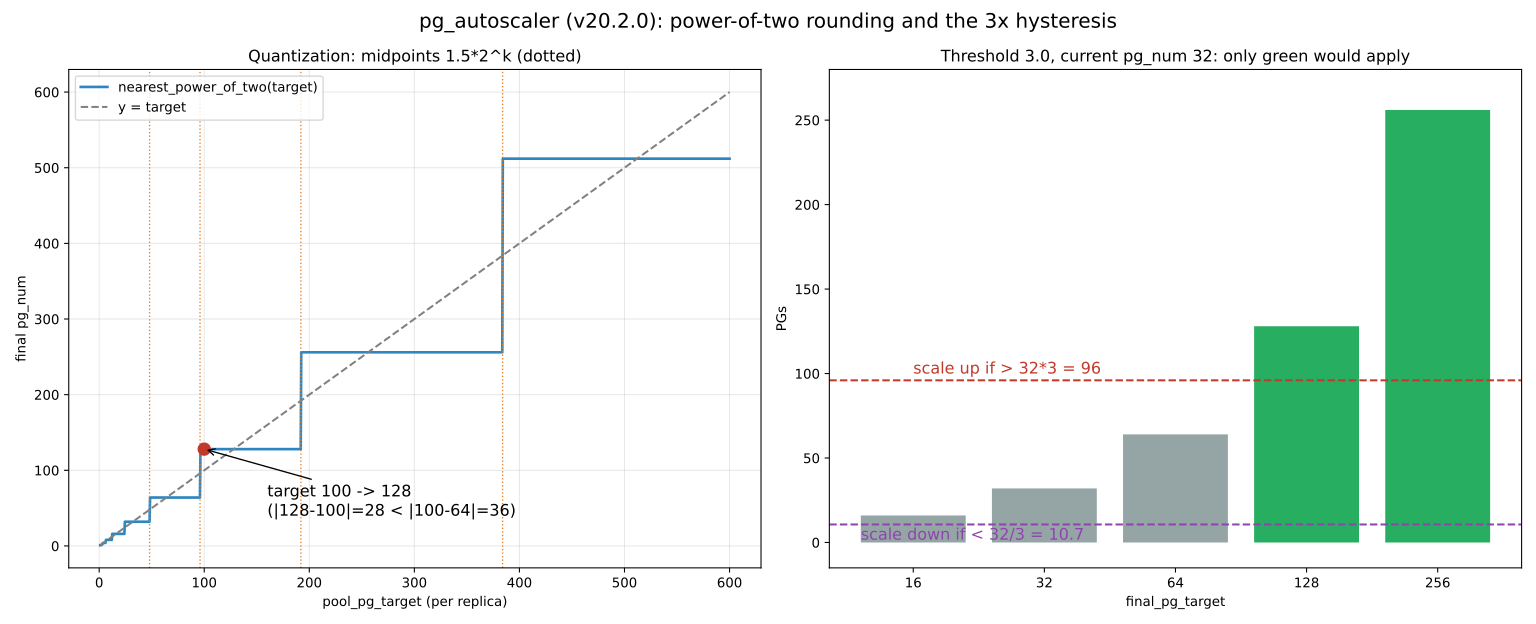
elif pool.mode == 'warn': raise POOL_TOO_FEW_PGS / POOL_TOO_MANY_PGSآستانه جلوی نوسان را میگیرد: autoscaler فقط وقتی pg_num را تغییر میدهد که مقدار ایدهآل دستکم سه برابر (پیشفرض threshold=3.0) بیشتر یا کمتر از مقدار فعلی باشد. حداقل مقدار مجاز آستانه ۱.۰ است (ceph osd pool set threshold).
در کد جاری (و Umbrella)، آستانه برای افزایش در چند اندازهی رایج پویا است:
# from ceph/ceph, LGPL — src/pybind/mgr/pg_autoscaler/module.py (excerpt)
def get_dynamic_threshold(self, final_pg_num: int, default_threshold: float) -> float:
    if final_pg_num in (512, 1024):
        return 1.0
    elif final_pg_num == 2048:
        return 2.0
    return default_threshold
یعنی رسیدن به ۵۱۲ یا ۱۰۲۴ PG بدون نیاز به اختلاف سهبرابری انجام میشود (هر افزایشی کافی است) و برای ۲۰۴۸ اختلاف دوبرابری کافی است. برای کاهش، همان آستانهی پیشفرض اعمال میشود. در Umbrella، گرد کردن pg_target به توان ۲ هم دیگر برای هر pool جداگانه انجام نمیشود: تابع _find_optimal_pg_distribution با برنامهنویسی پویای کولهپشتی تصمیم میگیرد کدام poolها رو به بالا و کدام رو به پایین گرد شوند تا مجموع خطای گرد کردن کمینه و بودجهی PG ریشه رعایت شود (این تابع در برچسب v20.2.0 وجود ندارد).
ceph osd pool autoscale-status
ceph osd pool set vm-fast target_size_ratio 0.4 # پیشبینی سهم آینده
ceph osd pool set archive bulk true # pool بزرگ: سهم کامل از ابتدا
ceph osd pool set archive pg_num_min 256
ceph osd pool get threshold
ceph osd pool set noautoscale # توقف موقت سراسری
ceph osd pool unset noautoscaleبرای poolهایی که میدانید بزرگ خواهند شد (دادهی RGW یا RBD اصلی)، از ابتدا bulk را فعال کنید. در غیر این صورت autoscaler با PG کم شروع میکند و همزمان با پر شدن pool، چند بار PGها را تقسیم میکند که هر بار جابهجایی داده دارد.
۱۹-۶ از درون کد: balancer#
۱۹-۶-۱ حالتها#
| حالت | سازوکار | پیشنیاز |
|---|---|---|
| upmap (پیشفرض) | افزودن pg_upmap_items برای جابهجایی تکتک PGها | کلاینتهای Luminous به بعد |
| crush-compat | تنظیم وزنهای جایگزین در یک weight-set سازگار | سازگار با کلاینتهای قدیمی |
| read و upmap-read | متعادل کردن primaryها (pg_upmap_primary) برای بار خواندن | کلاینتهای Reef به بعد |
۱۹-۶-۲ الگوریتم upmap#
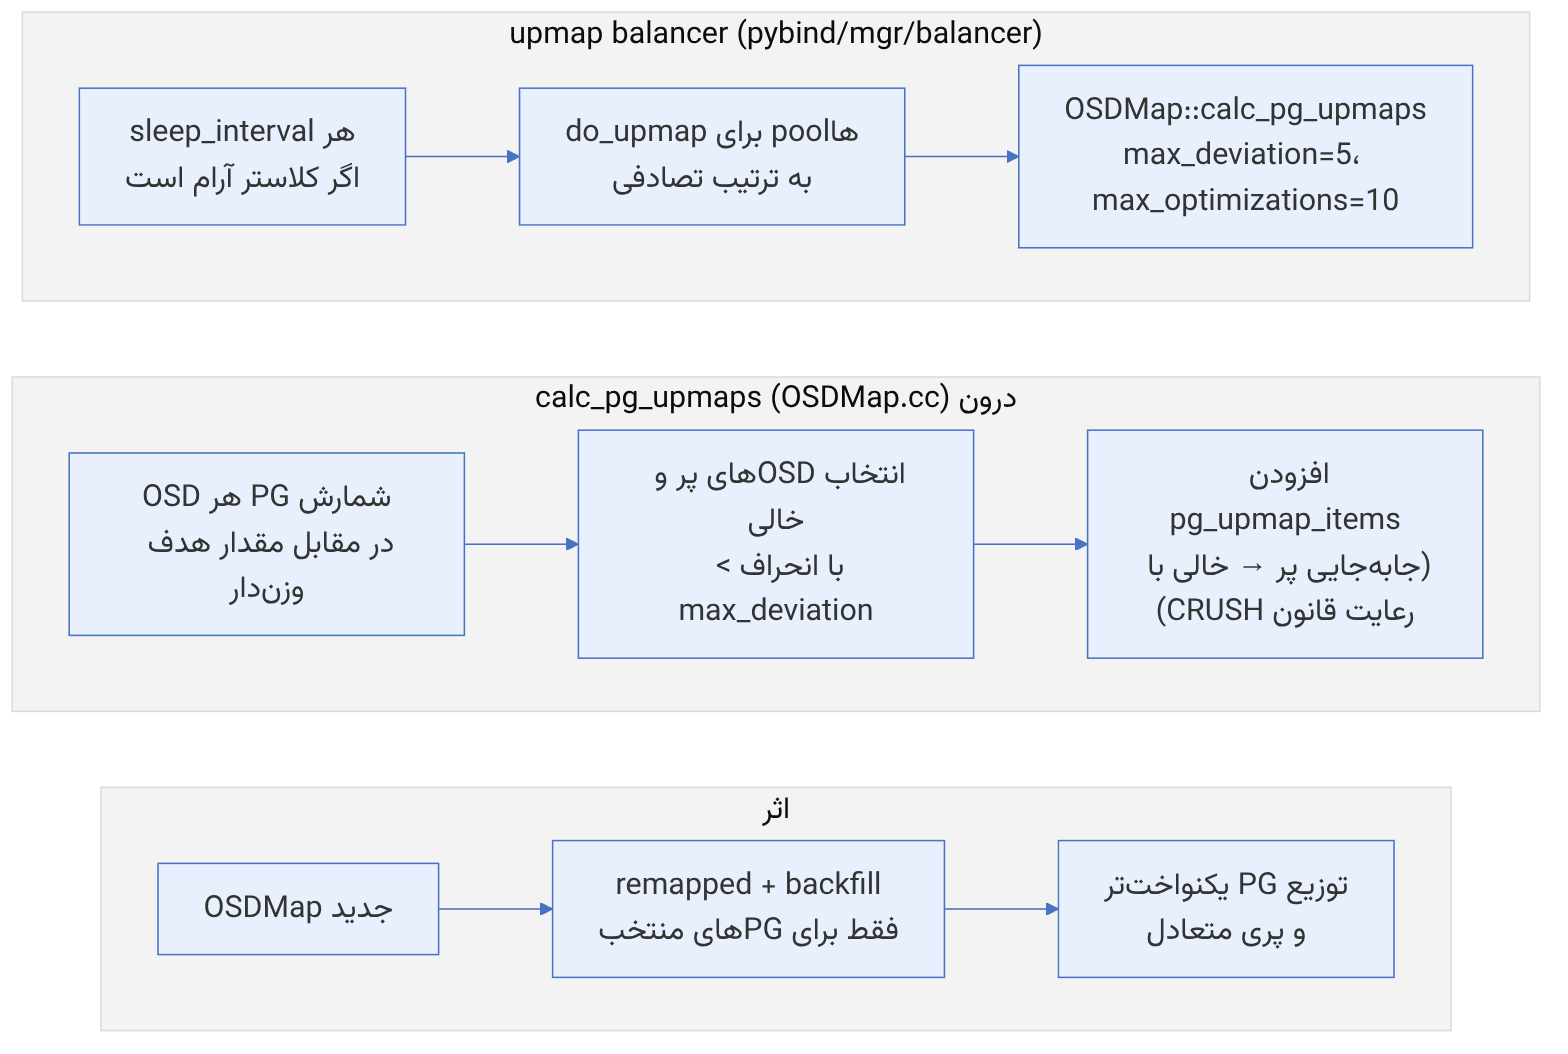
Module.do_upmap() در src/pybind/mgr/balancer/module.py با گزینههای upmap_max_optimizations (پیشفرض ۱۰، بیشینهی تغییر در هر دور) و upmap_max_deviation (پیشفرض ۵ PG) کار را به OSDMap::calc_pg_upmaps() در C++ میسپارد. منطق آن:
pseudocode: calc_pg_upmaps (خلاصهی این کتاب از OSDMap.cc)
for osd: target[osd] = total_pgs * weight[osd] / total_weight # سهم وزندار
deviation[osd] = pgs[osd] - target[osd]
repeat up to max_optimizations:
over = OSDs with deviation > max_deviation (پرترین اول)
under = OSDs with deviation < -max_deviation
if none: break
for pg on over[0]:
candidate = an OSD in under that keeps CRUSH rule valid
(همان دامنهی خرابی، بدون تکرار در up set)
if found: add pg_upmap_items[pg] += (over[0] → candidate); update counts; break
also: remove existing upmap items that no longer help
return pending incrementpg_upmap_items نگاشت CRUSH را دور نمیزند، بلکه روی خروجی CRUSH اعمال میشود: CRUSH up set را حساب میکند و سپس جفتهای (from → to) جایگزین میشوند. اگر بعداً تغییر CRUSH باعث شود upmap قانون را نقض کند (مثلاً دو نسخه در یک میزبان)، OSDMap هنگام اعمال آن را نادیده میگیرد و MON آن را پاک میکند (clean_pg_upmaps). به همین دلیل upmap ایمنتر از تغییر دستی وزنهاست.
ceph balancer status
ceph balancer mode upmap
ceph balancer on
ceph config set mgr mgr/balancer/upmap_max_deviation 1 # توزیع دقیقتر در کلاستر بزرگ
ceph balancer eval
ceph osd df tree | sort -nk17 | tail # ستونهای VAR و PGSbalancer فقط وقتی کار میکند که درصد PGهای misplaced کمتر از target_max_misplaced_ratio باشد (پیشفرض ۰.۰۵)؛ بنابراین در میانهی backfill سنگین، کار تازهای شروع نمیکند. حالتهای read balancer به کلاینتهای Reef به بعد نیاز دارند (ceph osd set-require-min-compat-client reef).
۱۹-۷ سه الگوریتم نگهداری با عدد#
بخشهای قبل autoscaler و balancer را در سطح مفهوم توضیح دادند. این بخش هر دو را تا سطح حلقه و عدد باز میکند. چون الگوریتم گرد کردن autoscaler در Umbrella عوض شده است، هر دو نسخه را جداگانه آوردهایم.
۱۹-۷-۱ گرد کردن به توان دو و آستانهی ۳ برابری#
منبع در کد: src/pybind/mgr/pg_autoscaler/module.py :: PgAutoscaler._calc_final_pg_target، nearest_power_of_two (برچسب v20.2.0)
پیچیدگی: O(P) برای P pool در هر ریشهی CRUSH؛ گرد کردن O(۱) با شیفت بیتی
pseudocode
budget[root] = Σ_osd mon_target_pg_per_osd / (تعداد ریشههای آن OSD) ; pg_left = budget
pass 1 (pool غیر bulk): used = capacity_ratio × pg_left ; pg_left −= used ; target = used / size × bias
pass 2 (bulk با ratio > even = 1/(pools − used_pools)): ratio = max(used, even) ; همان محاسبه
pass 3 (بقیهی bulk): ratio = 1/(باقی) ; target = ratio × pg_left / size × bias
final = max(pg_num_min=32, nearest_power_of_two(target)) ; final = min(final, pg_num_max)
adjust = (final > current × 3) or (final < current / 3) # threshold پیشفرض 3.0مثال عددی. ده OSD در یک ریشه با mon_target_pg_per_osd = 100 (پیشفرض v20.2.0) بودجهی ۱۰۰۰ نسخهی PG میدهند. pool غیر bulk به نام rbd با size 3 و capacity_ratio = ۰.۳ دارای used = ۳۰۰ است و target = ۳۰۰/۳ = ۱۰۰. تابع nearest_power_of_two(۱۰۰) کرانهای ۶۴ و ۱۲۸ را میسازد (با OR کردن شیفتها: ۹۹ → ۱۲۷ → ۱۲۸). چون ۱۲۸ − ۱۰۰ = ۲۸ < ۱۰۰ − ۶۴ = ۳۶، نتیجه ۱۲۸ است. اگر pg_num فعلی ۳۲ باشد، ۱۲۸ > ۹۶ است و تغییر اعمال میشود. اگر pg_num فعلی ۶۴ بود، ۱۲۸ < ۱۹۲ بود و autoscaler فقط هشدار میداد و چیزی را تغییر نمیداد. این هیسترزیس جلوی split/merge پشت سر هم را میگیرد. نقطهی تصمیم گرد کردن، ۱.۵ برابر هر توان دو است.
۱۹-۷-۲ گرد کردن سراسری با کولهپشتی (Umbrella)#
منبع در کد: src/pybind/mgr/pg_autoscaler/module.py :: PgAutoscaler._find_optimal_pg_distribution، _calculate_final_pool_pg_target، get_dynamic_threshold، PoolGroup.update (برچسب v21.2.0)
پیچیدگی: طبق docstring کد O(n·log2(budget))؛ فضای حالت = مجموعهای ممکن PG اضافه
pseudocode
برای هر گروه pool (همهدف، همsize، همbias): down = pow2_down(t)×size ، up = pow2_up(t)×size
cost_down = |down − t×size| ، cost_up = |up − t×size| ، extra = up − down
base = Σ down ; budget = pg_left − base
parent[0] = {0: (Σ cost_down)}
for group i: برای هر مجموع s در parent[i]:
s' = s + extra_i ; c' = c − cost_down_i + cost_up_i
if s' ≤ budget and (s' جدید یا c' کمتر): parent[i+1][s'] = (c', s)
opt = کمترین هزینه؛ در تساوی، بیشترین PG ; سپس عقبگرد برای یافتن گروههای «up»
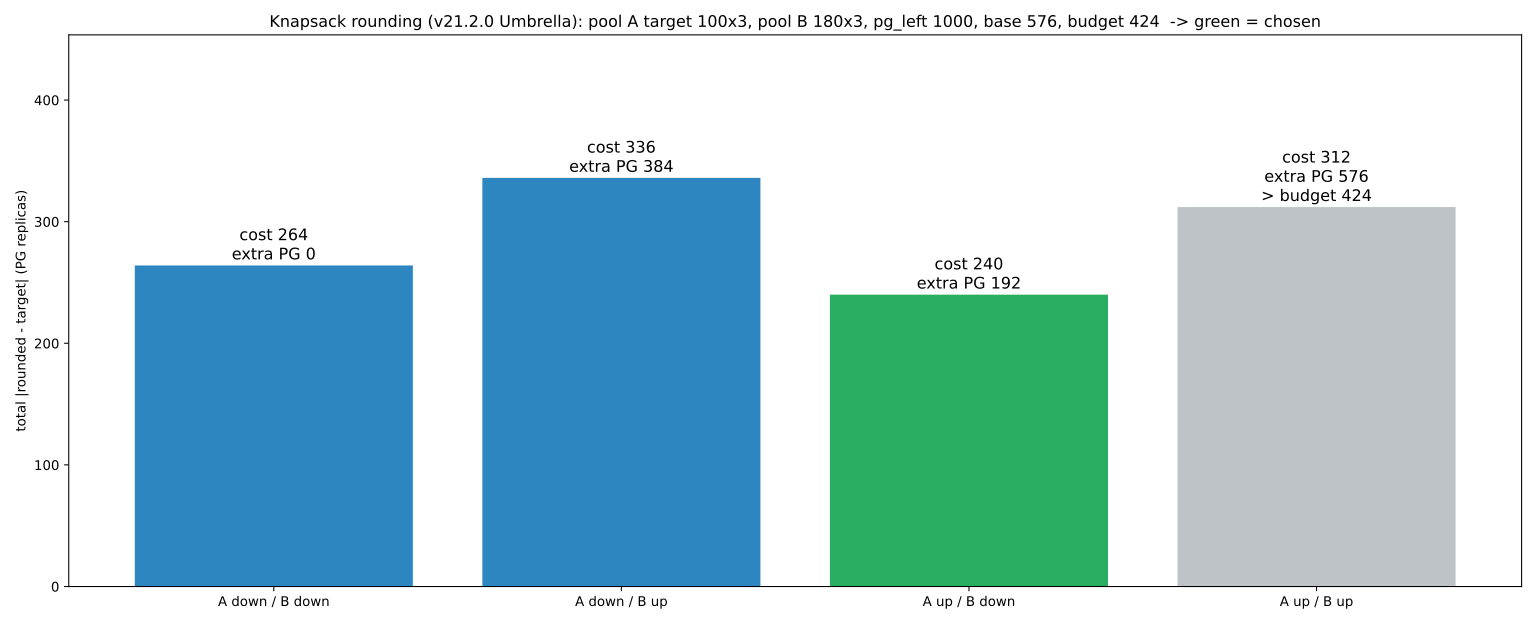
threshold پویا برای افزایش: final ∈ {512, 1024} ⇒ 1.0 ، final = 2048 ⇒ 2.0 ، وگرنه thresholdمثال عددی. pg_left = ۱۰۰۰. pool A هدف ۱۰۰ با size 3 دارد و pool B هدف ۱۸۰ با size 3.
- A: down = ۶۴×۳ = ۱۹۲، up = ۱۲۸×۳ = ۳۸۴، هزینهها ۱۰۸ و ۸۴، extra = ۱۹۲.
- B: down = ۱۲۸×۳ = ۳۸۴، up = ۲۵۶×۳ = ۷۶۸، هزینهها ۱۵۶ و ۲۲۸، extra = ۳۸۴.
base = ۵۷۶ و budget = ۴۲۴. چهار گزینه وجود دارد:
- هر دو پایین: هزینه ۲۶۴.
- فقط B بالا: ۳۳۶.
- فقط A بالا: ۲۴۰.
- هر دو بالا: ۵۷۶ PG اضافه، بیش از بودجه.
بنابراین A = ۱۲۸ و B = ۱۲۸ انتخاب میشود. در این مثال نتیجه با گرد کردن محلی یکی است. تفاوت وقتی پیدا میشود که گرد کردن محلی هر دو را بالا ببرد و بودجهی ریشه را بشکند. نسخهی سهگذره چنین چیزی را نمیدید. آستانهی پویا هم تغییر از ۲۵۶ به ۵۱۲ را بدون شرط ۳ برابری مجاز میکند.
وابسته به نسخه. این الگوریتم در برچسب v20.2.0 وجود ندارد و در v21.2.0 هست. در همان نسخه پیشفرض mon_target_pg_per_osd هم از ۱۰۰ به ۲۰۰ رسیده است، پس پس از ارتقا هم بودجه و هم روش گرد کردن تغییر میکند. در شاخهی main، کف pg_num_min بهجای ثابت PG_NUM_MIN = ۳۲ از osd_pool_default_pg_num خوانده میشود. پیش از تکیه بر آن، نسخهی خودتان را بررسی کنید.
۱۹-۷-۳ انحراف و امتیاز توازن در upmap#
منبع در کد: src/osd/OSDMap.cc :: OSDMap::calc_pg_upmaps، calc_deviations، fill_overfull_underfull
پیچیدگی: هر تکرار O(OSD + PG روی OSD پرتر × هزینهی CRUSH)؛ حداکثر upmap_max_optimizations = ۱۰ تغییر در هر دور
pseudocode
pgs_per_weight = total_pg_replicas / Σ weight
for osd: target = weight × pgs_per_weight ; dev = pgs − target
bal_score += (dev/target)^2 × weight ; max_dev = max(|dev|)
if max_dev ≤ max_deviation (5): return 0
loop (max بار): overfull = {dev > 5} ، underfull = {dev < −5}
if هر دو خالی: break ; if overfull خالی: از more_overfull (0 < dev ≤ 5) استفاده کن
از پرترین OSD: یک PG پیدا کن که جابهجاییاش به underfull قانون CRUSH را نشکند ⇒ pg_upmap_items
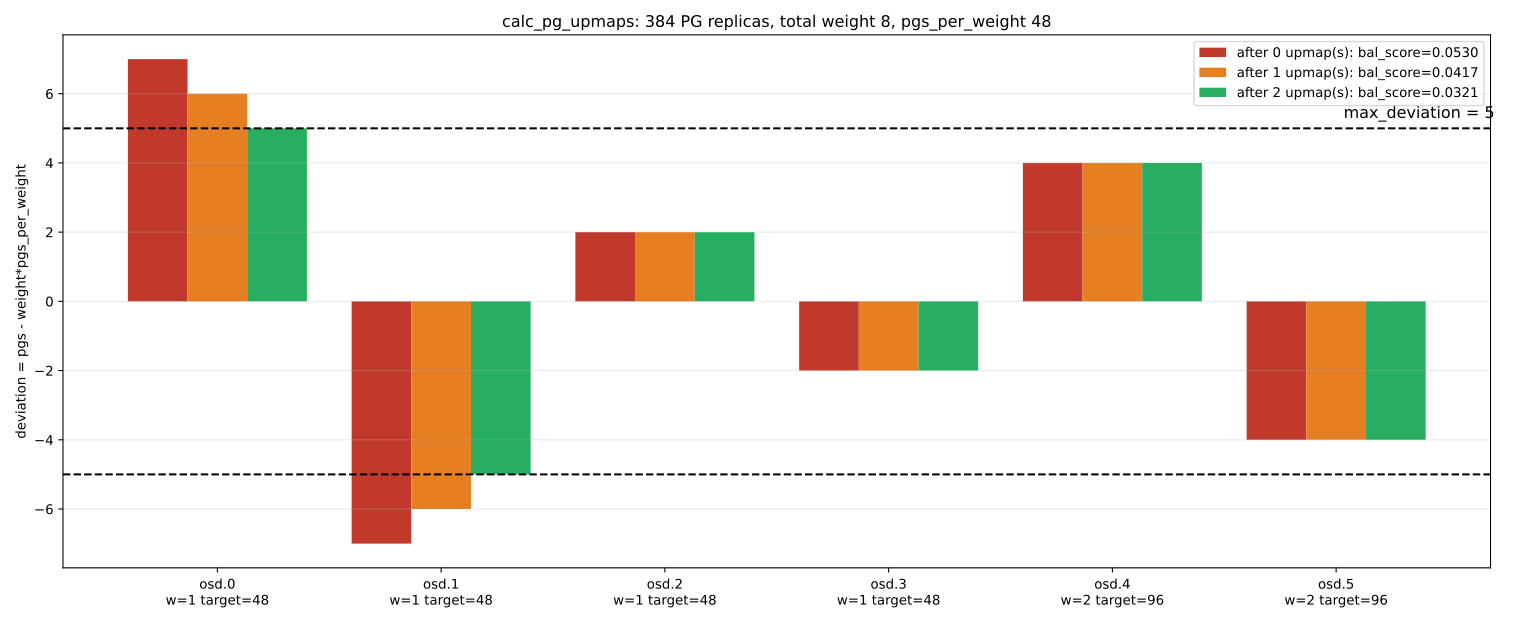
انحرافها را دوباره حساب کن ؛ فقط اگر bal_score بهتر شد بپذیرمثال عددی. شش OSD با وزنهای ۱، ۱، ۱، ۱، ۲ و ۲ (مجموع ۸) و ۳۸۴ نسخهی PG (۱۲۸ PG × size 3) داریم، پس pgs_per_weight = ۴۸. OSDهای وزن ۱ هدف ۴۸ دارند و وزن ۲ هدف ۹۶. شمارش فعلی ۵۵، ۴۱، ۵۰، ۴۶، ۱۰۰ و ۹۲ است، پس انحرافها +۷، −۷، +۲، −۲، +۴ و −۴.
- bal_score = .
- حرکت اول، یک PG از osd.0 به osd.1: انحراف ±۶ و امتیاز ۰.۰۴۱۷.
- حرکت دوم: ±۵ و امتیاز ۰.۰۳۲۱.
اکنون هیچ OSD انحراف بیش از ۵ ندارد و حلقه متوقف میشود. در عمل، انتخاب PG به قانون CRUSH محدود است. اگر osd.0 و osd.1 در یک میزبان باشند و قانون یک نسخه در هر میزبان را بخواهد، جابهجایی مستقیم ممکن نیست و الگوریتم سراغ OSD کمبار دیگری میرود. کد bal_score را عمداً در double جمع میکند، چون در float تغییر یک PG در کلاسترهای بزرگ کمتر از دقت عدد میشد و balancer متوقف میماند.
ceph balancer eval همین امتیاز را برای کل کلاستر یا یک pool گزارش میکند. ceph osd df tree ستون PGS را نشان میدهد که میتوانید انحراف را با آن دستی محاسبه کنید. برای توزیع یکنواختتر از پیشفرض، ceph config set mgr mgr/balancer/upmap_max_deviation 1 را امتحان کنید، اما این کار جابهجایی بیشتری ایجاد میکند.
۱۹-۸ balancer و split با نگاشت واقعی#
دو آزمایش این بخش روی همان نقشهی ۱۲۰ OSD (۱۰ میزبان × ۱۲، straw2، chooseleaf host، size = ۳) انجام شده است که در فصل ۱ ساختیم. ابزارها crushtool و osdmaptool از Ceph 18.2.7 بودند.
۱۹-۸-۱ upmap balancer روی ۱۰۲۴ و ۸۱۹۲ PG#
منبع در کد: src/osd/OSDMap.cc :: calc_pg_upmaps؛ src/pybind/mgr/balancer/module.py؛ همان کد در osdmaptool --upmap
پیچیدگی: هر دور O(pg_num × size) برای شمارش و انتخاب
pseudocode
برای هر OSD: target = pg_num × size × (وزن OSD / وزن کل pool)
deviation(o) = PGهای o − target(o)
تا وقتی max |deviation| > upmap_max_deviation و تعداد تغییرها < upmap_max:
o_over = بیشترین deviation مثبت ؛ o_under = بیشترین deviation منفی، با همان failure domain مجاز
یک PG از o_over بردار که قاعدهی CRUSH را نقض نکند و به o_under ببر
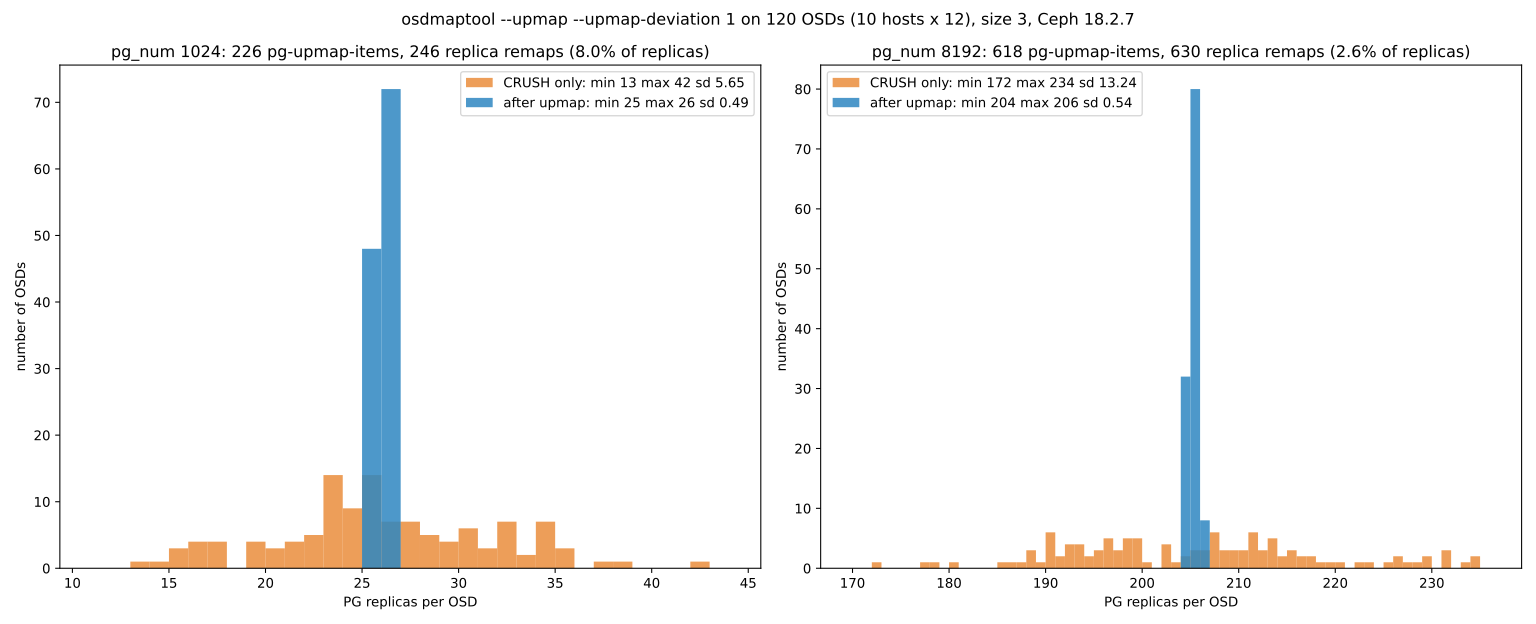
← ورودی pg-upmap-items: pg o_over o_underاندازهگیری. دستور osdmaptool om --mark-up-in --upmap out.txt --upmap-deviation 1 --upmap-max 10000 --upmap-pool rbd --save روی دو osdmap اجرا شد.
با ۸۱۹۲ PG، تنها CRUSH بین ۱۷۲ و ۲۳۴ PG به هر OSD میدهد (انحراف معیار ۱۳.۲۴ در برابر میانگین ۲۰۴.۸). بعد از ۶۱۸ ورودی pg-upmap-items (۶۳۰ جفت OSD، یعنی ۲.۶٪ replicaها) بازه به ۲۰۴ تا ۲۰۶ و انحراف معیار به ۰.۵۴ رسید.
با ۱۰۲۴ PG، بازه از ۱۳ تا ۴۲ به ۲۵ تا ۲۶ رسید. این کار ۲۲۶ ورودی و ۲۴۶ جفت لازم داشت که ۸.۰٪ replicaهاست. یعنی سهم جابهجایی لازم برای یکنواخت شدن در pg_num کم بیشتر است.
چون CRUSH با pg_num بالا یکنواختتر است، balancer هم کار کمتری دارد. اما در هر دو حالت برطرف کردن انحراف چند درصد داده را جابهجا میکند و balancer آن را با همان سقف ۵٪ (target_max_misplaced_ratio) قسطبندی میکند.
۱۹-۸-۲ دو برابر کردن pg_num: نیمی از داده جابهجا میشود#
منبع در کد: src/mgr/DaemonServer.cc :: adjust_pgs؛ گزینههای target_max_misplaced_ratio = 0.05 (global.yaml.in) و mgr_max_pg_num_change = 128 (mgr.yaml.in)
پیچیدگی: O(تعداد pool) در هر دور
pseudocode
اگر همهی PGهای pool فعالاند و pg_num − pgp_num < 128:
pg_num += min(128 − (pg_num − pgp_num), pg_num_target − pg_num) # split، هنوز بدون جابهجایی
target = min(pg_num_pending, pgp_num_target)
اگر inactive یا degraded یا unknown > 0 یا misplaced > 0.05: صبر
اگر pool تقریباً خالی است (اشیا ≤ pgp_num_target): pgp_num = target یکجا
وگرنه: room = min(0.05 − misplaced, 0.025) ؛ estmax = max(⌊pg_num × room⌋, 1)
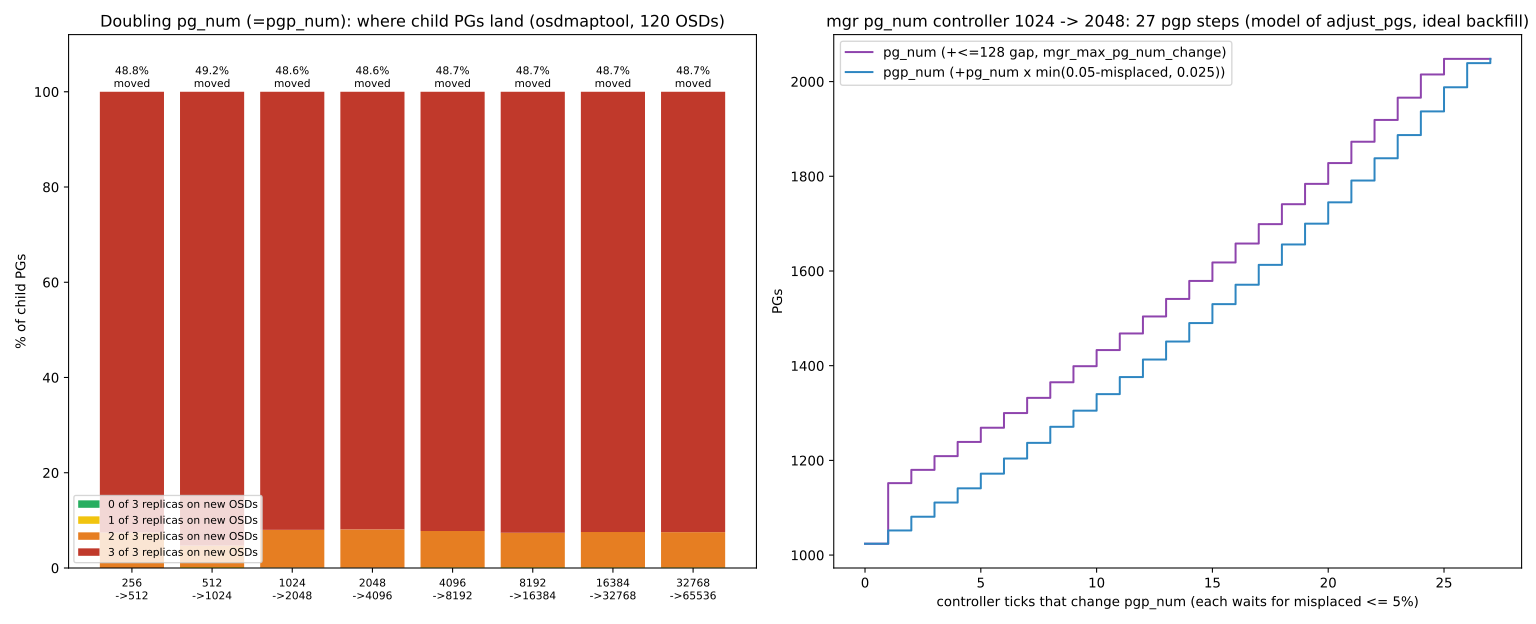
pgp_num = clamp(target, pgp_num − estmax, pgp_num + estmax) # جابهجایی واقعی اینجاستاندازهگیری. برای هر دو برابر شدن، نگاشت PG فرزند ps + n با نگاشت PG والد ps در osdmap قبلی مقایسه شد (pgp_num برابر pg_num). در همهی گامها از ۲۵۶ به ۵۱۲ تا ۳۲۷۶۸ به ۶۵۵۳۶، حدود ۹۲٪ فرزندها روی هر سه OSD جدید نشستند و بقیه تقریباً همه روی دو OSD جدید. در مجموع ۴۸.۶ تا ۴۹.۲ درصد کل داده جابهجا شد. هیچ PG والدی جای خود را عوض نکرد.
این عدد با یک برآورد ساده میخواند. نیمی از داده به فرزندها میرود. احتمال اینکه یک replica فرزند تصادفاً روی یکی از OSDهای والد بنشیند حدود ۳/۱۲۰ است. پس ۰.۵ × (۱ − ۳/۱۲۰) ≈ ۴۸.۷۵٪.
تا وقتی pgp_num بالا نرفته، فرزند با ceph_stable_mod(ps, pgp_num, mask) به همان جای والد نگاشت میشود و split فقط فراداده است. جابهجایی واقعی با بالا رفتن pgp_num رخ میدهد.
مدل کنترلگر نشان میدهد که mgr این جابهجایی را در گامهایی به اندازهی حدود ۲.۵٪ pg_num پخش میکند. شبیهسازی ۱۰۲۴ به ۲۰۴۸ با فرض پایان backfill پیش از هر دور، ۲۷ گام میدهد که نخستینشان ۱۰۲۴ به ۱۰۵۲ است. پس افزایش pg_num روی pool پر، معادل جابهجایی نیمی از دادهی pool است و بسته به حجم چند ساعت تا چند روز طول میکشد.
۱۹-۹ مدیریت پیکربندی#
از Mimic، پیکربندی مرکزی در پایگاه دادهی MON نگهداری میشود و ceph.conf روی میزبانها فقط برای یافتن MONها لازم است. این یعنی تغییرات پیکربندی قابل ردیابی، قابل بازگشت و یکسان روی همهی daemonها هستند.
ceph config dump | head
ceph config get osd.12 osd_memory_target
ceph config show osd.12 | grep -E "osd_memory_target|osd_max_backfills" # مقدار مؤثر و منبع آن
ceph config set osd/class:hdd osd_memory_target 6G # mask بر اساس device class
ceph config set osd.12 debug_osd 10/10 # موقت برای عیبیابی
ceph config rm osd.12 debug_osd
ceph config log 20 # تاریخچهی تغییرات
ceph config reset 1234 # بازگشت به نسخهی مشخص
ceph config help osd_op_queueceph config log و ceph config reset <num> ابزار بازگشت سریع پس از تغییر اشتباه هستند. پیش از هر تغییر گسترده، شمارهی آخرین ورودی log را یادداشت کنید.
تنظیماتی که با ceph tell osd.* injectargs یا ceph daemon ... config set اعمال میشوند موقتاند و پس از راهاندازی دوباره از بین میروند. برای ماندگاری، ceph config set به کار ببرید؛ برای تغییر موقت در حادثه، آگاهانه از tell استفاده کنید و در لاگ حادثه ثبت کنید.
۱۹-۱۰ پرچمهای نگهداری#
| پرچم | اثر | کاربرد |
|---|---|---|
| noout | OSDهای down به out نمیروند | نگهداری کوتاه (ترجیحاً set-group برای یک میزبان) |
| norebalance | جابهجایی برای متعادلسازی متوقف | تغییرات پیدرپی CRUSH |
| nobackfill / norecover | backfill یا recovery متوقف | کاهش بار در زمان اوج (موقت و خطرناک) |
| noscrub / nodeep-scrub | scrub جدید شروع نمیشود | ارتقا یا بار سنگین |
| pause | همهی خواندن و نوشتن متوقف | فقط شرایط اضطراری خاص |
ceph osd set-group noout stor-b3          # فقط OSDهای یک میزبان
ceph osd unset-group noout stor-b3
ceph osd set norebalance && ceph osd unset norebalance۱۹-۱۱ کارهای دورهای#
| بازه | کار |
|---|---|
| روزانه | ceph -s، هشدارهای تازه، ceph crash ls-new، پری (ceph df) |
| هفتگی | ceph osd df tree (VAR و PGS)، deep scrubهای عقبافتاده، وضعیت mirroring و multisite |
| ماهانه | بررسی نسخهها و انتشارهای نقطهای، بازبینی SMART دیسکها (ceph device ls)، آزمون بازیابی |
| فصلی | تمرین failover، بازبینی ظرفیت و پیشبینی رشد، بازبینی capها و کلیدها |
ماژول devicehealth در mgr دادهی SMART دیسکها را جمع میکند: ceph device ls، ceph device get-health-metrics <devid> و پیشبینی خرابی با ceph device predict-life-expectancy <devid>؛ پیشبینی بهصورت پیشفرض خاموش است (device_failure_prediction_mode=none) و برای حالت local باید ماژول diskprediction_local را فعال کنید. با mgr/devicehealth/mark_out_threshold میتوان OSD دیسک رو به خرابی را پیش از خرابی خودکار out کرد.
- ارتقا را فقط روی کلاستر سالم و پس از خواندن یادداشتهای انتشار شروع کنید.
- پس از ارتقا به Umbrella، تغییر پیشفرض mon_target_pg_per_osd (۱۰۰ به ۲۰۰) را مدیریت کنید.
- برای جایگزینی دیسک همیشه
--replace را به کار ببرید. - noout را با set-group برای یک میزبان و موقت تنظیم کنید.
- poolهای بزرگ را از ابتدا bulk کنید.
- همهی تغییرات پیکربندی را با ceph config و قابل بازگشت انجام دهید.
۱۹-۱۲ تکمیلی و بهروز#
- ارتقای OSD بر اساس bucket CRUSH و فرمان
ceph osd ok-to-upgrade در مستندات Umbrella آمده است. - در Umbrella، پیشفرض
mon_target_pg_per_osd به ۲۰۰ رسیده و گرد کردن PGها با بهینهسازی سراسری انجام میشود. -
ceph-deploy بایگانی شده و همهی روالها با cephadm انجام میشوند؛ ceph-ansible همچنان «فعلاً» نگهداری میشود و مهاجرت به cephadm توصیه شده است (فصل ۱۱). - read balancer از Reef برای متوازن کردن primaryها در دسترس است.
۱۹-۱۳ تمرین عملی#
- ۱. یک ارتقای نقطهای در کلاستر آزمایشی انجام دهید و ترتیب ارتقای daemonها را از
ceph -W cephadm ثبت کنید. - ۲. یک OSD را با
--replace حذف و دوباره بسازید؛ مقدار دادهی backfillشده را با حذف بدون --replace مقایسه کنید. - ۳. یک میزبان را به حالت نگهداری ببرید و پرچم noout گروهی را در
ceph osd dump ببینید. - ۴. خروجی
ceph osd pool autoscale-status را پیش و پس از تنظیم bulk و target_size_ratio مقایسه کنید. - ۵.
upmap_max_deviation را به ۱ کاهش دهید و تغییر ستون PGS در ceph osd df را دنبال کنید. - ۶. در
pg_autoscaler/module.py جای اعمال pg_num_min و pg_num_max را پیدا کنید.
۱۹-۱۴ پرسشهای مرور#
- ۱. ترتیب ارتقای daemonها در cephadm چیست و چرا mgr اول است؟
- ۲. ارتقای OSD بر اساس bucket CRUSH چه مزیتی دارد؟
- ۳. چرا
--replace جابهجایی داده را کم میکند؟ - ۴. maintenance enter چه کاری با پرچم noout انجام میدهد؟
- ۵. فرمول پایهی pg_target در autoscaler چیست؟
- ۶. آستانهی autoscaler چه مشکلی را حل میکند و آستانهی پویا چه زمانی اعمال میشود؟
- ۷. تغییر پیشفرض mon_target_pg_per_osd در Umbrella چه پیامدی دارد؟
- ۸. upmap balancer چگونه PGی را برای جابهجایی انتخاب میکند؟
- ۹. چرا upmap ایمنتر از تغییر دستی وزنهاست؟
- ۱۰. تفاوت ceph config set و injectargs چیست؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۹-۱۵ منابع این فصل#
- cephadm upgrade
https://docs.ceph.com/en/latest/cephadm/upgrade/ - cephadm upgrade (Umbrella
https://docs.ceph.com/en/umbrella/cephadm/upgrade/ - cephadm host management
https://docs.ceph.com/en/latest/cephadm/host-management/ - cephadm OSD service
https://docs.ceph.com/en/latest/cephadm/services/osd/ - Placement groups and autoscaling
https://docs.ceph.com/en/latest/rados/operations/placement-groups/ - Balancer
https://docs.ceph.com/en/latest/rados/operations/balancer/ - Configuring Ceph (central config
https://docs.ceph.com/en/latest/rados/configuration/ceph-conf/ - Source: src/mon/ConfigMonitor.cc (config log / reset
https://github.com/ceph/ceph/blob/main/src/mon/ConfigMonitor.cc - Device management
https://docs.ceph.com/en/latest/rados/operations/devices/ - Ceph releases
https://docs.ceph.com/en/latest/releases/ - Source: src/pybind/mgr/pg_autoscaler/module.py
https://github.com/ceph/ceph/blob/main/src/pybind/mgr/pg_autoscaler/module.py - Source: src/pybind/mgr/balancer/module.py
https://github.com/ceph/ceph/blob/main/src/pybind/mgr/balancer/module.py - Source: src/osd/OSDMap.cc (calc_pg_upmaps
https://github.com/ceph/ceph/blob/main/src/osd/OSDMap.cc