بخش تخصصی (۹): RGW — درون multisite: period، قالب لاگها، نسلهای bucket و موتور همگامسازی
حوصله ندارم این فصل در چند خط
- period پیکربندی multisite را ثبت میکند؛ تغییرات stage و سپس commit میشوند و epoch بالا میرود.
- metadata log، data log و bucket index log تغییرات را ثبت میکنند؛ zones_trace جلوی برگشت تغییرات به مبدأ را میگیرد.
- اشیای وضعیت sync در log pool مربوط به zone مقصد و با نام zone مبدأ نگه داشته میشوند.
- data sync با وجود خطاها marker هر shard را جلو میبرد و خطاها را از error repo دوباره امتحان میکند؛ نوشتن متادیتا به zone اصلی نیاز دارد.
۴۲-۱ پیش از شروع#
فصل ۵ multisite را از دید راهاندازی و بهرهبرداری آورد: سلسلهمراتب realm، zonegroup و zone، سه لاگ، ماشین حالت data sync، انتخاب shard datalog و mdlog، پنجرهی ادغام و trim. این فصل آخرِ بخش تخصصی، درون همان موتور را باز میکند: commit یک period دقیقاً چه بررسیهایی دارد و چه زمانی period جدید میسازد، رکوردهای bilog، datalog و mdlog چه فیلدهایی دارند، وضعیت همگامسازی در کدام اشیای RADOS است، reshard چگونه با «نسل»های لاگ با همگامسازی کنار میآید، خطاها کجا صف میشوند و تعارض نوشتن همزمان در دو zone چگونه حل میشود. نامها با شاخهی main (نوامبر ۲۰۲۶) تطبیق داده شدهاند.
۴۲-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
- چرا
period update --commit گاهی epoch را بالا میبرد و گاهی شناسهی period را عوض میکند؟ - یک ورودی bilog و یک ورودی datalog چه اطلاعاتی حمل میکنند؟
- وضعیت همگامسازی یک bucket shard در کدام شیء و با چه نامی ذخیره میشود؟
- پس از reshard در zone مبدأ، zone مقصد چگونه بدون از دست دادن تغییرات ادامه میدهد؟
- اگر همگامسازی یک bucket شکست بخورد، کجا ثبت و کی دوباره امتحان میشود؟
- اگر یک شیء همزمان در دو zone نوشته شود، کدام نسخه میماند؟
۴۲-۱-۲ پیشنیاز#
فصل ۵ (multisite)، فصل ۴۰ (bucket index و bilog) و فصل ۴۱ (مسیر درخواست).
۴۲-۲ period و commit#
پیکربندی multisite در یک period ثبت میشود: شناسه، epoch، realm_epoch، predecessor_uuid، master zonegroup و master zone و نقشهی کامل zonegroupها. تغییرها ابتدا در period «staging» (شناسهی <realm-id>:staging) جمع میشوند و radosgw-admin period update --commit آن را بر پایهی period جاری میسازد.
منبع در کد: src/rgw/rgw_zone.cc :: commit_period؛ src/rgw/rgw_period.cc
پیچیدگی: O(اندازهی نقشهی period)؛ سپس انتشار به همهی zoneها
pseudocode
commit_period(staging, current):
    require staging.master_zone == this zone                     # only the master zone commits
    require staging.predecessor_uuid == current.id
    require staging.realm_epoch == current.realm_epoch + 1
    if staging.master_zone != current.master_zone:               # failover / master change
        store current metadata sync status into the new period
        new period id ; epoch = FIRST_EPOCH ; realm_epoch advances
        set as realm's current period ; new mdlog prefix meta.log.<new-period>.
    else:
        require staging.epoch == current.epoch (else "period pull")
        keep current.id ; epoch = current.epoch + 1                # same period, newer epoch
    store period ; notify all zones (push to their /admin/realm/period)
نتیجه: تغییرهای معمولی (افزودن zone، endpoint، placement) فقط epoch را بالا میبرند و mdlog ادامه مییابد. اما تغییر master zone یک period جدید و در نتیجه mdlog جدید میسازد؛ وضعیت همگامسازی فراداده در period قبلی ذخیره میشود تا zoneها بتوانند ابتدا لاگ period قدیمی را تا انتها بخوانند و سپس به period جدید بروند. پیام «does not come directly after current realm epoch. Use 'realm pull'» یعنی این zone period جاری را ندارد.
# مثال: دیدن period جاری
radosgw-admin period get-current
radosgw-admin period get | jq '{id, epoch, realm_epoch, predecessor_uuid, master_zone}'مثال (خروجی):
{ "current_period": "7c1f2b9e-5d1a-4c2e-9a0f-3b8d6e4f1a20" }
{ "id": "7c1f2b9e-5d1a-4c2e-9a0f-3b8d6e4f1a20", "epoch": 4, "realm_epoch": 2,
"predecessor_uuid": "0e9a4d33-1b6c-4f7e-8a25-c5d2f8b7e911", "master_zone": "b3a9e1c4-...-zone-a" }۴۲-۳ قالب رکوردهای لاگ#
| لاگ | محل | رکورد | فیلدهای اصلی |
|---|---|---|---|
| bilog | در حالت InIndex در omap هر shard ایندکس با کلید 0x80 0_<index_ver>… (فصل ۴۰)؛ در حالت FIFO در اشیای FIFO جدا | rgw_bi_log_entry | id، object، instance، timestamp، ver، op، state، index_ver، tag، bilog_flags، owner (برای delete marker)، zones_trace |
| datalog | data_log.<N> در pool لاگ (FIFO یا omap) | rgw_data_change | entity_type، key (bucket:instance:shard)، timestamp، gen |
| mdlog | meta.log.<period>.<N> در pool لاگ | ورودی cls_log با section و name (مثلاً bucket و photos) و دادهی RGWMetadataLogData | read_version، write_version، status |
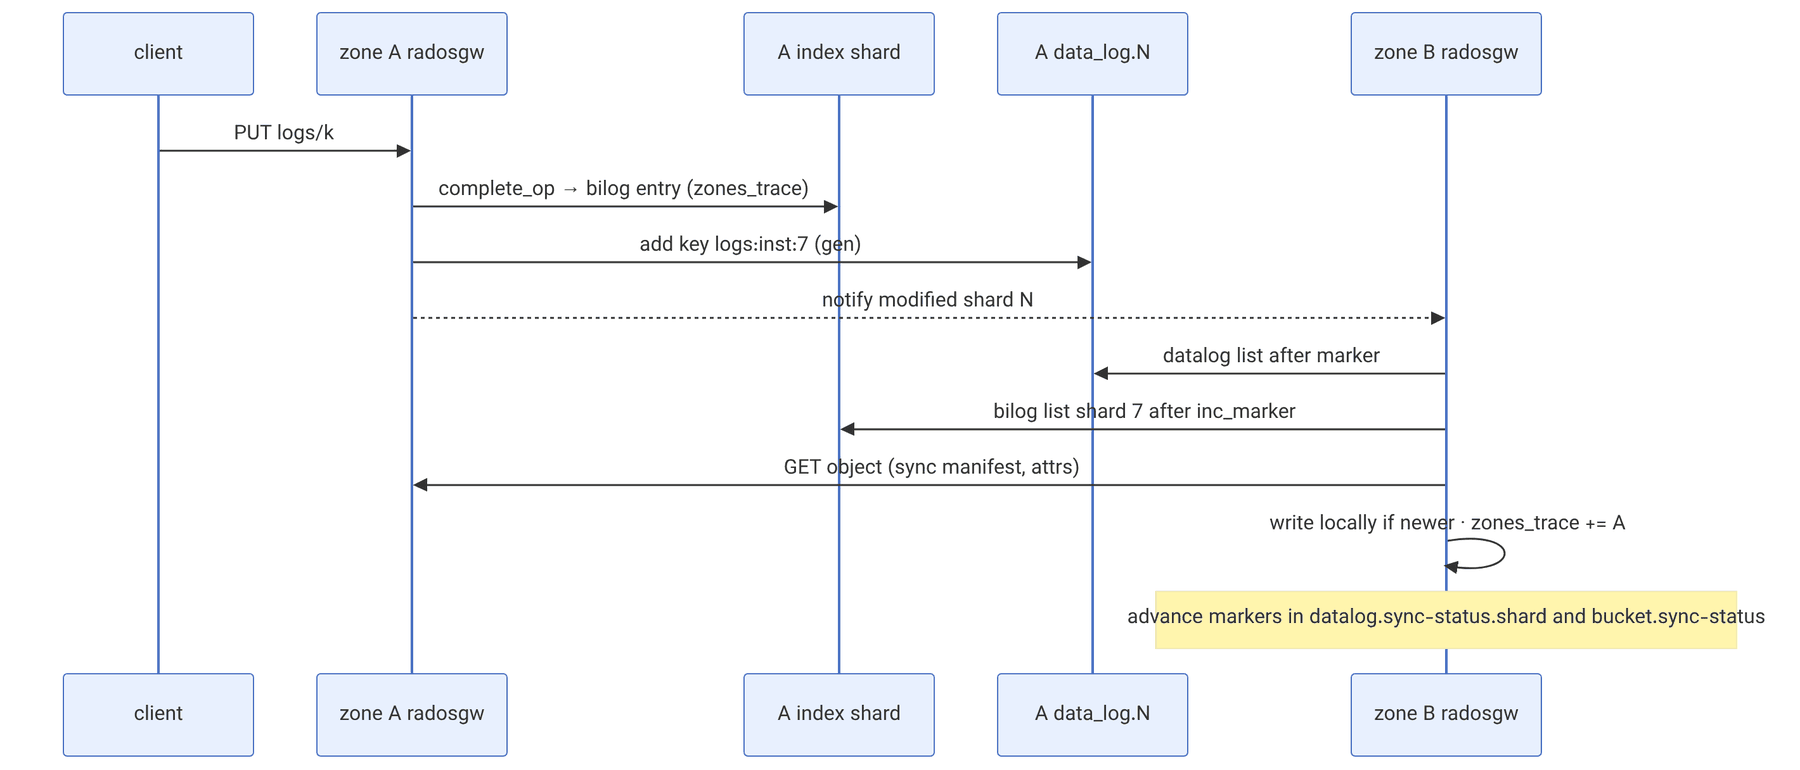
zones_trace فهرست zoneهایی است که یک تغییر از آنها گذشته؛ وقتی zone مقصد شیء را از مبدأ میگیرد و خودش یک ورودی bilog مینویسد، zone مبدأ در trace است و هنگام همگامسازی معکوس دوباره برگردانده نمیشود. بدون آن در توپولوژی active-active هر نوشتن در یک حلقهی بیپایان رفتوبرگشت میکرد.
فیلد gen در datalog (و پسوند نسل در نام وضعیتها) فقط پس از reshardهایی معنا دارد که نسل جدید ساختهاند؛ رمزگذاری rgw_data_change وقتی gen صفر است compat ۱ دارد و در غیر این صورت ۲، پس RGWهای قدیمی ورودیهای بدون نسل را همچنان میخوانند.
۴۲-۴ وضعیت همگامسازی روی RADOS#
همهی وضعیتها در pool لاگ zone مقصد (<zone>.rgw.log) و بر پایهی شناسهی zone مبدأ نامگذاری میشوند (rgw_data_sync.cc و rgw_sync.cc):
| شیء | محتوا |
|---|---|
datalog.sync-status.<src-zone> | rgw_data_sync_info: حالت کلی (Init، BuildingFullSyncMaps، Sync) و تعداد shard |
datalog.sync-status.shard.<src-zone>.<N> | rgw_data_sync_marker: حالت shard، marker، next_step_marker، total_entries، pos، timestamp |
datalog.sync-status.shard.<src-zone>.<N>.retry | error repo: کلید bucket shardهای شکستخورده در omap |
data.full-sync.index.<src-zone>.<N> | فهرست bucketهای این shard برای full sync |
bucket.full-sync-status.<src-zone>:<bucket> | rgw_bucket_sync_status: state، full، incremental_gen، shards_done_with_gen |
bucket.sync-status.<src-zone>:<bucket>:<shard>[:<gen>] | rgw_bucket_shard_sync_info: حالت (Init، FullSync، IncrementalSync، Stopped) و inc_marker |
mdlog.sync-status و mdlog.sync-status.shard.<N> | وضعیت همگامسازی فراداده |
data-sync-bids و meta-sync-bids | پیشنهادهای RGWها برای مالکیت shardها |
هر shard datalog در هر لحظه فقط توسط یک RGW در zone مقصد پردازش میشود. این کار با یک lease (قفل cls با rgw_sync_lease_period ۲ دقیقه که تمدید میشود) و در نسخههای جدید با سازوکار bid انجام میشود که shardها را میان RGWهای در دسترس پخش میکند؛ RGWی که bid را ببازد shard را رها میکند.
۴۲-۵ موتور همگامسازی داده#
منبع در کد: src/rgw/driver/rados/rgw_data_sync.cc :: RGWDataSyncShardCR، RGWDataIncSyncShardCR، RGWDataSyncSingleEntryCR، RGWDataFullSyncShardCR
پیچیدگی: O(ورودیهای جدید datalog)؛ حداکثر rgw_data_sync_spawn_window (۲۰) bucket shard همزمان
pseudocode
for each datalog shard N owned by this RGW (lease or bid):
    state Init → BuildingFullSyncMaps: list all buckets of source into data.full-sync.index.*
    full sync: for each bucket shard in index → sync bucket shard (full) ; advance marker
    incremental: loop
        also wake on out-of-band notify from source (modified shards)
        entries = remote datalog list(N, after marker)
        for each entry key = bucket:instance:shard (gen):
            spawn RGWDataSyncSingleEntryCR (≤ 20 in flight, same key coalesced)
                ok   → advance marker when all earlier entries done (marker tracker)
                fail → write key to <status>.retry (error repo) ; marker still advances
every pass: retry keys from error repo with backoff ; remove on successنکتهی اساسی این است که marker shard با وجود شکست جلو میرود؛ وگرنه یک bucket خراب کل shard را متوقف میکرد. شکستها در error repo میمانند و جداگانه تکرار میشوند. radosgw-admin sync error list شکستهای قطعی ثبتشده را نشان میدهد و data sync status --shard-id N --source-zone Z جزئیات یک shard را.
منبع در کد: src/rgw/driver/rados/rgw_data_sync.cc :: RGWSyncBucketCR، RGWBucketFullSyncCR، RGWBucketShardIncrementalSyncCR، RGWObjFetchCR؛ src/rgw/driver/rados/rgw_rados.cc :: fetch_remote_obj، obj_time_weight
پیچیدگی: full: O(اشیای bucket)؛ incremental: O(ورودیهای bilog پس از marker)
pseudocode
sync bucket (source bucket, dest bucket, gen):
    status = bucket.full-sync-status ; if Init → Full: list source bucket (versions) and fetch each
    init: incremental_gen = source latest_gen (full listing already covers older generations)
    Full done → Incremental
    incremental shard: bilog list(shard, gen, after inc_marker) from source
        squash entries of same object/instance ; skip entries whose zones_trace has this zone
        for each: ADD / LINK_OLH → fetch_remote_obj ; DEL / UNLINK_INSTANCE → remove locally
        advance inc_marker via marker tracker
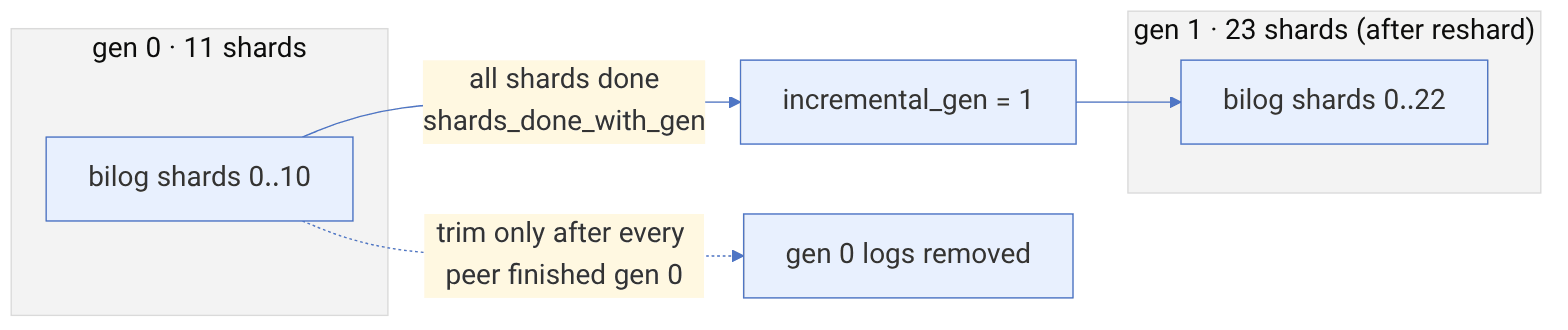
    when every shard of gen is done (shards_done_with_gen) and remote has gen+1:
        incremental_gen = gen+1 (shard count may differ after reshard)
fetch_remote_obj(copy_if_newer):
    GET object from source zone (with sync manifest, attrs, versioned_epoch)
    compare obj_time_weight: mtime (seconds unless high precision), then zone_short_id, then pg_ver
if destination copy is not older → skip ; else write locally, zones_trace += sourceنسلها و reshard. در مدل قدیمی reshard در یک zone، bilogهای shardهای قدیمی را از بین میبرد و zone مقصد مجبور میشد آن bucket را از نو full sync کند. با layout نسلدار، reshard نسل gen+1 را با تعداد shard تازه میسازد و bilogهای نسل قبلی را تا زمانی نگه میدارد که همهی peerها shards_done_with_gen آن نسل را کامل کرده باشند. مقصد نسل قدیم را تا انتها میخواند، سپس به نسل جدید میرود؛ وضعیت هر shard با پسوند :<gen> جدا ذخیره میشود. trim خودکار لاگ نسل قدیمی (rgw_sync_log_trim_interval ۲۰ دقیقه) پس از آن انجام میشود.
مثال تعارض. شیء k در zone A ساعت ۰۷:۱۵:۰۰.۴۰۰ و در zone B ساعت ۰۷:۱۵:۰۰.۹۰۰ نوشته میشود (همان ثانیه). با دقت ثانیه mtimeها برابرند و تصمیم با zone_short_id گرفته میشود: نسخهی zone با شناسهی کوتاه بزرگتر برنده است و هر دو zone در پایان همان نسخه را خواهند داشت. یعنی multisite آخرین نوشتن را به معنای دقیق زمانی تضمین نمیکند؛ برنامههایی که به ترتیب نوشتن حساساند باید هر کلید را فقط در یک zone بنویسند یا از versioning استفاده کنند.
۴۲-۶ همگامسازی فراداده#
منبع در کد: src/rgw/driver/rados/rgw_sync.cc :: RGWMetaSyncCR، RGWMetaSyncShardCR، RGWMetaSyncSingleEntryCR
پیچیدگی: O(ورودیهای جدید mdlog)؛ rgw_meta_sync_spawn_window (۲۰) همزمان
pseudocode
non-master zone, for each mdlog shard N of the current period (lease or bid):
    full sync: list all metadata keys on master (meta.full-sync.index.*) ; fetch each
    incremental: read meta.log.<period>.<N> after marker ; for each entry (section:key):
        GET /admin/metadata/<section>?key=K from master ; put locally (versioned with read/write version)
    on period change: finish old period's log to its end, then switch to new period's log
writes of metadata (create user, bucket) on non-master: forwarded to master zone first
به همین دلیل ساخت bucket یا کاربر در zone غیر master وقتی master در دسترس نیست شکست میخورد، ولی نوشتن شیء در bucketهای موجود ادامه مییابد. (failover و ارتقای master در فصل ۵ آمده است.)
۴۲-۷ مرجع دستورهای multisite#
| دستور | کاربرد |
|---|---|
radosgw-admin sync status | خلاصهی metadata و data sync در برابر هر مبدأ |
radosgw-admin data sync status --source-zone Z [--shard-id N] | وضعیت shardهای data sync |
radosgw-admin metadata sync status / metadata sync run | وضعیت و اجرای دستی metadata sync |
radosgw-admin bucket sync status --bucket B [--source-zone Z] | وضعیت یک bucket و نسلها |
radosgw-admin bucket sync markers --bucket B --source-zone Z | markerهای shardهای bucket |
radosgw-admin bucket sync run --bucket B --source-zone Z | همگامسازی دستی یک bucket |
radosgw-admin bucket sync {disable,enable} --bucket B | توقف و ازسرگیری برای یک bucket |
radosgw-admin bilog {list,status,trim,autotrim} --bucket B | bilog یک bucket |
radosgw-admin datalog {list,status,trim} [--shard-id N] | datalog |
radosgw-admin mdlog {list,status,trim} [--period P] | mdlog |
radosgw-admin sync error {list,trim} | خطاهای همگامسازی |
radosgw-admin data sync init --source-zone Z | بازگرداندن data sync به full sync (پرهزینه) |
radosgw-admin period {get,get-current,pull,update --commit} | period |
radosgw-admin sync group ... (با زیرفرمانهای flow و pipe) | sync policy (فصل ۵) |
# مثال: یک bucket که پس از reshard در نسل 1 است
radosgw-admin bucket sync status --bucket logs --source-zone zone-aمثال (خروجی):
realm 2f61a0c4-... (prod)
zonegroup 9b07d2e1-... (eu)
zone 5c3e8a77-... (zone-b)
bucket :logs[a1b2c3d4-...4123.9])
current time 2026-11-15T07:20:11Z
source zone b3a9e1c4-... (zone-a)
source bucket :logs[a1b2c3d4-...4123.9])
incremental sync on 23 shards
bucket is behind on 2 shards
behind shards: [4,17]۴۲-۸ تنظیم و عیبیابی#
- shardهای عقبمانده که جلو نمیروند:
sync error list و data sync status --shard-id N را ببینید؛ اگر یک bucket مدام خطا میدهد، bucket sync run برای همان bucket مشکل را جدا و قابل دیدن میکند. - رشد بیپایان datalog یا bilog: یک peer قدیمی یا حذفشده در zonegroup هنوز تعریف شده و trim منتظر marker اوست (فصل ۵)؛ zone مرده را از zonegroup حذف و period را commit کنید.
- همگامسازی کند با تعداد زیاد bucket کوچک:
rgw_data_sync_spawn_window و rgw_bucket_sync_spawn_window (هر دو ۲۰) را با احتیاط افزایش دهید و تعداد RGWهای همگامساز را بالا ببرید تا bidها پخش شوند. RGWهای سرویسدهنده به کاربر را میتوان با rgw_run_sync_thread = false از همگامسازی جدا کرد. - پس از تغییر master: اگر zoneها روی period قدیمی ماندهاند،
period pull و راهاندازی دوبارهی RGW لازم است. - تفاوت محتوا با وجود «caught up»:
rgw_sync_obj_etag_verify (پیشفرض false) را موقتاً روشن کنید تا ETag هر شیء کپیشده بررسی شود.
۴۲-۹ تکمیلی و بهروز#
- layout نسلدار bilog و همگامسازی پس از reshard در multisite از نسخههای اخیر پشتیبانی میشود و پیشنیاز آن ویژگی zonegroup
resharding است؛ پیش از reshard در multisite، radosgw-admin zonegroup get و فهرست enabled_features را بررسی کنید. - سازوکار bid برای پخش shardها در شاخهی main هست؛ در نسخههای قدیمیتر فقط lease وجود داشت و یک RGW میتوانست بیشتر shardها را بگیرد.
- در شاخهی main گزینهی
rgw_default_bucket_bilog_type (پیشفرض fifo) تعیین میکند bilog bucketهای جدید در ایندکس (inindex) باشد یا در FIFO جدا؛ bucketهای InIndex موجود در reshard بعدی مهاجرت میکنند. این رفتار در نسخههای منتشرشدهی قدیمیتر وجود ندارد؛ پیش از تکیه بر آن نسخهی خود را بررسی کنید.
۴۲-۱۰ تمرین عملی#
- ۱. در یک محیط دو zone، یک endpoint به zonegroup اضافه و commit کنید و تغییر epoch را ببینید. سپس master را عوض کنید و تغییر id و realm_epoch را ببینید.
- ۲. یک PUT انجام دهید و ورودی آن را در
bilog list، datalog list و سپس در bucket sync markers در zone مقصد دنبال کنید. - ۳. یک شیء را در یک ثانیه در هر دو zone بنویسید و ببینید کدام نسخه برنده میشود؛ نتیجه را با
zone_short_id دو zone (در zonegroup get) مقایسه کنید. - ۴. در zone مبدأ یک bucket را reshard کنید و
bucket sync status مقصد را تا رفتن به نسل جدید دنبال کنید.
۴۲-۱۱ پرسشهای مرور#
- ۱. commit یک period چه سه شرطی را پیش از هر چیز بررسی میکند؟
- ۲. چه زمانی commit شناسهی period را عوض میکند و پیامدش برای mdlog چیست؟
- ۳. zones_trace در bilog چه مشکلی را حل میکند؟
- ۴. کلید یک ورودی datalog چه چیزی را مشخص میکند؟
- ۵. وضعیت همگامسازی یک bucket shard در کدام شیء و کدام pool است؟
- ۶. چرا marker shard datalog با وجود شکست یک bucket جلو میرود و شکست کجا ثبت میشود؟
- ۷. lease و bid در همگامسازی چه نقشی دارند؟
- ۸. پس از reshard در zone مبدأ، zone مقصد چگونه بدون full sync ادامه میدهد؟
- ۹. تعارض نوشتن همزمان با چه ترتیبی از معیارها حل میشود؟
- ۱۰. چرا ساختن bucket در zone غیر master به در دسترس بودن master وابسته است؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۴۲-۱۲ منابع این فصل#
- rgw_zone.cc (commit_period
https://github.com/ceph/ceph/blob/main/src/rgw/rgw_zone.cc - rgw_data_sync.cc و rgw_data_sync.h
https://github.com/ceph/ceph/blob/main/src/rgw/driver/rados/rgw_data_sync.cc - rgw_sync.cc (metadata sync
https://github.com/ceph/ceph/blob/main/src/rgw/driver/rados/rgw_sync.cc - rgw_datalog.h
https://github.com/ceph/ceph/blob/main/src/rgw/driver/rados/rgw_datalog.h - cls_rgw_types.h (rgw_bi_log_entry
https://github.com/ceph/ceph/blob/main/src/cls/rgw/cls_rgw_types.h - مستند multisite
https://docs.ceph.com/en/latest/radosgw/multisite/ - مستند reshard پویا (شامل multisite
https://docs.ceph.com/en/latest/radosgw/dynamicresharding/