راهبری و مدیریت کلاستر Ceph
حوصله ندارم این فصل در چند خط
- در cephadm هر daemon یک container زیر systemd است و سرویسها را بهصورت اعلانی با
ceph orch مدیریت میکنید؛ پیکربندی در پایگاه دادهی MON است، نه در ceph.conf. - هیچ نودی بیش از حدود ۱۰ تا ۱۵ درصد ظرفیت خام نداشته باشد و فضای آزاد آنقدر باشد که با از دست رفتن بزرگترین دامنهی خرابی از
nearfull عبور نکنید. - OSD خراب پس از
mon_osd_down_out_interval (۱۰ دقیقه) out میشود و recovery شروع میشود؛ دیسک را با ceph orch osd rm --replace عوض کنید و برای کار برنامهریزیشده از حالت نگهداری میزبان استفاده کنید. - ارتقا با
ceph orch upgrade مرحلهای و خودکار است؛ سه آستانهی پرشدگی و MAX AVAIL در ceph df توضیح میدهند چرا فضای آزاد کمتر از ظاهرش است.
۷-۱ پیش از شروع#
۷-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
ساختن کلاستر کار یک روز است؛ راهبری آن کار چند سال. این فصل کارهای روزمرهی اپراتور را پوشش میدهد: مدیریت سرویسها، پیکربندی، بزرگ و کوچک کردن کلاستر، تعویض دیسک، ارتقای نسخه و کنترل بار بازیابی. کتاب ۲۰۱۹ این کارها را با ویرایش دستی ceph.conf، ceph-deploy و unitهای systemd بستهای انجام میداد. در یک کلاستر امروزی با cephadm، بیشتر این کارها اعلانی (declarative) شدهاند: شما وضعیت مطلوب را میگویید و orchestrator آن را برقرار نگه میدارد.
- مدیریت سرویس در cephadm چه لایههایی دارد و systemd کجای آن است؟
- پیکربندی امروز کجا نگهداری میشود و چرا
ceph.conf تقریباً خالی است؟ - چطور گره، OSD و MON اضافه یا حذف کنیم؟
- روال امن تعویض دیسک خراب چیست؟
- ارتقای نسخه را چطور بدون قطعی و با کنترل ریسک انجام دهیم؟
- بازیابی و backfill را چطور کند یا تند کنیم، بهویژه با زمانبند mClock؟
۷-۲ مدیریت سرویسها#
۷-۲-۱ لایههای کنترل#
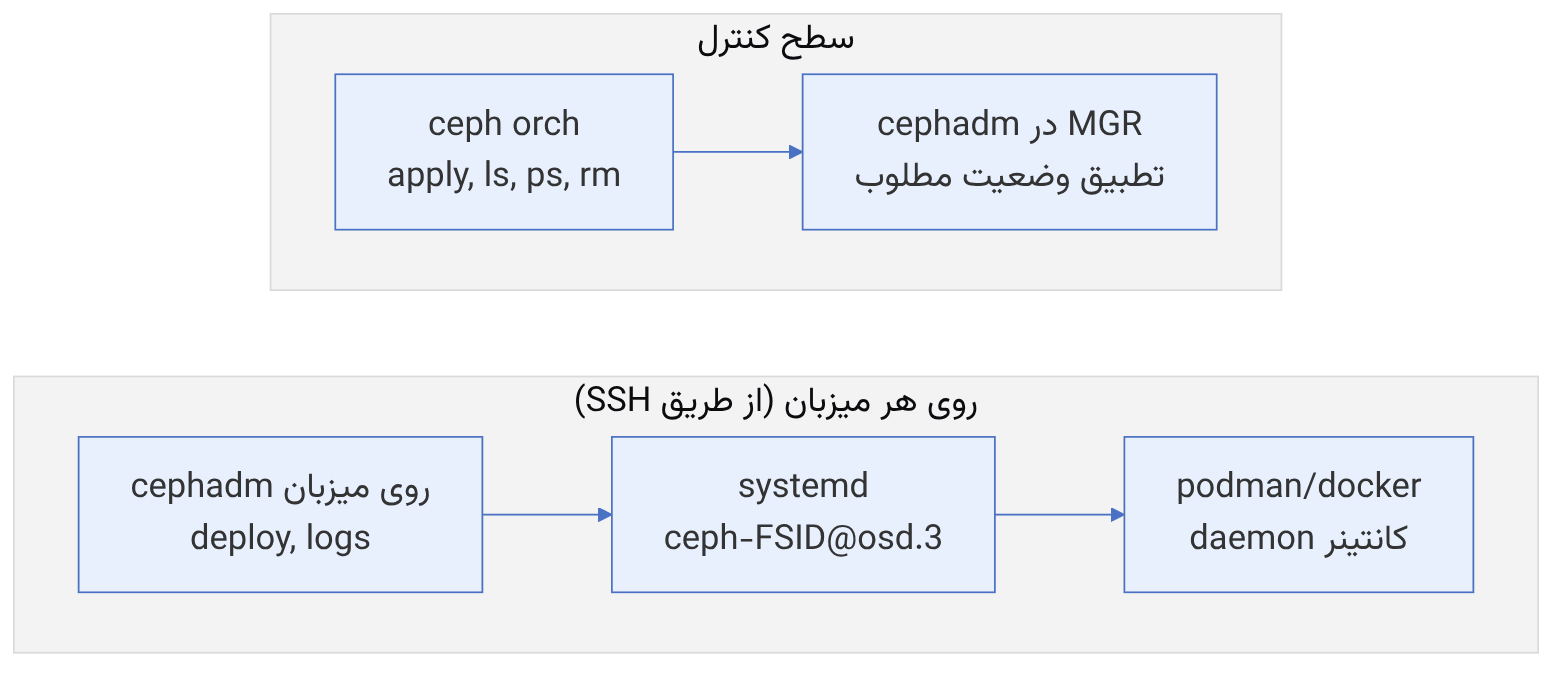
در cephadm، هر daemon یک کانتینر است که با یک unit systemd اجرا میشود. orchestrator (ماژول cephadm در MGR) از طریق SSH روی میزبانها daemon میسازد، حذف میکند یا راهاندازی مجدد میکند. شما معمولاً فقط با لایهی بالا کار میکنید:
ceph orch ls # سرویسها و تعداد daemonهای مطلوب/در حال اجرا
ceph orch ps # همهی daemonها
ceph orch ps --daemon-type osd --hostname ceph-node2
ceph orch ls --export > cluster-specs.yaml # پشتیبان از وضعیت مطلوب۷-۲-۲ شروع، توقف و راهاندازی مجدد#
ceph orch restart rgw.objstore # همهی daemonهای یک سرویس، یکییکی
ceph orch daemon restart osd.3
ceph orch daemon stop mds.fs01.ceph-node3.xyzabc
ceph orch daemon start mds.fs01.ceph-node3.xyzabc
ceph orch daemon redeploy mgr.ceph-node1.abcdef # ساخت دوبارهی کانتینر (مثلاً پس از تغییر image)۷-۲-۳ systemd در پشت صحنه#
روی هر میزبان، unitهای systemd نامگذاری مشخصی دارند که شامل fsid کلاستر است. این نامگذاری اجازه میدهد چند کلاستر روی یک میزبان (مثلاً در آزمایشگاه) بدون تداخل اجرا شوند.
FSID=$(ceph fsid)
systemctl list-units "ceph-${FSID}*"
systemctl status ceph-${FSID}@osd.3.service
sudo systemctl stop ceph-${FSID}.target # توقف همهی daemonهای این کلاستر روی این میزبان
sudo systemctl start ceph-${FSID}.target
journalctl -u ceph-${FSID}@osd.3 --since "1 hour ago"
cephadm logs --name osd.3 # همان لاگ از طریق cephadmاگر daemon را مستقیم با systemctl متوقف کنید، orchestrator از آن خبر ندارد و ممکن است در چرخهی بعدی تطبیق وضعیت آن را دوباره راه بیندازد یا گزارش خطا بدهد. برای کارهای برنامهریزیشده روی کل میزبان، از حالت نگهداری استفاده کنید (پایینتر). systemctl را برای اشکالزدایی محلی یا وقتی MGR در دسترس نیست نگه دارید.
۷-۳ پیکربندی#
۷-۳-۱ پایگاه پیکربندی متمرکز#
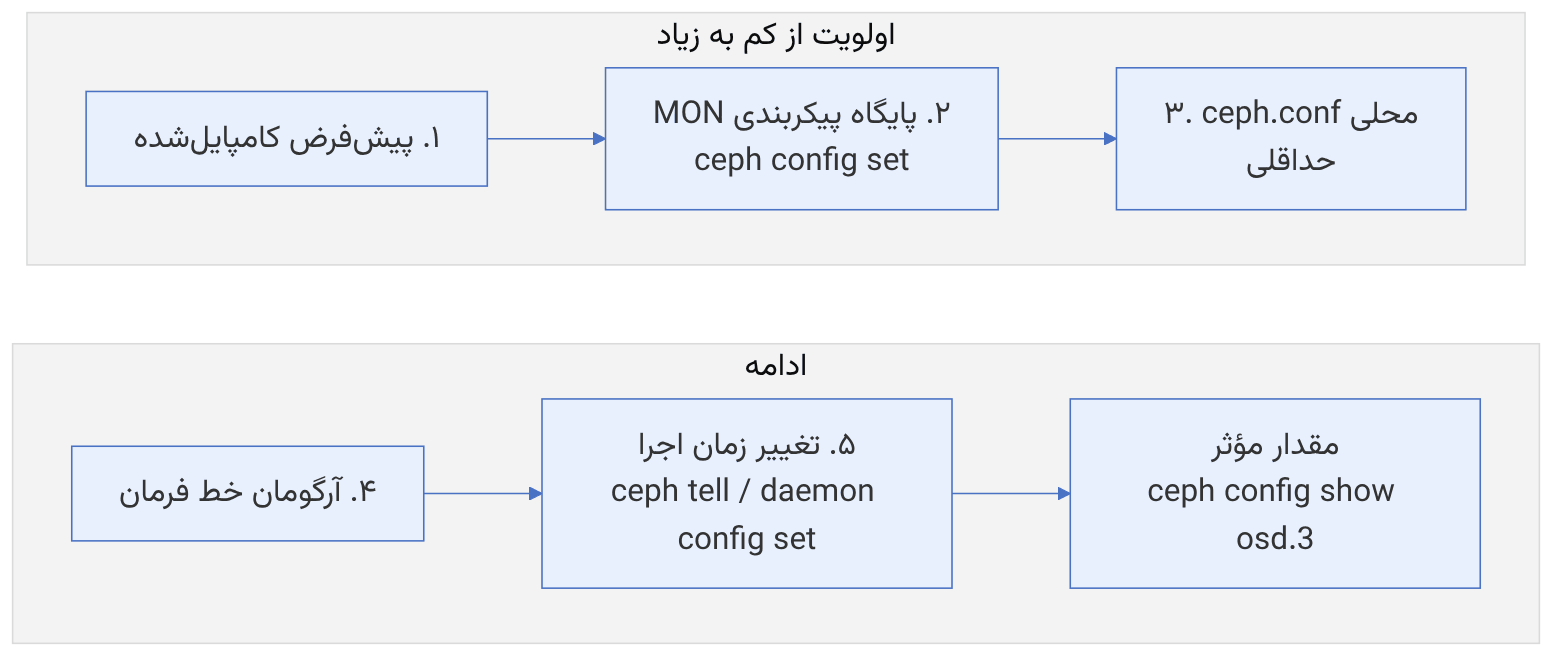
از Mimic، پیکربندی کلاستر در پایگاه پیکربندی MON نگه داشته میشود و ceph.conf روی میزبانها فقط حداقل اطلاعات لازم برای پیدا کردن MONها را دارد (fsid و mon_host). کتاب ۲۰۱۹ هنوز افزودن بخشهای [mon.a] و [osd.0] به ceph.conf را آموزش میداد؛ این کار امروز نه لازم است و نه توصیه میشود.
cat /etc/ceph/ceph.conf # معمولاً چند خط
ceph config dump # همهی تنظیمات غیرپیشفرض
ceph config get osd osd_memory_target
ceph config set osd osd_memory_target 6442450944
ceph config set osd.12 osd_memory_target 8589934592 # فقط یک OSD
ceph config set osd/class:ssd osd_memory_target 8589934592 # همهی OSDهای SSD (mask)
ceph config set client.rgw.objstore rgw_max_concurrent_requests 2048
ceph config show osd.3 | grep memory_target # مقدار مؤثر در daemon در حال اجرا
ceph config help osd_memory_target
ceph config log 10 # تاریخچهی تغییراتدستور ceph config log و ceph config reset <n> امکان برگرداندن تغییرات پیکربندی را میدهند. قبل از هر تغییر بزرگ خروجی ceph config dump را در کنترل نسخه (Git) ذخیره کنید تا بعداً بتوانید تفاوتها را مقایسه کنید.
۷-۳-۲ تغییر موقت در زمان اجرا#
ceph tell osd.* config set debug_osd 10/10 # موقتاً، تا راهاندازی مجدد
ceph tell osd.* config set debug_osd 1/5 # بازگرداندن
ceph daemon osd.3 config show # از طریق admin socket، روی همان میزبان (درون shell cephadm)ceph tell از طریق شبکه به daemon پیام میفرستد؛ ceph daemon از طریق admin socket محلی کار میکند و فقط روی میزبان همان daemon (در cephadm، داخل cephadm shell --name osd.3) در دسترس است. وقتی daemon به دلیل گیر کردن به پیامهای شبکه پاسخ نمیدهد، admin socket معمولاً هنوز جواب میدهد.
۷-۴ بزرگ و کوچک کردن کلاستر#
۷-۴-۱ scale-up یا scale-out؟#
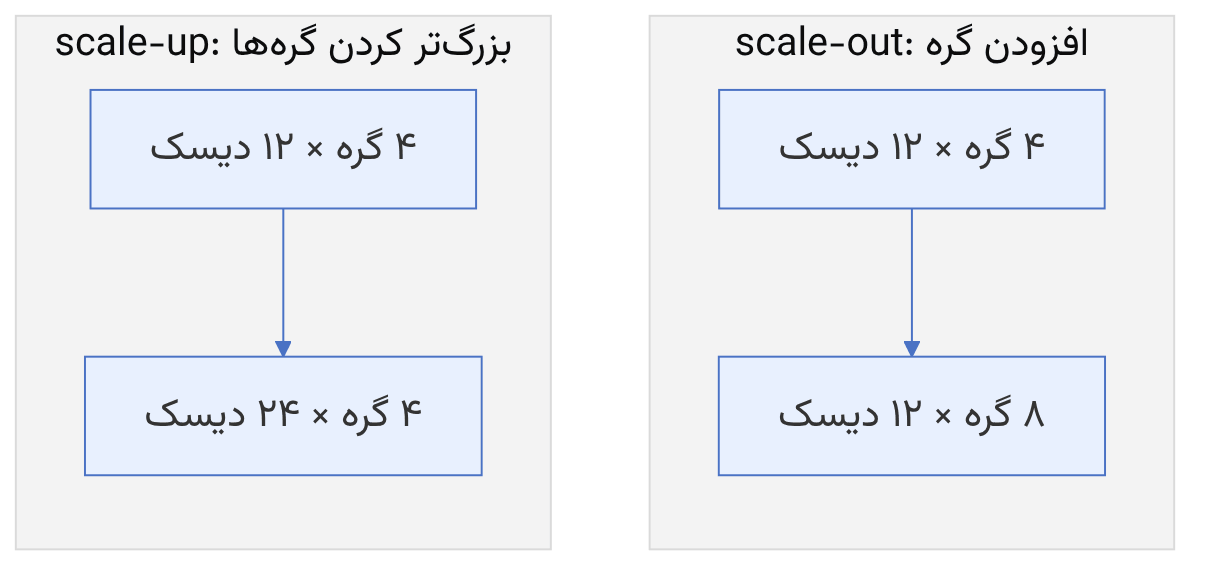
| معیار | scale-up (گرههای پرتراکمتر) | scale-out (گرههای بیشتر) |
|---|---|---|
| هزینهی هر ترابایت | معمولاً کمتر | کمی بیشتر (CPU، شبکه، رک) |
| دامنهی خرابی | بزرگ؛ از دست رفتن یک گره بخش بزرگی از داده را بازیابی میکند | کوچکتر؛ بازیابی سریعتر و کماثرتر |
| کارایی | CPU و شبکهی هر گره گلوگاه میشود | خطیتر با افزایش گرهها |
| محدودیت | حداقل تعداد گره برای EC و دامنهی خرابی | فضای رک، سوئیچ و برق |
یک قاعدهی عملی: هیچ گرهای نباید بیش از حدود ۱۰ تا ۱۵ درصد ظرفیت خام کلاستر را نگه دارد. همچنین فضای آزاد کلاستر باید آنقدر باشد که پس از از دست رفتن بزرگترین دامنهی خرابی (گره یا رک)، OSDها از نسبت nearfull عبور نکنند.
۷-۴-۲ افزودن گره و OSD#
# روی گره تازه: نصب podman، تنظیم زمان (chrony) و کلید SSH کلاستر
ssh-copy-id -f -i /etc/ceph/ceph.pub root@ceph-node5
ceph orch host add ceph-node5 192.168.10.15 --labels osd
ceph orch device ls ceph-node5 --refresh
# اگر spec OSD شما (مثلاً all-available-devices یا یک spec با فیلتر) فعال است، OSDها خودکار ساخته میشوند
ceph orch ls osd
ceph -sافزودن ناگهانی تعداد زیادی OSD باعث جابهجایی گستردهی PGها میشود. در کلاستر شلوغ قبل از افزودن، پرچمهای norebalance و nobackfill را بگذارید، همهی OSDها را بسازید و بعد پرچمها را بردارید تا داده یک بار و نه چند بار جابهجا شود. ابزارهایی مانند ماژول balancer پس از اتمام backfill، توزیع را یکنواخت میکنند.
ceph osd set norebalance && ceph osd set nobackfill
ceph orch apply -i osd-spec.yaml
ceph osd tree
ceph osd unset nobackfill && ceph osd unset norebalance
۷-۴-۳ افزودن MON و MGR#
در cephadm، تعداد و محل MONها با spec سرویس mon تعیین میشود:
service_type: mon
placement:
  count: 5
label: monceph orch host label add ceph-node5 mon
ceph orch apply -i mon-spec.yaml
ceph mon stat
ceph quorum_status -f json-pretty | jq '.quorum_names'تعداد MONها را فرد نگه دارید (۳ یا ۵). پنج MON تحمل از دست رفتن دو MON را میدهد؛ بیشتر از ۵ معمولاً فقط سربار اجماع را زیاد میکند. MONها را در دامنههای خرابی مختلف (رک یا اتاق) قرار دهید.
۷-۴-۴ حذف OSD#
ceph osd safe-to-destroy osd.9 # آیا بدون از دست رفتن داده میتوان حذف کرد؟
ceph osd ok-to-stop osd.9 # آیا توقف موقت باعث از دسترس رفتن PG میشود؟
ceph orch osd rm 9 # تخلیه و حذف
ceph orch osd rm statusceph orch osd rm ابتدا وزن OSD را صفر میکند، صبر میکند تا همهی PGها جای دیگری بروند، سپس daemon را حذف و OSD را از CRUSH و نقشه پاک میکند. با --zap دیسک هم پاکسازی (LVM و partitionها) میشود تا دوباره قابل استفاده باشد.
۷-۴-۵ حذف یک میزبان کامل#
ceph orch host drain ceph-node5 # همهی daemonها را تخلیه میکند، از جمله OSDها
ceph orch osd rm status
ceph orch ps ceph-node5 # باید خالی شود
ceph orch host rm ceph-node5--offline --force در host rm فقط برای میزبانی است که برای همیشه از دست رفته است؛ این گزینه OSDهای آن را بدون تخلیه حذف میکند و تنها وقتی امن است که دادهی آنها از روی نسخههای دیگر قابل بازسازی باشد.
۷-۵ تعویض دیسک خراب#
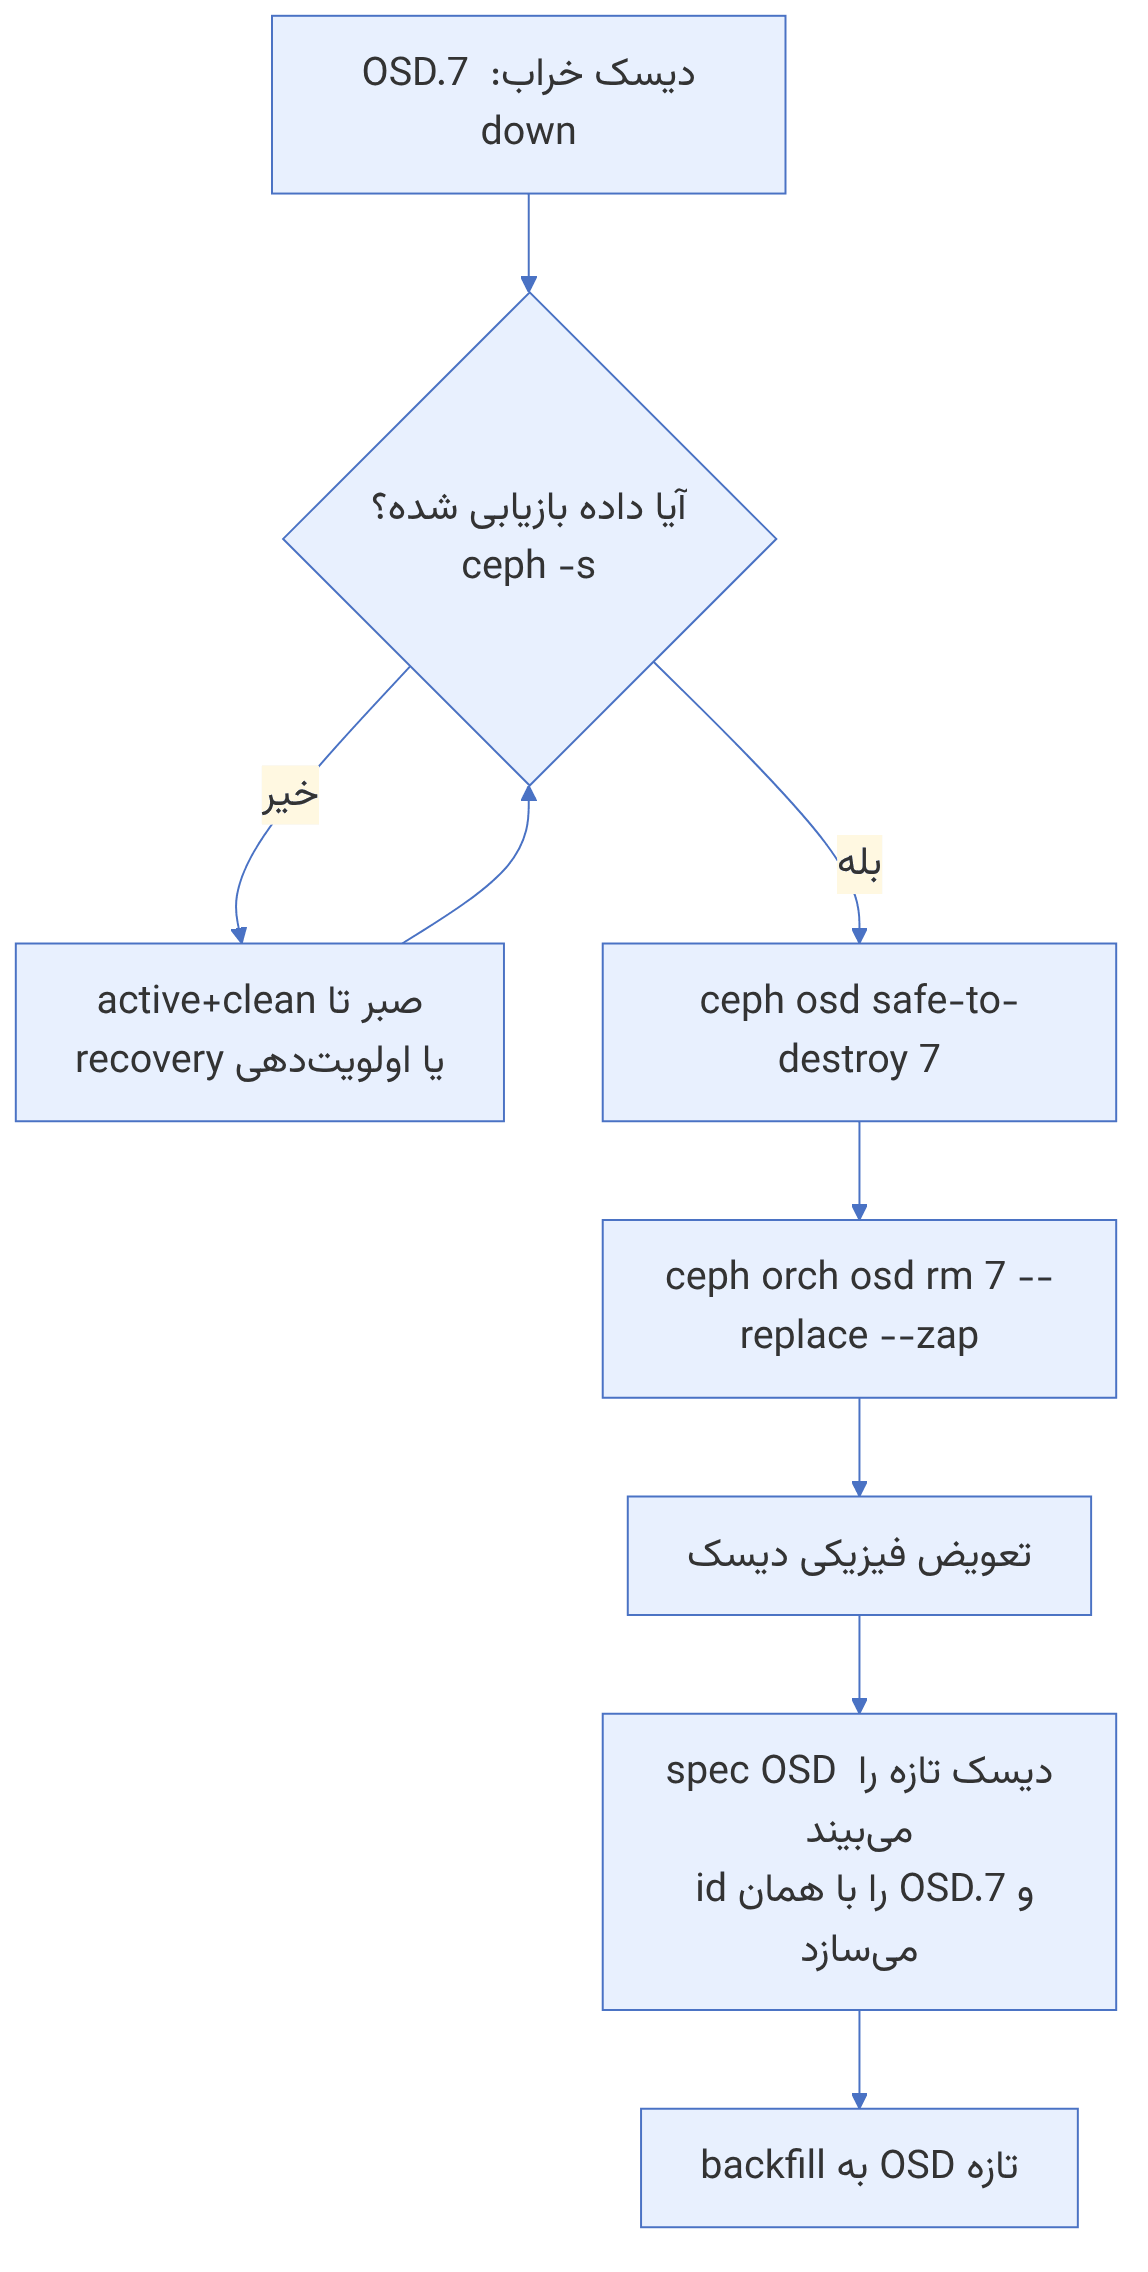
وقتی دیسکی خراب میشود، OSD آن down میشود و پس از mon_osd_down_out_interval (پیشفرض ۱۰ دقیقه) بهصورت خودکار out میشود و بازیابی شروع میشود. روال پیشنهادی:
ceph health detail
ceph osd tree down
ceph device ls-by-daemon osd.7 # شناسهی دستگاه و میزبان
ceph device light on <devid> ident # روشن کردن چراغ شناسایی (اگر سختافزار پشتیبانی کند)
# صبر تا داده بازیابی شود
ceph -s
ceph osd safe-to-destroy osd.7
ceph orch osd rm 7 --replace --zap
ceph orch osd rm status
# پس از تعویض فیزیکی دیسک
ceph orch device ls ceph-node2 --refresh
ceph osd tree | grep osd.7گزینهی --replace بهجای حذف کامل، OSD را در وضعیت destroyed نگه میدارد؛ id و جایگاهش در CRUSH حفظ میشود. وقتی spec OSD دیسک تازهی همان میزبان را میبیند، OSD جدید را با همان id میسازد. مزیتش این است که نقشهی CRUSH تغییر نمیکند و دادهی کمتری جابهجا میشود.
مدیریت سلامت دستگاهها (ceph device) دادهی SMART دیسکها را جمع میکند و میتواند خرابی را پیشبینی کند. با ceph device monitoring on و ceph device get-health-metrics <devid> آن را بررسی کنید. اگر mgr/devicehealth/self_heal فعال باشد، OSDهای دیسکهایی که احتمال خرابی بالایی دارند پیشدستانه out میشوند.
۷-۶ ارتقای نسخه#
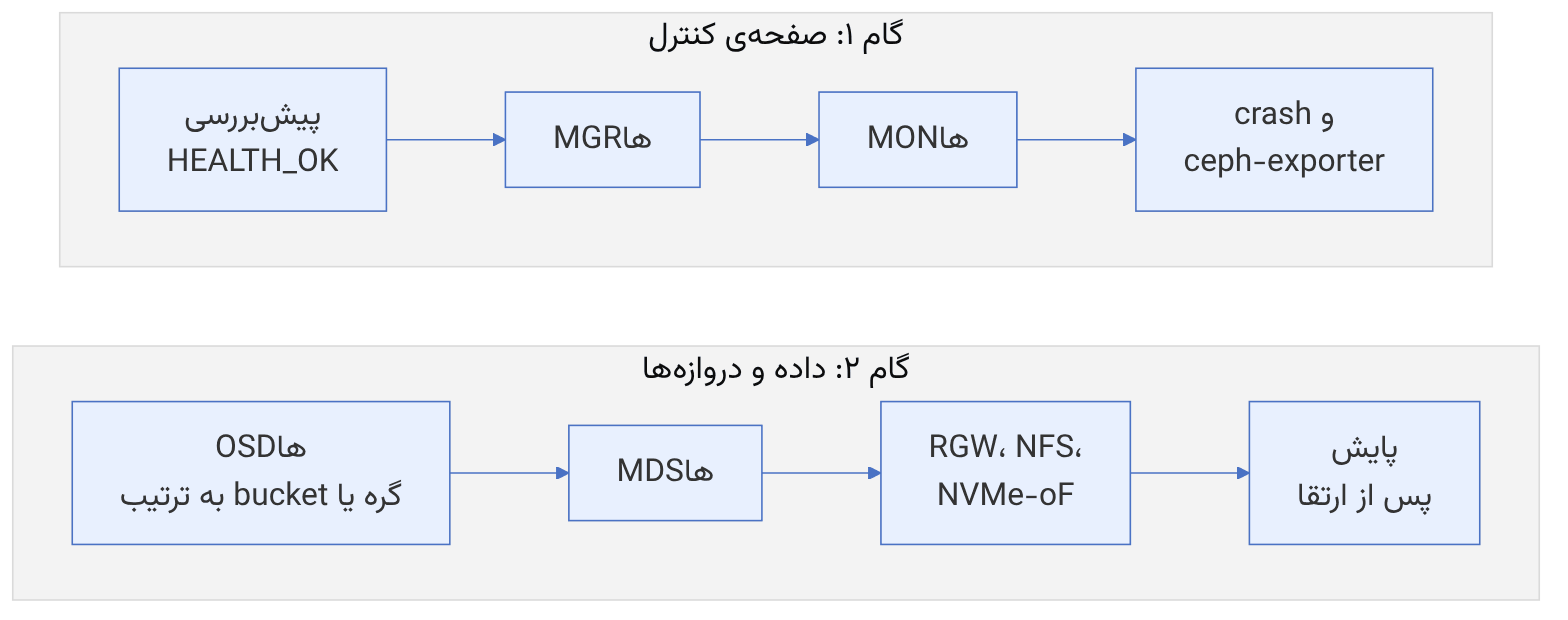
cephadm ارتقای نسخه را خودکار و مرحلهای انجام میدهد و ترتیب درست را رعایت میکند. پیش از ارتقا:
- یادداشتهای انتشار نسخهی مقصد را کامل بخوانید، بهویژه بخش «Upgrading» و تغییرات ناسازگار.
- مسیر ارتقای مجاز را بررسی کنید: Ceph معمولاً ارتقا را حداکثر از دو نسخهی اصلی قبلتر پشتیبانی میکند.
- کلاستر باید
HEALTH_OK باشد و همهی PGها active+clean. - برای Umbrella، پیشنیازهای میزبان را چک کنید: imageها مبتنی بر el10 هستند و CPU با سطح x86-64-v3 لازم است.
ceph versions
ceph orch upgrade start --image quay.io/ceph/ceph:v20.2.5
ceph orch upgrade status
ceph -W cephadm                         # دنبال کردن رویدادهای ارتقا
ceph orch upgrade pause                 # در صورت مشکل
ceph orch upgrade resume
ceph orch upgrade stop
۷-۶-۱ ارتقای مرحلهای و محدود#
cephadm اجازه میدهد ارتقا را به نوع daemon، سرویس یا میزبان خاصی محدود کنید. در Umbrella امکان ارتقای OSDها bucket به bucket در CRUSH اضافه شده است که با دستور تازهی ceph osd ok-to-upgrade بررسی میکند کدام OSDها را میتوان همزمان ارتقا داد:
ceph orch upgrade start --image quay.io/ceph/ceph:v21.2.0 --daemon-types mgr,mon
ceph orch upgrade start --image quay.io/ceph/ceph:v21.2.0 --daemon-types osd --crush_bucket_type rack --crush_bucket_name rack-aدر ارتقای چندمرحلهای، باید ترتیب را خودتان رعایت کنید: هیچ daemonی نباید جدیدتر از MGRها و MONها باشد. پس از ارتقای همهی OSDها، cephadm بهطور معمول require_osd_release را تنظیم میکند؛ با ceph osd dump | grep require_osd_release تأیید کنید. تا وقتی این مقدار تنظیم نشده، قابلیتهای جدید OSD فعال نمیشوند و هشدار مربوط باقی میماند.
۷-۷ ظرفیت و توازن#
۷-۷-۱ نسبتهای پر شدن#
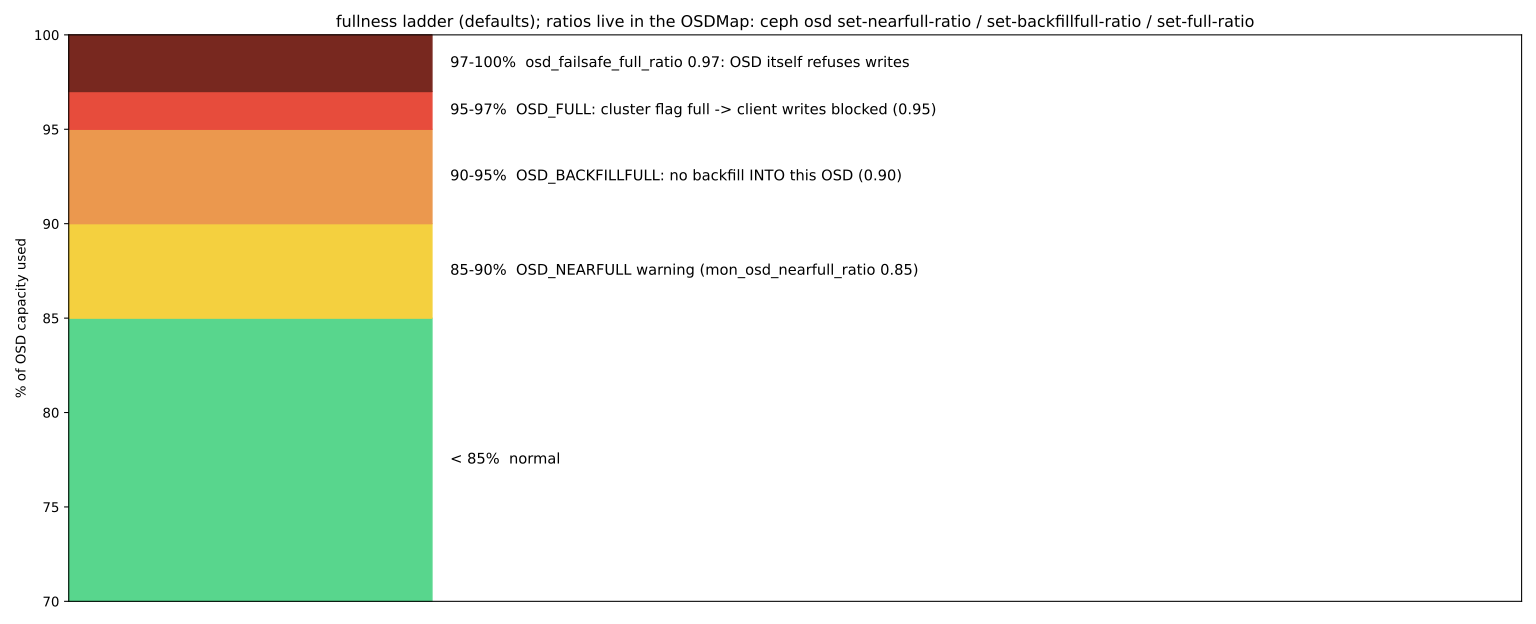
Ceph برای جلوگیری از پر شدن کامل OSDها سه آستانه دارد. پر شدن کامل یک OSD در Ceph بسیار خطرناک است، چون BlueStore برای حذف داده هم به فضای آزاد نیاز دارد:
| آستانه | پیشفرض | اثر |
|---|---|---|
| nearfull_ratio | ۰.۸۵ | هشدار OSD_NEARFULL |
| backfillfull_ratio | ۰.۹۰ | backfill به این OSD متوقف میشود |
| full_ratio | ۰.۹۵ | نوشتن در poolهای وابسته متوقف میشود (OSD_FULL) |
ceph osd dump | grep -E 'full_ratio|nearfull'
ceph osd df tree                    # درصد استفاده و تعداد PG هر OSD
ceph df detail # فضای خام و قابل استفاده هر poolاگر کلاستر به OSD_FULL رسید، اولین واکنش طبیعی (حذف داده) ممکن است کار نکند. روال اضطراری: موقتاً ceph osd set-full-ratio 0.97 (فقط برای فرصت حذف)، حذف یا انتقال دادهی غیرضروری، افزودن ظرفیت، و سپس بازگرداندن نسبت به مقدار پیشفرض. هرگز این نسبت را بهصورت دائمی بالا نبرید.
۷-۷-۲ ظرفیت «قابل استفاده» واقعی#
عدد MAX AVAIL در ceph df ظرفیت قابل استفادهی هر pool را با در نظر گرفتن نوع افزونگی و پرترین OSD محاسبه میکند. یعنی عدم توازن، ظرفیت قابل استفاده را کم میکند: اگر یک OSD زودتر پر شود، کل pool پر به حساب میآید. برای برنامهریزی ظرفیت این قاعدهها را به کار ببرید:
- ظرفیت خام را بر ضریب افزونگی تقسیم کنید (۳ برای تکثیر سهتایی،
(k+m)/k برای EC). - فضای لازم برای تحمل خرابی بزرگترین دامنه را کم کنید.
- حاشیهی امن تا nearfull را کم کنید (معمولاً هدف مصرف عادی زیر ۷۰ درصد).
کلاستری با ۸ گره و در هر گره ۱۲ دیسک ۱۶ ترابایتی دارید و دامنهی خرابی host است. ظرفیت خام ۱۵۳۶ ترابایت است. با تکثیر سهتایی حدود ۵۱۲ ترابایت قابل استفاده میماند. برای تحمل از دست رفتن یک گره (یکهشتم ظرفیت) و ماندن زیر ۸۵ درصد پس از بازیابی، مصرف عادی را حدود ۷۰ درصد یعنی نزدیک ۳۵۰ تا ۳۶۰ ترابایت نگه دارید. همین محاسبه را برای EC 4+2 تکرار کنید.
۷-۷-۳ balancer#
ماژول balancer در MGR با تنظیم نگاشتهای upmap (جابهجایی صریح PGها بین OSDها) توزیع را یکنواخت میکند. در نسخههای جاری بهصورت پیشفرض فعال است و حالت upmap به کلاینتهایی با حداقل نسخهی Luminous نیاز دارد.
ceph balancer status
ceph balancer mode upmap
ceph balancer on
ceph config set mgr target_max_misplaced_ratio .03 # حداکثر ۳٪ دادهی جابهجاشده در هر لحظه
ceph osd df | sort -nk17 | tail # پرترین OSDهادر Reef حالتهای تازهی read و upmap-read اضافه شدند که علاوه بر توزیع داده، primaryها را هم متعادل میکنند تا بار خواندن یکنواختتر شود (خواندن بهطور پیشفرض از OSD اصلی هر PG انجام میشود). این حالتها از نگاشت pg-upmap-primary استفاده میکنند و همهی کلاینتها باید Reef یا جدیدتر باشند. در کلاستری که دیسکهای ناهمگن دارد، این حالت میتواند گلوگاه خواندن روی چند OSD را کاهش دهد.
۷-۷-۴ مقیاسدهی خودکار PG#
ماژول pg_autoscaler تعداد PG هر pool را بر اساس دادهی ذخیرهشده یا اندازهی هدفی که اعلام میکنید تنظیم میکند:
ceph osd pool autoscale-status
ceph osd pool set rbd target_size_ratio 0.4          # این pool قرار است ۴۰٪ کلاستر را بگیرد
ceph osd pool set cephfs.fs01.meta pg_autoscale_mode on
ceph osd pool set images bulk true # pool بزرگ: از ابتدا PG کافی بگیرددر Umbrella پیشفرض mon_target_pg_per_osd از ۱۰۰ به ۲۰۰ و سقف mon_max_pg_per_osd از ۲۵۰ به ۵۰۰ افزایش یافت. پس از ارتقا، autoscaler ممکن است تعداد PG برخی poolها را بالا ببرد و جابهجایی داده شروع شود. خروجی autoscale-status را پیش و پس از ارتقا مقایسه کنید و اگر لازم است تغییرات را زمانبندی کنید.
ماشینحساب تعداد PG
تعداد OSDها و سهم هر pool از داده را بدهید: پاسخ pgcalc کلاسیک و انتخاب pg_autoscaler را گذر به گذر ببینید.
| Pool | size | pgcalc کلاسیک | ایدهآل (نسخههای PG) | autoscaler | تغییر میکند؟ |
|---|---|---|---|---|---|
| rbd | ۳ | ۹۳۵ → ۱۰۲۴ | ۲۳۰۴ | ۱۰۲۴ (bulk برابر) | بله: ۳۲ ← ۱۰۲۴ |
| cephfs.data | ۶ | ۳۱۲ → ۲۵۶ | ۲۳۰۴ | ۲۵۶ (bulk برابر) | بله: ۳۲ ← ۲۵۶ |
| cephfs.meta | ۳ | ۴۲ → ۳۲ | ۹۶ | ۳۲ (غیر bulk) | نه |
| .mgr | ۳ | ۸ → ۸ | ۰ | ۳۲ (غیر bulk) | بله: ۱ ← ۳۲ |
autoscaler: root budget = mon_target_pg_per_osd × OSDs = 200 × 24 = 4800; pool = ⌊capacity_ratio × pg_left⌋ / size, rounded down or up to a power of two by a knapsack over the budget; min pg_num_min (32); changes only past the threshold (3×; 1× at 512/1024, 2× at 2048)
autoscaler برای poolی که مدیریت میکند هیچوقت زیر ۳۲ PG (osd_pool_default_pg_num) نمیرود و اگر bulk روشن نباشد کوچک شروع میکند و با داده بزرگ میشود.
مطابق با:
src/pybind/mgr/pg_autoscaler/module.py :: _get_pool_status, _calculate_final_pool_pg_targetچهار گذر روی poolهای یک rootmodule.py :: PoolGroup, _find_optimal_pg_distribution, _append_resultگرد کردن گروههای pool درون بودجهmodule.py :: nearest_power_of_two, get_dynamic_thresholdتوان ۲ و آستانهٔ تغییرsrc/osd/OSDMap.cc :: pool_raw_used_rateفضای خام به ازای هر بایت (size یا (k+m)/k)src/common/options/mgr.yaml.in :: mon_target_pg_per_osd (200)هدف نسخههای PG به ازای هر OSDsrc/common/options/global.yaml.in :: mon_max_pg_per_osd (500), osd_pool_default_pg_num (32)سقف و کمینهٔ pg_num
۷-۸ از درون کد: MON، Paxos و سرویسهای نقشه#
۷-۸-۱ نقش Paxos در Ceph#
همهی نقشههای کلاستر (MonMap، OSDMap، MgrMap، FSMap، پیکربندی مرکزی، کلیدهای cephx و...) روی یک نمونهی Paxos مشترک در src/mon/Paxos.cc ذخیره میشوند. هر «سرویس» (PaxosService؛ مانند OSDMonitor، AuthMonitor، ConfigMonitor) تغییرات خود را به این Paxos پیشنهاد میکند و Paxos آنها را یکییکی با شمارهی نسخهی پیوسته (last_committed) در RocksDB مانیتور مینویسد. پیادهسازی Ceph نسخهای از Multi-Paxos با رهبر پایدار است: پس از انتخابات، رهبر یک بار مرحلهی بازیابی (collect/last) را انجام میدهد و سپس هر تغییر فقط به یک رفتوبرگشت (begin/accept) و یک پیام commit نیاز دارد.
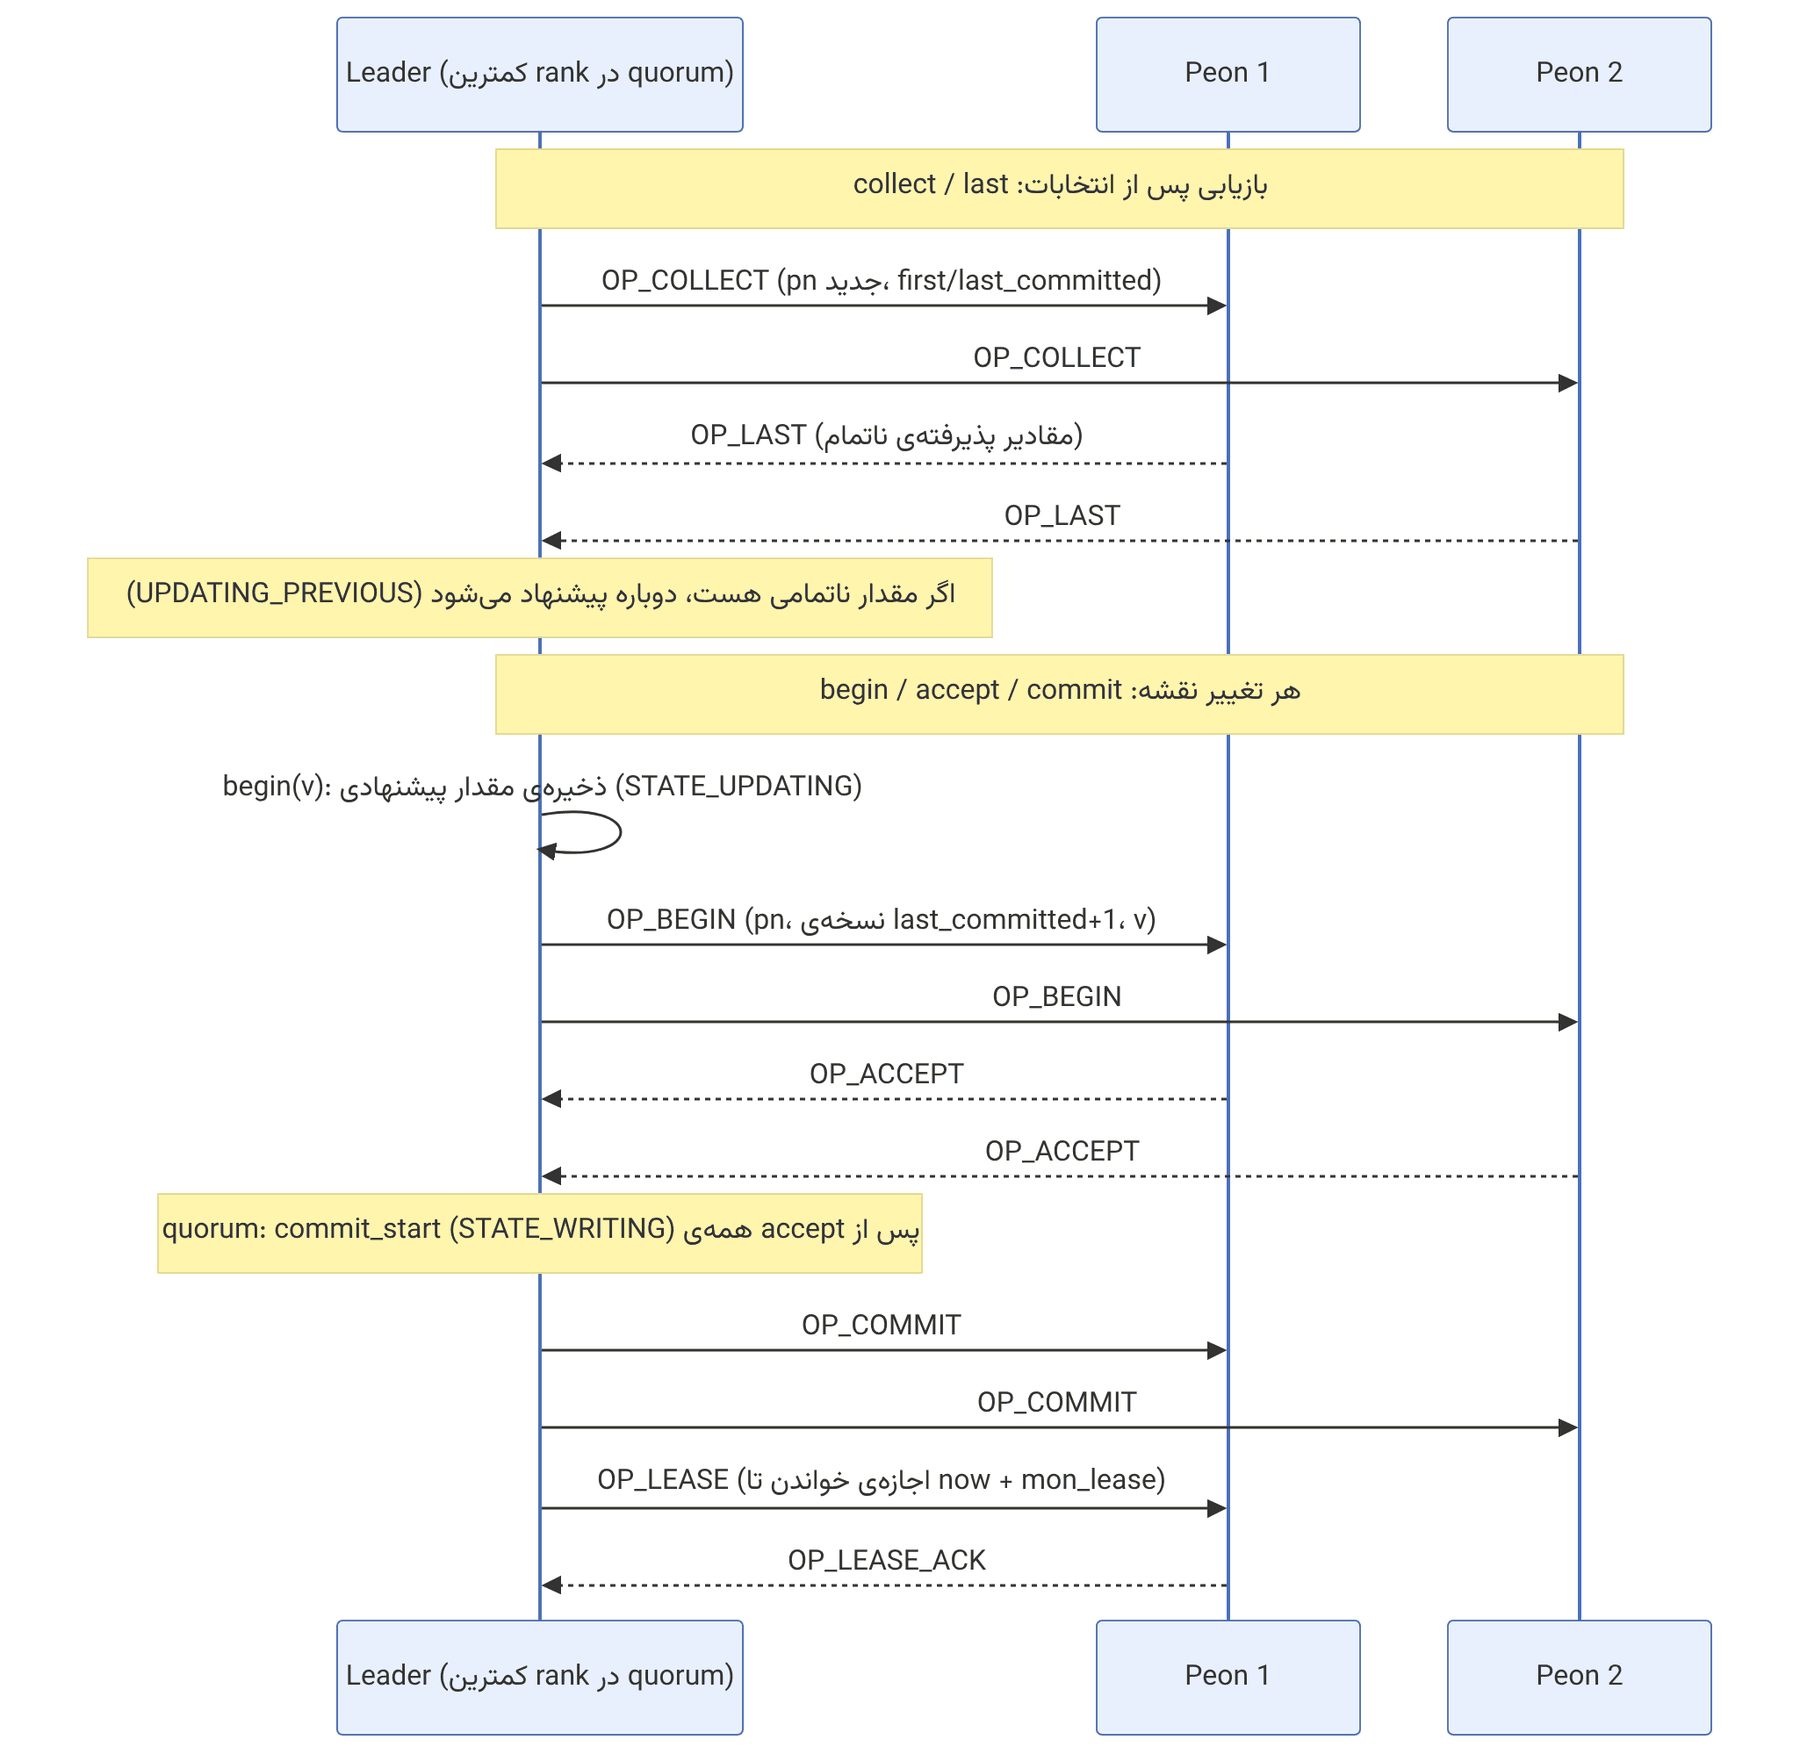
| پیام (MMonPaxos) | جهت | معنا |
|---|---|---|
| OP_COLLECT (۱) | رهبر → peon | شروع دور با شمارهی پیشنهاد (pn) جدید |
| OP_LAST (۲) | peon → رهبر | پذیرش pn و ارسال مقادیر پذیرفتهشدهی ناتمام |
| OP_BEGIN (۳) | رهبر → peon | مقدار پیشنهادی برای نسخهی بعد |
| OP_ACCEPT (۴) | peon → رهبر | پذیرش مقدار |
| OP_COMMIT (۵) | رهبر → peon | اعلام مقدار توافقشده |
| OP_LEASE (۶) | رهبر → peon | تمدید اجازهی خواندن |
| OP_LEASE_ACK (۷) | peon → رهبر | تأیید lease |
یک تفاوت مهم با Paxos کلاسیک: رهبر برای commit منتظر پذیرش همهی اعضای quorum فعلی میماند، نه فقط اکثریت. در Paxos::handle_accept():
// from ceph/ceph, LGPL — src/mon/Paxos.cc, handle_accept() (excerpt)
accepted.insert(from);
...
if (accepted == mon.get_quorum()) {
این ممکن است چون quorum خودش از انتخابات اکثریتی آمده است؛ اگر یکی از اعضای quorum پاسخ ندهد، accept timeout رخ میدهد و انتخابات دوباره برگزار میشود تا quorum کوچکتری (که هنوز اکثریت است) شکل بگیرد. مزیت: همهی اعضای quorum همیشه همهی نسخهها را دارند و میتوانند خواندن را با lease سرویس دهند.
۷-۸-۲ حالتها و lease#
حالتهای Paxos در Paxos.h: STATE_RECOVERING، STATE_ACTIVE، STATE_UPDATING، STATE_UPDATING_PREVIOUS، STATE_WRITING، STATE_WRITING_PREVIOUS، STATE_REFRESH (و SHUTDOWN). خواندن از یک peon فقط وقتی مجاز است که lease معتبر داشته باشد. پارامترها:
| گزینه | پیشفرض | نقش |
|---|---|---|
| mon_lease | ۵ ثانیه | مدت اعتبار lease خواندن |
| mon_lease_renew_interval_factor | ۰.۶ | تمدید پس از ۶۰٪ مدت lease |
| mon_lease_ack_timeout_factor | ۲ | اگر ack در دو برابر lease نرسد، انتخابات دوباره |
| paxos_propose_interval | ۱ ثانیه | فاصلهی دستهبندی تغییرات پیش از پیشنهاد |
| mon_election_timeout | ۵ ثانیه | مهلت انتخابات |
lease دلیل اصلی حساسیت MON به اختلاف ساعت است: رهبر به peon میگوید «تا زمان T میتوانی خواندن را سرویس دهی». اگر ساعت peon عقب باشد، ممکن است پس از اینکه رهبر نقشهی جدیدی commit کرده، هنوز نقشهی قدیمی را به کلاینت بدهد. هشدار MON_CLOCK_SKEW (آستانهی mon_clock_drift_allowed) برای جلوگیری از همین وضعیت است.
۷-۸-۳ از فرمان تا نقشهی جدید#
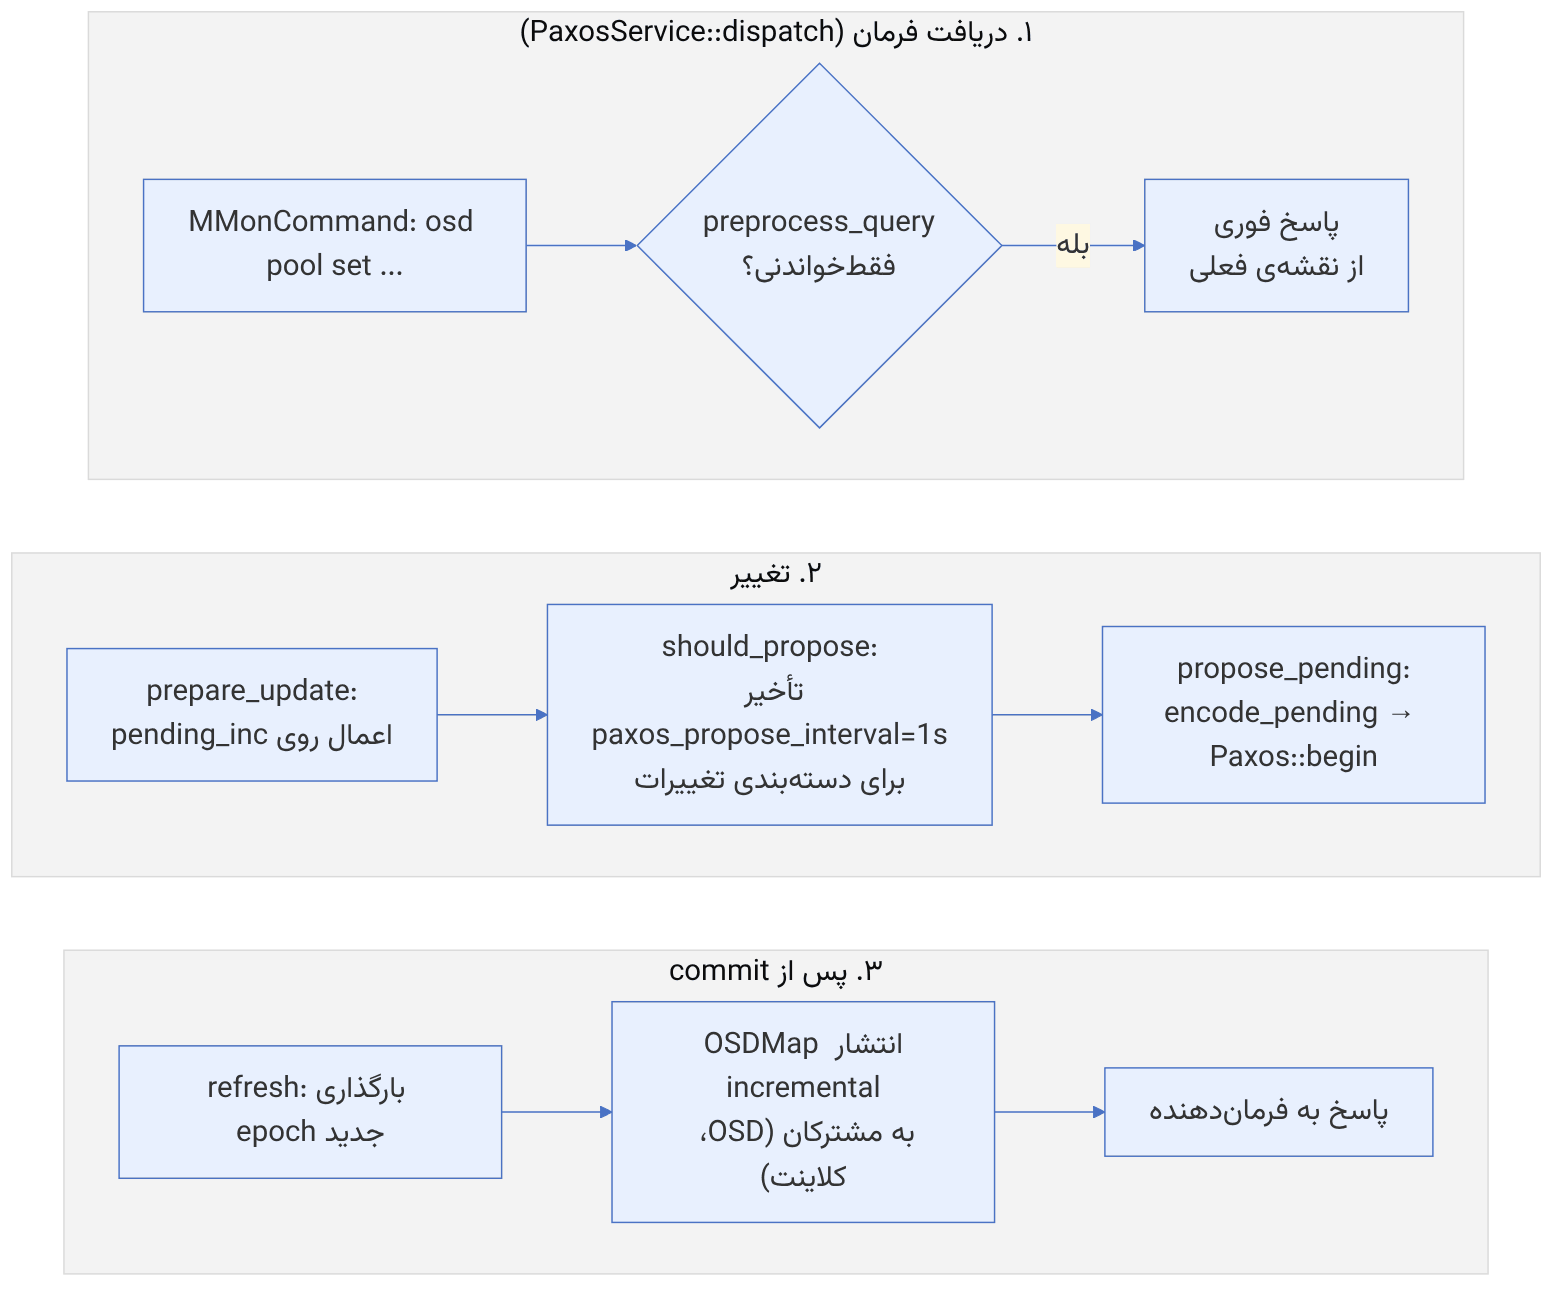
pseudocode: PaxosService (خلاصهی این کتاب از PaxosService.cc و OSDMonitor.cc)
dispatch(op):
if preprocess_query(op): return # فقطخواندنی؛ مثلاً osd dump
if not leader: forward(op to leader); return
if prepare_update(op): # تغییر روی pending_inc
if should_propose(delay): # دستهبندی با paxos_propose_interval
schedule propose_pending() after delay
propose_pending():
t = new transaction
encode_pending(t) # OSDMap::Incremental → bytes
paxos.begin(t) # OP_BEGIN به quorum
on commit:
update_from_paxos() # epoch جدید
publish incrementals to subscribers # OSDها و کلاینتها
reply to waiting opsبه همین دلیل اجرای همزمان چند ده فرمان ceph osd ... معمولاً یک epoch جدید با همهی تغییرات میسازد، نه دهها epoch. و به همین دلیل یک فرمان تغییردهنده حدود یک ثانیه طول میکشد حتی وقتی کلاستر کاملاً آرام است.
۷-۸-۴ انتخابات#
src/mon/ElectionLogic.h سه راهبرد انتخابات دارد: CLASSIC (بر اساس rank؛ کمترین rank برنده میشود)، DISALLOW (فهرستی از MONها نباید رهبر شوند) و CONNECTIVITY (شامل DISALLOW، و ترجیح MONی با اتصال بهتر بر اساس امتیازهای اتصال که در store ذخیره میشوند). stretch mode به connectivity نیاز دارد (فصل ۱۸).
ceph mon dump | grep election_strategy
ceph mon set election_strategy connectivity
ceph mon add disallowed_leader e         # MON داور هرگز رهبر نشود
ceph quorum_status | jq '.quorum_leader_name, .quorum_names'
ceph daemon mon.a sessions | jq length # روی میزبان MON۷-۹ عملیات روزمره با عدد: down، out، grace و MAX AVAIL#
چهار الگوریتم این بخش در MON اجرا میشوند و به چند پرسش روزمرهی اپراتور جواب میدهند: چرا OSD در این لحظه down شد یا نشد، چرا بعد از ده دقیقه out شد، و چرا ceph df فضای آزاد کمتری از فضای خام نشان میدهد. ارجاعها به main در نوامبر ۲۰۲۶ است و عددها با بازپیادهسازی پایتونی حساب شدهاند.
۷-۹-۱ علامتگذاری down: گزارشدهندهها و grace#
منبع در کد: src/mon/OSDMonitor.cc :: OSDMonitor::check_failure، get_grace_time، is_failure_stale
پیچیدگی: O(تعداد گزارشدهندهها)
pseudocode
گزارشدهندهها را بر حسب mon_osd_reporter_subtree_level (پیشفرض host) گروه کن
if تعداد گروهها < mon_osd_min_down_reporters (2): هنوز نه
failed_for = now − failed_since # از اولین گزارش، با عقببردن زمان
grace = osd_heartbeat_grace (20)
if mon_osd_adjust_heartbeat_grace (true):
decay = exp(failed_for × ln 0.5 / mon_osd_laggy_halflife (3600))
grace += decay × laggy_interval × laggy_probability # سابقهی خود OSD
grace += میانگین همان جمله برای گزارشدهندهها (با decay از down_stamp آنها)
if failed_for ≥ grace: OSD را در نقشهی بعدی down کن
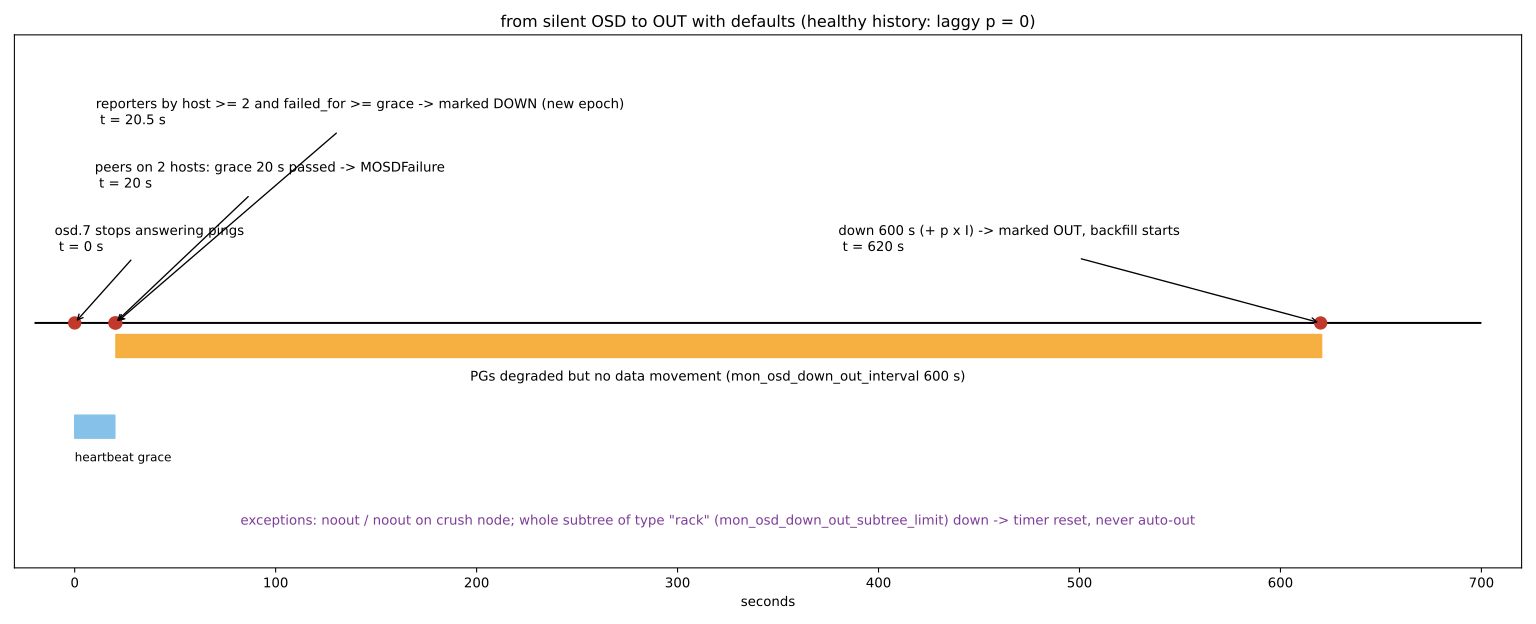
اگر failed_for ≥ grace + osd_heartbeat_stale (600 s) شد و هنوز تصمیمی نیست: گزارشها را دور بریزمثال عددی. OSD سالمی که سابقهی laggy ندارد (p = ۰) وقتی down میشود که همتایانش روی دستکم دو میزبان متفاوت گزارش بدهند و failed_for به ۲۰ ثانیه برسد. چون OSDها خودشان پس از ۲۰ ثانیه بدون پاسخ ping گزارش میدهند، این معمولاً تقریباً همزمان با اولین گزارشهاست. اگر همهی گزارشها از OSDهای یک میزبان باشند، شمارش گروهی ۱ است و OSD هیچوقت down نمیشود. این عمدی است، چون مشکل شبکهی یک میزبان نباید باعث down شدن بقیهی کلاستر شود. در کلاستر سهمیزبانی، اگر دو میزبان دیگر سالم باشند، این شرط برقرار میشود.
۷-۹-۲ سابقهی laggy: میانگین متحرک نمایی#
منبع در کد: src/mon/OSDMonitor.cc :: OSDMonitor::prepare_boot، grace_interval_threshold_exceeded، set_default_laggy_params
پیچیدگی: O(۱)
pseudocode
w = mon_osd_laggy_weight (0.3)
هنگام boot یک OSD که down علامت خورده بود:
    if boot_epoch == 0 (پردازه واقعاً از نو شروع شده):  p ×= 0.7 ; I ×= 0.7
    else (پردازه زنده بود، یعنی down اشتباه بود):
        gap = min(now − down_stamp, mon_osd_laggy_max_interval 300)
        I = w × gap + (1 − w) × I ;  p = w + (1 − w) × p
اگر down بعدی بیش از 48 × laggy_halflife (48 ساعت) پس از down_stamp قبلی بیفتد: p = I = 0
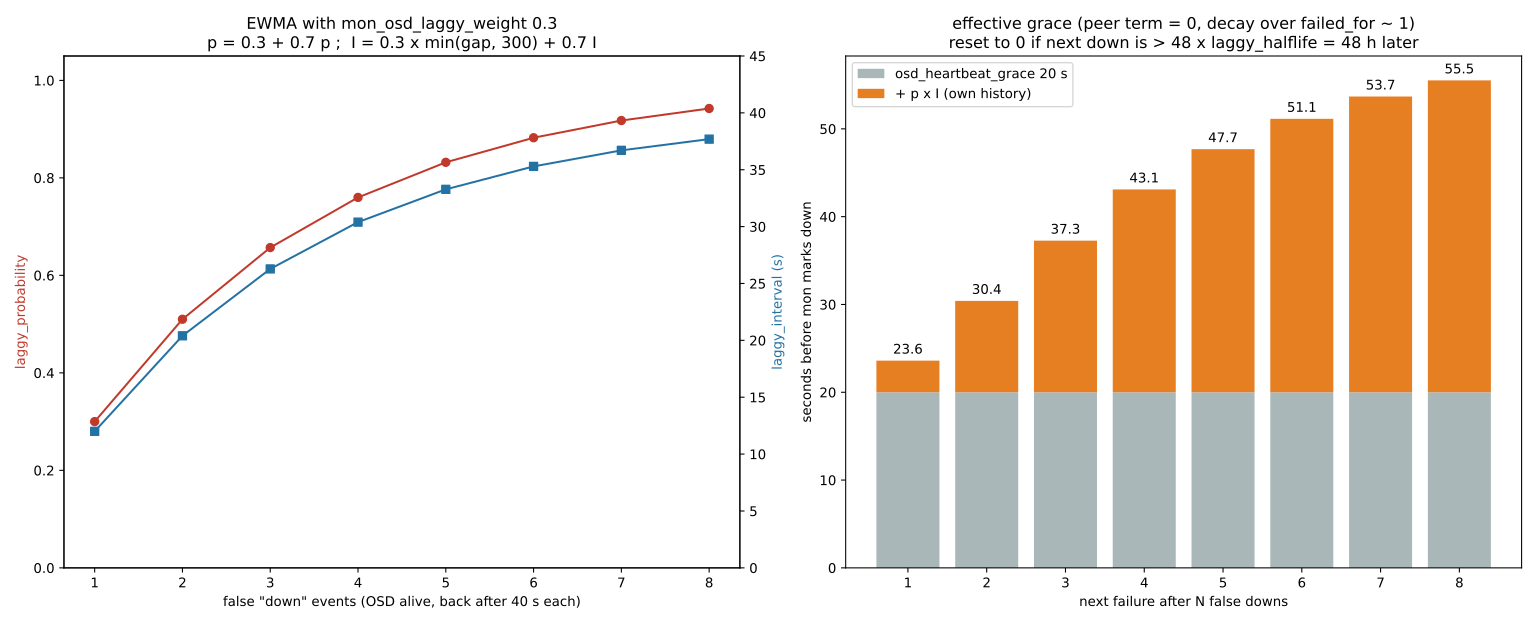
مثال عددی. OSDی که زیر بار سنگین به اشتباه down میشود و هر بار ۴۰ ثانیه بعد برمیگردد، پس از بار اول p = ۰.۳ و I = ۱۲ دارد. پس از بار دوم p = ۰.۵۱ و I = ۲۰.۴ است و پس از بار سوم p = ۰.۶۵۷ و I = ۲۶.۲۸. پس grace شکست بعدی تقریباً ۲۰ + ۰.۶۵۷ × ۲۶.۲۸ = ۳۷.۳ ثانیه است. decay در اینجا روی failed_for حساب میشود، یعنی چند ده ثانیه، و حدود ۰.۹۹۴ است. سری grace برای ۱ تا ۸ down اشتباه این است: ۲۳.۶، ۳۰.۴، ۳۷.۳، ۴۳.۱، ۴۷.۷، ۵۱.۱، ۵۳.۷ و ۵۵.۵ ثانیه. حد بالای آن ۲۰ + ۴۰ = ۶۰ ثانیه است. یعنی MON خود به خود با OSDهای «بدقلق» صبورتر میشود. چیزی که سابقه را پاک میکند گذشت زمان نیست، بلکه ریاستارت واقعی پردازه یا ۴۸ ساعت بدون down است. همین جمله، با decay بر اساس مدت down، به mon_osd_down_out_interval هم اضافه میشود. برای مثال بالا، out پس از حدود ۶۱۵ ثانیه انجام میشود، نه ۶۰۰.
۷-۹-۳ از down تا out#
منبع در کد: src/mon/OSDMonitor.cc :: OSDMonitor::tick (down_pending_out)، can_mark_out؛ src/osd/OSDMap.cc :: containing_subtree_is_down
پیچیدگی: O(OSDهای down × عمق CRUSH)
pseudocode
هر tick برای هر OSD در down_pending_out:
down = now − زمان down شدن
grace = mon_osd_down_out_interval (600) + exp(down × ln 0.5 / 3600) × I × p
if پرچم noout (سراسری یا روی گره CRUSH یا device class) یا can_mark_out رد کند: ادامه
if کل زیردرختی از نوع mon_osd_down_out_subtree_limit (rack) down است: down_pending_out[o] = now ; ادامه
if down ≥ grace: OSD را out کن (reweight = 0) ← PGها remap و backfill میشوندمثال عددی. OSD بیسابقه دقیقاً ۶۰۰ ثانیه پس از down، out میشود. اگر یک rack کامل با ۳ میزبان و ۳۶ OSD خاموش شود، شمارندهی هیچکدام جلو نمیرود و out خودکار انجام نمیشود. این سیاست محافظهکارانه است: فرض میکند خاموشی کامل یک rack (برق یا سوئیچ) گذرا است و نباید باعث جابهجایی چند ده ترابایت داده شود. برای نگهداری برنامهریزیشدهی یک میزبان، به جای پرچم سراسری از ceph osd set-group noout <host> یا ceph orch host maintenance enter استفاده کنید.
۷-۹-۴ MAX AVAIL در ceph df#
منبع در کد: src/mon/PGMap.cc :: PGMap::get_rule_avail، dump_object_stat_sum؛ src/osd/OSDMap.cc :: pool_raw_used_rate
پیچیدگی: O(OSDهای rule)
pseudocode
wm = سهم وزنی هر OSD در rule (get_rule_weight_osd_map، مجموع = 1)
برای هر OSD با وزن > 0:
avail = max(0, kb_avail − kb × (1 − full_ratio)) # 5٪ ذخیرهی پیش از full
proj = avail / wm[osd] # چقدر دادهی خام تا پر شدن همین OSD
raw_avail = min(proj) # پرترین OSD نسبت به سهمش
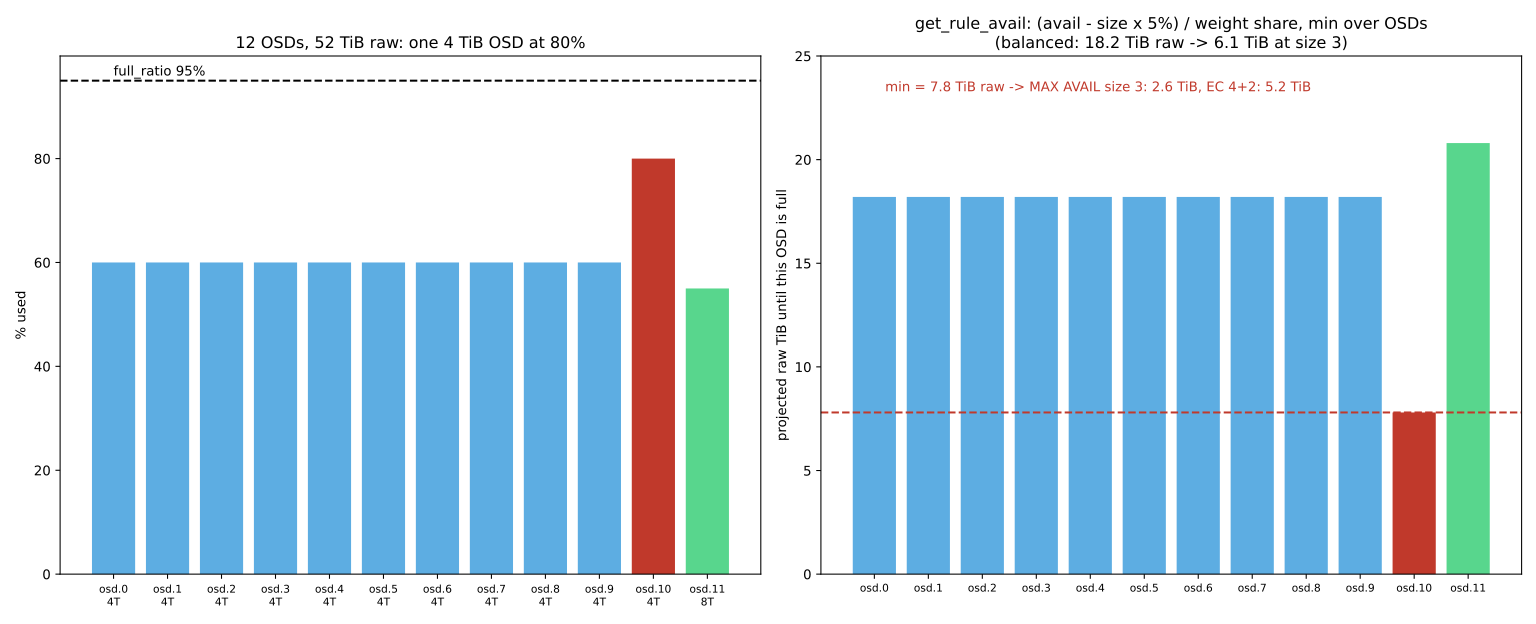
MAX AVAIL = raw_avail / raw_used_rate # replicated: size ؛ EC: (k + m) / kمثال عددی. کلاستری با ۵۲ TiB خام را در نظر بگیرید: یازده OSD چهار ترابایتی و یک OSD هشت ترابایتی. ده OSD چهار ترابایتی ۶۰٪ پرند، osd.10 ۸۰٪ و osd.11 (هشت ترابایتی) ۵۵٪. سهم وزنی هر OSD چهار ترابایتی ۴/۵۲ است. برای OSDهای ۶۰٪ داریم proj = (۱.۶ − ۰.۲) / (۴/۵۲) = ۱۸.۲ TiB، اما برای osd.10 فقط (۰.۸ − ۰.۲) / (۴/۵۲) = ۷.۸ TiB. MAX AVAIL یک pool سهنسخهای ۷.۸ / ۳ = ۲.۶ TiB است و یک pool EC ۴+۲ برابر ۷.۸ / ۱.۵ = ۵.۲ TiB. اگر osd.10 هم ۶۰٪ بود، همین pool سهنسخهای ۶.۱ TiB نشان میداد. پس یک OSD نامتوازن بیش از نیمی از فضای «قابلاستفاده»ی گزارششده را میخورد. این تعریف درست است، چون CRUSH داده را به نسبت وزن پخش میکند و همان OSD اول پر میشود. علاج آن balancer با حالت upmap است، نه افزودن دیسک.
۷-۱۰ نگهداری روزمره#
۷-۱۰-۱ حالت نگهداری میزبان#
برای کارهای برنامهریزیشده (بهروزرسانی هسته، تعویض قطعه، راهاندازی مجدد)، از حالت نگهداری cephadm استفاده کنید. این حالت همهی daemonهای Ceph روی میزبان را متوقف میکند و پرچم noout را فقط برای همان میزبان میگذارد تا OSDهایش out نشوند و بازیابی بیمورد شروع نشود:
ceph osd ok-to-stop $(ceph osd ls-tree ceph-node2 | tr '\n' ' ') # آیا توقف همهی OSDهای این میزبان امن است؟
ceph orch host maintenance enter ceph-node2
# ... راهاندازی مجدد میزبان یا تعمیر ...
ceph orch host maintenance exit ceph-node2
ceph -s--force در maintenance enter بررسیهای ایمنی را دور میزند. اگر میزبان آخرین MON سالم یا آخرین نسخهی در دسترس برخی PGها را دارد، ورود اجباری به نگهداری یعنی قطع دسترسی. اگر ok-to-stop منفی جواب داد، اول علت را برطرف کنید.
۷-۱۰-۲ پرچمهای کلاستر#
| پرچم | اثر | کاربرد معمول |
|---|---|---|
| noout | OSDهای down خودکار out نمیشوند | نگهداری کوتاهمدت |
| norebalance | بازتوزیع دادهی سالم متوقف میشود | افزودن گروهی OSD |
| nobackfill | backfill متوقف میشود | کاهش بار در ساعات اوج |
| norecover | بازیابی متوقف میشود | فقط در اضطرار و برای مدت کوتاه |
| noscrub, nodeep-scrub | scrub جدید شروع نمیشود | عملیات سنگین، ارتقا |
| pause | همهی خواندن و نوشتنها متوقف میشود | تقریباً هرگز در production |
ceph osd set noout
ceph osd unset noout
ceph osd set-group noout osd.4 # فقط یک OSD
ceph osd set-group noout ceph-node3 # همهی OSDهای یک میزبان (bucket CRUSH)
ceph osd unset-group noout ceph-node3پرچمهای فراموششده یکی از رایجترین علتهای رفتار عجیب کلاستر هستند (مثلاً داده هرگز بازیابی نمیشود چون norecover روشن مانده است). در پایش، هشدار OSDMAP_FLAGS را جدی بگیرید و بعد از هر نگهداری ceph osd dump | grep flags را بررسی کنید.
۷-۱۰-۳ کنترل سرعت بازیابی و backfill#
راهنماهای قدیمی برای کند کردن بازیابی، تنظیم مستقیم osd_max_backfills، osd_recovery_max_active و osd_recovery_sleep را آموزش میدادند. از Quincy، زمانبند پیشفرض OSD mClock است و این تنظیمات را خودش مدیریت میکند. راه درست امروزی انتخاب پروفایل است:
| پروفایل | اولویت | کاربرد |
|---|---|---|
| balanced (پیشفرض) | تعادل بین کلاینت و بازیابی | حالت عادی |
| high_client_ops | اولویت با کلاینت؛ بازیابی کندتر | ساعات اوج، کلاستر حساس به تأخیر |
| high_recovery_ops | اولویت با بازیابی | پس از خرابی بزرگ، در ساعات کمبار |
ceph config get osd osd_mclock_profile
ceph config set osd osd_mclock_profile high_recovery_ops
# پس از اتمام بازیابی
ceph config set osd osd_mclock_profile balancedدر حالت mClock، OSD مقادیری مثل osd_max_backfills و osd_recovery_max_active را نادیده میگیرد یا خودش تنظیم میکند. اگر واقعاً لازم است دستی تنظیمشان کنید، اول باید osd_mclock_override_recovery_settings را true کنید. mClock برای تخصیص سهمها به ظرفیت IOPS هر OSD تکیه دارد که در اولین راهاندازی اندازهگیری میشود (osd_mclock_max_capacity_iops_hdd و _ssd). اگر این اندازهگیری روی دیسک شلوغ انجام شده باشد، مقدار غیرواقعی سهم بازیابی را خراب میکند. در Squid برای HDDها پیشفرضهای shard تغییر کرد (osd_op_num_shards_hdd برابر ۱ با ۵ thread) تا رفتار mClock روی HDD قابل پیشبینیتر شود.
۷-۱۰-۴ اولویتدهی به PGهای خاص#
ceph pg force-recovery 2.1f
ceph pg force-backfill 2.1f 2.20
ceph pg cancel-force-recovery 2.1f
۷-۱۰-۵ scrub#
scrub سبک (هر روز) فرادادهی نسخهها را مقایسه میکند و deep-scrub (هر هفته) داده را با checksum بررسی میکند. برای کاهش اثر scrub بر کلاینت، آن را به ساعات کمبار محدود کنید:
ceph config set osd osd_scrub_begin_hour 1
ceph config set osd osd_scrub_end_hour 6
ceph pg deep-scrub 2.1f
ceph health detail | grep -i scrub- وضعیت مطلوب را با
ceph orch ls --export در Git نگه دارید. - پیکربندی در پایگاه MON است؛
ceph.conf را دستی ویرایش نکنید. - قبل از هر حذف:
ok-to-stop و safe-to-destroy. - تعویض دیسک با
--replace تا id و CRUSH حفظ شوند. - نگهداری میزبان فقط با
maintenance enter/exit. - پرچمها را پس از کار بردارید؛
OSDMAP_FLAGS را پایش کنید. - سرعت بازیابی را با پروفایل mClock کنترل کنید، نه تنظیم دستی.
- ارتقا: یادداشت انتشار، HEALTH_OK، مسیر حداکثر دو نسخه، پایش پس از ارتقا.
۷-۱۱ تکمیلی و بهروز#
- ceph-deploy بازنشسته شده و ceph-ansible هم دیگر مسیر توصیهشده نیست؛ cephadm و Rook دو روش پشتیبانیشدهی استقرار و راهبری هستند.
- پیکربندی متمرکز (Mimic) جای ویرایش
ceph.conf را گرفت. - mClock (پیشفرض از Quincy) کنترل بازیابی را به پروفایلها سپرد؛ نسخهی نقطهای ۱۹.۲.۱ از Squid پیشفرضهای shard HDD را به ۱ شارد × ۵ thread تغییر داد (issue 66289).
- Umbrella: ارتقای OSD به ترتیب bucketهای CRUSH و دستور
ceph osd ok-to-upgrade؛ پیشنیاز CPU x86-64-v3 و imageهای el10؛ و افزایش پیشفرضهای mon_target_pg_per_osd به ۲۰۰ و mon_max_pg_per_osd به ۵۰۰ که بر برنامهریزی PG در کلاسترهای ارتقایافته اثر دارد. - Tentacle: ماژولهای restful و zabbix از MGR حذف شدند؛ اگر اسکریپتهای عملیاتی شما به restful وابستهاند، پیش از ارتقا آنها را به API داشبورد منتقل کنید.
۷-۱۲ تمرین عملی#
- ۱. خروجی
ceph orch ls --export را ذخیره کنید، تعداد MGRها را تغییر دهید و تفاوت را با diff ببینید. - ۲.
osd_memory_target را فقط برای OSDهای کلاس ssd تغییر دهید و با ceph config show در یک OSD بررسی کنید. - ۳. یک میزبان را وارد حالت نگهداری کنید، آن را راهاندازی مجدد کنید و خارج شوید. در حین کار خروجی
ceph -s و پرچمها را یادداشت کنید. - ۴. خرابی دیسک را با
ceph orch daemon stop osd.N شبیهسازی کنید، پس از out شدن، روال تعویض با --replace را اجرا کنید. - ۵. پروفایل mClock را به
high_recovery_ops تغییر دهید و سرعت بازیابی (ceph -s) را با balanced مقایسه کنید. - ۶. در آزمایشگاه، کلاستر را به آخرین نسخهی نقطهای همان خط ارتقا دهید و مراحل را با
ceph -W cephadm دنبال کنید.
۷-۱۳ پرسشهای مرور#
- ۱. چرا توقف daemon با systemctl در cephadm توصیه نمیشود؟
- ۲. ترتیب اولویت منابع پیکربندی چیست و مقدار مؤثر را چطور میبینید؟
- ۳. تفاوت
ceph tell و ceph daemon چیست؟ - ۴. مزایا و معایب scale-up و scale-out را از نظر دامنهی خرابی مقایسه کنید.
- ۵. چرا هنگام افزودن تعداد زیادی OSD، پرچمهای norebalance و nobackfill مفیدند؟
- ۶. تفاوت
ok-to-stop و safe-to-destroy چیست؟ - ۷. گزینهی
--replace در حذف OSD چه مزیتی دارد؟ - ۸. حالت نگهداری cephadm چه کاری انجام میدهد؟
- ۹. چرا در mClock تنظیم مستقیم
osd_max_backfills اثر ندارد و راه درست چیست؟ - ۱۰. ارتقای OSD به ترتیب bucketهای CRUSH در Umbrella چه ریسکی را کاهش میدهد؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۷-۱۴ منابع این فصل#
- cephadm operations
https://docs.ceph.com/en/latest/cephadm/operations/ - Host management
https://docs.ceph.com/en/latest/cephadm/host-management/ - OSD service
https://docs.ceph.com/en/latest/cephadm/services/osd/ - Upgrading Ceph (cephadm
https://docs.ceph.com/en/latest/cephadm/upgrade/ - Configuring Ceph
https://docs.ceph.com/en/latest/rados/configuration/ceph-conf/ - ceph command reference
https://docs.ceph.com/en/latest/man/8/ceph/ - mClock config reference
https://docs.ceph.com/en/latest/rados/configuration/mclock-config-ref/ - Device management
https://docs.ceph.com/en/latest/rados/operations/devices/ - Monitor/OSD interaction
https://docs.ceph.com/en/latest/rados/configuration/mon-osd-interaction/ - Adding/removing monitors
https://docs.ceph.com/en/latest/rados/operations/add-or-rm-mons/ - Release index
https://docs.ceph.com/en/latest/releases/ - Tentacle release notes
https://docs.ceph.com/en/latest/releases/tentacle/