ذخیرهسازی شیء چندسایتی با RGW Multi-Site
حوصله ندارم این فصل در چند خط
- realm فضای نام سراسری است، zonegroup واحد تکثیر داده، zone یک کلاستر و period یک نسخهی commitشده از پیکربندی.
- metadata از zone اصلی (master) پخش میشود؛ دادهی اشیا بین zoneهای یک zonegroup بهصورت ناهمگام و active-active تکثیر میشود.
- راهاندازی دستی با
radosgw-admin یا خودکار با ceph rgw realm bootstrap است؛ پایش با sync status، bucket sync status و sync error list انجام میشود. - failover یعنی master کردن zone دیگر و commit کردن period؛ در قطعی کوتاه شبکه با عجله promote نکنید.
۵-۱ پیش از شروع#
۵-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
یک کلاستر Ceph، هر قدر هم بزرگ، در یک مرکز داده قرار دارد. برای بازیابی از سانحه، نزدیک کردن داده به کاربران در مناطق مختلف، یا مهاجرت بین مراکز داده، باید دادهی شیء را بین چند کلاستر مستقل تکثیر کنیم. RGW Multi-Site پاسخ Ceph به این نیاز است. در این فصل میبینیم:
- realm، zonegroup، zone و period چه هستند و چطور با هم یک فضای نام سراسری میسازند؟
- multisite امروزی (نسخهی ۲، از Jewel) چه فرقی با پیکربندی federated قدیمی Hammer دارد؟
- پیشنیازهای شبکه، زمان و ظرفیت برای یک استقرار چندسایتی چیست؟
- چطور دو zone را، هم به روش دستی با
radosgw-admin و هم با ماژول خودکار ceph rgw، پیکربندی کنیم؟ - چطور وضعیت همگامسازی را بخوانیم، مشکلات را پیدا کنیم و هنگام سانحه master را جابهجا کنیم؟
- sync policy، archive zone و resharding در multisite چگونه کار میکنند؟
۵-۱-۲ پیشنیاز#
دو کلاستر Ceph (برای آزمایشگاه دو کلاستر تکنودی کافی است) که RGWهایشان از طریق HTTP به هم دسترسی دارند. مفاهیم فصل ۴ را باید بدانید.
۵-۲ مفاهیم multisite#
۵-۲-۱ سلسلهمراتب#
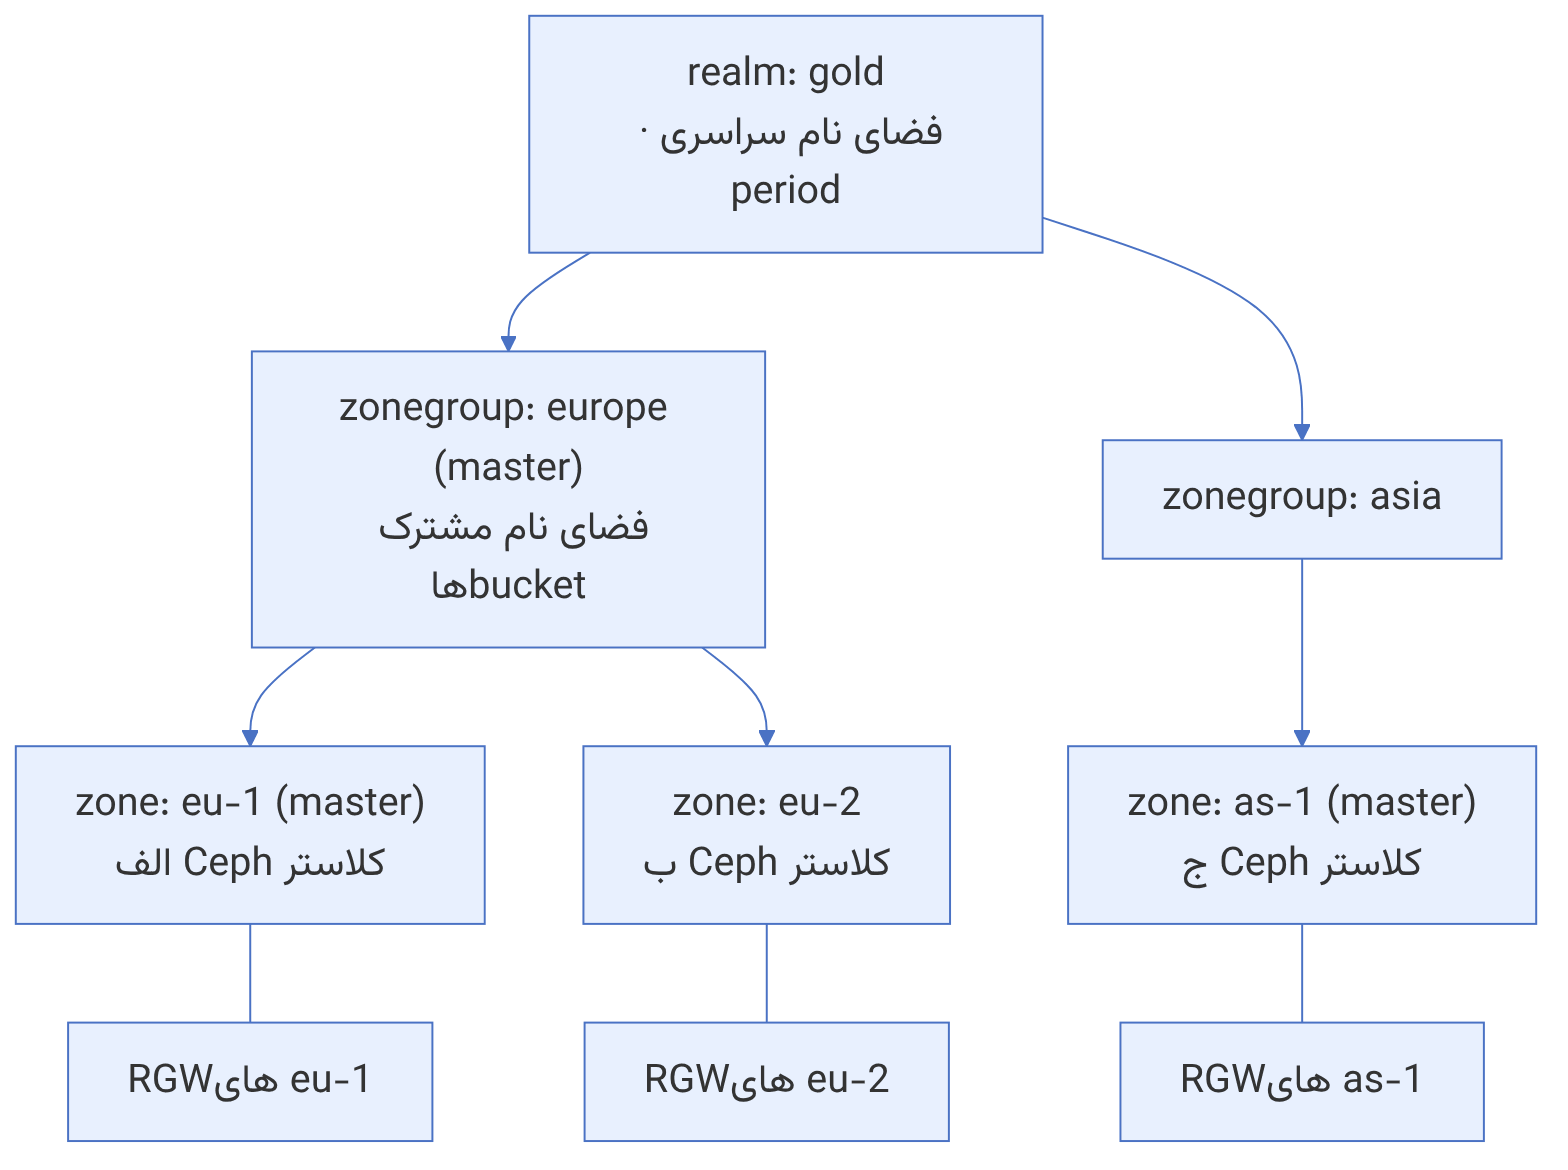
| مفهوم | تعریف | نکته |
|---|---|---|
| zone | مجموعهای از poolها و نمونههای RGW در یک کلاستر Ceph | هر zone در یک کلاستر است؛ یک کلاستر میتواند چند zone داشته باشد |
| zonegroup | گروهی از zoneها که دادهی bucketها بین آنها تکثیر میشود | قبلاً «region» نامیده میشد؛ یک zone آن master است |
| realm | ظرف سراسری شامل zonegroupها؛ فضای نام یکتای کاربران و bucketها | یک zonegroup آن master است |
| period | نسخهای از پیکربندی realm با شناسه و epoch | هر تغییر ساختاری با period update --commit منتشر میشود |
| master zone | zoneی که فراداده (کاربران، bucketها) را میپذیرد و به بقیه پخش میکند | ساخت کاربر و bucket فقط از طریق آن |
۵-۲-۲ چه چیزی و چطور تکثیر میشود؟#
- فراداده (کاربران، bucketها، سیاستها) در سطح realm تکثیر میشود و همیشه از master zone در master zonegroup منشأ میگیرد. درخواست ساخت bucket به zone غیر master بهطور خودکار به master forward میشود.
- دادهی اشیاء فقط بین zoneهای یک zonegroup تکثیر میشود. zonegroupهای مختلف فضای نام مشترک دارند (نام bucket یکتاست) اما دادهی هر bucket فقط در zonegroup خودش است.
- همگامسازی ناهمگام و active-active است: کلاینتها میتوانند در هر zone بنویسند و تغییرات با تأخیری کوتاه به zoneهای دیگر میرسند. در تعارض نوشتن همزمان روی یک شیء، آخرین نوشتن (بر اساس زمان) برنده است.
چون همگامسازی ناهمگام است، multisite جایگزین سازگاری قوی بین سایتها نیست. اگر برنامهای در سایت A مینویسد و بلافاصله در سایت B میخواند، ممکن است نسخهی قدیمی یا هیچ نسخهای نبیند. برنامهها را طوری طراحی کنید که هر کلاینت «سایت خانگی» داشته باشد، یا وابستگی به خواندن فوری بینسایتی نداشته باشند.
۵-۲-۳ تغییرات از پیکربندی federated در Hammer#
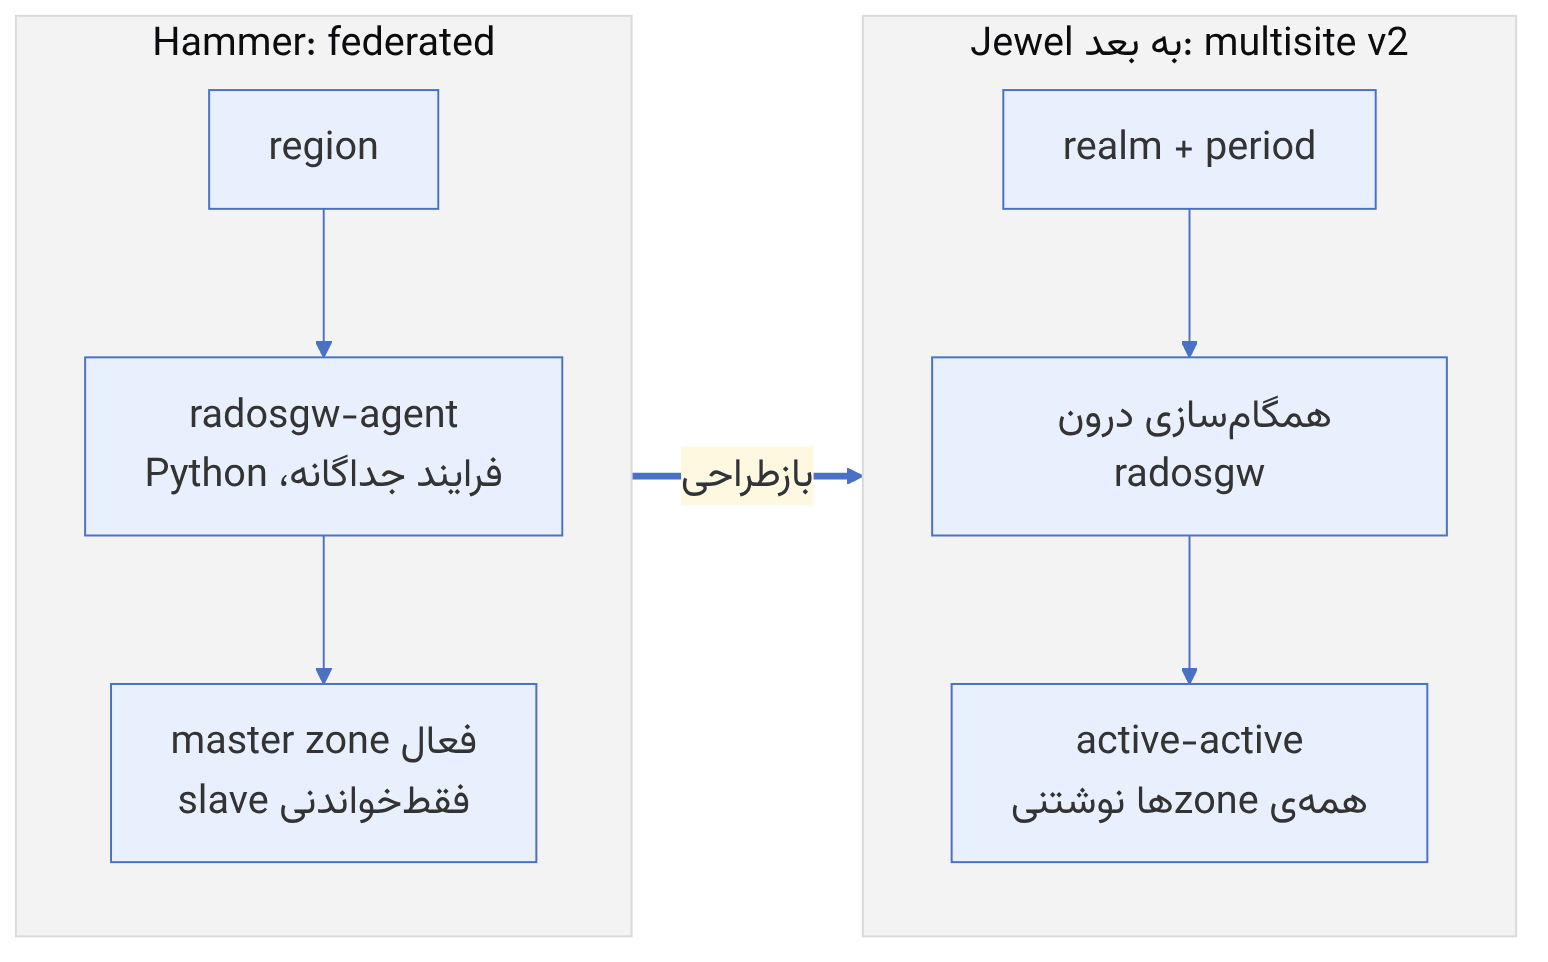
در Hammer و پیش از آن، تکثیر با یک فرایند Python بیرونی به نام radosgw-agent انجام میشد، zone ثانوی فقطخواندنی بود و مفهوم realm و period وجود نداشت. از Jewel، multisite بازطراحی شد:
- همگامسازی درون خود radosgw انجام میشود (نیازی به agent نیست).
- همهی zoneها میتوانند داده بپذیرند (active-active).
- realm و period امکان تغییر پیکربندی سازگار و نسخهدار را فراهم کردهاند.
- failover با جابهجایی master zone و commit یک period جدید انجام میشود.
از آن زمان قابلیتهای بسیاری اضافه شده است: sync policy با کنترل در سطح bucket (Octopus)، archive zone، resharding بدون توقف همگامسازی (از Reef با zone feature به نام resharding) و در Umbrella اصلاحهای متعدد در درستی همگامسازی.
۵-۳ پیشنیازهای multisite#
۵-۳-۱ شبکه و زمان#
- دسترسی HTTP(S) بین RGWها: RGWهای هر zone باید endpointهای zoneهای دیگر را ببینند. معمولاً endpoint هر zone نشانی load balancer آن است.
- پهنای باند: نرخ تغییر داده (نه حجم کل) تعیینکننده است. همگامسازی اولیه (full sync) کل دادهی موجود را منتقل میکند؛ برای دادهی چندصد ترابایتی، روزها طول میکشد.
- تأخیر: multisite برای WAN طراحی شده و تأخیر بالا را تحمل میکند، اما تأخیر زیاد، عقبماندگی را بالا میبرد.
- همگامی ساعت: حل تعارض و امضای درخواستها به زمان وابسته است. همهی nodeها باید با NTP همگام باشند.
۵-۳-۲ کاربر system و endpointها#
zoneها برای خواندن لاگها و اشیای یکدیگر از یک کاربر system با کلید مشترک استفاده میکنند. این کاربر در master zone ساخته میشود و کلیدش در پیکربندی همهی zoneها قرار میگیرد.
کاربر system به همهی دادهها و فرادادهی realm دسترسی کامل دارد. کلیدش را مثل کلید مدیر کلاستر حفاظت کنید، endpointهای همگامسازی را فقط روی شبکهی خصوصی یا VPN بین سایتها باز کنید و از TLS استفاده کنید.
۵-۳-۳ ظرفیت و poolها#
هر zone poolهای خودش را دارد که نامشان با نام zone شروع میشود (مثلاً eu-1.rgw.buckets.data). اگر poolها را پیش از راهاندازی بسازید، میتوانید قاعدهی CRUSH، EC و target_size_ratio را از ابتدا درست تعیین کنید؛ وگرنه RGW آنها را با پیشفرضها میسازد. علاوه بر داده، pool لاگ (<zone>.rgw.log) در multisite پرکارتر است و باید روی رسانهی سریع باشد.
هر دو سایت را از نظر ظرفیت متقارن طراحی کنید. zone ثانوی که زودتر پر شود، همگامسازی را متوقف میکند و بعد از آزاد کردن فضا باید عقبماندگی زیادی را جبران کند.
۵-۴ پیکربندی multisite به روش دستی#
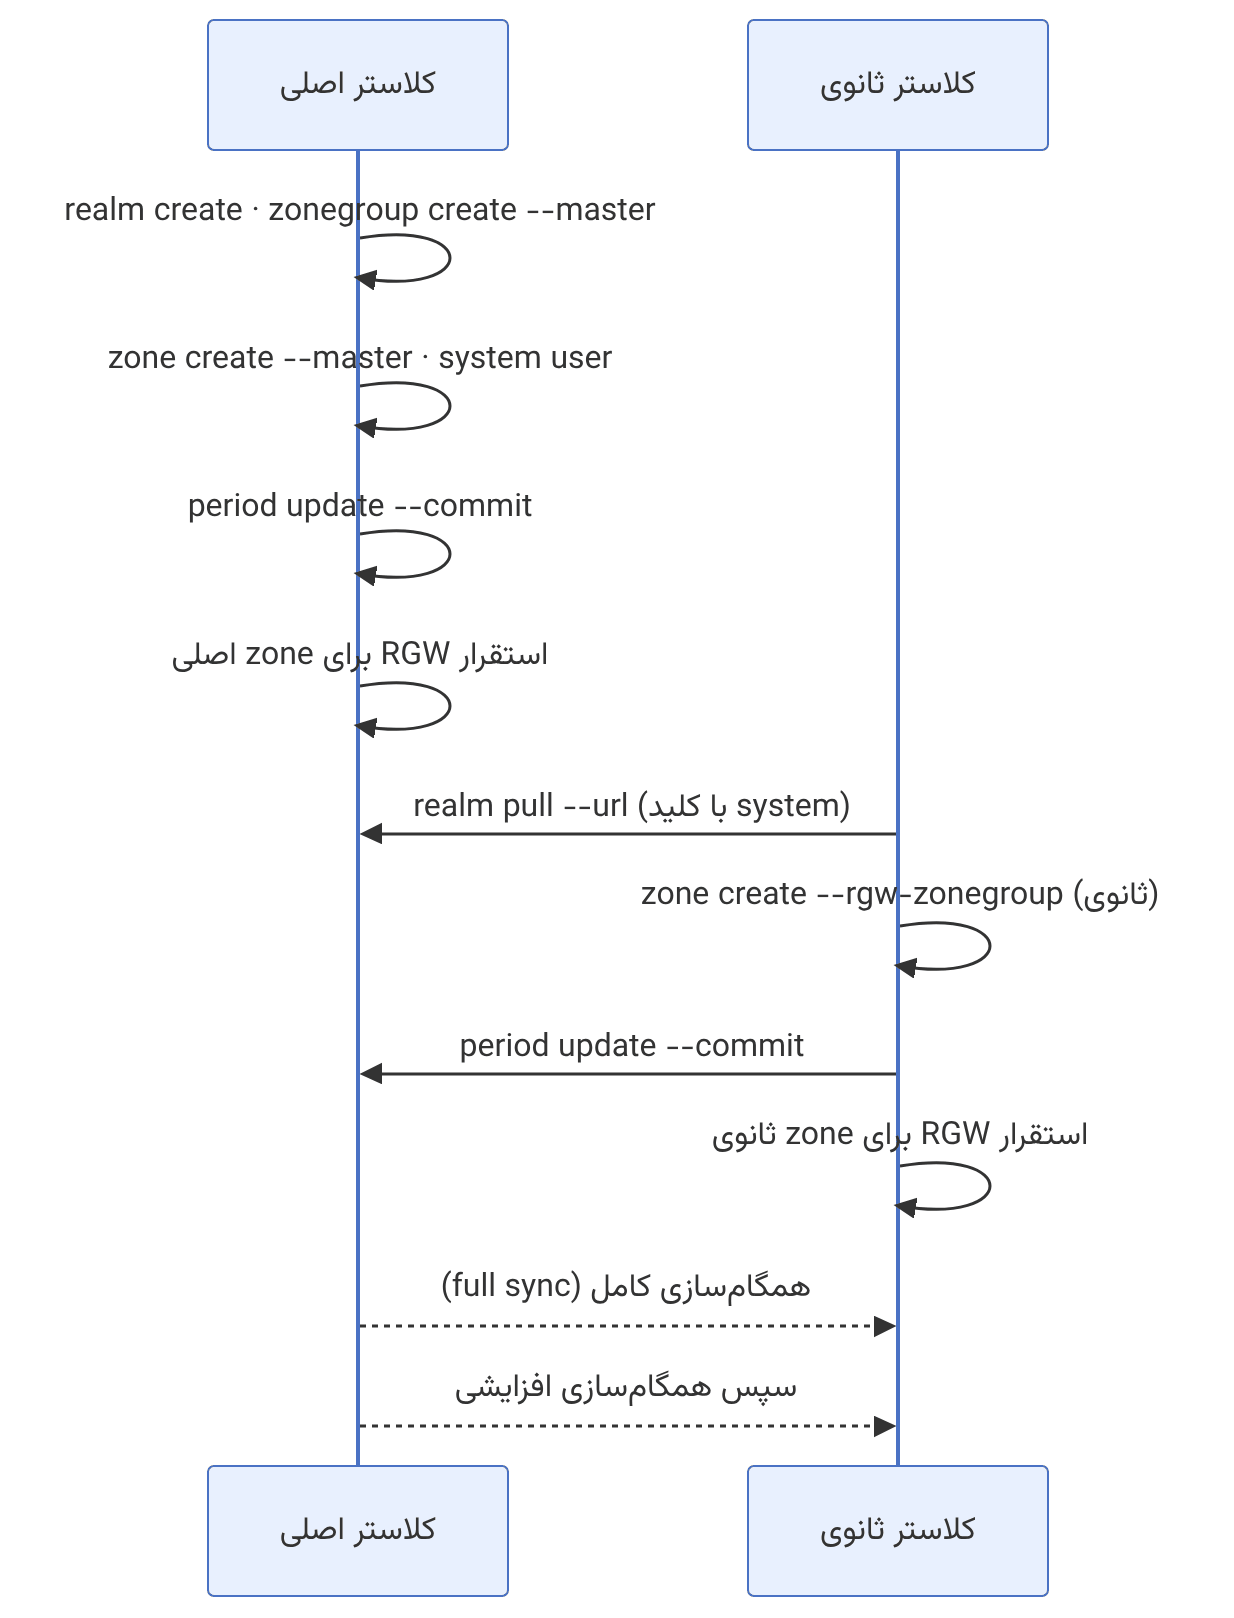
فرضها: کلاستر اصلی با RGW در دسترس روی http://rgw-eu1.example.com:80 و کلاستر ثانوی روی http://rgw-eu2.example.com:80. realm به نام gold، zonegroup به نام europe، zoneها eu-1 و eu-2.
۵-۴-۱ گام ۱: ساختار در کلاستر اصلی#
radosgw-admin realm create --rgw-realm=gold --default
radosgw-admin zonegroup create --rgw-zonegroup=europe \
  --endpoints=http://rgw-eu1.example.com:80 --rgw-realm=gold --master --default
radosgw-admin zone create --rgw-zonegroup=europe --rgw-zone=eu-1 \
  --endpoints=http://rgw-eu1.example.com:80 --master --default
اگر پیشتر RGW تکسایتی با zone و zonegroup پیشفرض (default) داشتهاید و داده دارد، بهجای ساختن zone جدید، zone و zonegroup پیشفرض را تغییر نام دهید و به realm اضافه کنید (مستندات «Migrating a Single-Site Deployment to Multi-Site»). در غیر این صورت دادهی موجود در zone قدیمی بیصاحب میماند.
۵-۴-۲ گام ۲: کاربر system#
radosgw-admin user create --uid=sync-user --display-name="Multisite sync" --system
# access_key و secret_key را از خروجی بردارید
radosgw-admin zone modify --rgw-zone=eu-1 --access-key=<AK> --secret=<SK>
radosgw-admin period update --commit
۵-۴-۳ گام ۳: RGW برای zone اصلی#
با cephadm، سرویس RGW را با realm و zone مشخص مستقر کنید:
ceph orch apply rgw gold-eu1 --realm=gold --zone=eu-1 \
  --placement="label:rgw count-per-host:1" --port=80
۵-۴-۴ گام ۴: کلاستر ثانوی#
radosgw-admin realm pull --url=http://rgw-eu1.example.com:80 \
  --access-key=<AK> --secret=<SK>
radosgw-admin realm default --rgw-realm=gold
radosgw-admin period pull --url=http://rgw-eu1.example.com:80 --access-key=<AK> --secret=<SK>
radosgw-admin zone create --rgw-zonegroup=europe --rgw-zone=eu-2 \
  --endpoints=http://rgw-eu2.example.com:80 --access-key=<AK> --secret=<SK>
radosgw-admin period update --commit
ceph orch apply rgw gold-eu2 --realm=gold --zone=eu-2 \
--placement="label:rgw count-per-host:1" --port=80اگر period update --commit در کلاستر ثانوی با خطای «failed to commit period» یا «connection refused» شکست خورد، از کلاستر ثانوی با curl http://rgw-eu1.example.com:80 دسترسی را بسنجید و مطمئن شوید کلیدهای system در zone modify درست قرار گرفتهاند (radosgw-admin zone get --rgw-zone=eu-1). یک خطای رایج، نام میزبانی است که فقط در یکی از سایتها قابلحل است.
۵-۵ پیکربندی خودکار با ماژول rgw#
از Reef به بعد، ماژول MGR به نام rgw (فرمان ceph rgw) همهی گامهای بالا را در دو دستور خلاصه میکند و با ارکستراتور هماهنگ است:
# primary.yaml روی کلاستر اصلی
rgw_realm: gold
rgw_zonegroup: europe
rgw_zone: eu-1
placement:
  label: rgw
  count_per_host: 1
spec:
rgw_frontend_port: 80ceph mgr module enable rgw
ceph rgw realm bootstrap -i primary.yaml
ceph rgw realm tokens # توکن base64 شامل realm، endpoint و کلیدها# secondary.yaml روی کلاستر ثانوی
rgw_zone: eu-2
rgw_realm_token: <token>
placement:
label: rgw
spec:
rgw_frontend_port: 80ceph mgr module enable rgw
ceph rgw zone create -i secondary.yamlروش خودکار برای ساختارهای ساده (یک zonegroup و دو یا چند zone) بسیار سریعتر و کمخطاتر است. برای ساختارهای پیچیده (چند zonegroup، placementهای سفارشی، مهاجرت از تکسایتی) روش دستی کنترل بیشتری میدهد. داشبورد Ceph هم از Tentacle یک wizard برای خودکارسازی multisite دارد.
توکن realm حاوی کلید کاربر system است. همان مراقبتی که برای توکن bootstrap در RBD mirroring گفتیم، اینجا هم لازم است.
۵-۶ بررسی وضعیت همگامسازی#
۵-۶-۱ sync status#
radosgw-admin sync statusخروجی نمونه در zone ثانوی:
          realm 1c2d... (gold)
      zonegroup 7a8b... (europe)
           zone 9e0f... (eu-2)
   current time 2026-11-15T08:12:44Z
zonegroup features enabled: resharding
  metadata sync syncing
                full sync: 0/64 shards
                incremental sync: 64/64 shards
                metadata is caught up with master
      data sync source: 3d4e... (eu-1)
                        syncing
                        full sync: 0/128 shards
                        incremental sync: 128/128 shards
                        data is caught up with source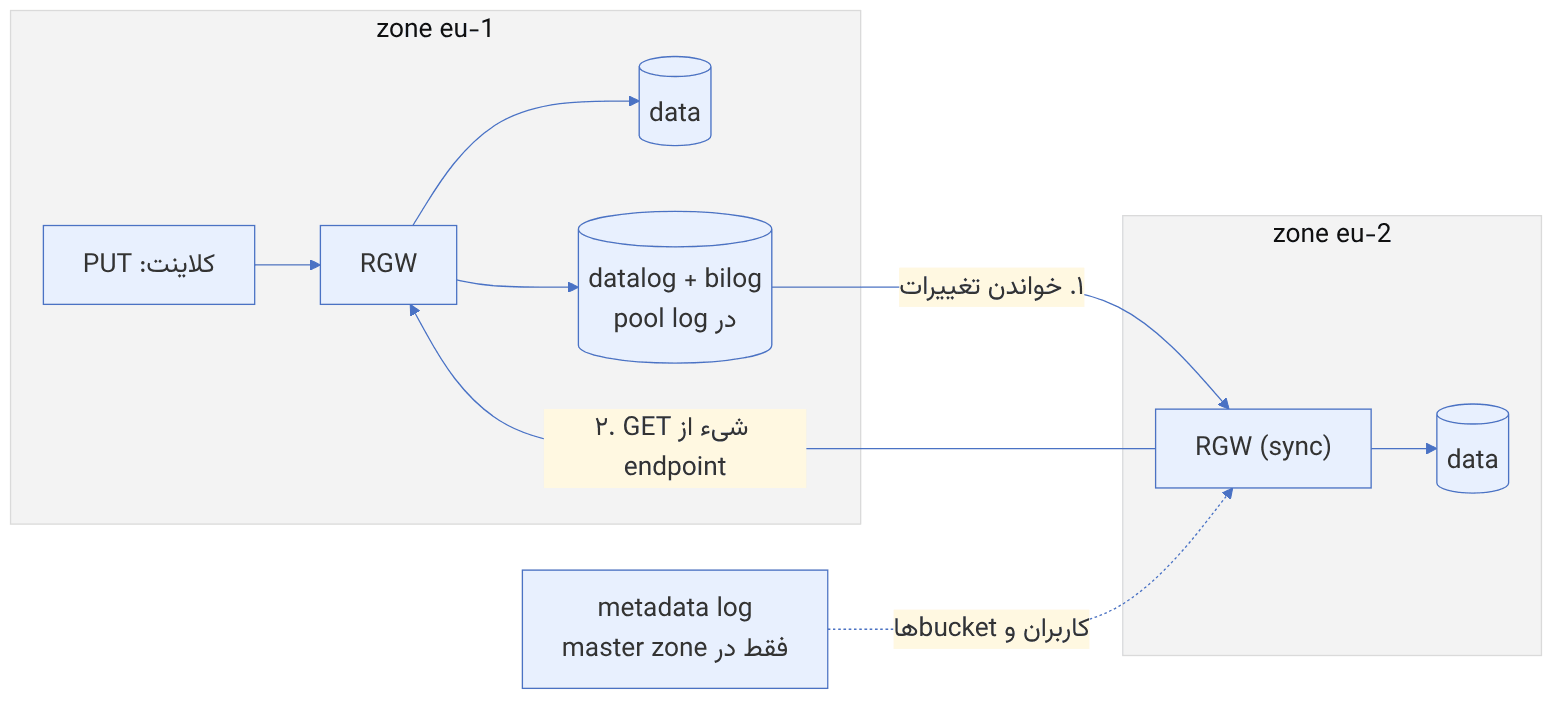
| عبارت در خروجی | معنا | اقدام |
|---|---|---|
| metadata is caught up with master | فراداده همگام است | — |
| data is caught up with source | دادهی همهی shardها همگام است | — |
| behind shards: [..] | برخی shardهای داده عقباند | اگر ماندگار است، sync error list و پهنای باند را بررسی کنید |
| oldest incremental change not applied | قدیمیترین تغییر اعمالنشده | اختلاف زمانی را با now مقایسه کنید (RPO واقعی) |
| full sync: N/M shards | همگامسازی کامل در جریان است | طبیعی پس از راهاندازی یا resync |
۵-۶-۲ دستورهای تکمیلی#
radosgw-admin sync status --rgw-zone=eu-2
radosgw-admin metadata sync status
radosgw-admin data sync status --source-zone=eu-1
radosgw-admin bucket sync status --bucket=photos
radosgw-admin sync error list | head -50
radosgw-admin sync error trim
radosgw-admin period get | jq '.period_map.zonegroups[].zones[].name'سه مشکل پرتکرار:
عقبماندگی ماندگار در چند shard: معمولاً یک bucket خیلی پرتغییر یا شیء خراب. bucket sync status روی bucketهای پرترافیک و sync error list را ببینید.
خطاهای ۴۰۳ در لاگ همگامسازی: کلید system در یکی از zoneها با کاربر واقعی یکی نیست یا کاربر system حذف یا تعلیق شده است.
همگامسازی شروع نمیشود: endpointهای zone (zone get) به نشانیای اشاره میکنند که از سایت دیگر در دسترس نیست (مثلاً localhost یا نام داخلی).
۵-۷ آزمون همگامسازی کاربر، bucket و شیء#
# روی کلاستر اصلی (master zone)
radosgw-admin user create --uid=tester --display-name="Multisite tester"
# روی کلاستر ثانوی، پس از چند ثانیه:
radosgw-admin user info --uid=tester        # کاربر همگام شده است
# با s3cmd یا aws-cli
aws --endpoint-url http://rgw-eu1.example.com s3 mb s3://ms-test
aws --endpoint-url http://rgw-eu1.example.com s3 cp ./report.pdf s3://ms-test/
aws --endpoint-url http://rgw-eu2.example.com s3 ls s3://ms-test/
# نوشتن در zone ثانوی و دیدن در اصلی (active-active)
aws --endpoint-url http://rgw-eu2.example.com s3 cp ./notes.txt s3://ms-test/
aws --endpoint-url http://rgw-eu1.example.com s3 ls s3://ms-test/
radosgw-admin bucket sync status --bucket=ms-testزمان رسیدن شیء به zone دیگر را اندازه بگیرید: در یک حلقه هر ثانیه یک شیء کوچک با زمان فعلی در نام در eu-1 بنویسید و در eu-2 فهرست بگیرید. سپس با ابزار tc روی میزبان RGW ثانوی ۲۰۰ میلیثانیه تأخیر شبیهسازی کنید (tc qdisc add dev eth0 root netem delay 200ms) و اثرش را ببینید. یادتان نرود در پایان tc qdisc del dev eth0 root اجرا کنید.
۵-۸ از درون کد: لاگها و coroutineهای همگامسازی multisite#
۵-۸-۱ سه لاگ، سه لایه#
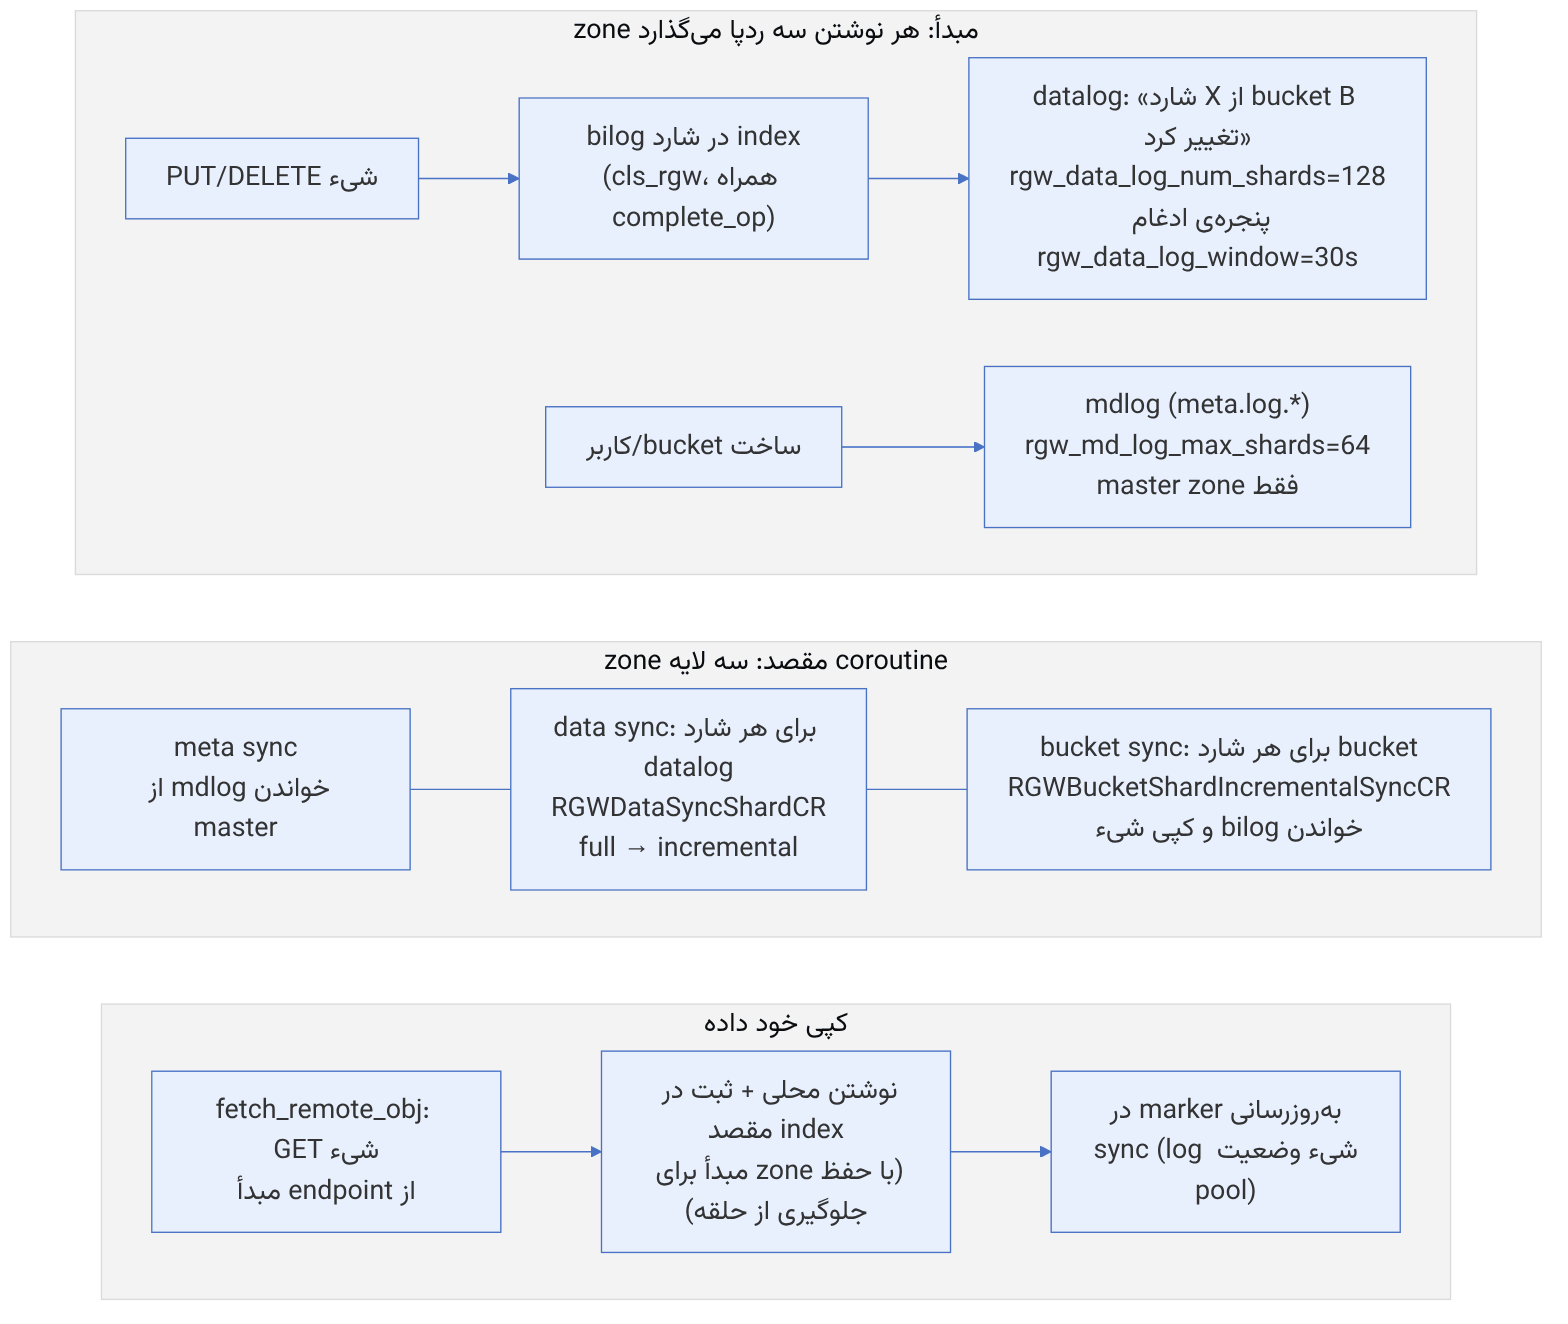
همگامسازی multisite در RGW کششی (pull) است. هر zone مقصد با REST، لاگهای zone مبدأ را میخواند و تغییرات را خودش اعمال میکند. سه نوع لاگ در این کار نقش دارند:
| لاگ | کجا ذخیره میشود | چه چیزی را ثبت میکند | پیشفرضها (main) |
|---|---|---|---|
| bilog | کنار هر شارد bucket index (cls_rgw) | هر تغییر شیء در آن شارد | همراه complete_op |
| datalog | pool log zone | «این bucket shard تغییر کرده است» (نه خود شیء) | rgw_data_log_num_shards=128، rgw_data_log_window=30 |
| mdlog | اشیای meta.log.* (rgw_mdlog.h) | تغییر فراداده: کاربر، bucket، bucket instance | rgw_md_log_max_shards=64 |
۵-۸-۲ ماشین حالت data sync#
rgw_data_sync_info در src/rgw/driver/rados/rgw_data_sync.h سه حالت دارد: StateInit = 0، StateBuildingFullSyncMaps = 1 و StateSync = 2. پیادهسازی بر پایهی چارچوب coroutine خود RGW (RGWCoroutine) است. کلاسهای اصلی در rgw_data_sync.cc اینها هستند: RGWDataSyncShardCR (حلقهی هر شارد)، RGWDataFullSyncShardCR، RGWDataIncSyncShardCR، RGWListRemoteDataLogShardCR و برای لایهی bucket، RGWBucketShardIncrementalSyncCR.
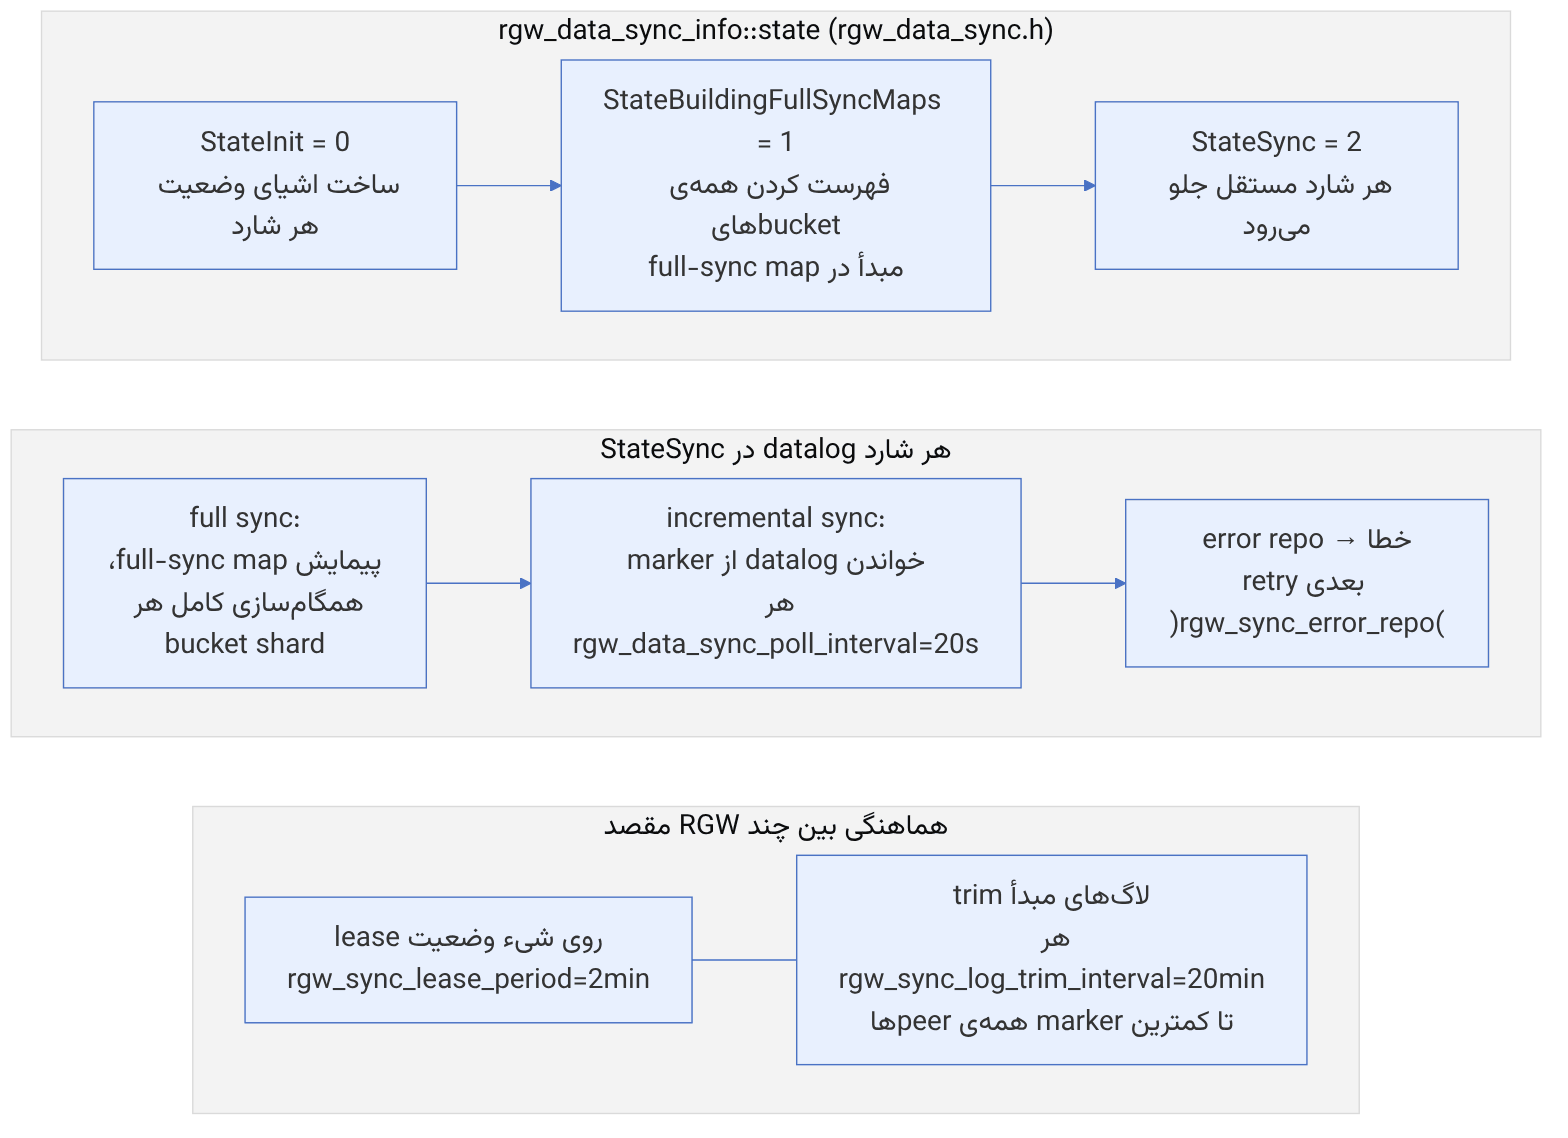
pseudocode: یک شارد datalog در zone مقصد (خلاصهی این کتاب از rgw_data_sync.cc)
loop:
acquire lease(shard, rgw_sync_lease_period) # 2min؛ فقط یک RGW
if shard.state == full_sync:
for bucket_shard in full_sync_map[shard] from marker:
run bucket sync (full) ; persist marker
shard.state = incremental
else:
entries = remote.list_datalog(shard, after=marker)
for e in entries (dedup by bucket_shard):
spawn bucket_incremental_sync(e.bucket_shard) # حداکثر rgw_bucket_sync_spawn_window=20 همزمان
→ read remote bilog after bucket marker
→ for op in bilog: fetch_remote_obj / remove
persist marker ; if no entries: sleep rgw_data_sync_poll_interval (20s)
on error: add to error repo for retry| گزینه | پیشفرض | نکتهی SRE |
|---|---|---|
| rgw_run_sync_thread | true | روی RGWهای سمت کاربر میتوان false کرد تا sync فقط روی RGWهای مخصوص اجرا شود |
| rgw_data_sync_poll_interval | ۲۰ | حداقل تأخیر حالت آرام |
| rgw_meta_sync_poll_interval | ۲۰ | برای فراداده |
| rgw_bucket_sync_spawn_window | ۲۰ | موازیسازی bucket sync در هر شارد |
| rgw_sync_lease_period | ۲_min | اگر RGW بمیرد، شارد پس از انقضا به RGW دیگری میرسد |
| rgw_sync_log_trim_interval | ۲۰_min | peer عقبمانده جلوی trim را میگیرد و log pool رشد میکند |
یک zone مقصد خاموش یا عقبمانده جلوی trim لاگهای مبدأ را میگیرد، چون trim فقط تا کمترین marker پیش میرود. نتیجه رشد omap در pool log و هشدار LARGE_OMAP_OBJECTS است. zone حذفشده را حتماً از zonegroup هم حذف و period را commit کنید.
فرمانهای بررسی:
radosgw-admin sync status
radosgw-admin data sync status --source-zone=us-east --shard-id=7
radosgw-admin bucket sync status --bucket=photos
radosgw-admin sync error list | jq '.[0].entries[:5]'
radosgw-admin datalog status ; radosgw-admin mdlog status
radosgw-admin bilog list --bucket=photos --max-entries=5۵-۹ multisite با عدد: shardهای datalog و mdlog، پنجرهی ادغام و trim#
این بخش چهار تابع کوچک را بررسی میکند که بار و تأخیر همگامسازی multisite را تعیین میکنند. ارجاعها به کد main در نوامبر ۲۰۲۶ است. عددها با بازپیادهسازی پایتونی ceph_str_hash_linux (از src/common/ceph_hash.cc) حساب شدهاند. نکتهی «بیتهای پایین hash» در زیر نتیجهی تحلیل و شبیهسازی خود ما است، نه گزارهای از مستندات Ceph.
۵-۹-۱ کدام shard از datalog؟#
منبع در کد: src/rgw/driver/rados/rgw_datalog.cc :: RGWDataChangesLog::choose_oid
پیچیدگی: O(طول نام bucket)
pseudocode
shift = max(bucket_shard_id, 0)
index = (ceph_str_hash_linux(bucket.name) + shift) mod rgw_data_log_num_shards # پیشفرض 128
# بدون XOR و بدون عدد اول؛ shardهای یک bucket روی shardهای پشتسرهم datalog میافتندمثال عددی. hash نام photos برابر ۳۴۸۴۷۹۹۲۶۳ است و ۳۴۸۴۷۹۹۲۶۳ mod 128 = ۳۱. اگر bucket ۱۱ shard ایندکس داشته باشد، تغییرات آن در shardهای ۳۱ تا ۴۱ از datalog ثبت میشوند. این پخش عمدی است و Casey Bodley در طراحی reshard چندسایتی آن را «خاصیت مهم مقیاسپذیری» نامیده است، چون چند RGW مقصد میتوانند بار یک bucket پرتغییر را بین خود تقسیم کنند (هر shard datalog با lease دودقیقهای فقط در اختیار یک RGW است).
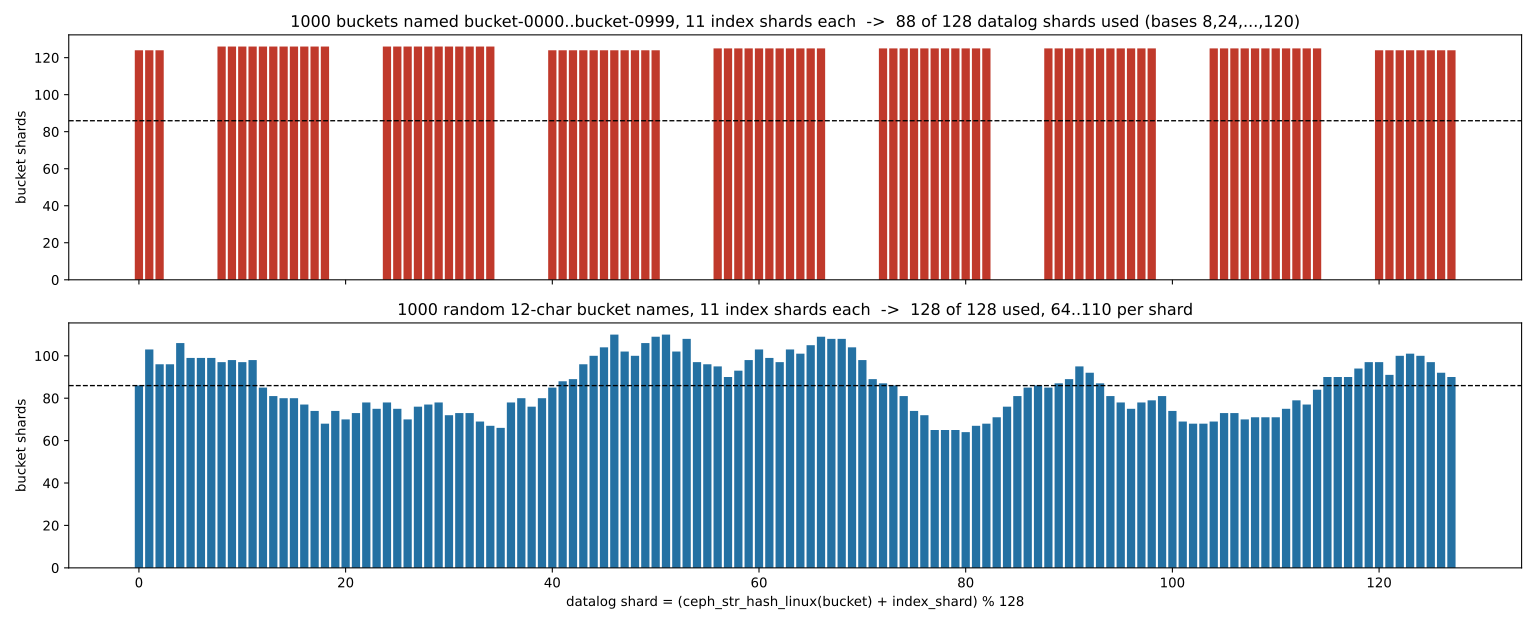
نکتهی بیتهای پایین. در هر گام hash، مقدار c<<4 مضرب ۱۶ است. پس hash mod 16 فقط به نیبل بالای نویسهها بستگی دارد (برای همهی رقمهای ASCII برابر ۳، برای a تا o برابر ۶ و برای p تا z برابر ۷). بنابراین همهی نامهای همطولی که فقط در رقمها با هم فرق دارند، hash mod 16 یکسانی دارند. برای ۱۰۰۰ bucket با نامهای bucket-0000 تا bucket-0999، hash mod 16 همیشه ۸ است و فقط ۸ مقدار پایه (۸، ۲۴، …، ۱۲۰) از ۱۲۸ ممکن است. با ۱۱ shard برای هر bucket، فقط ۸۸ shard از ۱۲۸ shard datalog کار دارند و ۴۰ shard همیشه خالی میمانند. همین تعداد bucket با نام تصادفی ۱۲ نویسهای هر ۱۲۸ shard را پر میکند. ایندکس bucket این مشکل را ندارد، چون پیش از mod، بایت پایین را با XOR به بالا میبرد و بر عدد اول ۷۸۷۷ تقسیم میکند. این نکته روی درستی همگامسازی اثری ندارد. فقط موازیسازی و پخش بار بین RGWهای مقصد را کم میکند.
۵-۹-۲ پنجرهی ادغام datalog#
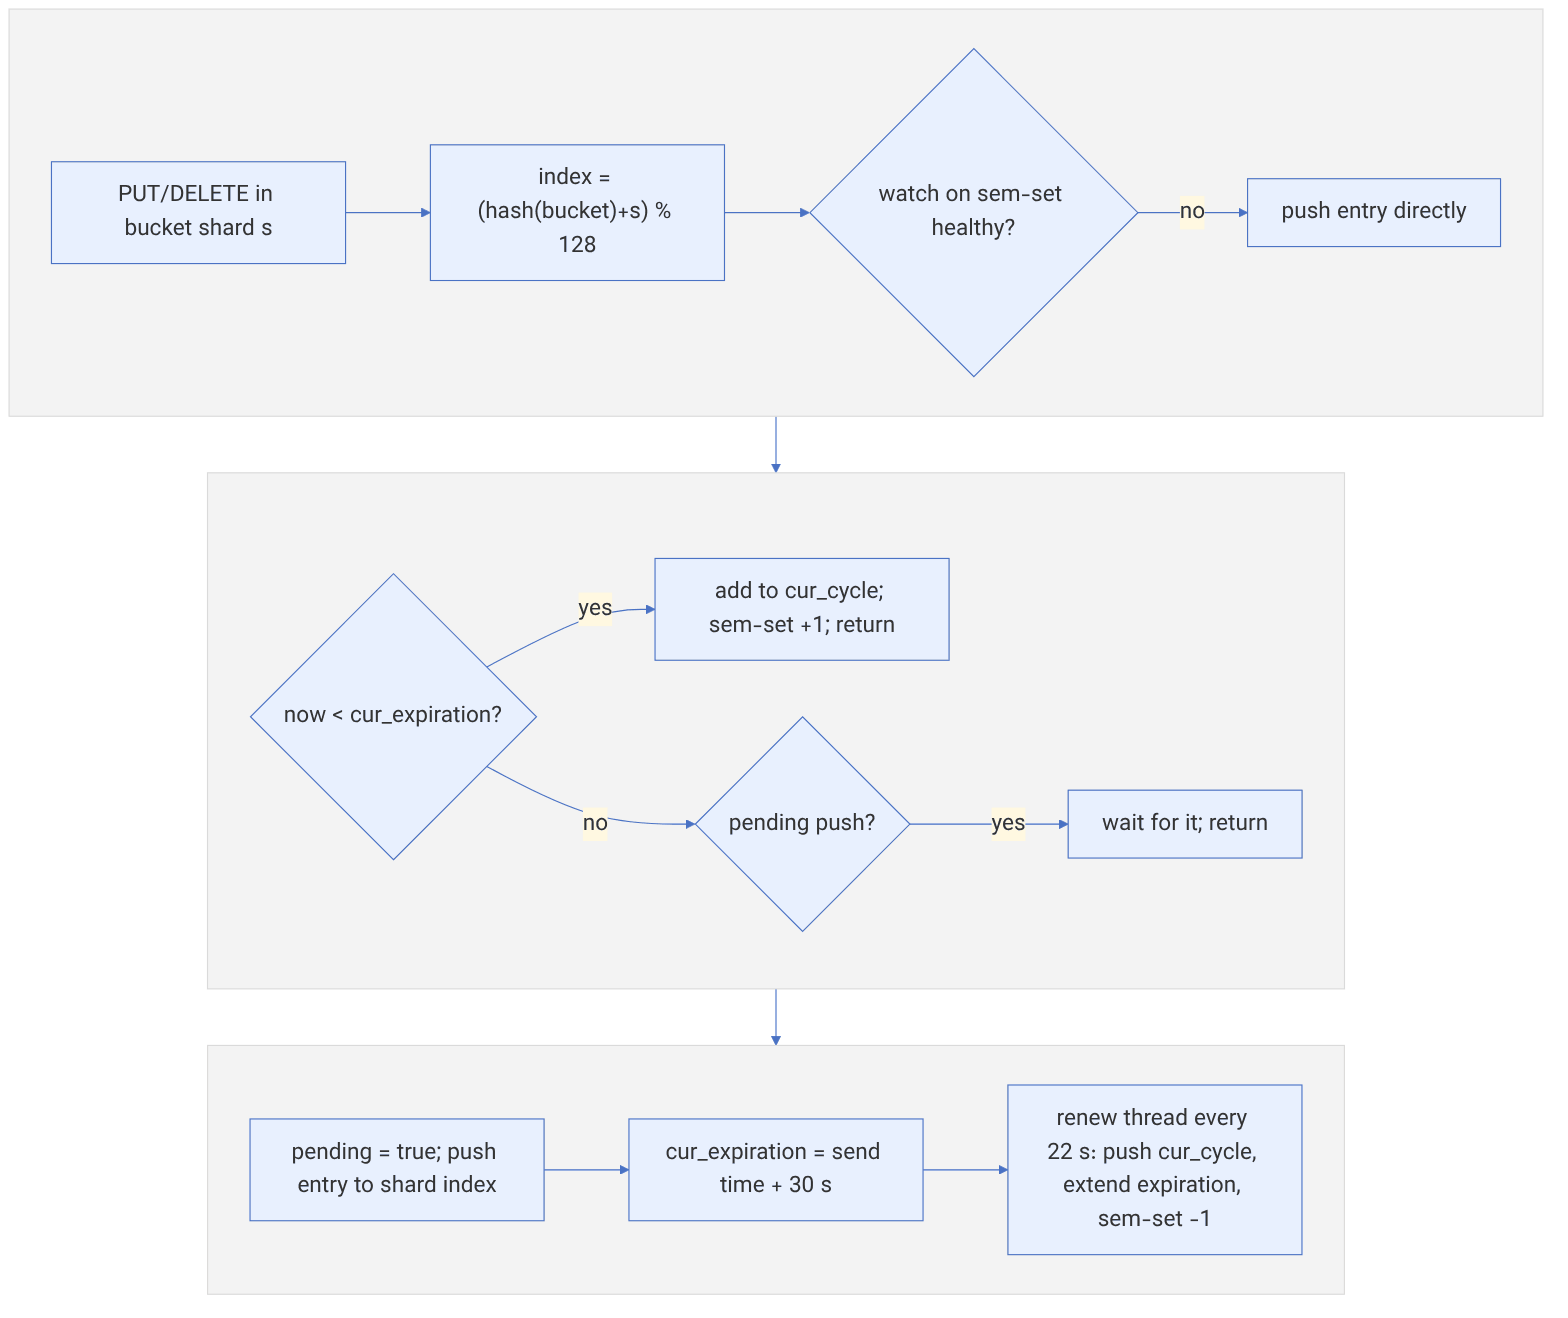
منبع در کد: src/rgw/driver/rados/rgw_datalog.cc :: RGWDataChangesLog::add_entry، renew_entries، renew_run
پیچیدگی: O(۱) برای هر نوشتن و O(تعداد bucket shard فعال) برای هر renew
pseudocode
add_entry(bs):
if watch روی sem-set سالم نیست: push(entry) ; return # مسیر ایمن، بدون بهینهسازی
status = change_status[bs]
if now < status.cur_expiration: # در 30 ثانیهی اخیر ثبت شده
cur_cycle.add(bs) ; sem_set[index] += key ; return
if status.pending: منتظر push جاری بمان ; return
status.pending = true ; sent = now
push(entry{key=bs, gen, timestamp=now})
status.cur_expiration = sent + rgw_data_log_window # از زمان شروع، نه پایان
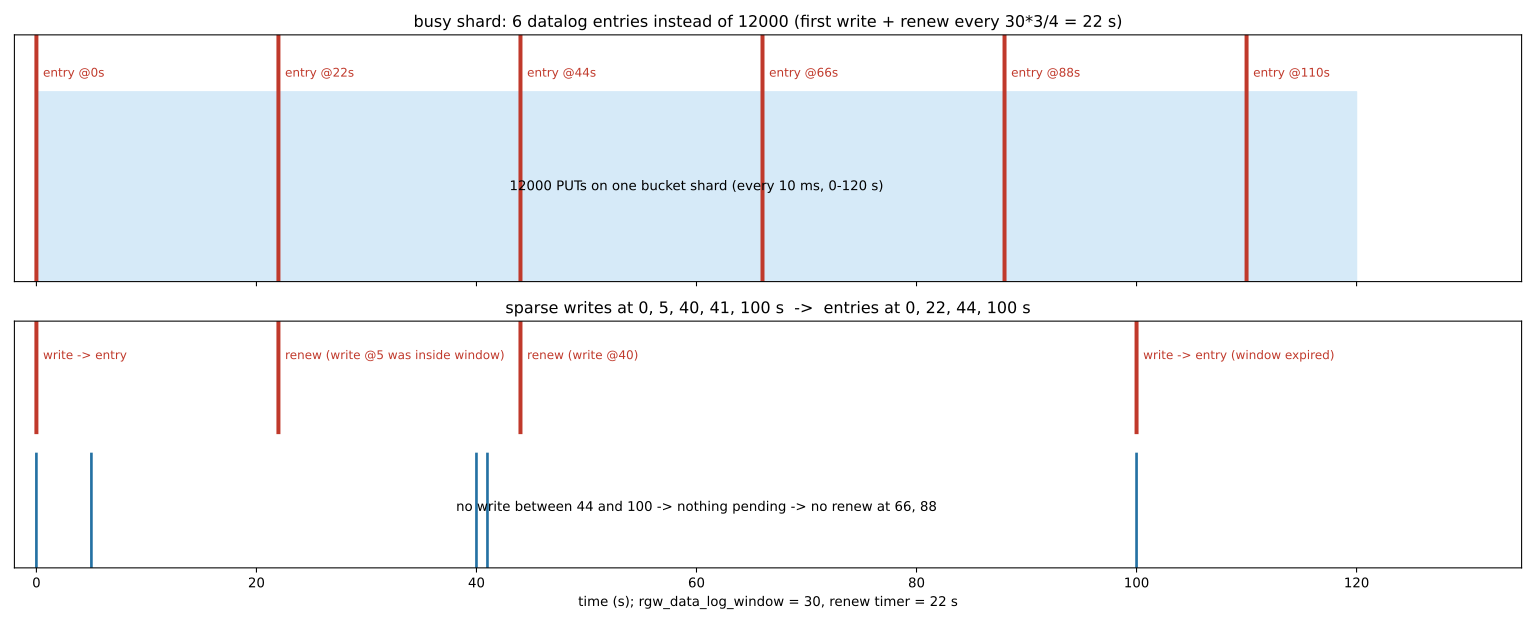
renew_run: هر window × 3/4 ثانیه (با 30 → 22 ثانیه، تقسیم صحیح)
برای هر bs در cur_cycle: push(entry) ; cur_expiration = now + window ; sem_set −= keyمثال عددی. فرض کنید از ثانیهی ۰ تا ۱۲۰ هر ۱۰ میلیثانیه یک PUT روی یک bucket shard انجام شود (۱۲۰۰۰ نوشتن). ورودیهای datalog فقط در ثانیههای ۰، ۲۲، ۴۴، ۶۶، ۸۸ و ۱۱۰ ثبت میشوند: شش ورودی به جای ۱۲۰۰۰. اگر نوشتنها پراکنده باشند (ثانیههای ۰، ۵، ۴۰، ۴۱ و ۱۰۰)، ورودیها در ۰، ۲۲ (renew برای نوشتن ثانیهی ۵)، ۴۴ (renew برای ۴۰ و ۴۱) و ۱۰۰ ثبت میشوند. چون بین ۴۴ و ۱۰۰ نوشتنی نیست، چیزی برای renew در ۶۶ و ۸۸ نمانده است. هر ورودی datalog فقط یعنی «این bucket shard را دوباره نگاه کن». جزئیات تغییر در bilog هست و مقصد آن را میخواند. پس ادغام چیزی را گم نمیکند، فقط حداکثر حدود یک پنجره به تأخیر کشف تغییر اضافه میکند. مجموعهی شمارندهی sem-set و مسیر «watch سالم نیست» در کد main وجود دارند و هدفشان این است که اگر RGW پیش از renew بمیرد، کلیدهای در انتظار گم نشوند. نسخههای قدیمیتر این سازوکار را نداشتند. پیش از تکیه بر آن، کد نسخهی خود را بررسی کنید.
۵-۹-۳ کدام shard از mdlog؟#
منبع در کد: src/rgw/driver/rados/rgw_sal_rados.cc (hash_key = section + ":" + key)؛ src/rgw/driver/rados/rgw_metadata.cc :: rgw_shard_name، RGWMetadataLog::add_entry
پیچیدگی: O(طول کلید)
pseudocode
hash_key = section + ":" + key # مثلاً "user:alice" یا "bucket:photos"
shard = ceph_str_hash_linux(hash_key) mod rgw_md_log_max_shards # پیشفرض 64
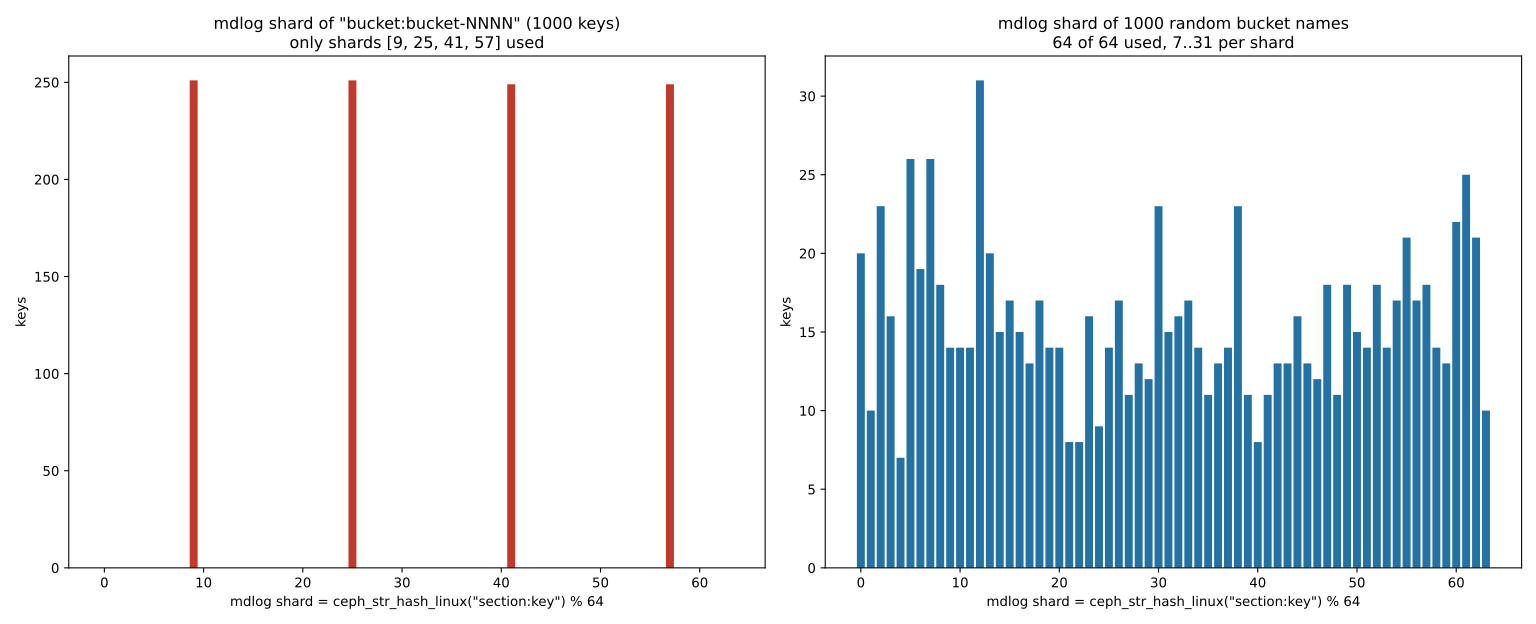
oid = "meta.log." + period_id + "." + shardمثال عددی. user:alice به shard ۵۲ میرود، bucket:photos به ۵۰ و bucket.instance:photos:a1b2c3d4.4567.1 به ۲۸. mdlog را فقط master zone تولید میکند و هر period لاگ خودش را دارد. همان نکتهی بیتهای پایین اینجا شدیدتر است، چون ۶۴ هم توان ۲ است و جابهجایی shard هم وجود ندارد. ۱۰۰۰ کلید bucket:bucket-0000 تا bucket:bucket-0999 فقط در ۴ shard (۹، ۲۵، ۴۱ و ۵۷) مینشینند، هر کدام حدود ۲۵۰ کلید. در عمل نتیجه این است که meta sync اولیهی چنین نامهایی روی ۴ shard متمرکز میشود، به جای اینکه بین ۶۴ shard پخش شود.
۵-۹-۴ trim لاگها: کمینهی markerها روی همهی peerها#
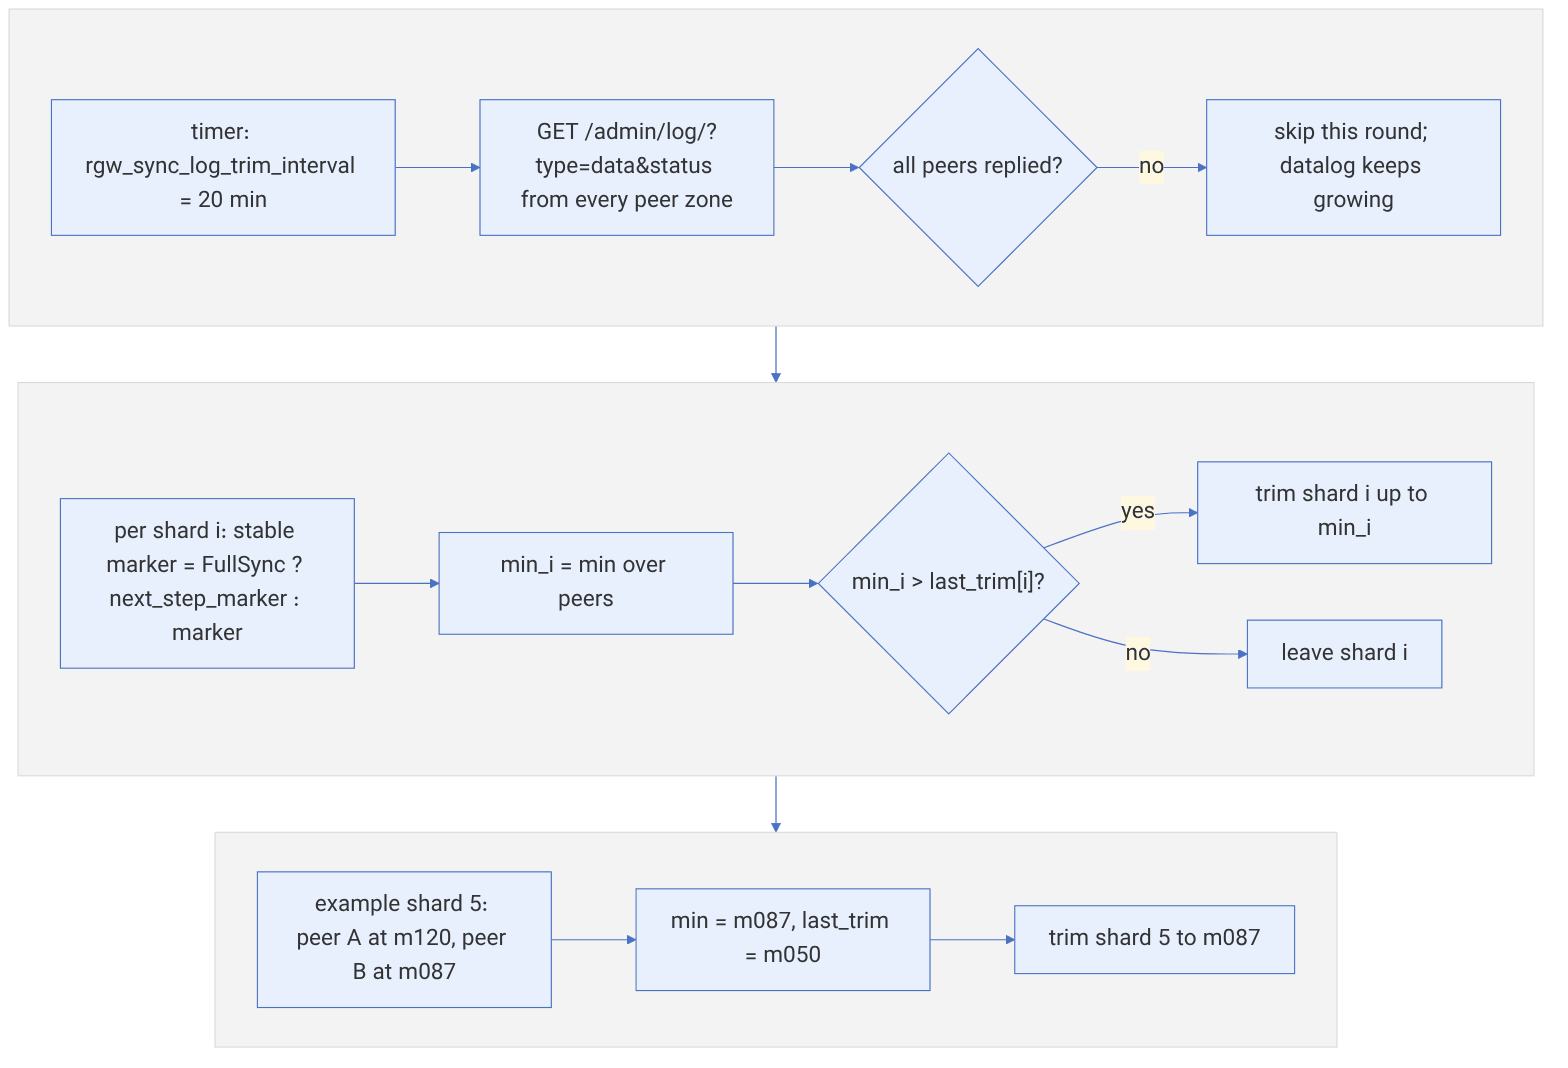
منبع در کد: src/rgw/driver/rados/rgw_trim_datalog.cc :: DataLogTrimCR، take_min_markers، get_stable_marker
پیچیدگی: O(peers × shards)
pseudocode
هر rgw_sync_log_trim_interval (20 دقیقه):
    status[p] = REST GET /admin/log/?type=data&status از هر peer
    اگر حتی یک peer پاسخ ندهد: این دور trim نکن
    for shard i:
        stable(p) = state == FullSync ? next_step_marker : marker
        min_i = min_p stable(p)
        if min_i > last_trim[i]: trim(shard i, up to min_i) ; last_trim[i] = min_i
مثال نمادین. فرض کنید در shard ۵، peer A تا marker m120 و peer B (که هنوز در full sync است) تا next_step_marker برابر m087 جلو رفتهاند و trim قبلی تا m050 بوده است. پس shard ۵ تا m087 کوتاه میشود. ورودیهای m088 تا m120 میمانند تا B هم به آنها برسد. markerهای واقعی به نوع backend (cls_log یا FIFO) بستگی دارند و m120 فقط نماد است. پیامد عملی این است که «همهی peerها باید پاسخ دهند». اگر یک zone مدت طولانی از دسترس خارج باشد، datalog و bilogهای zone مبدأ کوتاه نمیشوند و pool لاگ رشد میکند. پیش از حذف دائمی یک zone، آن را از zonegroup بیرون بیاورید و period را commit کنید.
۵-۱۰ failover و failback#
۵-۱۰-۱ وقتی master zone از دسترس خارج میشود#
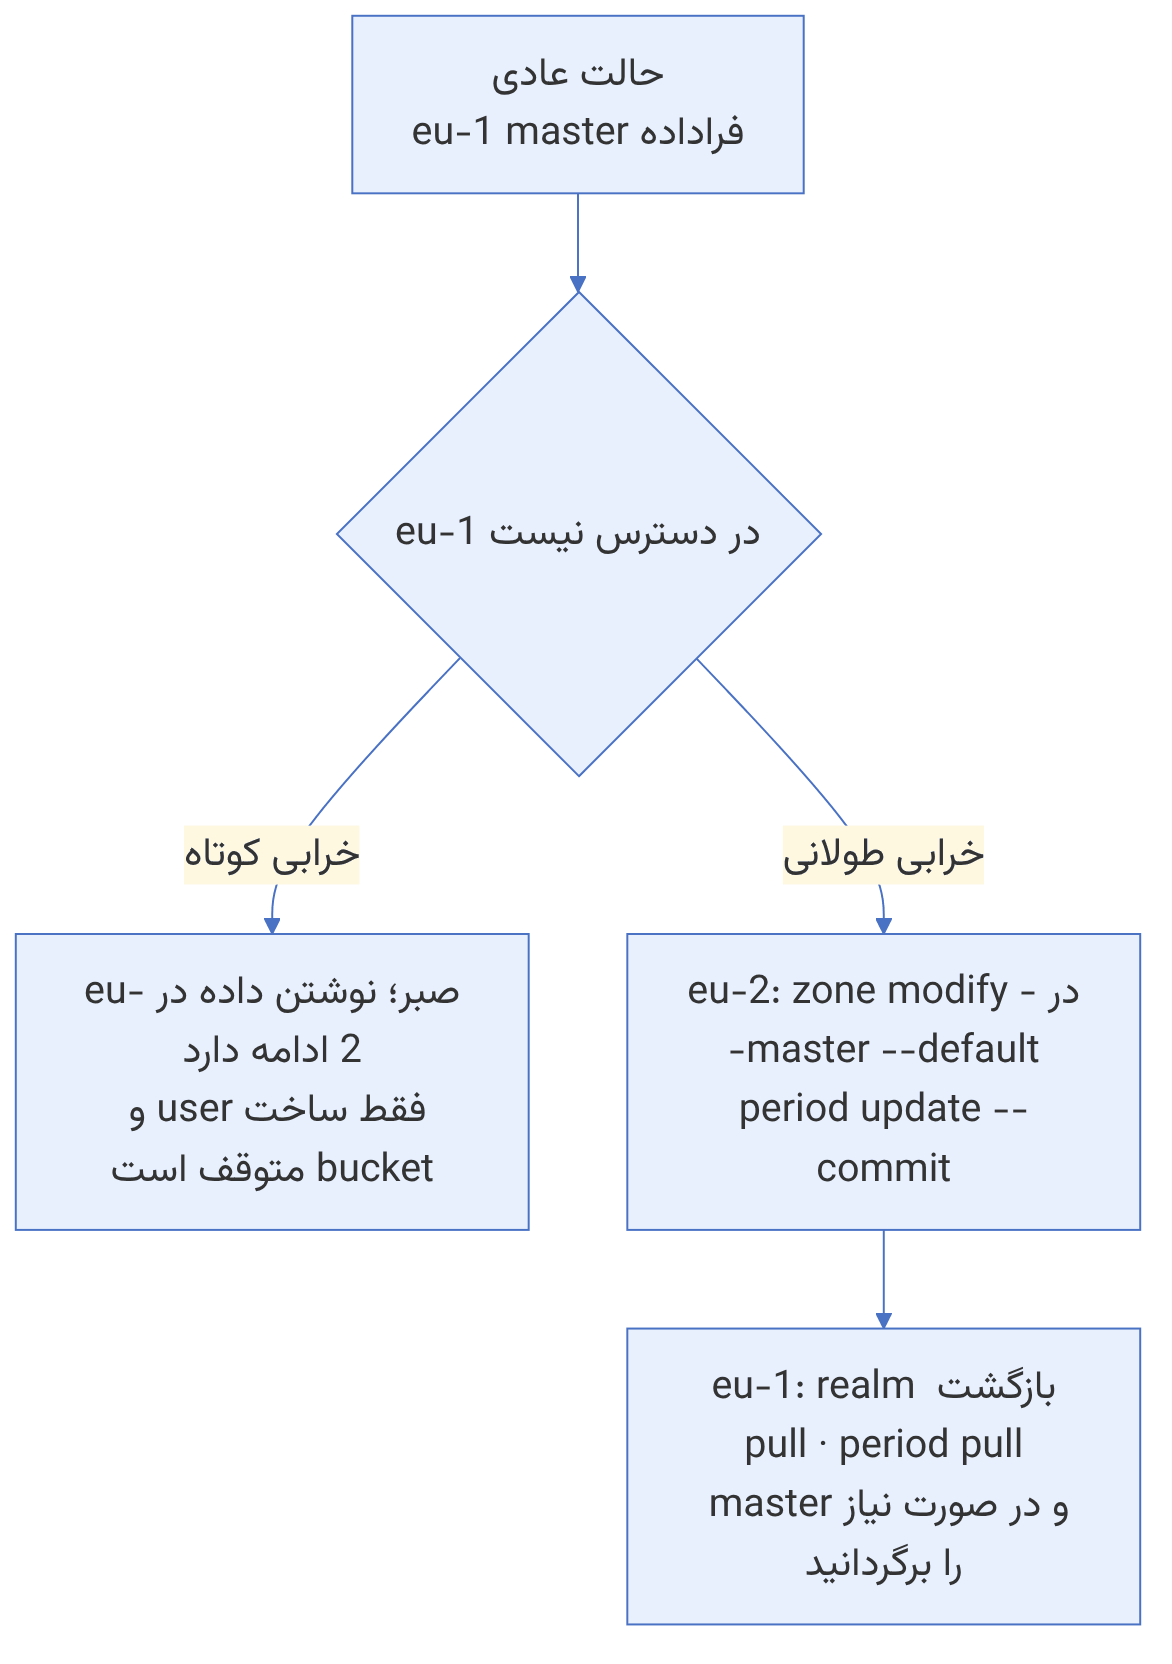
در خرابی master zone، zoneهای دیگر همچنان داده را میپذیرند و سرویس S3 برای bucketهای موجود ادامه دارد. اما عملیات فرادادهای که به master نیاز دارند (ساخت کاربر یا bucket، تغییر سیاست) با خطا مواجه میشوند. اگر خرابی طولانی است، zone ثانوی را master کنید:
# روی کلاستر eu-2
radosgw-admin zone modify --rgw-zone=eu-2 --master --default
radosgw-admin period update --commit
ceph orch restart rgw.gold-eu2
۵-۱۰-۲ بازگشت master قدیمی#
وقتی eu-1 برگشت، باید period جدید را از master فعلی بگیرد تا بفهمد دیگر master نیست:
# روی کلاستر eu-1
radosgw-admin realm pull --url=http://rgw-eu2.example.com:80 --access-key=<AK> --secret=<SK>
radosgw-admin period pull --url=http://rgw-eu2.example.com:80 --access-key=<AK> --secret=<SK>
ceph orch restart rgw.gold-eu1
radosgw-admin sync status
# اگر میخواهید master را برگردانید، پس از همگام شدن:
radosgw-admin zone modify --rgw-zone=eu-1 --master --default
radosgw-admin period update --commitاگر هر دو zone همزمان خودشان را master بدانند (مثلاً به دلیل قطع شبکه بین سایتها و ارتقای عجولانه)، دو تاریخچهی period متفاوت ساخته میشود. پیش از ارتقای zone ثانوی، مطمئن شوید master قدیمی واقعاً از دسترس خارج است یا RGWهایش متوقف شدهاند، و پس از بازگشت آن قبل از هر تغییری period را pull کنید.
۵-۱۰-۳ یک runbook حداقلی#
- ۱. تأیید خرابی master از دو مسیر مستقل (پایش و تماس با تیم سایت).
- ۲. اعلام وضعیت و توقف تغییرات فرادادهای غیرضروری.
- ۳. ارتقای zone ثانوی به master و commit period.
- ۴. بهروزرسانی DNS یا GSLB تا کلاینتها به endpoint سالم بروند.
- ۵. پس از بازگشت سایت اصلی: pull period، بررسی
sync status تا caught up، و تصمیم دربارهی بازگرداندن master. - ۶. ثبت زمانها و درسها در لاگ حادثه.
۵-۱۱ sync policy: کنترل دقیق همگامسازی#
از Octopus، sync policy امکان میدهد بهجای «همهی bucketها در همهی zoneها»، تعیین کنید چه چیزی از کجا به کجا برود. سیاستها در قالب گروه، flow (جریان بین zoneها) و pipe (کدام bucketها) تعریف میشوند و در سطح zonegroup یا bucket اعمال میشوند.
# همهی bucketها بهطور پیشفرض «مجاز» اما غیرفعال
radosgw-admin sync group create --group-id=global --status=allowed
radosgw-admin sync group flow create --group-id=global --flow-id=eu-mesh \
--flow-type=symmetrical --zones=eu-1,eu-2
radosgw-admin sync group pipe create --group-id=global --pipe-id=all \
--source-zones='*' --source-bucket='*' --dest-zones='*' --dest-bucket='*'
radosgw-admin period update --commit
# فعال کردن همگامسازی فقط برای یک bucket
radosgw-admin sync group create --bucket=critical-data --group-id=critical --status=enabled
radosgw-admin sync group pipe create --bucket=critical-data --group-id=critical \
--pipe-id=p1 --source-zones='*' --dest-zones='*'
radosgw-admin sync info --bucket=critical-data| وضعیت گروه | معنا |
|---|---|
| enabled | همگامسازی انجام میشود |
| allowed | مجاز است اما فقط اگر سیاست سطح پایینتر (bucket) فعالش کند |
| forbidden | ممنوع؛ سیاستهای سطح bucket هم نمیتوانند فعالش کنند |
یک الگوی رایج: در سطح zonegroup وضعیت allowed و در سطح bucket فقط برای bucketهای حساس enabled. این کار پهنای باند بینسایتی را برای bucketهای موقت یا قابل بازتولید هدر نمیدهد.
۵-۱۲ archive zone#
archive zone یک zone ویژه است که همهی نسخههای همهی اشیاء را نگه میدارد، حتی اگر در zoneهای دیگر حذف یا بازنویسی شوند. bucketها در archive zone خودکار versioning دارند. این راهی برای حفاظت در برابر حذف تصادفی یا مخرب بدون تحمیل versioning به کاربران است.
radosgw-admin zone create --rgw-zonegroup=europe --rgw-zone=eu-archive \
  --endpoints=http://rgw-arc.example.com:80 --tier-type=archive \
  --access-key=<AK> --secret=<SK>
radosgw-admin period update --commit۵-۱۳ resharding در multisite#
پیش از Reef، resharding پویا در multisite پشتیبانی نمیشد و reshard دستی هم همگامسازی bucket را مختل میکرد. از Reef، zonegroup feature به نام resharding این امکان را میدهد که هر zone مستقل bucketهایش را reshard کند بدون قطع تکثیر. طبق مستندات zone features، این قابلیت فقط وقتی باید فعال شود که همهی zoneها به نسخهی پشتیبان ارتقا یافته باشند:
radosgw-admin zonegroup modify --rgw-zonegroup=europe --enable-feature=resharding
radosgw-admin period update --commit
radosgw-admin sync status | grep features۵-۱۴ کارایی و طراحی#
- RGW اختصاصی همگامسازی: با گزینهی
rgw_run_sync_thread میتوانید همگامسازی را روی نمونههای خاصی اجرا کنید و نمونههای رو به کاربر را از بار آن آزاد کنید. endpointهای zone را روی نمونههای همگامساز (یا load balancer آنها) تنظیم کنید. - pool لاگ سریع: datalog و bilog در pool لاگ نوشته میشوند؛ این pool را روی SSD بگذارید.
- تعداد shardهای datalog: پیشفرض ۱۲۸ است و موازیسازی همگامسازی داده را تعیین میکند.
- پایش عقبماندگی: صادرکنندهی Prometheus در MGR و آمار perf کلاینت RGW معیارهای همگامسازی دارند. یک هشدار بر اساس «قدیمیترین تغییر اعمالنشده» تعریف کنید.
- ظرفیت لاگ: اگر یک zone مدتی طولانی قطع باشد، لاگهای تغییرات در zone دیگر انباشته میشوند. trim خودکار لاگها فقط وقتی انجام میشود که همهی zoneها آن تغییرات را دریافت کرده باشند.
RPO در multisite ثابت نیست؛ به نرخ تغییر، پهنای باند، تأخیر و تعداد اشیای کوچک بستگی دارد. اشیای کوچک بسیار زیاد (مثلاً میلیونها فایل چندکیلوبایتی) گلوگاه CPU و درخواستاند، نه پهنای باند. برای برآورد واقعی، با بار نمونهی خودتان آزمون کنید و «oldest incremental change not applied» را در اوج بار بسنجید.
۵-۱۵ تکمیلی و بهروز#
- خودکارسازی با
ceph rgw و wizard داشبورد (Tentacle) راهاندازی را به چند دقیقه رسانده است. - zone features: علاوه بر
resharding، قابلیتهایی مثل compress-encrypted (Reef) و notification_v2 (Squid) با سازوکار zone feature بهصورت هماهنگ در همهی zoneها فعال میشوند. - OIDC در multisite: در Umbrella پشتیبانی از OIDC در محیط چندسایتی اضافه شده است.
- اصلاحهای درستی همگامسازی: یادداشتهای Umbrella اصلاحهای متعددی را فهرست میکنند، از جمله حلقهی بیپایان full sync، خطای segfault هنگام راهاندازی، درخواستهای forwardشده با UNSIGNED-PAYLOAD، قفلگذاری full sync در سطح bucket و تغییر نام zonegroup. اگر روی نسخههای قدیمیتر مشکلات همگامسازی دارید، ارتقا را جدی بگیرید.
- cloud sync module: یک zone با
--tier-type=cloud میتواند داده را به یک سرویس S3 بیرونی تکثیر کند.
۵-۱۶ جمعبندی و مرور#
۵-۱۶-۱ خلاصهی فصل#
- realm فضای نام سراسری است؛ zonegroup واحد تکثیر داده؛ zone یک کلاستر؛ period نسخهی پیکربندی.
- فراداده از master zone پخش میشود؛ داده بین zoneهای یک zonegroup بهصورت ناهمگام و active-active تکثیر میشود.
- multisite نسخهی ۲ همگامسازی را درون radosgw برده و agent قدیمی Hammer را حذف کرده است.
- راهاندازی دستی با
radosgw-admin یا خودکار با ceph rgw realm bootstrap و ceph rgw zone create. -
sync status، bucket sync status و sync error list ابزارهای اصلی پایشاند. - failover یعنی master کردن zone دیگر و commit period؛ پس از بازگشت، period را pull کنید.
- sync policy، archive zone و zone feature
resharding multisite را منعطفتر کردهاند.
۵-۱۶-۲ اشتباهات رایج#
- endpointهایی که فقط از یک سایت قابلدسترسیاند.
- ساختن zone جدید بهجای تغییر نام zone پیشفرض دارای داده.
- نگه داشتن کلید کاربر system در اسکریپتها و مخازن.
- ارتقای عجولانهی zone ثانوی به master در قطع شبکهی موقت.
- فعال کردن zone feature پیش از ارتقای همهی zoneها.
- نادیده گرفتن عقبماندگی تا وقتی کاربران گزارش دهند.
۵-۱۶-۳ تمرین عملی#
- ۱. دو کلاستر تکنودی بسازید و multisite را یکبار دستی و یکبار با
ceph rgw realm bootstrap راه بیندازید. زمان و تعداد گامها را مقایسه کنید. - ۲. هزار شیء در zone اصلی بنویسید و با
sync status و bucket sync status روند همگامسازی را ثبت کنید. - ۳. RGWهای zone اصلی را متوقف کنید، در zone ثانوی شیء بنویسید و ساخت bucket را امتحان کنید. پیام خطا را توضیح دهید. سپس failover کامل انجام دهید.
- ۴. یک sync policy بسازید که فقط bucketی با نام
critical-* همگام شود و نشان دهید bucketهای دیگر همگام نمیشوند. - ۵. یک archive zone اضافه کنید، شیئی را در zone اصلی حذف کنید و نسخهی آن را در archive zone پیدا کنید.
۵-۱۶-۴ پرسشهای مرور#
- ۱. تفاوت نقش zonegroup و realm در تکثیر داده و فراداده چیست؟
- ۲. period چیست و چرا پس از تغییرات ساختاری باید commit شود؟
- ۳. سه تفاوت اصلی multisite نسخهی ۲ با پیکربندی federated در Hammer کداماند؟
- ۴. چرا ساخت bucket در zone غیر master هنگام از دست رفتن master شکست میخورد اما نوشتن شیء نه؟
- ۵. کاربر system چه نقشی دارد و چرا باید بهشدت حفاظت شود؟
- ۶. در خروجی
sync status عبارت «oldest incremental change not applied» چه اطلاعاتی میدهد؟ - ۷. گامهای failover و بازگرداندن master قدیمی را بنویسید.
- ۸. تفاوت وضعیتهای enabled، allowed و forbidden در sync policy چیست؟
- ۹. archive zone چه مشکلی را حل میکند؟
- ۱۰. چرا resharding پیش از Reef در multisite مشکلساز بود و امروز چطور حل شده است؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۵-۱۶-۵ منابع این فصل#
- مستندات Ceph — Multi-Site
https://docs.ceph.com/en/latest/radosgw/multisite/ - مستندات Ceph — Multisite Sync Policy
https://docs.ceph.com/en/latest/radosgw/multisite-sync-policy/ - مستندات Ceph — Zone Features
https://docs.ceph.com/en/latest/radosgw/zone-features/ - مستندات Ceph — ماژول rgw در MGR
https://docs.ceph.com/en/latest/mgr/rgw/ - مستندات Ceph — Archive Sync Module
https://docs.ceph.com/en/latest/radosgw/archive-sync-module/ - مستندات Ceph — Cloud Sync Module
https://docs.ceph.com/en/latest/radosgw/cloud-sync-module/ - مستندات cephadm — سرویس RGW در multisite
https://docs.ceph.com/en/latest/cephadm/services/rgw/ - یادداشتهای انتشار Umbrella (بخش Multisite
https://docs.ceph.com/en/latest/releases/umbrella/