سامانهی فایل Ceph (CephFS)
حوصله ندارم این فصل در چند خط
- CephFS متادیتا (درخت، inodeها و journal مربوط به MDS) را در pool متادیتا و محتوای فایلها را در pool داده نگه میدارد؛ کلاینت داده را مستقیم با OSDها میخواند و مینویسد.
- کلاینت محدود را با
ceph fs authorize بسازید؛ MDS با capabilityها (caps) به کلاینتها اجازه میدهد بدون قفل سراسری، cache منسجم داشته باشند. -
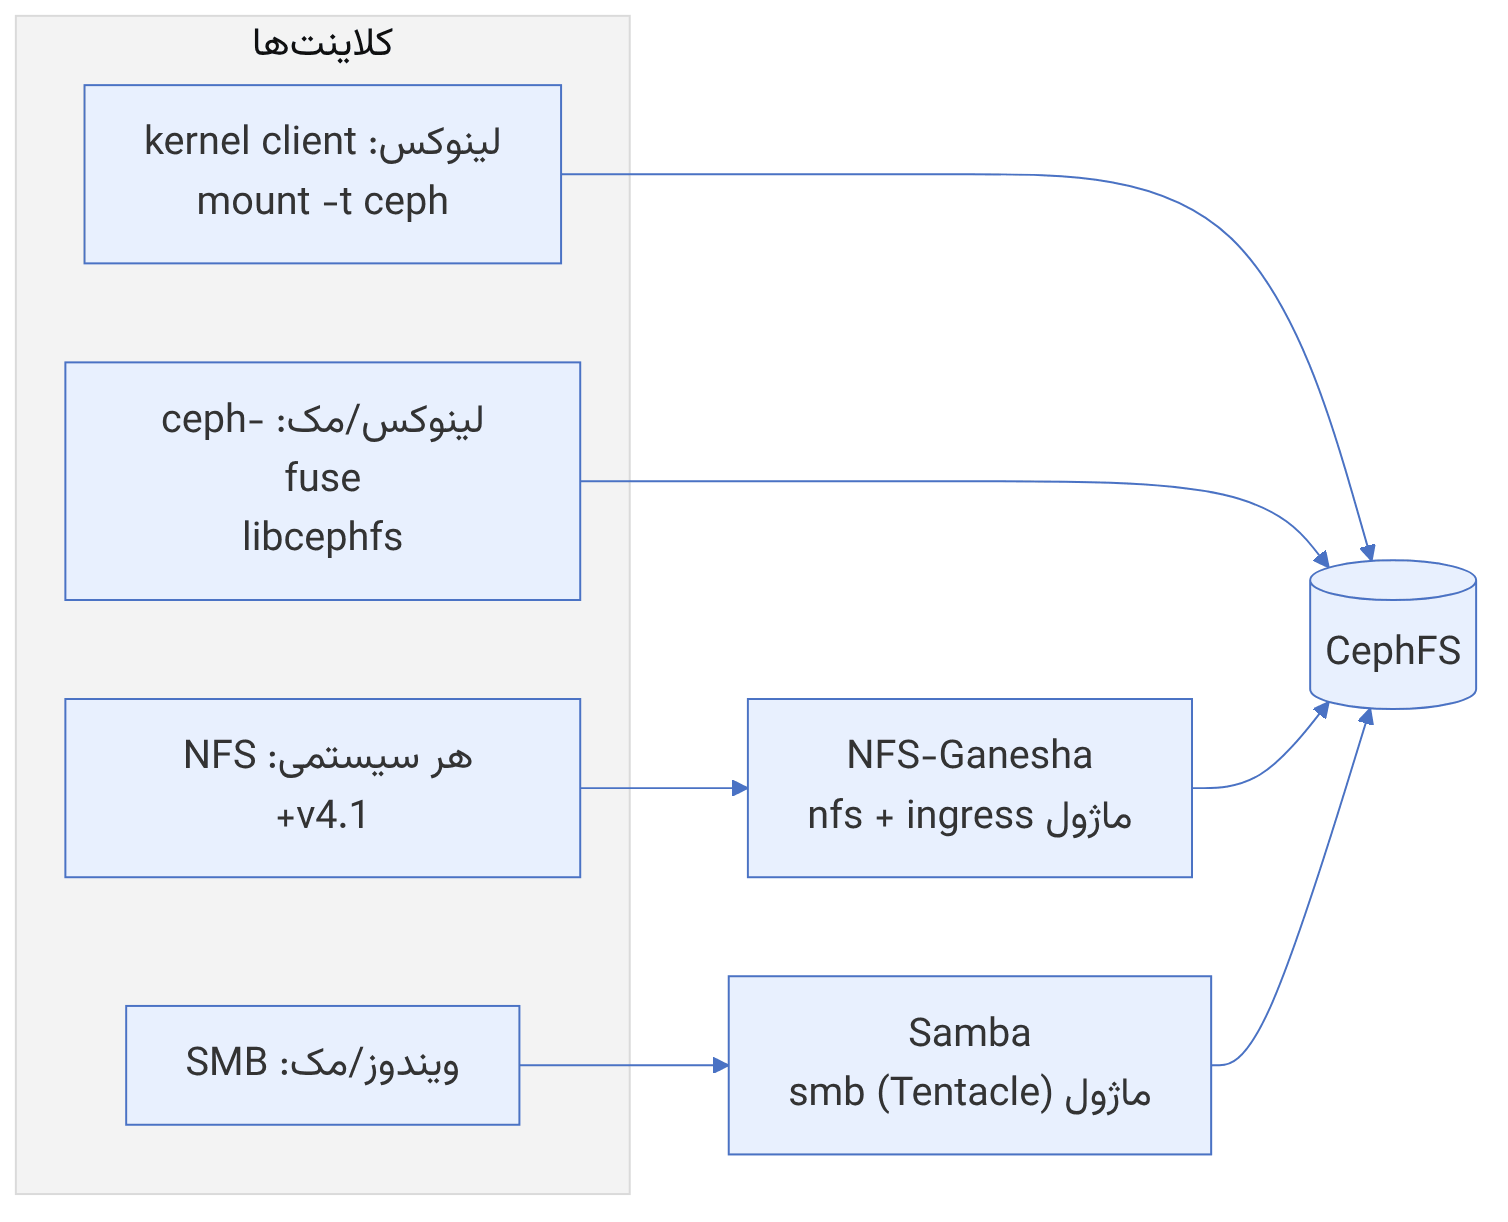
fs volumes برای Kubernetes و Manila، subvolume با quota و snapshot فراهم میکند؛ NFS-Ganesha و در Tentacle سرویس SMB به کلاینتهایی میرسند که نمیتوانند CephFS را mount کنند. - cephfs-mirror، snapshotها را به کلاستر دیگری میبرد؛ کلاینتی که mountش قفل شده معمولاً evict شده است، پس
dmesg را ببینید و دوباره mount کنید.
۶-۱ پیش از شروع#
۶-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
CephFS قدیمیترین هدف پروژهی Ceph بود (پایاننامهی Sage Weil دربارهی یک فایلسیستم توزیعشده بود) و در عین حال آخرین رابطی بود که به بلوغ production رسید؛ از نسخهی Jewel پایدار اعلام شد. امروز CephFS پشتوانهی اشتراکهای فایل در OpenStack Manila، volumeهای ReadWriteMany در Kubernetes، خانهی کاربران در خوشههای HPC و حتی اشتراکهای SMB برای کاربران ویندوز است. در این فصل:
- معماری CephFS چیست و MDS دقیقاً چه کاری انجام میدهد که OSD نمیکند؟
- چطور فایلسیستم بسازیم، MDSها را مستقر کنیم و دسترسپذیری بالا (standby و standby-replay) داشته باشیم؟
- با کلاینت هسته و FUSE چطور mount کنیم و کدام را کی انتخاب کنیم؟
- چطور CephFS را با NFS (و از Tentacle با SMB) صادر کنیم؟
- subvolume، snapshot، quota و layout چه هستند؟
- ادعای قدیمی «CephFS جایگزین HDFS» امروز چه وضعی دارد؟
۶-۱-۲ پیشنیاز#
کلاستر فصل ۱ و client-node1. اگر در فصل ۱ ceph fs volume create cephfs01 را اجرا کردهاید، یک فایلسیستم آماده دارید.
۶-۲ CephFS و MDS#
۶-۲-۱ معماری#
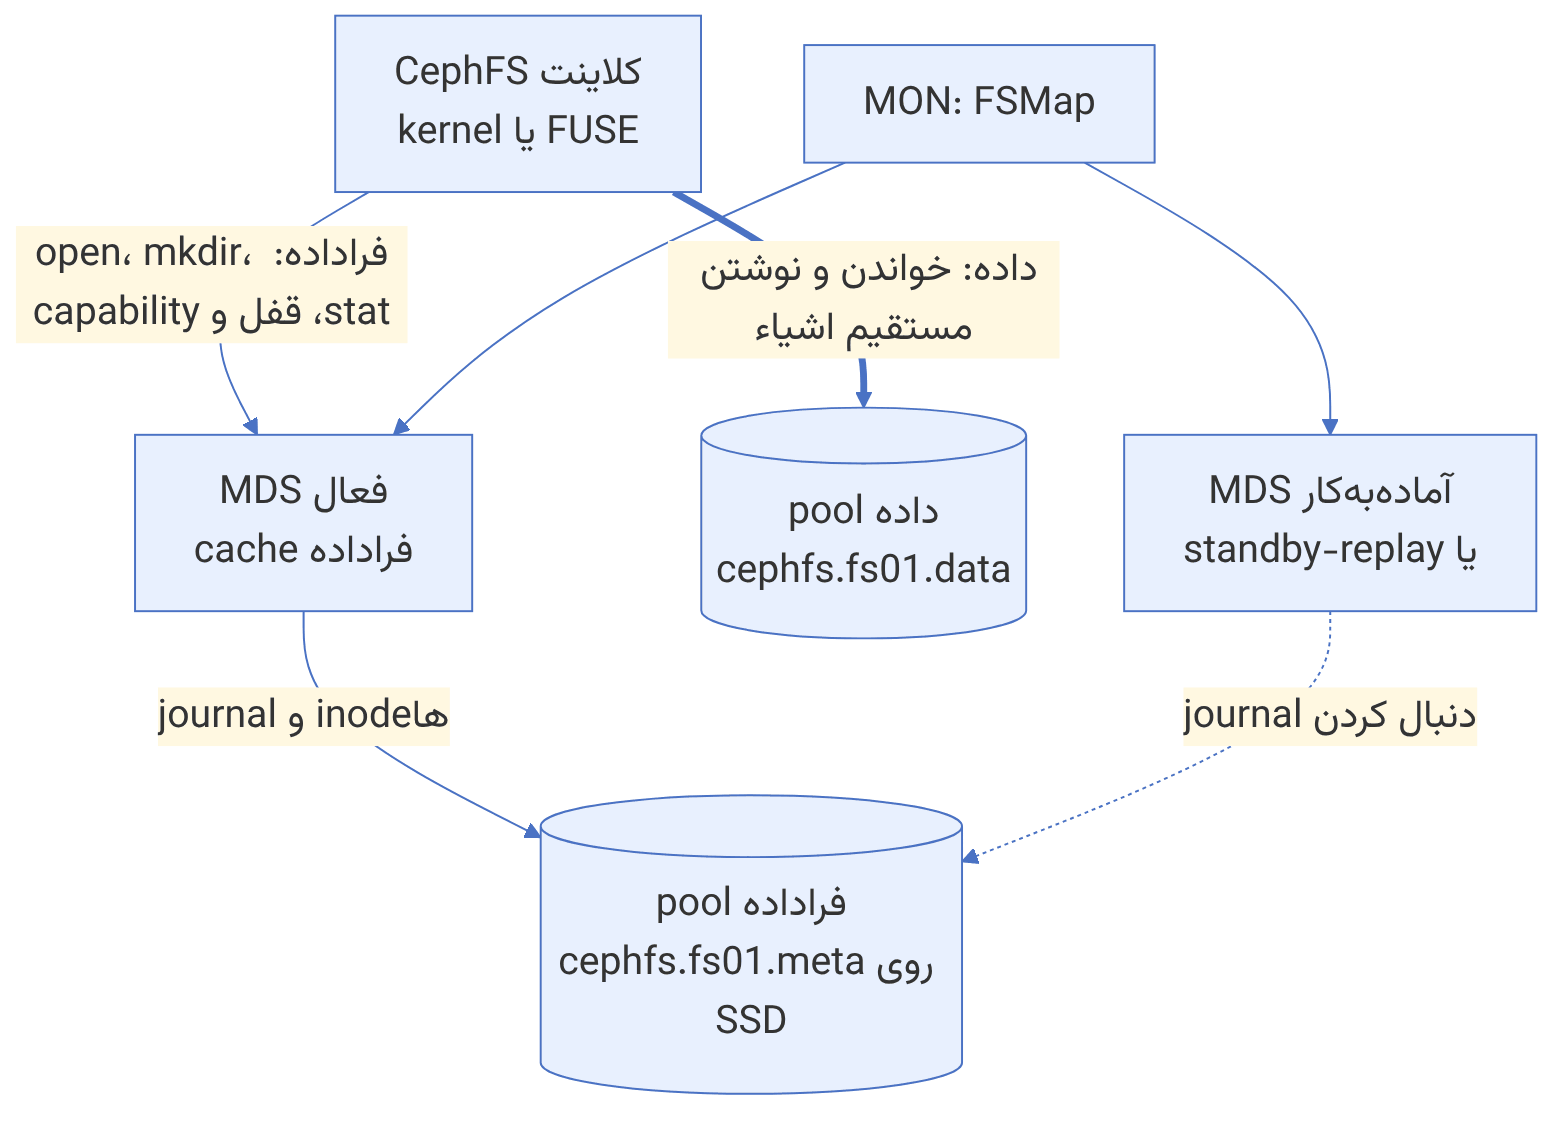
CephFS از دو pool استفاده میکند: یک pool فراداده (درخت پوشهها، inodeها و journal MDS) و یک یا چند pool داده (محتوای فایلها، شکسته به اشیای ۴ مگابایتی، مانند RBD). نکتهی کلیدی این طراحی جداسازی مسیر فراداده و داده است:
- کلاینت برای
open، mkdir، stat، rename و قفلها با MDS صحبت میکند. - پس از گرفتن مجوز، کلاینت داده را مستقیم با OSDها میخواند و مینویسد. MDS در مسیر داده نیست و گلوگاه پهنای باند نمیشود.
MDS خودش هیچ دادهای را روی دیسک محلی نگه نمیدارد. همهی وضعیت پایدارش در RADOS است: تغییرات فراداده اول در یک journal در pool فراداده نوشته میشوند و بعد به اشیای پوشهها (dirfrag) منتقل میشوند. این یعنی هر MDS آمادهبهکاری میتواند با بازپخش journal جای MDS خراب را بگیرد. حافظهی MDS عملاً یک cache بزرگ از فراداده است و اندازهی آن (mds_cache_memory_limit، پیشفرض ۴ گیگابایت) مهمترین تنظیم کارایی آن است.
۶-۲-۲ capability: هماهنگی cache بین کلاینتها#
CephFS سازگاری POSIX را جدی میگیرد: اگر یک کلاینت فایل را تغییر دهد، کلاینت دیگر باید فوراً تغییر را ببیند. این کار با capabilityها انجام میشود: MDS به هر کلاینت مجوزهای مشخصی (خواندن، نوشتن، cache کردن، buffer کردن) روی هر inode میدهد و در صورت نیاز آنها را پس میگیرد.
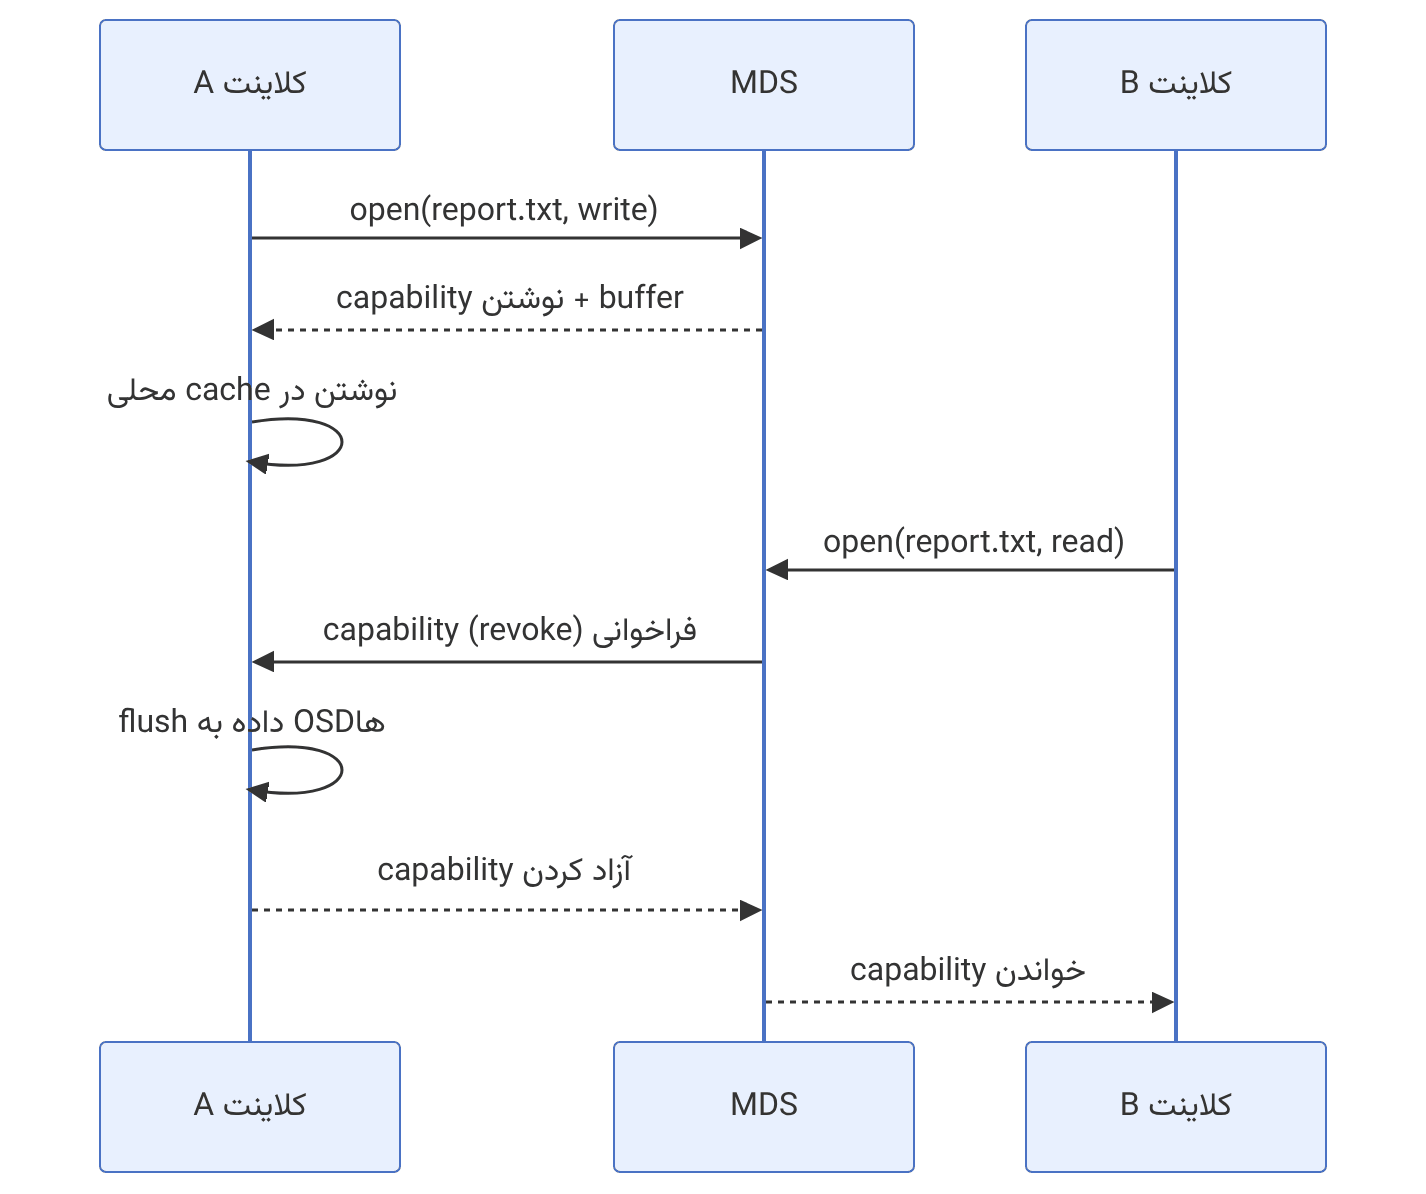
کلاینتی که capabilityها را آزاد نمیکند (مثلاً به دلیل قطع شبکه، باگ یا فرایند معلق) میتواند دسترسی بقیه را معطل کند. هشدارهایی مثل MDS_HEALTH_CLIENT_LATE_RELEASE و MDS_CLIENT_RECALL نشانهی همیناند. MDS پس از مهلت مشخص چنین کلاینتی را evict و در فهرست سیاه (blocklist) OSDها قرار میدهد تا نتواند دادهی کهنه بنویسد. کلاینت evictشده باید دوباره mount شود.
۶-۲-۳ ساختن فایلسیستم#
سادهترین راه با cephadm، رابط volumes در MGR است که poolها، فایلسیستم و MDSها را یکجا میسازد:
ceph fs volume create fs01 --placement="2 ceph-node3 ceph-node4"
ceph fs ls
ceph fs status fs01
ceph orch ps --daemon-type mds
روش دستی، وقتی کنترل کامل بر poolها لازم است:
ceph osd pool create cephfs.fs02.meta
ceph osd pool create cephfs.fs02.data
ceph osd pool set cephfs.fs02.meta crush_rule ssd-rule     # فراداده روی SSD
ceph fs new fs02 cephfs.fs02.meta cephfs.fs02.data
ceph orch apply mds fs02 --placement="2 ceph-node3 ceph-node4"pool فراداده کوچک است اما حساس به تأخیر؛ همیشه آن را تکثیری (نه EC) و روی SSD یا NVMe بگذارید. اگر میخواهید داده روی EC باشد، pool دادهی پیشفرض را تکثیری بسازید و pool EC را بهعنوان pool دادهی دوم اضافه کنید (ceph fs add_data_pool) و با layout پوشهها را به آن هدایت کنید. دلیلش این است که CephFS فرادادهی backtrace همهی فایلها را در pool دادهی پیشفرض نگه میدارد. pool EC هم باید allow_ec_overwrites داشته باشد.
۶-۲-۴ دسترسپذیری بالا#
| حالت | رفتار | زمان جایگزینی |
|---|---|---|
| standby | MDS بیکار که در صورت خرابی هر rank فعالی جایش را میگیرد | باید journal را از ابتدا بازپخش و cache را گرم کند؛ ثانیهها تا دقیقهها |
| standby-replay | MDS که journal یک rank مشخص را دائماً دنبال میکند | بسیار سریع؛ cache تقریباً گرم است |
ceph fs set fs01 allow_standby_replay true
ceph fs set fs01 standby_count_wanted 1
ceph fs status fs01هر rank فعال فقط میتواند یک standby-replay داشته باشد. اگر چند فایلسیستم دارید، MDSهای آمادهبهکار معمولی بین همهی آنها مشترکاند، مگر اینکه با mds_join_fs یک MDS را به فایلسیستم خاصی وابسته کنید.
۶-۲-۵ چند MDS فعال#
وقتی یک MDS دیگر جوابگوی بار فراداده نیست (مثلاً میلیونها فایل کوچک یا هزاران کلاینت)، میتوانید چند MDS فعال داشته باشید. هر کدام یک rank است و مسئول بخشی از درخت پوشههاست:
ceph fs set fs01 max_mds 2
ceph fs status fs01
# سنجاق کردن صریح یک زیردرخت به یک rank
setfattr -n ceph.dir.pin -v 1 /mnt/fs01/home
# توزیع خودکار زیرپوشهها بین rankها (ephemeral distributed pin)
setfattr -n ceph.dir.pin.distributed -v 1 /mnt/fs01/scratch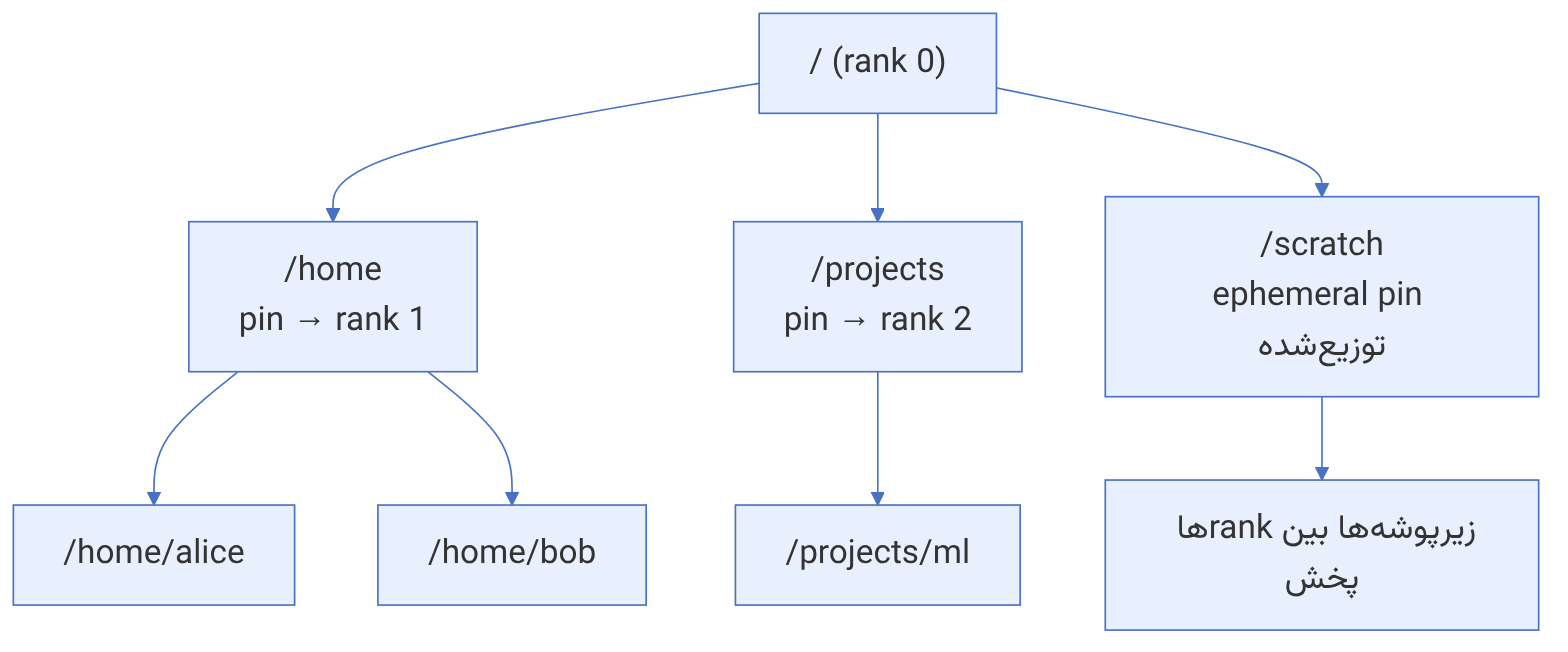
متعادلکنندهی خودکار MDS (که زیردرختها را بر اساس بار بین rankها جابهجا میکند) در گذشته منبع ناپایداری بوده است. توصیهی رایج جامعه و مستندات این است که در production از pinning صریح استفاده کنید. همچنین در Tentacle تغییر max_mds روی کلاستر ناسالم نیازمند پرچم تأیید --yes-i-really-mean-it شده است، چون افزودن MDS در حین مشکل معمولاً حالت را بدتر میکند.
۶-۳ دسترسی کلاینتها#
۶-۳-۱ ساختن کاربر با دسترسی محدود#
هیچوقت کلید client.admin را روی کلاینت فایلسیستم نگذارید. دستور ceph fs authorize کاربری میسازد که فقط به فایلسیستم و مسیر مشخصی دسترسی دارد و capabilityهای لازم روی MON، MDS و OSD را خودش تنظیم میکند:
ceph fs authorize fs01 client.webapp /web rw
ceph fs authorize fs01 client.analyst / r /reports rw
ceph auth get client.webapp
# روی کلاینت
ceph auth get client.webapp -o /etc/ceph/ceph.client.webapp.keyring   # از گره مدیریت
scp /etc/ceph/ceph.conf /etc/ceph/ceph.client.webapp.keyring client-node1:/etc/ceph/کاربر دوم مثال بالا کل فایلسیستم را فقطخواندنی و /reports را خواندنینوشتنی میبیند. برای جلوگیری از تغییر layout یا quota توسط کاربر، پرچمهای p (layout و quota) و s (snapshot) را به او ندهید؛ این پرچمها فقط وقتی صراحتاً بدهید (مثلاً rwps) فعالاند.
۶-۳-۲ کلاینت هسته#
کلاینت هستهی لینوکس (ceph.ko) سریعترین و کمسربارترین راه است و برای اغلب بارهای production گزینهی پیشفرض است. نحو جدید mount (که مستندات آن را «v2» مینامد) شکل name@fsid.fs_name=/path دارد:
sudo dnf install -y ceph-common            # یا apt install ceph-common
FSID=$(ceph fsid)
sudo mkdir -p /mnt/fs01
sudo mount -t ceph webapp@${FSID}.fs01=/web /mnt/fs01
# اگر ceph.conf روی کلاینت نیست، آدرس MONها را صریحاً بدهید
sudo mount -t ceph webapp@${FSID}.fs01=/web /mnt/fs01 -o mon_addr=192.168.10.11/192.168.10.12
df -h /mnt/fs01
برای mount دائمی در /etc/fstab:
webapp@<fsid>.fs01=/web /mnt/fs01 ceph noatime,_netdev 0 0نحو قدیمی mount -t ceph 192.168.10.11:6789:/ /mnt -o name=webapp هنوز کار میکند و در بسیاری از راهنماهای قدیمی آمده است. نحو جدید روشنتر است چون نام فایلسیستم و fsid را صریحاً مشخص میکند و در کلاسترهای چندفایلسیستمی ابهام ندارد. با -o ms_mode=secure هم ترافیک کلاینت هسته با msgr2 رمزنگاری میشود.
کلاینت هسته به نسخهی هستهی سیستمعامل گره خورده است. قابلیتهای جدید (مثل quota روی هستههای خیلی قدیمی یا رمزنگاری fscrypt) فقط روی هستههای جدید در دسترساند. روی توزیعهای enterprise، backportهای توزیعکننده مهمتر از شمارهی هستهاند؛ قبل از تصمیم، جدول سازگاری مستندات را بخوانید.
۶-۳-۳ ceph-fuse#
ceph-fuse در فضای کاربر اجرا میشود و بر پایهی libcephfs است، پس همیشه همنسخهی کلاستر است و قابلیتهای جدید را زودتر دارد؛ اما به دلیل تعویض context بین هسته و فضای کاربر کندتر است.
sudo dnf install -y ceph-fuse
sudo mkdir -p /mnt/fs01-fuse
sudo ceph-fuse --id webapp --client_fs fs01 -r /web /mnt/fs01-fuse
# fstab
# none /mnt/fs01-fuse fuse.ceph ceph.id=webapp,ceph.client_fs=fs01,ceph.client_mountpoint=/web,_netdev,defaults 0 0| معیار | کلاینت هسته | ceph-fuse |
|---|---|---|
| کارایی | بهتر؛ بدون سربار فضای کاربر | کمتر، بهویژه در فرادادهی سنگین |
| بهروز بودن | وابسته به هستهی سیستمعامل | همنسخه با بستههای Ceph |
| اشکالزدایی | سختتر (dmesg) | سادهتر (لاگ و admin socket) |
| خطای کلاینت | ممکن است کل گره را درگیر کند | محدود به همان فرایند |
| موارد مناسب | production، HPC، Kubernetes | کلاینتهای قدیمی، آزمایش، macOS |
۶-۴ صدور با NFS و SMB#
۶-۴-۱ NFS با ماژول nfs#
برای کلاینتهایی که نمیتوانند CephFS را مستقیم mount کنند (سیستمهای قدیمی، VMware، یا شبکههایی که نباید به شبکهی public کلاستر دسترسی داشته باشند)، Ceph سرویس NFS-Ganesha را مدیریت میکند. Ganesha یک سرور NFS در فضای کاربر است که از طریق libcephfs به CephFS وصل میشود.
ceph mgr module enable nfs # در نسخههای جدید معمولاً فعال است
ceph nfs cluster create nfs01 "2 ceph-node2 ceph-node3" --ingress --virtual_ip 192.168.10.50/24
ceph nfs cluster info nfs01
ceph nfs export create cephfs --cluster-id nfs01 --pseudo-path /shared --fsname fs01 --path /web
ceph nfs export ls nfs01 --detailed
# روی کلاینت
sudo mount -t nfs -o nfsvers=4.1,proto=tcp 192.168.10.50:/shared /mnt/sharedگزینهی --ingress یک سرویس ingress (haproxy و keepalived) جلوی daemonهای Ganesha مستقر میکند و یک IP مجازی ثابت میدهد. در حالت پیشفرض هر کلاینت به یک backend ثابت میچسبد، چون NFSv4 وضعیت دارد (stateful) و جابهجایی کلاینت بین سرورها نیازمند بازیابی وضعیت است. حالت keepalive-only فقط IP مجازی را بدون haproxy جابهجا میکند و برای سادهترین HA مناسب است. پیکربندی exportها در اشیای RADOS (در pool .nfs) ذخیره میشود، نه در فایل محلی، بنابراین همهی daemonها پیکربندی یکسانی دارند.
پشتیبانی رسمی ماژول nfs بر NFSv4.1 به بالاست. NFSv3 در نسخههای جدید با گزینهی --enable-nfsv3 در دسترس است، اما چون NFSv3 قفلگذاری را از طریق NLM جداگانه انجام میدهد، رفتار قفلها و failover را پیش از استفاده آزمایش کنید.
۶-۴-۲ SMB با ماژول smb (Tentacle)#
تا پیش از Tentacle، برای صدور CephFS به ویندوز باید Samba را دستی با ماژول vfs_ceph پیکربندی میکردید. در Tentacle ماژول smb به MGR اضافه شد که خوشههای Samba را در کانتینر مستقر و مدیریت میکند؛ هم با کاربران محلی و هم با پیوستن به Active Directory:
ceph mgr module enable smb
ceph smb cluster create smb01 user --define-user-pass=alice%S3cret-Ch@ngeMe --placement="1 ceph-node2"
ceph fs subvolumegroup create fs01 smb
ceph fs subvolume create fs01 docs --group_name smb --size 107374182400
ceph smb share create smb01 docs fs01 / --subvolume=smb/docs
ceph smb showرمز عبور در مثال بالا نمونه است؛ در محیط واقعی از Active Directory استفاده کنید یا رمز را از یک مخزن امن بخوانید تا در تاریخچهی shell نماند. Tentacle همچنین پوشههای غیرحساس به بزرگی و کوچکی حروف (case-insensitive) را به CephFS اضافه کرد که برای سازگاری با کلاینتهای ویندوز اهمیت دارد؛ دستورهای subvolume پرچم --casesensitive را برای همین دارند.
۶-۵ از درون کد: capabilityها، journal و dirfrag در MDS#
۶-۵-۱ capability: قرارداد کش بین MDS و کلاینت#
CephFS کش منسجم بین کلاینتها را بدون قفل توزیعشدهی عمومی، با capability (cap) پیاده میکند. MDS برای هر inode به هر کلاینت مجموعهای از بیتها میدهد که مشخص میکند کلاینت چه چیزی را میتواند محلی کش یا تغییر دهد. ثابتها در src/include/ceph_fs.h تعریف شدهاند. بیتهای عمومی CEPH_CAP_GSHARED=1، GEXCL=2، GCACHE=4، GRD=8، GWR=16، GBUFFER=32، GWREXTEND=64 و GLAZYIO=128 هستند. این بیتها روی پیشوندهای SAUTH=2، SLINK=4، SXATTR=6 و SFILE=8 شیفت داده میشوند و CEPH_CAP_PIN=1 جداگانه است.
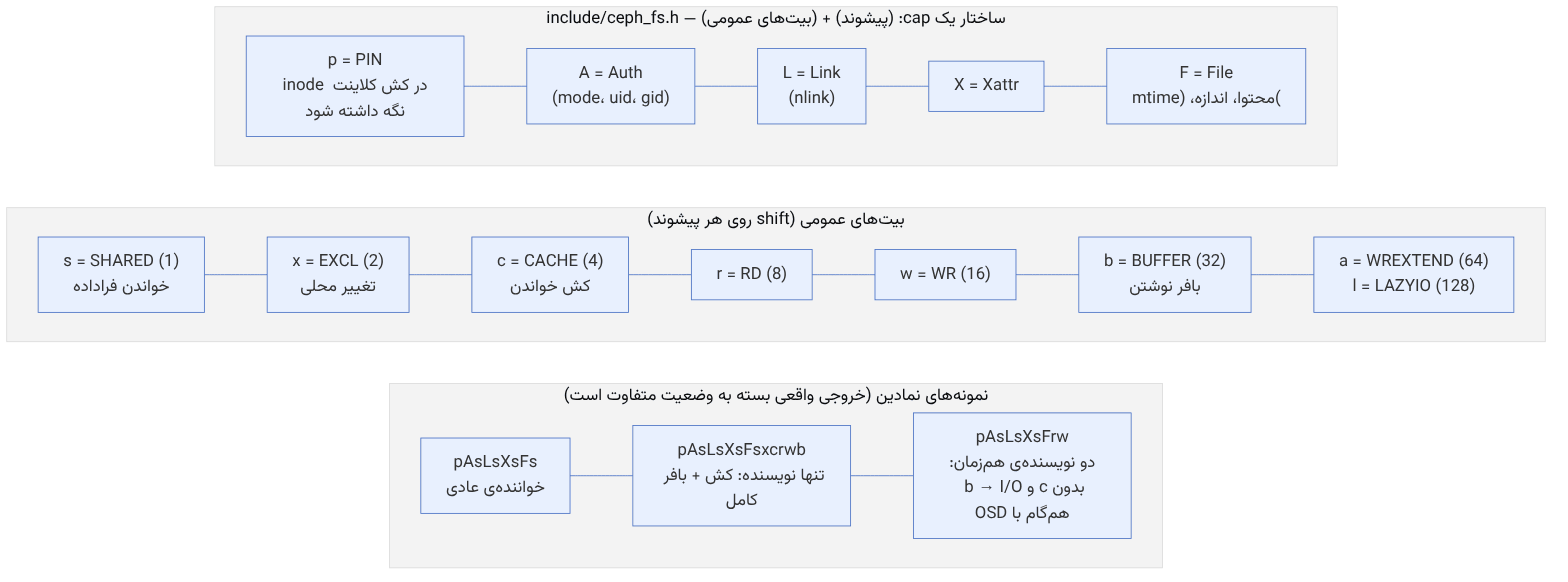
pseudocode: revoke (خلاصهی این کتاب از Locker.cc و Client.cc)
MDS: کلاینت B فایل را برای نوشتن باز میکند و A دارای Fcb است
issue_caps(A, wanted=Fsr) # CEPH_CAP_OP_REVOKE
A: flush dirty buffered data to OSD → MClientCaps(UPDATE/ack) with new issued
MDS: پس از ack، Fw به B و Fr به A (بدون c/b)
اگر A پاسخ ندهد: هشدار MDS_CLIENT_LATE_RELEASE
و اگر mds_cap_revoke_eviction_timeout>0 (پیشفرض 0 = غیرفعال) → evict + blocklist| گزینه (mds.yaml.in) | پیشفرض | نقش |
|---|---|---|
| mds_cache_memory_limit | ۴_G | هدف حافظهی کش؛ فراتر از آن recall cap |
| mds_recall_max_caps | ۳۰۰۰۰ | سقف cap فراخوانیشده در هر بار از یک session |
| mds_max_caps_per_client | ۱_M | سقف نرم cap برای هر کلاینت |
| mds_cap_revoke_eviction_timeout | ۰ | غیرفعال؛ اخراج خودکار کلاینتی که cap را پس نمیدهد |
| mds_session_blocklist_on_timeout / on_evict | true / true | blocklist کلاینت اخراجشده |
| mds_beacon_grace | ۱۵ | پس از این مدت بدون beacon، MON آن MDS را laggy/failed میداند |
۶-۵-۲ journal، segment و dirfrag#
هر تغییر فراداده ابتدا بهصورت رویداد (مثلاً EUpdate) در MDLog نوشته میشود. این journal روی pool metadata قرار دارد و مثل یک log پیوسته با striping روی اشیای RADOS ذخیره میشود. پس از flush journal، پاسخ «safe» به کلاینت داده میشود. خود دایرکتوریها بعداً هنگام expire شدن segmentها در اشیای dirfrag نوشته میشوند؛ هر dirfrag یک شیء با نام <ino hex>.<frag hex> است که ورودیهایش در omap قرار دارند.
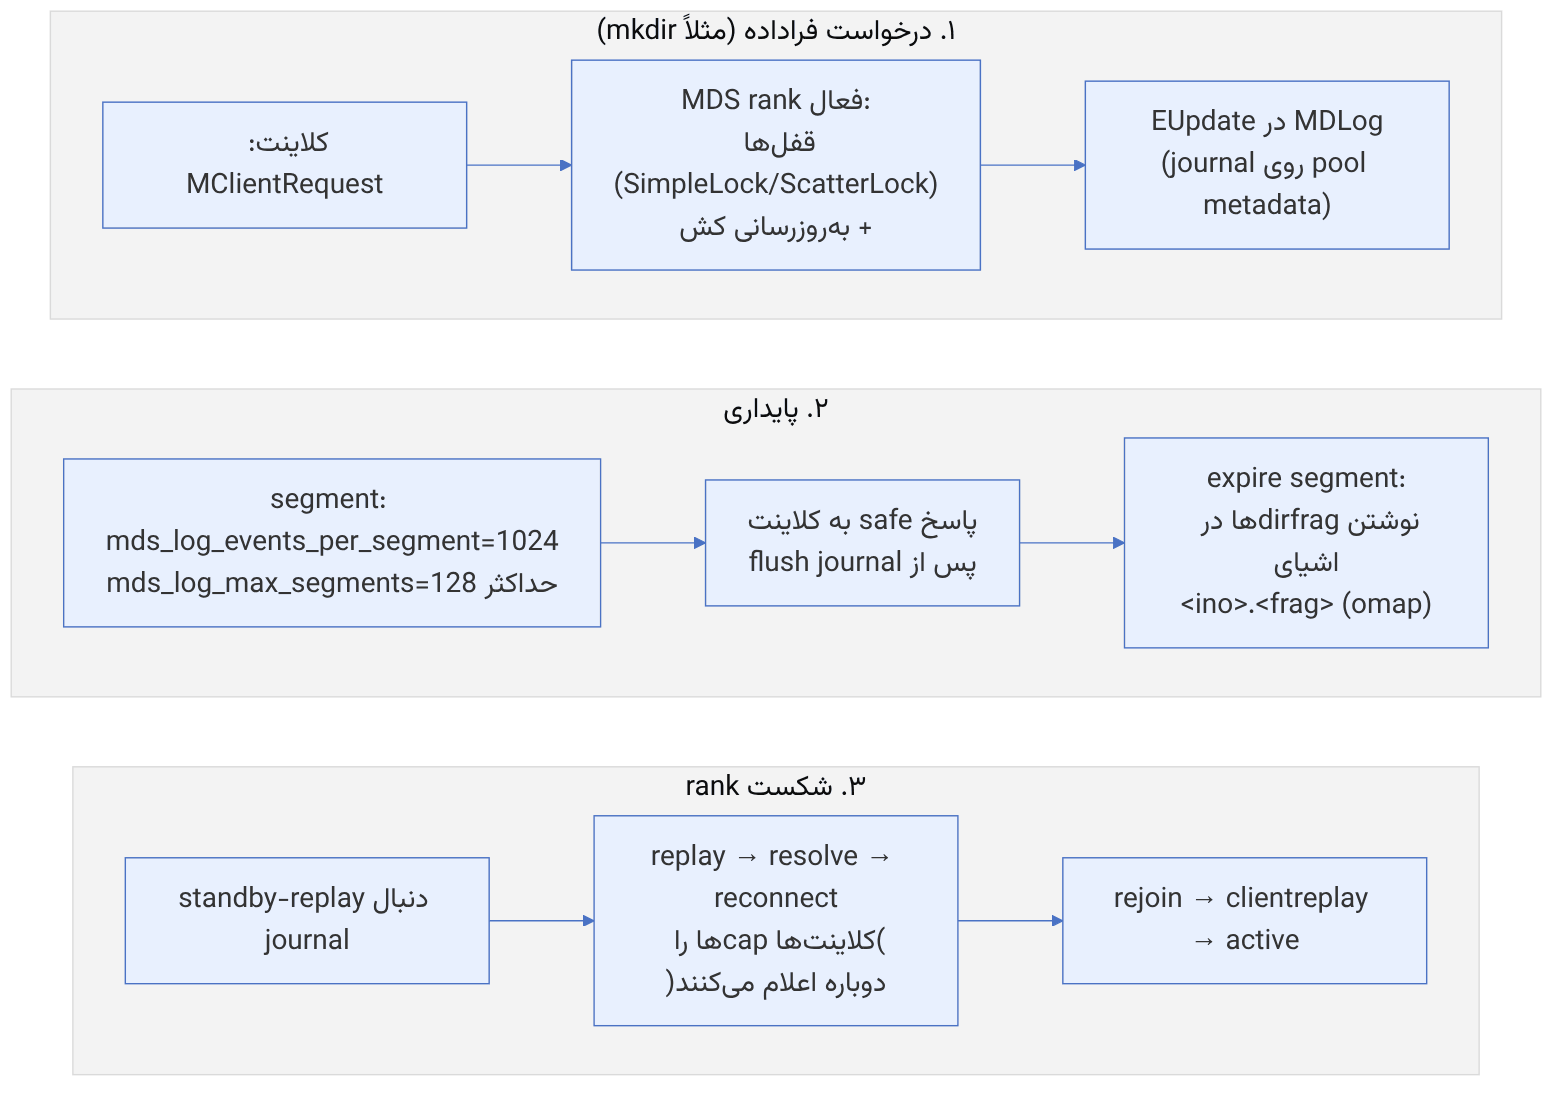
| حالت (ceph_fs.h) | مقدار | معنا |
|---|---|---|
| CEPH_MDS_STATE_REPLAY | ۸ | بازخوانی journal |
| CEPH_MDS_STATE_RESOLVE | ۹ | رفع ابهام عملیات بینrank |
| CEPH_MDS_STATE_RECONNECT | ۱۰ | انتظار برای reconnect کلاینتها |
| CEPH_MDS_STATE_REJOIN | ۱۱ | بازسازی کش توزیعشده |
| CEPH_MDS_STATE_CLIENTREPLAY | ۱۲ | اجرای دوبارهی درخواستهای تأییدنشدهی کلاینت |
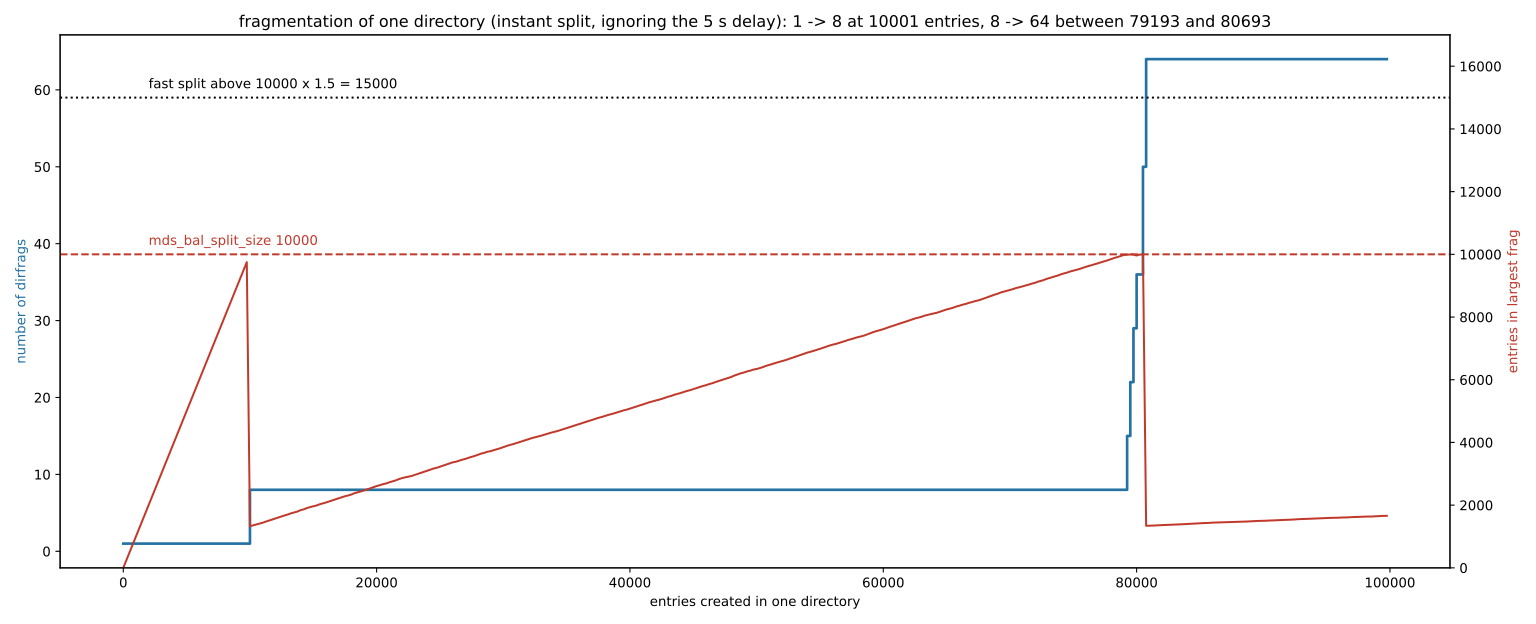
تکهتکه شدن دایرکتوری (dirfrag): وقتی تعداد ورودیهای یک fragment از mds_bal_split_size=10000 بیشتر شود، fragment تقسیم میشود. اگر از mds_bal_merge_size=50 کمتر شود، ادغام صورت میگیرد. mds_bal_fragment_size_max=100000 سقف سخت است و پس از آن ساخت فایل جدید در آن fragment با ENOSPC رد میشود. همین dirfragها واحد جابهجایی بین rankها در balancer یا با pinning هستند.
فرمانهای بررسی:
ceph fs status ; ceph health detail | grep -E 'MDS_|CLIENT'
ceph tell mds.cephfs:0 session ls | jq '.[] | {id, num_caps, "client": .client_metadata.hostname}'
ceph tell mds.cephfs:0 dump_ops_in_flight | jq '.ops[0]'
ceph tell mds.cephfs:0 perf dump mds_log | jq '.mds_log | {ev, seg, evtrm}'
ceph tell mds.cephfs:0 cache status
setfattr -n ceph.dir.pin -v 1 /mnt/cephfs/projects # pin دایرکتوری به rank 1۶-۶ CephFS با عدد: نام شیءها، dirfrag، تقسیم و شمارندهی محبوبیت#
این بخش نشان میدهد یک فایل و یک ورودی پوشه در CephFS دقیقاً به کدام شیء RADOS نگاشته میشوند، و MDS بر چه اساسی پوشه را تقسیم میکند. ارجاعها به main در نوامبر ۲۰۲۶ است. پیادهسازی پایتونی ما از rjenkins برای نام foo همان ۰x7fc1f406 را میدهد که ceph osd map گزارش میکند. همهی عددهای زیر با همین بازپیادهسازی حساب شدهاند.
۶-۶-۱ فایل به شیء#
منبع در کد: src/osdc/Striper.cc :: Striper::file_to_extents؛ src/include/object.cc :: file_object_t::c_str؛ src/mds/InoTable.cc :: InoTable::reset_state
پیچیدگی: O(۱) برای هر بایت و O(تعداد شیء) برای هر محدوده
pseudocode
inoهای rank r از (r+1) << 40 شروع میشوند (rank 0 → 0x10000000000)
blockno = off / su ; stripeno = blockno / sc ; stripepos = blockno mod sc
objsetno = stripeno / (object_size / su)
objectno = objsetno × sc + stripepos
obj_off = (stripeno mod (object_size / su)) × su + off mod su
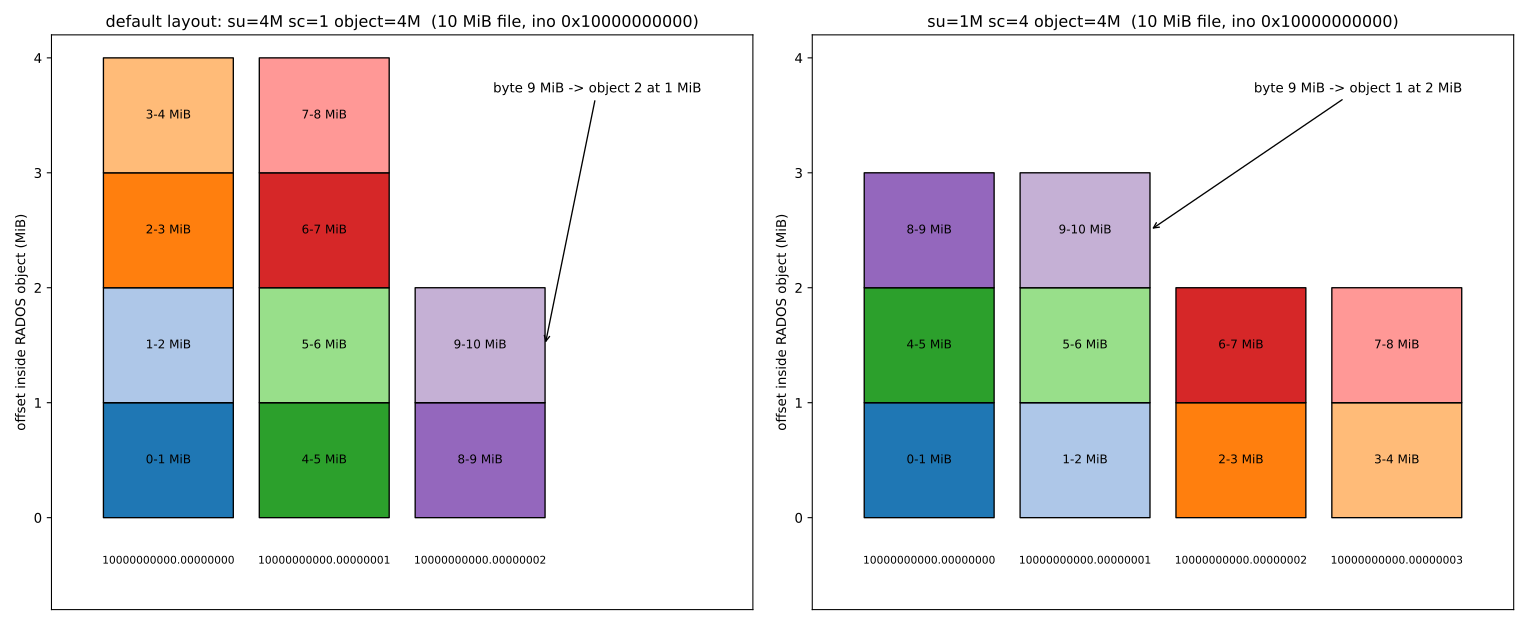
oid = sprintf("%llx.%08llx", ino, objectno) # در pool لایهی فایل (layout.pool_id)مثال عددی. با layout پیشفرض (su = ۴ MiB، sc = ۱ و شیء ۴ MiB)، یک فایل ۱۰ مگابایتی با ino ۰x10000000000 سه شیء دارد: 10000000000.00000000، .00000001 و .00000002. بایت ۹ MiB در شیء ۲ و offset ۱ MiB است. اگر پیش از نوشتن، با setfattr -n ceph.file.layout.stripe_unit -v 1048576 و stripe_count برابر ۴ layout را عوض کنید، همان بایت به شیء ۱ و offset ۲ MiB میرود و ۱۰ مگابایت روی ۴ شیء پخش میشود. بنابراین یک خواندن ترتیبی بزرگ همزمان به ۴ OSD میرسد. layout فایل فقط تا وقتی که فایل خالی است قابل تغییر است. layout پوشه فقط بر فایلهای تازه اثر دارد.
۶-۶-۲ نام ورودی به dirfrag#
منبع در کد: src/mds/CInode.cc :: InodeStoreBase::hash_dentry_name، pick_dirfrag؛ src/include/frag.h :: fragtree_t::operator[]؛ src/include/ceph_frag.h
پیچیدگی: O(عمق درخت frag)
pseudocode
h = ceph_str_hash(dir_layout.dl_dir_hash, name) # پیشفرض mds_default_dir_hash = 2 = rjenkins
frag = ریشه (bits=0, value=0)
تا وقتی frag در fragtree تقسیم شده (nb بیت):
frag = فرزندی که contains(h): (h AND mask) == value ، mask = 0xFFFFFF << (24 − bits)
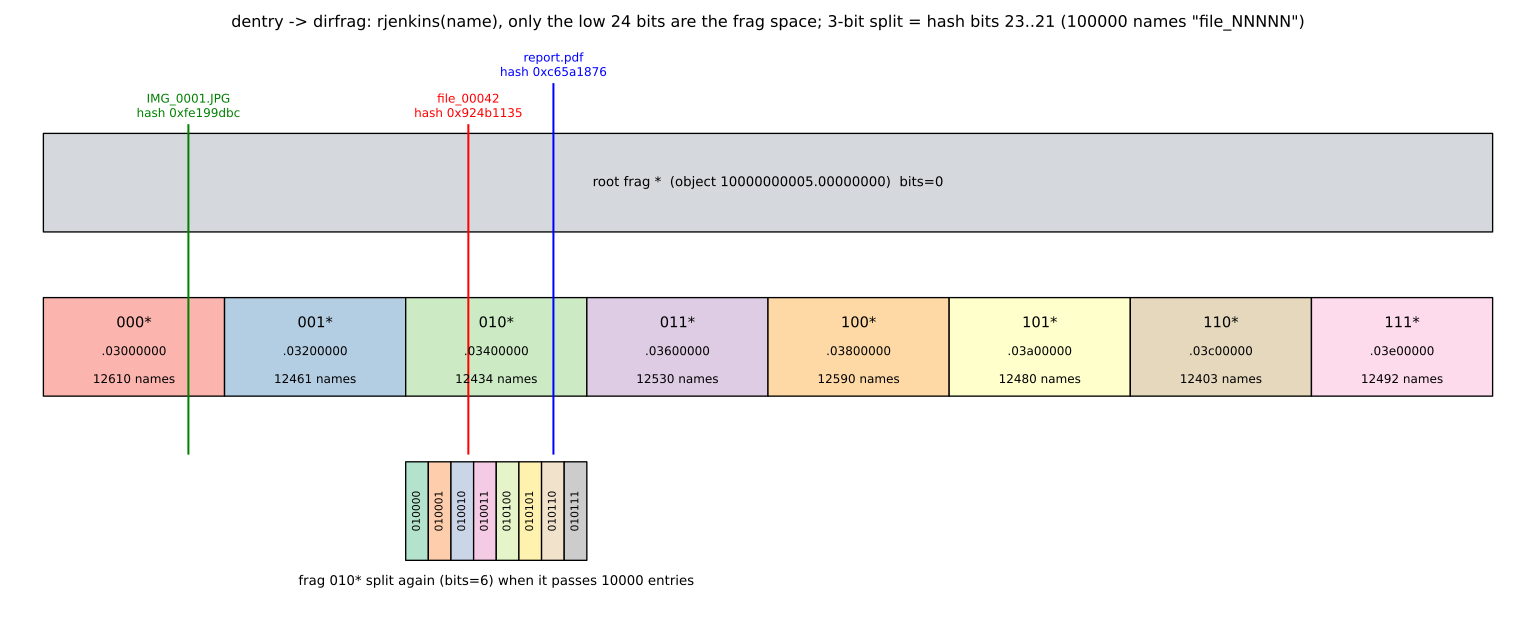
_enc = (bits << 24) | value ؛ شیء dirfrag = sprintf("%llx.%08llx", dir_ino, _enc)مثال عددی. فقط ۲۴ بیت پایین hash فضای frag را تشکیل میدهند. تقسیم سهبیتی بیتهای ۲۳ تا ۲۱ را میخواند. rjenkins برای file_00042 عدد ۰x924b1135 است و بیتهای ۲۳ تا ۲۱ آن ۰۱۰ است، پس ورودی به frag با _enc برابر ۰x03400000 میرود و شیء آن، برای پوشهای با ino ۰x10000000005، 10000000005.03400000 است. report.pdf با hash ۰xc65a1876 هم به همان frag میرود و IMG_0001.JPG با hash ۰xfe199dbc به frag ۰x03000000. 100000 نام file_00000 تا file_99999 بین ۸ frag بهصورت ۱۲۴۰۳ تا ۱۲۶۱۰ پخش میشوند. rjenkins برخلاف hash لینوکس روی بیتهای پایین هم خوب پخش میکند.
۶-۶-۳ کی تقسیم و کی ادغام؟#
منبع در کد: src/mds/MDBalancer.cc :: MDBalancer::hit_dir، maybe_fragment، queue_split؛ src/mds/CDir.cc :: CDir::should_split، should_split_fast، should_merge
پیچیدگی: O(۱) برای هر hit؛ تقسیم O(ورودیهای frag)
pseudocode
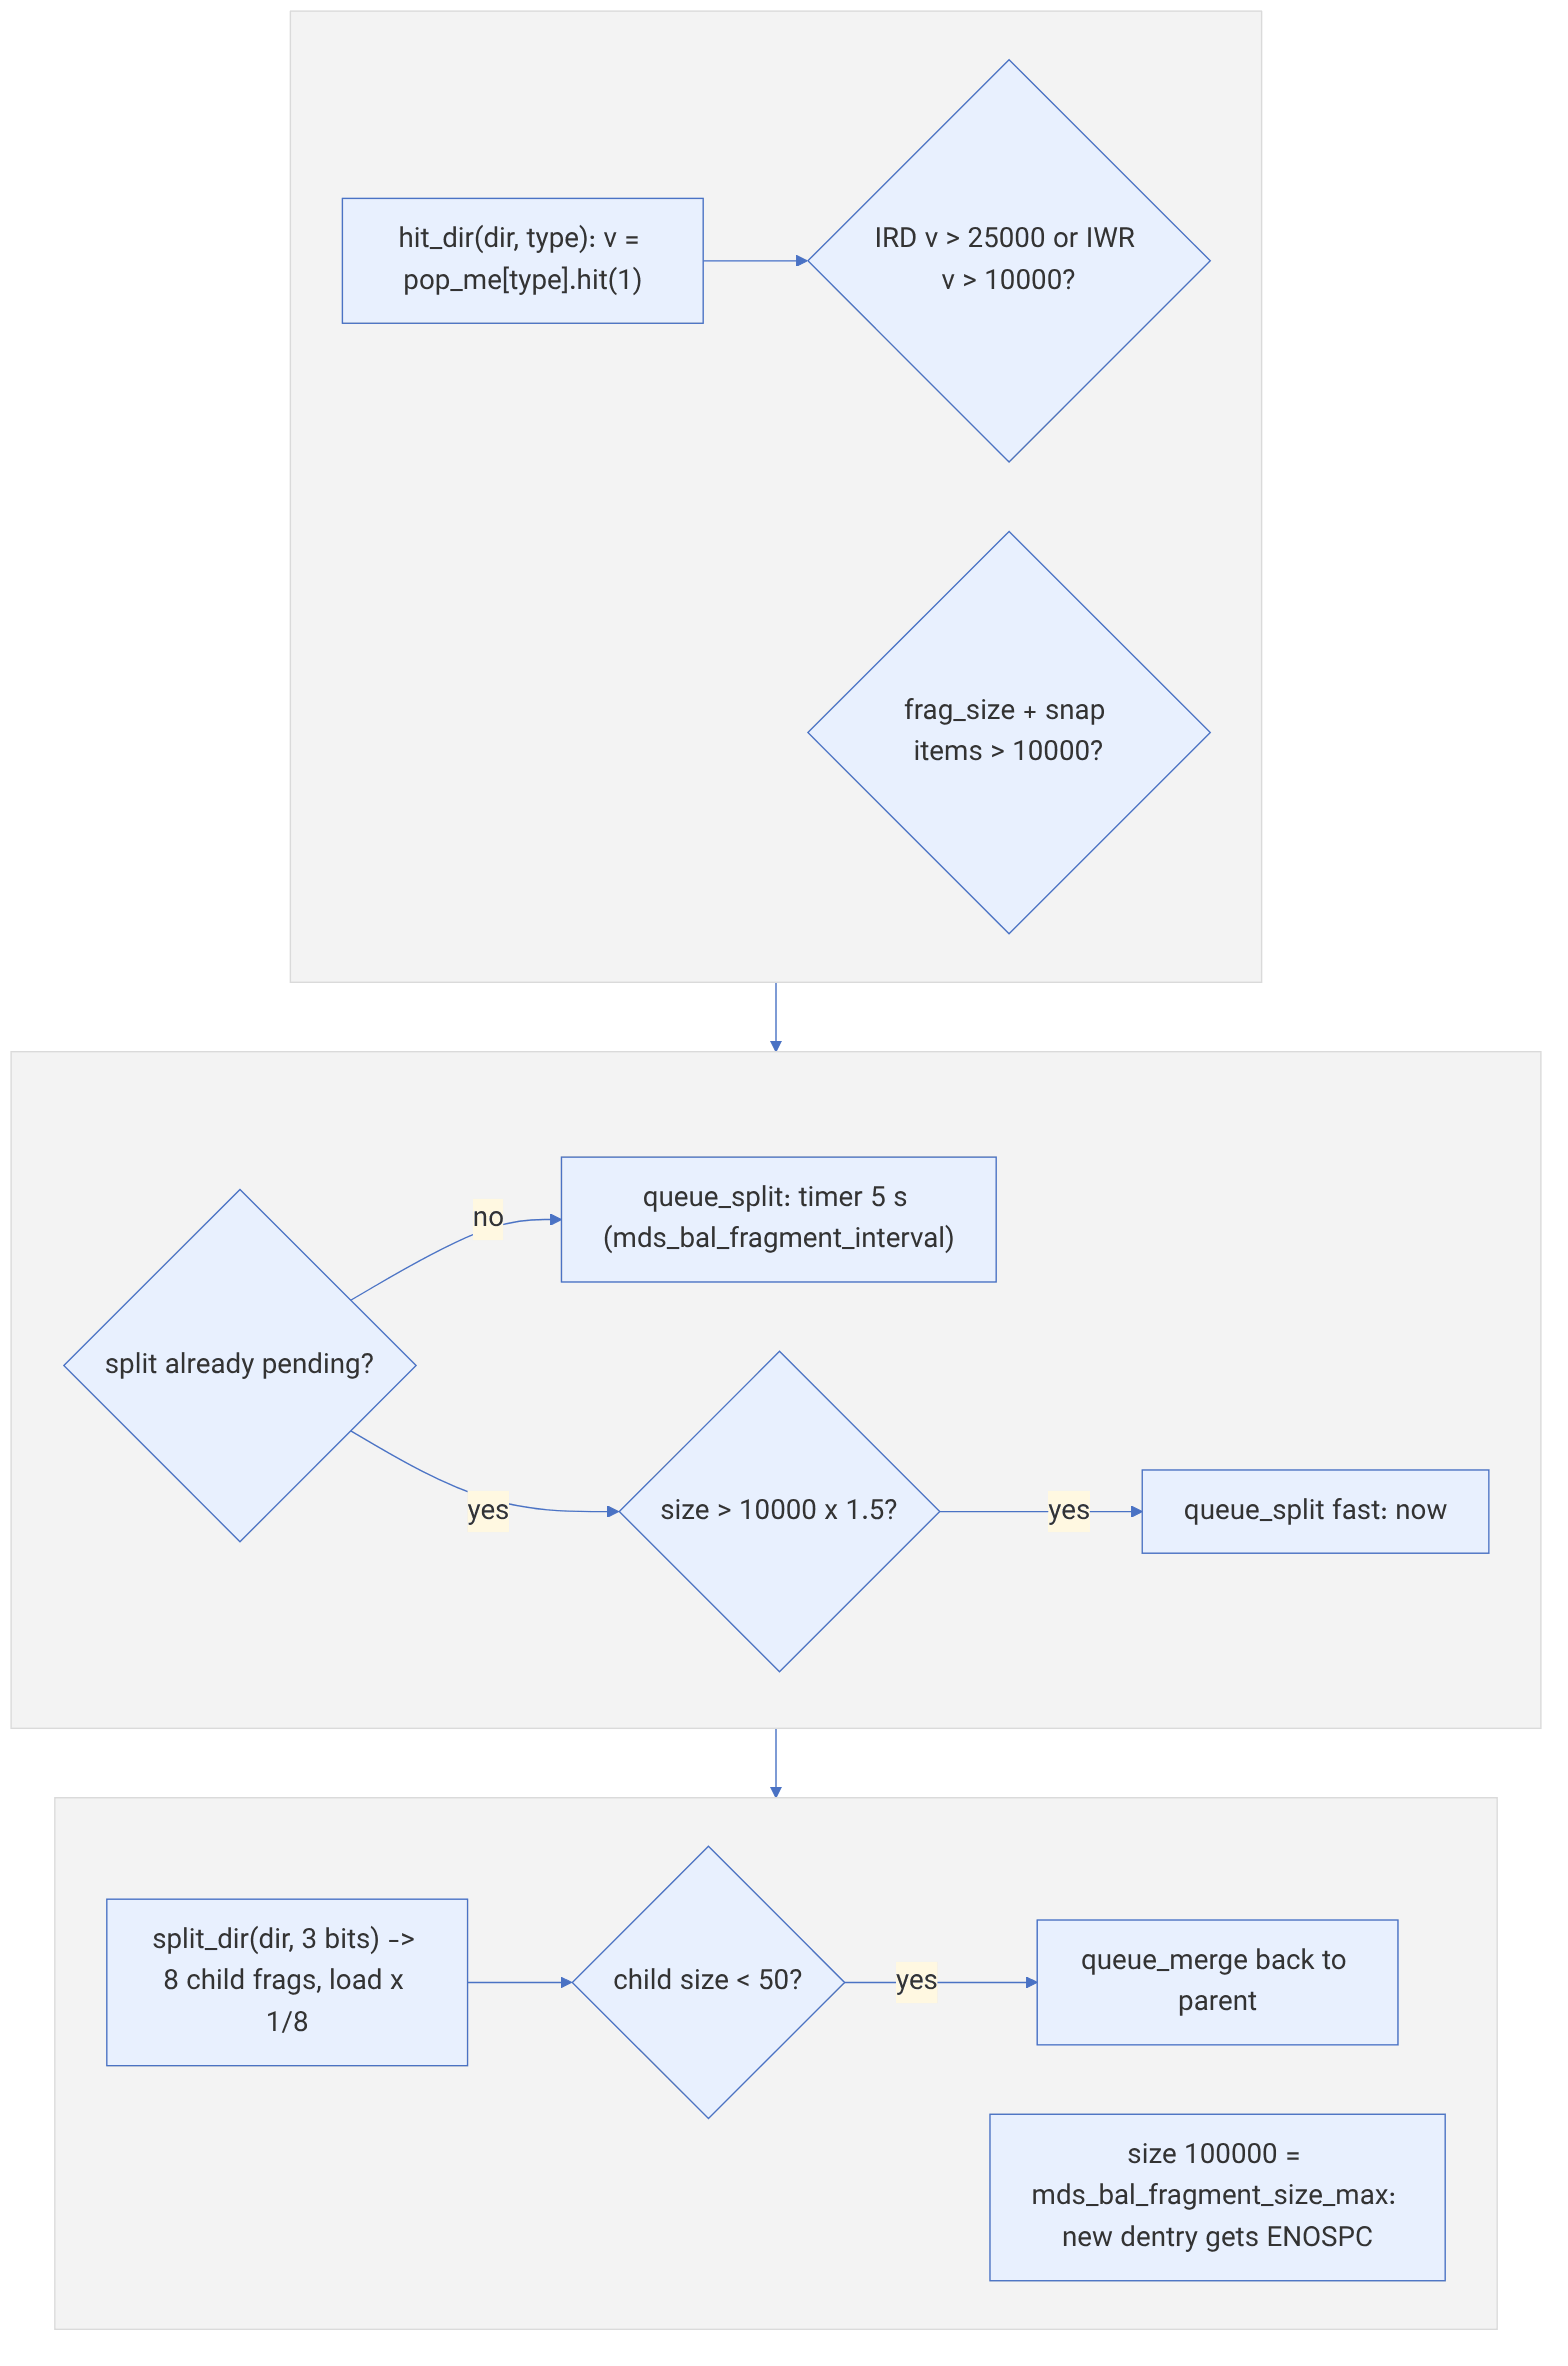
hit_dir(dir, type): v = dir.pop_me[type].hit(1)
hot = (type == IRD and v > mds_bal_split_rd 25000) or (type == IWR and v > mds_bal_split_wr 10000)
if should_split (size + snap > 10000) or hot:
if split در صف نیست: queue_split(dir) بعد از mds_bal_fragment_interval (5 s)
elif should_split_fast (size > 10000 × 1.5): queue_split(dir, fast) ، بیدرنگ
if should_merge (size + snap < 50 و frag ریشه نیست) : queue_merge
split_dir(dir, mds_bal_split_bits = 3) → 8 frag ؛ بار هر فرزند = بار والد × 1/8
سقف سخت: mds_bal_fragment_size_max = 100000 ← dentry تازه ENOSPC میگیردمثال عددی. اگر ۱۰۰۰۰۰ فایل file_NNNNN پشتسرهم در یک پوشه ساخته شوند و تقسیم بیدرنگ فرض شود، در ورودی ۱۰۰۰۱ پوشه به ۸ frag تقسیم میشود. هر frag حدود ۱۲۵۰ ورودی دارد و بعد همزمان رشد میکند. تقسیم دوم تقریباً همزمان برای هر هشت frag، بین ورودیهای ۷۹۱۹۳ و ۸۰۶۹۳، انجام میشود و تعداد frag به ۶۴ میرسد. در ۱۰۰۰۰۰ ورودی، اندازهی fragها ۱۴۶۲ تا ۱۶۶۳ است. در عمل تأخیر ۵ ثانیهای و مسیر fast (بالای ۱۵۰۰۰) تعیین میکنند که یک ساخت انبوه بسیار سریع از ۱۰۰۰۰ چقدر جلوتر برود. سقف ۱۰۰۰۰۰ فقط وقتی میرسد که تقسیم ممکن نباشد. MDCache::can_fragment در این حالتها تقسیم را رد میکند: فایلسیستم فقطخواندنی است، کلاستر MDS در وضعیت degraded است، scrub روی پوشه در جریان است، پوشه quiesce شده است، یا پوشهی ریشه، mdsdir یا stray است. maybe_fragment هم inodeهای پایه را کنار میگذارد. پس پوشهی ریشهی CephFS هیچوقت تقسیم نمیشود و نمیتواند بیش از ۱۰۰۰۰۰ ورودی داشته باشد. فایلهای انبوه را در زیرپوشهها بگذارید.
۶-۶-۴ شمارندهی محبوبیت با نیمهعمر#
منبع در کد: src/common/DecayCounter.cc :: DecayCounter::decay؛ src/common/DecayCounter.h :: DecayRate
پیچیدگی: O(۱)
pseudocode
k = ln(0.5) / mds_decay_halflife # نیمهعمر پیشفرض 5 ثانیه
hit(Δ): val = val × exp(k × (now − last)) + Δ ; last = now ; if val < 0.01: val = 0
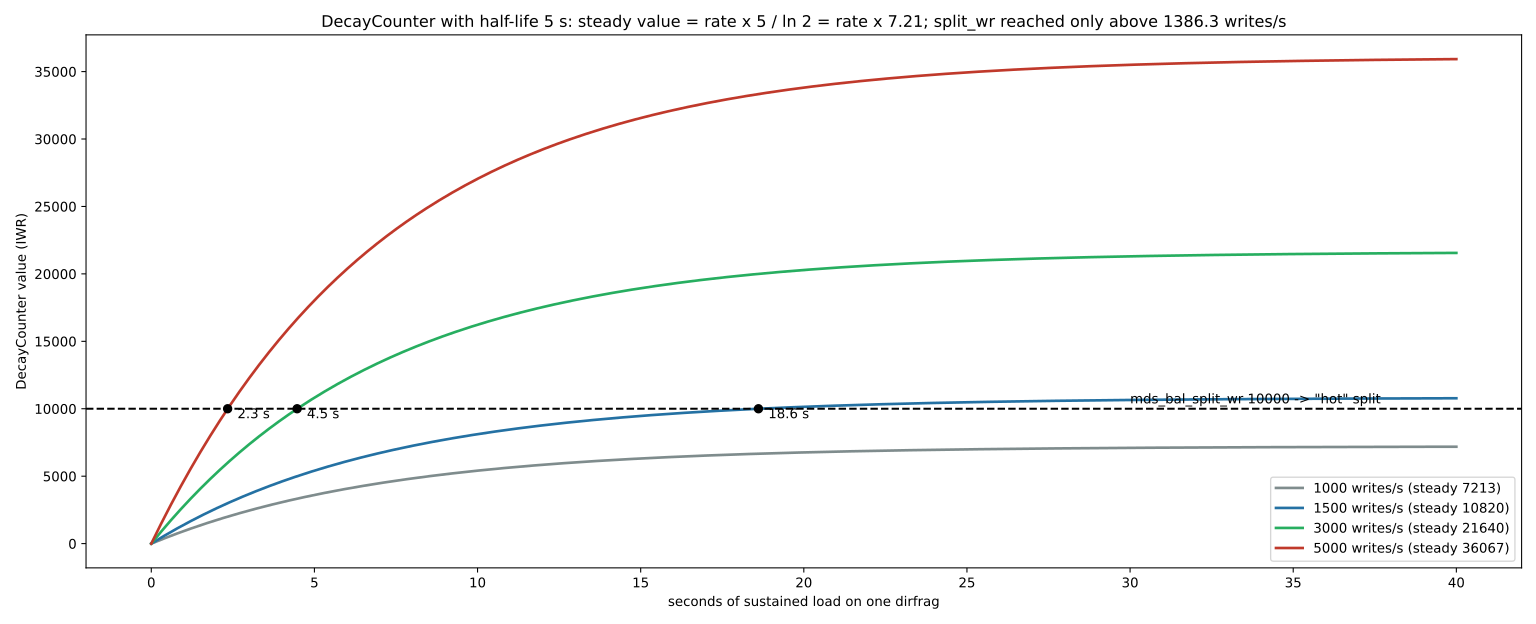
مقدار پایدار با نرخ r: r × halflife / ln 2 = r × 7.21
زمان رسیدن به آستانهی T: t = −halflife × log2(1 − T / (r × 7.21))مثال عددی. آستانهی نوشتن ۱۰۰۰۰ با نرخ پایدار r فقط وقتی رد میشود که r × ۷.۲۱ > ۱۰۰۰۰، یعنی r > ۱۳۸۶.۳ نوشتن بر ثانیه روی یک dirfrag. با ۱۰۰۰ نوشتن بر ثانیه، شمارنده در ۷۲۱۳ ثابت میماند و پوشه هیچوقت «داغ» نمیشود. با ۱۵۰۰، آستانه پس از ۱۸.۶ ثانیه رد میشود، با ۳۰۰۰ پس از ۴.۵ ثانیه و با ۵۰۰۰ پس از ۲.۳ ثانیه. برای خواندن، آستانهی ۲۵۰۰۰ به حدود ۳۴۶۶ خواندن بر ثانیه نیاز دارد. با ۴۰۰۰ خواندن بر ثانیه، ۱۴.۵ ثانیه طول میکشد. پس پوشهی کوچک اما پرترافیک هم تقسیم میشود و fragهایش واحد جابهجایی balancer بین rankها میشوند. همین DecayCounter در balancer برای سنجش بار rankها و در MDS برای شمارش recall capها هم به کار میرود.
۶-۷ subvolume، snapshot و quota#
۶-۷-۱ subvolume: واحد مدیریتی اشتراکها#
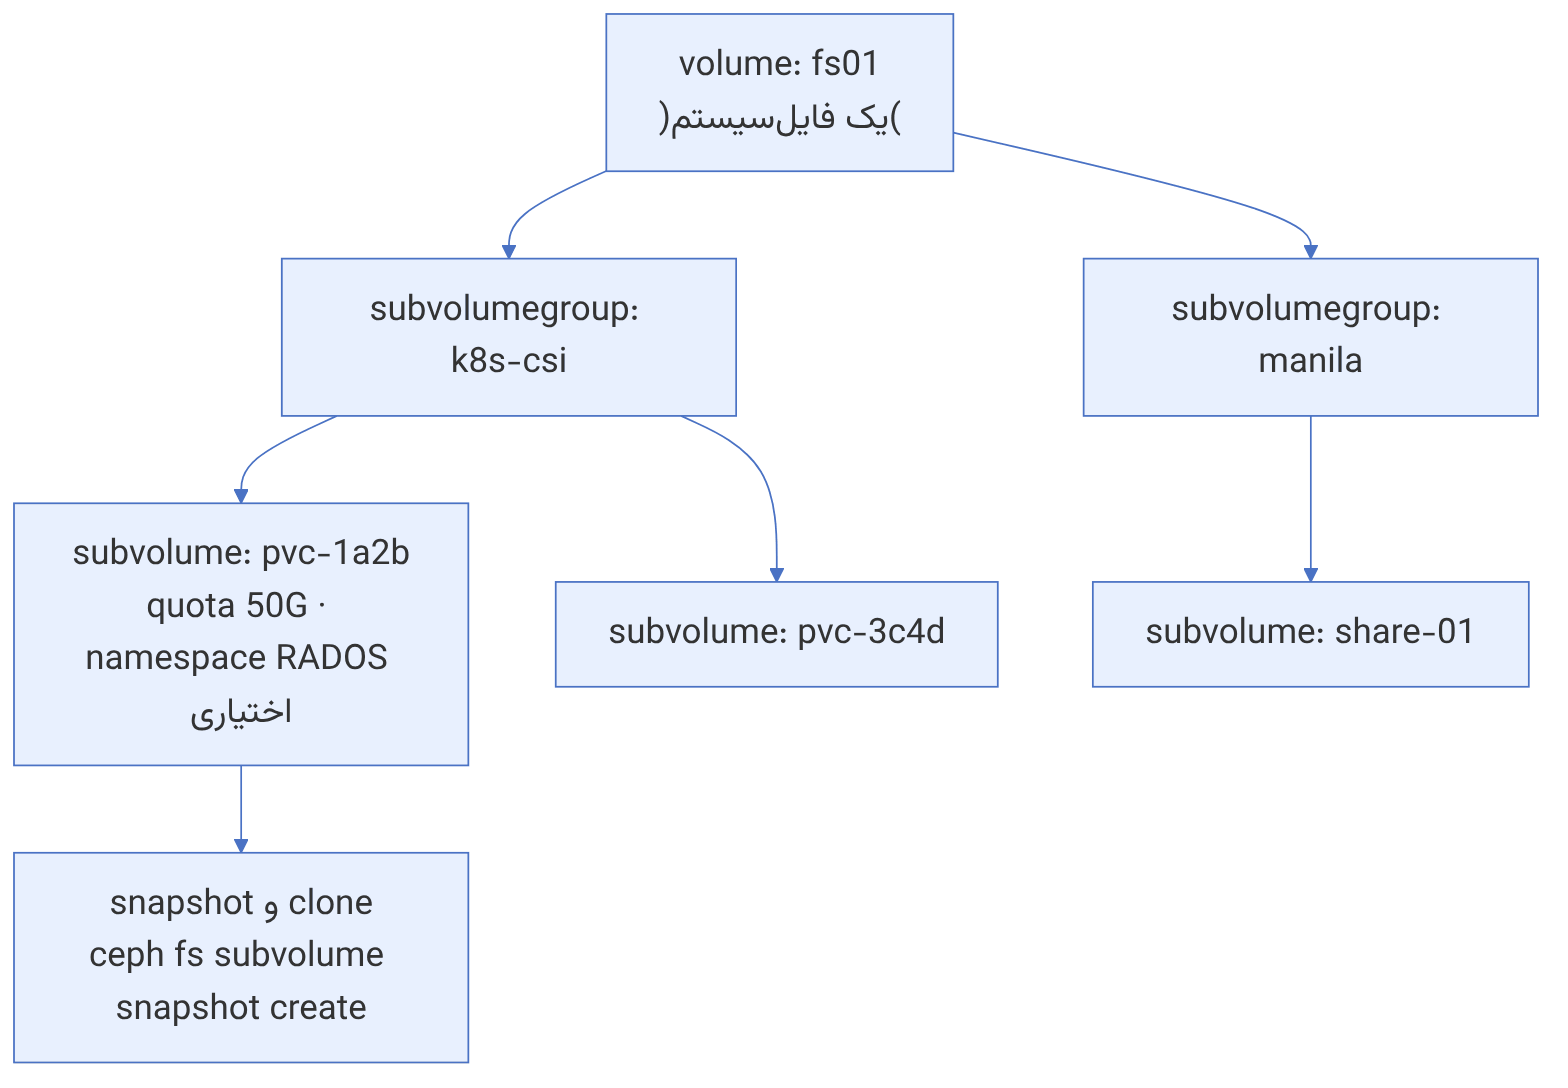
در محیطهای چندمستأجری (Kubernetes، Manila) هر مستأجر یا هر volume باید پوشهای مستقل با quota، مجوز و چرخهی عمر خودش داشته باشد. رابط fs volumes در MGR همین را با سه مفهوم ارائه میکند: volume (یک فایلسیستم)، subvolumegroup (گروهی از subvolumeها با layout مشترک) و subvolume (یک پوشهی مدیریتشده با quota).
ceph fs subvolumegroup create fs01 teams
ceph fs subvolume create fs01 data-eng --group_name teams --size 53687091200 --mode 770
ceph fs subvolume getpath fs01 data-eng --group_name teams
# خروجی شبیه: /volumes/teams/data-eng/<uuid>
ceph fs subvolume info fs01 data-eng --group_name teams
ceph fs subvolume resize fs01 data-eng 107374182400 --group_name teams --no_shrink
ceph fs subvolume ls fs01 --group_name teamsدرایور ceph-csi (که Rook هم از آن استفاده میکند) برای هر PVC از نوع CephFS یک subvolume در گروه csi میسازد. اگر در کلاستر Kubernetes میبینید subvolumeهای بیصاحب جمع شدهاند، معمولاً PVها با reclaimPolicy: Retain حذف شدهاند و subvolume پشت آنها باقی مانده است.
۶-۷-۲ snapshot#
snapshotهای CephFS در سطح هر پوشه گرفته میشوند، نه کل فایلسیستم، و از طریق پوشهی مجازی .snap در دسترساند. ایجاد آنها لحظهای است و از copy-on-write در سطح RADOS استفاده میکنند.
# روی پوشهی mountشده (کاربر باید پرچم s داشته باشد)
mkdir /mnt/fs01/projects/.snap/before-migration
ls /mnt/fs01/projects/.snap/
cp -a /mnt/fs01/projects/.snap/before-migration/report.xlsx /mnt/fs01/projects/ # بازیابی یک فایل
rmdir /mnt/fs01/projects/.snap/before-migration
# برای subvolumeها از رابط مدیریتی استفاده کنید
ceph fs subvolume snapshot create fs01 data-eng snap-2026-11-15 --group_name teams
ceph fs subvolume snapshot clone fs01 data-eng snap-2026-11-15 data-eng-test --group_name teams
ceph fs clone status fs01 data-eng-testclone یک subvolume از snapshot برخلاف clone در RBD لحظهای نیست؛ MGR داده را در پسزمینه کپی میکند و برای subvolumeهای بزرگ ساعتها طول میکشد. در Kubernetes این یعنی ساخت PVC از snapshot در CephFS میتواند کند باشد. برای بارهایی که clone سریع میخواهند، RBD مناسبتر است.
۶-۷-۳ snapshot زمانبندیشده#
ماژول snap_schedule گرفتن و حذف دورهای snapshotها را خودکار میکند:
ceph mgr module enable snap_schedule
ceph fs snap-schedule add /projects 1h --fs fs01
ceph fs snap-schedule retention add /projects h 24 --fs fs01
ceph fs snap-schedule retention add /projects d 7 --fs fs01
ceph fs snap-schedule status /projects --fs fs01
۶-۷-۴ quota#
quota در CephFS با ویژگیهای گسترده (xattr) روی هر پوشه تعیین میشود و دو نوع دارد: حداکثر بایت و حداکثر تعداد فایل.
setfattr -n ceph.quota.max_bytes -v 10737418240 /mnt/fs01/web
setfattr -n ceph.quota.max_files -v 100000 /mnt/fs01/web
getfattr -n ceph.quota.max_bytes /mnt/fs01/web
setfattr -n ceph.quota.max_bytes -v 0 /mnt/fs01/web # حذف quotaاعمال quota در CephFS همکارانه است: کلاینت خودش مصرف را دنبال میکند و وقتی به سقف رسید نوشتن را متوقف میکند. به همین دلیل کلاینتی که چند ثانیه با تأخیر از سقف باخبر شود، ممکن است کمی بیشتر از quota بنویسد، و کلاینت مخربی که کد را تغییر داده باشد میتواند quota را نادیده بگیرد. برای جداسازی سختگیرانهی مستأجران، علاوه بر quota از محدودیت مسیر در capability و namespace جدای RADOS استفاده کنید.
۶-۷-۵ layout: کنترل جای داده#
layout تعیین میکند دادهی فایلهای یک پوشه در کدام pool و با چه الگوی striping ذخیره شود. یک کاربرد رایج، هدایت دادهی آرشیوی به pool EC است:
ceph osd pool create cephfs.fs01.ec erasure
ceph osd pool set cephfs.fs01.ec allow_ec_overwrites true
ceph fs add_data_pool fs01 cephfs.fs01.ec
setfattr -n ceph.dir.layout.pool -v cephfs.fs01.ec /mnt/fs01/archive
getfattr -n ceph.dir.layout /mnt/fs01/archivelayout پوشه فقط روی فایلهایی اثر دارد که بعد از تنظیم ساخته میشوند. فایلهای موجود در pool قبلی میمانند؛ برای انتقالشان باید آنها را کپی کنید (نه mv، چون rename در یک فایلسیستم داده را جابهجا نمیکند).
۶-۸ آینهسازی و جایگزینی HDFS#
۶-۸-۱ آینهسازی snapshot بین کلاسترها#
از Pacific، daemon cephfs-mirror snapshotهای پوشههای انتخابشده را بهصورت ناهمگام به فایلسیستمی در کلاستر دیگر منتقل میکند. این سازوکار مبتنی بر snapshot است: هر snapshot جدید در مقصد هم ساخته میشود و فقط تفاوتها منتقل میشوند.
# کلاستر مقصد
ceph fs authorize fs01 client.mirror_remote / rwps
ceph fs snapshot mirror peer_bootstrap create fs01 client.mirror_remote site-b
# کلاستر مبدأ
ceph orch apply cephfs-mirror --placement="1 ceph-node2"
ceph mgr module enable mirroring
ceph fs snapshot mirror enable fs01
ceph fs snapshot mirror peer_bootstrap import fs01 <token>
ceph fs snapshot mirror add fs01 /projects
ceph fs snapshot mirror peer_list fs01آینهسازی CephFS یکطرفه و مبتنی بر snapshot است؛ RPO برابر فاصلهی snapshotهاست. آن را با snap-schedule ترکیب کنید تا snapshotها مرتب ساخته شوند. فایلسیستم مقصد در زمان عادی فقط باید خوانده شود.
۶-۸-۲ ادعای «جایگزین HDFS»#
در منابع قدیمیتر اجرای Hadoop روی CephFS بهجای HDFS زیاد توصیه میشد. وضعیت امروز:
- پلاگین
cephfs-hadoop سالهاست نگهداری فعال ندارد و در مستندات جاری بهعنوان مسیر توصیهشده نیامده است. - اکوسیستم دادهی بزرگ به سمت ذخیرهسازی شیء رفته است: Spark، Trino، Hive و Iceberg از طریق رابط S3A مستقیماً با RGW کار میکنند (فصل ۴).
- برای بارهایی که POSIX واقعاً لازم دارند (مثلاً آموزش مدلهای یادگیری ماشین با کتابخانههایی که فایل باز میکنند)، CephFS مستقیماً با کلاینت هسته mount میشود.
اگر امروز «Hadoop روی Ceph» از شما خواسته شد، تقریباً همیشه منظور «Spark یا Trino روی RGW با S3A» است. نکات کلیدی آن: فعال کردن path-style یا DNS درست برای bucketها، استفاده از committerهای مخصوص S3 (مثل magic committer) و مراقبت از تعداد اشیای هر bucket و reshard (فصل ۴).
۶-۹ عملیات و عیبیابی#
۶-۹-۱ پایش روزانه#
ceph fs status
ceph health detail | grep -i mds
ceph tell mds.fs01:0 session ls # فهرست کلاینتهای rank 0
ceph tell mds.fs01:0 perf dump mds_server
ceph tell mds.fs01:0 dump_ops_in_flight
ceph tell mds.fs01:0 cache status| هشدار | معنی | اقدام |
|---|---|---|
| MDS_CACHE_OVERSIZED | cache از سقف تعیینشده بزرگتر شده است | کلاینتهایی که capability زیادی نگه داشتهاند را پیدا کنید؛ در صورت نیاز mds_cache_memory_limit را بالا ببرید |
| MDS_CLIENT_RECALL | کلاینت به درخواست آزادسازی cache پاسخ نمیدهد | نسخهی کلاینت را بررسی کنید؛ ممکن است لازم باشد evict شود |
| MDS_HEALTH_CLIENT_LATE_RELEASE | کلاینت capability را دیر آزاد میکند | شبکه و فرایندهای معلق روی کلاینت |
| MDS_SLOW_REQUEST | درخواستهای فراداده کند | dump_ops_in_flight، کندی OSDهای pool فراداده |
| MDS_TRIM | journal عقب افتاده است | سلامت و تأخیر pool فراداده |
| FS_DEGRADED | یک یا چند rank فعال نیست | وضعیت MDSها و standbyها |
| MDS_INSUFFICIENT_STANDBY | کمتر از standby_count_wanted آمادهبهکار | MDS اضافه کنید |
۶-۹-۲ evict کردن کلاینت#
ceph tell mds.fs01:0 client ls | grep -E '"id"|hostname'
ceph tell mds.fs01:0 client evict id=4305
ceph osd blocklist lsکلاینتی که mount آن «یخ زده» است (هر ls معلق میماند) معمولاً evict شده است. dmesg روی کلاینت هسته را ببینید. پس از رفع علت، mount را با umount -f یا umount -l جدا و دوباره mount کنید. گزینهی recover_session=clean کلاینت هسته میتواند پس از evict خودکار دوباره وصل شود، اما دادهی کثیف cacheشده از دست میرود.
۶-۹-۳ خرابی فراداده#
ابزارهای cephfs-journal-tool، cephfs-data-scan و cephfs-table-tool برای بازیابی فرادادهی آسیبدیده وجود دارند. این ابزارها خطرناکاند و اشتباه در ترتیب اجرای آنها میتواند وضع را بدتر کند.
پیش از هر اقدام بازیابی فراداده، از journal پشتیبان بگیرید (cephfs-journal-tool --rank=fs01:0 journal export backup.bin) و دقیقاً مراحل صفحهی «Disaster recovery» مستندات CephFS را دنبال کنید. اگر دادهی مهمی در خطر است، قبل از اجرای cephfs-data-scan از متخصص یا فهرست پستی جامعه کمک بگیرید.
- pool فراداده: تکثیری، روی SSD/NVMe، با CRUSH rule جدا.
- همیشه حداقل یک MDS آمادهبهکار؛ برای failover سریع standby-replay.
- چند MDS فعال فقط وقتی لازم است؛ pinning صریح به جای balancer خودکار.
- هر کلاینت کاربر خودش با
ceph fs authorize و مسیر محدود. - RAM کافی برای MDS:
mds_cache_memory_limit بهعلاوهی سربار (حدود ۱.۵ برابر). - quota همکارانه است؛ برای جداسازی سخت، capability مسیر و namespace RADOS.
- clone در CephFS کپی کامل است و کند.
۶-۱۰ تکمیلی و بهروز#
- Pacific: پشتیبانی از چند فایلسیستم در کلاسترهای تازه بهصورت پیشفرض فعال شد (کلاسترهای قدیمیتر هنوز پرچم
enable_multiple لازم دارند) و آینهسازی snapshot با cephfs-mirror معرفی شد. - نسخههای بعدی: رابط subvolume مدام گسترش یافته است؛ نحو جاری
ceph fs subvolume create گزینههایی مثل --earmark، --normalization، --casesensitive و --namespace-isolated دارد که در کتاب ۲۰۱۹ وجود نداشتند. - Tentacle: ماژول smb برای مدیریت Samba، پوشههای غیرحساس به حروف و نرمالسازی نامها، نیاز به تأیید صریح برای تغییر
max_mds روی کلاستر ناسالم، و پشتیبانی Dashboard از NVMe/TCP. - مسیر قدیمی کتاب: ساخت MDS با ceph-deploy و mount با نحو IP قدیمی؛ امروز
ceph fs volume create و نحو v2 جایگزین شدهاند.
جزئیات هر نسخه را در یادداشتهای انتشار رسمی بخوانید؛ این فصل فقط تغییراتی را آورده که در مستندات جاری تأیید شدهاند.
۶-۱۱ تمرین عملی#
- ۱. فایلسیستم
lab-fs را با ceph fs volume create و دو MDS بسازید و standby-replay را فعال کنید. MDS فعال را با ceph mds fail lab-fs:0 از کار بیندازید و زمان failover را با ceph fs status اندازه بگیرید. - ۲. کاربر
client.lab را با دسترسی خواندنینوشتنی فقط به /lab بسازید. با کلاینت هسته mount کنید و بررسی کنید که به / دسترسی نوشتن ندارد. - ۳. quota یک گیگابایتی روی
/lab بگذارید و با dd از آن عبور کنید. چه خطایی میبینید و چه مقدار بیش از quota نوشته شد؟ - ۴. یک subvolume با سقف ۵ گیگابایت بسازید، snapshot بگیرید، فایلی را حذف و از
.snap بازیابی کنید. - ۵. یک خوشهی NFS با ingress بسازید، export تعریف کنید و از یک ماشین بدون بستههای Ceph آن را mount کنید.
- ۶. snap-schedule ساعتی با نگهداری ۶ عددی تعریف کنید و پس از چند ساعت خروجی
status را بررسی کنید.
۶-۱۲ پرسشهای مرور#
- ۱. چرا MDS در مسیر دادهی فایلها قرار ندارد و این چه مزیتی دارد؟
- ۲. capability چیست و چه زمانی MDS یک کلاینت را evict میکند؟
- ۳. تفاوت standby و standby-replay چیست؟
- ۴. چرا pool دادهی پیشفرض CephFS نباید EC باشد؟
- ۵. چه زمانی چند MDS فعال لازم است و چرا pinning صریح توصیه میشود؟
- ۶. کلاینت هسته و ceph-fuse را از نظر کارایی و بهروز بودن مقایسه کنید.
- ۷. چرا NFS-Ganesha پیکربندی exportها را در RADOS نگه میدارد؟
- ۸. چرا quota در CephFS «همکارانه» نامیده میشود؟
- ۹. چرا تغییر layout یک پوشه فایلهای موجود را جابهجا نمیکند؟
- ۱۰. امروز جایگزین معمول «Hadoop روی CephFS» چیست؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۶-۱۳ منابع این فصل#
- CephFS
https://docs.ceph.com/en/latest/cephfs/ - FS volumes and subvolumes
https://docs.ceph.com/en/latest/cephfs/fs-volumes/ - Mount using kernel driver
https://docs.ceph.com/en/latest/cephfs/mount-using-kernel-driver/ - Mount using FUSE
https://docs.ceph.com/en/latest/cephfs/mount-using-fuse/ - Client authentication
https://docs.ceph.com/en/latest/cephfs/client-auth/ - Configuring multiple active MDS
https://docs.ceph.com/en/latest/cephfs/multimds/ - Standby daemons
https://docs.ceph.com/en/latest/cephfs/standby/ - MDS cache configuration
https://docs.ceph.com/en/latest/cephfs/cache-configuration/ - Snapshot scheduling
https://docs.ceph.com/en/latest/cephfs/snap-schedule/ - CephFS mirroring
https://docs.ceph.com/en/latest/cephfs/cephfs-mirroring/ - NFS module
https://docs.ceph.com/en/latest/mgr/nfs/ - SMB module
https://docs.ceph.com/en/latest/mgr/smb/ - Quotas
https://docs.ceph.com/en/latest/cephfs/quota/ - File layouts
https://docs.ceph.com/en/latest/cephfs/file-layouts/ - Health messages
https://docs.ceph.com/en/latest/cephfs/health-messages/ - Disaster recovery
https://docs.ceph.com/en/latest/cephfs/disaster-recovery/ - Tentacle release notes
https://docs.ceph.com/en/latest/releases/tentacle/