بازیابی از فاجعه: rbd-mirror، stretch mode و نجات کلاستر
حوصله ندارم این فصل در چند خط
- تکثیر پشتیبان نیست: به نسخهای هم نیاز دارید که از دسترس همان اعتبارنامهها دور باشد، مثل snapshot محافظتشده یا کلاستری دیگر.
- rbd-mirror در مقصد اجرا میشود و داده را میکشد؛ حالت snapshot انتخاب پیشفرض معمول است و حالت journal برای RPO چندثانیهای.
- stretch mode یک کلاستر را با یک MON داور روی دو سایت نگه میدارد تا با از دست رفتن کامل یک سایت، RPO صفر بماند.
- اگر همهی MONها از دست بروند، store مانیتور را میتوان از روی OSDها بازسازی کرد؛
ceph-objectstore-tool میتواند PGها را از دیسک خوانای یک OSD مرده export و import کند.
۱۸-۱ پیش از شروع#
۱۸-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
«بازیابی از فاجعه» در Ceph یک قابلیت واحد نیست، بلکه چند لایهی دفاعی است که هر کدام از نوع خاصی از فاجعه محافظت میکنند. تکثیر سهتایی از خرابی دیسک و میزبان محافظت میکند، اما در برابر حذف اشتباه یک pool، باجافزار یا از دست رفتن کامل یک مرکز داده کاری از دستش برنمیآید. این فصل لایهها را از درون یک کلاستر تا نسخهی پشتیبان مستقل مرور میکند و دو سازوکار اصلی را تا سطح کد شرح میدهد: rbd-mirror و stretch mode.
- RPO و RTO هر لایه چیست و کدام لایه در برابر کدام فاجعه محافظت میکند؟
- rbd-mirror در دو حالت journal و snapshot چگونه کار میکند؟
- failover برنامهریزیشده و اضطراری چه تفاوتی دارند و split-brain چگونه رفع میشود؟
- stretch mode چگونه یک کلاستر را روی دو سایت با RPO صفر نگه میدارد؟
- اگر همهی MONها از دست بروند، چگونه از روی OSDها نقشهها را بازسازی کنیم؟
- چه چیزهایی را باید جدا از Ceph پشتیبان گرفت؟
۱۸-۲ لایههای دفاعی#
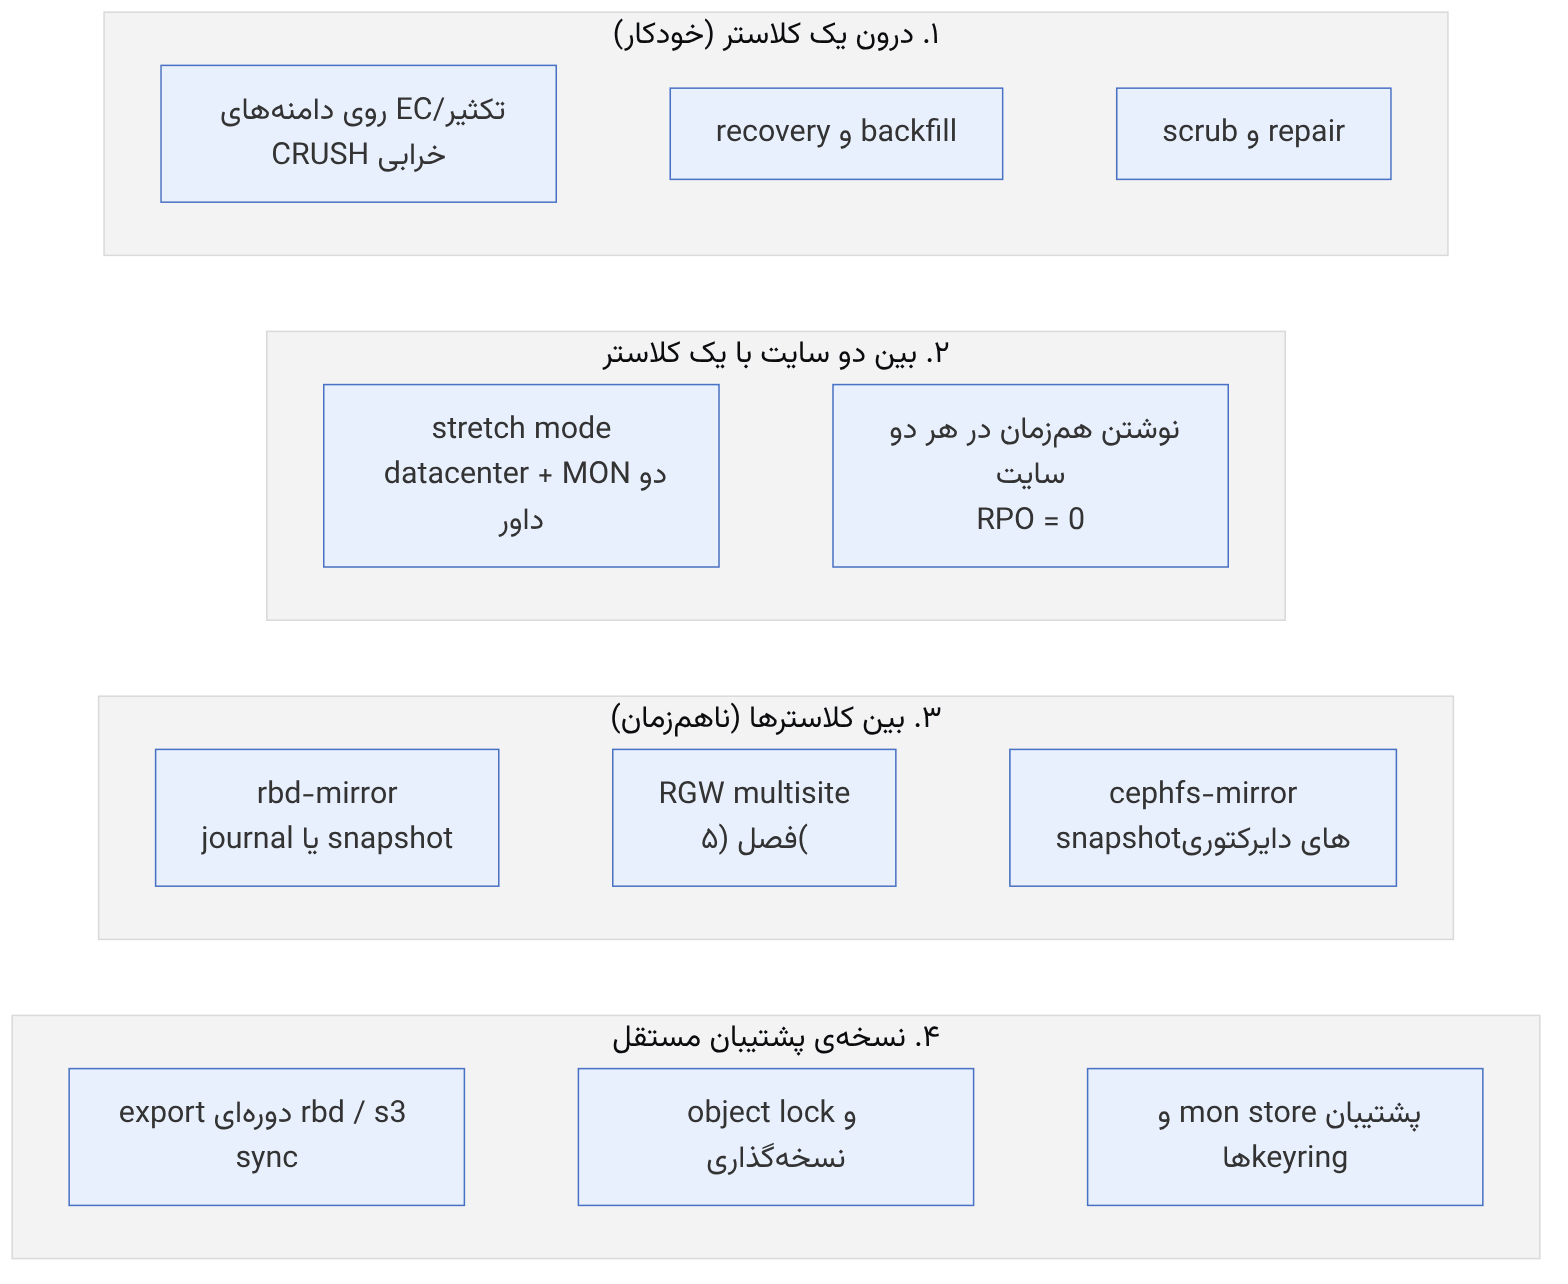
| لایه | محافظت در برابر | محافظت نمیکند در برابر | RPO تقریبی |
|---|---|---|---|
| تکثیر/EC درون کلاستر | خرابی دیسک، میزبان، رک | حذف اشتباه، باگ نرمافزار، از دست رفتن سایت | صفر |
| stretch mode | از دست رفتن یک سایت | حذف اشتباه، خرابی همزمان هر دو سایت | صفر |
| rbd-mirror / multisite | از دست رفتن کامل کلاستر یا سایت | حذف اشتباه (تکثیر میشود!) | ثانیهها تا دقیقهها |
| پشتیبان مستقل با object lock | حذف اشتباه، باجافزار، خرابی منطقی | — | بازهی پشتیبانگیری |
تکثیر، پشتیبان نیست. rbd rm روی سایت primary یا حذف یک bucket با تکثیر ناهمزمان به سایت دوم هم منتقل میشود. برای خطای انسانی و باجافزار به نسخهای نیاز دارید که از دسترس همان اعتبارنامهها خارج باشد: snapshotهای محافظتشده، object lock در حالت COMPLIANCE، یا پشتیبان در سامانهی دیگری.
۱۸-۳ rbd-mirror#
۱۸-۳-۱ دو حالت#
| ویژگی | journal-based | snapshot-based |
|---|---|---|
| سازوکار | هر نوشتن ابتدا در journal تصویر (اشیای RADOS) ثبت و سپس replay میشود | snapshotهای mirror دورهای و انتقال تفاوت بین آنها |
| سازگاری | crash-consistent در هر لحظه، ترتیب نوشتن حفظ میشود | crash-consistent در مرز هر snapshot |
| سربار نوشتن | هر نوشتن دو بار (یک بار در journal و یک بار در تصویر) | کم؛ فقط هنگام ساخت snapshot و انتقال تفاوت |
| RPO | ثانیهها | بازهی زمانبندی (مثلاً ۵ تا ۱۵ دقیقه) |
| کلاینت هسته (krbd) | ویژگی journaling در krbd پشتیبانی نمیشود (فهرست ویژگیهای هستهی خود را بررسی کنید) | قابل استفاده |
| پیشنیاز | ویژگی تصویر journaling (نیازمند exclusive-lock)؛ از Jewel | زمانبندی snapshot در mgr؛ از Octopus |
برای بیشتر استقرارهای امروزی، حالت snapshot انتخاب پیشفرض بهتری است: سربار نوشتن کمی دارد، با krbd کار میکند و رفتارش سادهتر است. journal را برای بارهایی نگه دارید که RPO چندثانیهای واقعاً لازم دارند و هزینهی نوشتن مضاعف را میپذیرند.
۱۸-۳-۲ راهاندازی (حالت snapshot)#
# روی هر دو کلاستر: سرویس rbd-mirror (در cephadm)
ceph orch apply rbd-mirror --placement=1
# سایت A
rbd mirror pool enable --site-name site-a vmpool image
rbd mirror pool peer bootstrap create --site-name site-a vmpool > /tmp/token
# سایت B (انتقال امن token؛ شامل کلید cephx است)
rbd mirror pool enable --site-name site-b vmpool image
rbd mirror pool peer bootstrap import --site-name site-b --direction rx-tx vmpool /tmp/token
# فعالسازی برای یک تصویر و زمانبندی
rbd mirror image enable vmpool/db01 snapshot
rbd mirror snapshot schedule add --pool vmpool 15m
rbd mirror snapshot schedule status --pool vmpool
rbd mirror pool status vmpool --verbosetoken خروجی peer bootstrap create حاوی اعتبارنامهی cephx برای دسترسی سایت مقابل است. آن را مانند رمز عبور منتقل و پس از import حذف کنید؛ در لاگها یا تیکتها قرار ندهید.
۱۸-۴ از درون کد: rbd-mirror#
۱۸-۴-۱ ساختار daemon#
rbd-mirror (src/tools/rbd_mirror/) یک daemon مستقل است که در کلاستر مقصد اجرا میشود و از کلاستر مبدأ میکشد (pull). برای هر pool یک PoolReplayer و برای هر تصویر یک ImageReplayer میسازد. ImageReplayer بسته به حالت تصویر، یکی از دو پیادهسازی را به کار میگیرد: image_replayer/journal/Replayer یا image_replayer/snapshot/Replayer. چند daemon rbd-mirror در یک کلاستر با هم هماهنگ میشوند (از راه leader election روی اشیای RADOS) و تصویرها را بین خود تقسیم میکنند.
۱۸-۴-۲ حالت snapshot: الگوریتم#
هر mirror snapshot در فضای نام snapshot با ساختار MirrorSnapshotNamespace (src/cls/rbd/cls_rbd_types.h) ثبت میشود. فیلدهای کلیدی:
| فیلد | معنا |
|---|---|
| state | PRIMARY، PRIMARY_DEMOTED، NON_PRIMARY یا NON_PRIMARY_DEMOTED |
| complete | برای snapshot مقصد: آیا کپی تفاوت کامل شده است |
| mirror_peer_uuids | peerهایی که هنوز به این snapshot نیاز دارند |
| primary_mirror_uuid / primary_snap_id | در مقصد: snapshot متناظر در مبدأ |
| last_copied_object_number | نقطهی ادامه برای کپی ناتمام |
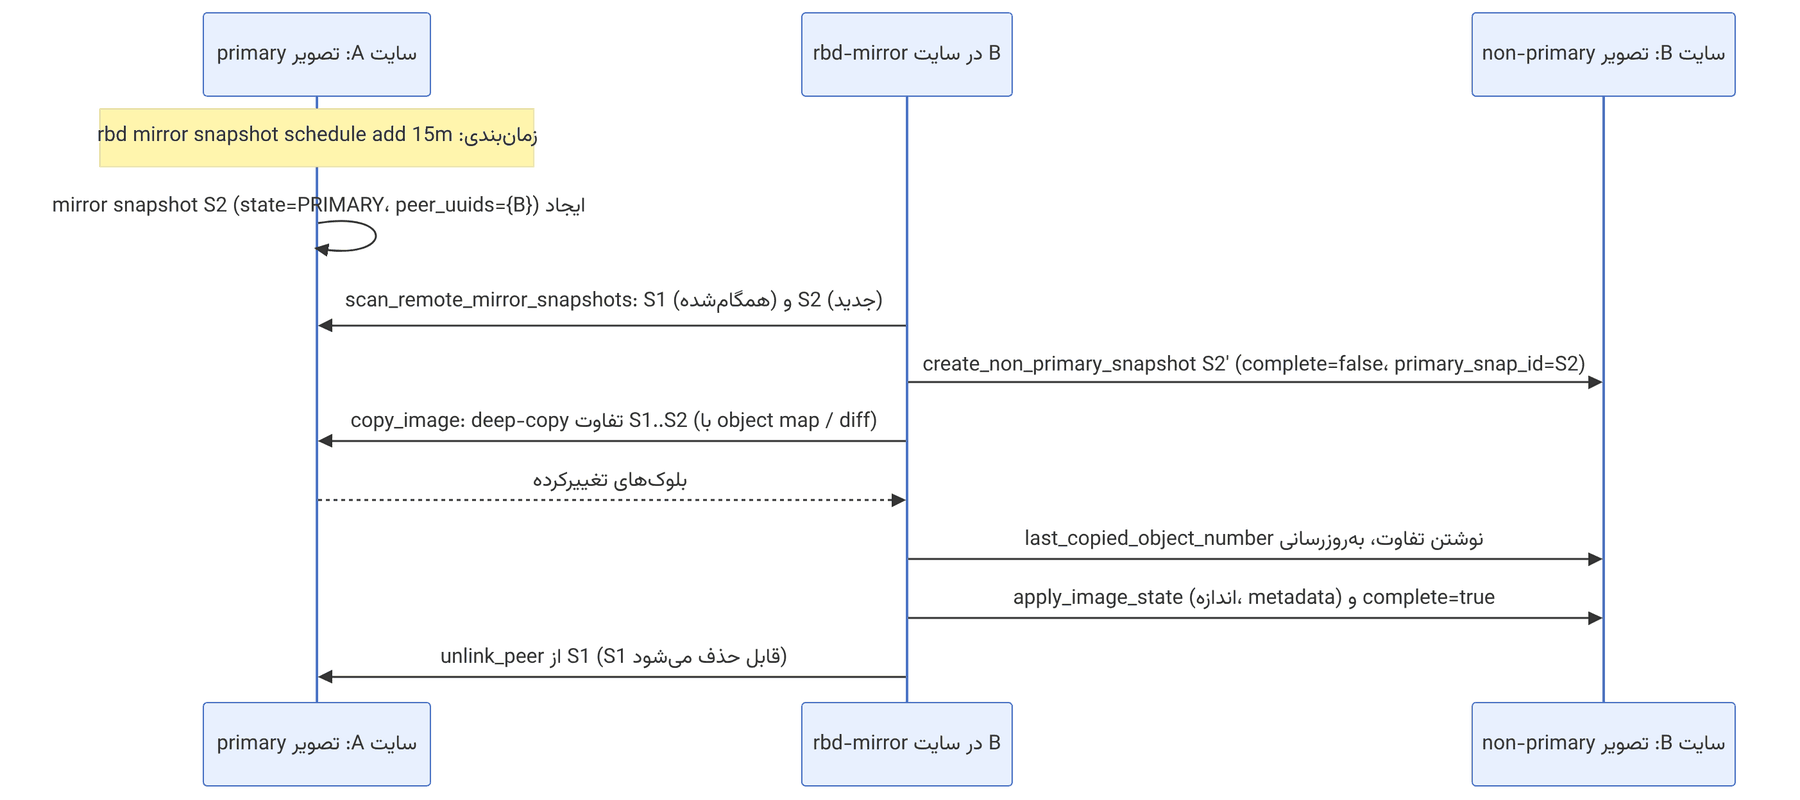
ترتیب توابع در snapshot/Replayer.cc دقیقاً همین مسیر را دنبال میکند: load_local_image_meta → refresh_remote_image / refresh_local_image → scan_local_mirror_snapshots → scan_remote_mirror_snapshots → create_non_primary_snapshot → copy_image → apply_image_state → update_non_primary_snapshot(complete=true) → unlink_peer.
pseudocode: یک دور Replayer (بازنویسی این کتاب)
local_last = آخرین snapshot کامل NON_PRIMARY در مقصد
remote_from = snapshot مبدأ متناظر با local_last.primary_snap_id
remote_to = نخستین snapshot PRIMARY بعد از remote_from که peer ما در mirror_peer_uuids آن است
if none: wait for remote image update notification; return
if local has incomplete snapshot for remote_to: resume from last_copied_object_number
else: create_non_primary_snapshot(remote_to, complete=false)
deep_copy(remote, local, snap range = (remote_from, remote_to]) # فقط اشیای تغییرکرده
apply_image_state(size, metadata, snapshot names)
mark local snapshot complete
unlink_peer(remote_from) # مبدأ میتواند snapshot قدیمی را prune کندچرا «complete=false» مهم است؟ اگر rbd-mirror وسط کپی متوقف شود، تصویر مقصد ترکیبی از S1 و بخشی از S2 است، یعنی ناسازگار. وجود snapshot ناقص به ابزارها میگوید آخرین نقطهی سازگار، snapshot کامل قبلی است. هنگام promote اضطراری، librbd تصویر مقصد را به آخرین snapshot کامل برمیگرداند (مرحلهی rollback در librbd/mirror/snapshot/PromoteRequest.cc) تا برنامه دادهی سازگار ببیند. این همان تضمین crash-consistency در مرز snapshot است.
۱۸-۴-۳ حالت journal: الگوریتم#
در حالت journal، librbd هر نوشتن را پیش از اعمال روی تصویر به journal (کتابخانهی src/journal/ که رویدادها را در اشیای RADOS همان pool ذخیره میکند) اضافه میکند. rbd-mirror در مقصد با init_remote_journaler به journal مبدأ وصل میشود، رویدادها را میخواند، با preprocess_entry (مثلاً نگاشت شناسهی snapshotها) آماده و با process_entry روی تصویر محلی replay میکند. موقعیت replay با flush_commit_position در journal مبدأ ثبت میشود تا مبدأ بتواند بخشهای مصرفشده را trim کند.
اگر rbd-mirror مقصد مدتی طولانی کار نکند، journal مبدأ رشد میکند و فضا مصرف میشود. سقف و رفتار آن با گزینههایی مانند rbd_journal_max_payload_bytes و rbd_mirroring_resync_after_disconnect و تنظیمات journal کنترل میشود؛ پایش rbd mirror pool status و هشدار برای تصاویر در وضعیت unknown یا error ضروری است.
۱۸-۴-۴ failover و failback#
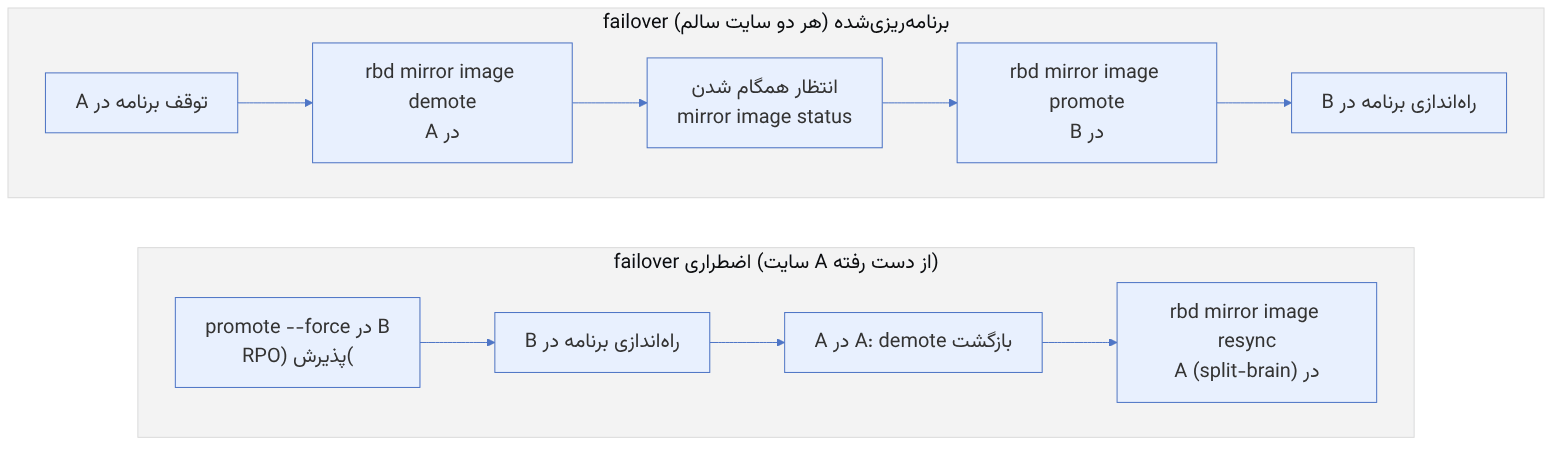
# برنامهریزیشده
rbd --cluster site-a mirror image demote vmpool/db01
rbd --cluster site-b mirror image status vmpool/db01 # منتظر up+replaying و همگامی
rbd --cluster site-b mirror image promote vmpool/db01
# اضطراری (سایت A در دسترس نیست)
rbd --cluster site-b mirror image promote --force vmpool/db01
# پس از بازگشت A: جلوگیری از دو primary
rbd --cluster site-a mirror image demote vmpool/db01
rbd --cluster site-a mirror image resync vmpool/db01پس از promote اجباری، اگر سایت A برگردد و تصویرش هنوز primary باشد، دو primary داریم (split-brain) و rbd-mirror همگامسازی را متوقف میکند. resync نسخهی محلی را دور میریزد و از نو از primary فعلی کپی میکند؛ هر نوشتنی که پس از قطع ارتباط روی A انجام شده از دست میرود. این را در runbook صریح بنویسید.
۱۸-۵ لایهی پایینتر: journal روی RADOS و ماشین حالت stretch#
۱۸-۵-۱ قالب journal در حالت journal-based mirroring#
کتابخانهی src/journal/ یک journal عمومی روی RADOS است و librbd فقط یکی از مصرفکنندههای آن است. هر تصویر یک شیء سرآیند با نام journal.<image_id> دارد که در omap آن order (اندازهی شیء)، splay_width، شمارهی set فعال، فهرست clientها (مثل rbd-mirror هر peer) و موقعیت commit هرکدام نگه داشته میشود. داده در اشیایی با نام journal_data.<pool_id>.<image_id>.<n> نوشته میشود (ثابتهای JOURNAL_HEADER_PREFIX و JOURNAL_OBJECT_PREFIX در Journaler.cc).
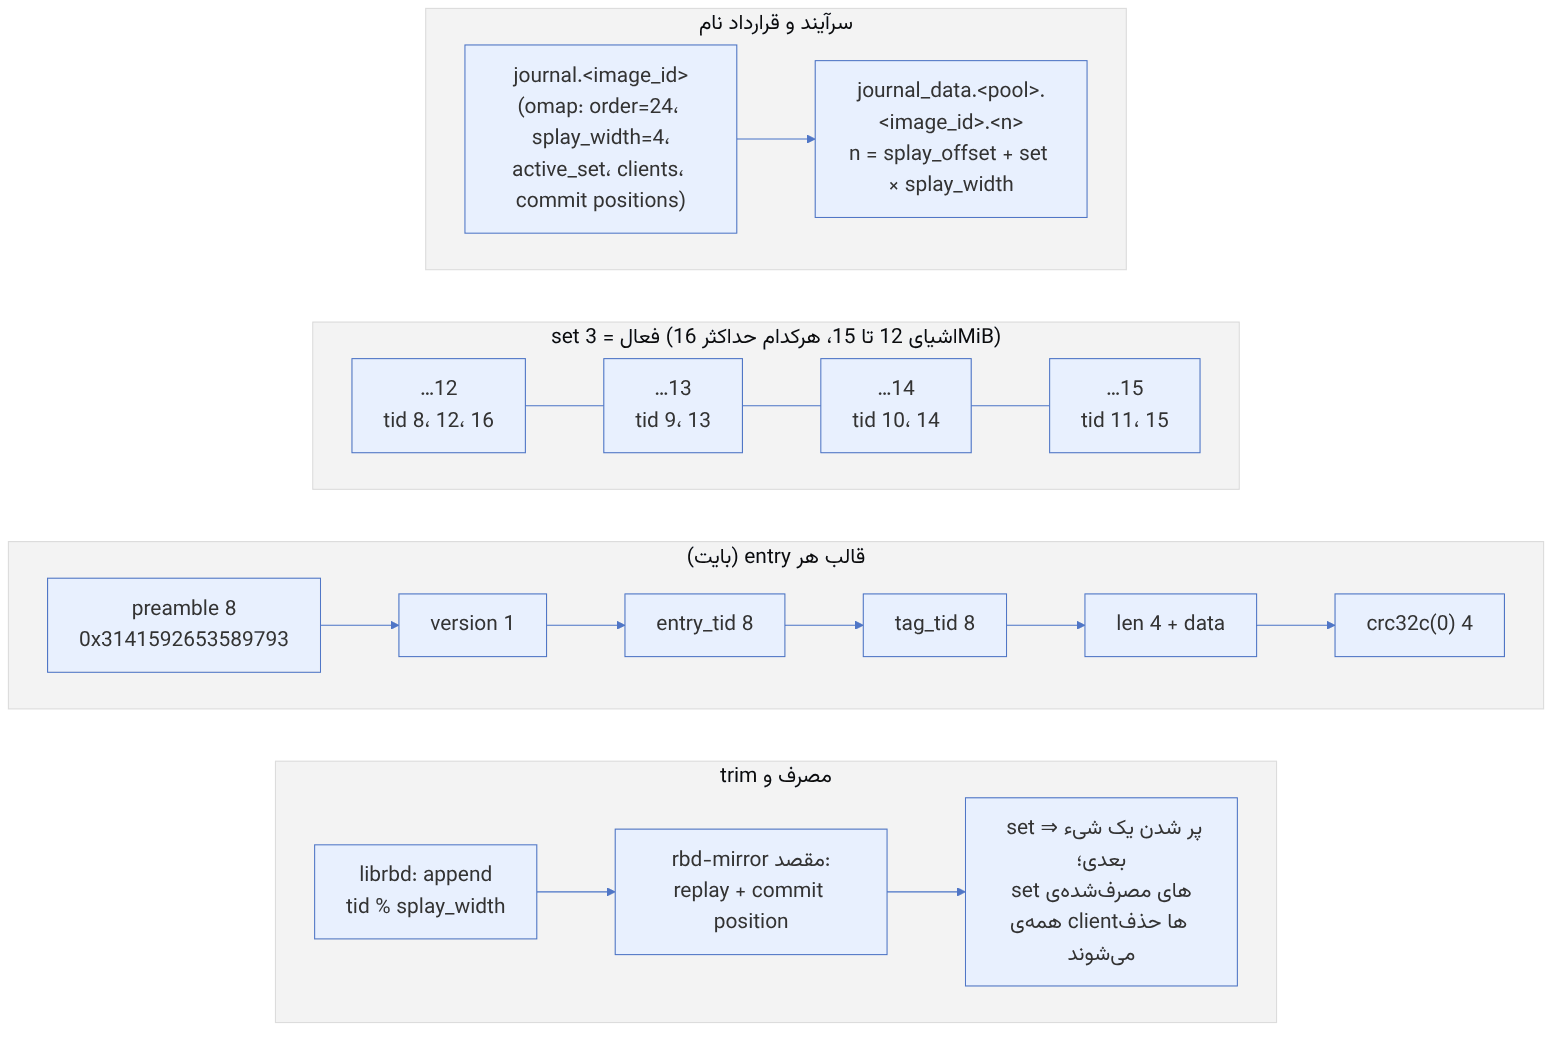
در JournalRecorder.cc دو رابطهی ساده همهچیز را تعیین میکنند:
splay_offset  = entry_tid % splay_width
object_number = splay_offset + active_set * splay_width
با پیشفرضها (rbd_journal_order=24 یعنی ۱۶MiB و rbd_journal_splay_width=4)، entry با tid=10 در set فعال ۳ به شیء شمارهی ۲+۳×۴=۱۴ میرود. پخش کردن entryها در چهار شیء، appendها را بین چهار PG (و معمولاً چهار OSD primary) پخش میکند تا یک شیء داغ گلوگاه نشود. هر set حداکثر ۴×۱۶MiB=64MiB داده دارد.
بایتهای یک entry#
Entry::encode بخش ثابت ۲۵ بایتی سرآیند (preamble، version، entry_tid، tag_tid) و بخش ثابت ۸ بایتی پایانی (طول داده و crc) را مینویسد. preamble عدد ثابت 0x3141592653589793 است (رقمهای π) که هنگام بازخوانی برای پیدا کردن مرز entry و تشخیص دادهی خراب بررسی میشود. crc با crc32c(0) روی همهچیز بهجز خود crc حساب میشود.
| آفست | طول | فیلد | مثال (tid=10، tag=1، داده «ABCD») |
|---|---|---|---|
| ۰ | ۸ | preamble (LE) | 93 97 58 53 26 59 41 31 |
| ۸ | ۱ | version | 01 |
| ۹ | ۸ | entry_tid | 0a 00 00 00 00 00 00 00 |
| ۱۷ | ۸ | tag_tid | 01 00 00 00 00 00 00 00 |
| ۲۵ | ۴ | طول داده | 04 00 00 00 |
| ۲۹ | ۴ | داده | 41 42 43 44 |
| ۳۳ | ۴ | crc32c(۰) بایتهای ۰ تا ۳۲ | 75 7d a6 34 (=۰x34A67D75) |
این مقدار crc را با پیادهسازی مستقل crc32c (چندجملهای Castagnoli، seed=0، بدون معکوسسازی نهایی، مثل ceph_crc32c) محاسبه کردهایم. همان تابع، مقدار استاندارد ۰xE3069283 را برای "۱۲۳۴۵۶۷۸۹" با seed=~0 و xor نهایی بازتولید میکند. در librbd، دادهی هر entry یک رویداد کدگذاریشدهی librbd (مثلاً AioWrite با offset، طول و بایتها) است و rbd_journal_max_payload_bytes=16K بزرگترین قطعهی داده در هر entry را محدود میکند. یک نوشتن ۶۴K به چند entry شکسته میشود.
هزینهی واقعی journal: هر نوشتن کلاینت دو بار نوشته میشود، یک بار در journal_data و یک بار در تصویر. علاوه بر این، librbd پیش از اعمال نوشتن روی تصویر منتظر ثبت امن آن در journal میماند. بنابراین تأخیر نوشتن تقریباً دو برابر و پهنای باند نوشتن pool دو برابر میشود. همین دلیل اصلی ترجیح snapshot-based mirroring در بیشتر استقرارهای امروزی است. اگر journal لازم است، میتوان آن را با rbd_journal_pool در pool سریعتری گذاشت.
rbd journal info --pool vmpool --image db01        # order، splay_width، object_pool
rbd journal status --pool vmpool --image db01      # active_set، minimum_set، موقعیت commit clientها
rados -p vmpool ls | grep '^journal_data\.' | sort -t. -k4 -n | tail -4
rbd journal inspect --pool vmpool --image db01 --verbose | head # بررسی سازگاری entryهاگزینههای مؤثر در rbd-mirror#
| گزینه | پیشفرض (main) | اثر |
|---|---|---|
rbd_mirror_concurrent_image_syncs | ۵ | بیشینهی همگامسازی کامل همزمان (bootstrap تصویر) |
rbd_mirroring_max_mirroring_snapshots | ۵ | سقف mirror snapshotها برای هر تصویر؛ قدیمیترها prune میشوند |
rbd_mirroring_replay_delay | ۰ | تأخیر عمدی replay (ثانیه) برای محافظت در برابر خطای انسانی |
rbd_mirror_memory_target | ۴G | هدف حافظهی daemon (cache) |
rbd_mirror_image_state_check_interval | ۳۰ | دورهی بررسی وضعیت تصاویر (ثانیه) |
rbd_mirror_concurrent_image_deletions | ۱ | حذف همزمان تصاویر حذفشده در مبدأ |
rbd_journal_commit_age | ۵ | حداکثر عمر commit position پیش از flush (ثانیه) |
rbd_mirroring_replay_delay یک «DR با تأخیر» میسازد. اگر کسی در مبدأ پایگاه داده را خراب کند، مقصد تا N ثانیه هنوز نسخهی سالم را دارد. این در حالت journal معنا دارد. در حالت snapshot، فاصلهی زمانبندی snapshot همین نقش را ایفا میکند.
۱۸-۵-۲ ماشین حالت stretch mode در کد#
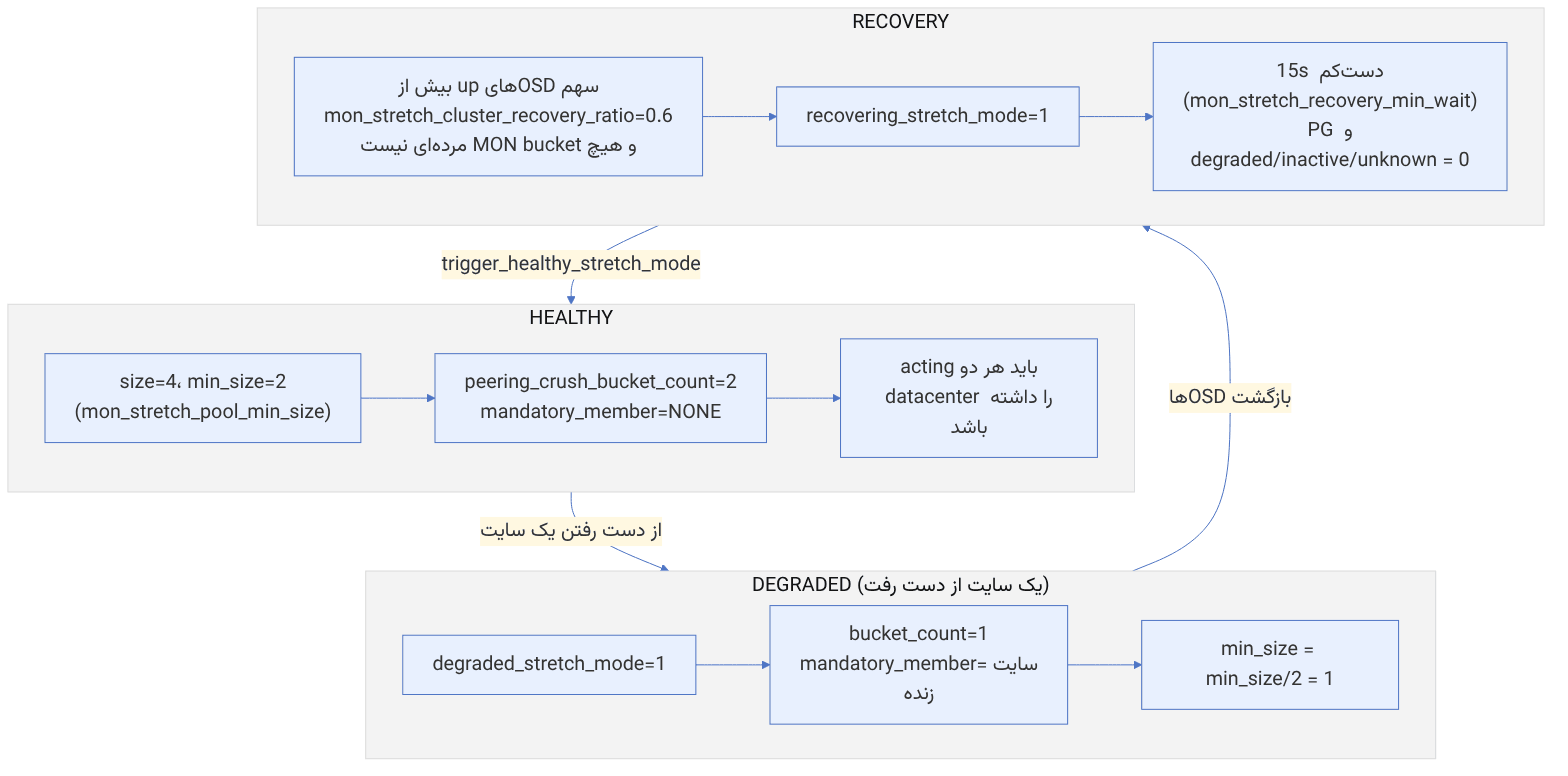
OSDMap در stretch mode پنج فیلد دارد: stretch_mode_enabled، stretch_bucket_count (تعداد سایتها، فعلاً ۲)، degraded_stretch_mode (۰ یا تعداد سایتهای زنده)، recovering_stretch_mode و stretch_mode_bucket (نوع bucket، مثلاً datacenter). هر pool کشیده هم چهار فیلد peering دارد: peering_crush_bucket_count، peering_crush_bucket_target، peering_crush_bucket_barrier و peering_crush_mandatory_member.
قلب ماجرا تابع pg_pool_t::stretch_set_can_peer است. پیش از آنکه یک PG بتواند با یک acting set فعال شود، اجداد OSDها در سطح barrier (datacenter) شمرده میشوند:
pseudocode: stretch_set_can_peer (خلاصه)
if pool is not stretch: return true
sites = { crush.parent_of_type(osd, barrier) for osd in want }
if |sites| < peering_crush_bucket_count: return false # همهی سایتها لازماند
if mandatory_member != NONE and mandatory_member not in sites: return false
return trueیعنی در حالت سالم، هیچ PG کشیدهای فقط با OSDهای یک سایت active نمیشود، حتی اگر به اندازهی min_size نسخه داشته باشد. این مانع اصلی split-brain است: اگر لینک بین سایتها قطع شود و MONها هنوز وضعیت را degraded نکرده باشند، PGها بهجای پذیرفتن نوشتن در یک سایت متوقف میشوند. فقط پس از تصمیم MONها (با داور) و ورود به DEGRADED، شمارش به ۱ کاهش مییابد و mandatory_member روی سایت زنده تنظیم میشود. سایت مرده حتی اگر برگردد، تا پایان recovery نمیتواند بهتنهایی PG را active کند.
| حالت | bucket_count | mandatory_member | min_size (size=۴) | تحمل |
|---|---|---|---|---|
| HEALTHY | ۲ | NONE | ۲ | از دست رفتن ۲ OSD با شرط حضور هر دو سایت |
| DEGRADED | ۱ | سایت زنده | ۱ | فقط سایت زنده؛ یک نسخه کافی است (ریسک بالا) |
| RECOVERY | ۱ (تا پایان) | سایت زنده | ۱ | backfill به سایت برگشته |
عدد min_size=1 را جدی بگیرید. در DEGRADED، min_size پیشفرض ۲ نصف و برابر ۱ میشود. اگر در همین دوره یکی از دو OSD باقیماندهی یک PG هم از دست برود، PG با یک نسخه به نوشتن ادامه میدهد و خرابی بعدی یعنی از دست رفتن داده. در دورهی degraded، تعویض دیسک و نگهداری برنامهریزیشده در سایت زنده را متوقف کنید.
وابسته به نسخه. جدول بالا از کد Squid خوانده شده است. در شاخهی main (پس از معرفی num_zones برای هر pool)، mon_stretch_pool_size=4 و mon_stretch_pool_min_size=2 در مستند گزینهها با برچسب LEGACY آمدهاند و فرمول min_size برای poolهای دارای num_zones متفاوت است. روی نسخهی خودتان ceph osd pool ls detail را بخوانید و دنبال peering_crush_bucket_count و min_size بگردید.
ceph osd dump | grep -E 'stretch_mode|degraded_stretch|recovering_stretch'
ceph osd pool ls detail | grep -E 'peering_crush|min_size'
ceph mon dump | grep -E 'tiebreaker|stretch|location'
ceph config get mon mon_stretch_cluster_recovery_ratio # 0.6۱۸-۶ بازیابی از فاجعه با عدد: امتیاز اتصال MONها، انتخابات connectivity و توزیع تصویرها در rbd-mirror#
سه الگوریتم این بخش تعیین میکنند در یک کلاستر دوسایتی کدام MON رهبر شود، و در rbd-mirror کدام daemon کدام تصویر را تکرار کند. ارجاعها به main در نوامبر ۲۰۲۶ است. سناریوها فرضیاند، اما همهی عددها با بازپیادهسازی پایتونی همان فرمولها حساب شدهاند.
۱۸-۶-۱ امتیاز اتصال هر جفت MON#
منبع در کد: src/mon/ConnectionTracker.cc :: report_live_connection، report_dead_connection، get_total_connection_score؛ src/mon/Elector.cc :: ping_check، dead_ping
پیچیدگی: O(۱) برای هر ping و O(تعداد MON) برای امتیاز کل
pseudocode
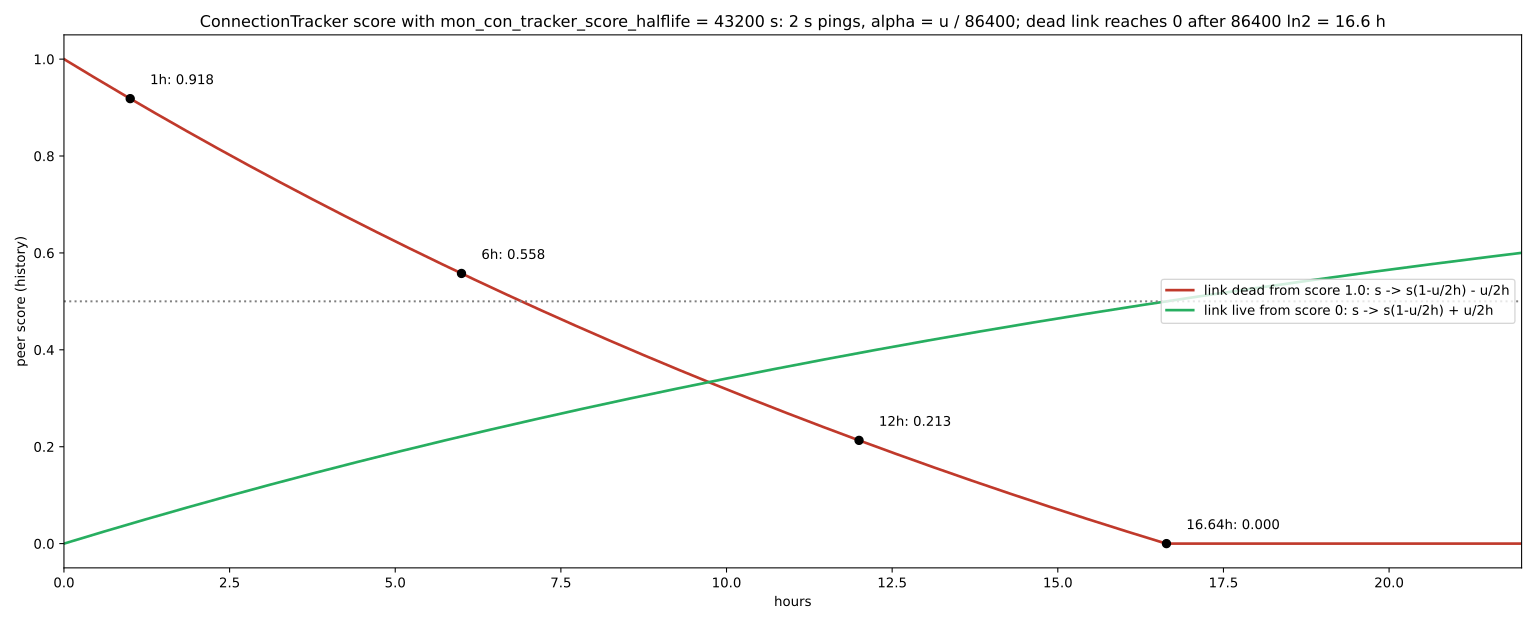
h = mon_con_tracker_score_halflife (43200 s) ؛ امتیاز اولیهی هر همتا 1.0
ping هر mon_elector_ping_timeout / divisor = 2 / 2 = 1 s ؛ پس از 2 s بیپاسخی، همتا «مرده» است
پاسخ زنده با فاصلهی u ثانیه: s = min(1, s × (1 − u/2h) + u/2h)
بیپاسخی u ثانیه (هر 2 s): s = max(0, s × (1 − u/2h) − u/2h)
score(r) = Σ روی گزارشهای دیگر MONها: history[r]، فقط اگر current[r] زنده باشدمثال عددی. با α = u / ۸۶۴۰۰، اتصالی که از امتیاز ۱ میمیرد پس از ۱۰ دقیقه به ۰.۹۸۶ میرسد، پس از یک ساعت به ۰.۹۱۸، پس از شش ساعت به ۰.۵۵۸، پس از دوازده ساعت به ۰.۲۱۳ و دقیقاً پس از ۵۹۸۸۸ ثانیه (۸۶۴۰۰ × ln 2، حدود ۱۶.۶ ساعت) به صفر. بازگشت هم با همان سرعت است: از ۰ تا ۰.۵ حدود ۱۶.۶ ساعت طول میکشد. این حافظهی طولانی عمدی است: اتصالی که مدام قطع و وصل میشود نباید با چند ping موفق دوباره «سالم» به حساب بیاید.
۱۸-۶-۲ انتخابات با راهبرد connectivity#
منبع در کد: src/mon/ElectionLogic.cc :: connectivity_election_score، propose_connectivity_handler
پیچیدگی: O(تعداد MON)
pseudocode
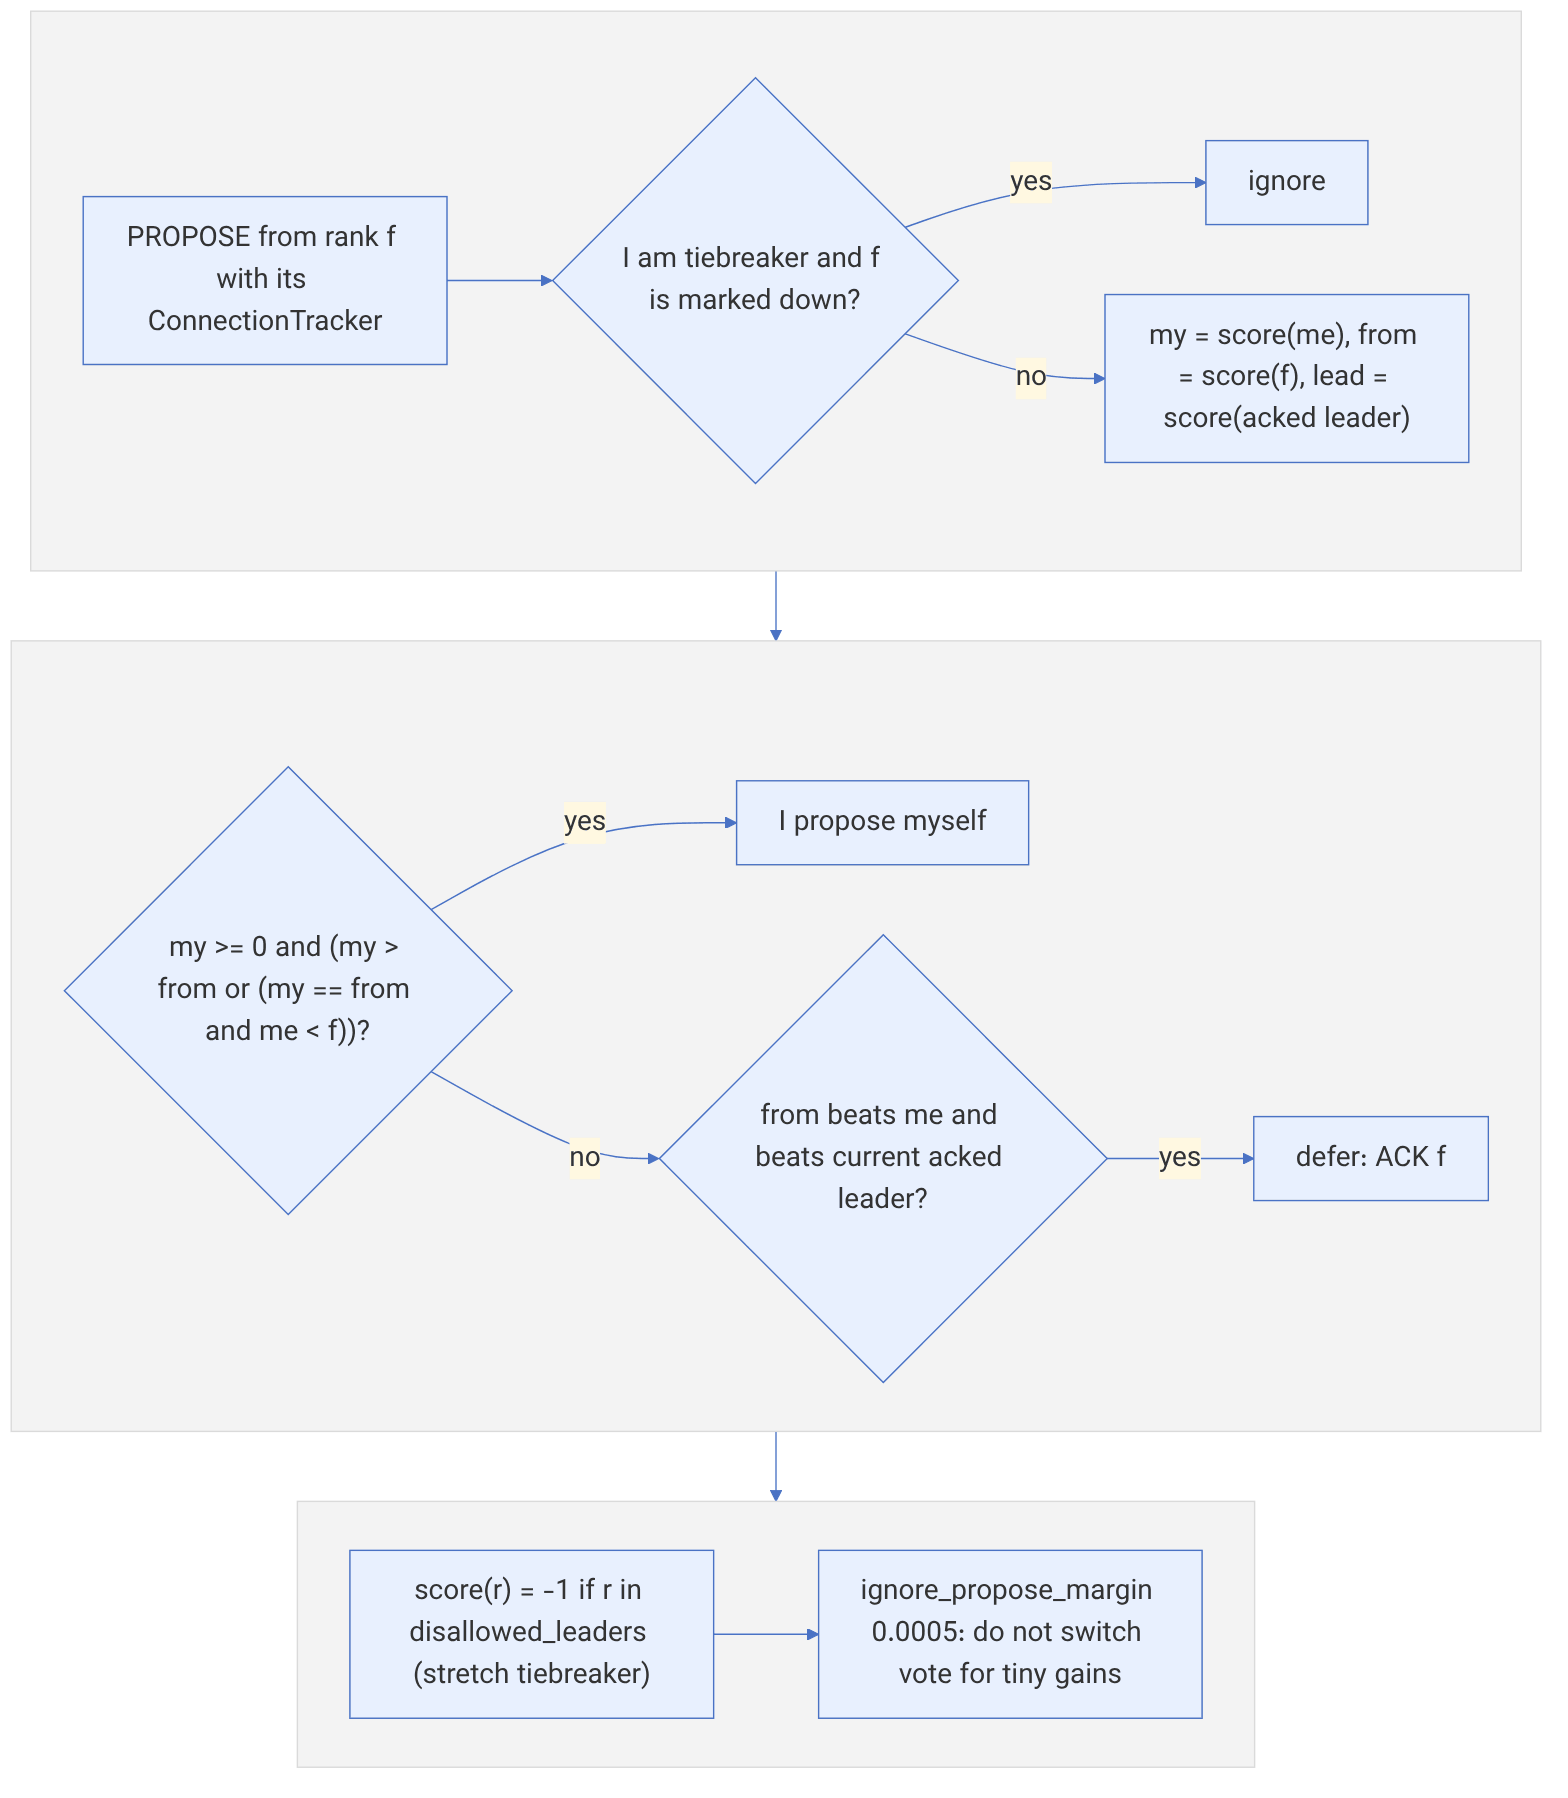
score(r) = −1 اگر r در disallowed_leaders باشد (مثلاً tiebreaker در stretch mode) ؛ وگرنه get_total_connection_score(r)
با دریافت PROPOSE از f:
اگر من tiebreaker هستم و f علامت down خورده: نادیده بگیر
my_win = my ≥ 0 و (my > from یا (my == from و rank من < f))
if my_win: خودم را پیشنهاد کن
elif from از من و از رهبر ackشدهی فعلی بهتر است: به f ACK بده
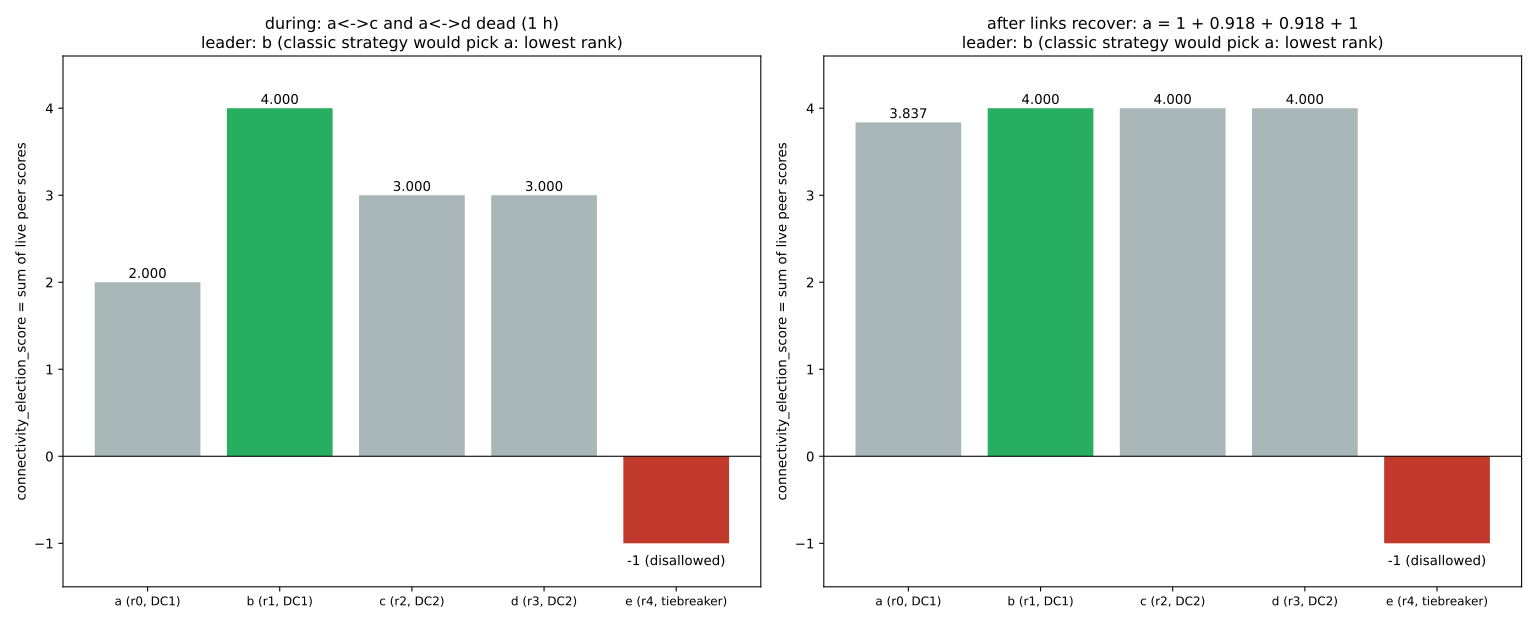
تغییر رأی برای بهبودی کمتر از mon_elector_ignore_propose_margin (0.0005) انجام نمیشودمثال عددی. پنج MON داریم: a و b در DC1، c و d در DC2، و e بهعنوان tiebreaker که رهبر شدنش ممنوع است. فرض کنید پیوند a با c و d یک ساعت قطع باشد و بقیه سالم باشند. امتیاز a فقط از گزارشهای زندهی b و e جمع میشود و ۲.۰ است. امتیاز b چهار است (۱ از هر یک از a، c، d و e). امتیاز c و d هر کدام ۳ است، چون گزارش a دربارهی آنها «مرده» است و شمرده نمیشود. پس b رهبر میشود. با راهبرد classic، a فقط به دلیل rank پایینتر رهبر میماند، در حالی که به نیمی از کلاستر دسترسی ندارد. پس از وصل شدن دوبارهی پیوندها، امتیاز a برابر ۱ + ۰.۹۱۸ + ۰.۹۱۸ + ۱ = ۳.۸۳۷ است و هنوز از b (۴.۰) کمتر است، پس رهبری عوض نمیشود. پیشفرض mon_election_default_strategy برابر ۱ (classic) است. stretch mode راهبرد connectivity را لازم دارد و با ceph mon set election_strategy connectivity تنظیم میشود.
۱۸-۶-۳ توزیع تصویرها بین daemonهای rbd-mirror#
منبع در کد: src/tools/rbd_mirror/image_map/SimplePolicy.cc :: calc_images_per_instance، do_shuffle_add_instances، do_map؛ src/tools/rbd_mirror/image_map/Policy.cc :: can_shuffle_image؛ src/tools/rbd_mirror/ImageMap.cc :: schedule_rebalance_task
پیچیدگی: O(تصویرها × نمونهها) برای هر جابهجایی
pseudocode
per = max(1, ⌊تعداد تصویرها / نمونههای زنده⌋)
هنگام افزوده شدن نمونه:
برای هر نمونه با بیش از per تصویر: cut = size − per
تصویرها را به ترتیب پیمایش کن: اگر در حال جابهجایی است cut−− ؛ elif can_shuffle: cut−− و آن را علامت بزن
can_shuffle = idle و (now − mapped_time ≥ rbd_mirror_image_policy_migration_throttle (300 s))
do_map(img) = نمونهی زنده با کمترین تصویر
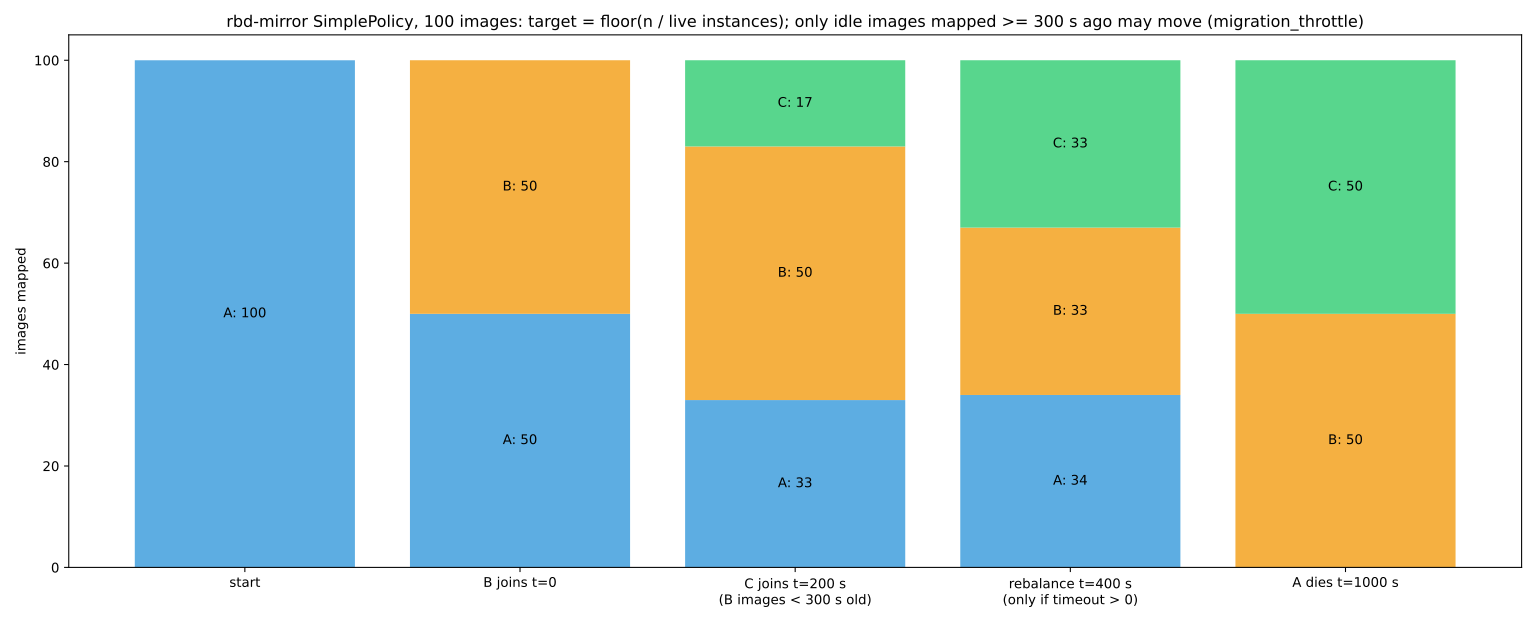
rebalance دورهای فقط اگر rbd_mirror_image_policy_rebalance_timeout > 0 باشد (پیشفرض 0 = خاموش)مثال عددی. ۱۰۰ تصویر قدیمی روی daemon A هستند. B در t = ۰ اضافه میشود: per = ۵۰، پس ۵۰ تصویر به B میروند (۵۰/۵۰). C در t = ۲۰۰ ثانیه اضافه میشود: per = ۳۳. A باید ۱۷ تصویر بدهد و میدهد. B هم باید ۱۷ تصویر بدهد، اما همهی تصویرهایش کمتر از ۳۰۰ ثانیه پیش نگاشت شدهاند، پس هیچکدام جابهجا نمیشود. نتیجه ۳۳/۵۰/۱۷ است. چون rebalance دورهای پیشفرض خاموش است، این نابرابری تا تغییر بعدی عضویت باقی میماند. اگر rbd_mirror_image_policy_rebalance_timeout مثلاً ۳۰۰ باشد، پس از آرام شدن نقشه دوباره پخش میشود و نتیجه ۳۴/۳۳/۳۳ خواهد بود. اگر A بمیرد، ۳۴ تصویرش یکییکی به کمبارترین نمونه میرسد و نتیجه ۵۰/۵۰ میشود. هر جابهجایی یعنی release و acquire دوبارهی تصویر و شروع replay از آخرین snapshot. پس نمونههای rbd-mirror را با هم بالا بیاورید، نه با فاصلهی چند دقیقه.
۱۸-۷ stretch mode: یک کلاستر روی دو سایت#
۱۸-۷-۱ مدل#
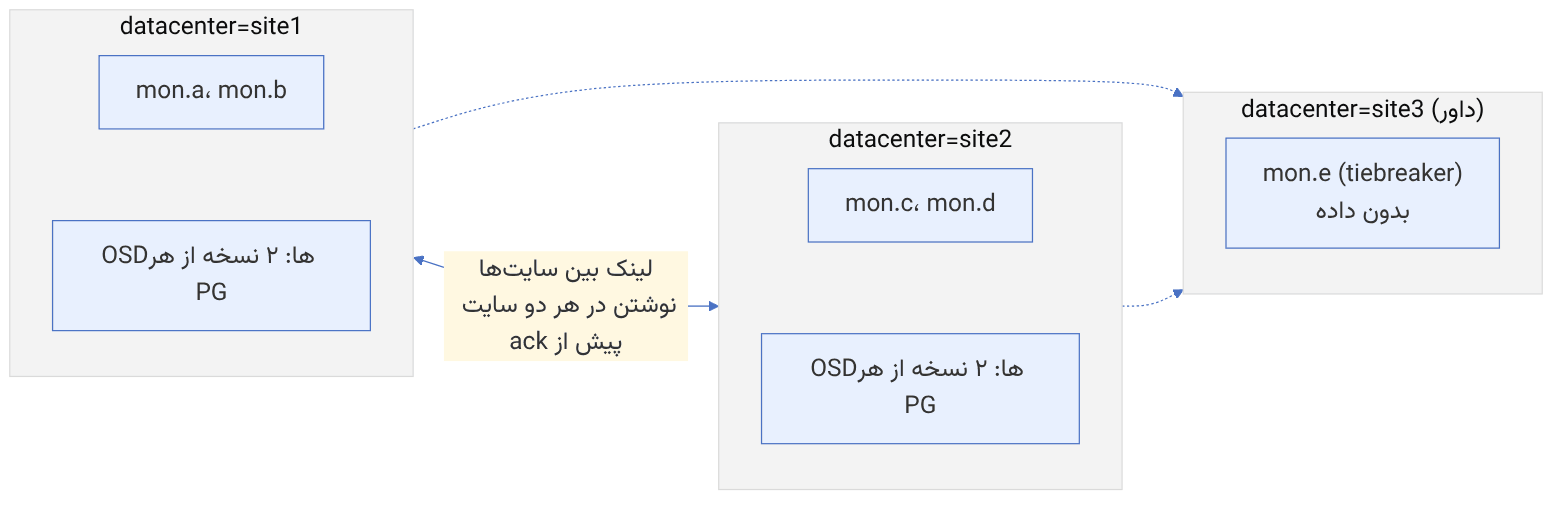
stretch mode برای وقتی است که دو مرکز داده با تأخیر کم (چند میلیثانیه) دارید و میخواهید از دست رفتن کامل یکی، بدون از دست رفتن داده (RPO صفر) و با ادامهی سرویس تحمل شود. هر سایت نسخهی کامل داده را نگه میدارد و یک MON داور (tiebreaker) در سایت سوم، که دادهای ندارد، هنگام قطع ارتباط دو سایت تعیین میکند کدام سایت فعال بماند.
۱۸-۷-۲ پیکربندی در نسخههای منتشرشده (Squid، Tentacle، Umbrella)#
روال کلی در مستندات این نسخهها:
- ۱. ساختن bucketهای
datacenter در CRUSH و انتقال میزبانها به آنها. - ۲. تعیین مکان هر MON با
ceph mon set_location <mon> datacenter=<site>. - ۳. ساختن قانون CRUSH که در هر datacenter دو نسخه قرار دهد (در مستندات با ویرایش نقشهی CRUSH).
- ۴. تغییر راهبرد انتخابات MON به
connectivity. - ۵. فعالسازی با
ceph mon enable_stretch_mode <tiebreaker-mon> <rule> datacenter.
ceph osd crush add-bucket site1 datacenter
ceph osd crush add-bucket site2 datacenter
ceph osd crush move site1 root=default
ceph osd crush move site2 root=default
ceph osd crush move stor-a1 datacenter=site1 # و سایر میزبانها
ceph mon set_location a datacenter=site1
ceph mon set_location b datacenter=site1
ceph mon set_location c datacenter=site2
ceph mon set_location d datacenter=site2
ceph mon set_location e datacenter=site3
ceph mon set election_strategy connectivity
ceph mon enable_stretch_mode e stretch_rule datacenterوابسته به نسخه. نام قانون در مثال مستندات Squid و Tentacle stretch_rule و در Umbrella stretch_replicated_rule است؛ نام قانون دلخواه است اما باید با قانونی که خودتان ساختهاید یکی باشد. مستندات شاخهی latest (نسخهی در حال توسعه) مدل تازهای را شرح میدهد که در آن هر pool با num_zones کشیده میشود، pool EC هم میتواند در دو zone پخش شود و فرمانهای ceph osd pool create ... --num_zones 2 و ceph osd pool default set معرفی شدهاند؛ این در صفحههای umbrella و tentacle وجود ندارد و پیش از استفاده باید نسخهی کلاستر خود را بررسی کنید.
۱۸-۷-۳ رفتار هنگام خرابی#
وقتی یک سایت از دست میرود، کلاستر وارد degraded stretch mode میشود: MONها با داور quorum میسازند و طبق مستندات Tentacle، min_size poolها به ۱ کاهش مییابد (size تغییر نمیکند) تا PGها با نسخههای سایت باقیمانده فعال بمانند؛ یعنی در این دوره فقط دو نسخه در یک سایت دارید و حاشیهی ایمنی کم است. پس از بازگشت سایت، کلاستر به حالت recovery میرود و پس از همگام شدن PGها، به حالت عادی برمیگردد.
stretch mode تأخیر نوشتن را به اندازهی رفتوبرگشت بین دو سایت افزایش میدهد، چون هر نوشتن پیش از ack باید در هر دو سایت ثبت شود. پیش از استقرار، RTT واقعی را اندازه بگیرید و بار نمونه را با آن بسنجید. MON داور باید در سایت سوم مستقل باشد؛ قرار دادن آن در یکی از دو سایت هدف را از بین میبرد.
۱۸-۸ وقتی همهی MONها از دست میروند#
۱۸-۸-۱ پیشگیری#
- دستکم سه و ترجیحاً پنج MON روی دیسکهای قابل اتکا با تنظیمات درست فلاش و نوشتن.
- از Umbrella: پشتیبان دورهای RocksDB مانیتور با
mon_backup_interval، پشتیبان دستی با ceph tell mon.* backup و بازیابی با ceph-mon --restore-backup (فصل ۸). این سادهترین و امنترین راه بازیابی MON است. - پشتیبان جدا از
ceph config dump، ceph auth export، و مشخصات سرویسهای ceph orch ls --export در جایی بیرون از کلاستر (رمزنگاریشده، چون شامل کلیدهاست).
۱۸-۸-۲ بازسازی از روی OSDها#
اگر پشتیبانی وجود ندارد، مستندات رسمی (Troubleshooting Monitors، بخش Monitor Store Failures) روالی برای بازسازی store مانیتور از نقشههایی ارائه میدهد که هر OSD نگه میدارد. خلاصهی آن به بیان این کتاب:
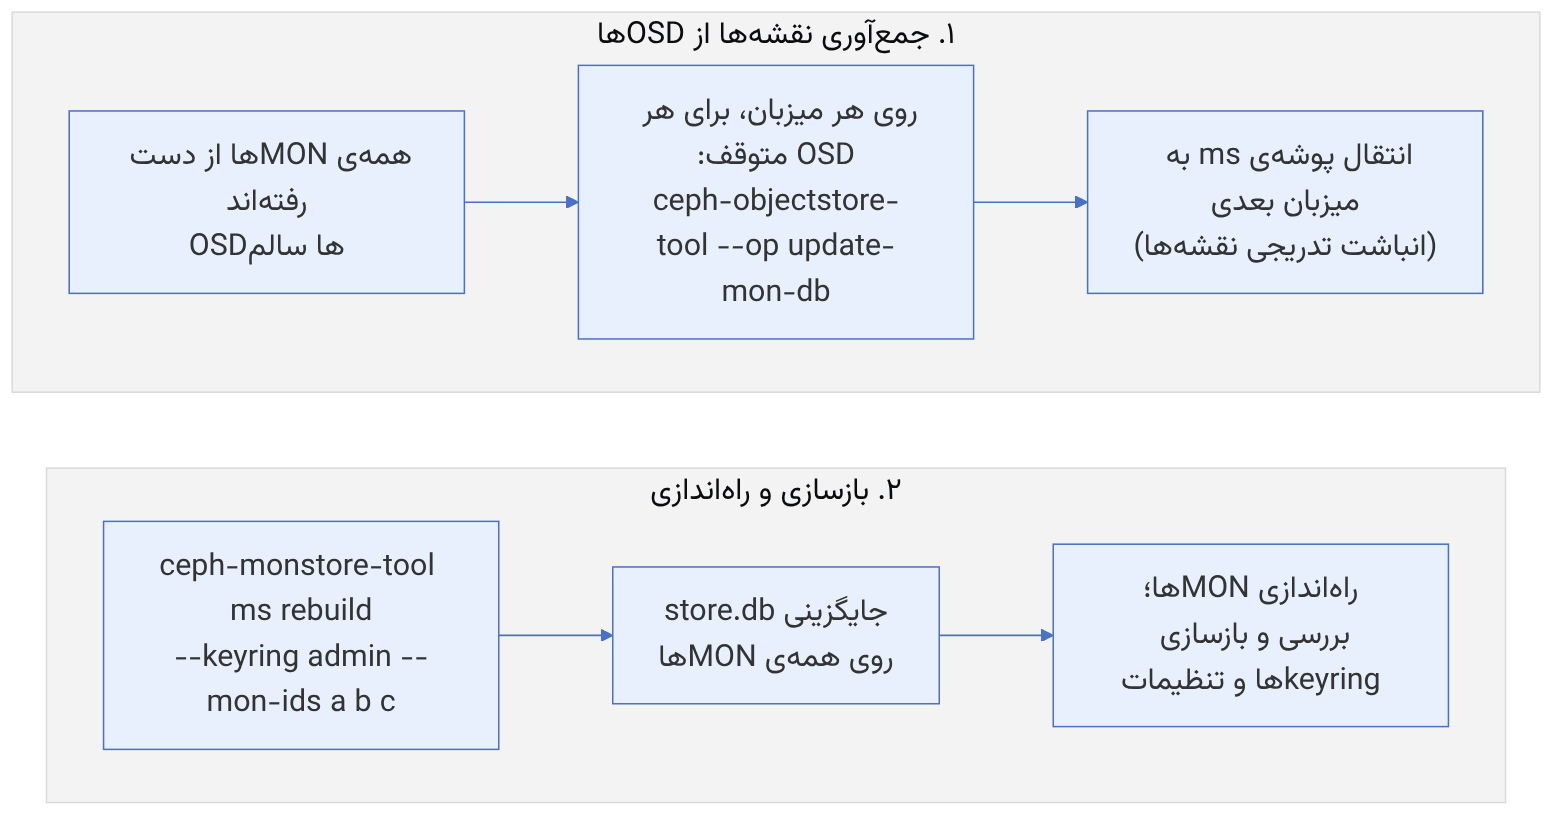
- ۱. همهی OSDها را متوقف کنید.
- ۲. یک پوشهی store خالی بسازید و آن را به نوبت به هر میزبان OSD ببرید؛ روی هر میزبان، برای هر OSD،
ceph-objectstore-tool --data-path <osd> --no-mon-config --op update-mon-db --mon-store-path <dir> را اجرا کنید تا نقشههای آن OSD به store اضافه شود؛ سپس store انباشته را برگردانید. - ۳. یک keyring بسازید که کلید
mon. و client.admin (و کلید mgrها) را با capهای لازم داشته باشد. - ۴.
ceph-monstore-tool <dir> rebuild -- --keyring <keyring> --mon-ids <ids> را اجرا کنید (ترتیب شناسهها اگر بر اساس IP مرتب نیستند مهم است). - ۵. از store.db خراب نسخه بگیرید، store بازسازیشده را جایگزین کنید، مالکیت فایلها را درست کنید و MONها را راهاندازی کنید.
محدودیتهای مستند این روال: keyringهای MDS و بسیاری از keyringهای دیگر بازیابی نمیشوند و باید دوباره افزوده شوند؛ poolهایی که در حال ساخت بودهاند ممکن است PGهای unknown داشته باشند (مستندات ceph osd force-create-pg را برای این حالت ذکر میکند)؛ و تنظیمات دیگری که فقط در MON بودهاند ممکن است گم شوند. در cephadm، مسیرها زیر /var/lib/ceph/<fsid>/ هستند و فرمانها باید درون cephadm shell با mount مناسب اجرا شوند. این روال را پیش از نیاز، در آزمایشگاه تمرین کنید.
۱۸-۹ نجات داده از OSD#
ceph-objectstore-tool روی OSD متوقف، امکان فهرست، صدور و ورود PGها را میدهد (فصل ۱۷). کاربرد DR آن وقتی است که چند OSD همزمان از دست رفتهاند و PG در وضعیت incomplete یا down مانده است، اما دیسک یکی از OSDهای مرده هنوز خوانا است.
# درون cephadm shell برای OSD متوقف
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-12 --op list-pgs
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-12 --pgid 2.5 --op info
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-12 --pgid 2.5 --op export --file /backup/2.5.export
# روی OSD مقصد (متوقف)
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-30 --op import --file /backup/2.5.export۱۸-۱۰ پشتیبان مستقل#
- RBD:
rbd export-diff بین snapshotها و rbd import-diff در کلاستر یا ذخیرهساز دیگر؛ یا ابزارهای پشتیبانگیری سطح VM. - RGW: نسخهگذاری bucket همراه S3 Object Lock در حالت COMPLIANCE تا حتی مدیر هم نتواند پیش از پایان دوره حذف کند (فصل ۴)؛ همگامسازی به ذخیرهساز بیرونی.
- CephFS: snapshotهای دایرکتوری و
cephfs-mirror به کلاستر دیگر (از Pacific؛ فصل ۶). - پیکربندی: خروجی
ceph orch ls --export، ceph config dump و keyringها.
| فاجعه | نخستین اقدام |
|---|---|
| خرابی کامل یک سایت با stretch mode | بررسی degraded stretch mode و quorum با داور |
| از دست رفتن کلاستر اصلی با rbd-mirror | promote --force در سایت دوم و پذیرش RPO |
| حذف اشتباه تصویر RBD | بررسی سطل زبالهی RBD با rbd trash ls و rbd trash restore |
| از دست رفتن همهی MONها | بازیابی از پشتیبان MON (Umbrella) یا بازسازی از OSDها |
| PG incomplete پس از خرابی چند دیسک | بازگرداندن OSDها؛ در غیر این صورت export/import با ceph-objectstore-tool |
- RPO و RTO هر سرویس را مکتوب کنید و لایهی مناسب را انتخاب کنید.
- تکثیر ناهمزمان حذفها را هم تکثیر میکند؛ پشتیبان مستقل با object lock لازم است.
- failover را دورهای تمرین کنید؛ runbook نوشتهنشده در بحران کار نمیکند.
- token و keyringها را مانند رمز نگه دارید.
- بازسازی MON از OSDها را پیش از نیاز در آزمایشگاه تمرین کنید.
۱۸-۱۱ تکمیلی و بهروز#
- mirroring مبتنی بر snapshot از Octopus در دسترس است و برای بیشتر کاربردها جایگزین مناسب journal شده است.
- Umbrella پشتیبانگیری داخلی از store مانیتور را افزوده است (فصل ۸).
- مستندات شاخهی در حال توسعه مدل تازهی stretch با
num_zones را شرح میدهد؛ تا انتشار رسمی آن در یک نسخه، از روال enable_stretch_mode استفاده کنید. -
ceph-deploy که در روالهای قدیمی بازسازی به کار میرفت، بایگانی شده است؛ همهی روالها امروز با cephadm انجام میشود.
۱۸-۱۲ تمرین عملی#
- ۱. دو کلاستر کوچک بسازید، mirroring snapshot را برای یک تصویر فعال کنید و با
rbd mirror image status تأخیر همگامی را اندازه بگیرید. - ۲. failover برنامهریزیشده را انجام دهید و تأیید کنید هیچ دادهای از دست نرفته است (checksum فایلها).
- ۳. failover اضطراری را با قطع شبکهی سایت A شبیهسازی کنید؛ سپس روال resync را اجرا کنید.
- ۴. در
snapshot/Replayer.cc، جای ادامهی کپی از last_copied_object_number را پیدا کنید. - ۵. در آزمایشگاه، store یک MON را حذف و روال بازسازی از OSDها را کامل اجرا کنید.
- ۶. یک bucket با object lock حالت COMPLIANCE بسازید و تلاش برای حذف را آزمایش کنید.
۱۸-۱۳ پرسشهای مرور#
- ۱. چرا تکثیر جایگزین پشتیبان نیست؟
- ۲. تفاوت mirroring مبتنی بر journal و snapshot در سربار و RPO چیست؟
- ۳. فیلد complete در MirrorSnapshotNamespace چه نقشی دارد؟
- ۴. rbd-mirror در کدام کلاستر اجرا میشود و چرا pull میکند؟
- ۵. پس از promote --force و بازگشت سایت قبلی چه باید کرد؟
- ۶. نقش MON داور در stretch mode چیست؟
- ۷. stretch mode چه اثری بر تأخیر نوشتن دارد؟
- ۸. چه اطلاعاتی در بازسازی MON از OSDها از دست میرود؟
- ۹. Umbrella چه ابزاری برای پشتیبان MON افزوده است؟
- ۱۰. ceph-objectstore-tool در DR چه کاربردی دارد و پیششرطش چیست؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۸-۱۴ منابع این فصل#
- RBD mirroring
https://docs.ceph.com/en/latest/rbd/rbd-mirroring/ - Stretch mode (Tentacle
https://docs.ceph.com/en/tentacle/rados/operations/stretch-mode/ - Stretch mode (Umbrella
https://docs.ceph.com/en/umbrella/rados/operations/stretch-mode/ - Stretch mode (latest/dev
https://docs.ceph.com/en/latest/rados/operations/stretch-mode/ - Troubleshooting monitors (Monitor Store Failures
https://docs.ceph.com/en/latest/rados/troubleshooting/troubleshooting-mon/ - CephFS mirroring
https://docs.ceph.com/en/latest/cephfs/cephfs-mirroring/ - RGW S3 bucket operations (object lock config
https://docs.ceph.com/en/latest/radosgw/s3/bucketops/ - Source: src/tools/rbd_mirror
https://github.com/ceph/ceph/tree/main/src/tools/rbd_mirror - Source: src/cls/rbd/cls_rbd_types.h
https://github.com/ceph/ceph/blob/main/src/cls/rbd/cls_rbd_types.h - Source: src/librbd/mirror/snapshot
https://github.com/ceph/ceph/tree/main/src/librbd/mirror/snapshot