بخش تخصصی (۳): RADOS — snapshot و clone، watch/notify و cls در سمت OSD، و مرجع rados و pool
حوصله ندارم این فصل در چند خط
- snapshotهای pool و snapshotهای خودمدیریت (RBD و CephFS) هر دو از
snap_seq در pool استفاده میکنند، پس هر pool فقط یکی از این دو را میپذیرد. - clone شیئی با همان نام و یک شناسهی snap است؛ SnapSet cloneها و همپوشانی آنها را ثبت میکند و BlueStore extentها را ارزان clone میکند.
- حذف snapshot فقط آن را در صف میگذارد و SnapTrimmer cloneها را در پسزمینه پاک میکند.
- وضعیت watch روی خود شیء ذخیره میشود و با عوض شدن primary از بین نمیرود؛ فصل با مرجع فرمانهای
rados و ceph osd pool تمام میشود.
۳۶-۱ پیش از شروع#
snapshot در RADOS پایهی snapshot در RBD و CephFS است، watch/notify پایهی هماهنگی میان کلاینتهای RBD و RGW، و کلاسهای شیء (cls) پایهی بیشتر فرادادهی RBD و RGW. فصل ۱۴ این سازوکارها را از دید librados و فصل ۱۵ نوشتن یک کلاس را نشان داد. این فصل همانها را درون OSD دنبال میکند: SnapSet چگونه تغییر میکند، clone چه زمانی ساخته میشود، خواندن از snapshot به کدام clone میرسد، snaptrim چگونه فضا را آزاد میکند، watch و notify چه حالتی در OSD دارند و فراخوانی کلاس چگونه درون همان تراکنش op اجرا میشود. فصل با مرجع کامل rados و ceph osd pool تمام میشود.
۳۶-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
- snapshot نوع pool و self-managed چه فرقی دارند و چرا نمیتوان هر دو را روی یک pool داشت؟
- SnapContext چیست و چه کسی آن را میفرستد؟
-
make_writeable چه زمانی clone میسازد و clone_overlap چه چیزی را نشان میدهد؟ - خواندن از snap شمارهی ۵ به کدام clone میرسد؟
- snaptrim پس از حذف snapshot چه میکند و SnapMapper چه کلیدهایی دارد؟
- watch در OSD چه زمانی منقضی میشود و notify کی کامل میشود؟
- فراخوانی cls چگونه با بقیهی opهای یک پیام در یک تراکنش اتمی مینشیند؟
۳۶-۱-۲ پیشنیاز#
فصل ۱۴ (librados، watch/notify)، فصل ۱۵ (cls)، فصل ۳۴ (object_info_t، SnapSet، مسیر op).
۳۶-۲ دو نوع snapshot#
| pool snapshot | self-managed snapshot | |
|---|---|---|
| ایجاد | ceph osd pool mksnap یا rados mksnap | selfmanaged_snap_create در librados (RBD و CephFS) |
| SnapContext | OSD از روی pool میسازد (همهی snapهای pool) | کلاینت در هر نوشتن میفرستد |
| دامنه | همهی اشیای pool | فقط اشیایی که کلاینت با آن SnapContext مینویسد |
| پرچم pool | FLAG_POOL_SNAPS (pool_snaps) | FLAG_SELFMANAGED_SNAPS (selfmanaged_snaps) |
هر دو نوع از یک شمارندهی snap_seq در pool شماره میگیرند. اگر هر دو روی یک pool فعال باشند، مالکیت شمارهها نامعلوم میشود. به همین دلیل mon پس از اولین استفاده از یک نوع، نوع دیگر را رد میکند. poolی که RBD از آن استفاده میکند نباید pool snapshot داشته باشد.
SnapContext دو چیز دارد: seq (بزرگترین شمارهی snapshot که نویسنده از آن خبر دارد) و snaps (فهرست snapshotهای زنده، به ترتیب نزولی). RBD آن را در header تصویر نگه میدارد و librbd در هر نوشتن روی اشیای داده آن را میفرستد (فصل ۳۷).
۳۶-۳ SnapSet و clone#
۳۶-۳-۱ فیلدهای SnapSet#
SnapSet در xattr snapset روی شیء head (فصل ۳۴) ذخیره میشود:
| فیلد | معنی |
|---|---|
seq | بزرگترین seq از SnapContextهایی که این شیء دیده است |
clones | شمارهی cloneها به ترتیب صعودی؛ هر clone با شمارهی بزرگترین snap خود نام میگیرد |
clone_snaps | برای هر clone، snapهایی که این clone نمایندهی آنهاست (نزولی) |
clone_size | اندازهی هر clone |
clone_overlap | بازههایی از هر clone که هنوز با clone جدیدتر (یا head) یکسان است |
clone خودش یک شیء RADOS با همان نام و hash ولی snap برابر شمارهی clone است. در BlueStore این clone با کپی منطقی (clone کردن extentها با شمارندهی ارجاع در shared blob، فصل ۲۴) ساخته میشود، پس ساختن آن ارزان است و فقط بخشهایی که بعداً بازنویسی میشوند فضای تازه میگیرند.
۳۶-۳-۲ ساختن clone هنگام نوشتن#
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::make_writeable، _make_clone
پیچیدگی: O(s) برای s snap جدید؛ clone در BlueStore بدون کپی داده
pseudocode
make_writeable(ctx, snapc):
if snapc.seq < snapset.seq: use snapset's newer context # کلاینت قدیمی
if head exists and not whiteout and snapc.snaps not empty
and snapc.snaps[0] > snapset.seq: # snap تازه از آخرین نوشتن
snaps = [s in snapc.snaps where s > snapset.seq] # نزولی
coid = head with snap = snapc.seq
_make_clone(head → coid) # clone در ObjectStore
snapset.clones.push_back(coid.snap)
snapset.clone_snaps[coid.snap] = snaps
snapset.clone_size[coid.snap] = head.size
snapset.clone_overlap[coid.snap] = [0, head.size)
log CLONE entry ; at_version.version++
if snapset.clones not empty:
clone_overlap[newest clone] -= modified_ranges(ctx) # بخش بازنویسیشده دیگر مشترک نیست
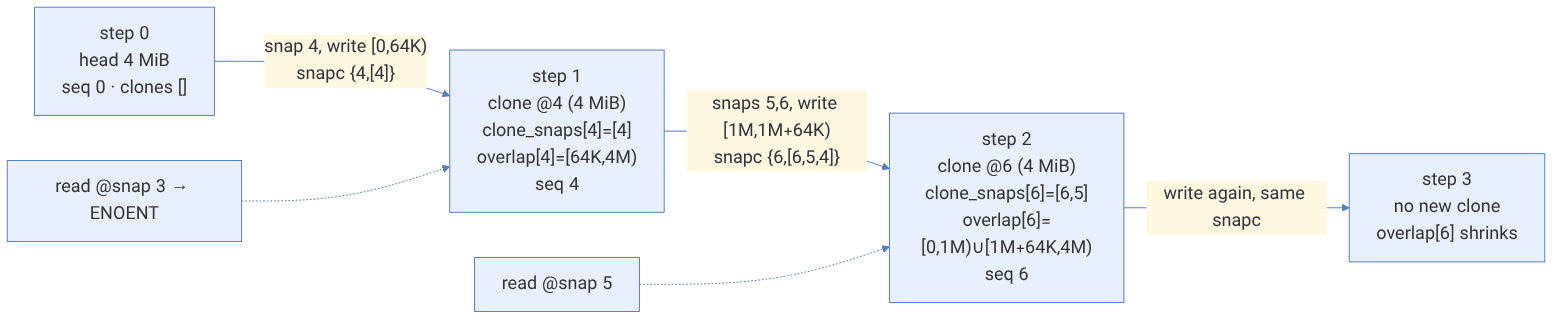
snapset.seq = max(snapset.seq, snapc.seq)مثال عددی. شیء rbd_data.5f3a.0000000000000000 با اندازهی ۴ MiB است و snapset.seq = 0.
- ۱. snapshot شمارهی ۴ گرفته میشود. librbd با SnapContext
{seq: 4, snaps: [4]} بازهی [0, 64K) را مینویسد. چون ۴ > ۰، clone @4 ساخته میشود: clone_snaps[4] = [4]، clone_size[4] = 4 MiB و پس از نوشتن clone_overlap[4] = [64K, 4M). seq برابر ۴ میشود. - ۲. snapshotهای ۵ و ۶ گرفته میشوند. نوشتن
[1M, 1M+64K) با {seq: 6, snaps: [6,5,4]} میآید. چون ۶ > ۴، clone @6 با clone_snaps[6] = [6,5] ساخته میشود و clone_overlap[6] = [0,1M) ∪ [1M+64K, 4M). - ۳. نوشتن بعدی با همان SnapContext دیگر clone نمیسازد (۶ > ۶ نیست) و فقط
clone_overlap[6] را کوچکتر میکند.
فضای واقعی clone @4 برابر بخشی است که در head یا cloneهای جدیدتر بازنویسی شده، یعنی ۴M منهای اندازهی clone_overlap[4]؛ در این مثال ۶۴ KiB. ceph df و rbd du همین حساب را انجام میدهند.
۳۶-۳-۳ خواندن از snapshot#
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::find_object_context
پیچیدگی: O(c) برای c clone (پیمایش خطی clones)
pseudocode
find_object_context(oid with snap = s):
    if s == NOSNAP: return head
    ss = snapset of head
    if s > ss.seq: return head                         # شیء پس از s تغییر نکرده
    k = first index with ss.clones[k] >= s
    if none: ENOENT                                    # شیء پس از s ساخته شده است
    clone = ss.clones[k]
    if clone is missing: EAGAIN (wait for recovery)
    if s not in ss.clone_snaps[clone]: ENOENT          # در زمان s شیء وجود نداشت
    if s in removed_snaps_queue of pool: ENOENT        # snap در حال حذف
    return clone
در مثال بالا: خواندن در snap 5 به clones = [4, 6] میرسد. اولین clone ≥ ۵ @6 است و ۵ در clone_snaps[6] = [6,5] هست، پس @6 خوانده میشود. خواندن در snap 7 (بزرگتر از seq=6) مستقیم head را برمیگرداند. خواندن در snap 3 به @4 میرسد ولی ۳ در [4] نیست، پس ENOENT میگیرد، چون شیء در snap 3 هنوز وجود نداشته است.
۳۶-۳-۴ حذف head و whiteout#
اگر head حذف شود ولی cloneهایی داشته باشد، OSD نمیتواند SnapSet را دور بریزد. در این حالت head بهصورت whiteout میماند: شیئی با پرچم whiteout در object_info_t که برای کلاینت وجود ندارد (stat آن ENOENT میدهد) ولی SnapSet را نگه میدارد. پس از آنکه snaptrim آخرین clone را پاک کند، whiteout هم حذف میشود.
۳۶-۴ snaptrim و SnapMapper#
۳۶-۴-۱ حذف snapshot#
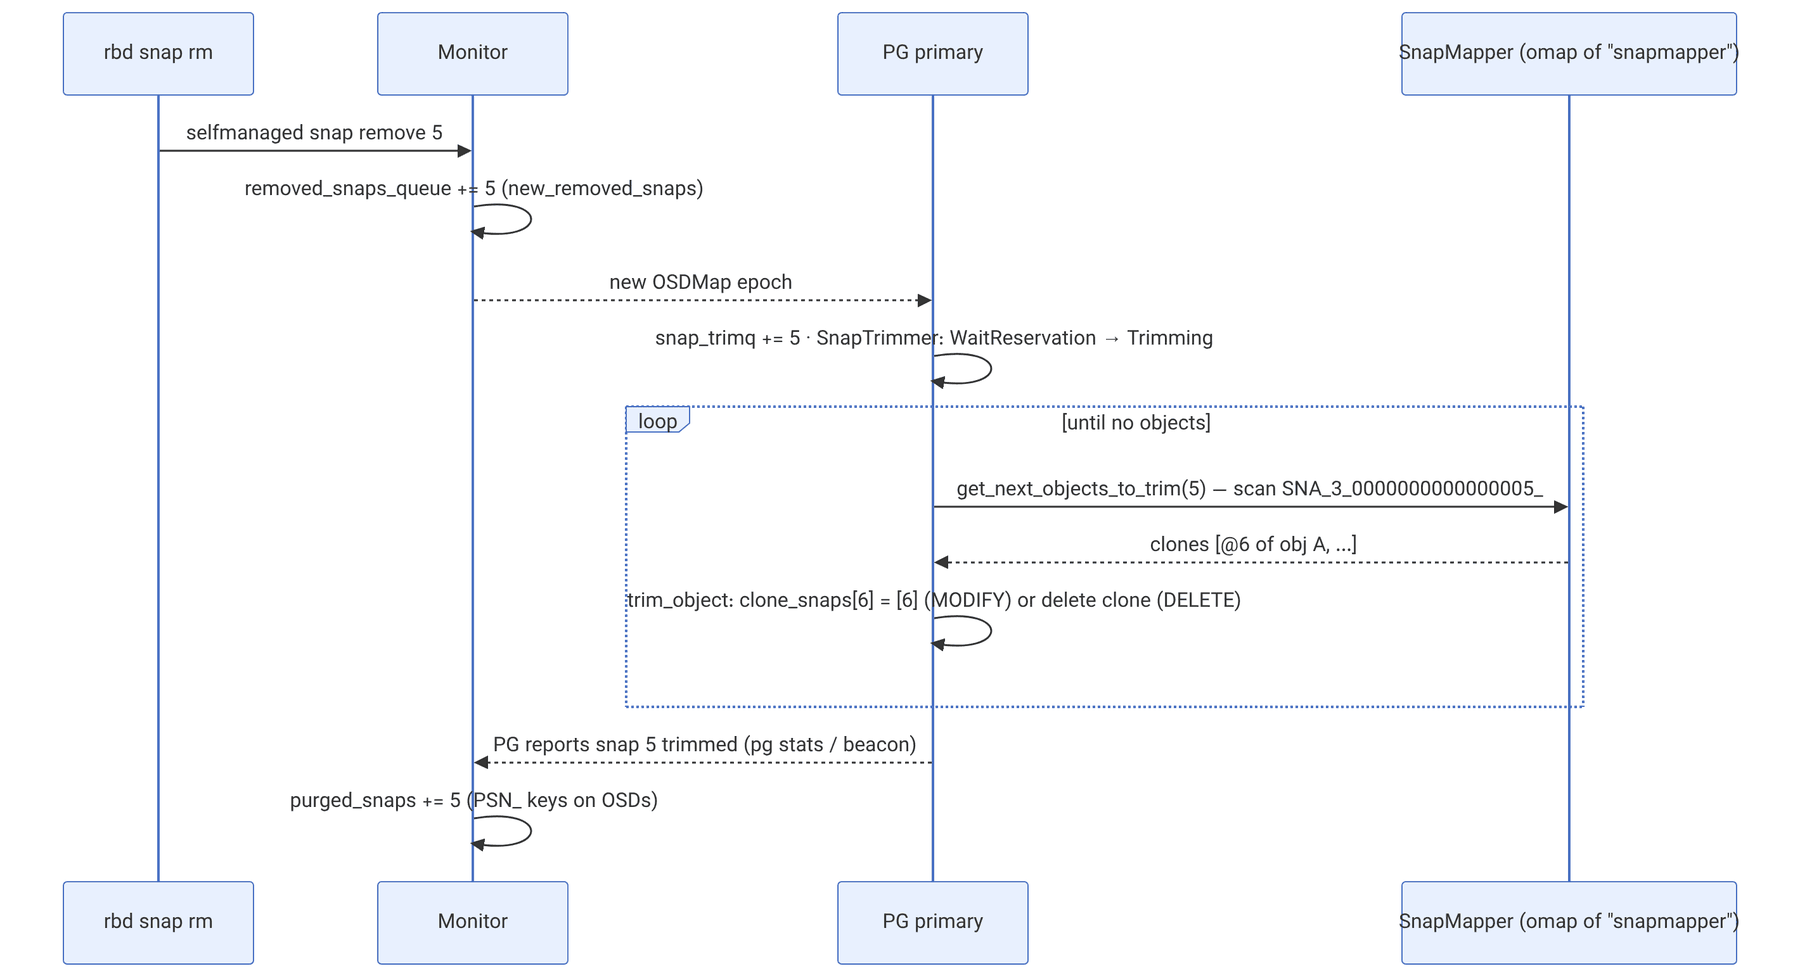
حذف یک snapshot در mon فقط شمارهی آن را به removed_snaps_queue pool اضافه میکند (و در OSDMap به new_removed_snaps). هر PG که نقشهی تازه را میبیند، آن snap را به snap_trimq خود اضافه میکند و ماشین حالت SnapTrimmer شروع به کار میکند. وقتی همهی PGها کار را تمام کردند، mon آن را در purged_snaps ثبت میکند.
برای پیدا کردن cloneهایی که یک snap دارند، پیمایش همهی اشیا گران است. SnapMapper یک نمایهی معکوس در omap شیء snapmapper در مجموعهی meta هر OSD نگه میدارد:
| پیشوند | قالب کلید | مقدار |
|---|---|---|
SNA_ | SNA_<pool>_<snap:016X>_<shard> + hobject.to_str() | نام clone برای این snap |
OBJ_ | OBJ_<shard> + hobject.to_str() | مجموعهی snapهای این clone |
PSN_ | PSN__<pool>_<last:016x> | بازهی snapهای purgeشده |
hobject_t::to_str() قالب <pool:016X>.<nibble-reversed hash:08X>.<snap>.<name>.<key>.<nspace> دارد. برای clone @6 شیء مثال ما در pool ۳ با hash 0x8c7e1b1f، کلید SNA برای snap 5 چنین است:
مثال:
SNA_3_0000000000000005_0000000000000003.F1B1E7C8.6.rbd_data.5f3a.0000000000000000..
کلید با پیشوند SNA_3_0000000000000005_ شروع میشود، پس همهی cloneهای snap 5 در pool ۳ با یک اسکن بازهای پیدا میشوند. برای EC، پیشوند shard (مثلاً .2_) هم اضافه میشود؛ برای replicated خالی است.
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::trim_object؛ src/osd/SnapMapper.cc :: SnapMapper::get_next_objects_to_trim
پیچیدگی: O(c) برای c clone شیء؛ هر trim یک تراکنش تکثیرشده
pseudocode
for coid in snapmapper.get_next_objects_to_trim(snap, max):
    new_snaps = clone_snaps[coid] minus (snaps removed or queued for removal)
    if new_snaps empty:                                  # clone دیگر لازم نیست
        if coid is not the oldest clone:
            clone_overlap[older] = clone_overlap[older] ∩ clone_overlap[coid]
        delete coid ; log DELETE
        remove coid from clones, clone_overlap, clone_size, clone_snaps
    else:
        clone_snaps[coid] = new_snaps ; log MODIFY (snapmapper update)
    if head is whiteout and clones empty: delete head
write new snapset to head| گزینه | پیشفرض main | معنی |
|---|---|---|
osd_pg_max_concurrent_snap_trims | ۲ | تعداد clone همزمان در هر PG |
osd_snap_trim_sleep_hdd | ۵ | توقف (ثانیه) میان دستهها روی HDD، وقتی osd_snap_trim_sleep صفر است |
osd_snap_trim_sleep_ssd | ۰ | همان روی SSD |
osd_max_trimming_pgs | ۲ | حداکثر PG در حال trim روی هر OSD |
با mClock، snaptrim یکی از کلاسهای پسزمینه است و اولویت آن از profile میآید (فصل ۲۱). حالت snaptrim_wait و snaptrim در ceph pg ls و پرچم nosnaptrim در ceph osd set برای کنترل آن به کار میروند.
۳۶-۵ watch و notify در OSD#
watch یک حالت روی شیء است: در object_info_t.watchers ثبت میشود (پس با شیء تکثیر و پس از تغییر primary حفظ میشود)، و روی primary یک شیء Watch با اتصال کلاینت و تایمر دارد. زیرعملیاتها در CEPH_OSD_OP_WATCH با کدهای WATCH (۳)، RECONNECT (۵)، PING (۷) و UNWATCH (۰) مشخص میشوند.
منبع در کد: src/osd/Watch.cc :: Watch::connect، Watch::got_ping، Notify::maybe_complete_notify، Notify::do_timeout
پیچیدگی: O(w) برای w watcher در هر notify
pseudocode
watch(cookie, timeout = osd_client_watch_timeout): # پیشفرض 30 ثانیه
oi.watchers[(client, cookie)] = watch_info ; persist with object
Watch.connect(con) ; register timeout callback
ping every few seconds → Watch.got_ping(now) → reset timer
timer fires (no ping) → remove watch from oi.watchers (یک نوشتن روی شیء)
notify(payload, timeout = osd_default_notify_timeout): # پیشفرض 30 ثانیه
for each watch on object: send MWatchNotify(NOTIFY) ; Notify.start_watcher
each watcher acks (notify_ack with reply payload) → complete_watcher
if all acked or timed_out:
reply MWatchNotify(NOTIFY_COMPLETE, data = {replies, missed watchers})
return_code = -ETIMEDOUT if timed_outنکتهی عملی: watch منقضیشده با یک نوشتن روی شیء حذف میشود، پس اگر شیء در PGای باشد که نوشتن را نمیپذیرد (PG فعال نیست، شیء degraded است یا scrub نوشتن را مسدود کرده)، حذف به تعویق میافتد و watch مرده تا آن زمان در فهرست میماند. rados listwatchers و rbd status همین فهرست را از object_info_t میخوانند.
# مثال: دیدن watcherها و ارسال یک notify آزمایشی
rados -p rbd listwatchers rbd_header.5f3a2b8c1d4e
rados -p rbd notify rbd_header.5f3a2b8c1d4e helloمثال (خروجی):
watcher=10.20.0.31:0/2846217731 client.24183 cookie=94823571521536۳۶-۶ فراخوانی cls در سمت OSD#
opی با کد CEPH_OSD_OP_CALL نام کلاس، نام متد و ورودی را دارد. do_osd_ops کلاس را از ClassHandler میگیرد (اگر لازم باشد، libcls_<name>.so را از osd_class_dir بارگذاری میکند) و متد را با یک cls_method_context_t صدا میزند که در واقع همان OpContext است.
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::do_osd_ops (case CEPH_OSD_OP_CALL)؛ src/osd/ClassHandler.cc؛ src/osd/objclass.cc :: cls_cxx_*
پیچیدگی: به اندازهی کار متد؛ هر cls_cxx_* یک زیرعملیات روی همان ctx
pseudocode
case CALL(class, method, indata):
cls = ClassHandler.open_class(class) # بارگذاری فقط اگر در osd_class_load_list باشد
m = cls.get_method(method)
check caps: m.flags RD → نیاز به r یا class-read ; WR → w یا class-write
r = m.exec(ctx, indata, outdata)
# درون متد: cls_cxx_read / cls_cxx_write / cls_cxx_map_set_vals / ...
# هر کدام do_osd_ops(ctx, [one op]) را روی همان ctx صدا میزند
if r < 0: whole message fails → no transaction applied
outdata → replyچون متد روی همان OpContext کار میکند، همهی تغییرهای آن با بقیهی opهای همان پیام در یک تراکنش و یک ورودی log مینشینند و اتمیاند. به همین دلیل RBD و RGW منطقهایی مثل «اگر کلید وجود ندارد، بساز و شمارنده را افزایش بده» را در کلاس پیاده میکنند.
| گزینه | پیشفرض main |
|---|---|
osd_class_load_list | cephfs hello journal lock log numops otp rbd refcount rgw rgw_gc timeindex |
osd_class_default_list | همان فهرست؛ کلاسهایی که بدون cap صریح class قابل فراخوانیاند |
کلاسهای دیگری مثل cas یا 2pc_queue و queue (که RGW برای gc و اعلانها استفاده میکند) با بستهها نصب میشوند ولی در این فهرستها نیستند. فهرست واقعی در توزیع شما ممکن است متفاوت باشد؛ با ceph config get osd osd_class_load_list بررسی کنید.
۳۶-۷ مرجع rados#
۳۶-۷-۱ دستورهای pool و شیء#
در جدولهای این فصل و فصلهای بعد، {a,b} یعنی «یکی از a یا b» و P، O و S بهترتیب نام pool، شیء و snapshot هستند.
| دستور | کاربرد |
|---|---|
rados lspools / rados df | فهرست pool و مصرف هر pool |
rados -p P ls [--all] [-N ns] | فهرست اشیا (همهی namespaceها با --all) |
rados -p P put O FILE / get O FILE / append / truncate / create / rm | عملیات پایه |
rados -p P stat O / stat2 O | اندازه و mtime (stat۲ با دقت بالاتر) |
rados -p P listxattr O / getxattr / setxattr / rmxattr | xattrهای کاربر |
rados -p P listomapkeys O / listomapvals / getomapval / setomapval / rmomapkey / clearomap | omap |
rados -p P getomapheader O / setomapheader | سرآیند omap |
rados -p P lssnap / mksnap S / rmsnap S / rollback O S | pool snapshot |
rados -p P -s S get O FILE | خواندن از یک pool snapshot |
rados -p P listsnaps O | cloneها، snapها، اندازه و overlap یک شیء |
rados -p P watch O / notify O MSG / listwatchers O | watch و notify |
rados -p P lock list O / lock info O NAME / lock break O NAME LOCKER | قفلهای مشورتی cls_lock |
rados -p P set-alloc-hint O SIZE WSIZE | راهنمای تخصیص برای BlueStore |
rados -p P bench SECS {write,seq,rand} -t N [--no-cleanup] / cleanup | آزمون کارایی (فصل ۱۰) |
rados -p P export FILE / import FILE | پشتیبان منطقی یک pool |
# مثال: cloneهای یک شیء RBD
rados -p rbd listsnaps rbd_data.5f3a.0000000000000000مثال (خروجی):
rbd_data.5f3a.0000000000000000 (seq:6):
cloneid snaps size overlap
4 4 4194304 [65536~4128768]
6 5,6 4194304 [0~1048576,1114112~3080192]
head - 4194304overlap با قالب [offset~length] نشان داده میشود: 65536~4128768 همان [64K, 4M) است.
۳۶-۸ مرجع ceph osd pool#
| دستور | کاربرد |
|---|---|
ceph osd pool create P [PG_NUM] [{replicated,erasure}] [{RULE,PROFILE}] | ساخت pool |
ceph osd pool application enable P {rbd,rgw,cephfs} | برچسب برنامه (لازم برای HEALTH_OK) |
ceph osd pool ls detail | همهی ویژگیها، از جمله flags و snap_seq |
ceph osd pool get P all / get P KEY | خواندن ویژگیها |
ceph osd pool set P {size,min_size} N | تعداد نسخهها و حداقل برای نوشتن |
ceph osd pool set P {pg_num,pgp_num} N | تعداد PG (با autoscaler معمولاً خودکار) |
ceph osd pool set P pg_autoscale_mode {on,warn,off} / bulk true / target_size_ratio R | autoscaler |
ceph osd pool set P crush_rule RULE | قاعدهی CRUSH |
ceph osd pool set P {compression_mode,compression_algorithm} ... | فشردهسازی BlueStore |
ceph osd pool set P {nodelete,nopgchange,nosizechange} true | محافظت از pool |
ceph osd pool set P {noscrub,nodeep-scrub} true | توقف scrub برای یک pool |
ceph osd pool set P allow_ec_overwrites true | نوشتن جزئی روی EC (برای RBD و CephFS) |
ceph osd pool set-quota P {max_objects,max_bytes} N / get-quota P | سهمیه |
ceph osd pool mksnap P S / rmsnap P S | pool snapshot |
ceph osd pool rename OLD NEW | تغییر نام |
ceph osd pool rm P P --yes-i-really-really-mean-it | حذف (نیازمند mon_allow_pool_delete) |
ceph osd pool stats [P] / ceph df detail | نرخ I/O و مصرف |
ceph osd pool autoscale-status | پیشنهاد autoscaler |
مثال (بخشی از ceph osd pool ls detail):
pool 3 'rbd' replicated size 3 min_size 2 crush_rule 0 object_hash rjenkins pg_num 32 pgp_num 32
  autoscale_mode on last_change 1462 lfor 0/0/980 flags hashpspool,selfmanaged_snaps stripe_width 0
application rbdmin_size پیشفرض صفر است که یعنی size − size/2؛ برای size=3 همان ۲.
۳۶-۹ تنظیم و عیبیابی#
- snaptrim کند و فضای آزادنشده:
ceph pg ls snaptrim_wait را ببینید. روی HDD، osd_snap_trim_sleep_hdd را با احتیاط کم کنید یا profile mClock را برای مدتی به high_recovery_ops ببرید. - کندی پس از گرفتن snapshot: نخستین نوشتن روی هر شیء پس از snapshot یک clone میسازد و فرادادهی بیشتری مینویسد. گرفتن snapshot بسیار پرتکرار روی تصویر پرنوشتن باعث تعداد زیادی clone و SnapMapper بزرگ میشود.
-
rados ls شیئی را نشان میدهد ولی stat آن ENOENT است: احتمالاً head whiteout است و cloneها هنوز trim نشدهاند. - watch مرده روی header تصویر RBD:
rbd status و rados listwatchers را ببینید. اگر کلاینت واقعاً مرده است، پس از osd_client_watch_timeout خودبهخود حذف میشود. برای قطع فوری، ceph osd blocklist add آدرس آن کلاینت را مسدود میکند. -
EOPNOTSUPP در فراخوانی کلاس: کلاس در osd_class_load_list نیست یا فایل .so آن نصب نشده است.
۳۶-۱۰ تکمیلی و بهروز#
- از Octopus به بعد، OSDMap فهرست کامل
removed_snaps را نگه نمیدارد و بهجای آن removed_snaps_queue و purged_snaps (و کلیدهای PSN_ در SnapMapper) به کار میروند. clusterهای قدیمیتر رفتار دیگری داشتند. - در شاخهی main، کپی cloneها در مهاجرت pool (
pool_migration) استثنای خودش را در بهروزرسانی clone_overlap دارد. - Crimson snapshot و snaptrim را با همان SnapSet و SnapMapper پیاده کرده است (
crimson/osd/osd_operations/snaptrim_event.cc).
۳۶-۱۱ تمرین عملی#
- ۱. روی یک pool آزمایشی (نه pool RBD) یک شیء بنویسید،
rados mksnap s1 بگیرید، بخشی از شیء را بازنویسی کنید و listsnaps را بخوانید. سپس rados -s s1 get را با نسخهی جاری مقایسه کنید. - ۲. یک تصویر RBD بسازید، سه snapshot بگیرید و میان آنها بنویسید؛ با
rados listsnaps روی یکی از اشیای داده، clone_snaps و overlap را با محاسبهی دستی تطبیق دهید. - ۳. snapshot میانی را حذف کنید و در
ceph pg ls snaptrim و دوباره در listsnaps اثر آن را ببینید. - ۴. در دو ترمینال
rados watch و rados notify را اجرا کنید؛ سپس فرایند watch را با kill -STOP متوقف و زمان حذف شدنش از listwatchers را اندازه بگیرید.
۳۶-۱۲ پرسشهای مرور#
- ۱. چرا یک pool نمیتواند هم pool snapshot و هم self-managed snapshot داشته باشد؟
- ۲. SnapContext چه فیلدهایی دارد و در RBD چه کسی آن را میفرستد؟
- ۳. شرط ساختن clone در make_writeable چیست؟
- ۴. clone با چه شمارهای نامگذاری میشود؟
- ۵. در مثال فصل، خواندن در snap 5 و snap 3 به چه نتیجهای میرسد؟
- ۶. whiteout چیست و چه زمانی حذف میشود؟
- ۷. کلید
SNA_ در SnapMapper چه ساختاری دارد و چرا به این شکل است؟ - ۸. وقتی clone دیگر هیچ snapی ندارد، با clone_overlap چه میشود؟
- ۹. watch منقضیشده چگونه حذف میشود و چرا ممکن است تا مدتی بماند؟
- ۱۰. چرا فراخوانی cls با بقیهی opهای یک پیام اتمی است؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۶-۱۳ منابع این فصل#
- PrimaryLogPG.cc (make_writeable، find_object_context، trim_object، CALL
https://github.com/ceph/ceph/blob/main/src/osd/PrimaryLogPG.cc - SnapMapper.cc
https://github.com/ceph/ceph/blob/main/src/osd/SnapMapper.cc - Watch.cc
https://github.com/ceph/ceph/blob/main/src/osd/Watch.cc - osd_types.h (SnapSet
https://github.com/ceph/ceph/blob/main/src/osd/osd_types.h - rados.cc (فهرست دستورهای rados
https://github.com/ceph/ceph/blob/main/src/tools/rados/rados.cc - مستند توسعهدهنده دربارهی snapshot
https://docs.ceph.com/en/latest/dev/osd_internals/snaps/ - مستند watch/notify
https://docs.ceph.com/en/latest/dev/osd_internals/watch_notify/ - مرجع pool
https://docs.ceph.com/en/latest/rados/operations/pools/