Ceph: آغاز دورانی تازه — معماری، برنامهریزی و نخستین کلاستر
حوصله ندارم این فصل در چند خط
- Ceph ذخیرهسازی نرمافزارمحور است: رابطهای بلوکی (RBD)، شیء (RGW) و فایل (CephFS) همه روی یک لایه، یعنی RADOS، ساخته شدهاند و جای آرایههای RAID را میگیرند.
- MONها نقشههای کلاستر را نگه میدارند، MGR آمار و ماژولها را و OSDها داده را؛ CRUSH جای هر شیء را محاسبه میکند و هیچ جدول مرکزیای در کار نیست.
- برنامهریزی تعیینکننده است: نوع بار، دامنهی خرابی، شبکه و MTU، درصد پرشدگی و SSD با محافظت در برابر قطع برق برای DB/WAL و MONها.
- cephadm ابزار رسمی استقرار است: یک میزبان را bootstrap کنید، میزبانها را اضافه کنید و سرویسهای دلخواه را با
ceph orch apply اعلام کنید.
۱-۱ پیش از شروع#
۱-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
فصل اول در ظاهر «معرفی» است، اما در عمل نقشهی ذهنیای میسازد که بقیهی کتاب روی آن بنا میشود. هر مفهومی که در فصلهای بعد میبینیم، از RBD و RGW تا CRUSH و BlueStore و erasure coding، در نهایت به چند ایدهی ساده برمیگردد که اینجا معرفی میشوند: ذخیرهسازی نرمافزارمحور، حذف «جدول مرکزی جای داده»، و توزیع هوشمند مسئولیت میان هزاران daemon مستقل. در این راهنما سعی کردهایم به این سؤالها جواب بدهیم:
- چرا ذخیرهسازی سنتی مبتنی بر RAID و آرایههای اختصاصی در مقیاس امروز به بنبست میرسد و Ceph دقیقاً کدام دردها را درمان میکند؟
- معماری Ceph از چه لایهها و daemonهایی تشکیل شده و هر کدام چه مسئولیتی دارد؟
- یک شیء از لحظهای که کلاینت آن را مینویسد تا وقتی روی سه دیسک در سه رک ذخیره میشود، چه مسیری را طی میکند؟
- پیش از خرید سختافزار یا ساختن اولین کلاستر، به چه پرسشهایی باید جواب داد؟
- چطور یک کلاستر آزمایشی واقعی با cephadm بسازیم، بزرگش کنیم و با آن کار کنیم؟
۱-۱-۲ پیشنیاز و شیوهی خواندن#
این فصل فرض میکند با لینوکس، مفاهیم پایهی دیسک (پارتیشن، LVM، فایلسیستم) و شبکه (IP، زیرشبکه، MTU) آشنا هستید. تجربهی کار با کانتینر (Podman یا Docker) کمک میکند، چون Ceph امروزی همهی daemonهایش را در کانتینر اجرا میکند. اگر کلاستر آزمایشی ندارید، بخش «ساختن آزمایشگاه» یک مسیر کامل با چهار ماشین مجازی پیشنهاد میدهد.
بسیاری از آموزشهای قدیمی Ceph بر پایهی نسخههای Jewel و Luminous نوشته شدهاند و برای نصب از ابزارهایی مثل ceph-deploy و ceph-ansible استفاده میکنند. هر دوی این ابزارها امروز کنار گذاشته شدهاند. در این کتاب همهی مثالها با cephadm و نسخههای جاری Ceph نوشته شدهاند. هر جا رفتار نسخهها با هم فرق دارد، صریحاً گفتهایم.
در طول متن چند نوع کادر میبینید:
کادر «نکته» یک توصیهی عملی یا میانبُر کاری است.
کادر «هشدار» جایی است که اشتباه در آن به از دست رفتن داده یا قطعی سرویس در production منجر میشود.
کادر «دستبهکار شوید» یک آزمایش کوچک روی کلاستر آزمایشی پیشنهاد میدهد.
کادر «عمیقتر» سازوکار پشت صحنه را توضیح میدهد؛ اگر عجله دارید میتوانید از رویش رد شوید.
کادر «عیبیابی» علامتها و راه بررسی مشکلات رایج همان بخش است.
کادر «یادداشت» توضیح جانبی یا تاریخی است.
۱-۱-۳ نقشهی راه فصل#
فصل را در هفت ایستگاه پیش میبریم: اول میبینیم ذخیرهسازی نرمافزارمحور چیست و Ceph از کجا آمد؛ بعد ضعفهای ساختاری RAID را مرور میکنیم؛ سپس معماری Ceph را لایهبهلایه باز میکنیم؛ بعد سراغ برنامهریزی استقرار و سختافزار میرویم؛ آنگاه یک آزمایشگاه مجازی میسازیم، Ceph را با cephadm نصب میکنیم و کلاستر را بزرگ میکنیم؛ و در پایان با pool، شیء و دیسک بلوکی کار عملی میکنیم. بخش «تکمیلی و بهروز» تغییرات مهم از ۲۰۱۹ تا امروز را جمعبندی میکند.
۱-۲ Ceph: آغاز دورانی تازه#
۱-۲-۱ از آرایهی ذخیرهسازی تا ذخیرهسازی نرمافزارمحور#
تا همین یک دهه پیش، «ذخیرهسازی سازمانی» تقریباً مترادف بود با یک جعبهی گرانقیمت از یک فروشندهی مشخص: دو کنترلر، چند قفسه دیسک، سیستمعامل بسته، و قرارداد پشتیبانیای که هر سال گرانتر میشد. این جعبهها کارشان را خوب انجام میدادند، اما سه محدودیت بنیادی داشتند:
- مقیاس عمودی: ظرفیت و کارایی با اضافه کردن قفسه به همان جفت کنترلر بالا میرفت. دیر یا زود کنترلرها گلوگاه میشدند و راهی جز خرید جعبهی بزرگتر نبود.
- وابستگی به فروشنده: دیسک، کنترلر، نرمافزار و حتی کابلها باید از همان فروشنده میآمدند. مهاجرت از یک نسل به نسل بعد معمولاً یعنی پروژهای چندماهه.
- جزیرههای داده: برای بلوک یک محصول، برای فایل محصولی دیگر، و برای پشتیبانگیری محصول سوم. هر کدام ابزار مدیریت و تیم متخصص خودش را میخواست.
ذخیرهسازی نرمافزارمحور (Software-Defined Storage یا SDS) این معادله را برعکس میکند: هوشمندی از سختافزار جدا میشود و در نرمافزاری مینشیند که روی سرورهای معمولی (commodity) اجرا میشود. سختافزار به کالایی قابلتعویض تبدیل میشود و نرمافزار وظیفهی تکثیر، توزیع، ترمیم و ارائهی رابطها را بر عهده میگیرد. نتیجه این است که برای بزرگتر شدن فقط کافی است سرور اضافه کنید، و نسلهای مختلف سختافزار میتوانند کنار هم در یک کلاستر کار کنند.
| ویژگی | آرایهی سنتی | ذخیرهسازی نرمافزارمحور (Ceph) |
|---|---|---|
| مقیاسپذیری | عمودی، محدود به کنترلر | افقی، با افزودن node |
| نقطهی شکست | جفت کنترلر | ندارد؛ همهی اجزا تکثیر میشوند |
| سختافزار | اختصاصی فروشنده | سرور x86 یا ARM معمولی |
| رابطها | معمولاً یک نوع در هر محصول | بلوک، شیء و فایل در یک کلاستر |
| ارتقا | جابهجایی داده به جعبهی جدید | جایگزینی تدریجی node به node |
| هزینهی مجوز | بالا و وابسته به ظرفیت | متنباز؛ پشتیبانی تجاری اختیاری |
۱-۲-۲ ذخیرهسازی ابری و نیازهای تازه#
ظهور ابرهای عمومی انتظارها را عوض کرد. کاربری که در AWS با یک فراخوانی API دیسک یا bucket میسازد، از ابر خصوصی سازمانش هم همین را میخواهد. ذخیرهسازی ابری چند ویژگی دارد که آرایههای سنتی برایش طراحی نشده بودند:
- سلفسرویس و APIمحور: ساختن، تغییر اندازه و حذف منابع باید از طریق API و بدون تیکت انجام شود. پروژههایی مثل OpenStack Cinder، Kubernetes CSI و API سازگار با S3 همه همین را میخواهند.
- چندمستاجری: هزاران مشتری با سهمیه، سیاست دسترسی و جداسازی کامل روی یک زیرساخت مشترک.
- مقیاس پتابایتی و رشد پیوسته: دادهی بدون ساختار (عکس، ویدئو، لاگ، پشتیبان، دیتاست یادگیری ماشین) با سرعتی رشد میکند که برنامهریزی چندساله برایش ممکن نیست.
- خرابی بهعنوان حالت عادی: در کلاستری با هزاران دیسک، هر روز چند دیسک خراب میشود. سیستم باید بدون دخالت انسان خودش را ترمیم کند.
Ceph دقیقاً برای همین دنیا طراحی شد. امروز ستون فقرات ذخیرهسازی بسیاری از ابرهای خصوصی و عمومی مبتنی بر OpenStack، بسیاری از پلتفرمهای Kubernetes (از طریق Rook) و سرویسهای ذخیرهسازی شیء سازگار با S3 است.
۱-۲-۳ معماری یکپارچهی نسل بعد#
مهمترین تمایز Ceph «یکپارچگی» آن است: یک کلاستر واحد همزمان سه نوع رابط ذخیرهسازی ارائه میدهد:
- ذخیرهسازی بلوکی (RBD): دیسکهای مجازی برای ماشینهای مجازی، کانتینرها و سرورهای فیزیکی، با snapshot، clone و تکثیر بینسایتی.
- ذخیرهسازی شیء (RGW): API سازگار با Amazon S3 و OpenStack Swift، با چندمستاجری، نسخهبندی، چرخهی عمر، object lock و تکثیر چندسایتی.
- ذخیرهسازی فایل (CephFS): فایلسیستم توزیعشدهی سازگار با POSIX، با snapshot، سهمیه و امکان ارائه از طریق NFS و SMB.
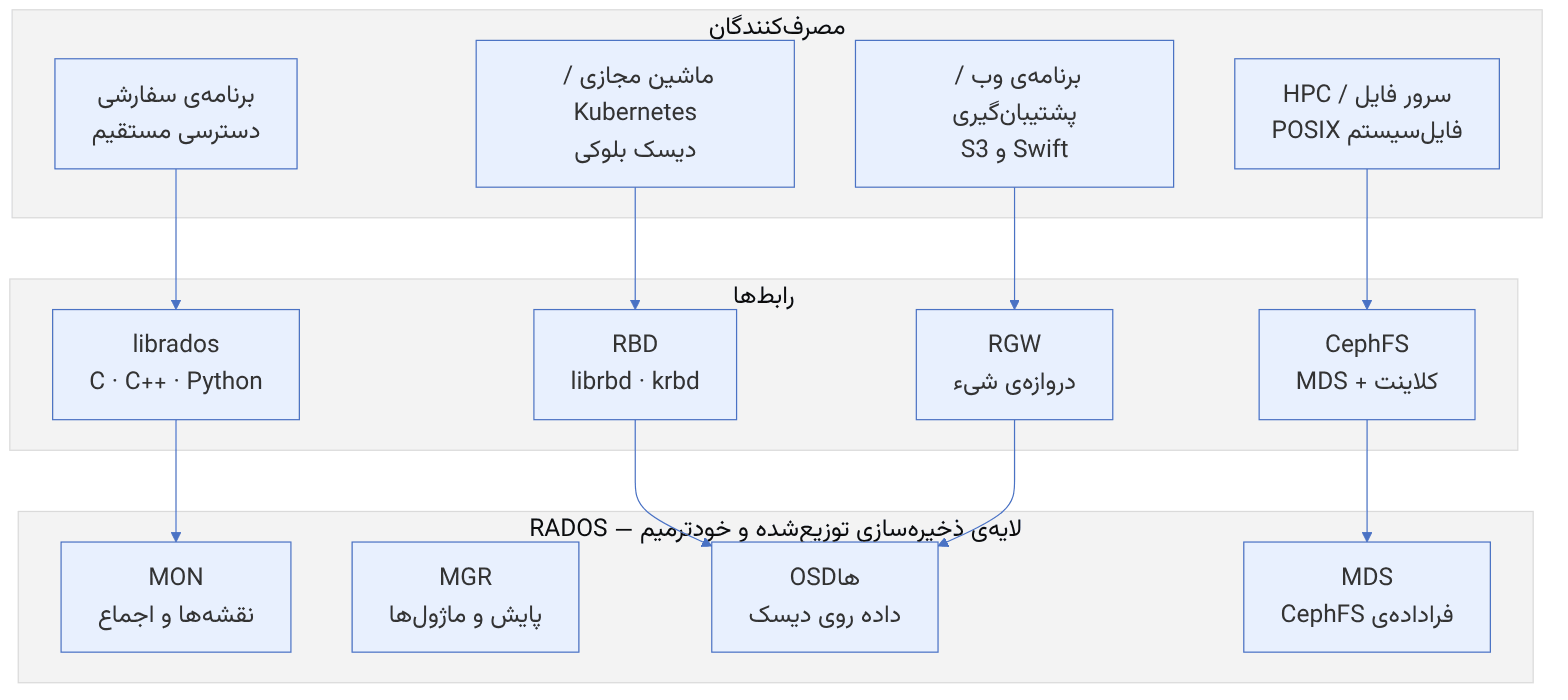
هر سه رابط روی یک لایهی مشترک به نام RADOS (Reliable Autonomic Distributed Object Store) ساخته شدهاند. این یعنی تکثیر، ترمیم، توزیع داده و مدیریت خرابی فقط یکبار و در یک جا پیادهسازی شده و همهی رابطها از آن بهره میبرند. از دید عملیاتی هم یک کلاستر، یک مجموعه ابزار پایش و یک تیم کافی است.
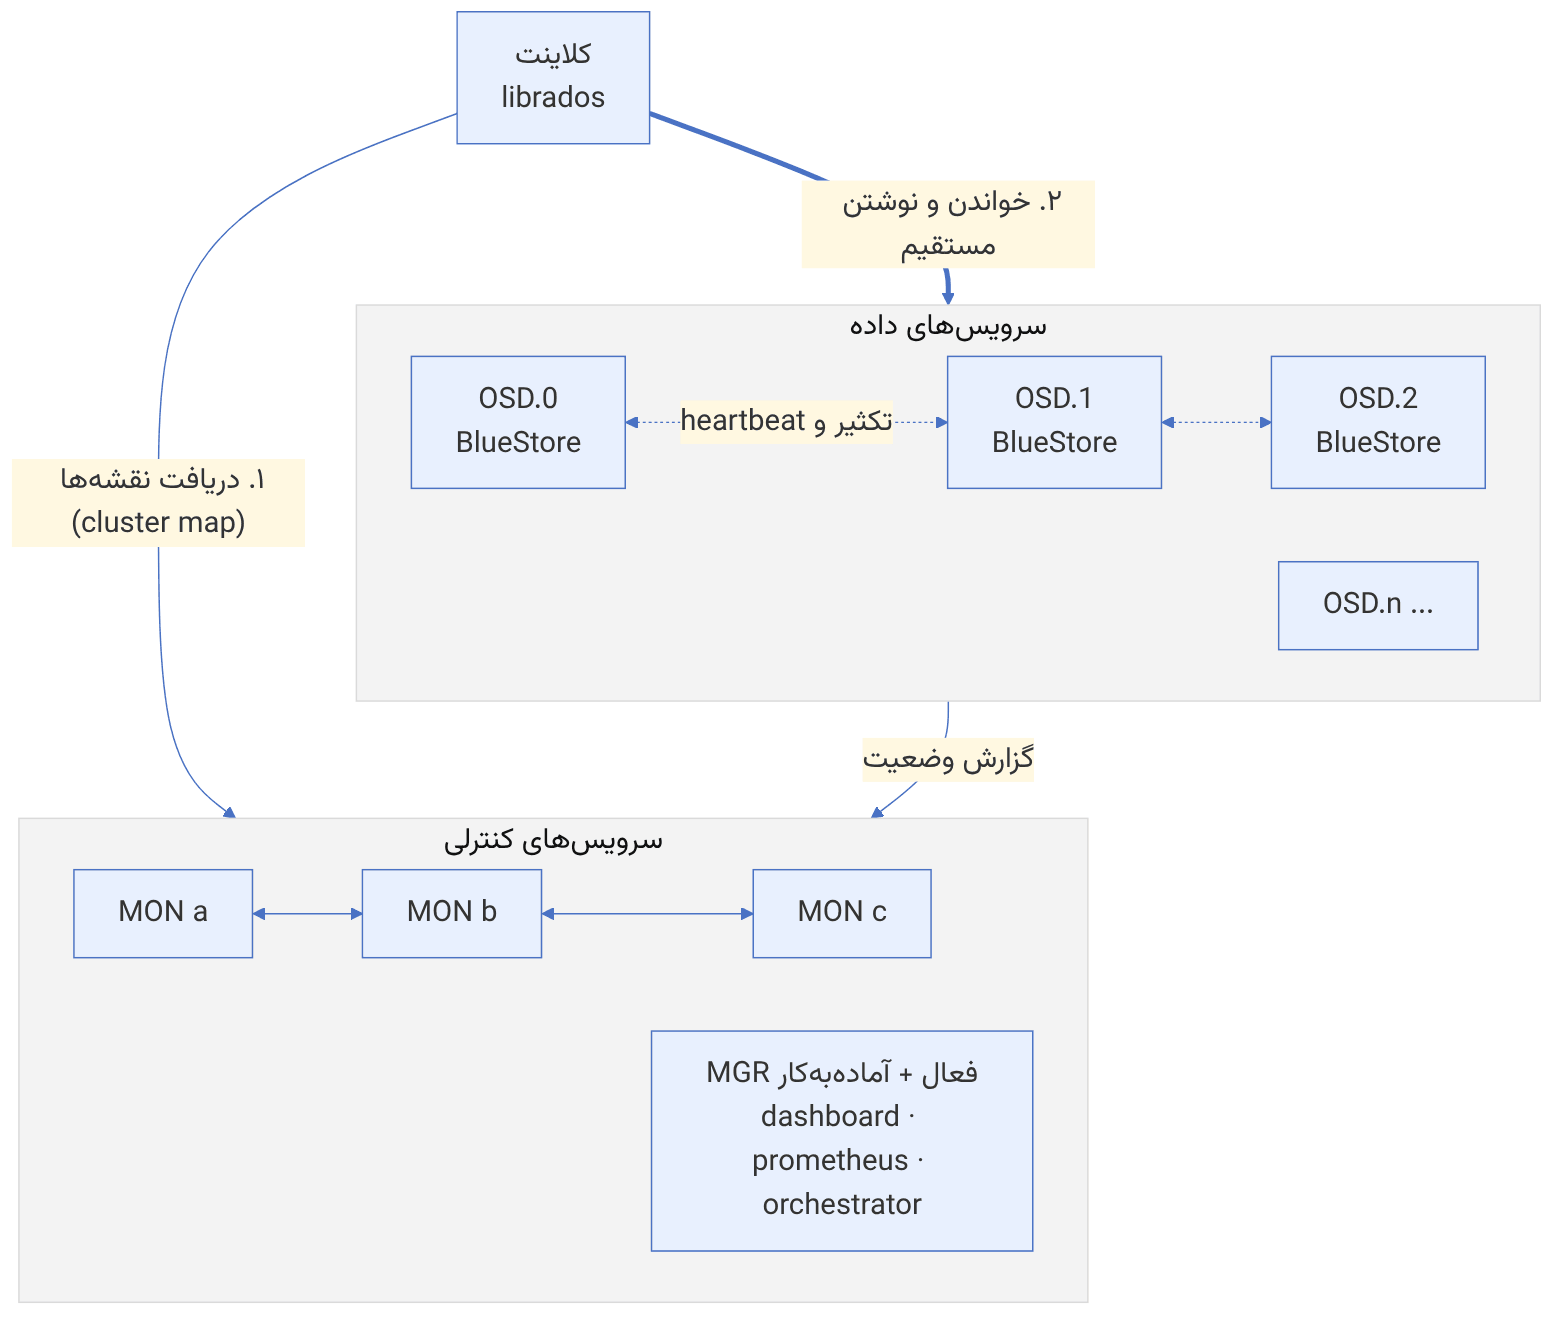
کلمهی «Autonomic» در نام RADOS کلیدی است. در Ceph هیچ سرور مرکزیای تصمیم نمیگیرد کدام داده باید کجا کپی شود. هر OSD خودش وضعیت همسایههایش را پایش میکند، خرابی را گزارش میدهد و وقتی نقشهی کلاستر عوض شد، خودش دادههای لازم را از همتایانش میکشد. MONها فقط «نقشه» را نگه میدارند و روی آن اجماع میکنند؛ در مسیر داده قرار ندارند. همین طراحی است که Ceph را تا هزاران OSD مقیاسپذیر میکند.
۱-۲-۴ Ceph از کجا آمد؟#
Ceph حاصل پژوهش دکترای Sage Weil در دانشگاه کالیفرنیا در سانتا کروز (UCSC) است. مقالههای بنیادی آن در سال ۲۰۰۶ منتشر شدند: مقالهی Ceph در کنفرانس OSDI و مقالهی الگوریتم CRUSH در کنفرانس SC. مقالهی RADOS هم در ۲۰۰۷ آمد. نام Ceph از «cephalopod» (سرپایان، خانوادهی هشتپا) گرفته شده و به همین دلیل نام نسخهها هم از جانوران این خانواده انتخاب میشود: از Argonaut و Bobtail تا Reef، Squid، Tentacle و Umbrella.
| سال | رویداد |
|---|---|
| ۲۰۰۶–۲۰۰۷ | انتشار مقالههای Ceph، CRUSH و RADOS |
| ۲۰۱۰ | ورود کلاینت CephFS به هستهی لینوکس (نسخهی ۲.۶.۳۴) |
| ۲۰۱۲ | تأسیس Inktank برای پشتیبانی تجاری؛ انتشار نخستین نسخهی پایدار Argonaut |
| ۲۰۱۴ | خرید Inktank توسط Red Hat |
| ۲۰۱۷ | Luminous: پایدار و پیشفرض شدن BlueStore و اجباری شدن ceph-mgr (معرفیشده در Kraken) |
| ۲۰۱۸ | تأسیس Ceph Foundation زیر چتر Linux Foundation |
| ۲۰۲۰ | Octopus: معرفی cephadm و ارکستراتور مبتنی بر کانتینر |
| ۲۰۲۳ | انتقال تیم ذخیرهسازی Red Hat (از جمله Ceph) به IBM |
| ۲۰۲۴–۲۰۲۶ | Squid، Tentacle و Umbrella؛ FastEC، دروازهی NVMe-oF، ماژول SMB و پیشنمایش Crimson |
تا چند سال پیش Jewel و Luminous رایج بودند، FileStore موتور ذخیرهسازی پیشفرض بود و نصب با ceph-deploy انجام میشد. اگر منابع قدیمیتر را خواندهاید، بخش زیادی از تفاوت آنها با این کتاب در همین موارد است.
۱-۳ پایان دوران RAID#
۱-۳-۱ RAID چه مشکلی را حل میکرد؟#
RAID در دههی ۱۹۸۰ برای حل مسئلهای مشخص طراحی شد: ساختن دیسکی بزرگتر، سریعتر و قابلاعتمادتر از چند دیسک کوچک و ارزان. RAID 1 با آینه کردن، RAID 5 با یک parity و RAID 6 با دو parity تحمل خرابی یک یا دو دیسک را ممکن میکردند. در دورهای که دیسکها چند ده گیگابایت بودند و هر سرور چند دیسک داشت، این راهحل عالی بود. اما ظرفیت دیسکها در سه دهه هزاران برابر شد و سرعت انتقالشان فقط دهها برابر. همین ناهمخوانی ساده است که RAID را در مقیاس امروز ناکارآمد میکند.
۱-۳-۲ بازسازی RAID دردناک است#
وقتی یک دیسک در آرایهی RAID 5 یا ۶ خراب میشود، کنترلر باید محتوای آن را از روی همهی دیسکهای باقیمانده بخواند، دوباره محاسبه کند و روی دیسک یدک بنویسد. سرعت این کار به سرعت نوشتن یک دیسک (یدک) محدود است. یک دیسک ۲۰ ترابایتی با نرخ پایدار حدود ۲۰۰ مگابایت بر ثانیه در بهترین حالت حدود ۲۸ ساعت برای پر شدن لازم دارد. در عمل، چون آرایه همزمان به کاربران هم سرویس میدهد، بازسازی معمولاً چند روز طول میکشد. در تمام این مدت:
- آرایه در حالت تنزلیافته کار میکند و کاراییاش بهشدت افت کرده است.
- تحمل خرابی کم شده است. در RAID 5، خرابی دیسک دوم یعنی از دست رفتن کل آرایه.
- همهی دیسکهای باقیمانده زیر بار سنگین خواندناند. این همان لحظهای است که دیسکهای همسن و همسری احتمال خرابی بیشتری دارند.
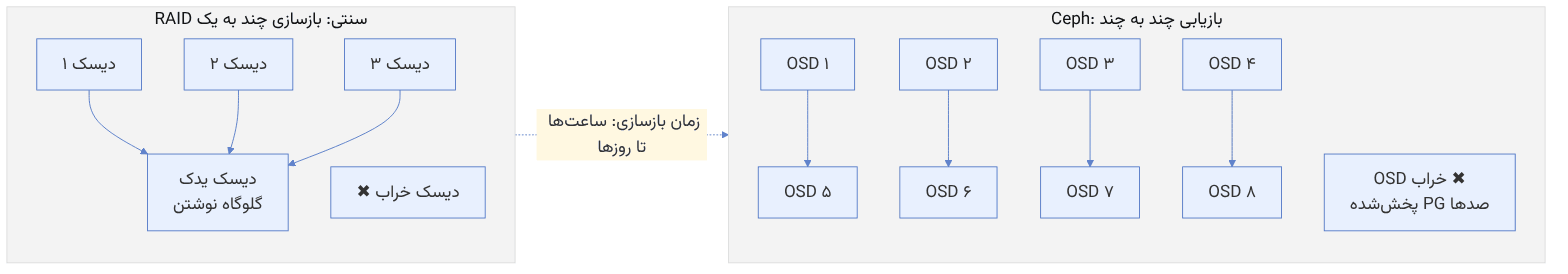
در Ceph دادهی یک OSD خراب در قالب صدها placement group روی دهها یا صدها OSD دیگر پراکنده است. وقتی OSD از کار میافتد، هر PG مستقلاً روی OSD جدیدی بازسازی میشود. یعنی دهها دیسک بهصورت موازی میخوانند و دهها دیسک دیگر موازی مینویسند. این بازیابی توزیعشده و غیرمتمرکز (declustered recovery) زمان ترمیم را از روزها به دقیقهها یا چند ساعت میرساند و هرچه کلاستر بزرگتر باشد، سریعتر هم میشود.
۱-۳-۳ دیسک یدک هزینه را بالا میبرد#
RAID برای واکنش سریع به خرابی به دیسک یدک داغ (hot spare) نیاز دارد: دیسکی که خریده شده، برق میخورد، جا اشغال میکند و هیچ دادهای ندارد. در یک مرکز داده با صدها آرایه، این یعنی صدها دیسک بیکار. در Ceph مفهوم دیسک یدک وجود ندارد. «ظرفیت آزاد» کل کلاستر نقش یدک را بازی میکند. کافی است کلاستر را طوری برنامهریزی کنید که پس از خرابی یک دامنهی خرابی (مثلاً یک میزبان) هنوز زیر آستانهی پر شدن بماند. این ظرفیت همزمان برای سرویسدهی عادی هم استفاده میشود و هدر نمیرود.
۱-۳-۴ RAID گران و وابسته به سختافزار است#
RAID سختافزاری به کنترلر اختصاصی، حافظهی نهان با باتری یا خازن پشتیبان، و اغلب دیسکهای «تأییدشده» با قیمت بالاتر نیاز دارد. وقتی کنترلر خراب شود، اغلب فقط کنترلر همان مدل (و گاهی همان نسخهی firmware) میتواند آرایه را دوباره بشناسد. Ceph برعکس، دیسکها را مستقیم و بدون لایهی RAID میبیند (حالت JBOD یا HBA). هوشمندی در نرمافزار است و هر سرور معمولی با کارت HBA ساده کفایت میکند.
هرگز OSDهای Ceph را روی volumeهای RAID 5 یا RAID 6 نسازید. این کار دو لایهی افزونگی روی هم میگذارد، ظرفیت را هدر میدهد، تأخیر نوشتن را بالا میبرد و مهمتر از همه، اطلاعات خرابی تکدیسک را از دید Ceph پنهان میکند. اگر کنترلر شما حالت HBA یا passthrough ندارد، بهترین گزینهی بعدی ساختن یک RAID 0 تکدیسکی برای هر دیسک فیزیکی است، و در این حالت حتماً حافظهی نهان نوشتن کنترلر را با دقت (و فقط با BBU سالم) پیکربندی کنید.
۱-۳-۵ بزرگ کردن گروه RAID دشوار است#
اضافه کردن دیسک به یک گروه RAID موجود یا ممکن نیست یا عملیاتی طولانی و پرخطر است که کل آرایه را بازنویسی میکند. در عمل، سازمانها گروه RAID جدید میسازند و داده را دستی بین گروهها پخش میکنند. در Ceph افزودن دیسک یعنی افزودن OSD. CRUSH بهطور خودکار و تنها با جابهجایی کمینهی دادهها، سهم متناسبی از PGها را به OSD جدید میدهد. میتوانید یک دیسک، یک سرور یا ده رک را به همان شیوه اضافه کنید.
۱-۳-۶ مدل اطمینانپذیری RAID دیگر قانعکننده نیست#
مهمترین ضعف RAID آماری است. دیسکهای سخت یک مشخصهی نرخ خطای خواندن غیرقابلبازیابی (URE) دارند که برای دیسکهای ردهی مصرفی معمولاً یک خطا در هر بیت و برای دیسکهای سازمانی یک خطا در هر بیت اعلام میشود. بیت حدود ۱۲٫۵ ترابایت است. بازسازی یک آرایهی RAID 5 که مجموع ظرفیت دیسکهای سالمش چند ده ترابایت است، یعنی خواندن چند برابر این مقدار. احتمال برخورد با دستکم یک URE در طول بازسازی دیگر ناچیز نیست، و در RAID 5 چنین خطایی میتواند به از دست رفتن بلوک یا شکست کامل بازسازی بینجامد.
محاسبهی سادهی این احتمال آموزنده است. اگر نرخ URE را در هر بیت بگیریم و بازسازی نیازمند خواندن بیت باشد، احتمال عبور بدون خطا تقریباً برابر است با . برای خواندن ۴۰ ترابایت (حدود بیت)، حدود ۳٫۲ میشود و احتمال عبور بدون خطا تنها حدود ۴ درصد است. این عدد بدبینانه است، چون نرخ واقعی دیسکها معمولاً از عدد درجشده در برگهی مشخصات بهتر است، اما جهت روند را بهخوبی نشان میدهد.
Ceph این مشکل را از چند جهت مهار میکند. اول، هر PG مستقل است، پس یک خطای خواندن فقط یک شیء را تحت تأثیر قرار میدهد، نه کل دیسک را. دوم، Ceph با checksum روی همهی دادهها (در BlueStore بهصورت پیشفرض crc32c) خرابی خاموش را تشخیص میدهد و نسخهی سالم را از همتای دیگر میخواند. سوم، فرایند scrub و deep scrub بهطور دورهای همهی نسخهها را با هم مقایسه میکند تا خرابیهای پنهان پیش از آنکه به آنها نیاز پیدا کنیم کشف شوند. چهارم، میتوانید با تکثیر سهتایی یا erasure coding با m بزرگتر، سطح حفاظت را برای هر pool جداگانه انتخاب کنید.
| جنبه | RAID 6 | Ceph با تکثیر ۳تایی | Ceph با EC 8+3 |
|---|---|---|---|
| تحمل خرابی همزمان | ۲ دیسک در هر گروه | ۲ دامنهی خرابی (مثلاً ۲ میزبان) | ۳ دامنهی خرابی |
| سربار ظرفیت | ۲ دیسک از n | ۲۰۰٪ | حدود ۳۸٪ |
| گلوگاه بازسازی | یک دیسک یدک | کل کلاستر | کل کلاستر |
| تشخیص خرابی خاموش | معمولاً محدود | checksum و deep scrub | checksum و deep scrub |
| دامنهی خرابی | یک سرور یا قفسه | قابلتنظیم: دیسک، میزبان، رک، اتاق | قابلتنظیم |
۱-۴ معماری Ceph در یک نگاه#
۱-۴-۱ RADOS: قلب سیستم#
همهچیز در Ceph در نهایت شیء است: یک دیسک RBD به هزاران شیء ۴ مگابایتی شکسته میشود، یک فایل CephFS به اشیای داده و فراداده، و یک شیء S3 به یک head object بههمراه بخشهایش. RADOS لایهای است که این اشیاء را ذخیره، تکثیر، توزیع و ترمیم میکند. هر شیء در RADOS یک نام، دادهی باینری، تعدادی xattr (ویژگیهای کوچک کلید-مقدار) و یک omap (فضای کلید-مقدار مرتب و بزرگتر) دارد. omap همان جایی است که مثلاً RGW فهرست اشیای هر bucket را نگه میدارد.
۱-۴-۲ daemonهای اصلی#
| daemon | نقش | تعداد معمول در production | نکتهی عملیاتی |
|---|---|---|---|
| MON (ceph-mon) | نگهداری نقشههای کلاستر و اجماع با Paxos؛ احراز هویت cephx | ۳ یا ۵ (فرد) | روی دیسک SSD با تأخیر کم؛ اکثریت باید زنده بماند |
| MGR (ceph-mgr) | آمار، ماژولها (dashboard، prometheus، orchestrator، balancer، pg_autoscaler) | ۲ (یکی فعال، یکی آمادهبهکار) | بدون MGR فعال، آمار و بسیاری از دستورها کار نمیکنند |
| OSD (ceph-osd) | ذخیرهی داده، تکثیر، بازیابی، scrub | یکی برای هر دیسک (یا چند تا برای NVMe بزرگ) | حافظهی پیشفرض هدف ۴ گیگابایت برای هر OSD |
| MDS (ceph-mds) | فرادادهی فایلسیستم CephFS | حداقل یک فعال و یک standby برای هر فایلسیستم | فقط برای CephFS لازم است |
| RGW (radosgw) | دروازهی HTTP برای S3 و Swift | چند نمونه پشت load balancer | بدون حالت؛ مقیاس افقی ساده |
Monitor (MON)#
MONها «حافظهی رسمی» کلاسترند. آنها مجموعهای از نقشهها را نگه میدارند: MON map، OSD map، PG map (در نسخههای جدید بخش بزرگی از آمار PG در MGR است)، CRUSH map، MDS map (FSMap) و غیره. هر تغییر در این نقشهها با الگوریتم اجماع Paxos بین MONها توافق میشود و یک epoch تازه میگیرد. برای اینکه کلاستر بتواند تصمیم بگیرد، باید اکثریت MONها (quorum) در دسترس باشند؛ به همین دلیل تعداد MONها فرد انتخاب میشود. سه MON خرابی یکی را تحمل میکنند و پنج MON خرابی دو تا را.
Manager (MGR)#
MGR از نسخهی Luminous به بعد بخش اجباری کلاستر است. آمار PGها، مصرف فضا و کارایی را جمع میکند و مجموعهای از ماژولهای Python را اجرا میکند. داشبورد وب، صادرکنندهی Prometheus، ارکستراتور cephadm، متعادلکننده (balancer) و مقیاسدهندهی خودکار PG همه ماژولهای MGR هستند. در هر لحظه فقط یک MGR فعال است و بقیه در حالت آمادهبهکار میمانند.
Object Storage Daemon (OSD)#
هر OSD معمولاً مسئول یک دستگاه ذخیرهسازی است. OSDها دادهها را ذخیره میکنند، در تکثیر و بازیابی شرکت میکنند، با همتایانشان heartbeat رد و بدل میکنند و خرابی همتایان را به MON گزارش میدهند. از Luminous به بعد موتور ذخیرهسازی پیشفرض BlueStore است که مستقیم روی دستگاه خام کار میکند (فصل ۱۲). OSDها هوشمندند: خودشان تشخیص میدهند کدام PGها متعلق به آنهاست و خودشان فرایند همتاسازی (peering) و بازیابی را هدایت میکنند.
MDS و RGW#
MDS فقط برای CephFS لازم است و فرادادهی فایلسیستم (درخت پوشهها، مجوزها، قفلها) را مدیریت میکند، در حالی که خود دادهی فایلها مستقیم بین کلاینت و OSDها جابهجا میشود. RGW یک سرور HTTP است که درخواستهای S3 و Swift را به عملیات RADOS ترجمه میکند. هر دو در فصلهای مربوط به خودشان (۴، ۵ و ۶) به تفصیل بررسی میشوند.
۱-۴-۳ CRUSH: محاسبه بهجای جستوجو#
سیستمهای ذخیرهسازی توزیعشدهی سنتی برای یافتن جای هر قطعهی داده به یک جدول جستوجوی مرکزی (metadata server یا name node) متکیاند. این جدول در مقیاس بزرگ هم گلوگاه کارایی است و هم نقطهی شکست. Ceph این جدول را حذف میکند. جای هر شیء با الگوریتم قطعی CRUSH (Controlled Replication Under Scalable Hashing) محاسبه میشود. هر کلاینتی که نقشهی کلاستر را داشته باشد، میتواند بدون پرسیدن از هیچ سروری بفهمد شیء موردنظرش روی کدام OSDها قرار دارد.
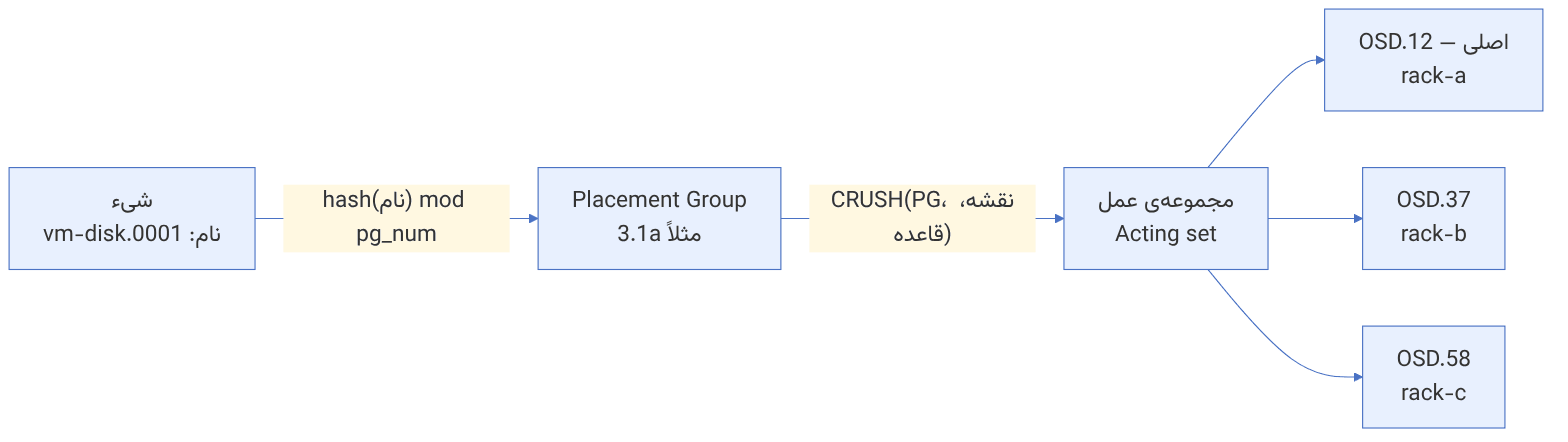
این نگاشت در دو مرحله انجام میشود:
- ۱. شیء به PG: نام شیء hash میشود و باقیماندهی آن بر تعداد PGهای pool (بهصورت پایدار و با روشی به نام stable mod) شمارهی PG را تعیین میکند. شناسهی PG ترکیبی از شمارهی pool و شمارهی PG است، مثلاً
3.1a. - ۲. PG به OSDها: CRUSH با ورودی شناسهی PG، نقشهی سلسلهمراتبی کلاستر (رکها، میزبانها، دیسکها و وزن آنها) و قاعدهی pool، فهرستی مرتب از OSDها برمیگرداند. اولین OSD اصلی (primary) است و نوشتنها از طریق آن هماهنگ میشوند.
چرا لایهی PG لازم است؟ اگر CRUSH را مستقیم روی هر شیء اجرا میکردیم، هر OSD باید وضعیت میلیاردها شیء را جداگانه با همتایانش هماهنگ میکرد. PG یک لایهی تجمیع است: میلیاردها شیء در چند هزار PG دستهبندی میشوند و همتاسازی، بازیابی و scrub در سطح PG انجام میشود. تعداد PGها مصالحهای است بین توزیع یکنواخت (PG بیشتر) و سربار حافظه و CPU (PG کمتر). از Nautilus به بعد ماژول pg_autoscaler این تعداد را خودکار تنظیم میکند.
۱-۴-۴ Pool: واحد سیاستگذاری#
pool یک فضای نام منطقی است که سیاست ذخیرهسازی را تعیین میکند: نوع حفاظت (تکثیر یا erasure coding)، تعداد نسخهها (size) و حداقل نسخهی لازم برای پذیرش I/O (min_size)، قاعدهی CRUSH (کدام دیسکها و کدام دامنهی خرابی)، تعداد PGها، فشردهسازی و سهمیه. هر pool یک application tag هم دارد (rbd، rgw یا cephfs) که مشخص میکند کدام رابط از آن استفاده میکند.
برای poolهای تکثیری، size=3 و min_size=2 پیشفرض و توصیهی استاندارد است. هرگز در production min_size=1 نگذارید: در این حالت ممکن است کلاستر با تنها یک نسخه نوشتن بپذیرد و اگر همان OSD هم از دست برود، دادهی تأییدشدهی کلاینت از بین میرود.
۱-۴-۵ مسیر نوشتن یک شیء#
وقتی کلاینت شیئی را در یک pool تکثیری با size=3 مینویسد:
- ۱. کلاینت (اگر نقشهی تازهای ندارد) آخرین OSD map را از یکی از MONها میگیرد.
- ۲. با hash و CRUSH، PG و OSD اصلی را محاسبه میکند و درخواست را مستقیم به OSD اصلی میفرستد.
- ۳. OSD اصلی نوشتن را در تراکنش محلی خود اعمال میکند و همزمان آن را برای دو OSD ثانویه میفرستد.
- ۴. هر OSD ثانویه پس از ثبت پایدار داده، به OSD اصلی پاسخ میدهد.
- ۵. وقتی همهی نسخههای مجموعهی عمل (acting set) نوشتن را پایدار کردند، OSD اصلی به کلاینت تأیید (ack) میفرستد.
این یعنی Ceph سازگاری قوی دارد: پس از تأیید نوشتن، هر خواندنی از هر کلاینتی آخرین داده را میبیند. خواندنها بهطور پیشفرض از OSD اصلی انجام میشوند (البته RBD و CephFS در شرایط خاص امکان خواندن از نزدیکترین نسخه را هم دارند).
۱-۵ برنامهریزی استقرار Ceph#
۱-۵-۱ از نیاز به معماری#
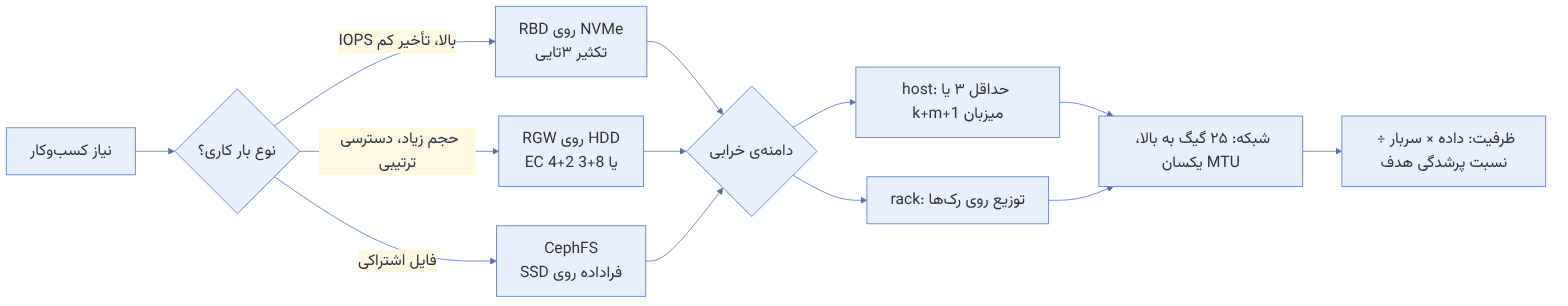
بیشترین اشتباههای پرهزینه در Ceph نه هنگام اجرا، که هنگام خرید سختافزار رخ میدهند. پیش از هر چیز باید به این پرسشها جواب داد:
- کدام رابطها؟ فقط RBD برای OpenStack یا Kubernetes، فقط S3 برای آرشیو و پشتیبان، یا ترکیبی از هر سه؟
- الگوی بار: I/O تصادفی کوچک (پایگاه داده، ماشین مجازی) یا ترتیبی بزرگ (ویدئو، پشتیبان، دادهی تحلیلی)؟ نسبت خواندن به نوشتن چقدر است؟
- ظرفیت مفید امروز و سه سال آینده و نرخ رشد ماهانه.
- اهداف کارایی: IOPS و توان عملیاتی موردنیاز و تأخیر قابلقبول در صدک ۹۹.
- دامنهی خرابی: خرابی چه چیزی را باید بدون قطعی تحمل کرد؟ یک دیسک، یک سرور، یک رک، یا یک سالن کامل؟
- دسترسپذیری جغرافیایی: آیا تکثیر به سایت دوم لازم است؟ همگام یا ناهمگام؟
۱-۵-۲ سختافزار: هر daemon چه میخواهد؟#
راهنمای سختافزار مستندات رسمی Ceph نقطهی شروع خوبی است. جدول زیر خلاصهای عملی از آن بههمراه تجربهی رایج در production است:
| جزء | CPU | حافظه | دیسک | نکته |
|---|---|---|---|---|
| MON | ۲ تا ۴ هسته | حداقل ۴ تا ۸ گیگابایت؛ در کلاسترهای بزرگ بیشتر | SSD با حدود ۱۰۰ گیگابایت برای /var/lib/ceph | حساس به تأخیر fsync؛ از دیسک مشترک با OSD پرهیز کنید |
| MGR | ۲ تا ۴ هسته | ۴ گیگابایت به بالا | ناچیز | معمولاً هممیزبان با MON |
| OSD روی HDD | حدود ۱ هسته برای هر OSD | ۴ گیگابایت (osd_memory_target) بهعلاوهی حاشیه | HDD با WAL و DB روی NVMe | نسبت معمول ۴ تا ۱۰ HDD به ازای یک NVMe برای DB |
| OSD روی NVMe | ۴ تا ۸ هسته یا بیشتر برای هر OSD | ۴ تا ۸ گیگابایت | NVMe سازمانی با PLP | CPU معمولاً گلوگاه اصلی است |
| MDS | هستهی پرسرعت (تکرشتهای مهم است) | بسته به cache؛ ۸ تا ۶۴ گیگابایت | ناچیز | mds_cache_memory_limit را تنظیم کنید |
| RGW | ۴ تا ۸ هسته | ۸ تا ۱۶ گیگابایت | ناچیز | پشت load balancer و چند نمونه |
SSDهای مصرفی بدون حفاظت در برابر قطع برق (Power Loss Protection یا PLP) برای Ceph مناسب نیستند. Ceph برای هر نوشتن پایدار از flush استفاده میکند و SSDهای بدون PLP در این الگو هم بسیار کند میشوند و هم در قطع ناگهانی برق ممکن است دادهی تأییدشده را از دست بدهند. برای OSD، DB/WAL و MON فقط از SSD یا NVMe سازمانی با PLP استفاده کنید.
۱-۵-۳ شبکه#
Ceph یک سیستم شبکهمحور است و شبکه بیش از هر جزء دیگری روی کارایی و پایداری اثر دارد. دو شبکهی منطقی وجود دارد:
- شبکهی عمومی (public network): ارتباط کلاینتها با MON، OSD، MDS و RGW. اجباری است.
- شبکهی کلاستر (cluster network): ترافیک تکثیر، بازیابی و heartbeat بین OSDها. اختیاری است.
مستندات جدید Ceph تأکید میکنند که شبکهی کلاستر جداگانه همیشه لازم نیست و در بسیاری از طراحیها یک شبکهی واحد با پهنای باند کافی (مثلاً دو پیوند ۲۵ یا ۱۰۰ گیگابیتی در قالب bond) سادهتر و قابلاعتمادتر است. اگر شبکهی کلاستر جدا بسازید، باید به همان اندازهی شبکهی عمومی قابلاعتماد باشد. خرابی نیمهی شبکهی کلاستر میتواند باعث شود OSDها همدیگر را down گزارش کنند در حالی که از دید MON زندهاند، و نتیجه پدیدهی ناخوشایند flapping است.
MTU را در کل مسیر یکسان نگه دارید. اگر jumbo frame (MTU ۹۰۰۰) فعال میکنید، باید روی همهی کارتها، bondها، VLANها و سوئیچها فعال باشد. یک سوئیچ با MTU متفاوت میتواند باعث شود بستههای کوچک (heartbeat) رد شوند و بستههای بزرگ (تکثیر) گم شوند، که یکی از گیجکنندهترین مشکلات Ceph است. با ping -M do -s 8972 بین همهی nodeها آزمایش کنید.
۱-۵-۴ ظرفیت و نسبت پر شدن#
ظرفیت مفید کلاستر را نباید با «جمع دیسکها تقسیم بر ضریب تکثیر» محاسبه کرد. سه عامل دیگر باید در نظر گرفته شود:
- نسبتهای پر شدن: بهطور پیشفرض در ۸۵٪ هشدار
nearfull، در ۹۰٪ توقف backfill (backfillfull) و در ۹۵٪ توقف کامل نوشتن (full) رخ میدهد. - ظرفیت لازم برای بازیابی: پس از خرابی بزرگترین دامنهی خرابی (مثلاً یک میزبان)، دادهی آن باید روی بقیه جا شود و هنوز زیر nearfull بماند.
- عدم توازن: حتی با balancer، OSDها کاملاً یکسان پر نمیشوند و پرترین OSD تعیینکننده است.
یک محاسبهی سرانگشتی: ۶ میزبان، هر کدام ۱۲ دیسک ۱۶ ترابایتی، تکثیر سهتایی. ظرفیت خام ۱۱۵۲ ترابایت است. اگر یک میزبان از دست برود، ۹۶۰ ترابایت باقی میماند. برای ماندن زیر ۸۰٪ پس از خرابی، دادهی خام نباید از ۷۶۸ ترابایت بیشتر شود، یعنی حدود ۲۵۶ ترابایت دادهی مفید. همین کلاستر با EC 4+2 (سربار ۱٫۵) حدود ۵۱۲ ترابایت دادهی مفید میپذیرد، به شرط آنکه حداقل ۶ میزبان برای دامنهی خرابی host داشته باشیم (و ترجیحاً ۷ تا تا پس از خرابی یک میزبان، بازیابی ممکن باشد).
۱-۵-۵ دامنههای خرابی و تعداد node#
تعداد کمینهی میزبان به سیاست حفاظت بستگی دارد. برای تکثیر سهتایی با دامنهی خرابی host حداقل سه میزبان لازم است، اما چهار میزبان توصیه میشود تا پس از خرابی یکی، Ceph بتواند نسخهی سوم را جای دیگری بازسازی کند. برای erasure coding با پروفایل k+m حداقل k+m میزبان لازم است و k+m+1 برای ترمیم خودکار توصیه میشود. هرچه تعداد میزبانها بیشتر باشد، سهم هر کدام از داده کمتر و اثر خرابی هر یک کوچکتر است.
در کلاسترهای کوچک (سه یا چهار میزبان) خرابی یک میزبان یعنی از دست رفتن ۲۵ تا ۳۳ درصد ظرفیت خام و بار سنگین بازیابی روی بقیه. برنامهریزی نسبت پر شدن در این کلاسترها اهمیت دوچندان دارد.
۱-۶ ساختن آزمایشگاه مجازی#
۱-۶-۱ طراحی آزمایشگاه#
روش رایج قدیمی استفاده از VirtualBox و Vagrant برای ساختن چند ماشین مجازی بود. این روش هنوز کار میکند، اما امروز گزینههای سبکتری هم داریم: KVM/libvirt روی لینوکس، LXD یا Incus با ماشین مجازی، Multipass، یا حتی یک سرور ابری با چند ماشین. مهم نیست کدام را انتخاب کنید؛ ساختار پیشنهادی ما این است:
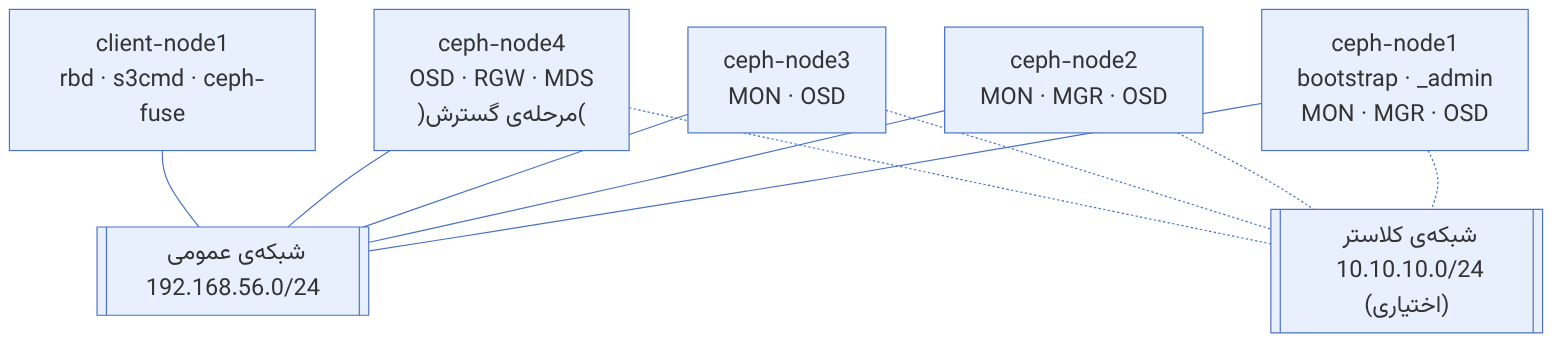
| ماشین | vCPU | حافظه | دیسکها | نقش |
|---|---|---|---|---|
| ceph-node1 | ۲ | ۴ گیگابایت | ۲۰ گیگابایت سیستم + ۳ دیسک ۲۰ گیگابایتی | bootstrap، _admin، MON، MGR، OSD |
| ceph-node2 | ۲ | ۴ گیگابایت | سیستم + ۳ دیسک | MON، MGR، OSD |
| ceph-node3 | ۲ | ۴ گیگابایت | سیستم + ۳ دیسک | MON، OSD |
| ceph-node4 | ۲ | ۴ گیگابایت | سیستم + ۳ دیسک | افزودهشده در بخش «بزرگ کردن کلاستر» |
| client-node1 | ۱ | ۲ گیگابایت | فقط سیستم | کلاینت RBD، S3 و CephFS |
۱-۶-۲ آمادهسازی ماشینها#
روی هر node یک توزیع پشتیبانیشده (مثلاً Rocky Linux 9، CentOS Stream 9 یا Ubuntu 24.04) نصب کنید. پیشنیازهای cephadm طبق مستندات رسمی عبارتاند از: Python 3 (در Umbrella دستکم ۳٫۹)، systemd، Podman یا Docker، همگامسازی زمان (chrony) و LVM2.
# روی همهی nodeها (نمونه برای Rocky/Alma 9)
sudo dnf install -y podman lvm2 chrony python3
sudo systemctl enable --now chronyd
# نامها باید از همهی nodeها قابلحل باشند
cat <<'H' | sudo tee -a /etc/hosts
192.168.56.11 ceph-node1
192.168.56.12 ceph-node2
192.168.56.13 ceph-node3
192.168.56.14 ceph-node4
192.168.56.20 client-node1
H
# دیسکهای خالی را ببینید (نباید پارتیشن یا فایلسیستم داشته باشند)
lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINTCeph Umbrella بر پایهی imageهای Rocky Linux 10 ساخته شده که به CPU با سطح ریزمعماری x86-64-v3 نیاز دارد. اگر آزمایشگاه شما روی ماشین مجازی با مدل CPU قدیمی یا شبیهسازیشده (مثلاً qemu64) است، daemonها اجرا نمیشوند. در libvirt از host-passthrough استفاده کنید یا برای آزمایشگاه نسخهی Tentacle را انتخاب کنید.
اگر بعداً cephadm دیسکی را «در دسترس» نشان نداد، معمولاً یکی از این دلایل است: دیسک پارتیشن یا امضای فایلسیستم قدیمی دارد، کمتر از ۵ گیگابایت است، mount شده است، یا LVM روی آن هست. با ceph orch device ls --wide دلیل رد شدن (ستون REJECT REASONS) را ببینید و در آزمایشگاه با ceph orch device zap <host> <path> --force پاکش کنید.
۱-۷ نصب و پیکربندی Ceph با cephadm#
۱-۷-۱ چرا cephadm؟#
cephadm از نسخهی Octopus ابزار رسمی استقرار و مدیریت چرخهی عمر Ceph است. سه ویژگی آن را از ابزارهای قدیمی متمایز میکند:
- کانتینری: هر daemon در یک کانتینر Podman یا Docker با image رسمی Ceph اجرا میشود. نسخهی Ceph از نسخهی بستههای سیستمعامل جداست و ارتقا یعنی تعویض image.
- ارکستراتور داخلی: cephadm بهصورت یک ماژول MGR اجرا میشود و از طریق SSH با میزبانها کار میکند. شما «وضعیت مطلوب» را اعلام میکنید (مثلاً «سه MON روی این میزبانها») و ماژول آن را برقرار نگه میدارد؛ شبیه کنترلرهای Kubernetes.
- بدون وابستگی خارجی: به Ansible، Salt یا ابزار مدیریت پیکربندی دیگری نیاز ندارد. فقط SSH، Python و یک موتور کانتینر.
۱-۷-۲ نصب cephadm و bootstrap#
مستندات رسمی دو راه برای گرفتن cephadm پیشنهاد میدهند: بستهی توزیع (مثلاً apt install cephadm در Ubuntu یا مخزن centos-release-ceph-* در CentOS Stream) یا دریافت فایل اجرایی با curl. این دو روش را با هم ترکیب نکنید.
# روی ceph-node1 بهعنوان root
CEPH_RELEASE=tentacle # یا umbrella؛ فهرست نسخههای فعال را در صفحهی releases ببینید
curl --silent --remote-name --location \
https://download.ceph.com/rpm-${CEPH_RELEASE}/el9/noarch/cephadm
chmod +x cephadm
./cephadm add-repo --release ${CEPH_RELEASE}
./cephadm install
which cephadm # /usr/sbin/cephadmحالا نخستین MON و MGR را میسازیم. نشانی --mon-ip باید روی شبکهی عمومی باشد و از همهی nodeها و کلاینتها در دسترس باشد:
cephadm bootstrap \
  --mon-ip 192.168.56.11 \
  --cluster-network 10.10.10.0/24 \
  --initial-dashboard-user admin \
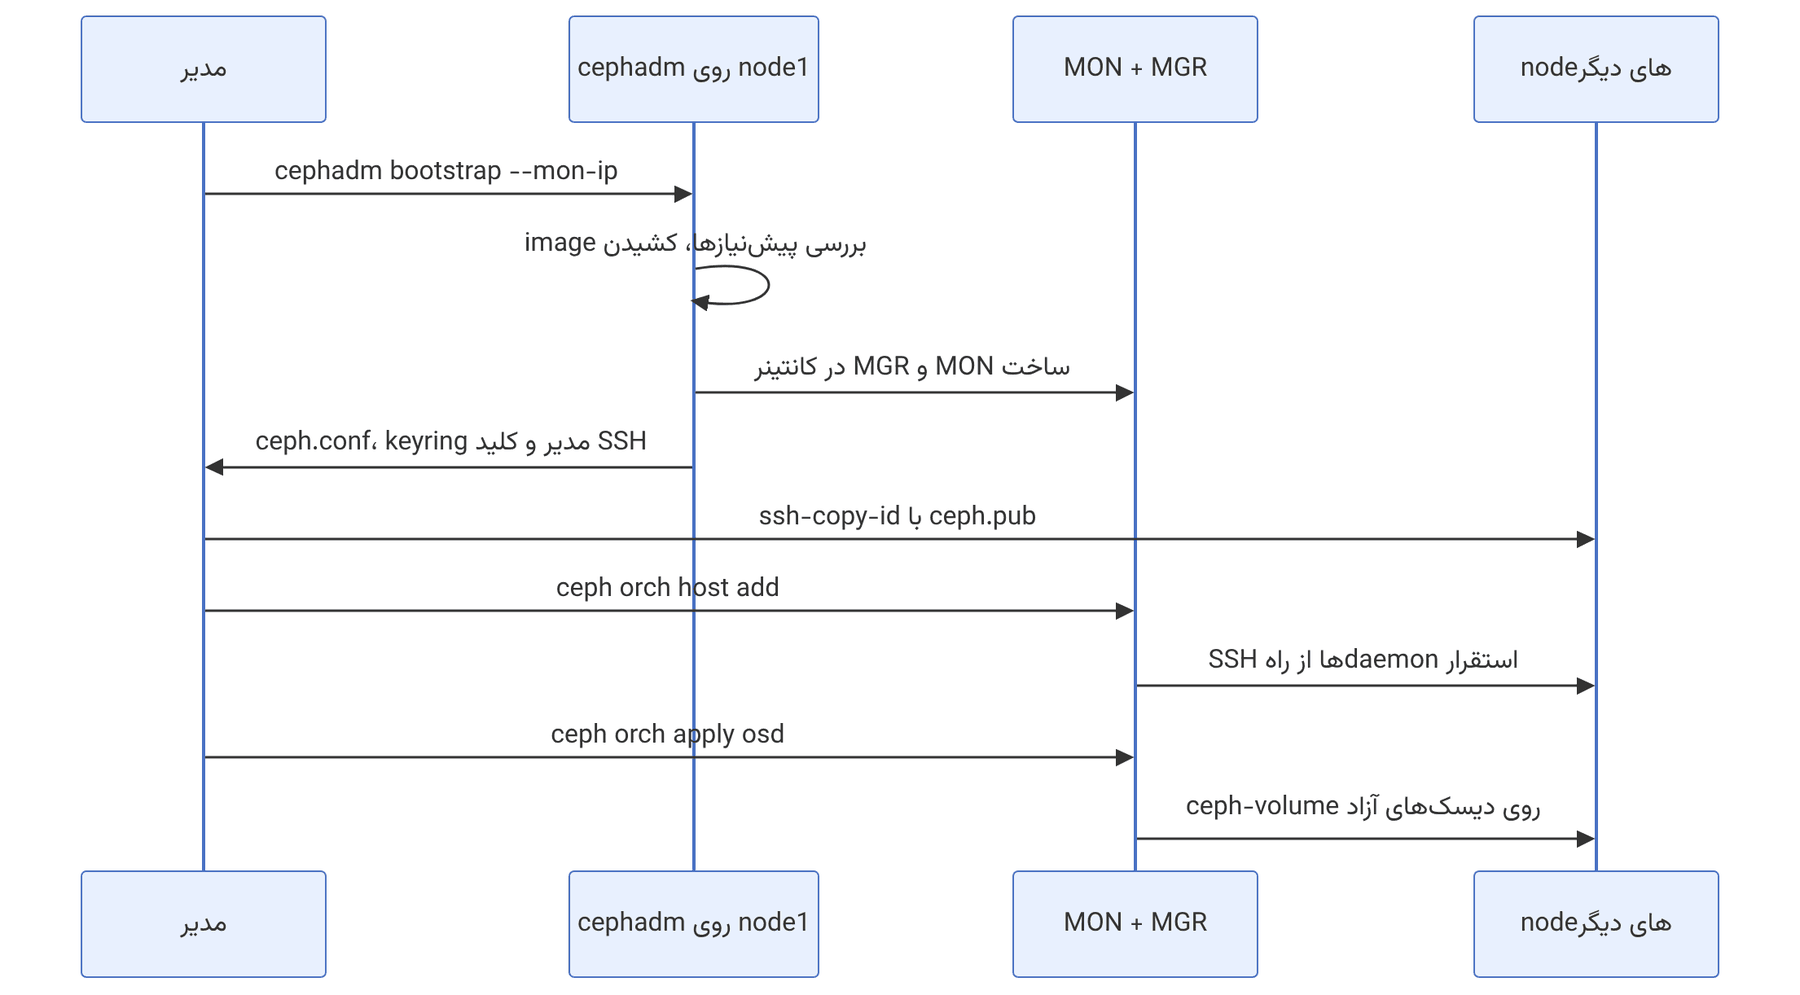
--allow-fqdn-hostnamebootstrap در پایان این کارها را انجام داده است: یک MON و یک MGR روی میزبان محلی ساخته، کلید SSH تازهای تولید و در authorized_keys کاربر root گذاشته، کلید عمومی را در /etc/ceph/ceph.pub نوشته، یک ceph.conf حداقلی و keyring مدیر (ceph.client.admin.keyring) را در /etc/ceph قرار داده، و برچسب _admin را به میزبان bootstrap داده است. نشانی و رمز موقت داشبورد هم در خروجی چاپ میشود.
فایل /etc/ceph/ceph.client.admin.keyring کلید کامل مدیریتی کلاستر است. هر کسی که آن را داشته باشد، میتواند همهی دادهها را بخواند یا حذف کند. این فایل را فقط روی میزبانهای مدیریتی (با برچسب _admin) نگه دارید، در مخزن Git یا پشتیبانهای عمومی قرار ندهید و برای برنامهها کاربر جداگانه با دسترسی محدود بسازید (فصل ۸).
۱-۷-۳ دسترسی به خط فرمان Ceph#
cephadm نیازی به نصب بستههای Ceph روی میزبان ندارد. دو راه برای اجرای دستورها دارید:
# راه ۱: پوستهای در کانتینر با همهی ابزارها
cephadm shell
cephadm shell -- ceph -s
# راه ۲: نصب ابزارهای خط فرمان روی میزبان
cephadm install ceph-common
ceph -v
ceph statusخروجی ceph status در این مرحله چیزی شبیه این است. هشدار مربوط به تعداد OSD طبیعی است، چون هنوز دیسکی اضافه نکردهایم:
  cluster:
    id:     3f6c1d2e-....-....
    health: HEALTH_WARN
            OSD count 0 < osd_pool_default_size 3
  services:
    mon: 1 daemons, quorum ceph-node1 (age 2m)
    mgr: ceph-node1.xkqzpa(active, since 1m)
    osd: 0 osds: 0 up, 0 in
۱-۷-۴ افزودن میزبانها#
برای اینکه ارکستراتور بتواند روی میزبانهای دیگر daemon بسازد، کلید عمومی کلاستر باید در authorized_keys آنها باشد:
ssh-copy-id -f -i /etc/ceph/ceph.pub root@ceph-node2
ssh-copy-id -f -i /etc/ceph/ceph.pub root@ceph-node3
ceph orch host add ceph-node2 192.168.56.12 --labels _admin
ceph orch host add ceph-node3 192.168.56.13
ceph orch host ls
پس از افزودن میزبانها، cephadm بهطور پیشفرض MONها را تا پنج عدد و MGRها را تا دو عدد روی میزبانهای موجود پخش میکند. در production بهتر است جای آنها را صریح تعیین کنید:
ceph orch apply mon --placement="ceph-node1,ceph-node2,ceph-node3"
ceph orch apply mgr --placement="ceph-node1,ceph-node2"
ceph orch ls
ceph orch psبهجای فهرست نام میزبانها، از برچسب استفاده کنید. مثلاً به سه میزبان برچسب mon بدهید و ceph orch apply mon --placement="label:mon" اجرا کنید. بعدها جابهجا کردن MON فقط با جابهجا کردن برچسب انجام میشود و نیازی به ویرایش spec نیست.
۱-۷-۵ افزودن OSDها#
سادهترین راه این است که بگوییم هر دیسک آزاد و مناسبی که در کلاستر هست، OSD شود:
ceph orch device ls
ceph orch apply osd --all-available-devices
# یا دیسک به دیسک:
ceph orch daemon add osd ceph-node1:/dev/sdb--all-available-devices یک سرویس مداوم میسازد: هر دیسک آزادی که بعداً به هر میزبانی اضافه شود هم خودکار OSD میشود. در آزمایشگاه این راحت است، اما در production ممکن است دیسکی را که برای کار دیگری وصل کردهاید ببلعد. پس از استقرار اولیه میتوانید با ceph orch apply osd --all-available-devices --unmanaged=true این رفتار را متوقف کنید، یا از ابتدا از یک OSD service spec با فیلترهای دقیق استفاده کنید (فصل ۱۱).
پس از چند دقیقه کلاستر باید به HEALTH_OK برسد:
ceph -s
ceph osd tree
ceph dfاگر OSDها ساخته نشدند، ceph orch ps --daemon-type osd و ceph log last cephadm را ببینید. روی میزبان مقصد هم cephadm ls و journalctl -u ceph-<fsid>@osd.<id> اطلاعات بیشتری میدهند. بیشتر اوقات مشکل یکی از اینهاست: کلید SSH اضافه نشده، image کانتینر قابل دریافت نیست (مثلاً به دلیل محدودیت اینترنت یا نبود mirror داخلی)، یا ساعت nodeها همگام نیست.
در محیطهایی که دسترسی مستقیم به quay.io ندارند، باید یک registry داخلی بسازید و image را آنجا mirror کنید، سپس با cephadm --image <registry>/ceph/ceph:<tag> bootstrap ... شروع کنید. مستندات «Deployment in an Isolated Environment» جزئیات را دارد.
۱-۷-۶ پیکربندی متمرکز#
از نسخهی Mimic به بعد پیکربندی Ceph بهجای فایلهای ceph.conf روی هر میزبان، در پایگاه پیکربندی MONها نگه داشته میشود. فایل ceph.conf روی میزبانها تقریباً فقط نشانی MONها را دارد.
ceph config dump # همهی تنظیمات غیرپیشفرض
ceph config get osd osd_memory_target # مقدار برای یک نوع daemon
ceph config set osd osd_max_backfills 2 # تغییر برای همهی OSDها
ceph config show osd.0 | head # مقدار مؤثر روی یک daemon در حال اجرا
ceph config help osd_memory_target # توضیح، نوع و مقدار پیشفرضcephadm هنگام bootstrap قابلیت تنظیم خودکار حافظهی OSD (osd_memory_target_autotune) را فعال میکند و بهطور پیشفرض ۰٫۷ حافظهی میزبان را میان OSDها تقسیم میکند. روی میزبانهایی که کار دیگری هم انجام میدهند (مثلاً hyperconverged)، این نسبت را کاهش دهید.
۱-۸ بزرگ کردن کلاستر#
۱-۸-۱ افزودن node چهارم#
یکی از زیباییهای Ceph این است که بزرگ کردن کلاستر یک «عملیات عادی» است، نه پروژه. ceph-node4 را مثل بقیه آماده کنید و اضافه کنید:
ssh-copy-id -f -i /etc/ceph/ceph.pub root@ceph-node4
ceph orch host add ceph-node4 192.168.56.14
ceph orch host label add ceph-node4 rgw
# اگر سرویس all-available-devices فعال است، دیسکها خودکار OSD میشوند
ceph orch device ls ceph-node4
watch -n 5 ceph -sدر خروجی ceph -s میبینید که بخشی از PGها در وضعیت remapped و backfilling قرار میگیرند. CRUSH سهم متناسبی از PGها را به OSDهای جدید داده و دادهها در حال جابهجاییاند. در این مدت کلاستر کاملاً در دسترس است.
در کلاستر production که دادهی زیادی دارد، افزودن ناگهانی تعداد زیادی OSD میتواند باعث موج سنگین backfill شود. از Quincy به بعد زمانبند mClock سهم بازیابی را خودکار مدیریت میکند. اگر کنترل بیشتری میخواهید، پیش از افزودن OSDها پرچم norebalance را بگذارید، همه را اضافه کنید و بعد پرچم را بردارید تا جابهجایی فقط یکبار و به مقصد نهایی انجام شود. ابزارهایی مثل upmap-remapped هم برای افزودن تدریجی وزن به کار میروند (فصل ۷).
۱-۸-۲ افزودن MON و سرویسهای دیگر#
ceph orch host label add ceph-node4 mon
# با برچسب، اما با سقف صریح ۳ نمونه (spec به زبان YAML)
cat > mon.yaml <<'Y'
service_type: mon
placement:
  count: 3
  label: mon
Y
ceph orch apply -i mon.yamlتعداد MONها را زوج نکنید. چهار MON هم مثل سه MON فقط خرابی یکی را تحمل میکنند (اکثریت ۳ از ۴)، اما یک عضو بیشتر برای رأیگیری و یک نقطهی خرابی بیشتر دارند. یا ۳ MON بمانید یا مستقیم به ۵ بروید.
در همین مرحله میتوانیم سرویسهای رابط را هم مستقر کنیم تا در فصلهای بعد از آنها استفاده کنیم:
ceph orch apply rgw demo --placement="label:rgw" --port=8080
ceph fs volume create cephfs01 # MDSها خودکار مستقر میشوند
ceph orch ls۱-۹ کار عملی با کلاستر#
۱-۹-۱ pool، شیء و rados#
بیایید با پایینترین لایه، یعنی RADOS، شروع کنیم. یک pool آزمایشی میسازیم، چند شیء در آن مینویسیم و میبینیم کجا ذخیره شدهاند:
ceph osd pool create lab-pool
ceph osd pool application enable lab-pool rados-test
echo "salam ceph" > /tmp/hello.txt
rados -p lab-pool put hello /tmp/hello.txt
rados -p lab-pool ls
rados -p lab-pool stat hello
ceph osd map lab-pool hello
خروجی ceph osd map چیزی شبیه این است و همهی مسیر نگاشتی را که در بخش CRUSH دیدیم نشان میدهد: شمارهی pool و PG، و فهرست OSDهای up و acting که اولیشان primary است.
osdmap e87 pool 'lab-pool' (5) object 'hello' -> pg 5.4a3e9f1b (5.1b) -> up ([4,9,1], p4) acting ([4,9,1], p4)یک OSD از این مجموعه را موقتاً متوقف کنید (ceph orch daemon stop osd.9)، دوباره ceph osd map را اجرا کنید و ceph -s را ببینید. PG وارد حالت degraded میشود، اما خواندن شیء (rados -p lab-pool get hello -) همچنان کار میکند. پس از حدود ده دقیقه (مقدار پیشفرض mon_osd_down_out_interval)، OSD متوقفشده out میشود و بازیابی آغاز میشود. در پایان OSD را دوباره راه بیندازید: ceph orch daemon start osd.9.
۱-۹-۲ نگاهی به PGها و فضا#
ceph osd pool ls detail
ceph pg ls-by-pool lab-pool | head
ceph osd df tree
ceph df detail
ceph osd pool autoscale-status
در خروجی ceph df دو ستون مهم وجود دارد: STORED (دادهی کاربر) و USED (فضای واقعی مصرفشده با احتساب تکثیر). ستون MAX AVAIL هم فضای قابلنوشتن را با در نظر گرفتن پرترین OSD و نسبت full نشان میدهد؛ همین است که برنامهریزی ظرفیت را باید بر اساس آن انجام داد، نه جمع خام.
۱-۹-۳ یک دیسک بلوکی سریع#
ceph osd pool create rbd
rbd pool init rbd
rbd create rbd/disk01 --size 10G
rbd info rbd/disk01
# روی client-node1 (پس از کپی ceph.conf و یک keyring مناسب؛ فصل ۲)
sudo rbd map rbd/disk01
sudo mkfs.xfs /dev/rbd0 && sudo mount /dev/rbd0 /mnt
۱-۹-۴ پاکسازی#
حذف pool در Ceph عمداً دشوار است تا تصادفی رخ ندهد:
ceph config set mon mon_allow_pool_delete true
ceph osd pool rm lab-pool lab-pool --yes-i-really-really-mean-it
ceph config set mon mon_allow_pool_delete falseهرگز mon_allow_pool_delete را در production بهطور دائم روشن نگذارید. یک اشتباه تایپی در اسکریپت پاکسازی میتواند یک pool واقعی را برای همیشه حذف کند. هیچ «سطل بازیافتی» برای pool وجود ندارد.
۱-۱۰ از درون کد: از نام شیء تا بایت روی دیسک#
۱-۱۰-۱ سه لایهی نگاشت#
هر درخواست RADOS از سه لایهی نگاشت عبور میکند. در هیچکدام جدول مرکزی «این شیء کجاست» وجود ندارد؛ همهچیز از روی نام شیء و OSDMap محاسبه میشود. این مهمترین تصمیم طراحی Ceph است و بقیهی فصلها بر پایهی آن هستند.
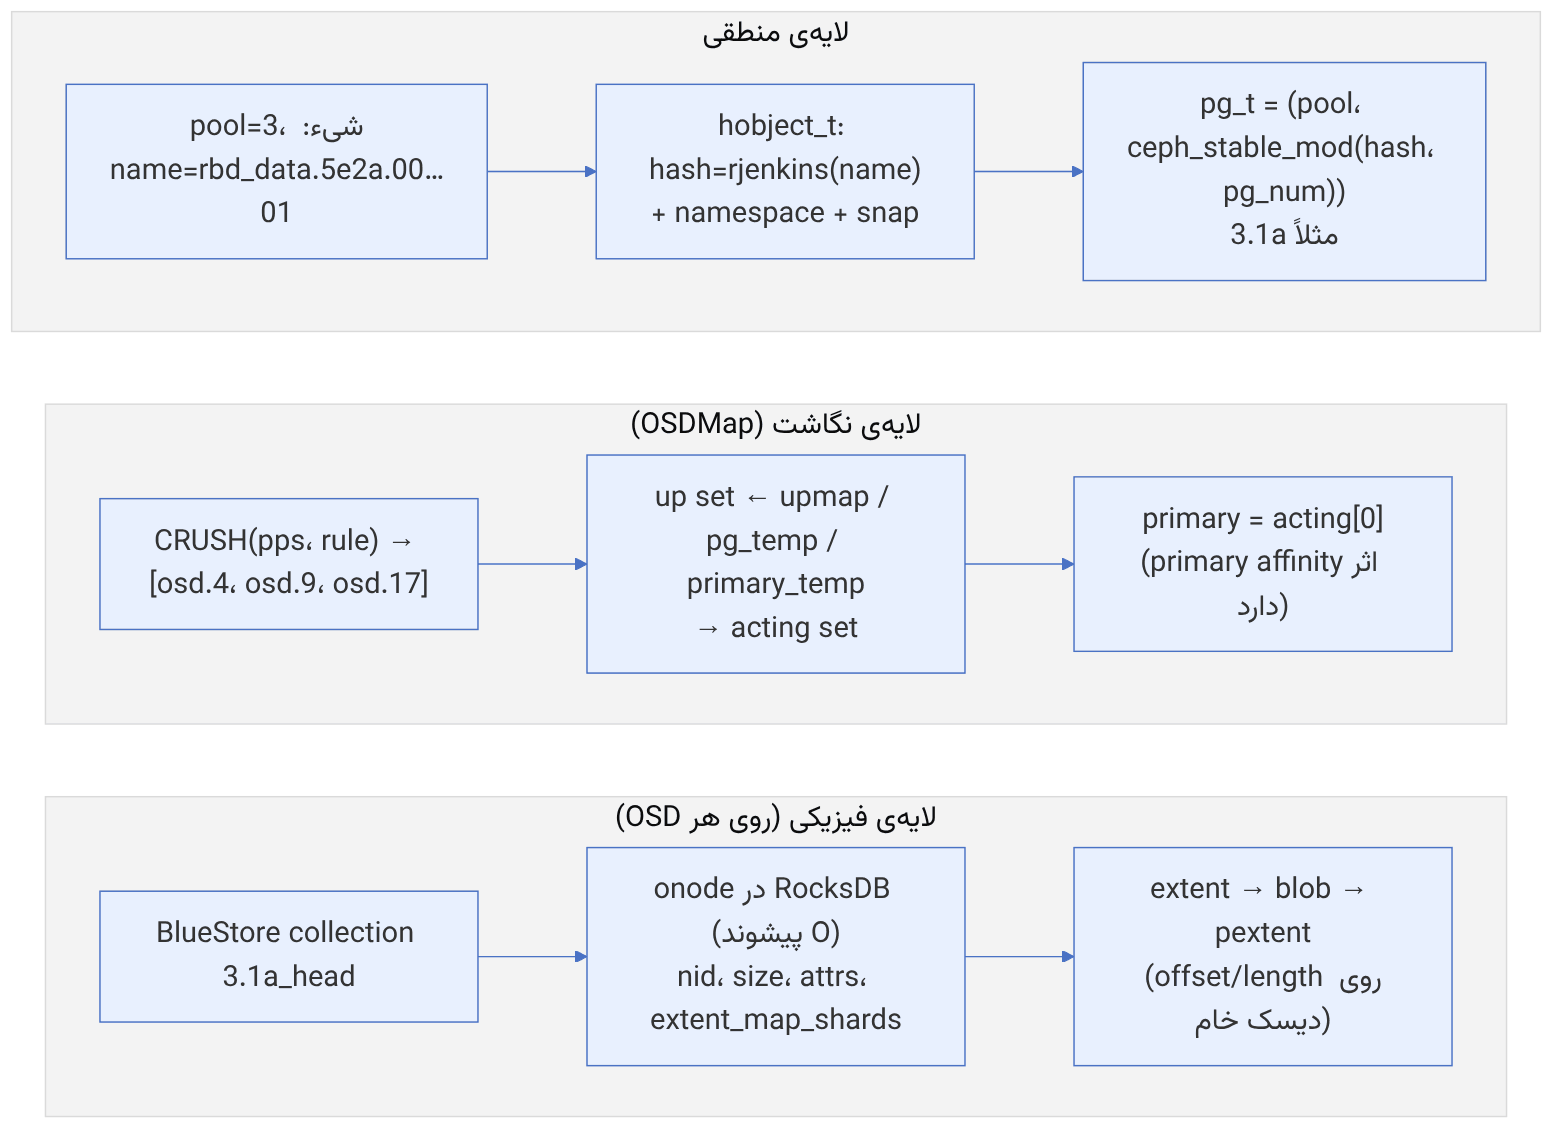
pseudocode: object → OSD (خلاصهی این کتاب از Objecter::_calc_target و OSDMap)
ps = ceph_str_hash_rjenkins(name) # یا hash pool دیگر
pg = (pool_id, ceph_stable_mod(ps, pg_num, pg_num_mask))
pps = crush_hash32_2(pg.ps, pool_id) # seed جایگذاری (هر pool متفاوت)
raw = crush_do_rule(rule, pps, size, weights)
up = apply_upmap(raw) ; drop down/out OSDs
acting = pg_temp.get(pg, up) ; primary = primary_temp.get(pg, acting[0])این محاسبه را خودتان اجرا کنید: ceph osd map rbd myobject همان مسیر را با OSDMap فعلی انجام میدهد و pg، up و acting را چاپ میکند. برای اجرای آفلاین روی یک نسخه از نقشه: ceph osd getmap -o om && osdmaptool om --test-map-object myobject --pool 3.
۱-۱۰-۲ ساختارهای روی دیسک#
bluestore_onode_t در src/os/bluestore/bluestore_types.h فیلدهای nid (شناسهی عددی یکتا در OSD)، size، attrs (xattrها)، extent_map_shards و راهنماهای expected_object_size، expected_write_size و alloc_hint_flags را دارد. bluestore_blob_t واحد checksum و فشردهسازی است و bluestore_pextent_t یک بازهی فیزیکی (offset و length) است. blobها میتوانند بین cloneها بهصورت bluestore_shared_blob_t مشترک باشند.
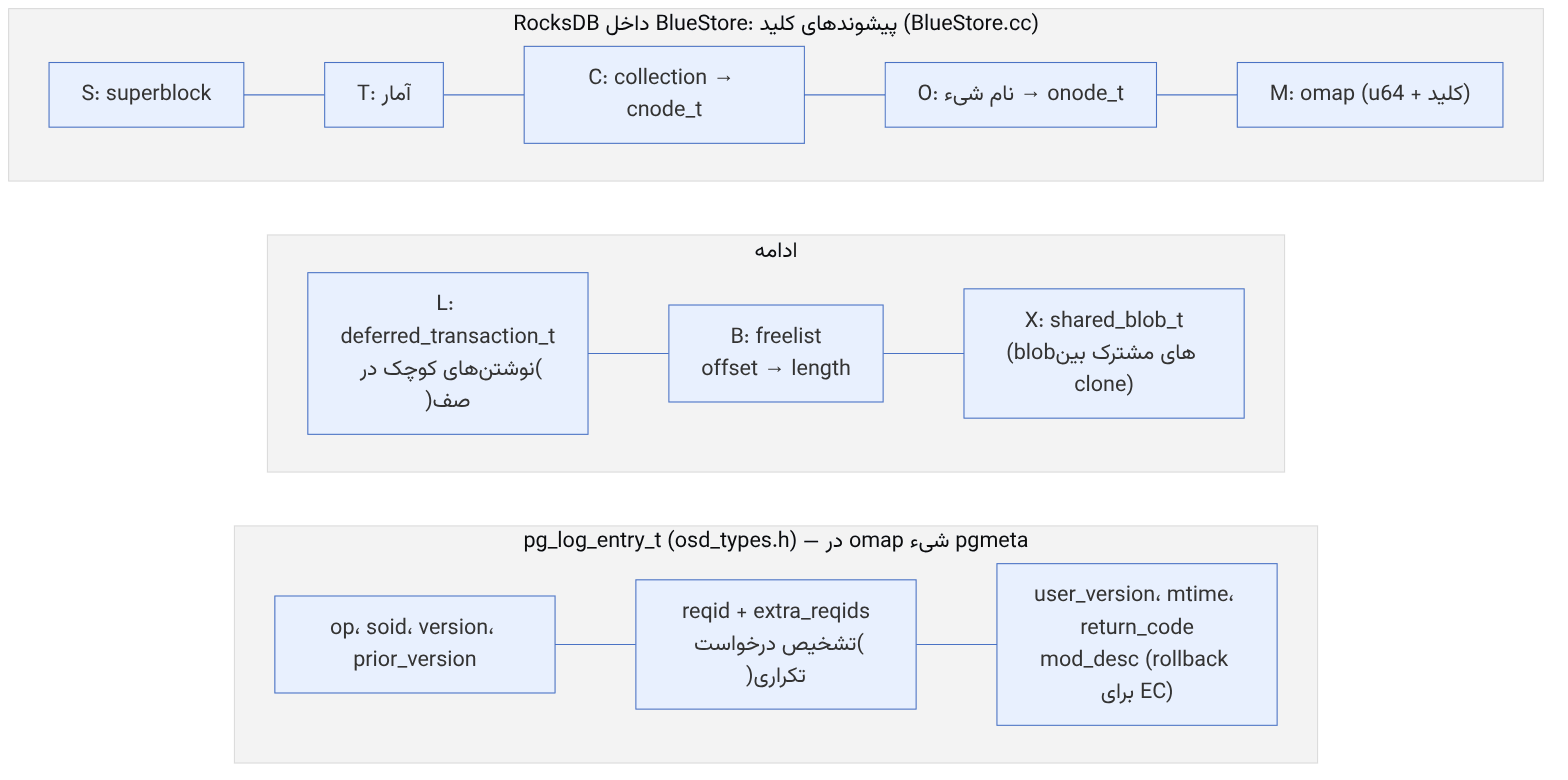
| ثابت/گزینه | مقدار (main) | اهمیت |
|---|---|---|
| bluestore_min_alloc_size_hdd / _ssd | ۴_K / ۴_K | کوچکترین واحد تخصیص؛ هنگام ساخت OSD ثابت میشود |
| bluestore_prefer_deferred_size_hdd / _ssd | ۶۴_K / ۰ | نوشتنهای کوچکتر روی HDD ابتدا در WAL ثبت میشوند (deferred) |
| bluestore_max_blob_size_hdd / _ssd | ۶۴_K / ۶۴_K | سقف اندازهی blob |
| bluestore_allocator | hybrid | تخصیصدهندهی پیشفرض |
| osd_min_pg_log_entries / osd_max_pg_log_entries | ۲۵۰ / ۱۰۰۰۰ | طول pg log؛ بیشتر یعنی recovery مبتنی بر log بهجای backfill |
| osd_target_pg_log_entries_per_osd | ۳۰۰۰۰۰ | بودجهی کل log هر OSD |
مقدار bluestore_min_alloc_size در زمان mkfs روی OSD ثبت میشود و تغییر option روی OSD موجود اثری ندارد. OSDهای قدیمی HDD که با ۶۴K ساخته شدهاند (پیش از Pacific) برای اشیای کوچک مثل RGW فضای زیادی هدر میدهند و تنها راه اصلاح، بازسازی OSD است.
دیدن این ساختارها در عمل (OSD را ابتدا متوقف کنید):
ceph osd map rbd rbd_data.5e2a.0000000000000001
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-4 --op list --pgid 3.1a | head
ceph-objectstore-tool --data-path ... --pgid 3.1a '<obj-json>' dump | jq '.onode'
ceph-objectstore-tool --data-path ... --op log --pgid 3.1a | jq '.pg_log_t.log[-1]'
ceph-bluestore-tool show-label --dev /dev/sdb
ceph daemon osd.4 bluestore allocator score block۱-۱۱ برنامهریزی با عدد: تعداد PG و احتمال از دست رفتن داده، و زمان بازسازی#
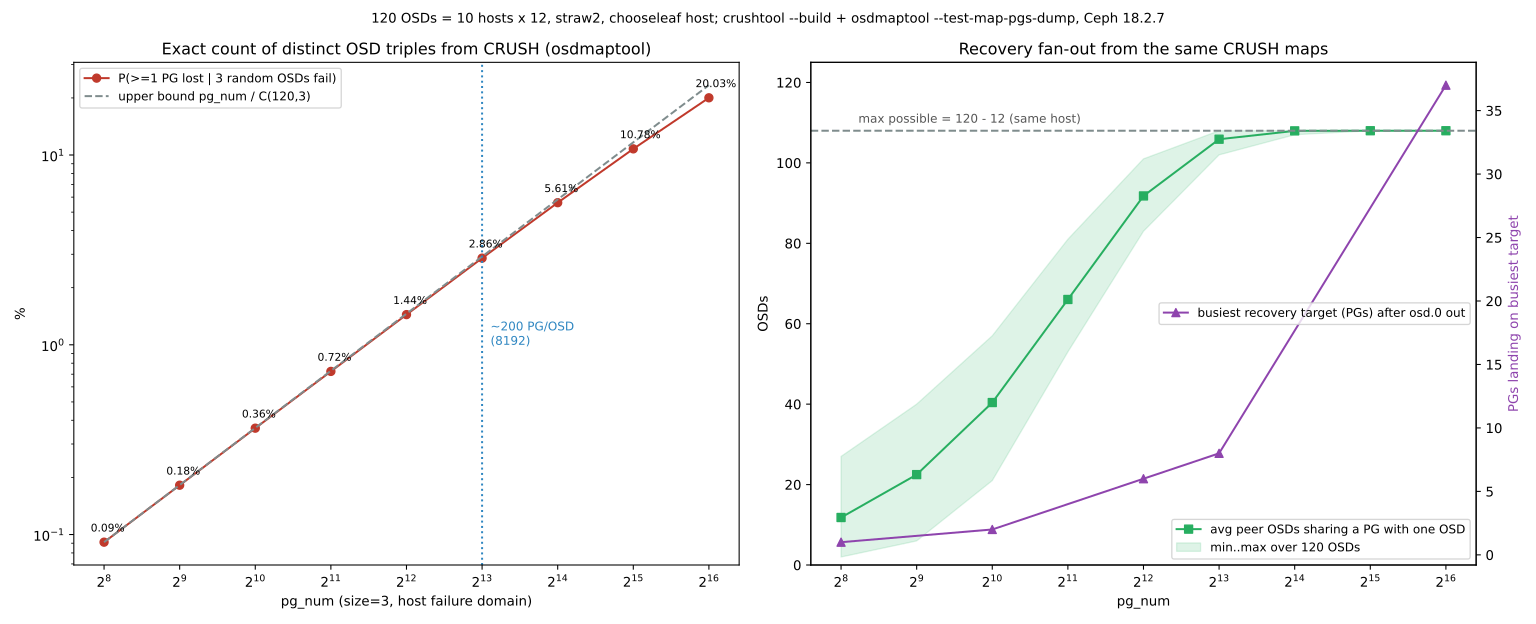
عددهای این بخش از نگاشت واقعی CRUSH به دست آمدهاند، نه از جایگذاری تصادفی. با crushtool --build --num_osds 120 … host straw2 12 root straw2 0 یک نقشهی ۱۰ میزبان × ۱۲ OSD ساختیم که قاعدهی پیشفرض آن chooseleaf firstn 0 type host است. برای هر pg_num یک osdmap با osdmaptool --createsimple 128 --pg-bits b --pgp-bits b ساخته و نقشه را در آن import کردیم. هشت OSD اضافه در CRUSH نیستند و داده نمیگیرند. سپس همهی PGها را با osdmaptool --mark-up-in --test-map-pgs-dump نگاشت کردیم. ابزارها از Ceph 18.2.7 (Reef) بودند. تابع انتخاب straw2 (bucket_straw2_choose در src/crush/mapper.c) در شاخهی main همان است، پس نتیجه برای نسخههای جدیدتر هم معتبر است. تنها فرض این بخش نرخ بازسازی هر دیسک است که صریحاً علامت خورده است.
۱-۱۱-۱ تعداد PG و «copyset»ها#
منبع در کد: محاسبهی دقیق روی نگاشت CRUSH با osdmaptool؛ پیشفرض mon_target_pg_per_osd = 200 از src/common/options/mgr.yaml.in
پیچیدگی: O(pg_num) برای نگاشت و شمارش
pseudocode
برای هر ps در [0, pg_num): up(ps) = CRUSH(rjenkins(ps, pool), rule) # osdmaptool --test-map-pgs-dump
S = مجموعهی سهتاییهای (بیترتیب) متمایز در up
P(loss | سه OSD تصادفی همزمان خراب شوند) = |S| / C(120, 3) # دقیق، نه نمونهگیری
E[کسر PGهای ازدسترفته] = Σ_PG 1/C(120,3) / pg_num = 1 / C(120,3) # مستقل از pg_numنتیجه (۱۲۰ OSD، size = ۳). C(۱۲۰, ۳) = ۲۸۰۸۴۰ سهتایی ممکن وجود دارد.
| pg_num | سهتاییهای متمایز | احتمال از دست رفتن دستکم یک PG |
|---|---|---|
| ۱۰۲۴ | ۱۰۲۱ | ۰.۳۶٪ |
| ۸۱۹۲ (حدود ۲۰۰ PG برای هر OSD) | ۸۰۳۷ | ۲.۸۶٪ |
| ۶۵۵۳۶ | ۵۶۲۴۶ | ۲۰.۰٪ |
در pg_numهای بزرگ، تعداد سهتاییهای متمایز بهخاطر برخوردها کمتر از pg_num میشود. امید ریاضی کسر دادهی ازدسترفته در چنین رخدادی دقیقاً ۱/۲۸۰۸۴۰ است و به pg_num بستگی ندارد. هر PG دقیقاً یک سهتایی است و احتمال اینکه سهتایی خراب همان باشد ۱/C(۱۲۰,۳) است.
انتخاب واقعی بین «بهندرت اما زیاد» و «بیشتر اما کم» است. همین نگاشتها نشان میدهند که با ۸۱۹۲ PG، تعداد PGهای هر OSD بین ۱۷۲ و ۲۳۴ است. این ناهمواری دلیل وجود balancer و upmap است (فصل ۸).
پراکندگی recovery. همان نگاشتها نشان میدهند هر OSD بهطور میانگین با چند OSD دیگر PG مشترک دارد. این عدد با ۱۰۲۴ PG حدود ۴۰ است و از ۸۱۹۲ به بعد به سقف ۱۰۸ (یعنی ۱۲۰ منهای ۱۲ OSD هممیزبان) میرسد. پس recovery سریع (پنجرهی کوتاهی که در آن سه خرابی باید همزمان رخ دهند) خیلی بیشتر از خود pg_num اهمیت دارد.
۱-۱۱-۲ بازسازی خوشهای در برابر RAID#
منبع در کد: نگاشت پیش و پس از osdmaptool --mark-out 0؛ محدودیتهای واقعی: osd_max_backfills، پروفایل mClock (فصل 21) و شبکه
پیچیدگی: O(pg_num)
pseudocode
A = up پیش از خرابی ؛ B = up پس از out شدن osd.0
moved = {pg : 0 ∈ A[pg]} ؛ برای هر pg: dst(pg) = B[pg] − A[pg] # در همهی موارد دقیقاً یک OSD
دادهی هر PG = ظرفیت دیسک / |moved|
t ≈ max_d |{pg : dst(pg) = d}| × دادهی هر PG / r # r = نرخ نوشتن یک دیسک (فرض)
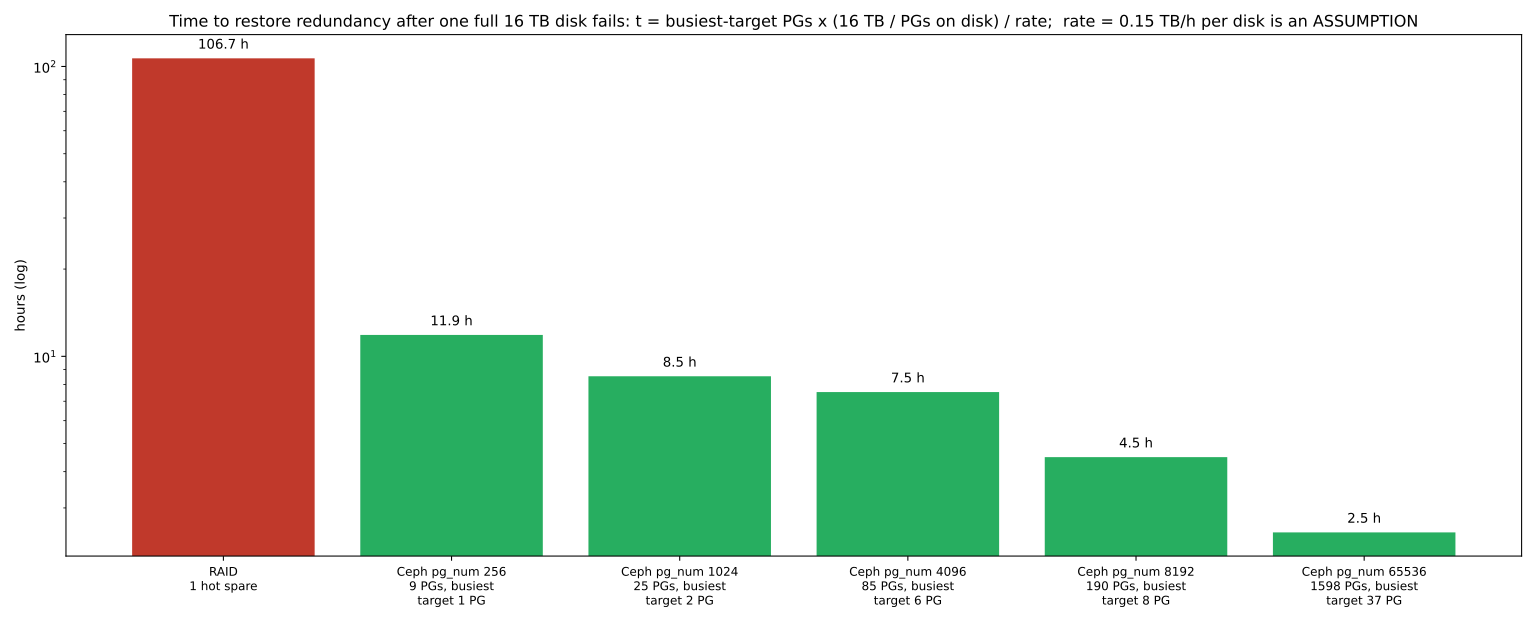
RAID با یک دیسک یدک: t = ظرفیت / rمثال عددی (دیسک پر ۱۶ TB، نرخ فرضی r = ۰.۱۵ TB/h). RAID حدود ۱۰۷ ساعت طول میکشد. نگاشت واقعی برای Ceph این نتیجهها را میدهد:
| pg_num | PG روی osd.0 | پرکارترین مقصد | زمان |
|---|---|---|---|
| ۲۵۶ | ۹ | ۱ PG | ۱۱.۹ ساعت |
| ۱۰۲۴ | ۲۵ | ۲ PG | ۸.۵ ساعت |
| ۸۱۹۲ | ۱۹۰ | ۸ PG | ۴.۵ ساعت |
| ۶۵۵۳۶ | ۱۵۹۸ | ۳۷ PG | ۲.۵ ساعت |
در این نگاشتها جابهجایی جانبی وجود نداشت: هیچ PG دیگری جز PGهای osd.0 جابهجا نشد. با ۸۱۹۲ PG، ۳۸ مقصد از ۱۹۰ (۲۰٪) روی همان میزبان osd.0 بودند. دلیلش این است که «out» وزن میزبان را در CRUSH تغییر نمیدهد و تلاش دوباره گاهی دوباره همان میزبان را انتخاب میکند.
r فرض است و در عمل شبکه، osd_max_backfills یا پروفایل mClock زودتر سقف میگذارند. اما ساختار نتیجه واقعی است: زمان را پرکارترین مقصد تعیین میکند و نه میانگین، و pg_num بزرگتر بار را یکنواختتر پخش میکند. این دلیل اصلی کنار گذاشتن RAID زیر Ceph است.
۱-۱۲ تکمیلی و بهروز#
۱-۱۲-۱ از ۲۰۱۹ تا امروز: چه چیزهایی عوض شده است؟#
در سال ۲۰۱۹ نسخههای Jewel (۱۰٫۲) و Luminous (۱۲٫۲) هنوز رایج بودند. از آن زمان هشت نسخهی اصلی دیگر منتشر شده و چند تغییر بنیادی رخ داده که هر کسی که با منابع قدیمیتر آشناست باید از آنها باخبر باشد:
| موضوع | در زمان کتاب | امروز |
|---|---|---|
| ابزار استقرار | ceph-deploy و ceph-ansible | cephadm (از Octopus) و Rook در Kubernetes؛ ceph-deploy دیگر نگهداری نمیشود |
| موتور ذخیرهسازی | FileStore پیشفرض، BlueStore تازه | BlueStore تنها گزینهی پشتیبانیشده؛ FileStore در Reef حذف شد |
| پیکربندی | ceph.conf روی هر میزبان | پایگاه پیکربندی متمرکز در MON (ceph config) |
| تعداد PG | محاسبهی دستی | pg_autoscaler پیشفرض (از Octopus) |
| زمانبندی I/O | WPQ با تنظیم دستی سهم بازیابی | mClock پیشفرض (از Quincy) با پروفایلها |
| پروتکل شبکه | msgr v1 | msgr2 با رمزنگاری اختیاری روی پورت ۳۳۰۰ (از Nautilus) |
| cache tiering | قابلیت فعال | منسوخشده از Reef |
| مدیریت گرافیکی | Calamari، VSM | Ceph Dashboard داخل MGR |
| رابطهای تازه | — | دروازهی NVMe-oF/TCP برای RBD، ماژول SMB برای CephFS، حسابهای کاربری IAM در RGW |
| OSD نسل بعد | — | Crimson و SeaStore (پیشنمایش فنی) |
۱-۱۲-۲ نسخههای فعال در زمان نگارش#
طبق صفحهی رسمی نسخهها (بازدید آبان ۱۴۰۵)، سه نسخهی پایدار بهطور فعال نگهداری میشوند: Umbrella (۲۱٫۲، نخستین انتشار ۲۸ اکتبر ۲۰۲۶)، Tentacle (۲۰٫۲، نخستین انتشار ۱۸ نوامبر ۲۰۲۵؛ آخرین نسخه در زمان نگارش ۲۰٫۲٫۵) و Squid (۱۹٫۲، با پایان عمر تخمینی ۲ دسامبر ۲۰۲۶). Reef اکنون بایگانیشده است. Ceph هر سال یک نسخهی اصلی منتشر میکند و نسخههای X.2.Z نسخههای پایدار مخصوص production هستند (X.1.Z نامزد انتشار و X.0.Z نقطههای توسعهاند).
سیاست رایج در production این است که روی نسخهی اصلی قبلی بمانید تا چند نسخهی اصلاحی (point release) از نسخهی جدید منتشر شود. مثلاً در زمان نگارش، Tentacle با پنج نسخهی اصلاحی انتخاب محافظهکارانهتری از Umbrella است که چند هفته از انتشارش میگذرد. پیش از ارتقا یادداشتهای انتشار را کامل بخوانید؛ بهویژه بخشهایی که پیشفرضها را عوض میکنند.
Umbrella چند تغییر پیشفرض دارد که میتواند پس از ارتقا رفتار کلاستر را عوض کند: مقدار پیشفرض mon_target_pg_per_osd از ۱۰۰ به ۲۰۰ و mon_max_pg_per_osd از ۲۵۰ به ۵۰۰ رسیده است، پس poolهای موجود ممکن است پس از ارتقا به PG بیشتری autoscale شوند. یادداشتهای انتشار برای کلاسترهایی که هدف حافظهی OSD کمتر از ۴ گیگابایت دارند یا SSDهایی که به بیش از دو OSD تقسیم شدهاند، پیشنهاد میکنند پیش از ارتقا مقادیر قدیمی را صریحاً تثبیت کنند.
۱-۱۲-۳ Rook: Ceph در Kubernetes#
اگر زیرساخت شما Kubernetes است، Rook اپراتور رسمی CNCF (پروژهی graduated) برای اجرای Ceph در Kubernetes است. Rook همان daemonهای Ceph را بهصورت Pod اجرا میکند و منابعی مثل CephCluster، CephBlockPool، CephObjectStore و CephFilesystem را بهشکل CRD در اختیار میگذارد. در زمان نگارش، آخرین نسخهی Rook نسخهی ۱٫۲۱٫۲ است. cephadm و Rook هر دو روی مفاهیم مشترک ارکستراتور Ceph کار میکنند، اما برای یک کلاستر فقط یکی را انتخاب کنید.
۱-۱۲-۴ چه زمانی Ceph انتخاب مناسبی نیست؟#
Ceph ابزار قدرتمندی است، اما برای هر مسئلهای مناسب نیست:
- کلاسترهای خیلی کوچک: زیر سه یا چهار میزبان، سربار عملیاتی و ظرفیت هدررفتهی Ceph معمولاً توجیه ندارد. یک NAS یا ZFS ساده بهتر است.
- تأخیر بسیار کم برای یک برنامهی تک: هر نوشتن در Ceph حداقل یک رفتوبرگشت شبکه به OSD اصلی و یکی به ثانویهها دارد. برای پایگاه دادهای که به تأخیر زیر ۱۰۰ میکروثانیه نیاز دارد، NVMe محلی با تکثیر در سطح برنامه گزینهی بهتری است.
- تیم بدون تجربهی عملیاتی: Ceph در خرابیها خوب رفتار میکند، به شرطی که کسی بداند در شرایط غیرعادی چه کند. سرمایهگذاری روی آموزش و پایش بخشی از هزینهی واقعی Ceph است.
۱-۱۳ جمعبندی و مرور#
۱-۱۳-۱ خلاصهی فصل#
- ذخیرهسازی نرمافزارمحور هوشمندی را از سختافزار جدا میکند و مقیاس افقی، استقلال از فروشنده و یکپارچگی رابطها را ممکن میکند.
- RAID در مقیاس دیسکهای چندترابایتی با بازسازی چند به یک، دیسک یدک و ریسک URE به بنبست میرسد؛ Ceph با بازیابی چند به چند، checksum و scrub این مشکلات را حل میکند.
- همهی رابطهای Ceph (RBD، RGW، CephFS) روی RADOS ساخته شدهاند. MONها نقشه را نگه میدارند، MGR آمار و ماژولها را، OSDها داده را.
- CRUSH جای داده را محاسبه میکند؛ هیچ جدول مرکزیای وجود ندارد. شیء به PG و PG به مجموعهای از OSDها در دامنههای خرابی متفاوت نگاشت میشود.
- برنامهریزی درست (نوع بار، دامنهی خرابی، شبکه، نسبت پر شدن، SSD با PLP) مهمترین عامل موفقیت Ceph است.
- cephadm ابزار رسمی امروز برای استقرار است: bootstrap، افزودن میزبان، اعلام وضعیت مطلوب با
ceph orch apply.
۱-۱۳-۲ اشتباهات رایج#
- ساختن OSD روی RAID 5/6 یا روی دیسکهای مجازی که روی یک دیسک فیزیکی مشترک قرار دارند.
- استفاده از SSD مصرفی بدون PLP برای DB/WAL یا MON.
- گذاشتن
min_size=1 برای «بالا ماندن» در زمان خرابی. - MTU ناهمگون در مسیر شبکه.
- تعداد زوج MON، یا قرار دادن همهی MONها در یک رک.
- برنامهریزی ظرفیت بر اساس ظرفیت خام بدون در نظر گرفتن nearfull و خرابی بزرگترین دامنه.
- رها کردن سرویس
all-available-devices در production.
۱-۱۳-۳ چکلیست خودارزیابی#
- میتوانم سه رابط Ceph و لایهی مشترکشان را توضیح دهم.
- میدانم MON، MGR، OSD، MDS و RGW هر کدام چه میکنند و چندتا از هر کدام لازم است.
- میتوانم مسیر شیء ← PG ← OSD را با
ceph osd map نشان دهم. - میتوانم یک کلاستر سهنودی با cephadm بسازم و node چهارم را اضافه کنم.
- میتوانم ظرفیت مفید یک طراحی را با در نظر گرفتن تکثیر، خرابی و nearfull برآورد کنم.
۱-۱۳-۴ تمرین عملی#
- ۱. آزمایشگاه چهار نودی این فصل را بسازید و کلاستر را با سه node bootstrap کنید. خروجی
ceph -s و ceph orch ps را ذخیره کنید. - ۲. یک pool تکثیری بسازید، ۱۰۰ شیء کوچک با یک حلقهی bash در آن بنویسید (
for i in $(seq 1 100); do rados -p lab-pool put obj$i /etc/hosts; done) و با ceph pg ls-by-pool توزیع آنها را بین PGها ببینید. - ۳. node چهارم را اضافه کنید و با
ceph -s روند backfill را دنبال کنید. چند درصد PGها جابهجا شدند؟ چرا همه جابهجا نشدند؟ - ۴. یک OSD را متوقف کنید و زمان لازم تا
out شدن و پایان بازیابی را اندازه بگیرید. سپس mon_osd_down_out_interval را در آزمایشگاه به ۶۰ ثانیه کاهش دهید و دوباره آزمایش کنید. - ۵. ظرفیت مفید طراحی خودتان را برای دو سناریوی تکثیر سهتایی و EC 4+2 با شرط ماندن زیر ۸۰٪ پس از خرابی یک میزبان محاسبه کنید.
۱-۱۳-۵ پرسشهای مرور#
- ۱. سه محدودیت بنیادی آرایههای ذخیرهسازی سنتی که ذخیرهسازی نرمافزارمحور برطرف میکند کداماند؟
- ۲. چرا زمان بازسازی RAID با بزرگتر شدن دیسکها بدتر میشود، اما زمان بازیابی Ceph با بزرگتر شدن کلاستر بهتر میشود؟
- ۳. نقش MON و OSD را در مسیر نوشتن یک شیء مقایسه کنید. آیا داده از MON عبور میکند؟
- ۴. لایهی PG چه مشکلی را حل میکند و اگر وجود نداشت چه میشد؟
- ۵. چرا تعداد MONها فرد انتخاب میشود؟ چهار MON چند خرابی را تحمل میکنند؟
- ۶. تفاوت
size و min_size چیست و چرا min_size=1 خطرناک است؟ - ۷. چه زمانی شبکهی کلاستر جداگانه مفید است و چه خطری دارد؟
- ۸. چرا SSD بدون PLP برای Ceph نامناسب است؟
- ۹. cephadm در bootstrap چه فایلهایی در
/etc/ceph میسازد و کدامیک حساسترین است؟ - ۱۰. دو تغییر پیشفرض Umbrella که میتواند پس از ارتقا رفتار کلاستر را عوض کند کداماند؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱-۱۳-۶ منابع این فصل#
- مستندات Ceph — معماری
https://docs.ceph.com/en/latest/architecture/ - مستندات Ceph — راهنمای سختافزار
https://docs.ceph.com/en/latest/start/hardware-recommendations/ - مستندات cephadm — استقرار کلاستر جدید
https://docs.ceph.com/en/latest/cephadm/install/ - مستندات cephadm — مدیریت میزبانها
https://docs.ceph.com/en/latest/cephadm/host-management/ - مستندات cephadm — مشخصات سرویس و placement
https://docs.ceph.com/en/latest/cephadm/services/ - مستندات Ceph — پیکربندی شبکه
https://docs.ceph.com/en/latest/rados/configuration/network-config-ref/ - مستندات Ceph — نسخهها و چرخهی انتشار
https://docs.ceph.com/en/latest/releases/ - یادداشتهای انتشار Umbrella
https://docs.ceph.com/en/latest/releases/umbrella/ - یادداشتهای انتشار Tentacle
https://docs.ceph.com/en/latest/releases/tentacle/ - Weil et al., «Ceph: A Scalable, High-Performance Distributed File System», OSDI 2006
https://www.usenix.org/legacy/event/osdi06/tech/weil.html - Weil et al., «CRUSH: Controlled, Scalable, Decentralized Placement of Replicated Data», SC 2006
https://ceph.io/assets/pdfs/weil-crush-sc06.pdf - Weil et al., «RADOS: A Scalable, Reliable Storage Service for Petabyte-scale Storage Clusters», PDSW 2007
https://ceph.io/assets/pdfs/weil-rados-pdsw07.pdf - مستندات Rook
https://rook.io/docs/rook/latest-release/