لایههای پایینی (۲): قالب رویدیسک BlueStore و BlueFS
حوصله ندارم این فصل در چند خط
- BlueFS فایلسیستم کوچکی است که RocksDB را نگه میدارد؛ superblock و log آن فایلها را توصیف میکنند و log با بزرگ شدن فشرده (compact) میشود.
- کلید اشیا در RocksDB طوری ساخته شده که یک range scan اشیای یک PG را به ترتیب برگرداند؛ onode اندازه، xattrها و extent map را نگه میدارد.
- extent map بازههای منطقی را به blobها نگاشت میکند؛ blobهای مشترک با شمارش ارجاع، clone و snapshot را ارزان میکنند.
- تخصیصدهندهها (AVL، bitmap و hybrid) و freelist فضای آزاد را دنبال میکنند؛ امتیاز fragmentation نشان میدهد این فضا چقدر پراکنده است.
۲۴-۱ مقدمه: BlueStore روی دیسک چه مینویسد؟#
در فصل ۲۳ دیدیم بایتها چگونه از bufferlist به io_submit میرسند. این فصل نشان میدهد آن بایتها روی دیسک کجا و با چه قالبی قرار میگیرند: از نخستین ۴ کیلوبایت دستگاه (label) تا superblock و لاگ BlueFS، و از کلیدهای RocksDB که onode و extent map را نگه میدارند تا بیتهای freelist و ساختار کش در حافظه. همهی ساختارها از شاخهی main کد Ceph (src/os/bluestore/) استخراج شدهاند. هرجا رفتار به نسخه بستگی دارد، علامتگذاری شده است.
- ۴K اول هر دستگاه BlueStore یک label است و ۴K دوم superblock مربوط به BlueFS. نسخههای جدید label را در ۱G، ۱۰G، ۱۰۰G و ۱۰۰۰G هم کپی میکنند.
- BlueFS یک فایلسیستم کوچک فقط-افزودنی برای RocksDB است. فرادادهاش در یک فایل لاگ (ino 1) با تراکنشهایی از نوع
bluefs_transaction_t قرار دارد. - کدگذاری فشرده با
denc_varint_lowz و denc_lba باعث میشود یک extent همتراز ۴K معمولاً در ۵ بایت جا شود. - onode در کلید
O است و extent mapهای بزرگ به shardهایی با پسوند x شکسته میشوند. - allocator پیشفرض hybrid است (AVL با سرریز به Bitmap). freelist در RocksDB فقط وقتی استفاده میشود که حالت «allocation from file» خاموش باشد.
۲۴-۲ label دستگاه: bluestore_bdev_label_t#
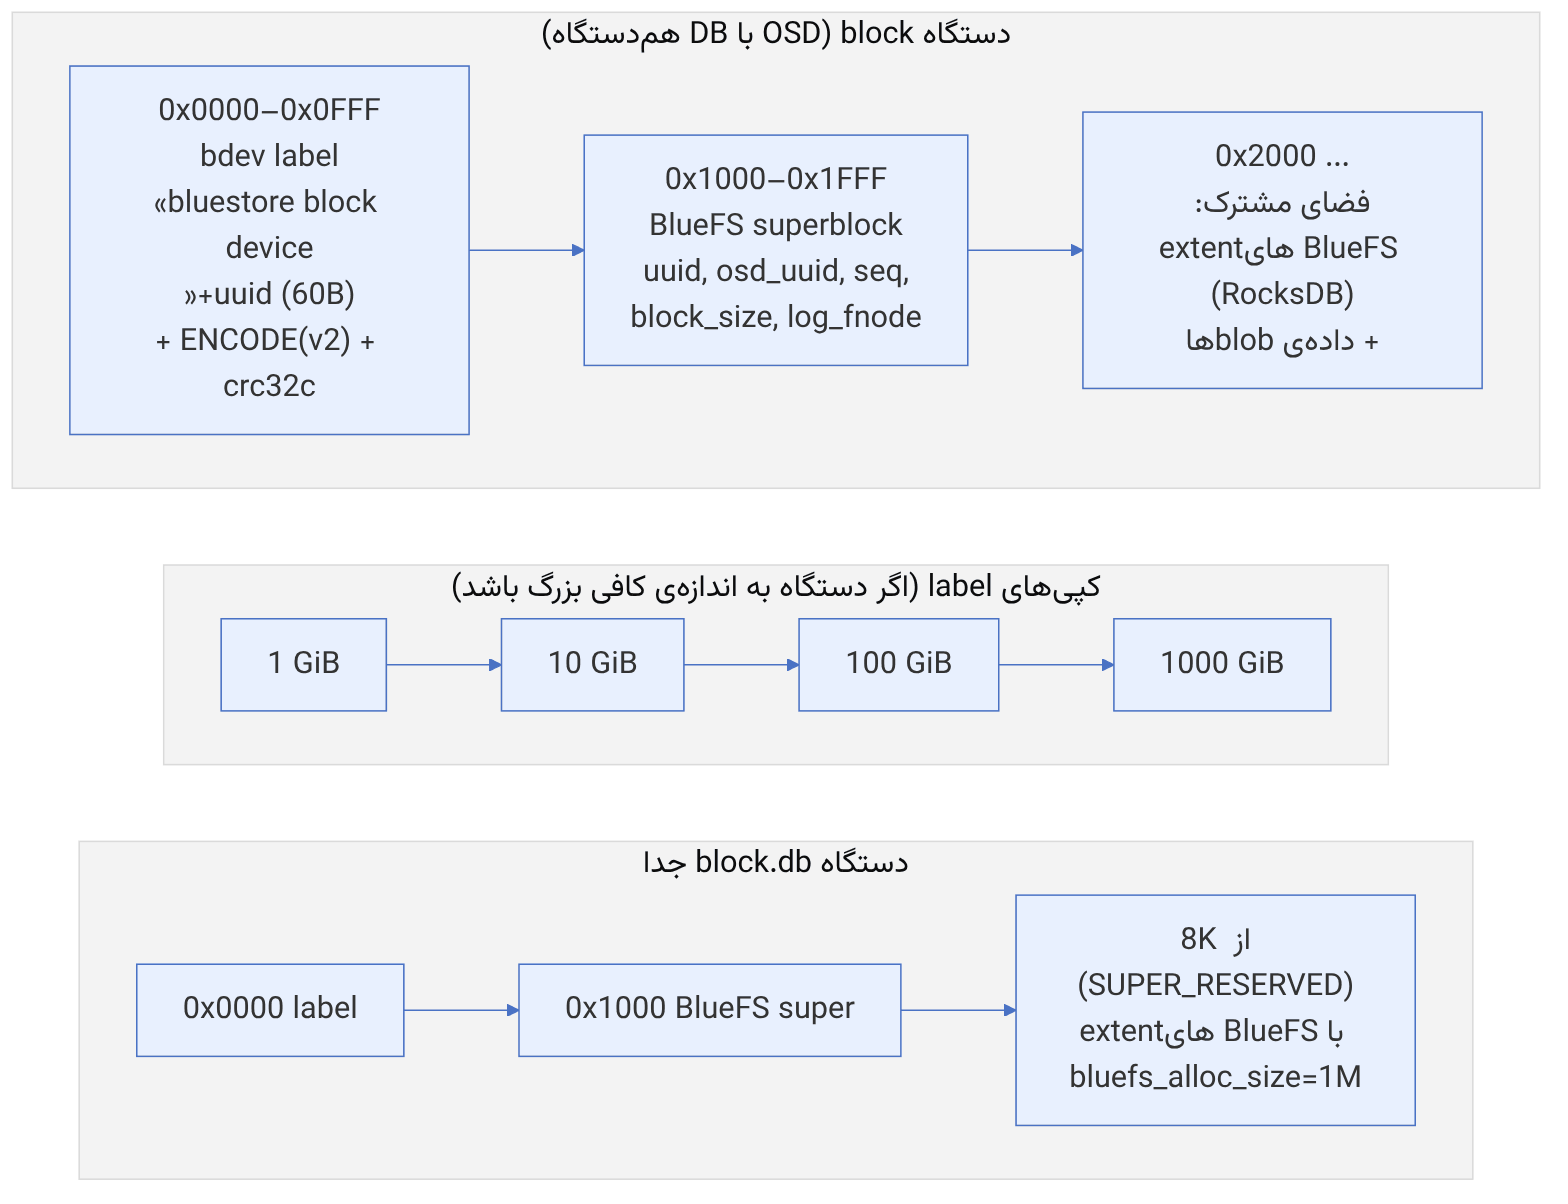
ثابتها در bluestore_common.h تعریف شدهاند: BDEV_FIRST_LABEL_POSITION = 0، BDEV_LABEL_BLOCK_SIZE = 4096، BLUEFS_SUPER_POSITION = 4096 و SUPER_RESERVED = 8192. محتوای label به این ترتیب است:
| بایت | محتوا | توضیح |
|---|---|---|
| ۰–۲۲ | bluestore block device\n | ۲۳ بایت ASCII، برای کسی که با hexdump دستگاه را نگاه میکند |
| ۲۳–۵۸ | uuid مربوط به OSD به شکل متن | ۳۶ کاراکتر |
| ۵۹ | \n | در مجموع ۶۰ بایت؛ decoder با p += 60 از این بخش میگذرد |
| ۶۰… | ENCODE_START(2,1) | struct_v=2، compat=1، طول (u32) |
| … | osd_uuid (۱۶ بایت)، size (u۶۴)، btime (utime_t)، description (string) | description مثلاً main یا bluefs db |
| … | meta: map<string,string> | کلیدهایی مثل ceph_fsid، whoami، osd_key، ready، kv_backend، type=bluestore |
| انتها | crc32c (u۳۲) روی همهی موارد بالا با seed −۱ | سپس تا ۴۰۹۶ بایت صفر میشود |
# خواندن label (فقط خواندنی؛ OSD میتواند در حال اجرا باشد)
ceph-bluestore-tool show-label --dev /dev/ceph-xxx/osd-block-yyy
dd if=/dev/ceph-xxx/osd-block-yyy bs=4096 count=1 2>/dev/null | hexdump -C | head -5مقدار osd_key در meta یک کلید cephx است. خروجی show-label را هرگز بدون پاک کردن این فیلد در تیکت یا چت قرار ندهید.
چرا کپیهای چندگانه؟ در نسخههای قدیمی خراب شدن ۴K اول (مثلاً با wipefs یا نوشتن اشتباه یک ابزار پارتیشنبندی) OSD را غیرقابلبازیابی میکرد. شاخهی main آرایهی bdev_label_positions = {0, 1G, 10G, 100G, 1000G} را دارد. BlueStore هنگام mount، label معتبر را از هر موقعیت سالم میخواند (_read_multi_bdev_label) و موقعیتهای معتبر را در bdev_label_valid_locations نگه میدارد. چون ممکن است نسخههای قدیمی آن نواحی را برای داده استفاده کرده باشند، کپی فقط جایی نوشته میشود که allocator آن را رزرو کرده باشد. سازوکار رزرو و محدودهی دقیق نسخهها را پیش از تکیه بر آن در یادداشتهای انتشار نسخهی خود بررسی کنید.
۲۴-۳ کدگذاریهای فشرده: varint، lowz و lba#
پیش از رفتن سراغ ساختارها باید سه کدگذاری را شناخت که در include/denc.h تعریف شدهاند و همهجا در فرادادهی BlueStore به کار میروند:
| تابع | قالب | کاربرد |
|---|---|---|
denc_varint | ۷ بیت داده در هر بایت؛ بیت بالا یعنی «بایت دیگری میآید» (little-endian) | شمارندهها، blobid |
denc_varint_lowz | ۲ بیت پایین = تعداد nibbleهای صفر انتهایی حذفشده (۰ تا ۳)، سپس varint | طولها (معمولاً مضرب ۴K) |
denc_lba | یک کلمهی ۳۲ بیتی: ۱ تا ۳ بیت اول نوع حذف صفرهای انتهایی (0=۱۲ بیت، 01=۱۶، 011=۲۰، 111=هیچ)، سپس ۲۸ تا ۳۰ بیت داده، بیت ۳۱ = ادامه | offsetهای فیزیکی روی دیسک |
| مقدار | denc_varint | denc_varint_lowz | denc_lba |
|---|---|---|---|
| ۰x1000 (۴K) | 80 20 | 07 | 02 00 00 00 |
| ۰x3000 (۱۲K) | 80 60 | 0f | — |
| ۰x10000 (۶۴K) | 80 80 04 | 43 | — |
| ۰x12340000 | — | — | d1 48 00 00 |
| ۰x3a8f05000 | — | — | 0a 1e 75 00 |
مثال گامبهگام lowz برای ۰x10000: این عدد ۱۶ بیت صفر انتهایی، یعنی ۴ nibble، دارد ولی سقف ۳ است. پس ۰x10000 >> ۱۲ = ۰x10 و (۰x10 << ۲) | ۳ = ۰x43 که در یک بایت جا میشود.
مثال lba برای ۰x12340000: این عدد ۱۸ بیت صفر انتهایی، یعنی ۴ nibble کامل، دارد. پس t = ۴ − ۳ = ۱، حالت «۱۶ بیت حذف» با پیشوند 01 انتخاب میشود: ۰x12340000 >> ۱۶ = ۰x1234 و word = ۰b01 | (۰x1234 << ۲) = ۰x48D1. خروجی چهار بایت little-endian است: d1 48 00 00. این مقادیر را با یک پیادهسازی پایتونی مستقل از روی منطق denc.h محاسبه کردهایم.
نتیجهی عملی: یک bluestore_pextent_t (offset با denc_lba و length با denc_varint_lowz) برای یک extent معمولی ۶۴K همتراز با ۴K فقط ۵ بایت است، در حالی که شکل خام آن ۱۲ بایت (u64 + u32) میشد. وقتی میلیاردها extent در RocksDB دارید، این تفاوت در اندازهی DB و نرخ برخورد کش بسیار اثر دارد.
۲۴-۴ BlueFS: فایلسیستمی برای RocksDB#
RocksDB به یک فایلسیستم نیاز دارد (فایلهای SST، WAL، MANIFEST، CURRENT). BlueStore بهجای ext4 یا XFS، فایلسیستم کوچک خودش یعنی BlueFS را دارد که از طریق BlueRocksEnv به RocksDB وصل میشود. BlueFS فقط چیزهایی را پیاده میکند که RocksDB لازم دارد: چند دایرکتوری تخت، فایلهای فقط-افزودنی، rename و unlink و fsync.
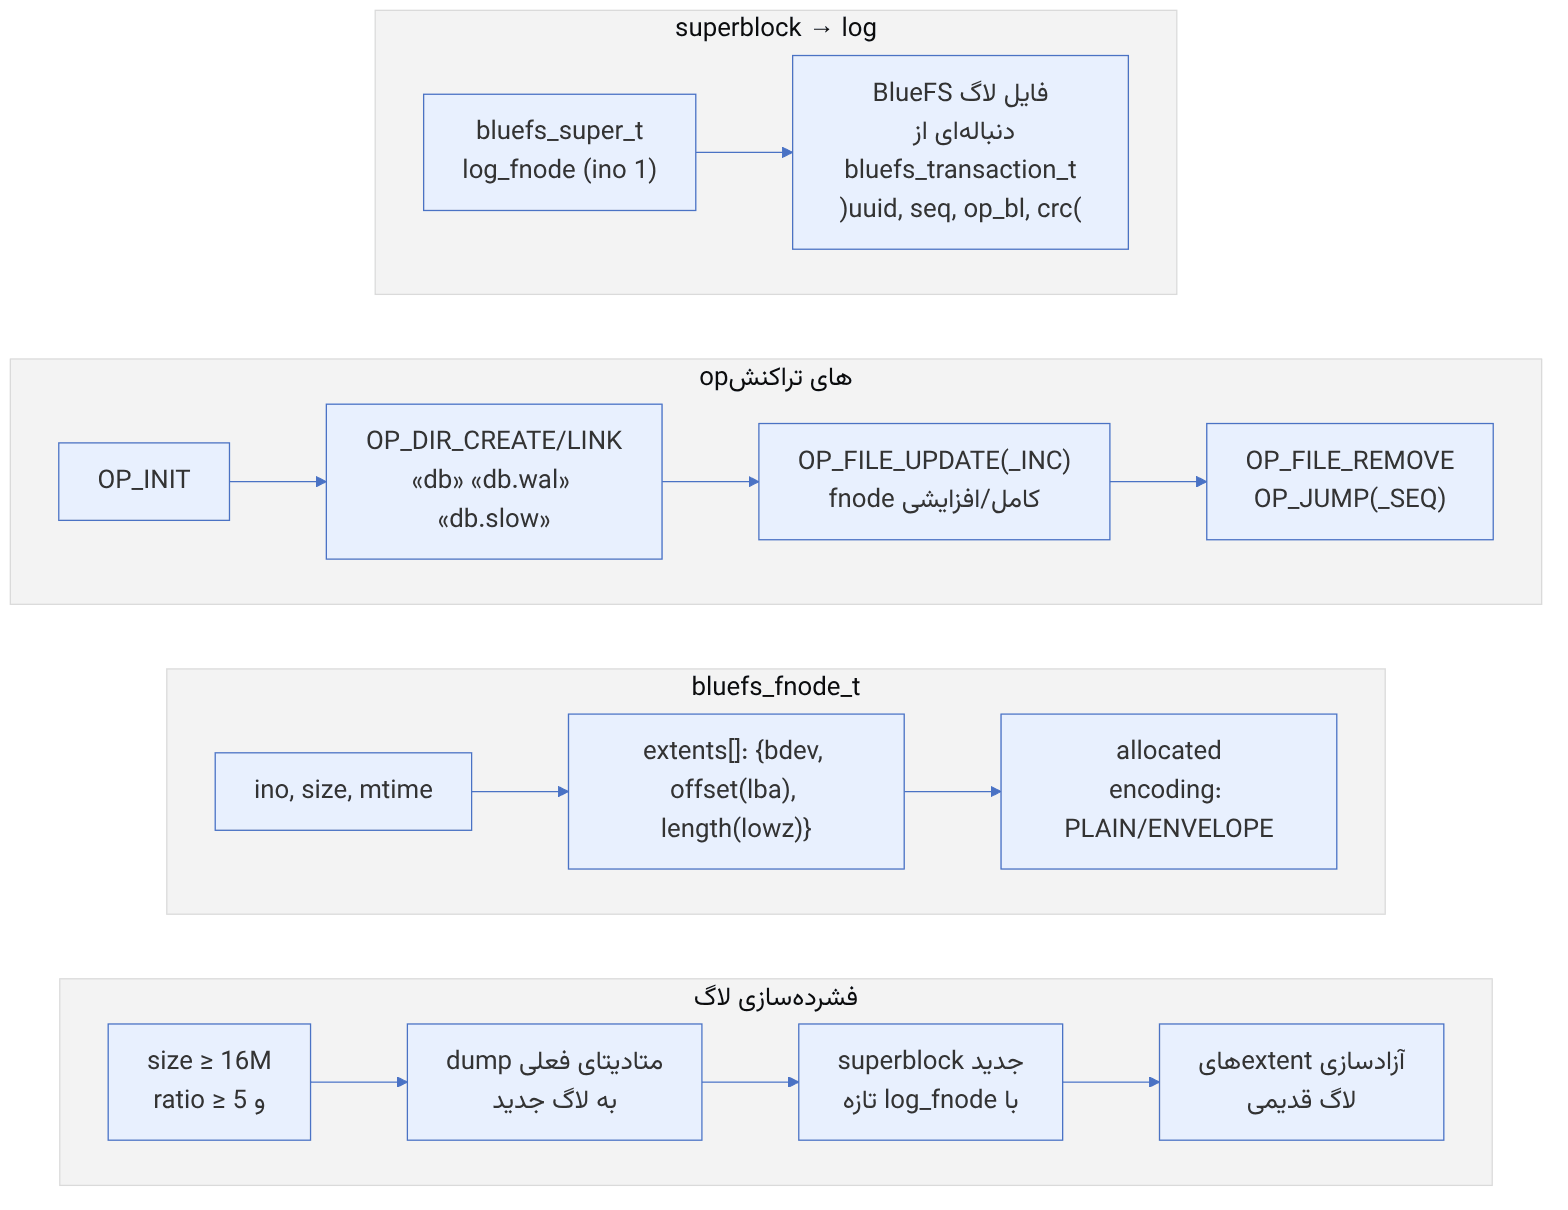
۲۴-۴-۱ ساختارها#
| struct | فیلدها | نکته |
|---|---|---|
bluefs_super_t | _version، uuid، osd_uuid، seq، block_size، log_fnode، memorized_layout | _version برابر BASELINE=2 یا ENVELOPE_MODE_ENABLED=3 است |
bluefs_fnode_t | ino، size، mtime، extents، allocated، encoding، content_size | extents_index فقط در حافظه است، برای یافتن extent با upper_bound |
bluefs_extent_t | offset (lba)، length (lowz)، bdev (u8) | bdev: WAL=0، DB=1، SLOW=2، NEWWAL=3، NEWDB=4 (MAX_BDEV=۵) |
bluefs_transaction_t | uuid، seq، op_bl | op_t از OP_NONE تا OP_FILE_UPDATE_INC؛ opهای ALLOC_ADD/RM منسوخاند |
pseudocode: mount مربوط به BlueFS (خلاصهی این کتاب)
super = decode(read(bdev[DB or SLOW], 0x1000, 4096)); verify crc
log_reader = open(super.log_fnode)
pos = 0
repeat:
read header at pos; if uuid != super.uuid or seq != expected → end of log
t = decode(bluefs_transaction_t); verify crc
for op in t.op_bl:
INIT → nothing
DIR_CREATE → dir_map[name] = {}
DIR_LINK → dir_map[d][f] = ino
FILE_UPDATE → file_map[ino].fnode = fnode
FILE_UPDATE_INC → merge extents into file_map[ino].fnode
FILE_REMOVE → release extents (unless shared)
JUMP/JUMP_SEQ → pos/seq = ...
pos = next block-aligned boundary
# در پایان، allocator هر bdev از روی extentهای همهی fnodeها ساخته میشود| گزینه | پیشفرض (main) | اثر |
|---|---|---|
bluefs_alloc_size | ۱_M | واحد تخصیص روی دستگاههای اختصاصی DB و WAL |
bluefs_shared_alloc_size | ۶۴_K | واحد تخصیص روی دستگاه مشترک با داده |
bluefs_min_log_runway / bluefs_max_log_runway | ۱_M / ۴_M | فضای از پیش تخصیصیافته برای ادامهی لاگ |
bluefs_log_compact_min_size | ۱۶_M | لاگ کوچکتر از این هرگز فشرده نمیشود |
bluefs_log_compact_min_ratio | ۵ | نسبت اندازهی واقعی به تخمینی برای آغاز فشردهسازی |
bluefs_buffered_io | true | خواندنهای BlueFS از page cache هسته استفاده میکنند |
۲۴-۴-۲ فشردهسازی لاگ و حالت envelope#
_should_start_compact_log_L_N() اندازهی فعلی لاگ را با _estimate_log_size_N() مقایسه میکند. اگر هر دو شرط جدول بالا برقرار باشد، _compact_log_async_LD_LNF_D() اجرا میشود: تصویر کامل فراداده (همهی دایرکتوریها و fnodeها) در یک لاگ تازه نوشته میشود، superblock با log_fnode جدید و seq بالاتر بهروزرسانی میشود و extentهای لاگ قدیمی آزاد میشوند. ترتیب این مراحل طوری است که crash در هر لحظه یا لاگ قدیمی سالم یا لاگ جدید کامل را باقی بگذارد.
وابسته به نسخه: bluefs_node_encoding (PLAIN، ENVELOPE، ENVELOPE_FIN) در Tentacle و main وجود دارد ولی در Squid نیست. در حالت envelope، دادهای که به فایل (مثلاً WAL مربوط به RocksDB) افزوده میشود در یک پوشش خودتوصیف قرار میگیرد. بنابراین برای هر fsync لازم نیست اندازهی فایل در لاگ BlueFS بهروز شود و یک نوشتن همگام اضافه حذف میشود. پس از crash، ناحیهی بین size و allocated برای یافتن envelopeها پویش میشود.
ceph-bluestore-tool bluefs-bdev-sizes --path /var/lib/ceph/osd/ceph-4 # OSD متوقف
ceph-bluestore-tool bluefs-log-dump --path /var/lib/ceph/osd/ceph-4
ceph daemon osd.4 bluefs stats # admin socket روی میزبان OSD
ceph-bluestore-tool bluefs-export --path ... --out-dir /tmp/bluefs # فایلهای RocksDB برای ldb۲۴-۵ نقشهی کامل پیشوندهای KV#
تمام فرادادهی BlueStore در RocksDB قرار دارد. نخستین کاراکتر هر کلید «پیشوند» آن است و در BlueStore.cc تعریف شده است:
| پیشوند | نام ثابت | کلید → مقدار |
|---|---|---|
S | PREFIX_SUPER | نام فیلد → مقدار (nid_max، blobid_max، min_alloc_size، per_pool_omap، ...) |
T | PREFIX_STAT | آمار pool یا کل store (آرایهی int64 با merge operator از نوع int64_array) |
C | PREFIX_COLL | نام collection (PG) → bluestore_cnode_t (فقط فیلد bits) |
O | PREFIX_OBJ | کلید شیء → bluestore_onode_t؛ shardهای extent map با پسوند x |
M | PREFIX_OMAP | u64 (nid) + نام کلید → مقدار (omap قدیمی، سراسری) |
P | PREFIX_PGMETA_OMAP | omap مربوط به شیء pgmeta (pg log و pg info) |
m | PREFIX_PERPOOL_OMAP | s64 (pool) + u64 (nid) + نام کلید → مقدار |
p | PREFIX_PERPG_OMAP | u64 (pool) + u32 (hash) + u64 (nid) + نام کلید → مقدار (پیشفرض نسخههای جدید) |
L | PREFIX_DEFERRED | seq → bluestore_deferred_transaction_t |
B | PREFIX_ALLOC | فرادادهی freelist (اندازه، blocks_per_key، ...) |
b | PREFIX_ALLOC_BITMAP | offset → bitmap (از طریق BitmapFreelistManager) |
X | PREFIX_SHARED_BLOB | sbid → bluestore_shared_blob_t |
برای دیدن حجم هر پیشوند روی یک OSD متوقف از ceph-kvstore-tool bluestore-kv /var/lib/ceph/osd/ceph-4 stats استفاده کنید، یا با list O | wc -l تعداد کلیدهای onode را بشمارید. در یک OSD سالم RBD معمولاً O و p بیشترین حجم را دارند. اگر L بزرگ باشد، یعنی deferred writeها انباشته شدهاند.
۲۴-۶ onode: از کلید تا extent#
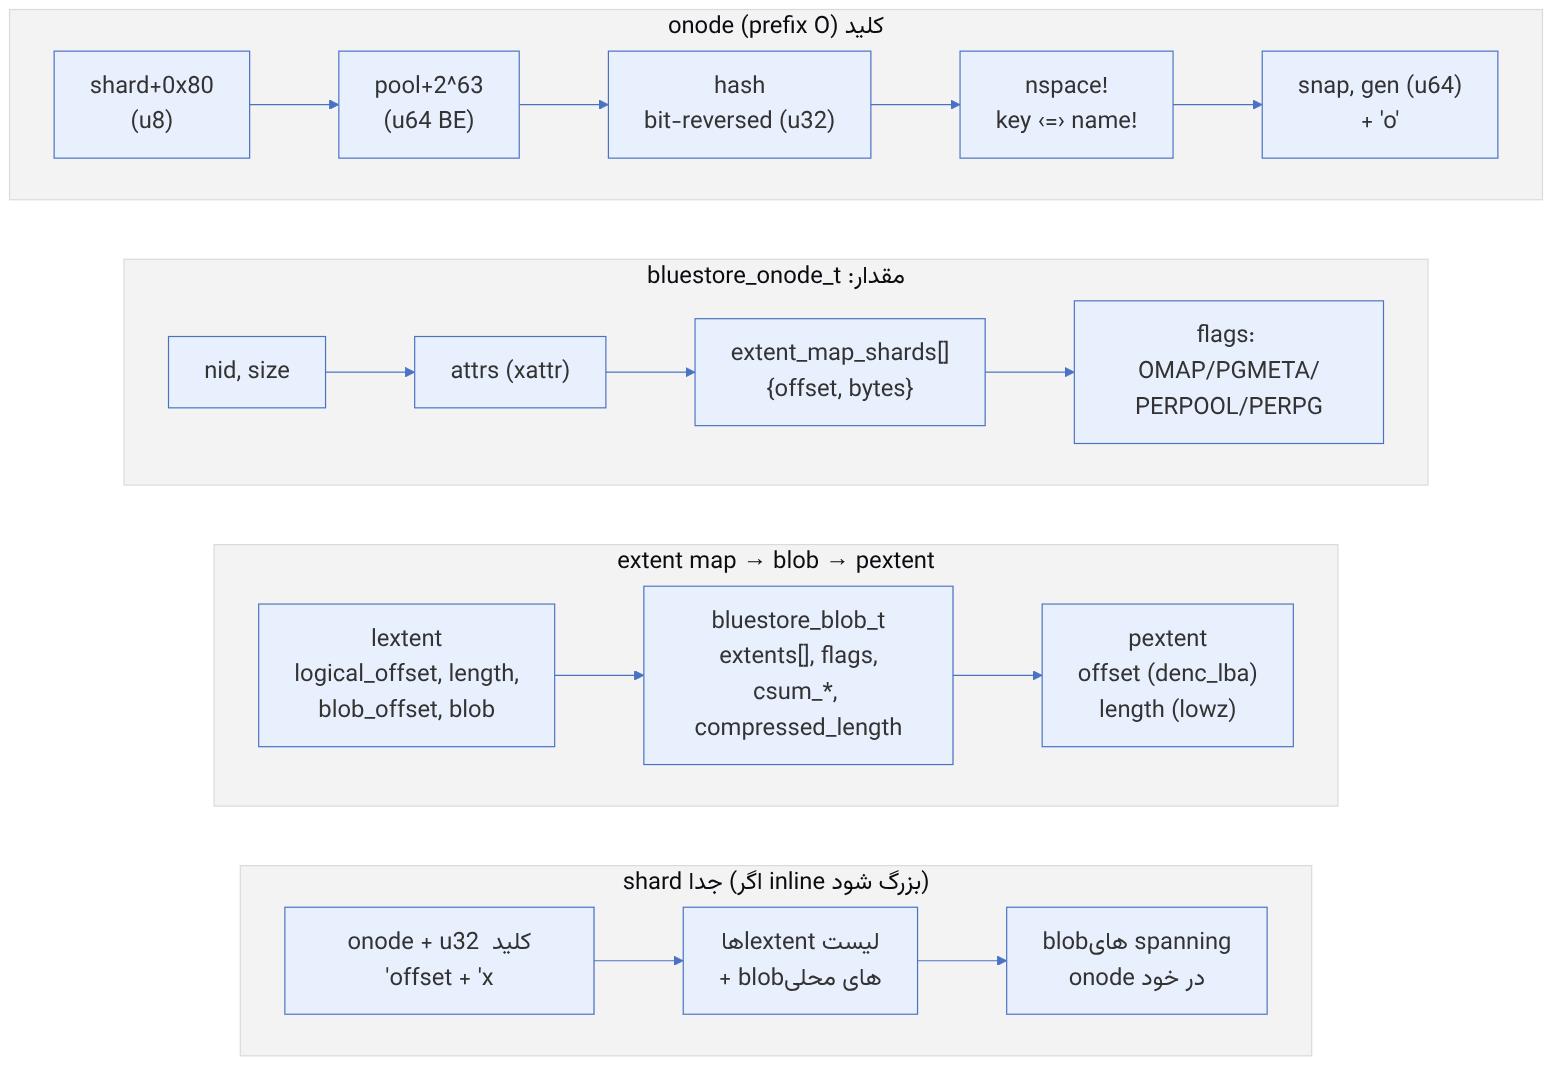
۲۴-۶-۱ کلید شیء#
کلید طوری ساخته میشود که پیمایش ترتیبی RocksDB دقیقاً همان ترتیب اشیای یک PG را بدهد. بنابراین collection_list (که در scrub و backfill استفاده میشود) به یک range scan ساده تبدیل میشود:
| جزء | کدگذاری | دلیل |
|---|---|---|
| shard | u8(shard.id + 0x80) | shard = −۱ (NO_SHARD) به ۰x7F تبدیل میشود و پیش از shardهای EC (۰x۸۰ به بعد) قرار میگیرد |
| pool | u64(pool + 2^63) بهصورت big-endian | poolهای منفی (temp) پیش از مثبتها مرتب میشوند |
| hash | u32 بیتمعکوس، big-endian | PGها بازههای پیوستهای از hash بیتمعکوساند، پس اشیای یک PG کنار هم میافتند |
| namespace و key | رشتهی escapeشده + ! | نویسههای ≤ # به #xx و ≥ ~ به ~xx تبدیل میشوند |
< یا = یا > | یک نویسه | = یعنی key با نام یکی است و نام دوباره نوشته نمیشود |
| snap، generation | u64 big-endian | snapها و نسلهای EC پشت سر هم |
o | پسوند | تمایز onode از shardهای extent (x) |
۲۴-۶-۲ bluestore_onode_t#
فیلدهای اصلی: nid (شناسهی عددی محلی برای کلیدهای omap)، size، attrs (xattrها مثل _ برای object_info_t و snapset)، extent_map_shards (فهرست {offset, bytes})، expected_object_size، expected_write_size، alloc_hint_flags، segment_size و flags (FLAG_OMAP=1، FLAG_PGMETA_OMAP=2، FLAG_PERPOOL_OMAP=4، FLAG_PERPG_OMAP=8). اگر extent_map_shards خالی باشد، کل extent map بهصورت inline پس از onode در همان مقدار ذخیره میشود.
۲۴-۶-۳ extent map و کدگذاری فشردهی آن#
هر lextent چهار عدد دارد: logical_offset، length، blob_offset و یک ارجاع به blob. ExtentMap::encode_some با چهار پرچم در بیتهای پایین blobid از تکرار اطلاعات پرهیز میکند:
| پرچم | مقدار | معنی |
|---|---|---|
BLOBID_FLAG_CONTIGUOUS | ۰x1 | این extent دقیقاً پس از قبلی شروع میشود، پس logical_offset نوشته نمیشود |
BLOBID_FLAG_ZEROOFFSET | ۰x2 | blob_offset صفر است |
BLOBID_FLAG_SAMELENGTH | ۰x4 | طول با extent قبلی برابر است |
BLOBID_FLAG_SPANNING | ۰x8 | blob از نوع spanning است (میان چند shard مشترک) و شناسهاش نوشته میشود |
بقیهی بیتها (پس از BLOBID_SHIFT_BITS = 4) شناسهی blob است. اگر blob محلی باشد و برای نخستین بار در این shard ظاهر شود، شناسه صفر نوشته میشود و decoder آن را از شمارندهی خودش استنتاج میکند.
مثال عددی: یک تصویر RBD با شیء ۴M که دو نوشتن ۶۴K پشتسرهم در offsetهای ۰ و ۰x10000، هرکدام در blob تازه، دریافت کرده است:
| extent | blobid پیش از varint | بایتهای lextent |
|---|---|---|
| ۱: lo=0، len=0x10000، boff=0 | CONTIGUOUS + ZEROOFFSET = ۰x3 | 03 + lowz(۰x۱۰۰۰۰)=43 → ۲ بایت |
| ۲: lo=0x10000، len=0x10000، boff=0 | CONTIGUOUS + ZEROOFFSET + SAMELENGTH = ۰x7 | 07 → ۱ بایت |
پس از هر lextent، اگر blob تازه باشد، خود blob هم کدگذاری میشود: پرچمها، pextentها (حدود ۵ بایت برای هرکدام) و آرایهی checksum. برای blob ۶۴K با crc32c و chunk ۴K، آرایهی checksum برابر ۱۶ × ۴ = ۶۴ بایت است. پس checksum غالبترین بخش حجم onode است، نه آدرسها. با bluestore_csum_type=crc32c_16 این حجم نصف میشود.
| گزینه | پیشفرض | نقش |
|---|---|---|
bluestore_extent_map_shard_max_size | ۱۲۰۰ | اگر shard از این اندازه (بایت کدگذاریشده) بزرگتر شود، دوباره shardبندی میشود |
bluestore_extent_map_shard_target_size | ۵۰۰ | اندازهی هدف هنگام shardبندی دوباره |
bluestore_extent_map_shard_min_size | ۱۵۰ | shardهای کوچکتر از این با همسایه ادغام میشوند |
bluestore_extent_map_inline_shard_prealloc_size | ۲۵۶ | پیشتخصیص بافر برای shard درون onode |
چرا shardبندی؟ RocksDB هر بهروزرسانی را بهصورت کامل بازنویسی میکند (LSM خاصیت read-modify-write در سطح مقدار ندارد). اگر یک تصویر RBD نوشتنهای تصادفی ۴K زیادی روی یک شیء ۴M داشته باشد، extent map آن صدها lextent پیدا میکند. بدون shard، هر نوشتن ۴K باید چند کیلوبایت onode را دوباره در WAL و memtable بنویسد و write amplification فراداده بهشدت بالا میرود. با shard، فقط shardی که بازهی نوشتهشده در آن است (حدود ۵۰۰ بایت) dirty میشود.
۲۴-۶-۴ shared blob و clone#
وقتی rbd snap یا clone_range یک blob را بین دو onode مشترک میکند، پرچم FLAG_SHARED روی blob گذاشته میشود و یک sbid میگیرد. شمارش ارجاع extentهای فیزیکی آن (bluestore_extent_ref_map_t: offset → {length، refs}) در کلید X + sbid ذخیره میشود. حذف یکی از cloneها فقط refs را کم میکند. فضای فیزیکی وقتی آزاد میشود که refs به صفر برسد.
۲۴-۷ deferred write روی دیسک#
برای نوشتنهای کوچکتر از bluestore_prefer_deferred_size (در HDD برابر ۶۴K)، BlueStore داده را ابتدا همراه تراکنش فراداده در RocksDB مینویسد. ساختار آن:
| struct | فیلدها |
|---|---|
bluestore_deferred_op_t | op (فقط OP_WRITE=1)، extents (PExtentVector مقصد)، data (bufferlist) |
bluestore_deferred_transaction_t | seq، ops (لیست)، released (interval_set فضاهایی که پس از اعمال آزاد میشوند) |
pseudocode: چرخهی deferred (خلاصهی این کتاب)
txc: kv.set("L" + seq, encode(deferred_txn)); kv.submit_sync() # WAL مربوط به RocksDB = پایداری
ack → client
deferred_queue: جمعآوری تا bluestore_deferred_batch_ops یا فشار throttle (128M)
_deferred_submit: aio_write(extents, data) روی دستگاه اصلی (بدون fsync جداگانه)
_deferred_aio_finish → در txc بعدی: kv.rmkey("L" + seq) # پس از flush دستگاه
mount پس از crash: _deferred_replay() همهی L* را دوباره روی دیسک مینویسد (idempotent)۲۴-۸ allocator: چه کسی فضای خالی را میشناسد؟#
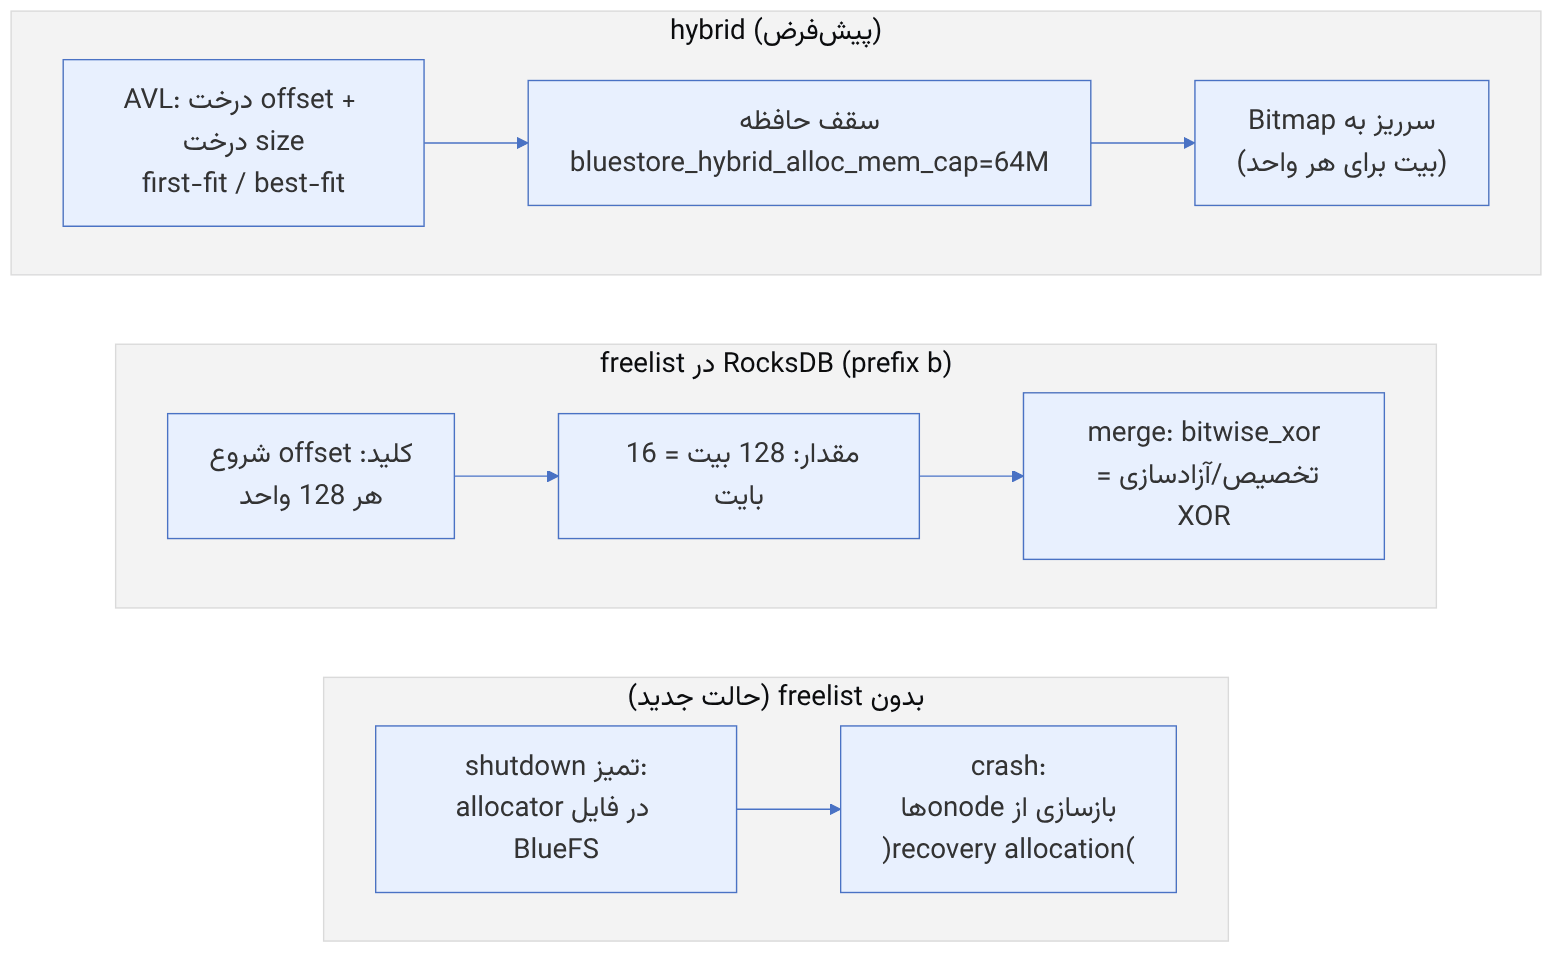
| allocator | ساختار | ویژگی |
|---|---|---|
bitmap | درخت سهسطحی بیت (fastbmap_allocator_impl) | حافظهی ثابت و قابل پیشبینی (۱ بیت برای هر واحد)، ولی جستجوی تکههای بزرگ کندتر است |
avl | دو درخت AVL: بر اساس offset و بر اساس size | first-fit تا bluestore_avl_alloc_bf_threshold=128K یا تا وقتی آزاد بیش از bf_free_pct=4% باشد، سپس best-fit |
btree / hybrid_btree2 | B-tree بهجای AVL | مصرف حافظهی کمتر برای هر بازه |
hybrid (پیشفرض) | AVL + Bitmap برای سرریز | سقف حافظه با bluestore_hybrid_alloc_mem_cap=64M |
stupid | درختهای bin | فقط برای آزمایش |
bluestore_allocator_lookup_policy (در Squid، Tentacle و main موجود است) مشخص میکند جستجو از آخرین موقعیت یافتهشده ادامه یابد (hdd_optimized، برای نوشتن پیوسته روی HDD و QLC) یا از ابتدای دستگاه آغاز شود (ssd_optimized)، یا بر اساس نوع دستگاه بهطور خودکار (auto) تعیین شود.
۲۴-۸-۱ امتیاز تکهتکه شدن#
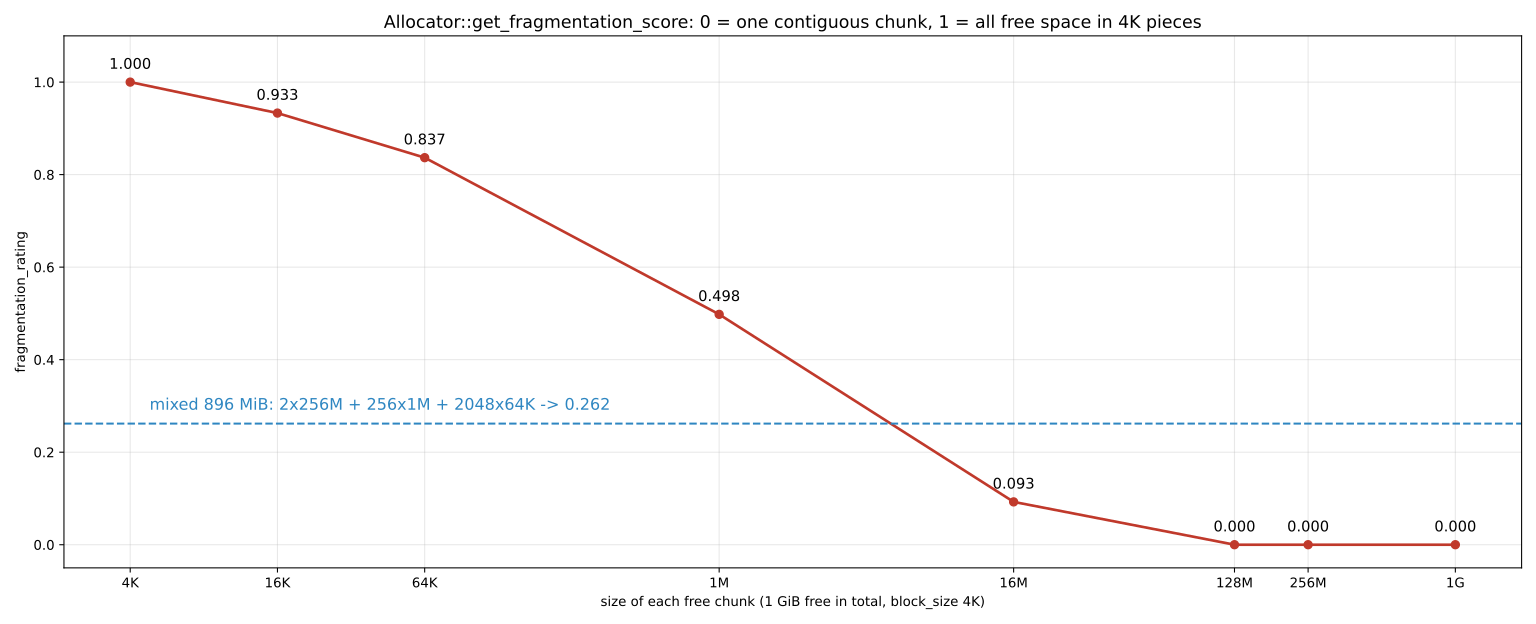
Allocator::get_fragmentation_score() عددی بین ۰ (یک تکهی پیوسته) و ۱ (همهی فضای آزاد در تکههای تکبلوکی) برمیگرداند. ایدهی آن این است که یک تکهی ۲X بایتی ارزشمندتر از دو تکهی X بایتی است. برای تکههای کوچکتر از ۱M هر دو برابر شدن طول ۱٫۲ برابر وزن میگیرد، این ضریب تا ۱۲۸M بهطور خطی به ۱ میرسد و بالاتر از آن ثابت است. امتیاز به این شکل حساب میشود:
score(len) ≈ تابع افزایشی محدب (درونیابی خطی بین 2^k و 2^(k+1) با ضرایب بالا)
ideal = score(sum) # همهی آزاد در یک تکه
terrible = (sum / block_size) × score(block_size)
actual = Σ score(len_i)
fragmentation = (ideal − actual) / (ideal − terrible)| وضعیت فضای آزاد (مثال مفهومی) | امتیاز |
|---|---|
| یک تکهی پیوستهی ۱۰۰G | ۰ |
| هزاران تکهی ۴M | میانه |
| میلیونها تکهی ۴K پراکنده | نزدیک ۱ |
ceph daemon osd.4 bluestore allocator score block       # {"fragmentation_rating": 0.27...}
ceph daemon osd.4 bluestore allocator fragmentation histogram block
ceph-bluestore-tool free-score --path /var/lib/ceph/osd/ceph-4 # OSD متوقفامتیاز بالای ۰٫۸ روی HDD معمولاً یعنی blobهای جدید به چند تکه شکسته میشوند و نوشتن ترتیبی به تصادفی تبدیل میشود. راه حل معمول افزودن ظرفیت یا کاهش پرشدگی است. ابزار جادویی defrag برای BlueStore وجود ندارد. بازسازی OSD (حذف و backfill) آخرین راه است.
۲۴-۸-۲ freelist و حالت بدون freelist#
در BitmapFreelistManager، bytes_per_block برابر واحد تخصیص (min_alloc_size) و blocks_per_key = bluestore_freelist_blocks_per_key = 128 است. پس هر کلید b با ۱۶ بایت مقدار، ۱۲۸ واحد (با واحد ۴K، یعنی ۵۱۲K دیسک) را پوشش میدهد. تخصیص و آزادسازی هر دو XOR با یک ماسکاند (XorMergeOperator با نام bitwise_xor). بنابراین بدون خواندن مقدار قبلی، فقط یک merge به RocksDB فرستاده میشود.
گزینهی bluestore_allocation_from_file از Quincy وجود دارد (در Pacific نیست) و در main پیشفرض true است. در این حالت بهروزرسانی freelist در مسیر نوشتن حذف میشود و BlueStore هنگام umount تمیز، نقشهی allocator را در فایل ALLOCATOR_NCB_DIR/ALLOCATOR_NCB_FILE درون BlueFS مینویسد. اگر shutdown تمیز نباشد، mount بعدی با read_allocation_from_onodes همهی onodeها را پویش میکند تا فضای استفادهشده را بازسازی کند. این روش تراکنشها را سبکتر میکند، ولی پس از crash زمان mount روی OSDهای پراز اشیا را چند دقیقه بیشتر میکند.
۲۴-۹ کش BlueStore#
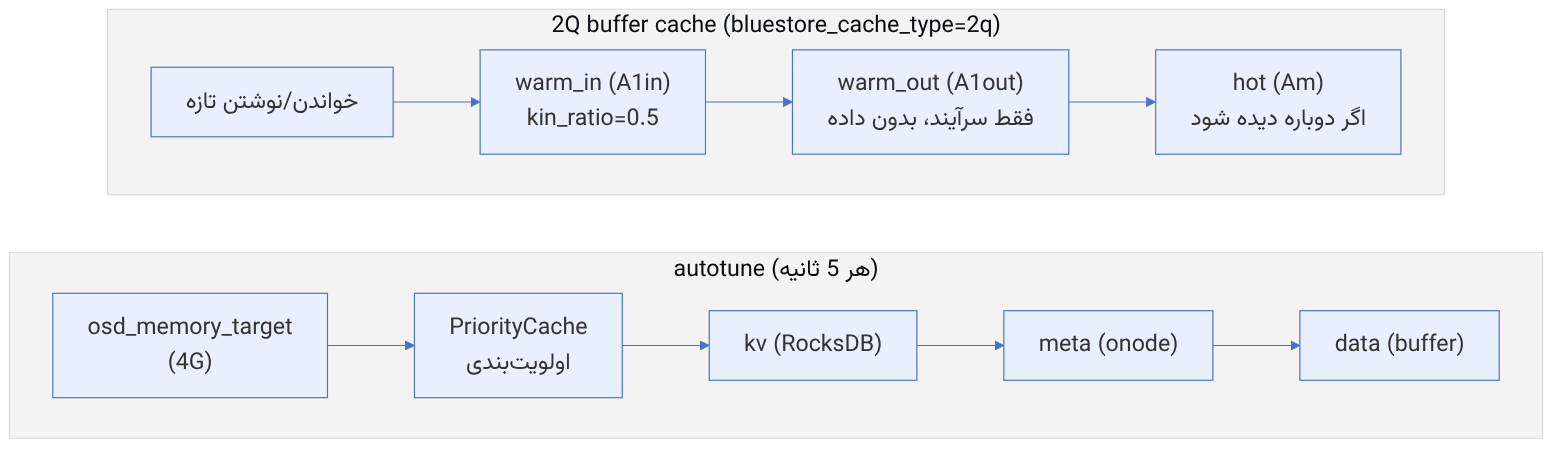
| گزینه | پیشفرض | نقش |
|---|---|---|
bluestore_cache_type | ۲q | نوع کش buffer (2q یا lru)؛ کش onode همیشه LRU است |
bluestore_2q_cache_kin_ratio / kout_ratio | ۰.۵ / ۰.۵ | سهم warm_in و اندازهی warm_out |
bluestore_cache_autotune | true | تقسیم پویا با PriorityCache |
bluestore_cache_autotune_interval | ۵ | ثانیه |
bluestore_cache_size_hdd / ssd | ۱_G / ۳_G | فقط وقتی autotune خاموش باشد |
bluestore_cache_meta_ratio / kv_ratio / kv_onode_ratio | ۰.۴۵ / ۰.۴۵ / ۰.۰۴ | سهمهای اولیه در حالت دستی |
osd_memory_cache_min | ۱۲۸_M | کف کل کش |
کشها shardبندی شدهاند (هر shard عملیاتی OSD کش خودش را دارد) تا رقابت روی قفل کم شود. onodeها با شمارندهی ارجاع pin میشوند. onodeی که در یک تراکنش در جریان استفاده میشود، تا پایان تراکنش بیرون رانده نمیشود، حتی اگر کش پر باشد.
ceph daemon osd.4 perf dump bluestore | jq '.bluestore | {onodes, onode_hits, onode_misses}'
ceph daemon osd.4 dump_mempools | jq '.mempool.by_pool | {o: .bluestore_cache_onode, d: .bluestore_cache_data}'۲۴-۱۰ تخصیص فضا با عدد#
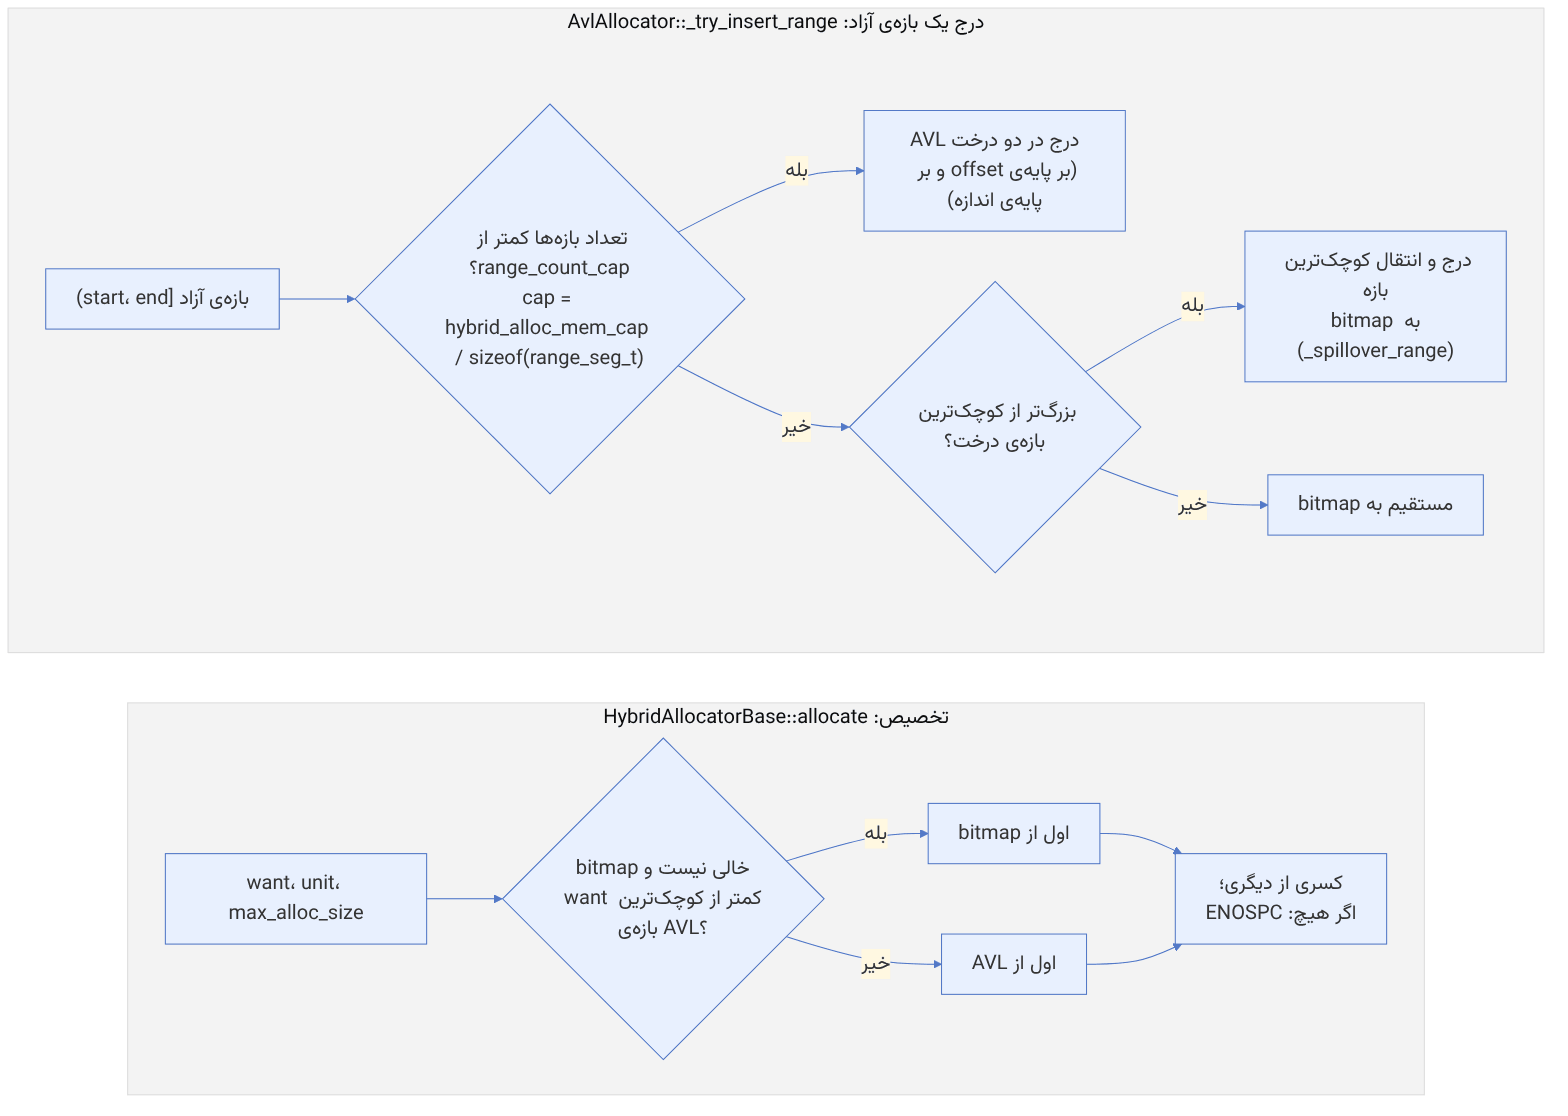
فضای آزاد دستگاه اصلی BlueStore را تخصیصدهنده (allocator) نگه میدارد. پیشفرض bluestore_allocator = hybrid است: یک AVL allocator که بخشی از بازههایش را در صورت نیاز به bitmap allocator میسپارد. این بخش سه الگوریتم آن را با عدد دنبال میکند.
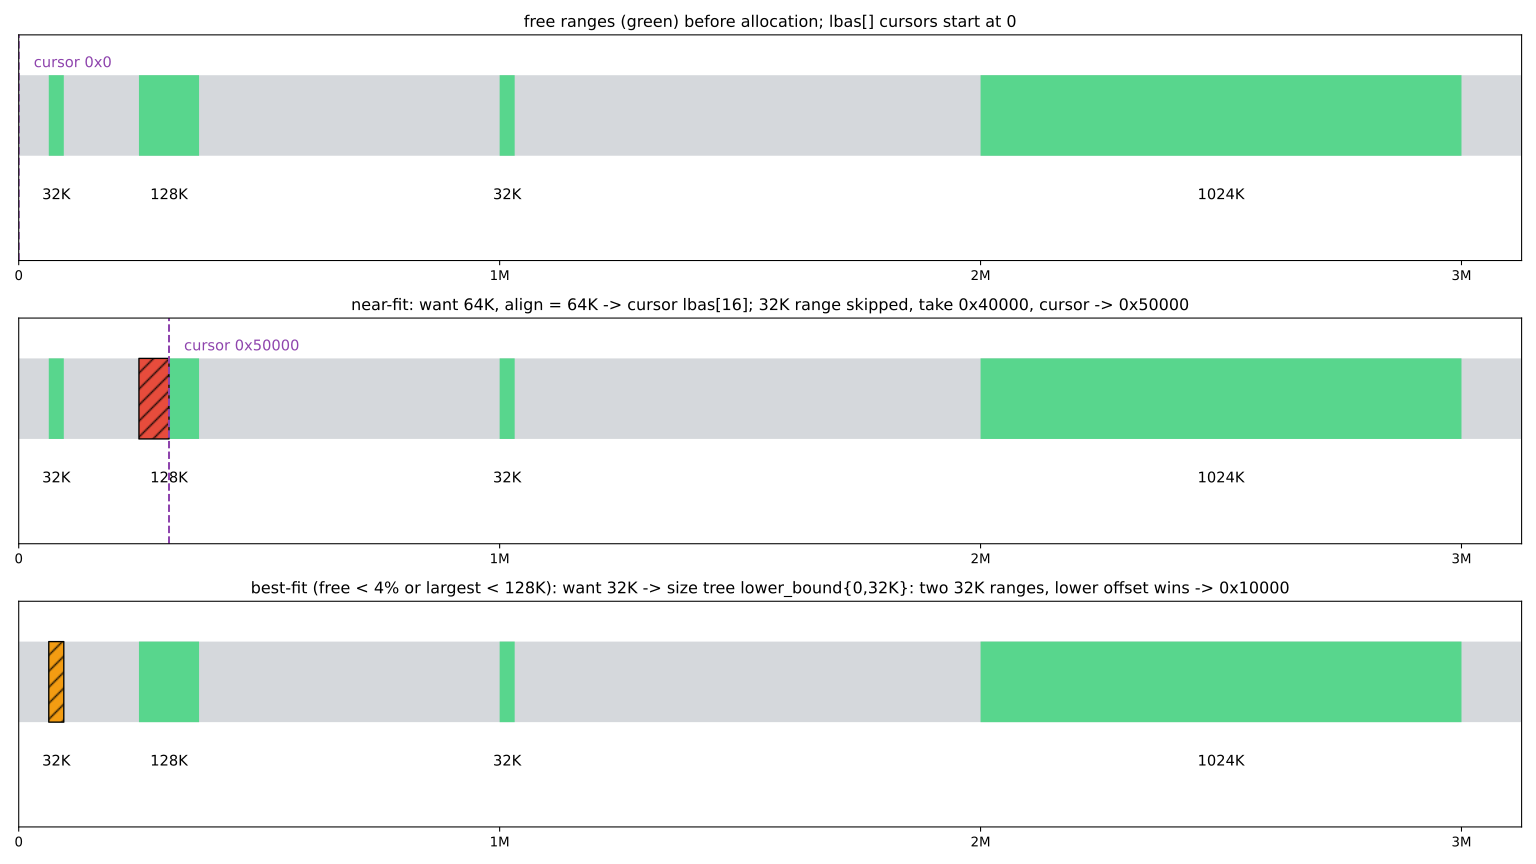
۲۴-۱۰-۱ near-fit و best-fit در AVL#
منبع در کد: src/os/bluestore/AvlAllocator.cc :: AvlAllocator::_allocate، _pick_block_after، _pick_block_fits
پیچیدگی: near-fit O(log R + c) با سقف c = ۱۰۰ گام یا ۱۶ MiB پیمایش؛ best-fit O(log R) روی درخت اندازه
pseudocode
max_size = بزرگترین بازه (انتهای درخت اندازه)
if max_size < want: want = p2align(max_size, unit) ; force best-fit # تخصیص تکهای
free_pct = num_free × 100 / device_size
if force or max_size < bf_threshold (128K) or free_pct < bf_free_pct (4): best-fit
else near-fit:
align = want & −want ; cursor = lbas[cbits(align) − 1] # یک cursor برای هر توان دو
از lower_bound(cursor) در درخت offset جلو برو تا offset + want ≤ end
(حداکثر ff_max_search_count = 100 بازه یا ff_max_search_bytes = 16M؛ بعد از ابتدا تا cursor)
best-fit: lower_bound({0, want}) در درخت اندازه ⇒ کوچکترین بازهی کافی؛ در تساوی، offset کمترمثال عددی. بخشی از دستگاه چهار بازهی آزاد دارد: ۳۲K در ۰x10000، ۱۲۸K در ۰x40000، ۳۲K در ۰x100000 و ۱M در ۰x200000.
- درخواست ۶۴K (near-fit): align = ۰x10000، پس cbits = ۱۷ و cursor = lbas[16] = ۰. بازهی اول کوچک است و cursor به ۰x20000 میرود. بازهی دوم جا دارد: offset = ۰x40000 و cursor = ۰x50000. درخواست ۶۴K بعدی با همین cursor از ۰x50000 ادامه میدهد، پس تخصیصهای هماندازه کنار هم میافتند.
- درخواست ۳۲K (best-fit): فرض کنید دستگاه بزرگ است و فضای آزاد زیر ۴٪ آمده. درخت اندازه دو بازهی ۳۲K دارد و lower_bound با کلید {۰، ۳۲K} آنکه offset کمتر دارد را برمیگرداند، یعنی ۰x10000. بازهی ۱M دست نخورده میماند.
جریمهی near-fit این است که بازههای بزرگ را تکهتکه میکند. best-fit کندتر نیست، اما تخصیصهای پیاپی را از هم دور میکند. به همین دلیل فقط وقتی فضا کم است فعال میشود.
۲۴-۱۰-۲ امتیاز تکهتکه شدن با عدد#
منبع در کد: src/os/bluestore/Allocator.cc :: Allocator::get_fragmentation_score
پیچیدگی: O(R) برای R بازهی آزاد (یک پیمایش با foreach_interruptible)
pseudocode
scale[0] = 1 ; scale[k+1] = scale[k] × w(k) # w = 1.2 تا 2^20، خطی تا 1.0 در 2^27، بعد 1.0
score(v): sc = floor(log2 v) ; b = 2^sc ; x = (v − b)/b
return b·scale[sc]·(1 − x) + 2b·scale[sc+1]·x # درونیابی خطی
actual = Σ score(len_i) ; ideal = score(Σ len) ; terrible = (Σ len / block_size) × score(block_size)
rating = (ideal − actual) / (ideal − terrible)مثال عددی (block_size = ۴K، ۱ GiB آزاد). این اعداد با پیادهسازی مستقل همین فرمول حساب شدهاند:
- یک تکهی ۱G، و هر تکهی بزرگتر از ۱۲۸M: امتیاز ۰.
- تکههای ۱۶M: 0.093.
- تکههای ۱M: 0.498.
- تکههای ۶۴K: 0.837.
- تکههای ۱۶K: 0.933.
- تکههای ۴K: 1.
- ترکیب ۸۹۶ مگابایتی (دو تکهی ۲۵۶M، ۲۵۶ تکهی ۱M و ۲۰۴۸ تکهی ۶۴K): ۰.۲۶۲. بیشتر فضا در تکههای بزرگ است، پس امتیاز پایین میماند، هرچند تعداد تکههای کوچک زیاد است.
چون ضریب بالای ۱۲۸M برابر ۱ است، تکههایی بزرگتر از ۱۲۸M هیچ جریمهای ندارند. امتیاز بالای ۰.۸ روی HDD معمولاً یعنی min_alloc_size کوچک و تخصیصهای پراکنده. در این حالت نوشتنهای بزرگ به چند extent شکسته میشوند.
۲۴-۱۰-۳ سرریز hybrid به bitmap#
منبع در کد: src/os/bluestore/AvlAllocator.h :: AvlAllocator::_try_insert_range؛ src/os/bluestore/HybridAllocator_impl.h :: HybridAllocatorBase::allocate، _spillover_range
پیچیدگی: درج O(log R)؛ با سقف R ≤ range_count_cap
pseudocode
range_count_cap = bluestore_hybrid_alloc_mem_cap (64M) / sizeof(range_seg_t)
insert(start, end):
if size_tree.size < cap: درج در AVL
elif end − start > کوچکترین بازهی AVL: درج و انتقال کوچکترین به bitmap
else: مستقیم به bitmap
allocate(want):
primary = AVL ، مگر bitmap فضای آزاد دارد و want < کوچکترین بازهی AVL ⇒ primary = bitmap
از primary بگیر ؛ کسری را از دیگری بگیر ؛ هیچ ⇒ ENOSPCمثال عددی. هر range_seg_t دو عدد ۶۴ بیتی (start و end، روی هم ۱۶ بایت) و دو hook درخت AVL از boost::intrusive دارد (offset_hook و size_hook). MEMPOOL_CLASS_HELPERS() فقط operator new/delete تعریف میکند و عضو دادهای اضافه نمیکند. هر avl_set_member_hook<> با پارامترهای پیشفرض (بدون optimize_size) سه اشارهگر parent، left و right و یک فیلد balance دارد که با همترازی ۸ بایتی ۳۲ بایت میشود. پس sizeof(range_seg_t) = ۱۶ + ۳۲ + ۳۲ = ۸۰ بایت است. این عدد را با کامپایل یک برنامهی کوچک با همین چیدمان روی x86-64 (هدرهای boost.intrusive شاخهی اصلی، Clang 22.1 از طریق zig c++ 0.17.1، استاندارد C++17) بررسی کردیم: خروجی hook = ۳۲، seg = ۸۰، offsetof(size_hook) = ۴۸ و alignof = ۸ بود. سقف ۶۴ مگابایتی (bluestore_hybrid_alloc_mem_cap = ۶۴ MiB = ۶۷۱۰۸۸۶۴ بایت) بنابراین ⌊۶۷۱۰۸۸۶۴ / ۸۰⌋ = ۸۳۸۸۶۰ بازه را در AVL نگه میدارد. حافظهی واقعی کمی بیشتر است، چون سربار تخصیصدهندهی heap در این محاسبه نیست. روی معماریهای ۳۲ بیتی یا با هدرهای boost دیگر ممکن است عدد فرق کند.
- HDD شانزده ترابایتی با ۳۰٪ فضای آزاد و میانگین تکهی ۶۴K: حدود ۴.۸T / ۶۴K، یعنی نزدیک ۷۳ میلیون بازه وجود دارد. پس بیش از ۹۸٪ بازهها، یعنی کوچکترینها، در bitmap میمانند و AVL فقط بزرگترینها را نگه میدارد.
- تخصیص ۴K: از کوچکترین بازهی AVL کوچکتر است، پس مستقیم از bitmap گرفته میشود و بازههای بزرگ دست نخورده میمانند.
برای دیدن وضعیت واقعی، ceph daemon osd.N bluestore allocator score block و bluestore allocator fragmentation histogram block را اجرا کنید. اگر بیشتر بازهها کوچکاند و امتیاز بالاست، ceph-bluestore-tool --command free-dump توزیع کامل را میدهد. این دستور فقط روی OSD متوقف اجرا میشود.
۲۴-۱۱ روی دیسک واقعی: label و نقشهی فضای آزاد#
دو شکل این بخش از OSDهای BlueStore یک کلاستر آزمایشی با Ceph 18.2.7 گرفته شدهاند. دستگاه block هر OSD یک فایل sparse دهگیگابایتی بود.
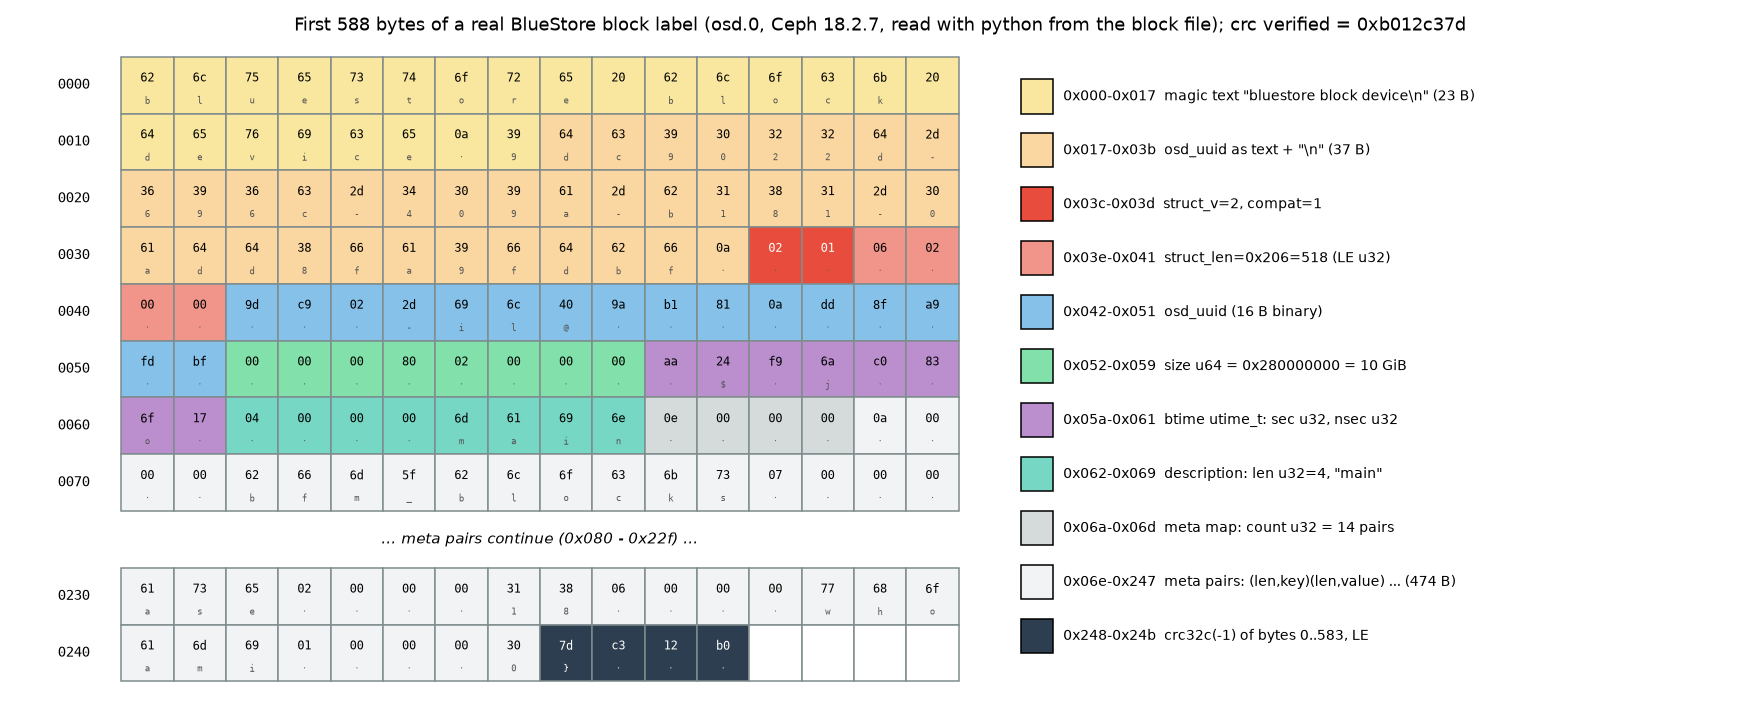
۲۴-۱۱-۱ ۵۸۸ بایت نخست label#
بایتها مستقیم از فایل block خوانده شدند و با خروجی ceph-bluestore-tool show-label مقایسه شدند. این کلاستر بدون cephx بود، پس meta کلید osd_key نداشت. در کلاستر واقعی این فیلد را پیش از نشان دادن به کسی حذف کنید.
منبع در کد: bluestore_bdev_label_t::encode/decode در src/os/bluestore/bluestore_types.cc؛ _write_bdev_label با bl.crc32c(-1) در BlueStore.cc
پیچیدگی: O(طول label)
pseudocode
b = 4 KiB نخست دستگاه
از 60 بایت متنی بپر: "bluestore block device\n" (23) + uuid متنی + "\n" (37)
struct_v = b[60] ؛ compat = b[61] ؛ len = u32le(b[62:66])        # ENCODE_START(2, 1)
osd_uuid = b[66:82] ؛ size = u64le(b[82:90]) ؛ btime = (u32 sec, u32 nsec)
description = (u32 len, bytes) ؛ meta = u32 count و سپس count جفت (u32 len, key)(u32 len, value)
end = 60 + 6 + len ؛ crc = u32le(b[end:end+4])
درست اگر crc32c(seed = 0xffffffff, بدون xor پایانی)(b[0:end]) == crc
مقادیر واقعی.
- سرآیند ساختار: در آفست ۰x3c مقدار
02 01 یعنی struct_v = ۲ و compat = ۱، و 06 02 00 00 یعنی طول ۵۱۸. پس بدنه تا آفست ۵۸۴ ادامه دارد. - size:
00 00 00 80 02 00 00 00 برابر ۰x280000000، یعنی ۱۰۷۳۷۴۱۸۲۴۰ بایت. - btime: شامل sec = ۱۷۹۴۷۱۲۷۴۶ و nsec = ۳۹۳۱۸۴۱۹۲، یعنی ۲۰۲۶-۱۱-۱۵ ۰۶:۴۹:۰۶.۳۹۳ به وقت تهران.
- description و meta: مقدار description برابر "main" است و meta چهارده جفت دارد، از جمله
bfm_blocks = 2621440، bfm_bytes_per_block = 4096، kv_backend = rocksdb و magic = ceph osd volume v026. - crc: چهار بایت آفست ۰x248 برابر ۰xb012c37d است. همین مقدار را با پیادهسازی مستقل crc32c (چندجملهای Castagnoli، seed برابر −۱، بدون xor پایانی) دوباره حساب کردیم. decoder همان ۶۰ بایت را با
p += 60u رد میکند.
۲۴-۱۱-۲ نقشهی فضای آزاد allocator#
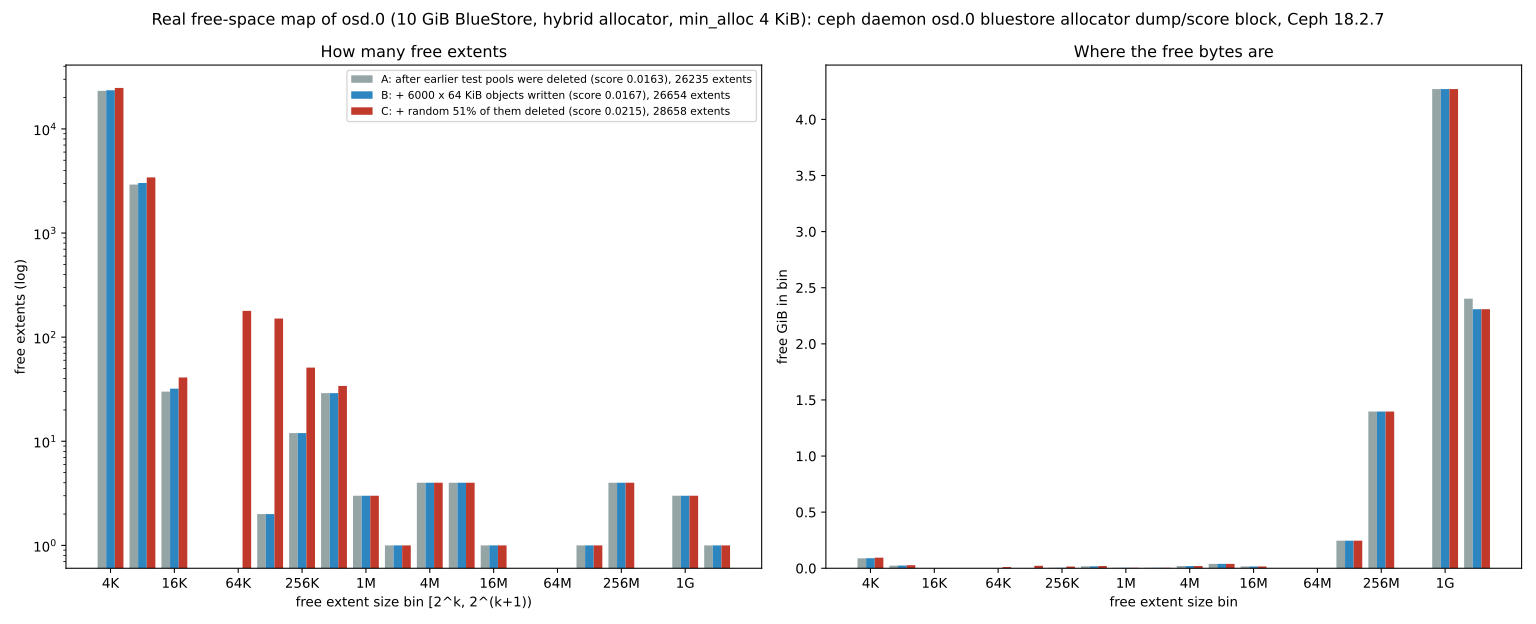
ابزار مورد استفاده ceph daemon osd.0 bluestore allocator dump block است. این فرمان فهرست کامل extentهای آزاد را میدهد. … allocator score block هم fragmentation_rating را برمیگرداند. هر دو برای allocator پیشفرض این نسخه (hybrid) با min_alloc_size برابر ۴ KiB گرفته شدند. سه لحظه ثبت شد:
- A: پس از حذف poolهای آزمایشی قبلی (بنچمارکهای ۴ KiB و ۴ MiB). امتیاز ۰.۰۱۶۳ بود.
- B: پس از نوشتن ۶۰۰۰ شیء ۶۴ KiB در یک pool تکنسخهای. امتیاز ۰.۰۱۶۷ بود.
- C: پس از حذف تصادفی ۵۱٪ آن شیءها. امتیاز ۰.۰۲۱۵ بود.
آنچه داده نشان میدهد.
- ۱. حفرههای ۴ KiB: حتی در A، فضای آزاد به ۲۶۲۳۵ extent تکه شده بود که ۲۳۲۱۸ تای آنها فقط ۴ KiB بودند. علت دقیق این حفرهها را در این آزمایش جدا نکردیم. احتمالاً به جایگیری درهم با دادهها و فرادادههای زنده برمیگردد.
- ۲. حجم فضای آزاد: حدود ۸.۵ GiB فضای آزاد تقریباً همه در چند extent بزرگ ۲۵۶ MiB تا ۲.۴ GiB است.
- ۳. نوشتن ۶۴ KiB: این نوشتنها حفرههای ۴ KiB را پر نکردند، چون allocator برای درخواست ۶۴ KiB یک extent پیوسته میخواهد. حذف تصادفی بعدی حدود ۳۳۰ حفرهی تازهی ۶۴ تا ۵۱۲ KiB ساخت.
- ۴. امتیاز کلی: fragmentation_rating در هر سه حالت زیر ۰.۰۳ ماند. این امتیاز با وزن بایت حساب میشود (الگوریتم امتیاز fragmentation در بخش قبل) و وقتی بیشتر بایتهای آزاد در extentهای بزرگاند، دهها هزار حفرهی کوچک آن را بالا نمیبرند.
پس امتیاز پایین به این معنا نیست که «حفرهی کوچک نداریم». تعداد extentها روی حافظهی allocator و زمان جستوجو اثر دارد. برای دیدن آن، خود فهرست extentها را بشمارید.
۲۴-۱۲ تکمیلی و بهروز#
- کپیهای label (
bdev_label_positions) در کد Squid، Tentacle و main وجود دارند. حالت envelope در BlueFS فقط در Tentacle و main هست و در Squid نیست. اگر خوشهی مختلط دارید، روی OSDهای قدیمیتر روی این ویژگیها حساب نکنید. -
hybrid_btree2 و bluestore_allocator_lookup_policy در Squid و بالاتر وجود دارند. - شاخهی main همچنین ساختارهای مربوط به نوشتن جدید BlueStore (مثل
segment_size در onode و FragMetric در bluestore_common.h) را دارد که بخشی از کارهای در جریان روی کاهش تکهتکه شدن و EC جدید است. جزئیات آن را پیش از انتشار نهایی در یادداشتهای نسخه دنبال کنید.
۲۴-۱۳ تمرین عملی#
- ۱. روی یک OSD آزمایشی ۴K اول دستگاه را با
dd بخوانید. ۶۰ بایت متنی را ببینید، بقیه را با خروجی ceph-bluestore-tool show-label مقایسه کنید و crc را با تابع پایتون فصل ۲۳ دوباره حساب کنید. - ۲. یک تابع
lowz و lba بنویسید، مقادیر جدول این فصل را بازتولید کنید و برای offsetهای واقعی خروجی ceph-bluestore-tool fsck --deep یا dump onode اندازهی کدگذاری را بسنجید. - ۳. یک تصویر RBD را با fio بهصورت تصادفی ۴K بنویسید و تعداد کلیدهای
O با پسوند x (shardها) را پیش و پس از آن با ceph-kvstore-tool بشمارید. - ۴.
bluestore allocator score block را روزانه روی چند OSD ثبت و با درصد پر بودن آنها مقایسه کنید. - ۵. OSD را با
kill -9 متوقف کنید، دوباره راه بیندازید و در لاگ زمان read_allocation_from_onodes را اندازه بگیرید.
۲۴-۱۴ پرسشهای مرور#
- ۱. ۶۰ بایت اول label شامل چیست و چرا decoder از آن میپرد؟
- ۲. چرا superblock مربوط به BlueFS همیشه در offset 4096 است؟
- ۳.
denc_lba برای offset همتراز با ۴K چند بایت مصرف میکند و چرا؟ - ۴. چه شرطی فشردهسازی لاگ BlueFS را آغاز میکند؟
- ۵. چرا hash در کلید onode بیتمعکوس است؟
- ۶. پرچمهای BLOBID در extent map چه صرفهجوییای ایجاد میکنند؟
- ۷. چرا checksum بزرگترین بخش یک blob کدگذاریشده است؟
- ۸. hybrid allocator چگونه مصرف حافظه را محدود میکند؟
- ۹. چرا freelist از merge با XOR استفاده میکند؟
- ۱۰. الگوریتم ۲Q چه مشکلی از LRU را حل میکند؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۴-۱۵ منابع این فصل#
- انواع BlueStore
https://github.com/ceph/ceph/blob/main/src/os/bluestore/bluestore_types.h - انواع BlueFS
https://github.com/ceph/ceph/blob/main/src/os/bluestore/bluefs_types.h - کدگذاری denc
https://github.com/ceph/ceph/blob/main/src/include/denc.h - امتیاز تکهتکه شدن
https://github.com/ceph/ceph/blob/main/src/os/bluestore/Allocator.cc - BitmapFreelistManager
https://github.com/ceph/ceph/blob/main/src/os/bluestore/BitmapFreelistManager.cc - پیکربندی BlueStore
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - ceph-bluestore-tool
https://docs.ceph.com/en/latest/man/8/ceph-bluestore-tool/ - مقالهی BlueStore (SOSP ۲۰۱۹
https://www.pdl.cmu.edu/PDL-FTP/Storage/ceph-exp-sosp19.pdf - ۲Q (Johnson و Shasha، VLDB 1994
https://www.vldb.org/conf/1994/P439.PDF