بخش تخصصی (۵): RBD — مسیر I/O در librbd، layering و copyup، exclusive-lock، cache و QoS
حوصله ندارم این فصل در چند خط
- librbd هر درخواست را از زنجیرههای لایهای ImageDispatcher و ObjectDispatcher (QoS، cache، journal و دیگران) عبور میدهد.
- clone در محدودهی overlap از والد میخواند؛ اولین نوشتن دادهی والد را بالا میآورد (copyup) و flatten همه را کپی میکند.
- exclusive-lock همیارانه است و با یک نویسنده در هر لحظه object map، journal و cache را سازگار نگه میدارد.
- cache پیشفرض writearound است؛ QoS برای هر محدودیت یک token bucket دارد؛ krbd، librbd و rbd-nbd در پشتیبانی از قابلیتها متفاوتاند.
۳۸-۱ پیش از شروع#
librbd یک کتابخانهی سنگین است: هر درخواست از چند لایهی dispatch در سطح image و سپس در سطح شیء عبور میکند، و ویژگیهایی مثل exclusive-lock، journaling، cache، رمزنگاری و QoS هر کدام یک لایهاند. این فصل آن لایهها را به ترتیب واقعیشان نشان میدهد، سپس سه سازوکار پرکاربرد را در جزئیات باز میکند: copyup در clone و flatten، گرفتن و شکستن exclusive-lock با blocklist، و cache پیشفرض writearound. در پایان krbd، librbd و rbd-nbd را از نظر ویژگی و کارایی مقایسه میکند. نامها و پیشفرضها با شاخهی main مخزن ceph/ceph (نوامبر ۲۰۲۶) تطبیق داده شدهاند.
۳۸-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
- یک
rbd_aio_write از کدام لایهها عبور میکند؟ - نوشتن روی شیئی از clone که هنوز وجود ندارد چگونه انجام میشود؟
- deep-flatten چه فرقی با flatten معمولی دارد؟
- دو کلاینت که همزمان یک image را باز میکنند چگونه قفل را دستبهدست میکنند؟
- چه زمانی librbd کلاینت دیگری را blocklist میکند؟
- cache پیشفرض librbd چه کار میکند و چه کار نمیکند؟
- QoS در librbd چگونه کار میکند و چه محدودیتی دارد؟
۳۸-۱-۲ پیشنیاز#
فصل ۲ (RBD)، فصل ۲۹ (krbd)، فصل ۳۶ (SnapContext و clone در RADOS)، فصل ۳۷ (header و object map).
۳۸-۲ لایههای dispatch#
ImageDispatcher و ObjectDispatcher دو زنجیره از لایهها هستند. هر لایه میتواند درخواست را بگیرد و تمام کند، تغییر دهد و به لایهی بعد بسپارد، یا تا رفع شرطی نگه دارد. ترتیب از librbd/io/Types.h:
| ترتیب | لایهی image | نقش |
|---|---|---|
| ۱ | QUEUE | صف ورودی و انتقال به thread pool (rbd_op_threads) |
| ۲ | QOS | محدودیت IOPS و پهنای باند (token bucket) |
| ۳ | EXCLUSIVE_LOCK | نگه داشتن نوشتنها تا گرفتن قفل |
| ۴ | REFRESH | بهروزرسانی ImageCtx اگر header تغییر کرده باشد |
| ۵ | MIGRATION | هدایت به image مبدأ در مهاجرت زنده |
| ۶ | JOURNAL | ثبت رویداد در journal پیش از نوشتن (فصل ۳۹) |
| ۷ | WRITE_BLOCK | توقف موقت نوشتنها در عملیاتی مثل snapshot |
| ۸ | WRITEBACK_CACHE | cache پایدار PWL، اگر فعال باشد |
| ۹ | CORE | تبدیل extent تصویر به extent شیء با Striper (فصل ۳۷) |
| ترتیب | لایهی شیء | نقش |
|---|---|---|
| ۱ | CACHE | writearound یا ObjectCacher (writeback و writethrough) |
| ۲ | CRYPTO | رمزنگاری LUKS در سطح بلوک |
| ۳ | JOURNAL | تأخیر نوشتن شیء تا commit رویداد journal |
| ۴ | PARENT_CACHE | cache فقطخواندنی والد از طریق ceph-immutable-object-cache |
| ۵ | SCHEDULER | ادغام نوشتنهای کوچک پشتسرهم (rbd_io_scheduler) |
| ۶ | CORE | ساختن ObjectRequest و ارسال op به RADOS |
منبع در کد: src/librbd/io/ImageDispatcher.cc؛ src/librbd/io/ObjectDispatcher.cc؛ src/librbd/io/ImageRequest.cc :: ImageWriteRequest؛ src/librbd/io/ObjectRequest.cc :: ObjectWriteRequest
پیچیدگی: O(L) لایه برای هر درخواست، بهعلاوهی O(k) شیء پس از striping
pseudocode
ImageDispatcher.send(write(extents, data)):
    for layer in [QUEUE, QOS, EXCLUSIVE_LOCK, REFRESH, MIGRATION, JOURNAL, WRITE_BLOCK, WRITEBACK_CACHE, CORE]:
        result = layer.write(...)          # true = layer took it
        if result == CONTINUE: next layer
        if result == COMPLETE: done
        if layer is holding it: it resumes later from the next layer
CORE: Striper.file_to_extents → for each object extent:
    ObjectDispatcher.send(write(objectno, off, data, snapc = image snapc))
        CACHE → CRYPTO → JOURNAL → PARENT_CACHE → SCHEDULER → CORE
CORE: ObjectWriteRequest:
    if object_map says may not exist and has parent overlap → copyup (الگوریتم ۳۸-۲)
    else object_map_update(EXISTS) if needed → RADOS write op with snapc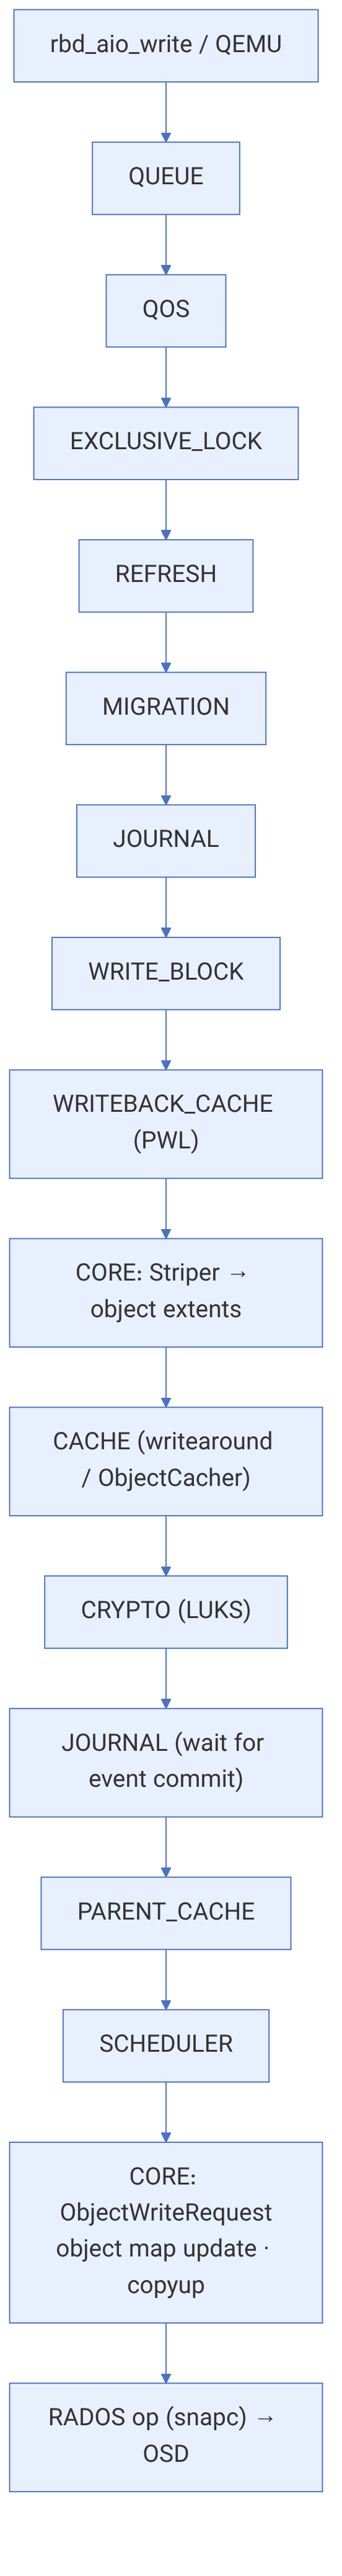
۳۸-۳ layering: clone، copyup و flatten#
clone یک image است که در header خود کلید parent (pool، namespace، image و snap والد و overlap) دارد. overlap بخشی از فضای آدرس است که هنوز میتواند از والد خوانده شود؛ اگر clone کوچک شود، overlap هم کم میشود و دیگر بزرگ نمیشود.
- خواندن: اگر شیء در clone وجود نداشته باشد (ENOENT یا object map NONEXISTENT) و extent در overlap باشد، همان extent از والد خوانده میشود. با
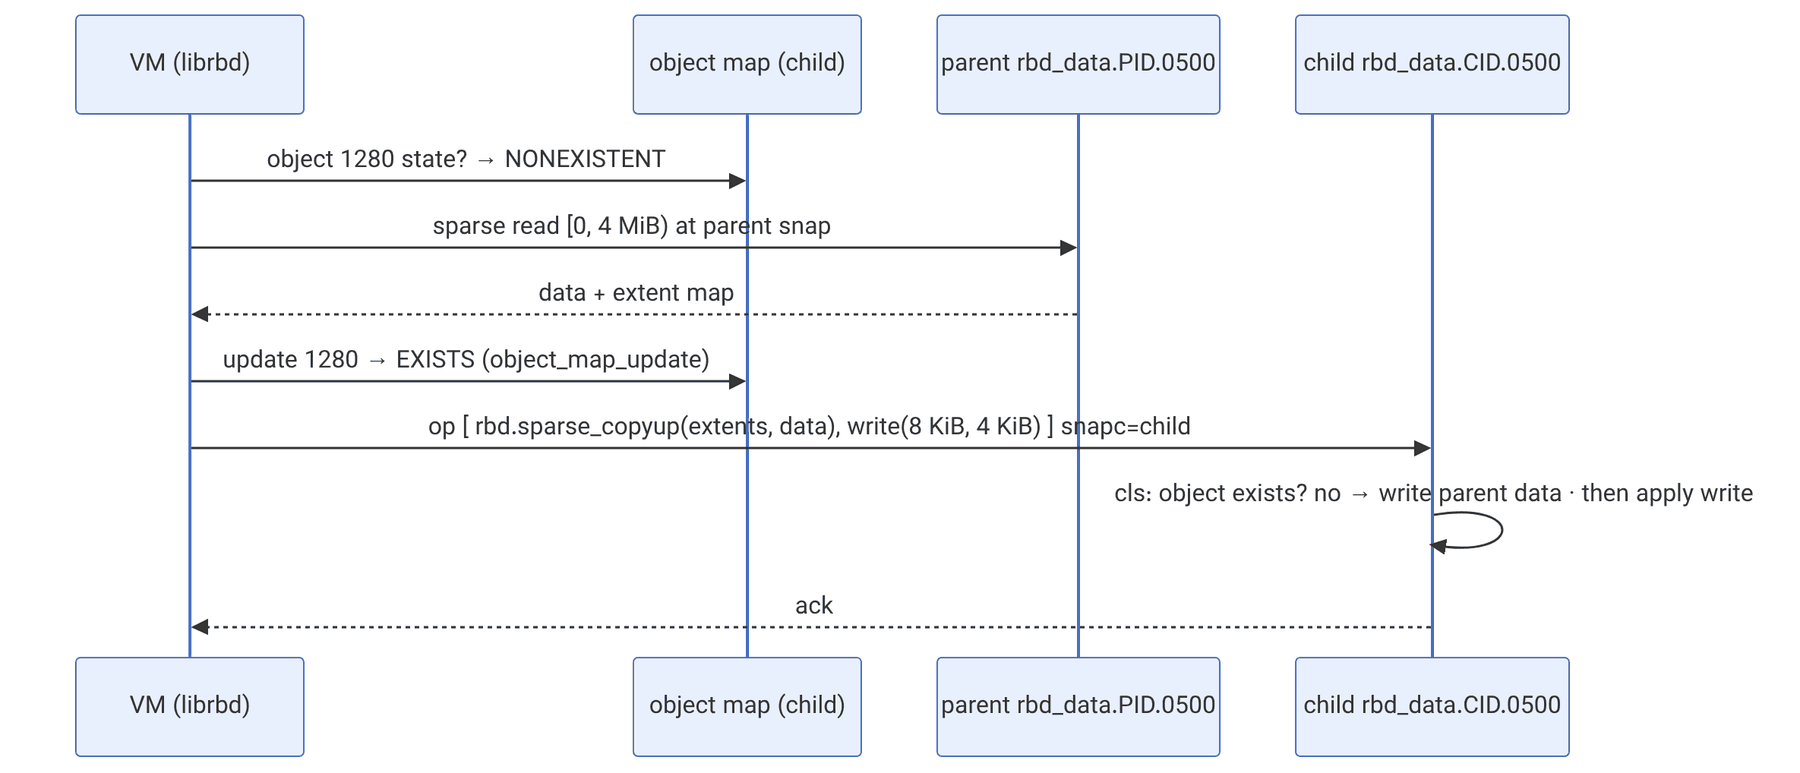
rbd_clone_copy_on_read همان داده بلافاصله در clone هم نوشته میشود. - نوشتن: نوشتن جزئی روی شیئی که هنوز در clone نیست ابتدا باید بقیهی شیء را از والد بیاورد، وگرنه بخشهای نخوانده صفر خواهند شد. این کار copyup است.
منبع در کد: src/librbd/io/ObjectRequest.cc :: AbstractObjectWriteRequest::compute_parent_info، send_write، handle_write_object؛ src/librbd/io/CopyupRequest.cc؛ src/cls/rbd/cls_rbd.cc :: copyup
پیچیدگی: یک خواندن از والد (تا اندازهی شیء) و یک op مرکب روی شیء clone
pseudocode
write to child object o:
copyup_enabled = has_parent and extent of o within overlap
if object map says o does not exist and copyup_enabled: goto copyup # بهینهسازی
send write with assert_exists guard
on -ENOENT and copyup_enabled: goto copyup
copyup (one CopyupRequest per object; later writes append to it):
read parent extents of o (sparse read)
if snapshots exist on child (deep_copyup): first send copyup alone with EMPTY snapc
# تا cloneهای RADOS برای snapshotهای child هم دادهی والد را ببینند
op = cls rbd.copyup(data) or rbd.sparse_copyup(extent_map, data)
append all pending writes of this object to the same op (if not deep_copyup)
update object maps (head, and snapshots if deep-flatten) → EXISTS
send op with child snapc
cls rbd.copyup on OSD: if object exists → return 0 ; else write data at offset 0نکتهی ظریف در cls: اگر دو کلاینت همزمان copyup کنند، دومی میبیند شیء وجود دارد و دادهی والد را نمینویسد، ولی نوشتن خودش (که در همان op است) اعمال میشود. چون copyup و نوشتن در یک op اتمیاند، هیچکس نیمهی پر شیء را نمیبیند.
flatten همهی اشیای درون overlap را با یک copyup بدون دادهی کاربر پر میکند (FlattenRequest برای هر شیء یک نوشتن خالی میفرستد که copyup را برمیانگیزد) و سپس پیوند والد را حذف میکند (child_detach در header والد و حذف کلید parent). deep-flatten یعنی copyup به snapshotهای clone هم برسد؛ بدون آن، snapshotهای clone هنوز به والد وابسته میمانند و والد را نمیتوان حذف کرد.
مثال عددی. یک clone از تصویر سیستمعامل ۲۰ GiB با ۵۱۲۰ شیء. VM ۴ KiB در آفست ۵ GiB + ۸ KiB مینویسد. شیء ۱۲۸۰ در clone وجود ندارد. librbd شیء ۱۲۸۰ والد را (فرض: کاملاً پر، ۴ MiB) میخواند و op مرکب [rbd.copyup(4 MiB), write(8 KiB, 4 KiB)] را میفرستد. پس نخستین نوشتن ۴ KiB روی هر شیء clone در واقع ۴ MiB خواندن و ۴ MiB نوشتن است. به همین دلیل VMهای تازهی clone در دقایق اول کندترند و rbd du روی clone بهسرعت بالا میرود.
۳۸-۴ exclusive-lock#
exclusive-lock تضمین میکند در هر لحظه فقط یک کلاینت روی image مینویسد، تا object map، journal و cache سازگار بمانند. این قفل همکارانه است: اگر کلاینت دیگری بخواهد بنویسد، از مالک میخواهد قفل را رها کند.
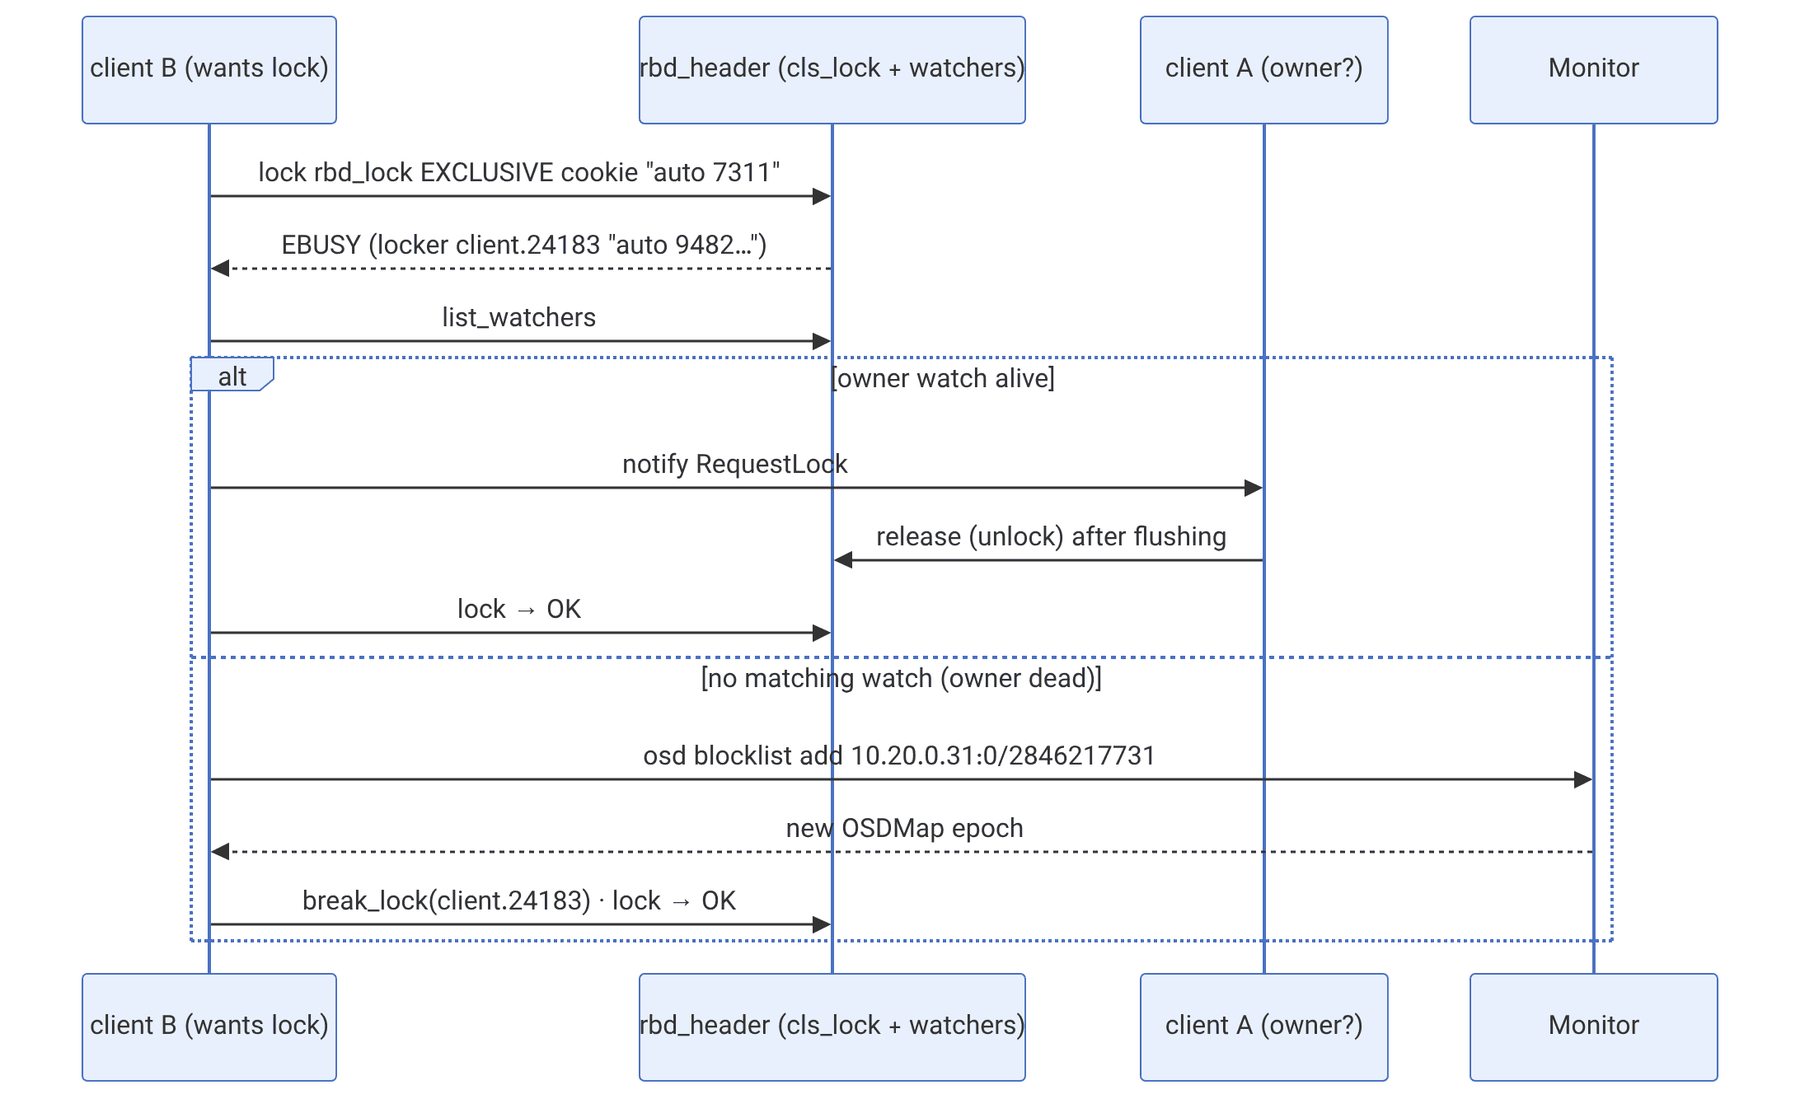
قفل یک قفل cls_lock با نام rbd_lock، نوع exclusive، tag internal و cookie auto <watch handle> روی شیء header است. cookie شامل handle همان watch است، پس دیگران میتوانند با list_watchers بفهمند صاحب قفل هنوز زنده است یا نه.
منبع در کد: src/librbd/ManagedLock.cc؛ src/librbd/managed_lock/AcquireRequest.cc، BreakRequest.cc، Utils.cc :: encode_lock_cookie؛ src/librbd/ExclusiveLock.cc
پیچیدگی: چند رفتوبرگشت RADOS؛ در بدترین حالت بهعلاوهی یک بهروزرسانی OSDMap برای blocklist
pseudocode
acquire():
get_locker(header) # cls_lock get_info
try lock(header, "rbd_lock", EXCLUSIVE, cookie = "auto " + watch_handle, tag = "internal")
if ok: post_acquire (open object map, journal, ...) ; done
if EBUSY:
if locker has a live watch on header (same address and cookie handle):
notify RequestLock to owner ; wait (owner releases if it allows)
retry acquire later
else: # مالک مرده یا جدا شده
if rbd_blocklist_on_break_lock: # پیشفرض true
mon: osd blocklist add <locker addr> expire = rbd_blocklist_expire_seconds (0 → پیشفرض mon)
wait until our OSDMap epoch >= blocklist epoch
break_lock(locker) ; retry lockچرا blocklist؟ مالکی که «مرده» به نظر میرسد ممکن است فقط از شبکه جدا شده و هنوز نوشتنهایی در مسیر داشته باشد. اگر قفل بدون blocklist شکسته شود، آن نوشتنها بعداً روی دادهی مالک جدید فرود میآیند. blocklist در OSDMap تضمین میکند همهی OSDها opهای آن آدرس را رد کنند. این همان مکانیزم fencing در کلاستر است.
# مثال: دیدن قفل و watcherهای یک image
rbd lock ls rbd/vm01
rbd status rbd/vm01
ceph osd blocklist lsمثال (خروجی):
There is 1 exclusive lock on this image.
Locker ID Address
client.24183 auto 94823571521536 10.20.0.31:0/2846217731
Watchers:
watcher=10.20.0.31:0/2846217731 client.24183 cookie=94823571521536
10.20.0.44:0/1739920384 2026-11-15T10:41:07.512038+0330
listed 1 entriescookie قفل (auto 94823571521536) با cookie watcher برابر است، پس مالک زنده است. خط blocklist نشان میدهد کلاینت دیگری (آدرس …۴۴) پیشتر fence شده است.
اگر دو VM یک image را با exclusive-lock باز کنند، هیچ خطایی نمیبینند: قفل مدام میان آنها دستبهدست میشود و هر دو مینویسند (با کارایی بسیار بد). exclusive-lock جلوی دسترسی همزمان را نمیگیرد. برای جلوگیری واقعی، image را با rbd device map -o exclusive (krbd) یا گزینهی RBD_LOCK_MODE_EXCLUSIVE در rbd_lock_acquire باز کنید تا قفل به درخواست دیگران رها نشود.
۳۸-۵ cache#
۳۸-۵-۱ writearound (پیشفرض)#
در شاخهی main rbd_cache = true و rbd_cache_policy = writearound است. این cache داده را نگه نمیدارد؛ فقط نوشتن را پیش از رسیدن به OSD تأیید میکند تا تأخیر از دید برنامه کم شود.
منبع در کد: src/librbd/cache/WriteAroundObjectDispatch.cc :: dispatch_io، block_overlapping_io، flush
پیچیدگی: O(log n) برای بررسی همپوشانی در extentهای در جریان
pseudocode
write(object, extent):
    if max_dirty == 0 or FUA flag: pass through (writethrough)
    if extent overlaps an in-flight write on same object: block until it completes
    elif in_flight_bytes + len <= rbd_cache_max_dirty:
        complete to caller NOW ; send to RADOS in background
    else: queue until in-flight bytes drop
flush(): wait for all in-flight writes ; then complete
read: not cached → straight to RADOS
rbd_cache_writethrough_until_flush: until the guest sends its first flush, behave as writethroughrbd_cache_writethrough_until_flush = true از سیستمعاملهای قدیمی که flush نمیفرستند محافظت میکند: تا نخستین flush دیده نشود، همهی نوشتنها همگاماند.
۳۸-۵-۲ writeback و writethrough (ObjectCacher)#
با rbd_cache_policy = writeback لایهی CACHE همان ObjectCacher قدیمی است: دادهی خواندهشده و نوشتهشده را تا rbd_cache_size (پیشفرض ۳۲ MiB) نگه میدارد و dirty را تا rbd_cache_max_dirty (۲۴ MiB) جمع میکند. این cache فرّار است و فقط با flush مهمان پایدار میشود.
۳۸-۵-۳ cache پایدار (PWL)#
rbd_persistent_cache_mode (پیشفرض disabled) با مقدار ssd یا rwl یک log پایدار روی SSD محلی یا PMEM میسازد. نوشتن پس از ثبت در log محلی تأیید میشود و بعداً به RADOS میرود. بیت dirty-cache در features نشان میدهد image دادهی ننوشته در یک میزبان دارد؛ باز کردن آن در میزبان دیگر تا flush شدن cache مجاز نیست. این cache تأخیر نوشتن را بسیار کم میکند، ولی میزبان را به نقطهی شکست داده تبدیل میکند.
۳۸-۶ QoS#
لایهی QOS برای هر نوع محدودیت (iops، bps، read_iops، write_iops، read_bps، write_bps) یک TokenBucketThrottle دارد. تایمر هر rbd_qos_schedule_tick_min میلیثانیه (پیشفرض ۵۰) توکن اضافه میکند.
منبع در کد: src/common/Throttle.cc :: TokenBucketThrottle::add_tokens، get؛ src/librbd/io/QosImageDispatch.cc
پیچیدگی: O(b) برای b درخواست منتظر در هر tick
pseudocode
every tick (>= rbd_qos_schedule_tick_min ms):
    bucket.put(avg * tick / 1000, burst_ratio = max(burst, avg) / avg)   # سقف سطل = burst × burst_seconds
    while blockers not empty:
        b = front ; got = bucket.get(b.tokens)
        if got == b.tokens: release b
        else: b.tokens -= got ; break
request(tokens = 1 for iops, bytes for bps):
    if bucket has tokens: proceed ; else enqueue as blocker
مثال عددی. rbd_qos_iops_limit = 500 و burst خاموش. در هر tick ۵۰ ms، ۲۵ توکن اضافه میشود. VM با عمق صف ۳۲ درخواست ۴K میفرستد؛ ۲۵ درخواست در هر tick آزاد و بقیه منتظر میمانند، پس تأخیر میانگین از دید VM حدود ۳۲/۵۰۰ = ۶۴ ms است. QoS در librbd برای هر image و هر کلاینت جداست. دو کلاینتی که یک image را باز کنند هر کدام ۵۰۰ IOPS میگیرند و هیچ هماهنگی سراسری وجود ندارد. برای سقف سطح کلاستر باید از mClock در OSD (فصل ۲۱) کمک گرفت.
۳۸-۷ krbd، librbd و rbd-nbd#
| krbd | librbd (QEMU) | rbd-nbd | |
|---|---|---|---|
| محل اجرا | هسته | فرایند QEMU | فرایند rbd-nbd + nbd هسته |
| journaling و mirroring حالت journal | خیر | بله | بله |
| object-map و fast-diff | از هستهی ۵.۳ | بله | بله |
| cache librbd و PWL | خیر (page cache هسته) | بله | بله |
| QoS در librbd | خیر | بله | بله |
| رمزنگاری LUKS librbd | خیر (dm-crypt جدا) | بله | بله |
| کپیهای اضافهی داده | کمترین | کم | بیشتر (هسته ↔ فضای کاربر) |
| ارتقا | با هسته | با بستهی Ceph | با بستهی Ceph |
پشتیبانی ویژگیها در krbd به نسخهی هسته وابسته است (striping سفارشی از ۴.۱۷، deep-flatten از ۵.۱، object-map و fast-diff از ۵.۳، طبق مستند rbd(۸)). اگر image ویژگی ناشناختهای برای هسته داشته باشد، rbd device map با «image uses unsupported features» شکست میخورد و باید آن ویژگی را خاموش کرد یا rbd-nbd را به کار برد.
۳۸-۸ تنظیم و عیبیابی#
- کندی شدید با دو کلاینت:
rbd status را ببینید؛ اگر دو watcher دارد و قفل مدام جابهجا میشود (در لاگ librbd پیامهای request lock)، یکی از کلاینتها نباید image را باز کرده باشد. - VM پس از failover میزبان «read-only» میشود: میزبان قبلی blocklist شده و نوشتنهای آن رد میشوند. این رفتار درست است؛ پس از بازگشت، فرایند QEMU قدیمی را متوقف کنید و
ceph osd blocklist rm فقط پس از اطمینان از توقف آن. - کندی clone تازه: هزینهی copyup است.
rbd flatten را در زمان خلوت اجرا کنید یا parent cache (rbd_parent_cache_enabled با ceph-immutable-object-cache) را برای خواندنها روشن کنید. -
rbd_op_threads: پیشفرض ۱ است. برای یک فرایند با تعداد زیادی image یا IOPS بسیار بالا، افزایش آن تا ۲ یا ۴ میتواند کمک کند، ولی ترتیب callbackها را تضمین نمیکند. - مهلت درخواست:
rbd_request_timed_out_seconds (۳۰) فقط برای پیامهای notify میان کلاینتهاست، نه برای I/O.
۳۸-۹ تکمیلی و بهروز#
- در نسخههای قدیمیتر پیشفرض
rbd_cache_policy همان writeback بود. هنگام ارتقای clusterهای قدیمی، تنظیمات صریح در ceph.conf میزبانهای QEMU را بررسی کنید. - لایهی
SCHEDULER (rbd_io_scheduler = simple) نوشتنهای کوچک پشتسرهم روی یک شیء را ادغام میکند. اثر آن روی بارهای ترتیبی کوچک مثبت و روی بارهای تصادفی ناچیز است. -
rbd_read_from_replica_policy با مقدار balance یا localize خواندن را به replicaها هم میفرستد؛ این کار فقط روی clusterهایی با require_osd_release جدید و برای imageهایی که نوشتن همزمان ندارند ایمن است.
۳۸-۱۰ تمرین عملی#
- ۱. با
debug_rbd=20 یک نوشتن ۴K بفرستید و نام لایههایی را که در لاگ دیده میشوند به ترتیب یادداشت کنید. - ۲. یک clone بسازید، روی یک شیء خالی آن ۴ KiB بنویسید و با
rados stat اندازهی شیء clone را ببینید. سپس rbd du را پیش و پس مقایسه کنید. - ۳. image را در دو فرایند
rbd bench همزمان باز کنید و IOPS هر کدام را با حالت تکفرایندی مقایسه کنید. - ۴.
rbd config image set rbd/vm01 rbd_qos_iops_limit 500 را تنظیم و با rbd bench --io-threads 32 تأخیر را اندازه بگیرید. با محاسبهی مثال فصل مقایسه کنید.
۳۸-۱۱ پرسشهای مرور#
- ۱. لایهی EXCLUSIVE_LOCK پیش از کدام لایهها اجرا میشود و چرا؟
- ۲. چه زمانی copyup بدون فرستادن نخستین نوشتن انجام میشود؟
- ۳. چرا متد cls
copyup اگر شیء وجود داشته باشد کاری نمیکند؟ - ۴. deep-flatten چه چیزی را اضافه میکند؟
- ۵. cookie قفل
rbd_lock چه ساختاری دارد و به چه کاری میآید؟ - ۶. چرا شکستن قفل بدون blocklist خطرناک است؟
- ۷. writearound چه زمانی نوشتن را بلافاصله تأیید نمیکند؟
- ۸.
rbd_cache_writethrough_until_flush از چه چیزی محافظت میکند؟ - ۹. با
rbd_qos_iops_limit = 1000 و tick ۵۰ ms، در هر tick چند توکن اضافه میشود؟ - ۱۰. دو دلیل برای استفاده از rbd-nbd بهجای krbd نام ببرید.
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۸-۱۲ منابع این فصل#
- librbd/io (Types.h، ImageDispatcher، ObjectRequest، CopyupRequest
https://github.com/ceph/ceph/tree/main/src/librbd/io - librbd/managed_lock و ExclusiveLock.cc
https://github.com/ceph/ceph/tree/main/src/librbd/managed_lock - WriteAroundObjectDispatch.cc
https://github.com/ceph/ceph/blob/main/src/librbd/cache/WriteAroundObjectDispatch.cc - Throttle.cc (TokenBucketThrottle
https://github.com/ceph/ceph/blob/main/src/common/Throttle.cc - گزینههای RBD
https://docs.ceph.com/en/latest/rbd/rbd-config-ref/ - cache پایدار
https://docs.ceph.com/en/latest/rbd/rbd-persistent-write-log-cache/ - مستند exclusive lock
https://docs.ceph.com/en/latest/rbd/rbd-exclusive-locks/ - rbd(۸) و ویژگیهای krbd
https://docs.ceph.com/en/latest/man/8/rbd/