لایههای پایینی (۱۱): حافظه و CPU درون OSD، از mempool تا NUMA و پروفایلگیری
حوصله ندارم این فصل در چند خط
- بیشتر شکایتهای کارایی OSD به حافظه (کشته شدن با OOM) یا اشباع یک thread یا shard برمیگردد.
- opهای هر PG به shard شمارهی
ps % num_shards میروند، پس یک PG داغ میتواند یک shard را اشباع کند و بقیه بیکار بمانند. - mempoolها بدون قفل، بایتها و آیتمهای هر زیرسیستم را میشمارند؛ tcmalloc ممکن است حافظهی آزادشده را نگه دارد، پس RSS با جمع mempoolها فرق دارد.
- PriorityCache مقدار
osd_memory_target را میان cacheهای onode، داده و RocksDB تقسیم میکند؛ NUMA affinity و profiling (perf و flame graph) نقاط داغ CPU را پیدا میکنند.
۳۳-۱ چرا حافظه و CPU؟#
بیشتر شکایتهای کارایی از یک OSD در نهایت به یکی از این دو بازمیگردد: یا OSD بیش از سهم خود حافظه مصرف میکند (و OOM killer آن را میکشد)، یا یک thread یا یک shard اشباع شده است در حالی که بقیه بیکارند. این فصل سازوکارهای درونی هر دو را تابع به تابع بررسی میکند: mempool برای حسابداری حافظه، tcmalloc بهعنوان تخصیصدهنده، PriorityCache برای تقسیم بودجهی حافظه میان cacheها، threadهای OSD و توزیع کار میان آنها، NUMA، و ابزارهای اندازهگیری (perf، bpftrace و uftrace). همهی ارجاعها به main است.
۳۳-۲ threadهای یک OSD کلاسیک#
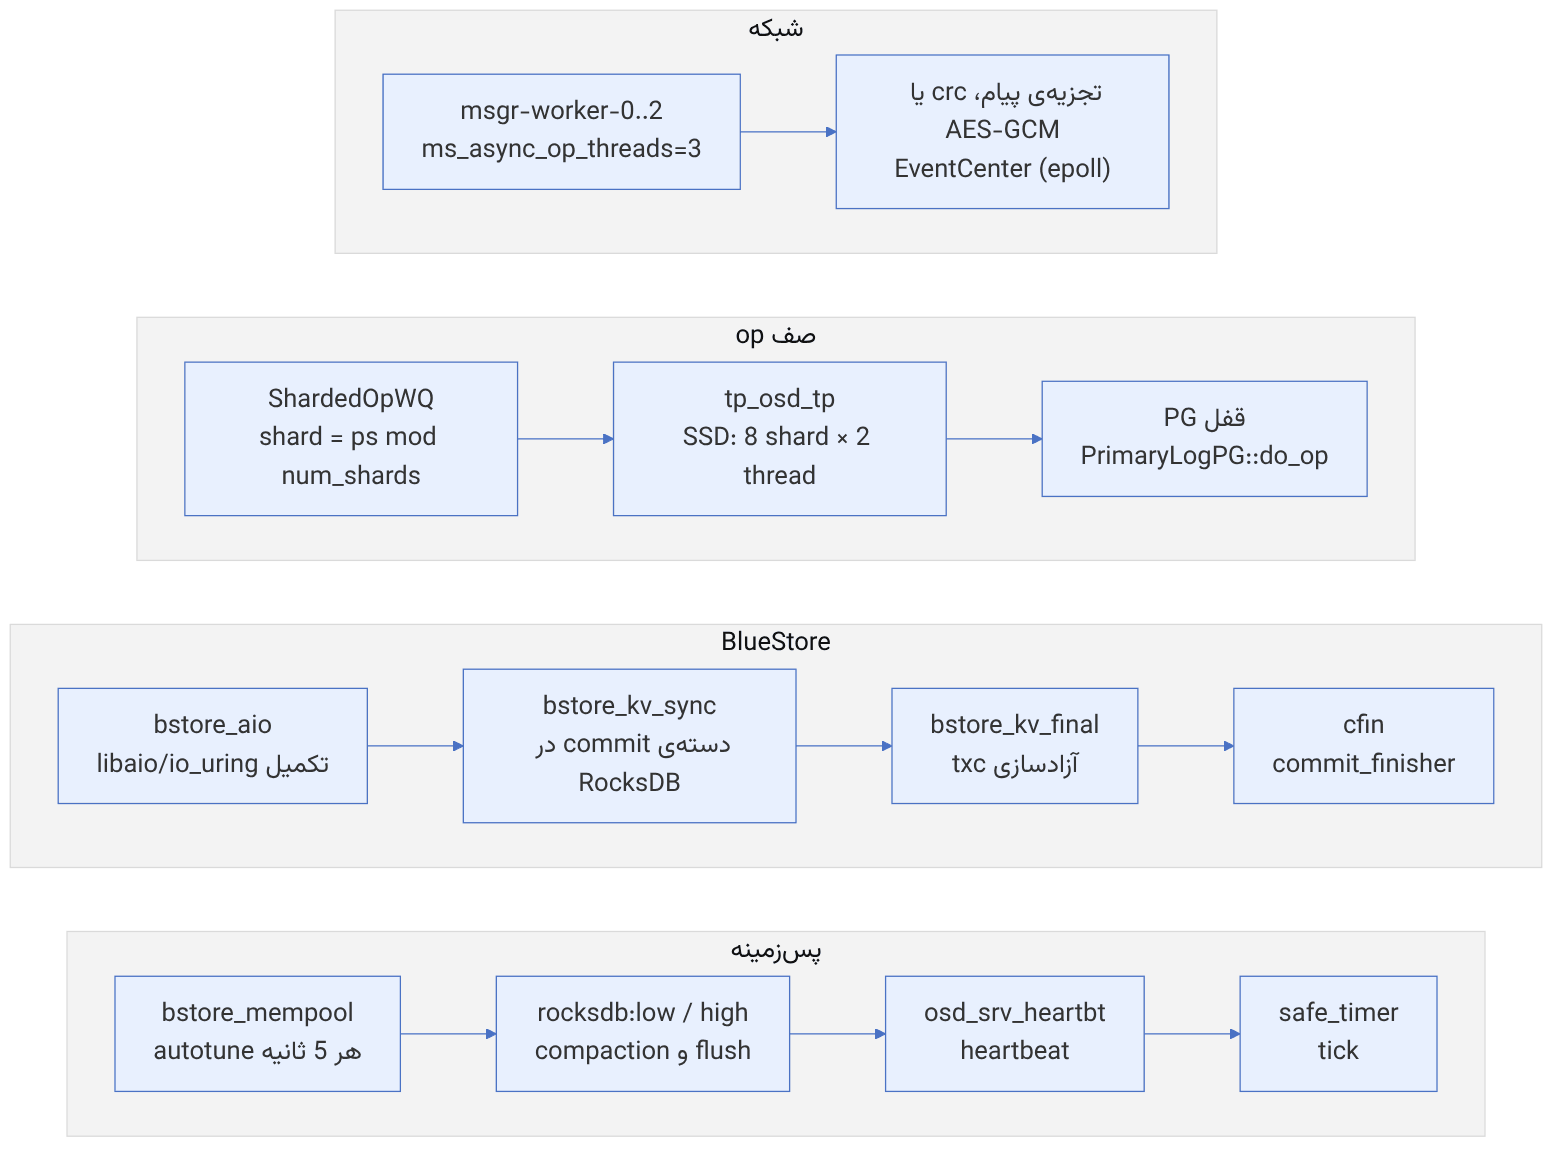
| نام thread | سازنده در کد | تعداد پیشفرض | نکته |
|---|---|---|---|
| msgr-worker-N | msg/async/Stack.h | ms_async_op_threads=3 | برای هر messenger (public و cluster) جدا |
| tp_osd_tp | OSD.cc: osd_op_tp | shards × threads_per_shard: SSD 8×۲=۱۶، HDD 1×۵=۵ (از v19.2.1) | timeout 15 ثانیه و suicide 150 ثانیه |
| bstore_aio | blk/kernel/KernelDevice.cc | یکی برای هر دستگاه | در مسیر SPDK نیست (فصل ۳۱) |
| bstore_kv_sync | BlueStore.cc | ۱ | گلوگاه رایج در نوشتنهای کوچک |
| bstore_kv_final | BlueStore.cc | ۱ | اجرای on_commit |
| cfin | BlueStore.cc: commit_finisher | ۱ | finisher مربوط به commit |
| bstore_mempool | BlueStore.h: MempoolThread | ۱ | tune_memory هر ۱ ثانیه، balance هر ۵ ثانیه |
| osd_srv_heartbt | OSD.cc | ۱ | heartbeat هر osd_heartbeat_interval=6 ثانیه |
| safe_timer | common/Timer.cc | چند عدد | tickهای OSD و mgr client |
۳۳-۲-۱ توزیع op میان shardها#
OSD::enqueue_op برای هر op شاخص shard را با pgid.hash_to_shard(num_shards) محاسبه میکند. این تابع در osd_types.h بهسادگی ps() % num_shards است. همهی opهای یک PG همیشه در یک shard صف میشوند و ترتیب آنها حفظ میشود. اما توزیع بار میان shardها به پراکندگی ps مربوط به PGهای همان OSD بستگی دارد.
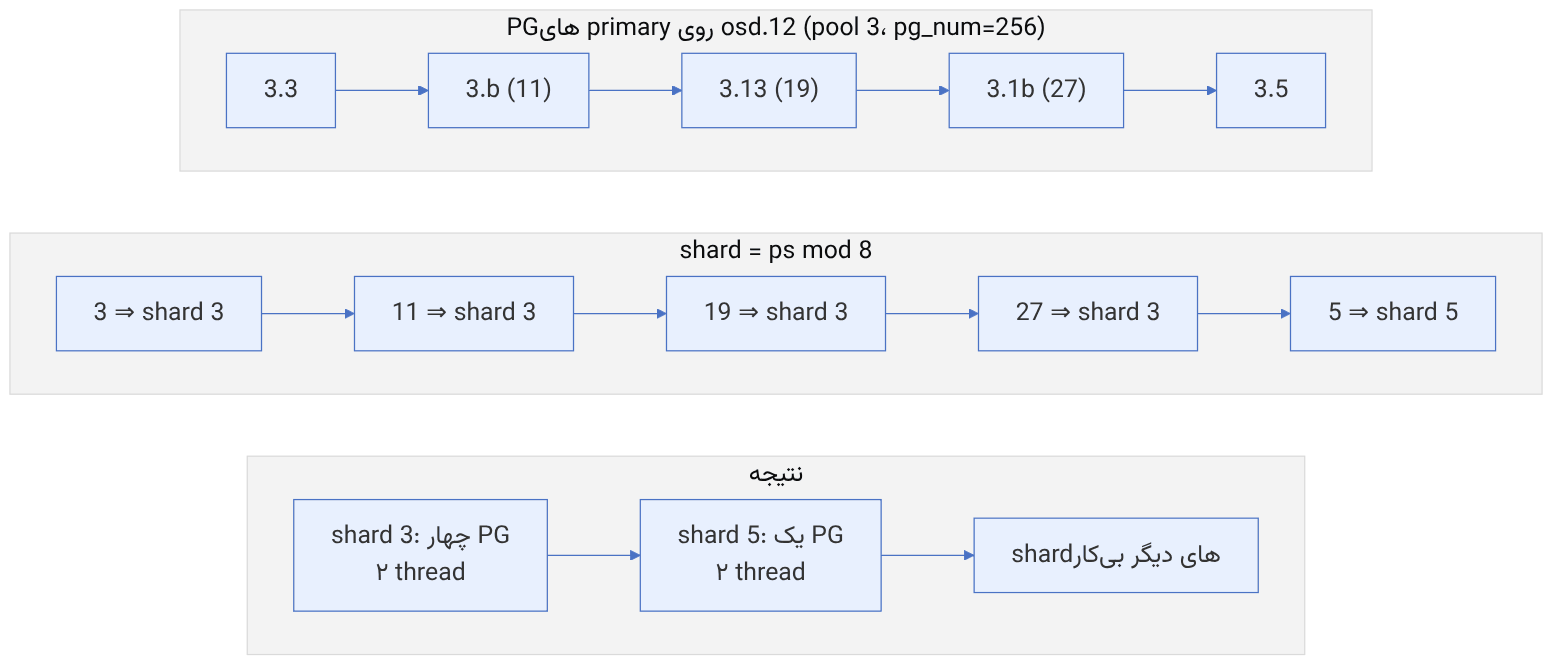
منبع در کد: src/osd/osd_types.h :: spg_t::hash_to_shard و src/osd/OSD.cc :: OSD::enqueue_op
پیچیدگی: O(۱)
shard_index = pg.ps mod num_shards # num_shards = osd_op_num_shards_ssd (8)
sdata = shards[shard_index]
sdata.shard_lock: enqueue(op) با زمانبند mClock یا WPQ
thread t از آن shard: dequeue ⇒ قفل PG ⇒ do_op
فقط thread با thread_index < num_shards صف context (oncommit) را هم خالی میکندمثال عددی. یک OSD در خوشهای با ۱۰۰ OSD و pool با pg_num=256 و size=3 حدود ۲۵۶×۳/۱۰۰ ≈ ۷.۷ PG دارد که حدود ۲.۶ تای آنها primary است. با ۸ shard، احتمال اینکه دو PG primary به یک shard بیفتند بالاست (مسئلهی روز تولد: برای سه PG در ۸ خانه، ). وقتی یک PG بخش عمدهی بار را دارد (مثلاً یک تصویر RBD پرکار)، حداکثر دو thread روی آن کار میکنند، چون قفل PG اجرای موازی opهای یک PG را محدود میکند. به همین دلیل، افزایش osd_op_num_threads_per_shard برای یک PG داغ کمکی نمیکند. افزایش pg_num (و در نتیجه تقسیم دادهی داغ) راهحل واقعی است.
وابسته به نسخه. پیشفرض HDD در v19.2.0 پنج shard با یک thread بود و از v19.2.1 یک shard با پنج thread است (فصل ۲۱). گزینههای shard فقط هنگام راهاندازی OSD خوانده میشوند و تغییر آنها راهاندازی دوباره میخواهد.
۳۳-۳ mempool: حسابداری بدون قفل#
هر ساختار دادهی مهم در Ceph با یک allocator مخصوص mempool ساخته میشود (مثلاً mempool::bluestore_cache_onode::map). این allocator هنگام تخصیص و آزادسازی، شمارندههای items و bytes آن pool را بهروز میکند. چالش این است که این بهروزرسانی در مسیر داغ و از دهها thread همزمان رخ میدهد. یک شمارندهی atomic مشترک، cache line را میان هستهها پاس میدهد و صدها نانوثانیه هزینه دارد.
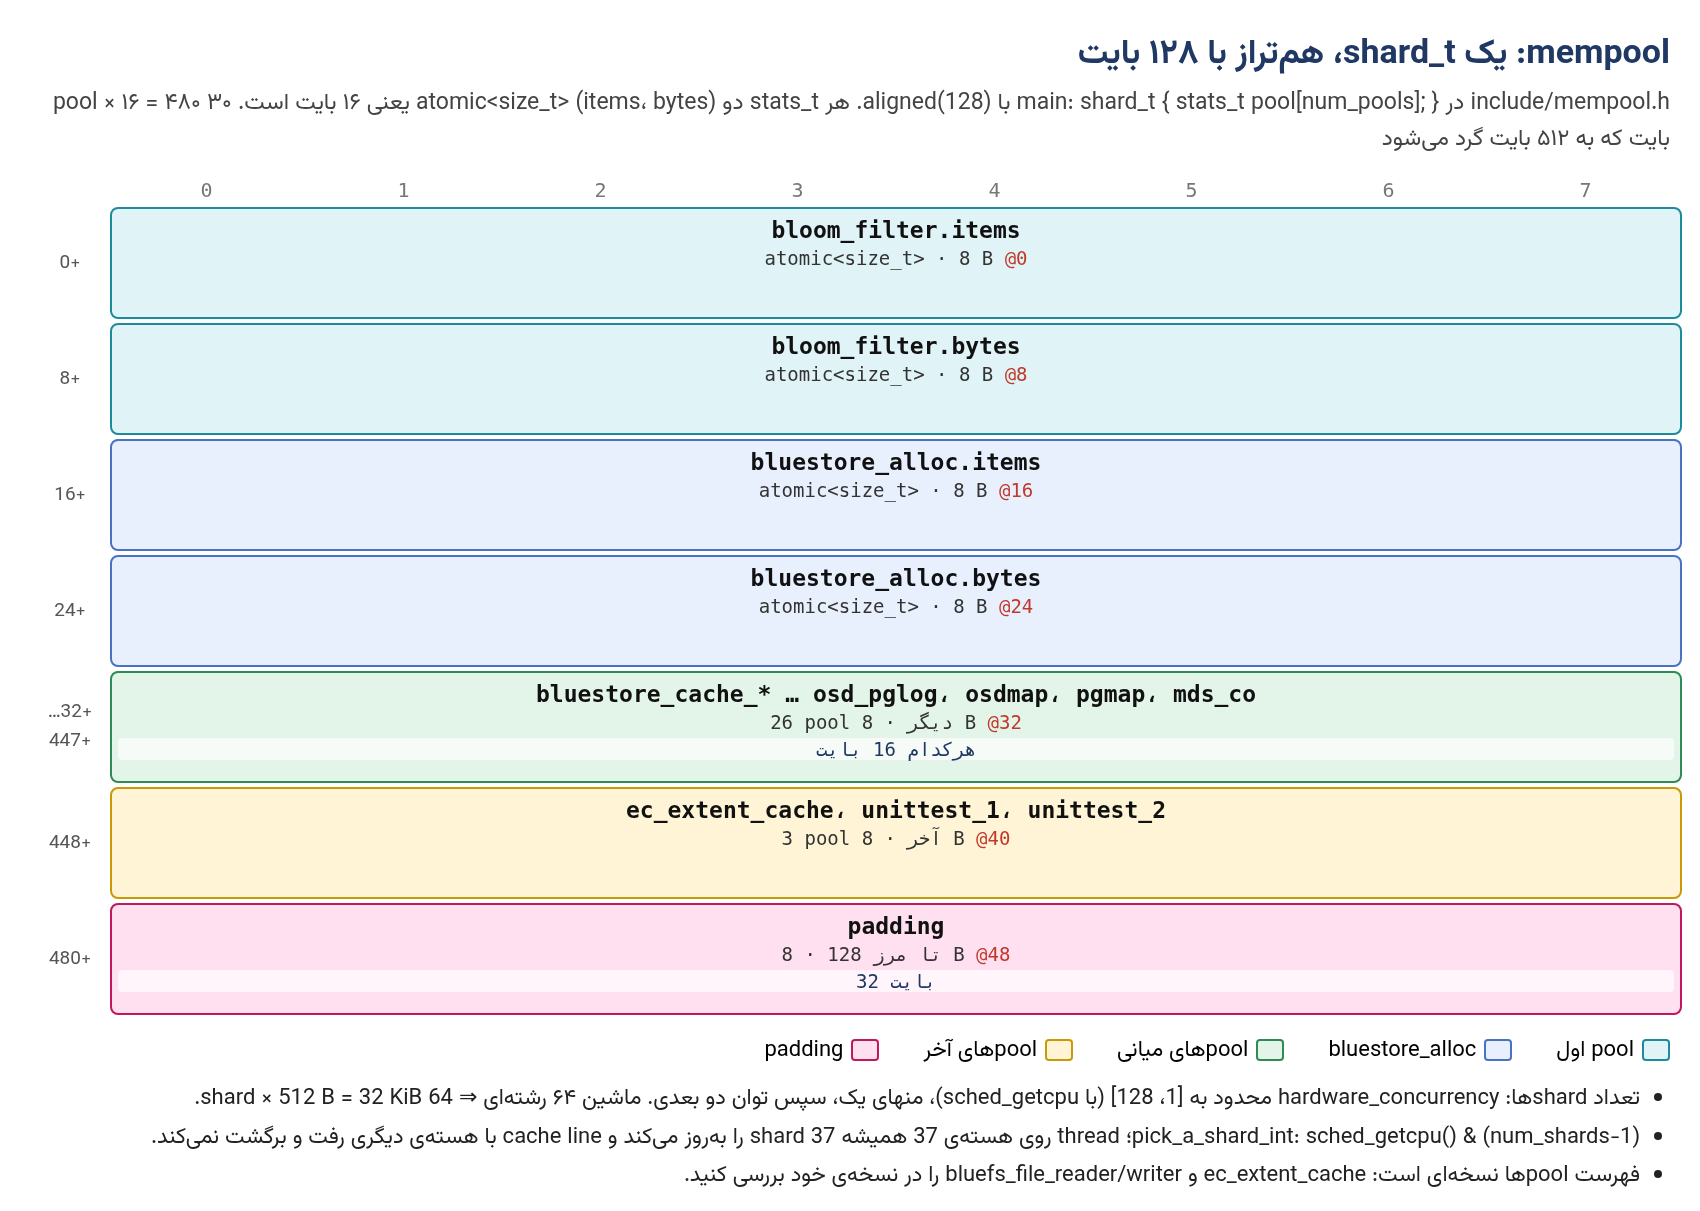
منبع در کد: src/common/mempool.cc :: get_num_shards، pick_a_shard_int؛ include/mempool.h :: pool_allocator::allocate
پیچیدگی: بهروزرسانی O(۱) بدون رقابت؛ خواندن کل O(num_shards)
init: threads = clamp(hardware_concurrency, MIN_SHARDS, 128) − 1
bits = تعداد بیتهای threads ; num_shards = 1 << bits
allocate(n, T):
shid = sched_getcpu() & (num_shards − 1) # یا round-robin ثابت برای هر thread
shards[shid].pool[ix].bytes += n × sizeof(T) # atomic اما محلی برای هسته
shards[shid].pool[ix].items += n
allocated_bytes(pool) = Σ over shards of bytes # فقط هنگام dumpمثال عددی. ماشین با ۴۸ رشتهی سختافزاری: threads = ۴۸ − ۱ = ۴۷ = ۰b101111 (۶ بیت)، پس num_shards = ۶۴. هر shard_t با ۳۰ pool در main 480 بایت است که به ۵۱۲ گرد میشود. کل ۶۴ × ۵۱۲ = ۳۲ KiB. thread روی هستهی ۳۷ همیشه shard 37 را بهروز میکند. تنها رقابت ممکن وقتی است که thread میان sched_getcpu() و بهروزرسانی جابهجا شود، که نادر است. dump کامل ۶۴ × ۳۰ جمع است، که در مقایسه با یک بار در ثانیه هیچ هزینهای ندارد.
ceph tell osd.N dump_mempools فقط حافظهای را نشان میدهد که از allocatorهای mempool گذشته است. حافظهی RocksDB (بهجز block cache که PriorityCache آن را مدیریت میکند)، memtableها، پشتهی threadها و تکهتکه شدن tcmalloc در آن نیستند. اختلاف میان RSS و جمع mempoolها چند صد مگابایت تا بیش از یک گیگابایت طبیعی است. osd_memory_base=768M دقیقاً برای همین بخش «حسابنشده» در نظر گرفته شده است.
۳۳-۴ tcmalloc و حافظهی «نگاشتهشده»#
ceph-osd بهطور پیشفرض با tcmalloc (از gperftools) لینک میشود. tcmalloc حافظه را در سه سطح نگه میدارد: cache هر thread، فهرستهای آزاد مرکزی برای هر کلاس اندازه، و page heap که spanها را از سیستمعامل میگیرد. حافظهی آزادشده لزوماً به سیستمعامل برنمیگردد. فقط وقتی span کاملاً آزاد باشد و ReleaseFreeMemory یا آزادسازی تدریجی آن را با madvise برگرداند، در pageheap_unmapped_bytes حساب میشود.
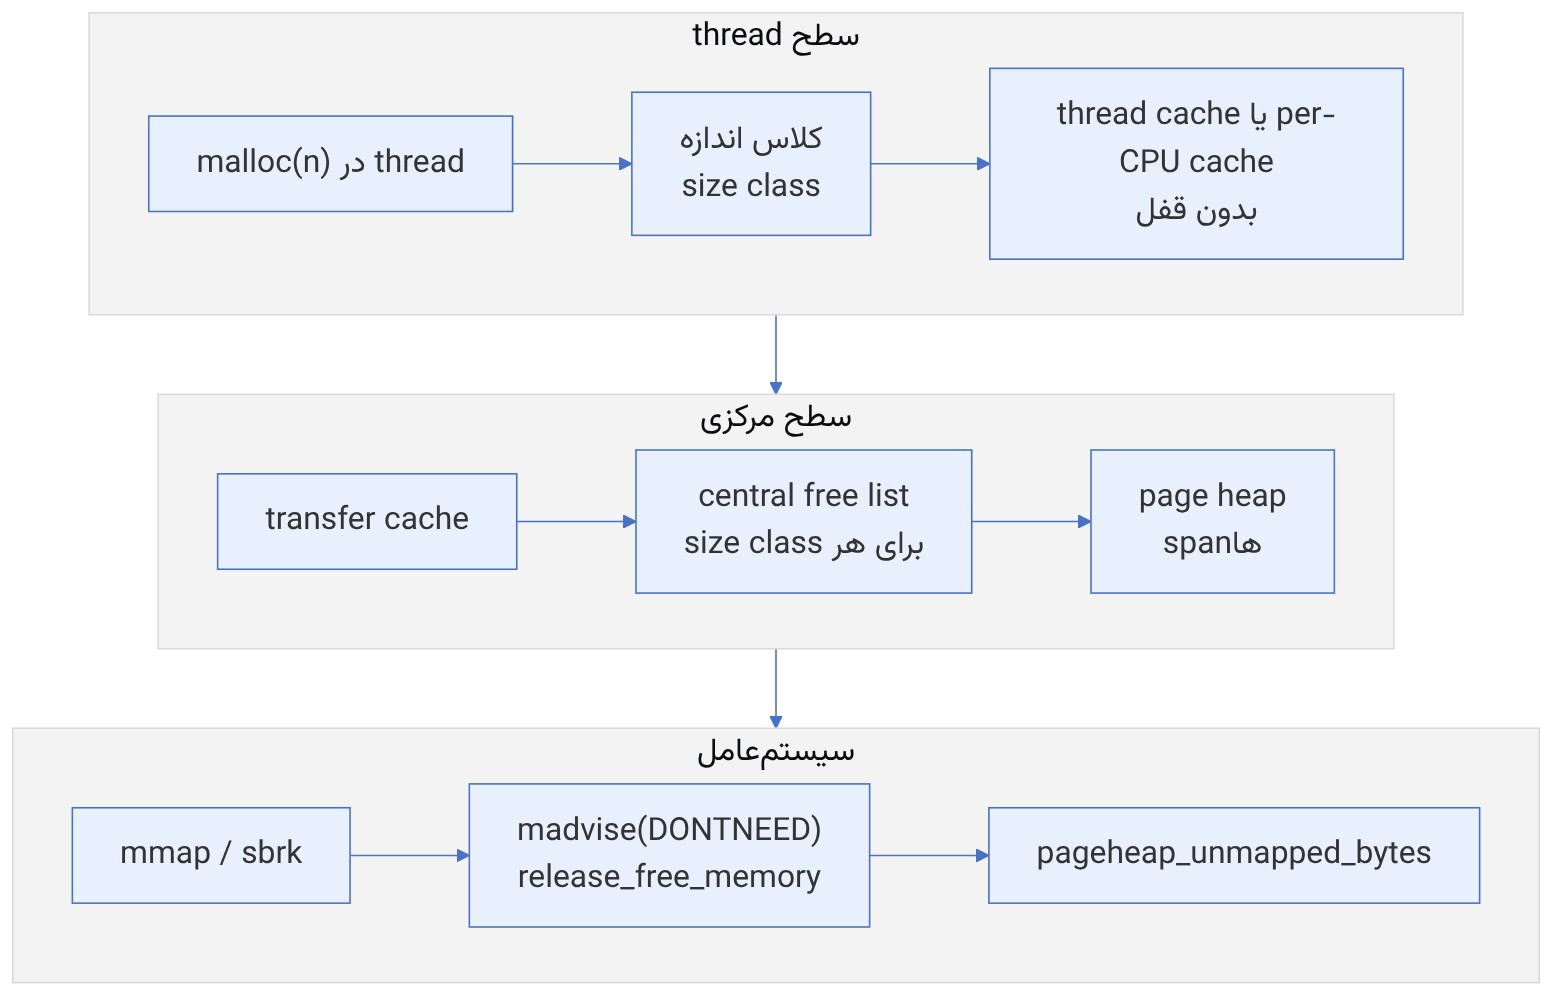
فایل محیطی بستهها (etc/sysconfig/ceph در مخزن) مقدار TCMALLOC_MAX_TOTAL_THREAD_CACHE_BYTES=134217728 (۱۲۸ MiB) را میگذارد. این سقف کل cacheهای thread در فرایند است. اگر کمتر باشد، threadهای op بیشتر به central free list (با قفل) مراجعه میکنند. اگر بیشتر باشد، حافظهی «پنهان» در cacheهای thread بیشتر میشود. استقرار cephadm متغیرهای محیطی کانتینر را جدا تنظیم میکند. مقدار واقعی را با ceph tell osd.N heap stats بخوانید.
۳۳-۵ PriorityCache: تقسیم بودجهی حافظه#
۳۳-۵-۱ از osd_memory_target به بودجهی cache#
BlueStore::MempoolThread::_update_cache_settings و _resize_shards سه عدد را برای PriorityCache::Manager (با نام «bluestore-pricache») تعیین میکنند:
target  = osd_memory_target                         (4 GiB)
ltarget = (1 − osd_memory_expected_fragmentation) × target = 0.85 × 4096 = 3481.6 MiB
max     = ltarget − osd_memory_base = 3481.6 − 768 = 2713.6 MiB    (اگر ltarget > base + min)
min = osd_memory_cache_min = 128 MiBمنبع در کد: src/common/PriorityCache.cc :: PriorityCache::Manager::tune_memory
پیچیدگی: O(۱) در هر دور (هر osd_memory_cache_resize_interval = ۱ ثانیه)
mapped = heap_size − pageheap_unmapped_bytes        # از tcmalloc
new = clamp(tuned_mem, min, max)
if mapped < target:  new += (1 − mapped/target) × (max − new)      # آرام به max نزدیک شو
else:                new −= (1 − target/mapped) × (new − min)      # سریع عقب بکش
tuned_mem = new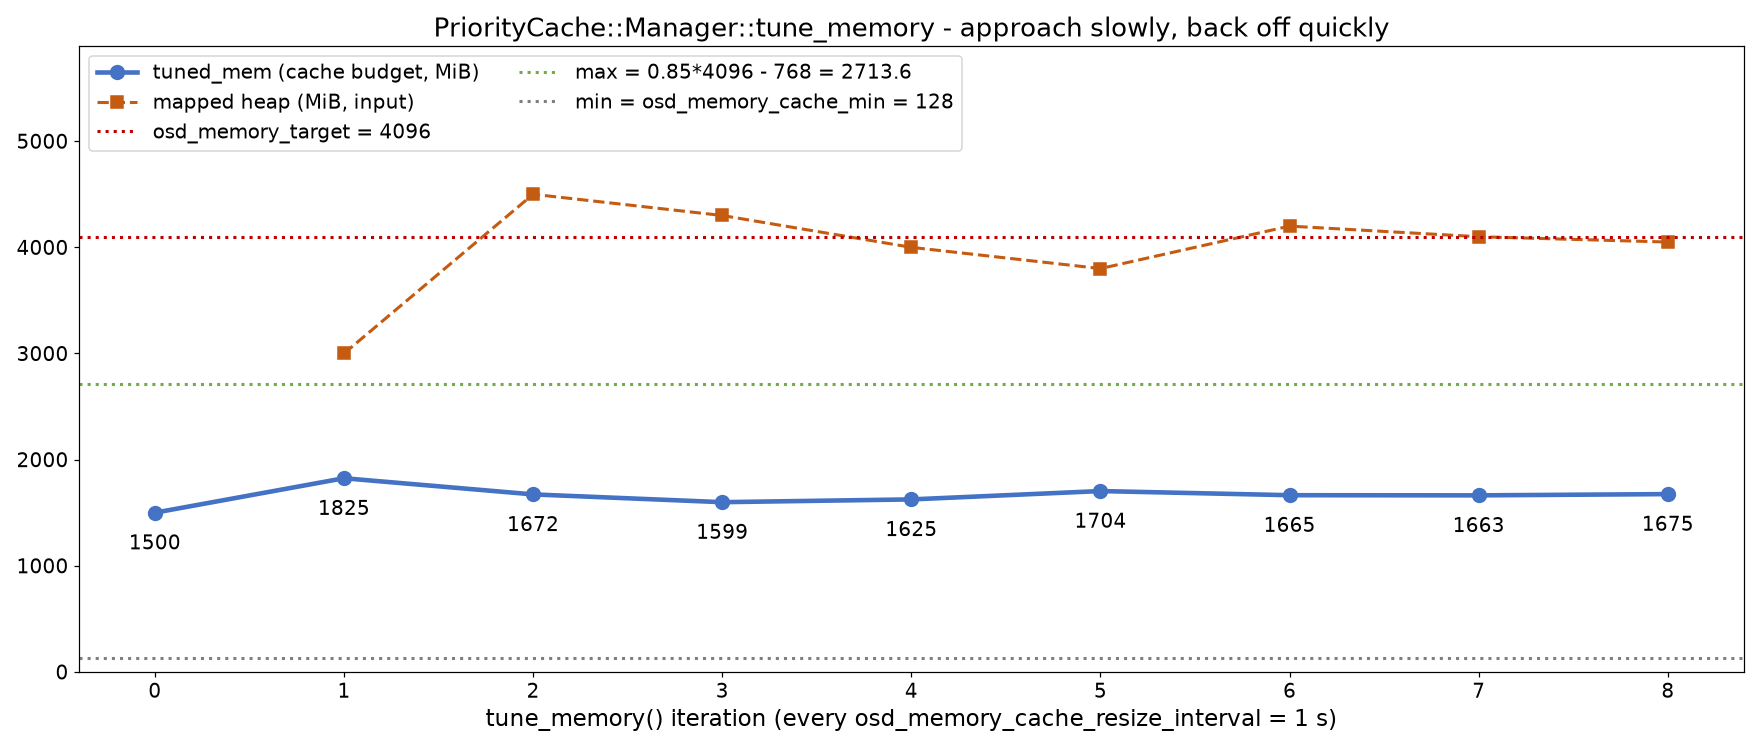
مثال عددی (دو دور اول شکل). tuned_mem=1500 و mapped=3000: نسبت = ۱ − ۳۰۰۰/۴۰۹۶ = ۰.۲۶۷۶، پس new = ۱۵۰۰ + ۰.۲۶۷۶ × (۲۷۱۳.۶ − ۱۵۰۰) = ۱۸۲۴.۷ MiB. دور بعد mapped=4500: نسبت = ۱ − ۴۰۹۶/۴۵۰۰ = ۰.۰۸۹۸، پس new = ۱۸۲۴.۷ − ۰.۰۸۹۸ × (۱۸۲۴.۷ − ۱۲۸) = ۱۶۷۲.۴ MiB. عبارت «approach slowly, bounce away quickly» در خود کد آمده است. وقتی فاصلهی mapped تا target زیاد است، ضریب افزایش بزرگ است، اما هرچه نزدیکتر شود کوچکتر میشود. کاهش متناسب با فاصله تا min است، پس در بودجههای بزرگ کاهش مطلق بیشتر است.
چرا OSD گاهی از osd_memory_target بیشتر میخورد. این حلقهی بازخورد فقط اندازهی cacheها را کم میکند. اگر حافظهی حسابنشده (pg log در هنگام recovery، بافرهای messenger زیر فشار، osdmapهای زیاد) خودش از target بیشتر شود، حتی با cache در حداقل ۱۲۸ MiB، OSD از هدف عبور میکند. osd_memory_target سقف سخت نیست. در کانتینر، osd_memory_target_cgroup_limit_ratio=0.8 پیشفرض target را ۸۰٪ محدودیت cgroup میگذارد تا این حاشیه حفظ شود.
۳۳-۵-۲ balance: تقسیم میان cacheها و اولویتها#
BlueStore چهار cache در Manager ثبت میکند: kv (block cache مربوط به RocksDB)، kv_onode، meta (onodeها) و data (بافرها). نسبتها از bluestore_cache_kv_ratio=0.45، bluestore_cache_meta_ratio=0.45 و bluestore_cache_kv_onode_ratio=0.04 میآیند و data باقیمانده (حدود ۰.۰۶) را میگیرد. هر cache دادههایش را بر پایهی سن در bin قرار میدهد. اولویتهای PRI1 تا PRI10 به بازههای سنی نگاشته میشوند (تازهتر = اولویت بالاتر). PRI0 مخصوص indexها و filterهای RocksDB است.
منبع در کد: src/common/PriorityCache.cc :: Manager::balance و balance_priority؛ BlueStore.h :: MempoolCache::request_cache_bytes
پیچیدگی: O(L × R × C) برای L اولویت، R دور و C cache
mem_avail = tuned_mem − C × get_chunk(1, tuned_mem) # ذخیرهی یک chunk برای هر cache
for pri in PRI0..PRI11:
pending = all caches; ratios = Σ ratio
while pending and mem_avail > |pending|:
for c in pending:
want = c.request_cache_bytes(pri) # آنچه در binهای این اولویت دارد − اختصاصیافته
share = mem_avail × c.ratio / ratios
if want > share: c.add(pri, share) # میماند برای دور بعد
else: c.add(pri, want); pending.remove(c)
mem_avail −= assigned; ratios = Σ ratio of remaining
PRI11 (LAST): باقیمانده فقط بر پایهی نسبتها تقسیم میشود
commit: هر cache به مضرب get_chunk گرد میشود (usage + 64 MiB، با chunk میان 4 و 64 MiB)مثال عددی. tuned_mem=1672 MiB. get_chunk: 1672 به توان دو بعدی یعنی ۲۰۴۸ MiB گرد میشود و تقسیم بر ۲۵۶ میدهد ۸ MiB (میان ۴ و ۶۴). get_chunk(۱) برابر ۱ بایت + ۶۴ MiB است که به مضرب ۸ MiB یعنی ۷۲ MiB گرد میشود. چهار cache × ۷۲ = ۲۸۸ MiB ذخیره، پس mem_avail = ۱۳۸۴ MiB.
- PRI0: فقط kv میخواهد (فرض: ۲۰۰ MiB index و filter). سهم آن ۰.۴۵ × ۱۳۸۴ = ۶۲۲.۸ است و همهی ۲۰۰ را میگیرد. mem_avail = ۱۱۸۴.
- PRI1، دور ۱ (فرض خواستهها: kv 300، meta 900، data 100، kv_onode 50): سهمها ۵۳۲.۸، ۵۳۲.۸، ۷۱.۰ و ۴۷.۴ MiB. kv خواستهاش (۳۰۰) را کامل میگیرد و خارج میشود. بقیه سهم کامل میگیرند و میمانند. جمع اختصاص ۹۵۱.۲، پس mem_avail = ۲۳۲.۸ و نسبتهای باقیمانده ۰.۵۵.
- PRI1، دور ۲: meta 0.45/0.55 × ۲۳۲.۸ = ۱۹۰.۵ (هنوز ۳۶۷.۲ میخواهد)، data 25.4 (هنوز ۲۹ میخواهد) و kv_onode فقط ۲.۶ باقیماندهاش را میگیرد. پس از چند دور دیگر، mem_avail به کمتر از تعداد cacheها میرسد و اولویتهای پایینتر چیزی نمیگیرند.
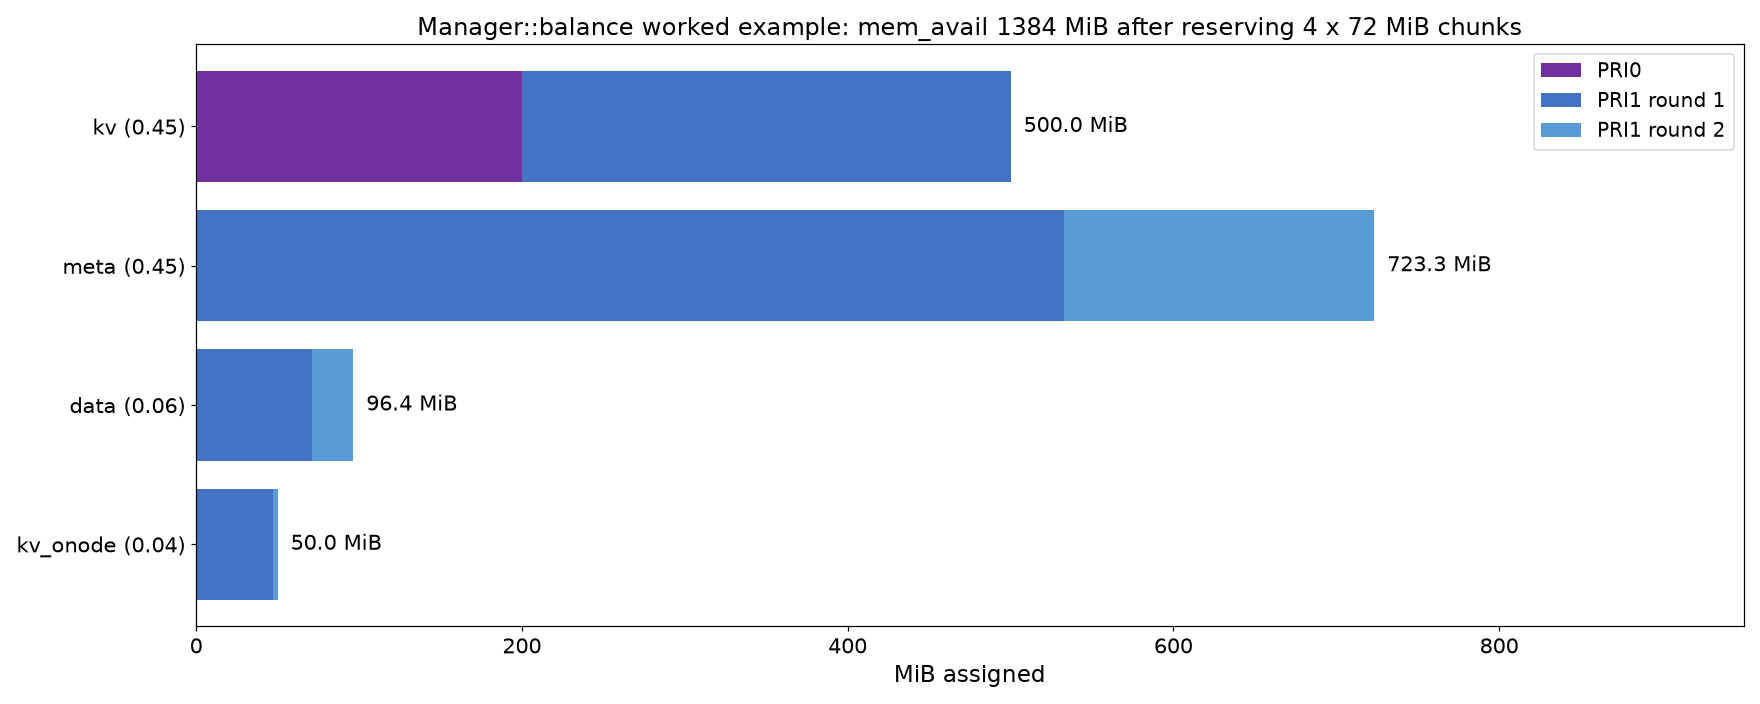
پیامد عملی این مثال: در OSDی که حافظهاش کم است، دادههای تازهی همهی cacheها پیش از دادههای قدیمی هر cache تأمین میشوند. اگر onodeهای پرکاربرد در meta جا نشوند، هر خواندن یک مراجعهی اضافه به RocksDB دارد (فصل ۲۵). شمارندههای bluestore-pricache:meta و مشابه در perf dump (فیلدهای pri0_bytes تا pri11_bytes، committed_bytes و reserved_bytes) نشان میدهند بودجه دقیقاً کجا رفته است.
۳۳-۶ NUMA#
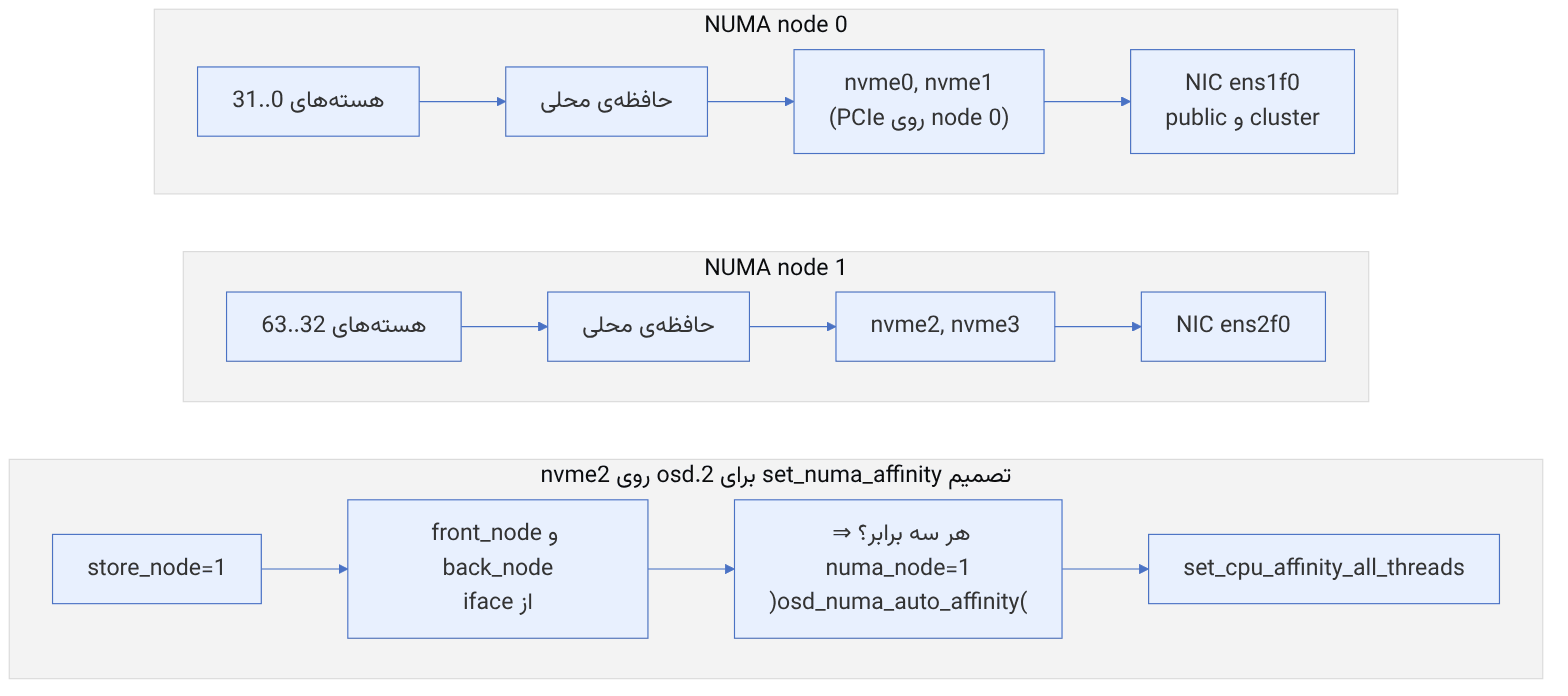
در سرورهای دوسوکتی، دسترسی به حافظه یا دستگاه PCIe سوکت دیگر از راه اتصال میانسوکتی میگذرد و تأخیر و پهنای باند بدتری دارد. OSD::set_numa_affinity این را بهطور خودکار مدیریت میکند.
منبع در کد: src/osd/OSD.cc :: OSD::set_numa_affinity
پیچیدگی: O(۱) هنگام راهاندازی
store_node = store.get_numa_node()
front = iface_numa(public addr); back = iface_numa(cluster addr)
if front == back == store_node and osd_numa_auto_affinity: node = front
if osd_numa_node ≥ 0: node = osd_numa_node                # اولویت با تنظیم دستی
if node ≥ 0: set_cpu_affinity_all_threads(cpus(node))
مثال. میزبانی با دو گره: nvme0 و nvme1 و NIC اول روی گره ۰، و nvme2 و nvme3 و NIC دوم روی گره ۱. برای osd.2 روی nvme2، اگر public و cluster هر دو روی NIC دوم باشند، OSD خودکار به هستههای ۳۲ تا ۶۳ بسته میشود. اگر شبکهی public روی NIC اول باشد، پیام «public and cluster network numa nodes do not match» در لاگ دیده میشود و هیچ وابستگیای تنظیم نمیشود. osd_numa_prefer_iface=true باعث میشود OSD هنگام انتخاب نشانی، IP روی رابط همگره با دستگاه را ترجیح دهد. فرمان ceph osd numa-status وضعیت را برای همهی OSDها نشان میدهد.
۳۳-۷ پروفایلگیری#
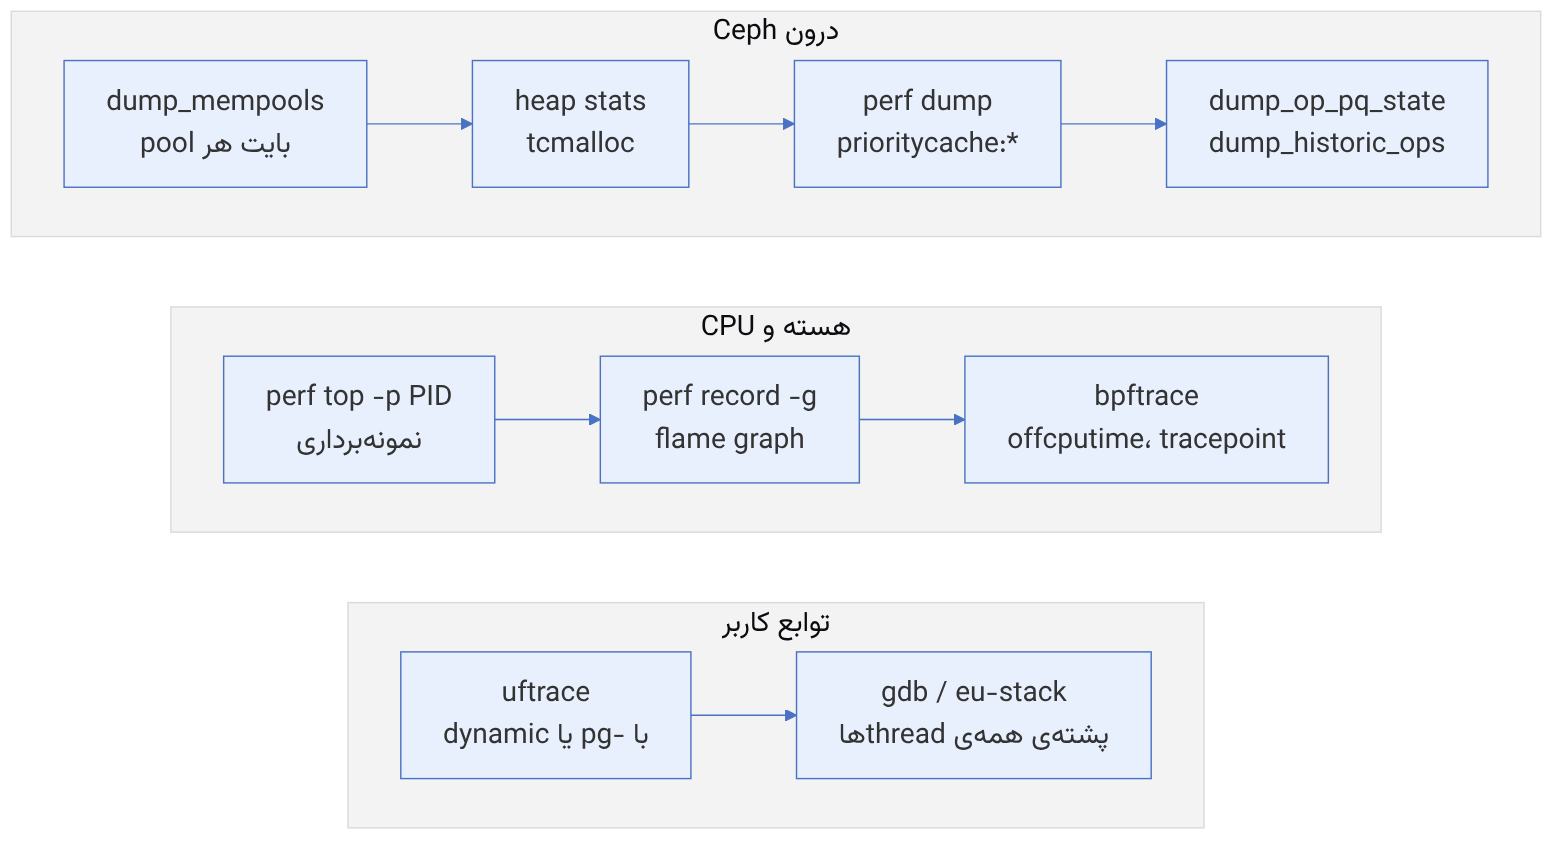
ceph tell osd.3 dump_mempools | jq '.mempool.by_pool | to_entries | sort_by(-.value.bytes) | .[:5]'
ceph tell osd.3 heap stats
ceph tell osd.3 perf dump | jq '."bluestore-pricache:meta"'
ceph osd numa-status
top -H -p $(pidof ceph-osd) # نام threadها
perf record -F 99 -g -p PID -- sleep 30 && perf script | stackcollapse-perf.pl | flamegraph.pl > osd.svg
bpftrace -e 'kprobe:finish_task_switch /pid == PID/ { @[kstack, comm] = count(); }' # off-CPU تقریبی
uftrace record --no-libcall -P 'BlueStore::_txc_.*' -- ceph-osd -f --id 3 # اجرای OSD آزمایشی زیر uftrace (uftrace فرایند را خودش اجرا میکند)
eu-stack -p PID > stacks.txt # همهی threadها، بدون توقف طولانیاستدلال بودجهی CPU برای هر op (مدل فرضی). فرض کنید یک OSD روی NVMe با ۱۶ thread مربوط به tp_osd_tp، ۳۰ هزار نوشتن ۴ KiB در ثانیه انجام میدهد و perf نشان میدهد ceph-osd حدود ۶ هستهی کامل مصرف میکند. بودجه = ۶ / ۳۰۰۰۰ = ۲۰۰ میکروثانیهی CPU برای هر op (شامل replica). اگر flame graph نشان دهد ۱۵٪ در crc32c و رمزگذاری msgr2، ۳۵٪ در PrimaryLogPG و ساخت تراکنش، ۳۰٪ در BlueStore و RocksDB و ۲۰٪ در messenger و تخصیص حافظه است، حذف رمزگذاری (حالت crc بهجای secure) حداکثر ۳۰ میکروثانیه صرفهجویی میکند. در مقابل، کم کردن تقویت نوشتن RocksDB (فصل ۲۵) روی بخش بزرگتری اثر دارد. این نوع حساب «سهم × بودجه» پیش از هر تنظیم، جلوی بهینهسازیهای بیاثر را میگیرد. اعداد واقعی را خودتان اندازه بگیرید.
۳۳-۸ mempoolها با دادهی واقعی#
این بخش عددهای واقعی mempool را از سه OSD BlueStore یک کلاستر آزمایشی با Ceph 18.2.7 نشان میدهد. خروجی ceph daemon osd.N dump_mempools هر pool را با دو عدد گزارش میکند: items و bytes. نسبت این دو یعنی «هزینهی هر آیتم»، و بهترین راه برای برآورد حافظه در مقیاس است.
۳۳-۸-۱ طول pg log و بودجهی هر OSD#
منبع در کد: OSDService::get_target_pg_log_entries در src/osd/OSD.cc؛ برش در PeeringState::calc_trim_to با osd_pg_log_trim_min = 100
پیچیدگی: O(۱) برای هر PG
pseudocode
num_pgs = تعداد PGهای این OSD (primary و replica)
target = osd_target_pg_log_entries_per_osd # پیشفرض 300000
اگر num_pgs > 0 و target > 0:
entries = max(min(target / num_pgs, osd_max_pg_log_entries = 10000), osd_min_pg_log_entries = 250)
وگرنه entries = osd_min_pg_log_entries
برش فقط وقتی انجام میشود که دستکم osd_pg_log_trim_min ورودی برای حذف باشد ← طول تا حدود entries + 100 بالا میرود
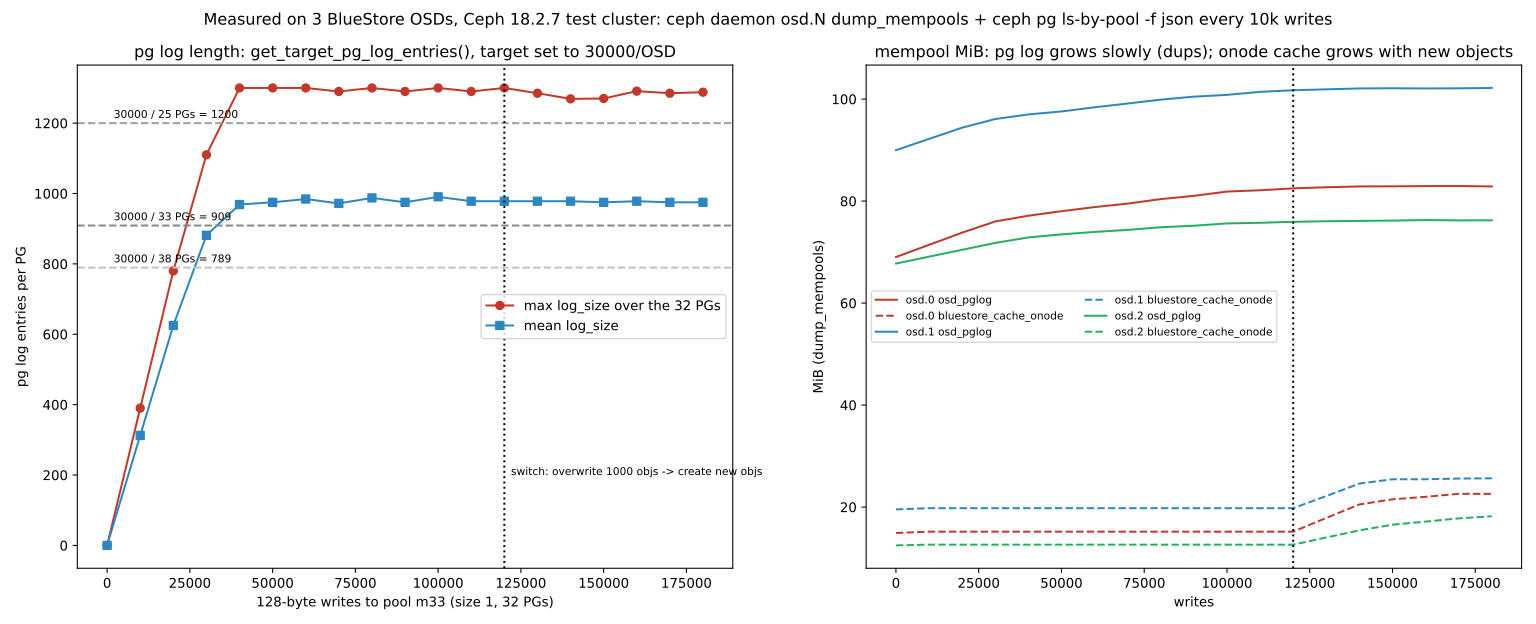
ورودیهای حذفشده به dups (تا osd_pg_log_dups_tracked = 3000) منتقل میشوند؛ هر دو در mempool osd_pglogآزمایش. برای اینکه سقف زود دیده شود، osd_target_pg_log_entries_per_osd را روی ۳۰۰۰۰ گذاشتیم. سپس روی pool m33 (۳۲ PG، size = ۱) صد و بیست هزار نوشتن ۱۲۸ بایتی روی ۱۰۰۰ شیء انجام دادیم (بازنویسی) و بعد شصت هزار نوشتن روی شیءهای تازه. هر ده هزار نوشتن، mempoolها و log_size همهی PGها را خواندیم.
نتیجه. OSDها ۳۳، ۳۸ و ۲۵ PG داشتند، پس بودجهها ۹۰۹، ۷۸۹ و ۱۲۰۰ بود. طول log در حدود ۴۰ هزار نوشتن ثابت شد. میانگین حدود ۹۸۰ و بیشینه ۱۳۰۰ بود، که همان ۱۲۰۰ بهعلاوهی حداکثر ۱۰۰ ورودیِ منتظر برش است. پس از رسیدن به سقف، mempool osd_pglog باز هم آهسته رشد کرد: روی osd.0 از ۷۹.۷ به ۸۶.۵ MiB. دلیلش این است که ورودیهای برشخورده به dups میروند و dups هم در همین mempool است (mempool::osd_pglog::list<pg_log_dup_t> dups در osd_types.h). در این دوره هر آیتم تازه بهطور میانگین حدود ۱۱۰ بایت هزینه داشت، در برابر حدود ۳۰۰ بایت در ابتدای پر شدن log.
۳۳-۸-۲ هزینهی هر آیتم#
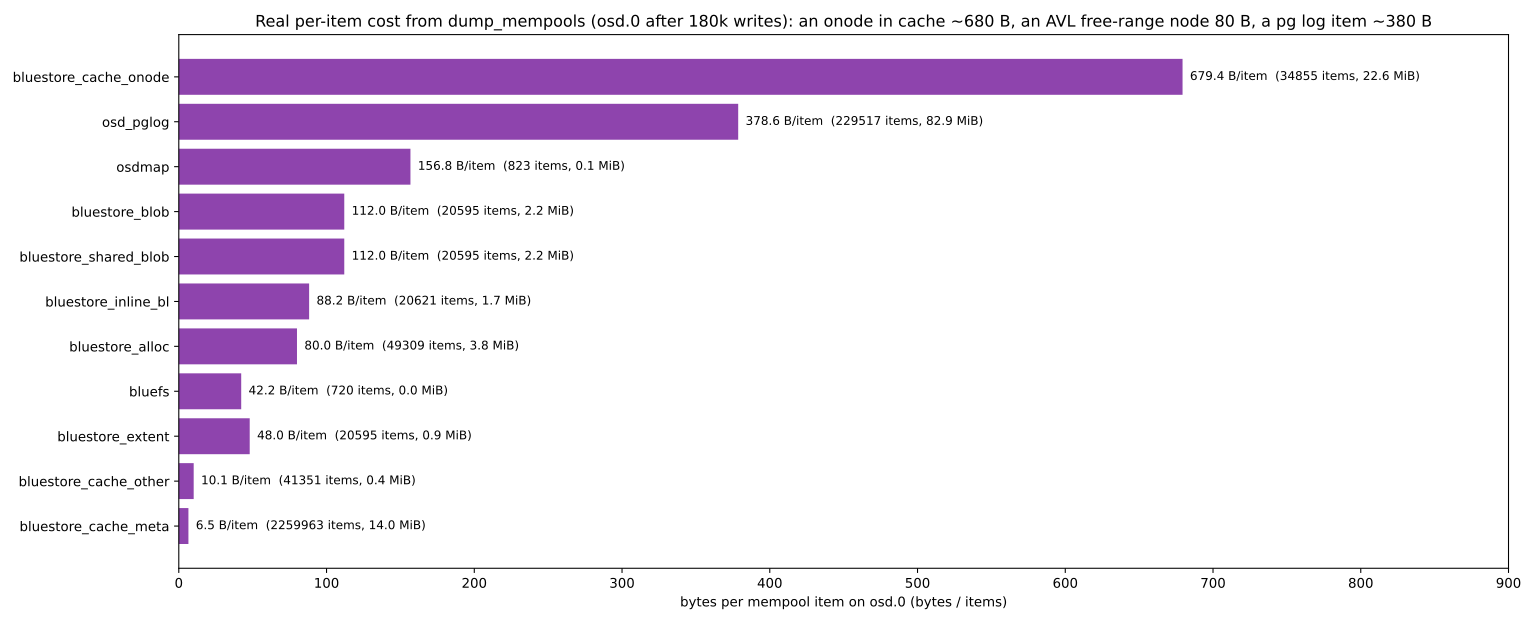
از آخرین نمونهی osd.0 (پس از ۱۸۰ هزار نوشتن) این هزینهها به دست آمد:
| mempool | بایت در هر آیتم | برداشت |
|---|---|---|
| bluestore_cache_onode | ۶۷۹.۴ | هر onode در cache حدود ۶۸۰ بایت. یک میلیون onode در cache حدود ۶۵۰ MiB است |
| osd_pglog | ۳۷۸.۶ | میانگین مخلوط ورودیهای log و dups |
| bluestore_blob و bluestore_shared_blob | ۱۱۲.۰ | برای هر blob |
| bluestore_inline_bl | ۸۸.۲ | دادهی inline کوچک |
| bluestore_alloc | ۸۰.۰ | برابر اندازهی گرهی range_seg_t در allocator AVL/hybrid (فصل ۲۴) |
| bluestore_extent | ۴۸.۰ | هر extent منطقی |
این عددها را مستقیم برای برآورد به کار ببرید. برای مثال ۳۰۰۰۰۰ ورودی pg log در هر OSD با حدود ۳۸۰ بایت تقریباً ۱۱۰ MiB است، آن هم بدون dups. اگر dups برای هر PG تا ۳۰۰۰ پر شوند، روی OSD با ۲۰۰ PG، ۶۰۰۰۰۰ dup اضافه میشود.
اینها خارج از بودجهی cache در osd_memory_target نیستند. PriorityCache فقط cacheهای BlueStore و RocksDB را تنظیم میکند. pg log حافظهی ثابتی است که از سهم cache کم میشود.
عدد ۸۰ بایت برای bluestore_alloc با اندازهی range_seg_t که در فصل ۲۴ از روی کد به دست آوردیم یکی است. این تطابق وارسی مستقلی برای آن عدد است.
۳۳-۹ تکمیلی و بهروز#
- فهرست poolهای mempool در main شامل
ec_extent_cache و bluefs_file_reader و bluefs_file_writer است. در نسخهی خود با dump_mempools ببینید کدام poolها وجود دارند. - در Crimson (فصل ۳۰)، بهجای thread pool، هر reactor یک هسته دارد و Seastar allocator خودش را برای هر هسته دارد. مدل حافظه و CPU این فصل فقط برای OSD کلاسیک است.
-
osd_memory_target_autotune (پیشفرض false) به cephadm اجازه میدهد target را در سطح میزبان و بر پایهی حافظهی کل و تعداد OSDها تنظیم کند. این تنظیم بیرون از OSD انجام میشود و ارتباطی با حلقهی tune_memory درون OSD ندارد. - PriorityCache در monها هم برای cacheهای RocksDB و osdmap استفاده میشود (گزینههای
mon_memory_target و mon_memory_autotune).
۳۳-۱۰ تمرین عملی#
- ۱. روی یک OSD آزمایشی،
osd_memory_target را به ۲ GiB کاهش دهید و هر ۵ ثانیه perf dump بخش bluestore-pricache را ثبت کنید. کاهش تدریجی committed_bytes را با مدل tune_memory مقایسه کنید. - ۲. برای ماشین خودتان num_shards مربوط به mempool را از روی nproc حساب کنید.
- ۳. PGهای primary یک OSD را با
ceph pg ls-by-primary osd.N فهرست کنید، ps هر PG را در پیمانهی ۸ حساب کنید و بار shardها را تخمین بزنید. - ۴. با
perf record یک flame graph از OSD هنگام rados bench -t 64 write بسازید و سهم crc32c، RocksDB و tcmalloc را بخوانید. - ۵.
ceph osd numa-status را اجرا کنید و برای هر OSD توضیح دهید چرا وابستگی NUMA تنظیم شده یا نشده است.
۳۳-۱۱ پرسشهای مرور#
- ۱. چرا mempool بهجای یک شمارندهی atomic مشترک از shard استفاده میکند و shard چگونه انتخاب میشود؟
- ۲. اندازهی shard_t چرا مضرب ۱۲۸ است؟
- ۳. دو عددی را که از osd_memory_target بهعنوان max و min بودجهی cache به دست میآیند با پیشفرضها محاسبه کنید.
- ۴. tune_memory در افزایش و کاهش چه رفتار متفاوتی دارد؟
- ۵. چرا osd_memory_target سقف سخت نیست؟
- ۶. در balance، cacheی که کمتر از سهمش میخواهد چه میشود و باقیمانده به چه کسی میرسد؟
- ۷. get_chunk برای tuned_mem برابر ۱۶۷۲ MiB چه مقداری دارد؟
- ۸. چرا افزایش threads_per_shard برای یک PG داغ کمکی نمیکند؟
- ۹. OSD در چه شرطی خودکار وابستگی NUMA تنظیم میکند؟
- ۱۰. «بودجهی CPU برای هر op» را چگونه حساب میکنید و از آن چه نتیجهای میگیرید؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۳-۱۲ منابع این فصل#
- پیکربندی حافظهی BlueStore
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - مرجع گزینههای OSD
https://docs.ceph.com/en/latest/rados/configuration/osd-config-ref/ - mempool
https://github.com/ceph/ceph/blob/main/src/include/mempool.h - PriorityCache
https://github.com/ceph/ceph/blob/main/src/common/PriorityCache.cc - BlueStore MempoolThread
https://github.com/ceph/ceph/blob/main/src/os/bluestore/BlueStore.cc - NUMA در OSD
https://github.com/ceph/ceph/blob/main/src/osd/OSD.cc - tcmalloc (gperftools
https://github.com/gperftools/gperftools - perf
https://perfwiki.github.io/main/ - bpftrace
https://github.com/bpftrace/bpftrace - uftrace
https://github.com/namhyung/uftrace - Flame graphs
https://www.brendangregg.com/flamegraphs.html