پایش Ceph: Prometheus، ceph-exporter، هشدارها و مشاهدهپذیری
حوصله ندارم این فصل در چند خط
- پشتهی پایش شامل ماژول prometheus در MGR، ceph-exporter برای perf counterهای هر daemon، Prometheus، Alertmanager و Grafana با داشبوردها و هشدارهای ceph-mixin است.
- perf counterها متغیرهای اتمی درون هر daemon هستند؛ نوع آنها (شمارنده، میانگین، هیستوگرام) را بشناسید تا درست بخوانیدشان.
- چند سیگنال کلیدی را زیر نظر بگیرید: سلامت، وضعیت PGها، تأخیر، ظرفیت و slow opها؛ قانونهای هشدار خودتان را کنار ceph-mixin اضافه کنید، نه به جای آن.
- mgmt-gateway در Tentacle همهی رابطهای پایش را پشت یک درِ ورودی میبرد؛ نماهای SLO را روی داشبوردهای ceph-mixin بسازید.
۲۰-۱ پیش از شروع#
۲۰-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
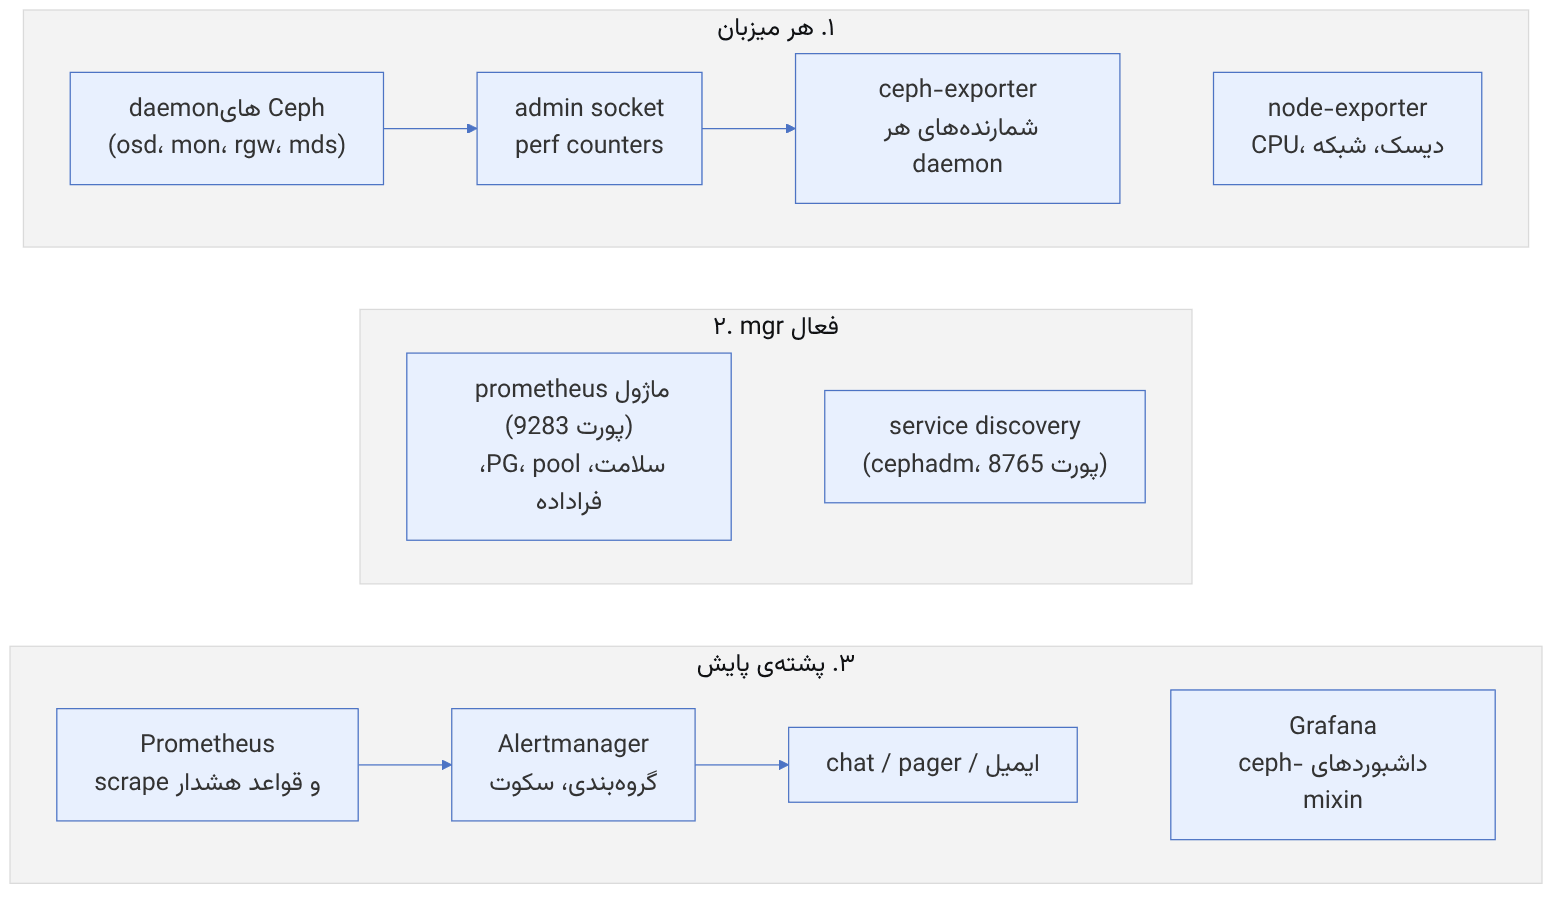
ceph -s برای یک نگاه سریع کافی است، اما برای پاسخ به پرسشهایی مانند «تأخیر نوشتن از سهشنبه چرا بالا رفته؟» یا «کدام OSD در یک ساعت گذشته کندترین بوده؟» به سریهای زمانی، قواعد هشدار و داشبورد نیاز داریم. Ceph امروز پشتهی پایش استانداردی دارد که cephadm آن را مستقر میکند: ماژول prometheus در mgr، daemon ceph-exporter روی هر میزبان، node-exporter، Prometheus، Alertmanager و Grafana، و در Tentacle دروازهی mgmt-gateway.
- هر مؤلفهی پشته چه دادهای تولید میکند و چرا شمارندههای عملکرد از mgr به ceph-exporter منتقل شدند؟
- کدام متریکها مهمترین سیگنالها هستند؟
- قاعدهی هشدار خوب برای Ceph چه ویژگیهایی دارد؟
- شمارندههای داخلی daemonها (perf counters) چگونه ساخته و خوانده میشوند؟
- mgmt-gateway و oauth2-proxy چه مشکلی را حل میکنند؟
۲۰-۲ معماری پشتهی پایش#
ceph mgr module enable prometheus
ceph orch apply node-exporter
ceph orch apply ceph-exporter
ceph orch apply alertmanager
ceph orch apply prometheus
ceph orch apply grafana
ceph orch ls --service-type prometheus
ceph dashboard get-prometheus-api-host| مؤلفه | داده | نکته |
|---|---|---|
| ماژول prometheus در mgr | سلامت، کدهای health، وضعیت OSD و PG، مصرف pool، فرادادهی daemonها، متریکهای تصویر RBD (اختیاری) | پورت پیشفرض ۹۲۸۳؛ فقط mgr فعال داده میدهد |
| ceph-exporter | شمارندههای عملکرد هر daemon محلی (از admin socket) | روی هر میزبان؛ بار mgr را کم میکند |
| node-exporter | CPU، حافظه، دیسک، شبکهی میزبان | برای همبستگی کندی Ceph با سختافزار |
| Prometheus | ذخیرهی سری زمانی و ارزیابی قواعد | قواعد ceph-mixin همراه cephadm |
| Alertmanager | گروهبندی، سکوت و ارسال هشدار | Dashboard هشدارها را نمایش میدهد |
| Grafana | داشبوردهای آماده | درون Dashboard جاسازی میشود |
تغییر نسبت به نسخههای قدیمی. طبق مستندات ماژول prometheus، شمارندههای عملکرد daemonها دیگر بهصورت پیشفرض از این ماژول منتشر نمیشوند و این کار به ceph-exporter سپرده شده است؛ گزینهی mgr/prometheus/exclude_perf_counters فقط وقتی باید غیرفعال شود که هیچ ceph-exporterی مستقر نیست. دلیل: جمعآوری همهی شمارندهها از یک نقطه در کلاسترهای بزرگ کارایی mgr را پایین میآورد.
فقط mgr فعال متریکهای کلاستر را منتشر میکند. اگر Prometheus بیرونی دارید، همهی mgrها را بهعنوان هدف تعریف کنید (یا از service discovery در http(s)://<mgr>:8765/sd/prometheus/sd-config?service=... استفاده کنید) تا پس از failover، scrape قطع نشود. رفتار mgrهای standby با standby_behaviour و کد پاسخ آنها با standby_error_status_code تنظیم میشود.
۲۰-۲-۱ Prometheus بیرونی#
# prometheus.yml — نمونهی این کتاب برای Prometheus بیرونی
scrape_configs:
- job_name: ceph
honor_labels: true
http_sd_configs:
- url: http://mgr1.example.internal:8765/sd/prometheus/sd-config?service=mgr-prometheus
- job_name: ceph-exporter
honor_labels: true
http_sd_configs:
- url: http://mgr1.example.internal:8765/sd/prometheus/sd-config?service=ceph-exporter
- job_name: node
http_sd_configs:
- url: http://mgr1.example.internal:8765/sd/prometheus/sd-config?service=node-exporterhonor_labels: true لازم است تا برچسبهایی مانند ceph_daemon و instance که Ceph تنظیم میکند، با برچسبهای Prometheus بازنویسی نشوند. نام دقیق سرویسها در service discovery را با مستندات نسخهی خود تطبیق دهید. طبق مستندات cephadm، اگر mgr/cephadm/secure_monitoring_stack فعال باشد یا mgmt-gateway مستقر شده باشد، این endpoint روی https و با basic auth سرویس میدهد و تعریف job باید basic_auth و tls_config داشته باشد.
۲۰-۳ از درون کد: perf counters#
۲۰-۳-۱ ساخت شمارندهها#
هر daemon Ceph شمارندههای خود را با PerfCountersBuilder (src/common/perf_counters.h) تعریف میکند. هر شمارنده یک کلید عددی، یک نام، یک نوع و یک اولویت دارد. انواع اصلی:
| تابع سازنده | نوع | مثال |
|---|---|---|
| add_u64 | مقدار لحظهای (gauge) | تعداد عملیات در جریان |
| add_u64_counter | شمارندهی افزایشی | تعداد کل عملیات نوشتن |
| add_time_avg | مجموع زمان و تعداد (برای میانگین) | op_w_latency |
| add_u64_counter_histogram | هیستوگرام دوبعدی (مثلاً اندازه × تأخیر) | توزیع تأخیر بر حسب اندازه |
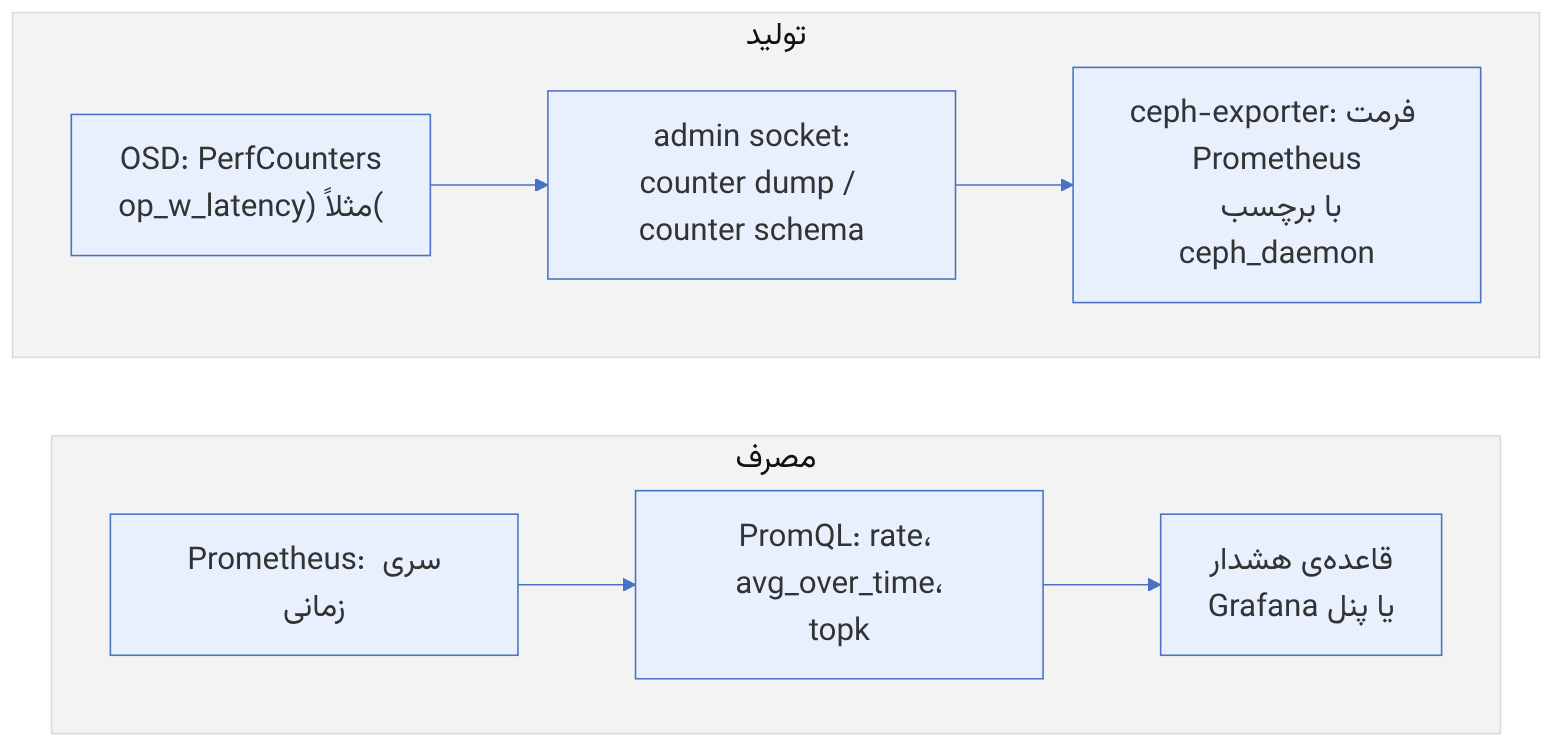
اولویتها از PRIO_CRITICAL=10 تا PRIO_DEBUGONLY=0 هستند (PRIO_INTERESTING=8، PRIO_USEFUL=5). این اولویت نقش عملی دارد: ceph-exporter فقط شمارندههایی با اولویت دستکم exporter_prio_limit را منتشر میکند که در src/common/options/ceph-exporter.yaml.in پیشفرضش ۵ است. بنابراین شمارندههای DEBUGONLY به Prometheus نمیرسند مگر این حد را کاهش دهید (که حجم متریکها را بسیار زیاد میکند).
# خواندن مستقیم شمارندهها روی میزبان
ceph daemon osd.3 counter schema | jq 'keys' | head
ceph daemon osd.3 counter dump | jq '.osd[0].counters | {op_w, op_r}'
ceph daemon osd.3 perf dump osd | jq '.osd.op_w_latency' # شکل قدیمیتر: avgcount و sum
ceph config get client.ceph-exporter exporter_prio_limitفرمانهای counter dump و counter schema در src/common/ceph_context.cc ثبت شدهاند و شکل برچسبدار (labeled) شمارندهها را برمیگردانند؛ perf dump شکل قدیمیتر است. ceph-exporter با فاصلهی exporter_stats_period (پیشفرض ۵ ثانیه) از socketهای پوشهی exporter_sock_dir میخواند و روی پورت exporter_http_port (پیشفرض ۹۹۲۶) منتشر میکند.
۲۰-۳-۲ از time_avg به تأخیر#
شمارندهی add_time_avg دو مقدار دارد: sum (مجموع ثانیهها) و avgcount (تعداد). میانگین تأخیر در یک بازه، نسبت افزایش این دو است، نه نسبت مقادیر خام (که میانگین کل عمر daemon است):
avg_latency(window) = Δsum / Δavgcount
PromQL: rate(ceph_osd_op_w_latency_sum[5m]) / rate(ceph_osd_op_w_latency_count[5m])نام دقیق متریکها را از خود endpoint بخوانید (curl -s http://host:9926/metrics | grep op_w_latency)؛ پسوندها (_sum، _count) و برچسبها ممکن است بین نسخهها و بین ماژول mgr و ceph-exporter متفاوت باشند.
۲۰-۴ سیگنالهای کلیدی#
| سیگنال | متریک یا PromQL نمونه | چرا |
|---|---|---|
| سلامت کلی | ceph_health_status (۰ سالم، ۱ هشدار، ۲ خطا) | خلاصهی وضعیت |
| کد سلامت مشخص | ceph_health_detail{name="MON_DOWN"} == 1؛ برای SLOW_OPS متریک جداگانهی ceph_healthcheck_slow_ops > 0 (فهرست HEALTH_CHECKS در module.py) | هشدار دقیق بر اساس کدهای فصل ۱۷ |
| OSDهای down | count(ceph_osd_up == 0) | از دست رفتن ظرفیت و افزونگی |
| PGهای غیرفعال | ceph_pool_metadata * on(cluster,pool_id,instance) group_left() (ceph_pg_total - ceph_pg_active) > 0 (عین قاعدهی CephPGsInactive) | توقف I/O، به تفکیک pool |
| پری pool | ceph_pool_percent_used (کسری بین ۰ و ۱، نه درصد) | پیشگیری از OSD_FULL |
| quorum | ceph_mon_quorum_status | سلامت لایهی کنترل |
| تأخیر نوشتن OSD | rate(ceph_osd_op_w_latency_sum[5m]) / rate(ceph_osd_op_w_latency_count[5m]) به تفکیک ceph_daemon | کندی کاربر |
| mirroring | topk by (cluster,ceph_daemon,image,namespace,pool) (1, ceph_rbd_mirror_snapshot_image_local_timestamp) - topk by (…) (1, ceph_rbd_mirror_snapshot_image_remote_timestamp) != 0 (قاعدهی CephRBDMirrorImagesNotInSync) | تأخیر RPO |
همهی نامهای متریک و عبارتهای جدول بالا در نوامبر ۲۰۲۶ با src/pybind/mgr/prometheus/module.py و قواعد هشدار رسمی monitoring/ceph-mixin/prometheus_alerts.yml شاخهی main تطبیق داده شدهاند. فایل قواعد ceph-mixin در شاخهی main (هنگام نگارش) ۱۰۹ قاعده دارد؛ از جمله CephHealthError، CephMonDownQuorumAtRisk، CephOSDDown، CephOSDNearFull، CephPGsInactive، CephPGUnavailableBlockingIO، CephSlowOps، CephPoolGrowthWarning و قواعد سختافزاری (مانند PowerSupplyFailed) و NVMe-oF.
۲۰-۵ طراحی قواعد هشدار#
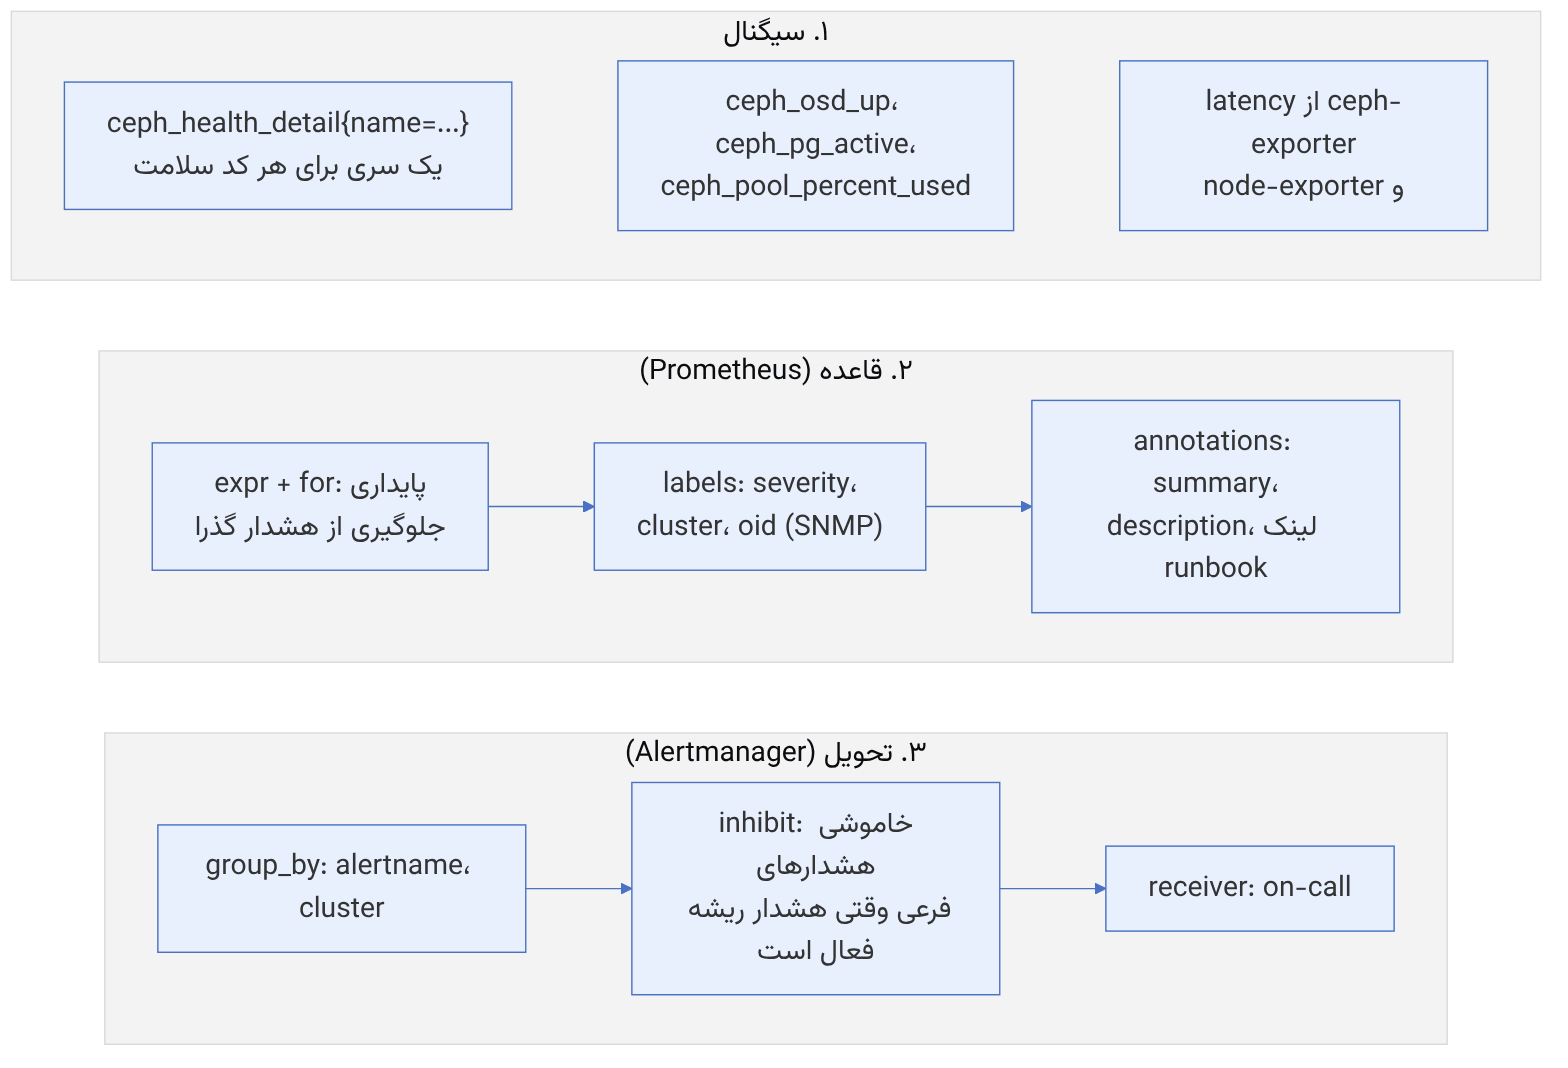
قواعد زیر نمونهی خود این کتاباند و جایگزین ceph-mixin نیستند، بلکه الگوی افزودن قواعد محلی را نشان میدهند:
groups:
- name: ceph-local
rules:
- alert: CephWriteLatencyHigh
expr: |
( rate(ceph_osd_op_w_latency_sum[5m]) / rate(ceph_osd_op_w_latency_count[5m]) ) > 0.05
for: 15m
labels: { severity: warning }
annotations:
summary: "تأخیر نوشتن {{ $labels.ceph_daemon }} بیش از ۵۰ میلیثانیه"
runbook: "https://wiki.example.internal/runbooks/ceph-slow-osd"
- alert: CephPoolFillingFast
expr: predict_linear(ceph_pool_percent_used[6h], 3 * 24 * 3600) > 0.85
for: 1h
labels: { severity: warning }
annotations:
summary: "pool {{ $labels.pool_id }} در سه روز آینده از ۸۵٪ میگذرد"# Alertmanager: خاموش کردن هشدار OSD منفرد وقتی کل میزبان down است
inhibit_rules:
- source_matchers: [ alertname = "CephOSDHostDown" ]
target_matchers: [ alertname = "CephOSDDown" ]
equal: [ cluster ]مقادیر آستانهی بالا (۵۰ میلیثانیه، ۸۵٪) نمونهاند. آستانهی واقعی را از پایهی رفتار کلاستر خودتان (مثلاً صدک ۹۵ هفتهی گذشته) و SLOهای سرویس استخراج کنید. هشداری که هر روز بیدلیل به صدا درآید، بهسرعت نادیده گرفته میشود.
در cephadm، قواعد سفارشی کنار قواعد پیشفرض قرار میگیرند: فایل را با ceph config-key set mgr/cephadm/services/prometheus/alerting/custom_alerts.yml -i custom_alerts.yml ثبت و سپس ceph orch reconfig prometheus را اجرا کنید (مستندات monitoring در cephadm). طبق همان مستندات، قواعد سفارشی با Jinja پردازش نمیشوند.
۲۰-۶ لایهی پایینتر: از متغیر atomic تا سطر /metrics#
هر عدد روی داشبورد از یک متغیر std::atomic<uint64_t> در حافظهی یک daemon شروع میشود. این بخش مسیر آن را تا Prometheus در سطح بایت و کد دنبال میکند تا بدانید هر عدد دقیقاً چه چیزی را اندازه میگیرد و کجا ممکن است دروغ بگوید.
۲۰-۶-۱ ساختار یک شمارنده#
perf_counter_data_any_d در src/common/perf_counters.h برای هر شمارنده یک بایت نوع (bitmask)، یک اولویت و یک واحد نگه میدارد:
| بیت نوع | مقدار | معنا |
|---|---|---|
PERFCOUNTER_TIME | ۰x1 | مقدار زمانی؛ به نانوثانیه در u64 ذخیره میشود (to_nsec) |
PERFCOUNTER_U64 | ۰x2 | عدد صحیح (یکی از TIME یا U64 باید روشن باشد) |
PERFCOUNTER_LONGRUNAVG | ۰x4 | جفت «مجموع + تعداد» برای میانگین بلندمدت |
PERFCOUNTER_COUNTER | ۰x8 | شمارندهی صعودی (در برابر gauge) |
PERFCOUNTER_HISTOGRAM | ۰x10 | هیستوگرام (مثلاً دوبعدی اندازه × تأخیر) |
اولویتها PRIO_CRITICAL=10، PRIO_INTERESTING=8، PRIO_USEFUL=5، PRIO_UNINTERESTING=2 و PRIO_DEBUGONLY=0 هستند. این عدد تعیین میکند شمارنده اصلاً از daemon بیرون برود یا نه: MgrClient فقط شمارندههایی را گزارش میکند که اولویت تنظیمشدهشان >= mgr_stats_threshold (پیشفرض ۵) باشد. ceph-exporter هم همین کار را با exporter_prio_limit=5 انجام میدهد. پس شمارندهای که در ceph daemon osd.3 perf dump میبینید ولی در Prometheus نیست، احتمالاً اولویتی کمتر از ۵ دارد.
۲۰-۶-۲ میانگین بدون قفل#
tinc برای یک شمارندهی LONGRUNAVG سه کار را به این ترتیب انجام میدهد: avgcount++، سپس u64 += nsec و در پایان avgcount2++. خواننده (read_avg) برعکس عمل میکند:
pseudocode: read_avg (الگوی seqlock-مانند)
repeat:
c = avgcount2 # شمارندهی «پایان نوشتن»
sum = u64
until avgcount == c # در این فاصله نوشتنی شروع نشده است
return (sum, c)اگر وسط خواندن یک tinc انجام شود، avgcount از avgcount2 جلو میافتد و حلقه تکرار میشود. بنابراین جفت (sum, count) همیشه با هم سازگار است، بدون mutex در مسیر داغ I/O. چون نویسندههای چندتایی (threadهای شارد) همزمان هستند، این تضمین «تقریباً» سازگار است و برای آمار کافی است، نه برای حسابداری دقیق.
عدد خامی که میبینید میانگین از لحظهی شروع daemon است. perf dump برای op_r_latency مقادیر avgcount و sum (به ثانیه) و avgtime=sum/avgcount را میدهد. avgtime میانگین از زمان شروع daemon است و یک کندی ۵ دقیقهای را پس از یک ماه کار عملاً نشان نمیدهد. همیشه از تفاضل دو نمونه استفاده کنید.
مثال عددی#
فرض کنید دو نمونه به فاصلهی ۶۰ ثانیه از osd.3 گرفتهایم:
| نمونه | op_r_latency.avgcount | op_r_latency.sum (s) | avgtime گزارششده |
|---|---|---|---|
| t=0 | ۵۰,۰۰۰ | ۱۲۰.۵ | ۲.۴۱ ms |
| t=60s | ۵۳,۰۰۰ | ۱۲۳.۵ | ۲.۳۳ ms |
| تفاضل | ۳,۰۰۰ | ۳.۰ | ۱.۰۰ ms (تأخیر واقعی این دقیقه) |
IOPS خواندن در این دقیقه ۳۰۰۰/۶۰=۵۰ است. avgtime از ۲.۴۱ به ۲.۳۳ رسیده و ظاهراً بهبود کمی نشان میدهد، در حالی که تأخیر واقعی این دقیقه ۱ms بوده است. برعکسش هم ممکن است: یک دقیقه با تأخیر ۵۰ms، avgtime را فقط کمی بالا میبرد. در PromQL معادل همین تفاضل این است:
rate(ceph_osd_op_r_latency_sum[1m]) / rate(ceph_osd_op_r_latency_count[1m])۲۰-۶-۳ پروتکل admin socket#
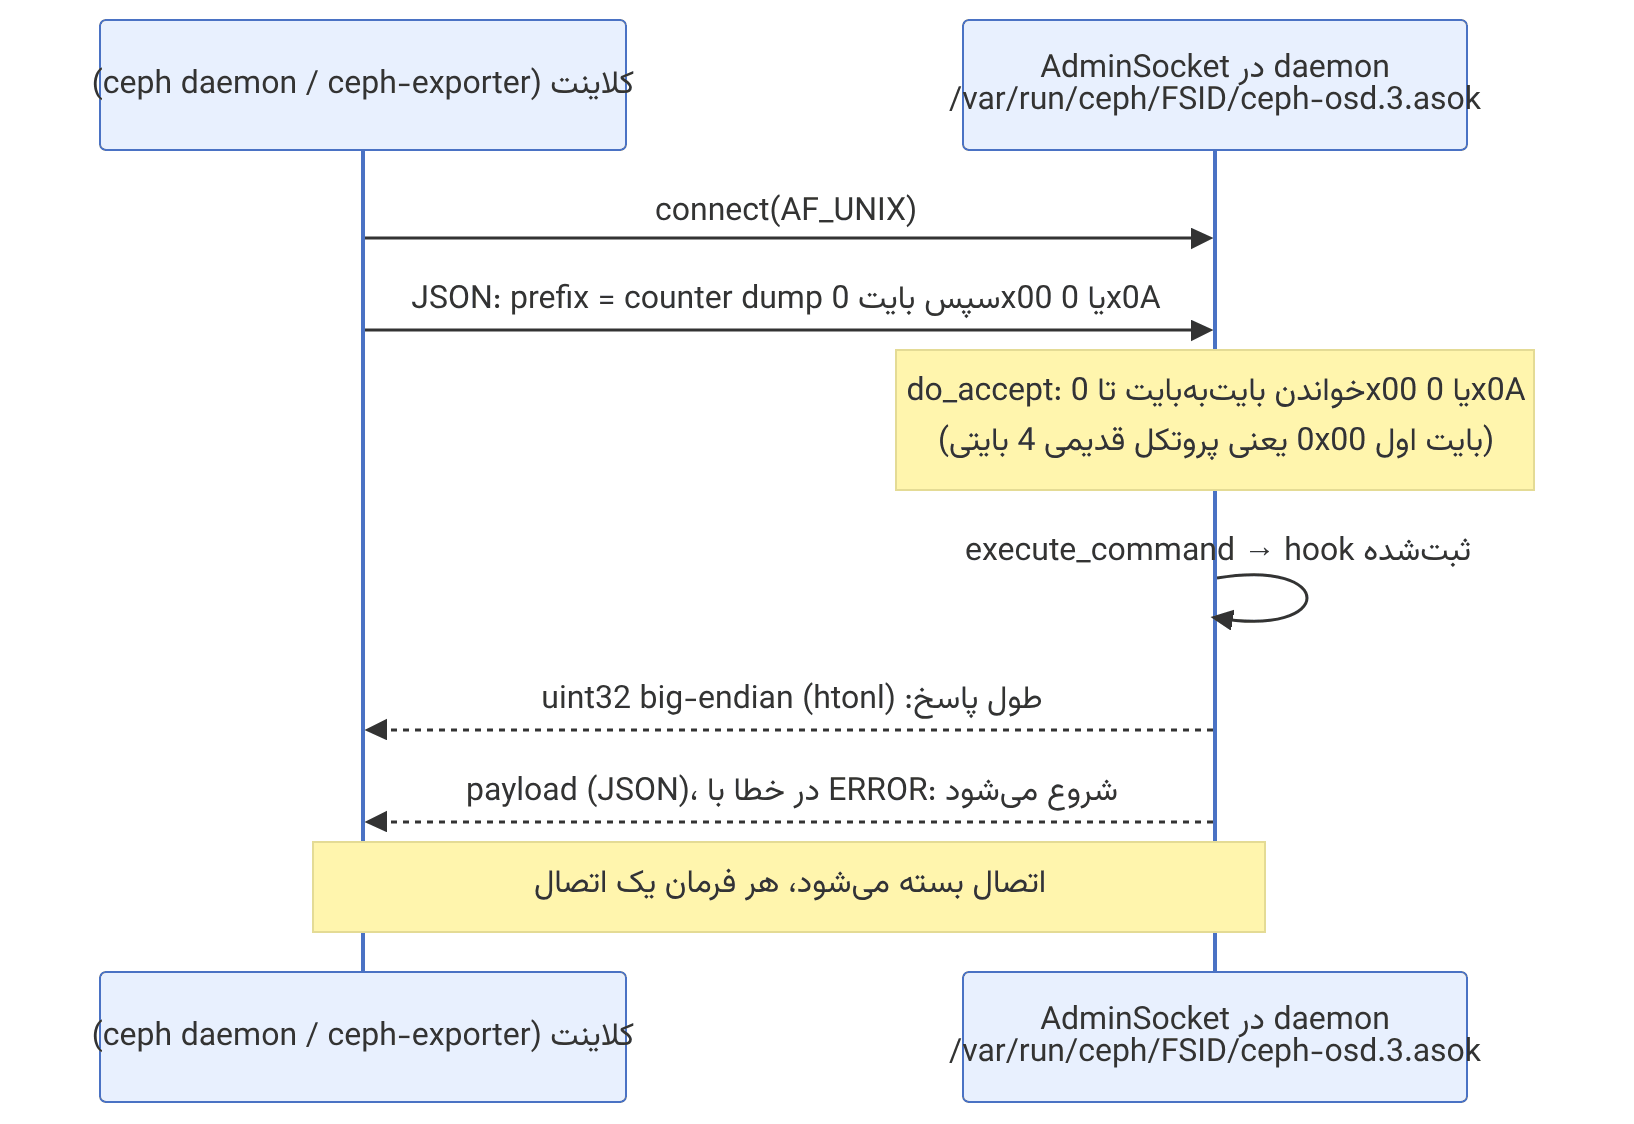
در AdminSocket::do_accept کد خطا روی سیم ارسال نمیشود. اگر فرمان شکست بخورد، پاسخ با رشتهی ERROR: شروع میشود، پس ابزار خودکار باید همین پیشوند را بررسی کند. یک کلاینت حداقلی (نوشتهی این کتاب، فقط برای فهم پروتکل):
import socket, struct, json, sys
def asok(path, prefix):
    s = socket.socket(socket.AF_UNIX); s.connect(path)
    s.sendall(json.dumps({"prefix": prefix}).encode() + b"\0")
    n = struct.unpack(">I", s.recv(4, socket.MSG_WAITALL))[0]
    buf = b""
    while len(buf) < n: buf += s.recv(n - len(buf))
    s.close()
    if buf.startswith(b"ERROR: "): raise RuntimeError(buf[:200].decode())
    return json.loads(buf)
d = asok(sys.argv[1], "perf dump")
lat = d["osd"]["op_r_latency"]; print(lat["avgcount"], lat["sum"])admin socket دسترسی کامل به daemon میدهد (از جمله config set و فرمانهای مخرب). فقط root یا کاربر ceph باید به فایل .asok دسترسی داشته باشد. هرگز دایرکتوری /var/run/ceph را در یک کانتینر پایش با دسترسی نوشتن mount نکنید، مگر آنکه همان ceph-exporter رسمی باشد.
۲۰-۶-۴ دو مسیر رسیدن به Prometheus#
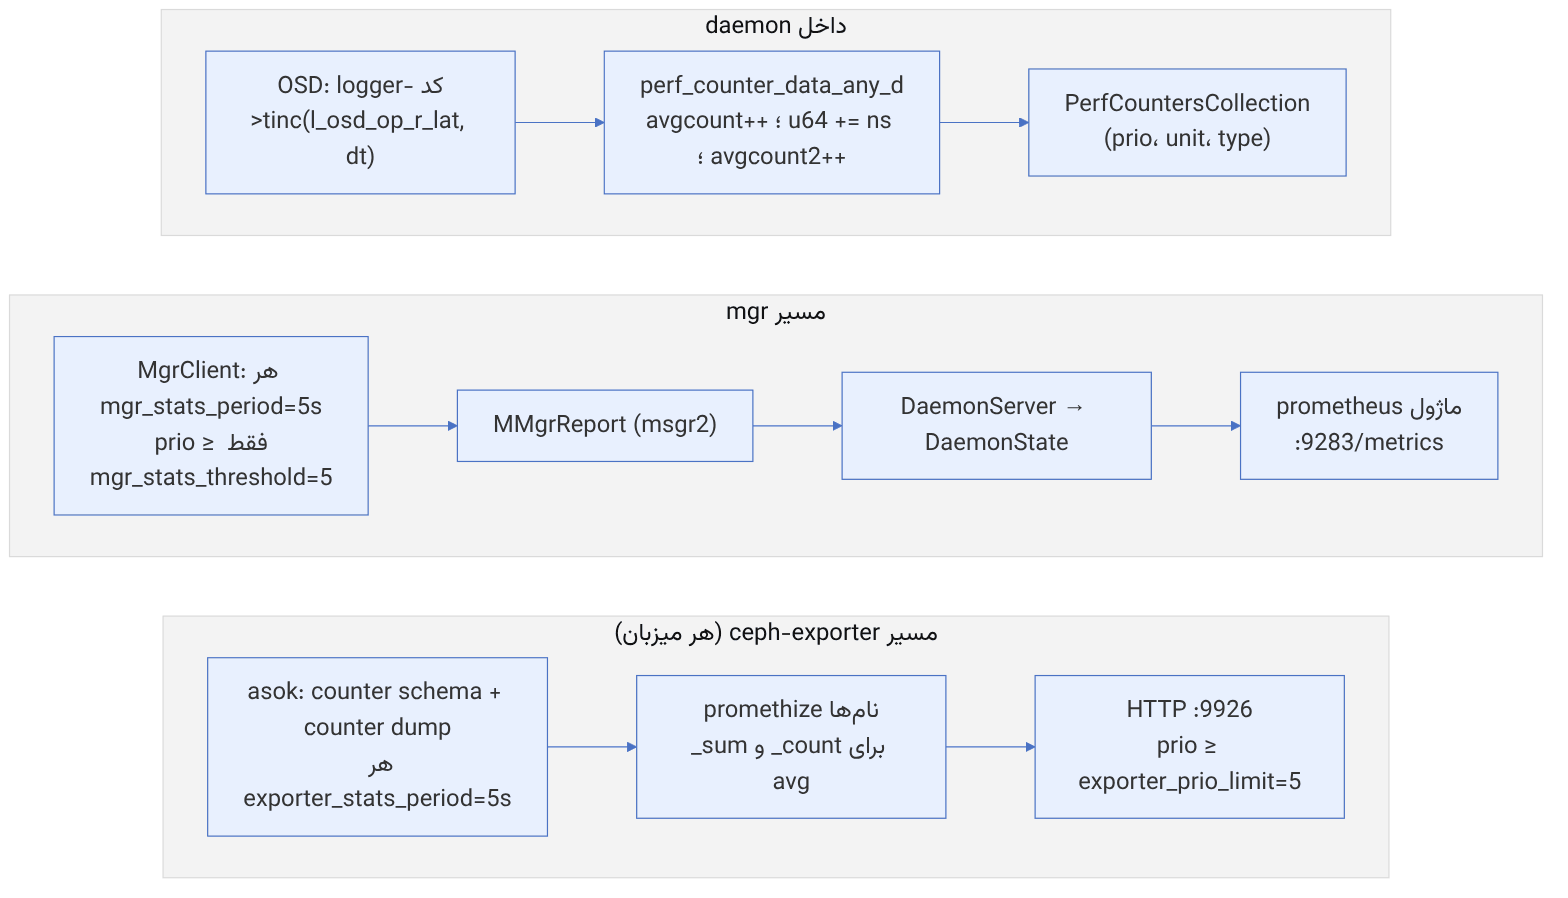
| گزینه | پیشفرض (main) | مسیر |
|---|---|---|
mgr_stats_period | ۵ s | MgrClient → mgr |
mgr_stats_period_autotune | true | افزایش خودکار period وقتی صف پیام mgr پر شود (در yaml نسخههای Squid و Tentacle هم هست) |
mgr_stats_threshold | ۵ | کمترین اولویت ارسالی به mgr |
exporter_stats_period | ۵ s | ceph-exporter |
exporter_http_port | ۹۹۲۶ | ceph-exporter |
exporter_prio_limit | ۵ | کمترین اولویت منتشرشده در exporter |
exporter_sock_dir | /var/run/ceph/ | محل جستوجوی asokها |
چرا ceph-exporter؟ در خوشهی بزرگ، مسیر mgr همهی شمارندههای همهی daemonها را از یک فرایند Python عبور میدهد و mgr گلوگاه میشود. ceph-exporter این بار را بین میزبانها پخش میکند. وقتی هر دو فعالاند، شمارندههای per-daemon را فقط از یکی scrape کنید تا سریهای تکراری نداشته باشید (در cephadm، ceph-exporter سرویس جداگانهای با نام ceph-exporter است؛ وضعیت آن را با ceph orch ls ceph-exporter ببینید).
دقت زمانی#
عدد Prometheus در بدترین حالت قدیمیتر از scrape_interval بهعلاوهی دورهی جمعآوری (۵ ثانیه) است. با scrape هر ۱۵ ثانیه، یک spike سهثانیهای ممکن است فقط بهصورت افزایش کوچکی در rate() دیده شود. برای عیبیابی لحظهای، مستقیم از ceph daemon osd.N perf dump یا ceph tell osd.N dump_historic_ops (فصل ۲۲) استفاده کنید، نه از داشبورد.
ceph daemon osd.3 perf schema | jq '.osd.op_r_latency' # type، priority، units
ceph daemon osd.3 perf dump | jq '.osd.op_r_latency' # avgcount، sum، avgtime
ceph daemon osd.3 counter dump | jq 'keys' | head # شمارندههای برچسبدار (نسخههای جدیدتر)
curl -s localhost:9926/metrics | grep -m3 ceph_osd_op_r_latency
ceph config get mgr mgr_stats_period۲۰-۷ پایش با عدد: هیستوگرام، cache و سه قاعدهی هشدار#
این بخش پنج الگوریتم کوچک پشتهی پایش را با عدد بررسی میکند. دو الگوریتم درون خود Ceph هستند: هیستوگرام دوبعدی perf counterها و cache ماژول prometheus در mgr. سه الگوریتم دیگر قواعد هشدار پیشفرض بستهی monitoring/ceph-mixin هستند که cephadm همراه Prometheus مستقر میکند. همهی ارجاعها به شاخهی main در نوامبر ۲۰۲۶ است. متن قواعد هشدار در نسخههای مختلف بارها تغییر کرده است، پس فایل prometheus_alerts.yml نسخهی خودتان را با این متن مقایسه کنید. عددهای مثال با بازپیادهسازی پایتونی همین منطق حساب شدهاند. در مورد rate() و predict_linear() در Prometheus، پیادهسازی ما یک تقریب از منطق Prometheus است.
۲۰-۷-۱ هیستوگرام دوبعدی تأخیر و اندازه#
منبع در کد: src/common/perf_histogram.cc :: PerfHistogramCommon::get_bucket_for_axis، get_axis_bucket_ranges؛ src/osd/osd_perf_counters.cc :: op_hist_x_axis_config، op_hist_y_axis_config
پیچیدگی: O(B) برای B bucket در هر محور (B = ۳۲)؛ حافظه B_x × B_y شمارنده
pseudocode
bucket(v, axis):
if v < min: return 0 # bucket صفر: کمتر از min
q = (v − min) / quant
LINEAR: return min(q + 1, buckets − 1)
LOG2: for i in 1 .. buckets−1: if q < 2^(i−1): return i
return buckets − 1 # bucket آخر: هر چیز بزرگتر
محدودهی bucket i در LOG2: [min + 2^(i−2)·quant ، min + 2^(i−1)·quant − 1] (i ≥ 2)
hinc(latency_ns, bytes): counts[bucket_x(latency)][bucket_y(bytes)] += 1OSD دو هیستوگرام از این نوع دارد: op_w_latency_in_bytes_histogram و op_r_latency_out_bytes_histogram. محور x تأخیر است. برچسب آن در کد «Latency (usec)» است، اما مقدار ورودی latency.to_nsec() است و quant برابر ۱۰۰۰۰۰ نانوثانیه، یعنی ۱۰۰ میکروثانیه. محور y اندازهی درخواست است با quant ۵۱۲ بایت. هر دو محور LOG2 و ۳۲ bucket دارند.
مثال عددی. نوشتنی با تأخیر ۱.۵ ms: q = ۱۵۰۰۰۰۰ / ۱۰۰۰۰۰ = ۱۵. کوچکترین i با عدد ۵ است، پس bucket 5 با محدودهی ۸۰۰ تا ۱۶۰۰ میکروثانیه. اندازهی ۴ KiB: q = ۴۰۹۶ / ۵۱۲ = ۸ و i = ۵، یعنی محدودهی ۴۰۹۶ تا ۸۱۹۱ بایت. نوشتن ۴ MiB به bucket 15 میرود. نوشتن ۶۴ KiB به bucket 9 میرود. تأخیر ۱۵۰ µs در bucket 2 (۱۰۰ تا ۲۰۰ µs) و ۳۰ ms در bucket 10 (۲۵.۶ تا ۵۱.۲ ms) است. bucket آخر (۳۱) از ثانیه شروع میشود و در عمل هرگز پر نمیشود. کل هیستوگرام ۳۲ × ۳۲ = ۱۰۲۴ شمارندهی ۶۴ بیتی، یعنی ۸ KiB برای هر OSD و هر جهت است.
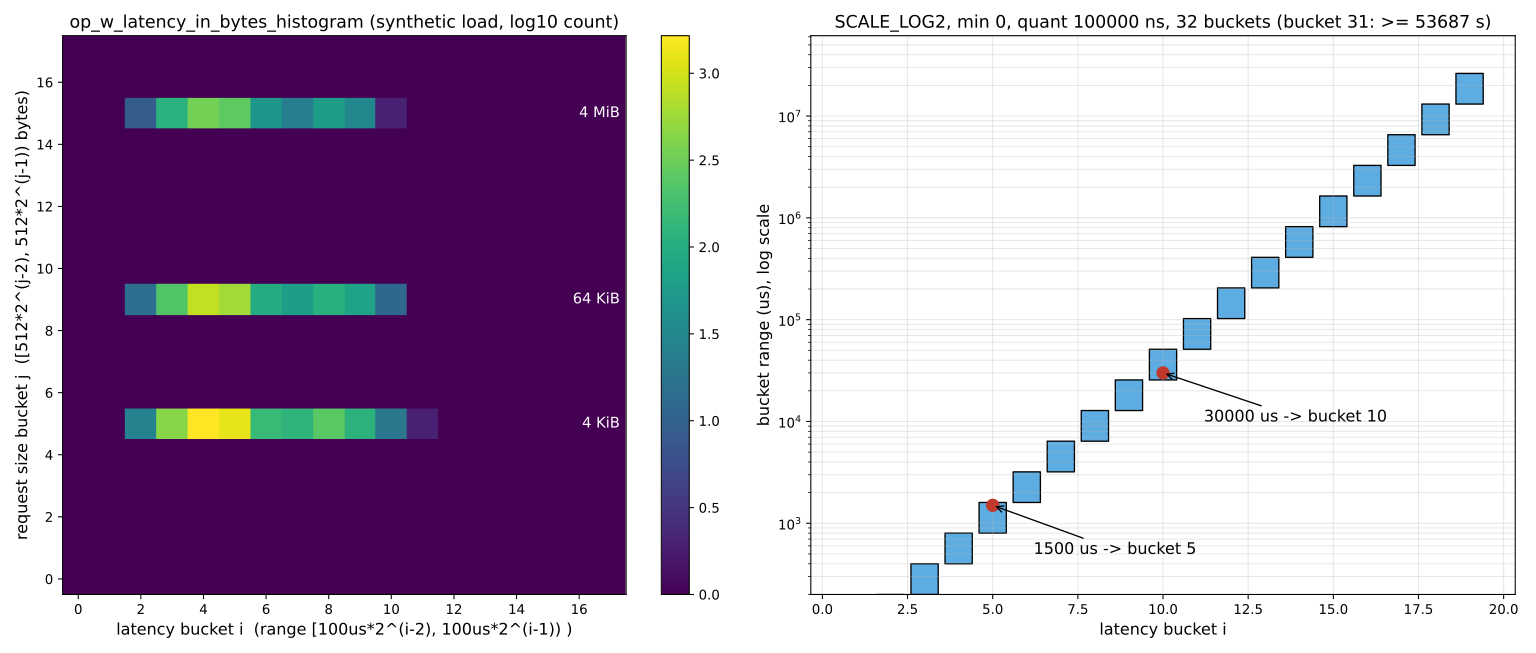
ارزش این هیستوگرام در مقایسه با op_w_latency (که فقط میانگین است) این است که دُم توزیع را نشان میدهد. اگر میانگین تأخیر ۲ ms باشد، نمیدانیم همهی درخواستها ۲ ms هستند یا ۹۵ درصد ۱ ms و ۵ درصد ۲۰ ms. هیستوگرام این را جدا میکند و سطر به سطر نشان میدهد کدام اندازهی درخواست کند است. هیستوگرام از راه admin socket با ceph daemon osd.N perf histogram dump خوانده میشود. در کد main، ماژول prometheus شمارندههای نوع histogram را صریحاً رد میکند (توضیح کد: «they are represented by long running avgs»). ceph-exporter هم شمارندهها را از خروجی counter dump و counter schema میخواند که محل این هیستوگرامها نیست. پس برای p99 در Prometheus باید از ابزار جانبی یا از اسکریپتی استفاده کرد که dump را میخواند.
۲۰-۷-۲ cache ماژول prometheus#
منبع در کد: src/pybind/mgr/prometheus/module.py :: MetricCollectionThread.collect، Module.config_notify، Root.metrics
پیچیدگی: O(۱) برای هر scrape (پاسخ از cache)؛ جمعآوری O(OSD + PG + pool) در thread جدا
pseudocode
thread جمعآوری (اگر cache = true):
loop: start = now ; data = collect() ; d = now − start
collect_cache = data ; collect_time = d
sleep(max(0, scrape_interval − d)) # اگر d > interval: هشدار در لاگ و بدون خواب
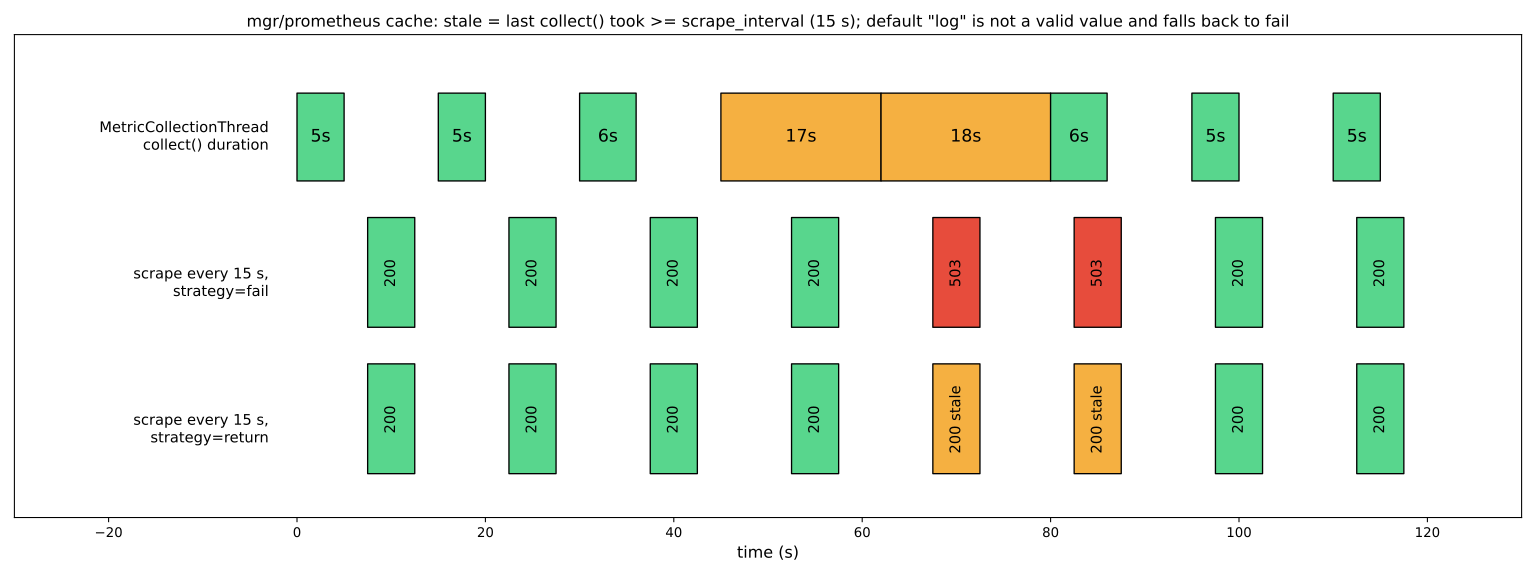
config: اگر stale_cache_strategy ∉ {fail, return}: strategy = fail # پیشفرض گزینه «log» است
GET /metrics:
if collect_cache خالی: 503
if collect_time < scrape_interval: 200 با cache
if strategy == return: 200 با cache کهنه (و پیام در لاگ)
if strategy == fail: 503دو نکتهی کمتر شناختهشده در این کد هست. اول، «کهنه بودن» بر اساس مدت آخرین جمعآوری سنجیده میشود، نه بر اساس سن cache. اگر آخرین collect() ۱۷ ثانیه طول کشیده باشد و scrape_interval برابر ۱۵ ثانیه باشد، cache کهنه حساب میشود، حتی اگر همین یک ثانیه پیش بهروز شده باشد. دوم، مقدار پیشفرض گزینهی stale_cache_strategy در تعریف گزینه «log» است. این مقدار در فهرست مقادیر معتبر نیست و هنگام بارگذاری پیکربندی به fail تبدیل میشود. مستندات هم میگوید رفتار پیشفرض پاسخ ۵۰۳ است. پس عملاً پیشفرض fail است.
مثال عددی. با scrape_interval = ۱۵ ثانیه، فرض کنید مدت جمعآوریها ۵، ۵، ۶، ۱۷، ۱۸، ۶ و ۵ ثانیه باشد (مثلاً هنگام peering گسترده). جمعآوریهای ۱۷ و ۱۸ ثانیهای بدون خواب پشت هم اجرا میشوند. scrapeهای Prometheus که پس از پایان این دو جمعآوری و پیش از پایان جمعآوری ۶ ثانیهای بعدی میرسند، در حالت fail پاسخ ۵۰۳ میگیرند. در شبیهسازی ما، دو scrape متوالی (در ثانیهی ۷۰ و ۸۵) ۵۰۳ میشوند. Prometheus هشدار up == 0 یا «target down» را برای mgr میبیند، در حالی که mgr سالم است و فقط کند است. در حالت return همان دو scrape دادهی کهنه میگیرند و هیچ شکافی در نمودارها دیده نمیشود. برای کلاسترهای بزرگ (مستندات عدد بیش از ۱۰۰۰ OSD را ذکر میکند)، یا scrape_interval ماژول را بالا ببرید و با Prometheus هماهنگ کنید، یا strategy را return بگذارید.
۲۰-۷-۳ قاعدهی CephOSDFlapping#
منبع در کد: monitoring/ceph-mixin/prometheus_alerts.yml :: CephOSDFlapping
پیچیدگی: O(n) برای n نمونه در پنجرهی ۵ دقیقه برای هر OSD
pseudocode
expr: (rate(ceph_osd_up[5m]) × on(cluster, ceph_daemon) group_left(hostname) ceph_osd_metadata) × 60 > 1
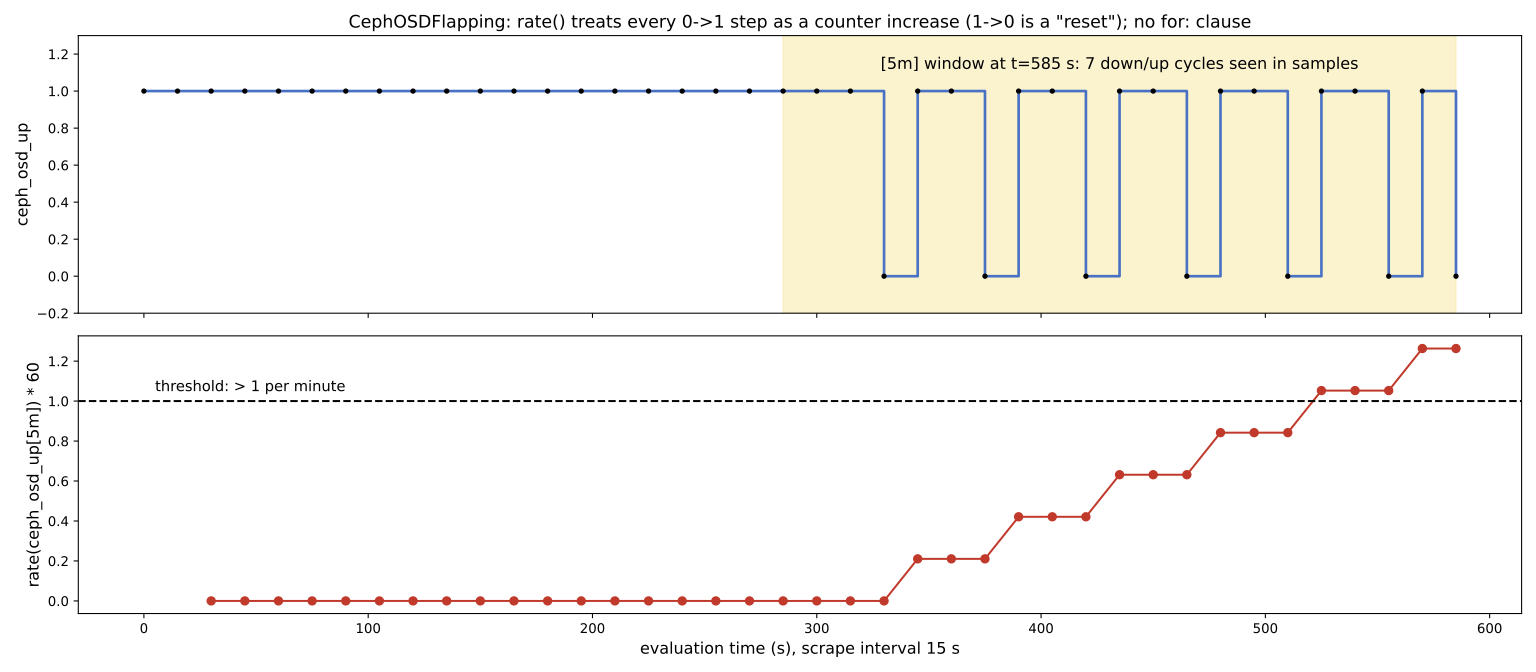
rate روی نمونهها: increase = Σ (v_i − v_{i−1} اگر v_i ≥ v_{i−1} ، وگرنه v_i) # افت 1→0 «reset» است و 0 اضافه میکند
هر گذار 0→1 یک واحد افزایش است
increase برونیابی به لبههای پنجره ؛ تقسیم بر 300 ثانیه
×60 ⇒ تعداد «بالا آمدن» در دقیقه ؛ هشدار اگر بیش از 1 (بدون for:)ceph_osd_up یک gauge با مقدار ۰ یا ۱ است، اما قاعده rate() را روی آن به کار میبرد که برای counter ساخته شده است. نتیجه کار میکند، چون rate() هر افت را reset تلقی میکند و هر صعود از ۰ به ۱ را یک واحد افزایش حساب میکند. پس rate × ۶۰ تقریباً تعداد دفعاتی است که OSD در هر دقیقه دوباره up شده است.
مثال عددی. Prometheus هر ۱۵ ثانیه نمونه میگیرد. OSD در فاصلهی ثانیهی ۳۳۰ تا ۵۸۵ هفت بار down و دوباره up دیده میشود (هر بار در یک نمونه ۰ است). در ارزیابی ثانیهی ۵۸۵، پنجرهی [۲۸۵، ۵۸۵] بیست نمونه و هفت افزایش دارد. برونیابی Prometheus آن را حدود ۷ × ۳۰۰ / ۲۸۵ ≈ ۷.۴ میکند، و rate × ۶۰ ≈ ۱.۲۶ > ۱ است. هشدار فوراً فعال میشود. دو محدودیت مهم دارد. اول، OSDی که بین دو نمونه down و up شود (کمتر از ۱۵ ثانیه) دیده نمیشود. دوم، شش flap در پنج دقیقه هنوز ممکن است زیر آستانه بماند. برای دید دقیقتر، ceph osd stat و لاگ mon (پیامهای «wrongly marked me down») قابل اعتمادترند.
۲۰-۷-۴ قاعدهی CephPGImbalance#
منبع در کد: monitoring/ceph-mixin/prometheus_alerts.yml :: CephPGImbalance
پیچیدگی: O(N) برای N OSD در هر ارزیابی
pseudocode
x_o = ceph_osd_numpg{o} (فقط اگر > 0) با برچسب device_class از ceph_osd_metadata
avg_c = میانگین x_o روی OSDهای همان (cluster, job, device_class)
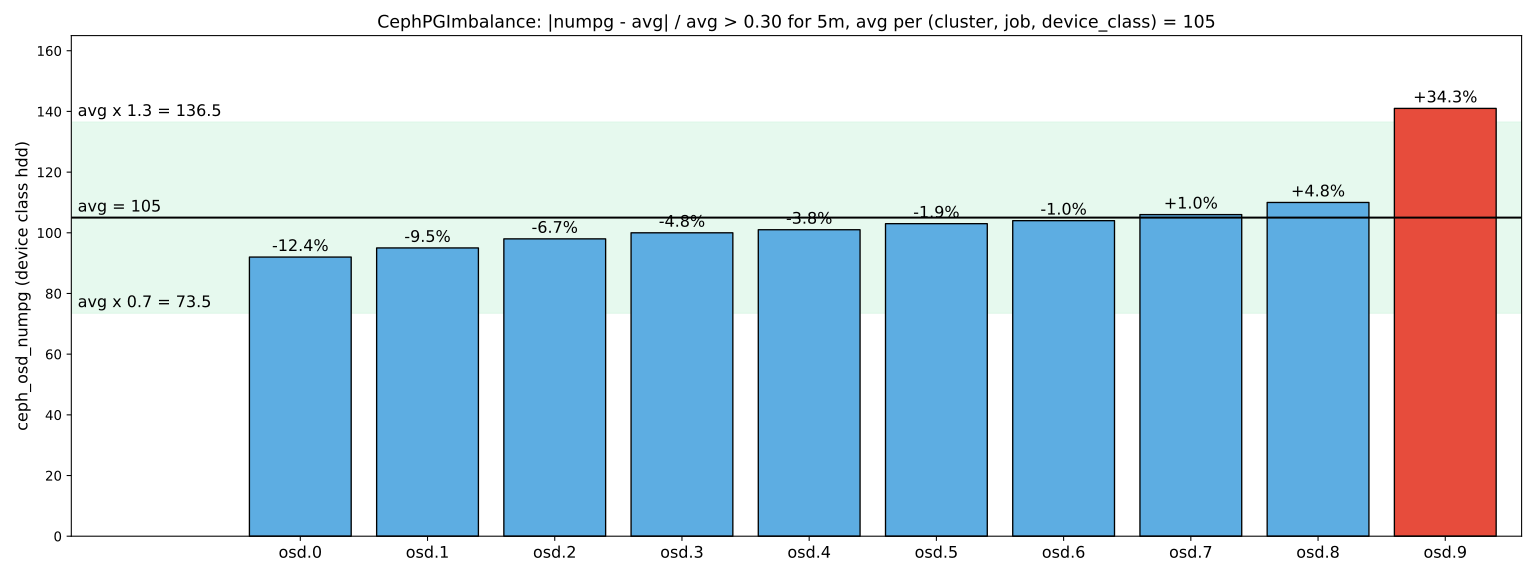
هشدار اگر |x_o − avg_c| / avg_c > 0.30  به مدت 5 دقیقه (for: 5m)
مثال عددی. ده OSD در کلاس hdd به ترتیب ۹۲، ۹۵، ۹۸، ۱۰۰، ۱۰۱، ۱۰۳، ۱۰۴، ۱۰۶، ۱۱۰ و ۱۴۱ PG دارند. میانگین ۱۰۵ است و باند مجاز ۷۳.۵ تا ۱۳۶.۵. osd.9 با ۱۴۱ PG حدود ۳۴.۳ درصد بالاتر از میانگین است و پس از پنج دقیقه هشدار میگیرد. osd.0 با ۱۲.۴ درصد کمتر از میانگین در باند است. دو نکته: OSD با صفر PG (مثلاً تازه اضافهشده یا out) با فیلتر > 0 از محاسبه کنار میرود و خودش هشدار نمیگیرد. همچنین آستانهی ۳۰ درصد بسیار گشادهتر از هدف balancer است. balancer در حالت upmap تلاش میکند انحراف هر OSD از هدف به حدود چند PG برسد (فصل ۱۹). پس اگر این هشدار فعال شد، معمولاً balancer خاموش است یا نمیتواند کار کند، مثلاً به دلیل وزنهای نادرست CRUSH یا OSDهای تقریباً پر.
۲۰-۷-۵ قاعدهی CephPoolGrowthWarning#
منبع در کد: monitoring/ceph-mixin/prometheus_alerts.yml :: CephPoolGrowthWarning؛ Prometheus :: predict_linear
پیچیدگی: O(n) برای n نمونه در پنجرهی ۲ روزه
pseudocode
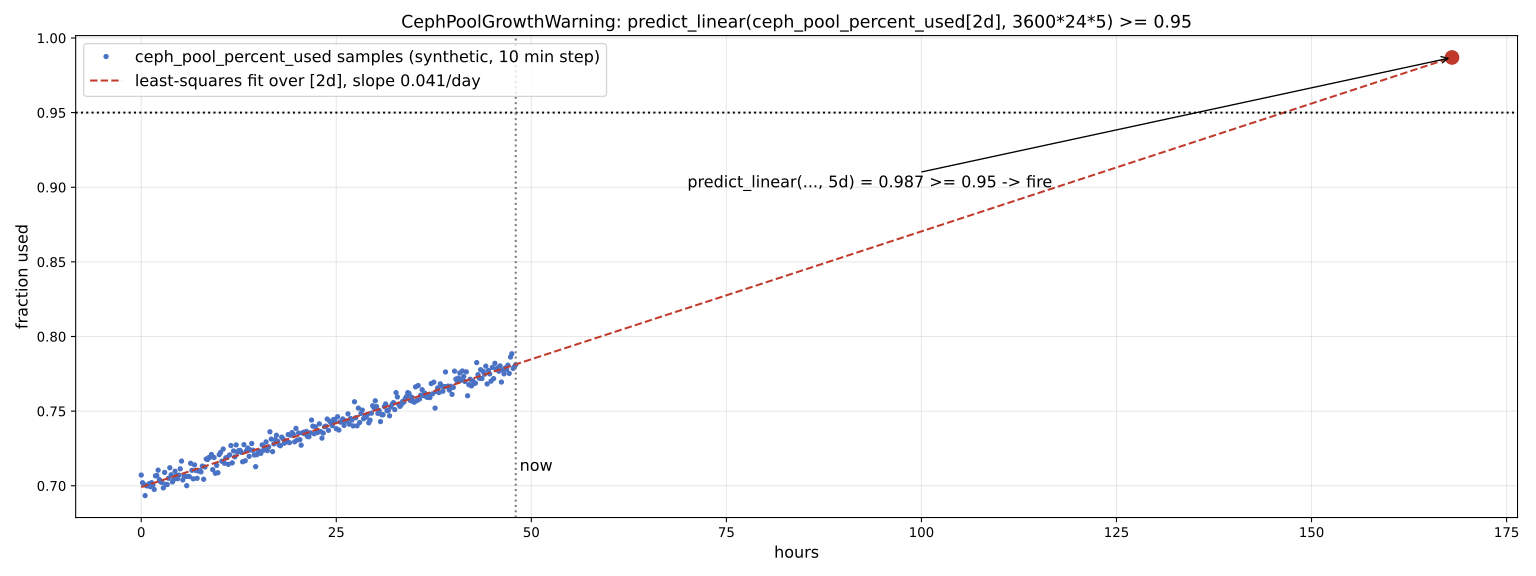
expr: (predict_linear(ceph_pool_percent_used[2d], 3600 × 24 × 5) × on(cluster, pool_id, instance) group_right() ceph_pool_metadata) ≥ 0.95
predict_linear: (a, b) = کمترین مربعات روی نمونههای 48 ساعت گذشته ، با t نسبت به زمان ارزیابی
خروجی a + b × 432000 # مقدار پیشبینیشده 5 روز بعد
هشدار اگر خروجی ≥ 0.95 (بدون for:)مثال عددی. pool در دو روز گذشته از ۷۰ درصد به ۷۸ درصد رسیده است، یعنی شیب ۰.۰۴ در روز. نمونهها هر ۱۰ دقیقه گرفته شدهاند. بدون نویز، پیشبینی ۵ روز بعد ۰.۷۸ + ۵ × ۰.۰۴ = ۰.۹۸ است که از ۰.۹۵ بیشتر است و هشدار فعال میشود. با نویز مصنوعی (انحراف معیار ۰.۰۰۴) خروجی ۰.۹۸۷ شد. هشدار یعنی «با این روند، پنج روز دیگر pool پر است»، نه اینکه الان پر است. برعکس، اگر رشد ناگهانی در دو ساعت آخر رخ داده باشد، رگرسیون روی ۴۸ ساعت آن را رقیق میکند و هشدار دیر میآید. توجه کنید که ceph_pool_percent_used به max_avail وابسته است. max_avail با پرترین OSD زیر CRUSH rule آن pool محاسبه میشود. بنابراین عدم توازن داده، percent_used را بالا میبرد و این هشدار را زودتر فعال میکند.
۲۰-۸ mgmt-gateway: یک درِ ورودی#
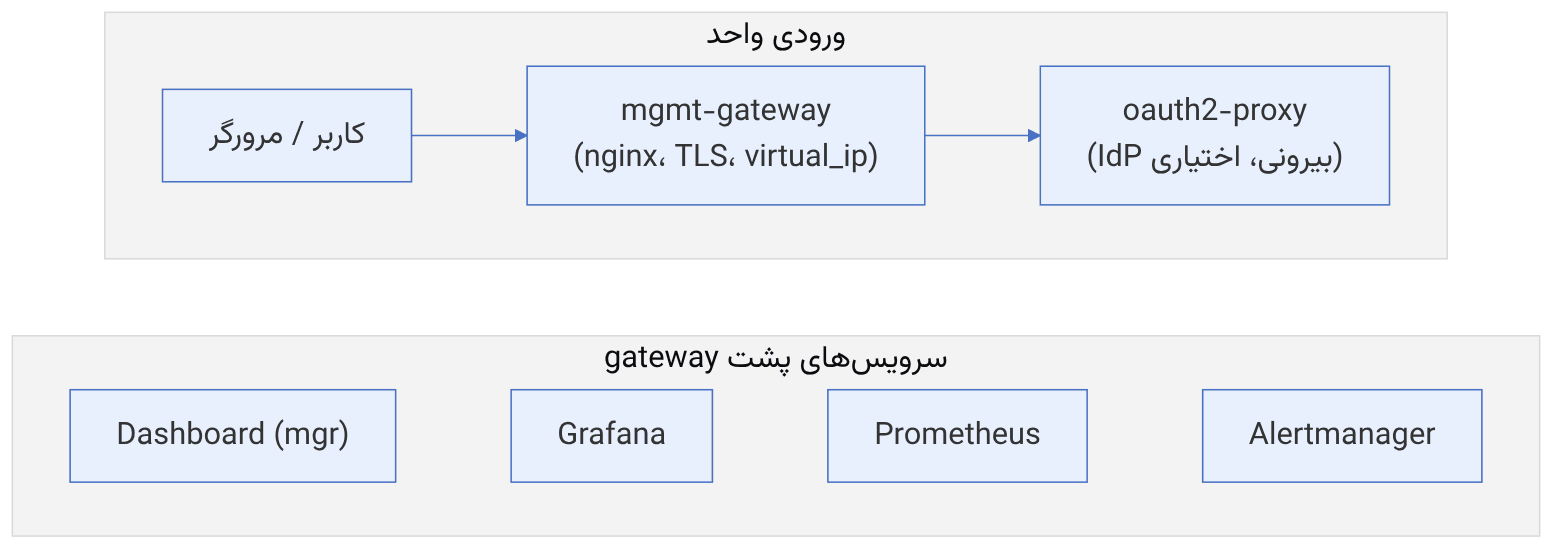
در استقرارهای پیش از Tentacle، Dashboard، Grafana، Prometheus و Alertmanager هر کدام پورت و گواهی جدا داشتند و کاربر باید به چند نشانی دسترسی داشت. mgmt-gateway (سرویس cephadm مبتنی بر nginx) همه را پشت یک نقطهی ورود با TLS قرار میدهد و با oauth2-proxy میتواند احراز هویت را به یک IdP بیرونی (OIDC) بسپارد.
ceph orch apply mgmt-gateway --placement="label:mgmt"
# با نشانی مجازی و احراز هویت (طبق مستندات mgmt-gateway)
ceph orch apply mgmt-gateway --virtual_ip 192.0.2.50 --enable-auth=true --placement="label:mgmt"
ceph orch apply oauth2-proxy -i oauth2-proxy.yaml
ceph orch ls | grep -E "mgmt-gateway|oauth2"طبق مستندات، نشانی virtual_ip در mgmt-gateway باید IP ساده باشد و برای دسترسیپذیری بالا همراه سرویس ingress با همان IP (با پیشوند شبکه) به کار میرود؛ oauth2-proxy بیحالت است و میتواند چند نمونه داشته باشد. پس از استقرار gateway، endpointهای پشتهی پایش (از جمله service discovery) امن (https) میشوند.
Prometheus و Alertmanager را مستقیماً در معرض شبکهی کاربران قرار ندهید: مستندات monitoring یادآوری میکند که مدل امنیتی Prometheus فرض میکند کاربران نامطمئن به endpoint و دادهها دسترسی دارند و API فقطخواندنی آن همهی (فرا)دادههای جمعآوریشده را آشکار میکند. gateway یا فایروال لازم است.
۲۰-۹ log و رویدادها#
- log کلاستر در MON:
ceph log last 200، و پیگیری زنده با ceph -w؛ کانال cephadm با ceph -W cephadm. - log daemonها در cephadm به journald میروند:
cephadm logs --name osd.3 یا journalctl -u ceph-<fsid>@osd.3؛ برای نوشتن در فایل ceph config set global log_to_file true. - crashها با ماژول crash جمع میشوند و در هشدار RECENT_CRASH ظاهر میشوند؛
ceph crash ls، ceph crash info <id>، ceph crash archive-all. - telemetry (اختیاری و با رضایت): ارسال آمار ناشناس به پروژه؛ پیشنمایش با
ceph telemetry preview (فصل ۹).
برای جمعآوری متمرکز log، journald میزبانها را با ابزار انتخابی سازمان (مثلاً یک عامل جمعآوری log) به سامانهی مرکزی بفرستید و برچسب fsid و نام daemon را حفظ کنید تا بتوانید log را با متریکها و هشدارها همزمان کنید.
۲۰-۱۰ داشبوردها و SLO#
داشبوردهای ceph-mixin (کلاستر، میزبان، OSD، pool، RGW، RBD، CephFS) همراه Grafana مستقر میشوند. برای راهبری سرویس، علاوه بر آنها چند نمای سطح سرویس بسازید:
| SLI | تعریف نمونه | منبع |
|---|---|---|
| دسترسپذیری RBD | درصد زمانی که همهی PGهای pool فعالاند | ceph_pg_active / ceph_pg_total برای pool |
| تأخیر نوشتن | صدک ۹۹ تأخیر نوشتن OSD یا کلاینت | ceph-exporter (و شمارندههای librbd در صورت فعال بودن) |
| دسترسپذیری S3 | نسبت پاسخهای غیر ۵xx در RGW | log دسترسی RGW یا شمارندههای rgw |
| RPO mirroring | اختلاف timestamp محلی و راه دور تصاویر | متریکهای ceph_rbd_mirror_snapshot_* |
- پشتهی پایش را با cephadm مستقر و ceph-exporter را روی همهی میزبانها فعال کنید.
- همهی mgrها یا service discovery را برای scrape تعریف کنید تا failover نقطهی کور نسازد.
- میانگین تأخیر را از نسبت rate شمارندهها حساب کنید، نه از مقدار خام.
- قواعد محلی را با runbook همراه کنید و آستانه را از رفتار واقعی بگیرید.
- Prometheus و Alertmanager را پشت mgmt-gateway یا فایروال نگه دارید.
۲۰-۱۱ تکمیلی و بهروز#
- انتقال perf counters از ماژول prometheus به ceph-exporter (پیشفرض
exclude_perf_counters) مهمترین تغییر معماری پایش از ۲۰۱۹ است؛ در آن سالها پایش بیشتر بر Calamari و ابزارهای جانبی تکیه داشت که امروز جای خود را به Dashboard و پشتهی Prometheus دادهاند. - mgmt-gateway و oauth2-proxy در Tentacle آمدهاند.
- قواعد سختافزاری (منبع تغذیه، خنککننده، NVMe) و NVMe-oF به ceph-mixin افزوده شدهاند.
۲۰-۱۲ تمرین عملی#
- ۱. پشتهی پایش را با cephadm مستقر کنید و همهی هدفها را در صفحهی Targets پرومتئوس سالم ببینید.
- ۲. با
ceph daemon osd.N counter dump و curl روی پورت ceph-exporter، یک شمارنده را در هر دو شکل مقایسه کنید. - ۳. قاعدهی CephWriteLatencyHigh را اضافه کنید و با
tc netem روی شبکهی cluster آن را فعال کنید. - ۴. یک قاعدهی inhibit برای CephOSDHostDown و CephOSDDown بنویسید و با خاموش کردن یک میزبان آزمایش کنید.
- ۵. mgr فعال را با
ceph mgr fail جابهجا کنید و پیوستگی سریهای زمانی را بررسی کنید. - ۶. mgmt-gateway را مستقر کنید و دسترسی مستقیم به پورت Prometheus را با فایروال ببندید.
۲۰-۱۳ پرسشهای مرور#
- ۱. چرا perf counters از ماژول prometheus به ceph-exporter منتقل شدند؟
- ۲. چرا باید همهی mgrها یا service discovery را برای scrape تعریف کرد؟
- ۳. اولویت شمارنده و exporter_prio_limit چه رابطهای دارند؟
- ۴. میانگین تأخیر یک بازه از شمارندهی time_avg چگونه محاسبه میشود؟
- ۵. متریک ceph_health_detail چه کاربردی دارد؟
- ۶. نقش for در قاعدهی هشدار چیست؟
- ۷. inhibit در Alertmanager چه مشکلی را حل میکند؟
- ۸. mgmt-gateway چه مزایایی دارد؟
- ۹. چرا Prometheus نباید مستقیماً در معرض کاربران باشد؟
- ۱۰. چند SLI مناسب برای سرویس RBD نام ببرید.
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۰-۱۴ منابع این فصل#
- Monitoring overview
https://docs.ceph.com/en/latest/monitoring/ - cephadm monitoring services
https://docs.ceph.com/en/latest/cephadm/services/monitoring/ - Prometheus manager module
https://docs.ceph.com/en/latest/mgr/prometheus/ - mgmt-gateway
https://docs.ceph.com/en/latest/cephadm/services/mgmt-gateway/ - oauth2-proxy
https://docs.ceph.com/en/latest/cephadm/services/oauth2-proxy/ - Ceph Dashboard
https://docs.ceph.com/en/latest/mgr/dashboard/ - Crash module
https://docs.ceph.com/en/latest/mgr/crash/ - ceph-mixin alerts
https://github.com/ceph/ceph/blob/main/monitoring/ceph-mixin/prometheus_alerts.yml - Source: src/common/perf_counters.h
https://github.com/ceph/ceph/blob/main/src/common/perf_counters.h - Source: src/common/options/ceph-exporter.yaml.in
https://github.com/ceph/ceph/blob/main/src/common/options/ceph-exporter.yaml.in - Prometheus security model
https://prometheus.io/docs/operating/security/