Ceph از درون: CRUSH، نقشهها، احراز هویت و PGها
حوصله ندارم این فصل در چند خط
- CRUSH جای جدول مرکزی را میگیرد: سلسلهمراتبی از bucketها بههمراه قانونها، OSDهای هر PG را محاسبه میکند و کلاینت خودش داده را پیدا میکند.
- شیء با hash به یک PG و PG به OSDهایی در دامنههای خرابی متفاوت نگاشت میشود؛ هر تغییر نقشهها با یک epoch نسخهگذاری میشود.
- tunableها رفتارهای قدیمی CRUSH را اصلاح میکنند اما نگاشت را تغییر میدهند، پس فعال کردنشان داده جابهجا میکند.
- cephx احراز هویت دوطرفهای شبیه Kerberos با ticketهای زماندار است؛ device class یک pool را روی OSDهای انتخابی مینشاند.
۸-۱ پیش از شروع#
۸-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
تا اینجا Ceph را از بیرون دیدیم: دستورها، سرویسها و رابطها. این فصل به درون میرود. هر تصمیم مهم در طراحی و عیبیابی Ceph (چرا داده آنجاست، چرا PG گیر کرده، چرا یک قانون CRUSH جواب نمیدهد) به چند سازوکار پایه برمیگردد که در این فصل بررسی میکنیم:
- داده چطور بدون جدول مرکزی جای خودش را پیدا میکند؟
- نقشهی CRUSH چه ساختاری دارد و قانونها را چطور بنویسیم؟
- tunableها چه هستند و چرا هشدار «non-optimal tunables» میآید؟
- نقشههای کلاستر کداماند و MONها چطور دسترسپذیر میمانند؟
- cephx چطور کار میکند و capabilityها را چطور محدود کنیم؟
- مسیر یک نوشتن از کلاینت تا دیسک چیست و PGها چه حالتهایی دارند؟
- چطور یک pool را روی OSDهای خاص قرار دهیم؟
۸-۲ مقیاسپذیری بدون جدول مرکزی#
۸-۲-۱ مسئلهی جاشناسی#
بیشتر سامانههای ذخیرهسازی توزیعشدهی قدیمی یک سرور فراداده یا جدول جستوجو داشتند که میگفت هر بلوک کجاست. این جدول در مقیاس بزرگ سه مشکل دارد: گلوگاه کارایی میشود، نقطهی شکست واحد است و با هر تغییر سختافزار باید بهروز شود. Ceph این جدول را حذف کرده است: هر کلاینت و هر OSD خودش محل داده را محاسبه میکند. ورودیهای این محاسبه فقط نام شیء، شناسهی pool و نقشهی کلاستر هستند که همه آن را دارند.
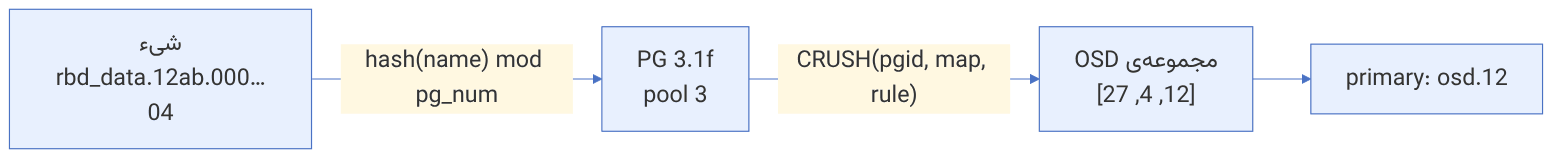
۸-۲-۲ دو مرحلهی نگاشت#
- ۱. شیء به PG: نام شیء hash میشود و باقیماندهی آن بر تعداد PGهای pool (بهصورت دقیقتر با الگوریتم stable mod) شمارهی PG را میدهد. شناسهی PG ترکیب شمارهی pool و شمارهی PG است، مثل
3.1f. - ۲. PG به OSD: الگوریتم CRUSH با ورودی شناسهی PG، نقشهی CRUSH و قانون pool، فهرست مرتبی از OSDها را برمیگرداند. اولین OSD فعال، primary است.
ceph osd map rbd rbd_data.12ab.0000000000000004
# osdmap e1234 pool 'rbd' (3) object '...' -> pg 3.8c7e1b1f (3.1f) -> up ([12,4,27], p12) acting ([12,4,27], p12)
ceph pg map 3.1fچرا لایهی میانی PG؟ اگر CRUSH را مستقیماً روی هر شیء اجرا میکردیم، کلاستر برای هر شیء باید وضعیت تکثیر، بازیابی و scrub را جداگانه پیگیری میکرد؛ برای میلیاردها شیء غیرممکن است. PGها اشیا را به چند هزار گروه تقسیم میکنند و همهی سازوکارهای حفاظت داده (peering، log، بازیابی، scrub) در سطح PG کار میکنند. تعداد PG یک مصالحه است: کم باشد، توزیع ناهموار میشود؛ زیاد باشد، حافظه و CPU OSDها و بار peering بالا میرود.
۸-۲-۳ up و acting#
up set خروجی خالص CRUSH است. acting set مجموعهای است که واقعاً به درخواستها پاسخ میدهد. این دو معمولاً یکساناند؛ تفاوتشان یعنی Ceph موقتاً از OSDهای دیگری استفاده میکند (مثلاً pg_temp در حین backfill تا OSD جدید داده را کامل بگیرد) یا یک upmap صریح، نتیجهی CRUSH را برای آن PG تغییر داده است.
۸-۳ سازوکار CRUSH#
۸-۳-۱ سلسلهمراتب#
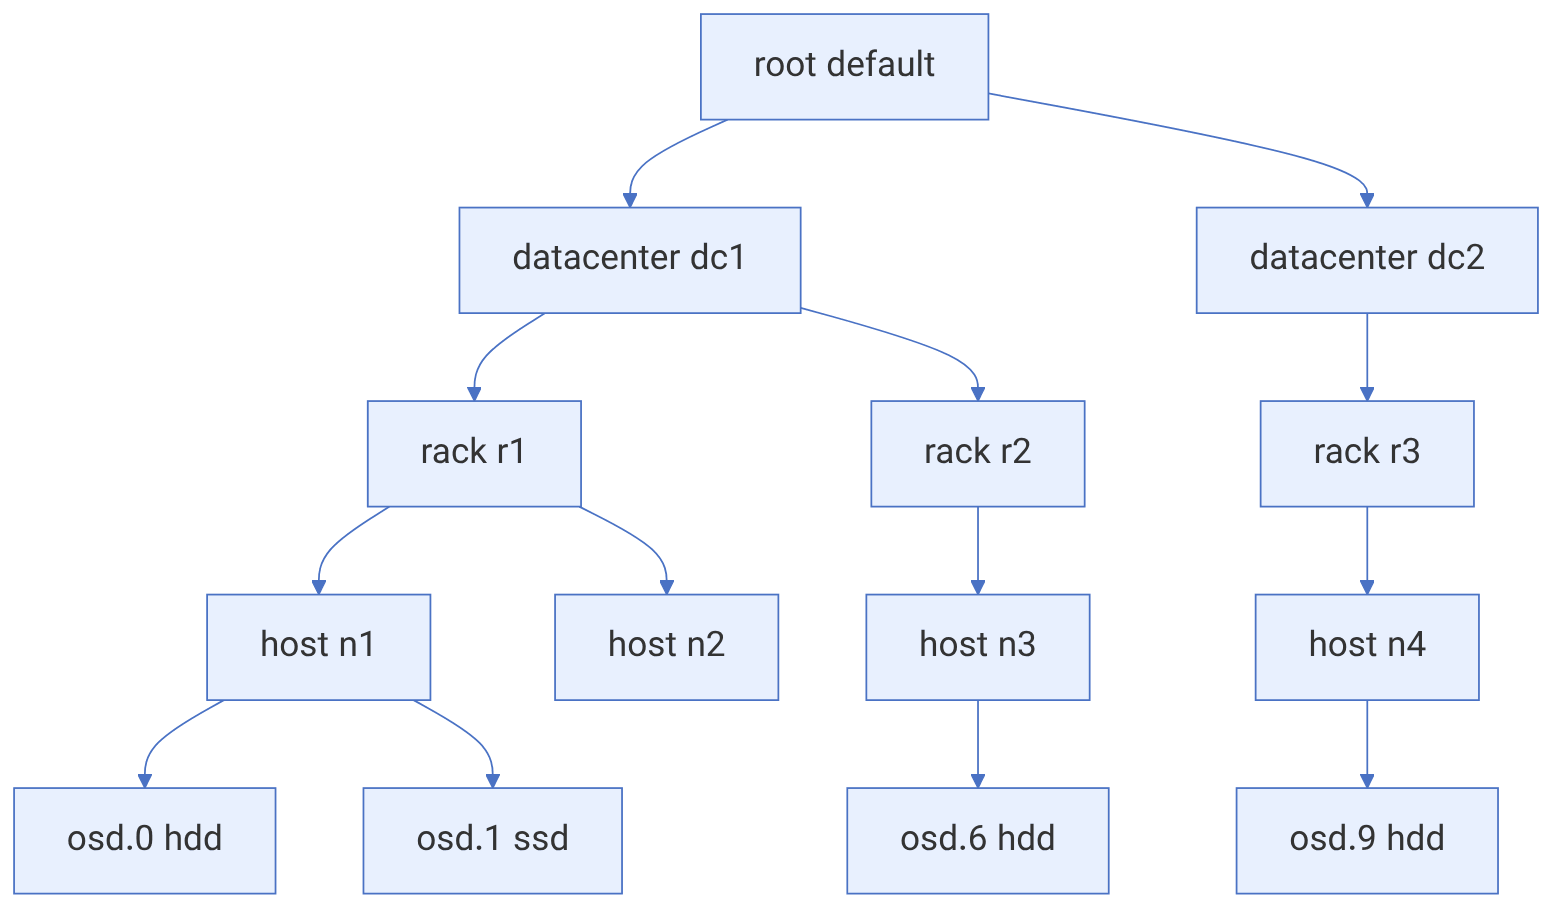
نقشهی CRUSH از دو بخش تشکیل شده است: سلسلهمراتب (درختی از bucketها که مکان فیزیکی هر OSD را نشان میدهد) و قانونها (rules) که میگویند نسخهها را چطور در این درخت پخش کنیم. انواع پیشفرض bucket از پایین به بالا عبارتاند از osd، host، chassis، rack، row، pdu، pod، room، datacenter، zone، region و root. لازم نیست از همه استفاده کنید؛ فقط سطوحی را تعریف کنید که واقعاً دامنهی خرابی مستقلاند.
ceph osd crush tree --show-shadow
ceph osd crush add-bucket rack1 rack
ceph osd crush move rack1 root=default
ceph osd crush move ceph-node1 rack=rack1
ceph osd crush set-device-class nvme osd.20
ceph osd crush class lsبا cephadm میتوانید مکان CRUSH میزبان را در spec میزبان (location: {rack: rack1}) تعیین کنید تا OSDهای تازه مستقیماً زیر rack درست قرار بگیرند. در غیر این صورت هر OSD زیر host و مستقیماً زیر root=default میرود و پس از جابهجایی دستی، داده یک بار دیگر حرکت میکند.
۸-۳-۲ وزن#
هر OSD یک وزن CRUSH دارد (بهطور پیشفرض برابر ظرفیت به ترابایت) و وزن هر bucket مجموع وزن فرزندان آن است. CRUSH داده را به نسبت وزن پخش میکند. وزن دیگری به نام reweight (بین ۰ و ۱) هم وجود دارد که برای اصلاح موقت توزیع به کار میرفت؛ امروز balancer با upmap این کار را دقیقتر انجام میدهد.
ceph osd crush reweight osd.20 3.49309     # وزن دائمی CRUSH
ceph osd reweight 20 0.9                   # اصلاح موقت (ترجیحاً از balancer استفاده کنید)
۸-۳-۳ الگوریتم bucket#
CRUSH برای انتخاب فرزند در هر bucket الگوریتمی دارد. امروز عملاً فقط straw2 استفاده میشود (از Hammer، پیشفرض bucketهای تازه). مزیت کلیدی straw2 این است که تغییر وزن یک آیتم فقط داده را بین آن آیتم و بقیه جابهجا میکند، نه بین آیتمهای دیگر؛ یعنی حداقل جابهجایی لازم.
۸-۳-۴ قانونها#
قانون CRUSH مراحل انتخاب را تعریف میکند. بیشتر وقتها لازم نیست قانون را دستی بنویسید؛ دستورهای کمکی کافیاند:
# تکثیری: نسخهها در hostهای مختلف، فقط روی SSD
ceph osd crush rule create-replicated rep-ssd-host default host ssd
# تکثیری با دامنهی خرابی rack
ceph osd crush rule create-replicated rep-rack default rack
# EC از روی پروفایل
ceph osd erasure-code-profile set ec42-rack k=4 m=2 crush-failure-domain=rack crush-device-class=hdd
ceph osd crush rule create-erasure ec42-rack ec42-rack
ceph osd crush rule ls
ceph osd crush rule dump rep-ssd-hostبرای حالتهای پیچیدهتر، نقشه را استخراج، ویرایش و پیش از اعمال آزمایش کنید:
ceph osd getcrushmap -o crush.bin
crushtool -d crush.bin -o crush.txt
# ویرایش crush.txt
crushtool -c crush.txt -o crush.new
crushtool -i crush.new --test --rule 1 --num-rep 3 --show-statistics --show-bad-mappings
ceph osd setcrushmap -i crush.newنمونهی یک قانون دستی که دو نسخه را در یک datacenter و نسخهی سوم را در datacenter دیگر میگذارد:
rule rep-2dc {
    id 5
    type replicated
    step take default
    step choose firstn 2 type datacenter
    step chooseleaf firstn 2 type host
    step emit
}قانون بالا با size=3 دو نسخه در datacenter اول و یک نسخه در دومی میگذارد، اما کدام datacenter دو نسخه میگیرد برای هر PG متفاوت است. اگر میخواهید هر دو سایت قطعاً نسخه داشته باشند و نوشتن هنگام قطع یک سایت ادامه یابد، به جای قانون دستی از stretch mode (فصل ۱۸) استفاده کنید که منطق quorum و min_size را هم مدیریت میکند.
Squid نوع تازهای از قانون به نام MSR (Multi-Step Retry) اضافه کرد که به گفتهی یادداشتهای انتشار، پیکربندیهای انعطافپذیرتری برای EC ممکن میکند؛ کاربرد رایج آن قرار دادن کنترلشدهی چند shard در یک دامنهی خرابی است وقتی تعداد دامنهها کمتر از k+m است. چون این نوع قانون در نقشهی CRUSH ثبت میشود، require_min_compat_client هم روی آن اثر دارد؛ پیش از استفاده نسخهی کلاینتها را بررسی کنید.
۸-۳-۵ کلاس دستگاه و shadow tree#
از Luminous هر OSD یک کلاس دستگاه (hdd، ssd، nvme یا هر نام دلخواه) دارد. CRUSH برای هر کلاس یک درخت سایه (shadow) میسازد، مثلاً default~ssd، که فقط OSDهای آن کلاس را دارد. قانونی که کلاس دارد روی همین درخت سایه اجرا میشود. این قابلیت جایگزین ترفند قدیمی کتاب ۲۰۱۹ است که برای جدا کردن SSD و HDD دو root جدا میساخت.
۸-۴ tunableها#
۸-۴-۱ چرا tunable؟#
CRUSH از ابتدا کامل نبود. در برخی سلسلهمراتبها (مثلاً درختهای کوچک یا وقتی OSDهای زیادی out هستند) نمیتوانست برای همهی PGها نسخهی کافی پیدا کند، یا با تغییرات کوچک دادهی زیادی را جابهجا میکرد. اصلاح این رفتارها نتیجهی نگاشت را تغییر میدهد، پس نمیشد آنها را بیصدا اعمال کرد: هر کلاینت باید همان نتیجهای را محاسبه کند که OSDها محاسبه میکنند. راهحل Ceph، tunableهاست: پرچمهایی در نقشهی CRUSH که رفتار الگوریتم را تعیین میکنند و بهصورت پروفایلهایی به نام نسخهها گروهبندی شدهاند.
| پروفایل | ویژگی اصلی | حداقل هستهی کلاینت (طبق مستندات) |
|---|---|---|
| argonaut (legacy) | رفتار اولیه | همه |
| bobtail (CRUSH_TUNABLES۲) | کاهش شکست در یافتن نگاشت و اصلاح retryها | ۳.۹ |
| firefly (CRUSH_TUNABLES۳) | اصلاح رفتار chooseleaf با پیمایش دوباره | ۳.۱۵ |
| hammer (CRUSH_V۴) | bucket نوع straw2 | ۴.۱ |
| jewel (CRUSH_TUNABLES۵) | chooseleaf_stable: جابهجایی کمتر هنگام out شدن OSD | ۴.۵ |
ceph osd crush show-tunables
ceph osd crush tunables optimal # جابهجایی داده دارد!
ceph features # نسخه و قابلیتهای کلاینتهای متصل
ceph osd get-require-min-compat-clientتغییر پروفایل tunable روی کلاستر پرداده، بخش بزرگی از داده را جابهجا میکند. این کار را در ساعات کمبار، با پروفایل mClock مناسب و پس از اطمینان از سازگاری همهی کلاینتها (بهویژه کلاینتهای هستهی قدیمی RBD و CephFS) انجام دهید. کلاسترهایی که با نسخههای جدید ساخته شدهاند از ابتدا tunableهای بهینه دارند و این بخش بیشتر برای کلاسترهای قدیمیِ ارتقایافته اهمیت دارد.
۸-۴-۲ هشدار non-optimal#
اگر tunableهای کلاستر از پروفایل بهینهی نسخهی فعلی عقب باشند، هشدار OLD_CRUSH_TUNABLES نمایش داده میشود. میتوانید آن را با بهروزرسانی tunableها رفع کنید یا، اگر کلاینت قدیمی دارید که نمیتوانید ارتقا دهید، با mon_warn_on_legacy_crush_tunables=false موقتاً خاموش کنید. هشدار مشابه OLD_CRUSH_STRAW_CALC_VERSION هم وقتی ظاهر میشود که نقشه هنوز از نسخهی قدیمی و معیوب محاسبهی وزن در bucketهای straw استفاده کند.
# تبدیل bucketهای straw به straw2 با حداقل جابهجایی
ceph osd crush set-all-straw-buckets-to-straw2۸-۵ نقشههای کلاستر و MONها#
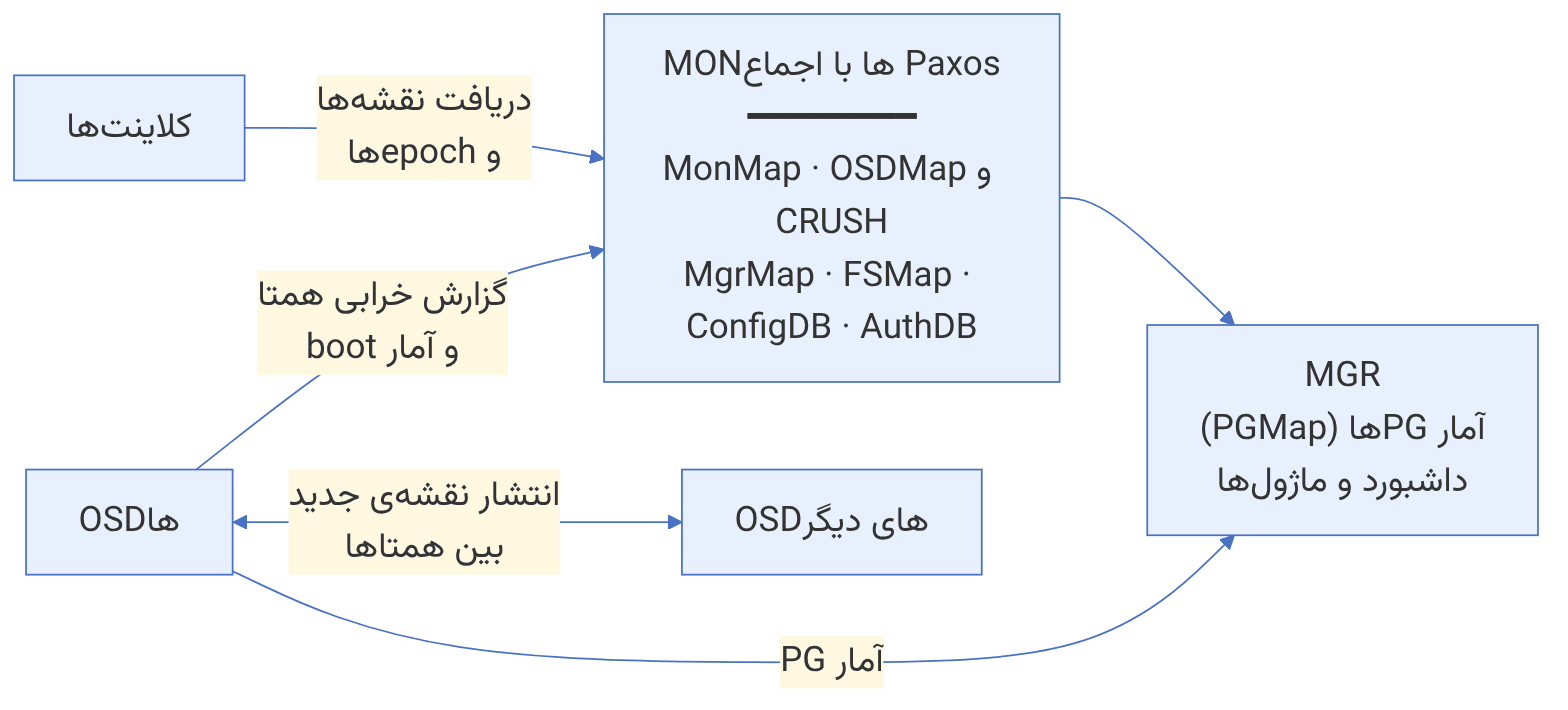
۸-۵-۱ نقشهها#
وضعیت کلاستر در چند نقشه نگهداری میشود که همه با یک epoch (شمارهی نسخهی صعودی) نسخهگذاری شدهاند:
| نقشه | محتوا | دستور مشاهده |
|---|---|---|
| MonMap | fsid، فهرست MONها و آدرسهایشان | ceph mon dump |
| OSDMap | poolها، OSDها و وضعیت up/in، pg_temp و upmapها، پرچمها و نقشهی CRUSH | ceph osd dump |
| MgrMap | MGR فعال، آمادهبهکارها و ماژولها | ceph mgr dump |
| FSMap | فایلسیستمها و MDSها | ceph fs dump |
| PGMap | آمار PGها (در MGR، نه MON) | ceph pg dump |
OSDها نقشهی جدید را لزوماً از MON نمیگیرند: هر پیام بین OSDها و کلاینتها epoch فرستنده را دارد و طرفی که نقشهی جدیدتری دارد، تغییرات (incremental) را برای دیگری میفرستد. این «شایعهپراکنی» (gossip) بار MONها را کم میکند. پیامد عملی: OSDی که مدتی خاموش بوده باید هنگام بالا آمدن همهی epochهای از دست رفته را پردازش کند، و اگر MONها epochهای قدیمی را نگه داشته باشند (مثلاً چون کلاستر مدتها ناسالم بوده) پایگاه دادهی MON بزرگ میشود.
۸-۵-۲ دسترسپذیری MONها#
MONها با الگوریتم Paxos اجماع میکنند: هر تغییر نقشه فقط وقتی معتبر است که اکثریت MONها (quorum) آن را بپذیرند. یکی از MONها leader است و بقیه peon.
ceph mon stat
ceph quorum_status -f json-pretty
ceph mon dump
ceph tell mon.ceph-node1 mon_status| تعداد MON | اکثریت لازم | تحمل خرابی |
|---|---|---|
| ۱ | ۱ | ۰ |
| ۳ | ۲ | ۱ |
| ۵ | ۳ | ۲ |
| ۷ | ۴ | ۳ |
تعداد زوج MON تحمل خرابی را افزایش نمیدهد: چهار MON هم فقط یک خرابی را تحمل میکنند. MONها به ساعت دقیق حساساند (هشدار MON_CLOCK_SKEW)؛ chrony یا NTP را روی همهی گرهها پیکربندی و پایش کنید. پایگاه دادهی MON (RocksDB) را روی SSD قرار دهید و فضای دیسک آن را پایش کنید؛ وقتی فضای آزاد کم شود، هشدار MON_DISK_LOW و در نهایت توقف MON پیش میآید.
Umbrella سازوکار اختیاری پشتیبانگیری و بازیابی RocksDB MON را اضافه کرده است (تنظیم mon_backup_interval، دستور ceph tell mon.* backup و بازیابی آفلاین با ceph-mon --restore-backup). پیش از هر عملیات پرخطر روی MONها (حذف، بازسازی یا ارتقای اصلی) از این امکان یا از روشهای مستند بازسازی پایگاه MON آگاه باشید؛ از دست رفتن همهی MONها بدون پشتیبان، بدترین سناریوی Ceph است.
۸-۶ از درون کد: جایگذاری، احراز هویت و پیامرسانی#
۸-۶-۱ از نام شیء تا OSD#
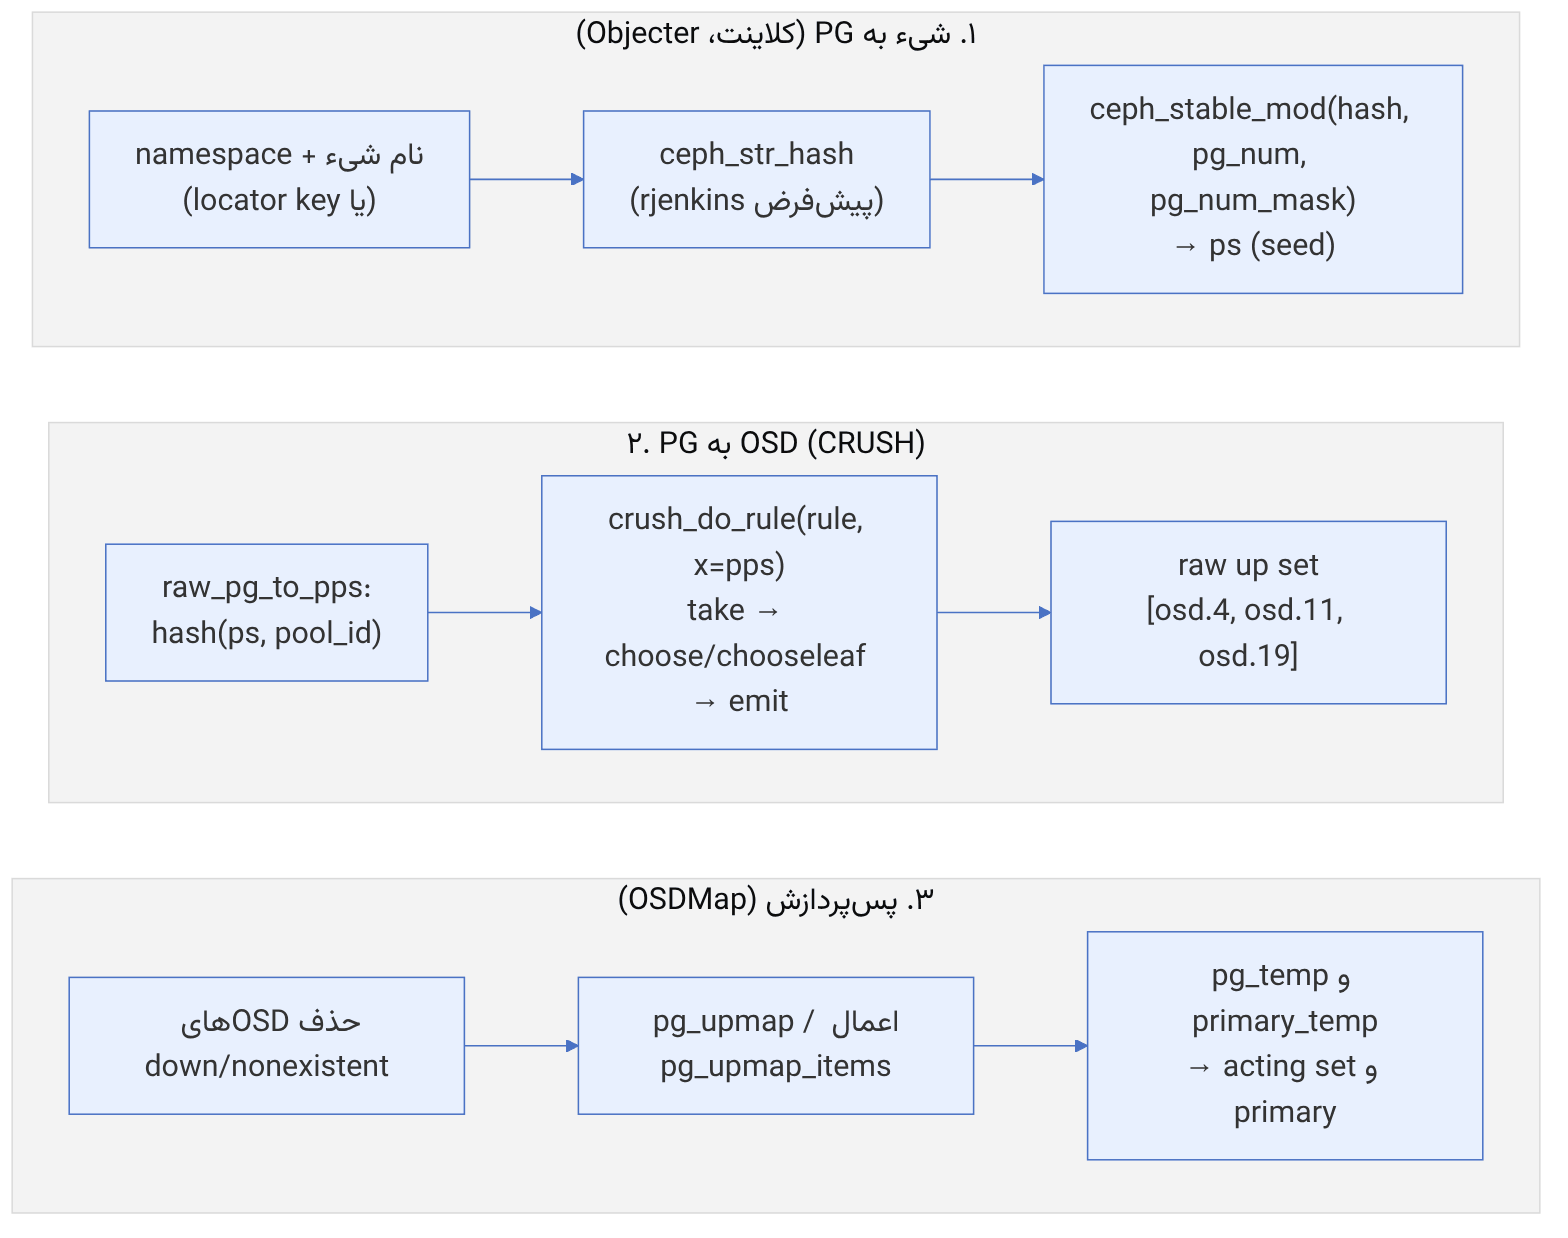
مرحلهی اول در pg_pool_t::hash_key() (src/osd/osd_types.cc) انجام میشود: نام شیء، و در صورت وجود namespace، با تابع درهمسازی pool (پیشفرض rjenkins) به یک عدد ۳۲بیتی تبدیل میشود. سپس این عدد با ceph_stable_mod() به بازهی PGها نگاشت میشود. این تابع کوچک یکی از هوشمندانهترین قطعههای Ceph است:
/* from ceph/ceph, LGPL — src/include/rados.h (excerpt) */
static inline int ceph_stable_mod(int x, int b, int bmask)
{
	if ((x & bmask) < b)
		return x & bmask;
	else
		return x & (bmask >> 1);
}b تعداد PGها و bmask کوچکترین توان ۲ منهای یک است که دستکم b باشد. اگر pg_num توان ۲ نباشد (مثلاً ۱۲ با bmask=15)، مقادیر ۱۲ تا ۱۵ که PG متناظر ندارند به نیمهی پایین (۴ تا ۷) «تا» میشوند. نتیجهی مهم: وقتی pg_num از ۱۲ به ۱۳ افزایش مییابد، فقط اشیایی که به PG ۵ میرفتند و hash آنها در ۱۳ میافتد جابهجا میشوند؛ یعنی تقسیم PG محلی است و همهی داده بازچینی نمیشود. همین ویژگی است که افزایش تدریجی pg_num (از Nautilus) را ممکن کرده است.
به همین دلیل، وقتی pg_num توان ۲ نیست، اندازهی PGها نابرابر است: PGهای «تاشده» تقریباً دو برابر داده دارند. این یکی از دلایل توصیهی توان ۲ و رفتار autoscaler است (فصل ۱۹).
۸-۶-۲ straw2: انتخاب با کشیدن قرعهی نمایی#
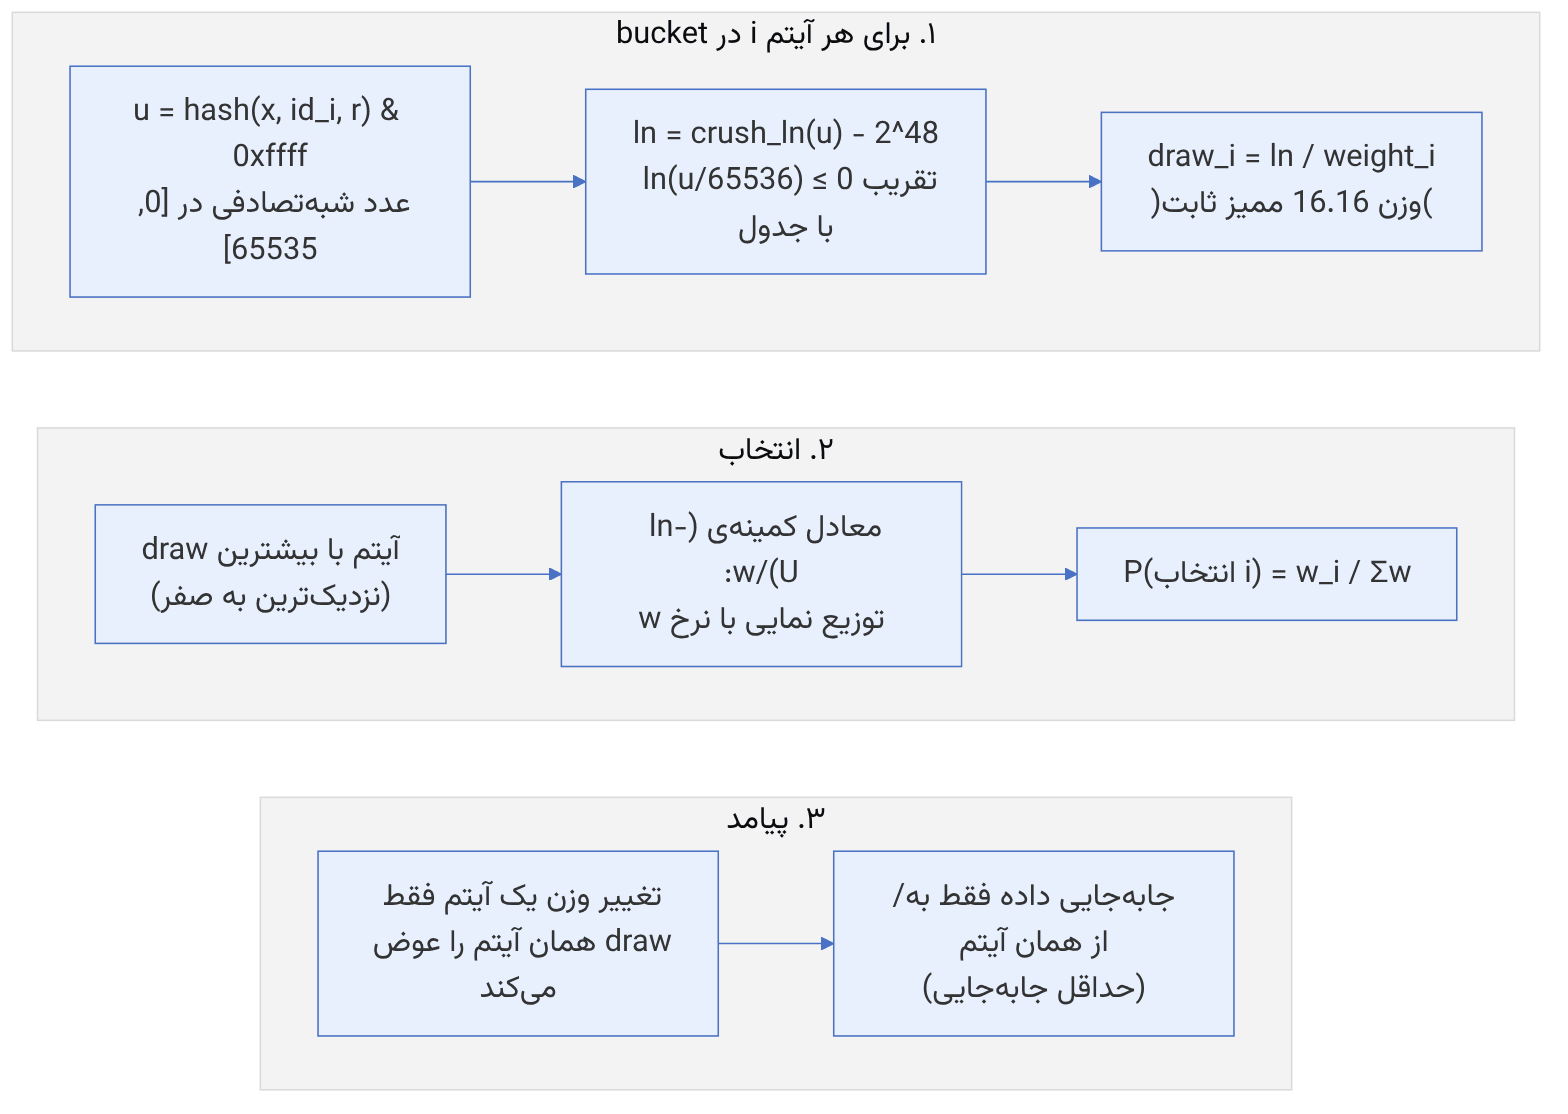
bucket_straw2_choose() در src/crush/mapper.c برای هر آیتم bucket یک «قرعه» (draw) محاسبه و بزرگترین را انتخاب میکند. هستهی محاسبه:
/* from ceph/ceph, LGPL — src/crush/mapper.c, generate_exponential_distribution() (excerpt) */
unsigned int u = crush_hash32_3(type, x, y, z);
u &= 0xffff;
__s64 ln = crush_ln(u) - 0x1000000000000ll;
return div64_s64(ln, weight);
ریاضیات پشت آن (به بیان این کتاب): فرض کنید U یکنواخت در (۰، ۱] باشد. آنگاه −ln(U) / w متغیری نمایی با نرخ w است. کمینهی چند متغیر نمایی مستقل با نرخهای w₁ تا wₙ، با احتمال wᵢ / Σw متعلق به آیتم i است. چون ln(U) منفی است، ln(U)/w بزرگترین مقدار را برای همان آیتمی دارد که −ln(U)/w کمینه است. بنابراین:
draw_i = ln(u_i / 65536) / w_i          (u_i = hash(x, id_i, r) mod 2^16)
choose argmax_i draw_i ⇒ P(i) = w_i / Σ_j w_jcrush_ln() لگاریتم را با جدولهای ممیز ثابت (بدون ممیز شناور، چون همین کد در هستهی لینوکس هم اجرا میشود) تقریب میزند؛ خروجی آن در بازهی [۰, ۲⁴⁸) است و تفریق ۲⁴⁸ آن را به مقدار منفی معادل ln(u/۶۵۵۳۶) تبدیل میکند. وزنها در قالب ۱۶.۱۶ ممیز ثابتاند (۰x10000 یعنی ۱.۰).
چرا straw2 جابهجایی را کمینه میکند؟ draw هر آیتم فقط به hash خودش و وزن خودش بستگی دارد. اگر وزن آیتم A افزایش یابد، فقط draw آن بزرگتر میشود؛ PGهایی که قبلاً A را انتخاب کرده بودند همچنان A را انتخاب میکنند و برخی PGهای دیگر به A منتقل میشوند، اما هیچ PGی بین دو آیتم دیگر (B و C) جابهجا نمیشود. در الگوریتم قدیمی straw، طول «نی»ها به وزن همهی آیتمها وابسته بود و این ویژگی برقرار نبود؛ به همین دلیل straw2 از Hammer معرفی و بعدها پیشفرض شد.
زمین بازی CRUSH
یک root، چند host و OSD بسازید، قاعده را انتخاب کنید و ببینید straw2 هر PG را کجا میگذارد؛ یک OSD را out یا down کنید یا وزنش را تغییر دهید و ببینید کدام PGها جابهجا میشوند.
تغییر آخر: osd.4 out شد. shardهای جابهجاشده در فهرست برجسته شدهاند.
PG ← مجموعهٔ up (۶۴ PG؛ primary زیرخطدار)
- 1.0[0,6,5]
- 1.1[7,4,0]
- 1.2[4,7,0]
- 1.3[4,8,2]
- 1.4[1,8,5]
- 1.5[4,8,0]
- 1.6[6,4,2]
- 1.7[1,7,5]
- 1.8[6,0,4]
- 1.9[8,4,2]
- 1.a[1,5,7]
- 1.b[1,8,5]
- 1.c[6,5,2]
- 1.d[7,4,2]
- 1.e[1,8,4]
- 1.f[6,2,4]
- 1.10[5,2,8]
- 1.11[4,8,0]
- 1.12[0,6,5]
- 1.13[4,6,1]
- 1.14[5,8,1]
- 1.15[8,5,2]
- 1.16[5,0,6]
- 1.17[8,0,5]
- 1.18[6,2,4]
- 1.19[6,0,4]
- 1.1a[4,2,8]
- 1.1b[8,1,4]
- 1.1c[8,4,1]
- 1.1d[6,0,5]
- 1.1e[8,4,0]
- 1.1f[8,5,2]
- 1.20[2,6,5]
- 1.21[6,0,4]
- 1.22[2,4,6]
- 1.23[0,5,7]
- 1.24[0,4,6]
- 1.25[8,5,0]
- 1.26[1,4,6]
- 1.27[1,7,5]
- 1.28[5,7,0]
- 1.29[8,2,4]
- 1.2a[5,2,6]
- 1.2b[8,0,4]
- 1.2c[7,0,4]
- 1.2d[2,7,4]
- 1.2e[6,2,4]
- 1.2f[0,4,6]
- 1.30[6,5,0]
- 1.31[0,6,4]
- 1.32[0,6,4]
- 1.33[4,6,2]
- 1.34[8,0,5]
- 1.35[8,2,4]
- 1.36[7,0,4]
- 1.37[4,7,0]
- 1.38[6,4,2]
- 1.39[0,5,6]
- 1.3a[0,8,4]
- 1.3b[4,1,6]
- 1.3c[5,6,0]
- 1.3d[5,8,2]
- 1.3e[5,1,7]
- 1.3f[7,4,1]
مطابق با:
src/crush/mapper.c :: crush_do_ruleاجرای گامهای قاعده (take، chooseleaf، emit)src/crush/mapper.c :: crush_choose_firstn, crush_choose_indepحلقههای انتخاب replicated (firstn) و EC (indep) با تلاش دوبارهsrc/crush/mapper.c :: bucket_straw2_choose, generate_exponential_distribution, crush_lnstraw2: بزرگترین ln(hash)/weight برنده استsrc/crush/mapper.c :: is_outبررسی reweight که OSD خارجشده را رد میکندsrc/crush/hash.c :: crush_hash32_rjenkins1_2, _3hash جنکینز که CRUSH به کار میبردsrc/osd/osd_types.cc :: pg_pool_t::raw_pg_to_pps, hash_keyبذر PG که وارد CRUSH میشودsrc/include/rados.h :: ceph_stable_modنگاشت hash شیء به PG وقتی pg_num توانی از ۲ نیستsrc/common/ceph_hash.cc :: ceph_str_hash_rjenkinshash نام شیءsrc/osd/OSDMap.cc :: _pg_to_raw_osds, _raw_to_up_osdsاز مجموعهٔ خام تا مجموعهٔ up (OSDهای down حذف یا NONE میشوند)src/crush/CrushWrapper.cc :: add_simple_rule_at, insert_item; CrushWrapper.h :: set_tunables_jewelقاعدهای که ceph osd pool create میسازد و tunables نسخهٔ jewel
۸-۶-۳ تلاش دوباره: collision و reject#
crush_choose_firstn() برای هر نسخه (rep) یک bucket را پایین میرود تا به نوع مورد نظر برسد. اگر آیتم انتخابشده قبلاً انتخاب شده باشد (collide) یا OSD خارج یا بیشازحد پر باشد (reject)، شمارندهی ftotal افزایش مییابد و انتخاب با r' = r + ftotal تکرار میشود؛ تا سقف choose_total_tries (tunable، پیشفرض ۵۰ در پروفایلهای جدید).
pseudocode: crush_choose_firstn (خلاصهی این کتاب)
for rep in 0..numrep-1:
ftotal = 0
loop:
r = rep + ftotal
item = descend(bucket, x, r) until type matches # straw2 در هر سطح
collide = item in out[0..rep-1]
reject = is_out(item, x) or (chooseleaf and leaf selection failed)
if not collide and not reject: out[rep] = item; break
ftotal += 1
if ftotal >= choose_total_tries: give up on this repتابع is_out() جالب است: OSDی با reweight بین ۰ و ۱ بهصورت احتمالاتی رد میشود؛ hash(x, item) & 0xffff با وزن reweight (۱۶.۱۶) مقایسه میشود. پس ceph osd reweight 12 0.8 یعنی حدود ۲۰٪ از PGهایی که CRUSH به osd.12 میداد، با تلاش دوباره به OSD دیگری میروند. reweight به همین دلیل با وزن CRUSH (که سهم را در straw2 تغییر میدهد) فرق دارد.
crushtool --test همین کد را خارج از کلاستر اجرا میکند. برای دیدن اثر یک تغییر پیش از اعمال: ceph osd getcrushmap -o cm، ویرایش، سپس crushtool -i cm --test --show-statistics --rule 0 --num-rep 3 --min-x 0 --max-x 100000 و مقایسهی --show-mappings قبل و بعد.
۸-۶-۴ cephx: بلیتها و کلیدهای چرخشی#
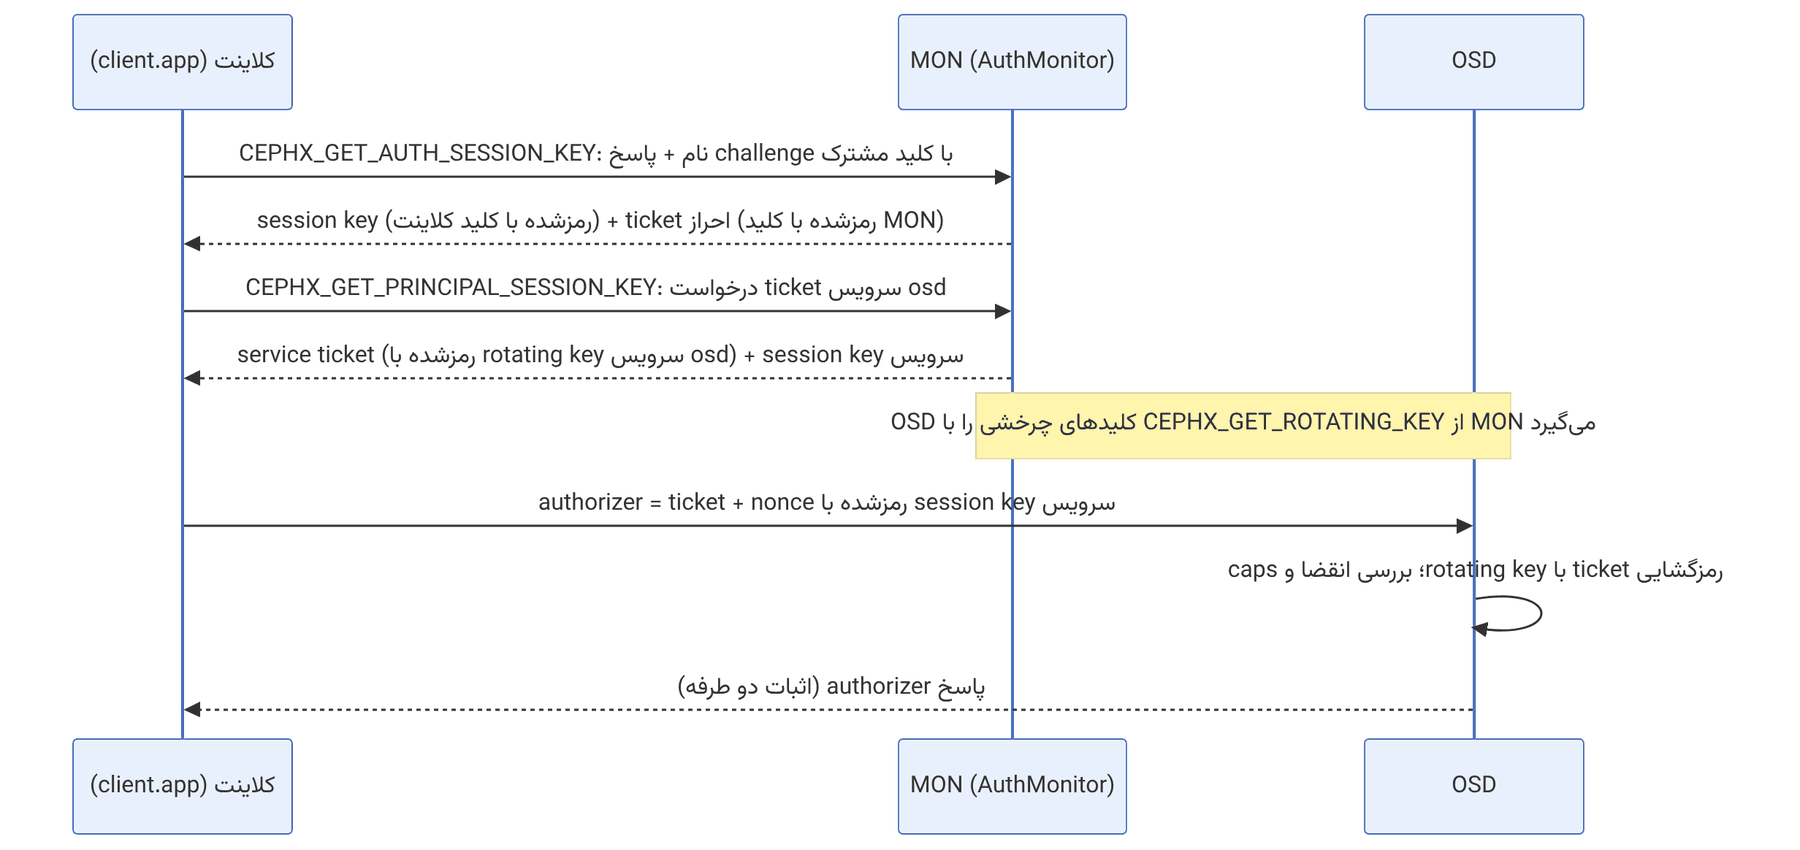
ساختارهای اصلی در src/auth/cephx/CephxProtocol.h تعریف شدهاند: CephXServerChallenge، CephXAuthenticate، CephXTicketBlob، CephXServiceTicket، CephXServiceTicketInfo و CephXAuthorizer. سه نوع درخواست اصلی با ثابتهای CEPHX_GET_AUTH_SESSION_KEY (۰x0100)، CEPHX_GET_PRINCIPAL_SESSION_KEY (۰x0200) و CEPHX_GET_ROTATING_KEY (۰x0400) مشخص میشوند.
- کلید مشترک کلاینت هرگز روی شبکه منتقل نمیشود؛ کلاینت فقط ثابت میکند آن را دارد (پاسخ به challenge).
- بلیت سرویس با کلید چرخشی سرویس رمز میشود که MON دورهای عوض میکند و OSDها میگیرند؛ بنابراین OSD برای بررسی بلیت نیازی به تماس با MON ندارد.
- عمر بلیتها با
auth_mon_ticket_ttl (پیشفرض ۷۲ ساعت) و auth_service_ticket_ttl (پیشفرض ۱ ساعت) کنترل میشود؛ کلاینت پیش از انقضا تمدید میکند.
چون بلیتها زمان انقضا دارند، اختلاف ساعت بین کلاینت، MON و OSD میتواند احراز را بشکند. پیامهایی مانند «could not get service secret» یا خطای احراز پس از راهاندازی دوبارهی میزبانی با ساعت نادرست، اغلب از همین است. NTP/chrony روی همهی میزبانها و کلاینتها الزامی است.
۸-۶-۵ msgr2: قابها و حالت امن#
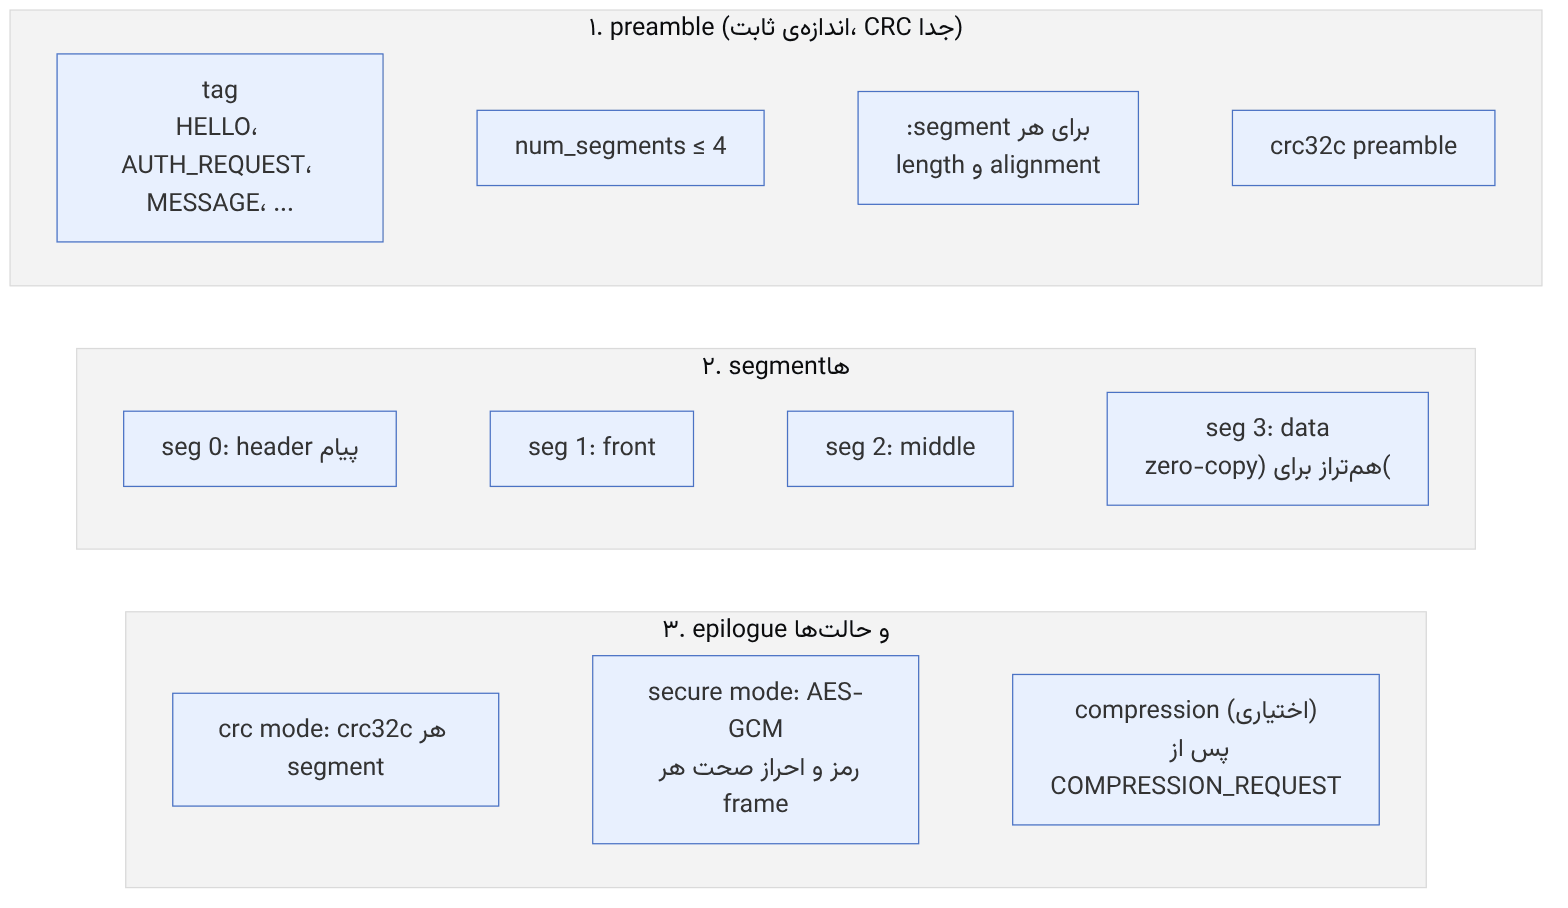
در src/msg/async/frames_v2.h، هر قاب با یک preamble_block_t شروع میشود که برچسب (enum class Tag: HELLO، AUTH_REQUEST، AUTH_REQUEST_MORE، ...، SESSION_RECONNECT، MESSAGE، KEEPALIVE2، COMPRESSION_REQUEST و...)، تعداد segmentها (حداکثر MAX_NUM_SEGMENTS = 4) و طول و همترازی هر segment را دارد. جدا کردن segment داده با همترازی مشخص اجازه میدهد بافر داده بدون کپی (zero-copy) مستقیم به BlueStore برسد.
ceph config get mon ms_cluster_mode # crc یا secure (و ترتیب ترجیح)
ceph config get mon ms_service_mode
ceph config get mon ms_client_mode
ceph config set global ms_cluster_mode "secure" # رمزنگاری ترافیک بین OSDها
ceph mon dump | grep -E "v2:|v1:" # نشانیهای دو پروتکلحالت secure هزینهی CPU دارد، اما روی پردازندههای دارای AES-NI معمولاً قابلتحمل است. پیش از فعالسازی روی شبکهی cluster پرترافیک، اثر را در آزمایشگاه بسنجید. پورت پیشفرض msgr2 روی MON ۳۳۰۰ و msgr1 ۶۷۸۹ است.
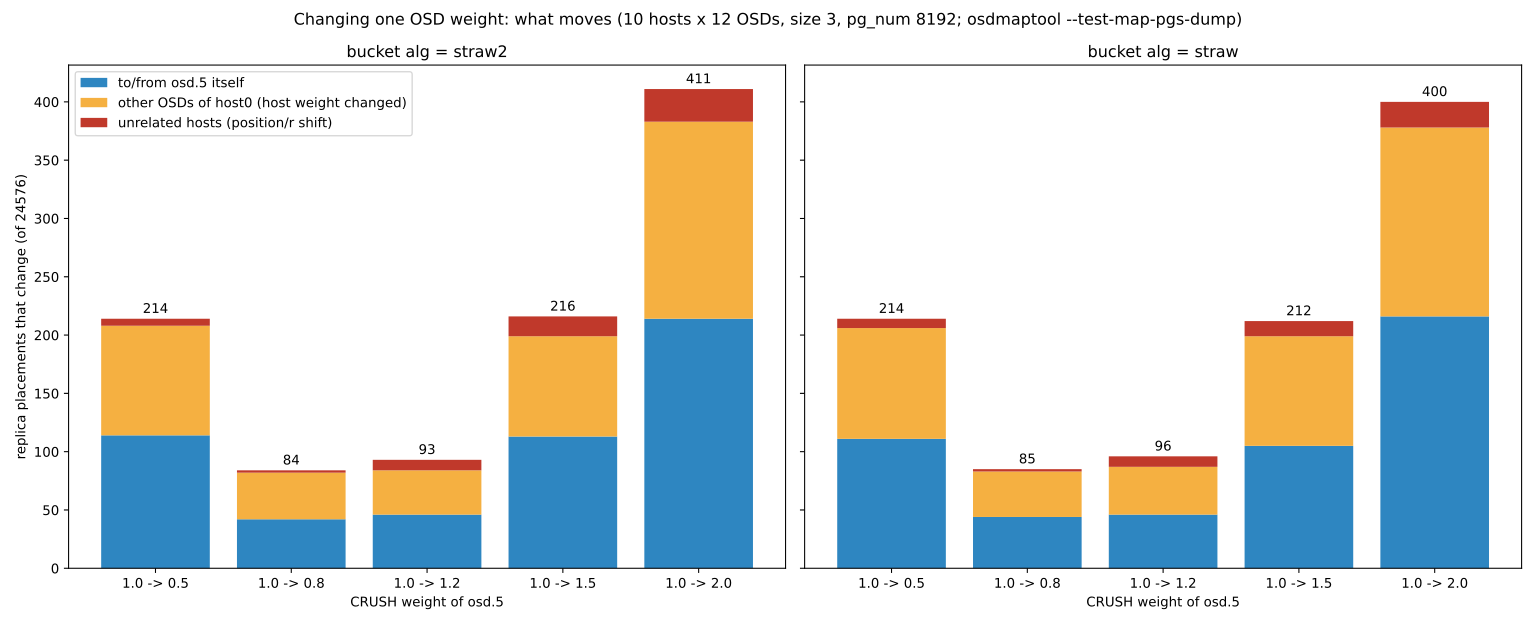
۸-۷ جابهجایی داده با عدد: افزودن میزبان و تغییر وزن#
این بخش دو پرسش عملی را با نگاشت واقعی CRUSH پاسخ میدهد: «با افزودن یک میزبان چه مقدار داده جابهجا میشود؟» و «با تغییر وزن یک OSD چه چیزی جابهجا میشود؟». نقشه با crushtool --build --num_osds 132 … host straw2 12 root straw2 0 ساخته شد. نسخهی دهمیزبانی همان نقشه با --remove-item به دست آمد تا شناسهی همهی bucketها و OSDها ثابت بماند، چون straw2 شناسهی آیتم را در hash به کار میبرد. pool سهنسخهای با ۸۱۹۲ PG در osdmaptool --createsimple 256 --pg-bits 5 --pgp-bits 5 تعریف شد و نگاشت هر حالت با --test-map-pgs-dump گرفته شد. ابزارها از Ceph 18.2.7 بودند و tunableها پیشفرض: chooseleaf_vary_r 1، chooseleaf_stable 1 و choose_total_tries 50.
یک دام در osdmaptool: گزینهی --mark-up-in به هر OSD با وزن CRUSH صفر وزن ۱.۰ میدهد (src/tools/osdmaptool.cc، بلوک if (mark_up_in) با adjust_item_weightf(…, 1.0)). پس برای شبیهسازی «میزبان هنوز اضافه نشده» نمیتوان وزن OSDها را صفر کرد و باید آنها را از نقشه حذف کرد. ما اول همین اشتباه را کردیم و هیچ جابهجاییای ندیدیم.
۸-۷-۱ افزودن یک میزبان#
منبع در کد: osdmaptool --test-map-pgs-dump پیش و پس از تغییر؛ bucket_straw2_choose و crush_choose_firstn در src/crush/mapper.c
پیچیدگی: O(pg_num × size)
pseudocode
A = up(pg) با نقشهی قدیم ؛ B = up(pg) با نقشهی جدید # برای هر pg در [0, pg_num)
moved = Σ_pg |set(B[pg]) − set(A[pg])| # جایگذاریهای تازه، بیتوجه به ترتیب
to_new = Σ_pg |{o ∈ B[pg] − A[pg] : o روی میزبان جدید}|
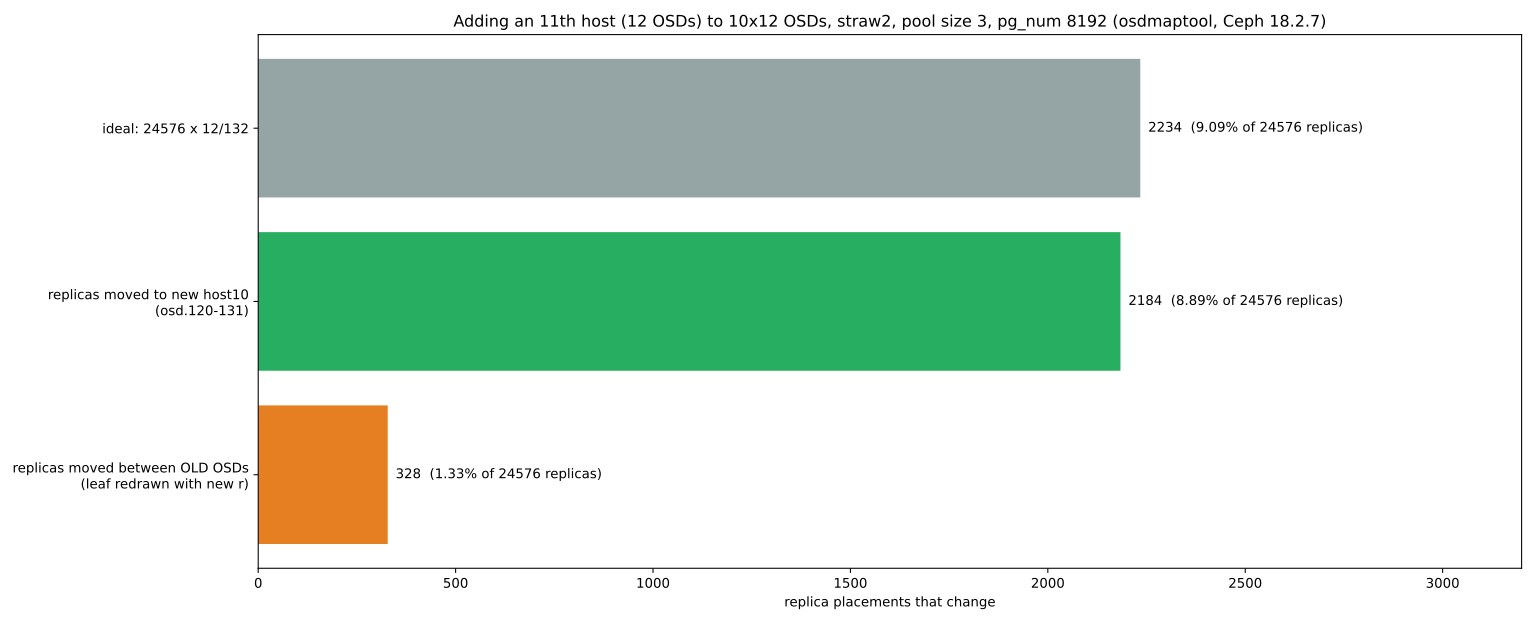
ideal = pg_num × size × (وزن میزبان جدید / وزن کل) # 24576 × 12/132نتیجه. از ۲۴۵۷۶ جایگذاری replica، ۲۱۸۴ مورد (۸.۸۹٪) به میزبان جدید رفت. حد ایدهآل ۲۲۳۴ (۹.۰۹٪) است. این همان رفتاری است که straw2 تضمین میکند: هر آیتم یک «قرعه»ی مستقل ln(u)/w دارد (تابع generate_exponential_distribution) و افزودن یک آیتم فقط در جاهایی برنده را عوض میکند که قرعهی آیتم تازه بالاتر باشد.
اما ۳۲۸ جایگذاری دیگر (۱.۳۳٪) بین OSDهای قدیمی جابهجا شد. نمونهای واقعی از همین نگاشت: PG 1.58 از [76, 113, 46] به [76, 125, 116] رفت. میزبان جدید در جایگاه دوم نشست و میزبان ۹ به جایگاه سوم رانده شد. در crush_choose_firstn برگ درون میزبان با sub_r = r >> (vary_r − 1) انتخاب میشود، یعنی به r جایگاه بستگی دارد. پس در همان میزبان ۹ بهجای osd.113، osd.116 انتخاب شد. نتیجهی عملی این است که افزودن ظرفیت حدود ۱۵٪ بیشتر از حد ایدهآل جابهجایی ایجاد میکند (۲۵۱۲ در برابر ۲۲۳۴). این را در برآورد زمان backfill لحاظ کنید.
۸-۷-۲ تغییر وزن یک OSD#
منبع در کد: crushtool --reweight-item (وزن والدها را هم بهروز میکند)؛ همان مقایسهی A و B
پیچیدگی: O(pg_num × size)
pseudocode
برای هر جایگذاری تازه y ∈ B[pg] − A[pg]:
اگر osd.5 در ورودی یا خروجی این PG باشد → «خود osd.5»
وگرنه اگر ورودی یا خروجی روی host0 باشد → «دیگر OSDهای host0» (وزن host0 در root عوض شده)
وگرنه → «میزبانهای نامربوط» (جابهجایی جایگاه/r)نتیجه. وقتی وزن osd.5 از ۱.۰ به ۲.۰ میرسد، ۴۱۱ جایگذاری عوض میشود: ۲۱۴ مورد خود osd.5، ۱۶۹ مورد دیگر OSDهای host0 و ۲۸ مورد میزبانهای نامربوط. وقتی وزن به ۰.۸ کم میشود، ۸۴ جایگذاری عوض میشود: ۴۲، ۴۰ و ۲.
بخش بزرگ «دیگر OSDهای host0» اشکال straw2 نیست. crushtool --reweight-item وزن host0 را در root هم از ۱۲ به ۱۳ میبرد و host0 سهم بیشتری از PGها میگیرد. straw2 این سهم را درون host0 به نسبت ۲/۱۳ برای osd.5 و ۱/۱۳ برای هر OSD دیگر پخش میکند.
در این آزمایش الگوریتم قدیمی straw نتیجهی تقریباً یکسانی داد (۴۰۰ در برابر ۴۱۱ برای وزن ۲.۰)، چون همهی آیتمها جز یکی هموزن بودند. ایراد مستند straw قدیمی (جابهجایی بین آیتمهای دیگرِ همان bucket هنگام تغییر وزن یکی) در bucketهای با وزنهای نابرابر بروز میکند. با این حال، straw2 تنها الگوریتمی است که این ویژگی را برای هر توزیع وزنی تضمین میکند.
پیش از هر تغییر وزن یا افزودن میزبان روی کلاستر واقعی، همین مقایسه را آفلاین انجام دهید: ceph osd getmap -o om، سپس osdmaptool om --export-crush cm، تغییر روی cm با crushtool، osdmaptool om --import-crush cm2 روی یک کپی، و مقایسهی دو خروجی --test-map-pgs-dump. در این حالت --mark-up-in لازم نیست، چون osdmap واقعی وضعیت up و in را دارد.
۸-۸ احراز هویت و مجوزها#
۸-۸-۱ cephx#
Ceph از پروتکل cephx برای احراز هویت دوطرفه بین کلاینتها و daemonها استفاده میکند. ایدهی آن شبیه Kerberos است: کلید مخفی هرگز روی شبکه ارسال نمیشود و MON بهعنوان مرجع، ticketهای زماندار صادر میکند که کلاینت با آنها مستقیماً با OSDها و MDSها صحبت میکند.
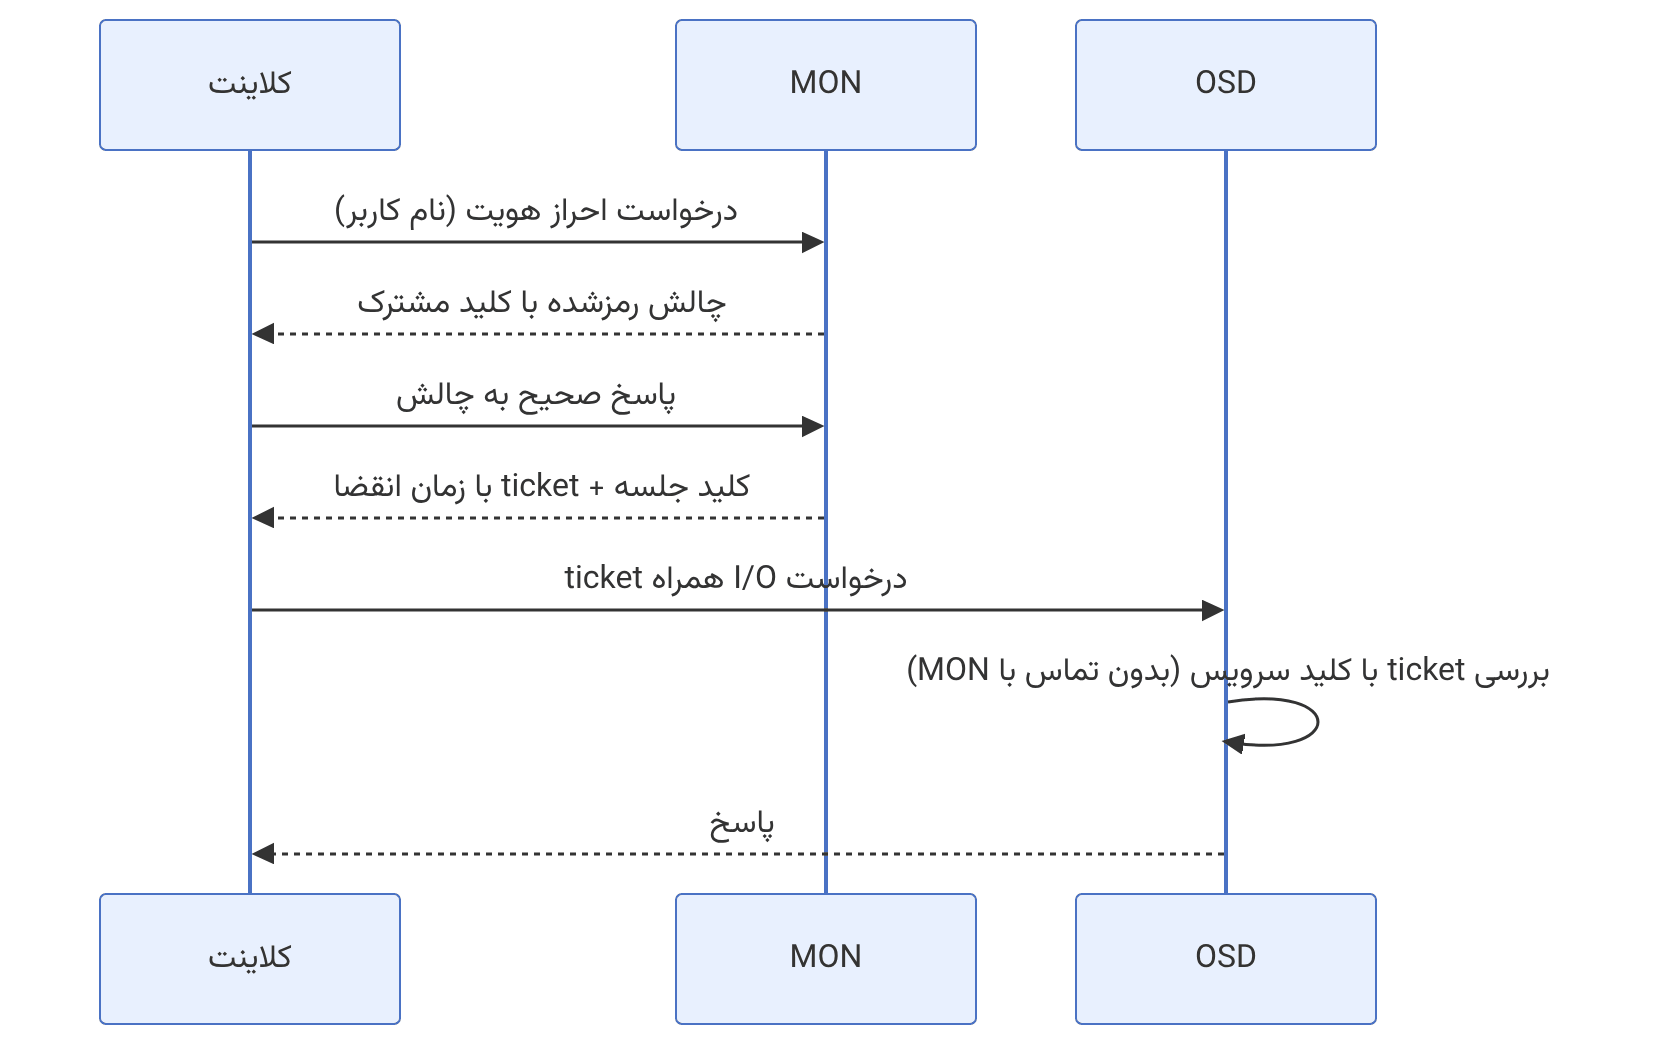
اگر هر درخواست I/O برای بررسی مجوز به MON میرفت، MONها گلوگاه میشدند. با ticket، OSD فقط با کلید سرویس خودش (که از MON گرفته و دورهای چرخانده میشود) اعتبار ticket را بررسی میکند. به همین دلیل اختلاف ساعت بین گرهها میتواند به خطاهای احراز هویت منجر شود: ticketها زمان انقضا دارند.
۸-۸-۲ کاربران و capabilityها#
هر هویت در Ceph به شکل type.id است (مثلاً client.backup یا osd.3) و یک کلید و مجموعهای capability دارد. capabilityها برای هر نوع daemon جداگانه تعریف میشوند:
ceph auth ls
ceph auth get client.admin
# کاربر فقط برای RBD در یک pool
ceph auth get-or-create client.vmhost mon 'profile rbd' osd 'profile rbd pool=vms' mgr 'profile rbd pool=vms'
# کاربر فقطخواندنی برای پایش
ceph auth get-or-create client.monitor mon 'allow r' mgr 'allow r'
# کاربر محدود به یک namespace
ceph auth get-or-create client.tenant1 mon 'allow r' osd 'allow rw pool=shared namespace=tenant1'
ceph auth caps client.vmhost mon 'profile rbd' osd 'profile rbd pool=vms, profile rbd-read-only pool=images'
ceph auth rm client.old-appهمیشه از profileها (profile rbd، profile rbd-read-only، profile crash، profile bootstrap-osd) به جای نوشتن دستی capabilityهای سطح پایین استفاده کنید. profileها capabilityهای لازم برای عملیاتی مثل blocklist کردن کلاینت قبلی (برای قفل exclusive-lock در RBD) را هم دارند که در capabilityهای دستی معمولاً فراموش میشوند.
۸-۸-۳ چرخش کلید و رمزنگاری#
- کلید یک کاربر را میتوان با
ceph auth rotate (در نسخههای جدید) یا ساختن کلید تازه و جایگزینی تدریجی چرخاند. - Umbrella cephx را سختتر کرد: رمز تازهی AES256KRB5 به جای انواع کلید قدیمیتر پیشفرض شد و چرخش آنلاین کلیدها اضافه شد. پیش از ارتقا، سازگاری کلاینتهای قدیمی (بهویژه کلاینتهای هسته) را بررسی کنید.
- برای رمزنگاری ترافیک شبکه، حالت
secure در msgr2 را فعال کنید (ms_cluster_mode، ms_service_mode، ms_client_mode). این حالت سربار CPU دارد؛ آن را روی سختافزار واقعی اندازه بگیرید.
ceph config set global ms_client_mode secure
ceph config set global ms_service_mode secure
ceph config get mon ms_cluster_mode۸-۹ مسیر I/O و PGها#
۸-۹-۱ مسیر یک نوشتن#
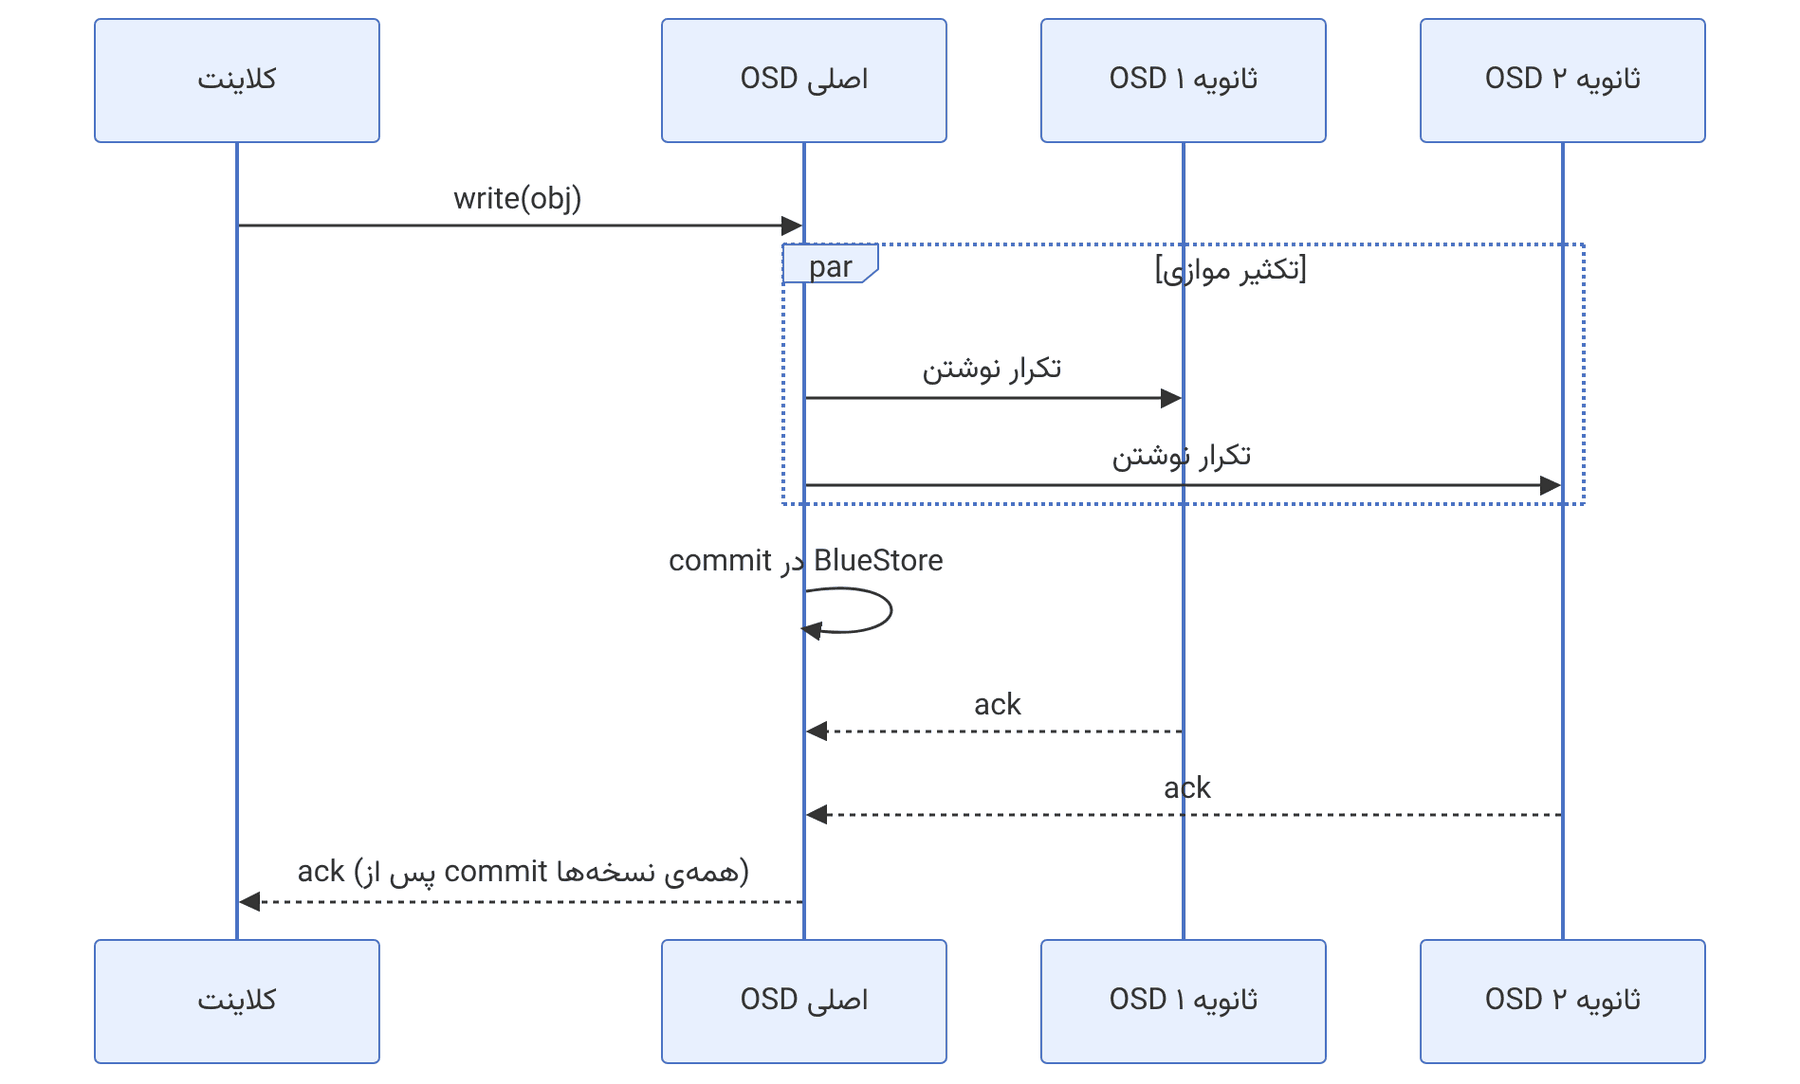
- ۱. کلاینت (librados) با نقشهای که دارد، PG و primary را محاسبه میکند.
- ۲. درخواست را فقط به primary میفرستد.
- ۳. primary عملیات را در log آن PG ثبت و بهطور موازی به ثانویهها میفرستد.
- ۴. هر OSD تراکنش را در BlueStore commit میکند.
- ۵. primary پس از دریافت تأیید از همهی OSDهای acting set به کلاینت ack میدهد.
بنابراین تأخیر نوشتن برابر کندترین OSD در acting set بهعلاوهی دو رفتوبرگشت شبکه است. همین دلیل است که یک دیسک کند کل کلاستر را کند میکند (فصل ۱۷). در pool EC، primary داده را به k قطعهی داده و m قطعهی parity تقسیم و هر قطعه را به یک OSD میفرستد (فصل ۱۳).
خواندن بهطور پیشفرض از primary انجام میشود. کلاینتهای RBD و RGW میتوانند در شرایط خاص از نزدیکترین نسخه بخوانند (مثلاً گزینهی rbd_read_from_replica_policy با مقادیر balance و localize)، که در کلاسترهای گسترده بین سایتها مفید است.
۸-۹-۲ حالتهای PG#
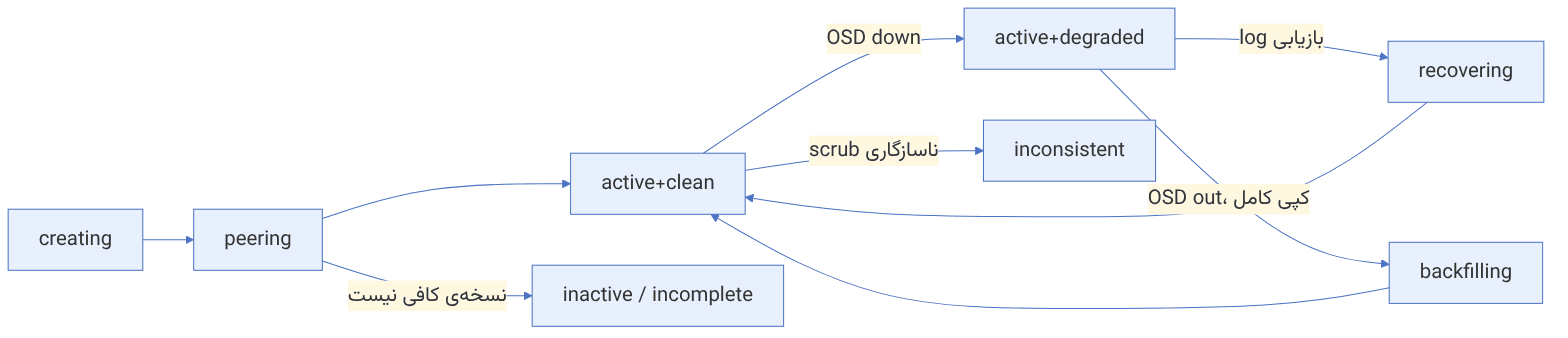
| حالت | معنی | نگرانکننده؟ |
|---|---|---|
| active+clean | همهی نسخهها موجود و همگام | خیر؛ حالت مطلوب |
| peering | OSDها در حال توافق بر وضعیت PG | فقط اگر طول بکشد |
| degraded | برخی اشیا نسخهی کافی ندارند | تا بازیابی کامل، ریسک بالاتر |
| recovering | همگامسازی از روی log | طبیعی پس از خرابی کوتاه |
| backfilling, backfill_wait | کپی کامل PG به OSD جدید | طبیعی پس از تغییر نقشه |
| remapped | acting set موقتاً با up set فرق دارد | طبیعی در حین backfill |
| undersized | تعداد OSDها کمتر از size | بررسی شود |
| inconsistent | scrub ناسازگاری پیدا کرده | بله؛ باید بررسی و repair شود |
| incomplete, down | نسخهی معتبر کافی برای فعال شدن نیست | بله؛ I/O این PG متوقف است |
| stale | primary مدتی آمار نفرستاده | بله؛ OSDها را بررسی کنید |
ceph pg stat
ceph pg dump_stuck inactive
ceph pg dump_stuck unclean
ceph pg ls degraded
ceph pg 3.1f query | jq '.recovery_state'برای PGی که در peering یا incomplete گیر کرده، خروجی ceph pg <id> query را از پایین به بالا بخوانید. بخش recovery_state معمولاً میگوید منتظر کدام OSD است (blocked_by یا down_osds_we_would_probe). اگر آن OSD برای همیشه از دست رفته است، تصمیمهایی مثل ceph osd lost یا علامتگذاری اشیای گمشده ریسک از دست رفتن داده دارند؛ قبل از اجرا فصل ۱۷ را بخوانید.
۸-۹-۳ min_size و size#
size تعداد نسخههاست و min_size حداقل نسخهی سالمی که PG برای پذیرش I/O لازم دارد. برای pool تکثیری سهتایی، min_size=2 استاندارد است. کاهش آن به ۱ کلاستر را در حین خرابی «در دسترس» نگه میدارد اما ریسک از دست رفتن داده را بهشدت بالا میبرد، چون یک نوشتن ممکن است فقط روی یک دیسک وجود داشته باشد.
۸-۱۰ pool روی OSDهای مشخص#
راه امروزی قرار دادن یک pool روی گروه خاصی از OSDها، کلاس دستگاه است. اگر کلاسهای پیشفرض کافی نیستند (مثلاً میخواهید دیسکهای NVMe یک مدل خاص را برای یک مستأجر کنار بگذارید)، کلاس دلخواه تعریف کنید:
for id in 30 31 32 33 34 35; do
  ceph osd crush rm-device-class osd.$id
  ceph osd crush set-device-class fastnvme osd.$id
done
ceph osd crush rule create-replicated fast-host default host fastnvme
ceph osd pool create tenant-a-db 64 64 replicated fast-host
ceph osd pool application enable tenant-a-db rbd
ceph pg ls-by-pool tenant-a-db | headدر spec OSD در cephadm هم میتوانید crush_device_class را تعیین کنید تا OSDهای تازه از ابتدا کلاس درست را بگیرند و نیازی به اجرای دوبارهی دستورهای بالا نباشد.
- محل داده محاسبه میشود، نه جستوجو؛
ceph osd map ابزار اول شماست. - فقط دامنههای خرابی واقعی را در CRUSH تعریف کنید و مکان میزبان را در spec بدهید.
- قبل از اعمال هر نقشهی دستی،
crushtool --test اجرا کنید. - برای SSD/HDD از کلاس دستگاه استفاده کنید، نه rootهای جدا.
- تغییر tunable یعنی جابهجایی بزرگ؛ سازگاری کلاینتها را با
ceph features بررسی کنید. - MON فرد (۳ یا ۵)، روی SSD، با ساعت دقیق.
- capability با profile و حداقل دسترسی؛ min_size را پایین نیاورید.
۸-۱۱ تکمیلی و بهروز#
- کلاس دستگاه و shadow tree (Luminous) جایگزین rootهای جداگانهی SSD/HDD شد که در منابع قدیمی دیده میشود.
- upmap و balancer: جای reweight دستی را گرفتهاند (فصل ۷).
- قانون MSR (Squid) برای EC انعطاف بیشتری میدهد.
- cephx در Umbrella: رمز AES256KRB5 بهعنوان پیشفرض و چرخش آنلاین کلید.
- پشتیبان RocksDB MON (Umbrella).
- read balancer (Reef) برای توزیع primaryها.
۸-۱۲ تمرین عملی#
- ۱. برای سه شیء مختلف
ceph osd map بگیرید و مسیر PG و OSDها را با ceph pg map مقایسه کنید. - ۲. یک سلسلهمراتب دو rackی بسازید، میزبانها را جابهجا کنید و قانون
rep-rack را روی یک pool آزمایشی اعمال کنید. حجم جابهجایی را مشاهده کنید. - ۳. نقشهی CRUSH را استخراج کنید، قانون دو datacenterی را اضافه کنید و پیش از اعمال، با
crushtool --test توزیع را بررسی کنید. - ۴. کاربری با
profile rbd فقط برای یک pool بسازید و ثابت کنید به pool دیگر دسترسی ندارد. - ۵. یک OSD را متوقف کنید و حالتهای PG را در طول زمان با
ceph pg stat ثبت کنید. - ۶. با کلاس دستگاه دلخواه یک pool روی سه OSD خاص بسازید و توزیع PGها را بررسی کنید.
۸-۱۳ پرسشهای مرور#
- ۱. دو مرحلهی نگاشت شیء به OSD کداماند و چرا PG لازم است؟
- ۲. تفاوت up set و acting set چیست؟
- ۳. مزیت straw2 نسبت به الگوریتمهای قبلی چیست؟
- ۴. چرا تغییر tunableها باعث جابهجایی داده میشود و پیش از آن چه چیزی را باید بررسی کرد؟
- ۵. چرا چهار MON از سه MON تحمل خرابی بیشتری ندارد؟
- ۶. OSDها نقشهی جدید را از کجا دریافت میکنند؟
- ۷. چرا cephx از ticket استفاده میکند؟
- ۸. چرا تأخیر نوشتن به کندترین OSD acting set بستگی دارد؟
- ۹. حالتهای incomplete و inconsistent چه تفاوتی دارند؟
- ۱۰. راه توصیهشده برای قرار دادن یک pool روی OSDهای خاص چیست؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۸-۱۴ منابع این فصل#
- CRUSH maps
https://docs.ceph.com/en/latest/rados/operations/crush-map/ - CRUSH map edits
https://docs.ceph.com/en/latest/rados/operations/crush-map-edits/ - Placement groups
https://docs.ceph.com/en/latest/rados/operations/placement-groups/ - PG states
https://docs.ceph.com/en/latest/rados/operations/pg-states/ - Monitoring OSDs and PGs
https://docs.ceph.com/en/latest/rados/operations/monitoring-osd-pg/ - User management
https://docs.ceph.com/en/latest/rados/operations/user-management/ - Cephx config
https://docs.ceph.com/en/latest/rados/configuration/auth-config-ref/ - Messenger v2
https://docs.ceph.com/en/latest/rados/configuration/msgr2/ - Architecture
https://docs.ceph.com/en/latest/architecture/ - Health checks
https://docs.ceph.com/en/latest/rados/operations/health-checks/ - Read balancer
https://docs.ceph.com/en/latest/rados/operations/read-balancer/ - Squid release notes
https://docs.ceph.com/en/latest/releases/squid/ - Umbrella release notes
https://docs.ceph.com/en/latest/releases/umbrella/ - Weil et al., CRUSH (SC ۲۰۰۶
https://ceph.io/assets/pdfs/weil-crush-sc06.pdf