عیبیابی Ceph: از HEALTH_WARN تا ماشین حالت Peering
حوصله ندارم این فصل در چند خط
- اول وضعیت را ثبت کنید (
ceph -s، ceph health detail، ceph osd tree و ceph pg dump_stuck)، سپس از MONها به OSDها و بعد PGها بروید. - MON بدون quorum هیچ کاری نمیکند؛ پرچمهایی مثل
noout و nodown ابزار موقتاند و باید بعداً برداشته شوند. -
ceph pg <pgid> query مسیر PG در ماشین حالت peering و چیزی را که مانع آن است نشان میدهد. - slow opها را با
dump_ops_in_flight و dump_historic_ops دنبال کنید؛ ceph-objectstore-tool و فرمانهای اشیای unfound را فقط با احتیاط و پس از پشتیبانگیری به کار ببرید.
۱۷-۱ پیش از شروع#
۱۷-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
عیبیابی Ceph در لحظهی حادثه بیشتر از هر چیز به روش نیاز دارد تا حافظه: اینکه از کجا شروع کنیم، کدام فرمان کدام لایه را نشان میدهد و کی باید دست نگه داشت. این فصل یک روش منظم ارائه میدهد و سپس به درون کد میرود تا ببینیم وضعیتهایی مثل down، incomplete یا peering دقیقاً از کجای ماشین حالت PG میآیند.
- روش گامبهگام عیبیابی از
ceph -s تا ریشهی مشکل چیست؟ - مشکلات MON، OSD و شبکه را چگونه جدا کنیم؟
- وضعیتهای PG چه معنایی دارند و ماشین حالت Peering چگونه کار میکند؟
- slow ops را چگونه تا رویداد دقیق در مسیر عملیات دنبال کنیم؟
- scrub چگونه ناسازگاری را پیدا میکند و تعمیر کی بیخطر است؟
- کدام فرمانها خطرناکاند و فقط در آخرین مرحله به کار میروند؟
۱۷-۲ روش عیبیابی#
ceph -s                           # نمای کلی: health، mon، osd، pgs، io
ceph health detail                # کد هر هشدار با جزئیات
ceph health detail --format json-pretty | jq '.checks | keys'
ceph versions                     # ناهمگونی نسخه پس از ارتقای ناتمام
ceph crash ls-new                 # crashهای تازه (RECENT_CRASH)
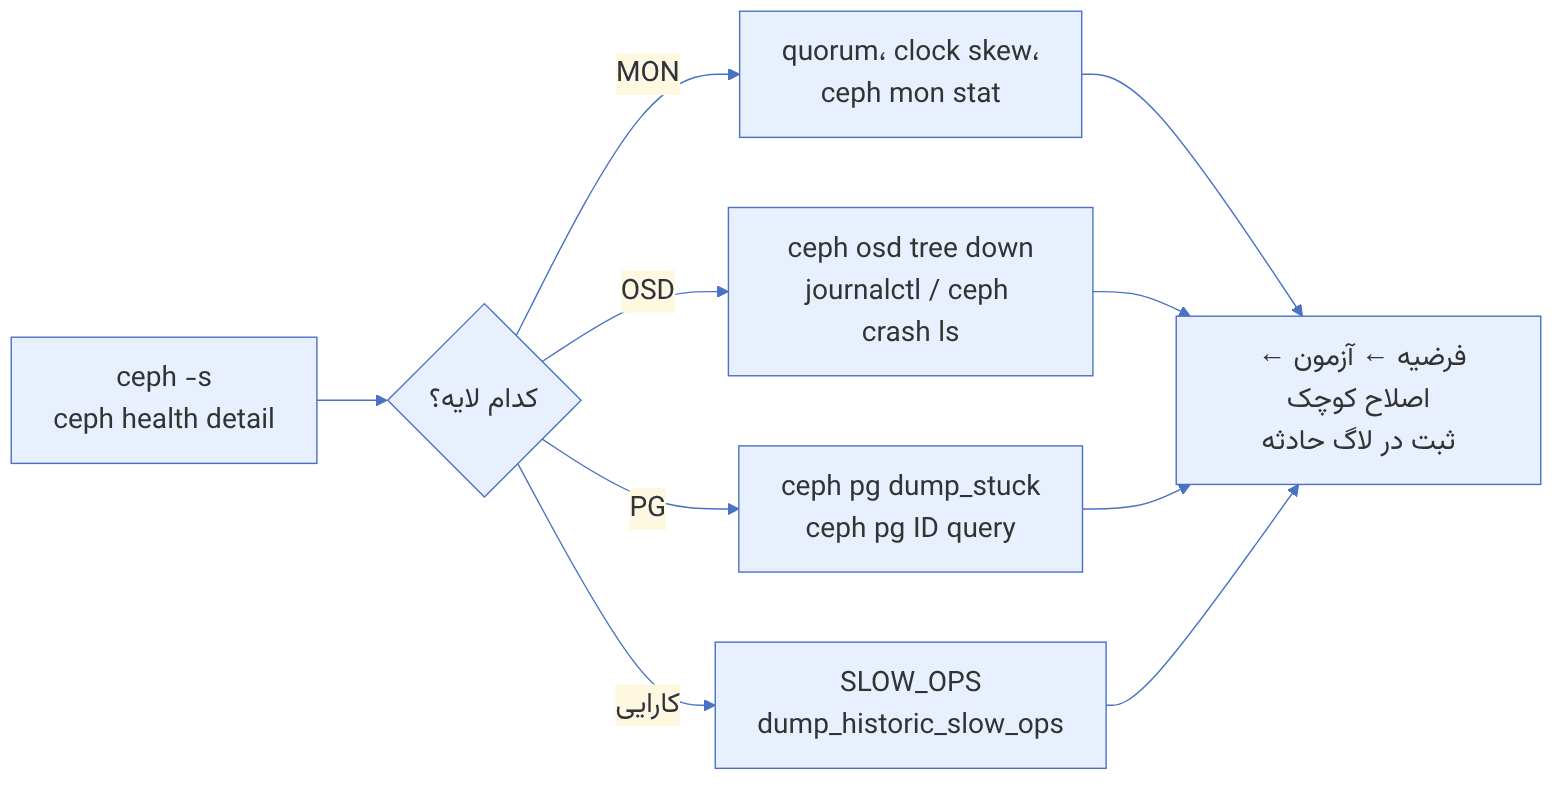
ceph log last 100 # log کلاستر در MONپیش از هر اقدام، وضعیت را ثبت کنید: خروجی ceph -s، ceph health detail، ceph osd tree و ceph pg dump_stuck را در فایلی با زمان ذخیره کنید. در بازبینی پس از حادثه، این دادهها از همه چیز ارزشمندترند.
در لحظهی بحران وسوسهی «یک کاری بکن» شدید است. Ceph در بیشتر موارد خودش را ترمیم میکند (recovery و backfill). مداخلهی شتابزده، مثل ceph osd out گروهی یا راهاندازی دوبارهی همهی OSDها، معمولاً وضعیت را بدتر میکند. قاعده: یک تغییر در هر زمان، و مشاهدهی اثر آن.
۱۷-۲-۱ هشدارهای پرتکرار#
| کد سلامت | معنای کوتاه | نخستین فرمان |
|---|---|---|
| OSD_DOWN | یک یا چند OSD پاییناند | ceph osd tree down |
| PG_AVAILABILITY | PGهایی غیرفعالاند و I/O ندارند | ceph pg dump_stuck inactive |
| PG_DEGRADED | نسخههای کمتر از size | ceph pg dump_stuck degraded |
| SLOW_OPS | عملیات بیش از osd_op_complaint_time در جریان | ceph daemon osd.N dump_historic_slow_ops |
| OSD_NEARFULL / OSD_FULL | پر شدن OSD | ceph osd df tree |
| OSD_SCRUB_ERRORS / PG_DAMAGED | ناسازگاری یافتهشده در scrub | rados list-inconsistent-obj PGID |
| OBJECT_UNFOUND | نسخهی معتبر شیء پیدا نمیشود | ceph pg PGID list_unfound |
| MON_CLOCK_SKEW | اختلاف ساعت MONها | chronyc tracking |
| LARGE_OMAP_OBJECTS | شیء با omap بسیار بزرگ | ceph log last و grep Large omap |
| BLUEFS_SPILLOVER | RocksDB از block.db به دیسک کند سرریز کرده | ceph daemon osd.N bluefs stats |
| BLUESTORE_SLOW_OP_ALERT | عملیات کند در لایهی BlueStore | ceph health detail |
| RECENT_CRASH | crash تازهی daemon | ceph crash info ID |
همهی کدهای جدول بالا در صفحهی Health Checks مستندات latest ثبت شدهاند. پیوست «کتابچهی عیبیابی» فهرست کاملتر را دارد.
۱۷-۳ مشکلات MON#
- از دست رفتن quorum: هیچ فرمانی پاسخ نمیدهد. روی هر میزبان MON با سوکت مدیریت بررسی کنید:
ceph daemon mon.$(hostname -s) mon_status (در cephadm: cephadm shell --name mon.<host> و سپس همان فرمان). فیلدهای state، quorum و outside_quorum را ببینید. - clock skew: Paxos به lease زمانی وابسته است؛
chronyc sources و chronyc tracking روی همهی MONها. - رشد store.db: در دورههای طولانی ناسالم، MON نقشههای قدیمی را trim نمیکند.
ceph tell mon.* compact و رفع علت ناسالمی.
چرا MON بدون quorum هیچ کاری نمیکند؟ هر تغییر نقشه یک پیشنهاد Paxos است که باید به تأیید اکثریت برسد (src/mon/Paxos.cc). حتی خواندنها از MONی که lease معتبر ندارد سرویس داده نمیشوند تا کلاینت نقشهی کهنه نگیرد. پس با سه MON، از دست رفتن دو MON یعنی توقف کامل مدیریت کلاستر، هرچند OSDها با آخرین نقشه به سرویس I/O ادامه میدهند تا وقتی که به تغییر نقشه نیاز باشد.
۱۷-۴ مشکلات OSD#
ceph osd tree down
ceph osd find 12                         # میزبان و مسیر
cephadm logs --name osd.12 -- -n 200     # روی میزبان
ceph crash ls | grep osd.12
ceph daemon osd.12 status                # اگر بالا است
ceph osd dump | grep -E "^osd.12 "| نشانه | علت محتمل | اقدام |
|---|---|---|
| OSD مدام down/up میشود (flapping) | شبکهی cluster، heartbeat، بار سنگین | بررسی شبکه، ceph osd set nodown فقط موقت |
| OSD بالا نمیآید با خطای BlueStore | خرابی دیسک یا فراداده | ceph-bluestore-tool fsck، بررسی SMART |
| OSD با OOM کشته میشود | osd_memory_target بیش از RAM | کاهش هدف حافظه، بررسی cache |
| OSD «wrongly marked me down» | تأخیر heartbeat | شبکه، osd_heartbeat_grace (پیشفرض ۲۰ ثانیه) |
nodown و noout ابزارهای موقتاند. nodown روی OSD واقعاً مرده باعث میشود کلاینتها منتظر OSDی بمانند که هرگز پاسخ نمیدهد. پس از رفع مشکل حتماً ceph osd unset کنید؛ هشدار OSDMAP_FLAGS یادآور شماست. OSDی که down است پس از mon_osd_down_out_interval (پیشفرض ۱۰ دقیقه) بهطور خودکار out میشود و backfill آغاز میشود.
۱۷-۵ وضعیتهای PG#
| وضعیت | معنا | نگرانی |
|---|---|---|
| active+clean | سالم: همهی نسخهها همگام | ندارد |
| peering | OSDها در حال توافق بر سر تاریخچهی PG | اگر طولانی شود |
| activating | peering تمام شده، در حال فعالسازی | معمولاً کوتاه |
| degraded | برخی اشیا نسخهی کمتر از size دارند | متوسط |
| undersized | تعداد OSDهای acting کمتر از size | متوسط |
| remapped | acting با up متفاوت است (pg_temp) | معمولاً گذرا |
| backfill_wait / backfilling | انتظار برای رزرو یا کپی کامل PG | گذرا |
| recovery_wait / recovering | انتظار یا بازیابی بر پایهی log | گذرا |
| down | OSDهای لازم برای peering در دسترس نیستند | بالا: I/O متوقف |
| incomplete | هیچ OSDی تاریخچهی کافی ندارد | بالا |
| stale | MON مدتی از primary خبری نگرفته | بالا |
| inconsistent | scrub ناسازگاری یافته | بالا |
| recovery_unfound / backfill_unfound | شیء بدون نسخهی معتبر | بحرانی |
ceph pg stat
ceph pg dump_stuck inactive
ceph pg dump_stuck unclean
ceph pg dump_stuck stale
ceph pg ls down
ceph pg 2.1f query | jq '.state, .recovery_state[0]'خروجی ceph pg <pgid> query بخشی به نام recovery_state دارد که مسیر ماشین حالت PG را نشان میدهد؛ مثلاً Started/Primary/Peering/GetInfo یا Started/Primary/Peering/Down همراه با blocked و down_osds_we_would_probe. این همان نامهایی است که در PeeringState.h تعریف شدهاند.
۱۷-۶ از درون کد: ماشین حالت Peering#
۱۷-۶-۱ ساختار سلسلهمراتبی#
src/osd/PeeringState.h ماشین حالت PG را با boost::statechart تعریف میکند. هر حالت یک struct است که والدش را مشخص میکند؛ مثلاً struct GetInfo : boost::statechart::state<GetInfo, Peering>. بنابراین نام کامل حالت یک مسیر است: Started/Primary/Peering/GetInfo. رویدادها (مانند AdvMap برای نقشهی جدید، MNotifyRec برای دریافت اطلاعات از OSD دیگر، GotLog، Activate) بین حالتها جابهجا میکنند.
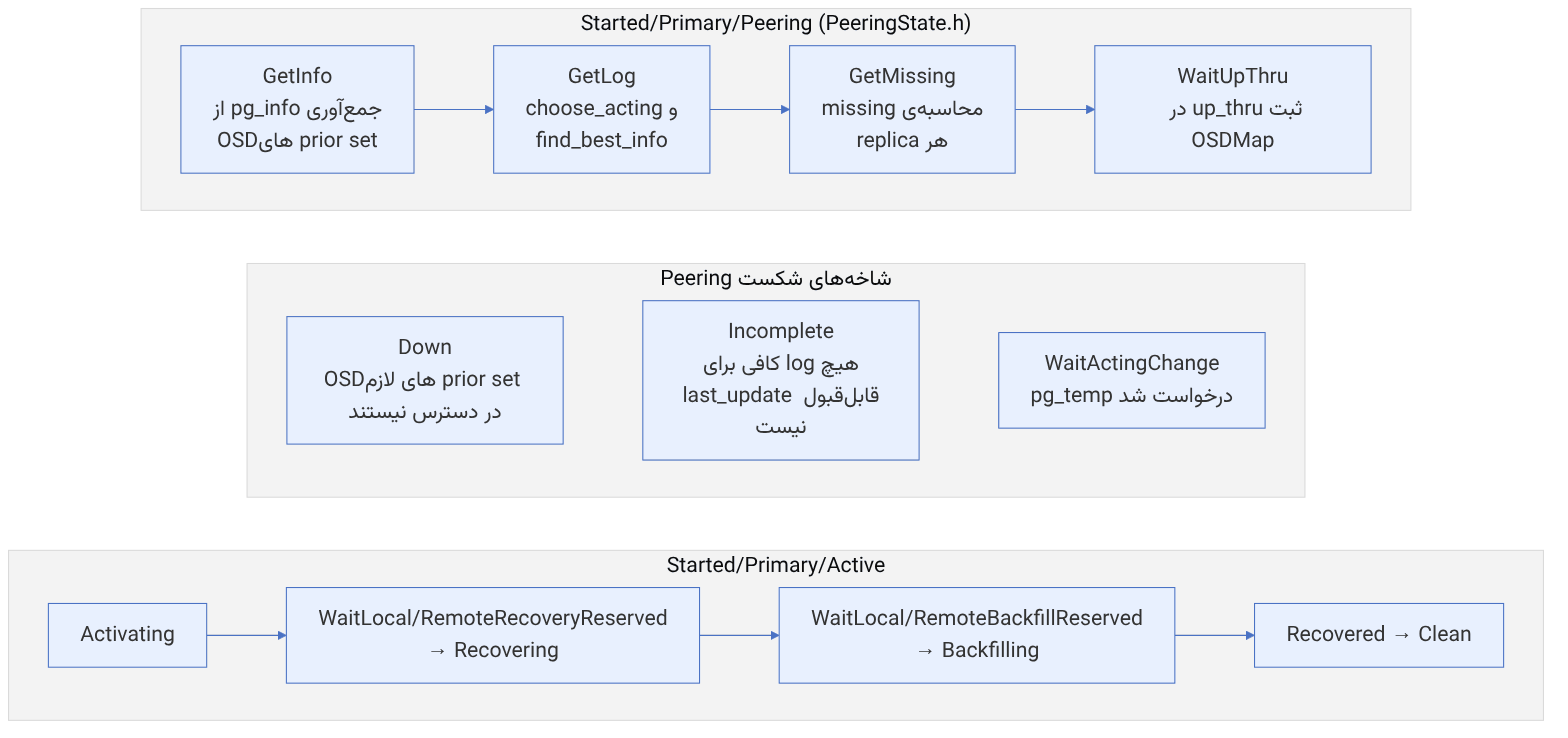
| حالت | کار |
|---|---|
| GetInfo | از همهی OSDهای prior set (OSDهایی که ممکن است از آخرین interval فعال، نوشتن داشته باشند) pg_info میخواهد |
| GetLog | با choose_acting بهترین log را انتخاب و در صورت نیاز از آن OSD میگیرد |
| GetMissing | log هر replica را با log معتبر مقایسه و فهرست missing را میسازد |
| WaitUpThru | منتظر میماند تا MON ثبت up_thru این OSD را در نقشه منتشر کند |
| Down | اطلاعات کافی از prior set نیست؛ منتظر بازگشت OSDها |
| Incomplete | log کافی برای ادامه نیست؛ نیاز به مداخلهی دستی |
| WaitActingChange | primary درخواست pg_temp داده و منتظر نقشهی جدید است |
۱۷-۶-۲ prior set و up_thru: چرا PG «down» میشود#
مسئلهی اصلی peering این است: آیا ممکن است نوشتنی تأییدشده وجود داشته باشد که ما از آن خبر نداریم؟ هر بار که acting set عوض میشود، یک interval جدید آغاز میشود. PG برای هر interval گذشته از زمان آخرین active شدن، بررسی میکند آیا در آن interval ممکن بوده PG فعال شده و نوشتن پذیرفته باشد. این «ممکن بودن» با up_thru سنجیده میشود: primary پیش از active شدن باید منتظر بماند تا MON در OSDMap ثبت کند که این OSD تا این epoch زنده بوده است (حالت WaitUpThru). اگر intervalی وجود داشته باشد که در آن up_thru ثبت شده (پس شاید نوشتن رخ داده) و هیچیک از OSDهای آن interval اکنون در دسترس نباشند، PG نمیتواند مطمئن شود و به Down میرود.
pseudocode: ساختن prior set (خلاصهی این کتاب از PastIntervals در osd_types)
for interval in past_intervals since last_epoch_started:
if not interval.maybe_went_rw: continue # up_thru ثبت نشده → نوشتن ممکن نبوده
up_now = [osd for osd in interval.acting if osd is up]
# تکثیری: اگر هیچ OSD زندهای از آن interval نمانده باشد → down
if not recoverable(up_now): pg_down = true # EC: کمتر از k shard (سادهشده؛ predicate واقعی IsPGRecoverablePredicate)
probe += up_now
return (probe, pg_down, down_osds_we_would_probe)به همین دلیل خروجی pg query در وضعیت down فیلد down_osds_we_would_probe را نشان میدهد: OSDهایی که اگر برگردند، PG میتواند peering را کامل کند. راه درست تقریباً همیشه برگرداندن همان OSDها است، نه علامت زدن آنها به عنوان lost. فرمان ceph osd lost به PG اجازه میدهد بدون آن OSD ادامه دهد، اما هر نوشتن تأییدشدهای که فقط روی آن OSD بوده برای همیشه از دست میرود.
۱۷-۶-۳ find_best_info: کدام log معتبر است؟#
در GetLog، تابع PeeringState::find_best_info() از میان pg_infoهای دریافتشده بهترین را انتخاب میکند. منطق آن (بازنویسی این کتاب):
pseudocode: find_best_info(infos)
(max_les, min_lu) = calculate_maxles_and_minlua(infos) # بیشینهی last_epoch_started
if min_lu == max: return none # هیچ نامزد قابل قبولی نیست
best = none
for (shard, info) in infos:
skip if info.last_update < min_lu
skip if info.last_epoch_started < max_les
skip if info.is_incomplete()
if best is none: best = info; continue
if pool.require_rollback(): # EC: کمترین last_update ایمن است (rollback ممکن)
prefer smaller last_update
else: # تکثیری: بیشترین last_update
prefer larger last_update
then prefer smaller log_tail # log بلندتر → recovery بر پایهی log برای بیشتر replicaها
then prefer complete (no missing)
then prefer current primary / up set
return bestتفاوت تکثیری و EC آموزنده است: در pool تکثیری، replica با جدیدترین نوشتن مرجع میشود و بقیه با log به آن میرسند. در EC، نوشتن ناقص روی چند shard قابل بازسازی نیست؛ بنابراین Ceph نسخهای را مرجع میگیرد که همهی shardها بتوانند به آن برگردند (rollback). این همان دلیلی است که EC به rollback info در log نیاز دارد (require_rollback()).
گزینهی osd_find_best_info_ignore_history_les (که در PeeringState.cc بررسی میشود) فقط برای بازیابی اضطراری PGهای incomplete است و میتواند دادهی تأییدشده را دور بریزد. آن را فقط با درک کامل، روی یک OSD، بهطور موقت و ترجیحاً با راهنمایی متخصص به کار ببرید و بلافاصله برگردانید.
۱۷-۷ سه الگوریتم عیبیابی با عدد#
عیبیاب خوب باید بداند خروجیهایی مثل «PG down است»، «slow request 61 seconds old» یا «deep scrub عقب افتاده» دقیقاً از کدام محاسبه بیرون میآیند. این بخش سه محاسبه را با دادهی نمونه دنبال میکند.
۱۷-۷-۱ کدام OSD log معتبر را دارد؟#
منبع در کد: src/osd/PeeringState.cc :: PeeringState::calculate_maxles_and_minlua، PeeringState::find_best_info
پیچیدگی: O(R) برای R info دریافتی، دو گذر خطی
pseudocode
max_les = 0
for info: max_les = max(max_les, info.history.les) # مگر osd_find_best_info_ignore_history_les
if !incomplete: max_les = max(max_les, info.les)
min_lua = min(info.last_update | info.les ≥ max_les) # اگر هیچ: PG بدون info معتبر
best = ∅
for info (فقط up/acting اگر restrict):
رد شو اگر lu < min_lua یا les < max_les یا incomplete
replicated: lu بزرگتر بهتر ؛ EC (require_rollback): lu کوچکتر بهتر
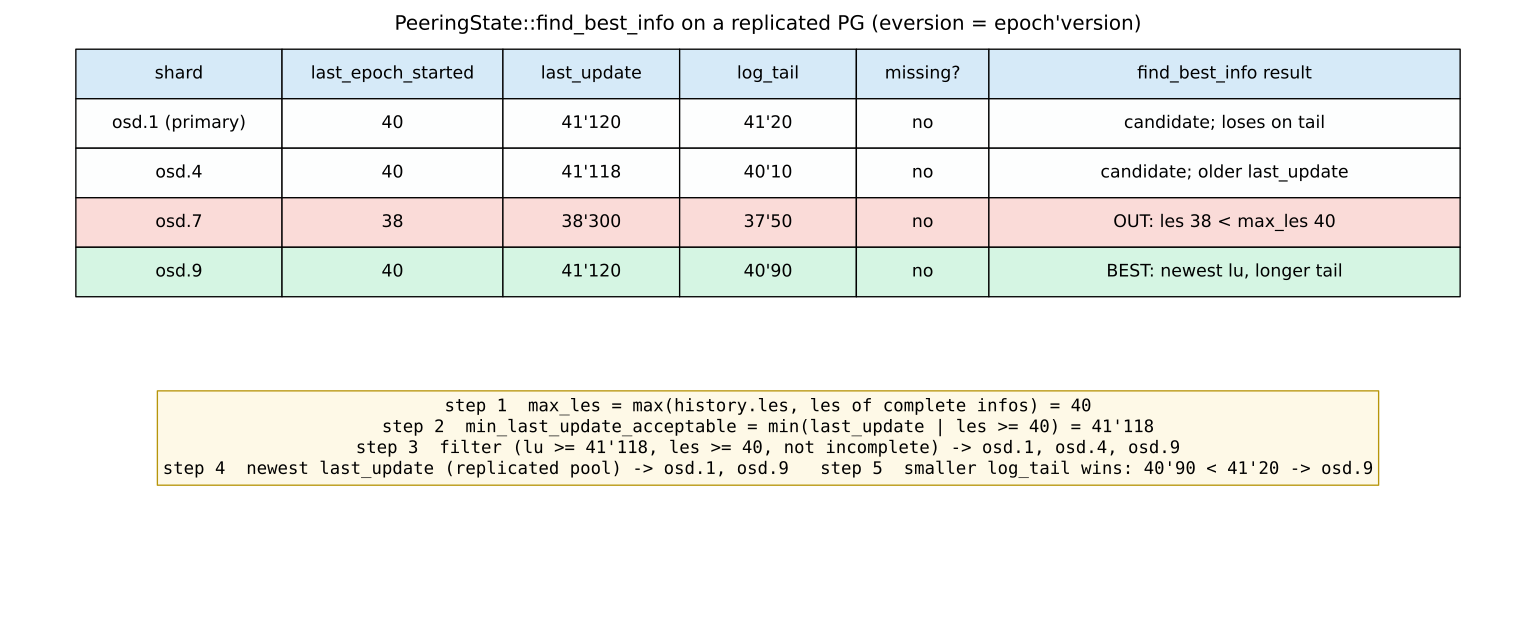
در تساوی: log_tail کوچکتر (log بلندتر) ؛ سپس بدون missing ؛ سپس primary فعلیمثال عددی. یک PG replicated چهار info میگیرد (eversion به شکل epoch'version):
| OSD | les | last_update | log_tail |
|---|---|---|---|
| osd.1 (primary) | ۴۰ | ۴۱'۱۲۰ | ۴۱'۲۰ |
| osd.4 | ۴۰ | ۴۱'۱۱۸ | ۴۰'۱۰ |
| osd.7 | ۳۸ | ۳۸'۳۰۰ | ۳۷'۵۰ |
| osd.9 | ۴۰ | ۴۱'۱۲۰ | ۴۰'۹۰ |
مراحل انتخاب:
- ۱. max_les = ۴۰.
- ۲. min_lua از میان les ≥ ۴۰ برابر ۴۱'۱۱۸ است. مقایسهی eversion نخست epoch را میسنجد، پس ۳۸'۳۰۰ از ۴۱'۱۱۸ کوچکتر است، هرچند version آن بزرگتر است.
- ۳. osd.7 به خاطر les 38 حذف میشود.
- ۴. از میان سه نامزد باقیمانده، osd.1 و osd.9 جدیدترین last_update را دارند.
- ۵. tail کوچکتر، یعنی ۴۰'۹۰ < ۴۱'۲۰، برنده است، پس osd.9 مرجع میشود، نه primary.
primary پس از این مرحله log معتبر را از osd.9 میگیرد (GetLog). اگر همهی OSDهای les = ۴۰ از کار افتاده باشند، min_lua تعریفنشده میماند و PG در حالت down/incomplete گیر میکند. این همان جایی است که ceph pg query در بخش recovery_state فهرست down_osds_we_would_probe را نشان میدهد.
۱۷-۷-۲ زمانبندی هشدار slow request#
منبع در کد: src/common/TrackedOp.cc :: OpTracker::with_slow_ops_in_flight، OpTracker::check_ops_in_flight، visit_ops_in_flight
پیچیدگی: O(تعداد op در حال اجرا) در هر بررسی؛ ops هر شارد به ترتیب زمان آغاز پیمایش و در اولین op جوان متوقف میشود
pseudocode
too_old = now − osd_op_complaint_time (30 s)
visit ops by initiated (قدیمی به جدید):
if op.initiated ≥ too_old: stop # بقیه جوانترند
if continuous یا multiplier == 0: skip
slow++ # در SLOW_OPS و health شمرده میشود
if warned ≥ osd_op_log_threshold (5): continue # فقط شمردن، نه لاگ
if op.initiated + 30 × multiplier ≥ now: continue
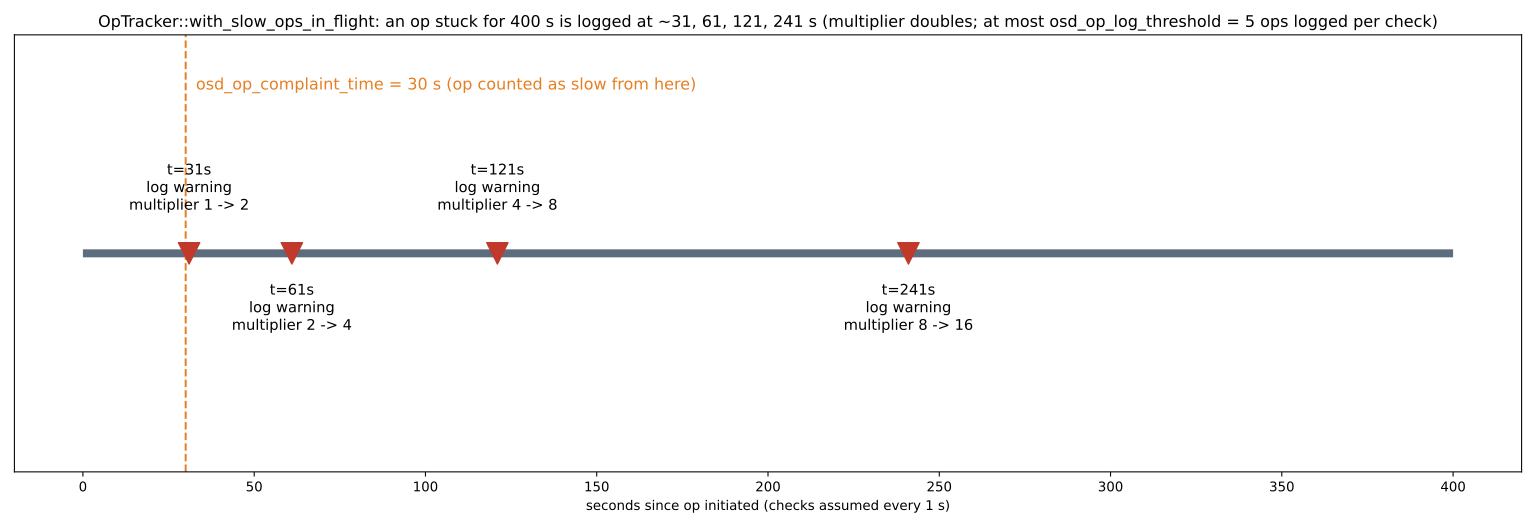
warned++ ; log "slow request …" ; multiplier ×= 2مثال عددی. یک op در t = ۰ گیر کرده است و OSD هر ثانیه بررسی میکند.
- t = ۳۱ s: op کند است و multiplier = ۱، پس ۰ + ۳۰ < ۳۱ و لاگ میشود. multiplier به ۲ میرسد.
- لاگ بعدی وقتی است که ۰ + ۶۰ < now، یعنی t = ۶۱. پس از آن t = ۱۲۱ و t = ۲۴۱ (multiplier 4 و ۸).
- در کل در ۴۰۰ ثانیه چهار خط لاگ برای این op نوشته میشود، اما در همهی این مدت در شمارش SLOW_OPS هست.
اگر ۵۰ op همزمان کند باشند، هر بررسی حداکثر ۵ خط لاگ میدهد، اما «۵۰ slow requests» گزارش میشود. پس خلوت بودن لاگ به معنای کم بودن opهای کند نیست. برای دیدن همه، از ceph daemon osd.N dump_ops_in_flight و dump_historic_slow_ops استفاده کنید.
۱۷-۷-۳ زمان scrub بعدی#
منبع در کد: src/osd/scrubber/scrub_job.cc :: ScrubJob::adjust_shallow_schedule، ScrubJob::adjust_deep_schedule، ScrubJob::guaranteed_offset؛ src/osd/scrubber/pg_scrubber.cc :: PgScrubber::populate_config_params
پیچیدگی: O(۱) برای هر PG پس از هر scrub
pseudocode
shallow (اگر فوری نیست): target = last + min_interval + min_interval × randomize_ratio × U[0,1]
                         not_before = max(last, target)
deep:  sdv = deep_interval × cv
       target = last + clamp(N(deep_interval, sdv), deep_interval − 2·sdv, deep_interval + 2·sdv)
فوری (operator/repair): زمان = scrub_must_stamp ، بدون تصادف
guaranteed_offset: shallow = min × (2 + ratio) ، deep = deep + 3·sdv + 10 s
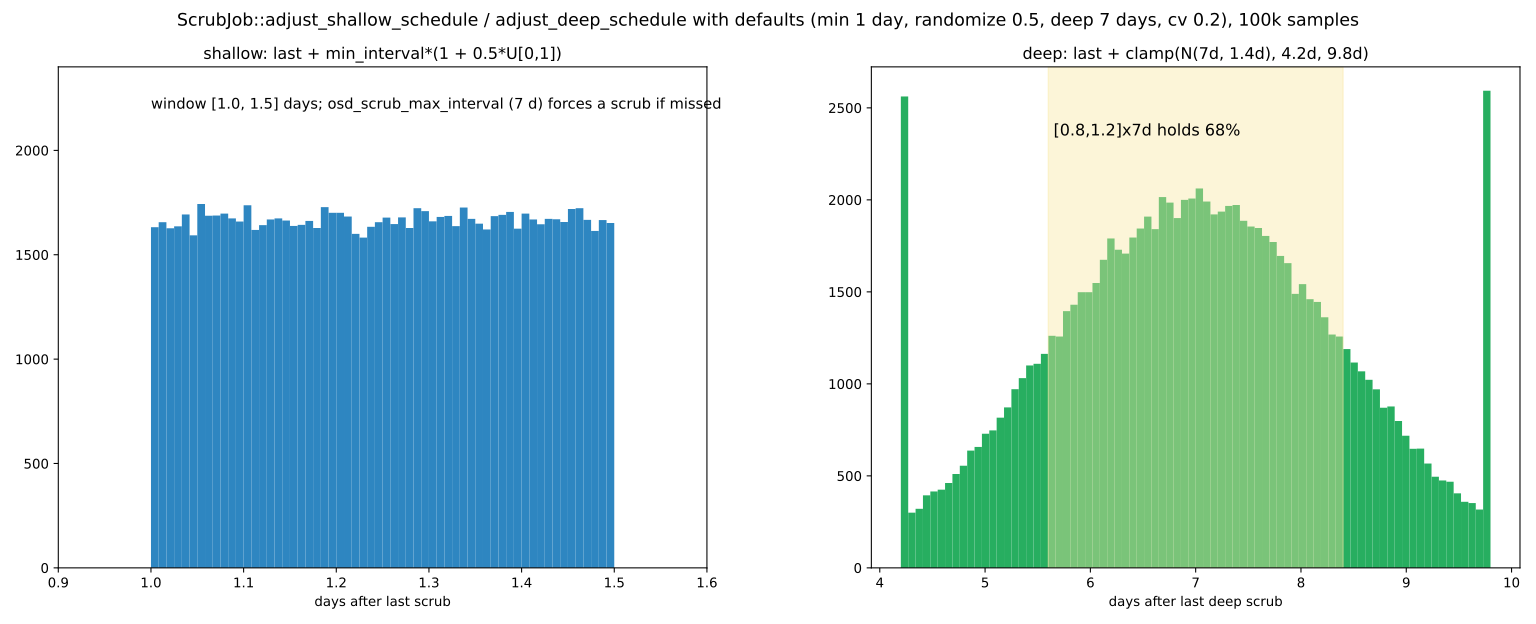
مثال عددی (پیشفرضها: min 1 روز، randomize 0.5، deep 7 روز، cv 0.2).
- scrub سطحی: بعدی در بازهی یکنواخت ۱ تا ۱.۵ روز پس از آخرین scrub است.
- scrub عمیق: sdv = ۱.۴ روز و نمونه به بازهی ۴.۲ تا ۹.۸ روز بریده میشود. در شبیهسازی ۱۰۰۰۰۰ نمونه، حدود ۶۸٪ در بازهی ۵.۶ تا ۸.۴ روز (۰.۸ تا ۱.۲ برابر) افتادند و حدود ۲.۳٪ دقیقاً روی دو مرز قرار گرفتند.
متن long_desc گزینهی osd_deep_scrub_interval_cv میگوید ۹۵٪ در [۰.۸، ۱.۲] هستند. اما با cv = ۰.۲ این بازه فقط یک انحراف معیار است. ۹۵٪ در ±۲σ، یعنی [۰.۶، ۱.۴] قرار میگیرد. این ناسازگاری در متن راهنمای گزینه است، نه در رفتار. برای کلاستری با ۴۰۹۶ PG، این پخششدگی یعنی بهطور متوسط حدود ۵۸۵ deep scrub در روز (۴۰۹۶/۷)، بدون اینکه همه با هم در یک روز شروع شوند.
وابسته به نسخه. گزینهی osd_deep_scrub_interval_cv و زمانبندی نرمال deep scrub از v19.2.x (Squid) به بعد وجود دارد (در v19.2.3، v20.2.0 و v21.2.0 بررسی شد). در v18.2.4 (Reef) این گزینه وجود ندارد و، deep scrub با osd_deep_scrub_randomize_ratio و احتمال ارتقای scrub سطحی به عمیق تصادفی میشد. پیش از تنظیم، ceph config help osd_deep_scrub_interval_cv را روی نسخهی خودتان بررسی کنید.
۱۷-۸ عیبیابی با دادهی اندازهگیریشده#
دو شکل این بخش از دادهی واقعی ساخته شدهاند و حدس نیستند. اولی خط زمانی حالت PGها را روی یک کلاستر آزمایشی واقعی نشان میدهد. دومی اثر از دست رفتن میزبان را با شمارش دقیق روی نگاشت CRUSH نشان میدهد.
۱۷-۸-۱ خط زمانی حالت PGها#
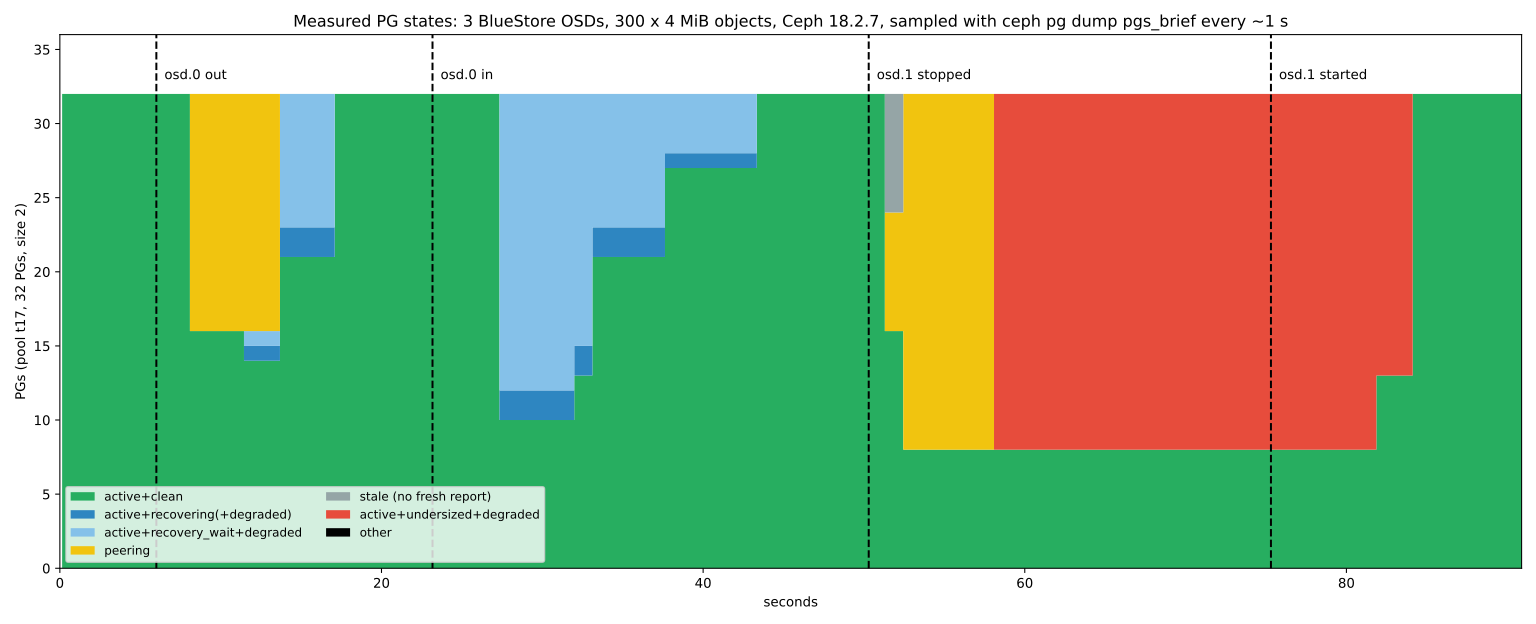
آزمایش روی یک کلاستر سهOSDی BlueStore با Ceph 18.2.7 (بستههای Debian) انجام شد. pool t17 با ۳۲ PG و size = ۲ داشت و ۳۰۰ شیء ۴ MiB در آن نوشته شده بود. هر ثانیه ceph pg dump pgs_brief -f json گرفته و حالتها شمرده شدند. چهار رخداد پشت سر هم اجرا شد: ceph osd out 0، سپس ceph osd in 0، سپس توقف فرایند osd.1 و در پایان راهاندازی دوبارهی آن.
منبع در کد: ceph pg dump pgs_brief (PGMap در mgr)؛ رشتهی حالت از pg_state_string در src/osd/osd_types.cc
پیچیدگی: O(pg_num) در هر نمونه
pseudocode
هر 1 ثانیه:
pgs = ceph pg dump pgs_brief -f json
count[state] += 1 برای هر pg # state مثل "active+recovery_wait+degraded"
گروهبندی: clean / recovering / recovery_wait / peering / stale / undersized
رخداد بعدی فقط وقتی اجرا میشود که هر 32 PG دوباره active+clean باشندآنچه دیده شد.
- out کردن osd.0: حدود ۱۶ PG به peering رفتند. سپس PGها بهجای backfill در حالت
recovery_wait+degraded و recovering دیده شدند. دلیلش این است که در این pool هر PG فقط حدود ۹ شیء دارد و log هر PG، که دستکم osd_min_pg_log_entries = ۲۵۰ ورودی نگه میدارد، همهی تغییرها را پوشش میدهد. پس OSD جدید از روی log بازیابی میشود. در کلاستر واقعی با هزاران شیء در هر PG، همین رخداد backfill_wait و backfilling میسازد. - in کردن دوباره: ۲۲ PG چند ثانیه در
recovery_wait+degraded ماندند و صف شدند. این همان سقف osd_max_backfills و osd_recovery_max_active زیر mClock است. - توقف osd.1: چند ثانیه
stale دیده شد، چون mgr هنوز گزارش تازهای نداشت. سپس حدود ۶ ثانیه peering طول کشید و در پایان دقیقاً ۲۴ PG، یعنی همهی PGهایی که osd.1 در up set آنها بود، active+undersized+degraded شدند. I/O ادامه یافت، چون min_size = ۱ بود. این تنظیم فقط برای آزمایش است و در محیط واقعی خطرناک است. - بالا آمدن osd.1: PGها با recovery از log در چند ثانیه clean شدند. مکث نشاندادهشده بیشتر تأخیر گزارش آمار است تا خود recovery.
۱۷-۸-۲ از دست رفتن یک، دو یا سه میزبان#
منبع در کد: نگاشت up از osdmaptool --test-map-pgs-dump؛ معیار min_size در PeeringState (فصل 17)
پیچیدگی: O(C(H,k) × pg_num × size)
pseudocode
برای هر ترکیب F از k میزبان (همهی C(10, k) ترکیب):
برای هر PG: n = تعداد replicaهای روی میزبانهای F
degraded اگر n ≥ 1 ؛ inactive اگر size − n < min_size ؛ lost اگر n = size
میانگین، کمینه و بیشینه روی ترکیبها
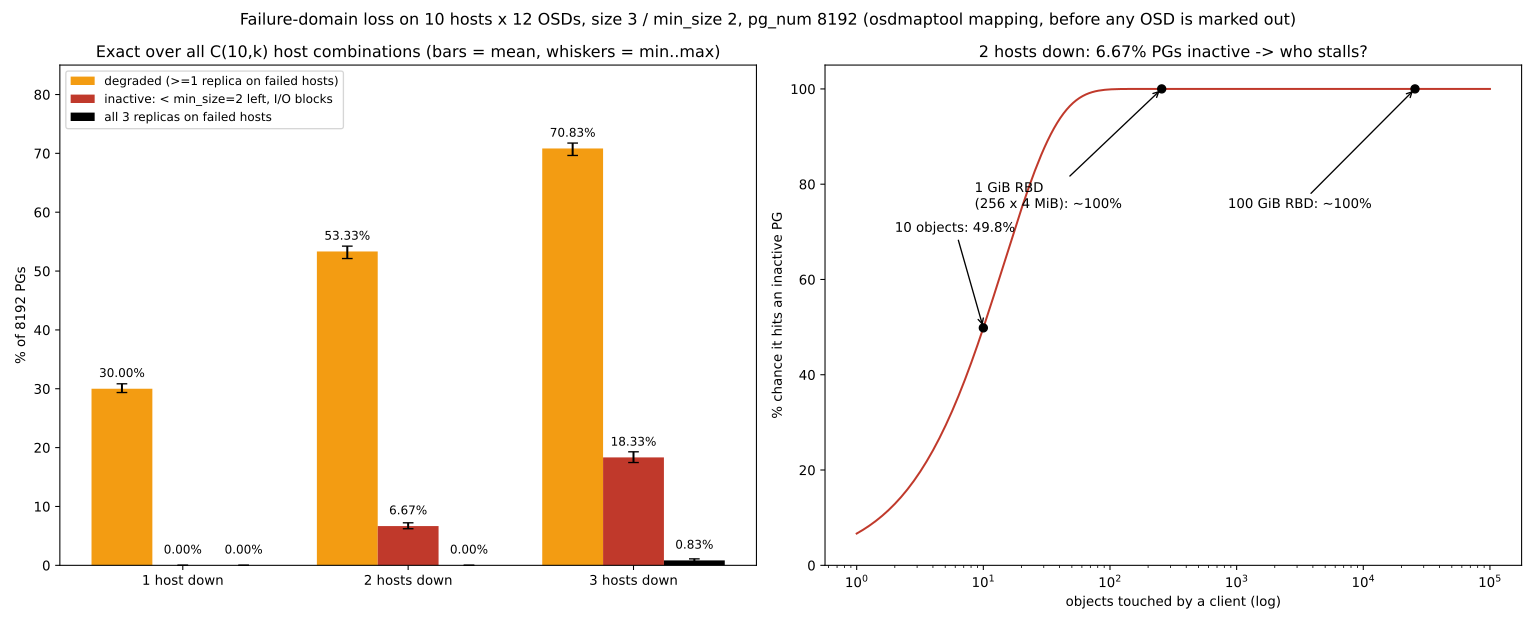
P(کلاینتی که N شیء را لمس میکند گیر کند) = 1 − (1 − p_inactive)^N # شیء→PG با hash یکنواختنتیجه (۱۲۰ OSD، size = ۳، min_size = ۲، ۸۱۹۲ PG).
| میزبانهای ازکارافتاده | PG degraded | PG inactive | PG بینسخه |
|---|---|---|---|
| ۱ | ۳۰.۰۰٪ | ۰ | ۰ |
| ۲ | ۵۳.۳۳٪ | ۶.۶۷٪ (۵۴۶ PG، بازهی ۵۰۹ تا ۵۹۲) | ۰ |
| ۳ | ۷۰.۸۳٪ | ۱۸.۳۳٪ | ۰.۸۳٪ (۶۸ PG) |
میانگینها با فرمول بسته میخوانند. برای یک میزبان ۳/۱۰ است. برای PGهای inactive با دو میزبان C(۸,۱)/C(۱۰,۳) = ۸/۱۲۰ است. برای PGهای بینسخه با سه میزبان ۱/C(۱۰,۳) = ۱/۱۲۰ است.
پیام عملی در ستون inactive است. با دو میزبان ازکارافتاده فقط ۶.۶۷٪ PGها I/O را متوقف میکنند. اما یک image RBD یکگیگابایتی (۲۵۶ شیء) با احتمال دستکم یک شیء روی آنها دارد. حتی کلاینتی که فقط ۱۰ شیء را لمس میکند در ۵۰٪ موارد گیر میکند. پس «فقط ۷٪ PGها» در عمل یعنی تقریباً همهی ماشینهای مجازی متوقف شدهاند.
تا وقتی OSDها out نشدهاند (mon_osd_down_out_interval، فصل ۷)، CRUSH جای تازهای انتخاب نمیکند و این وضعیت ادامه دارد. اگر دو failure domain همزمان در خطرند، چاره بالا بردن size یا انتخاب failure domain بزرگتر است، نه پایین آوردن min_size.
۱۷-۹ slow ops: دنبال کردن یک عملیات#
۱۷-۹-۱ TrackedOp و رویدادها#
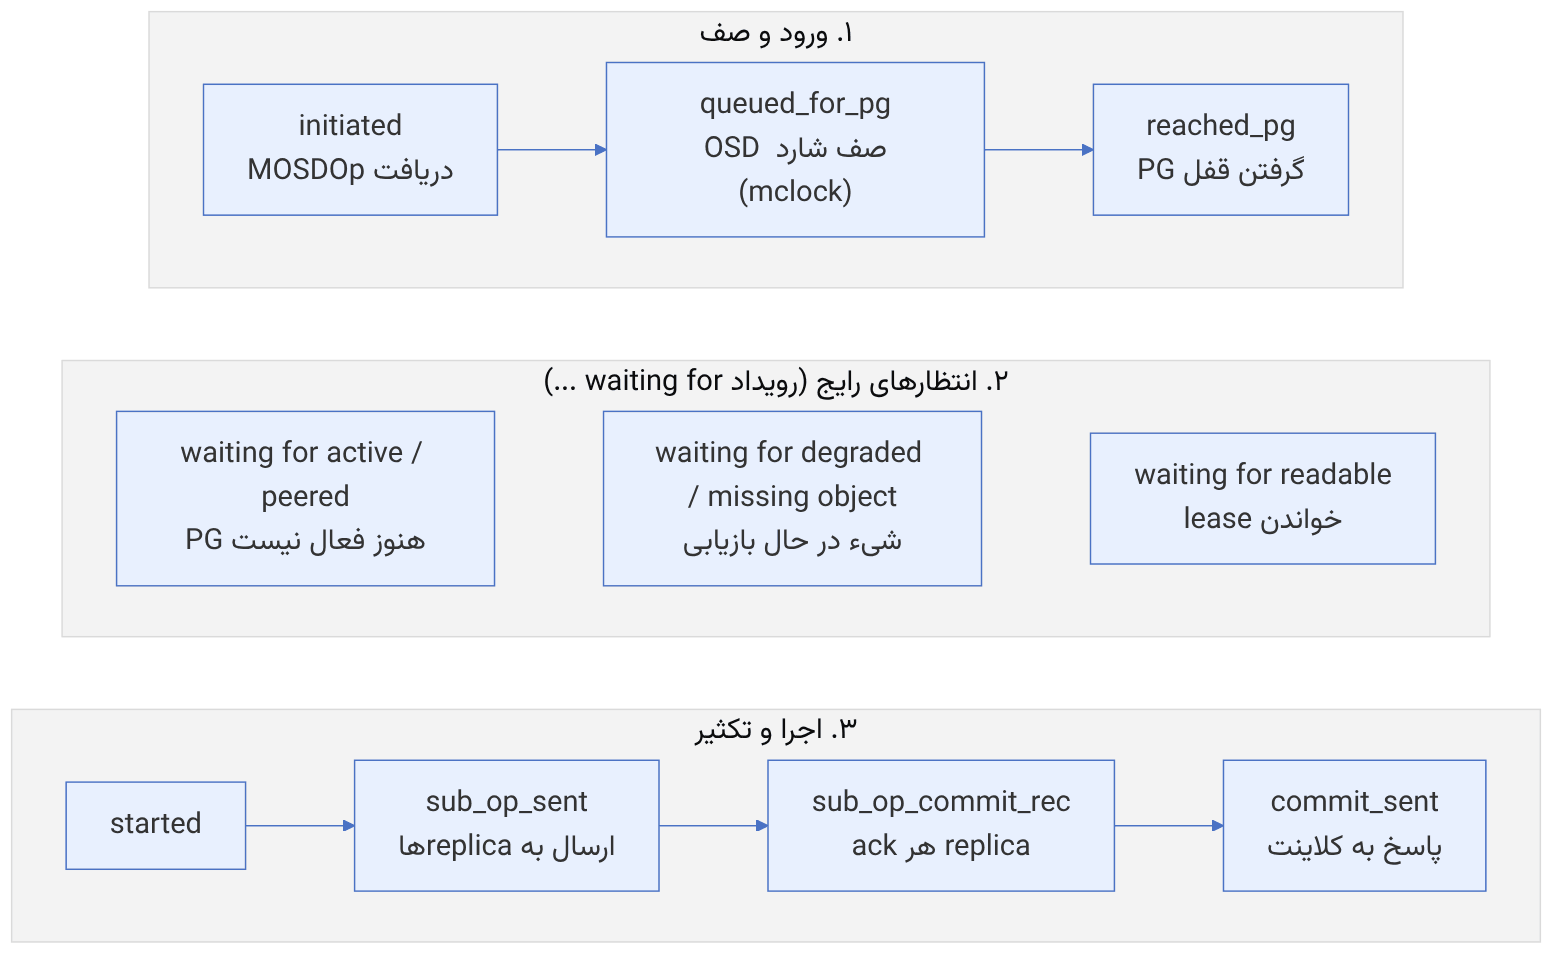
هر درخواست کلاینت در OSD یک OpRequest (زیرکلاس TrackedOp) است که در طول مسیر «رویداد» ثبت میکند. اگر عملیاتی بیش از osd_op_complaint_time (پیشفرض ۳۰ ثانیه) طول بکشد، در هشدار SLOW_OPS شمرده میشود.
ceph health detail | grep -A3 SLOW_OPS
ceph daemon osd.7 dump_ops_in_flight | jq '.ops[] | {age, description, last: .type_data.events[-1].event}'
ceph daemon osd.7 dump_blocked_ops
ceph daemon osd.7 dump_historic_slow_ops | jq '.ops[0].type_data.events'
ceph daemon osd.7 dump_historic_ops_by_duration | jq '.ops[0:3][] | {duration, description}'| آخرین رویداد | تفسیر | جای بعدی برای نگاه |
|---|---|---|
| queued_for_pg | در صف شارد مانده؛ OSD یا PG پربار | mclock، CPU، ceph osd perf |
| reached_pg و waiting for peered/active | PG فعال نیست | ceph pg PGID query |
| waiting for degraded/missing object | شیء در حال بازیابی | اولویت recovery، ceph pg force-recovery |
| sub_op_sent بدون sub_op_commit_rec | replica کند است | همان عملیات روی OSD replica، دیسک یا شبکهی آن |
| op_commit یا تأخیر BlueStore | دیسک محلی کند | ceph osd perf، iostat، BLUESTORE_SLOW_OP_ALERT |
نام رویدادهای پایه (queued_for_pg، reached_pg، started، commit_sent) در src/osd/OpRequest.h ثبت میشوند و رویدادهای «waiting for ...» در جاهای مختلف PrimaryLogPG.cc و OSD.cc. چون این رشتهها بخشی از رابط پایدار نیستند، در ابزارهای خودکار روی آنها تکیهی سخت نکنید.
یک slow op روی primary اغلب علامت است نه علت. اگر آخرین رویداد sub_op_sent است، همان شناسهی درخواست را روی OSDهای replica بگردید؛ معمولاً یک دیسک کند یا یک لینک شبکهی خراب پشت دهها slow op روی OSDهای مختلف است. ceph osd perf (ستونهای commit_latency و apply_latency) سریعترین راه یافتن OSD کند است.
۱۷-۱۰ scrub و ناسازگاری#
۱۷-۱۰-۱ ماشین حالت scrub#
scrub دورهای (پیشفرض osd_scrub_min_interval=1_day) فرادادهی اشیا را میان نسخهها مقایسه میکند و deep scrub (osd_deep_scrub_interval=7_day) داده را هم میخواند و checksum را بررسی میکند. کد جدید scrub در src/osd/scrubber/ است و ماشین حالت آن در scrub_machine.h با boost::statechart تعریف شده.
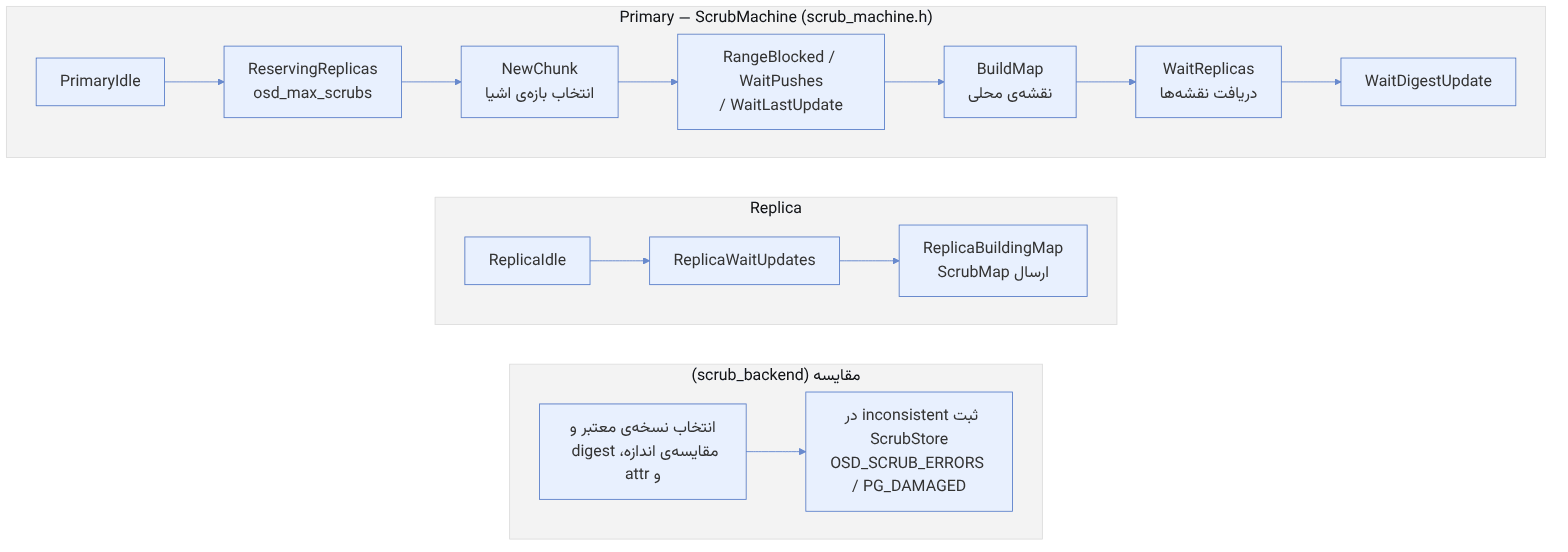
scrub بر اساس تکه (chunk) پیش میرود: primary یک بازه از اشیا را انتخاب میکند (NewChunk)، اگر نوشتنی روی آن بازه در جریان است منتظر میماند (RangeBlocked، WaitPushes، WaitLastUpdate)، سپس نقشهی محلی (ScrubMap) میسازد و از replicaها هم نقشه میخواهد. scrub_backend نقشهها را مقایسه میکند: اندازه، xattrها، digest داده و omap. ناسازگاریها در ScrubStore (یک شیء موقت) ثبت میشوند و با rados list-inconsistent-obj قابل خواندناند.
ceph health detail | grep -E "inconsistent|scrub errors"
rados list-inconsistent-pg rbd
rados list-inconsistent-obj 2.1f --format=json-pretty | jq '.inconsistents[] | {object: .object.name, errors, shards: [.shards[] | {osd, errors}]}'
ceph pg deep-scrub 2.1f          # تأیید دوباره پیش از تعمیر
ceph pg repair 2.1fپیش از ceph pg repair خروجی list-inconsistent-obj را بخوانید. اگر خطا روی یک shard یا یک OSD است (مثلاً read_error یا data_digest_mismatch فقط روی osd.12)، تعمیر نسخهی سالم را جایگزین میکند و باید دیسک osd.12 را بررسی کنید (SMART و dmesg). اگر چند نسخه با هم ناسازگارند و نسخهی معتبر روشن نیست، تعمیر ممکن است نسخهی اشتباه را انتخاب کند. افزایش شمارندهی OSD_TOO_MANY_REPAIRS نشانهی خرابی تدریجی دیسک است.
۱۷-۱۱ اشیای unfound و ابزارهای خطرناک#
ceph pg 2.5 list_unfound
ceph pg 2.5 query | jq '.recovery_state[] | select(.name|test("Active")) | .might_have_unfound'
# آخرین راه، پس از اطمینان از اینکه OSD دارای نسخه برنمیگردد:
ceph pg 2.5 mark_unfound_lost revert # یا delete| ابزار | کاربرد | خطر |
|---|---|---|
| ceph osd lost N | اجازهی peering بدون OSD مرده | از دست رفتن نوشتنهای تأییدشدهی منحصر به آن OSD |
| mark_unfound_lost revert/delete | پایان دادن به انتظار برای شیء unfound | بازگشت به نسخهی قبلی یا حذف شیء |
| ceph-objectstore-tool | خواندن، صدور و ورود PG از OSD متوقف | تغییر مستقیم دادهی OSD؛ فقط با OSD خاموش |
| ceph-bluestore-tool fsck/repair | بررسی و تعمیر فرادادهی BlueStore | repair ممکن است فراداده را تغییر دهد |
| osd_find_best_info_ignore_history_les | بازیابی PG incomplete | دور ریختن دادهی تأییدشده |
برای نجات یک PG از OSDی که دیگر بالا نمیآید ولی دیسکش خوانا است: OSD را متوقف کنید، با ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-12 --op list-pgs PGها را ببینید، با --op export --pgid 2.5 --file /backup/2.5.export صادر کنید و روی یک OSD سالم (متوقف) با --op import وارد کنید. در cephadm این کار را درون cephadm shell --name osd.12 انجام دهید. فصل ۱۸ این روال را کاملتر شرح میدهد.
- همیشه از
ceph health detail و کد هشدار شروع کنید. - پیش از تغییر، وضعیت را ثبت کنید؛ یک تغییر در هر زمان.
-
recovery_state در pg query نام دقیق حالت PeeringState را نشان میدهد. - PG down یعنی «OSDهای این فهرست را برگردان»، نه «lost کن».
- slow op را تا آخرین رویداد و تا OSD replica دنبال کنید.
- پیش از repair، ناسازگاری را بخوانید و دیسک مقصر را پیدا کنید.
۱۷-۱۲ تکمیلی و بهروز#
- کد scrub از Pacific به بعد بازنویسی و به
src/osd/scrubber/ منتقل شده و ماشین حالت جدا دارد؛ زمانبندی آن با mclock یکپارچه است. - هشدارهای تازهتری مانند
BLUESTORE_SLOW_OP_ALERT و DB_DEVICE_STALLED_READ_ALERT در مستندات Health Checks آمدهاند و کندی لایهی ذخیرهسازی را زودتر نشان میدهند. - در شاخهی main، حالتهای تازهای مانند
MigratingSource، MigratingTarget و WaitLocalPoolMigrationReserved برای مهاجرت pool به PeeringState افزوده شدهاند؛ این حالتها در برچسبهای v20.2.0 و v21.2.0 وجود ندارند و مربوط به نسخههای آیندهاند. -
ceph crash (ماژول mgr) جایگزین جستوجوی دستی core dumpها شده است.
۱۷-۱۳ تمرین عملی#
- ۱. در کلاستر آزمایشی با size=3 دو OSD از سه OSD یک PG را متوقف کنید و
recovery_state را در pg query دنبال کنید. - ۲. با
ceph osd set noout یک میزبان را برای نگهداری خاموش کنید؛ وضعیت PGها را ثبت و پس از بازگشت مقایسه کنید. - ۳. با
tc qdisc add dev eth1 root netem delay 200ms روی یک میزبان، slow ops بسازید و آن را تا OSD مقصر دنبال کنید. - ۴. یک شیء را مستقیماً روی یک OSD (با ceph-objectstore-tool) خراب کنید، deep scrub بگیرید و خروجی list-inconsistent-obj را تحلیل کنید.
- ۵. ماشین حالت
PeeringState.h را بخوانید و مسیر از Reset تا Clean را برای یک PG سالم بنویسید. - ۶. یک PG را با ceph-objectstore-tool صادر و روی OSD دیگری وارد کنید.
۱۷-۱۴ پرسشهای مرور#
- ۱. نخستین دو فرمان در هر حادثه کداماند و چرا؟
- ۲. تفاوت degraded، undersized و remapped چیست؟
- ۳. حالت WaitUpThru چه مشکلی را حل میکند؟
- ۴. چرا PG به حالت down میرود و فیلد down_osds_we_would_probe چه میگوید؟
- ۵. find_best_info در pool تکثیری و EC چه تفاوتی دارد و چرا؟
- ۶. آخرین رویداد sub_op_sent در یک slow op چه معنایی دارد؟
- ۷. scrub چگونه با نوشتنهای در جریان هماهنگ میشود؟
- ۸. پیش از ceph pg repair چه چیزی را باید بررسی کنید؟
- ۹. ceph osd lost چه خطری دارد؟
- ۱۰. چرا nodown و noout باید موقت باشند؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۷-۱۵ منابع این فصل#
- Health checks
https://docs.ceph.com/en/latest/rados/operations/health-checks/ - Monitoring OSDs and PGs
https://docs.ceph.com/en/latest/rados/operations/monitoring-osd-pg/ - Placement group states
https://docs.ceph.com/en/latest/rados/operations/pg-states/ - Troubleshooting PGs
https://docs.ceph.com/en/latest/rados/troubleshooting/troubleshooting-pg/ - Troubleshooting OSDs
https://docs.ceph.com/en/latest/rados/troubleshooting/troubleshooting-osd/ - Troubleshooting monitors
https://docs.ceph.com/en/latest/rados/troubleshooting/troubleshooting-mon/ - Peering (developer guide
https://docs.ceph.com/en/latest/dev/peering/ - Source: src/osd/PeeringState.h / .cc
https://github.com/ceph/ceph/blob/main/src/osd/PeeringState.h - Source: src/osd/scrubber
https://github.com/ceph/ceph/tree/main/src/osd/scrubber - Source: src/osd/OpRequest.h
https://github.com/ceph/ceph/blob/main/src/osd/OpRequest.h