از VSM تا Ceph Dashboard: مدیریت گرافیکی کلاستر
حوصله ندارم این فصل در چند خط
- Ceph Dashboard یک ماژول MGR است: یک REST API پایتونی و یک رابط Angular روی همان API که cephadm بهطور پیشفرض فعالش میکند.
- کنترل دسترسی مبتنی بر نقش (نقش روی scopeها) و SSO مشخص میکنند چه کسی چه کاری بکند؛ همهی کارها در audit log ثبت میشود.
- Tentacle سرویسهای mgmt-gateway و oauth2-proxy را آورد: یک درِ ورودی برای Dashboard، Grafana، Prometheus و Alertmanager.
- هر گام در Dashboard معادل CLI دارد؛ دادهها از حافظهی ceph-mgr خوانده میشوند و تازگیشان به گزارشهای دورهای OSDها بستگی دارد.
۹-۱ پیش از شروع#
۹-۱-۱ چرا این فصل بازنویسی شده است؟#
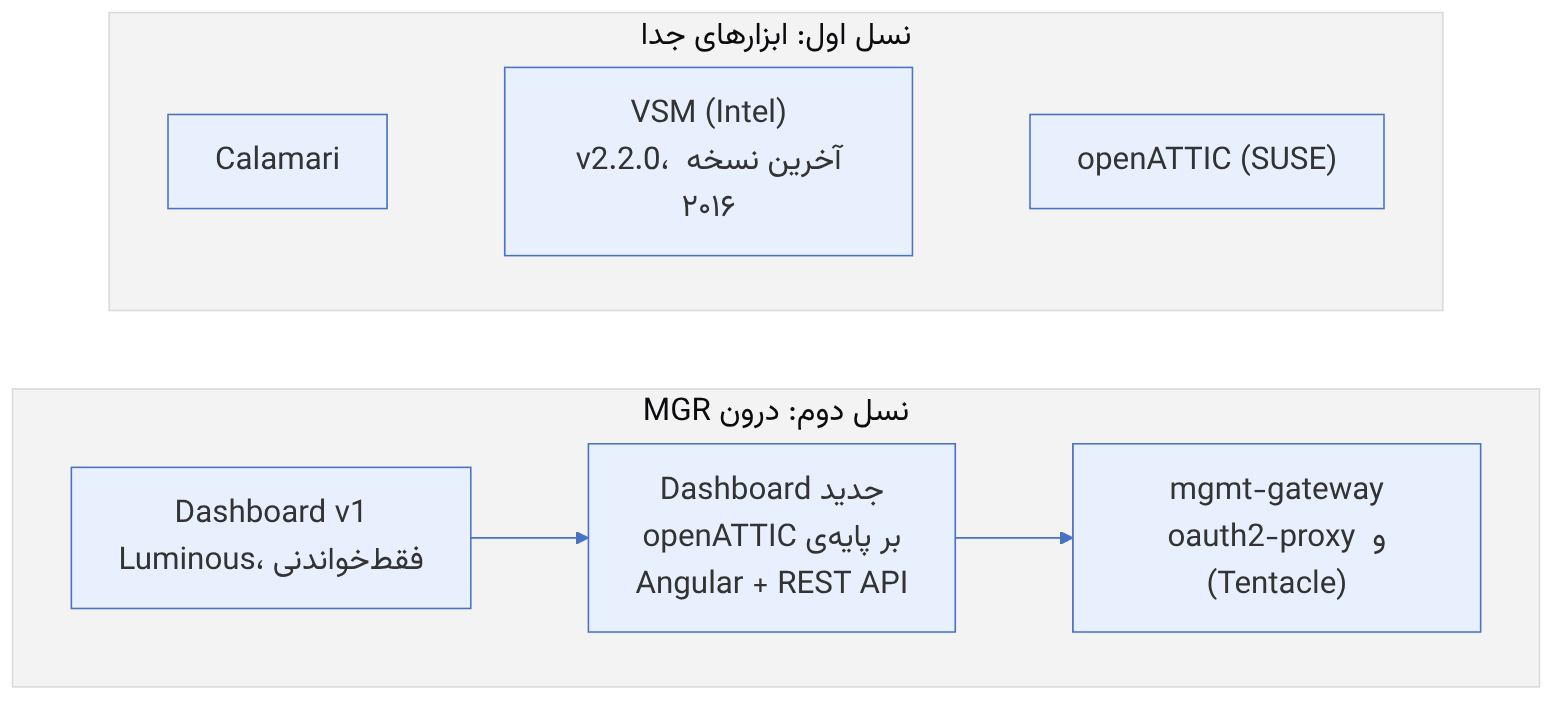
پیش از داشبورد، یکی از ابزارهای مدیریت گرافیکی شناختهشده Virtual Storage Manager (VSM) بود: ابزاری متنباز که Intel برای ساخت و مدیریت کلاستر Ceph از طریق رابط وب توسعه داده بود. امروز وضعیت این ابزار روشن است: مخزن آن در GitHub (intel/virtual-storage-manager) آرشیو شده، آخرین نسخهی منتشرشدهاش v2.2.0 در ژوئیهی ۲۰۱۶ است و آخرین تغییر کد به مارس ۲۰۱۷ برمیگردد. VSM فقط با نسخههای قدیمی Ceph (پیش از Luminous) کار میکرد و هیچ مسیر نگهداری ندارد.
بنابراین این فصل بهجای آموزش نصب VSM، همان نیاز را پاسخ میدهد: مدیریت گرافیکی کلاستر Ceph. ابزار امروزی این کار Ceph Dashboard است که جزئی از خود Ceph است. فصل را با مروری کوتاه بر تاریخچه شروع میکنیم تا روشن شود ایدههای VSM کجا رفتند.
- VSM چه بود و چرا کنار رفت؟
- معماری Ceph Dashboard چیست و چطور فعال و ایمن میشود؟
- کاربران، نقشها و SSO را چطور پیکربندی کنیم؟
- از Dashboard برای ساخت، پایش و ارتقا چطور استفاده کنیم؟
- mgmt-gateway و oauth2-proxy در Tentacle چه چیزی اضافه کردند؟
- محدودیتهای مدیریت گرافیکی و جایگاه درست آن کنار CLI و GitOps چیست؟
۹-۲ تاریخچه: از ابزارهای جدا تا Dashboard#
۹-۲-۱ VSM در یک نگاه#
VSM دو جزء اصلی داشت: یک کنترلر مرکزی (رابط وب، API و پایگاه داده) و یک عامل روی هر گره ذخیرهسازی که دستورهای کنترلر را اجرا میکرد. ایدههای کلیدی آن اینها بودند:
- گروههای ذخیرهسازی از پیش تعریفشده: مدیر سختافزار را در فایلهای manifest توصیف میکرد (کدام دیسک SSD است، کدام HDD، کدام گره در کدام zone) و VSM کلاستر را بر همان اساس میساخت.
- ساخت کلاستر، افزودن گره و ارتقا از طریق رابط وب.
- داشبورد وضعیت و یکپارچگی با OpenStack.
جالب است که بسیاری از این ایدهها امروز در خود Ceph وجود دارند، اما به شکل دیگری: «گروه ذخیرهسازی» به کلاس دستگاه و قانونهای CRUSH تبدیل شد (فصل ۸)، manifest سختافزار به spec سرویسها در cephadm (فصل ۱۱) و رابط وب به Dashboard. تفاوت اصلی این است که حالا همه درون پروژهی اصلیاند و با هر نسخهی Ceph بهروز میشوند.
۹-۲-۲ چرا ابزارهای جدا کنار رفتند؟#
ابزار مدیریتی که بیرون از Ceph نگهداری میشود، باید با هر نسخهی Ceph تطبیق داده شود؛ وقتی تیم یا شرکت پشتیبان اولویتش را تغییر دهد، ابزار از کار میافتد. Ceph با معرفی MGR در Luminous بستری فراهم کرد که ابزارهای مدیریتی به شکل ماژول پایتون درون خود Ceph اجرا شوند و مستقیماً به وضعیت کلاستر دسترسی داشته باشند. نسخهی اول Dashboard در Luminous فقطخواندنی بود؛ نسخهی بعدی بر پایهی معماری و کد openATTIC (که تیم SUSE توسعه میداد) بازنویسی شد و به ابزار مدیریت کامل تبدیل شد.
۹-۳ معماری Ceph Dashboard#
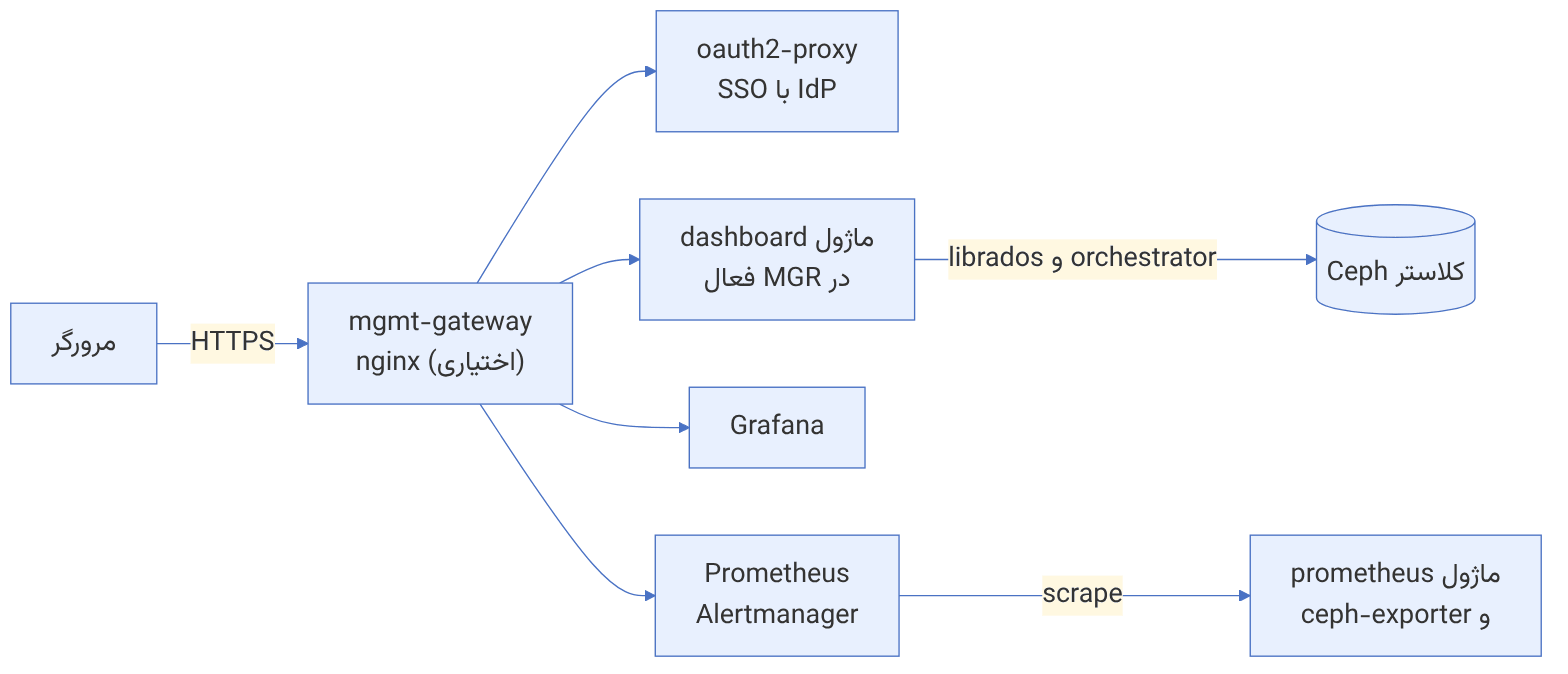
Dashboard یک ماژول MGR است: یک سرور وب پایتونی (CherryPy) که یک REST API ارائه میکند و یک رابط کاربری Angular که از همین API استفاده میکند. این یعنی:
- هر کاری که در رابط وب انجام میدهید، از طریق همین API هم قابل انجام و خودکارسازی است.
- Dashboard فقط روی MGR فعال سرویس میدهد؛ اگر MGR عوض شود، آدرس هم عوض میشود (مگر اینکه جلوی آن load balancer یا mgmt-gateway باشد).
- برای عملیات استقرار (افزودن میزبان، OSD، سرویس) از orchestrator (cephadm یا Rook) استفاده میکند. بدون orchestrator، بخشهایی از رابط فقطخواندنیاند.
- نمودارهای کارایی در Grafana رسم میشوند و Dashboard آنها را درون صفحات نشان میدهد؛ هشدارها از Prometheus و Alertmanager میآیند (فصل ۲۰).
۹-۴ فعالسازی و امنیت#
۹-۴-۱ فعالسازی#
در کلاستری که با cephadm ساخته شده، Dashboard بهطور پیشفرض فعال است و cephadm bootstrap آدرس و رمز اولیه را چاپ میکند. برای بررسی یا فعالسازی دستی:
ceph mgr module ls | grep -i dashboard
ceph mgr module enable dashboard
ceph mgr services                     # آدرس فعلی Dashboard، Prometheus و ...
ceph dashboard create-self-signed-cert     # فقط برای آزمایشگاه
۹-۴-۲ گواهی معتبر#
در محیط واقعی گواهی سازمانی یا Let's Encrypt بگذارید:
ceph dashboard set-ssl-certificate -i dashboard.crt
ceph dashboard set-ssl-certificate-key -i dashboard.key
ceph mgr module disable dashboard && ceph mgr module enable dashboardDashboard بهطور پیشفرض روی درگاه ۸۴۴۳ (HTTPS) گوش میدهد. اگر چند MGR دارید، میتوانید MGRهای آمادهبهکار را طوری تنظیم کنید که درخواستها را به MGR فعال redirect کنند یا خطای مشخصی برگردانند (تنظیم standby_behaviour)؛ این برای پشت load balancer قرار دادن Dashboard با health check مفید است.
۹-۴-۳ کاربر مدیر اولیه#
رمز عبور را از فایل بخوانید تا در تاریخچهی shell یا فهرست فرایندها دیده نشود:
umask 077
openssl rand -base64 18 > /root/dash-admin.pw
ceph dashboard ac-user-create admin2 -i /root/dash-admin.pw administrator
shred -u /root/dash-admin.pw            # پس از ذخیره در مدیر رمز عبور سازمان
ceph dashboard ac-user-show admin2Dashboard دسترسی مدیریتی کامل به کلاستر میدهد؛ آن را مستقیماً روی اینترنت باز نکنید. دسترسی را به شبکهی مدیریت یا VPN محدود کنید، SSO یا حداقل سیاست رمز عبور قوی و انقضای رمز را فعال کنید و حسابهای پیشفرض بلااستفاده را حذف یا غیرفعال کنید.
۹-۵ کاربران، نقشها و SSO#
۹-۵-۱ مدل دسترسی#
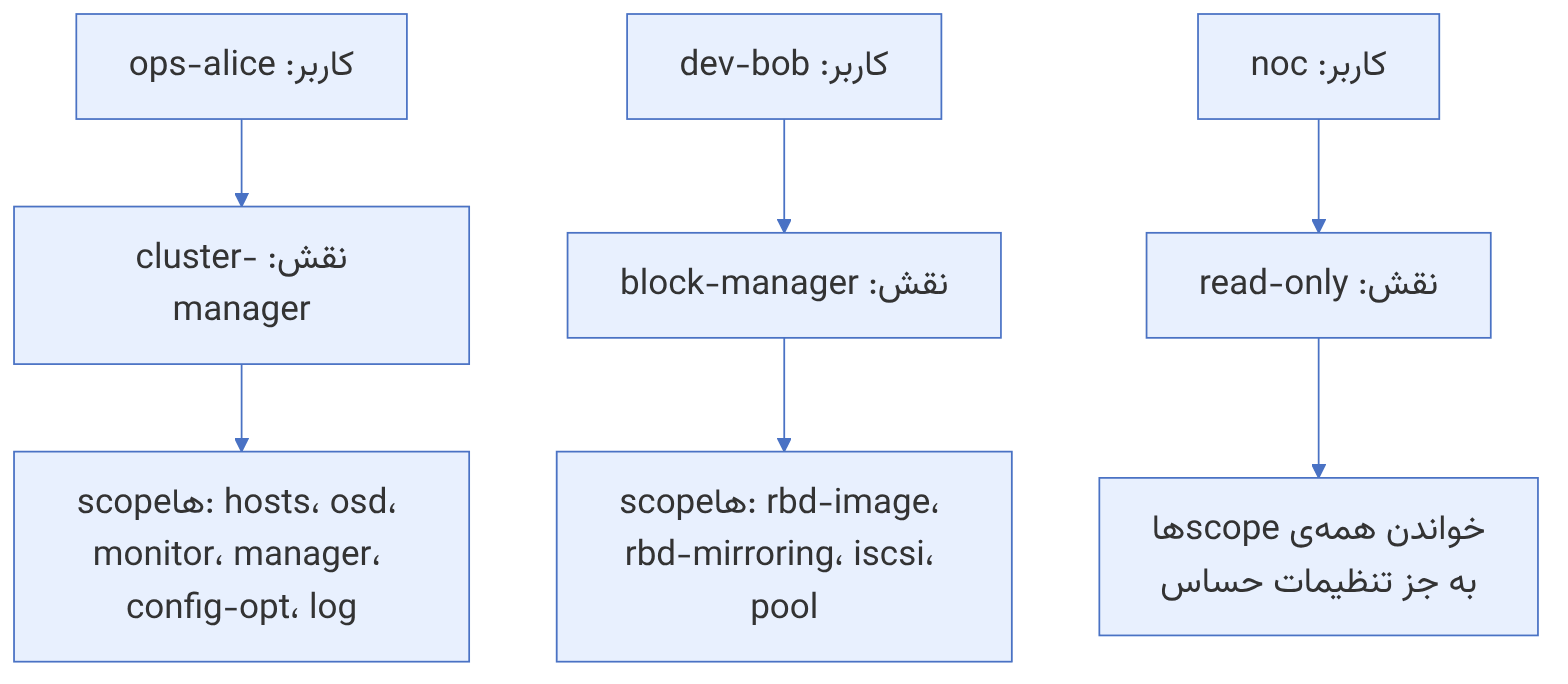
Dashboard کنترل دسترسی مبتنی بر نقش (RBAC) دارد. هر نقش مجموعهای از مجوزها (read، create، update، delete) روی scopeهایی مثل pool، rbd-image، osd، hosts، cephfs، rgw یا config-opt است. نقشهای از پیش تعریفشده:
| نقش | حوزهی دسترسی |
|---|---|
| administrator | همهی scopeها، با همهی مجوزها |
| read-only | خواندن همهچیز جز تنظیمات حساس Dashboard |
| block-manager | RBD، آینهسازی RBD و iSCSI |
| rgw-manager | Object Gateway |
| cluster-manager | میزبانها، OSDها، MON، MGR، تنظیمات و لاگها |
| pool-manager | poolها |
| cephfs-manager | CephFS |
| ganesha-manager | exportهای NFS |
ceph dashboard ac-role-show
ceph dashboard ac-role-create storage-ops "Ops team: OSD and pool only"
ceph dashboard ac-role-add-scope-perms storage-ops osd read update
ceph dashboard ac-role-add-scope-perms storage-ops pool read create update
umask 077; openssl rand -base64 15 > /root/alice.pw
ceph dashboard ac-user-create --pwd_update_required alice -i /root/alice.pw storage-ops
shred -u /root/alice.pw     # پس از تحویل امن رمز موقت به کاربر
ceph dashboard ac-user-set-roles alice storage-ops read-only
ceph dashboard ac-user-disable aliceنقشها را بر اساس وظیفه تعریف کنید، نه فرد. مثلاً تیم NOC فقط read-only لازم دارد، تیم پلتفرم ابری block-manager و تیم داده rgw-manager. حساب administrator را برای عملیات اضطراری نگه دارید و استفاده از آن را پایش کنید.
۹-۵-۲ سیاست رمز عبور و پیام روز#
ceph dashboard set-pwd-policy-enabled true
ceph dashboard set-pwd-policy-min-length 12
ceph dashboard set-pwd-policy-check-complexity-enabled true
ceph dashboard motd set warning 2h "Maintenance on ceph-node3 in progress"
ceph dashboard motd clear
۹-۵-۳ ورود یکپارچه (SSO)#
Dashboard از SSO با SAML 2.0 پشتیبانی میکند و در نسخههای جدید، از طریق oauth2-proxy و mgmt-gateway، از OAuth2/OIDC هم پشتیبانی دارد. نکتهی مهم: SSO فقط احراز هویت را انجام میدهد؛ کاربر باید در Dashboard هم وجود داشته باشد (با همان نام کاربری) تا نقشش مشخص شود.
ceph dashboard sso setup saml2 https://ceph-dash.example.internal \
  /etc/ceph/idp-metadata.xml uid https://idp.example.internal/realms/infra
ceph dashboard sso status
ceph dashboard sso enable saml2۹-۶ Tentacle: mgmt-gateway و oauth2-proxy#
در نسخههای قبلی، هر جزء مدیریتی (Dashboard، Grafana، Prometheus، Alertmanager) آدرس و درگاه خودش را داشت و جابهجا شدن MGR فعال، آدرس Dashboard را تغییر میداد. Tentacle دو سرویس cephadm را بهعنوان راهحل معرفی کرد:
- mgmt-gateway: یک nginx که نقطهی ورود واحد به همهی رابطهای مدیریتی است، TLS را خاتمه میدهد و درخواستها را به MGR فعال و سرویسهای پایش هدایت میکند. با IP مجازی میتوان آن را چندنمونهای و دسترسپذیر کرد.
- oauth2-proxy: احراز هویت متمرکز با یک ارائهدهندهی OIDC (مثل Keycloak یا سرویس هویت سازمان) برای همهی رابطهای پشت دروازه.
ceph orch apply mgmt-gateway --placement="label:mgmt"
# با احراز هویت و IP مجازی
ceph orch apply mgmt-gateway --virtual_ip 192.168.10.60 --enable-auth=true --placement="label:mgmt"
ceph orch ls mgmt-gatewayTentacle همچنین سرویس certmgr را برای مدیریت متمرکز گواهیهای TLS سرویسهای cephadm اضافه کرد. پیش از استقرار mgmt-gateway در production، مستندات هر دو سرویس را بخوانید؛ بهویژه پیکربندی oauth2-proxy (client id، secret و آدرس IdP) که باید در یک spec و نه خط فرمان قرار گیرد تا اسرار در تاریخچه نمانند.
۹-۷ کار روزمره با Dashboard#
۹-۷-۱ روز صفر: ساخت و گسترش#
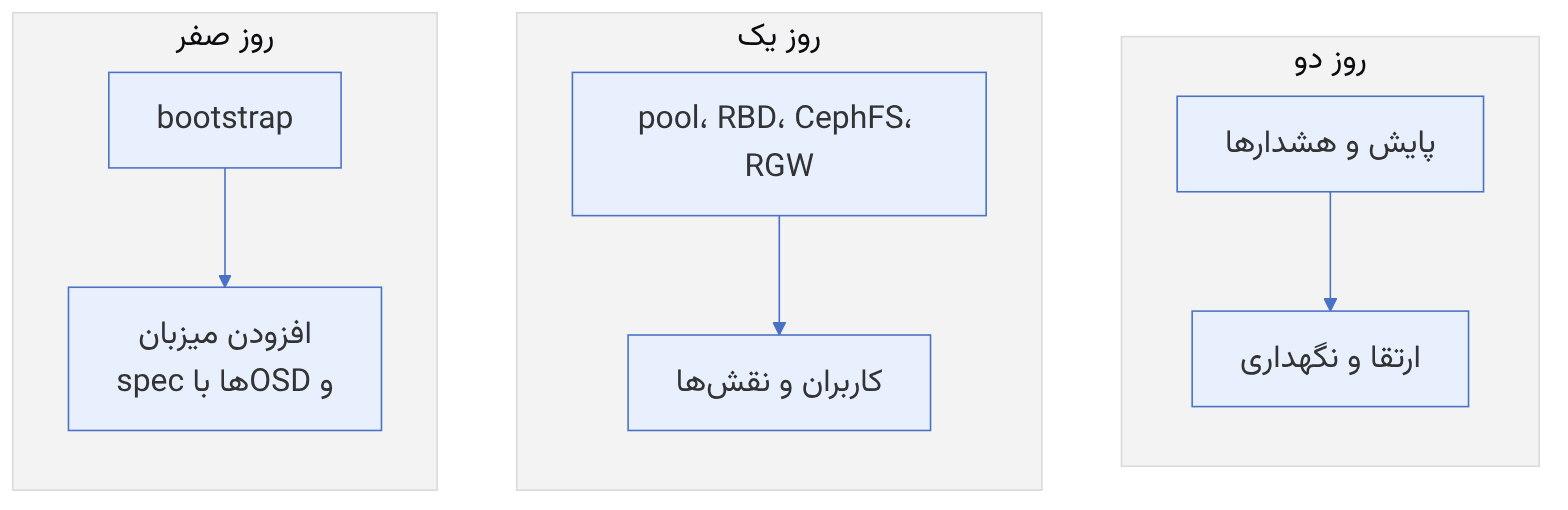
پس از bootstrap، صفحهی Expand Cluster در Dashboard راهنمای گامبهگام افزودن میزبانها، انتخاب دیسکها برای OSD و استقرار سرویسها را دارد. در پشت صحنه، همان specهای cephadm ساخته میشوند که با ceph orch ls --export قابل مشاهدهاند.
۹-۷-۲ روز یک: سرویسها#
از Dashboard میتوانید اینها را بسازید و مدیریت کنید:
- poolها (تکثیری و EC)، با نمایش وضعیت autoscaler؛
- imageهای RBD، snapshotها، clone و آینهسازی؛
- فایلسیستمهای CephFS، subvolumeها، snapshotها و exportهای NFS؛
- کاربران و bucketهای RGW، و پیکربندی multisite؛
- دروازههای NVMe/TCP و گروههای آنها (Tentacle).
۹-۷-۳ روز دو: پایش و نگهداری#
- صفحهی اصلی وضعیت سلامت، ظرفیت، کارایی و هشدارهای فعال را نشان میدهد.
- صفحهی OSDها امکان تغییر پرچمها، تعیین کلاس دستگاه، علامتگذاری out/in و حذف/تعویض دارد.
- صفحهی Upgrade نسخههای در دسترس را نشان میدهد و ارتقای cephadm را شروع و پیگیری میکند.
- لاگهای کلاستر و audit (چه کسی چه دستوری اجرا کرده) در صفحهی Logs در دسترساند.
# همان عملیات از طریق REST API
TOKEN=$(curl -sk -X POST https://ceph-dash.example.internal:8443/api/auth \
  -H 'Accept: application/vnd.ceph.api.v1.0+json' -H 'Content-Type: application/json' \
  -d "{\"username\":\"apiuser\",\"password\":\"$(cat /root/apiuser.pw)\"}" | jq -r .token)
curl -sk https://ceph-dash.example.internal:8443/api/health/minimal \
-H 'Accept: application/vnd.ceph.api.v1.0+json' -H "Authorization: Bearer $TOKEN" | jq .healthREST API Dashboard جایگزین ماژول قدیمی restful است که در Tentacle از MGR حذف شد. اگر اسکریپتها یا ابزارهای پایش شما از restful استفاده میکنند، پیش از ارتقا به Tentacle آنها را به API Dashboard (یا به Prometheus برای متریکها) منتقل کنید. برای API از یک کاربر جدا با کمترین نقش لازم استفاده کنید.
۹-۸ راهنمای گامبهگام: یک سرویس کامل از Dashboard#
در این بخش یک سناریوی واقعی را از ابتدا تا انتها با Dashboard پیش میبریم و برای هر گام، دستور CLI معادل را هم میآوریم تا بتوانید نتیجه را بررسی یا خودکارسازی کنید. سناریو: تیم «تحلیل داده» به یک pool برای RBD، یک فایلسیستم اشتراکی و یک bucket شیء نیاز دارد و باید فقط به منابع خودش دسترسی داشته باشد.
۹-۸-۱ گام ۱: pool با autoscaler#
در منوی Cluster → Pools گزینهی Create را بزنید، نوع replicated، اندازهی ۳، قانون CRUSH مبتنی بر SSD و application را rbd انتخاب کنید. Dashboard حالت autoscaler را بهطور پیشفرض روشن میگذارد.
ceph osd pool create analytics-rbd --autoscale-mode=on
ceph osd pool set analytics-rbd crush_rule rep-ssd-host
ceph osd pool application enable analytics-rbd rbd
rbd pool init analytics-rbd
۹-۸-۲ گام ۲: image و کاربر RBD#
در Block → Images یک image با اندازهی ۵۰۰ گیگابایت و قابلیتهای پیشفرض (layering، exclusive-lock، object-map، fast-diff) بسازید. کاربر cephx در Dashboard ساخته نمیشود اما صفحهی Cluster → Users (در نسخههای جدید) امکان مشاهده و ساخت کاربران cephx را میدهد.
rbd create analytics-rbd/warehouse --size 500G
ceph auth get-or-create client.analytics mon 'profile rbd' osd 'profile rbd pool=analytics-rbd' mgr 'profile rbd pool=analytics-rbd'
۹-۸-۳ گام ۳: subvolume در CephFS#
در File → File Systems فایلسیستم موجود را باز کنید، به زبانهی Subvolume groups بروید، گروه analytics و در آن subvolume shared با سقف ۲ ترابایت بسازید.
ceph fs subvolumegroup create fs01 analytics
ceph fs subvolume create fs01 shared --group_name analytics --size 2199023255552
ceph fs subvolume getpath fs01 shared --group_name analytics
۹-۸-۴ گام ۴: کاربر و bucket شیء#
در Object → Users کاربر analytics را با سهمیهی ۱۰ ترابایت بسازید؛ سپس در Object → Buckets یک bucket با مالکیت همین کاربر و versioning فعال ایجاد کنید.
radosgw-admin user create --uid=analytics --display-name="Analytics team"
radosgw-admin quota set --quota-scope=user --uid=analytics --max-size=10T
radosgw-admin quota enable --quota-scope=user --uid=analyticsدر نسخههای جدید RGW، مفهوم account (سازگار با IAM در AWS) برای چندمستأجری توصیه میشود و tenantهای قدیمی برای IAM منسوخ اعلام شدهاند (فصل ۴). Dashboard هم به تدریج امکانات account را اضافه کرده است؛ پیش از طراحی، صفحهی مستندات نسخهی خودتان را بررسی کنید.
۹-۸-۵ گام ۵: نقش محدود در Dashboard#
برای تیم تحلیل یک نقش Dashboard بسازید که فقط خواندن pool و RBD را داشته باشد تا مصرف و کارایی منابع خودشان را ببینند. توجه کنید که RBAC Dashboard در سطح scope است، نه در سطح یک pool خاص؛ کاربری که scope rbd-image را دارد، imageهای همهی poolها را میبیند.
همین محدودیت دلیل اصلی است که سلفسرویس کامل چندمستأجری را نباید روی Dashboard بنا کرد. برای ارائهی سرویس به مستأجران، از لایهی بالاتری مانند OpenStack (فصل ۳)، Kubernetes با Rook و ceph-csi، یا یک پورتال داخلی که با API محدود کار میکند استفاده کنید و Dashboard را برای اپراتورها نگه دارید.
۹-۸-۶ پایش منابع تیم#
پس از ساخت منابع، صفحههای جزئیات pool و image نمودار IOPS، توان و تأخیر را (از Grafana) نشان میدهند. برای اینکه این نمودارها در سطح image داده داشته باشند، باید جمعآوری متریکهای RBD per-image در ماژول prometheus فعال باشد:
ceph config set mgr mgr/prometheus/rbd_stats_pools "analytics-rbd"
ceph mgr module disable prometheus && ceph mgr module enable prometheusفعال کردن آمار per-image برای همهی poolها در کلاسترهای با دهها هزار image، بار MGR و حجم دادهی Prometheus را بسیار بالا میبرد. فقط poolهایی را اضافه کنید که واقعاً به نمودار هر image نیاز دارند.
۹-۹ قابلیتهای جانبی Dashboard#
۹-۹-۱ روشن و خاموش کردن بخشها#
اگر از برخی سرویسها استفاده نمیکنید، بخش مربوط را خاموش کنید تا رابط سادهتر شود و کاربران دنبال قابلیتهای بیاستفاده نروند:
ceph dashboard feature status
ceph dashboard feature disable iscsi mirroring
ceph dashboard feature enable mirroring
۹-۹-۲ telemetry#
ماژول telemetry گزارشهای ناشناس از پیکربندی و خرابیها را (با رضایت صریح شما) برای پروژهی Ceph میفرستد. Dashboard پس از نصب پیشنهاد فعالسازی آن را نشان میدهد. پیش از فعال کردن، محتوای گزارش را ببینید و با سیاست حریم خصوصی سازمان مقایسه کنید:
ceph telemetry preview # پیشنمایش گزارش وقتی telemetry خاموش است
ceph telemetry show # گزارش واقعی وقتی روشن است
ceph telemetry on --license sharing-1-0
ceph telemetry offدادهی telemetry به تیم توسعه کمک میکند خرابیها و الگوهای واقعی استفاده را ببیند. اگر محیط شما ایزوله است یا سیاست اجازه نمیدهد، آن را خاموش نگه دارید؛ هیچ قابلیتی به آن وابسته نیست.
۹-۱۰ از درون کد: معماری ceph-mgr و نوشتن یک ماژول#
۹-۱۰-۱ ساختار فرایند#
Dashboard، Prometheus، balancer، pg_autoscaler، cephadm، volumes و دهها قابلیت دیگر همه ماژولهای پایتون داخل یک فرایند C++ به نام ceph-mgr هستند. بخش C++ در src/mgr/ قرار دارد و فایلهای اصلی آن MgrStandby.cc، Mgr.cc، DaemonServer.cc، ClusterState.cc، DaemonState.cc، PyModuleRegistry.cc، ActivePyModules.cc، StandbyPyModules.cc، PyModuleRunner.cc و BaseMgrModule.cc هستند. بخش پایتون در src/pybind/mgr/ است و API پایه در mgr_module.py قرار دارد.
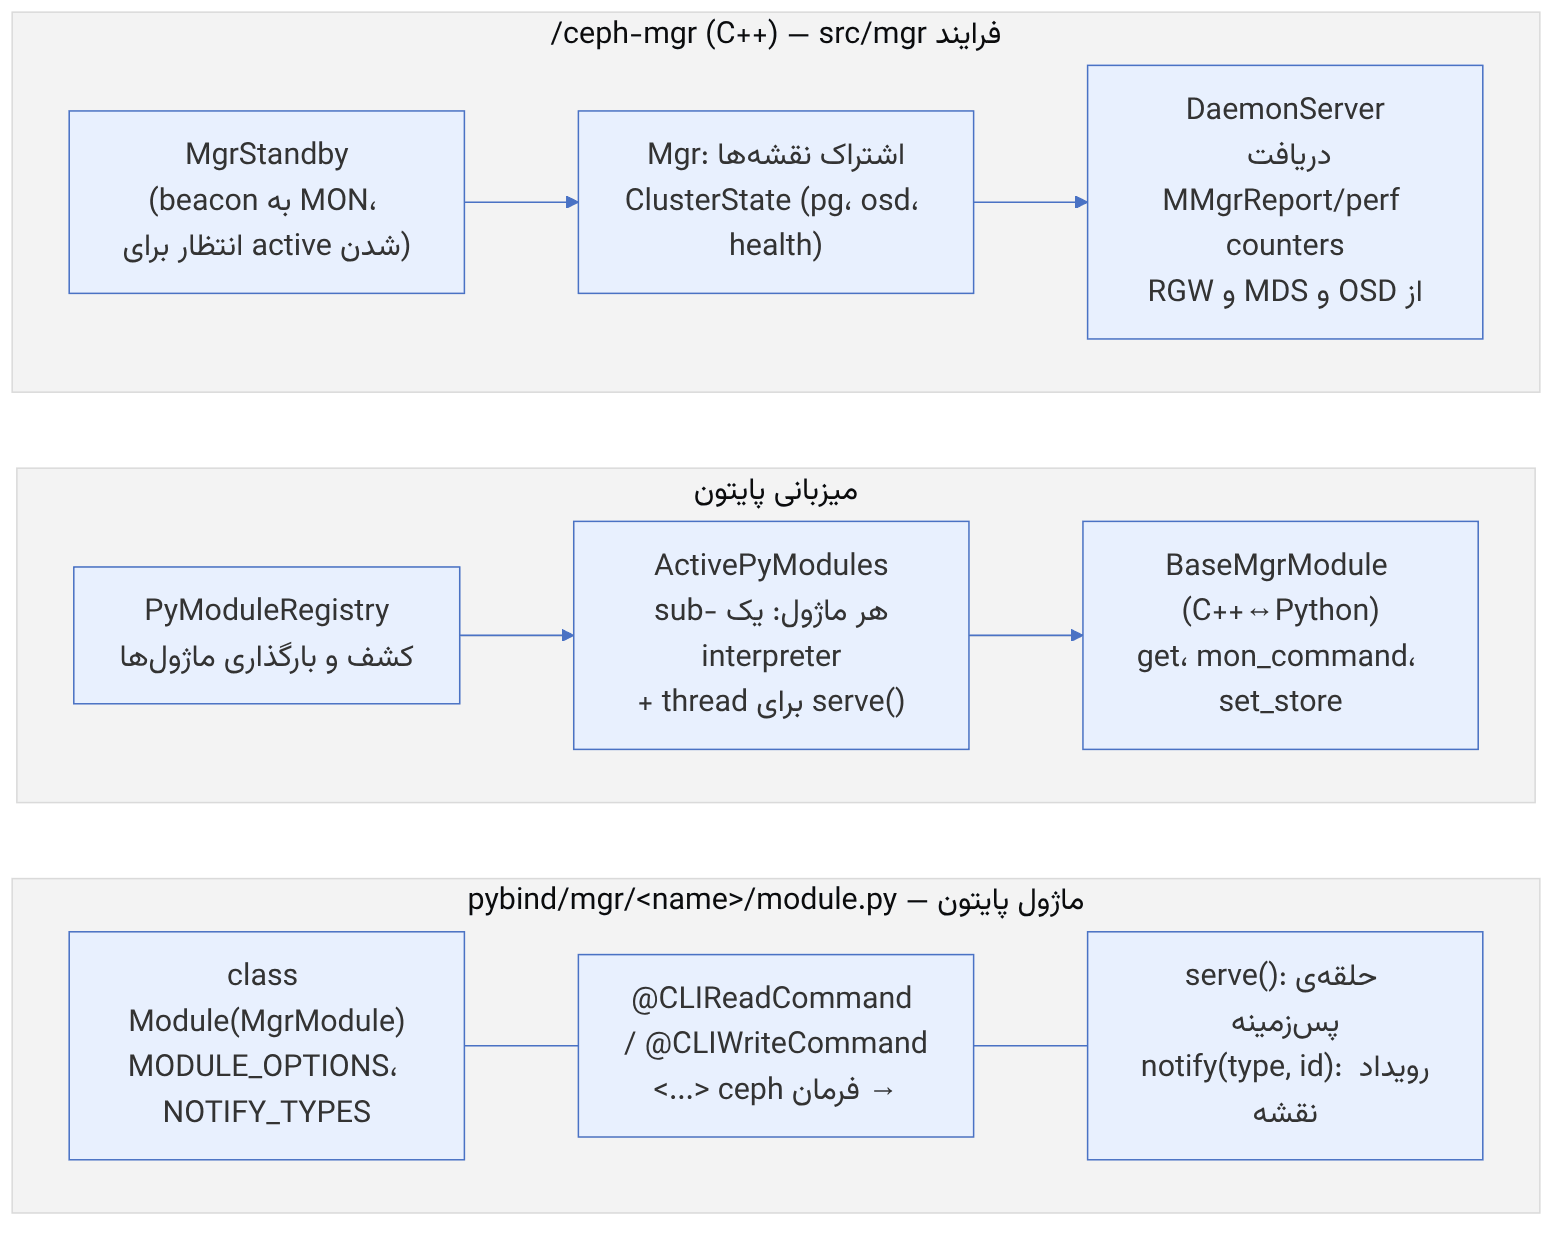
| API (mgr_module.py) | کاربرد |
|---|---|
serve() / shutdown() | حلقهی پسزمینهی ماژول و توقف تمیز |
notify(notify_type, notify_id) | رویدادهایی که در NOTIFY_TYPES خواسته شدهاند؛ NotifyType شامل mon_map، osd_map، fs_map، pg_summary، health، clog، command و... است |
get(data_name) | خواندن نقشهها از کش C++ مثل osd_map، pg_summary و health |
mon_command(cmd_dict) | اجرای فرمان MON و برگرداندن (retval، out، err) |
get_module_option / set_store / get_store | تنظیمات ماژول و ذخیرهی key-value در config-key |
CLIReadCommand / CLIWriteCommand | decoratorهایی که در mgr_module.py به CLICommandBase.Read و CLICommandBase.Write نگاشت شدهاند |
۹-۱۰-۲ یک ماژول کوچک (کد خود این کتاب)#
این ماژول فرمان ceph pgwatch status را اضافه میکند و در پسزمینه تعداد PGهای ناسالم را پایش میکند:
# pybind/mgr/pgwatch/module.py — مثال آموزشی این کتاب
import threading
from mgr_module import MgrModule, CLIReadCommand, Option, NotifyType

class Module(MgrModule):
    MODULE_OPTIONS = [Option('interval', type='secs', default=30)]
    NOTIFY_TYPES = [NotifyType.pg_summary]

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self._stop = threading.Event()
        self._last = {}

    def notify(self, notify_type, notify_id):
        if notify_type == NotifyType.pg_summary:
            self._last = self.get('pg_summary').get('all', {})

    @CLIReadCommand('pgwatch status')
    def status(self):
        """Show PG state counts seen by pgwatch"""
        bad = {k: v for k, v in self._last.items() if k != 'active+clean'}
        return 0, str(bad or 'all active+clean'), ''

    def serve(self):
        while not self._stop.wait(self.get_module_option('interval')):
            self.log.debug('pgwatch tick: %s', self._last)

    def shutdown(self):
self._stop.set()یک ماژول کند یا گیرکرده (مثلاً serve بدون wait یا فراخوانیهای سنگین get('pg_dump') در کلاستر بزرگ) کل mgr را کند میکند و ممکن است باعث از دست رفتن beacon و failover شود. هشدار MGR_MODULE_ERROR و فرمان ceph mgr module ls را بررسی کنید و برای عیبیابی سطح debug_mgr را به ۲۰ برسانید.
فرمانها:
ceph mgr module ls | jq '.enabled_modules'
ceph mgr module enable pgwatch --force     # ماژول خارج از فهرست رسمی
ceph pgwatch status
ceph config set mgr mgr/pgwatch/interval 10
ceph mgr fail                               # failover به standby
ceph tell mgr.$(ceph mgr stat | jq -r .active_name) config set debug_mgr 20۹-۱۱ سه الگوریتم امنیتی Dashboard با عدد#
کد Dashboard پایتون است و در فرایند ceph-mgr اجرا میشود. سه سازوکار امنیتی آن سادهاند، اما جزئیاتشان رفتارهایی میسازد که اپراتور باید بداند. مسیرهای زیر از برچسب v21.2.0 هستند.
۹-۱۱-۱ امتیاز پیچیدگی رمز عبور#
منبع در کد: src/pybind/mgr/dashboard/services/access_control.py :: PasswordPolicy.check_all، check_password_complexity، check_if_sequential_characters، check_if_repetitive_characters؛ src/pybind/mgr/dashboard/settings.py :: PWD_POLICY_*
پیچیدگی: O(n) برای رمز n نویسهای؛ فهرست واژههای ممنوع با یک regex
pseudocode
if !PWD_POLICY_ENABLED: پذیرش
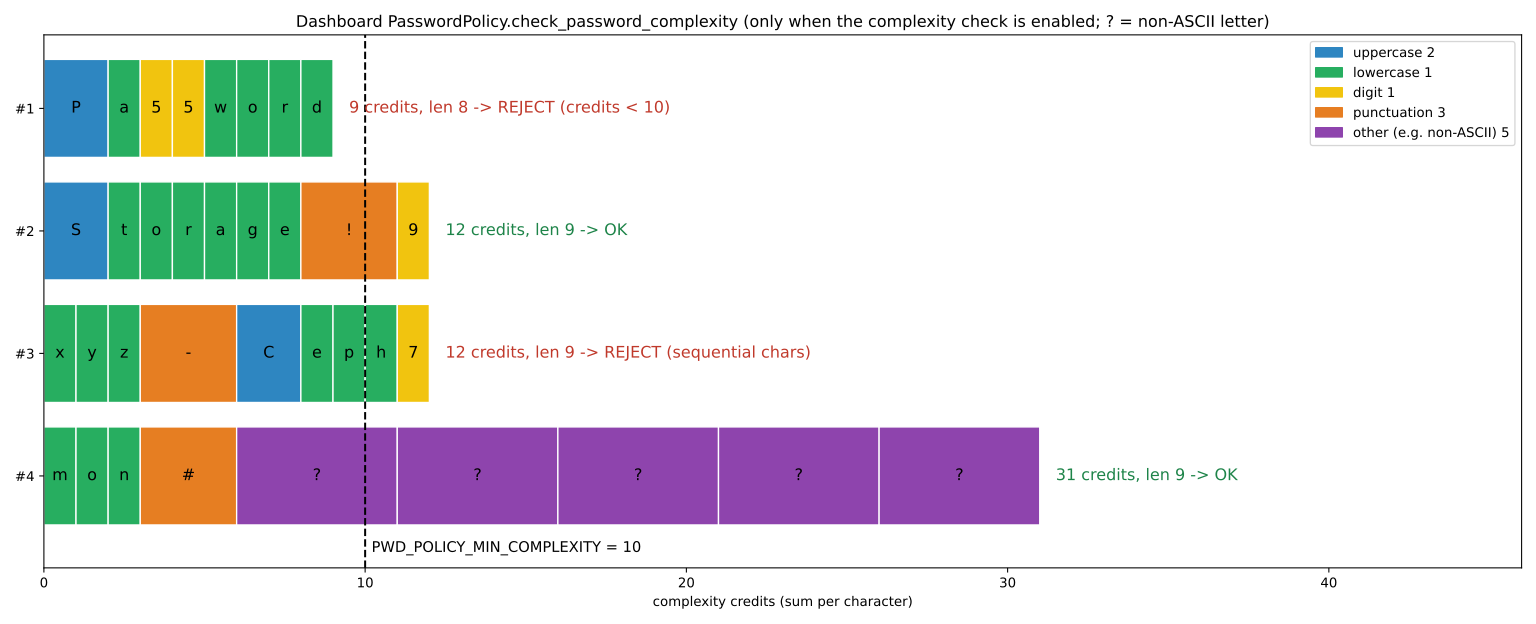
credits = Σ (بزرگ 2 ، کوچک 1 ، رقم 1 ، نشانه 3 ، سایر 5) # فقط اگر complexity فعال است، وگرنه = 10
if credits < MIN_COMPLEXITY (10) or len < MIN_LENGTH (8): «ضعیف»
if == رمز قبلی (پیشفرض فعال) ؛ شامل نام کاربر ؛ شامل واژهی ممنوع: رد
if سه نویسهی یکسان پیاپی (aaa) or سه کد پیاپی صعودی (abc، 123): ردمثال عددی (با فعال کردن complexity، sequential و repetitive).
-
Pa55word: P = ۲، a = ۱، دو رقم = ۲ و چهار حرف کوچک = ۴، مجموع ۹ < ۱۰. رد میشود، هرچند ۸ نویسه دارد. -
Storage!9: مجموع ۱۲ است و پذیرفته میشود. -
xyz-Ceph7: ۱۲ اعتبار دارد، اما x، y و z کدهای پیاپی صعودیاند، پس رد میشود. -
mon# همراه با پنج حرف فارسی: هر حرف غیر ASCII 5 اعتبار دارد، پس مجموع ۳۱ است.
بررسی ترتیب فقط صعودی است. cba رد نمیشود. فهرست پیشفرض واژههای ممنوع شامل osd، host، dashboard، pool، block، nfs، ceph، monitors، gateway، logs، crush و maps است. چون جستوجو بدون حساسیت به حروف است، Ceph2026 با این بررسی رد میشود. نکتهی مهم: در پیشفرضها، از میان این بررسیها فقط طول و تکرار رمز قبلی فعالاند.
۹-۱۱-۲ مجوز یک درخواست REST#
منبع در کد: src/pybind/mgr/dashboard/services/auth/auth.py :: AuthManagerTool._check_authorization، JwtManager.gen_token، JwtManager.get_user؛ src/pybind/mgr/dashboard/services/access_control.py :: User.authorize، Role.authorize؛ src/pybind/mgr/dashboard/controllers/_rest_controller.py :: _permission_map
پیچیدگی: O(R × P) برای R نقش کاربر و P مجوز خواستهشده
pseudocode
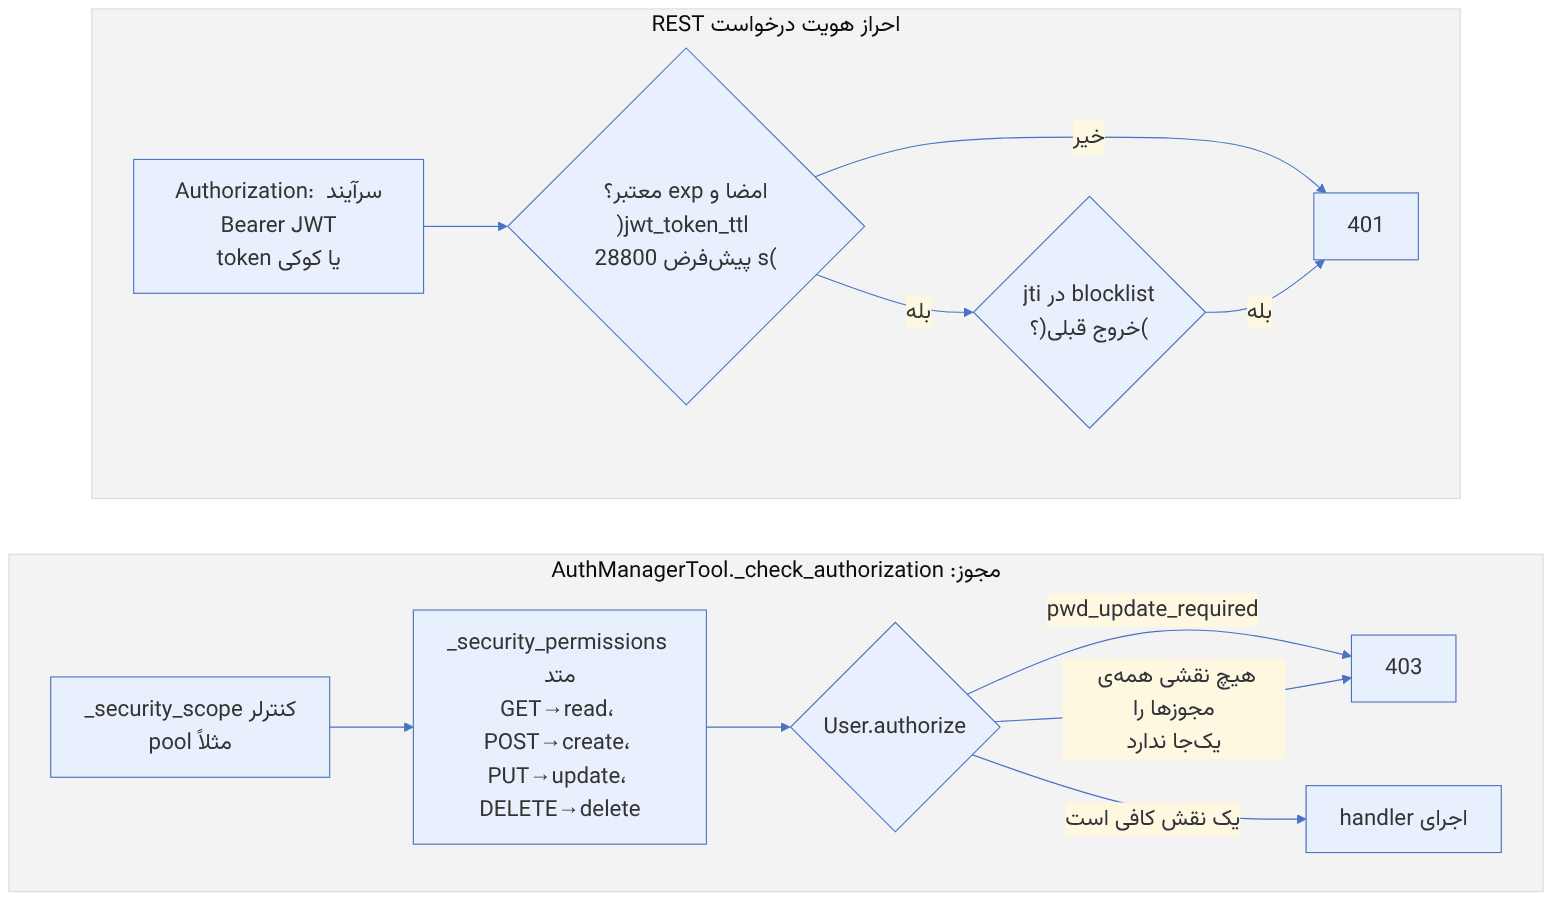
token = JWT{iss: ceph-dashboard, jti: uuid4, iat: now, exp: now + jwt_token_ttl (28800 s)}
درخواست: امضا و exp را بسنج ؛ jti در blocklist ⇒ 401
scope = controller._security_scope ; perms = handler._security_permissions (GET→read …)
if scope تعریف نشده: آزاد ; if perms خالی: 403
User.authorize: if pwd_update_required: false
    for role in roles: if role.scopes[scope] ⊇ perms: true     # همه از یک نقش
    false ⇒ 403
مثال عددی. کاربری دو نقش دارد: A با pool: [read] و B با pool: [update].
-
GET /api/pool: نیاز read دارد و نقش A کافی است، پس ۲۰۰. -
PUT /api/pool/rbd: نیاز update دارد و نقش B کافی است، پس ۲۰۰. - endpointی که همزمان
[read, update] بخواهد: هیچ نقشی هر دو را ندارد، پس ۴۰۳. این در حالی است که permissions_dict برای نمایش در UI اجتماع مجوزها را نشان میدهد و هر دو مجوز را میبینید.
اگر مدیر pwd_update_required را برای کاربر روشن کرده باشد، همهی endpointهای دارای scope تا عوض شدن رمز ۴۰۳ میدهند. توکن ۸ ساعت اعتبار دارد. با ceph dashboard set-jwt-token-ttl 3600 به یک ساعت کم میشود.
۹-۱۱-۳ قفل شدن حساب پس از تلاش ناموفق#
منبع در کد: src/pybind/mgr/dashboard/controllers/auth.py :: Auth.create؛ src/pybind/mgr/dashboard/services/access_control.py :: AccessControlDB.increment_attempt، reset_attempt، get_attempt
پیچیدگی: O(۱) برای هر تلاش؛ شمارنده در پایگاه کاربران Dashboard (KV در MON) ذخیره میشود
pseudocode
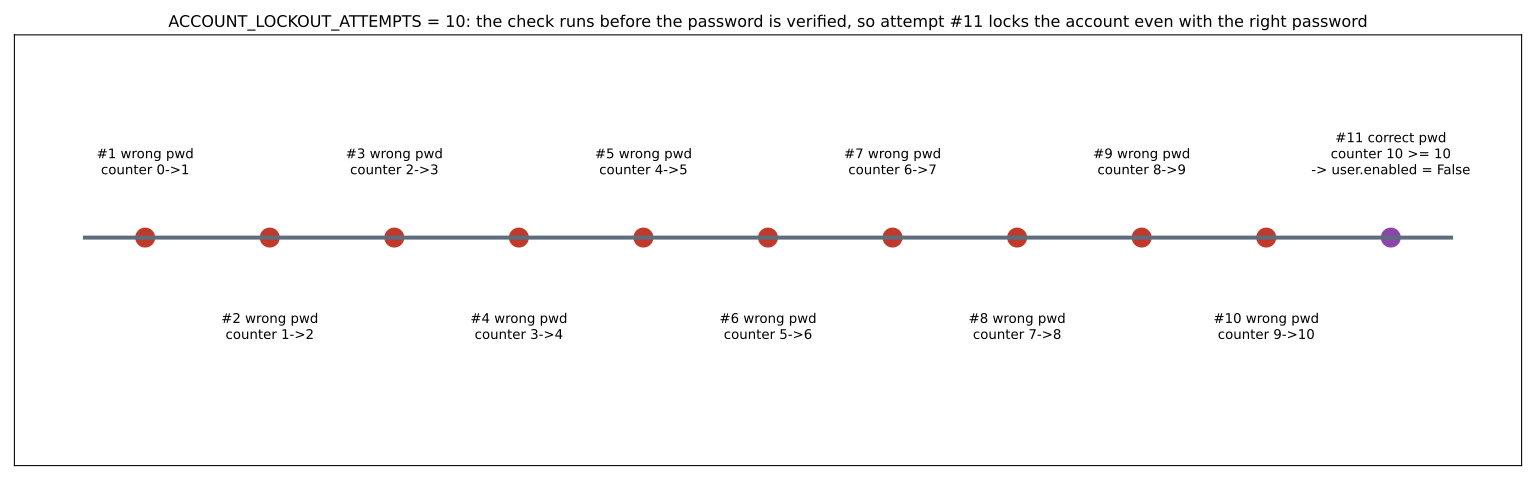
max = ACCOUNT_LOCKOUT_ATTEMPTS (10)
if max == 0 or attempts(user) < max:
if رمز درست: reset_attempt ; صدور توکن
else: increment_attempt ; InvalidCredentialsError
else: user.enabled = false ; هشدار «account was blocked» # پیش از سنجش رمز!
باز کردن: ceph dashboard ac-user-enable <user> (reset_attempt هم میکند)مثال عددی. ده تلاش با رمز اشتباه شمارنده را از ۰ به ۱۰ میبرد. تلاش یازدهم، حتی با رمز درست، به شاخهی else میرود، چون ۱۰ < ۱۰ برقرار نیست. پس حساب غیرفعال میشود. یک ورود موفق در هر نقطه پیش از آن شمارنده را صفر میکند. یعنی ۹ خطا، یک ورود درست و دوباره ۹ خطا حساب را قفل نمیکند. چون شمارنده به ازای نام کاربر است، مهاجم میتواند حساب admin را عمداً قفل کند. پس داشتن حساب مدیر دوم یا دسترسی CLI برای ac-user-enable ضروری است. ceph dashboard set-account-lockout-attempts 0 قفل را کاملاً خاموش میکند و توصیه نمیشود.
۹-۱۲ Dashboard چهقدر تازه است و نگاه کردن به آن چه هزینهای دارد؟#
هرچه Dashboard (و ceph -s، ceph df و ماژول prometheus) نشان میدهد، از حافظهی ceph-mgr خوانده میشود. خود mgr این داده را از گزارشهای دورهای OSDها میسازد. دو آزمایش زیر روی کلاستر آزمایشی سهOSDی با Ceph 18.2.7 انجام شد و هر دو به یک پرسش عملی جواب میدهند: عددی که میبینید چند ثانیه قدیمی است، و پرسوجوی مکرر از mgr چه هزینهای دارد.
۹-۱۲-۱ تأخیر آمار: mgr_stats_period#
گزینهی mgr_stats_period با پیشفرض ۵ ثانیه (src/common/options/mgr.yaml.in) تعیین میکند OSD و MDS هر چند وقت یکبار آمار خود را برای mgr بفرستند. mgr این دوره را از راه پیام MMgrConfigure به daemonها اعلام میکند.
منبع در کد: اندازهگیری؛ mgr_stats_period در src/common/options/mgr.yaml.in
پیچیدگی: O(دوره) برای هر نمونه
pseudocode
برای هر دوره p در {1, 2, 5, 10}:
ceph config set global mgr_stats_period p ؛ صبر 2p+2 ثانیه
15 بار: صبر تصادفی U(0, p) ؛ b = num_objects از «pg dump pools»
write_full(شیء تازه) ؛ t0 = now
تا وقتی num_objects ≤ b: هر 50 میلیثانیه دوباره بپرس
lag = now − t0نتیجه. با دورهی ۱ ثانیه، تأخیر بین ۱.۰ و ۱.۹ ثانیه بود. با دورهی ۲ ثانیه بین ۲.۲ و ۳.۹، با دورهی پیشفرض ۵ ثانیه بین ۱.۴ و ۶.۵ (میانه حدود ۴.۲) و با دورهی ۱۰ ثانیه بین ۱.۵ و ۹.۷ ثانیه.
پس با تنظیم پیشفرض، عدد اشیا و مصرف pool در Dashboard تا حدود شش ثانیه از واقعیت عقب است. در این مدت، نوشتن تازه یا پر شدن pool دیده نمیشود. کم کردن این دوره تازگی را بیشتر میکند، ولی در کلاستر بزرگ بار پردازش پیام در mgr را زیاد میکند. توضیح خود گزینه هم دقیقاً همین مصالحه را ذکر میکند.
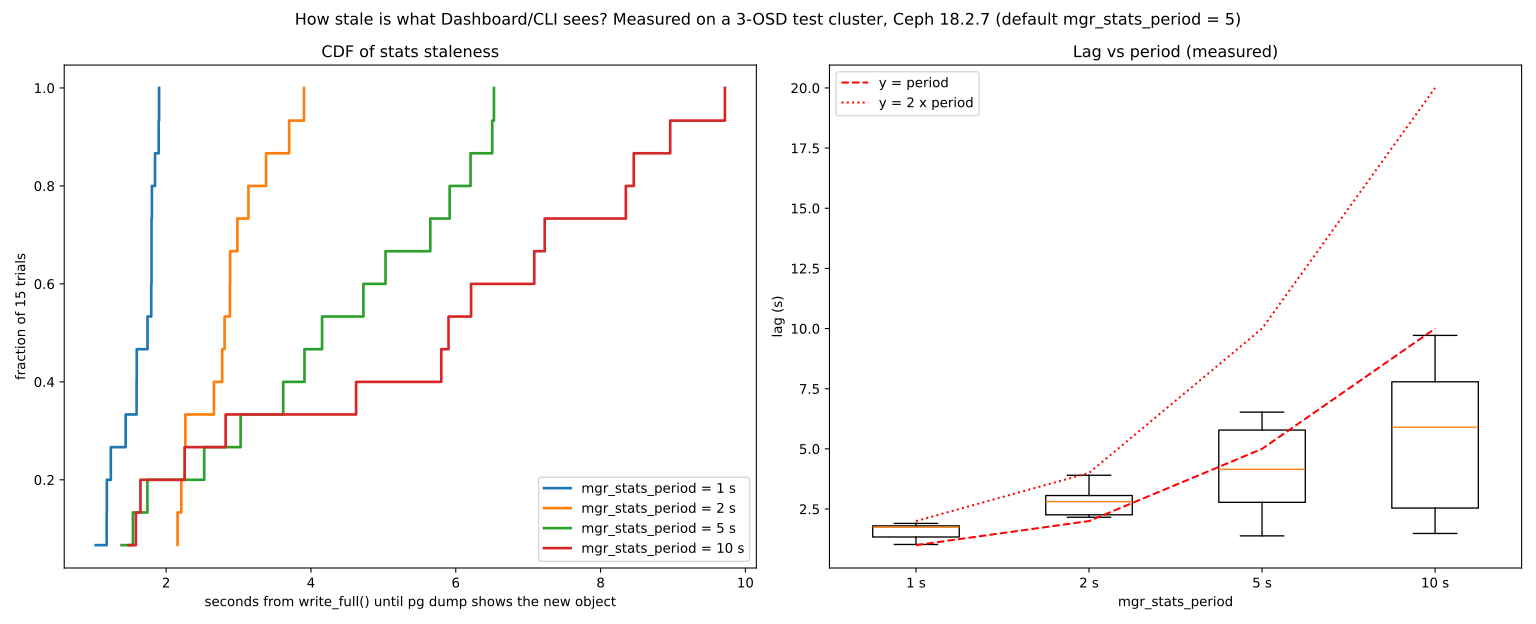
pg dump آن را نشان میدهد، برای چهار مقدار mgr_stats_period. چپ: توزیع تجمعی ۱۵ آزمایش. راست: جعبهنمودار همراه با خطهای y = p و y = ۲p. اندازهگیری روی Ceph 18.2.7۹-۱۲-۲ هزینهی پرسوجو: pg dump در برابر status#
منبع در کد: اندازهگیری؛ mgr_command('pg dump') و mon_command('status')
پیچیدگی: O(تعداد PG) برای pg dump و O(۱) برای status
pseudocode
برای تعداد PG در {32, 128, 512, 1024}: # با ساخت pool موقت p09 و صبر تا active+clean
برای هر فرمان در {pg dump (کامل), pg dump pgs_brief, status}:
10 بار اجرا کن ← میانهی زمان و اندازهی پاسخ JSONنتیجه. پاسخ کامل pg dump بهازای هر PG حدود ۲.۴ KiB است: با ۱۰۲۴ PG برابر ۲.۴۹ MB شد و ۲۵.۸ میلیثانیه طول کشید. نسخهی pgs_brief حدود ۹۶ بایت بهازای هر PG بود: ۹۸ KB و ۲.۱ میلیثانیه. پاسخ status در همهی حالتها حدود ۱.۷ KB ماند و زمانش زیر ۰.۲۵ میلیثانیه بود.
اگر رشد خطی را ادامه دهیم (برونیابی، نه اندازهگیری)، کلاستری با ۱۰۰ هزار PG در هر pg dump کامل حدود ۲۴۰ MB JSON تولید میکند. اسکریپت پایشی که هر چند ثانیه آن را صدا بزند، mgr را عملاً مشغول سریالسازی JSON نگه میدارد. این همان mgr تکنخیای است که Dashboard و prometheus هم به آن وابستهاند.
قاعدهی عملی: برای پایش از status، pg stat یا متریکهای prometheus استفاده کنید. اگر فهرست PG لازم است، pgs_brief را بخواهید. pg dump کامل را فقط برای عیبیابی موردی اجرا کنید.
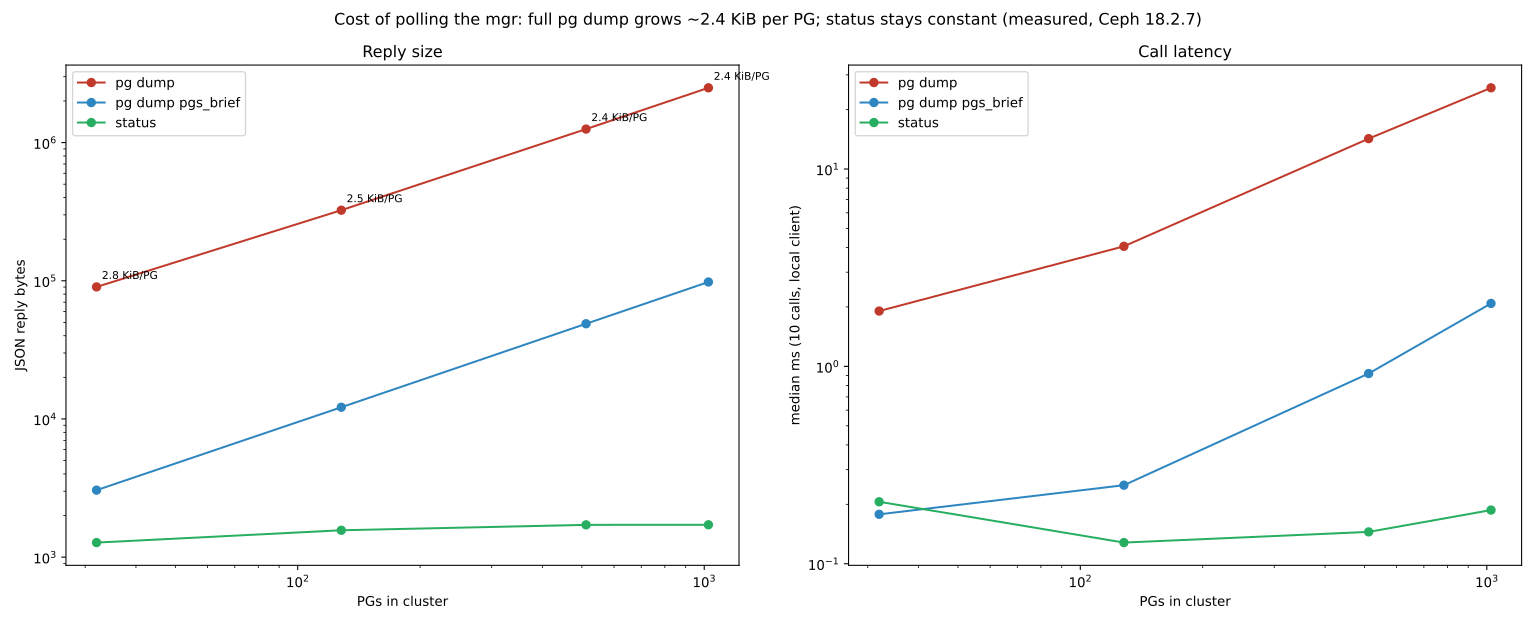
pg dump کامل، pg dump pgs_brief و status در کلاسترهایی با ۳۲ تا ۱۰۲۴ PG. اندازهگیری روی Ceph 18.2.7۹-۱۳ جایگاه Dashboard در عملیات#
۹-۱۳-۱ رابط گرافیکی، CLI یا GitOps؟#
| روش | نقطهی قوت | نقطهی ضعف |
|---|---|---|
| Dashboard | دید سریع، کشف قابلیتها، مناسب کاربران کمتر فنی و NOC | تغییرات بهراحتی مستند و بازبینی نمیشوند |
CLI (ceph، ceph orch) | دقیق، قابل اسکریپت، در همهی شرایط در دسترس | نیاز به دانش بیشتر؛ خطای تایپی پرهزینه است |
| GitOps (specهای cephadm یا CRDهای Rook در Git) | بازبینی، تاریخچه و بازگشتپذیری | راهاندازی اولیه و انضباط تیمی لازم دارد |
یک الگوی کاری متعادل:
- وضعیت مطلوب (سرویسها، specهای OSD، poolهای اصلی) در Git نگهداری و با بازبینی اعمال شود.
- عملیات روزانه و اضطراری با CLI انجام شود و در تیکت یا لاگ عملیات ثبت شود.
- Dashboard برای مشاهده، پایش، آموزش و کارهای سلفسرویس محدود (مثلاً ساخت bucket یا image توسط تیمها با نقش محدود) استفاده شود.
لاگ audit کلاستر (ceph log last 50 info audit) همهی دستورهای مدیریتی، چه از CLI و چه از Dashboard، را با نام کاربر ثبت میکند. این لاگ را به سامانهی لاگ متمرکز سازمان بفرستید تا بتوانید بفهمید چه کسی، کی و چه تغییری داده است.
۹-۱۳-۲ وقتی Dashboard در دسترس نیست#
Dashboard به MGR وابسته است و MGR به MONها. در بدترین بحرانها (از دست رفتن quorum، گیر کردن MGRها) Dashboard اولین چیزی است که از دسترس خارج میشود. بنابراین:
- تیم باید روالهای بحرانی را با CLI تمرین کرده باشد.
- پایش اصلی (Prometheus و Alertmanager) باید مستقل از Dashboard کار کند و هشدارها از مسیر جداگانه ارسال شوند.
- دسترسی SSH اضطراری به گرههای MON و
cephadm shell مستند باشد.
ceph mgr stat
ceph mgr fail # جابهجا کردن MGR فعال اگر Dashboard پاسخ نمیدهد
ceph mgr module disable dashboard && ceph mgr module enable dashboard
ceph log last 20 info clusterاگر Dashboard باز میشود ولی بخشهایی خالی است: بخشهای میزبان و سرویس به orchestrator نیاز دارند (ceph orch status)، نمودارها به Grafana (ceph dashboard get-grafana-api-url) و هشدارها به Alertmanager. بخش RGW وقتی خالی است که Dashboard نتواند اعتبارنامهی RGW را پیدا کند؛ ceph dashboard set-rgw-credentials این را تنظیم میکند.
- VSM آرشیو شده است؛ از آن استفاده نکنید.
- Dashboard را فقط از شبکهی مدیریت و با گواهی معتبر در دسترس قرار دهید.
- نقشها بر اساس وظیفه؛ administrator فقط برای اضطرار.
- رمزها از فایل، نه خط فرمان؛ سیاست رمز عبور فعال.
- در Tentacle، mgmt-gateway و oauth2-proxy برای نقطهی ورود واحد و SSO.
- restful حذف شده است؛ از API Dashboard استفاده کنید.
- وابستگی Dashboard به MGR را در طراحی پایش و روالهای اضطراری در نظر بگیرید.
۹-۱۴ تکمیلی و بهروز#
- VSM: مخزن آرشیو شده، آخرین نسخه v2.2.0 (ژوئیهی ۲۰۱۶).
- Dashboard: نسخهی اول فقطخواندنی در Luminous؛ نسخهی کامل بر پایهی openATTIC.
- Tentacle: سرویسهای mgmt-gateway، oauth2-proxy و certmgr در cephadm؛ حذف ماژول restful؛ پشتیبانی Dashboard از گروههای دروازهی NVMe/TCP.
- API نسخهدار: درخواستها با هدر
Accept: application/vnd.ceph.api.v1.0+json نسخهی API را مشخص میکنند تا ارتقای Ceph اسکریپتها را نشکند.
۹-۱۵ تمرین عملی#
- ۱. آدرس Dashboard را با
ceph mgr services پیدا کنید و با گواهی خودامضا وارد شوید. سپس گواهی را با گواهی صادرشده از یک CA آزمایشی جایگزین کنید. - ۲. نقشی به نام
storage-ops با دسترسی به osd و pool بسازید، کاربری با این نقش ایجاد کنید و بررسی کنید که بخش RGW برای او در دسترس نیست. - ۳. سیاست رمز عبور با حداقل طول ۱۲ را فعال کنید و ساخت کاربری با رمز کوتاه را آزمایش کنید.
- ۴. با REST API توکن بگیرید و وضعیت سلامت را با
/api/health/minimal بخوانید. - ۵. MGR فعال را با
ceph mgr fail عوض کنید و تغییر آدرس Dashboard را مشاهده کنید. سپس standby_behaviour را روی error بگذارید و رفتار MGR آمادهبهکار را بررسی کنید. - ۶. در کلاستر آزمایشی Tentacle یا Umbrella، mgmt-gateway را مستقر کنید و دسترسی به Grafana و Dashboard را از یک آدرس واحد آزمایش کنید.
۹-۱۶ پرسشهای مرور#
- ۱. چرا VSM امروز گزینهی مناسبی نیست؟
- ۲. کدام ایدههای VSM در Ceph امروزی ادامه یافتهاند و به چه شکلی؟
- ۳. چرا Dashboard فقط روی MGR فعال سرویس میدهد و این چه پیامدی دارد؟
- ۴. نقش orchestrator در Dashboard چیست؟
- ۵. چرا رمز عبور را با
-i از فایل میخوانیم؟ - ۶. تفاوت نقش و scope در RBAC Dashboard چیست؟
- ۷. چرا SSO به تنهایی برای دسترسی کافی نیست؟
- ۸. mgmt-gateway چه مشکلی را حل میکند؟
- ۹. پس از حذف ماژول restful، چه جایگزینی برای خودکارسازی وجود دارد؟
- ۱۰. چرا نباید پایش اصلی کلاستر فقط به Dashboard وابسته باشد؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۹-۱۷ منابع این فصل#
- Ceph Dashboard
https://docs.ceph.com/en/latest/mgr/dashboard/ - Ceph RESTful API (Dashboard API
https://docs.ceph.com/en/latest/mgr/ceph_api/ - Management gateway
https://docs.ceph.com/en/latest/cephadm/services/mgmt-gateway/ - OAuth2 proxy service
https://docs.ceph.com/en/latest/cephadm/services/oauth2-proxy/ - Monitoring services (cephadm
https://docs.ceph.com/en/latest/cephadm/services/monitoring/ - Ceph Manager daemon
https://docs.ceph.com/en/latest/mgr/ - Tentacle release notes
https://docs.ceph.com/en/latest/releases/tentacle/ - Intel VSM (archived
https://github.com/intel/virtual-storage-manager