BlueStore: موتور ذخیرهسازی OSD
حوصله ندارم این فصل در چند خط
- BlueStore مستقیم روی دستگاه خام مینویسد و همهی متادیتا (onodeها، omap، تخصیص) را در RocksDB روی BlueFS نگه میدارد و هر خواندن را با checksum بررسی میکند.
- block.db و WAL را روی دستگاه سریع بگذارید؛ cephadm فضای آن را بهطور مساوی بین OSDهای یک نود تقسیم میکند.
- نوشتنهای کوچک ممکن است از راه WAL در RocksDB به تعویق بیفتند (deferred)؛
min_alloc_size و تنظیمات فشردهسازی تعیین میکنند اشیای کوچک واقعاً چقدر فضای خام مصرف کنند. - OSDهای FileStore را باید پیش از ارتقا به Reef یا بالاتر بهصورت BlueStore از نو ساخت؛ تبدیل درجا وجود ندارد.
۱۲-۱ پیش از شروع#
۱۲-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
هر OSD در نهایت باید اشیای RADOS را روی یک دیسک فیزیکی بنویسد. لایهای که این کار را انجام میدهد object store نام دارد. در سال ۲۰۱۹ BlueStore تازه پیشفرض شده بود و بسیاری از کلاسترها هنوز FileStore داشتند. امروز وضعیت سادهتر است: FileStore از Reef به بعد پشتیبانی نمیشود و BlueStore تنها object store کلاسیک OSD است. اما فهم درونی BlueStore هنوز برای طراحی سختافزار، تنظیم کارایی و عیبیابی ضروری است.
- BlueStore چیست و چرا جایگزین FileStore شد؟
- RocksDB، BlueFS و نوشتنهای deferred چه نقشی دارند؟
- دستگاههای block، block.db و block.wal را چطور اندازهگذاری و چیدمان کنیم؟
- فشردهسازی، checksum و min_alloc_size چه اثری دارند؟
- چطور OSDها را به BlueStore (یا به چیدمان جدید) مهاجرت دهیم؟
- آینده: crimson و SeaStore کجا هستند؟
۱۲-۲ چرا BlueStore؟#
۱۲-۲-۱ نیازهای Ceph از لایهی ذخیرهسازی#
OSD برای پیادهسازی تضمینهای RADOS به چند قابلیت از لایهی زیرین نیاز دارد:
- تراکنش اتمی: یک عملیات RADOS ممکن است داده، ویژگیها (xattr) و omap را همزمان تغییر دهد و همه باید با هم انجام شوند یا هیچکدام.
- فهرستگیری مرتب: برای scrub و backfill باید اشیای هر PG را به ترتیب پیمایش کرد.
- فرادادهی کلید-مقدار سریع برای omap (که RGW برای شاخص bucketها و CephFS برای پوشهها به شدت از آن استفاده میکنند).
- checksum برای تشخیص خرابی خاموش داده.
۱۲-۲-۲ محدودیتهای FileStore#
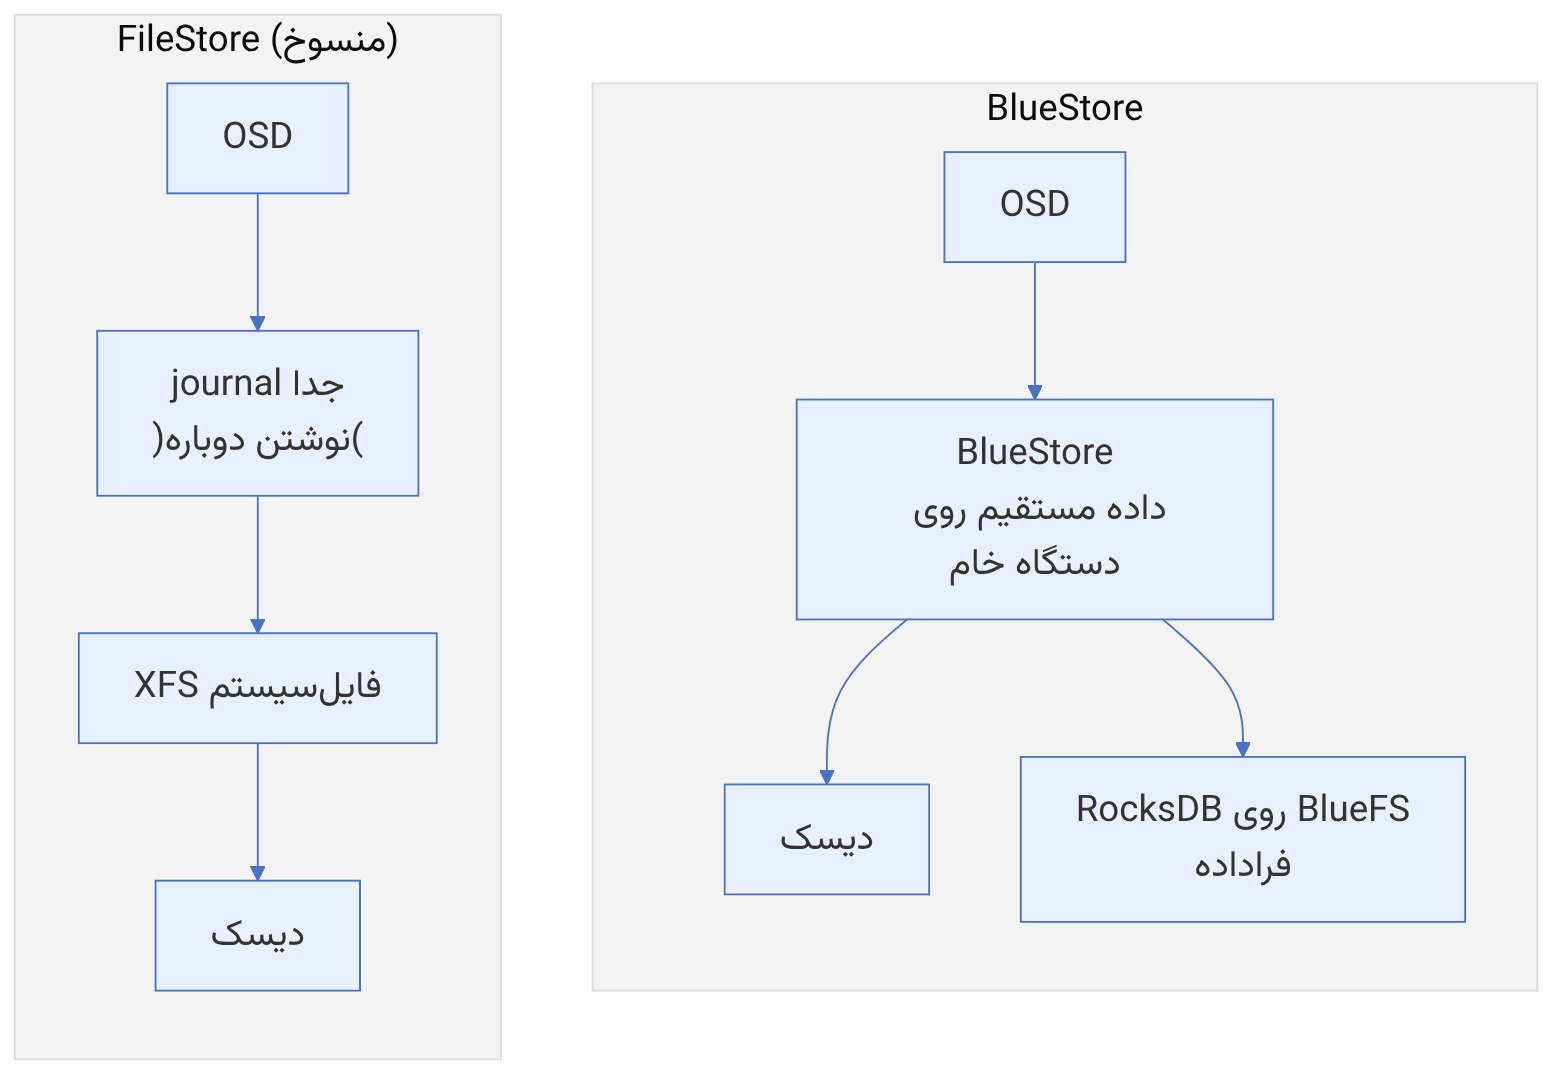
FileStore هر شیء را به شکل یک فایل روی XFS ذخیره میکرد. چون فایلسیستمهای POSIX تراکنش چندعملیاتی ندارند، FileStore برای اتمی بودن یک journal جدا داشت: هر نوشتن ابتدا کامل در journal و سپس در فایلسیستم نوشته میشد. پیامدها:
- نوشتن دوباره: هر بایت دو بار نوشته میشد، که توان مؤثر را تقریباً نصف میکرد.
- لایههای اضافه: cache صفحهی هسته، XFS، xattrها و omap در LevelDB/RocksDB جدا، که رفتار را غیرقابل پیشبینی میکرد.
- فهرستگیری مرتب با پوشههای تودرتو و تقسیم آنها، که در PGهای بزرگ کند بود.
- بدون checksum سرتاسری داده.
۱۲-۲-۳ راهحل BlueStore#
BlueStore داده را مستقیماً روی دستگاه بلوکی خام مینویسد و فراداده را در RocksDB نگه میدارد. با این طراحی:
- برای نوشتنهای بزرگ، داده یک بار نوشته میشود (در فضای تازه، به شیوهی copy-on-write) و فقط فراداده در تراکنش RocksDB ثبت میشود.
- هر بلوک داده checksum دارد (پیشفرض crc32c) و هر خواندن بررسی میشود.
- فشردهسازی درونخطی (inline) در سطح pool یا OSD ممکن است.
- cache داده و فراداده در حافظهی خود OSD مدیریت میشود و با
osd_memory_target کنترل میشود.
۱۲-۳ BlueStore چطور کار میکند؟#
۱۲-۳-۱ RocksDB#
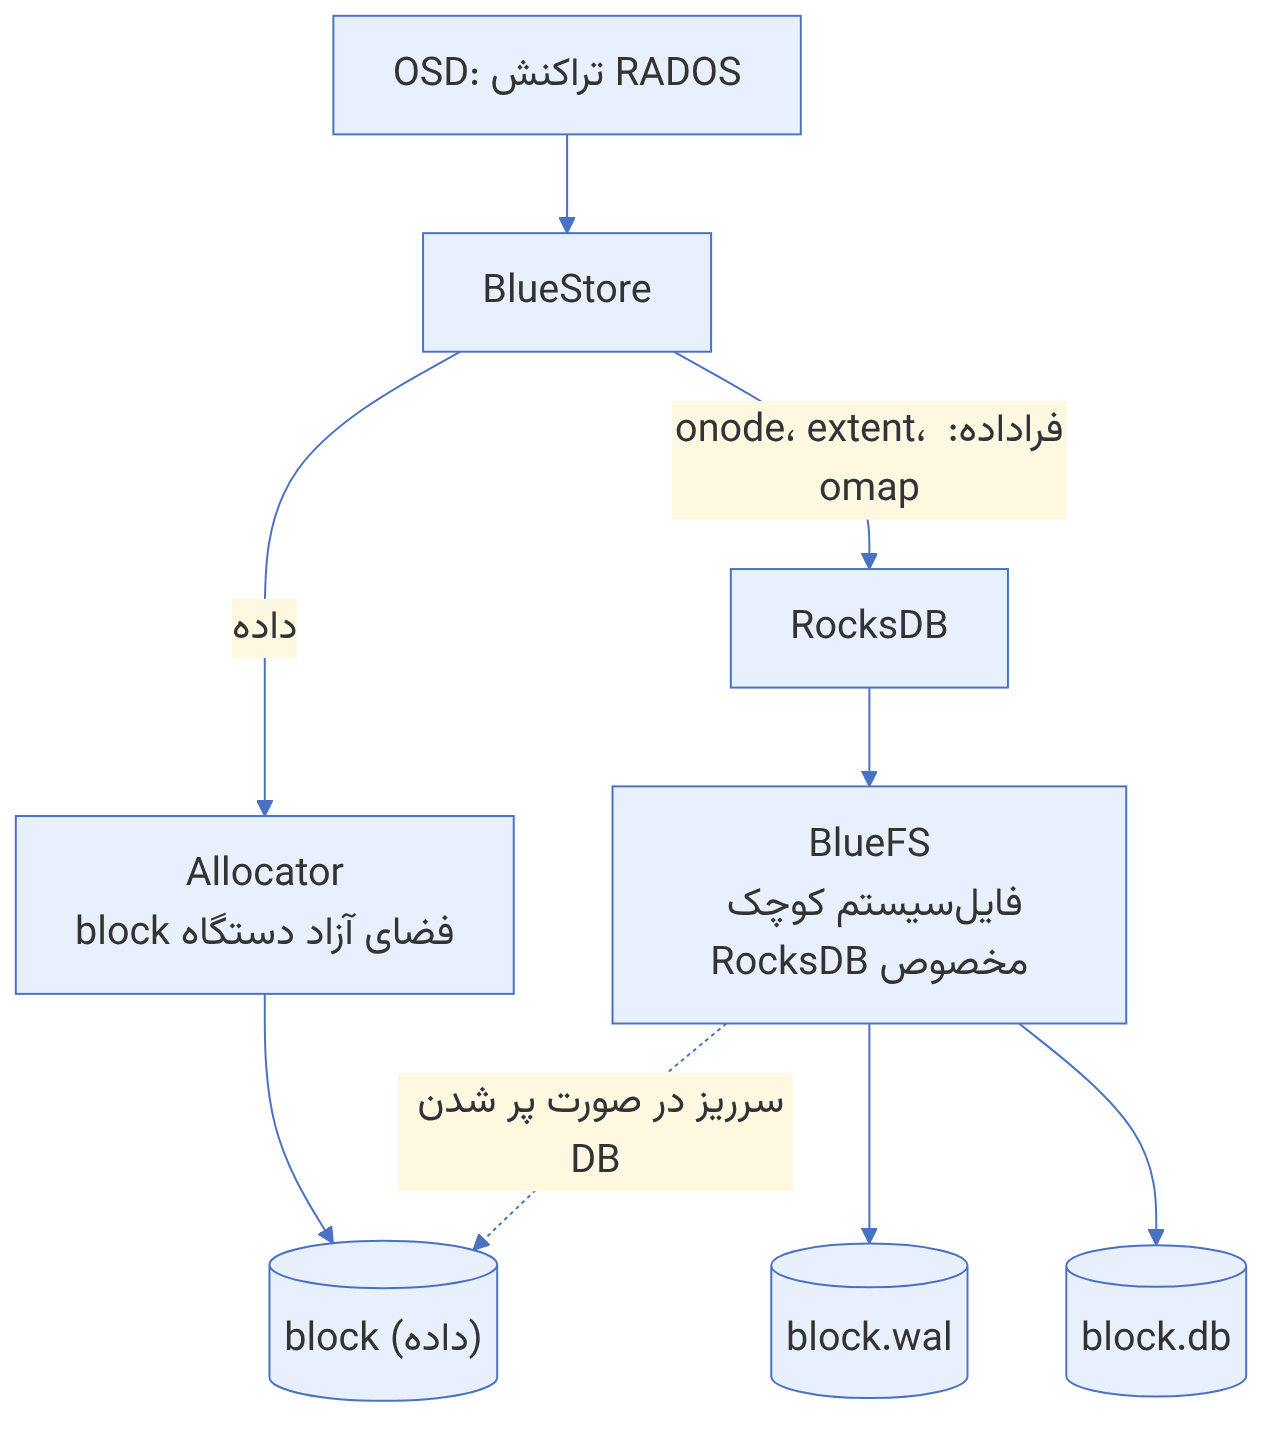
RocksDB یک پایگاه دادهی کلید-مقدار مبتنی بر ساختار LSM است. BlueStore همهی فراداده را در آن نگه میدارد: onode هر شیء (اندازه، نگاشت extentها، ویژگیها)، omap، نقشهی فضای آزاد (در برخی allocatorها) و log تراکنشها. از Pacific، OSDهای تازه RocksDB را sharded میسازند: انواع مختلف کلید در column familyهای جدا قرار میگیرند تا compaction یک نوع کلید روی بقیه اثر نگذارد. OSDهای قدیمیتر را میتوان با ceph-bluestore-tool reshard به چیدمان جدید برد.
در Squid فشردهسازی LZ4 برای RocksDB بهطور پیشفرض فعال شد. این کار حجم DB را کم میکند و بهویژه در کلاسترهای RGW با omap سنگین، احتمال سرریز DB از SSD به HDD را پایین میآورد.
۱۲-۳-۲ BlueFS#
RocksDB برای کار به یک فایلسیستم نیاز دارد (فایلهای SST و WAL خود را مینویسد). به جای XFS، BlueStore یک فایلسیستم بسیار کوچک و مخصوص به نام BlueFS دارد که فقط همین چند نوع فایل را پشتیبانی میکند. BlueFS میتواند روی سه دستگاه پخش شود:
| دستگاه | محتوا | سختافزار مناسب |
|---|---|---|
| block | دادهی اشیا (و در صورت نبود دستگاه دیگر، همهچیز) | HDD یا SSD اصلی |
| block.db | فایلهای RocksDB (و WAL اگر دستگاه wal جدا نباشد) | SSD یا NVMe سریع |
| block.wal | فقط WAL RocksDB | سریعترین دستگاه؛ فقط وقتی سریعتر از db باشد |
اگر block.db پر شود، BlueFS بقیهی فایلهای RocksDB را روی دستگاه block (معمولاً HDD کند) مینویسد. این سرریز (spillover) کارایی فراداده را ناگهان پایین میآورد و با هشدار BLUEFS_SPILLOVER گزارش میشود. نکتهی ظریف این است که RocksDB فایلها را در سطوح (level) با اندازههای تصاعدی نگه میدارد و یک سطح کامل یا روی DB میرود یا نمیرود؛ پس فضای DB بین آستانههای سطحها ممکن است بیاستفاده بماند.
۱۲-۳-۳ نوشتنهای deferred#
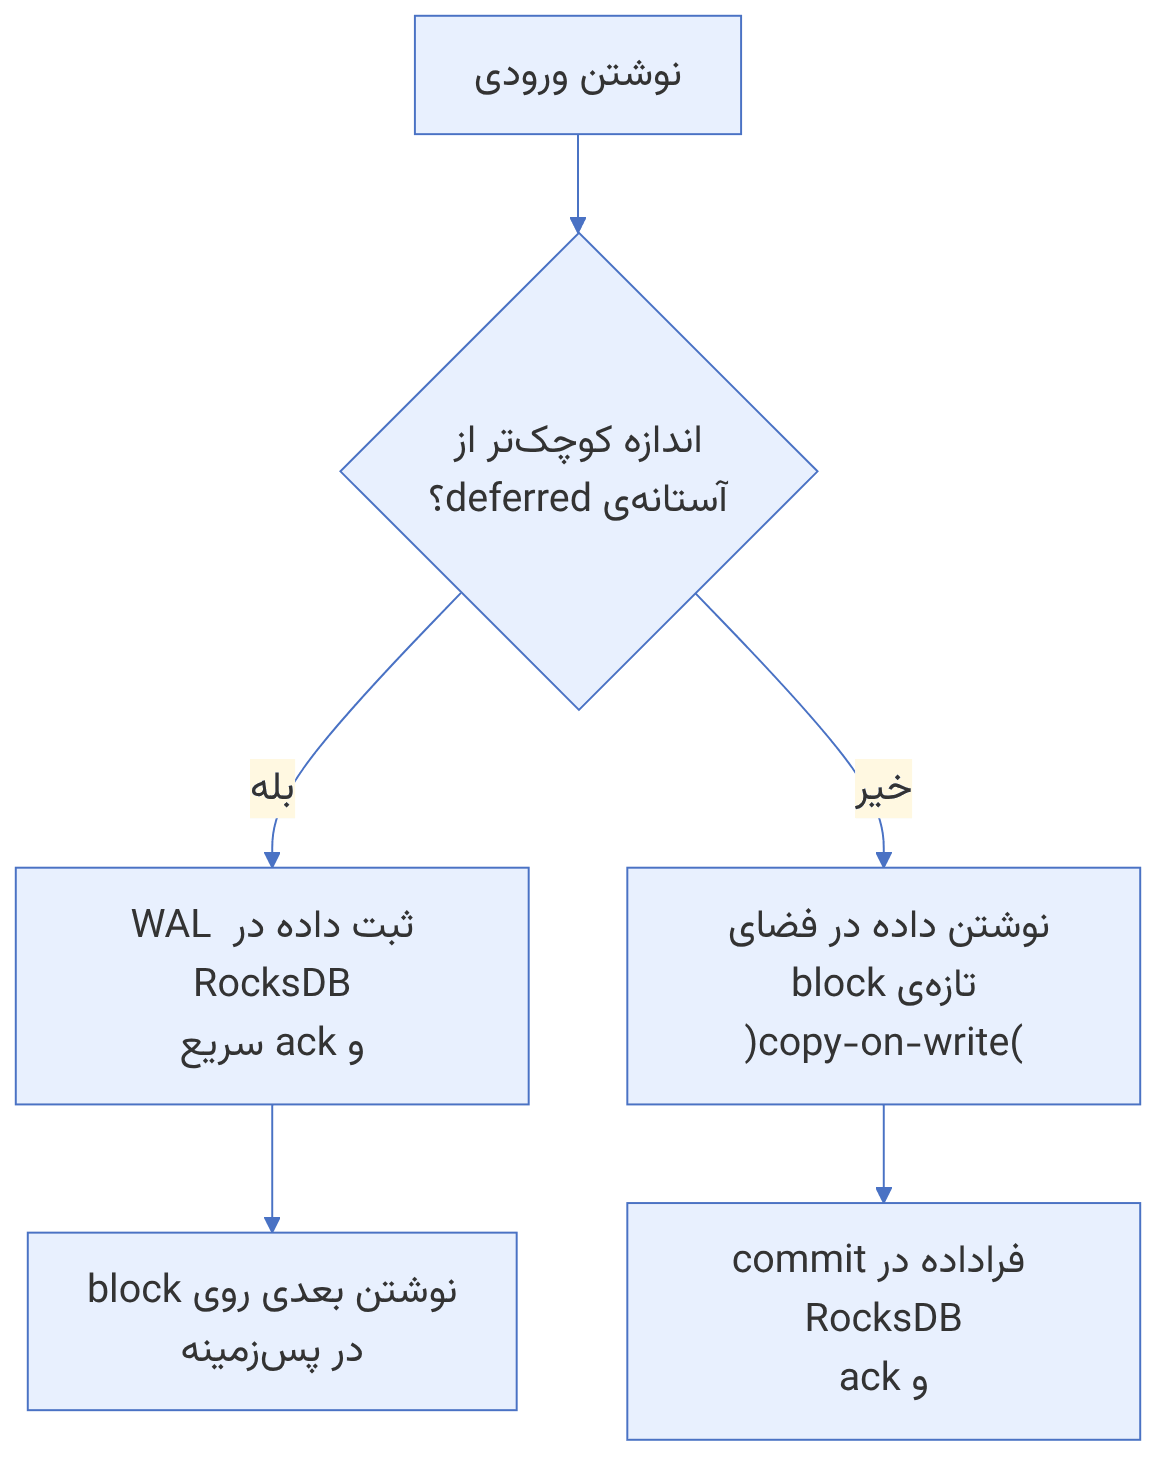
برای HDD، نوشتن تصادفی کوچک گران است (هر نوشتن یک seek). BlueStore نوشتنهای کوچکتر از یک آستانه را deferred میکند: داده همراه فراداده در WAL RocksDB (که معمولاً روی SSD است) ثبت میشود، به کلاینت ack داده میشود و بعداً در پسزمینه روی HDD اعمال میشود. نوشتنهای بزرگتر مستقیماً در فضای آزاد block نوشته میشوند و فقط فراداده در RocksDB commit میشود. آستانهها با bluestore_prefer_deferred_size_hdd و _ssd تنظیم میشوند و جریان این نوشتنها با bluestore_throttle_deferred_bytes محدود میشود.
همین سازوکار دلیل اصلی ارزش داشتن SSD برای block.db در OSDهای HDD است: نه فقط فراداده، بلکه نوشتنهای کوچک هم ابتدا روی SSD میروند. اما SSD باید حفاظت در برابر قطع برق داشته باشد؛ وگرنه نوشتنهای sync در WAL کند میشوند و مزیت از بین میرود (فصل ۱۰).
۱۲-۴ استفاده از BlueStore#
۱۲-۴-۱ چیدمان دستگاهها#
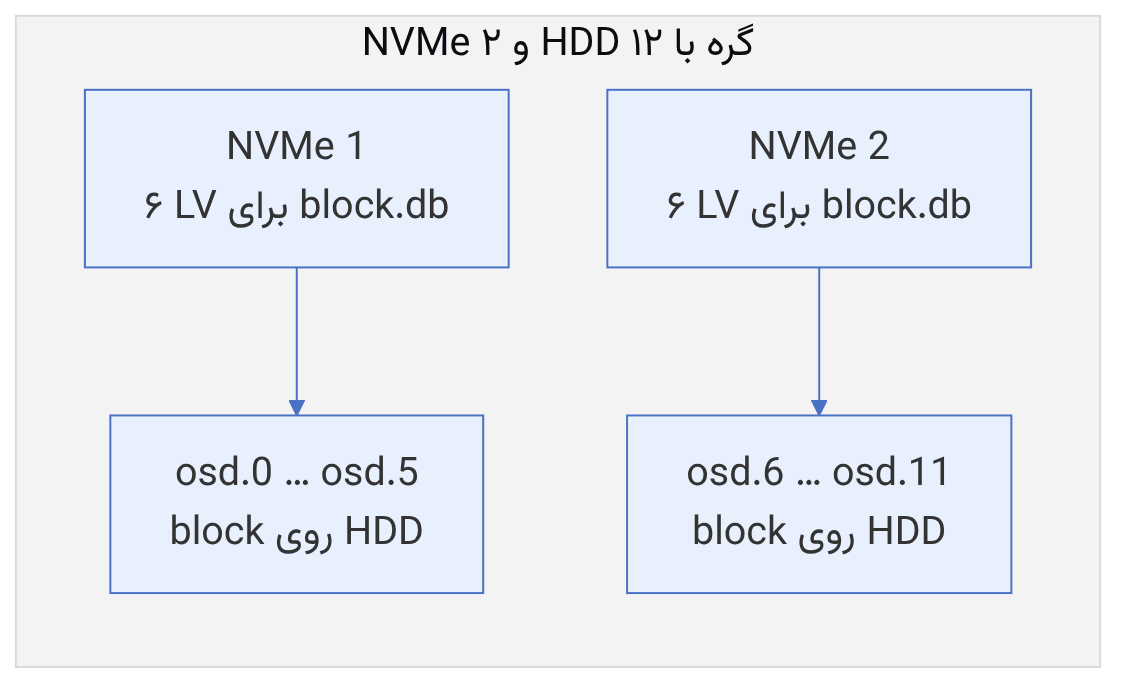
در cephadm، OSDها با ابزار ceph-volume و روی LVM ساخته میشوند. چیدمان را در spec OSD تعیین میکنید (فصل ۱۱)؛ cephadm فضای دستگاه سریع را بهطور مساوی بین OSDهای آن گره تقسیم میکند. سه الگوی رایج:
| الگو | چیدمان | کاربرد |
|---|---|---|
| همهروییک | block، db و wal روی یک SSD یا NVMe | کلاسترهای تمامفلش |
| ترکیبی | block روی HDD، db (و wal همراهش) روی SSD/NVMe مشترک | ظرفیت بالا با هزینهی کم؛ RBD و RGW |
| سهلایه | block روی HDD، db روی SSD، wal روی NVMe یا Optane | نادر؛ فقط وقتی دستگاه wal واقعاً سریعتر است |
در الگوی ترکیبی، از دست رفتن دستگاه db یعنی از دست رفتن همهی OSDهایی که db آنها روی آن است. اگر یک NVMe پشتیبان db دوازده HDD باشد، خرابی آن همارز خرابی دوازده OSD است. نسبت OSD به هر دستگاه db را طوری انتخاب کنید که این دامنهی خرابی با طراحی CRUSH و ظرفیت بازیابی سازگار باشد؛ معمولاً حداکثر ۴ تا ۶ HDD بهازای هر SSD SATA و بیشتر برای NVMe.
۱۲-۴-۲ اندازهی block.db#
مستندات جاری (پس از فعال شدن فشردهسازی RocksDB در Squid) توصیه میکند block.db دستکم ۲.۵ درصد اندازهی دستگاه block باشد. برای نسخههای قدیمیتر و بارهای سنگین omap (RGW) عدد ۴ درصد ذکر شده و برای RBD اغلب ۱ تا ۲ درصد کافی است. مثال: HDD هجده ترابایتی برای RGW به حدود ۴۵۰ تا ۷۲۰ گیگابایت db نیاز دارد.
ceph osd metadata 3 | jq '{bluefs_dedicated_db, bluefs_db_size, devices}'
ceph tell osd.3 bluefs stats
ceph health detail | grep -i spillover
۱۲-۴-۳ min_alloc_size#
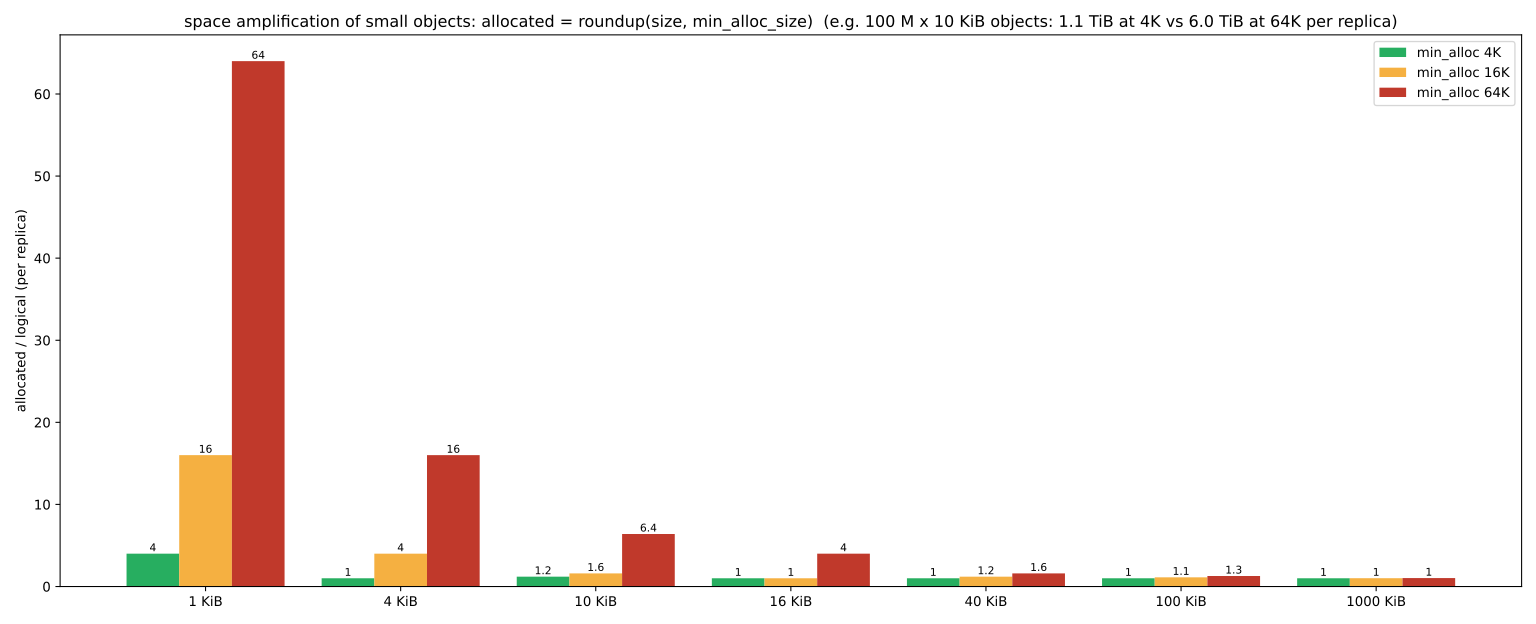
bluestore_min_alloc_size کوچکترین واحد تخصیص روی دستگاه است و فقط هنگام ساخت OSD ثابت میشود. پیشفرضها در کد جاری (src/common/options/global.yaml.in) برای HDD و SSD هر دو 4_K است. سیر تغییر: تا Mimic، ۶۴ کیلوبایت برای HDD و ۱۶ کیلوبایت برای SSD؛ Octopus SSD را به ۴ و Pacific HDD را به ۴ کیلوبایت رساند. انگیزه، تقویت فضا (space amplification) در RGW با اشیای کوچک بود: یک شیء ۱ کیلوبایتی با واحد ۶۴ کیلوبایت، ۶۳ کیلوبایت هدر میداد.
OSDهایی که پیش از Pacific ساخته شدهاند هنوز مقدار قدیمی دارند، حتی پس از ارتقای نرمافزار. با ceph osd metadata <id> | jq .bluestore_min_alloc_size بررسی کنید. تنها راه تغییر، ساختن دوبارهی OSD است.
۱۲-۴-۴ فشردهسازی و checksum#
ceph osd pool set rgw-data compression_algorithm zstd # یا lz4، snappy، zlib
ceph osd pool set rgw-data compression_mode aggressive # none، passive، aggressive، force
ceph osd pool set rgw-data compression_required_ratio 0.875
ceph df detail | grep -E 'POOL|rgw-data' # ستونهای USED COMPR و UNDER COMPR| حالت | رفتار |
|---|---|
| none | هرگز فشرده نکن |
| passive | فقط وقتی کلاینت اشارهی «قابل فشردهسازی» بدهد |
| aggressive | فشرده کن مگر کلاینت بگوید «غیرقابل فشردهسازی» |
| force | همیشه تلاش کن |
فشردهسازی فقط وقتی نگه داشته میشود که نسبت اندازهی فشرده به اصلی از compression_required_ratio کمتر باشد. checksum پیشفرض crc32c است؛ گزینههای crc32c_16، crc32c_8، xxhash32 و xxhash64 هم وجود دارند. checksumهای کوتاهتر حافظهی فراداده را کم میکنند اما قدرت تشخیص خطا را هم پایین میآورند.
۱۲-۵ مهاجرت و نگهداری OSDها#
۱۲-۵-۱ از FileStore به BlueStore#
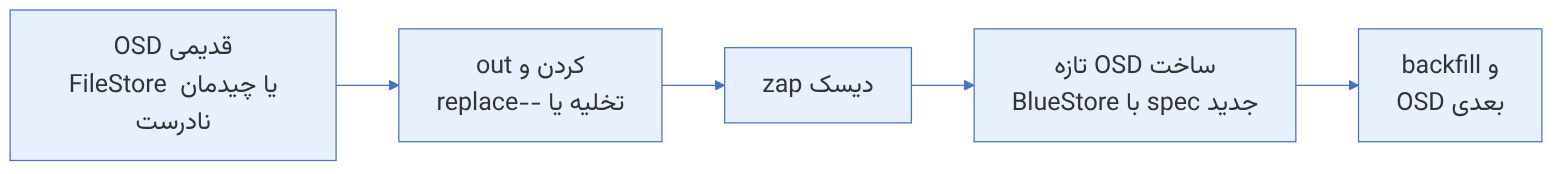
اگر هنوز OSD FileStore دارید، پیش از ارتقا به Reef یا بالاتر باید آنها را تبدیل کنید. تبدیل درجا وجود ندارد؛ روش، ساختن دوبارهی OSD است. دو راهبرد مستند:
- جایگزینی OSD به OSD: هر OSD را با
ceph orch osd rm <id> --replace --zap حذف کنید تا با همان id و این بار BlueStore ساخته شود. ساده اما هر OSD دو بار جابهجایی داده دارد. - جایگزینی میزبان به میزبان: یک میزبان خالی را BlueStore کنید، دادهی یک میزبان FileStore را به آن منتقل کنید، و میزبان آزادشده را برای دور بعد استفاده کنید. جابهجایی کمتر، اما به یک میزبان اضافه نیاز دارد.
۱۲-۵-۲ افزودن یا جابهجا کردن DB#
اگر OSD را بدون db ساختهاید و بعداً SSD اضافه کردهاید، یا dbها کوچک بودهاند، ceph-volume lvm new-db و ceph-volume lvm migrate بدون ساختن دوبارهی OSD این کار را انجام میدهند (OSD باید متوقف باشد):
ceph orch daemon stop osd.7
cephadm shell --name osd.7
ceph-volume lvm new-db --osd-id 7 --osd-fsid <fsid> --target vg_nvme/db_osd7
ceph-volume lvm migrate --osd-id 7 --osd-fsid <fsid> --from data --target vg_nvme/db_osd7
exit
ceph orch daemon start osd.7
۱۲-۵-۳ ابزار ceph-bluestore-tool#
ceph-bluestore-tool show-label --dev /dev/ceph-vg/osd-block-xxxx
ceph-bluestore-tool fsck --path /var/lib/ceph/osd/ceph-7 --deep
ceph-bluestore-tool bluefs-bdev-sizes --path /var/lib/ceph/osd/ceph-7
ceph-bluestore-tool bluefs-bdev-expand --path /var/lib/ceph/osd/ceph-7   # پس از بزرگ کردن LV
ceph-bluestore-tool reshard --path /var/lib/ceph/osd/ceph-7 --sharding "<spec>"همهی این دستورها فقط روی OSD متوقف اجرا میشوند. repair و reshard فراداده را تغییر میدهند؛ ابتدا fsck بگیرید و مطمئن شوید PGهای آن OSD نسخهی سالم در جای دیگر دارند (ceph osd ok-to-stop).
۱۲-۶ BlueStore با عدد: آزمون پذیرش فشردهسازی، اثر min_alloc_size و اندازهی سطحهای RocksDB#
سه محاسبهی این بخش، با پیشفرضهای main در نوامبر ۲۰۲۶، به سه پرسش رایج جواب میدهند: چرا فشردهسازی روی بعضی OSDها هیچ اثری ندارد، چرا اشیای کوچک فضای خام زیادی مصرف میکنند، و block.db چقدر باید باشد. مسیر نوشتن deferred و autotune حافظه در فصل ۲۱ و allocator در فصل ۲۴ آمدهاند.
۱۲-۶-۱ آزمون پذیرش فشردهسازی#
منبع در کد: src/os/bluestore/BlueStore.cc :: BlueStore::_do_alloc_write (want_len، result_len)
پیچیدگی: O(طول blob) برای فشردهسازی و O(۱) برای آزمون
pseudocode
crr = compression_required_ratio در pool یا bluestore_compression_required_ratio (0.875)
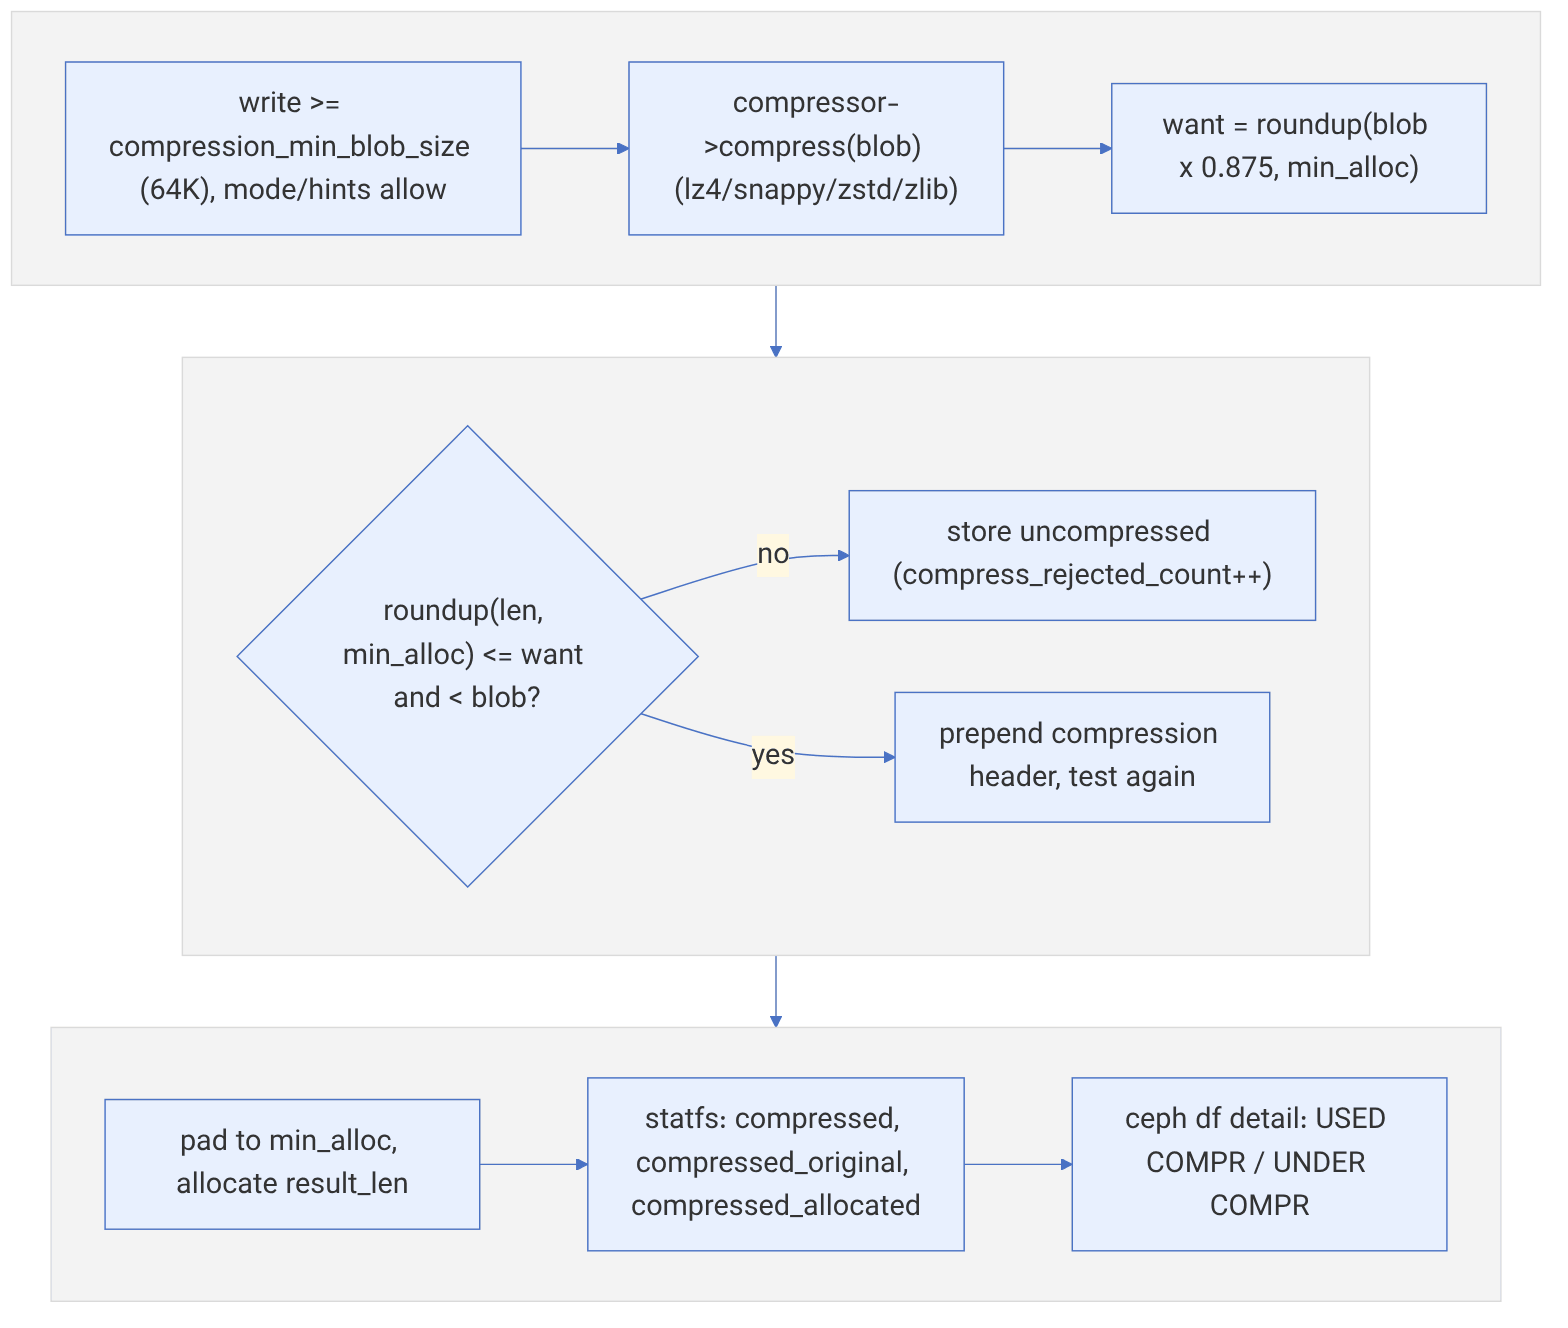
want = p2roundup(blob_length × crr, min_alloc_size)
result = p2roundup(compressed_len, min_alloc_size)
if result ≤ want و result < blob_length:
سرآیند فشردهسازی را اضافه کن و آزمون را تکرار کن ؛ در صورت موفقیت تا min_alloc پر کن
else: ذخیرهی بدون فشردهسازی (شمارندهی compress_rejected_count)
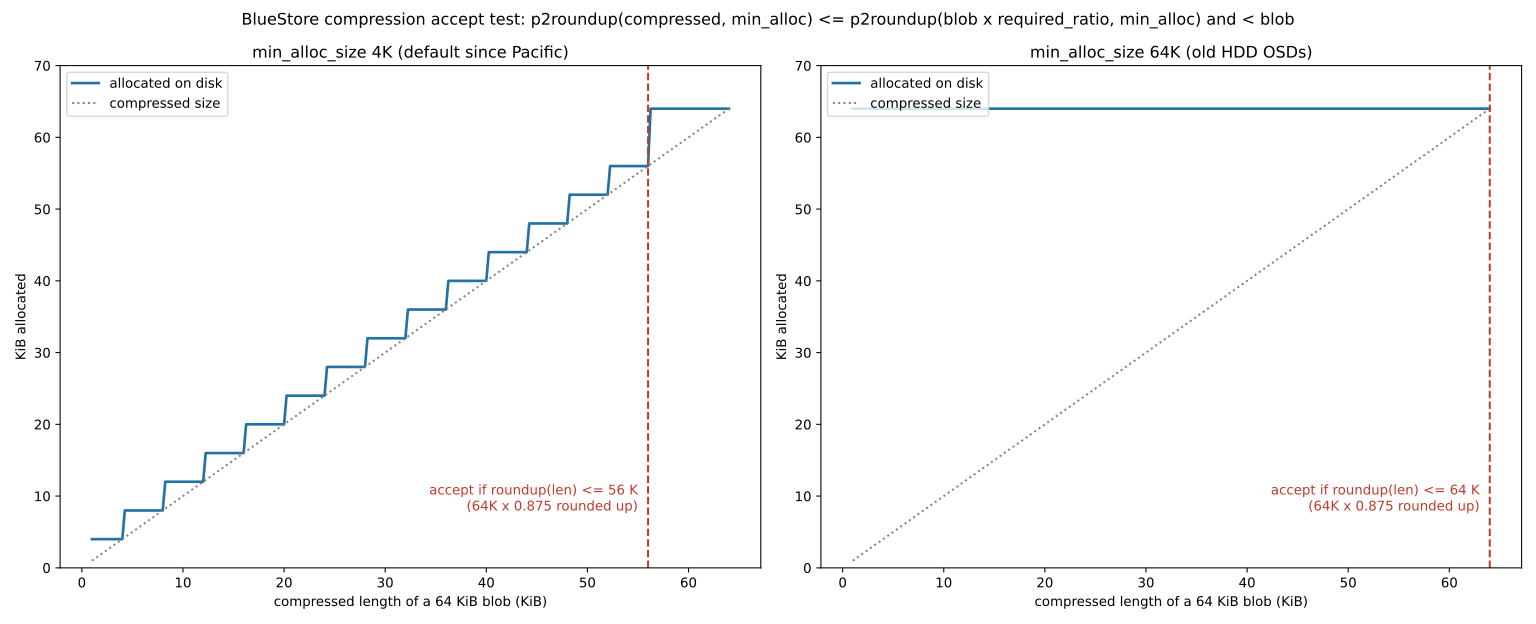
اندازهی blob فشرده: bluestore_compression_min/max_blob_size_{hdd,ssd} (هر دو 64K در main)مثال عددی (blob ۶۴ KiB). با min_alloc_size برابر ۴K، want = ۵۶ KiB است. اگر فشردهی blob ۵۰ KiB شود، result = ۵۲ KiB پذیرفته میشود و ۱۲ KiB صرفهجویی دارد. ۵۷.۵ KiB پذیرفته نمیشود، چون به ۶۰ KiB گرد میشود. با min_alloc_size برابر ۶۴K، که پیشفرض HDD پیش از Pacific بود و پس از ساخت OSD قابل تغییر نیست، want = ۶۴ KiB است و result حتی برای یک blob ۳۰ KiB هم ۶۴ KiB میشود. شرط «result < blob» هیچوقت برقرار نمیشود، پس روی چنین OSDی با blobهای ۶۴ KiB فشردهسازی هرگز صرفهجویی نمیکند. نشانهاش این است که در ceph df detail ستون USED COMPR صفر میماند و شمارندهی compress_rejected بالا میرود. علاج آن ساختن دوبارهی OSD است، یا بزرگ کردن compression_max_blob_size، که هزینهی خواندن تصادفی را بالا میبرد.
۱۲-۶-۲ min_alloc_size و اشیای کوچک#
منبع در کد: src/os/bluestore/BlueStore.cc (min_alloc_size ثبتشده در superblock هنگام mkfs)؛ پیشفرضهای bluestore_min_alloc_size_{hdd,ssd} = 4K در main
پیچیدگی: O(۱)
pseudocode
allocated(size) = p2roundup(size, min_alloc_size) # برای هر replica یا هر shard
amplification = allocated / size
در EC: هر shard جداگانه گرد میشود ← shard = ceil(size / k) گرد به min_allocمثال عددی. شیء ۱ KiB با min_alloc 4K، چهار برابر فضا مصرف میکند و با ۶۴K شصتوچهار برابر. شیء ۱۰ KiB به ترتیب ۱.۲ و ۶.۴ برابر مصرف دارد. برای ۱۰۰ میلیون شیء دهکیلوبایتی (مثلاً thumbnailهای RGW)، مصرف هر replica با ۴K حدود ۱.۱۲ TiB و با ۶۴K حدود ۵.۹۶ TiB است. در pool سهنسخهای این اختلاف به ۱۴.۵ TiB خام میرسد. در EC اثر بدتر است: همان شیء ۱۰ KiB در ۴+۲، شش shard میسازد که هر کدام به ۴K گرد میشوند، یعنی ۲۴ KiB خام برای ۱۰ KiB داده. نسخهی min_alloc_size هر OSD با ceph osd metadata <id> | grep min_alloc دیده میشود.
۱۲-۶-۳ اندازهی سطحهای RocksDB و block.db#
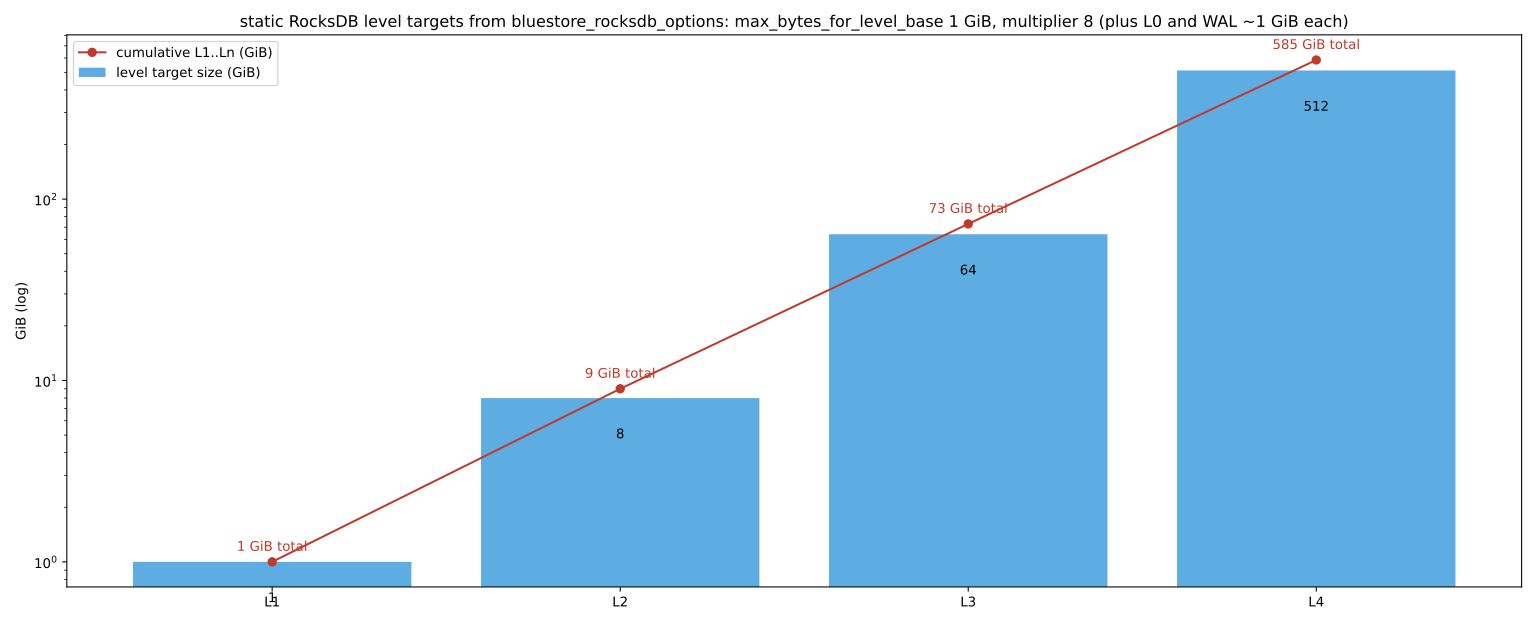
منبع در کد: src/common/options/global.yaml.in :: bluestore_rocksdb_options (max_bytes_for_level_base = 1 GiB، max_bytes_for_level_multiplier = 8)
پیچیدگی: O(تعداد سطحها)
pseudocode
target(L1) = 1 GiB ؛ target(Ln) = target(Ln−1) × 8
cumulative(Ln) = Σ target(L1..Ln) ← 1، 9، 73، 585 GiB
یک سطح فقط وقتی کامل روی دستگاه سریع میماند که فضای آن برای همهی سطحهای پایینتر کافی باشد
افزون بر آن: L0 (تا 8 فایل memtable 16 MiB پیش از compaction) و WAL (max_total_wal_size = 1 GiB)نتیجه. با سطحبندی ایستا، block.db حدود ۱۰ GiB فقط تا L2 را نگه میدارد و حدود ۷۵ تا ۸۰ GiB تا L3 را. هر چیزی بین این دو مقدار در عمل به همان اندازهی کوچکتر کار میکند، چون سطح بعدی جا نمیشود و به دستگاه کند میریزد (هشدار BLUEFS_SPILLOVER). این اعداد فرض «سطحبندی ایستا» دارند. نسخههای تازهی RocksDB گزینهی level_compaction_dynamic_level_bytes را بهطور پیشفرض روشن کردهاند. BlueFS هم در main با bluestore_volume_selection_policy مقداری فضای اضافه را مدیریت میکند. پس این جدول راهنمای نقطهی آغاز است، نه قانون. برای اطمینان، خروجی ceph daemon osd.N bluefs stats را روی یک OSD پرکار بررسی کنید.
۱۲-۷ از درون کد: BlueStore#
این بخش BlueStore را از روی کد منبع Ceph (شاخهی main، مخزن ceph/ceph، نسخهی تاریخ ۲۳ آبان ۱۴۰۵) بررسی میکند. نام فایلها و توابع را میآوریم تا خودتان بتوانید دنبال کنید. رفتار ممکن است بین نسخهها فرق کند؛ هر جا که مهم است، نسخه را ذکر کردهایم.
۱۲-۷-۱ نقشهی فایلها#
| فایل در src/os/bluestore | مسئولیت |
|---|---|
| BlueStore.cc / .h | پیادهسازی ObjectStore: تراکنشها، خواندن و نوشتن، cache، mount/fsck |
| BlueStore_components.h | ساختارهای TransContext، Onode، Blob، ExtentMap و حالتهای txc |
| Writer.cc | منطق نوشتن جدید (تصمیم deferred یا مستقیم، تقسیم به blobها) |
| BlueFS.cc / bluefs_types.h | فایلسیستم کوچک RocksDB و log آن |
| BlueRocksEnv.cc | پل RocksDB به BlueFS (پیادهسازی rocksdb::Env) |
| HybridAllocator*, AvlAllocator*, BitmapAllocator*, Btree2Allocator* | تخصیصدهندههای فضای آزاد |
| BitmapFreelistManager.cc | ذخیرهی پایدار نقشهی فضای آزاد در KV |
| bluestore_types.h | ساختارهای رویدیسک: bluestore_onode_t، bluestore_blob_t، pextent |
| bluestore_tool.cc | ابزار ceph-bluestore-tool |
۱۲-۷-۲ فضای کلید RocksDB#
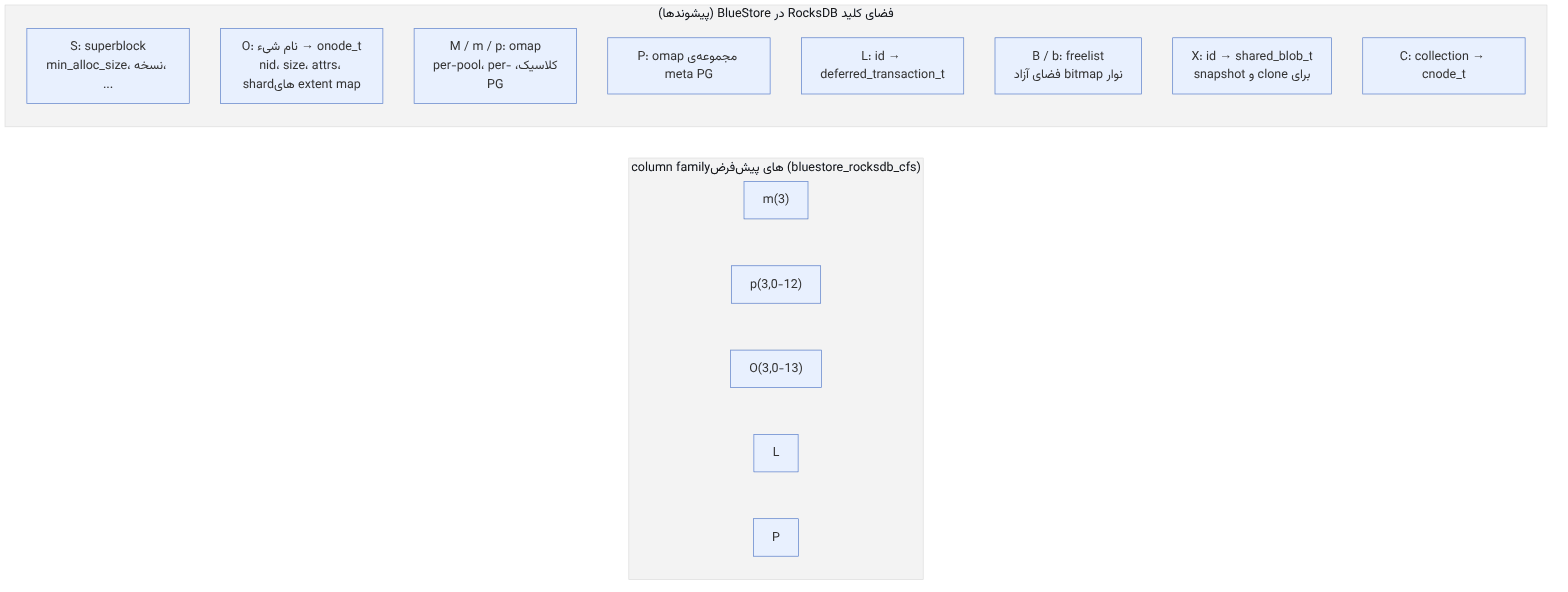
BlueStore همهی فراداده را در یک پایگاه کلید-مقدار نگه میدارد و انواع آن را با یک پیشوند از هم جدا میکند. تعریفها در ابتدای BlueStore.cc آمدهاند:
// from ceph/ceph, LGPL — src/os/bluestore/BlueStore.cc (excerpt)
const std::string PREFIX_SUPER = "S";       // field -> value
const std::string PREFIX_COLL = "C";        // collection name -> cnode_t
const std::string PREFIX_OBJ = "O";         // object name -> onode_t
const std::string PREFIX_OMAP = "M";        // u64 + keyname -> value
const std::string PREFIX_PERPOOL_OMAP = "m"; // s64 + u64 + keyname -> value
const std::string PREFIX_PERPG_OMAP = "p";   // u64(pool) + u32(hash) + u64(id) + keyname -> value
const std::string PREFIX_DEFERRED = "L";    // id -> deferred_transaction_t
const std::string PREFIX_ALLOC = "B";       // u64 offset -> u64 length (freelist)
const std::string PREFIX_SHARED_BLOB = "X"; // u64 SB id -> shared_blob_t
سه نسل omap در این فهرست دیده میشود: M (قدیمی، یک فضای مشترک)، m (per-pool، تا آمار omap هر pool دقیق باشد) و p (per-PG، تا حذف یا انتقال یک PG با یک بازهی پیوسته از کلیدها انجام شود). OSDهای قدیمی پس از ارتقا هشدار BLUESTORE_NO_PER_POOL_OMAP یا BLUESTORE_NO_PER_PG_OMAP میدهند تا با fsck/repair تبدیل شوند.
پیشفرض column familyها در کد جاری:
bluestore_rocksdb_cfs = m(3) p(3,0-12) O(3,0-13)=block_cache={type=binned_lru}
                        L=min_write_buffer_number_to_merge=32 P=min_write_buffer_number_to_merge=32
عدد داخل پرانتز تعداد shard است و بازهی بعدی، بایتهایی از کلید که برای hash استفاده میشوند. مثلاً O(3,0-13) یعنی onodeها در سه column family پخش میشوند. هدف این است که compaction یک نوع کلید (مثلاً omapهای پرحجم RGW) کل پایگاه را قفل نکند. تنظیمات RocksDB هم در bluestore_rocksdb_options است که در کد جاری با compression=kLZ4Compression شروع میشود (همان تغییر Squid).
۱۲-۷-۳ Onode، ExtentMap و Blob#
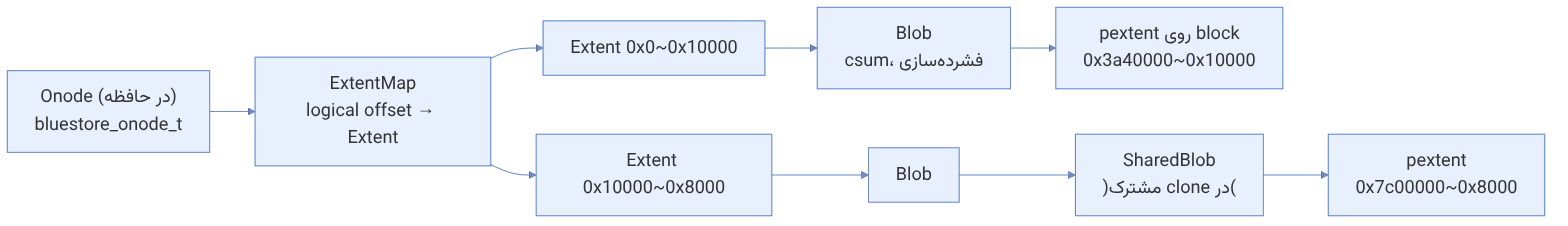
- Onode نمایش در حافظهی
bluestore_onode_t است. فیلدهای اصلی آن: nid (شناسهی عددی محلی)، size، attrs (xattrها)، extent_map_shards و اشارههای تخصیص (expected_object_size، alloc_hint_flags). - ExtentMap نگاشت offset منطقی شیء به Extentهاست. برای اشیای بزرگ، این نقشه به shardهایی تقسیم و هر shard جداگانه در KV ذخیره میشود تا تغییر کوچک در یک شیء ۴ مگابایتی نیازمند بازنویسی کل نقشه نباشد.
- Blob واحد checksum و فشردهسازی است و فهرست pextentها (offset و طول فیزیکی روی block) را دارد.
- SharedBlob وقتی ساخته میشود که دو شیء (مثلاً یک شیء و clone snapshot آن) یک Blob را به اشتراک بگذارند؛ شمارش ارجاع آن زیر پیشوند
X ذخیره میشود.
cache: Onodeها و بافرهای داده در cache جداگانهای نگه داشته میشوند که با bluestore_cache_autotune=true (پیشفرض) و هدف کلی osd_memory_target (پیشفرض 4_G در کد) بین onode، داده و cache بلوک RocksDB تقسیم میشود.
۱۲-۷-۴ چرخهی عمر یک تراکنش#
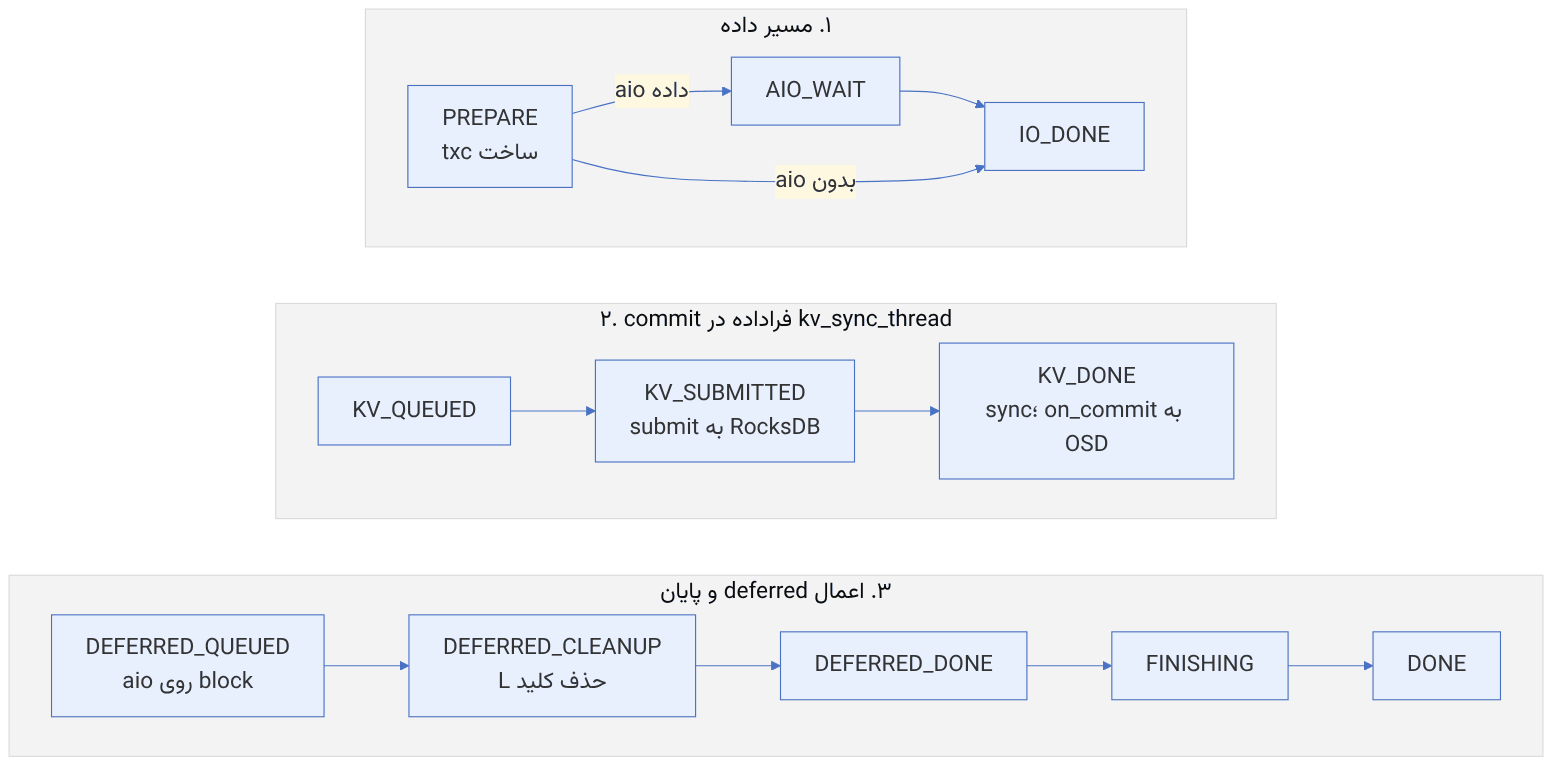
هر تراکنش ObjectStore که OSD با queue_transactions() میفرستد یک TransContext (txc) میسازد. حالتها در BlueStore_components.h تعریف شدهاند:
// from ceph/ceph, LGPL — src/os/bluestore/BlueStore_components.h (excerpt)
typedef enum {
  STATE_PREPARE,
  STATE_AIO_WAIT,
  STATE_IO_DONE,
  STATE_KV_QUEUED,     // queued for kv_sync_thread submission
  STATE_KV_SUBMITTED,  // submitted to kv; not yet synced
  STATE_KV_DONE,
  STATE_DEFERRED_QUEUED,    // in deferred_queue (pending or running)
  STATE_DEFERRED_CLEANUP,   // remove deferred kv record
  STATE_DEFERRED_DONE,
  STATE_FINISHING,
  STATE_DONE,
} state_t;
پیشروی بین این حالتها در BlueStore::_txc_state_proc() انجام میشود؛ یک حلقهی while(true) با switch روی حالت فعلی. روند به زبان ساده:
- ۱. PREPARE:
_txc_add_transaction عملیات را پردازش میکند؛ برای دادهی مستقیم، فضای تازه تخصیص و aio ثبت میشود؛ برای deferred، داده در یک bluestore_deferred_transaction_t قرار میگیرد. - ۲. AIO_WAIT → IO_DONE: منتظر پایان نوشتن داده روی block. ترتیب commit در هر collection (PG) حفظ میشود.
- ۳. KV_QUEUED → KV_SUBMITTED → KV_DONE: thread اختصاصی
_kv_sync_thread() تراکنشهای آماده را دستهای (batch) به RocksDB میفرستد و یک sync مشترک انجام میدهد. پس از sync، callback on_commit اجرا و OSD مطلع میشود که داده پایدار است. همینجا OSD میتواند به primary یا کلاینت ack دهد. - ۴. DEFERRED_*: اگر txc نوشتن deferred داشت، داده اکنون از WAL به جای واقعیاش روی block نوشته میشود (
_deferred_queue، دستهای و مرتبشده بر اساس offset تا HDD کمتر seek کند) و سپس کلید L حذف میشود.
چرا ack پس از KV_DONE ایمن است، حتی وقتی دادهی deferred هنوز روی block نیامده؟ چون خود داده همراه رکورد L در WAL RocksDB پایدار شده است. اگر OSD پیش از اعمال deferred خاموش شود، هنگام mount تابع _deferred_replay() همهی کلیدهای L را میخواند و دوباره اعمال میکند. نوشتن مستقیم هم ایمن است چون در فضای تازه نوشته میشود و تا commit فراداده، هیچ اشارهای به آن نیست؛ اگر خرابی رخ دهد، نسخهی قبلی شیء دستنخورده است.
۱۲-۷-۵ تصمیم deferred یا مستقیم#
در مسیر نوشتن جدید (Writer.cc)، تابع BlueStore::Writer::_defer_or_allocate() تصمیم میگیرد:
// from ceph/ceph, LGPL — src/os/bluestore/Writer.cc (excerpt)
uint32_t released_size = 0;
for (const auto& r : released) {
  released_size += r.length;
}
uint32_t au_size = bstore->min_alloc_size;
do_deferred = need_size <= released_size && released_size < bstore->prefer_deferred_size;
یعنی نوشتن وقتی deferred میشود که (۱) بتواند در همان فضایی نوشته شود که با این نوشتن آزاد میشود (بازنویسی درجا) و (۲) این فضا کوچکتر از prefer_deferred_size باشد. پیشفرضها در کد جاری: bluestore_prefer_deferred_size_hdd = 64_K و bluestore_prefer_deferred_size_ssd = 0 (روی SSD عملاً deferred استفاده نمیشود، چون نوشتن تصادفی ارزان است). کامنت بالای این تابع هم یادآوری میکند که اجرای بخشی از یک نوشتن بهصورت deferred و بخش دیگر مستقیم، در هر حال بهینه نیست؛ پس تصمیم برای کل نوشتن یکجا گرفته میشود.
مسیر نوشتن BlueStore
دستگاه، offset و طول یک نوشتن را انتخاب کنید و ببینید BlueStore چطور آن را تکه میکند و تصمیم میگیرد چه چیزی از WAL (deferred) و چه چیزی مستقیم نوشته شود.
| تکه | بازه | مسیر | شیوه | خواندن پیشین | تخصیص |
|---|---|---|---|---|---|
| big | ۰ B + ۴ KiB | بازنویسی بزرگ در blobهای موجود | deferred (WAL) | – | – |
- queue_transactions OSD تراکنشی به BlueStore میدهد؛ یک TransContext در حالت PREPARE ساخته میشود.
BlueStore::queue_transactions, _txc_create - بُرش در min_alloc _do_write_data نوشتن را به ۱ تکه میبُرد و هر تکه را به _do_write_small یا _do_write_big میفرستد.
BlueStore::_do_write_data, _do_write_small, _do_write_big - عملیات deferred بایتهایی که باید در جا نوشته شوند در یک bluestore_deferred_op_t درون همان تراکنش RocksDB قرار میگیرند.
bluestore_deferred_op_t, BlueStore::_txc_add_transaction - commit در KV همراه داده _kv_sync_thread، metadata و دادهٔ deferred را با یک sync در RocksDB commit میکند؛ نوشتن WAL تنها نوشتن همزمان روی دیسک است.
BlueStore::_kv_sync_thread, _txc_apply_kv - تأیید پس از commit نوشتن ماندگار است؛ _txc_committed_kv callbackهای OSD را کامل میکند و کلاینت میتواند تأییدش را بگیرد.
BlueStore::_txc_committed_kv, _txc_state_proc - نوشتن deferred بعداً و دستهدسته (bluestore_deferred_batch_ops)، بایتهای deferred سر جایشان روی block device نوشته میشوند.
BlueStore::_deferred_queue, _deferred_submit_unlock - پاکسازی وقتی آن نوشتن روی دیسک رفت، _deferred_aio_finish رکورد deferred را از RocksDB پاک میکند.
BlueStore::_deferred_aio_finish
مطابق با:
src/os/bluestore/BlueStore.cc :: _do_write, _do_write_dataبریدن نوشتن به سر، میانه و دُمBlueStore.cc :: _do_write_small, _do_write_bigمسیرهای نوشتن کوچک و بزرگBlueStore.cc :: _do_alloc_write (prefer_deferred_size)تخصیص و تصمیم deferred یا مستقیمBlueStore.cc :: _txc_state_proc, _kv_sync_thread, _deferred_queueماشین حالت تراکنش، commit در KV و صف deferredsrc/os/bluestore/BlueStore_components.h :: TransContext::state_tحالتهای TransContextsrc/common/options/global.yaml.in :: bluestore_min_alloc_size_hdd/ssd (4K), bluestore_prefer_deferred_size_hdd (64K) / _ssd (0)اندازههای پیشفرضی که اینجا به کار رفته
۱۲-۷-۶ تخصیصدهندهی فضای آزاد#
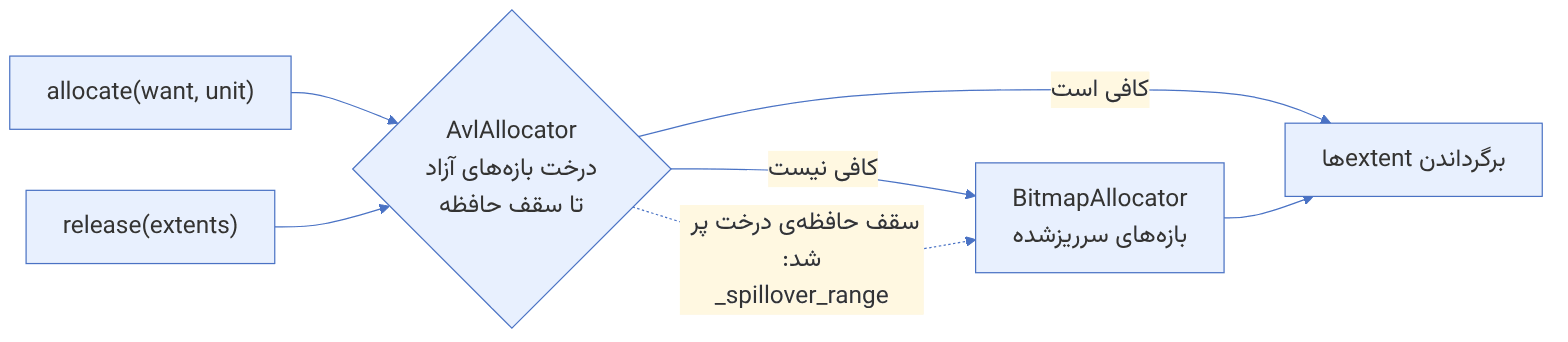
پیشفرض bluestore_allocator در کد جاری hybrid است. HybridAllocator (فایل HybridAllocator.h) ترکیبی از AvlAllocator و BitmapAllocator است: درخت AVL بازههای آزاد را بر اساس offset و اندازه نگه میدارد و تخصیص بازههای پیوسته را سریع میکند، اما حافظهاش با تعداد بازهها رشد میکند. وقتی دیسک تکهتکه (fragmented) شود و تعداد بازهها از سقف حافظه بگذرد، _spillover_range() بازهها را به بیتمپ منتقل میکند. پیامد عملی: روی OSDهای بسیار تکهتکه، تخصیص کندتر میشود. شاخص تکهتکگی را ببینید:
ceph tell osd.3 bluestore allocator score block
ceph tell osd.3 bluestore allocator fragmentation histogram blockنقشهی فضای آزاد روی دیسک (BitmapFreelistManager زیر پیشوندهای B/b) جدا از تخصیصدهندهی در حافظه است. در نسخههای جدید، BlueStore میتواند به جای بهروزرسانی freelist در هر تراکنش، وضعیت تخصیص را هنگام خاموشی تمیز ذخیره کند و پس از خاموشی ناگهانی آن را از روی onodeها بازسازی کند (OnodeScan.cc)؛ این کار بار نوشتن KV را کم میکند اما زمان راهاندازی پس از crash را بیشتر.
۱۲-۷-۷ شبهکد خلاصهی مسیر نوشتن#
queue_transactions(ops):
txc = new TransContext(state=PREPARE)
for op in ops: # write, setattr, omap_set, remove, clone, ...
onode = get_onode(op.oid) # از cache یا کلید O
if op is write:
released = extents overwritten by [off, off+len)
if len <= released and released < prefer_deferred_size:
txc.deferred.append(data) # ثبت در کلید L همراه فراداده
else:
ext = allocator.allocate(round_up(len, min_alloc_size))
aio_write(ext, data, csum=crc32c)
onode.extent_map.update(off, len, blobs)
txc.kv.set("O"+oid, encode(onode)) # و omap/attr/shared_blob بهروزشده
state_proc(txc) # AIO_WAIT -> KV_* -> DEFERRED_* -> DONE- FileStore از Reef پشتیبانی نمیشود؛ پیش از ارتقا همهی OSDها را BlueStore کنید.
- block.db دستکم ۲.۵٪ (RGW سنگین: ۴٪)؛
BLUEFS_SPILLOVER را پایش کنید. - دامنهی خرابی دستگاه db مشترک را در طراحی لحاظ کنید.
- min_alloc_size هنگام ساخت ثابت میشود؛ OSDهای پیش از Pacific را بررسی کنید.
- SSD با حفاظت قطع برق برای db/wal.
- ابزارهای bluestore فقط روی OSD متوقف؛ fsck پیش از repair.
- تکهتکگی تخصیصدهنده را روی OSDهای پر و قدیمی پایش کنید.
۱۲-۸ تکمیلی و بهروز#
- پیشفرضهای کد جاری:
bluestore_allocator=hybrid، bluestore_min_alloc_size_hdd/ssd=4_K، bluestore_prefer_deferred_size_hdd=64_K، bluestore_csum_type=crc32c، osd_memory_target=4_G. - Pacific: sharding RocksDB برای OSDهای تازه؛ min_alloc_size HDD به ۴ کیلوبایت.
- Squid: فشردهسازی LZ4 در RocksDB بهطور پیشفرض؛ کاهش توصیهی اندازهی db به ۲.۵٪.
- Reef: FileStore پشتیبانی نمیشود.
- crimson/SeaStore: crimson در Squid و SeaStore در Tentacle پیشنمایش فناوریاند؛ crimson OSD میتواند BlueStore را هم بهعنوان backend استفاده کند. برای production هنوز BlueStore کلاسیک توصیه میشود.
۱۲-۹ تمرین عملی#
- ۱. با
ceph osd metadata برای سه OSD، نوع دستگاهها، اندازهی db و min_alloc_size را استخراج کنید. - ۲. یک pool آزمایشی با فشردهسازی zstd در حالت aggressive بسازید، فایل متنی بزرگ و فایل فشردهشده بنویسید و ستونهای فشردهسازی
ceph df detail را مقایسه کنید. - ۳. با
ceph tell osd.N bluefs stats مصرف db و slow را ببینید. اگر سرریز دارید، علتش را با اندازهی db تحلیل کنید. - ۴. در آزمایشگاه، یک OSD را بدون db بسازید، سپس با
ceph-volume lvm new-db و migrate به آن db اضافه کنید. - ۵. سطح debug BlueStore را موقتاً روی یک OSD به ۱۰ ببرید، یک نوشتن کوچک و یک نوشتن بزرگ انجام دهید و در لاگ کلمات
deferred و direct و حالتهای txc را پیدا کنید. سپس debug را برگردانید. - ۶. در کد منبع، تابع
_deferred_replay را پیدا کنید و توضیح دهید هنگام mount چه کلیدهایی را میخواند.
۱۲-۱۰ پرسشهای مرور#
- ۱. سه محدودیت اصلی FileStore کدام بودند؟
- ۲. چرا BlueStore برای نوشتنهای بزرگ نیازی به journal جدا ندارد؟
- ۳. BlueFS چیست و چرا Ceph از XFS برای RocksDB استفاده نمیکند؟
- ۴. سرریز BlueFS چیست و چه اثری دارد؟
- ۵. شرط deferred شدن یک نوشتن در
_defer_or_allocate چیست؟ - ۶. چرا ack به کلاینت پس از KV_DONE ایمن است؟
- ۷. سه نسل omap در فضای کلید BlueStore کداماند و چرا per-PG بهتر است؟
- ۸. چرا min_alloc_size از ۶۴ کیلوبایت به ۴ کیلوبایت کاهش یافت؟
- ۹. HybridAllocator چه مصالحهای بین AVL و bitmap برقرار میکند؟
- ۱۰. خرابی یک NVMe پشتیبان db چه اثری بر کلاستر دارد؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۲-۱۱ منابع این فصل#
- BlueStore configuration reference
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - BlueStore migration
https://docs.ceph.com/en/latest/rados/operations/bluestore-migration/ - ceph-bluestore-tool
https://docs.ceph.com/en/latest/man/8/ceph-bluestore-tool/ - ceph-volume lvm migrate
https://docs.ceph.com/en/latest/ceph-volume/lvm/migrate/ - Health checks
https://docs.ceph.com/en/latest/rados/operations/health-checks/ - Source: src/os/bluestore (BlueStore.cc, BlueStore_components.h, Writer.cc, HybridAllocator.h
https://github.com/ceph/ceph/tree/main/src/os/bluestore - Source: option definitions
https://github.com/ceph/ceph/blob/main/src/common/options/global.yaml.in - Aghayev et al., "File Systems Unfit as Distributed Storage Backends: Lessons from 10 Years of Ceph Evolution" (SOSP ۲۰۱۹
https://www.pdl.cmu.edu/PDL-FTP/Storage/ceph-exp-sosp19.pdf - Squid release notes
https://docs.ceph.com/en/latest/releases/squid/ - Reef release notes
https://docs.ceph.com/en/latest/releases/reef/