کدگذاری پاکشونده (Erasure Coding) برای بهرهوری ذخیرهسازی
حوصله ندارم این فصل در چند خط
- erasure coding داده را به k تکهی داده و m تکهی parity میشکند؛ هر k تکه برای بازسازی کافی است، پس m خرابی با فضای خام بسیار کمتر از replication تحمل میشود.
- در pool از نوع EC هر OSD در acting set یک shard را نگه میدارد؛ RBD و CephFS روی EC به
allow_ec_overwrites نیاز دارند و RBD متادیتا را در pool از نوع replicated نگه میدارد. - در Tentacle افزونهی پیشفرض کلاسترهای تازه ISA-L شد و FastEC (خواندن و نوشتن جزئی و parity-delta) پشت
allow_ec_optimizations آمد. - عدد
2147483647 در نگاشت PG همان CRUSH_ITEM_NONE است: CRUSH برای آن shard هیچ OSDی پیدا نکرده است.
۱۳-۱ پیش از شروع#
۱۳-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
تکثیر سهتایی ساده و سریع است، اما برای هر ترابایت دادهی کاربر سه ترابایت دیسک مصرف میکند. کدگذاری پاکشونده (Erasure Coding یا EC) با همان یا حتی بیشتر از سطح تحمل خرابی، سربار را به حدود ۱.۵ برابر یا کمتر میرساند. بهای آن پیچیدگی بیشتر، مصرف CPU و تأخیر بالاتر در نوشتنهای کوچک است. از ۲۰۱۹ تا امروز EC در Ceph دو تحول بزرگ داشته: پیشفرض شدن ISA-L به جای Jerasure و معرفی FastEC در Tentacle.
- EC چیست و پارامترهای k و m چه معنایی دارند؟
- EC درون Ceph چطور پیاده شده است: stripe، shard و chunk؟
- افزونهها (ISA، Jerasure، LRC، SHEC، CLAY) چه تفاوتی دارند؟
- کجا از EC استفاده کنیم و کجا نه؟
- pool EC را چطور بسازیم و overwrite و FastEC را فعال کنیم؟
- خطای معروف «۲۱۴۷۴۸۳۶۴۷» از کجا میآید؟
۱۳-۲ EC چیست؟#
۱۳-۲-۱ k+m#
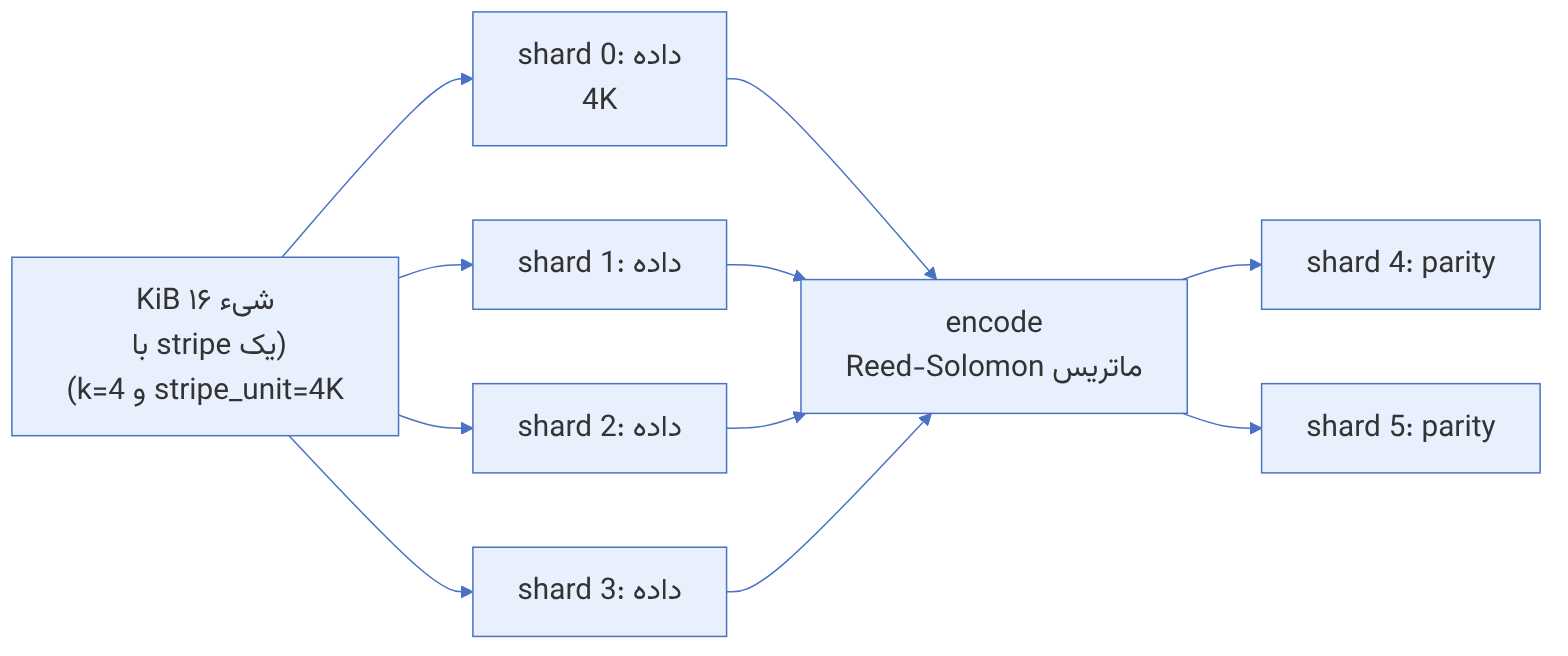
در EC، داده به k قطعهی داده تقسیم میشود و از آنها m قطعهی parity محاسبه میشود. هر k قطعه از k+m قطعه برای بازسازی کامل داده کافی است؛ بنابراین تا m خرابی همزمان قابل تحمل است.
| طرح | سربار ذخیرهسازی | تحمل خرابی | حداقل دامنهی خرابی (host) |
|---|---|---|---|
| تکثیر ۳ | ۳.۰× | ۲ | ۳ |
| EC 2+1 | ۱.۵× | ۱ | ۳ |
| EC 4+2 | ۱.۵× | ۲ | ۶ |
| EC 8+3 | ۱.۳۷۵× | ۳ | ۱۱ |
| EC 8+4 | ۱.۵× | ۴ | ۱۲ |
«حداقل دامنهی خرابی» شوخی نیست: با EC 8+3 و دامنهی خرابی host به یازده میزبان نیاز دارید و برای اینکه پس از خرابی یک میزبان بتوان shardها را بازسازی کرد، دوازده میزبان یا بیشتر. EC روی کلاستر کوچک یا فشار به جای دامنهی خرابی (مثلاً crush-failure-domain=osd) دوام واقعی را از بین میبرد.
Replication یا erasure coding
k، m و plugin را انتخاب کنید و ظرفیت قابلاستفاده، سربار، خرابیهای قابلتحمل و هزینهٔ بازسازی یک chunk را مقایسه کنید.
EC isa k=4 m=2
- قابلاستفاده
- ۵۱۲ TB (۶۶٫۷٪)
- تا nearfull (۸۵٪)
- ۴۳۵٫۲ TB
- بایت خام به ازای هر بایت مفید
- ۱٫۵×
- از دست رفتن OSD/host بدون از دست رفتن داده
- ۲
- size / min_size
- ۶ / ۵
- از دست رفتن با ادامهٔ I/O
- ۱
- خواندن برای بازسازی یک chunk
- ۴ chunk
تکراری، size برابر ۳
- قابلاستفاده
- ۲۵۶ TB (۳۳٫۳٪)
- تا nearfull (۸۵٪)
- ۲۱۷٫۶ TB
- بایت خام به ازای هر بایت مفید
- ۳×
- از دست رفتن OSD/host بدون از دست رفتن داده
- ۲
- size / min_size
- ۳ / ۲
- از دست رفتن با ادامهٔ I/O
- ۱
- خواندن برای بازسازی یک chunk
- ۱ chunk
ceph osd erasure-code-profile set prof-4-2 plugin=isa k=4 m=2 crush-failure-domain=host
ceph osd pool create ecpool erasure prof-4-2
ceph osd pool set ecpool allow_ec_overwrites true   # RBD, CephFS
profile پیشفرض در main برابر plugin=isa technique=reed_sol_van k=2 m=2 است؛ profile را پس از آنکه poolی از آن استفاده کرد نمیتوان تغییر داد.
مطابق با:
src/mon/OSDMonitor.cc :: prepare_pool_sizesize و min_size یک pool تازهsrc/common/options/global.yaml.in :: osd_pool_default_erasure_code_profile, mon_osd_nearfull_ratioprofile پیشفرض و نسبتهای پرشدگیsrc/erasure-code/lrc/ErasureCodeLrc.cc :: parse_kmlقاعدههای k، m و l در LRCsrc/erasure-code/clay/ErasureCodeClay.cc :: parseبازهٔ d در CLAYsrc/erasure-code/shec/ErasureCodeShec.cc :: parseقاعدهٔ c در SHECsrc/osd/OSDMap.cc :: pool_raw_used_rateفضای خام به ازای هر بایت (size یا (k+m)/k)
۱۳-۲-۲ ریاضیات به زبان ساده#
کدهای Reed-Solomon (که ISA-L و Jerasure پیاده میکنند) روی میدان گالوا (معمولاً ) کار میکنند: هر بایت یک عنصر میدان است و جمع، XOR است. k بایت داده را بردار d در نظر بگیرید؛ shardها حاصل ضرب ماتریس مولد G با ابعاد (k+m)×k در d هستند. k سطر اول G ماتریس همانی است (پس shardهای داده همان دادهاند) و m سطر بعدی ضرایب parity. برای بازسازی، از هر k shard در دسترس، زیرماتریس k×k متناظر را میگیریم و معکوس میکنیم. شرط کار این است که هر زیرماتریس k×k وارونپذیر باشد؛ ماتریسهای Vandermonde (reed_sol_van) و Cauchy (cauchy) این ویژگی را دارند.
shard_i = Σ_j  G[i][j] ⊗ d_j      (⊗ ضرب در GF(2^8)، Σ همان XOR)
برای i < k:  G[i] = e_i  →  shard_i = d_i
decode: d = (G_S)^-1 · shards_S (S: هر k اندیس در دسترس)۱۳-۳ EC درون Ceph#
۱۳-۳-۱ stripe، shard و chunk#
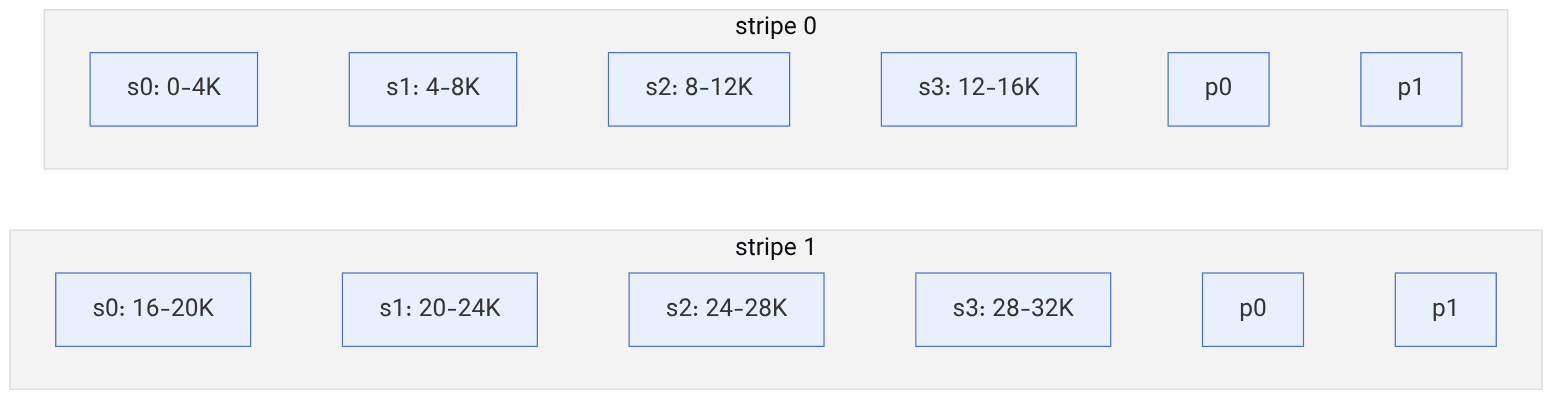
در pool EC، هر PG به جای «نسخه» shard دارد: OSD شمارهی i در acting set، shard i است و فقط قطعهی خودش را نگه میدارد. شیء به stripeهایی به اندازهی k × stripe_unit تقسیم میشود (پیشفرض stripe_unit چهار کیلوبایت). برای هر stripe، k قطعهی داده و m قطعهی parity ساخته و قطعهی i روی shard i ذخیره میشود. پس روی هر OSD، شیء به شکل یک «شیء shard» شامل همهی قطعههای i آن شیء دیده میشود.
۱۳-۳-۲ primary در EC#
primary در pool EC مسئول encode و decode است: کلاینت فقط با primary صحبت میکند، primary داده را encode و قطعهها را به shardها میفرستد. در خواندن، primary قطعههای لازم را از shardها جمع و در صورت نیاز decode میکند. این یعنی بار CPU و شبکهی EC روی primaryها متمرکز است.

۱۳-۳-۳ نوشتن جزئی و overwrite#
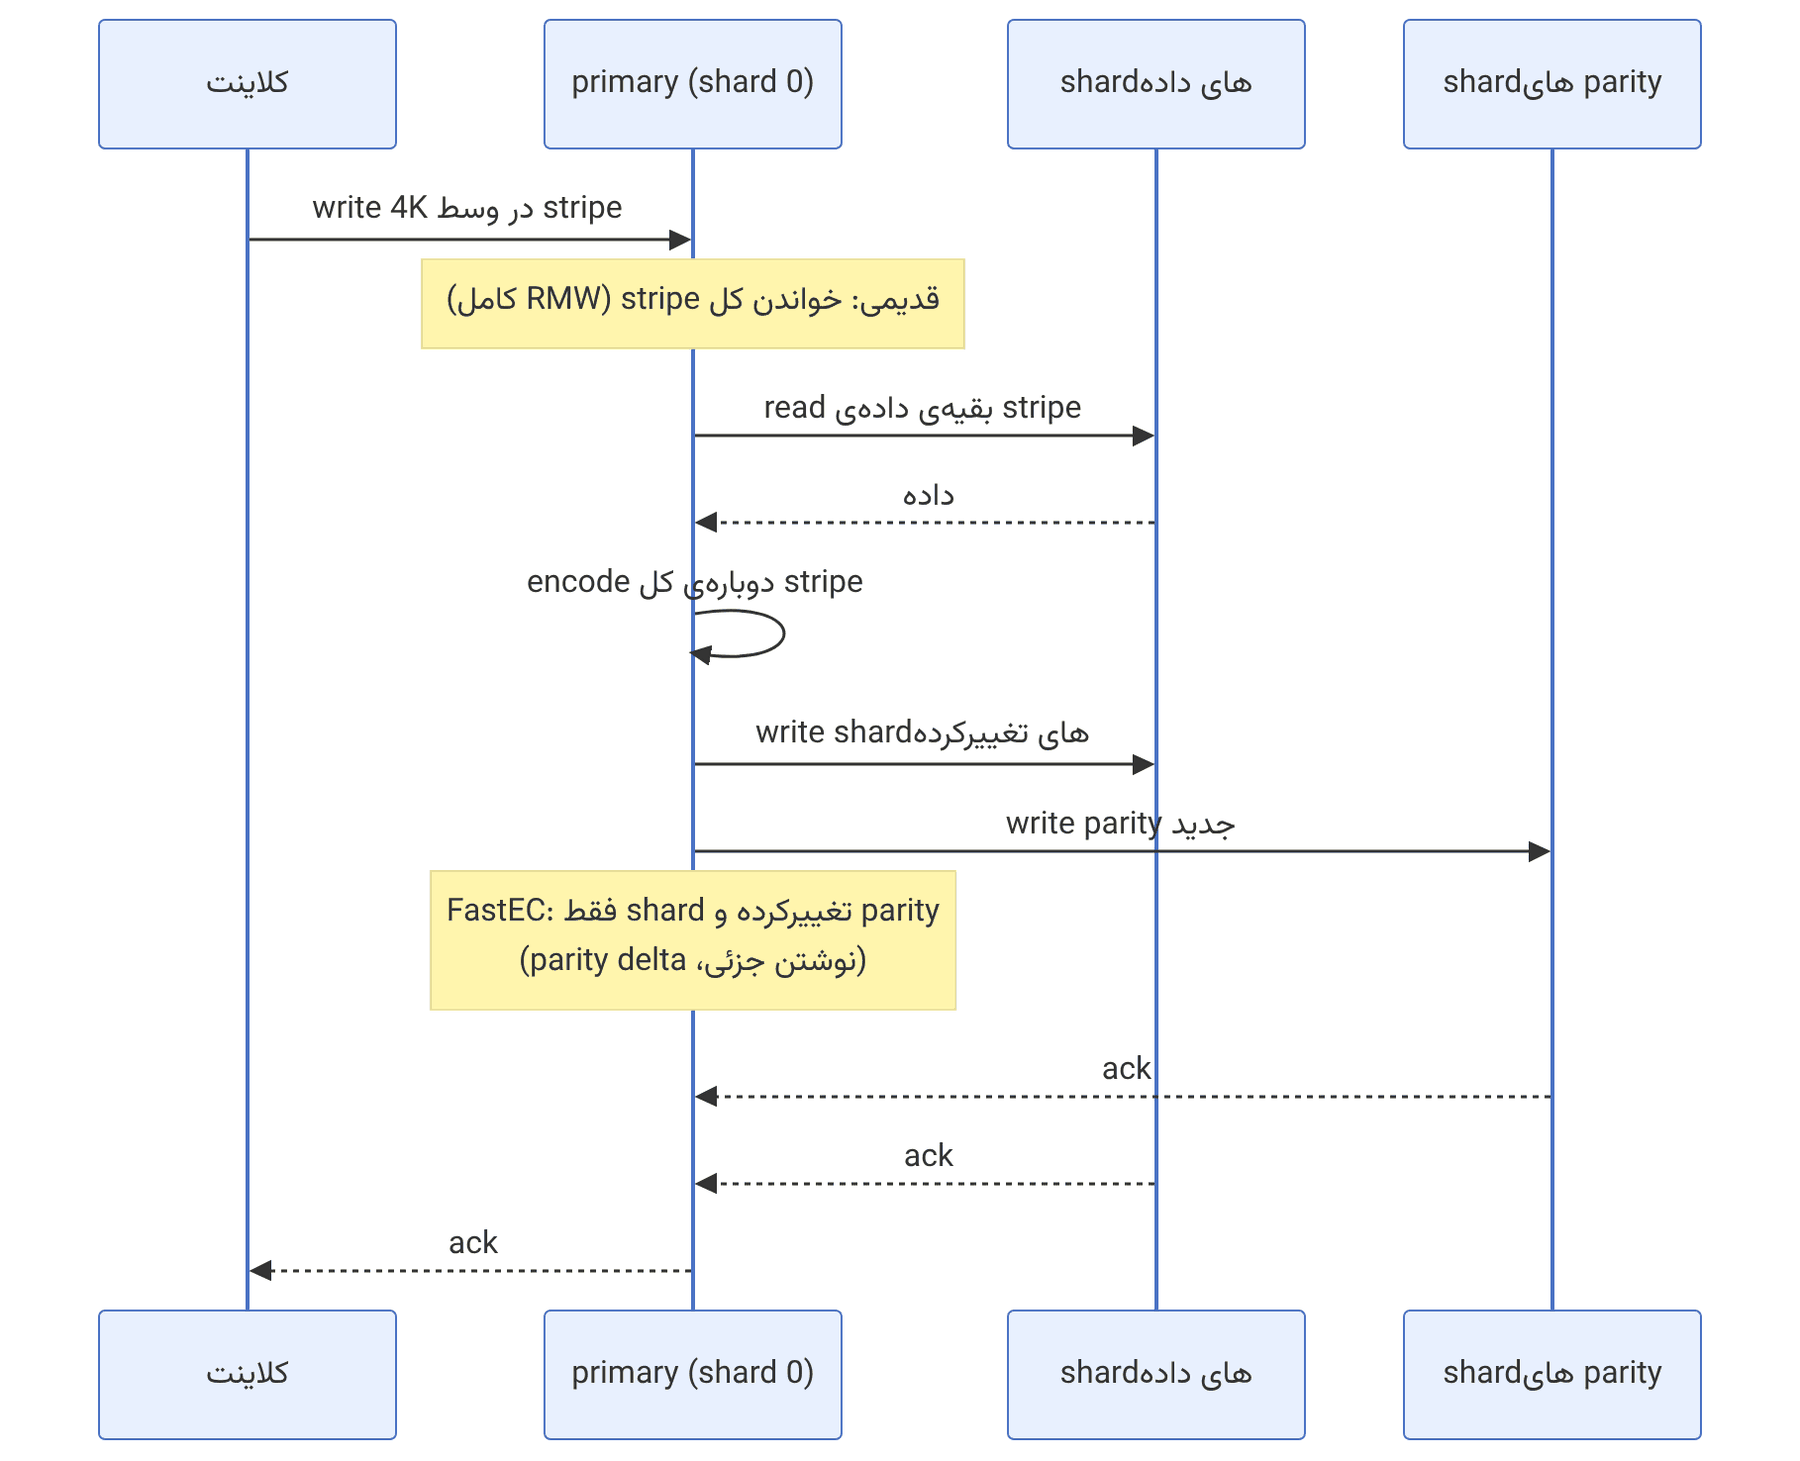
EC در ابتدا (پیش از Luminous) فقط append را پشتیبانی میکرد و برای RBD و CephFS قابل استفاده نبود. پرچم allow_ec_overwrites (از Luminous، که سرفصل قدیمی آن را با Kraken مرتبط کرده) بازنویسی را ممکن کرد. اما در پیادهسازی قدیمی، بازنویسی ۴ کیلوبایت در وسط یک stripe یعنی read-modify-write کامل: خواندن بقیهی stripe، encode دوباره و نوشتن همهی shardها.
۱۳-۴ افزونهها و پروفایلها#
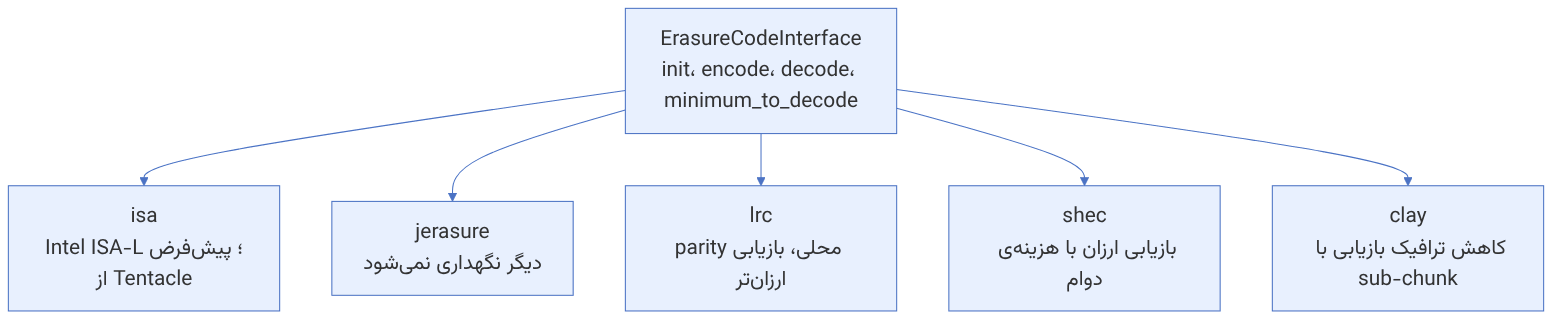
| افزونه | ایده | کاربرد |
|---|---|---|
| isa | Reed-Solomon با کتابخانهی Intel ISA-L (ماتریس Vandermonde یا Cauchy)؛ پیشفرض کلاسترهای تازه از Tentacle | انتخاب پیشفرض؛ پشتیبانی از FastEC |
| jerasure | Reed-Solomon و کدهای دیگر با کتابخانهی Jerasure؛ کتابخانه دیگر نگهداری نمیشود | کلاسترهای قدیمی؛ FastEC فقط با reed_sol_van |
| lrc | Locally Repairable Code: گروههای محلی با parity محلی | بازیابی با خواندن کمتر؛ کلاسترهای چندرکی |
| shec | Shingled EC: parityهای همپوشان | کاهش هزینهی بازیابی با هزینهی کمی دوام |
| clay | Coupled-layer: تقسیم chunk به sub-chunk | کاهش شدید ترافیک شبکه در بازیابی یک shard |
طبق یادداشت انتشار Tentacle، افزونهی پیشفرض از Jerasure به ISA-L تغییر کرد. کلاسترهایی که روی Tentacle یا بعد ساخته شوند از ISA-L استفاده میکنند؛ کلاسترهای ارتقایافته پیشفرض قبلی را نگه میدارند. در کد جاری، osd_pool_default_erasure_code_profile برابر plugin=isa technique=reed_sol_van k=2 m=2 است.
۱۳-۴-۱ ساخت پروفایل و pool#
ceph osd erasure-code-profile ls
ceph osd erasure-code-profile get default
ceph osd erasure-code-profile set ec42 plugin=isa technique=reed_sol_van k=4 m=2 \
     crush-failure-domain=host crush-device-class=hdd
ceph osd pool create ecpool erasure ec42
ceph osd pool set ecpool allow_ec_overwrites true     # برای RBD و CephFS
ceph osd pool application enable ecpool rgwپروفایل یک pool پس از ساخت قابل تغییر نیست: k، m، افزونه و stripe_unit ثابت میمانند. برای تغییر باید pool تازه ساخت و داده را منتقل کرد. پیش از ساخت، رشد آیندهی کلاستر و تعداد دامنههای خرابی را در نظر بگیرید.
۱۳-۴-۲ LRC و CLAY#
# LRC: k=4 داده، m=2 parity سراسری، l=3 → هر ۳ قطعه یک parity محلی
ceph osd erasure-code-profile set lrc42 plugin=lrc k=4 m=2 l=3 crush-failure-domain=host
# CLAY: d تعداد shardهایی که در بازیابی یک shard مشارکت میکنند
ceph osd erasure-code-profile set clay42 plugin=clay k=4 m=2 d=5 crush-failure-domain=hostدر Reed-Solomon معمولی، بازسازی یک shard گمشده نیازمند خواندن k shard کامل است: برای ۸+۳ یعنی هشت برابر حجم دادهی گمشده روی شبکه. LRC با parity محلی این را به اندازهی گروه محلی کاهش میدهد (با هزینهی فضای بیشتر). CLAY هر chunk را به sub-chunkها تقسیم میکند و در بازیابی فقط بخشی از sub-chunkهای هر یک از d کمککننده را میخواند؛ با همان سربار فضای RS، ترافیک بازیابی کمتری دارد اما خواندنها پراکندهترند.
۱۳-۵ کجا EC و کجا تکثیر؟#
| بار | توصیه |
|---|---|
| اشیای RGW بزرگ (آرشیو، پشتیبان، رسانه) | EC؛ بهترین نسبت هزینه |
| pool شاخص bucket و فرادادهی RGW | تکثیری؛ omap در EC پشتیبانی نمیشود |
| RBD برای پایگاه دادهی حساس به تأخیر | تکثیری |
| RBD برای VMهای عمومی یا پشتیبان | EC با FastEC و stripe_unit=16K (Tentacle+) |
| CephFS دادهی آرشیو | pool دادهی دوم EC با layout |
| فرادادهی CephFS و pool دادهی پیشفرض | تکثیری |
RBD روی EC همیشه دو pool دارد: فرادادهی image (header، omap) در pool تکثیری و داده در pool EC با گزینهی --data-pool:
rbd create rbd/vm01 --size 200G --data-pool ecpool
rbd info rbd/vm01 | grep data_pool۱۳-۶ FastEC در Tentacle#
۱۳-۶-۱ چه چیزی تغییر کرد؟#
Tentacle پیادهسازی تازهای از مسیر I/O در EC اضافه کرد که مجموعاً FastEC نامیده میشود: خواندن جزئی (فقط shardهای لازم)، نوشتن جزئی، نوشتن parity delta، حذف padding صفرها و صرفهجویی در فضای اشیای کوچک. با پرچم هر pool فعال میشود:
ceph osd pool set ecpool allow_ec_optimizations true
ceph osd pool get ecpool allow_ec_optimizations
# پیشفرض برای poolهای تازه
ceph config set global osd_pool_default_flag_ec_optimizations trueمحدودیتها طبق مستندات:
- همهی MONها و OSDها باید Tentacle یا جدیدتر باشند؛ کلاینتها نیازی به ارتقا ندارند.
- پرچم پس از فعال شدن خاموششدنی نیست، چون شیوهی ذخیرهی دادهی جدید را تغییر میدهد.
- فقط با ISA-L یا Jerasure با
reed_sol_van کار میکند؛ CLAY، LRC و SHEC رد میشوند. - stripe_unit باید مضرب ۴ کیلوبایت باشد؛ مستندات برای بیشتر بارها ۱۶ کیلوبایت را توصیه میکند و برای بارهای عمدتاً خواندنی تا ۲۵۶ کیلوبایت.
ceph osd erasure-code-profile set ec42fast plugin=isa technique=reed_sol_van k=4 m=2 \
     stripe_unit=16K crush-failure-domain=host
ceph osd pool create rbd-ec erasure ec42fast
ceph osd pool set rbd-ec allow_ec_overwrites true
ceph osd pool set rbd-ec allow_ec_optimizations true۱۳-۷ عیبیابی: خطای ۲۱۴۷۴۸۳۶۴۷#
در خروجی ceph pg dump یا ceph pg map برای pool EC گاهی به جای شمارهی OSD عدد ۲۱۴۷۴۸۳۶۴۷ میبینید. این عدد همان ثابت CRUSH_ITEM_NONE است:
/* from ceph/ceph, LGPL — src/crush/crush.h */
#define CRUSH_ITEM_NONE 0x7fffffffمعنیاش این است که CRUSH نتوانسته برای آن جایگاه shard یک OSD پیدا کند. در pool تکثیری، جایگاه خالی ساده حذف میشود؛ اما در EC جایگاه هر shard معنی دارد (shard 3 باید shard 3 بماند)، پس به جای حذف، با NONE پر میشود. علتهای رایج:
- تعداد دامنههای خرابی کمتر از k+m (مثلاً ۴+۲ با پنج میزبان).
- OSDهای out یا down که دامنهای را خالی کردهاند.
- قانون CRUSH که کلاس دستگاه یا root اشتباهی دارد.
- تعداد تلاشهای CRUSH کم است و در سلسلهمراتب نامتوازن نتیجه نمیگیرد (
set_choose_tries).
ceph pg ls-by-pool ecpool | grep -c 2147483647
ceph osd crush rule dump ecpool
ceph osd getcrushmap -o cm && crushtool -i cm --test --rule <id> --num-rep 6 --show-bad-mappingsاگر --show-bad-mappings خروجی داد ولی تعداد میزبانها کافی است، در قانون EC گام set_choose_tries 100 را بررسی کنید (قانونهایی که با create-erasure ساخته میشوند معمولاً آن را دارند). اگر میزبان کافی ندارید، راه درست افزودن میزبان یا انتخاب k+m کوچکتر است، نه پایین آوردن دامنهی خرابی به osd.
۱۳-۸ درون backend مربوط به EC: نوشتن، rollback و recovery#
این بخش پلی است به فصل ۲۷ («ریاضیات erasure coding»). در اینجا بهجای ریاضیات، مکانیک OSD را بررسی میکنیم: یک نوشتن EC چگونه میان shardها هماهنگ میشود، اگر وسط کار خرابی رخ دهد چه میشود، و recovery دقیقاً چه چیزی را میخواند و مینویسد. کلاسهای مرتبط در src/osd/ شاخهی main عبارتاند از ECBackend، ECCommon، ECTransaction، ECUtil و نسخههای «L» (legacy) آنها، که ECSwitch بر اساس پرچم pool میانشان انتخاب میکند.
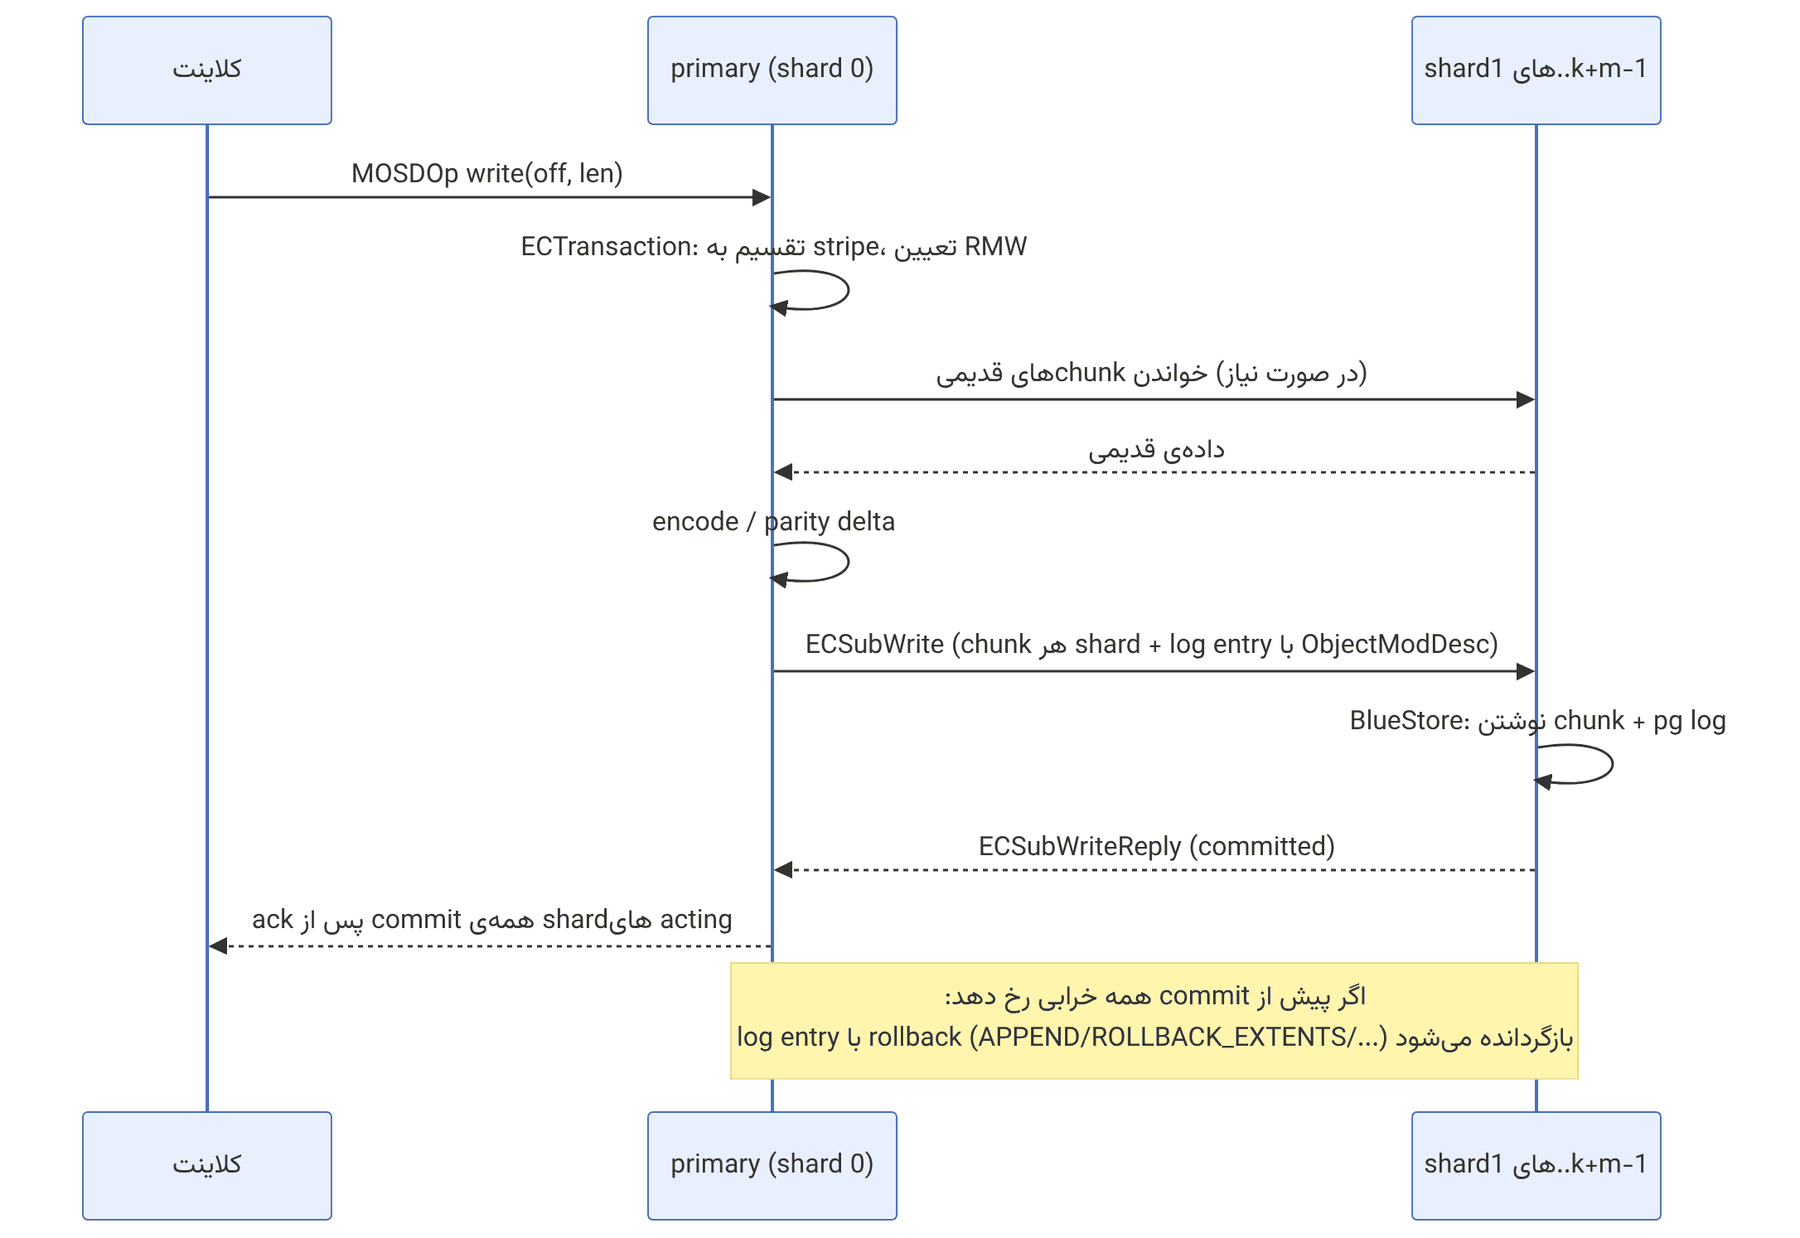
۱۳-۸-۱ چرا EC به rollback نیاز دارد؟#
در replication، هر replica یک کپی کامل است. اگر نوشتنی فقط روی برخی replicaها commit شود، recovery میتواند همان نسخهی جدید را از یک replica به بقیه کپی کند. در EC هیچ shardی کل داده را ندارد. اگر نوشتن روی ۳ shard از ۶ shard commit شده باشد و سپس primary بمیرد، نه نسخهی قدیم و نه نسخهی جدید از هیچ k shard سازگاری قابل بازسازی نیست. راه حل Ceph این است که تغییرات «برگشتپذیر» باشند: هر ورودی pg log در EC یک ObjectModDesc دارد و پس از peering، shardهایی که از نقطهی توافقشده جلوترند، تغییرات را به عقب برمیگردانند.
op در ObjectModDesc::ModID | مقدار | چگونه برمیگردد |
|---|---|---|
| APPEND | ۱ | بریدن (truncate) به اندازهی قبلی |
| SETATTRS | ۲ | بازگرداندن xattrهای قبلی ذخیرهشده |
| DELETE | ۳ | شیء بهجای حذف، به نسخهی موقت stash منتقل شده و برگردانده میشود |
| CREATE | ۴ | حذف شیء تازه |
| UPDATE_SNAPS | ۵ | بازگرداندن snapset قبلی |
| TRY_DELETE | ۶ | حذف اختیاری |
| ROLLBACK_EXTENTS | ۷ | برای overwrite: extentهای قبلی در شیء موقت نگه داشته میشوند |
| EC_OMAP | ۸ | برای omap در EC (در main) |
pg_log_t دو مرز دارد: can_rollback_to (ورودیهای جدیدتر از آن قابل بازگشتاند) و rollback_info_trimmed_to (اطلاعات stash تا آنجا پاک شده است). وقتی primary مطمئن شود یک ورودی روی همهی shardها commit شده، can_rollback_to جلو میرود و دادهی stash (مثلاً extentهای قدیمی ROLLBACK_EXTENTS) میتواند پاک شود. این همان دلیلی است که overwrite در EC قدیمی نسبت به replication فضای موقت و نوشتن اضافه دارد.
هزینهی پنهان ROLLBACK_EXTENTS: برای هر overwrite جزئی، دادهی قدیمی همان بازه باید پیش از بازنویسی در یک شیء موقت (generation) کپی شود تا اگر rollback لازم شد، برگردانده شود. در BlueStore این کپی با clone_range و blob مشترک انجام میشود (فصل ۲۴، shared blob)، پس دادهی واقعی دوباره نوشته نمیشود، ولی فرادادهی اضافه (کلیدهای X و extent map) ایجاد میشود. EC بهینه در Tentacle بخشی از این کار را با انتخاب دقیقتر بازهها کاهش میدهد.
۱۳-۸-۲ min_size پیشفرض و دلیل آن#
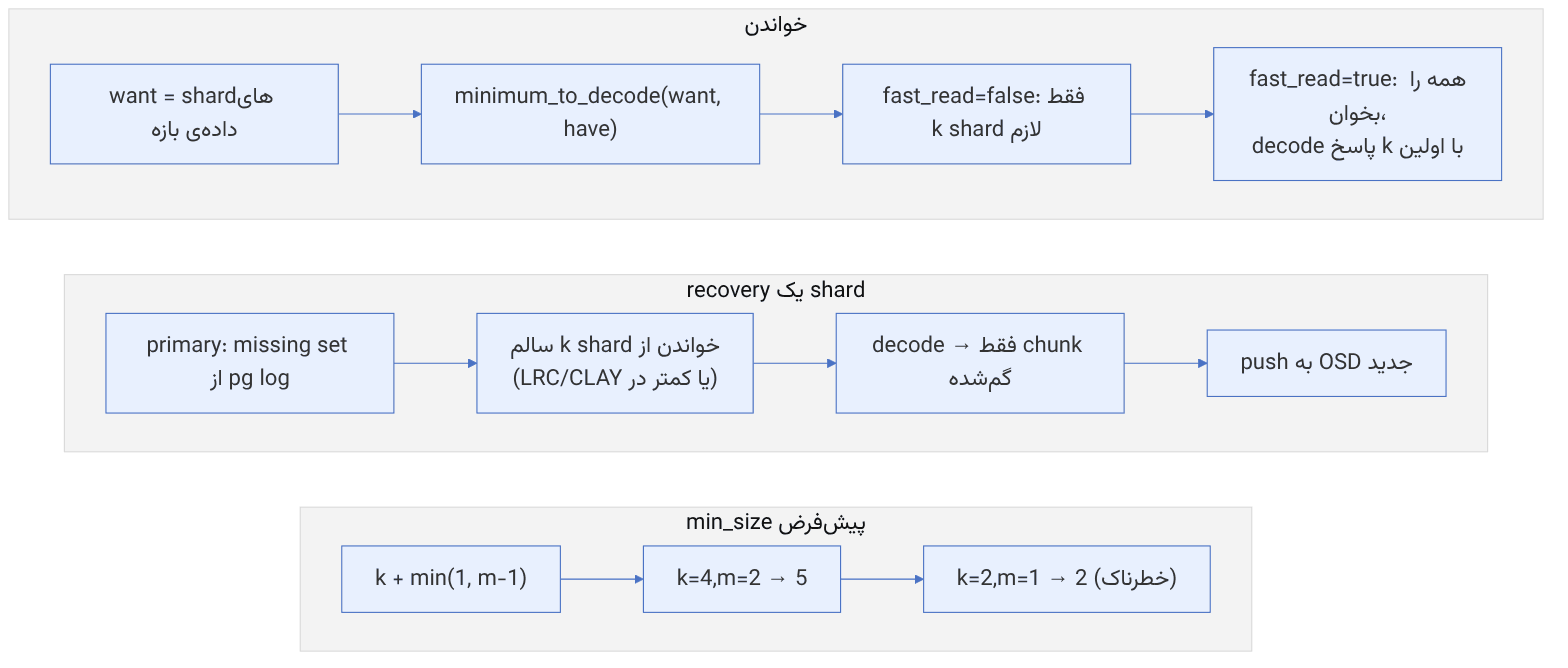
در OSDMonitor::prepare_pool_size، برای poolهای EC مقدار پیشفرض min_size = k + min(1, m − 1) است (و size = num_zones × (k + m)). یعنی برای k=4، m=2 مقدار min_size برابر ۵ است: pool تا وقتی دستکم ۵ shard در دسترس باشد، نوشتن را میپذیرد. بنابراین پس از از دست رفتن یک shard، هنوز یک shard اضافه برای تحمل خرابی بعدی وجود دارد. برای m=1، min_size = k است و هر خرابی دوم در حین recovery یعنی از دست رفتن داده. به همین دلیل m=1 برای دادهی مهم توصیه نمیشود.
| گزینهی pool | اثر |
|---|---|
fast_read | خواندن موازی همهی shardها؛ کاهش tail latency در ازای ترافیک بیشتر |
allow_ec_overwrites | لازم برای RBD و CephFS روی EC؛ فعالسازی RMW و ROLLBACK_EXTENTS |
allow_ec_optimizations (Tentacle به بعد) | backend بهینه؛ برگشتناپذیر (فصل ۲۷) |
min_size | حداقل shardهای در دسترس برای پذیرش I/O |
ceph osd pool set ecpool fast_read 1
ceph pg 5.1as2 query | jq '.info | {last_update, last_complete, log_tail}'   # shard 2 از PG 5.1a
ceph pg 5.1a list_unfound
ceph daemon osd.4 dump_ops_in_flight | jq '.ops[] | select(.description|test("ECSub"))'نام PG در EC پسوند shard دارد: 5.1as2 یعنی shard 2 از PG 5.1a. این پسوند در ceph pg dump و در نام collectionها روی OSD (5.1as2_head) دیده میشود و همان shard_id است که در کلید onode با ۰x80 جمع میشود (فصل ۲۴).
۱۳-۹ کدگذاری پاکشونده با عدد: ماتریس Reed-Solomon، حد MDS، بهروزرسانی دلتای parity و هزینهی بازسازی#
این بخش ریاضیات پشت افزونهی ISA را روی بایتهای واقعی اجرا میکند. ارجاعها به src/erasure-code/isa در main (نوامبر ۲۰۲۶) و به تابع gf_gen_rs_matrix در کتابخانهی ISA-L (erasure_code/ec_base.c) است. حساب با چندجملهای ۰x11d در پایتون بازپیادهسازی و با جدول gff_base در ISA-L تطبیق داده شده است.
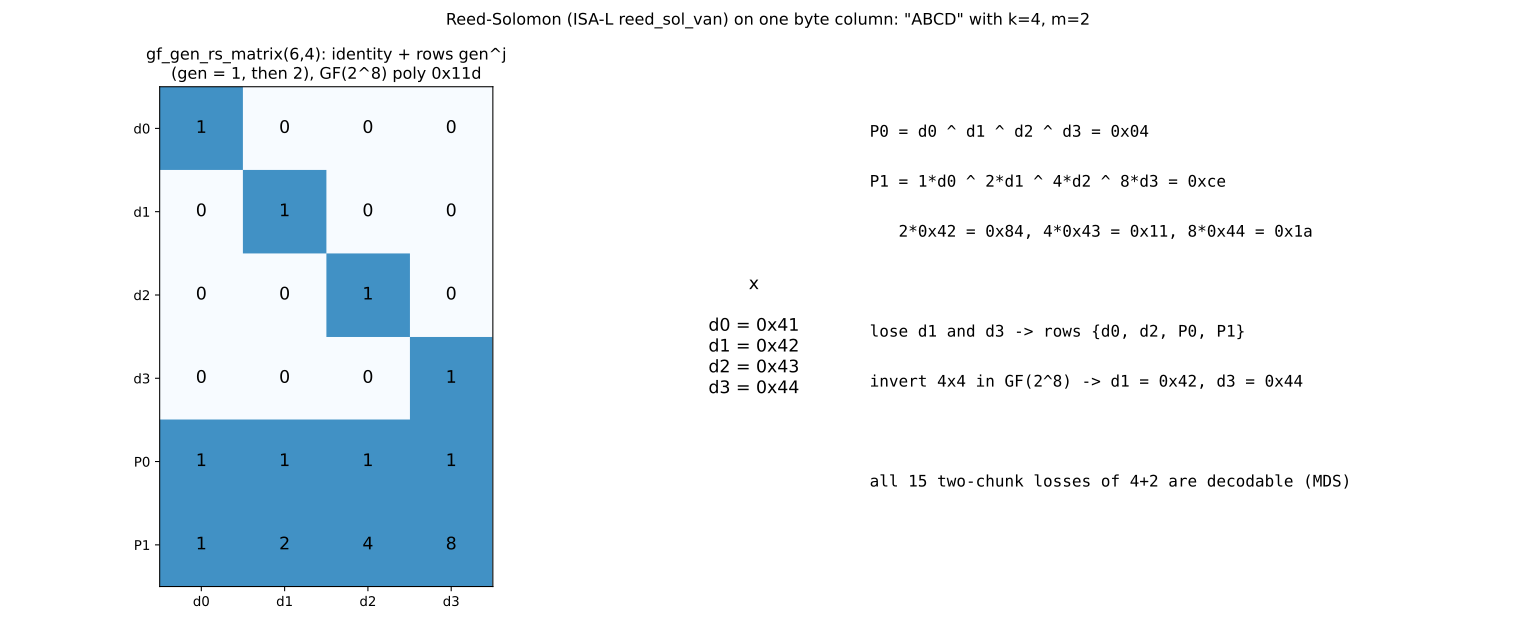
۱۳-۹-۱ کدگذاری و بازگشایی یک ستون بایت#
منبع در کد: src/erasure-code/isa/ErasureCodeIsa.cc :: ErasureCodeIsaDefault::prepare، isa_encode، isa_decode؛ ISA-L ec_base.c :: gf_gen_rs_matrix
پیچیدگی: کدگذاری O(k × m) ضرب GF برای هر بایت؛ بازگشایی O(k³) برای وارون ماتریس (در cache جدولها نگهداری میشود)
pseudocode
G[0..k−1] = I_k # systematic: shardهای داده همان دادهاند
gen = 1
for i in k .. k+m−1: G[i][j] = gen^j ; gen = gen × 2 (در GF(2^8))
parity_i = ⊕_j G[i][j] ⊗ d_j
بازگشایی: k سطر سالم را انتخاب کن ← B ؛ d = B⁻¹ × (shardهای سالم)مثال عددی (k = ۴، m = ۲، بایتهای «ABCD»). سطر P0 همه یک است، پس P0 = ۰x41 ⊕ ۰x42 ⊕ ۰x43 ⊕ ۰x44 = ۰x04. سطر P1 برابر ۱، ۲، ۴ و ۸ است: ۲ ⊗ ۰x42 = ۰x84، ۴ ⊗ ۰x43 = ۰x11 و ۸ ⊗ ۰x44 = ۰x1a، پس P1 = ۰xce. اگر d1 و d3 از دست بروند، سطرهای d0، d2، P0 و P1 یک ماتریس ۴×۴ میسازند که وارون آن ۰x42 و ۰x44 را دوباره میدهد. هر ۱۵ حالت از دست رفتن دو shard در ۴+۲ قابل بازگشایی است.
۱۳-۹-۲ چرا ISA گاهی به Cauchy برمیگردد؟#
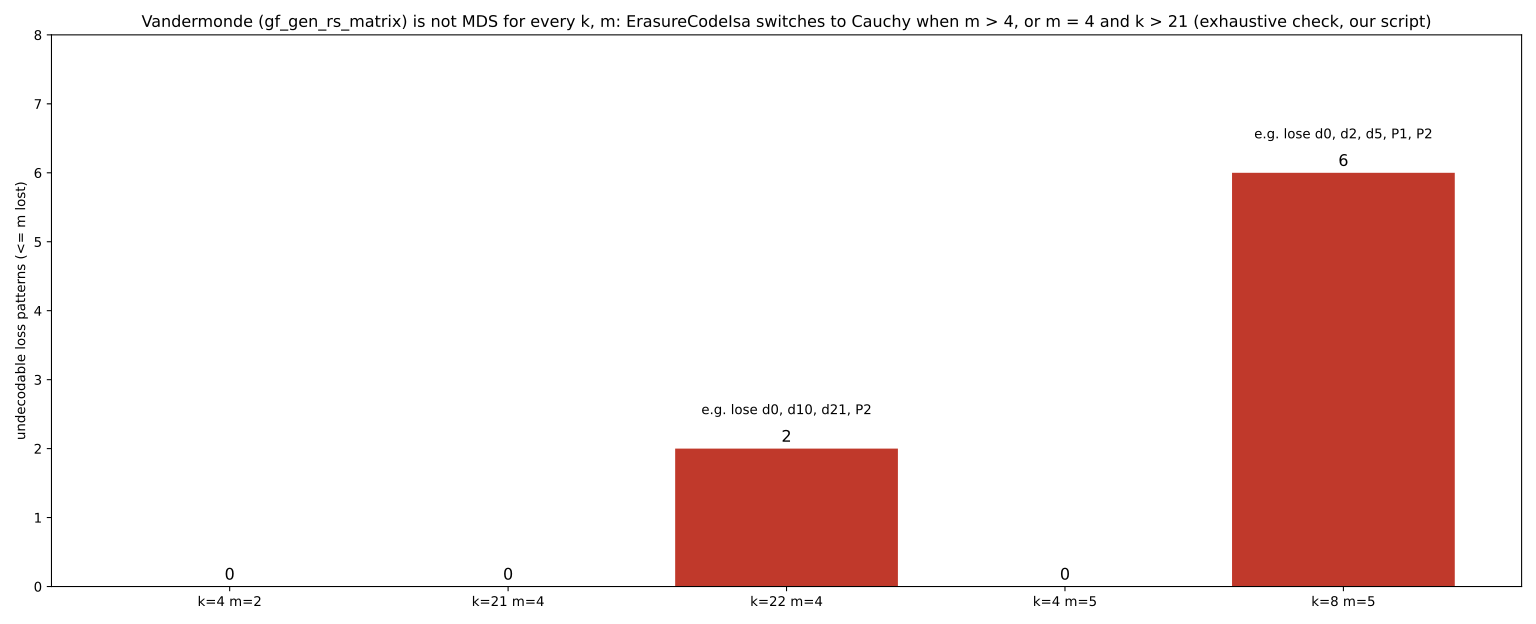
منبع در کد: src/erasure-code/isa/ErasureCodeIsa.cc :: ErasureCodeIsaDefault::parse (m > 4، یا m = 4 و k > 21 ← cauchy)
پیچیدگی: بررسی کامل: Σ C(k,e)·C(m,e) وارون ماتریس
pseudocode
برای هر e از 1 تا m، هر زیرمجموعهی L از e shard داده و P از e سطر parity:
سطرها = (دادههای سالم) ∪ P
if det = 0 در GF(2^8): الگوی L قابل بازگشایی نیست
کد MDS است اگر هیچ الگویی شکست نخوردنتیجهی بررسی کامل ما. برای ۴+۲ و ۲۱+۴ هیچ الگوی شکستی نیست. برای ۲۲+۴ دو الگو وجود دارد، مثلاً از دست رفتن d0، d10، d21 و P2، که با وجود m = ۴ داده را برنمیگرداند. برای ۸+۵ شش الگو هست (مثلاً d0، d2، d5، P1 و P2). برای ۴+۵ مشکلی پیدا نشد. پس قاعدهی کد، یعنی تغییر به Cauchy برای m > ۴ یا m = ۴ با k > ۲۱، دقیقاً همان مرز شکست در m = ۴ است و برای m > ۴ محافظهکارانه عمل میکند. پیام هشدار آن هنگام ساخت پروفایل («switching to Cauchy technique») را جدی بگیرید: technique واقعی pool با چیزی که نوشتهاید فرق میکند.
۱۳-۹-۳ بهروزرسانی دلتای parity#
منبع در کد: src/erasure-code/isa/ErasureCodeIsa.cc :: encode_delta، apply_delta (ec_encode_data_update)؛ src/osd/ECTransaction.cc (do_parity_delta_write)
پیچیدگی: O(m) ضرب GF برای هر بایت تغییرکرده
pseudocode
delta = old_d ⊕ new_d                       # encode_delta
for هر parity i: P_i ⊕= G[i][j] ⊗ delta      # apply_delta؛ برای m=1 فقط XOR
انتخاب در OSD (ec_pdw_write_mode = 0):
    conv = shardهایی که RMW معمولی باید بخواند ؛ pdw = shard تغییرکرده + parityها
    if |pdw| ≥ k: معمولی
    elif pdw بازسازی لازم دارد: معمولی ؛ elif فقط معمولی بازسازی لازم دارد: pdw
    else: pdw اگر |pdw| ≤ |conv|  (تساوی ← pdw)
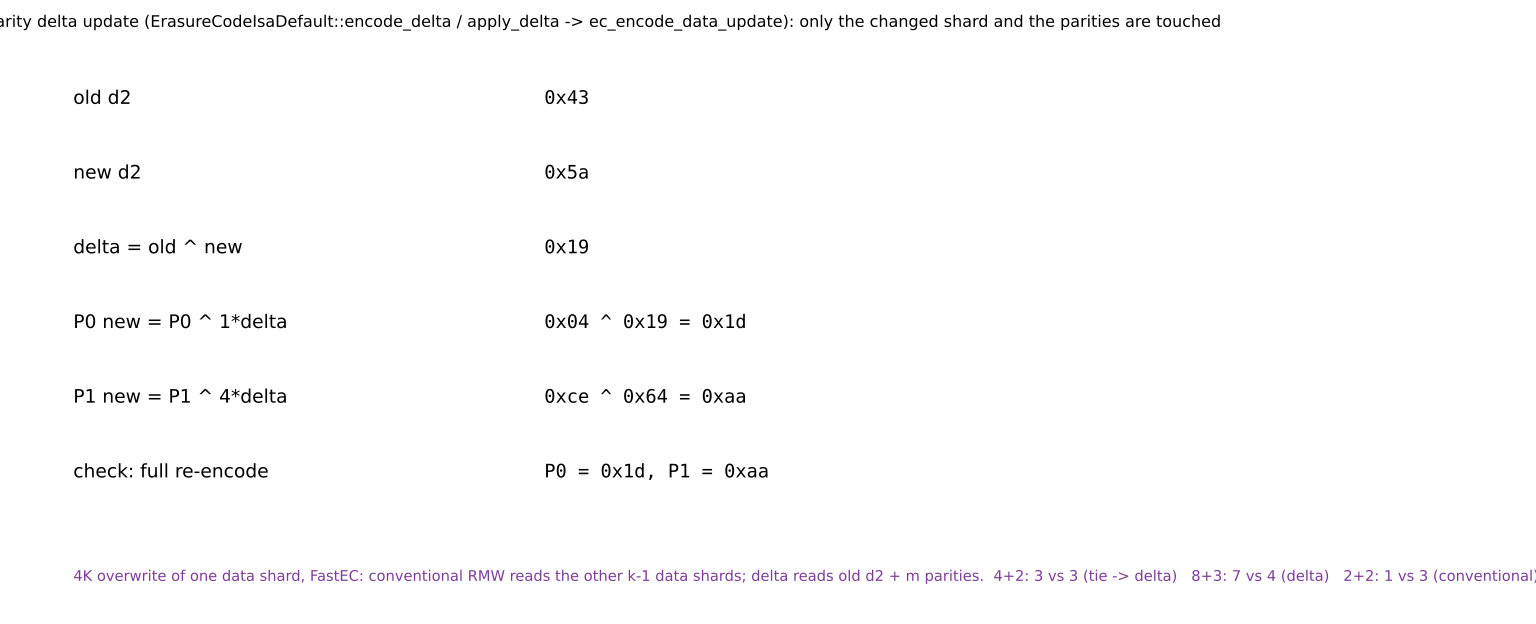
مثال عددی. d2 از ۰x43 به ۰x5a تغییر میکند. delta = ۰x19 است، پس P0 = ۰x04 ⊕ ۰x19 = ۰x1d و P1 = ۰xce ⊕ (۴ ⊗ ۰x19 = ۰x64) = ۰xaa، که همان نتیجهی کدگذاری دوبارهی کامل است. برای بازنویسی ۴K یک shard: در ۴+۲، RMW معمولی سه shard دادهی دیگر را میخواند و PDW شامل d2 قدیمی و دو parity است، یعنی ۳ در برابر ۳. در تساوی PDW انتخاب میشود. در ۸+۳ مقایسه ۷ در برابر ۴ و به نفع PDW است. در ۲+۲ مقایسه ۱ در برابر ۳ است و مسیر معمولی برنده است. این مسیر فقط در pool با FastEC (allow_ec_optimizations، Tentacle به بعد) و افزونهای که پرچم paritydelta دارد (ISA و Jerasure) فعال است.
۱۳-۹-۴ هزینهی بازسازی یک shard: RS، LRC و CLAY#
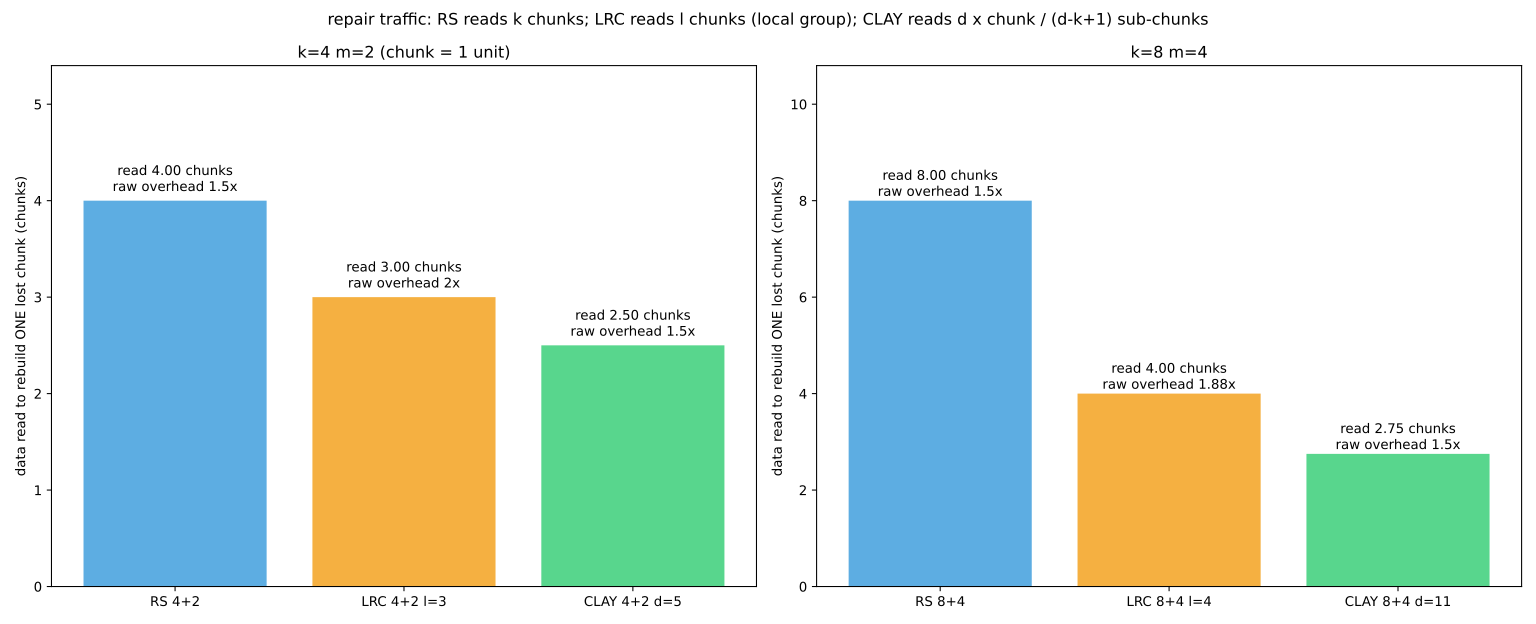
منبع در کد: src/erasure-code/clay/ErasureCodeClay.cc :: parse (q = d − k + 1، t = (k+m+nu)/q، sub_chunk_no = qᵗ)؛ src/erasure-code/lrc
پیچیدگی: O(۱)
pseudocode
RS: read = k chunk
LRC: read = l chunk (گروه محلی) ؛ سربار خام = (k + m + (k+m)/l) / k
CLAY: q = d − k + 1 ؛ هر یک از d کمککننده 1/q از chunk را میفرستد ؛ read = d / q chunk
شرط: k + 1 ≤ d ≤ k + m − 1 ؛ sub-chunkها = q^tمثال عددی. در ۴+۲، بازسازی RS چهار chunk میخواند. LRC با l = ۳ سه chunk میخواند، اما سربار خامش ۲.۰ است، نه ۱.۵. CLAY با d = ۵ (q = ۲، t = ۳ و ۸ sub-chunk) فقط ۲.۵ chunk میخواند و سربار ۱.۵ را حفظ میکند. در ۸+۴، اعداد برای RS، LRC (l = ۴، سربار ۱.۸۷۵) و CLAY (d = ۱۱، q = ۴، ۶۴ sub-chunk) به ترتیب ۸، ۴ و ۲.۷۵ chunk است. هزینهی CLAY در خواندنهای تکهتکه است: هر کمککننده sub-chunkهای پراکنده میفرستد، پس روی HDD تعداد seekها بیشتر میشود.
۱۳-۱۰ از درون کد: EC در OSD#
۱۳-۱۰-۱ نقشهی فایلها#
| مسیر | نقش |
|---|---|
| src/erasure-code/ErasureCodeInterface.h | رابط افزونهها: init، encode، decode، minimum_to_decode، پرچمهای بهینهسازی |
| src/erasure-code/isa, jerasure, lrc, shec, clay | پیادهسازی افزونهها |
| src/osd/ECSwitch.h | سوییچ بین پیادهسازی قدیمی (ECBackendL) و بهینه (ECBackend) |
| src/osd/ECBackend.cc, ECCommon.cc | مسیر خواندن، نوشتن و بازیابی بهینه |
| src/osd/ECTransaction.cc | برنامهریزی نوشتن: تعیین خواندنهای لازم، RMW یا parity delta |
| src/osd/ECUtil.h | stripe_info_t و نگاشت محدودهی منطقی به shardها |
| src/osd/OSDMap.cc | pgtemp_primaryfirst برای انتخاب primary در poolهای بهینه |
۱۳-۱۰-۲ رابط افزونه#
هر افزونه کلاسی است که ErasureCodeInterface را پیاده میکند. توابع کلیدی (امضاها خلاصه شدهاند):
-
init(profile, ss): پارامترهای پروفایل را میخواند و ماتریس را میسازد. -
get_chunk_count() و get_data_chunk_count(): k+m و k. -
minimum_to_decode(want_to_read, available, minimum): کمترین مجموعهی shard برای خواندن خواستهشده. -
encode(want_to_encode, in, encoded) و decode(want_to_read, chunks, decoded). -
get_supported_optimizations(): پرچمهایی که FastEC بر اساس آنها تصمیم میگیرد.
// from ceph/ceph, LGPL — src/erasure-code/ErasureCodeInterface.h (excerpt)
FLAG_EC_PLUGIN_PARTIAL_READ_OPTIMIZATION = 1<<0,
FLAG_EC_PLUGIN_PARTIAL_WRITE_OPTIMIZATION = 1<<1,
FLAG_EC_PLUGIN_ZERO_INPUT_ZERO_OUTPUT_OPTIMIZATION = 1<<2,
FLAG_EC_PLUGIN_ZERO_PADDING_OPTIMIZATION = 1<<3,
FLAG_EC_PLUGIN_PARITY_DELTA_OPTIMIZATION = 1<<4,
این پرچمها توضیح میدهند چرا FastEC فقط با برخی افزونهها کار میکند: هر بهینهسازی به ویژگی ریاضی خاصی نیاز دارد. مثلاً «zero in, zero out» یعنی encode بلوک تمامصفر، parity تمامصفر میدهد (برای کدهای خطی درست است) تا بتوان از نوشتن padding صفر صرفنظر کرد. parity delta به خطی بودن کد تکیه دارد: اگر دادهی shard j از d به d' تغییر کند، parity جدید برابر است با parity قدیم بهعلاوهی G[i][j]⊗(d ⊕ d').
۱۳-۱۰-۳ ECSwitch: گذار تدریجی#
کامنت ابتدای ECSwitch.h صریح است: این کلاس «سوییچر موقت» بین پیادهسازی legacy و optimized است تا وقتی پیادهسازی جدید به اندازهی کافی مورد اعتماد شود. ECSwitch هر دو شیء ECLegacy::ECBackendL legacy و ECBackend optimized را دارد و بر اساس پرچم pool (allow_ec_optimizations) درخواستها را به یکی هدایت میکند. به همین دلیل پرچم برگشتپذیر نیست: پس از نوشتن داده با قالب جدید، پیادهسازی قدیمی نمیتواند آن را بخواند.
۱۳-۱۰-۴ تصمیم RMW یا parity delta#
در ECTransaction.cc برای هر نوشتن، طرح (plan) ساخته میشود. منطق انتخاب، سادهشده:
// from ceph/ceph, LGPL — src/osd/ECTransaction.cc (excerpt, simplified indentation)
if (sinfo.supports_parity_delta_writes() && !object_in_cache &&
    orig_size == projected_size && !reads.empty() && !op.truncate) {
  ...
  if (pdw_write_mode != 0) {
    do_parity_delta_write = (pdw_write_mode == 2);
  } else if (pdw_read_shards.size() >= sinfo.get_k()) {
    do_parity_delta_write = false;
  } else if (!shard_id_set::difference(pdw_read_shards, readable_shards).empty()) {
    do_parity_delta_write = false;
  } else if (!shard_id_set::difference(read_shards, readable_shards).empty()) {
    do_parity_delta_write = true;
  } else {
    do_parity_delta_write = pdw_read_shards.size() <= read_shards.size();
  }
}
خوانش: parity delta فقط وقتی معنا دارد که اندازهی شیء تغییر نکند، truncate نباشد و داده در cache نباشد. اگر parity delta نیازمند k خواندن یا بیشتر باشد، مزیتی ندارد؛ اگر برای parity delta بازسازی لازم باشد، کنار گذاشته میشود؛ اگر برای RMW معمولی بازسازی لازم باشد ولی برای parity delta نه، parity delta انتخاب میشود؛ در غیر این صورت روشی که خواندن کمتری دارد (با ترجیح parity delta در تساوی). متغیر pdw_write_mode اجازه میدهد برای آزمایش یکی از دو روش را اجبار کرد.
۱۳-۱۰-۵ چرا shard 0 همیشه primary نیست؟#
در poolهای بهینه، برخی shardهای داده در هر I/O بهروز نمیشوند (نوشتن جزئی فقط shard تغییرکرده و parityها را لمس میکند). چنین shardی نمیتواند primary شود، چون primary باید log کامل PG را داشته باشد. اما منطق انتخاب primary در OSDMap را نمیتوان تغییر داد بدون اینکه کلاینتها ارتقا یابند. راهحل OSDMap::pgtemp_primaryfirst(): OSDMonitor هنگام تنظیم pg_temp ترتیب را طوری عوض میکند که shardهای مجاز primary اول بیایند.
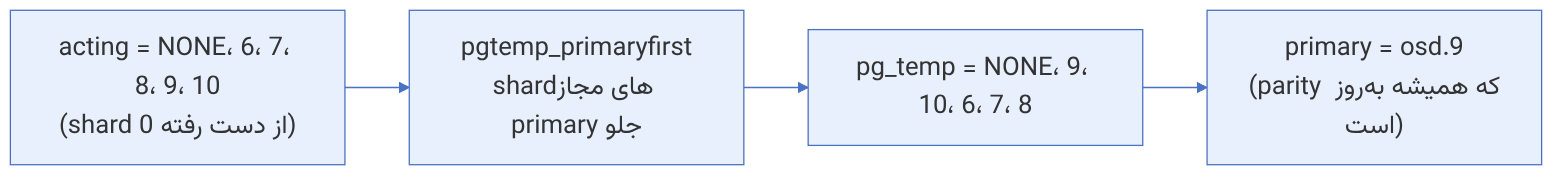
// from ceph/ceph, LGPL — src/osd/OSDMap.cc (comment excerpt)
 * Example: Optimized EC pool 4+2
 * acting_set = {NONE, 6, 7, 8, 9, 10}
 * non_primary_shards = {1, 2, 3} # data shards other than shard 0
 * pg_temp = {NONE, 9, 10, 6, 7, 8} # non-primary shards at end
 * primary will be OSD 9(1)
۱۳-۱۰-۶ شبهکد خواندن تخریبشده#
read(obj, off, len):
want = shards_covering(off, len) # ECUtil: محدودهی منطقی → shard extents
avail = shards_up_and_not_missing(obj)
if want ⊆ avail: # خواندن جزئی (FastEC)
return gather(want)
need = ec_impl.minimum_to_decode(want, avail) # k shard
chunks = gather(need)
return ec_impl.decode(want, chunks)[off:len]- EC به دامنههای خرابی کافی نیاز دارد: دستکم k+m، ترجیحاً k+m+1.
- پروفایل تغییرناپذیر است؛ از ابتدا درست انتخاب کنید.
- poolهای تازه: ISA-L؛ در Tentacle+ با FastEC و stripe_unit=16K برای RBD/CephFS.
- فراداده، omap و شاخص bucketها روی pool تکثیری.
- ۲۱۴۷۴۸۳۶۴۷ یعنی CRUSH جایگاه shard را پر نکرده؛
crushtool --test را اجرا کنید. - بازیابی EC پرهزینه است؛ LRC یا CLAY را برای کلاسترهای بزرگ بررسی کنید.
۱۳-۱۱ تکمیلی و بهروز#
- Luminous:
allow_ec_overwrites و پشتیبانی RBD و CephFS روی EC. - Tentacle: FastEC با
allow_ec_optimizations؛ ISA-L پیشفرض کلاسترهای تازه؛ رفع اشکالهای برنامهریزی truncate+write. - Squid: قانون CRUSH نوع MSR برای پیکربندیهای انعطافپذیرتر EC.
- کد جاری:
osd_pool_default_flag_ec_optimizations=false (FastEC برای poolهای تازه خودکار روشن نیست).
۱۳-۱۲ تمرین عملی#
- ۱. پروفایلهای ۲+۱، ۴+۲ و ۸+۳ را بسازید و با
ceph osd erasure-code-profile get مقایسه کنید. کدام روی کلاستر شما قابل اجراست؟ - ۲. یک pool 4+2 بسازید، شیئی بنویسید و با
ceph osd map ببینید هر shard روی کدام OSD است. یک OSD را متوقف کنید و شیء را بخوانید. - ۳. pool EC را بهعنوان data-pool یک image RBD استفاده کنید و با fio نوشتن تصادفی ۴ کیلوبایتی را با pool تکثیری مقایسه کنید.
- ۴. در کلاستر Tentacle آزمایشی، همان آزمایش را با
allow_ec_optimizations و stripe_unit=16K تکرار کنید. - ۵. pool 4+2 را روی کلاستری با پنج میزبان بسازید و ۲۱۴۷۴۸۳۶۴۷ را در
ceph pg dump مشاهده کنید؛ سپس با crushtool --test تأیید کنید. - ۶. در کد، تابع
pgtemp_primaryfirst را بخوانید و با مثال خودتان (۸+۳) خروجی را پیشبینی کنید.
۱۳-۱۳ پرسشهای مرور#
- ۱. سربار و تحمل خرابی EC 8+3 در مقایسه با تکثیر سهتایی چیست؟
- ۲. چرا هر زیرماتریس k×k ماتریس مولد باید وارونپذیر باشد؟
- ۳. تفاوت shard در EC و نسخه در تکثیر چیست؟
- ۴. چرا نوشتن کوچک در EC قدیمی پرهزینه بود؟
- ۵. parity delta بر چه ویژگی ریاضی تکیه دارد؟
- ۶. محدودیتهای فعالسازی FastEC کداماند؟
- ۷. چرا پرچم allow_ec_optimizations برگشتپذیر نیست؟
- ۸. CLAY و LRC چطور ترافیک بازیابی را کاهش میدهند؟
- ۹. عدد ۲۱۴۷۴۸۳۶۴۷ در نگاشت PG چه معنایی دارد و علتهای رایج آن کداماند؟
- ۱۰. چرا در pool بهینه، primary همیشه shard 0 نیست؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۳-۱۴ منابع این فصل#
- Erasure code
https://docs.ceph.com/en/latest/rados/operations/erasure-code/ - Erasure code profiles
https://docs.ceph.com/en/latest/rados/operations/erasure-code-profile/ - ISA plugin
https://docs.ceph.com/en/latest/rados/operations/erasure-code-isa/ - LRC plugin
https://docs.ceph.com/en/latest/rados/operations/erasure-code-lrc/ - CLAY plugin
https://docs.ceph.com/en/latest/rados/operations/erasure-code-clay/ - SHEC plugin
https://docs.ceph.com/en/latest/rados/operations/erasure-code-shec/ - Tentacle release notes
https://docs.ceph.com/en/latest/releases/tentacle/ - Source: src/erasure-code
https://github.com/ceph/ceph/tree/main/src/erasure-code - Source: src/osd/ECTransaction.cc, ECSwitch.h, OSDMap.cc
https://github.com/ceph/ceph/tree/main/src/osd - Intel ISA-L
https://github.com/intel/isa-l - Plank, "A Tutorial on Reed-Solomon Coding for Fault-Tolerance in RAID-like Systems"
https://web.eecs.utk.edu/~jplank/plank/papers/CS-96-332.pdf