سنجش کارایی و ابزارهای کارشناسی Ceph
حوصله ندارم این فصل در چند خط
- لایهبهلایه بسنجید: دیسکها با fio، شبکه، سپس RADOS، RBD، RGW و CephFS تا بدانید عدد ناامیدکننده از کجا میآید.
-
ceph tell osd.N bench فقط BlueStore یک OSD را بدون شبکه و تکثیر میسنجد و rados bench کل مسیر کلاستر را؛ این دو قابل مقایسه نیستند. - موتور rbd در fio، ابزار warp برای S3 و admin socket (
perf dump و dump_historic_ops) ابزارهای اصلی اپراتورند. - گزارش بنچمارک بدون سختافزار، نسخهها، تنظیمات، مدت آزمون و صدکها بیارزش است.
۱۰-۱ پیش از شروع#
۱۰-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
«کلاستر ما چقدر سریع است؟» سؤالی است که هر تیم Ceph بالاخره با آن روبهرو میشود، و جواب درست آن تقریباً هیچوقت یک عدد نیست. این فصل روش سنجش کارایی را از پایینترین لایه (دیسک و شبکه) تا رابطها آموزش میدهد و سپس به جعبهابزار اپراتور کارشناس میپردازد: admin socket، ceph tell، API مدیریتی، پروفایل حافظه و ceph-objectstore-tool. سرفصل قدیمی چند ابزار را هم داشت که امروز کنار رفتهاند (ceph-medic، ماژول restful، BlueStore «آزمایشی»)؛ وضعیت آنها را هم روشن میکنیم.
- چرا باید سنجش را لایهبهلایه انجام داد؟
- خط پایهی دیسک و شبکه را چطور بگیریم؟
-
rados bench، rbd bench و fio را چطور درست اجرا و تفسیر کنیم؟ - admin socket و
ceph tell چه تفاوتی دارند و چه اطلاعاتی میدهند؟ - مصرف حافظهی daemonها را چطور بررسی کنیم؟
-
ceph-objectstore-tool چه زمانی ابزار نجات است و چه زمانی خطرناک؟
۱۰-۲ روش سنجش لایهای#
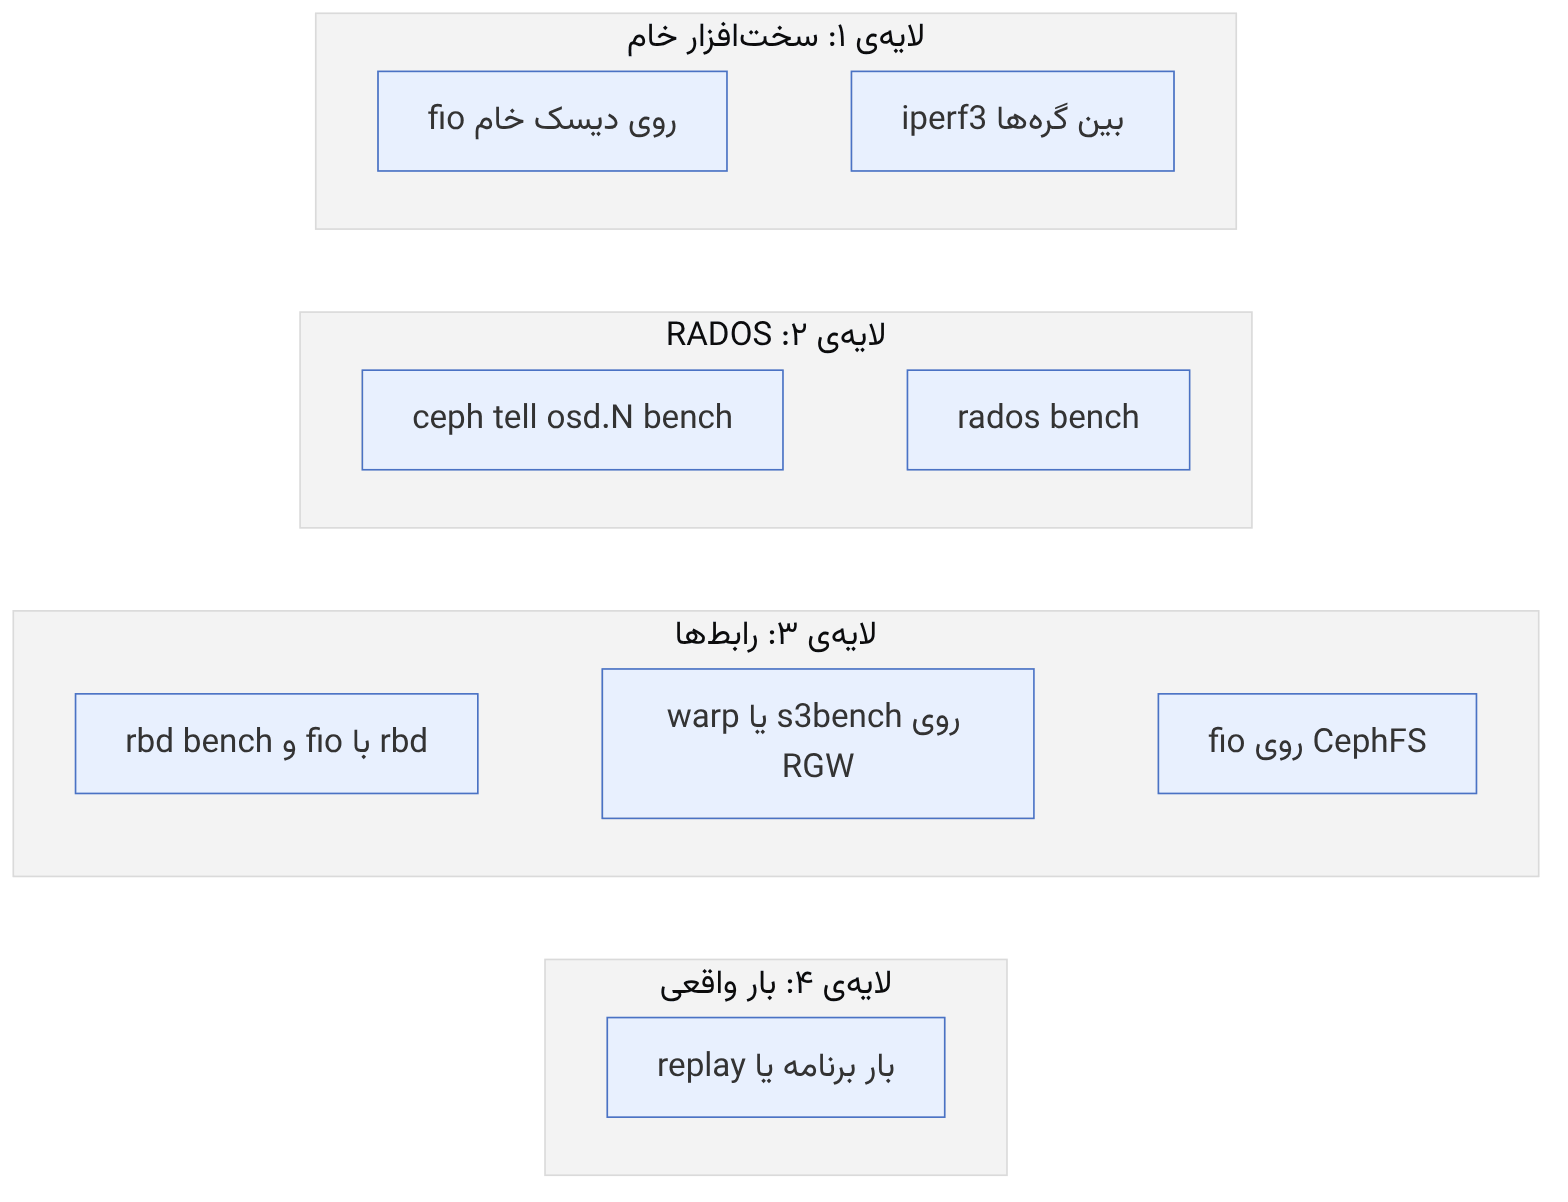
اگر rbd bench عدد ناامیدکنندهای بدهد، نمیدانید مشکل از دیسک است، از شبکه، از پیکربندی OSD یا از کلاینت. اما اگر بدانید هر دیسک چند IOPS میدهد و شبکه چند گیگابیت، میتوانید سقف نظری را حساب کنید و ببینید کجا فاصله ایجاد شده است. قاعدهی کلی:
- ۱. سقف هر دیسک و هر لینک شبکه را جداگانه اندازه بگیرید.
- ۲. سقف نظری کلاستر را حساب کنید (با در نظر گرفتن ضریب تکثیر یا EC).
- ۳. RADOS را مستقیم بسنجید.
- ۴. رابطها (RBD، RGW، CephFS) را بسنجید.
- ۵. بار واقعی برنامه را آزمایش کنید.
هرگز بنچمارک خواندن را بلافاصله پس از نوشتن همان داده تفسیر نکنید: cache صفحهی سیستمعامل کلاینت، cache کلاینت RBD و cache BlueStore عددها را غیرواقعی میکنند. روی کلاستری که دادهی production دارد هم بنچمارک سنگین اجرا نکنید؛ بنچمارک نوشتن میتواند تأخیر همهی مستأجران را بالا ببرد.
۱۰-۳ خط پایهی سختافزار#
۱۰-۳-۱ دیسک#
ابزار درست برای سنجش دیسک fio است؛ dd فقط یک الگوی سادهی ترتیبی را میسنجد و عمق صف را کنترل نمیکند. آزمایشهای زیر را روی دیسکی انجام دهید که هنوز OSD نشده است، چون نوشتن مستقیم روی دیسک خام دادهی آن را نابود میکند.
# نوشتن ترتیبی بلوک بزرگ (توان)
sudo fio --name=seqwrite --filename=/dev/sdX --rw=write --bs=4M --direct=1 \
  --ioengine=libaio --iodepth=16 --runtime=60 --time_based --group_reporting
# نوشتن تصادفی بلوک کوچک با sync (نزدیک به رفتار WAL)
sudo fio --name=syncwrite --filename=/dev/sdX --rw=randwrite --bs=4k --direct=1 \
  --sync=1 --ioengine=libaio --iodepth=1 --numjobs=1 --runtime=60 --time_based
# خواندن تصادفی
sudo fio --name=randread --filename=/dev/sdX --rw=randread --bs=4k --direct=1 \
--ioengine=libaio --iodepth=32 --runtime=60 --time_basedآزمایش دوم (نوشتن ۴ کیلوبایتی با sync و عمق صف ۱) مهمترین آزمایش برای SSDهایی است که قرار است DB/WAL یا OSD باشند. SSDهای مصرفی بدون حفاظت در برابر قطع برق (PLP) در این آزمایش گاهی فقط چند صد IOPS میدهند، در حالی که SSDهای دیتاسنتری با PLP دهها هزار IOPS. علتش این است که SSD بدون PLP باید هر نوشتن sync را واقعاً روی NAND ببرد. این تفاوت مستقیماً در تأخیر نوشتن Ceph دیده میشود.
۱۰-۳-۲ اجرای همزمان روی چند دیسک#
برای پیدا کردن گلوگاه کنترلر یا گذرگاه، همان آزمایش را همزمان روی همهی دیسکهای یک گره اجرا کنید و مجموع را با حاصلضرب تعداد دیسک در عدد تکدیسک مقایسه کنید. اگر مجموع بسیار کمتر است، کنترلر HBA، expander یا PCIe گلوگاه است.
sudo fio --rw=write --bs=4M --direct=1 --ioengine=libaio --iodepth=16 --runtime=60 --time_based --group_reporting \
  --name=d1 --filename=/dev/sdb --name=d2 --filename=/dev/sdc --name=d3 --filename=/dev/sdd
۱۰-۳-۳ شبکه#
# روی گره ۱
iperf3 -s
# روی گره ۲: چند جریان موازی، چون یک جریان TCP معمولاً لینک ۲۵ یا ۱۰۰ گیگابیتی را پر نمیکند
iperf3 -c ceph-node1 -P 8 -t 30
# بررسی MTU و jumbo frame از سر تا سر
ping -M do -s 8972 -c 3 ceph-node1MTU ناهماهنگ (مثلاً ۹۰۰۰ روی گرهها و ۱۵۰۰ روی یک سوئیچ) یکی از رایجترین علتهای رفتار عجیب Ceph است: heartbeatهای کوچک رد میشوند و OSDها up به نظر میرسند، اما پیامهای بزرگ گم میشوند و عملیات کند یا معلق میشود. آزمایش ping -M do را بین همهی جفت گرهها و در هر دو شبکهی public و cluster اجرا کنید.
۱۰-۳-۴ سقف نظری#
با اعداد خط پایه میتوانید سقف تقریبی را حساب کنید. مثلاً با ۶ گره، هر کدام ۱۰ SSD که هرکدام ۱.۵ گیگابایت بر ثانیه نوشتن ترتیبی دارند، و شبکهی ۲۵ گیگابیتی (حدود ۳ گیگابایت بر ثانیه) در هر گره:
- دیسکها: ۶ × ۱۰ × ۱.۵ = ۹۰ گیگابایت بر ثانیه نوشتن خام.
- با تکثیر سهتایی، هر بایت کاربر سه بار نوشته میشود: حدود ۳۰ گیگابایت بر ثانیه.
- اما شبکهی هر گره فقط ۳ گیگابایت بر ثانیه است و هر بایت ورودی دو بار دیگر روی شبکه به ثانویهها میرود؛ پس شبکه گلوگاه است و سقف واقعی بسیار پایینتر از ۳۰ است.
این نوع محاسبه نشان میدهد سرمایهگذاری بعدی باید روی شبکه باشد، نه دیسک.
۱۰-۴ سنجش RADOS#
۱۰-۴-۱ بنچمارک OSD منفرد#
هر OSD یک بنچمارک داخلی دارد که مستقیماً روی BlueStore همان OSD مینویسد (بدون شبکه و تکثیر). برای پیدا کردن OSDهای کند در میان صدها OSD مفید است:
ceph tell osd.0 bench # پیشفرض: ۱ گیگابایت با بلوک ۴ مگابایتی
ceph tell osd.0 bench 12288000 4096 4194304 100 # کل بایت، اندازهی بلوک، اندازهی شیء، تعداد اشیا
for i in $(ceph osd ls); do echo -n "osd.$i "; ceph tell osd.$i bench -f json | jq -r .bytes_per_sec; done | sort -nk2 | head۱۰-۴-۲ rados bench#
rados bench بار را مستقیماً روی یک pool میفرستد و مسیر کامل RADOS (شبکه، تکثیر، commit) را میسنجد. pool جداگانه بسازید تا دادهی آزمایشی با دادهی واقعی مخلوط نشود:
ceph osd pool create benchpool 128 128
ceph osd pool application enable benchpool rados-bench --yes-i-really-mean-it
rados bench -p benchpool 60 write -b 4M -t 16 --no-cleanup
rados bench -p benchpool 60 seq -t 16
rados bench -p benchpool 60 rand -t 16
rados bench -p benchpool 60 write -b 4K -t 64 --no-cleanup     # IOPS بلوک کوچک
rados -p benchpool cleanupنتیجهی rados bench شامل میانگین توان، IOPS و تأخیر (میانگین، حداکثر و انحراف معیار) است. انحراف معیار بالای تأخیر یا «حداکثر» خیلی بزرگ نشانهی یک یا چند OSD کند است، حتی اگر میانگین خوب به نظر برسد. خواندن ترتیبی و تصادفی باید از همان میزبانی اجرا شوند که نوشتن را انجام داده است، چون نام اشیا شامل نام میزبان است. برای شبیهسازی چند کلاینت، چند نمونه را همزمان از چند میزبان با --run-name متفاوت اجرا کنید.
rados load-gen که در منابع قدیمی آمده است، در صفحهی راهنمای جاری rados دیده نمیشود. برای بارهای ترکیبی امروز از fio با موتور rados یا rbd استفاده کنید که کنترل بسیار بیشتری روی الگوی بار میدهد.
۱۰-۵ سنجش RBD#
۱۰-۵-۱ rbd bench#
rbd create rbd/benchimg --size 100G
rbd bench --io-type write --io-size 4K --io-threads 32 --io-total 10G --io-pattern rand rbd/benchimg
rbd bench --io-type read --io-size 4K --io-threads 32 --io-total 10G --io-pattern rand rbd/benchimg
rbd bench --io-type readwrite --rw-mix-read 70 --io-size 16K --io-pattern rand rbd/benchimg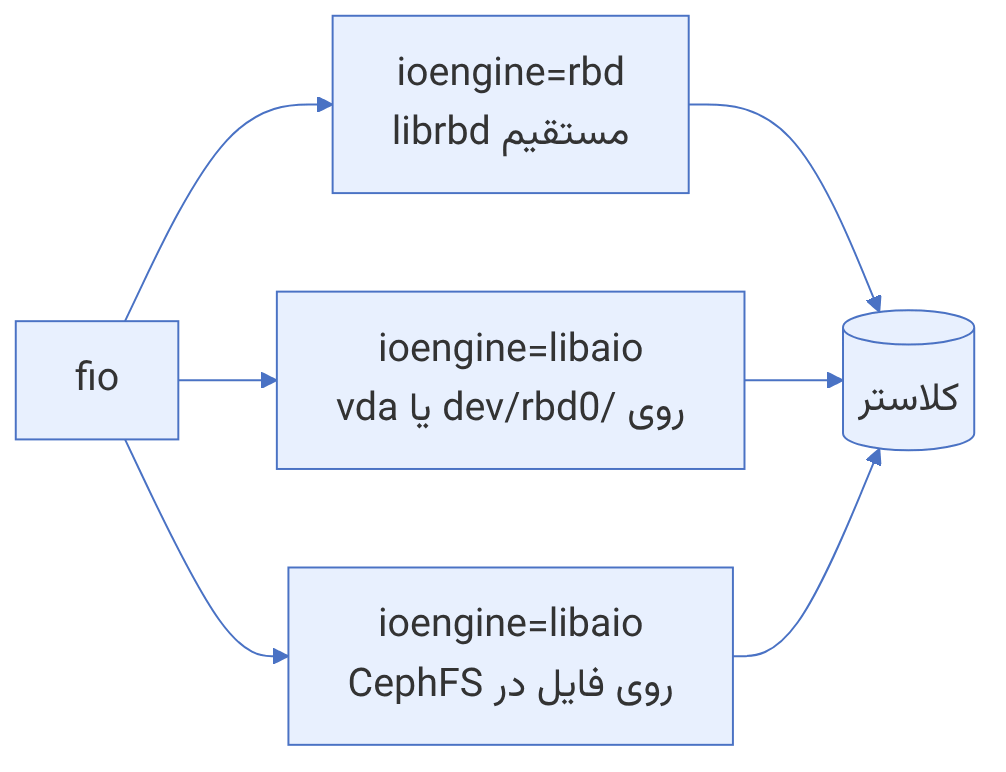
۱۰-۵-۲ fio با موتور rbd#
fio موتور rbd دارد که مستقیماً از librbd استفاده میکند؛ بدون نیاز به rbd map یا ماشین مجازی. این روش برای مقایسهی پیکربندیها ایدهآل است:
# rbd-randwrite.fio
[global]
ioengine=rbd
clientname=admin
pool=rbd
rbdname=benchimg
direct=1
time_based=1
runtime=120
ramp_time=15
group_reporting=1

[randwrite-4k]
rw=randwrite
bs=4k
iodepth=32
numjobs=4

[randread-4k]
stonewall
rw=randread
bs=4k
iodepth=32
numjobs=4fio rbd-randwrite.fio --output-format=json > result.json
jq '.jobs[] | {name: .jobname, write_iops: .write.iops, read_iops: .read.iops, p99_us: (.write.clat_ns.percentile."99.000000" // .read.clat_ns.percentile."99.000000")/1000}' result.jsonبرای سنجش نزدیک به واقعیت، fio را درون یک ماشین مجازی روی دیسک RBD همان ماشین هم اجرا کنید. تفاوت بین fio با موتور rbd و fio درون VM، سربار لایهی مجازیسازی (virtio، QEMU، cache) را نشان میدهد. همیشه صدک ۹۹ و ۹۹.۹ تأخیر را گزارش کنید، نه فقط میانگین IOPS؛ پایگاههای داده به دم توزیع تأخیر حساساند.
۱۰-۵-۳ پیشگرم کردن image#
اولین نوشتن روی هر بخش از image تازه کندتر است، چون اشیای RADOS باید ساخته شوند. پیش از سنجش نوشتن تصادفی، image را یک بار با نوشتن ترتیبی کامل پر کنید؛ در غیر این صورت عدد اندازهگیریشده ترکیبی از «ساخت شیء» و «بازنویسی» است.
۱۰-۶ جعبهابزار اپراتور#
۱۰-۶-۱ admin socket و ceph tell#
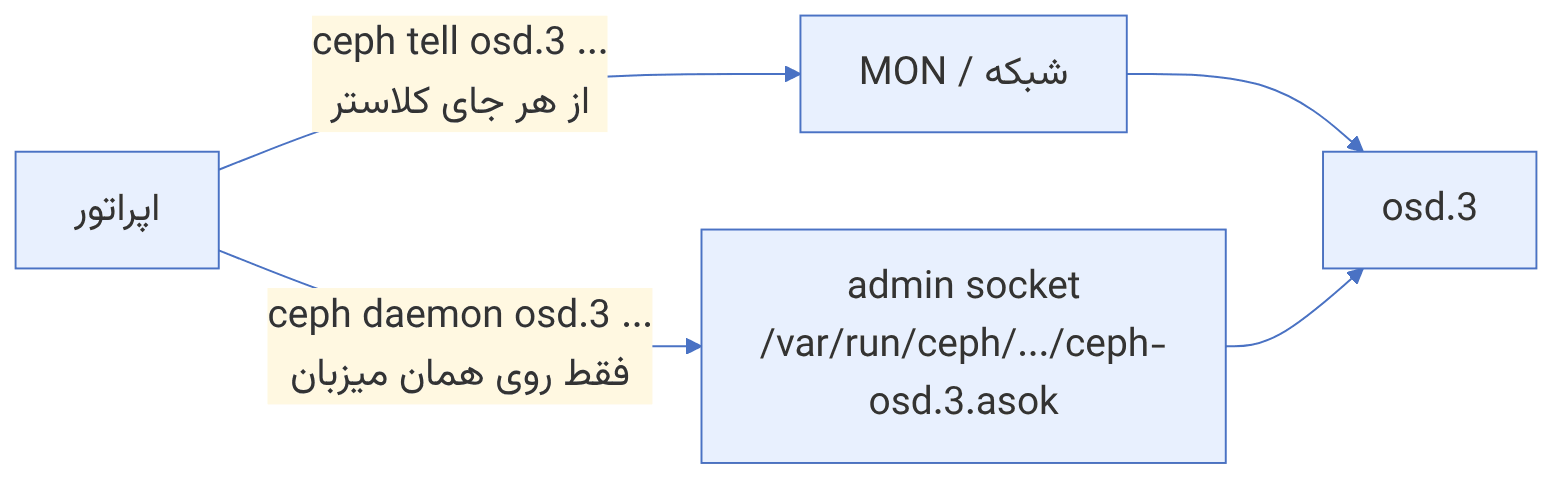
هر daemon یک admin socket (فایل سوکت یونیکس) دارد که دستورهای تشخیصی را بدون نیاز به MON یا شبکه پاسخ میدهد. در cephadm، سوکتها زیر /var/run/ceph/<fsid>/ قرار دارند و سادهترین راه استفاده، cephadm shell --name است:
cephadm shell --name osd.3 -- ceph daemon osd.3 help
cephadm shell --name osd.3 -- ceph daemon osd.3 dump_ops_in_flight
cephadm shell --name osd.3 -- ceph daemon osd.3 dump_historic_ops
cephadm shell --name osd.3 -- ceph daemon osd.3 perf dump bluestore
cephadm shell --name osd.3 -- ceph daemon osd.3 config diff
بسیاری از همین دستورها با ceph tell از هر جای کلاستر هم در دسترساند:
ceph tell osd.3 dump_ops_in_flight
ceph tell osd.3 dump_historic_slow_ops
ceph tell osd.* version
ceph tell mon.* sessions | jq length
ceph tell mds.fs01:0 perf dump| دستور | کاربرد |
|---|---|
| dump_ops_in_flight | عملیات در جریان؛ اولین ابزار برای slow ops |
| dump_historic_ops, dump_historic_slow_ops | عملیات کند اخیر با زمان هر مرحله |
| perf dump | شمارندههای داخلی (BlueStore، RocksDB، messenger و ...) |
| config diff | تنظیماتی که با پیشفرض فرق دارند |
| dump_mempools | مصرف حافظه به تفکیک بخشها |
| status | خلاصهی وضعیت daemon |
در خروجی dump_historic_slow_ops، هر عملیات فهرستی از رویدادها با زمان دارد (مثل queued_for_pg، reached_pg، sub_op_committed). فاصلهی بزرگ بین دو رویداد نشان میدهد عملیات کجا معطل شده است: انتظار در صف PG (معمولاً قفل یا PG شلوغ)، انتظار برای ثانویهها (OSD یا شبکهی کند دیگر) یا commit محلی (دیسک کند).
۱۰-۶-۲ API مدیریتی#
در گذشته «Ceph REST API» بر اساس ماژول restful ارائه میشد. این ماژول در Tentacle حذف شد. برای خودکارسازی امروز دو راه دارید:
- API Dashboard برای عملیات مدیریتی (فصل ۹)، با احراز هویت JWT و نسخهدار.
- کتابخانههای librados (پایتون، C، Go و ...) برای دسترسی برنامهنویسی به RADOS و حتی ارسال دستورهای MON (فصل ۱۴).
import rados, json
cluster = rados.Rados(conffile='/etc/ceph/ceph.conf', name='client.monitor')
cluster.connect()
ret, out, err = cluster.mon_command(json.dumps({"prefix": "df", "format": "json"}), b'')
stats = json.loads(out)["stats"]
print(stats["total_bytes"], stats["total_used_raw_bytes"])
cluster.shutdown()۱۰-۷ سنجش RGW و CephFS#
۱۰-۷-۱ ذخیرهسازی شیء#
برای RGW، ابزار عمومی و متنباز رایج warp است (از پروژهی MinIO) که هر سرویس سازگار با S3 را میسنجد. پیش از اجرا یک کاربر و bucket جدا برای آزمایش بسازید:
radosgw-admin user create --uid=bench --display-name="Benchmark user"
# کلیدها را از خروجی بردارید و در متغیرهای محیطی بگذارید، نه در خط فرمان
export WARP_ACCESS_KEY=... WARP_SECRET_KEY=...
warp put --host rgw.example.internal:8080 --bucket bench-put --obj.size 4MiB --concurrent 32 --duration 2m
warp get --host rgw.example.internal:8080 --bucket bench-get --obj.size 4MiB --concurrent 32 --duration 2m
warp mixed --host rgw.example.internal:8080 --bucket bench-mixed --obj.size 64KiB --duration 3mدر سنجش RGW سه گلوگاه رایج را جدا کنید: (۱) خود RGW (CPU و تعداد thread یا rgw_max_concurrent_requests)، (۲) load balancer جلوی آن، و (۳) pool شاخص bucketها. اندازهی اشیا نتیجه را کاملاً تغییر میدهد: با اشیای کوچک، عملیات فراداده (بهروزرسانی شاخص bucket) غالب است و با اشیای بزرگ، پهنای باند شبکه و دیسک. برای هر دو حالت جداگانه عدد بگیرید.
برای بنچمارک اشیای کوچک، bucket را از ابتدا با تعداد shard کافی بسازید یا مطمئن شوید reshard پویا فعال است؛ وگرنه در میانهی آزمایش reshard اتفاق میافتد و نتیجه را آشفته میکند (فصل ۴).
۱۰-۷-۲ فایلسیستم#
برای CephFS دو نوع آزمایش لازم است: داده (توان خواندن و نوشتن فایلهای بزرگ) و فراداده (ساخت، stat و حذف تعداد زیادی فایل کوچک). fio برای داده کافی است؛ برای فراداده، ابزارهایی مثل mdtest (از مجموعهی IOR در جامعهی HPC) یا یک اسکریپت ساده مناسباند.
# داده: چند job همزمان روی فایلهای جدا
fio --name=cephfs-seq --directory=/mnt/fs01/bench --rw=write --bs=4M --size=8G \
--numjobs=8 --direct=1 --ioengine=libaio --iodepth=8 --group_reporting
# فراداده: ساخت و حذف ۱۰۰ هزار فایل خالی
time (mkdir -p /mnt/fs01/meta && cd /mnt/fs01/meta && seq 1 100000 | xargs -P 16 -n 1000 touch)
time rm -rf /mnt/fs01/meta
ceph tell mds.fs01:0 perf dump mds_server | jq '.mds_server | {req: .handle_client_request}'آزمایش فراداده بار سنگینی روی MDS و pool فراداده میگذارد و cache MDS را پر میکند. آن را روی فایلسیستم production اجرا نکنید و پس از آزمایش، هشدارهای MDS_CACHE_OVERSIZED یا کند شدن درخواستها را بررسی کنید.
۱۰-۸ گزارش بنچمارک#
عدد بدون زمینه بیارزش است. هر گزارش بنچمارک باید شامل این موارد باشد تا دیگران بتوانند آن را تکرار یا مقایسه کنند:
| بخش | محتوا |
|---|---|
| سختافزار | تعداد و مدل گرهها، CPU، حافظه، مدل دیسکها، کنترلر، شبکه و MTU |
| نرمافزار | نسخهی دقیق Ceph، سیستمعامل و هسته، نسخهی fio یا ابزار |
| پیکربندی | نوع pool (تکثیر یا EC)، تعداد PG، پروفایل mClock، تنظیمات غیرپیشفرض (ceph config dump) |
| بار | ابزار، فایل پیکربندی کامل، اندازهی بلوک، عمق صف، تعداد کلاینت، مدت و ramp |
| نتیجه | IOPS، توان، تأخیر میانگین و صدکهای ۹۵، ۹۹ و ۹۹.۹ |
| وضعیت | خروجی ceph -s پیش و پس از آزمایش؛ آیا recovery یا scrub در جریان بود؟ |
هر آزمایش را دستکم سه بار تکرار کنید و میانه را گزارش دهید. اگر اختلاف تکرارها زیاد است، چیزی در محیط ثابت نیست (scrub، بار دیگر، cache یا thermal throttling دیسک). در طول آزمایش، Grafana را باز نگه دارید تا تأخیر هر OSD را ببینید؛ OSD کند معمولاً همانجا خودش را نشان میدهد.
۱۰-۹ از درون کد: osd bench، rados bench و سنجش ظرفیت mClock#
۱۰-۹-۱ دو ابزار، دو چیز متفاوت#
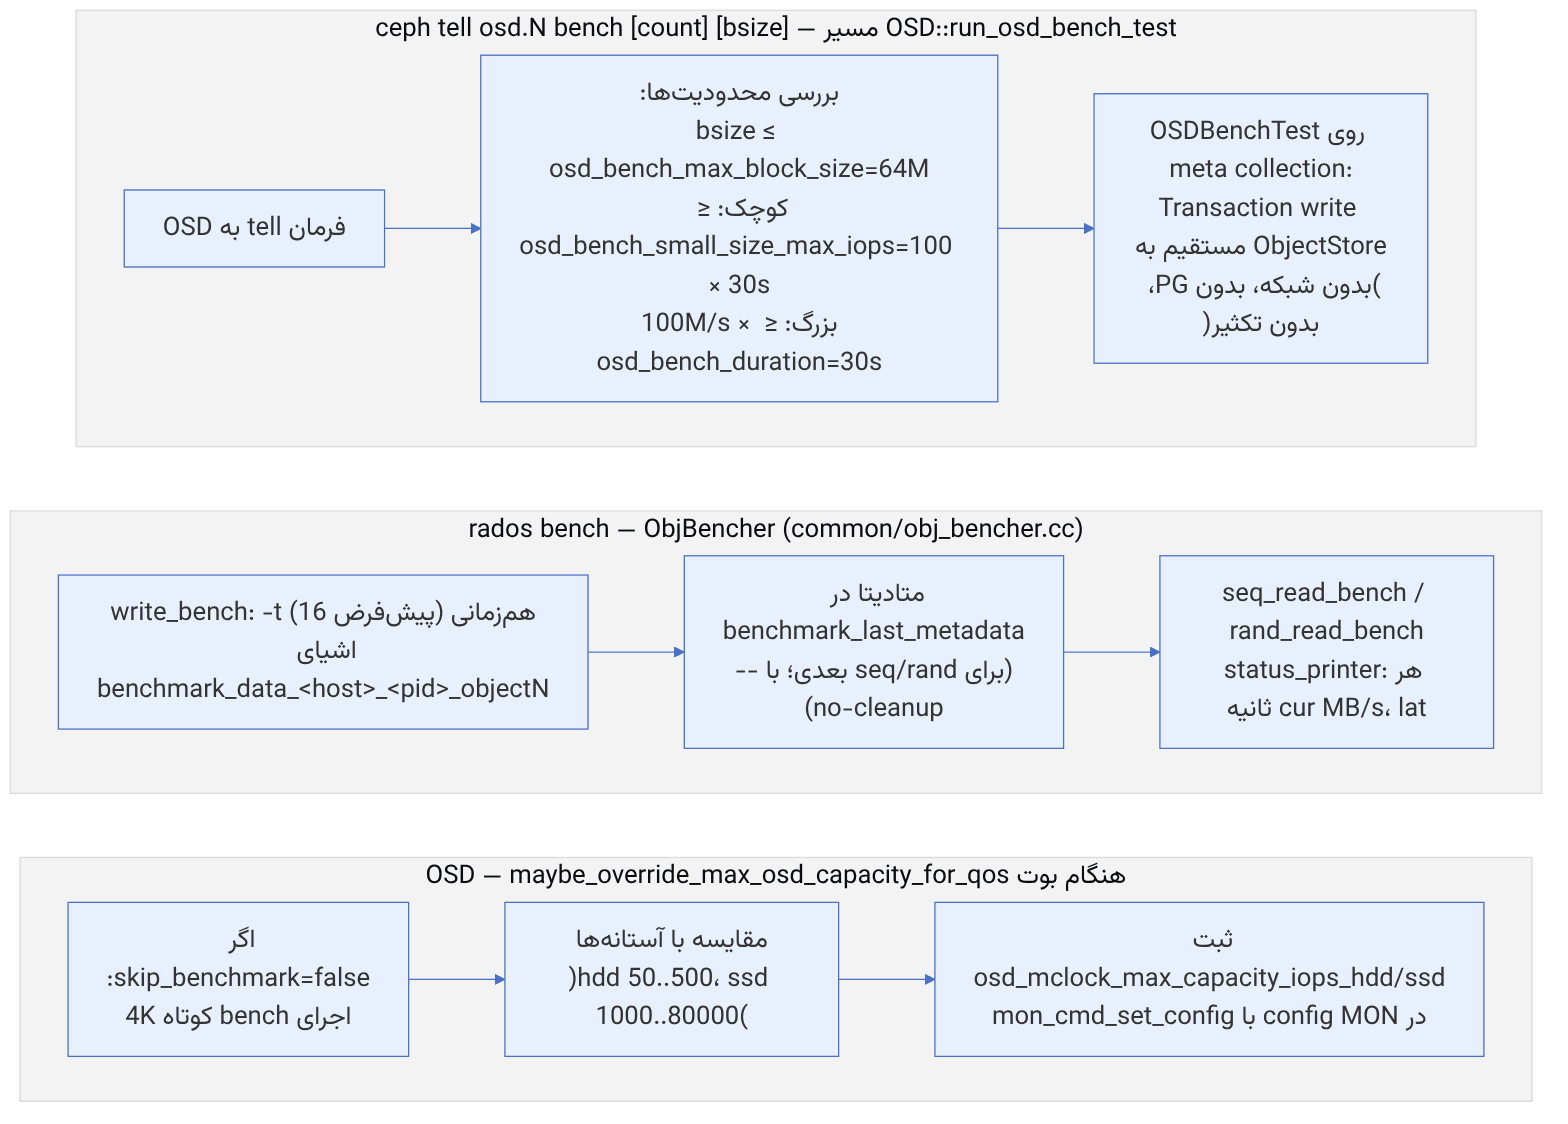
خطای رایج این است که خروجی ceph tell osd.N bench را با rados bench مقایسه کنیم. این دو ابزار دو لایهی کاملاً متفاوت را میسنجند و کد آنها هم این تفاوت را نشان میدهد.
| osd bench | rados bench | |
|---|---|---|
| چه چیزی را میسنجد | ObjectStore محلی (BlueStore + دیسک) | کل مسیر: کلاینت، شبکه، PG، تکثیر/EC، BlueStore |
| تابع ورودی | OSD::run_osd_bench_test → OSDBenchTest | ObjBencher::aio_bench → write_bench / seq_read_bench / rand_read_bench |
| پیشفرضها | count=1G، bsize=4M؛ محدودیتهای osd_bench_* | -t 16، -b 4M؛ پاکسازی خودکار مگر با --no-cleanup |
| خطای تفسیر رایج | نتیجهی آن را ظرفیت کلاستر دانستن | اجرا از یک کلاینت و نتیجهگیری دربارهی کل کلاستر |
pseudocode: ObjBencher::write_bench (خلاصهی این کتاب)
start status_printer thread
for slot in 0..concurrentios-1: aio_write(obj_name(slot), data)
while elapsed < seconds:
wait any completion c # lc.cond
record latency(c) → min/max/avg, iops
issue next aio_write in the same slot
wait all ; write metadata object (BENCH_LASTRUN_METADATA)
print: Bandwidth (MB/sec), Average IOPS, Average Latency(s), Stddevاندازهگیری هنگام بوت فقط نوشتن ۱۲۲۸۸۰۰۰ بایت با بلوک ۴۰۹۶ روی ۱۰۰ شیء ۴MiB است (همان مقادیری که در کد هستند) و اگر دیسک کش نوشتن داشته باشد یا OSD همزمان مشغول recovery باشد، عدد غیرواقعی تولید میشود. Ceph عددهای خارج از بازهی آستانه را نادیده میگیرد و در لاگ OSD هشدار میدهد. مقدار ثبتشده را بررسی کنید و در صورت نیاز بر اساس fio خودتان override کنید (فصل ۲۱).
فرمانها:
ceph tell osd.4 bench                       # 1G با بلوک 4M
ceph tell osd.4 bench 12288000 4096 4194304 100   # همان پارامترهای آزمون بوت mClock
ceph config dump | grep osd_mclock_max_capacity_iops
rados bench -p bench 60 write -t 32 -b 4M --no-cleanup
rados bench -p bench 60 rand -t 32 ; rados -p bench cleanup
ceph osd perf # commit/apply latency هر OSD در حین آزمون۱۰-۱۰ سه الگوریتم سنجش با عدد#
۱۰-۱۰-۱ سقف ایمنی osd bench#
منبع در کد: src/osd/OSD.cc :: OSDBenchTest::precheck، OSDBenchTest::run_test (v21.2.0 و main)؛ در v20.2.0 همین منطق در OSD::run_osd_bench_test است
پیچیدگی: O(۱) برای اعتبارسنجی؛ خود آزمون O(count / bsize) نوشتن
pseudocode
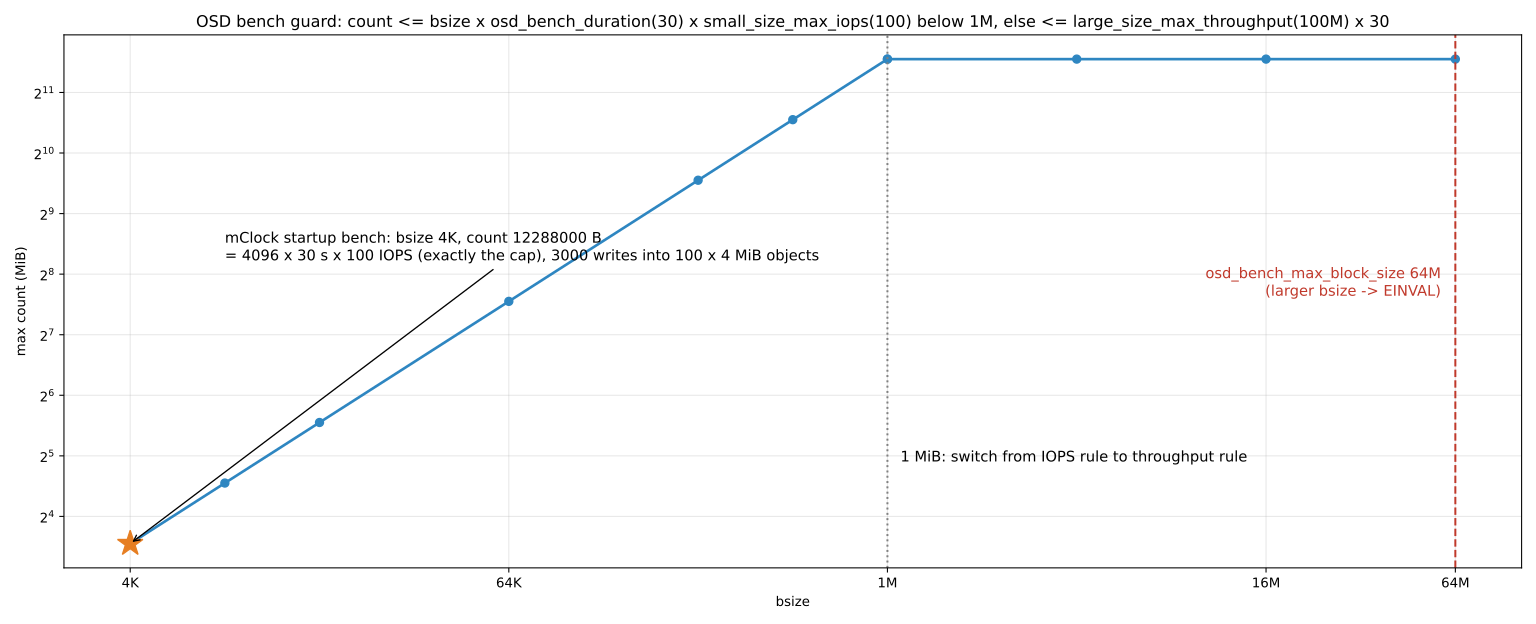
duration = osd_bench_duration (30)
if bsize > osd_bench_max_block_size (64M): EINVAL
elif bsize < 1M: max_count = bsize × duration × osd_bench_small_size_max_iops (100)
else: max_count = osd_bench_large_size_max_throughput (100M) × duration
if count > max_count: EINVAL
if osize and bsize > osize: bsize = osize
run: flush cache ; prefill onum × osize ; write count بایت در تکههای bsize ; cleanup
bandwidth = count / elapsed ; iops = bandwidth / bsizeمثال عددی. با ceph tell osd.4 bench 12288000 4096 4194304 100 داریم bsize = ۴K < ۱M. پس max_count = ۴۰۹۶ × ۳۰ × ۱۰۰ = ۱۲۲۸۸۰۰۰. count دقیقاً برابر سقف است و پذیرفته میشود. کد آزمون بوت mClock هم همین عدد را به کار میبرد. این آزمون ۳۰۰۰ نوشتن ۴K را در ۱۰۰ شیء ۴ مگابایتی پخش میکند. اگر ۱۰ ثانیه طول بکشد، bandwidth = ۱۲۲۸۸۰۰ B/s و iops = ۳۰۰.
برای بلوک ۴M، سقف ۱۰۰M × ۳۰ = ۳۱۴۵۷۲۸۰۰۰ بایت است. همین عدد برای بلوک ۱M هم از قاعدهی IOPS به دست میآید (۱M × ۳۰ × ۱۰۰)، پس دو قاعده در مرز ۱M پیوستهاند. ceph tell osd.4 bench 4294967296 4194304 (۴ GiB) با EINVAL رد میشود.
۱۰-۱۰-۲ پذیرش ظرفیت اندازهگیریشده برای mClock#
منبع در کد: src/osd/OSD.cc :: OSD::maybe_override_max_osd_capacity_for_qos
پیچیدگی: یک آزمون O(۳۰۰۰ نوشتن ۴K) هنگام بوت؛ فقط اگر مقدار فعلی همان پیشفرض باشد
pseudocode
if scheduler ≠ mClock or osd_mclock_skip_benchmark or store == memstore: return
key = rotational ? osd_mclock_max_capacity_iops_hdd : …_ssd
if !force_run_benchmark_on_init and current(key) ≠ default(key): return   # کاربر یا بوت قبلی تنظیم کرده
iops = OSDBenchTest(count 12288000, bsize 4096, osize 4M, onum 100).run()
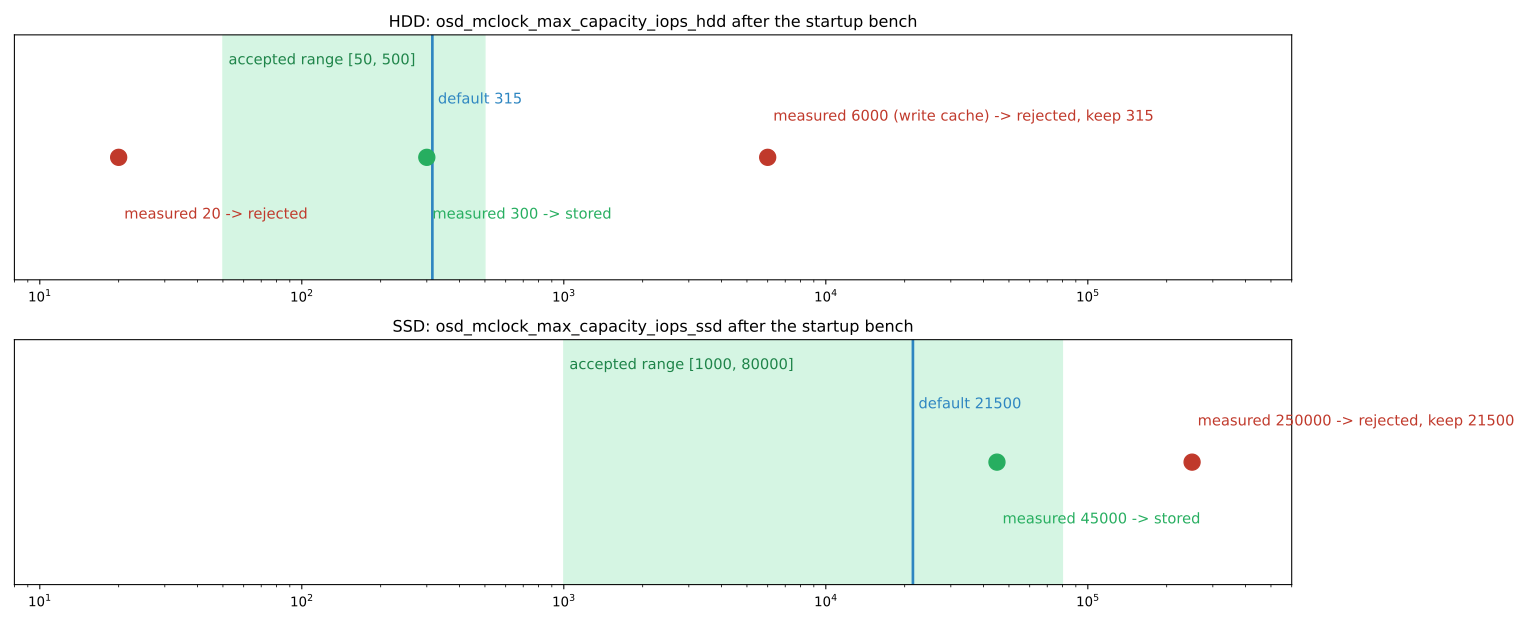
(lo, hi) = rotational ? (50, 500) : (1000, 80000)
if lo ≤ iops ≤ hi: mon_cmd_set_config(key, iops)       # در پایگاه پیکربندی MON
else: هشدار کلاستر و نگه داشتن مقدار فعلی
مثال عددی.
- HDD، اندازهگیری ۳۰۰ IOPS: در بازهی [۵۰، ۵۰۰] است، پس در پایگاه پیکربندی MON ذخیره میشود. از بوت بعد، چون مقدار دیگر پیشفرض نیست، آزمون اجرا نمیشود.
- HDD با کش نوشتن، ۶۰۰۰ IOPS: بزرگتر از ۵۰۰ است، پس رد میشود و ۳۱۵ میماند.
- SSD، اندازهگیری ۴۵۰۰۰: در بازهی [۱۰۰۰، ۸۰۰۰۰] است و ذخیره میشود.
- NVMe، اندازهگیری ۲۵۰۰۰۰: رد میشود و ۲۱۵۰۰ میماند. برای چنین دستگاهی باید مقدار را خودتان از fio تنظیم کنید.
برای اندازهگیری دوباره، ceph config rm osd.N osd_mclock_max_capacity_iops_ssd و راهاندازی دوبارهی OSD لازم است، یا osd_mclock_force_run_benchmark_on_init = true.
۱۰-۱۰-۳ از ظرفیت تا رزرو هر کلاس#
منبع در کد: src/common/mclock_common.cc :: MclockConfig::set_from_config، ClientRegistry::update_from_profile، MclockConfig::calc_scaled_cost؛ src/common/mclock_common.h :: HIGH_CLIENT_OPS، BALANCED، HIGH_RECOVERY_OPS (v21.2.0)
پیچیدگی: O(۱) برای هر تغییر پیکربندی؛ هزینهی هر op در O(۱)
pseudocode
bw = osd_mclock_max_sequential_bandwidth_{hdd 150M | ssd 1200M} ; iops = max_capacity_iops
cost_per_io = bw / iops ; cap_per_shard = bw / num_shards (hdd 1 ، ssd 8)
for class in (client, background_recovery, background_best_effort):
res = r ? r × cap_per_shard : کمینه ; lim = l ? l × cap_per_shard : بیسقف ; weight = w
cost(op) = max(op_bytes, cost_per_io) # opهای کوچک دستکم یک «IO کامل» هزینه دارندمثال عددی (HDD با پیشفرضها). cost_per_io = ۱۵۷۲۸۶۴۰۰ / ۳۱۵ = ۴۹۹۳۲۲ بایت. پس یک نوشتن ۴K هزینهای برابر ۴۸۸ KiB دارد. با پروفایل پیشفرض balanced (v۲۱.۲.۰):
- client: رزرو ۰.۵ × ۱۵۰ MiB/s، معادل ۱۵۷.۵ op کوچک در ثانیه.
- background_recovery: همان ۱۵۷.۵.
- background_best_effort: رزرو ۰.۰۵، معادل ۱۵.۷۵ op، و سقف ۰.۹، معادل ۲۸۳.۵ op.
در high_client_ops رزرو client به ۱۸۹ و وزنش به ۲ میرسد. در SSD با ۲۱۵۰۰ IOPS و ۸ شارد، cost_per_io = ۵۸۵۲۵ بایت است و رزرو client در balanced برای هر شارد ۱۳۴۳.۷۵ op و در کل ۱۰۷۵۰ op میشود. یعنی همان نیمی از ۲۱۵۰۰.
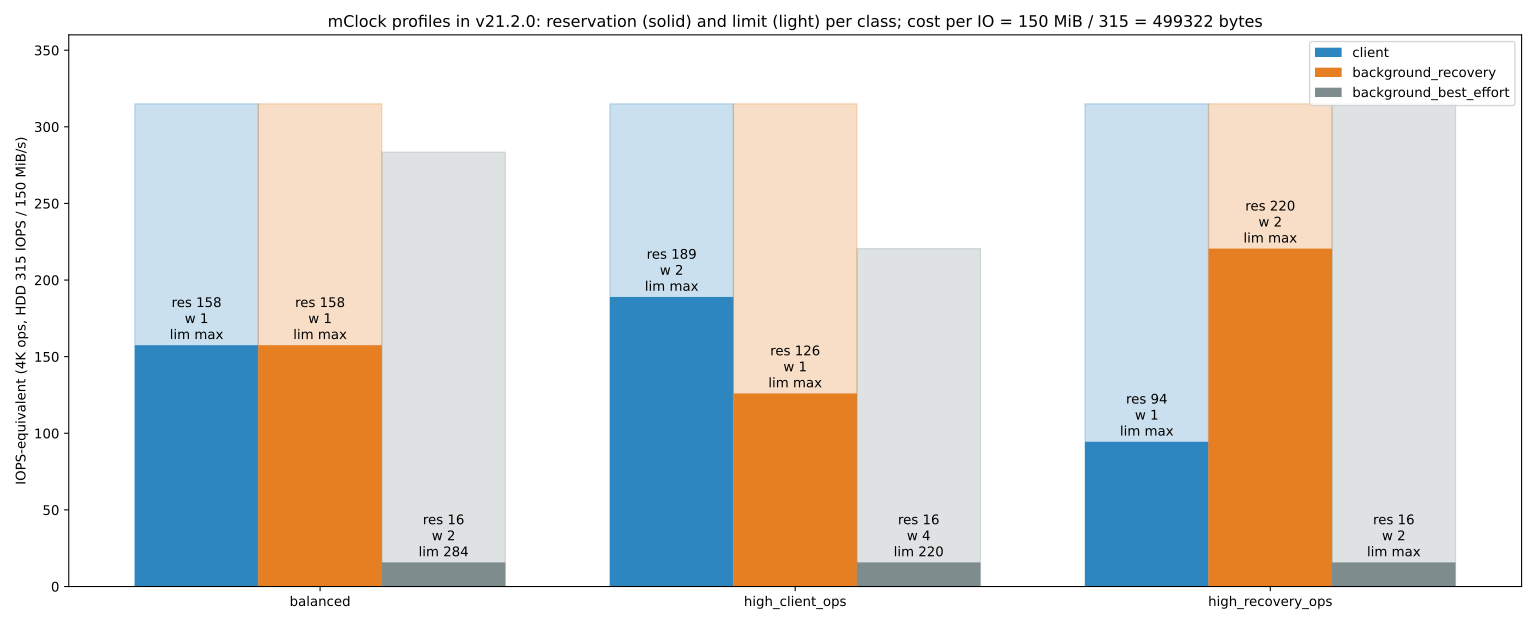
وابسته به نسخه. در v20.2.0 مقادیر پروفایل در src/osd/scheduler/mClockScheduler.cc تعریف شدهاند و کلاس background_best_effort رزرو ۰ و وزن ۱ دارد. در v21.2.0 این مقادیر به src/common/mclock_common.h منتقل شدهاند و best_effort رزرو ۰.۰۵ دارد، با وزن ۴ در high_client_ops و وزن ۲ در balanced و high_recovery_ops. پیش از تکیه بر اعداد، ceph config show osd.N | grep mclock_scheduler را روی نسخهی خودتان بخوانید.
۱۰-۱۱ سنجش واقعی روی یک کلاستر آزمایشی#
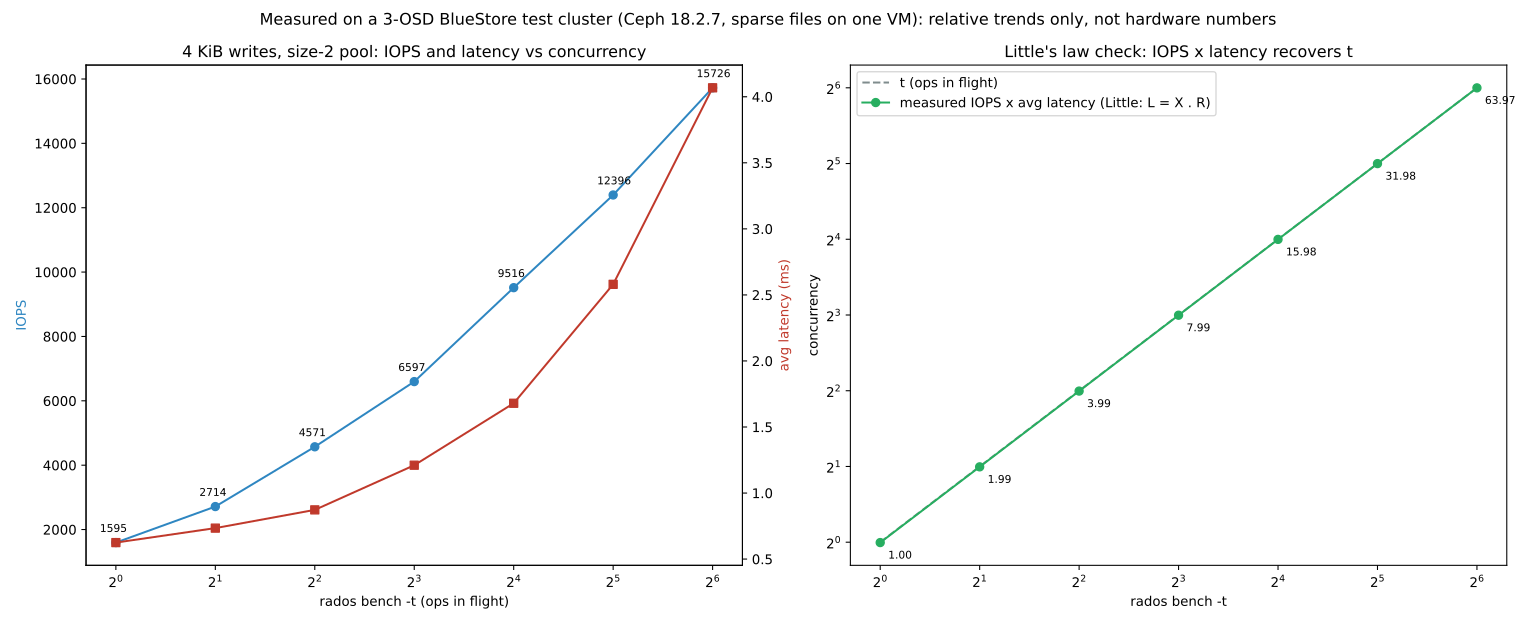
دو اندازهگیری این بخش روی یک کلاستر سهOSDی BlueStore اجرا شدهاند: Ceph 18.2.7 از بستههای Debian، با فایلهای sparse دهگیگابایتی روی دیسک یک ماشین مجازی. عددهای مطلق سختافزار واقعی را نشان نمیدهند، چون cache صفحهی سیستمعامل و یک CPU مشترک در کارند. اما شکل منحنیها همان چیزی است که روی هر کلاستری خواهید دید. هدف آموختن خواندن این منحنیهاست.
۱۰-۱۱-۱ همروندی، تأخیر و قانون Little#
منبع در کد: rados bench (src/common/obj_bencher.cc)؛ L = X · R
پیچیدگی: O(۱) برای بررسی هر نقطه
pseudocode
rados bench -t T: همیشه دقیقاً T عملیات در پرواز ← هر completion یک op تازه میفرستد
X = IOPS اندازهگیریشده ؛ R = میانگین تأخیر
قانون Little برای سامانهی بسته: L = X · R = T
پس: R = T / X ← وقتی X اشباع شود، R خطی با T رشد میکنداندازهگیری (نوشتن ۴ KiB، pool با size = ۲، هر نقطه ۸ ثانیه).
| -t | IOPS | تأخیر میانگین (ms) | IOPS × تأخیر |
|---|---|---|---|
| ۱ | ۱۵۹۵ | ۰.۶۲ | ۱.۰۰ |
| ۴ | ۴۵۷۱ | ۰.۸۷ | ۳.۹۹ |
| ۱۶ | ۹۵۱۶ | ۱.۶۸ | ۱۵.۹۸ |
| ۶۴ | ۱۵۷۲۶ | ۴.۰۷ | ۶۳.۹۷ |
ستون آخر عملاً همان T است. این ثابت میکند rados bench یک بار کاری حلقهبسته است. نتیجهی عملی: اگر با بالا بردن -t تأخیر بالا میرود ولی IOPS کمتر از نسبت بالا میرود (از ۱۶ به ۶۴، چهار برابر همروندی فقط ۱.۶۵ برابر IOPS داد)، به گلوگاه رسیدهاید. از آنجا به بعد، همروندی بیشتر فقط صف را طولانیتر میکند.
در گزارش بنچمارک همیشه -t را کنار IOPS بنویسید. عدد IOPS بدون همروندی معنا ندارد. وقتی سنجش با iodepth ثابت (fio) یا با نرخ ثابت (حلقهباز) انجام شود، این رابطه شکل دیگری دارد.
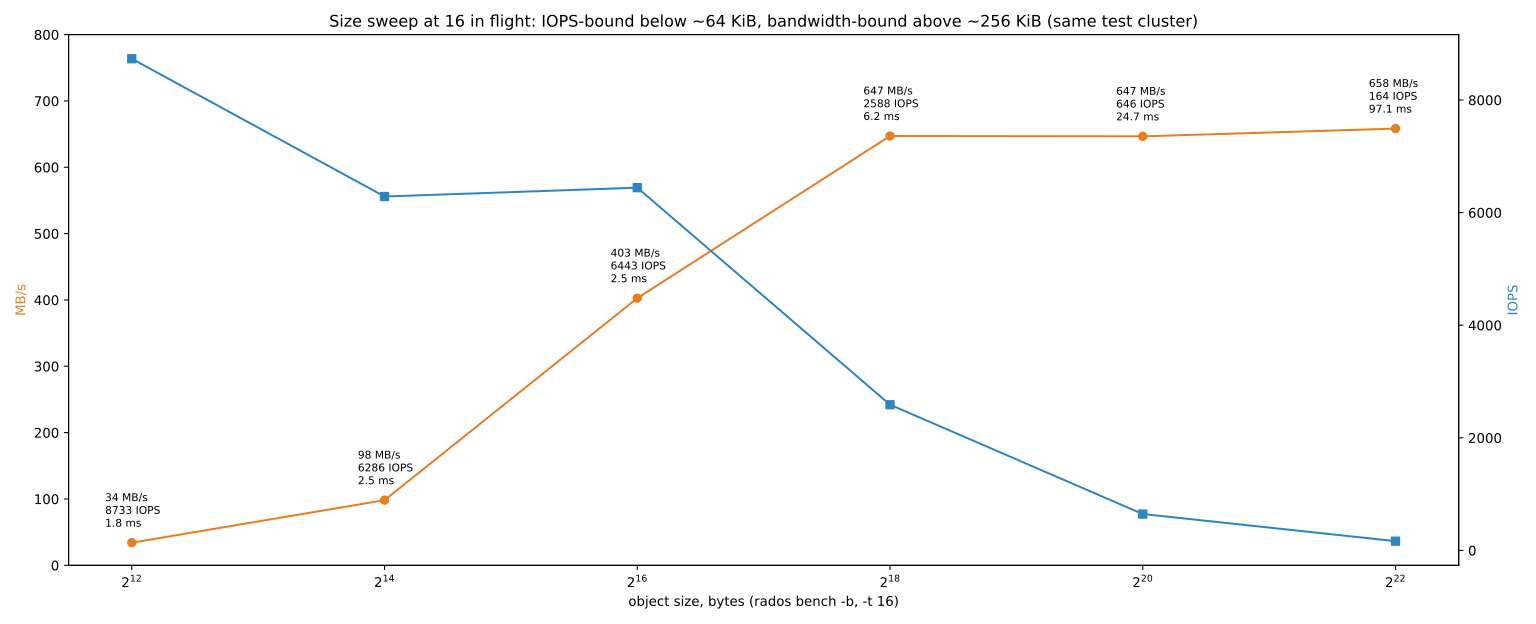
۱۰-۱۱-۲ اندازهی شیء: از سقف IOPS تا سقف پهنای باند#
اندازهگیری (-t 16). از ۴ KiB تا ۶۴ KiB، IOPS تقریباً ثابت میماند (۸۷۳۳، ۶۲۸۶ و ۶۴۴۳) و MB/s با اندازه رشد میکند. یعنی گلوگاه هزینهی هر عملیات است: CPU، پیامرسانی و تراکنش RocksDB. از ۲۵۶ KiB به بالا، MB/s روی حدود ۶۵۰ ثابت میشود و IOPS با اندازه کم میشود. گلوگاه حالا پهنای باند است.
نقطهی شکست (حدود ۶۴ تا ۲۵۶ KiB در این کلاستر) را برای هر کلاستر جداگانه اندازه بگیرید. این نقطه میگوید کدام بار کاری را با «IOPS» و کدام را با «MB/s» باید سنجید.
در BlueStore نقطهی مهم دیگری هم هست. نوشتن کوچکتر از bluestore_prefer_deferred_size ابتدا در WAL RocksDB نوشته و بعداً اعمال میشود (فصل ۱۲). روی HDD همین جا منحنی تأخیر میشکند.
۱۰-۱۱-۳ پروفایل حافظه#
مصرف حافظهی OSDها با osd_memory_target (پیشفرض ۴ گیگابایت، در cephadm با autotune) کنترل میشود. وقتی یک daemon بیش از انتظار حافظه مصرف میکند، اول ببینید حافظه کجا رفته است:
ceph tell osd.3 dump_mempools | jq '.mempool.by_pool | to_entries | sort_by(-.value.bytes) | .[0:5]'
ceph tell osd.3 heap stats
ceph tell osd.3 heap release # برگرداندن حافظهی آزاد tcmalloc به سیستمعامل
ceph orch ps --daemon-type osd --format json | jq -r '.[] | "\(.daemon_name) \(.memory_usage)"' | sort -nk2 | tailبرای اشکالزدایی نشت حافظه، profiler داخلی tcmalloc را موقتاً فعال کنید:
ceph tell osd.3 heap start_profiler
# چند دقیقه یا ساعت صبر کنید تا الگو ظاهر شود
ceph tell osd.3 heap dump
ceph tell osd.3 heap stop_profiler
# فایلهای heap در مسیر لاگ daemon ساخته میشوند و با pprof (google-perftools) تحلیل میشونداگر heap stats نشان میدهد مقدار زیادی حافظه «freelist» یا «unmapped» در tcmalloc است، heap release معمولاً فوراً مصرف RSS را پایین میآورد. اگر بیشتر حافظه در mempoolهای bluestore_cache_* است، این رفتار طبیعی است و autotune آن را در حد osd_memory_target نگه میدارد. اگر osd_pglog بزرگ است، احتمالاً تعداد PG هر OSD یا طول log PG زیاد است.
۱۰-۱۱-۴ ceph-objectstore-tool#
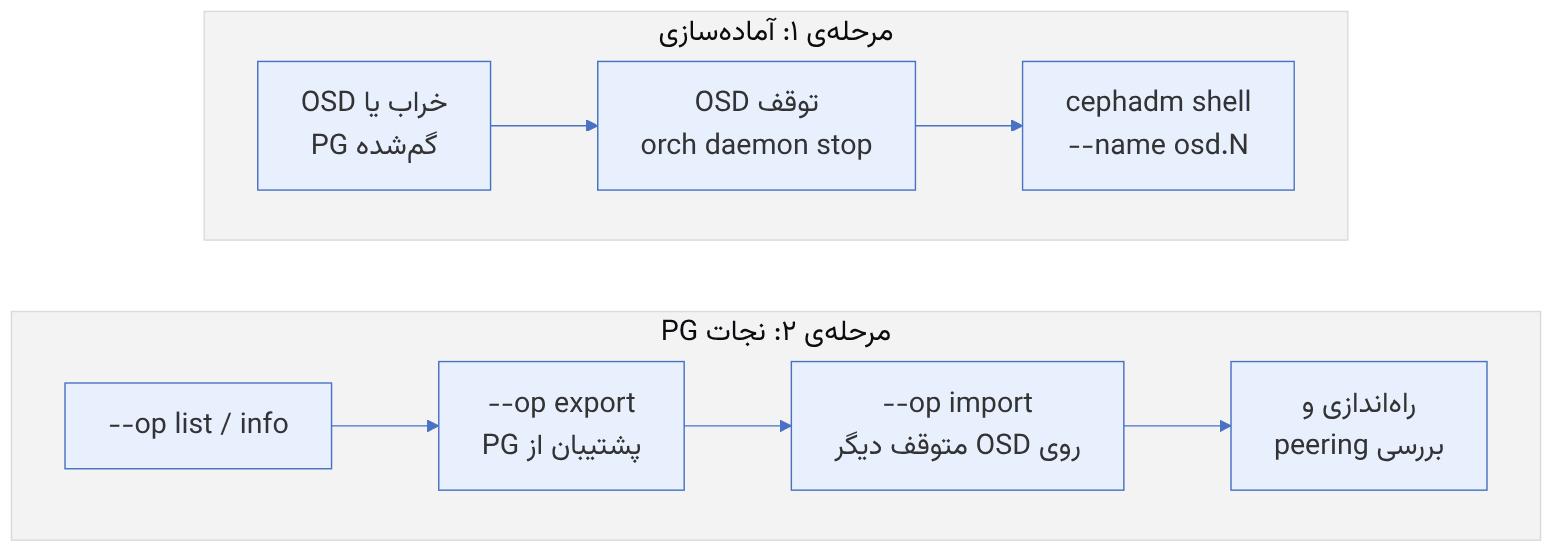
ceph-objectstore-tool مستقیماً روی دادهی یک OSD متوقفشده کار میکند: میتواند PGها و اشیا را فهرست کند، یک PG را export یا import کند، فراداده را بخواند و در موارد خاص اصلاح کند. کاربرد کلاسیک آن نجات PGی است که همهی نسخههای سالمش روی OSDهایی بوده که دیگر بالا نمیآیند، اما دیسکشان هنوز خواناست.
ceph orch daemon stop osd.12
cephadm shell --name osd.12
# درون shell
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-12 --op list-pgs
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-12 --pgid 5.3a --op info
ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-12 --pgid 5.3a --op export --file /var/log/ceph/pg5.3a.export
exit
# روی OSD مقصد (آن هم متوقف)
ceph orch daemon stop osd.20
cephadm shell --name osd.20 -- ceph-objectstore-tool --data-path /var/lib/ceph/osd/ceph-20 --op import --file /var/log/ceph/pg5.3a.export
ceph orch daemon start osd.20
ceph pg 5.3a query | jq .stateاین ابزار هیچ محافظی ندارد: میتواند PG را حذف کند، فراداده را خراب کند و وضعیت را غیرقابل بازگشت کند. همیشه پیش از هر عملیات تغییردهنده، export پشتیبان بگیرید، از --dry-run در صورت امکان استفاده کنید و فقط وقتی سراغش بروید که روالهای عادی (بالا آوردن OSD، بازیابی خودکار) شکست خوردهاند. فایل export را در مسیری بنویسید که خارج از کانتینر هم باقی بماند (در cephadm مسیر لاگ daemon روی میزبان mount شده است).
۱۰-۱۱-۵ ابزارهای کنار رفته#
| ابزار قدیمی | وضعیت امروز | جایگزین |
|---|---|---|
| ceph-medic | توسعهی فعال ندارد (آخرین تغییر مخزن در ۲۰۲۰) و از مستندات پایش حذف شده است | ceph health detail، health checkهای cephadm، هشدارهای Prometheus |
| ماژول restful | در Tentacle حذف شد | API Dashboard |
| rados load-gen | در راهنمای جاری rados نیست | fio با موتور rados یا rbd |
| BlueStore «آزمایشی» | از Luminous پایدار و پیشفرض؛ FileStore از Reef پشتیبانی نمیشود | BlueStore (فصل ۱۲) |
cephadm خودش بررسیهای پیشنیاز میزبان را انجام میدهد (cephadm check-host) و orchestrator هشدارهایی مثل CEPHADM_HOST_CHECK_FAILED یا CEPHADM_STRAY_DAEMON میدهد. این همان نقشی است که ceph-medic برای بررسی پیکربندی در دوران ceph-deploy بازی میکرد.
cephadm check-host
ceph health detail | grep -i cephadm- سنجش لایهای: دیسک و شبکه، سپس RADOS، سپس رابطها، سپس بار واقعی.
- SSD برای DB/WAL را با نوشتن sync در عمق صف ۱ بسنجید.
- MTU را سرتاسر با
ping -M do آزمایش کنید. - صدکهای تأخیر را گزارش کنید، نه فقط میانگین.
-
dump_historic_slow_ops مرحلهی معطلی را نشان میدهد. - حافظه: اول mempoolها و heap stats، بعد profiler.
-
ceph-objectstore-tool فقط روی OSD متوقف و پس از export پشتیبان.
۱۰-۱۲ تکمیلی و بهروز#
- FileStore از Reef به بعد پشتیبانی نمیشود (هنگام ارتقا هشدار
OSD_FILESTORE میدهد) و BlueStore تنها پشتهی ذخیرهسازی پشتیبانیشدهی OSD کلاسیک است؛ crimson/SeaStore هنوز پیشنمایش فناوریاند (Squid و Tentacle). - ماژول restful در Tentacle حذف شد.
- cephadm: بررسی میزبان و هشدارهای orchestrator جایگزین ابزارهای جانبی بررسی پیکربندی شدند.
- mClock نتیجهی بنچمارک را تحت تأثیر قرار میدهد: پروفایل فعال (balanced، high_client_ops) سهم کلاینت را تعیین میکند؛ در گزارش بنچمارک، پروفایل را ذکر کنید.
۱۰-۱۳ تمرین عملی#
- ۱. روی یک دیسک خالی، سه آزمایش fio این فصل را اجرا کنید و نتایج را در جدول بنویسید. آزمایش sync را روی یک SSD مصرفی و یک SSD دیتاسنتری (اگر دارید) مقایسه کنید.
- ۲. با iperf3 و ping با MTU بزرگ، شبکهی public و cluster را بین همهی جفت گرهها بسنجید.
- ۳. با حلقهی
ceph tell osd.N bench، کندترین سه OSD را پیدا کنید. - ۴.
rados bench را با بلوک ۴ مگابایت و ۴ کیلوبایت اجرا کنید و نسبت توان و IOPS را با سقف نظری مقایسه کنید. - ۵. فایل fio این فصل را با موتور rbd اجرا کنید و p99 تأخیر را استخراج کنید. سپس پروفایل mClock را تغییر دهید و تکرار کنید.
- ۶. در آزمایشگاه، یک PG از OSD متوقف را export و روی OSD دیگری import کنید و peering را مشاهده کنید.
۱۰-۱۴ پرسشهای مرور#
- ۱. چرا سنجش کارایی باید لایهبهلایه انجام شود؟
- ۲. چرا fio برای سنجش دیسک بر dd ترجیح دارد؟
- ۳. چرا آزمایش نوشتن sync با عمق صف ۱ برای انتخاب SSD مهم است؟
- ۴. MTU ناهماهنگ چه علائمی در Ceph ایجاد میکند؟
- ۵. در مثال سقف نظری، چرا شبکه گلوگاه شد؟
- ۶. تفاوت
ceph tell osd.N bench و rados bench چیست؟ - ۷. چرا باید image RBD را پیش از سنجش نوشتن تصادفی پر کرد؟
- ۸. تفاوت admin socket و
ceph tell چیست و هر کدام چه زمانی مفیدترند؟ - ۹. در خروجی
heap stats، حافظهی freelist چه معنایی دارد؟ - ۱۰. پیش از استفاده از
ceph-objectstore-tool چه اقدامهایی لازم است؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۰-۱۵ منابع این فصل#
- rados manual
https://docs.ceph.com/en/latest/man/8/rados/ - rbd manual
https://docs.ceph.com/en/latest/man/8/rbd/ - Control commands (osd bench
https://docs.ceph.com/en/latest/rados/operations/control/ - Memory profiling
https://docs.ceph.com/en/latest/rados/troubleshooting/memory-profiling/ - ceph-objectstore-tool manual
https://docs.ceph.com/en/latest/man/8/ceph-objectstore-tool/ - Troubleshooting OSDs
https://docs.ceph.com/en/latest/rados/troubleshooting/troubleshooting-osd/ - Ceph API
https://docs.ceph.com/en/latest/mgr/ceph_api/ - librados Python
https://docs.ceph.com/en/latest/rados/api/python/ - fio documentation
https://fio.readthedocs.io/en/latest/fio_doc.html - iperf3
https://software.es.net/iperf/ - warp (S۳ benchmark
https://github.com/minio/warp - IOR and mdtest
https://github.com/hpc/ior - ceph-medic repository
https://github.com/ceph/ceph-medic - Tentacle release notes
https://docs.ceph.com/en/latest/releases/tentacle/