لایههای پایینی (۱۰): scrub، recovery، backfill و repair در سطح کد
حوصله ندارم این فصل در چند خط
- scrub در
src/osd/scrubber/ است: PgScrubber، ماشین حالت ScrubMachine، ScrubBackend برای مقایسه و زمانبندی در سطح OSD. - هر PG دو هدف scrub سطحی و عمیق با زمان و فوریت دارد؛ درخواست اپراتور مقدم است.
- پس از peering، recovery اشیای گمشده را از روی log پر میکند و backfill کل PG را به مقصدهایی که log مشترک ندارند کپی میکند.
- repair همان recovery است با یک فهرست missing مصنوعی، پس محدودیتهای recovery (رزرو و
osd_max_backfills) بر آن هم اعمال میشود.
۳۲-۱ نقشهی فصل#
سه سازوکار درستی داده در OSD را در سطح کد بررسی میکنیم:
- scrub: مقایسهی دورهای نسخههای یک PG روی OSDهای مختلف. shallow فقط فراداده و اندازه را مقایسه میکند و deep همهی داده و omap را میخواند و digest میسازد.
- recovery و backfill: بازگرداندن نسخههای گمشده. recovery بر پایهی pg log است و backfill بر پایهی اسکن کامل محتوا.
- repair: ترکیب این دو. scrub نسخهی معتبر را پیدا و recovery آن را جایگزین نسخهی خراب میکند.
کد scrub از نسخهی Quincy به بعد در src/osd/scrubber/ به چند جزء جدا شده است: PgScrubber (منطق هر PG)، ScrubMachine (ماشین حالت boost::statechart)، ScrubBackend (مقایسهی نقشهها)، OsdScrub و ScrubQueue (زمانبندی در سطح OSD) و ScrubResources و ScrubReservations (رزرو). همهی ارجاعها به main است. پیشفرضها از osd.yaml.in همان شاخه خوانده شدهاند.
۳۲-۲ زمانبندی scrub#
۳۲-۲-۱ هدفها و تصادفیسازی#
هر PG یک ScrubJob با دو هدف (shallow_target و deep_target) دارد. هر هدف scheduled_at (زمان مطلوب)، not_before (زودترین زمان مجاز) و یک فوریت (urgency) دارد. فوریتها از periodic_regular تا operator_requested و must_repair متغیرند. فقط هدفهای دورهای تصادفیسازی میشوند (requires_randomization).
منبع در کد: src/osd/scrubber/scrub_job.cc :: ScrubJob::adjust_shallow_schedule و adjust_deep_schedule
پیچیدگی: O(۱) برای هر PG؛ صف OSD با مرتبسازی O(log n)
pseudocode
shallow: target = last_scrub + I_s + I_s × ratio × U(0,1)          # I_s = osd_scrub_min_interval
         not_before = max(last_scrub, target)
deep:    sd = I_d × cv                                              # cv = osd_deep_scrub_interval_cv
         delay = clamp(Normal(I_d, sd), I_d − 2sd, I_d + 2sd)
         target = not_before = last_deep + delay
initiate_scrub (هر tick مربوط به OSD):
   if random() < osd_scrub_backoff_ratio: skip           # پرتاب سکه: 0.66
   if loadavg/ncpu ≥ osd_scrub_load_threshold: فقط scrubهای ضروری
   از صف، زودترین هدف واجد شرایط (not_before ≤ now) را بردار و منابع را رزرو کن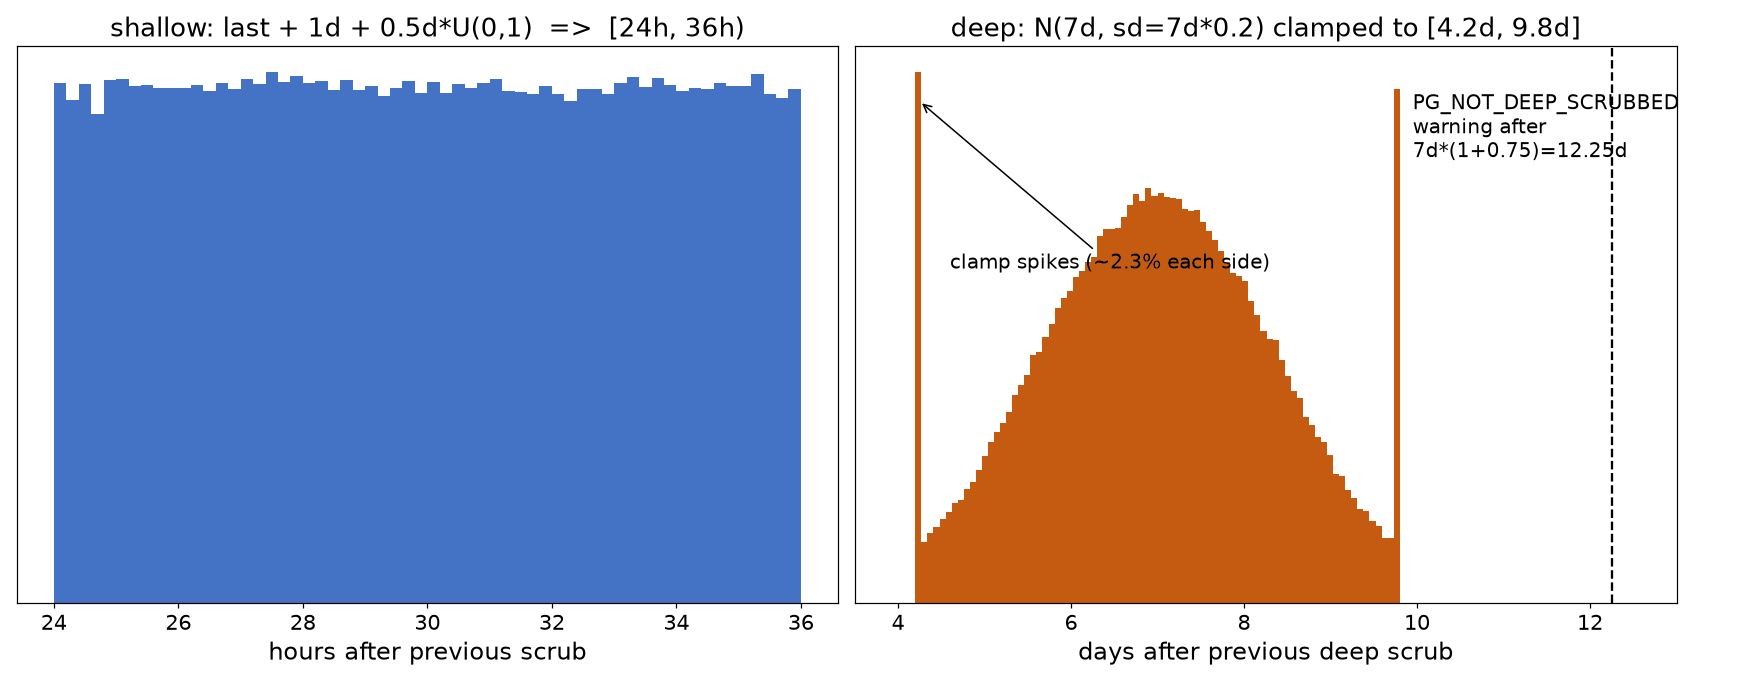
مثال عددی. آخرین deep scrub یک PG دوشنبه ساعت ۱۰ بوده است. sd = ۷×۰.۲ = ۱.۴ روز. با احتمال حدود ۶۸٪ بعدی میان ۵.۶ و ۸.۴ روز بعد است، یعنی از شنبه حدود ساعت ۲۲ تا سهشنبهی هفتهی بعد حدود ساعت ۲۰. هیچوقت زودتر از ۴.۲ روز (جمعه حدود ساعت ۱۵) یا دیرتر از ۹.۸ روز نیست، مگر صف OSD عقب باشد. mon هشدار PG_NOT_DEEP_SCRUBBED را وقتی میدهد که از آخرین deep scrub بیش از I_d × (1 + mon_warn_pg_not_deep_scrubbed_ratio) = ۷ × ۱.۷۵ = ۱۲.۲۵ روز گذشته باشد (PGMap.cc). پس فاصلهی ۹.۸ تا ۱۲.۲۵ روز حاشیهی عقبافتادگی صف است. هشدار مشابه برای shallow با osd_scrub_max_interval × 1.5 = ۱۰.۵ روز محاسبه میشود.
وابسته به نسخه. osd_deep_scrub_interval_cv در شاخههای squid، tentacle و main وجود دارد و osd_deep_scrub_randomize_ratio در توضیح خود «deprecated، بدون اثر» علامت خورده است. در نسخههای قدیمیتر، deep scrub بهصورت تصادفی با احتمال randomize_ratio هنگام shallow scrub رخ میداد. این رفتار حذف شده است.
پرتاب سکه و بار. OsdScrub::scrub_random_backoff با احتمال osd_scrub_backoff_ratio=0.66 کل تلاش آن tick را لغو میکند. اگر tick هر ثانیه باشد، OSD بهطور میانگین در هر ۳ ثانیه یک بار تلاش میکند (۱/(۱−۰.۶۶) ≈ ۲.۹). این کار هزینهی پیمایش صف را کم و شروع scrubها را میان OSDها نامنظم میکند. osd_scrub_load_threshold=10.0 با loadavg تقسیم بر تعداد CPU مقایسه میشود. روی ماشینی با ۳۲ هسته، loadavg باید از ۳۲۰ بیشتر باشد تا scrubهای عادی متوقف شوند. به همین دلیل این گزینه در عمل بهندرت اثر دارد.
۳۲-۲-۲ رزرو منابع#
پیش از شروع، PgScrubber یک خانه از osd_max_scrubs (پیشفرض ۳) روی OSD خودش (inc_scrubs_local) و سپس روی هر replica رزرو میکند (حالت ReservingReplicas). اگر یک replica رد کند، کل رزرو آزاد و PG با تأخیر osd_scrub_retry_delay (۳۰ ثانیه) دوباره صف میشود. از Squid به بعد، replicaها درخواستهای رزرو را صف میکنند و فوراً رد نمیکنند. osd_scrub_disable_reservation_queuing=true رفتار پیش از Squid (پاسخ فوری پذیرش یا رد) را برمیگرداند. طبق توضیح گزینه، این گزینه فقط برای خوشههای با نسخههای مختلف و اشکالزدایی است و در نسخهی بعد حذف میشود.
۳۲-۳ ماشین حالت scrub#
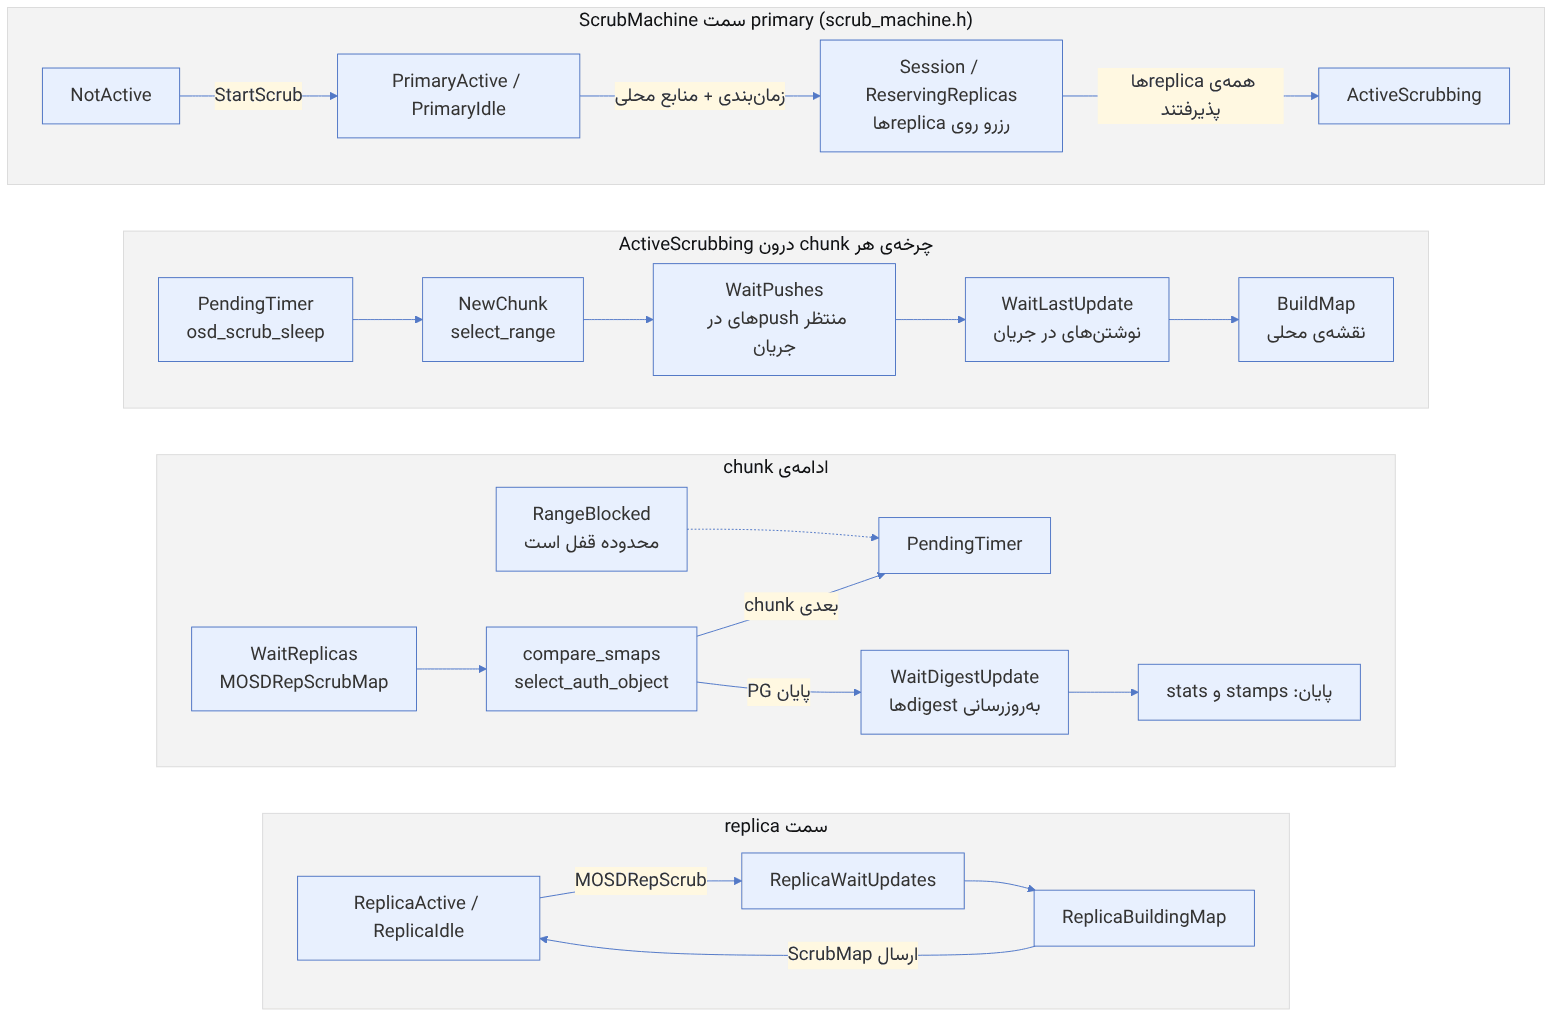
چرا WaitPushes و WaitLastUpdate؟ primary پیش از ساختن نقشهی خودش باید مطمئن شود که pushهای recovery در جریان تمام شدهاند (WaitPushes) و همهی نوشتنهایی که در بازهی chunk پذیرفته شدهاند روی دیسک خودش اعمال شدهاند (WaitLastUpdate، تا last_update_applied برسد). replica هم پیش از ساختن نقشه در ReplicaWaitUpdates میماند تا pushهای در جریانش صفر شوند. فیلد scrub_to در MOSDRepScrub طبق توضیح خود کد دیگر استفاده نمیشود. چون بازه پیش از ارسال قفل شده است، نوشتن تازهای در آن پذیرفته نمیشود. بدون این انتظارها، replica و primary تصویرهای متفاوتی از یک لحظه را مقایسه میکنند و ناسازگاری کاذب گزارش میشود.
۳۲-۳-۱ انتخاب chunk و preemption#
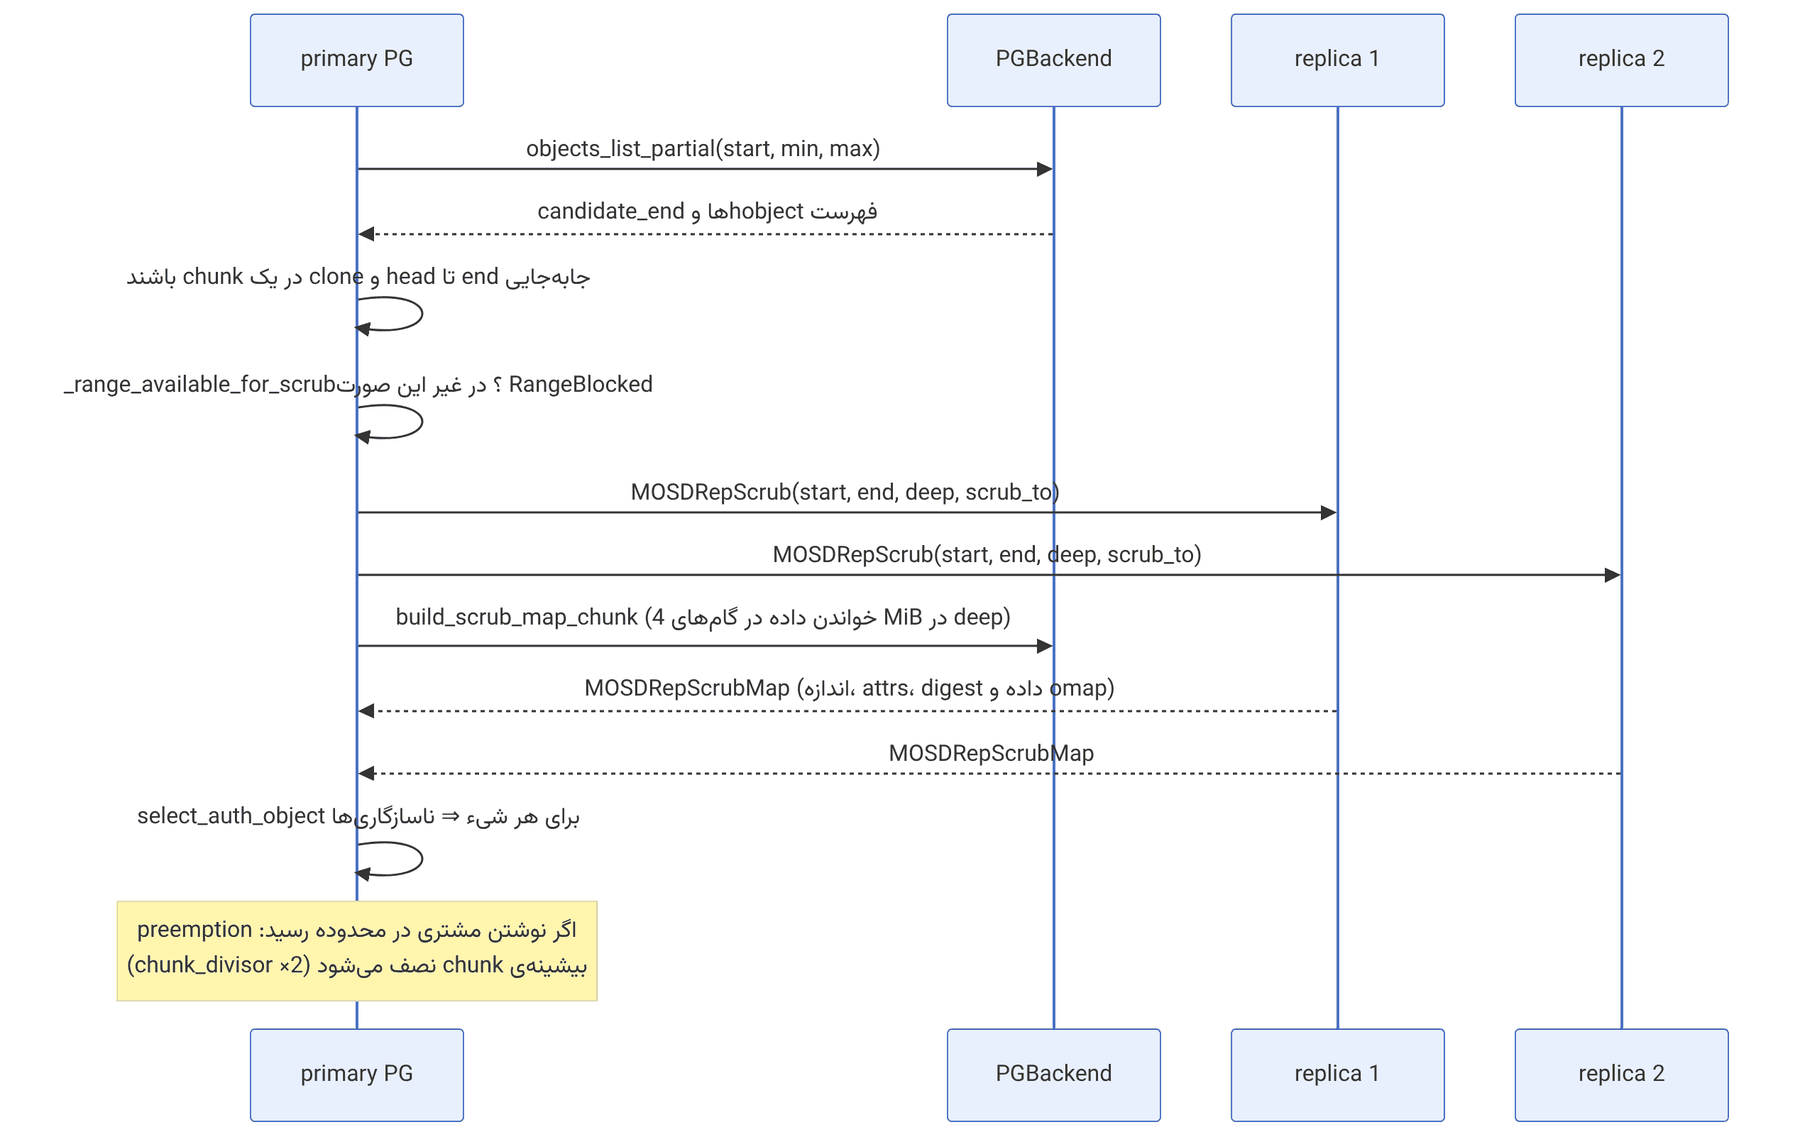
منبع در کد: src/osd/scrubber/pg_scrubber.cc :: PgScrubber::select_range؛ preemption_data_t::adjust_left در pg_scrubber.h
پیچیدگی: O(chunk) برای فهرست کردن؛ کل PG در O(N/chunk) دور
pseudocode
min_sz = max(3, deep ? osd_scrub_chunk_min : osd_shallow_scrub_chunk_min)
max_sz = max(min_sz, (deep ? osd_scrub_chunk_max : osd_shallow_scrub_chunk_max) / divisor)
objects, end = objects_list_partial(start, min_sz, max_sz)
while end.is_head() and end == objects.back().get_head():   # head و cloneها جدا نشوند
    end = objects.pop_back()
if end.is_head(): end = end.get_object_boundary()
if not range_available_for_scrub(start, end): return blocked   # RangeBlocked
on preemption (نوشتن مشتری در بازه): if left > 0: left -= 1; divisor *= 2
مثال عددی. deep scrub با پیشفرضها: min=max(۳,۵)=۵ و max=15. پس از هر preemption، divisor دو برابر میشود: بیشینهی chunk به ترتیب ۱۵، ۷، ۵، ۵، ... (چون ۱۵/۴=۳ کمتر از ۵ است). پس از osd_scrub_max_preemptions=5 بار، preemption دیگری مجاز نیست و نوشتنهای مشتری در آن بازه تا پایان chunk منتظر میمانند. برای shallow: min=50 و max=100 و پس از اولین preemption همهی chunkها ۵۰ شیئیاند. یک PG با ۳۰۰۰ شیء در deep scrub بدون preemption دستکم ۳۰۰۰/۱۵ = ۲۰۰ chunk دارد. اگر osd_scrub_sleep=0.1 باشد، دستکم ۲۰ ثانیه فقط خواب میان chunkهاست.
چرا head و clone با هم؟ clone همیشه «درست سمت چپ» head در ترتیب hobject ساخته میشود. اگر مرز chunk درست روی head باشد، ممکن است clone در chunk قبلی scrub شده و پس از آن clone تازهای ساخته شود که هیچ chunkی آن را نمیبیند. توضیح بالای select_range دقیقاً این را میگوید و حلقهی while آن را جلوگیری میکند.
۳۲-۳-۲ مقایسه و انتخاب نسخهی معتبر#
پس از رسیدن نقشهها، ScrubBackend::scrub_compare_maps برای هر شیء در اجتماع نقشهها select_auth_object را صدا میزند و سپس هر shard را با نسخهی معتبر مقایسه میکند (compare_obj_in_maps و compare_obj_details): اندازه، object_info، snapset، attrها، data_digest و omap_digest.
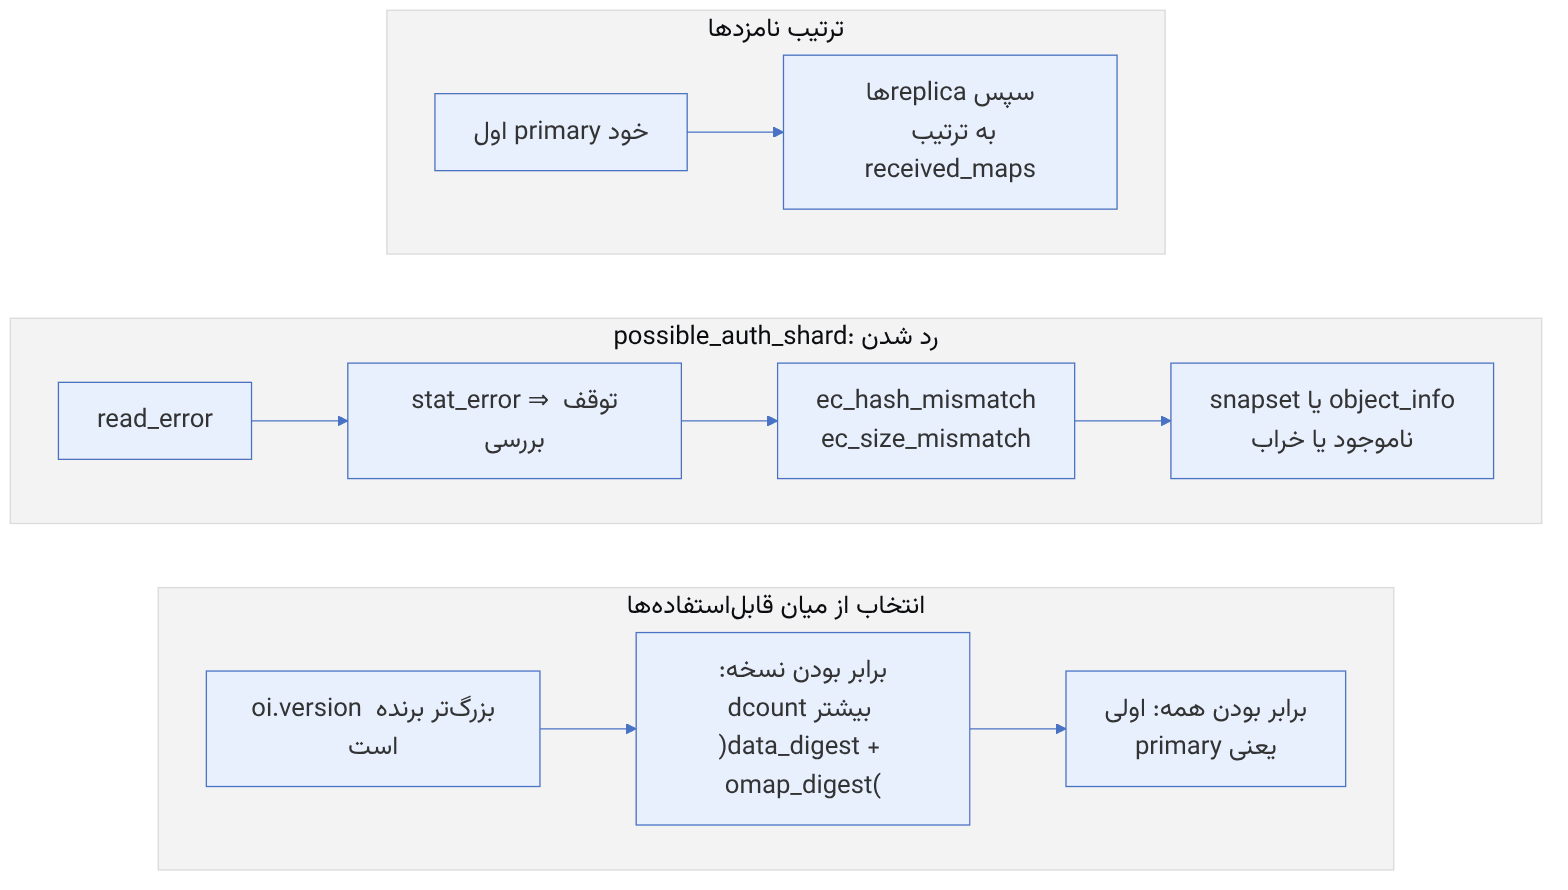
منبع در کد: src/osd/scrubber/scrub_backend.cc :: ScrubBackend::select_auth_object و possible_auth_shard
پیچیدگی: O(S) برای S shard در هر شیء؛ کل chunk O(S × objects)
pseudocode
shards = [primary] + others
for s in shards:
    r = possible_auth_shard(obj, s)          # خطاهای read/stat/ec/oi/snapset
    if r.unusable: record error; continue
    if auth is none or r.oi.version > auth.version
       or (r.oi.version == auth.version and dcount(r.oi) > dcount(auth.oi)):
         auth = s
    if digests of s and auth differ: digest_match = false
dcount(oi) = [data_digest present] + [omap_digest present]
مثال عددی. شیء rbd_data.abc.0000000000000012 روی سه shard. primary (osd.۴): oi.version = ۸۱۲'۵۵۳۰ و هر دو digest ثبت شدهاند. osd.9: همان نسخه، فقط data_digest ثبت شده است. osd.11: خطای خواندن (EIO از BlueStore به خاطر ناهمخوانی checksum). نتیجه: osd.11 کنار گذاشته و در shard_info با read_error علامت میخورد. میان osd.4 و osd.9 نسخه برابر است، اما dcount(osd.۴)=۲ > dcount(osd.۹)=۱، پس osd.4 معتبر است. اگر digest دادهی osd.9 با osd.4 فرق کند، ناسازگاری data_digest_mismatch برای osd.9 هم ثبت میشود. خروجی rados list-inconsistent-obj همین ساختار را نشان میدهد.
digest در deep scrub. در deep scrub، هر شیء در گامهای osd_deep_scrub_stride (۴ MiB) خوانده و crc32c آن بهصورت پیوسته محاسبه میشود. omap در دستههای osd_deep_scrub_keys (۱۰۲۴ کلید) پیمایش و digest آن ساخته میشود. اگر شیء digest ذخیرهشده در object_info داشته باشد، مقدار محاسبهشده با آن هم مقایسه میشود. در غیر این صورت، اگر شیء از osd_deep_scrub_update_digest_min_age قدیمیتر باشد، در WaitDigestUpdate digest ثبت میشود. در EC، هر shard hash خودش را دارد و بررسی ناسازگاری در check_ec_stripe_digests در سطح stripe انجام میشود (برای جزئیات ریاضی EC فصل ۲۷ را ببینید).
۳۲-۴ recovery و backfill#
۳۲-۴-۱ از peering تا رزرو#
پس از peering (فصل ۱۷)، primary میداند کدام shardها شیء گمشده دارند (peer_missing) و کدام shardها کل محتوا را نیاز دارند (backfill_targets، چون log آنها با log معتبر همپوشانی ندارد). PG در Active وارد زیرماشینی میشود که در شکل زیر آمده است.
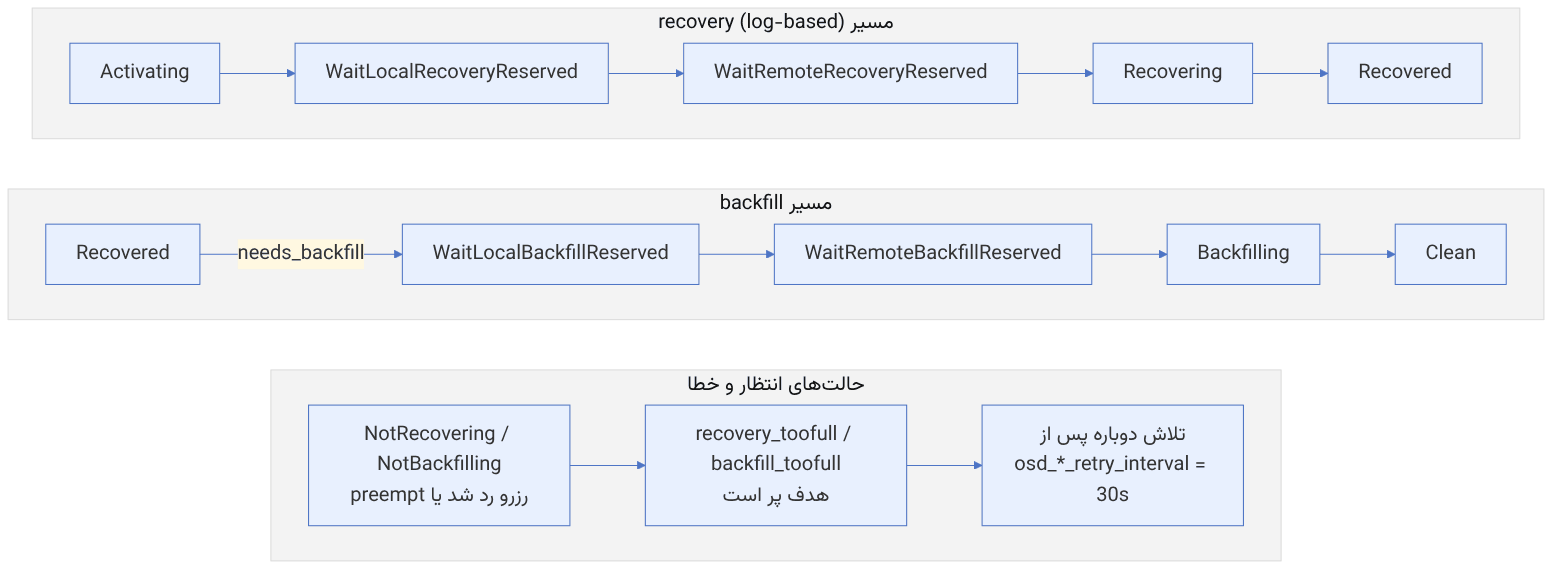
۳۲-۴-۲ اولویت رزرو#
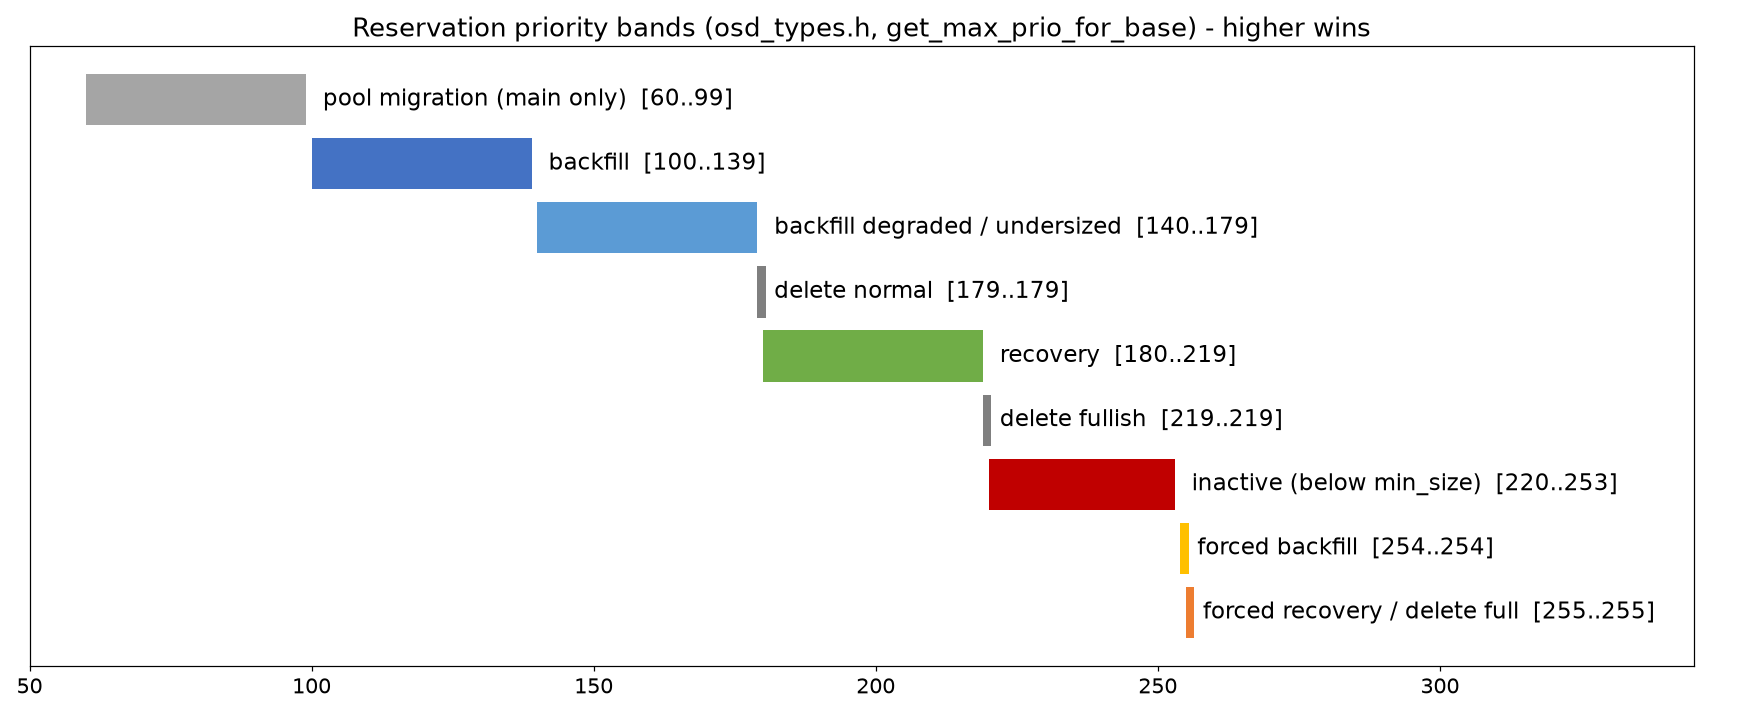
منبع در کد: src/osd/PeeringState.cc :: get_recovery_priority، get_backfill_priority، clamp_recovery_priority
پیچیدگی: O(n) برای شمارش acting در برابر min_size
pseudocode
backfill:
if FORCED_BACKFILL: return 254
below = num_acting_below_min_size(pool, acting)
if below: base = 220; p = 220 + below
elif undersized: base = 140; p = 140 + (size − |actingset|)
elif degraded: base = p = 140
else: base = p = 100
recovery:
if FORCED_RECOVERY: return 255
base = p = 180; if degraded and below(avail_no_missing): base = 220; p = 220 + below
clamp(p, pool_prio, max_for_base):
pool_prio = clamp(pool_prio, −10, +10) + 10 # جابهجایی به 0..20
return clamp(p + pool_prio, 0, max_for_base)مثال عددی. pool تکراری با size=3 و min_size=2 و recovery_priority پیشفرض صفر را در نظر بگیرید:
| وضعیت PG | پایه | محاسبه | اولویت نهایی |
|---|---|---|---|
| backfill عادی (جابهجایی پس از افزودن OSD) | ۱۰۰ | ۱۰۰ + (۰+۱۰) | ۱۱۰ |
| backfill با undersized: ۲ از ۳ در acting | ۱۴۰ | ۱۴۰ + ۱ + ۱۰ | ۱۵۱ |
| recovery معمولی | ۱۸۰ | ۱۸۰ + ۱۰ | ۱۹۰ |
| recovery با فقط ۱ shard سالم (کمتر از min_size) | ۲۲۰ | ۲۲۰ + ۱ + ۱۰ | ۲۳۱ |
| همان با recovery_priority=10 برای pool | ۲۲۰ | ۲۲۰ + ۱ + ۲۰ | ۲۴۱ |
| backfill عادی با recovery_priority=10 اما سقف پایه | ۱۰۰ | ۱۰۰ + ۲۰ = ۱۲۰ ≤ ۱۳۹ | ۱۲۰ |
نکتهی ظریف این است که حتی با recovery_priority=0، جابهجایی +۱۰ همیشه اعمال میشود، چون بازهی −۱۰ تا +۱۰ به ۰ تا ۲۰ منتقل میشود. سقفهای هر پایه تضمین میکنند که حتی بیشترین اولویت pool، یک backfill عادی (حداکثر ۱۳۹) را از یک backfill دچار کمبود replica (دستکم ۱۴۰) جلو نیندازد.
وابسته به نسخه. پایهی OSD_POOL_MIGRATION_PRIORITY_BASE=60 و حالتهای MigratingSource و MigratingTarget در main برای قابلیت مهاجرت pool وجود دارند، اما در شاخههای squid و tentacle دیده نمیشوند.
۳۲-۴-۳ AsyncReserver: رزرو با preemption#
هر OSD دو رزروکننده دارد: local_reserver (برای PGهایی که این OSD primary آنهاست) و remote_reserver (برای PGهایی که این OSD هدف آنهاست). سقف هر دو osd_max_backfills است (پیشفرض ۱). با زمانبند mClock، تغییر این گزینه فقط وقتی اثر دارد که osd_mclock_override_recovery_settings=true باشد (OSD::maybe_override_options_for_qos). در غیر این صورت، تغییر از پایگاه پیکربندی پاک میشود.
منبع در کد: src/common/AsyncReserver.h :: AsyncReserver::do_queues و preempt_one
پیچیدگی: O(log P) برای P سطح اولویت در هر اعطا
pseudocode
queues: map<prio, list<Reservation>>; in_progress; preempt_by_prio: set<(prio, item)>
do_queues():
while preempt_by_prio not empty and (|in_progress| > max_allowed or min(preempt_by_prio).prio < min_priority):
preempt_one() # کماولویتترین قابلpreempt
while queues not empty:
(prio, list) = highest
if prio < min_priority: break
if |in_progress| ≥ max_allowed and preempt_by_prio not empty and prio > min(preempt_by_prio).prio:
preempt_one()
if |in_progress| ≥ max_allowed: break
grant(list.pop_front()); if preemptible: preempt_by_prio.insert(prio, item)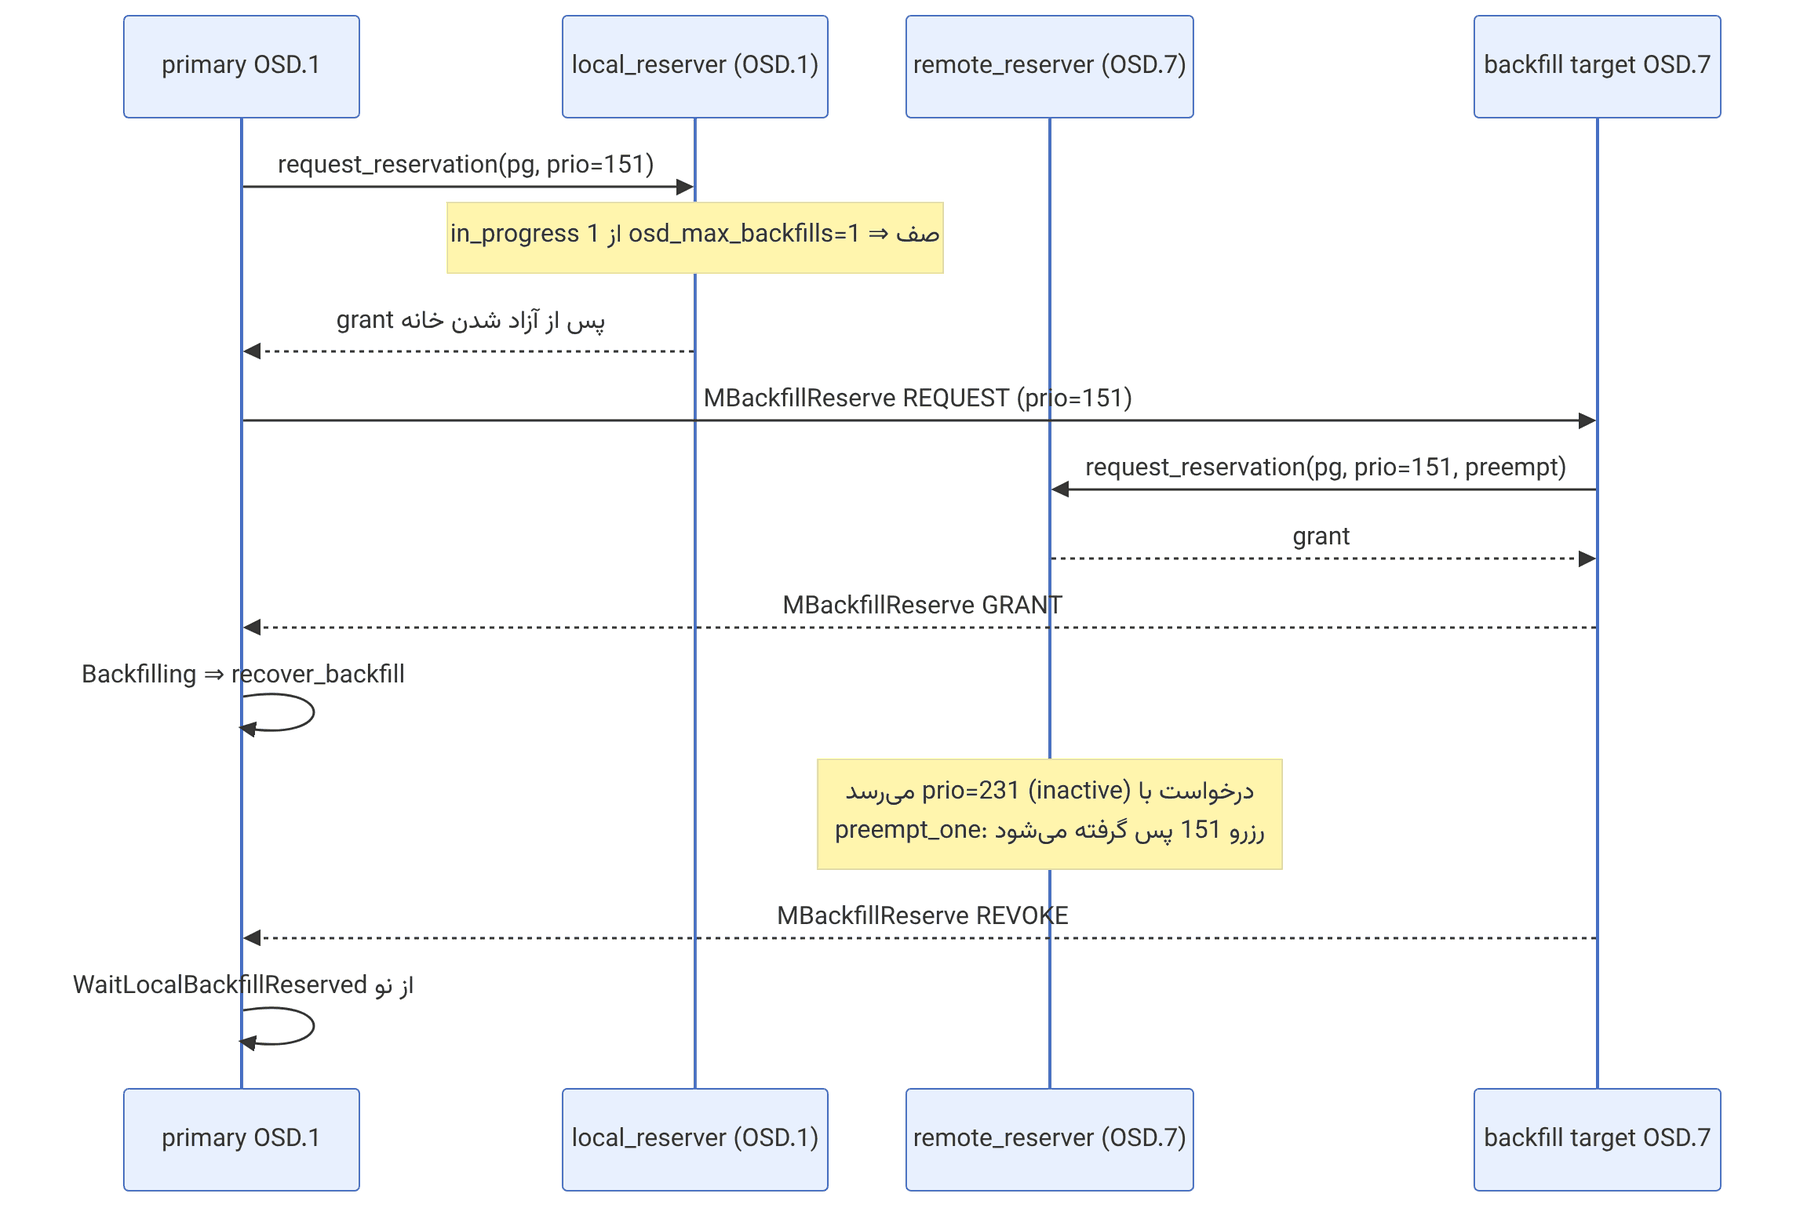
مثال عددی. osd.7 هدف backfill برای PGی با اولویت ۱۵۱ است و تنها خانهی remote_reserver (max=1) را گرفته است. PG دیگری که فقط یک shard سالم دارد (اولویت ۲۳۱) از osd.7 رزرو میخواهد. در do_queues، بالاترین صف ۲۳۱ است، in_progress پر است و ۲۳۱ > ۱۵۱، پس preempt_one رزرو ۱۵۱ را پس میگیرد. primary آن PG پیام REVOKE دریافت میکند و به WaitLocalBackfillReserved برمیگردد. رزرو ۲۳۱ فوراً اعطا میشود. این همان سازوکاری است که اجازه میدهد PGهای غیرفعال بدون منتظر ماندن برای backfillهای طولانی بازیابی شوند.
۳۲-۴-۴ recovery بر پایهی log و async recovery#
در recovery، primary فهرست missing هر shard را دارد و اشیا را به ترتیب نسخه بازیابی میکند: اول اشیای گمشدهی خودش را pull میکند (recover_primary)، سپس به replicaها push میکند (recover_replicas). شمار عملیات همزمان با osd_recovery_max_active_hdd=3 و osd_recovery_max_active_ssd=10 محدود است. هر push حداکثر osd_recovery_max_chunk=8M داده دارد. در async recovery، shardی که فاصلهی زیادی دارد از acting بیرون گذاشته میشود تا نوشتنها منتظر آن نمانند، و در پسزمینه بازیابی میشود.
منبع در کد: src/osd/PeeringState.cc :: PeeringState::choose_async_recovery_replicated
پیچیدگی: O(n log n) برای n عضو want
pseudocode
for osd in want (up و غیر stray):
    cost = |auth.last_update.version − osd.last_update.version| + osd.stats.num_objects_missing
    if cost > osd_async_recovery_min_cost (100): candidates.add(cost, osd)
for (cost, osd) in candidates از بیشترین هزینه:
    w = want − {osd}
    if acting_set_writeable(pool, w): want = w; async_recovery.add(osd)
مثال عددی. want=[1، ۲، ۳]، size=3، min_size=2. last_update.version معتبر ۵۰۰۰ است. osd.2 در نسخهی ۴۹۹۰ است و هیچ شیء گمشدهای ندارد، پس هزینهاش ۱۰ است و نامزد نیست. osd.3 در نسخهی ۴۸۰۰ است با ۳۰ شیء گمشدهی تاریخی، پس هزینهاش ۲۳۰ > ۱۰۰ است. [۱، ۲] هنوز قابل نوشتن است، پس osd.3 هدف async recovery میشود و acting [۱، ۲] است. نوشتنهای مشتری با دو نسخه تأیید میشوند، و پس از پایان recovery osd.3 دوباره به acting برمیگردد. اگر osd.2 هم هزینهی بالای ۱۰۰ داشت، حذف دومی [۱] را میساخت که از min_size کمتر است و انجام نمیشد.
۳۲-۴-۵ backfill: ادغام دو فهرست مرتب#
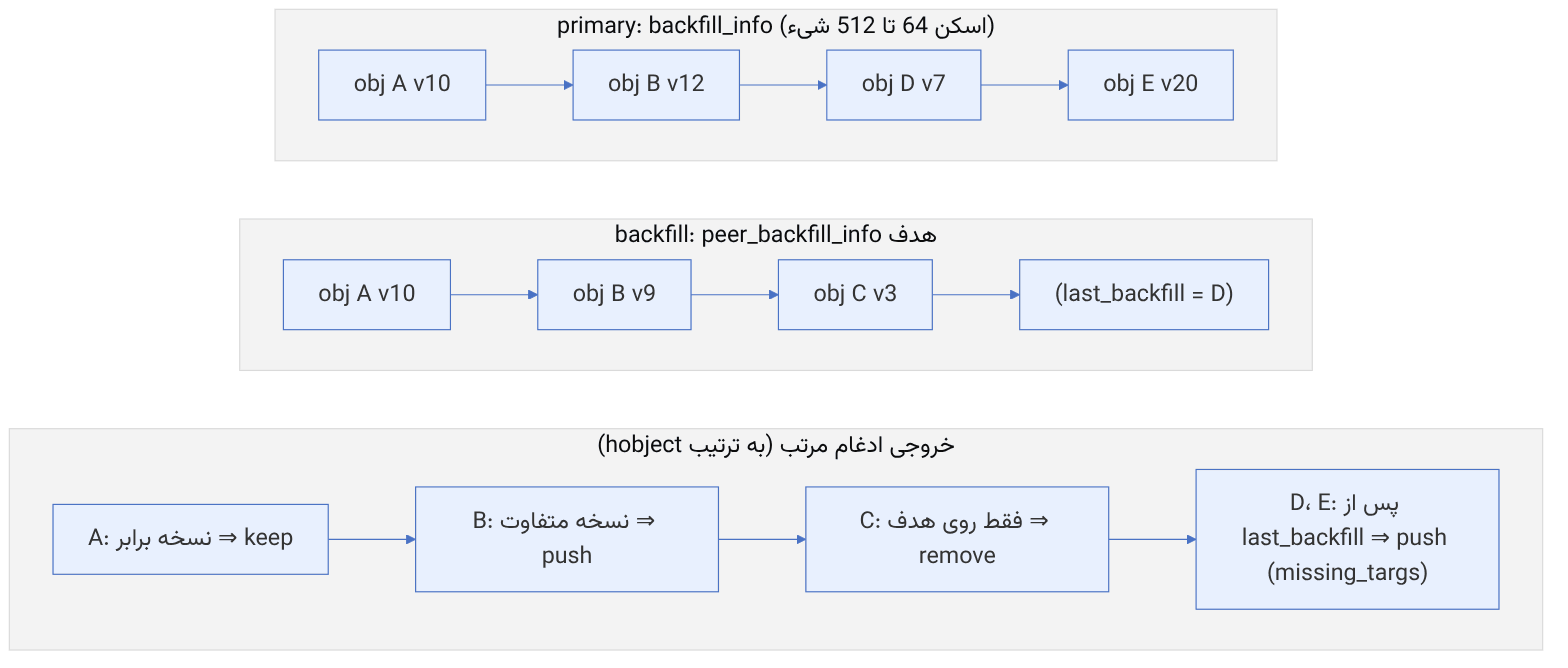
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::recover_backfill، scan_range، prep_backfill_object_push
پیچیدگی: O(N + M) مقایسه برای N شیء primary و M شیء هدف؛ حافظه O(scan_max)
pseudocode
while ops < max:
    refill backfill_info / peer intervals if exhausted (MOSDPGScan for replicas)   # یک op
    check = min(backfill_info.begin, min over targets of pbi.begin)
    if check < backfill_info.begin:                 # فقط روی هدف(ها)
        for t with pbi.begin == check: to_remove.add(check, t); pbi.pop_front()
    else:                                           # شیء primary
        for t in targets:
            if pbi.begin == check: (version differs ? need_ver : keep_ver).add(t)
            elif check > peer_info[t].last_backfill: missing.add(t)
        if need_ver or missing: prep_backfill_object_push(check, need_ver ∪ missing); ops++
        pop check from backfill_info and matching pbi
    last_backfill_started = check
send MOSDPGBackfill(progress, last_backfill) periodically
برآورد زمان. یک PG با ۵۰ GiB داده در اشیای ۴ MiB (۱۲۸۰۰ شیء) را روی یک هدف HDD در نظر بگیرید که push هر شیء را با حدود ۱۰۰ MB/s مینویسد. هر شیء حدود ۴۲ میلیثانیه طول میکشد. با یک PG همزمان (osd_max_backfills=1)، کل backfill حدود ۱۲۸۰۰ × ۰.۰۴۲ ≈ ۵۳۷ ثانیه، یعنی حدود ۹ دقیقه، طول میکشد. اگر osd_recovery_sleep_hdd=0.1 میان opها اعمال شود (با زمانبند wpq؛ با mClock، زمانبند هزینه را کنترل میکند)، ۱۲۸۰۰ × ۰.۱ = ۱۲۸۰ ثانیهی دیگر اضافه میشود. جمع حدود ۳۰ دقیقه است. این نشان میدهد چرا با HDD، backfill یک OSD کامل با صدها PG ساعتها طول میکشد.
۳۲-۵ repair#
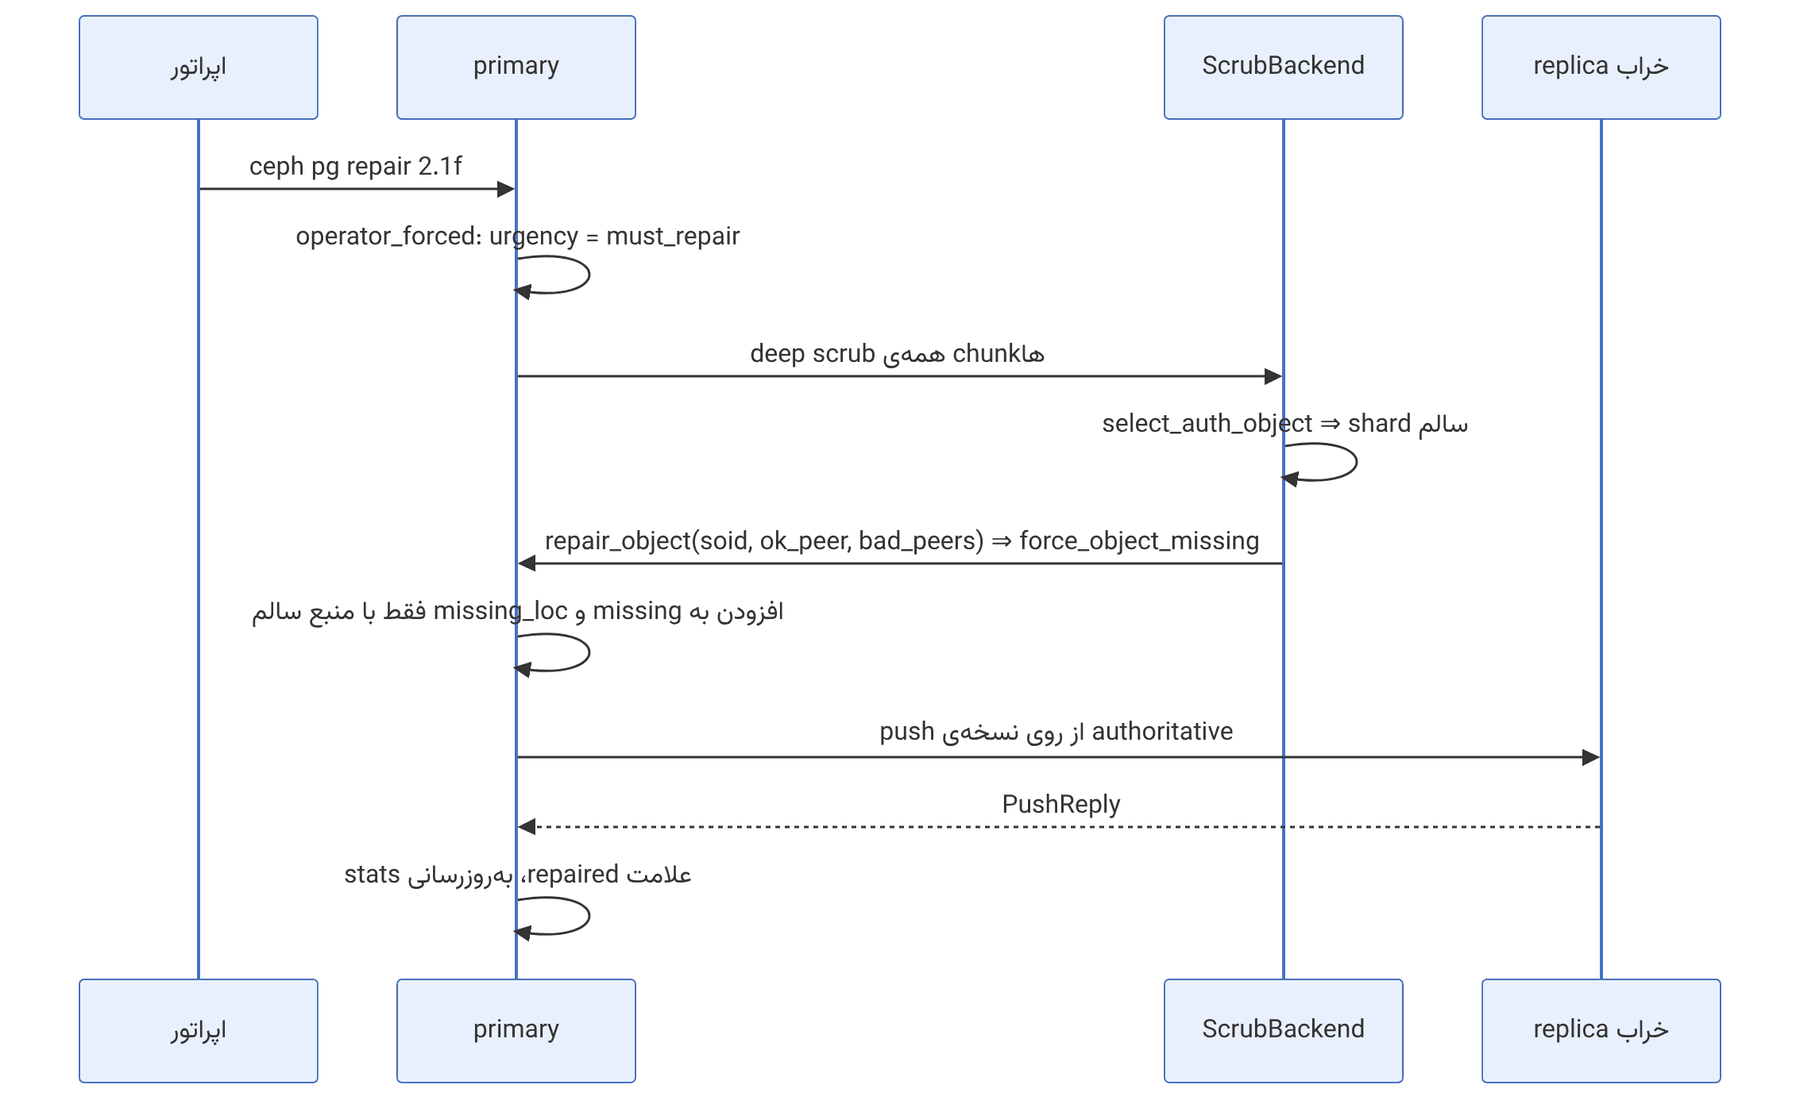
نکتهی کلیدی این است که repair سازوکار جداگانهای برای کپی داده ندارد. همان recovery است که با فهرست missing ساختگی تغذیه میشود. بنابراین همهی محدودیتهای recovery (رزرو، max_active و اولویت) روی repair هم اعمال میشوند. اگر هیچ shard قابلاستفادهای نباشد (مثلاً همه خطای خواندن دارند)، repair کاری نمیتواند بکند و شیء «unfound» میماند. باید با ceph pg PGID mark_unfound_lost revert|delete تصمیم گرفت.
| گزینه | پیشفرض (main) | اثر |
|---|---|---|
| osd_scrub_auto_repair | false | اگر true باشد، scrub دورهای خطاها را خودکار repair میکند |
| osd_scrub_auto_repair_num_errors | ۵ | اگر خطاها بیشتر باشد، auto repair انجام نمیشود |
| osd_max_scrubs | ۳ | scrubهای همزمان روی یک OSD |
| osd_scrub_during_recovery | false | اجازهی scrub وقتی PGهای OSD در recovery هستند |
| osd_scrub_retry_delay | ۳۰ | تأخیر تلاش دوباره پس از شکست |
| osd_recovery_max_active_hdd / _ssd | ۳ / ۱۰ | عملیات recovery همزمان در هر OSD |
| osd_backfill_scan_min / max | ۶۴ / ۵۱۲ | اندازهی اسکن backfill |
| osd_async_recovery_min_cost | ۱۰۰ | حد هزینه برای async recovery |
خطای رایج. فرمان ceph pg repair را بدون بررسی rados list-inconsistent-obj PGID --format=json-pretty اجرا نکنید. اگر ناسازگاری از نوع omap_digest_mismatch روی primary باشد و primary به اشتباه معتبر انتخاب شود، repair نسخهی خراب را روی replicaها پخش میکند. منطق انتخاب نسخهی معتبر در تساوی نسخه به primary اولویت میدهد. در موارد مشکوک، اول OSD خراب را بیرون بگذارید یا با ceph-objectstore-tool نسخه را دستی بررسی کنید.
۳۲-۶ فرمانها و اشکالزدایی#
ceph pg deep-scrub 2.1f # درخواست اپراتور (فوریت operator_requested)
ceph tell osd.4 dump_scrubs # صف scrub این OSD: هدفها، not_before و فوریت
ceph tell osd.4 dump_scrub_reservations # رزروهای محلی و راه دور
rados list-inconsistent-obj 2.1f --format=json-pretty
ceph pg 2.1f query | jq '.recovery_state' # حالت فعلی ماشین peering/recovery
ceph tell osd.4 dump_recovery_reservations # local_reserver و remote_reserver
ceph config set osd debug_osd 20/20 # موقت؛ پیامهای select_range و do_queuesاگر PG مدت زیادی در backfill_wait مانده است: (۱) dump_recovery_reservations را روی primary و هدف ببینید. معمولاً یک PG دیگر خانهی تنهای osd_max_backfills را گرفته است. (۲) اولویت را با ceph pg PGID query بررسی کنید. (۳) برای فوریت، ceph pg force-backfill PGID اولویت را به ۲۵۴ میبرد. اما اگر برای بسیاری از PGها این کار را بکنید، اولویتبندی بیمعنا میشود.
۳۲-۷ تکمیلی و بهروز#
- در Squid، کد scrub بازسازی شد: صف رزرو replica، دو هدف جدا برای shallow و deep در ScrubJob و گزینهی cv برای deep. فرمانهای
dump_scrubs در نسخههای قدیمیتر ساختار خروجی متفاوتی داشتند. - در main،
ScrubBackend بررسی stripe در EC را با ec_stripe_mismatches و find_corrupt_zone_copies گسترش داده است که با FastEC (فصل ۲۷) مرتبط است. پیش از تکیه بر جزئیات خروجی ناسازگاری EC، نسخهی خود را بررسی کنید. - Crimson (فصل ۳۰) backfill را با یک ماشین حالت جدا (
BackfillState در src/crimson/osd/backfill_state.cc) پیاده میکند. منطق ادغام همان است.
۳۲-۸ تمرین عملی#
- ۱. با vstart یک pool با size=3 بسازید، شیئی بنویسید و با
ceph-objectstore-tool روی یک replica آن را خراب کنید. deep scrub و خروجی list-inconsistent-obj را ببینید و توضیح دهید چرا آن shard انتخاب نشد. - ۲.
osd_scrub_sleep=0.5 بگذارید و زمان deep scrub یک PG هزارشیئی را پیشبینی و اندازهگیری کنید. - ۳. با
ceph osd out روی یک OSD، اولویت backfill PGهای undersized را از pg query بخوانید و با جدول این فصل مقایسه کنید. - ۴. با
debug_osd=20، پیامهای do_queues و preempt_one را هنگام همزمانی یک PG غیرفعال و یک backfill عادی پیدا کنید.
۳۲-۹ پرسشهای مرور#
- ۱. زمان scrub بعدی shallow و deep با پیشفرضها در چه بازهای است و چرا توزیع deep در لبهها قله دارد؟
- ۲. هشدار PG_NOT_DEEP_SCRUBBED دقیقاً پس از چه مدتی داده میشود؟
- ۳. چرا chunk scrub نباید head را از cloneهایش جدا کند؟
- ۴. پس از سه preemption در deep scrub، بیشینهی اندازهی chunk چقدر است؟
- ۵. در select_auth_object، اگر نسخهها برابر باشند، چه معیاری برنده را تعیین میکند؟
- ۶. اولویت backfill یک PG undersized با size=3 و دو عضو acting چقدر است؟
- ۷. چرا حتی با recovery_priority=0 اولویت ۱۰ واحد بالا میرود؟
- ۸. AsyncReserver در چه شرطی یک رزرو در جریان را پس میگیرد؟
- ۹. async recovery چه هدفی را از acting بیرون میگذارد و چه شرطی آن را محدود میکند؟
- ۱۰. چرا repair همان محدودیتهای recovery را دارد؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۲-۱۰ منابع این فصل#
- scrub در مستند Ceph
https://docs.ceph.com/en/latest/rados/configuration/osd-config-ref/#scrubbing - مستند توسعهدهندهی scrub
https://docs.ceph.com/en/latest/dev/osd_internals/scrub/ - رزرو و اولویت backfill
https://docs.ceph.com/en/latest/dev/osd_internals/backfill_reservation/ - recovery در مستند توسعهدهنده
https://docs.ceph.com/en/latest/dev/osd_internals/recovery_reservation/ - کد scrubber
https://github.com/ceph/ceph/tree/main/src/osd/scrubber - PeeringState
https://github.com/ceph/ceph/blob/main/src/osd/PeeringState.cc - AsyncReserver
https://github.com/ceph/ceph/blob/main/src/common/AsyncReserver.h - PrimaryLogPG
https://github.com/ceph/ceph/blob/main/src/osd/PrimaryLogPG.cc - گزینههای OSD
https://github.com/ceph/ceph/blob/main/src/common/options/osd.yaml.in - عیبیابی PG و repair ناسازگاریها
https://docs.ceph.com/en/latest/rados/troubleshooting/troubleshooting-pg/