بخش تخصصی (۲): RADOS — pg log، intervalها، missing و سازوکار recovery و backfill
حوصله ندارم این فصل در چند خط
-
pg_info_t و pg_history_t آخرین بهروزرسانی PG و epochهای intervalهای آن را ثبت میکنند. - past intervals مجموعهی prior را میدهد: OSDهایی که شاید نوشتنی را نگه داشته باشند و باید در peering پرسیده شوند.
- primary معتبرترین log را انتخاب و ادغام میکند؛ missing setها فهرست چیزهایی است که هر عضو باید بازیابی کند.
- عضوی که log مشترک ندارد به جای recovery مبتنی بر log، backfill میشود؛ طول log (و trim آن) حافظه را با سرعت بازیابی معاوضه میکند.
۳۵-۱ پیش از شروع#
فصل ۱۷ ماشین حالت peering و انتخاب info معتبر را نشان داد و فصل ۳۲ رزرو و زمانبندی recovery را. این فصل لایهی میانی را باز میکند: PG چگونه میفهمد کدام OSDها را باید بپرسد (past intervals و prior set)، log دو OSD چگونه ادغام میشود، با ورودیهای divergent چه میکند، missing set چگونه ساخته میشود، log چه زمانی و چقدر trim میشود، و recovery و backfill در عمل شیء به شیء چه کار میکنند. نام توابع و پیشفرضها با شاخهی main مخزن ceph/ceph (نوامبر ۲۰۲۶) تطبیق داده شده است.
۳۵-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
- چه تغییری در OSDMap یک interval تازه میسازد و
maybe_went_rw چگونه تعیین میشود؟ - PG چرا گاهی
down میشود و blocked_by در ceph pg query (فیلد peering_blocked_by) چه میگوید؟ -
merge_log با log جلوتر یا عقبتر یک peer چه میکند؟ - ورودی divergent چیست و پنج حالت رسیدگی به آن کداماند؟
- طول pg log چگونه تعیین میشود و چه چیزی جلوی trim را میگیرد؟
- چه زمانی recovery بر پایهی log کافی است و چه زمانی backfill لازم میشود؟
- backfill اشیا را چگونه مقایسه و منتقل میکند؟
۳۵-۱-۲ پیشنیاز#
فصل ۱۷ (peering)، فصل ۳۲ (scrub و recovery) و فصل ۳۴ (pg log روی دیسک و نسخهها).
۳۵-۲ info و history یک PG#
هر عضو PG یک pg_info_t دارد. فیلدهای کلیدی:
| فیلد | معنی |
|---|---|
last_update | آخرین نسخهای که در log این عضو هست |
last_complete | تا این نسخه همهی اشیا روی همین عضو کاملاند (هیچ missing قدیمیتری نیست) |
log_tail | قدیمیترین ورودی log |
last_backfill | اشیای بزرگتر از این (در ترتیب hobject_t) ممکن است روی این عضو نباشند؛ MAX یعنی backfill لازم نیست |
last_epoch_started | آخرین epochی که PG روی این عضو active شد |
purged_snaps | snapهایی که پاکسازی آنها تمام شده است (فصل ۳۶) |
history | یک pg_history_t مشترک میان اعضا |
pg_history_t تاریخچهی PG را در سطح epoch نگه میدارد: epoch_created، same_interval_since (از کی up و acting تغییر نکرده)، same_up_since، same_primary_since، last_epoch_started و last_interval_started (آخرین باری که PG در هر جایی active شد)، last_epoch_clean و last_interval_clean، و زمانهای scrub.
last_update و last_complete دو مفهوم جدا هستند. یک replica ممکن است log را تا 1462'93 داشته باشد (last_update) ولی شیء A که در 1462'80 نوشته شده هنوز روی دیسکش نباشد. در این حالت last_complete 1462'79 است و A در missing set آن عضو است.
۳۵-۳ past intervals و prior set#
۳۵-۳-۱ interval تازه چه زمانی شروع میشود؟#
یک interval بازهای از epochهاست که در آن نقشهی PG ثابت بوده است. PastIntervals::is_new_interval در هر نقشهی جدید بررسی میکند که آیا یکی از اینها تغییر کرده است یا نه: primary یا مجموعهی acting، primary یا مجموعهی up، size یا min_size pool، split یا merge (و حالتهای pending آنها)، sort_bitwise، recovery_deletes، پارامترهای stretch در CRUSH (crush_count، crush_target، crush_barrier، crush_member)، روشن شدن بهینهسازیهای EC و در شاخهی main ورود یا خروج PG از مهاجرت pool. پس عوض شدن min_size بهتنهایی هم peering میآورد.
منبع در کد: src/osd/osd_types.cc :: PastIntervals::is_new_interval، PastIntervals::check_new_interval
پیچیدگی: O(n) برای n عضو acting در هر نقشهی جدید
pseudocode
check_new_interval(old, new, same_interval_since, last_epoch_clean):
if not is_new_interval(old, new): return false
i = interval(first = same_interval_since, last = new_epoch - 1,
acting = old_acting, up = old_up, primary = old_primary)
if acting non-empty and primary != -1 and acting_set_writeable(old pool, old acting)
and could_have_gone_active(acting shards):
if up_thru[primary] >= i.first and up_from[primary] <= i.first:
i.maybe_went_rw = true # primary خبر up_thru را به mon رسانده بود
elif i.first <= last_epoch_clean <= i.last:
i.maybe_went_rw = true # PG در این بازه clean شده، پس نوشتن داشته
else: i.maybe_went_rw = false
else: i.maybe_went_rw = false # acting کوچکتر از min_size
past_intervals.add_interval(i)نقش up_thru حیاتی است. primary پیش از active شدن با MOSDAlive از mon میخواهد up_thru او را دستکم تا epoch جاری بالا ببرد. اگر یک interval حتی آنقدر طول نکشیده باشد که up_thru ثبت شود، primary نمیتوانسته active شود و هیچ نوشتنی در آن رخ نداده است. پس peering بعدی لازم نیست منتظر اعضای آن interval بماند.
۳۵-۳-۲ prior set و حالت down#
PastIntervals::PriorSet فهرست OSDهایی است که primary باید از آنها info و log بگیرد. همهی اعضای up و acting فعلی و همهی اعضای intervalهای گذشته که اکنون up هستند در probe قرار میگیرند. سپس برای هر interval با maybe_went_rw از last_epoch_started به این سو:
منبع در کد: src/osd/osd_types.h :: PastIntervals::PriorSet::PriorSet؛ src/osd/osd_types.cc :: PastIntervals::iterate_mayberw_back_to
پیچیدگی: O(I × n) برای I interval و n عضو
pseudocode
for interval in past_intervals where maybe_went_rw, newest → last_epoch_started:
up_now = {osd in interval.acting | osd is UP now or marked LOST}
candidate_blocked_by = {osd in interval.acting | osd is DOWN now}
if not recoverable(up_now) and candidate_blocked_by not empty:
pg_down = true # ممکن است دادهای فقط روی آنها باشد
blocked_by += candidate_blocked_by
# recoverable: replicated → دستکم یک عضو ; EC → دستکم k shard متمایزمثال عددی. PG ۳.۱f با size=3 و min_size=2 در interval [۱۴۰۰, ۱۴۴۹] روی [۱۲,۴,۲۷] بوده است. در epoch ۱۴۵۰ هر دو OSD 4 و ۲۷ از کار افتادهاند و acting به [۱۲] رسید. چون یک عضو کمتر از min_size است، interval [۱۴۵۰, ۱۴۶۰] نوشتنی نداشته است (maybe_went_rw=false). حالا در epoch ۱۴۶۱ خود osd.12 هم down شد و ۴ و ۲۷ برگشتند. interval [۱۴۰۰, ۱۴۴۹] نوشتنی بوده و اعضای up آن ۴ و ۲۷ هستند؛ برای replicated یک عضو کافی است، پس PG down نمیشود. اما اگر فقط osd.12 از این interval زنده مانده بود و آن هم اکنون down بود، pg_down=true و blocked_by: [12] میشد. راه برونرفت یا برگرداندن osd.12 است یا اعلام ceph osd lost 12 که پذیرش از دست رفتن دادههای احتمالی است.
مثال (بخشی از ceph pg 3.1f query):
"recovery_state": [ { "name": "Started/Primary/Peering/Down",
    "comment": "not enough up instances of this PG to go active" },
  { "name": "Started/Primary/Peering",
    "probing_osds": [ "4", "27" ],
    "blocked": "peering is blocked due to down osds",
    "down_osds_we_would_probe": [ 12 ],
    "peering_blocked_by": [ { "osd": 12, "current_lost_at": 0,
        "comment": "starting or marking this osd lost may let us proceed" } ] } ]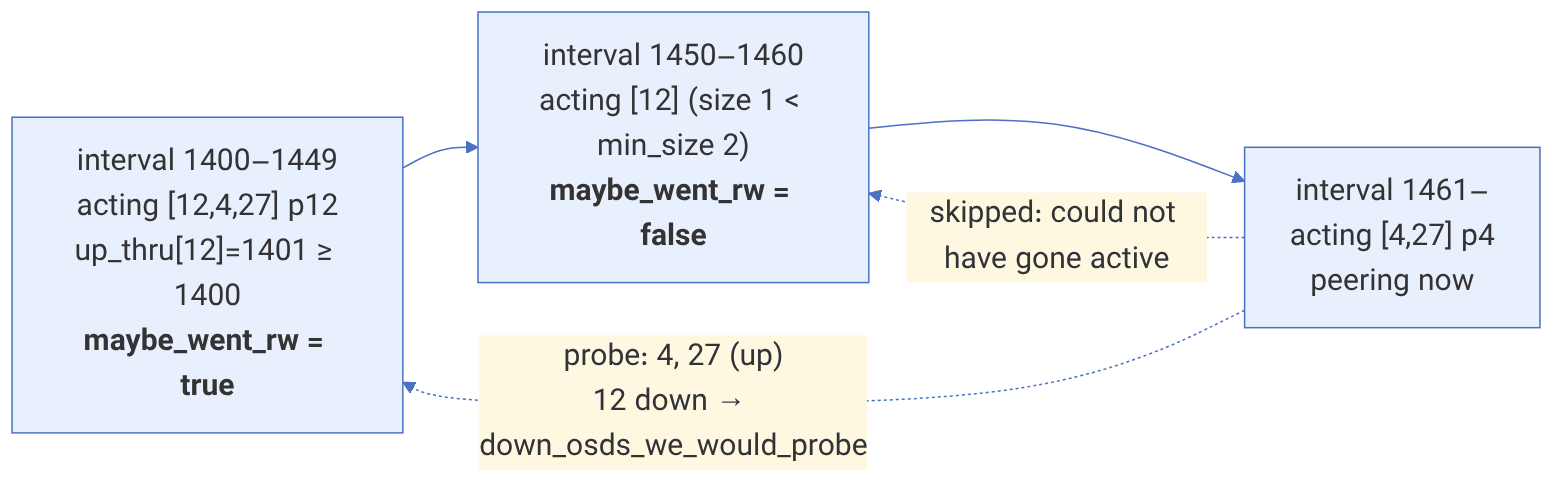
۳۵-۴ ادغام log#
پس از اینکه primary با find_best_info (فصل ۱۷) عضوی را که معتبرترین log را دارد انتخاب کرد، log او را میگیرد و با PGLog::merge_log در log خودش ادغام میکند. برای replicaها هم proc_replica_log همین منطق را روی کپی log آنها اجرا میکند تا missing هر replica محاسبه شود.
منبع در کد: src/osd/PGLog.cc :: PGLog::merge_log، PGLog::rewind_divergent_log
پیچیدگی: O(E) برای E ورودی جدید یا divergent؛ بهروزرسانی missing برای هر شیء
pseudocode
merge_log(olog from authoritative peer):
assert overlap: log.head >= olog.tail and olog.head >= log.tail
if olog.tail < log.tail: # گسترش دم
splice older entries of olog before log; log.tail = olog.tail
if olog.head < log.head: # ما جلوتر بودیم: ورودیهای اضافه divergent هستند
rewind_divergent_log(olog.head)
if olog.head > log.head: # گسترش سر
lower_bound = newest olog entry <= log.head
divergent = log.rewind_from_head(lower_bound) # ورودیهایی که olog آنها را ندارد
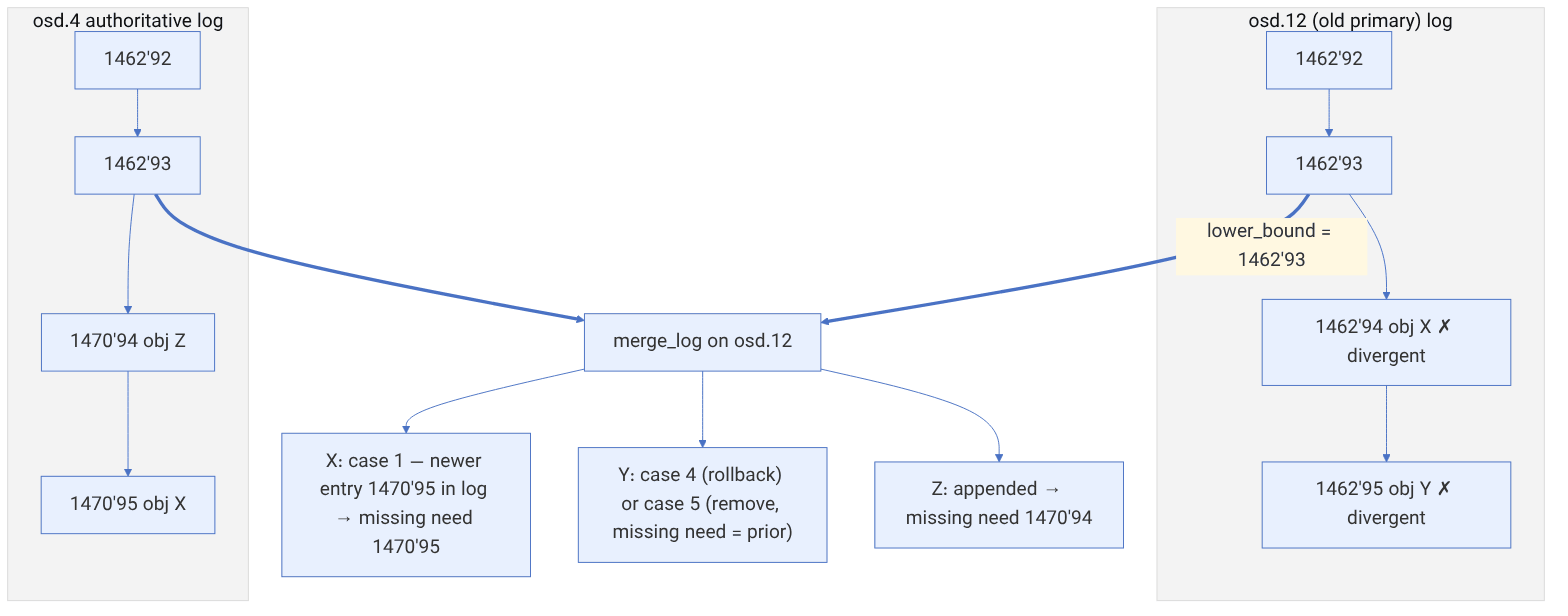
append olog entries after lower_bound; for each: missing.add_next_event(entry)
_merge_divergent_entries(divergent)
info.last_update = log.head = olog.head
info.last_user_version = oinfo.last_user_version ; info.purged_snaps = oinfo.purged_snapsافزودن هر ورودی جدید به missing ساده است: اگر شیء قبلاً missing نبوده، have همان prior_version ورودی و need نسخهی ورودی میشود. اگر بوده، فقط need جلو میرود. برای ورودی DELETE، پرچم FLAG_DELETE گذاشته میشود تا recovery بهجای کپی، حذف کند.
۳۵-۴-۱ ورودیهای divergent#
ورودی divergent ورودیای است که در log یک عضو هست ولی در log معتبر نیست؛ مثلاً primary قبلی نوشتنی را محلی ثبت کرد و پیش از رسیدن آن به بقیه از کار افتاد. چون کلاینت برای آن نوشتن هرگز پاسخ نگرفته (پاسخ فقط پس از commit همهی acting داده میشود)، باید آن را برگرداند. _merge_object_divergent_entries ورودیها را بر اساس شیء گروه میکند و برای هر شیء یکی از پنج حالت را اجرا میکند:
منبع در کد: src/osd/PGLog.h :: PGLog::_merge_object_divergent_entries
پیچیدگی: O(e) برای e ورودی divergent آن شیء
pseudocode
for each object hoid with divergent entries (sorted by version):
if hoid > info.last_backfill: ignore # هنوز backfill نشده
prior = prior_version of first divergent entry
1) if log (authoritative) has a newer entry for hoid:
nothing to do — merge_log already set missing to that newer version
2) elif prior == eversion_t() or first entry is a clone:
object should not exist: remove it from store, drop from missing
3) elif hoid is already missing:
if missing.have == prior: drop from missing ; else missing.need = prior
4) elif every entry can_rollback() and version > olog.can_rollback_to:
rollback each entry (EC: از stashهای rollback) # شیء missing نمیشود
5) else:
remove object from store ; missing.add(hoid, need=prior, have=none)حالت ۴ بیشتر در EC رخ میدهد، چون backend مربوط به EC برای هر نوشتن اطلاعات rollback (مثلاً نسخهی قبلی xattrها یا طول قبلی شیء) نگه میدارد. در replicated بیشتر نوشتنها rollback ندارند و حالت ۵ اجرا میشود: شیء حذف و از عضو دیگری با نسخهی prior بازیابی میشود.
۳۵-۵ طول log و trim#
هر چه log طولانیتر باشد، OSDی که مدت بیشتری خاموش بوده باز هم میتواند با log برگردد (بدون backfill)، ولی حافظه و فضای omap بیشتری مصرف میشود.
منبع در کد: src/osd/OSD.cc :: OSDService::get_target_pg_log_entries؛ src/osd/PeeringState.cc :: PeeringState::calc_trim_to
پیچیدگی: O(t) برای t ورودیای که trim میشود
pseudocode
target = clamp(osd_target_pg_log_entries_per_osd / num_pgs_on_osd,
min = osd_min_pg_log_entries, max = osd_max_pg_log_entries)
limit = min(min_last_complete_ondisk, can_rollback_to)
if log.size > target:
n = min(log.size - target, osd_pg_log_trim_max)
if n < osd_pg_log_trim_min: return # trim در دستههای بزرگتر
trim_to = version of the n-th oldest entry, but never beyond limit| گزینه | پیشفرض main |
|---|---|
osd_target_pg_log_entries_per_osd | ۳۰۰۰۰۰ |
osd_min_pg_log_entries | ۲۵۰ |
osd_max_pg_log_entries | ۱۰۰۰۰ |
osd_pg_log_trim_min | ۱۰۰ |
osd_pg_log_trim_max | ۱۰۰۰۰ |
osd_pg_log_dups_tracked | ۳۰۰۰ |
مثال عددی. OSDی با ۲۰۰ PG: ۳۰۰۰۰۰/۲۰۰ = ۱۵۰۰، که بین ۲۵۰ و ۱۰۰۰۰ است؛ پس هدف ۱۵۰۰ ورودی برای هر PG است. با ۱۵۰۰ PG روی همان OSD (فرض: pool بزرگ با pg_num زیاد) هدف به ۲۰۰ میرسد و به حداقل ۲۵۰ گرد میشود. پیامد عملی: هر چه PG بیشتری روی یک OSD باشد، log هر PG کوتاهتر است و OSDی که چند دقیقه خاموش بوده زودتر به backfill میافتد.
چه چیزی جلوی trim را میگیرد؟ min_last_complete_ondisk، یعنی کمترین last_complete میان همهی اعضای acting. اگر یک replica شیئی را missing داشته باشد، log از آن نقطه trim نمیشود، چون missing همان عضو به آن ورودیها وابسته است. PGای که مدت طولانی degraded میماند log بلندتری دارد و این در mempool osd_pglog دیده میشود.
۳۵-۶ recovery و backfill در عمل#
۳۵-۶-۱ log کافی است یا backfill؟#
در PeeringState::activate برای هر عضو acting یا backfill تصمیم گرفته میشود. اگر pg_log.get_tail() > peer.last_update باشد، یعنی log ما دیگر ورودیهای بعد از آخرین نسخهی peer را ندارد، یا اگر peer.last_backfill خالی باشد (عضو تازه)، آن عضو backfill میشود: last_backfill او به ابتدا (hobject_t()) برمیگردد و از اول شیء به شیء پر میشود. در غیر این صورت ورودیهای بعد از peer.last_update برایش فرستاده میشوند و missing او از روی همین ورودیها ساخته میشود.
گامبهگام peering و recovery
سه داستان از یک PG با سه نسخه را گامبهگام دنبال کنید و ماشین حالت PeeringState، مجموعههای up و acting و لاگهای PG را ببینید.
۶/۸ · merge_log ورودی واگرا را عقب میبرد
merge_log میبیند که 40'4 در تاریخچهٔ معتبر نیست: rewind_divergent_log آن را کنار میگذارد و _merge_divergent_entries سرنوشت شیء را تعیین میکند. D پیشتر وجود نداشت، پس حذف میشود؛ E و B روی osd.0 در فهرست missing میروند.
مطابق با: PGLog::merge_log, rewind_divergent_log, _merge_divergent_entries
- Reset
- Started
- Primary
- Peering
- GetInfo
- GetLog
- GetMissing
- WaitUpThru
- WaitActingChange
- Active
- Activating
- WaitLocalRecoveryReserved
- WaitRemoteRecoveryReserved
- Recovering
- WaitLocalBackfillReserved
- WaitRemoteBackfillReserved
- Backfilling
- Recovered
- Clean
- ReplicaActive
- Stray
- ToDelete
osd.0 primary
- 5'1 A
- 5'2 B
- 5'3 C
- 41'4 E برای بازیابی
- 41'5 B برای بازیابی
osd.1 replica
- 5'1 A
- 5'2 B
- 5'3 C
- 41'4 E
- 41'5 B
osd.2 replica
- 5'1 A
- 5'2 B
- 5'3 C
- 41'4 E
- 41'5 B
آنچه تا اینجا رخ داد
- e40 primary نوشتنی را لاگ میکند
- e41 osd.0 رفته است؛ osd.1 رهبری میکند
- e41 نوشتنهای تازه در interval تازه
- e45 osd.0 بهعنوان primary برمیگردد
- e45 لاگ osd.1 برنده است
- e45 merge_log ورودی واگرا را عقب میبرد
مطابق با:
src/osd/PeeringState.h :: struct Started, Primary, Peering, GetInfo, GetLog, GetMissing, Active, …ماشین حالت و تودرتویی آنsrc/osd/PeeringState.cc :: start_peering_interval, should_restart_peering, build_priorpeering کی از نو شروع میشود و از کدام OSDهای گذشته باید پرسیدsrc/osd/PeeringState.cc :: find_best_info, choose_acting, calc_replicated_actingلاگ معتبر و مجموعهٔ actingsrc/osd/PeeringState.cc :: proc_master_log, proc_replica_log, activateادغام لاگها و active کردن replicaهاsrc/osd/PGLog.cc :: merge_log, rewind_divergent_log, _merge_divergent_entries, proc_replica_logادغام و عقب بردن ورودیهای واگراsrc/osd/PrimaryLogPG.cc :: start_recovery_ops, recover_primary, recover_replicas, recover_backfillبازیابی بر پایهٔ لاگ و backfill
۳۵-۶-۲ ترتیب کار در start_recovery_ops#
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::start_recovery_ops، recover_primary، recover_replicas، recover_backfill
پیچیدگی: هر دور حداکثر max عملیات (بر پایهی osd_recovery_max_active و mClock)
pseudocode
start_recovery_ops(max):
    if primary has no missing or all its missing are unfound:
        started = recover_replicas(max)                  # push به replicaهایی که missing دارند
    if started == 0:
        started += recover_primary(max)                  # pull برای missingهای خود primary
    if started == 0 and new unfound objects appeared:
        started = recover_replicas(max)
    if backfill targets exist and started < max and primary missing is empty
       and backfill reservation granted:
        started += recover_backfill(max - started)
# main: سپس recover_pool_migration برای مهاجرت poolrecover_primary برای هر شیء missing منبعی از missing_loc (عضوی که آن نسخه را دارد) انتخاب و آن را pull میکند. recover_replicas شیء را از primary به replica push میکند. هر push حداکثر osd_recovery_max_chunk (پیشفرض ۸ MiB) داده دارد و اشیای بزرگتر در چند دور منتقل میشوند. اگر هیچ عضو up نسخهی لازم را نداشته باشد، شیء unfound است (فصل ۱۷ و ceph pg <pgid> list_unfound).
۳۵-۶-۳ backfill: مقایسهی دو پیمایش مرتب#
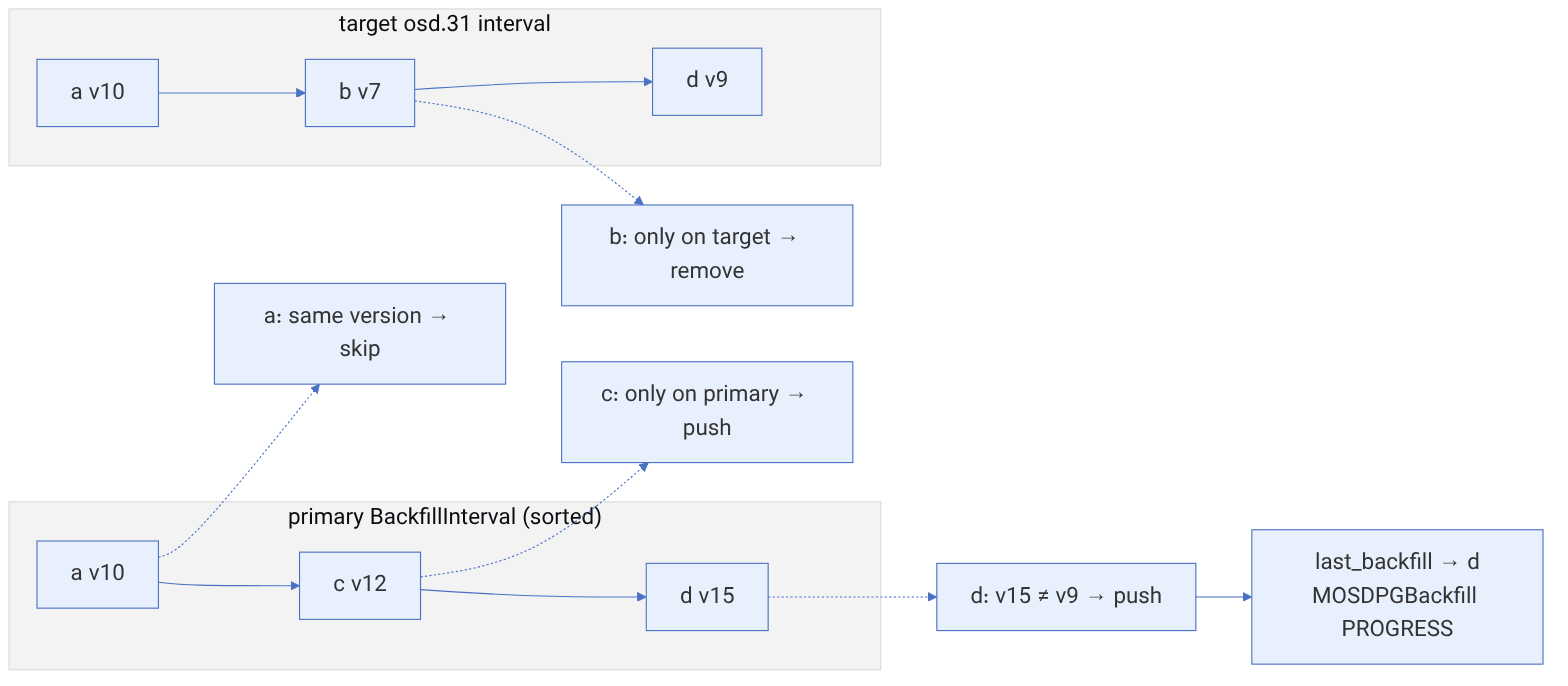
backfill از log استفاده نمیکند. primary و هر backfill target محتوای PG را به ترتیب hobject_t (فصل ۳۴) در بازههای کوچک پیمایش میکنند (BackfillInterval، با حداقل osd_backfill_scan_min = ۶۴ و حداکثر osd_backfill_scan_max = ۵۱۲ شیء در هر scan) و مثل ادغام دو فهرست مرتب، آنها را مقایسه میکنند.
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::recover_backfill، scan_range_primary، scan_range_replica
پیچیدگی: O(N) برای N شیء PG؛ هر scan حداکثر osd_backfill_scan_max شیء
pseudocode
loop while ops < max:
    refill backfill_info (primary) and peer_backfill_info[t] when exhausted (MOSDPGScan)
    check = min(begin of all intervals)
    for each target t:
        if t's next object < check: t has extra object → send remove to t
    if primary has check:
        for targets whose version != primary version (and t.last_backfill < check):
            push check to them
    advance all intervals past check
    new_last_backfill = largest object fully handled on all targets
send MOSDPGBackfill PROGRESS(last_backfill) ; at end FINISH (last_backfill = MAX)نوشتنهای کلاینت در حین backfill هم ادامه دارند. اگر شیئی که نوشته میشود پیش از last_backfill هدف باشد، بهطور عادی برای آن هدف تکثیر میشود. اگر بعد از آن باشد، فقط در log ثبت میشود و خود backfill بعداً نسخهی تازه را منتقل میکند. شیئی که دقیقاً در حال backfill است برای نوشتن قفل میشود و op در waiting_for_degraded_object میماند (فصل ۳۴).
۳۵-۷ دستورها و عیبیابی#
| دستور | کاربرد |
|---|---|
ceph pg <pgid> query | info همهی اعضا، past_intervals، probing_osds، peering_blocked_by و recovery_progress |
ceph pg ls recovering / backfilling / down / incomplete | فهرست PGها بر اساس حالت |
ceph pg <pgid> list_unfound | اشیای unfound و OSDهایی که بررسی شدهاند |
ceph pg <pgid> mark_unfound_lost revert یا delete | آخرین راه برای unfound؛ داده از دست میرود |
ceph osd lost <id> --yes-i-really-mean-it | اعلام از دست رفتن یک OSD تا peering منتظرش نماند |
ceph-objectstore-tool --op log --pgid <pgid> | log، dups و missing یک PG روی OSD خاموش |
ceph-objectstore-tool --op export / import | نجات یک PG از OSD معیوب |
ceph daemon osd.N dump_recovery_reservations | رزروها (فصل ۳۲) |
مثال (بخشی از ceph pg 3.1f query در حین backfill):
"info": { "last_update": "1470'2210", "last_complete": "1470'2210",
          "log_tail": "1468'710", "last_backfill": "MAX" },
"peer_info": [ { "peer": "31", "last_update": "1470'2210",
                 "last_backfill": "3:fa21c9e8:::rbd_data.5f3a2b8c1d4e.0000000000000c1a:head" } ],
"recovery_state": [ { "name": "Started/Primary/Active",
    "recovery_progress": { "backfill_targets": [ "31" ],
        "waiting_on_backfill": [], "last_backfill_started": "3:fa21c9e8:::rbd_data...0c1a:head",
"backfill_info": { "begin": "3:fa21c9e8:::rbd_data...0c1a:head", "end": "3:fa2a...", "objects": [ "..." ] } } } ]last_backfill هدف ۳۱ یک hobject_t با کلید بیتی fa21c9e8 است. چون بازهی این PG در pg_num=32 از f8000000 تا ffffffff است، با یک تقسیم ساده پیشرفت تقریبی به دست میآید: (۰xfa21c9e8 − ۰xf8000000) / ۰x08000000 ≈ ٪۲۷.
۳۵-۷-۱ نشانهها و راهحلها#
- PG در
peering میماند و peering_blocked_by دارد: یک OSD که در interval نوشتنی عضو بوده down است. اول آن را برگردانید؛ ceph osd lost آخرین گزینه است. - PG
incomplete: هیچ عضو زندهای log کامل تا last_epoch_started ندارد. پیش از osd_find_best_info_ignore_history_les یا export و import با ceph-objectstore-tool، از OSDها پشتیبان بگیرید. - OSD پس از چند دقیقه خاموشی به backfill افتاد: log کوتاه بوده است. تعداد PG هر OSD را بررسی کنید یا در تعمیرات برنامهریزیشده زمان خاموشی را کوتاهتر کنید.
- log بلند و حافظهی زیاد: PGهای degraded طولانی جلوی trim را گرفتهاند. recovery را تمام کنید.
۳۵-۸ تکمیلی و بهروز#
- در شاخهی main، پشتیبانی از نوشتنهای جزئی EC (
written_shards در pg_log_entry_t و partial_writes_last_complete) منطق divergent و backfill را برای EC پیچیدهتر کرده است؛ برخی ورودیها روی بعضی shardها اصلاً اعمال نشدهاند و نباید آنها را missing دانست. -
recover_pool_migration و migrating_pgs در شاخهی main برای مهاجرت داده میان poolها اضافه شدهاند. پیش از استفاده بررسی کنید در نسخهی شما وجود دارند یا نه. - Crimson منطق PeeringState را مستقیم به اشتراک میگذارد، ولی backfill را با یک ماشین حالت جدا (
crimson/osd/backfill_state.cc) پیاده کرده است.
۳۵-۹ تمرین عملی#
- ۱. روی یک pool آزمایشی
min_size را عوض کنید و در ceph pg <pgid> query تغییر same_interval_since را ببینید. - ۲. یک OSD را
noout و خاموش کنید، چند هزار نوشتن انجام دهید و با osd_max_pg_log_entries کوچک آزمایش کنید که پس از بازگشت، OSD با log برمیگردد یا backfill میشود. - ۳. با
ceph-objectstore-tool --op log روی یک OSD خاموش، فیلدهای pg_missing را پیدا کنید و need و have را با ورودیهای log تطبیق دهید. - ۴. در حین backfill،
last_backfill هدف را چند بار بخوانید و درصد پیشرفت را با روش کلید بیتی تخمین بزنید.
۳۵-۱۰ پرسشهای مرور#
- ۱. چه تغییرهایی در OSDMap یک interval تازه میسازند؟ سه مورد غیر از up و acting نام ببرید.
- ۲.
maybe_went_rw در چه شرایطی true است؟ - ۳. چرا up_thru برای ایمنی peering لازم است؟
- ۴. چه زمانی PG down میشود و
blocked_by چه کسی را نشان میدهد؟ - ۵. merge_log وقتی log معتبر جلوتر است چه کار میکند؟
- ۶. ورودی divergent چیست و چرا برگرداندن آن ایمن است؟
- ۷. حالتهای ۴ و ۵ رسیدگی به divergent چه فرقی دارند؟
- ۸. هدف طول log برای OSDی با ۶۰۰ PG با پیشفرضها چقدر است؟
- ۹. چه شرطی تعیین میکند یک عضو backfill شود؟
- ۱۰. backfill چگونه تشخیص میدهد شیئی باید از هدف حذف شود؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۵-۱۱ منابع این فصل#
- osd_types.cc و osd_types.h (PastIntervals، PriorSet، pg_info_t، pg_missing_item
https://github.com/ceph/ceph/blob/main/src/osd/osd_types.cc - PGLog.cc و PGLog.h (merge_log، divergent
https://github.com/ceph/ceph/blob/main/src/osd/PGLog.h - PeeringState.cc (activate، calc_trim_to
https://github.com/ceph/ceph/blob/main/src/osd/PeeringState.cc - PrimaryLogPG.cc (start_recovery_ops، recover_backfill
https://github.com/ceph/ceph/blob/main/src/osd/PrimaryLogPG.cc - مستند توسعهدهنده دربارهی peering
https://docs.ceph.com/en/latest/dev/peering/ - مستند توسعهدهنده دربارهی log-based PG
https://docs.ceph.com/en/latest/dev/osd_internals/log_based_pg/ - عیبیابی PG
https://docs.ceph.com/en/latest/rados/troubleshooting/troubleshooting-pg/