کار با Ceph Block Device (RBD)
حوصله ندارم این فصل در چند خط
- هر image در RBD مجموعهای thin از اشیای ۴ مگابایتی RADOS است که روی همهی OSDهای pool پخش میشود؛ به هر کلاینت کاربر جداگانه با
profile rbd بدهید، نه client.admin. - krbd سریع و بیوابستگی است اما در قابلیتها عقبتر است؛ librbd (در QEMU و rbd-nbd) کاملترین مسیر است.
- snapshot فوری و copy-on-write است، clone قابل نوشتن و ارزان است و
flatten وابستگی clone به والد را قطع میکند؛ snapshot بدون freeze فقط crash-consistent است. - mirroring در حالت journal (RPO چند ثانیه، نوشتن دوبرابر) یا snapshot (RPO برابر زمانبندی) کار میکند؛ promote اجباری بدون fencing خطر split-brain دارد.
۲-۱ پیش از شروع#
۲-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
RBD (RADOS Block Device) پرکاربردترین رابط Ceph است. بیشتر کلاسترهای Ceph دنیا، دیسک ماشینهای مجازی OpenStack، Proxmox و CloudStack یا volumeهای پایدار Kubernetes را از همین رابط تأمین میکنند. در این فصل یاد میگیریم:
- یک image در RBD واقعاً چیست و چطور روی اشیای RADOS نگاشت میشود؟
- چطور یک کلاینت را با دسترسی حداقلی پیکربندی کنیم و image را بسازیم، map کنیم و تغییر اندازه دهیم؟
- snapshot و clone چطور کار میکنند و چرا اساس «قالب طلایی» ماشینهای مجازیاند؟
- RBD mirroring چیست، دو حالت journal و snapshot چه فرقی دارند و چطور تکثیر یکطرفه و دوطرفه را برقرار کنیم؟
- هنگام سانحه چطور سایت پشتیبان را ارتقا دهیم و بعد از بازگشت سایت اصلی، داده را برگردانیم؟
۲-۱-۲ پیشنیاز#
کلاستر آزمایشی فصل ۱ با یک pool به نام rbd و ماشین client-node1. برای بخش mirroring به یک کلاستر دوم نیاز دارید؛ سادهترین راه، bootstrap یک کلاستر تکنودی دیگر با cephadm است (با --single-host-defaults).
۲-۲ RBD از درون#
۲-۲-۱ image، شیء و striping#
یک image در RBD دیسکی مجازی با اندازهی ثابت است که روی اشیای RADOS پخش میشود. بهطور پیشفرض هر شیء ۴ مگابایت است (--object-size)، پس یک image صد گیگابایتی حداکثر ۲۵٬۶۰۰ شیء دارد. اما RBD thin provisioned است: شیئی که هنوز در آن نوشته نشده اصلاً وجود ندارد و فضایی مصرف نمیکند.
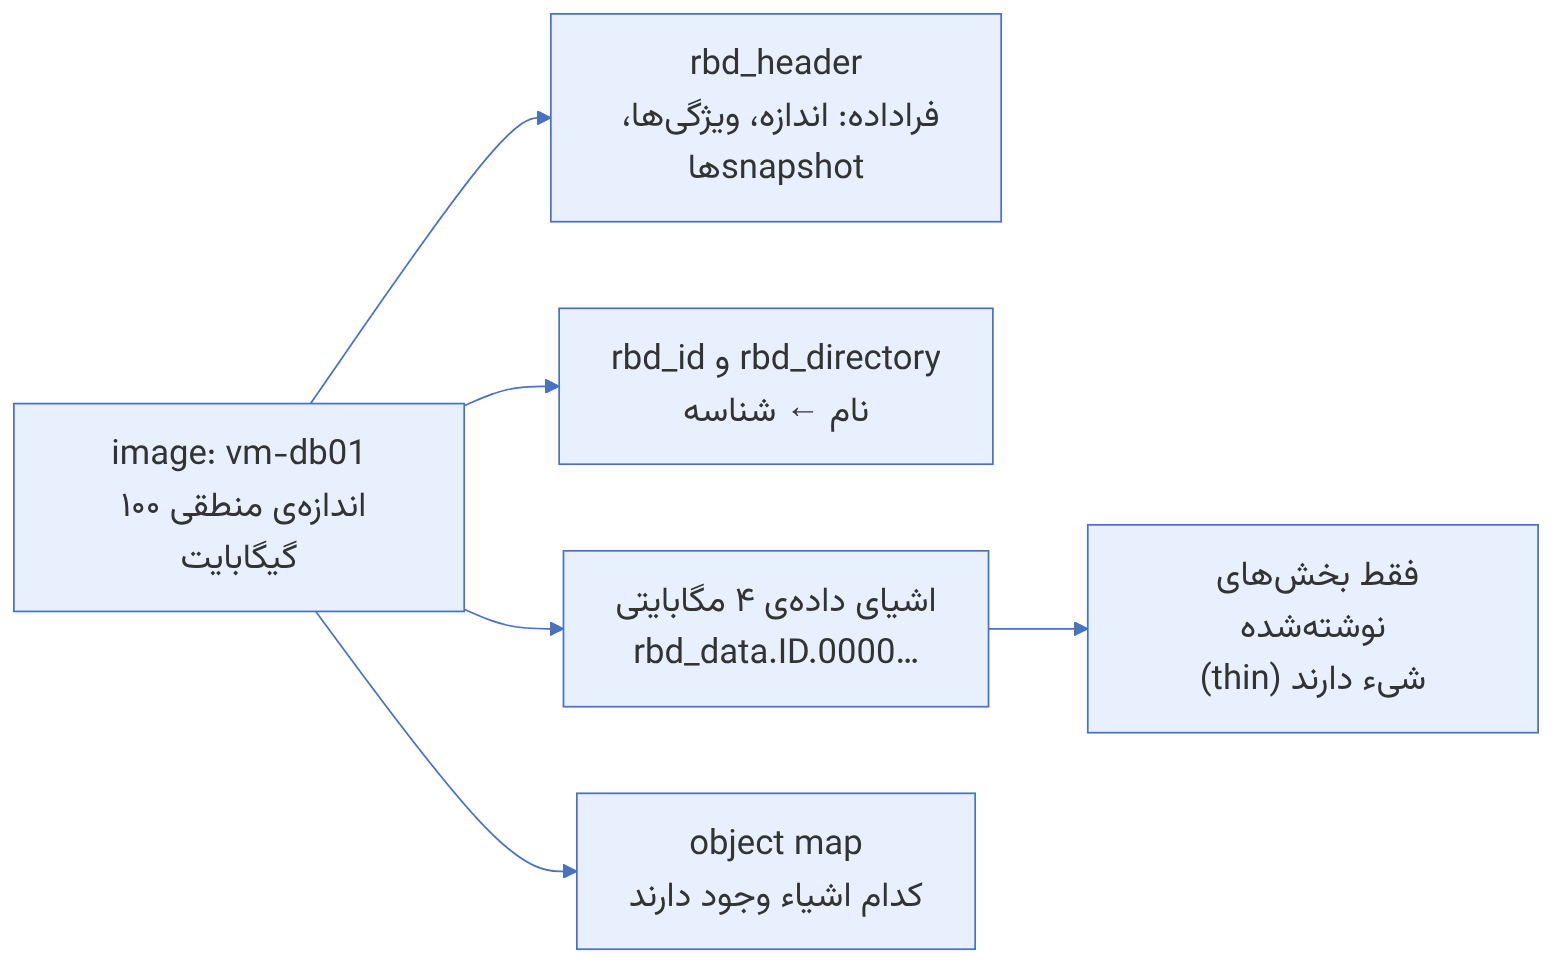
برای هر image (در قالب ۲ که از سالها پیش پیشفرض است) این اشیاء در pool وجود دارند:
| شیء | محتوا |
|---|---|
rbd_directory | نگاشت نام imageها به شناسهشان در pool |
rbd_id.<name> | شناسهی یکتای image |
rbd_header.<id> | فراداده: اندازه، ترتیب شیء، ویژگیها، فهرست snapshotها، والد (برای clone) |
rbd_data.<id>.<offset> | دادهی واقعی؛ شمارهی hex نشاندهندهی جای شیء در image |
rbd_object_map.<id> | نقشهی وجود اشیاء (اگر ویژگی object-map فعال باشد) |
چون هر شیء ۴ مگابایتی با CRUSH مستقلاً روی OSDها جایگذاری میشود، یک image بزرگ عملاً روی همهی OSDهای pool پخش است. این همان دلیلی است که RBD در I/O موازی (مثلاً عمق صف بالا) خیلی خوب مقیاس میگیرد، اما در I/O تکرشتهای با عمق صف ۱ تأخیر یک رفتوبرگشت شبکه و تکثیر را تمام و کمال میپردازد. striping سفارشی (--stripe-unit و --stripe-count) میتواند برای بارهای ترتیبی بزرگ مفید باشد، اما krbd فقط برخی ترکیبها را پشتیبانی میکند؛ پیشفرض را بیدلیل تغییر ندهید.
۲-۲-۲ ویژگیهای image#
هر image مجموعهای از ویژگیها (features) دارد که هنگام ساخت تعیین میشود و برخی بعداً قابل روشن یا خاموش کردن است:
| ویژگی | کاربرد | وابستگی |
|---|---|---|
| layering | پشتیبانی از clone | — |
| exclusive-lock | تنها یک کلاینت در هر لحظه میتواند بنویسد؛ پیشنیاز ویژگیهای پیشرفته | — |
| object-map | ردیابی اشیای موجود؛ سرعت دادن به du، diff، export و حذف | exclusive-lock |
| fast-diff | محاسبهی سریع تفاضل بین snapshotها | object-map |
| deep-flatten | امکان flatten کردن clone همراه با snapshotهایش | — |
| journaling | ثبت همهی تغییرات در journal برای mirroring حالت journal | exclusive-lock |
پیشفرض نسخههای جدید layering, exclusive-lock, object-map, fast-diff, deep-flatten است. ماژول هسته (krbd) در نسخههای جدید لینوکس همهی اینها بهجز journaling را پشتیبانی میکند؛ روی هستههای قدیمی ممکن است هنگام map خطای «image uses unsupported features» بگیرید.
۲-۲-۳ مسیرهای دسترسی کلاینت#
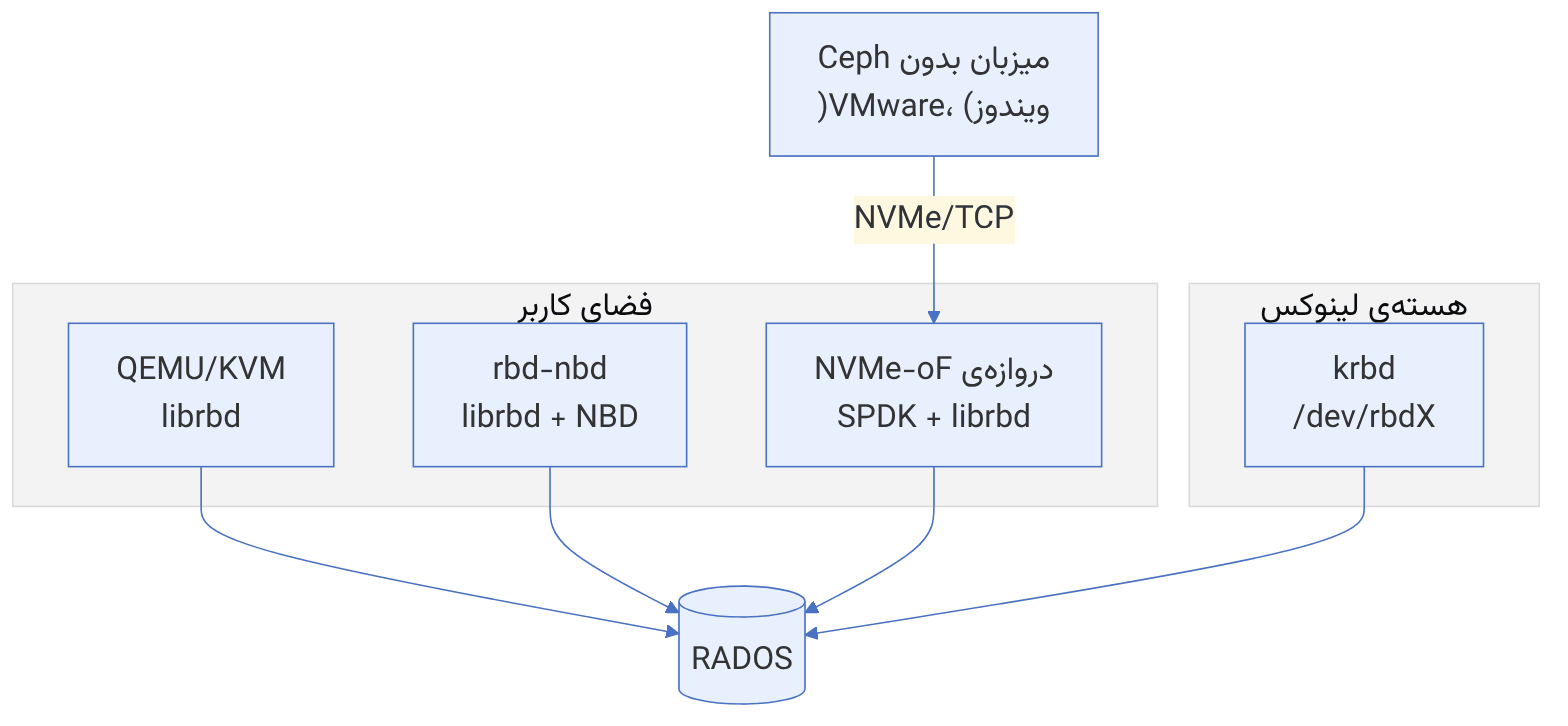
- librbd: کتابخانهی فضای کاربر. QEMU/KVM، libvirt، OpenStack و بسیاری از ابزارها از آن استفاده میکنند. همهی ویژگیها، از جمله journaling و cache سمت کلاینت، را پشتیبانی میکند.
- krbd: راهانداز هستهی لینوکس که image را بهصورت
/dev/rbdX نشان میدهد. سریع و بدون وابستگی به بستههای فضای کاربر برای مسیر داده، اما مجموعهی ویژگیهایش به نسخهی هسته بستگی دارد. Ceph CSI در Kubernetes بهطور پیشفرض از آن استفاده میکند. - rbd-nbd: پلی بین librbd و دستگاه NBD هسته؛ وقتی ویژگیای لازم است که krbd ندارد.
- دروازهی NVMe-oF: برای میزبانهایی که Ceph بومی ندارند (مثلاً VMware ESXi یا ویندوز). image از طریق پروتکل NVMe/TCP صادر میشود. این دروازه جانشین عملی دروازهی iSCSI است؛ طبق مستندات رسمی، دروازهی iSCSI از نوامبر ۲۰۲۲ در حالت «فقط نگهداری» است و قابلیت تازهای نمیگیرد.
۲-۳ پیکربندی کلاینت Ceph#
۲-۳-۱ ساختن کاربر با دسترسی حداقلی#
برای کلاینت هرگز از client.admin استفاده نکنید. Ceph profileهای آمادهای برای RBD دارد که دقیقاً همان مجوزهای لازم را میدهند:
ceph auth get-or-create client.rbd-lab \
  mon 'profile rbd' \
  osd 'profile rbd pool=rbd' \
  mgr 'profile rbd pool=rbd' \
  -o /etc/ceph/ceph.client.rbd-lab.keyring
ceph auth get client.rbd-labبرای کلاینتی که فقط باید بخواند (مثلاً سرور پشتیبانگیری که از snapshotها export میگیرد) از profile rbd-read-only استفاده کنید. برای جداسازی مستاجرها در یک pool هم میتوانید از namespace استفاده کنید: rbd namespace create rbd/tenant-a و سپس osd 'profile rbd pool=rbd namespace=tenant-a'.
۲-۳-۲ انتقال پیکربندی به کلاینت#
کلاینت به دو چیز نیاز دارد: فایل پیکربندی حداقلی (برای یافتن MONها) و keyring کاربر خودش.
# روی یک میزبان مدیریتی
ceph config generate-minimal-conf > /tmp/ceph.conf
scp /tmp/ceph.conf client-node1:/etc/ceph/ceph.conf
scp /etc/ceph/ceph.client.rbd-lab.keyring client-node1:/etc/ceph/
# روی client-node1
sudo dnf install -y ceph-common # یا apt install ceph-common
rbd --id rbd-lab ls rbd
ceph --id rbd-lab -s # profile rbd اجازهی خواندن وضعیت را میدهدنسخهی بستههای ceph-common کلاینت را با نسخهی کلاستر نزدیک نگه دارید. کلاینتهای خیلی قدیمی ممکن است ویژگیهای جدید (مثلاً قالب clone نسخهی ۲ یا msgr2) را نشناسند. با ceph features میتوانید نسخهی کلاینتهای متصل را ببینید و پیش از روشن کردن ویژگیهایی که set-require-min-compat-client لازم دارند، مطمئن شوید هیچ کلاینت قدیمیای وصل نیست.
۲-۴ ساختن، map کردن و تغییر اندازه#
۲-۴-۱ ساختن image#
rbd --id rbd-lab create rbd/disk01 --size 10G
rbd --id rbd-lab ls -l rbd
rbd --id rbd-lab info rbd/disk01
خروجی rbd info شامل اندازه، تعداد اشیاء، order 22 (یعنی اشیای بایتی = ۴ مگابایت)، پیشوند نام اشیای داده (block_name_prefix) و فهرست ویژگیهاست.
۲-۴-۲ map کردن با krbd#
sudo rbd --id rbd-lab device map rbd/disk01      # /dev/rbd0
rbd device list
sudo mkfs.xfs /dev/rbd0
sudo mkdir -p /mnt/disk01 && sudo mount /dev/rbd0 /mnt/disk01
df -h /mnt/disk01
برای map خودکار پس از راهاندازی مجدد، سرویس rbdmap را به کار ببرید:
echo "rbd/disk01 id=rbd-lab,keyring=/etc/ceph/ceph.client.rbd-lab.keyring" | sudo tee -a /etc/ceph/rbdmap
echo "/dev/rbd/rbd/disk01 /mnt/disk01 xfs noauto,_netdev 0 0" | sudo tee -a /etc/fstab
sudo systemctl enable --now rbdmapگزینهی _netdev در fstab را فراموش نکنید. بدون آن، سیستم ممکن است در زمان بوت پیش از بالا آمدن شبکه سعی کند فایلسیستم را mount کند و بوت متوقف شود. در خاموش کردن هم ترتیب اهمیت دارد: اول umount، بعد unmap، بعد قطع شبکه.
اگر rbd map با خطای RBD image feature set mismatch یا unsupported features شکست خورد، پیام dmesg را ببینید. ویژگی ناسازگار را خاموش کنید (rbd feature disable rbd/disk01 journaling) یا از rbd-nbd استفاده کنید. اگر map معطل ماند، دسترسی کلاینت به پورتهای MON (۳۳۰۰ و ۶۷۸۹) و بازهی پورت OSDها (۶۸۰۰ تا ۷۳۰۰) را با فایروال بررسی کنید.
۲-۴-۳ تغییر اندازه#
بزرگ کردن یک image در Ceph فوری است، چون فقط فراداده تغییر میکند. بعد باید فایلسیستم را هم بزرگ کرد:
rbd --id rbd-lab resize rbd/disk01 --size 20G
sudo xfs_growfs /mnt/disk01          # برای ext4: sudo resize2fs /dev/rbd0
lsblk /dev/rbd0
کوچک کردن خطرناک است و Ceph بدون پرچم صریح اجازه نمیدهد:
rbd resize rbd/disk01 --size 5G --allow-shrinkپیش از کوچک کردن image، اول فایلسیستم را کوچک کنید (XFS اصلاً کوچک شدن را پشتیبانی نمیکند). کوچک کردن image زیر اندازهی فایلسیستم یعنی بریدن انتهای فایلسیستم و از دست رفتن داده. در عمل، برای کاهش فضا ساختن image جدید و کپی داده امنتر است.
۲-۴-۴ فضای واقعی و آزادسازی#
چون RBD thin است، rbd du فضای واقعاً مصرفشده را نشان میدهد. وقتی فایلها را در فایلسیستم حذف میکنید، فضا تنها وقتی به Ceph برمیگردد که فایلسیستم دستور discard بفرستد:
rbd du rbd/disk01
sudo fstrim -v /mnt/disk01        # یا فعال کردن fstrim.timer
در ماشینهای مجازی QEMU هم برای رسیدن discard به Ceph باید دیسک با discard=unmap و کنترلر virtio-scsi (یا virtio-blk در نسخههای جدید) تعریف شده باشد.
۲-۵ snapshot و clone#
۲-۵-۱ snapshot: تصویر لحظهای فقطخواندنی#
snapshot در RBD نسخهی فقطخواندنی image در یک لحظهی مشخص است. ساختنش تقریباً آنی است، چون Ceph داده را کپی نمیکند. از آن لحظه به بعد، هر شیئی که تغییر کند، OSD نسخهی قبلیاش را بهعنوان «clone شیء» نگه میدارد (copy-on-write در سطح شیء RADOS).
rbd snap create rbd/disk01@before-upgrade
rbd snap ls rbd/disk01
rbd du rbd/disk01 # سهم هر snapshot از فضا
# بازگرداندن کل image به snapshot (image باید map نشده یا بیاستفاده باشد)
rbd snap rollback rbd/disk01@before-upgrade
rbd snap rm rbd/disk01@before-upgrade
rbd snap purge rbd/disk01 # حذف همهی snapshotهاsnapshot RBD در سطح بلوک گرفته میشود و از فایلسیستم داخل image خبر ندارد. اگر روی image در حال استفاده snapshot بگیرید، نتیجه فقط crash-consistent است، یعنی مثل قطع ناگهانی برق. برای سازگاری بهتر پیش از snapshot فایلسیستم را با fsfreeze -f /mnt/disk01 منجمد و بعد با fsfreeze -u آزاد کنید. در ماشینهای مجازی QEMU guest agent همین کار را انجام میدهد. برای پایگاه دادهها از سازوکار خود پایگاه داده (مثلاً حالت backup) استفاده کنید.
rbd snap rollback کل دادهی image را بازنویسی میکند و برای imageهای بزرگ کند است. اگر فقط چند فایل لازم است، بهتر است از snapshot یک clone بسازید، آن را map کنید و فایلها را کپی کنید.
۲-۵-۲ زمانبندی snapshot#
از نسخهی Octopus، ماژول MGR به نام rbd_support امکان زمانبندی snapshot را برای mirroring فراهم میکند. برای snapshotهای پشتیبانگیری عمومی معمولاً از ابزار بیرونی (cron، Velero، Backy2/Benji یا ابزار پلتفرم مجازیسازی) استفاده میشود.
۲-۵-۳ clone: نوشتنی و ارزان#
clone imageی نوشتنی است که بر پایهی یک snapshot ساخته میشود. تا وقتی clone در شیئی ننوشته، خواندن آن شیء از والد انجام میشود. این همان سازوکاری است که ساختن صدها ماشین مجازی از یک «image طلایی» را در چند ثانیه ممکن میکند.
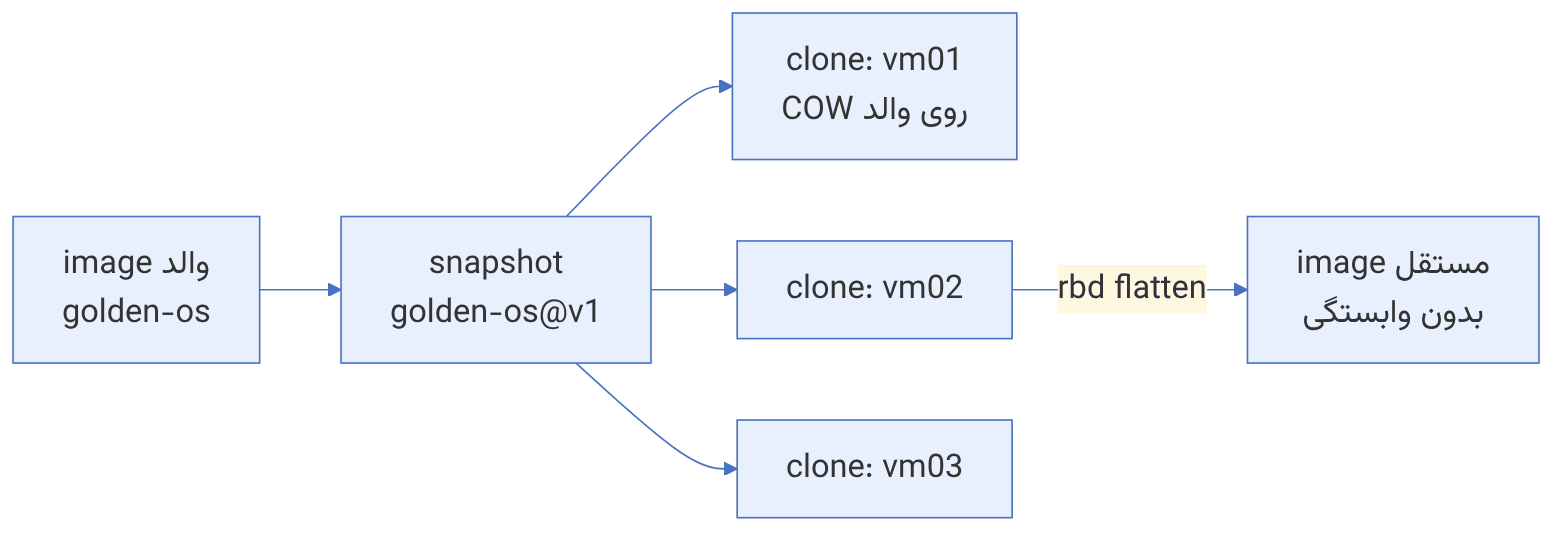
rbd create rbd/golden-os --size 20G
# ... نصب سیستمعامل روی golden-os ...
rbd snap create rbd/golden-os@v1
# در قالب clone نسخهی ۱ لازم بود snapshot محافظت شود:
rbd snap protect rbd/golden-os@v1
rbd clone rbd/golden-os@v1 rbd/vm01
rbd clone rbd/golden-os@v1 rbd/vm02
rbd children rbd/golden-os@v1
rbd info rbd/vm01 | grep parentاز Mimic به بعد قالب clone نسخهی ۲ وجود دارد که دیگر نیازی به snap protect ندارد. در این قالب، اگر snapshot والدی را که هنوز فرزند دارد حذف کنید، Ceph آن را به «سطل زبالهی snapshot» منتقل میکند و وقتی آخرین فرزند flatten یا حذف شد، واقعاً پاکش میکند. شرط استفاده این است که کلاستر حداقل نسخهی کلاینت سازگار را دستکم Mimic اعلام کرده باشد (ceph osd set-require-min-compat-client mimic). گزینهی rbd_default_clone_format (با مقدار پیشفرض auto) تعیین میکند کدام قالب استفاده شود.
۲-۵-۴ flatten: بریدن بند ناف#
clone تا وقتی والدش وجود دارد به آن وابسته است. اگر بخواهید image طلایی را حذف کنید یا clone را به pool دیگری مهاجرت دهید، باید آن را flatten کنید: همهی اشیایی که clone هنوز از والد میخواند، در خود clone کپی میشوند.
rbd flatten rbd/vm02
rbd info rbd/vm02 | grep parent      # دیگر parent ندارد
rbd snap unprotect rbd/golden-os@v1 # فقط اگر قالب ۱ و دیگر فرزندی نمانده باشدزنجیرههای clone عمیق (clone از clone از clone) کارایی خواندن را کم میکنند، چون خواندن شیء نانوشته باید از چند سطح والد عبور کند. OpenStack و پلتفرمهای مشابه معمولاً فقط یک سطح clone میسازند. اگر زنجیره عمیق شد، flatten کنید.
۲-۵-۵ سطل زباله و حذف امن#
RBD یک trash دارد. بهجای حذف فوری، image را به آن منتقل کنید تا در صورت اشتباه قابل بازیابی باشد:
rbd trash mv rbd/vm01 --expires-at "2026-12-01"
rbd trash ls rbd
rbd trash restore rbd/<image-id>
rbd trash purge rbd # حذف همهی imageهای منقضیشده۲-۵-۶ مهاجرت زنده#
rbd migration امکان انتقال image به pool دیگر (مثلاً از HDD به NVMe یا از تکثیری به EC) را با کمترین قطعی فراهم میکند. کلاینت فقط در لحظهی prepare باید image را رها کند و بعد میتواند روی image مقصد کارش را ادامه دهد، در حالی که داده در پسزمینه کپی میشود:
rbd migration prepare rbd/disk01 fast-nvme/disk01
# کلاینت حالا میتواند fast-nvme/disk01 را باز کند
rbd migration execute fast-nvme/disk01
rbd migration commit fast-nvme/disk01در Tentacle امکان وارد کردن آنی image از یک کلاستر Ceph دیگر یا از منابع و قالبهای بیرونی هم به مهاجرت زنده اضافه شده است.
۲-۶ بازیابی از سانحه با RBD mirroring#
۲-۶-۱ مفهوم و دو حالت آن#
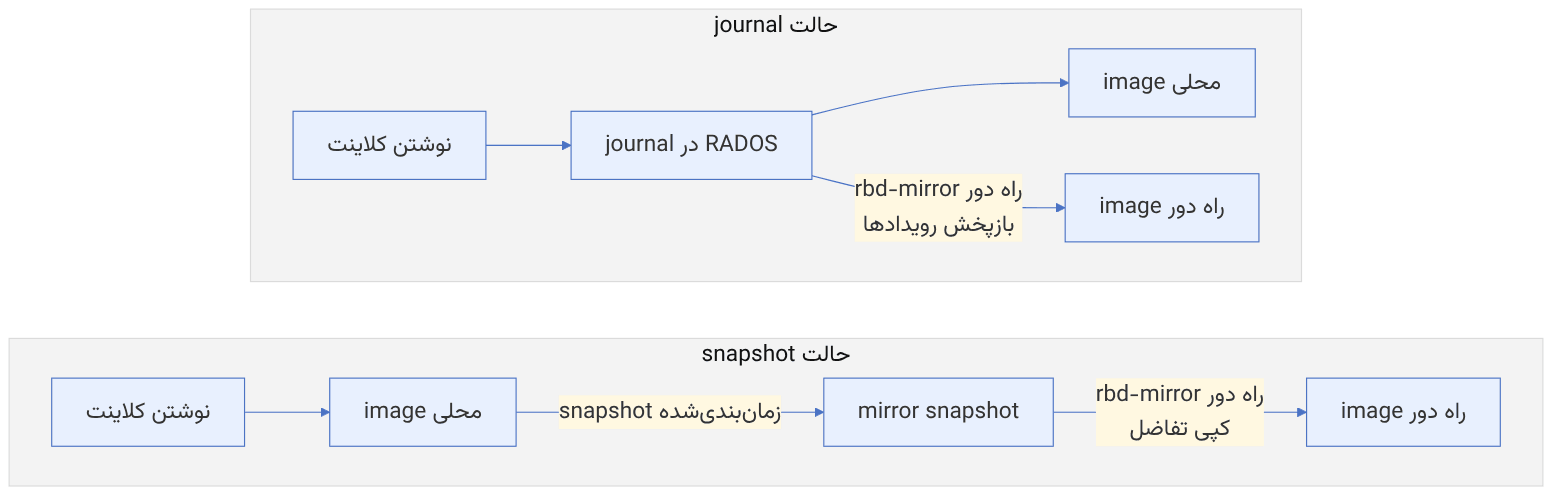
RBD mirroring تکثیر ناهمگام imageها بین دو (یا چند) کلاستر Ceph مستقل است. یک daemon به نام rbd-mirror در کلاستر مقصد اجرا میشود، تغییرات را از کلاستر مبدأ میخواند و روی نسخهی محلی اعمال میکند. هر image در هر لحظه فقط در یک کلاستر primary (نوشتنی) است و در بقیه non-primary (فقطخواندنی).
| جنبه | حالت journal | حالت snapshot |
|---|---|---|
| سازوکار | هر نوشتن اول در journal درون RADOS ثبت و سپس روی image اعمال میشود | snapshotهای mirror بهصورت دورهای ساخته و تفاضل آنها منتقل میشود |
| RPO | ثانیهها (وابسته به تأخیر بازپخش) | برابر فاصلهی زمانبندی (مثلاً ۵ دقیقه یا ۱ ساعت) |
| سربار نوشتن | تقریباً دو برابر (journal + داده) | کم؛ فقط در زمان snapshot |
| پشتیبانی krbd | ندارد (journaling پشتیبانی نمیشود) | دارد |
| ترتیب نوشتن | حفظ میشود (point-in-time consistent) | crash-consistent در لحظهی snapshot |
| توصیهی امروز | برای RPO بسیار کم و کلاینت librbd | انتخاب پیشفرض برای بیشتر کاربردها |
۲-۶-۲ حالتهای pool#
mirroring در سطح pool با یکی از این حالتها فعال میشود:
- image: هر image باید جداگانه و صریحاً برای mirroring فعال شود. انعطاف بیشتر و تنها حالت ممکن برای mirroring نوع snapshot.
- pool: همهی imageهایی که ویژگی journaling دارند خودکار mirror میشوند (فقط حالت journal).
- init-only: pool برای mirroring آماده میشود اما خود pool mirror نمیشود؛ برای حالتی که فقط namespaceها mirror شوند.
۲-۶-۳ استقرار rbd-mirror#
# روی کلاستر مقصد (و برای دوطرفه، روی هر دو کلاستر)
ceph orch apply rbd-mirror --placement="2 ceph-node2 ceph-node3"
ceph orch ps --daemon-type rbd-mirrorدو نمونهی rbd-mirror در هر کلاستر اجرا کنید. نمونهها کار را بین خودشان تقسیم میکنند و خرابی یکی، تکثیر را متوقف نمیکند. rbd-mirror پهنای باند و CPU قابلتوجهی مصرف میکند؛ آن را روی میزبانی بگذارید که هم به شبکهی عمومی محلی و هم به کلاستر راه دور دسترسی خوب دارد.
۲-۶-۴ پیکربندی تکثیر یکطرفه#
فرض کنید دو کلاستر site-a (اصلی) و site-b (پشتیبان) داریم و pool به نام vms در هر دو با همین نام ساخته شده است.
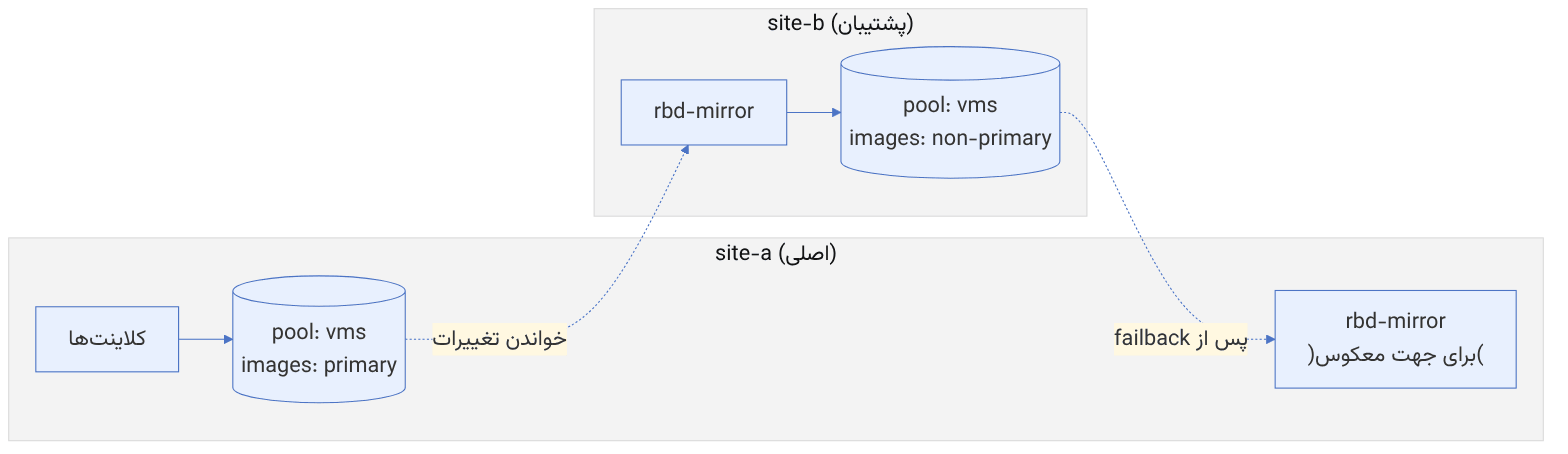
# روی هر دو کلاستر
ceph osd pool create vms && rbd pool init vms
# site-a
rbd mirror pool enable --site-name site-a vms image
# site-b
rbd mirror pool enable --site-name site-b vms image
# site-a: ساختن توکن bootstrap (شامل fsid، کاربر و نشانی MONها)
rbd mirror pool peer bootstrap create --site-name site-a vms > /root/vms-token
# انتقال امن توکن به site-b و وارد کردن آن
rbd mirror pool peer bootstrap import --site-name site-b --direction rx-only vms /root/vms-token
rbd mirror pool info vmsتوکن bootstrap حاوی کلید یک کاربر Ceph با دسترسی به pool است. آن را مثل رمز عبور منتقل کنید (scp از کانال امن)، در تیکت یا چت قرار ندهید و پس از import پاکش کنید.
۲-۶-۵ فعال کردن mirroring برای imageها#
# حالت snapshot (پیشنهادی)
rbd create vms/db01 --size 50G
rbd mirror image enable vms/db01 snapshot
# زمانبندی snapshotهای mirror برای کل pool یا یک image
rbd mirror snapshot schedule add --pool vms 15m
rbd mirror snapshot schedule ls --pool vms --recursive
# حالت journal (فقط برای کلاینت librbd)
rbd create vms/app01 --size 20G --image-feature exclusive-lock,journaling
rbd mirror image enable vms/app01 journal۲-۶-۶ بررسی وضعیت همگامسازی#
rbd mirror pool status vms --verbose
rbd mirror image status vms/db01
وضعیت سالم برای یک image non-primary در حالت snapshot معمولاً up+replaying است و توضیح آن نشان میدهد آخرین snapshot همگامشده کدام است و چقدر از آن گذشته. در حالت journal، فاصلهی ورودیهای journal (entries_behind_primary) معیار عقبماندگی است.
وضعیت down+unknown یعنی rbd-mirror در کلاستر مقصد اجرا نمیشود یا نمیتواند به کلاستر راه دور برسد. ceph orch ps --daemon-type rbd-mirror، لاگ daemon و دسترسی شبکه به MONها و OSDهای راه دور را بررسی کنید. وضعیت up+error همراه با split-brain یعنی image در هر دو طرف primary شده است (بخش بعد را ببینید).
۲-۶-۷ تکثیر دوطرفه#
در حالت دوطرفه هر کلاستر هم مبدأ برخی imageها و هم مقصد برخی دیگر است. کافی است rbd-mirror را روی هر دو کلاستر مستقر کنید و توکن را با جهت rx-tx (پیشفرض) وارد کنید:
rbd mirror pool peer bootstrap import --site-name site-b --direction rx-tx vms /root/vms-tokenدوطرفه بودن به این معنی نیست که یک image در هر دو طرف همزمان نوشتنی است. معنایش این است که imageهای primary در site-a به site-b و imageهای primary در site-b به site-a تکثیر میشوند، و پس از failover جهت تکثیر بدون پیکربندی دوباره برعکس میشود.
۲-۷ از درون کد: چیدمان اشیای RBD، object map و exclusive lock#
۲-۷-۱ یک تصویر RBD روی RADOS چگونه ذخیره میشود#
تصویر RBD در RADOS هیچ «فایل» یکپارچهای نیست. librbd آن را به مجموعهای از اشیای جدا تبدیل میکند. پیشوندها در src/include/rbd_types.h تعریف شدهاند: rbd_id.، rbd_header.، rbd_object_map.، rbd_data. و اشیای سطح pool یعنی rbd_directory و rbd_trash.
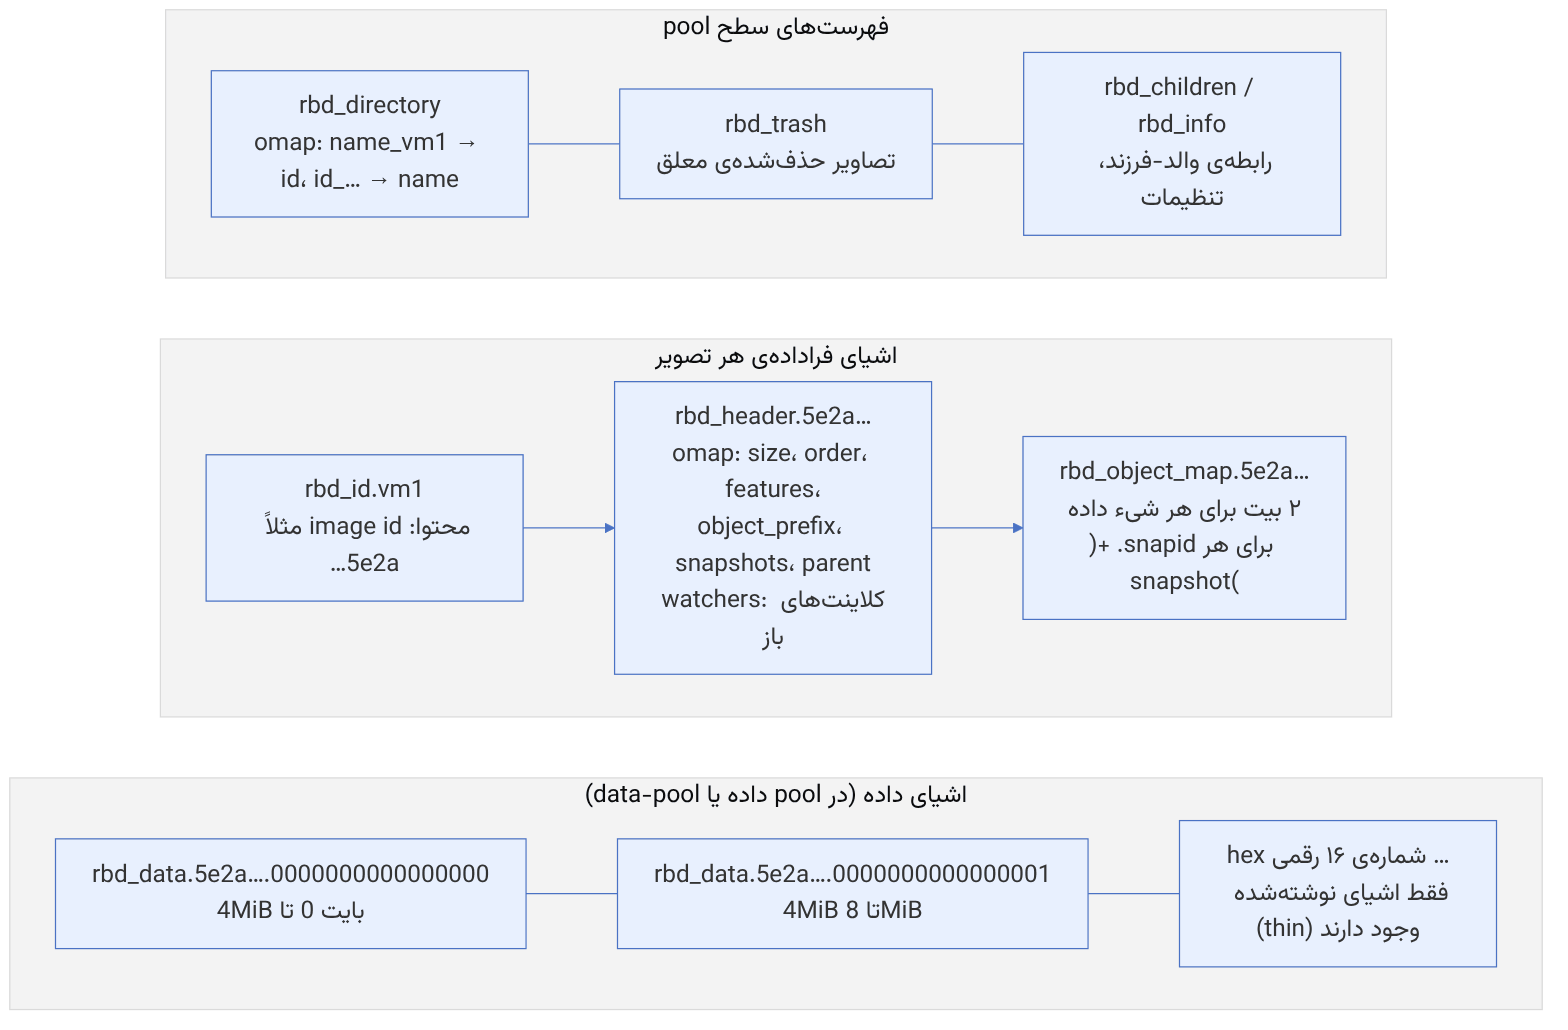
فرمول یافتن شیء برای یک offset، بدون striping سفارشی (stripe_unit = اندازهی شیء):
pseudocode (خلاصهی این کتاب از ImageCtx/Striper)
object_size = 1 << order # order=22 → 4 MiB
objno = offset // object_size
obj_off = offset % object_size
oid = sprintf("%s.%016llx", object_prefix, objno) # object_prefix = "rbd_data.<id>"rbd info rbd/vm1 | grep -E 'block_name_prefix|order|features'
rados -p rbd listomapvals rbd_directory | head
rados -p rbd listomapkeys rbd_header.$(rados -p rbd get rbd_id.vm1 - | strings)
rados -p rbd ls | grep -c "^rbd_data.<id>" # تعداد اشیای واقعاً تخصیصیافته
rbd du rbd/vm1 # با fast-diff سریع استاگر rbd du روی تصویری بزرگ ثانیهها یا دقیقهها طول میکشد، احتمالاً object map/fast-diff غیرفعال یا نامعتبر است. rbd info را برای flags نگاه کنید (object map invalid) و با rbd object-map rebuild بازسازی کنید.
۲-۷-۲ object map: دو بیت که I/O را سریع میکنند#
ثابتهای src/include/rbd/object_map_types.h:
| مقدار | نام | معنا |
|---|---|---|
| ۰ | OBJECT_NONEXISTENT | شیء وجود ندارد؛ خواندن صفر برمیگرداند و نیازی به رفتن به OSD نیست |
| ۱ | OBJECT_EXISTS | شیء وجود دارد و پس از آخرین snapshot تغییر کرده است |
| ۲ | OBJECT_PENDING | حذف/discard در جریان است |
| ۳ | OBJECT_EXISTS_CLEAN | شیء وجود دارد ولی از آخرین snapshot تغییر نکرده است (پایهی fast-diff) |
object map فقط زمانی قابل اعتماد است که یک نویسنده داشته باشد. به همین دلیل feature object-map به exclusive-lock وابسته است. سقف تعداد اشیای پوششدادهشده در cls_rbd_types.h برابر MAX_OBJECT_MAP_OBJECT_COUNT = 256000000 است؛ با اشیای ۴MiB، این حدود ۹۷۶ TiB میشود.
pseudocode: نوشتن با object map (خلاصهی این کتاب)
write(objno, data):
if objmap[objno] in {NONEXISTENT, EXISTS_CLEAN}:
objmap_update(objno, EXISTS) # ابتدا بهروزرسانی شیء rbd_object_map (cls_rbd)
send write to rbd_data.<id>.<objno>
discard(objno):
objmap_update(objno, PENDING) → remove object → objmap_update(objno, NONEXISTENT)۲-۷-۳ exclusive lock و ManagedLock#
پیشفرض rbd_default_features در rbd.yaml.in برابر layering,exclusive-lock,object-map,fast-diff,deep-flatten است. قفل با کلاس cls_lock و نام rbd_lock (RBD_LOCK_NAME) روی شیء header گرفته میشود. ماشین حالت librbd/managed_lock/AcquireRequest سه گام اصلی دارد: GET_LOCKER، LOCK_IMAGE و در صورت مرده بودن مالک، BREAK_LOCK.
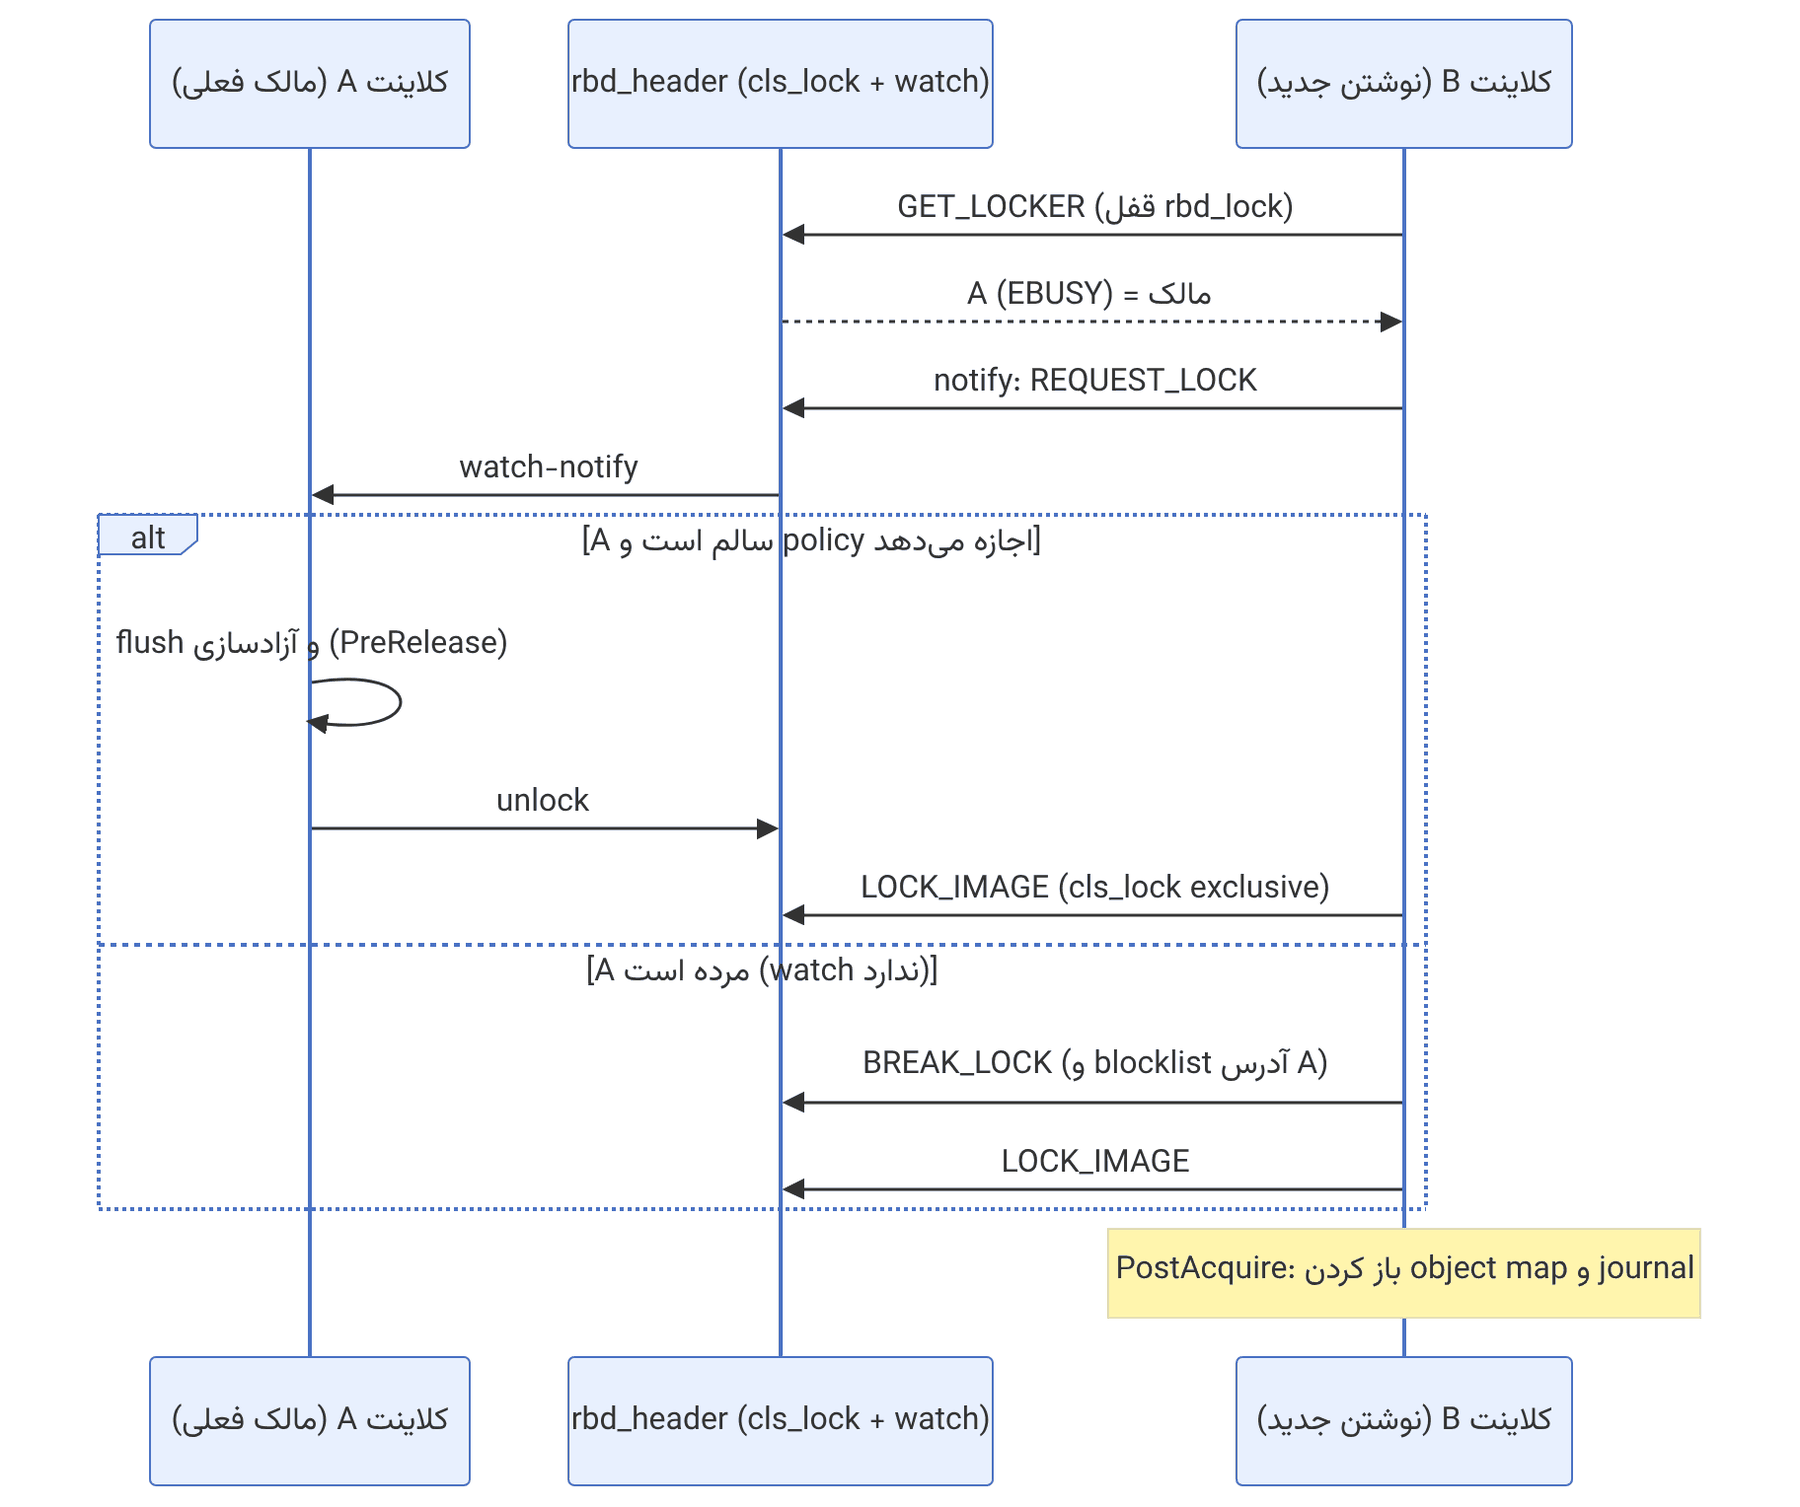
exclusive lock سازوکار حفاظت از چند نویسندهی همزمان نیست. این قفل بهصورت همکارانه بین کلاینتها دستبهدست میشود. اگر یک تصویر را روی دو VM همزمان mount کنید (مثلاً با ext4)، داده خراب میشود. برای جلوگیری سخت، rbd map --exclusive (krbd) یا قفلهای سطح orchestrator لازم است.
دستورهای عیبیابی قفل و watcher:
rbd status rbd/vm1 # watcherها
rbd lock ls rbd/vm1 # قفلهای مشورتی و مالک
ceph osd blocklist ls # آیا کلاینت قبلی blocklist شده است؟
rbd feature disable rbd/vm1 fast-diff object-map # ترتیب: وابستهها اول۲-۸ RBD با عدد: شناسهی image، discard و rbd du#
این بخش سه الگوریتم کوچک librbd را بررسی میکند که در کار روزمره زیاد دیده میشوند: نامگذاری شیءهای یک image، تبدیل discard به عملیات شیء، و چگونگی شمارش فضای مصرفی در rbd du. ارجاعها به main در نوامبر ۲۰۲۶ است. striping و object map در فصل ۳ آمدهاند.
۲-۸-۱ شناسه و شیءهای یک image#
منبع در کد: src/librbd/Utils.cc :: generate_image_id؛ src/include/rbd_types.h (پیشوندها)؛ src/cls/rbd/cls_rbd.cc :: dir_add_image
پیچیدگی: O(۱)
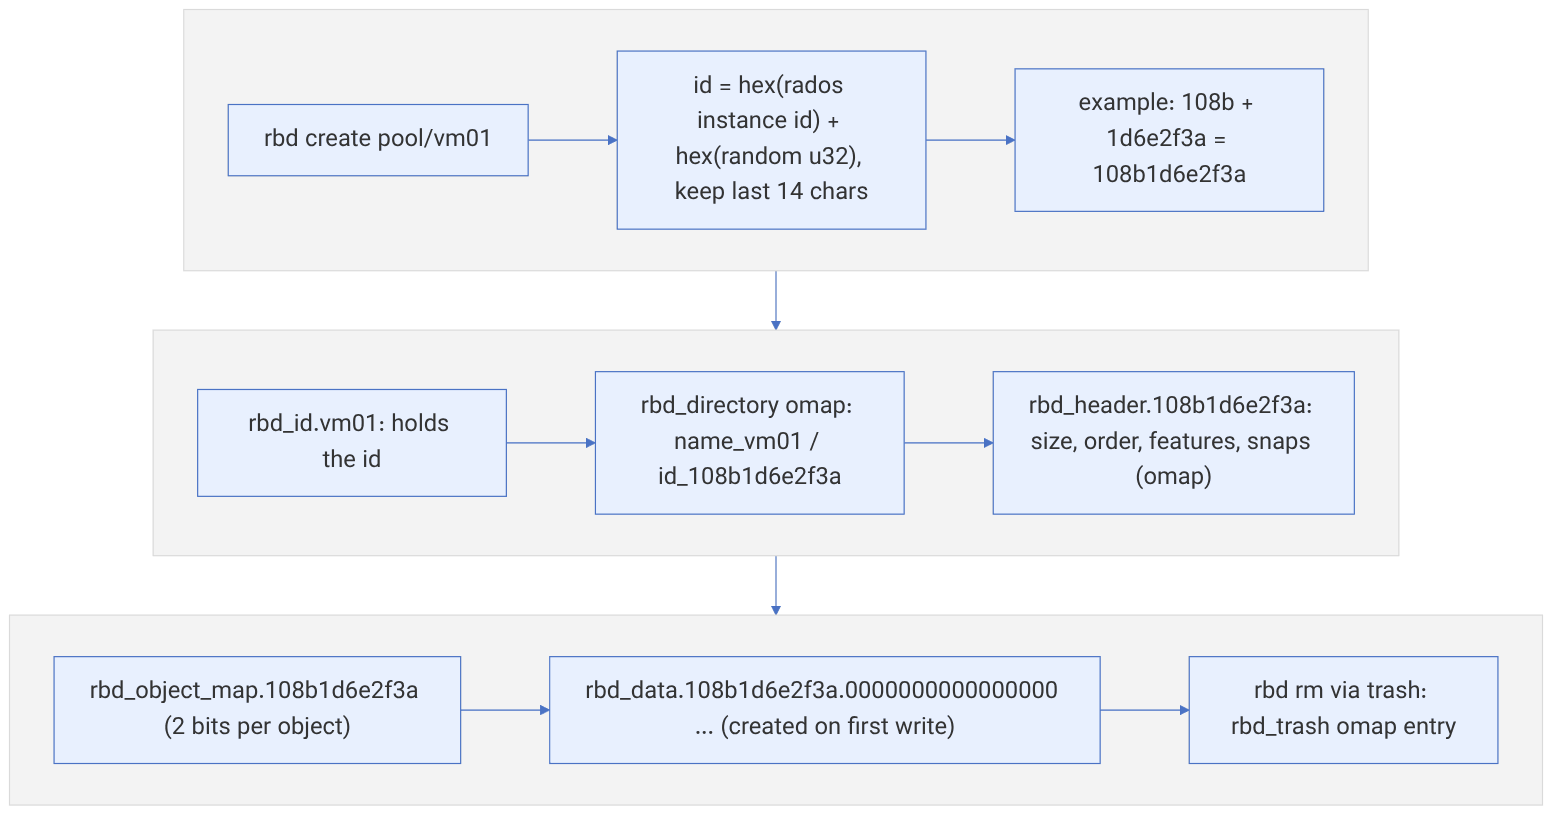
pseudocode
bid = rados.get_instance_id() # شناسهی سراسری این اتصال به کلاستر
extra = عدد تصادفی 32 بیتی
id = hex(bid) + hex(extra) # بدون صفر پیشرو؛ اگر > 14 نویسه: 14 نویسهی آخر
rbd_id.<name> ← id
rbd_directory (omap) ← name_<name> = id ، id_<id> = name
rbd_header.<id> ← size، order، features، snapshotها، parent (omap)
rbd_object_map.<id> ← 2 بیت برای هر شیء (اگر object-map فعال باشد)
rbd_data.<id>.%016x ← شیء داده با شمارهی hex شانزدهرقمی، فقط پس از اولین نوشتنمثال نمادین. اگر instance id برابر ۴۲۳۵ (۰x108b) و عدد تصادفی ۰x1d6e2f3a باشد، id برابر 108b1d6e2f3a (۱۲ نویسه) است و شیء سوم داده rbd_data.108b1d6e2f3a.0000000000000002 نام دارد. سقف ۱۴ نویسه (RBD_MAX_IMAGE_ID_LENGTH) از RBD_MAX_BLOCK_NAME_SIZE برابر ۲۴ میآید: «rbd_data.» (۹ نویسه)، ۱۴ نویسهی id و نویسهی پایان. چون شیءهای داده فقط پس از اولین نوشتن ساخته میشوند، rbd create --size 10T در کسری از ثانیه تمام میشود و هیچ فضایی مصرف نمیکند. برای دیدن شیءهای موجود، rados -p <pool> ls | grep 108b1d6e2f3a را اجرا کنید.
۲-۸-۲ discard: از محدودهی image تا remove، truncate یا zero#
منبع در کد: src/librbd/io/ImageRequest.cc :: ImageDiscardRequest::prune_object_extents؛ src/librbd/io/ObjectRequest.h :: ObjectDiscardRequest؛ src/librbd/ImageCtx.cc (skip_partial_discard)
پیچیدگی: O(تعداد شیءهای درگیر)
pseudocode
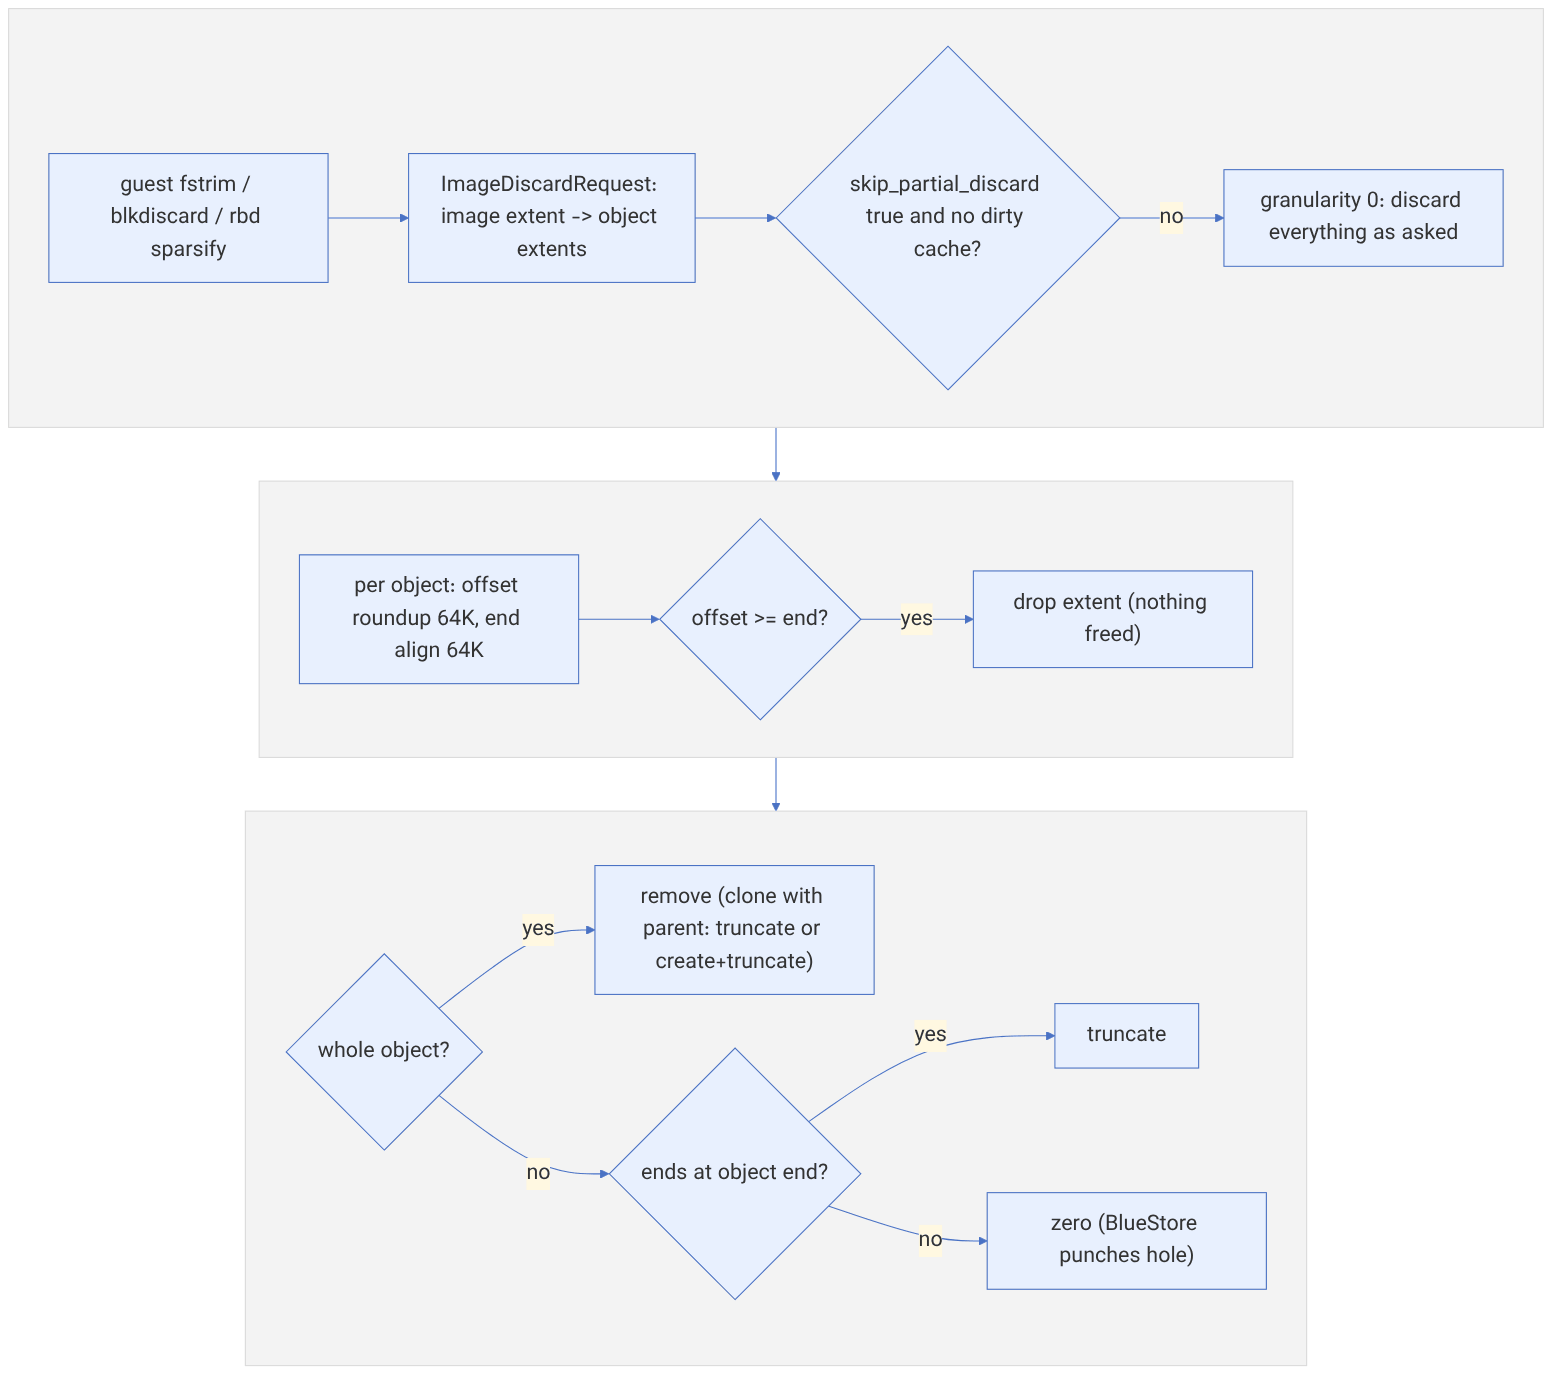
g = rbd_skip_partial_discard (true) و بدون dirty cache ? rbd_discard_granularity_bytes (64K) : 0
g = min(g, object_size)
برای هر extent شیء (off, len):
if g > 0: off = roundup(off, g) ; end = align(off + len, g) ; if off ≥ end: حذف extent
if کل شیء: REMOVE (clone با parent: TRUNCATE یا create+truncate تا parent پنهان شود)
elif به انتهای شیء میرسد: TRUNCATE
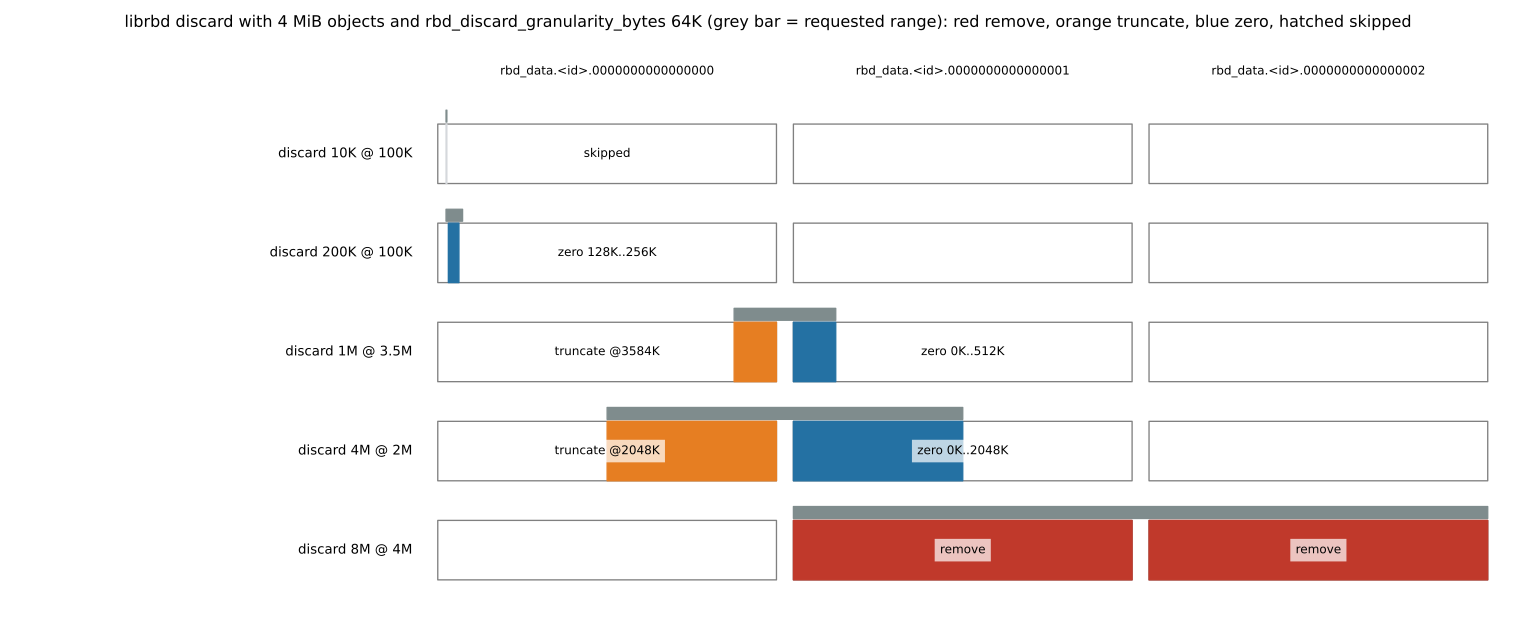
else: ZEROمثال عددی (شیء ۴ MiB). discard ۱۰ KiB در offset ۱۰۰ KiB به بازهی [۱۲۸K, 64K) گرد میشود که خالی است، پس کاری انجام نمیشود. discard ۲۰۰ KiB در offset ۱۰۰ KiB به zero در بازهی ۱۲۸K تا ۲۵۶K تبدیل میشود. discard ۱ MiB در offset ۳.۵ MiB دو عمل میسازد: truncate شیء ۰ در ۳۵۸۴K و zero بازهی ۰ تا ۵۱۲K در شیء ۱. discard ۴ MiB در offset ۲ MiB، شیء ۰ را از ۲ MiB به بعد truncate و نیمهی اول شیء ۱ را zero میکند. discard ۸ MiB در offset ۴ MiB شیءهای ۱ و ۲ را کامل حذف میکند. پس fstrim روی فایلسیستمی که بلوکهای کوچک پراکنده آزاد میکند، تقریباً هیچ فضایی پس نمیدهد. چیزی که فضا را واقعاً آزاد میکند truncate یا remove شیء است، یا zero در BlueStore که اگر همتراز با min_alloc_size باشد، آن بلوکها را آزاد میکند.
۲-۸-۳ rbd du: کل شیء یا extent دقیق؟#
منبع در کد: src/tools/rbd/action/DiskUsage.cc :: get_image_disk_usage (diff_iterate2 با whole_object = !exact)؛ src/librbd/api/DiffIterate.cc
پیچیدگی: با fast-diff: O(تعداد شیء) از object map؛ با --exact: O(تعداد شیء) فراخوانی list-snaps
pseudocode
whole_object = not --exact
diff_iterate2(from_snap, 0, size, include_parent=false, whole_object, cb)
if whole_object و fast-diff معتبر: از object map، هر شیء EXISTS یا EXISTS_CLEAN = یک بازهی کامل
else: برای هر شیء list-snaps ← calc_snap_set_diff
# بدون snapshot: بازهی [0, size شیء)، نه extentهای پراکندهی نوشتهشده
USED = Σ طول بازهها # PROVISIONED = اندازهی image
اگر fast-diff نامعتبر یا غیرفعال باشد: هشدار و کندی (پیمایش همهی شیءها)اندازهگیری واقعی. این چهار بار کاری را روی یک کلاستر آزمایشی سهOSDی با Ceph 18.2.7 (Reef، بستههای Debian) و imageهای ده گیگابایتی با شیء ۴ MiB و featureهای پیشفرض (۶۱، یعنی layering، exclusive-lock، object-map، fast-diff و deep-flatten) اجرا کردیم:
| بار کاری | بایت نوشتهشده | rbd du --exact | rbd du پیشفرض |
|---|---|---|---|
| A: صد نوشتن ۱ KiB در آفست ۰ صد شیء | ۱۰۰ KiB | ۱۰۰ KiB | ۴۰۰ MiB |
| B: هزار نوشتن ۱ KiB در آفست ۰ هزار شیء | ۱۰۰۰ KiB | ۱۰۰۰ KiB | ۴۰۰۰ MiB |
| C: 256 MiB ترتیبی | ۲۵۶ MiB | ۲۵۶ MiB | ۲۵۶ MiB |
| D: دوهزار نوشتن ۴ KiB تصادفی در ۲ GiB نخست (۵۰۳ شیء) | ۷.۸ MiB | ۱.۵۱ GiB | ۱.۹۶ GiB |
سطر D نکتهای را نشان میدهد که از نام --exact برنمیآید. در calc_snap_set_diff (فایل src/librados/snap_set_diff.cc) اگر شیء در snapshot آغاز وجود نداشته باشد، diff برابر کل بازهی [0, size) شیء گذاشته میشود. اندازهی یک شیء RADOS بالاترین بایت نوشتهشده در آن است. پس --exact تا آخرین بایت هر شیء را میشمارد، نه extentهای پراکنده را. نوشتن ۴ KiB در انتهای یک شیء آن را ۴ MiB حساب میکند. در D هر شیء بهطور میانگین حدود چهار نوشتن تصادفی دارد. امید بیشینهی چهار نقطهی یکنواخت ۴/۵ طول است و همین ۵۰۳ × ۴ MiB × ۰.۸ ≈ ۱.۵۷ GiB را پیشبینی میکند که به ۱.۵۱ GiB اندازهگیریشده نزدیک است. --exact فقط وقتی به دادهی واقعاً نوشتهشده نزدیک است که نوشتنها از ابتدای شیء پیوسته باشند (A، B و C). هیچکدام از دو عدد مصرف خام را نشان نمیدهد. مصرف خام به size یا k+m و به min_alloc_size BlueStore (۴ KiB در نسخههای اخیر) هم بستگی دارد و BlueStore بخشهای نانوشته را تخصیص نمیدهد. برای ظرفیتسنجی از ceph df detail استفاده کنید و rbd du را فقط برای مقایسهی imageها به کار ببرید.
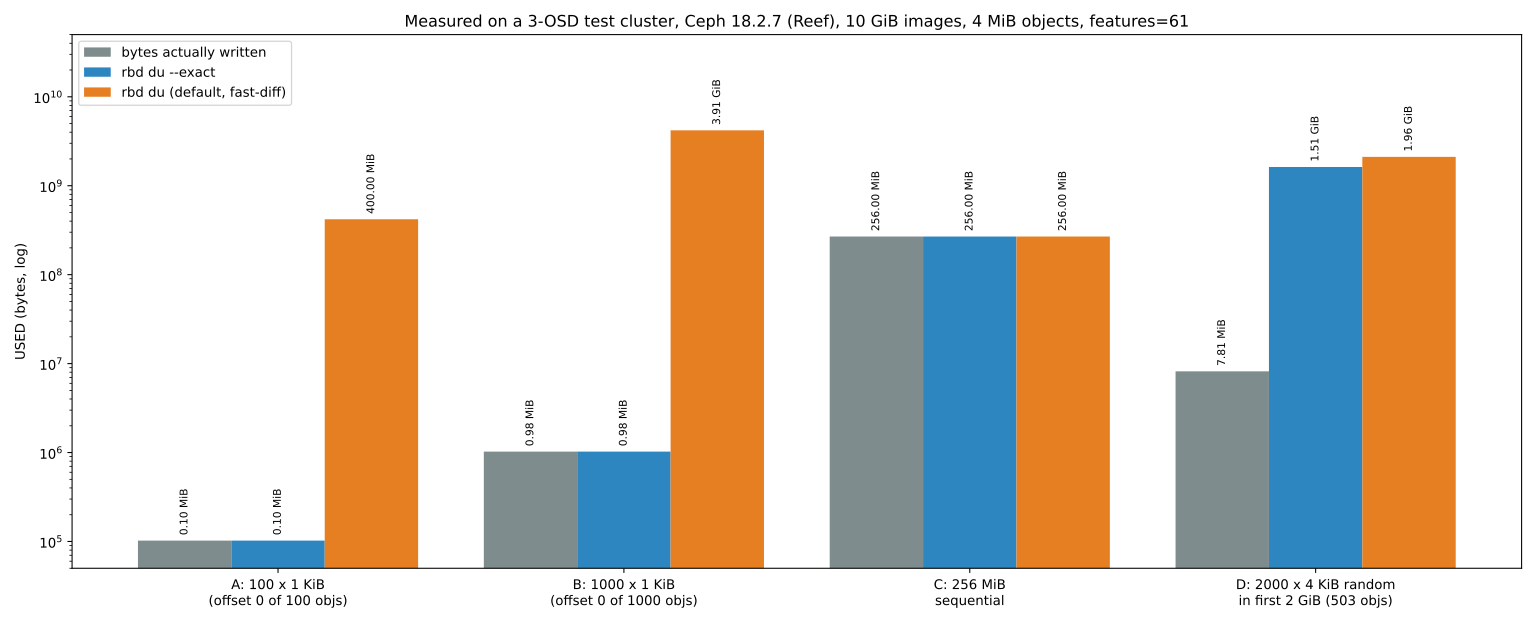
rbd du --exact و نارنجی rbd du پیشفرض (شمارش کل شیء از object map). محور عمودی لگاریتمی است. در بار تصادفی D، --exact هم حدود دویست برابر دادهی نوشتهشده را نشان میدهد، چون هر شیء را از بایت ۰ تا بالاترین بایت نوشتهشده میشمارد۲-۹ بازگشت از سانحه#
۲-۹-۱ سه سناریو#
در عمل با سه موقعیت متفاوت روبهرو میشویم و روش هر کدام فرق دارد:
| سناریو | وضعیت site-a | اقدام | از دست رفتن داده |
|---|---|---|---|
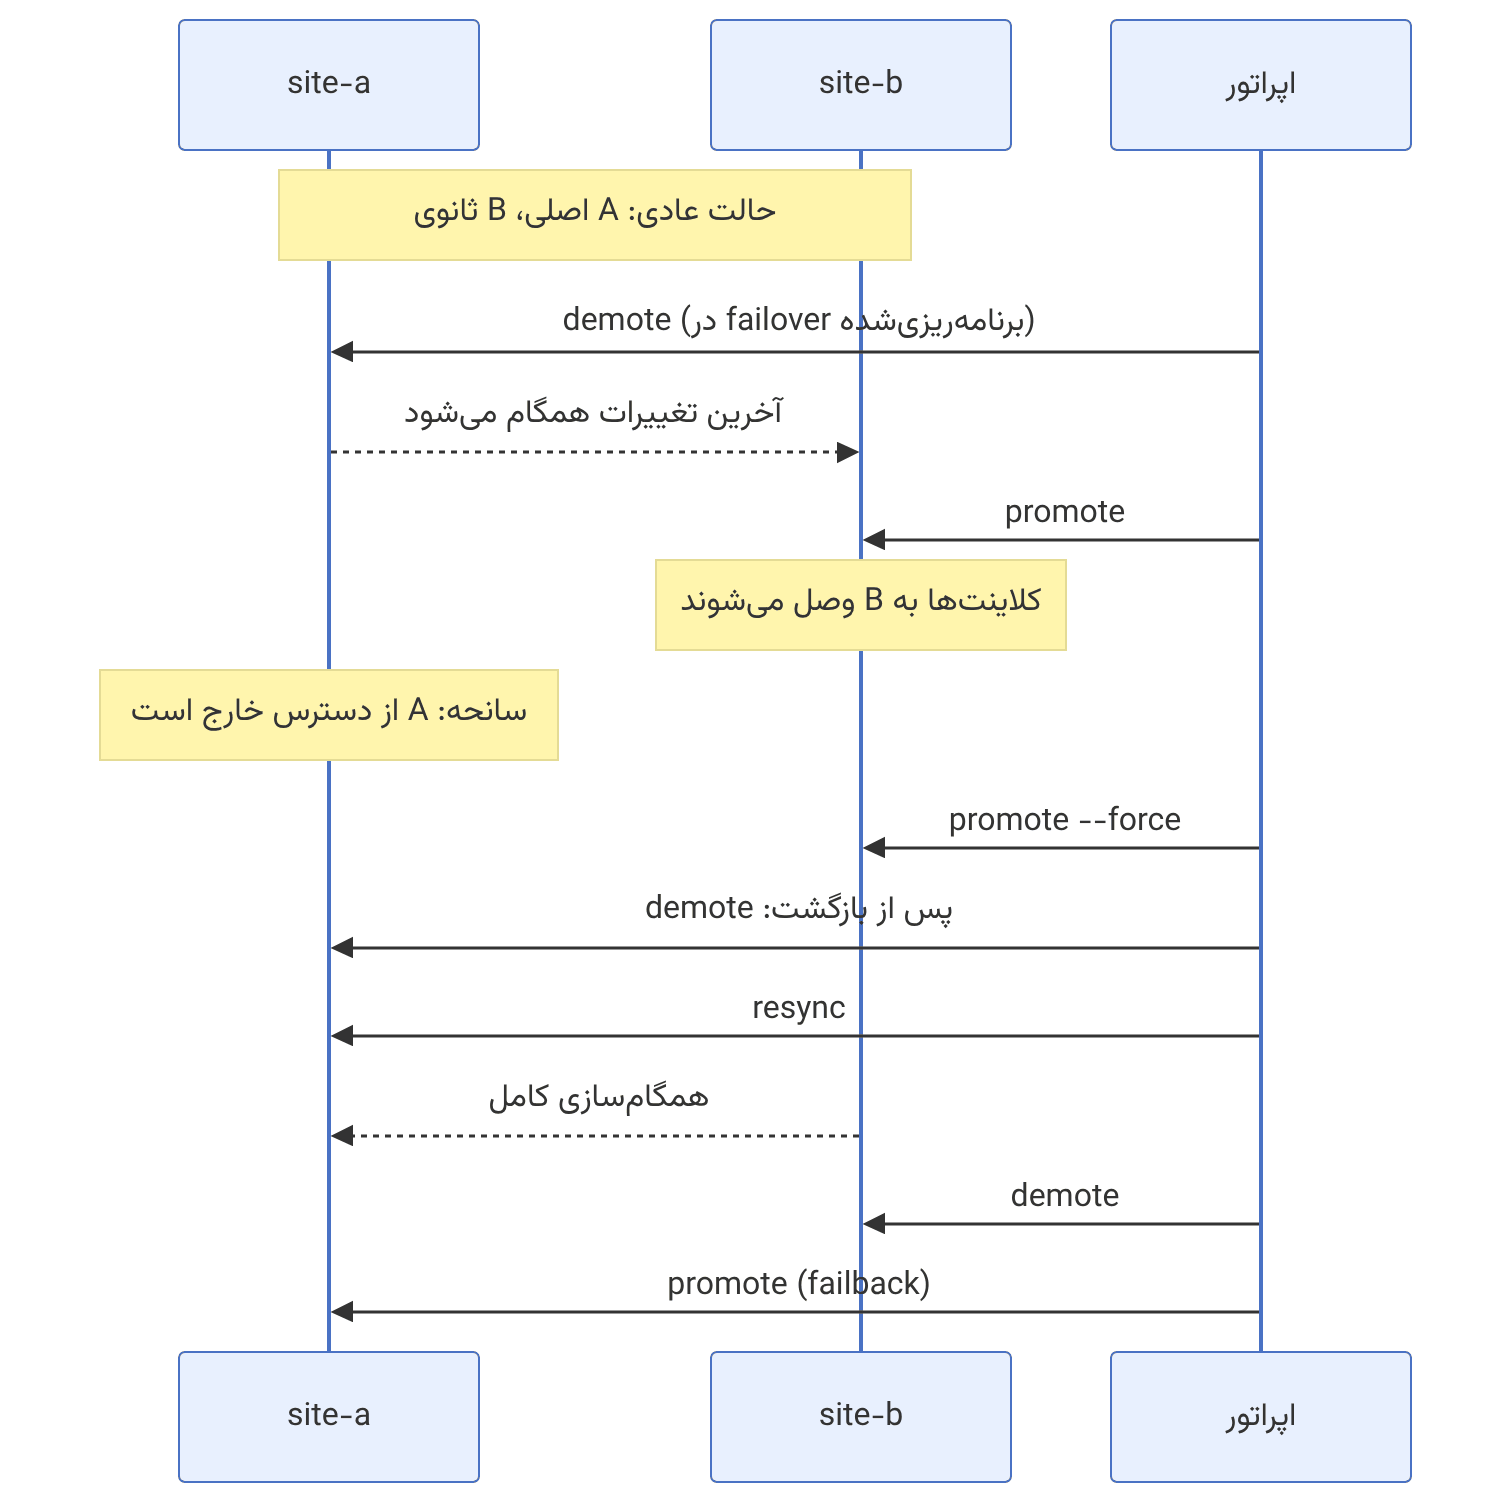
| جابهجایی برنامهریزیشده (switchover) | سالم | demote در A، صبر تا همگام شدن، promote در B | صفر |
| سانحه (failover) | در دسترس نیست | promote --force در B | به اندازهی RPO |
| بازگشت (failback) | دوباره سالم شده | demote و resync در A، سپس switchover معکوس | صفر (پس از resync) |
۲-۹-۲ جابهجایی برنامهریزیشده#
# ۱. توقف برنامهها و umount در site-a
# ۲. تنزل image در site-a
rbd --cluster site-a mirror image demote vms/db01
# ۳. صبر تا site-b آخرین snapshot را دریافت کند
rbd --cluster site-b mirror image status vms/db01
# ۴. ارتقا در site-b و راهاندازی برنامهها آنجا
rbd --cluster site-b mirror image promote vms/db01برای کل pool هم دستورهای rbd mirror pool demote vms و rbd mirror pool promote vms وجود دارند.
۲-۹-۳ failover اجباری#
وقتی site-a در دسترس نیست، demote ممکن نیست. image را در site-b بهاجبار ارتقا میدهیم:
rbd --cluster site-b mirror image promote --force vms/db01promote اجباری یعنی پذیرفتن از دست رفتن تغییراتی که هنوز به site-b نرسیده بودند. پیش از آن مطمئن شوید site-a واقعاً از کار افتاده یا کاملاً ایزوله شده است. اگر site-a فقط از دید شما قطع است اما برنامههایش هنوز روی image مینویسند، با promote اجباری split-brain ساختهاید: دو نسخهی primary با تاریخچههای متفاوت. Fencing (قطع دسترسی کلاینتهای قدیمی) بخشی جداییناپذیر از هر runbook بازیابی از سانحه است.
۲-۹-۴ failback#
وقتی site-a برگشت، image آنجا هنوز خودش را primary میداند. باید آن را تنزل دهیم و دوباره همگامش کنیم:
rbd --cluster site-a mirror image demote vms/db01
rbd --cluster site-a mirror image resync vms/db01
rbd --cluster site-a mirror image status vms/db01   # تا up+replaying
# پس از همگام شدن، switchover معکوس:
rbd --cluster site-b mirror image demote vms/db01
rbd --cluster site-a mirror image promote vms/db01resync نسخهی محلی را دور میریزد و از نسخهی primary فعلی دوباره میسازد. برای imageهای بزرگ این یعنی انتقال کامل داده؛ پهنای باند و زمان لازم را در برنامهریزی RTO در نظر بگیرید.
در آزمایشگاه، یک image را با حالت snapshot و زمانبندی یک دقیقهای mirror کنید، داخلش فایلی بنویسید، دو دقیقه صبر کنید، سپس rbd-mirror کلاستر مقصد را متوقف کنید و فایل دیگری بنویسید. حالا با promote اجباری در مقصد ببینید کدام فایلها آنجا هستند. این آزمایش ساده مفهوم RPO را ملموس میکند.
۲-۹-۵ ملاحظات طراحی DR#
- نام poolها در دو طرف باید یکسان باشد (یا از remap namespace در نسخههای جدید استفاده کنید).
- ظرفیت مقصد باید برای همهی imageهای mirrorشده بهعلاوهی snapshotهای mirror کافی باشد.
- پهنای باند بینسایتی: نرخ تغییر روزانهی داده (نه اندازهی کل) تعیینکننده است. با
rbd mirror image status و آمار rbd-mirror در Prometheus، عقبماندگی را پایش کنید. - پایش و هشدار: هشدار برای imageهایی که بیش از دو برابر فاصلهی زمانبندی از آخرین همگامسازیشان گذشته است.
- آزمون دورهای: runbook بازیابی از سانحهای که آزموده نشده، فقط یک سند امیدوارکننده است. دستکم هر فصل یکبار switchover واقعی انجام دهید.
۲-۱۰ تکمیلی و بهروز#
۲-۱۰-۱ دروازهی NVMe-oF#
از Squid به بعد دروازهی NVMe over Fabrics (روی TCP) راه رسمی ارائهی RBD به میزبانهایی است که کلاینت Ceph ندارند. این دروازه بر پایهی SPDK ساخته شده و با cephadm مستقر میشود. دروازهها در gateway group سازمان مییابند. طبق مستندات، هر گروه در حال حاضر تا هشت دروازه را پشتیبانی میکند و دسترسپذیری بالا بهصورت فعال/آمادهبهکار برای هر namespace کار میکند: هر namespace به یک load-balancing group تعلق دارد و با خرابی یک دروازه، دروازهی دیگری مسئولیتش را بر عهده میگیرد. برای HA دستکم دو دروازه لازم است. داشبورد Ceph از Tentacle مدیریت گروهها و namespaceهای متعدد NVMe-oF را پشتیبانی میکند و در Umbrella امکاناتی مثل TLS/mTLS، احراز هویت DHCHAP و KMIP به آن افزوده شده است.
ceph osd pool create nvmeof-pool && rbd pool init nvmeof-pool
ceph orch apply nvmeof nvmeof-pool group1 --placement="ceph-node2,ceph-node3"
۲-۱۰-۲ رمزنگاری سطح image#
RBD از نسخهی Pacific میتواند image را با قالب LUKS1 یا LUKS2 در خود librbd رمزنگاری کند (rbd encryption format). کلید رمزنگاری با passphrase کاربر محافظت میشود و هیچگاه ذخیره نمیشود. این قابلیت با librbd و rbd-nbd کار میکند. برای krbd، رمزنگاری معمول با dm-crypt روی دستگاه /dev/rbdX انجام میشود (روشی که Ceph CSI هم برای volumeهای رمزنگاریشده به کار میبرد).
rbd encryption format rbd/secure01 luks2 /root/passphrase.bin
rbd-nbd map rbd/secure01 -o encryption-format=luks2,encryption-passphrase-file=/root/passphrase.bin
۲-۱۰-۳ کیفیت سرویس (QoS)#
librbd محدودیتهای QoS سمت کلاینت دارد که میتوان آنها را در سطح pool یا image تعیین کرد، مثل rbd_qos_iops_limit و rbd_qos_bps_limit:
rbd config image set rbd/vm01 rbd_qos_iops_limit 2000
rbd config pool set rbd rbd_qos_bps_limit 209715200   # 200 MiB/s
rbd config image ls rbd/vm01 | grep qos
این محدودیتها فقط روی librbd اعمال میشوند، نه krbd. برای کلاینتهای krbd، کنترل باید در لایهی cgroup میزبان انجام شود.
۲-۱۰-۴ تغییرات دیگر از زمان کتاب#
- snapshot گروهی:
rbd group امکان گرفتن snapshot سازگار از چند image همزمان را میدهد؛ برای برنامههایی که دادهشان روی چند دیسک است (مثلاً داده و لاگ پایگاه داده). در Tentacle دستورهای مربوط به اطلاعات گروه و snapshot گروهی گسترش یافتهاند. - remap namespace در mirroring: در Tentacle امکان mirror کردن یک namespace به namespace با نام دیگر در کلاستر مقابل اضافه شده است.
- پیشفرض msgr2 برای krbd: از Tentacle،
rbd device map بهطور پیشفرض از پروتکل msgr2 استفاده میکند. - diff-iterate محلی: در Squid،
diff-iterate میتواند محلی اجرا شود که کارایی همگامسازی زندهی دیسک در QEMU و ابزارهای پشتیبانگیری مبتنی بر تفاضل را بهشدت بهتر کرده است. - دروازهی iSCSI: در حالت نگهداری است؛ برای استقرار تازه NVMe-oF را انتخاب کنید.
۲-۱۱ جمعبندی و مرور#
۲-۱۱-۱ خلاصهی فصل#
- image در RBD روی اشیای ۴ مگابایتی RADOS نگاشت میشود، thin است و روی همهی OSDهای pool پخش میشود.
- کلاینت باید کاربر اختصاصی با
profile rbd داشته باشد، نه client.admin. - krbd سریع و بدون وابستگی است اما همهی ویژگیها را ندارد؛ librbd کاملترین مسیر است.
- snapshot فوری و COW است؛ clone نوشتنی و ارزان است و flatten وابستگی آن را قطع میکند. snapshot بدون freeze فقط crash-consistent است.
- RBD mirroring در دو حالت journal (RPO ثانیهای، سربار بالا) و snapshot (RPO برابر زمانبندی، سربار کم) کار میکند و با promote و demote جهت آن عوض میشود.
- promote اجباری بدون fencing یعنی خطر split-brain.
۲-۱۱-۲ اشتباهات رایج#
- استفاده از
client.admin روی همهی hypervisorها. - فراموش کردن
_netdev و ترتیب خاموش شدن، و گیر کردن بوت یا خاموش شدن میزبان. - کوچک کردن image بدون کوچک کردن فایلسیستم.
- فعال نکردن discard و پر شدن تدریجی کلاستر با فضای حذفشدهی داخل ماشینهای مجازی.
- نگه داشتن صدها snapshot قدیمی که هر نوشتن را گرانتر و scrub را سنگینتر میکنند.
- فعال کردن journaling روی imageهایی که با krbd map میشوند.
- نداشتن runbook آزمودهشده برای failover و failback.
۲-۱۱-۳ تمرین عملی#
- ۱. یک کاربر با
profile rbd محدود به namespace بسازید و نشان دهید نمیتواند imageهای namespace دیگر را ببیند. - ۲. یک image بسازید، map و فرمت کنید، ۱ گیگابایت داده بنویسید و
rbd du را ببینید. سپس فایلها را حذف کنید، fstrim بزنید و دوباره rbd du را مقایسه کنید. - ۳. یک image طلایی با snapshot بسازید، ده clone از آن ایجاد کنید و زمان ساخت را اندازه بگیرید. یکی از cloneها را flatten کنید و فضای مصرفی را مقایسه کنید.
- ۴. دو کلاستر تکنودی بسازید و mirroring حالت snapshot با زمانبندی ۵ دقیقهای برقرار کنید. یک switchover کامل و یک failover اجباری با failback انجام دهید و همهی گامها را به شکل runbook بنویسید.
- ۵. با
rbd bench --io-type write --io-size 4K --io-threads 16 rbd/disk01 و سپس با --io-size 4M کارایی را بسنجید و تفاوت IOPS و توان را توضیح دهید.
۲-۱۱-۴ پرسشهای مرور#
- ۱. یک image صد گیگابایتی تازهساختهشده که هنوز در آن نوشته نشده، چند شیء در RADOS دارد؟ چرا؟
- ۲. تفاوت krbd، librbd و rbd-nbd چیست و هر کدام کجا مناسب است؟
- ۳. چرا ویژگی object-map به exclusive-lock وابسته است؟
- ۴. snapshot crash-consistent با application-consistent چه فرقی دارد و چطور دومی را به دست میآوریم؟
- ۵. در قالب clone نسخهی ۲ چه چیزی نسبت به نسخهی ۱ عوض شده است؟
- ۶. حالتهای journal و snapshot در mirroring را از نظر RPO، سربار و سازگاری با krbd مقایسه کنید.
- ۷. تفاوت
--direction rx-only و rx-tx در bootstrap import چیست؟ - ۸. چرا promote اجباری بدون fencing خطرناک است؟
- ۹. گامهای failback پس از بازگشت سایت اصلی کداماند؟
- ۱۰. برای میزبان VMware که کلاینت Ceph ندارد، امروز کدام راه برای استفاده از RBD توصیه میشود؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲-۱۱-۵ منابع این فصل#
- مستندات Ceph — Ceph Block Device
https://docs.ceph.com/en/latest/rbd/ - مستندات Ceph — دستورهای پایهی RBD
https://docs.ceph.com/en/latest/rbd/rados-rbd-cmds/ - مستندات Ceph — snapshotهای RBD و clone
https://docs.ceph.com/en/latest/rbd/rbd-snapshot/ - مستندات Ceph — RBD mirroring
https://docs.ceph.com/en/latest/rbd/rbd-mirroring/ - مستندات Ceph — مهاجرت زندهی image
https://docs.ceph.com/en/latest/rbd/rbd-live-migration/ - مستندات Ceph — رمزنگاری image
https://docs.ceph.com/en/latest/rbd/rbd-encryption/ - مستندات Ceph — مرجع پیکربندی librbd و QoS
https://docs.ceph.com/en/latest/rbd/rbd-config-ref/ - مستندات Ceph — دروازهی NVMe-oF
https://docs.ceph.com/en/latest/rbd/nvmeof-overview/ - مستندات Ceph — دروازهی iSCSI (وضعیت نگهداری
https://docs.ceph.com/en/latest/rbd/iscsi-overview/ - مستندات Ceph — krbd
https://docs.ceph.com/en/latest/rbd/rbd-ko/ - مستندات cephadm — استقرار rbd-mirror
https://docs.ceph.com/en/latest/rbd/rbd-mirroring/ - یادداشتهای انتشار Squid
https://docs.ceph.com/en/latest/releases/squid/