لایههای پایینی (۱): دستگاه بلوکی، bufferlist، mempool و crc32c
حوصله ندارم این فصل در چند خط
-
KernelDevice دستگاه بلوکی را با O_DIRECT باز میکند و I/O را با libaio یا io_uring میفرستد؛ offset، طول و بافر باید با اندازهی بلوک همتراز باشند. -
flush به fdatasync ختم میشود و discard میتواند همگام یا ناهمگام باشد؛ NVMEDevice در SPDK هسته را کاملاً دور میزند. -
bufferlist فهرستی از اشارهگرهای بافر با شمارش ارجاع است؛ c_str() روی فهرست چندتکه بیصدا همه را در یک بافر کپی میکند. - mempoolها حافظه را به تفکیک زیرسیستم حساب میکنند و BlueStore بهطور پیشفرض بلوکها را با crc32c بررسی میکند.
۲۳-۱ جایگاه این بخش#
بخش «لایههای پایینی» از جایی شروع میشود که فصلهای قبل متوقف شدند: پس از اینکه BlueStore تصمیم گرفت «این بایتها را در این offset بنویس»، چه اتفاقی میافتد؟ این فصل مسیر را از bufferlist در حافظهی ceph-osd تا فرمان DMA روی دستگاه دنبال میکند. فصلهای بعدی همین کار را برای قالب روی دیسک BlueStore، RocksDB، msgr2، ریاضیات erasure code، CRUSH در سطح بیت و کلاینتهای هسته انجام میدهند. همهی نامها با شاخهی main مخزن ceph/ceph تطبیق داده شدهاند.
-
KernelDevice: باز کردن دستگاه با O_DIRECT، قفل، write hint، discard و flush - libaio در برابر io_uring و مسیر
aio_submit تا callback تکمیل - همترازی و
bdev_block_size - ساختار درونی
bufferlist، ptr و raw، کپی صفر و mempool - crc32c: انتخاب پیادهسازی سختافزاری و یک مثال عددی
۲۳-۲ KernelDevice: پنجرهی BlueStore به دیسک#
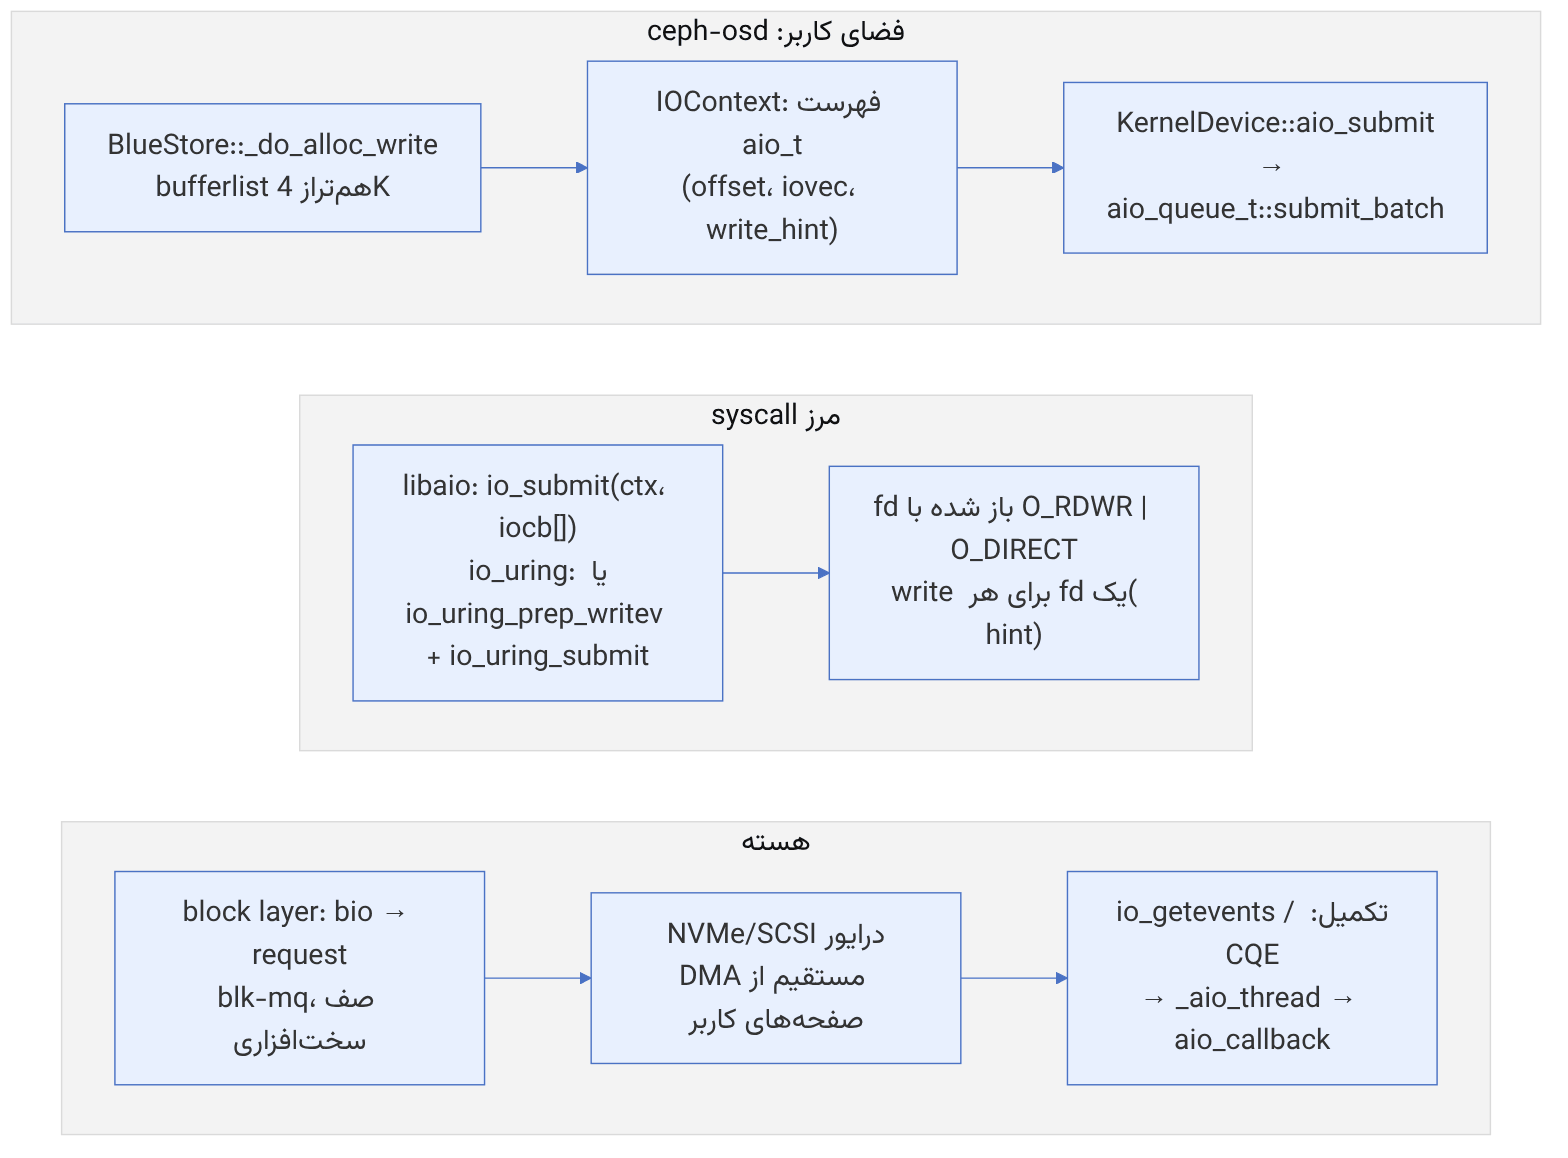
src/blk/BlockDevice.h رابط انتزاعی BlockDevice را تعریف میکند و BlockDevice.cc نوع آن را انتخاب میکند. در شاخهی main فقط دو نوع وجود دارد: aio (کلاس KernelDevice در src/blk/kernel/) و spdk (کلاس NVMEDevice در src/blk/spdk/). پیادهسازی PMEM که در نسخههای قدیمیتر وجود داشت، در main دیگر در block_device_t نیست.
۲۳-۲-۱ باز کردن دستگاه#
KernelDevice::open() برای هر مقدار write hint از WRITE_LIFE_NOT_SET تا WRITE_LIFE_MAX دو fd باز میکند: یکی در fd_directs با O_RDWR | O_DIRECT و دیگری در fd_buffereds بدون O_DIRECT برای مسیرهای buffered (مثلاً خواندنهای بزرگ BlueFS). اگر هسته از F_SET_FILE_RW_HINT پشتیبانی کند، روی هر fd hint مربوطه با fcntl تنظیم میشود تا SSDهای دارای streams بتوانند دادههای با طول عمر متفاوت را جدا نگه دارند. روی fd buffered هم posix_fadvise(..., POSIX_FADV_RANDOM) تنظیم میشود.
قفل انحصاری: KernelDevice::_lock() ابتدا قفل رکورد (struct flock با F_WRLCK) و در صورت نیاز flock(fd, LOCK_EX | LOCK_NB) را امتحان میکند، با حداکثر bdev_flock_retry=3 بار تلاش دوباره. این قفل مانع میشود که دو فرایند (مثلاً OSD در حال اجرا و یک ceph-bluestore-tool اشتباهی) همزمان روی یک دستگاه بنویسند.
pseudocode: KernelDevice::open (خلاصهی این کتاب)
for hint in WRITE_LIFE_NOT_SET .. WRITE_LIFE_MAX-1:
fd_directs[hint] = open(path, O_RDWR | O_DIRECT | O_CLOEXEC)
fd_buffereds[hint] = open(path, O_RDWR | O_CLOEXEC)
if F_SET_FILE_RW_HINT: fcntl(fd, F_SET_FILE_RW_HINT, &hint)
_lock() # flock/F_WRLCK، تا 3 بار retry
fstat → size، block_size = bdev_block_size (4K)؛ اگر st_blksize فرق کند فقط هشدار
detect rotational، discard support، NUMA node، device model/serial
if bdev_aio: io_queue = io_uring (اگر bdev_ioring=true و پشتیبانی شود) یا libaio
start _aio_thread ؛ start discard threads (bdev_async_discard_threads)۲۳-۲-۲ همترازی#
با O_DIRECT، هسته داده را مستقیم از صفحههای کاربر DMA میکند. بنابراین offset، طول و آدرس بافر باید با اندازهی بلوک منطقی دستگاه همتراز باشند. Ceph این را با bdev_block_size=4_K و assert در مسیرهای نوشتن تضمین میکند. بافرهای خواندن با bdev_read_buffer_alignment=4_K تخصیص مییابند. نتیجهی عملی: BlueStore هرگز کمتر از ۴K روی دستگاه نمینویسد. نوشتن ۱۰۰ بایتی کلاینت یا به یک read-modify-write روی یک بلوک ۴K تبدیل میشود یا (روی HDD) به نوشتن deferred در WAL (فصل ۲۴).
دیسکهایی که «۴K native» نیستند ولی بلوک فیزیکی ۴K را در قالب ۵۱۲e گزارش میکنند، با bdev_block_size=4K درست کار میکنند. اما دستگاهی با بلوک منطقی بزرگتر از ۴K (برخی آرایههای سختافزاری) با پیشفرضها سازگار نیست و OSD هنگام mkfs یا open خطا میدهد. پیش از خرید، مقدار cat /sys/block/<dev>/queue/logical_block_size را بررسی کنید.
۲۳-۲-۳ libaio یا io_uring#
| گزینه | پیشفرض (main) | نقش |
|---|---|---|
| bdev_aio | true | استفاده از I/O ناهمگام |
| bdev_ioring | false | استفاده از io_uring بهجای libaio (اگر هسته و liburing پشتیبانی کنند) |
| bdev_ioring_hipri / bdev_ioring_sqthread_poll | false / false | poll سختافزاری و thread ارسال هسته |
| bdev_aio_max_queue_depth | ۱۰۲۴ | عمق صف aio |
| bdev_aio_reap_max | ۱۶ | حداکثر تکمیلهای برداشتهشده در هر بار |
| bdev_aio_poll_ms | ۲۵۰ | مهلت انتظار برای تکمیل |
| bdev_block_size | ۴_K | اندازهی بلوک فرضی |
| bdev_enable_discard | false | ارسال discard/TRIM پس از آزادسازی فضا |
| bdev_async_discard_threads | ۰ | discard ناهمگام (جایگزین گزینهی قدیمی bdev_async_discard) |
| bdev_flock_retry | ۳ | تلاش دوباره برای قفل |
در libaio (src/blk/aio/aio.cc)، aio_queue_t::submit_batch آرایهای از iocbها را با io_submit ارسال میکند. فیلد iocb باید نخستین عضو aio_t باشد تا اشارهگر برگشتی از هسته مستقیم به aio_t cast شود (توضیح خود کد در aio.h). در صورت EAGAIN، ارسال با تأخیر کوتاه تکرار میشود. get_next_completed با io_getevents منتظر تکمیل میماند. در io_uring (src/blk/kernel/io_uring.cc) همان رابط با io_uring_prep_writev، io_uring_prep_readv و io_uring_submit پیاده شده است.
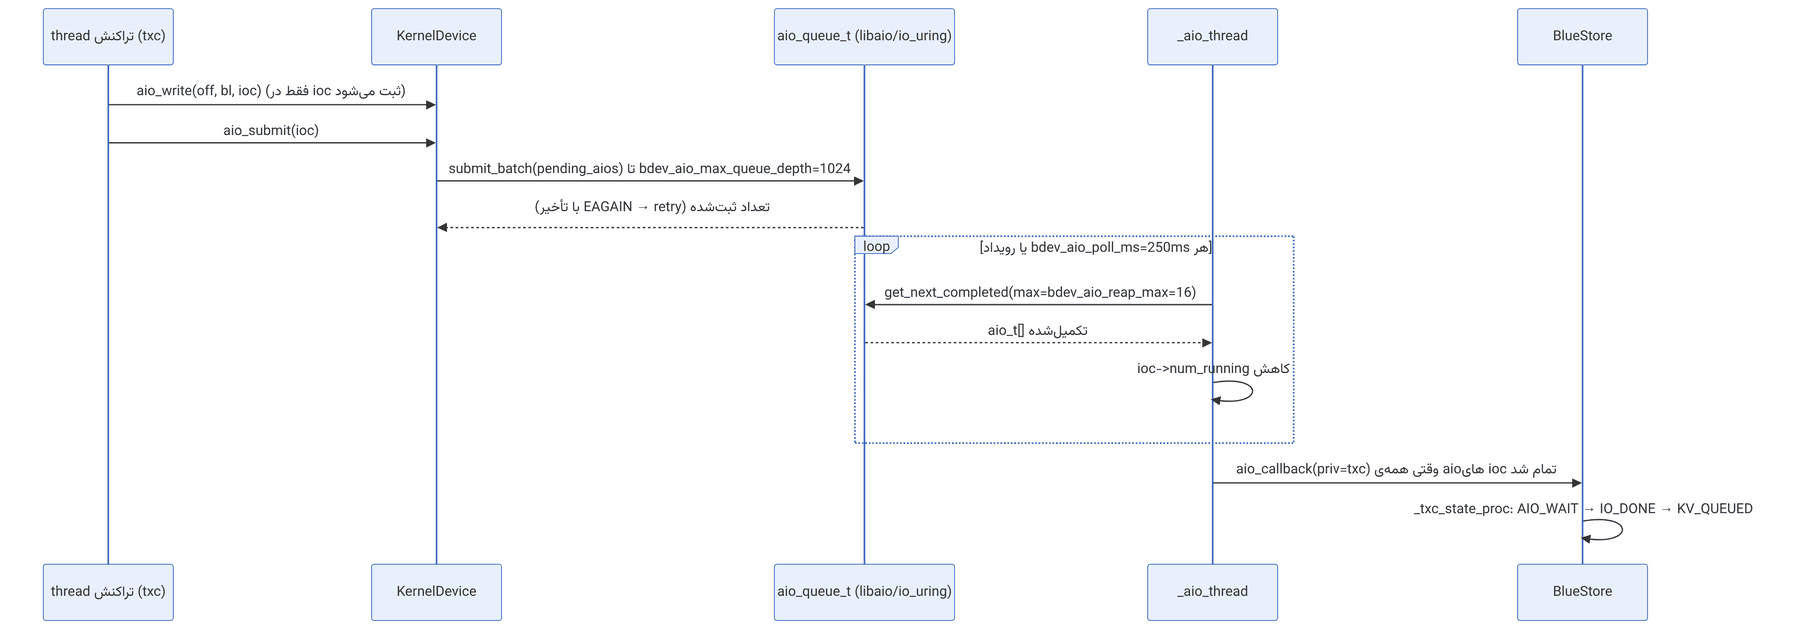
// from ceph/ceph, LGPL — src/blk/kernel/KernelDevice.cc, _aio_thread() (excerpt)
	if (--ioc->num_running == 0) {
	    aio_callback(aio_callback_priv, ioc->priv);
۲۳-۲-۴ flush و discard#
KernelDevice::flush() در انتها fdatasync(fd_directs[WRITE_LIFE_NOT_SET]) را اجرا میکند تا کش نوشتن دستگاه تخلیه شود. در BlueStore::_kv_sync_thread منطقی به نام force_flush وجود دارد: اگر داده و DB روی یک دستگاه باشند، commit لاگ BlueFS خودش دستگاه را flush میکند و flush جداگانه لازم نیست. در غیر این صورت (یا وقتی چیزی برای commit در RocksDB نیست)، flush دستگاه داده اجباری میشود تا دادهی aio پیش از ثبت فراداده پایدار باشد. discard فقط وقتی ارسال میشود که دستگاه آن را پشتیبانی کند و bdev_enable_discard=true باشد. با bdev_async_discard_threads>0، discard در threadهای جدا و با سقف صف bdev_async_discard_max_pending انجام میشود تا تأخیر نوشتن را بالا نبرد.
چرا discard پیشفرض خاموش است: روی بسیاری از SSDهای SATA، فرمان TRIM همگام و کند است و میتواند صف دستگاه را چند میلیثانیه مسدود کند. SSDهای امروزی NVMe معمولاً بدون discard هم عملکرد خوبی دارند، چون over-provisioning داخلی دارند. اگر discard را فعال میکنید، آن را ناهمگام کنید و تأخیر p99 را قبل و بعد بسنجید.
۲۳-۲-۵ SPDK#
NVMEDevice در src/blk/spdk/ دستگاه NVMe را کاملاً از هسته جدا میکند: درایور فضای کاربر SPDK صفهای NVMe را مستقیم با polling مدیریت میکند و هیچ syscall و وقفهای در مسیر داده نیست. مسیر دستگاه با پیشوند spdk: در bluestore_block_path مشخص میشود. هزینهی آن، اختصاص هستهی CPU به polling، نیاز به hugepage و vfio، و از دست رفتن ابزارهای معمول هسته (iostat، blktrace) است. در عمل بیشتر استقرارها همان KernelDevice را ترجیح میدهند و crimson با SeaStore مسیر دیگری برای حذف سربار هسته دنبال میکند.
دیدن مسیر واقعی I/O:
ceph osd metadata 4 | jq '{bluestore_bdev_type, bluestore_bdev_rotational, bluestore_bdev_dev_node}'
cat /sys/block/nvme0n1/queue/{logical_block_size,physical_block_size,write_cache}
ceph config get osd.4 bdev_ioring
strace -f -e trace=io_submit,io_getevents,io_uring_enter -p $(pgrep -f 'ceph-osd.*--id 4') 2>&1 | head
blktrace -d /dev/nvme0n1 -o - | blkparse -i - | head -30 # Q/G/D/C برای هر request۲۳-۳ bufferlist: ساختار دادهی اصلی Ceph#
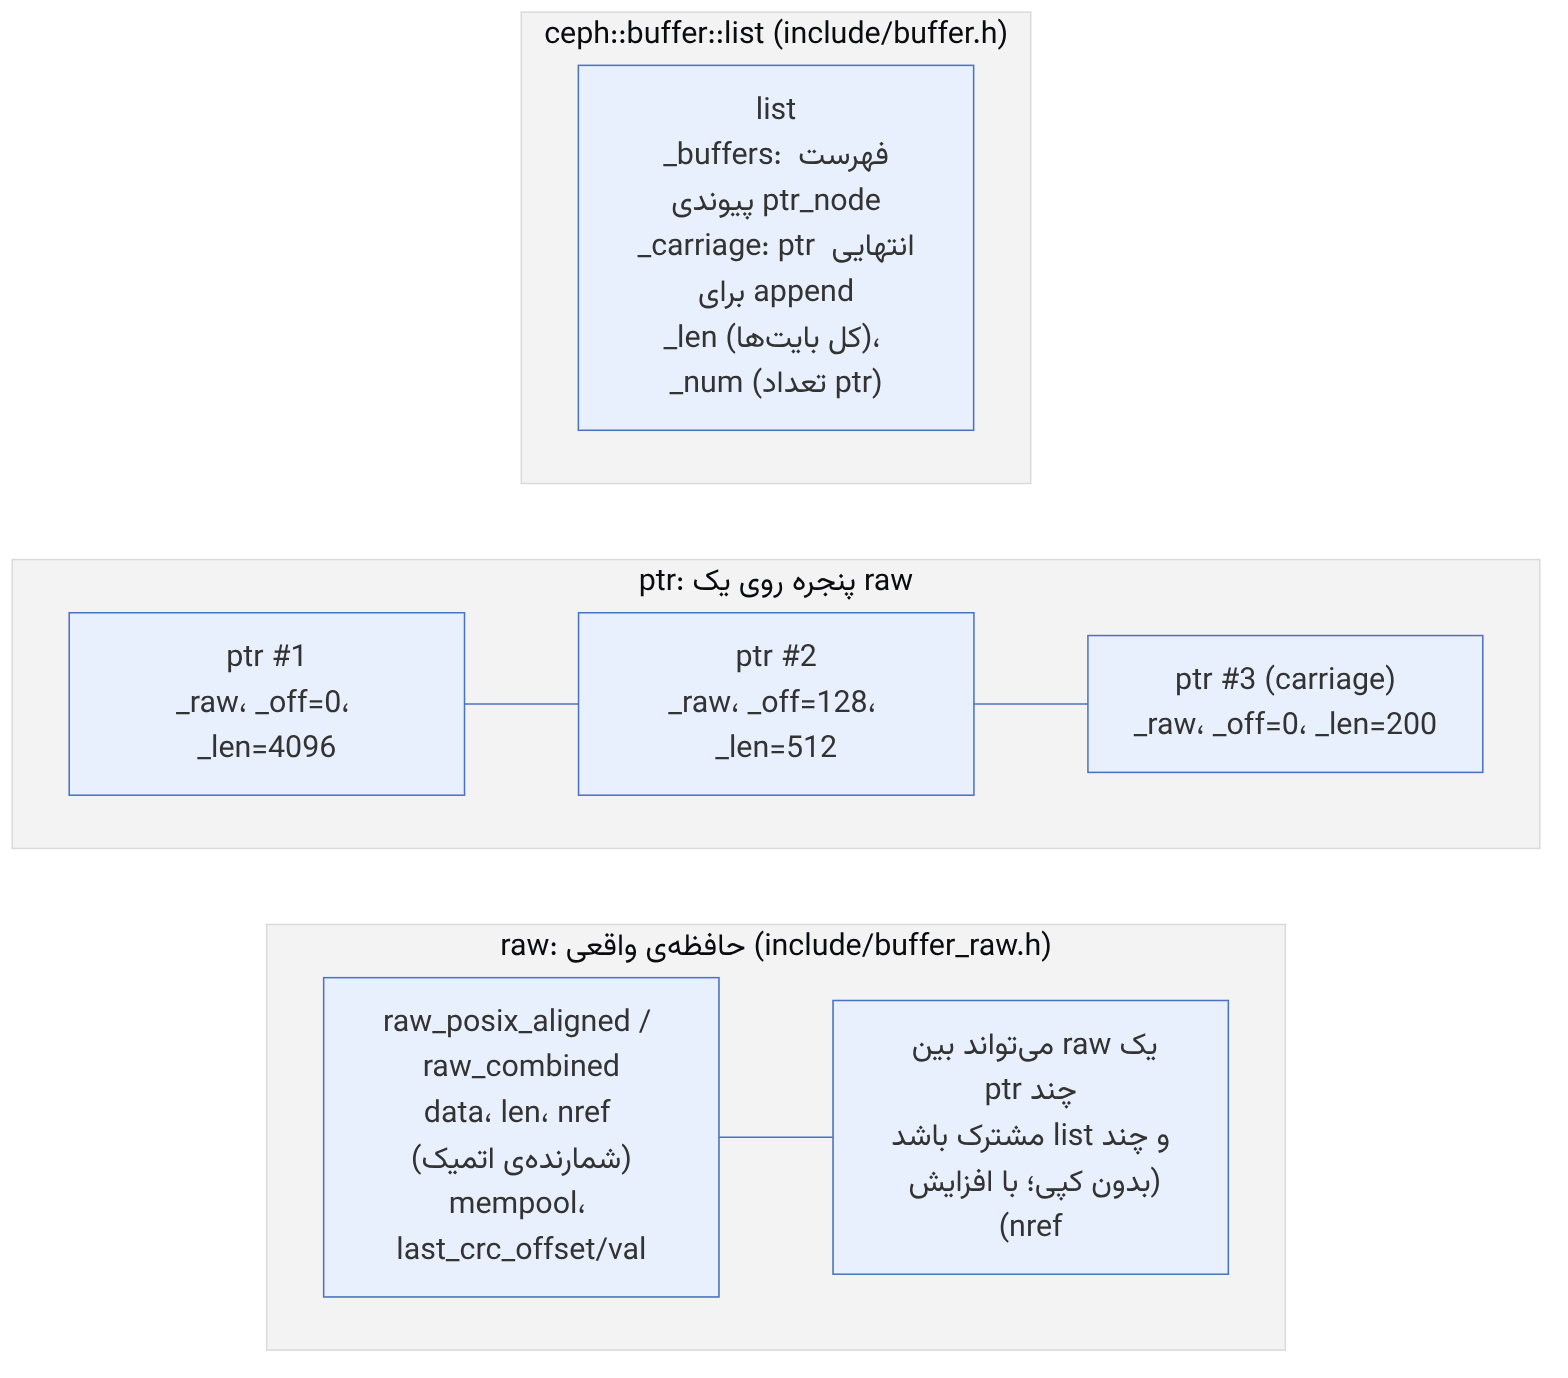
تقریباً هر بایتی که در Ceph جابهجا میشود، چه پیام شبکه، چه دادهی شیء، چه رکورد RocksDB، داخل یک ceph::buffer::list (معمولاً با نام کوتاه bufferlist) است. طراحی آن سه هدف دارد: کپی صفر (اتصال تکهها بدون جابهجایی بایتها)، اشتراک (چند لیست به یک حافظه اشاره کنند) و حسابداری حافظه (هر تکه به یک mempool تعلق دارد).
| نوع | فایل | نکته |
|---|---|---|
buffer::ptr | include/buffer.h | فیلدهای _raw، _off، _len؛ متدهای c_str()، length()، is_aligned()، is_page_aligned() |
buffer::list | include/buffer.h | _buffers، _carriage، _len، _num؛ append، claim_append، splice، rebuild، c_str() |
buffer::raw | include/buffer_raw.h | data، len، nref، mempool، last_crc_offset/last_crc_val با crc_spinlock |
| پیادهسازیهای raw | common/buffer.cc | create_aligned، create_small_page_aligned، claim_char، claim_malloc، claim_buffer (با deleter دلخواه)، raw_hack_aligned |
۲۳-۳-۱ هزینهی واقعی c_str()#
list::c_str() اشارهگری به یک ناحیهی پیوسته برمیگرداند. اگر لیست از چند ptr تشکیل شده باشد، ابتدا rebuild() اجرا میشود که یک raw تازه میسازد و همهی تکهها را در آن کپی میکند. بنابراین یک فراخوانی ظاهراً بیخطر میتواند یک کپی چند مگابایتی ایجاد کند. کد مسیر داده برای همین از iteratorها (begin()، copy()) یا از rebuild_aligned_size_and_memory (برای O_DIRECT) استفاده میکند.
pseudocode: مسیر بدون کپی یک نوشتن (خلاصهی این کتاب)
msgr2 دریافت: segment داده در یک raw تازه (با همترازی اعلامشده در preamble) خوانده میشود
MOSDOp::decode: ptr روی همان raw (بدون کپی) → OSDOp.indata
PrimaryLogPG: t.write(oid, off, len, indata) # nref++
BlueStore::_do_write: اگر همتراز → همان ptrها به iovec تبدیل میشوند
اگر نه → pad با صفر/دادهی قبلی + rebuild_aligned (یک کپی)
KernelDevice::aio_write: iovec[] → io_prep_pwritev (DMA از همان صفحهها)crc کششده روی raw: buffer::list::crc32c() برای هر ptr با raw::get_crc بررسی میکند آیا raw برای همان بازه قبلاً crc را محاسبه و با set_crc جفت (seed پایه، crc) را ذخیره کرده است (last_crc_offset و last_crc_val). اگر seed فعلی با seed ذخیرهشده فرق کند، بهجای خواندن دوبارهی داده، اختلاف seed با کمک خطی بودن crc و تابع ceph_crc32c_zeros (crc یک ناحیهی صفر به طول بازه) اصلاح میشود. هر تغییری در raw (مثلاً copy_in یا zero) این کش را با invalidate_crc() باطل میکند. این کار برای پیامهایی که چند بار با crc ارسال یا بررسی میشوند صرفهجویی بزرگی است.
۲۳-۴ mempool: حسابداری حافظه#
src/include/mempool.h با ماکرو DEFINE_MEMORY_POOLS_HELPER فهرست ثابتی از poolها تعریف میکند. هر allocator از نوع mempool::<pool>::vector، map و... تعداد بایتها و آیتمها را بهصورت شاردشده (برای کاهش رقابت روی cache line) در همان pool ثبت میکند. osd_memory_target و autotune کش BlueStore بر اساس همین اعداد تصمیم میگیرند.
| pool | چه چیزی |
|---|---|
| bluestore_cache_onode / _meta / _data / _buffer / _other | اجزای کش BlueStore |
| bluestore_alloc | ساختارهای allocator |
| bluestore_extent / _blob / _shared_blob / _inline_bl | ساختارهای فرادادهی onode در حافظه |
| bluestore_txc / _writing / _writing_deferred | تراکنشها و دادههای در حال نوشتن |
| bluefs / bluefs_file_reader / bluefs_file_writer | BlueFS |
| buffer_anon / buffer_meta | bufferهای بدون pool مشخص و فرادادهی آنها |
| osd / osd_mapbl / osd_pglog / osdmap / osdmap_mapping / pgmap | ساختارهای OSD و نقشهها |
ceph tell osd.4 dump_mempools | jq '.mempool.by_pool | to_entries | sort_by(-.value.bytes) | .[:6]'
ceph tell osd.4 dump_mempools | jq '.mempool.total'
ceph config get osd.4 osd_memory_target # پیشفرض 4_Gرشد بیرویهی buffer_anon معمولاً به این معنی است که دادهی شبکه یا پیامها در جایی نگه داشته شدهاند (مثلاً صفهای بزرگ op در یک OSD کند، یا کلاینتهایی که پاسخ نمیخوانند). رشد osd_pglog به طول بیش از حد pg log اشاره دارد (گزینههای osd_min_pg_log_entries و osd_max_pg_log_entries).
۲۳-۵ crc32c: از دستور CPU تا checksum بلوک#
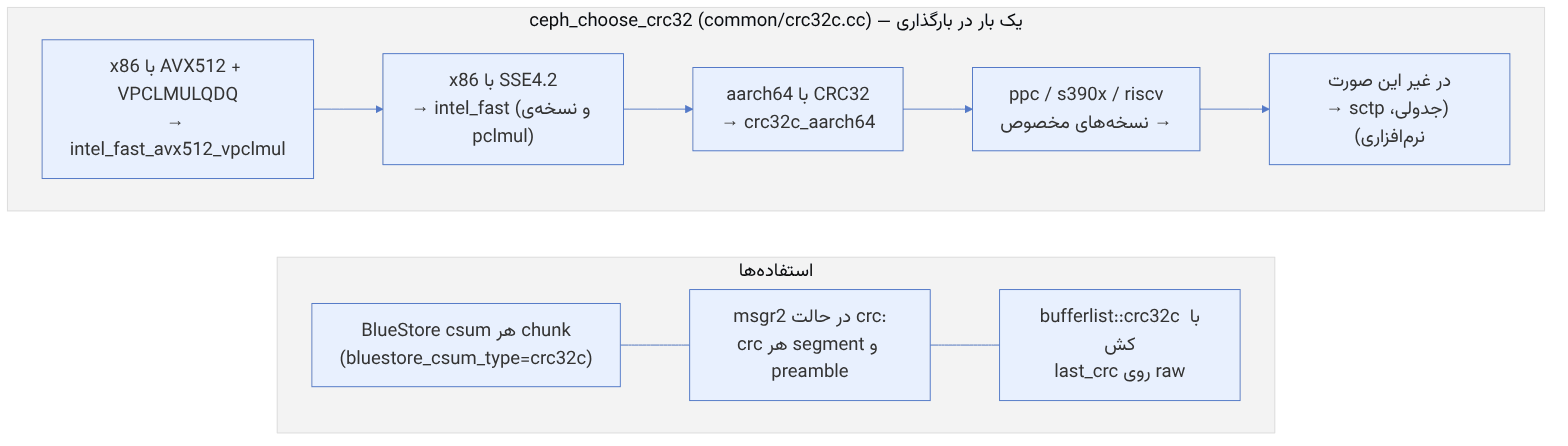
Ceph از crc32c (چندجملهای Castagnoli، به شکل معکوس ۰x82F63B78) هم برای checksum داده در BlueStore و هم برای سلامت پیام در msgr2 استفاده میکند. ceph_choose_crc32() در common/crc32c.cc یک بار هنگام بارگذاری بهترین پیادهسازی را برای CPU انتخاب میکند.
۲۳-۵-۱ یک مثال عددی#
ceph_crc32c(seed, data, len) بدون معکوس کردن نهایی کار میکند و BlueStore با seed برابر -1 (۰xFFFFFFFF) شروع میکند. برای رشتهی مرجع "123456789":
| ورودی | seed | خروجی ceph_crc32c | پس از XOR نهایی با ۰xFFFFFFFF |
|---|---|---|---|
"123456789" (۹ بایت) | ۰xFFFFFFFF | ۰x1CF96D7C | ۰xE3069283 (مقدار مرجع استاندارد CRC-32C) |
| ۴۰۹۶ بایت صفر | ۰xFFFFFFFF | ۰x6706BE76 | — |
"ceph" | ۰ | ۰x575990D6 | — |
# مثال خود این راهنما: crc32c بیتبهبیت (کند، فقط برای فهم)
def crc32c(crc, data):
for b in data:
crc ^= b
for _ in range(8):
crc = (crc >> 1) ^ (0x82F63B78 if crc & 1 else 0)
return crc
assert crc32c(0xFFFFFFFF, b"123456789") == 0x1CF96D7Cنسخهی سختافزاری همین کار را با دستور crc32 در x86 (۸ بایت در هر دستور) و با سه جریان موازی ترکیبشده با PCLMULQDQ انجام میدهد. روی پردازندههای امروزی سرعت آن چند ده گیگابایت در ثانیه در هر هسته است، بنابراین checksum در عمل تقریباً رایگان است.
۲۳-۵-۲ checksum در BlueStore#
Checksummer.h انواع CSUM_XXHASH32=2، CSUM_XXHASH64=3، CSUM_CRC32C=4، CSUM_CRC32C_16=5 (۱۶ بیت پایین) و CSUM_CRC32C_8=6 را تعریف میکند و پیشفرض bluestore_csum_type=crc32c است. هر blob (فصل ۲۴) فیلدهای csum_type، csum_chunk_order (اندازهی chunk برابر 1 << order بایت) و csum_data (آرایهی checksumها) دارد.
حساب سربار: با chunk ۴K و crc32c، هر ۴۰۹۶ بایت داده ۴ بایت checksum دارد، یعنی حدود ۰.۱٪. برای یک OSD با ۱۰ TiB داده، این حدود ۱۰ GiB checksum در onodeها است که بخشی از آن در کش onode قرار میگیرد. اگر chunk را بزرگتر کنید (blobهای بزرگ و خواندنهای ترتیبی، مثل RGW)، این سربار کم میشود ولی هر خواندن کوچک مجبور است کل chunk را بخواند تا آن را بررسی کند.
۲۳-۶ libaio و io_uring در سطح ساختار و قفل#
بخش KernelDevice مسیر کلی را نشان داد. اینجا همان مسیر در سطح بایتها، قفلها و threadها دنبال میشود. KernelDevice در KernelDevice::KernelDevice بر اساس bdev_ioring (پیشفرض false) یکی از دو صف را میسازد: aio_queue_t (libaio) یا ioring_queue_t (io_uring). عمق صف در هر دو حالت bdev_aio_max_queue_depth (پیشفرض ۱۰۲۴) است.
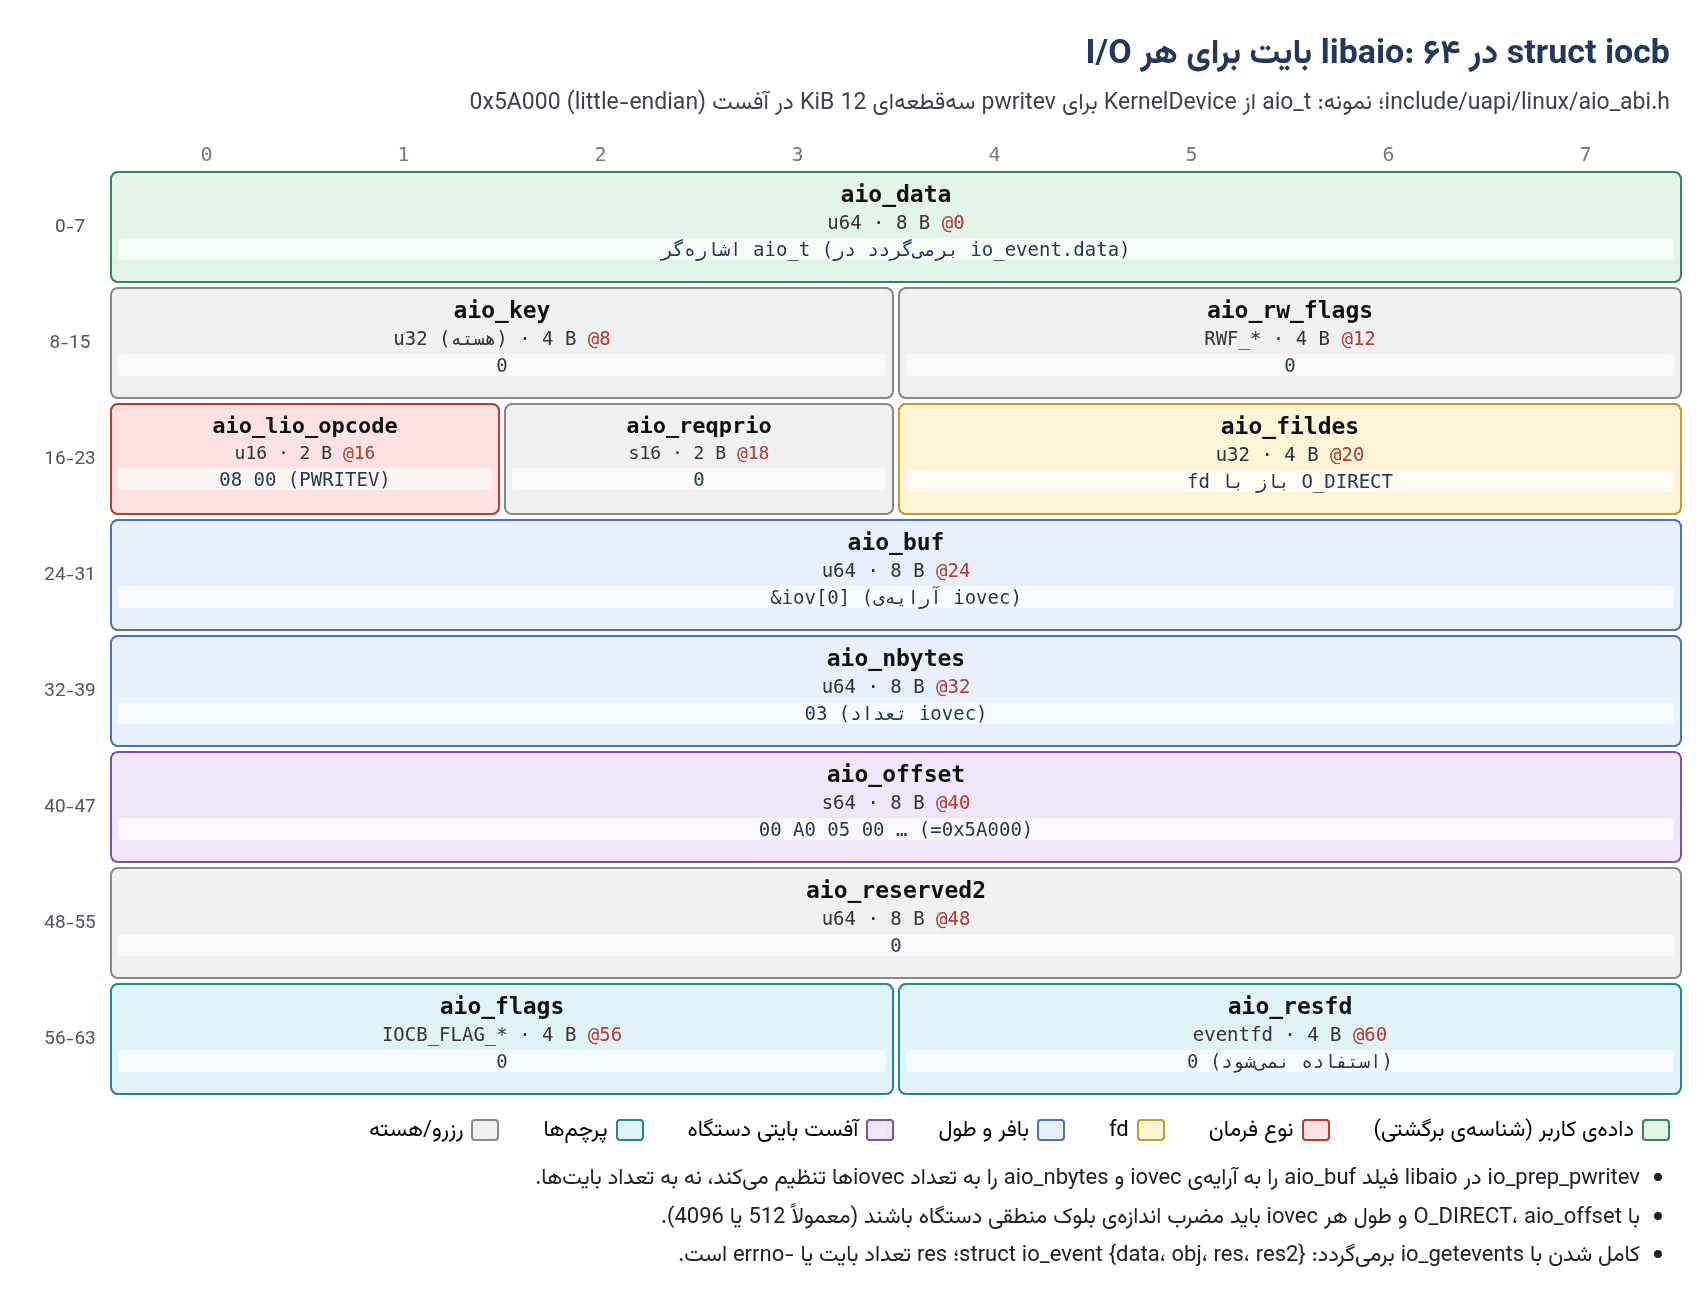
منبع در کد: src/blk/aio/aio.cc :: aio_queue_t::submit_batch
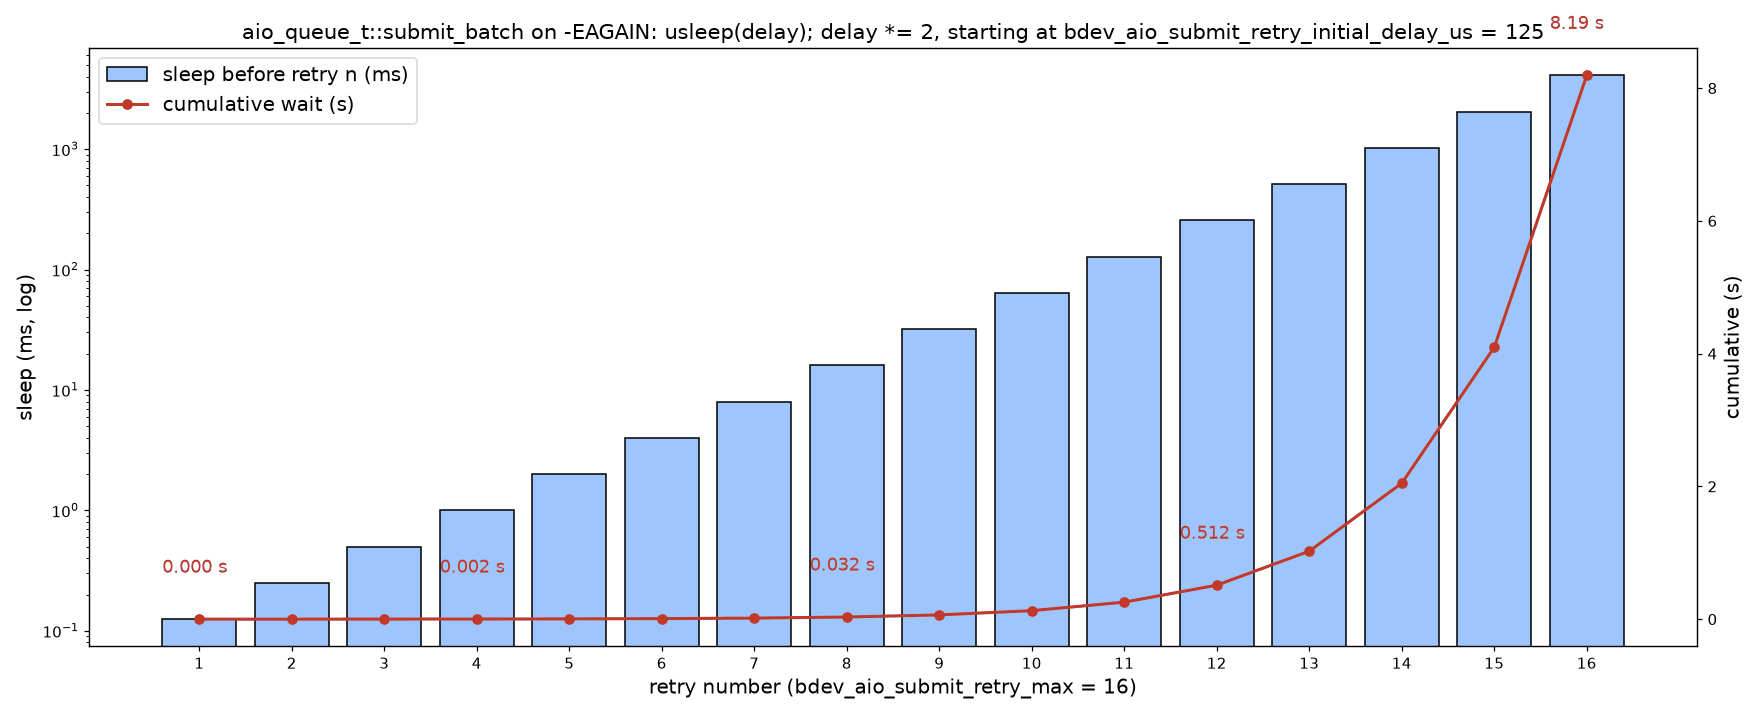
پیچیدگی: O(N/max_iodepth) فراخوانی io_submit در حالت عادی؛ در بدترین حالت ۱۶ تلاش و حدود ۸.۲ ثانیه انتظار تجمعی
pseudocode
attempts = bdev_aio_submit_retry_max (16) ; delay = 125 µs
while کار باقی است:
    piocb[] را تا max_iodepth از فهرست پر کن
    r = io_submit(ctx, pulled − pushed, piocb + pushed)
    if 0 ≤ r < toSubmit: pushed += r ; r = −EAGAIN      # پذیرش جزئی
    if r == −EAGAIN and attempts−− > 0:
        usleep(delay) ; delay ×= 2 ; retries++ ; continue
    if r < 0: return r
    pushed = pulled = 0 ; attempts و delay را بازنشانی کن
مثال عددی. با ۱۰۲۴ درخواست معلق در صف هسته و یک دستهی ۶۴ تایی، io_submit ممکن است فقط ۱۰ درخواست را بپذیرد. در این حالت pushed = ۱۰، r به −EAGAIN تبدیل میشود و پس از ۱۲۵ µs تلاش دوباره انجام میشود. اگر صف همچنان پر بماند، انتظارها ۱۲۵، ۲۵۰، ۵۰۰ µs و همینطور دوبرابر میشوند تا ۴.۱ ثانیه برای تلاش شانزدهم. جمع کل ثانیه است. شمارندهی retries در لاگ «aio_submit retries» دیده میشود. اگر این عدد در لاگ OSD زیاد دیده شود، عمق صف یا تأخیر دستگاه مشکل دارد، نه CPU.
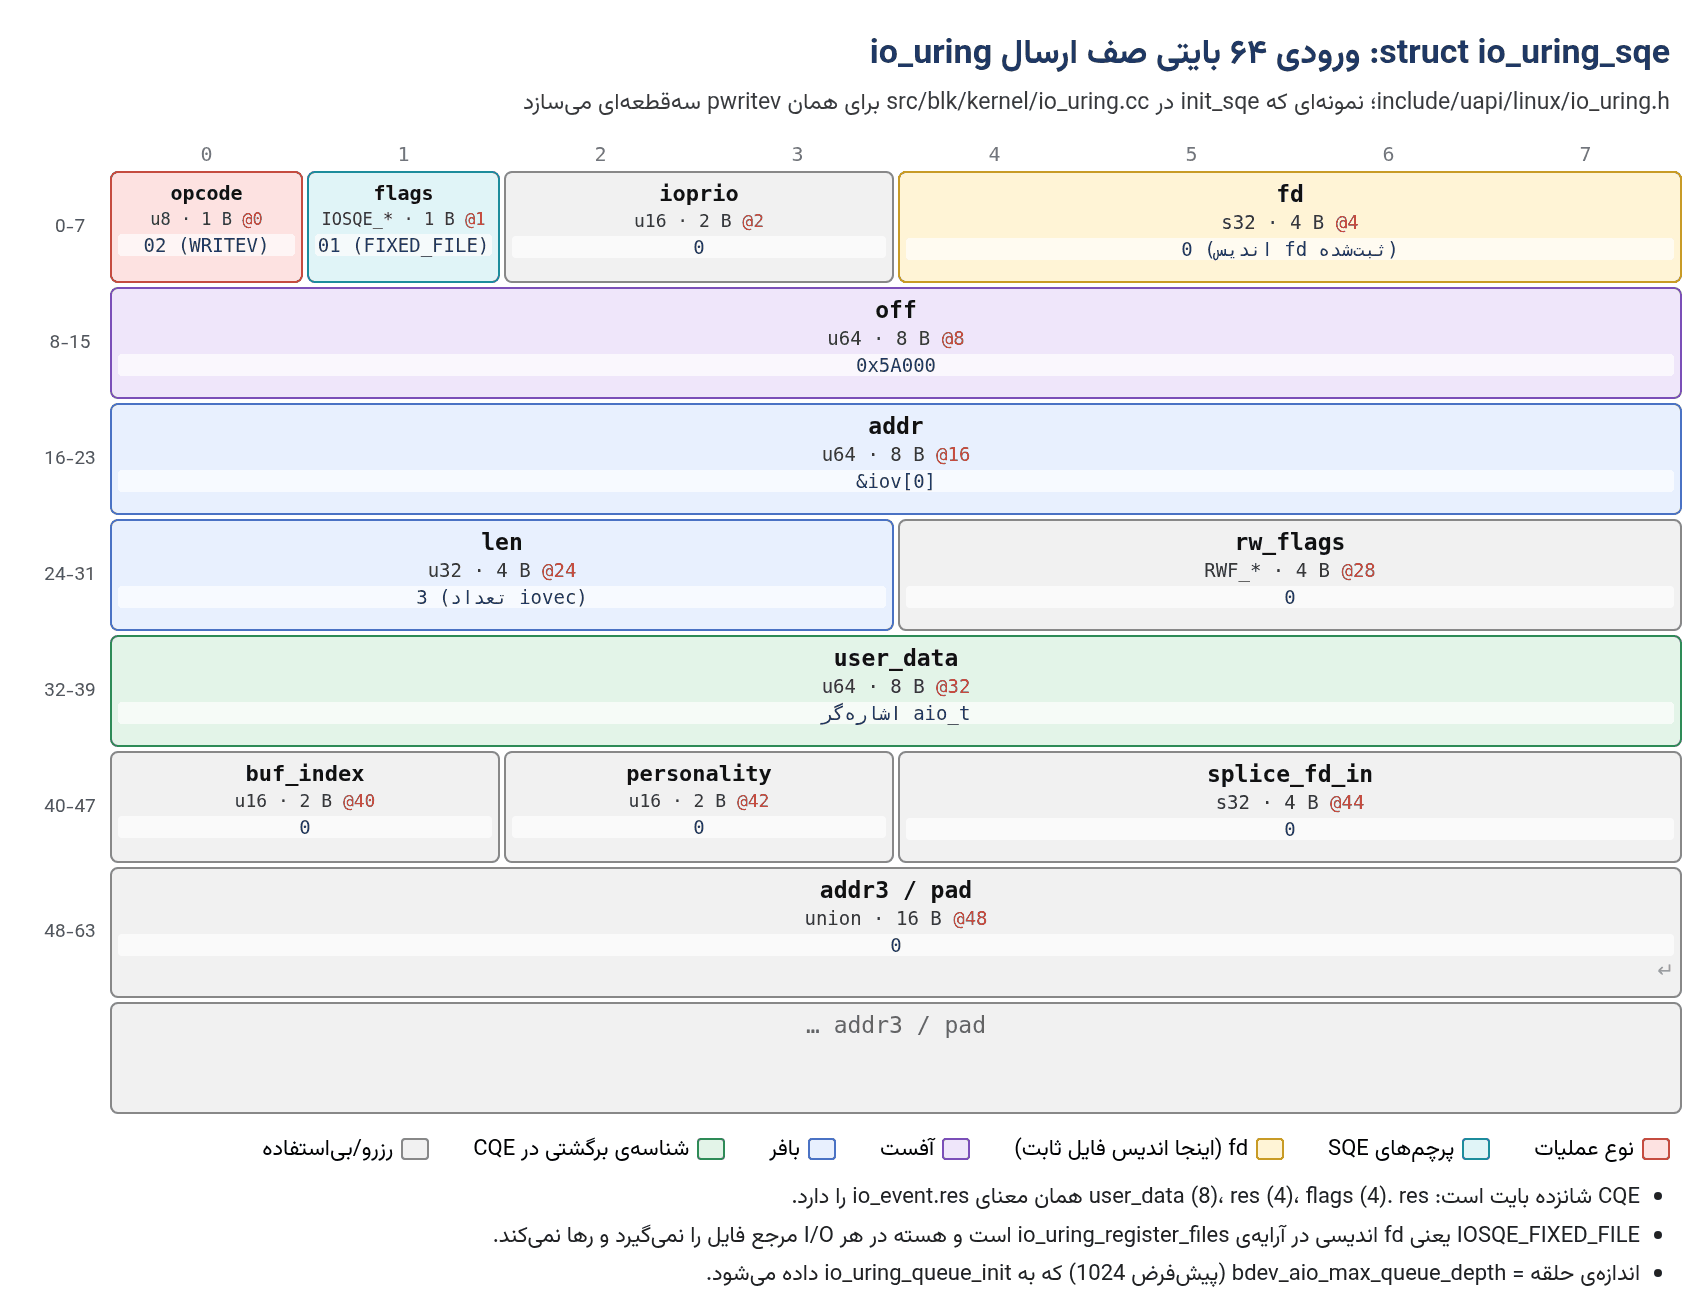
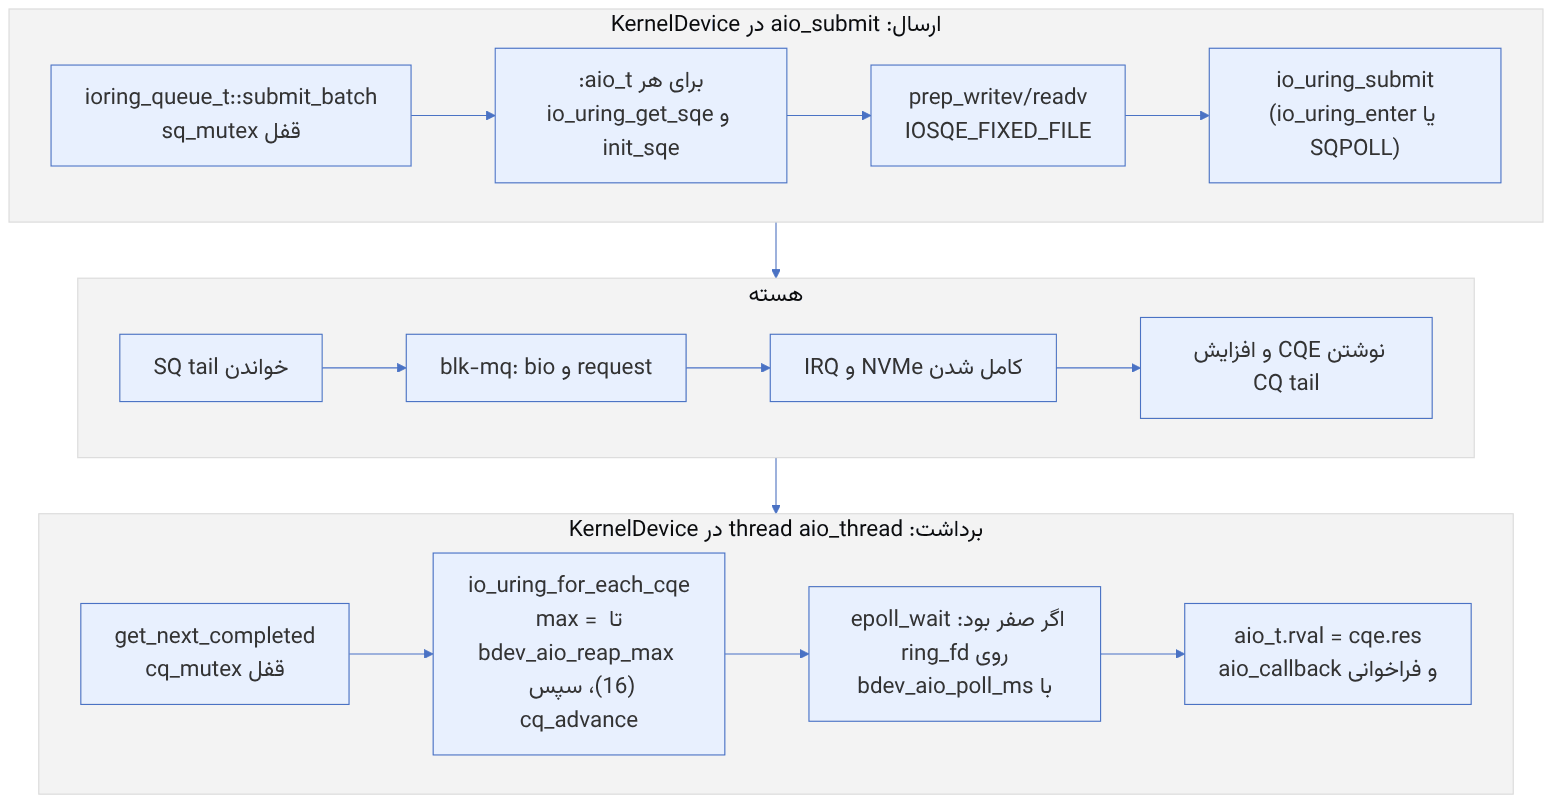
منبع در کد: src/blk/kernel/io_uring.cc :: ioring_queue_t::submit_batch، ioring_queue، ioring_get_cqe، get_next_completed
پیچیدگی: ارسال O(N) نوشتن SQE و یک io_uring_submit؛ برداشت O(min(ready, reap_max)) بدون فراخوانی سیستمی وقتی CQE آماده است
pseudocode
submit_batch(beg, end):
lock(sq_mutex)
for io in [beg, end): sqe = io_uring_get_sqe() ; if null: break # حلقه پر است
init_sqe(sqe, io) # prep_writev/readv، FIXED_FILE، user_data=io
rc = io_uring_submit() # io_uring_enter، یا فقط بهروزرسانی tail در SQPOLL
unlock(sq_mutex) ; return rc
get_next_completed(timeout, paio[], max):
lock(cq_mutex) ; for each cqe تا max: io.rval = cqe.res ; paio[n++] = io
io_uring_cq_advance(n) ; unlock(cq_mutex)
if n == 0: epoll_wait(ring_fd, timeout = bdev_aio_poll_ms) ؛ اگر آماده بود، دوباره برومثال عددی و تفاوت با libaio. با حلقهی ۱۰۲۴ خانهای، SQ برابر ۱۰۲۴ × ۶۴ = ۶۴ KiB و CQ (که هسته بهطور پیشفرض دو برابر SQ میسازد) ۲۰۴۸ × ۱۶ = ۳۲ KiB است. هر دو با mmap بین هسته و Ceph مشترکاند. در libaio هر دسته دستکم یک io_submit و هر برداشت یک io_getevents دارد. در io_uring، وقتی CQE آماده است، برداشت فقط خواندن حافظهی مشترک است. با bdev_ioring_sqthread_poll=true (پرچم IORING_SETUP_SQPOLL) ارسال هم فراخوانی سیستمی ندارد، اما یک thread هسته روی یک هستهی CPU میچرخد. bdev_ioring_hipri پرچم IORING_SETUP_IOPOLL را میگذارد: کامل شدن با polling روی صف NVMe انجام میشود، و این فقط برای دستگاههایی که poll queue دارند و با O_DIRECT کار میکند.
io_uring در Ceph بهطور پیشفرض خاموش است و روی بعضی هستهها و سیاستهای امنیتی ممکن است غیرفعال یا محدود باشد (مثلاً sysctl kernel.io_uring_disabled در هستههای جدیدتر). ioring_queue_t::supported() با ساختن یک حلقهی ۱۶ تایی آزمایشی پشتیبانی را میسنجد. اگر شکست بخورد، OSD با هشدار به libaio برمیگردد.
۲۳-۷ رشد بافر در bufferlist::append#
منبع در کد: src/common/buffer.cc :: buffer::list::append(const char*, unsigned)، refill_append_space
پیچیدگی: O(۱) سرشکن برای هر append کوچک؛ O(log(L/۴K)) تخصیص تا سقف ۲۵۶K و سپس L/256K تخصیص
pseudocode
append(data, len):
    first = min(len, فضای خالی انتهای _carriage)
    memcpy درون همان raw (برای طول ≤ 32 با کپی inline) ; _carriage.len += first
    if len − first > 0: refill_append_space(len − first).append(بقیه)
refill_append_space(len):
    alen = round_up(round_up(len, 8) + S, 4096)          # S = sizeof(raw_combined)
    if _carriage آخرین ptr است:
        alen = max(alen, min(2 × round_up(_carriage.raw_length, 4096), 256 KiB))
    raw_combined::create(alen − S) ← داده و سرآیند در یک تخصیص
مثال عددی. اگر encode یک ساختار ۱ MiB داده را در قطعههای کوچک (مثلاً u64 و رشتههای کوتاه) append کند، تخصیصها ۴K، ۸K، ۱۶K، ۳۲K، ۶۴K، ۱۲۸K و سپس ۲۵۶K هستند. پس از شش بافر اول ۲۵۲K پر شده است و ۷۷۲K باقیمانده به چهار بافر ۲۵۶K دیگر میرود. نتیجه ۱۰ ptr_node است، با جمع ۱۲۷۶ KiB تخصیص برای ۱۰۲۴ KiB داده، به جای ۲۵۶ بافر ۴K. سقف ۲۵۶K عمداً زیر آستانهی «شیء کوچک» tcmalloc است. هر raw_combined سرآیند کنترلی خود را در انتهای همان تخصیص دارد، پس هر بافر دقیقاً مضربی از ۴K حافظه از allocator میگیرد.
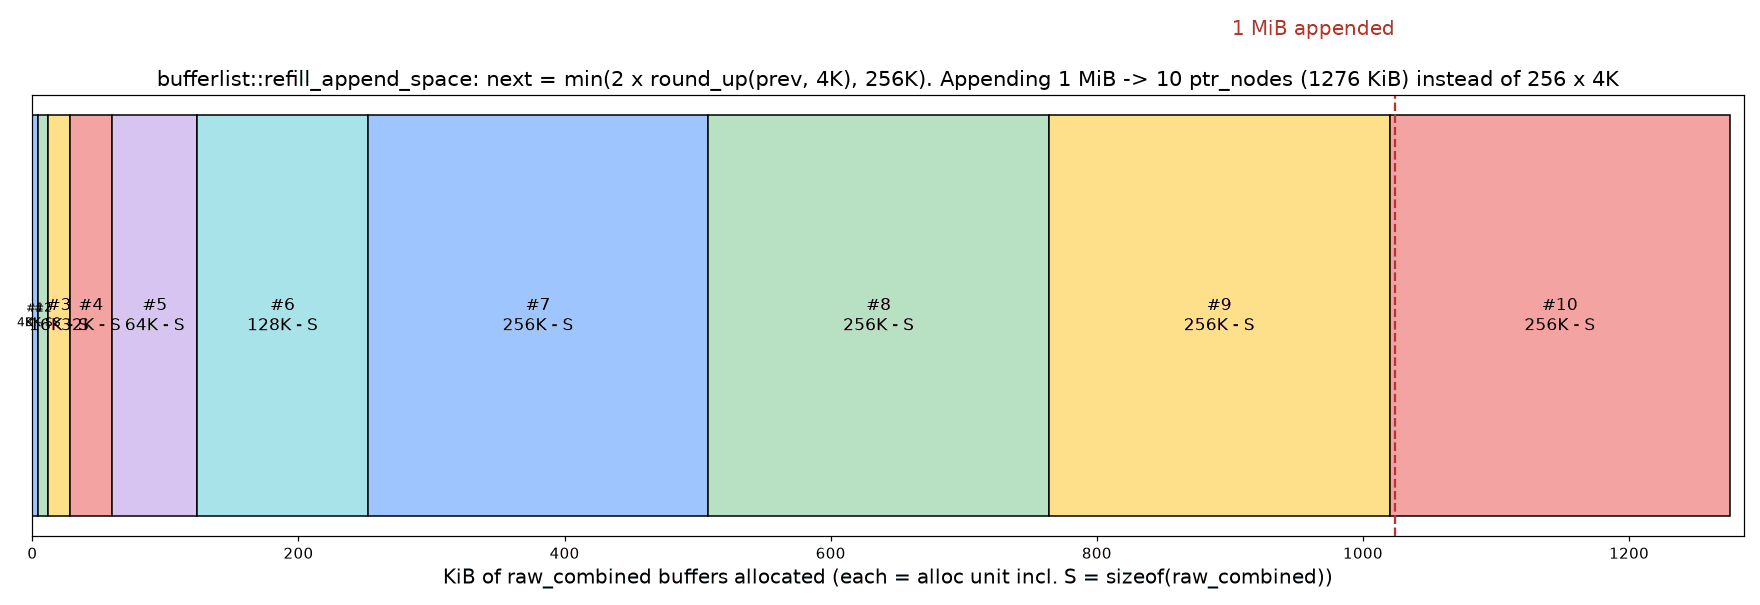
اگر اندازهی نهایی از پیش معلوم است، bl.reserve(n) یا bl.push_back(buffer::create(n)) همهی این تخصیصهای میانی را حذف میکند. در مسیرهای داغ Ceph، مثلاً encode پیامها با encode(..., features) و پیشبرآورد bound_encode در denc، از همین روش استفاده میشود.
۲۳-۸ crc32c برای صفرها و تطبیق seed#
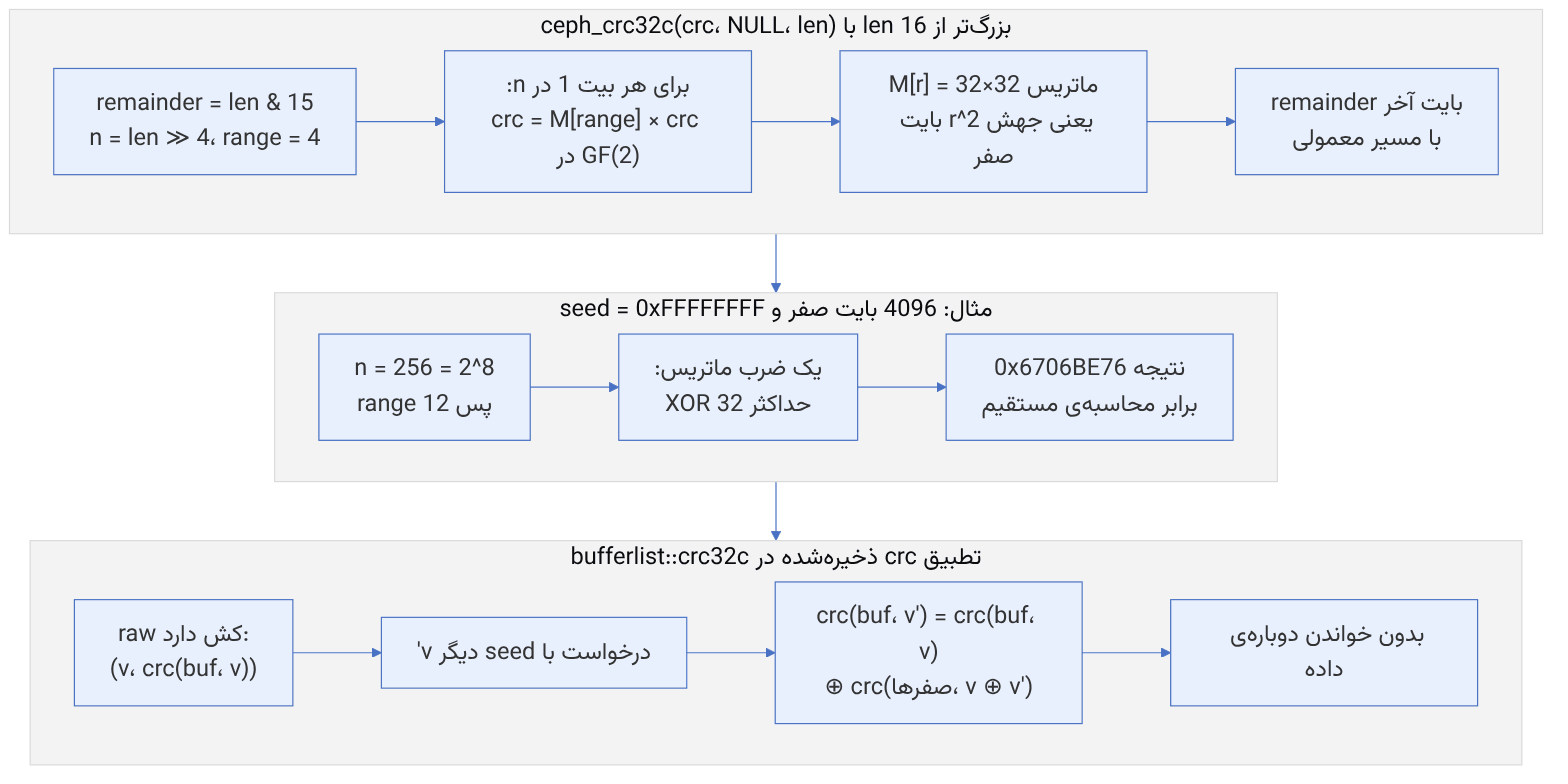
ceph_crc32c(crc, NULL, len) در include/crc32c.h قرارداد ویژهای دارد: اگر data تهی و len بزرگتر از ۱۶ باشد، crc یک ناحیهی تماماً صفر حساب میشود، آن هم بدون خواندن حافظه. BlueStore و bufferlist از این برای ناحیههای صفر (buffer::list::append_zero، بافرهای raw_zeros) و برای تطبیق crc ذخیرهشده استفاده میکنند.
منبع در کد: src/common/crc32c.cc :: ceph_crc32c_zeros، create_turbo_table (جدول crc_turbo_table[32][32])
پیچیدگی: O(log len) ضرب ماتریس ۳۲×۳۲ روی GF(۲)، هر ضرب حداکثر ۳۲ XOR؛ مستقل از طول (به جای O(len))
pseudocode
# M[0][bit] = crc(1≪bit، یک بایت صفر) ؛ M[r] = M[r−1]², یعنی جهش 2^r بایت
zeros(crc, len):
    rem = len & 15 ; n = len ≫ 4 ; r = 4                 # از جهش 16 بایتی شروع کن
    while n: if n & 1: crc = Σ_{bit j of crc = 1} M[r][j]   (XOR)
             n ≫= 1 ; r += 1
    if rem: crc = crc_معمولی(crc، rem بایت صفر)
مثال عددی. برای ۴۰۹۶ بایت صفر با seed = ۰xFFFFFFFF: rem = ۰ و ، پس فقط یک ضرب با M[12] لازم است و نتیجه ۰x6706BE76 است. محاسبهی مستقیم بایتبهبایت (پیادهسازی جداگانهی این راهنما) همین عدد را میدهد. برای ۶۹۶۳۷ = ۶۵۵۳۶ + ۴۰۹۶ + ۵ بایت: دو ضرب (M[16] و M[12]) و سپس ۵ بایت معمولی، با نتیجهی ۰xAC433F9D که باز با محاسبهی مستقیم یکی است. چهار مقدار اول ردیف M[0] (۰xF۲۶B۸۳۰۳، ۰xE13B70F7، ۰xC79A971F، ۰x8AD958CF) همان مقادیر جدول crc_turbo_table در کد Ceph هستند.
منبع در کد: src/common/buffer.cc :: buffer::list::crc32c؛ include/buffer_raw.h :: raw::get_crc، set_crc
پیچیدگی: O(log len) به جای O(len) برای هر raw که crc آن کش شده است
pseudocode
for node in _buffers:
    if raw.get_crc((off, off+len)) → (v, c):
        if v == crc: crc = c                                  # cache hit
        else: crc = c ⊕ ceph_crc32c(v ⊕ crc, NULL, len)       # adjust
    else: base = crc ; crc = ceph_crc32c(crc, data, len) ; raw.set_crc(..., (base, crc))
مثال عددی. برای یک بافر ۱۰۰۰ بایتی، crc با seed 0 برابر ۰xACBE2A2C است و در raw کش میشود. اکنون همان بافر با seed 0xFFFFFFFF خواسته میشود. تطبیق ۰xACBE2A2C ⊕ zeros(۰ ⊕ ۰xFFFFFFFF, 1000) = ۰x8B0C0F84 میدهد، که دقیقاً crc مستقیم با seed جدید است. این همان جایی است که پیامرسان (msgr) و BlueStore یک بافر را دو بار با seedهای متفاوت checksum میکنند و بار دوم فقط چند ده XOR هزینه دارد. آمار آن با buffer_track_crc در شمارندههای buffer_cached_crc و buffer_cached_crc_adjusted دیده میشود.
۲۳-۹ تکمیلی و بهروز#
- در main،
block_device_t فقط aio و spdk را دارد. پشتیبانی PMEM (دستگاههای DAX) در main حذف شده است، ولی Tentacle هنوز block_device_t::pmem را دارد. پیش از ارتقا، اگر از PMEM استفاده میکنید، یادداشتهای انتشار را بررسی کنید. - گزینهی
bdev_async_discard با bdev_async_discard_threads جایگزین شده است و کد برای سازگاری، مقدار قدیمی را به یک thread نگاشت میکند. - io_uring همچنان بهطور پیشفرض خاموش است (
bdev_ioring=false).
۲۳-۱۰ تمرین عملی#
- ۱. روی یک OSD آزمایشی با
strace -c -f -p <pid> در حین rados bench نسبت io_submit به io_getevents را بسنجید. سپس bdev_ioring=true را تنظیم کنید، OSD را راهاندازی دوباره کنید و تفاوت را با ceph osd perf مقایسه کنید. - ۲. تابع پایتون crc32c این فصل را اجرا کنید و نتیجه را برای یک بلوک ۴K تصادفی با
crcmod یا crc32c پایتون مقایسه کنید (یادتان باشد XOR نهایی را اعمال کنید). - ۳. خروجی
dump_mempools را قبل و بعد از یک rados bench بزرگ ذخیره و ۵ pool با بیشترین رشد را شناسایی کنید. - ۴.
cat /sys/block/<dev>/queue/write_cache و rotational را برای همهی دستگاههای OSD جمع کنید و با ceph osd metadata مقایسه کنید.
۲۳-۱۱ پرسشهای مرور#
- ۱. چرا KernelDevice برای هر write hint یک fd جدا باز میکند؟
- ۲. همترازی O_DIRECT چه محدودیتی بر کوچکترین نوشتن BlueStore میگذارد؟
- ۳. نقش
bdev_aio_max_queue_depth و bdev_aio_reap_max چیست؟ - ۴. چه زمانی BlueStore flush جداگانهی دستگاه داده را اجباری میکند؟
- ۵. چرا discard بهطور پیشفرض خاموش است؟
- ۶. تفاوت
buffer::ptr و buffer::raw چیست؟ - ۷. چرا
bufferlist::c_str() میتواند گران باشد؟ - ۸. mempool چگونه به autotune حافظه کمک میکند؟
- ۹. چرا crc32c مقدار
"123456789" در Ceph با مقدار مرجع استاندارد فرق دارد؟ - ۱۰. سربار checksum با chunk ۴K چقدر است و بزرگ کردن chunk چه بدهبستانی دارد؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۳-۱۲ منابع این فصل#
- کد KernelDevice
https://github.com/ceph/ceph/blob/main/src/blk/kernel/KernelDevice.cc - libaio در Ceph
https://github.com/ceph/ceph/blob/main/src/blk/aio/aio.cc - bufferlist
https://github.com/ceph/ceph/blob/main/src/include/buffer.h - mempool
https://github.com/ceph/ceph/blob/main/src/include/mempool.h - crc32c
https://github.com/ceph/ceph/blob/main/src/common/crc32c.cc - پیکربندی BlueStore (checksum و فشردهسازی
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - io_uring
https://kernel.dk/io_uring.pdf - CRC-32C (RFC ۳۷۲۰، پیوست B.4
https://www.rfc-editor.org/rfc/rfc3720