Ceph و OpenStack
حوصله ندارم این فصل در چند خط
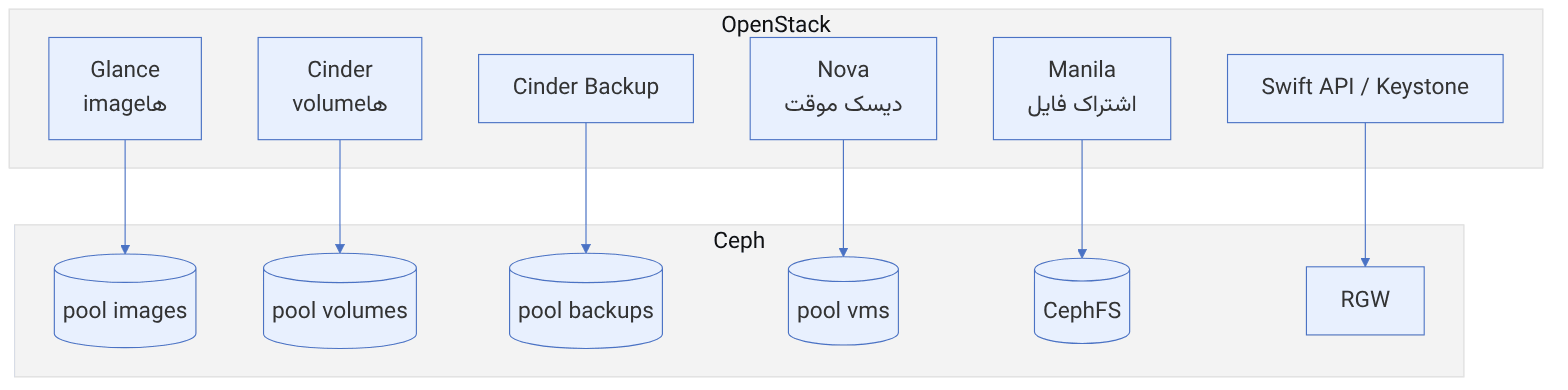
- یک کلاستر Ceph میتواند همهی نیازهای ذخیرهسازی OpenStack را پوشش دهد: Glance، Cinder، Cinder Backup، دیسکهای ephemeral در Nova، Manila و Swift/S3 از راه RGW.
- هر سرویس pool و کاربر Ceph خودش را دارد؛
client.cinder روی pool تصاویر فقط اجازهی خواندن دارد. - copy-on-write از image به volume به تصویر با قالب raw و
show_image_direct_url = True نیاز دارد؛ با qcow2 بیصدا از دست میرود. - UUID مربوط به secret در libvirt باید روی همهی compute nodeها یکسان و برابر
rbd_secret_uuid باشد؛ images_type = rbd دیسکهای ephemeral را هم به Ceph میبرد و live migration و evacuate را ساده میکند.
۳-۱ پیش از شروع#
۳-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
OpenStack و Ceph تقریباً همزمان بالغ شدند و خیلی زود به «زوج پیشفرض» ابرهای خصوصی تبدیل شدند. نظرسنجیهای کاربران OpenStack سالها نشان دادهاند که Ceph محبوبترین پشتوانهی ذخیرهسازی بلوکی آن است. در این فصل میبینیم:
- چرا Ceph اینقدر با OpenStack جور است و کدام سرویسهای OpenStack از کدام بخش Ceph استفاده میکنند؟
- برای Glance، Cinder، Cinder Backup و Nova چه poolها و کاربرانی با چه مجوزهایی لازم است؟
- پیکربندی هر سرویس چگونه است و copy-on-write چطور ساختن ماشین مجازی را از دقیقهها به ثانیهها میرساند؟
- راهاندازی یک محیط آزمایشی OpenStack امروز با چه ابزاری سادهتر است؟
- در production چه نکتههایی در کارایی، امنیت و عملیات اهمیت دارد؟
۳-۱-۲ پیشنیاز#
کلاستر Ceph فصل ۱ و آشنایی با RBD (فصل ۲). آشنایی مقدماتی با اجزای OpenStack کمک میکند. آموزشهای قدیمی از بستههای RDO روی CentOS 7 برای نصب OpenStack استفاده میکردند؛ ما گزینههای امروزی را معرفی میکنیم و پیکربندیها را به شکلی میآوریم که مستقل از ابزار نصب باشد.
۳-۲ Ceph: بهترین همراه OpenStack#
۳-۲-۱ چرا این زوج موفق شد؟#
- یک پشتوانه برای همه: Glance (imageها)، Cinder (volumeها)، Cinder Backup، Nova (دیسکهای موقت)، Manila (اشتراک فایل) و حتی API سازگار با Swift و S3 همه از یک کلاستر Ceph سرویس میگیرند.
- copy-on-write سرتاسری: وقتی Glance و Cinder/Nova هر دو روی Ceph هستند، ساختن volume یا دیسک VM از یک image فقط یک
rbd clone است. نیازی به کپی چندگیگابایتی image روی دیسک compute نیست. - مهاجرت زنده بدون ذخیرهسازی مشترک جداگانه: چون دیسک VM روی Ceph است، live migration فقط حافظه را جابهجا میکند.
- مقیاس همپای ابر: هر compute جدید فقط یک کلاینت دیگر است. ظرفیت و کارایی ذخیرهسازی با افزودن node به Ceph بزرگ میشود.
- متنباز و بدون قفل فروشنده: هر دو پروژه متنبازند و جامعهی مشترک بزرگی دارند.
۳-۲-۲ سرویسها و poolها#
| سرویس OpenStack | بخش Ceph | pool پیشنهادی | کاربر Ceph |
|---|---|---|---|
| Glance | RBD | images | client.glance |
| Cinder | RBD | volumes | client.cinder |
| Cinder Backup | RBD | backups | client.cinder-backup |
| Nova (ephemeral) | RBD | vms | client.cinder (یا client.nova) |
| Manila | CephFS (بومی یا NFS) | فایلسیستم CephFS | client.manila |
| Swift/S3 | RGW با Keystone | poolهای RGW | کاربر RGW (فصل ۴) |
۳-۳ راهاندازی OpenStack آزمایشی#
۳-۳-۱ گزینههای امروز#
روش قدیمی نصب OpenStack با بستههای RDO و ابزار Packstack روی CentOS 7 بود که امروز هر دو منسوخاند. امروز معمولترین راهها اینها هستند:
| ابزار | مناسب برای | نکته |
|---|---|---|
| DevStack | توسعه و آزمایش سریع روی یک ماشین | برای production نیست؛ با افزونهی devstack-plugin-ceph میتوان Ceph را هم وصل کرد |
| Kolla-Ansible | آزمایشگاه و production کانتینری | پشتیبانی جاافتاده از Ceph خارجی برای Glance، Cinder، Nova و Manila |
| OpenStack-Ansible | production روی LXC یا مستقیم | نقشهای Ansible برای اتصال Ceph |
| OpenStack Charms / Sunbeam | محیطهای Canonical | اتصال به Ceph از طریق رابطهای Juju |
در این فصل فرض میکنیم یک OpenStack آزمایشی (مثلاً با Kolla-Ansible یا DevStack) آماده است و Ceph از قبل وجود دارد، یعنی الگوی «Ceph خارجی» که در production هم رایجترین الگوست. پیکربندیها را با نام فایلهای استاندارد هر سرویس میآوریم؛ در Kolla-Ansible همین تنظیمات در پوشهی /etc/kolla/config/<service>/ قرار میگیرند.
Ceph را درون OpenStack (مثلاً با نقشهای قدیمی Kolla یا TripleO) مستقر نکنید. چرخهی عمر دو سیستم را جدا نگه دارید: Ceph با cephadm مستقر و ارتقا داده شود و OpenStack فقط کلاینت آن باشد. این جداسازی ارتقای هر کدام را مستقل و کمخطر میکند. TripleO هم که زمانی این الگو را ترویج میکرد، کنار گذاشته شده است.
۳-۴ پیکربندی OpenStack بهعنوان کلاینت Ceph#
۳-۴-۱ ساختن poolها#
for p in images volumes backups vms; do
  ceph osd pool create $p
  rbd pool init $p
done
ceph osd pool ls detail | grep -E "images|volumes|backups|vms"
با فعال بودن pg_autoscaler نیازی به تعیین دستی تعداد PG نیست، اما بهتر است سهم مورد انتظار هر pool را به autoscaler بگویید تا از ابتدا PG مناسب بگیرد و بعداً موج تقسیم PG نداشته باشید:
ceph osd pool set volumes target_size_ratio 0.6
ceph osd pool set vms target_size_ratio 0.2
ceph osd pool set images target_size_ratio 0.1
ceph osd pool set backups target_size_ratio 0.1
۳-۴-۲ کاربران و مجوزها#
مستندات رسمی Ceph این سه کاربر را پیشنهاد میکنند. دقت کنید که client.cinder روی images فقط اجازهی خواندن دارد، چون فقط باید از imageها clone بسازد:
ceph auth get-or-create client.glance \
  mon 'profile rbd' osd 'profile rbd pool=images' mgr 'profile rbd pool=images'
ceph auth get-or-create client.cinder \
  mon 'profile rbd' \
  osd 'profile rbd pool=volumes, profile rbd pool=vms, profile rbd-read-only pool=images' \
  mgr 'profile rbd pool=volumes, profile rbd pool=vms'
ceph auth get-or-create client.cinder-backup \
  mon 'profile rbd' osd 'profile rbd pool=backups' mgr 'profile rbd pool=backups'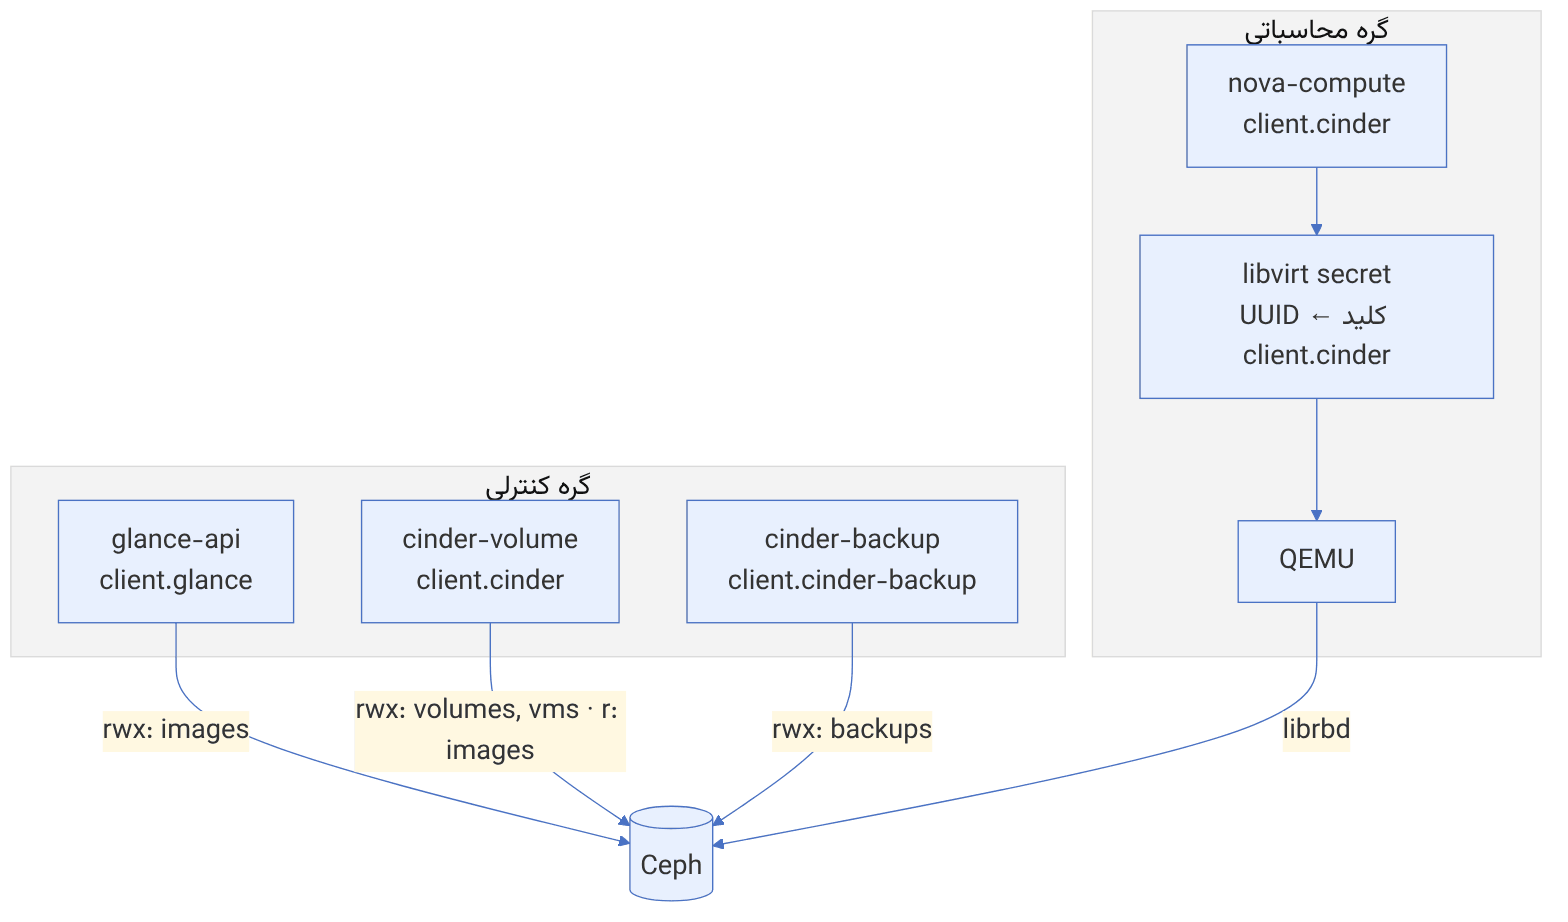
۳-۴-۳ توزیع keyring و ceph.conf#
ceph config generate-minimal-conf > /tmp/ceph.conf
# گره Glance
scp /tmp/ceph.conf glance-host:/etc/ceph/ceph.conf
ceph auth get client.glance | ssh glance-host sudo tee /etc/ceph/ceph.client.glance.keyring
ssh glance-host sudo chown glance:glance /etc/ceph/ceph.client.glance.keyring
# گرههای cinder-volume و nova-compute
ceph auth get client.cinder | ssh cinder-host sudo tee /etc/ceph/ceph.client.cinder.keyring
ceph auth get client.cinder | ssh compute1 sudo tee /etc/ceph/ceph.client.cinder.keyring
# گره cinder-backup
ceph auth get client.cinder-backup | ssh backup-host sudo tee /etc/ceph/ceph.client.cinder-backup.keyringkeyringها را با مالکیت و مجوز درست (chmod 600 و مالک کاربر سرویس) نگه دارید. اگر سرویس OpenStack نتواند keyring را بخواند، خطای معمولاً گمراهکنندهای مثل «error connecting to the cluster» یا «permission denied» با کد ۱۳ میگیرید.
۳-۴-۴ secret در libvirt#
QEMU روی گرههای compute کلید Ceph را از libvirt میگیرد، نه از فایل. باید یک secret با UUID ثابت بسازیم و همان UUID را بعداً در Cinder و Nova به کار ببریم:
UUID=$(uuidgen) # یکبار بسازید و روی همهی computeها همین را استفاده کنید
cat > secret.xml <<X
<secret ephemeral='no' private='no'>
<uuid>${UUID}</uuid>
<usage type='ceph'><name>client.cinder secret</name></usage>
</secret>
X
sudo virsh secret-define --file secret.xml
sudo virsh secret-set-value --secret ${UUID} \
--base64 $(ceph auth get-key client.cinder)
sudo virsh secret-listUUID secret باید روی همهی computeها یکسان باشد، وگرنه live migration شکست میخورد، چون XML دامنه با همان UUID به میزبان مقصد منتقل میشود. ابزارهای استقرار مثل Kolla-Ansible این کار را خودکار انجام میدهند؛ مقدار UUID را در inventory نگه دارید.
۳-۵ پیکربندی Glance با پشتوانهی Ceph#
۳-۵-۱ تنظیمات glance-api#
Glance imageها را بهشکل imageهای RBD در pool images نگه میدارد و پس از آپلود، از هر image یک snapshot به نام snap میسازد تا Cinder و Nova بتوانند از آن clone بگیرند.
# /etc/glance/glance-api.conf
[DEFAULT]
enabled_backends = ceph:rbd
show_image_direct_url = True

[glance_store]
default_backend = ceph

[ceph]
rbd_store_pool = images
rbd_store_user = glance
rbd_store_ceph_conf = /etc/ceph/ceph.conf
rbd_store_chunk_size = 8show_image_direct_url = True برای copy-on-write ضروری است، چون Cinder و Nova از روی همین نشانی (rbd://fsid/images/<id>/snap) تشخیص میدهند image روی همان کلاستر است و میتوانند clone بسازند. اما این گزینه محل ذخیرهی image را از طریق API نشان میدهد. اگر API Glance در دسترس کاربران نهایی است، با سیاستهای Glance دسترسی به این فیلد را محدود کنید یا از قابلیت چند نشانی و endpoint داخلی استفاده کنید.
۳-۵-۲ قالب image: همیشه raw#
copy-on-write فقط وقتی کار میکند که image در Glance با قالب raw ذخیره شده باشد. اگر qcow2 آپلود کنید، Cinder و Nova باید هر بار آن را دانلود و تبدیل کنند و مزیت اصلی از بین میرود.
qemu-img convert -f qcow2 -O raw ubuntu-24.04.qcow2 ubuntu-24.04.raw
openstack image create ubuntu-24.04 \
  --disk-format raw --container-format bare \
  --file ubuntu-24.04.raw \
  --property hw_scsi_model=virtio-scsi --property hw_disk_bus=scsi \
  --property hw_qemu_guest_agent=yes --property os_require_quiesce=yes
rbd -p images ls -l --id glanceویژگیهای بالا که مستندات Ceph هم پیشنهاد میکنند، به این معنیاند: کنترلر virtio-scsi (که discard را پشتیبانی میکند)، اتصال دیسکها به آن، فعال کردن QEMU guest agent و درخواست quiesce (fsfreeze) هنگام snapshot برای سازگاری بهتر.
نسخههای جدید Glance امکان «image conversion» هنگام import را دارند (import plugin). با فعال کردن آن، کاربر میتواند qcow2 آپلود کند و Glance خودش آن را به raw تبدیل و در Ceph ذخیره میکند. این برای ابرهای عمومی که کاربران نهایی image آپلود میکنند، راحتتر از آموزش دادن به آنهاست.
۳-۵-۳ غیرفعال کردن cache محلی Glance#
اگر cache مدیریتی Glance فعال باشد، imageها روی دیسک محلی گره Glance هم کپی میشوند که با Ceph بیفایده است. در پیکربندی pipeline، flavor را از keystone+cachemanagement به keystone برگردانید.
۳-۶ پیکربندی Cinder#
۳-۶-۱ backend RBD#
# /etc/cinder/cinder.conf
[DEFAULT]
enabled_backends = ceph
glance_api_version = 2

[ceph]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = ceph
rbd_pool = volumes
rbd_ceph_conf = /etc/ceph/ceph.conf
rbd_flatten_volume_from_snapshot = false
rbd_max_clone_depth = 5
rbd_store_chunk_size = 4
rados_connect_timeout = -1
rbd_user = cinder
rbd_secret_uuid = 457eb676-33da-42ec-9a8c-9293d545c337| گزینه | معنا | توصیه |
|---|---|---|
| rbd_flatten_volume_from_snapshot | volume ساختهشده از snapshot فوراً flatten شود؟ | false برای سرعت؛ true اگر میخواهید snapshot را زود پاک کنید |
| rbd_max_clone_depth | حداکثر عمق زنجیرهی clone پیش از flatten خودکار | ۵ (پیشفرض) مناسب است |
| rbd_store_chunk_size | اندازهی شیء به مگابایت | ۴ (همان پیشفرض RBD) |
| rbd_secret_uuid | UUID secret در libvirt | باید با secret تعریفشده روی computeها یکی باشد |
| rbd_exclusive_cinder_pool | pool فقط در اختیار Cinder است | true برای سرعت محاسبهی ظرفیت در poolهای بزرگ |
۳-۶-۲ نوع volume و چند backend#
در production معمولاً بیش از یک کلاس ذخیرهسازی دارید، مثلاً یک pool روی NVMe و یکی روی HDD. هر کدام یک backend جداگانه در Cinder و یک volume type میشوند:
[DEFAULT]
enabled_backends = ceph-nvme,ceph-hdd

[ceph-nvme]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = ceph-nvme
rbd_pool = volumes-nvme
rbd_user = cinder
rbd_secret_uuid = 457eb676-33da-42ec-9a8c-9293d545c337

[ceph-hdd]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = ceph-hdd
rbd_pool = volumes-hdd
rbd_user = cinder
rbd_secret_uuid = 457eb676-33da-42ec-9a8c-9293d545c337openstack volume type create fast
openstack volume type set fast --property volume_backend_name=ceph-nvme
openstack volume type create capacity
openstack volume type set capacity --property volume_backend_name=ceph-hddیادتان باشد که مجوز client.cinder باید poolهای جدید را هم شامل شود (ceph auth caps). pool NVMe هم با قاعدهی CRUSH مبتنی بر device class (ceph osd crush rule create-replicated nvme-rule default host nvme) روی دیسکهای درست قرار میگیرد (فصل ۸).
برای کلاسترهای چندهزار volume، Cinder active-active و نیز گزینهی backend_host (یا cluster در نسخههای جدید) را در نظر بگیرید تا چند سرویس cinder-volume بتوانند یک backend Ceph را مدیریت کنند و خرابی یکی، مدیریت volumeها را متوقف نکند.
۳-۷ پیکربندی Cinder Backup#
پشتیبانگیری از volume به یک pool جداگانه (یا ترجیحاً یک کلاستر Ceph دیگر) انجام میشود. درایور Ceph برای Cinder Backup قابلیت پشتیبانگیری افزایشی را دارد: اگر مبدأ و مقصد هر دو Ceph باشند، فقط تفاضل تغییرات با rbd export-diff و import-diff منتقل میشود.
[DEFAULT]
backup_driver = cinder.backup.drivers.ceph.CephBackupDriver
backup_ceph_conf = /etc/ceph/ceph.conf
backup_ceph_user = cinder-backup
backup_ceph_chunk_size = 134217728
backup_ceph_pool = backups
backup_ceph_stripe_unit = 0
backup_ceph_stripe_count = 0
restore_discard_excess_bytes = trueپشتیبانی که روی همان کلاستر Ceph نگه داشته شود، در برابر خرابی خود کلاستر (اشتباه مدیریتی، باگ نرمافزاری، باجافزاری که به اعتبارنامهی مدیر رسیده) محافظتی ندارد. قاعدهی ۳-۲-۱ را فراموش نکنید: برای دادهی حیاتی، backup را با backup_ceph_conf به یک کلاستر دیگر (ترجیحاً در سایت دیگر) بفرستید.
۳-۸ پیکربندی Nova#
۳-۸-۱ بوت مستقیم از Ceph (ephemeral روی RBD)#
بهطور پیشفرض Nova دیسکهای موقت ماشینها را روی دیسک محلی compute میسازد. با پیکربندی زیر، دیسک ریشهی هر VM یک image در pool vms میشود که از image Glance clone شده است:
# /etc/nova/nova.conf روی همهی computeها
[libvirt]
images_type = rbd
images_rbd_pool = vms
images_rbd_ceph_conf = /etc/ceph/ceph.conf
rbd_user = cinder
rbd_secret_uuid = 457eb676-33da-42ec-9a8c-9293d545c337
disk_cachemodes = "network=writeback"
hw_disk_discard = unmap
live_migration_permit_auto_converge = true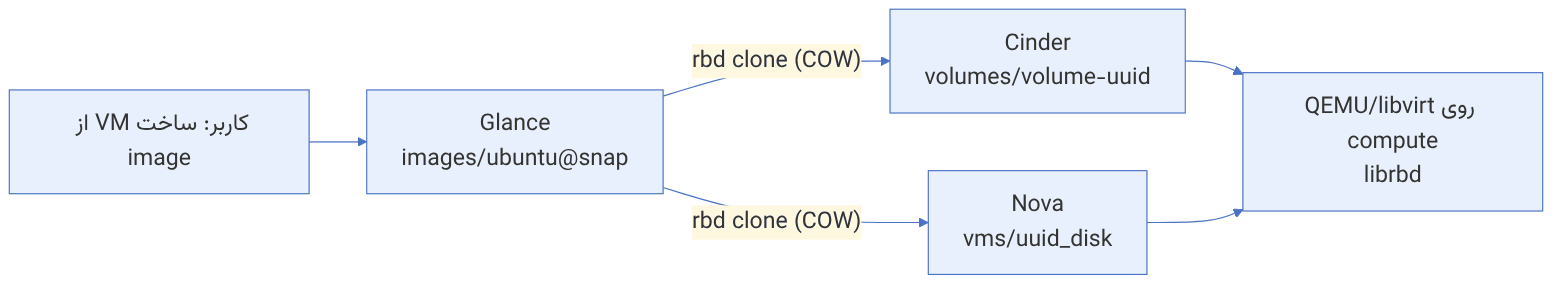
disk_cachemodes = "network=writeback" حالت cache دیسکهای شبکهای در QEMU را writeback میکند تا cache کلاینت librbd فعال شود. این امن است، چون librbd به flushهای سیستمعامل مهمان احترام میگذارد و گزینهی rbd cache writethrough until flush (پیشفرض true) تضمین میکند تا وقتی مهمان نشان نداده flush میفرستد، cache در حالت writethrough بماند. hw_disk_discard = unmap هم discard مهمان را به Ceph میرساند تا فضای حذفشده واقعاً آزاد شود.
۳-۸-۲ اتصال volumeهای Cinder#
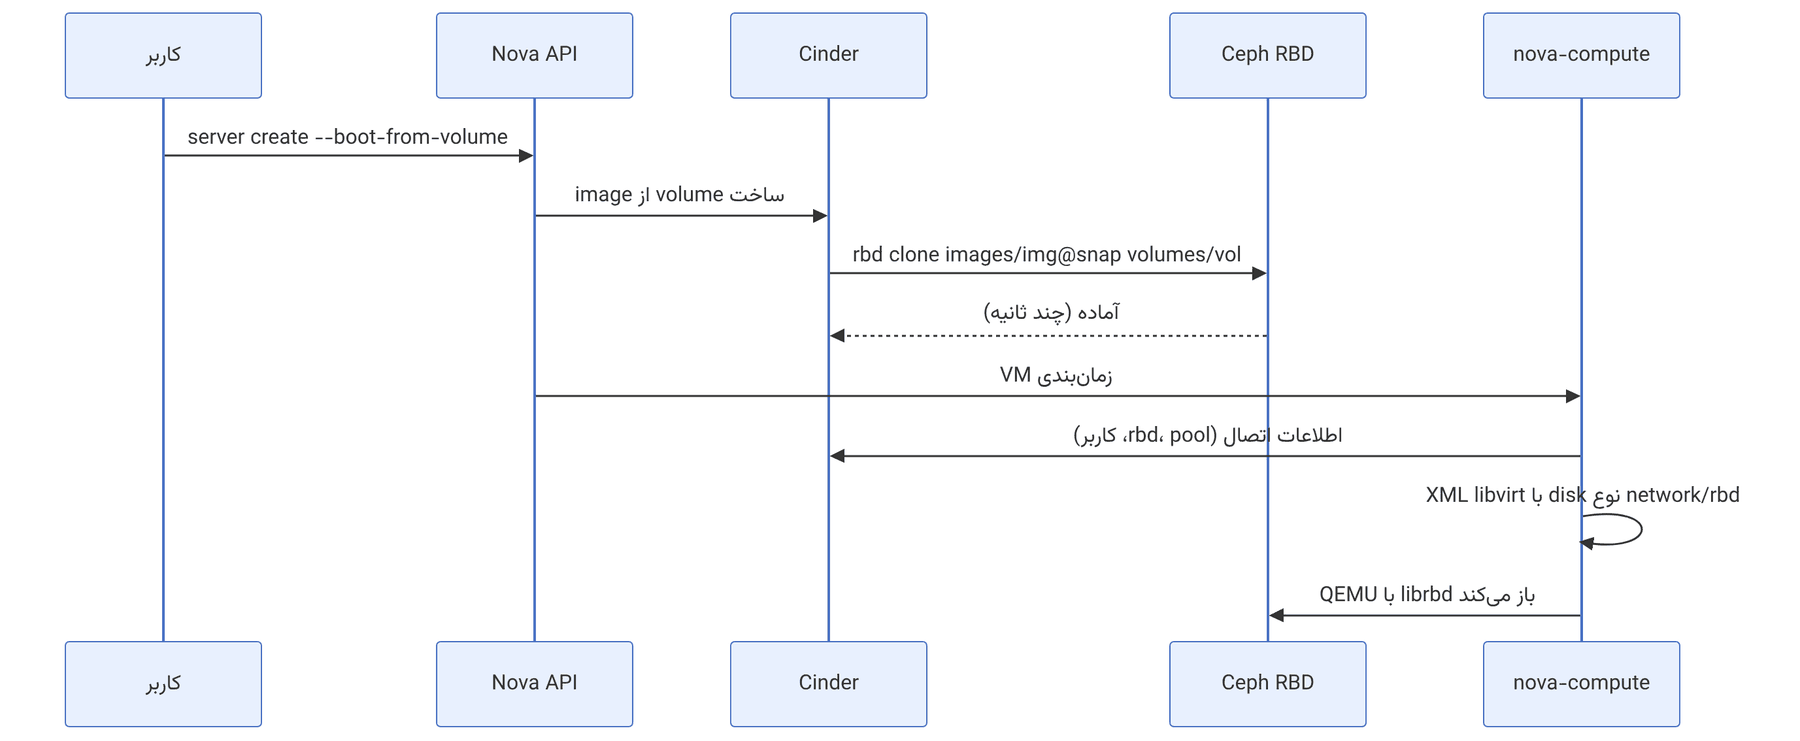
برای attach کردن volumeها نیازی به پیکربندی بیشتر در Nova نیست، به شرط آنکه secret libvirt تعریف شده و keyring client.cinder روی compute باشد. Nova از Cinder اطلاعات اتصال (پروتکل rbd، pool، نام image، کاربر و UUID secret) را میگیرد و در XML دامنه یک دیسک از نوع network با پروتکل rbd تعریف میکند.
۳-۸-۳ admin socket و لاگ برای ماشینهای مجازی#
مستندات Ceph پیشنهاد میکنند روی هر hypervisor برای کلاینتهای QEMU، admin socket و فایل لاگ فعال شود. این کار هنگام عیبیابی کارایی یک VM خاص بسیار ارزشمند است:
# /etc/ceph/ceph.conf روی computeها
[client]
rbd cache = true
rbd cache writethrough until flush = true
admin socket = /var/run/ceph/guests/$cluster-$type.$id.$pid.$cctid.asok
log file = /var/log/qemu/qemu-guest-$pid.log
rbd concurrent management ops = 20sudo mkdir -p /var/run/ceph/guests/ /var/log/qemu/
sudo chown qemu:libvirt /var/run/ceph/guests /var/log/qemu/ # نام کاربر و گروه به توزیع بستگی دارد
# بعد از راهاندازی دوبارهی VM:
sudo ceph --admin-daemon /var/run/ceph/guests/ceph-client.cinder.<pid>.<cctid>.asok perf dump۳-۹ از درون کد: clone، copy-on-write و copyup در librbd#
۳-۹-۱ چرا این بخش برای OpenStack مهم است#
وقتی Glance و Cinder/Nova هر دو روی Ceph باشند، ساختن یک VM جدید به معنای کپی کردن تصویر نیست. سرویس یک snapshot از تصویر Glance میگیرد و یک clone لایهای (feature layering) از آن میسازد. clone فقط فراداده است: یک header جدید با اشارهگر parent به (pool، image id، snap id) و overlap. هزینهی واقعی بعداً و بهصورت تدریجی پرداخت میشود، یعنی در اولین نوشتن روی هر شیء با عملیاتی به نام copyup.
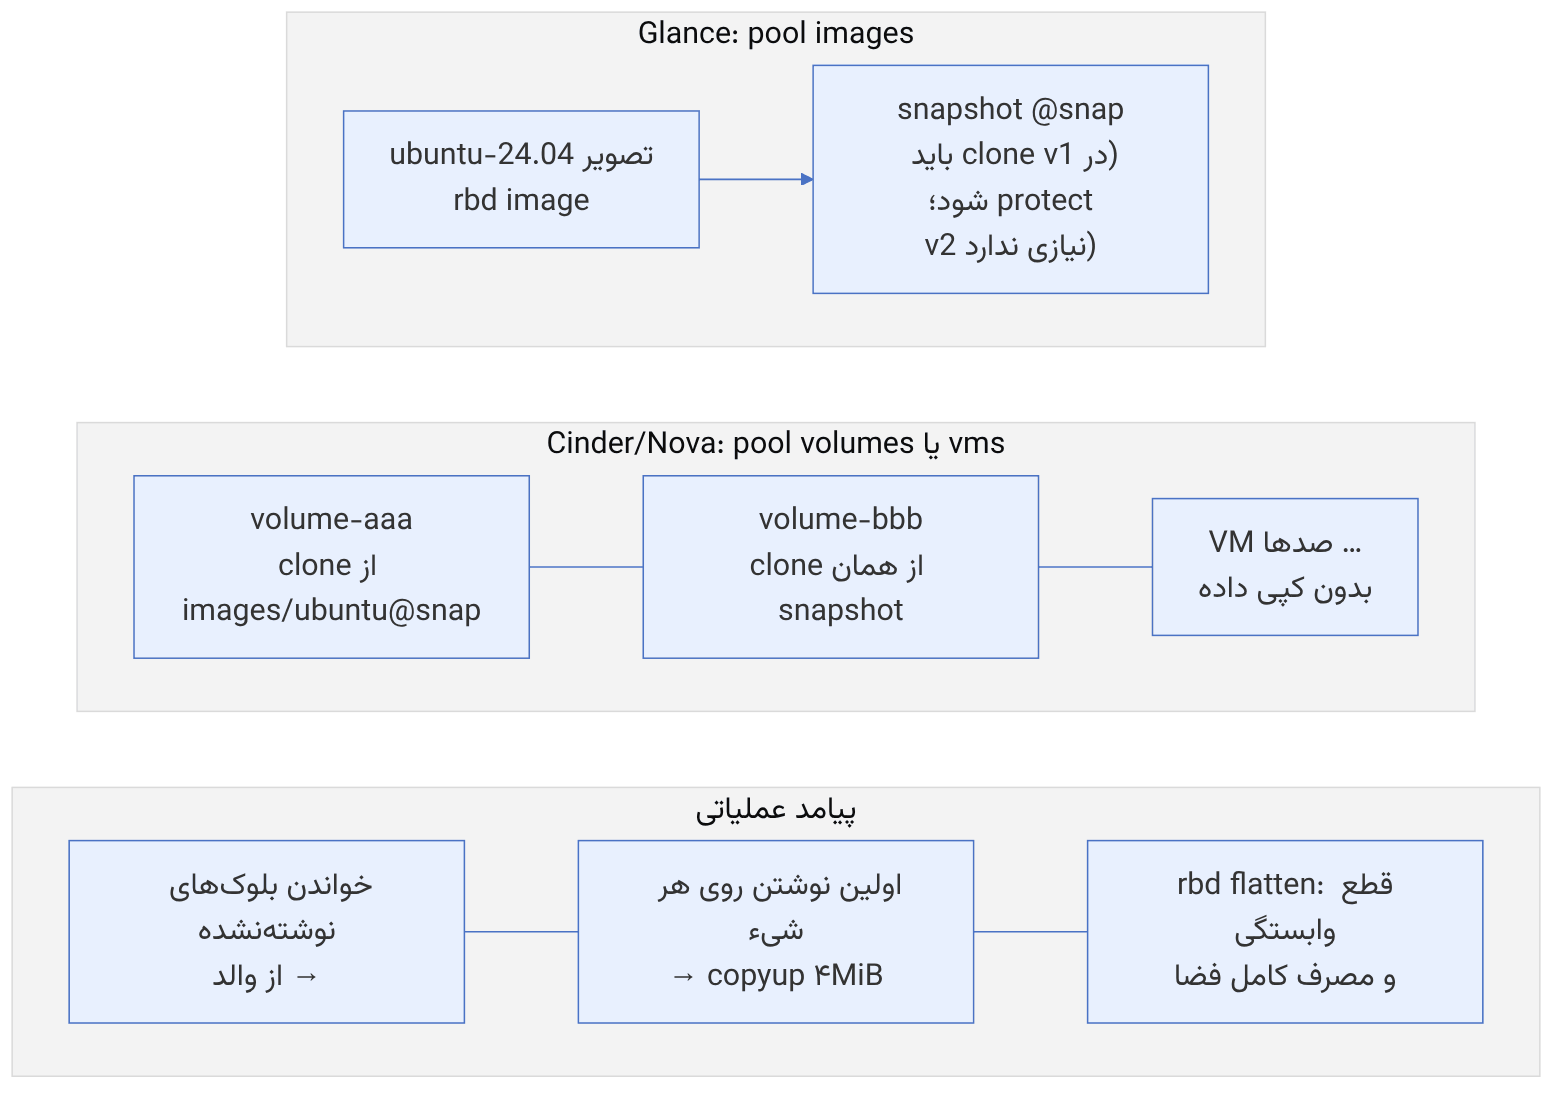
۳-۹-۲ ماشین حالت CopyupRequest#
در src/librbd/io/CopyupRequest.cc توابع به ترتیب اجرا اینها هستند: send → read_from_parent → (deep_copy در صورت نیاز) → update_object_maps → copyup → finish. چند درخواست نوشتن همزمان روی یک شیء با append_request به یک copyup مشترک متصل میشوند تا دادهی والد فقط یک بار خوانده شود.
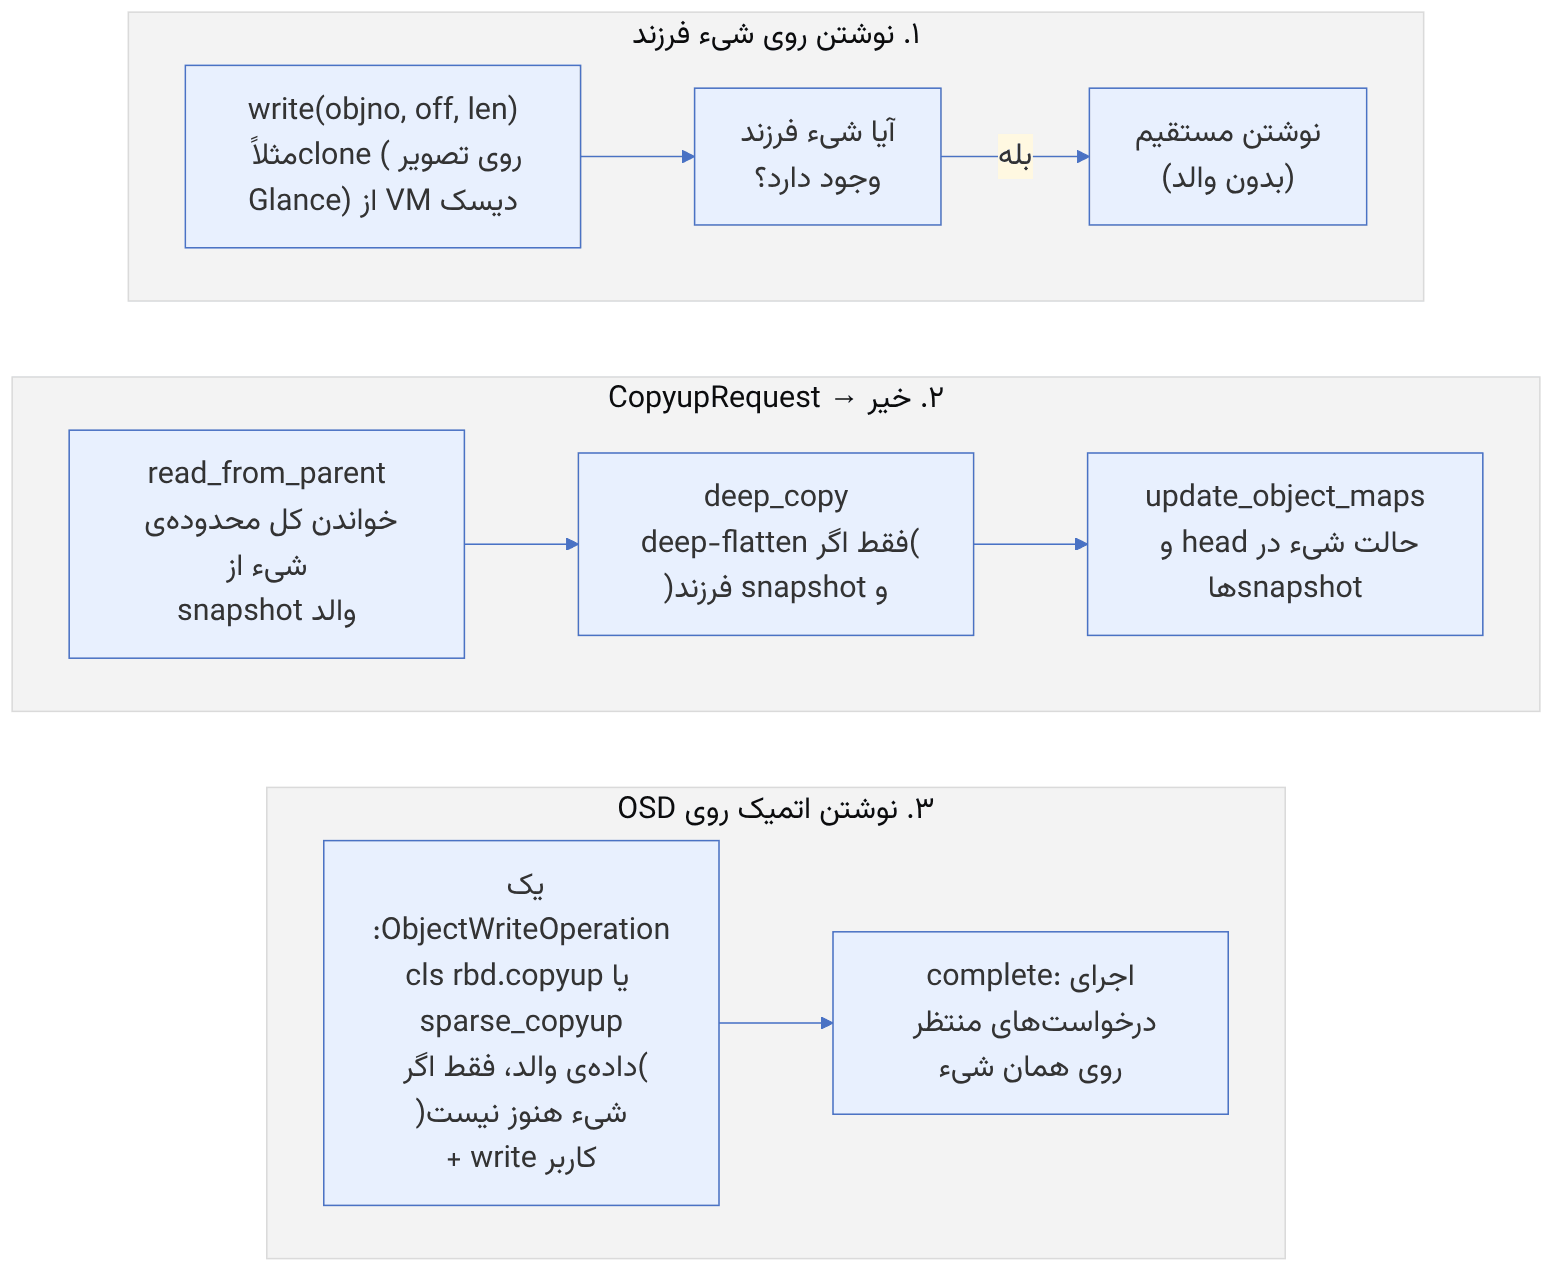
// from ceph/ceph, LGPL — src/librbd/io/CopyupRequest.cc, copyup() (excerpt)
    cls_client::sparse_copyup(op, m_copyup_extent_map, m_copyup_data);
...
cls_client::copyup(op, thick_bl);pseudocode: مسیر خواندن/نوشتن clone (خلاصهی این کتاب)
read(objno, extent):
r = osd_read(child_obj)
if r == -ENOENT and extent within parent_overlap:
r = read parent image @snap at same image offset
if rbd_clone_copy_on_read: schedule copyup(objno) # پیشفرض false
return r
write(objno, extent, data):
if child object may not exist (object map != EXISTS) and within overlap:
copyup = get_or_create CopyupRequest(objno); copyup.append(this)
else: osd_write(child_obj, data)| گزینه (rbd.yaml.in) | پیشفرض | اثر |
|---|---|---|
| rbd_default_clone_format | auto | v2 اگر min_compat_client حداقل mimic باشد |
| rbd_clone_copy_on_read | false | copyup هنگام خواندن (گرم کردن فرزند، با هزینهی نوشتن) |
| rbd_parent_cache_enabled | false | کش فقطخواندنی والد روی میزبان (immutable object cache) |
| rbd_sparse_read_threshold_bytes | ۶۴_K | آستانهی استفاده از sparse-read |
«طوفان copyup»: پس از راهاندازی همزمان صدها VM از یک تصویر، هر نوشتن کوچکی (مثل لاگ یا cloud-init) روی شیئی دستنخورده یک خواندن و نوشتن ۴MiB ایجاد میکند. نشانهها: افزایش ناگهانی write bandwidth با IOPS پایین در ceph osd pool stats. راهحلها: اشیای کوچکتر برای تصاویر پایه، rbd flatten تدریجی برای VMهای پرنوشتن، یا محدود کردن شدت boot.
بررسی زنجیرهی والد:
rbd info volumes/volume-aaa | grep -A3 parent
rbd children images/ubuntu@snap # همهی فرزندان (v2 شامل pool دیگر)
rbd du volumes/volume-aaa # مصرف واقعی پس از copyupها
rbd flatten volumes/volume-aaa # عملیات طولانی؛ پیشرفت را گزارش میدهد
ceph osd get-require-min-compat-client۳-۱۰ librbd زیر پای OpenStack، با عدد#
هر دیسکی که Nova، Cinder یا Glance روی Ceph میسازند، در نهایت یک image در librbd است. این بخش چهار الگوریتم librbd را که مستقیم روی رفتار ماشینهای مجازی OpenStack اثر میگذارند، با کد و عدد دنبال میکند: نگاشت بایتهای دیسک به شیء، object map، محاسبهی تفاوت میان snapshotها (پایهی پشتیبان افزایشی cinder-backup) و محدودکنندهی QoS. همهی ارجاعهای کد به شاخهی main مخزن Ceph است که در نوامبر ۲۰۲۶ بررسی شد. عددهای مثالها با بازپیادهسازی پایتونی همین توابع دوباره حساب شدهاند.
۳-۱۰-۱ از offset دیسک تا نام شیء#
منبع در کد: src/osdc/Striper.cc :: Striper::file_to_extents؛ src/librbd/ImageCtx.cc :: ImageCtx::init_layout
پیچیدگی: O(len / stripe_unit) قطعه برای هر درخواست؛ O(۱) برای هر قطعه
pseudocode
os = object_size ; su = stripe_unit ; sc = stripe_count
if sc == 1: su = os # حالت پیشفرض RBD: هر شیء یک «بلوک»
spo = os / su # stripe در هر شیء
cur = off ; left = len
while left > 0:
blockno = cur / su
stripeno = blockno / sc ; stripepos = blockno mod sc
objectset = stripeno / spo
objectno = objectset × sc + stripepos
x_off = (stripeno mod spo) × su + cur mod su
x_len = min(left, su − cur mod su)
به extent شیء objectno اضافه کن (buffer_extents ترتیب بافر کاربر را نگه میدارد)
cur += x_len ; left −= x_len
oid(objectno) = object_prefix + "." + hex16(objectno) # image قالب 2: rbd_data.<id>.%016llxمثال عددی. یک image با order = 22 (شیء ۴ MiB) و stripe پیشفرض (stripe_count = ۱) را در نظر بگیرید. VM مهمان ۱ MiB را از offset ۱۰.۵ MiB مینویسد. چون sc = ۱ است، su برابر ۴ MiB میشود. blockno = ⌊۱۰.۵ / ۴⌋ = ۲، پس objectno = ۲ و offset درون شیء ۱۰.۵ − ۸ = ۲.۵ MiB (۰x۲۸۰۰۰۰) است. کل نوشتن یک extent روی شیء rbd_data.<id>.0000000000000002 میشود.
حالا همان image را با «striping پیشرفته» بسازید (--stripe-unit 65536 --stripe-count 4، که ویژگی STRIPINGV2 را لازم دارد). su = ۶۴ KiB و spo = ۴ MiB / ۶۴ KiB = ۶۴. offset ۱۰.۵ MiB یعنی blockno = ۱۶۸، stripeno = ۴۲، stripepos = ۰، objectset = ⌊۴۲ / ۶۴⌋ = ۰ و objectno = ۰. نوشتن ۱ MiB به ۱۶ قطعهی ۶۴ KiB میشکند (blockno 168 تا ۱۸۳). قطعهها به نوبت به شیءهای ۰، ۱، ۲ و ۳ میروند: قطعهی ۰ به شیء ۰، قطعهی ۱ به شیء ۱ و همینطور تا آخر. هر شیء چهار قطعهی پشتسرهم در بازهی ۰x2a0000 تا ۰x2e0000 میگیرد (stripeno 42 تا ۴۵ ضرب در ۶۴ KiB). نتیجهی عملی این است که یک نوشتن ترتیبی بزرگ همزمان چهار PG و احتمالاً چهار OSD اصلی را درگیر میکند، اما هر درخواست ۴ KiB تصادفی همچنان به یک شیء میرود. QEMU و Nova هیچکدام از این را نمیبینند. striping فقط هنگام ساخت image تعیین میشود و بعداً قابل تغییر نیست.
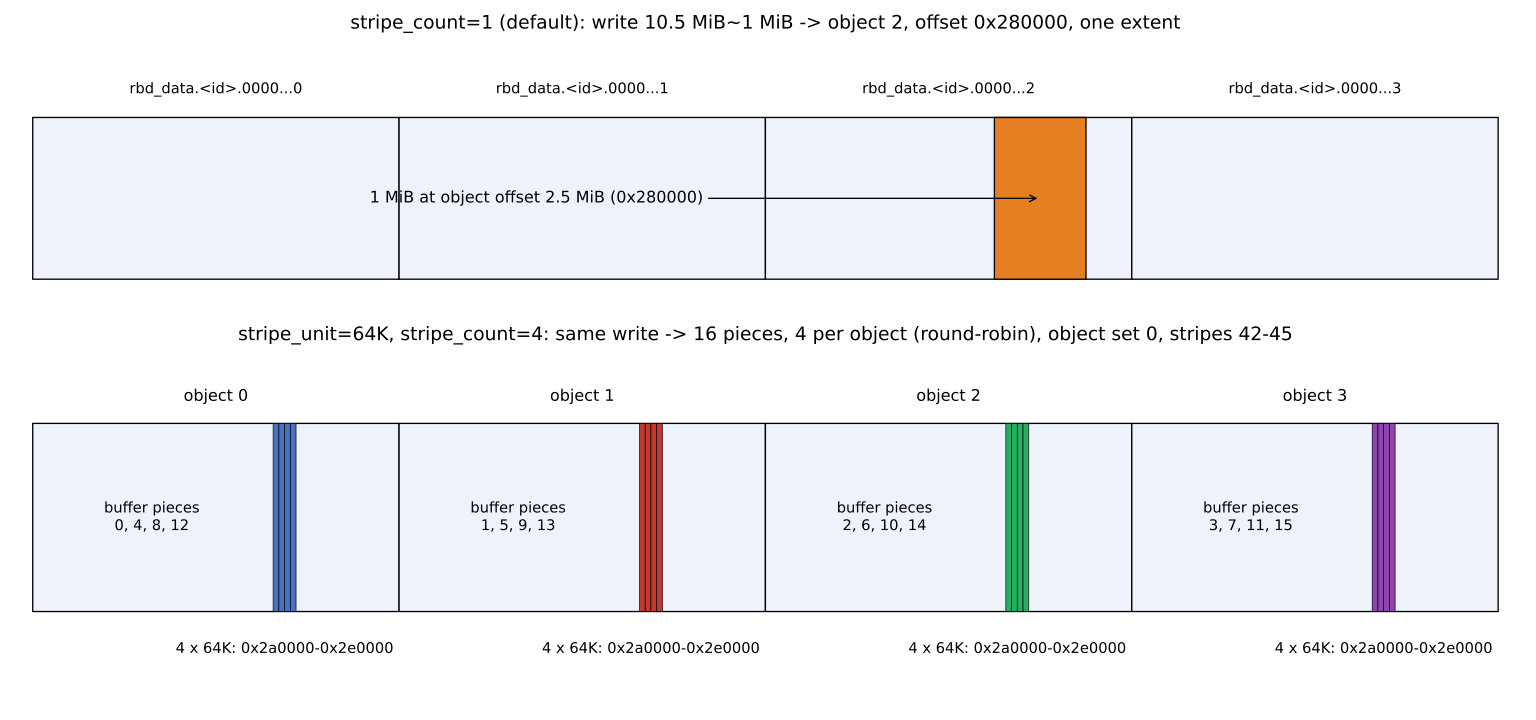
نمودار بالا یک نکتهی عملی را روشن میکند. وقتی پشتیبانگیری یا مهاجرت یک volume با rbd export انجام میشود، کارایی آن به تعداد شیءهایی بستگی دارد که همزمان خوانده میشوند. با stripe پیشفرض، librbd برای موازیسازی به rbd_concurrent_management_ops و چند درخواست همزمان تکیه میکند. با striping پیشرفته، حتی یک درخواست بزرگ واحد هم چند شیء را با هم درگیر میکند. برای VMهای OpenStack معمولاً همان پیشفرض بهتر است، چون بار مهمانها کوچک و تصادفی است.
۳-۱۰-۲ object map: دو بیت برای هر شیء#
منبع در کد: src/include/rbd/object_map_types.h؛ src/librbd/ObjectMap.cc :: ObjectMap::is_compatible؛ src/cls/rbd/cls_rbd_types.h :: MAX_OBJECT_MAP_OBJECT_COUNT؛ src/librbd/io/ObjectRequest.cc :: AbstractObjectWriteRequest؛ src/librbd/object_map/SnapshotCreateRequest.cc :: update_object_map
پیچیدگی: حافظه ۲·N بیت برای N شیء؛ هر بهروزرسانی O(۱) بهعلاوهی یک فراخوانی cls روی شیء rbd_object_map
pseudocode
N = ceil(image_size / object_size)
if N > 256000000: object map ناسازگار ⇒ ویژگی object-map/fast-diff قابل استفاده نیست
map = BitVector<2>[N] (00 NONEXISTENT، 01 EXISTS، 10 PENDING، 11 EXISTS_CLEAN)
write(objectno): اگر map[o] ≠ EXISTS: ابتدا map[o] = EXISTS (پیش از نوشتن داده)
discard/remove(o): map[o] = PENDING ; حذف شیء ; سپس map[o] = NONEXISTENT
snap create: کپی map در rbd_object_map.<id>.<snapid> ؛ در HEAD همهی EXISTS ⇒ EXISTS_CLEAN
read(o): اگر map[o] == NONEXISTENT ⇒ بدون رفتن به OSD (یا مستقیم به parent)مثال عددی. volume یک ترابایتی با شیء ۴ MiB برابر شیء است. object map آن ۲۶۲۱۴۴ × ۲ / ۸ = ۶۵۵۳۶ بایت، یعنی ۶۴ KiB میشود و بهراحتی در حافظهی هر کلاینت جا میگیرد. سقف ۲۵۶۰۰۰۰۰۰ شیء با شیء ۴ MiB یعنی image حداکثر ۲۵۶۰۰۰۰۰۰ × ۴ MiB ≈ ۹۷۶.۶ TiB. همین سقف با شیء ۶۴ KiB به حدود ۱۵.۳ TiB کاهش مییابد. map در این حالت ۲۵۶۰۰۰۰۰۰ × ۲ / ۸ = ۶۴۰۰۰۰۰۰ بایت (حدود ۶۱ MiB) است. اگر کسی برای پایگاه دادهای image با order = 16 بسازد، باید بداند که بالاتر از این اندازه object map و در نتیجه fast-diff و rbd du سریع را از دست میدهد.
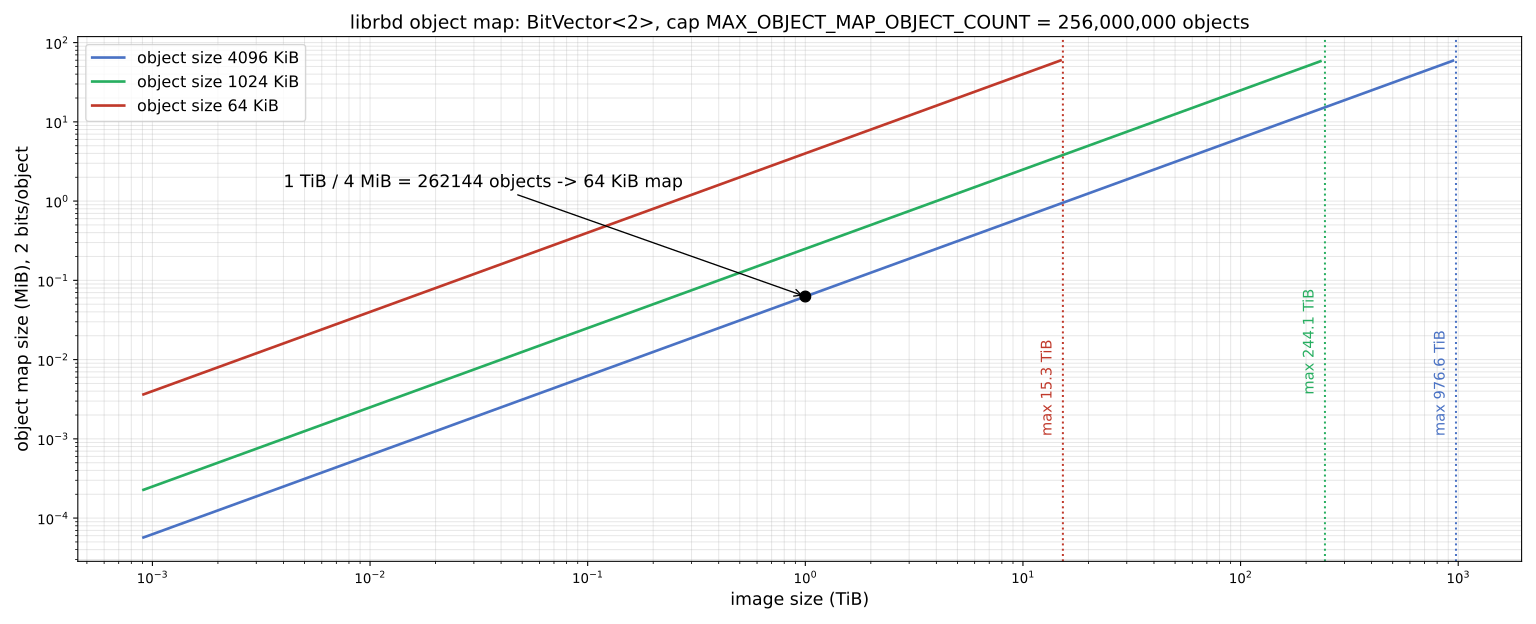
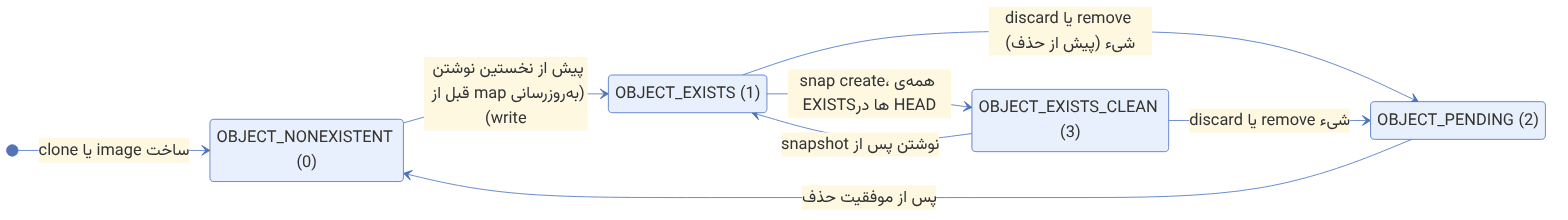
ترتیب «اول map، بعد داده» هزینه دارد: نخستین نوشتن روی هر شیء یک رفتوبرگشت اضافه به OSD نگهدارندهی rbd_object_map.<image id> اضافه میکند. این هزینه فقط یک بار برای هر شیء پرداخت میشود و پس از آن خانه EXISTS است. پس از هر snapshot، خانهها CLEAN میشوند و نخستین نوشتن روی هر شیء دوباره یک بهروزرسانی map دارد. به همین دلیل، snapshotهای بسیار مکرر (مثلاً هر دقیقه برای mirroring مبتنی بر snapshot) روی volumeهای پرنوشتن کمی تأخیر نوشتن را بالا میبرند. object map فقط با قفل انحصاری (exclusive-lock) کار میکند، چون فقط یک کلاینت باید map را بهروز کند.
۳-۱۰-۳ تفاوت میان snapshotها (fast-diff)#
منبع در کد: src/librbd/object_map/DiffRequest.cc :: DiffRequest::handle_load_object_map
پیچیدگی: O(N × S) برای N شیء و S object map میان دو snapshot؛ بدون خواندن داده
pseudocode
# برای diff-iterate از snap_start تا snap_end
نخستین map (snap_start): NONEXISTENT ⇒ HOLE ، وگرنه DATA (PENDING ⇒ DATA_UPDATED)
برای هر map بعدی m و هر شیء o:
HOLE: اگر m[o] ≠ NONEXISTENT و این map آخر است ⇒ DATA_UPDATED (در mapهای میانی HOLE میماند)
DATA: NONEXISTENT ⇒ HOLE_UPDATED ؛ EXISTS یا PENDING ⇒ DATA_UPDATED ؛ EXISTS_CLEAN ⇒ بدون تغییر
HOLE_UPDATED: اگر m[o] ≠ NONEXISTENT ⇒ DATA_UPDATED
DATA_UPDATED: NONEXISTENT ⇒ HOLE_UPDATED
خروجی: شیءهای *_UPDATED تغییرکردهاند ؛ HOLE_UPDATED یعنی «صفر/حذفشده گزارش کن»مثال عددی. شش شیء o0 تا o5 و سه map داریم: snap1، snap2 و HEAD. cinder-backup میخواهد پشتیبان افزایشی از snap1 تا وضعیت فعلی بسازد (همان کاری که rbd export-diff --from-snap snap1 میکند).
- o0: در snap1 EXISTS، در snap2 و HEAD EXISTS_CLEAN. از DATA شروع میشود و DATA میماند. تغییر نکرده و منتقل نمیشود.
- o1: پیش از snap2 نوشته شده است (در snap2 EXISTS). در snap2 به DATA_UPDATED میرود و همان میماند. منتقل میشود.
- o2: در snap1 وجود ندارد (HOLE). در snap2 ساخته شده، اما چون snap2 میانی است HOLE میماند. در HEAD (map آخر) به DATA_UPDATED میرود. منتقل میشود.
- o3: در snap2 حذف شده است و به HOLE_UPDATED میرود. بهصورت «ناحیهی صفر» گزارش میشود.
- o4: هیچجا وجود ندارد و HOLE است. هیچ دادهای منتقل نمیشود.
- o5: پس از snap2 دوباره نوشته شده است (در HEAD EXISTS). از DATA به DATA_UPDATED میرود. منتقل میشود.
از شش شیء، سه شیء داده و یک شیء علامت صفر منتقل میکنند. هیچ شیئی برای مقایسه خوانده نشد: کل diff فقط از سه map کوچک به دست آمد. برای volume یک ترابایتی، این یعنی پیمایش ۳ × ۶۴ KiB بهجای خواندن یک ترابایت.
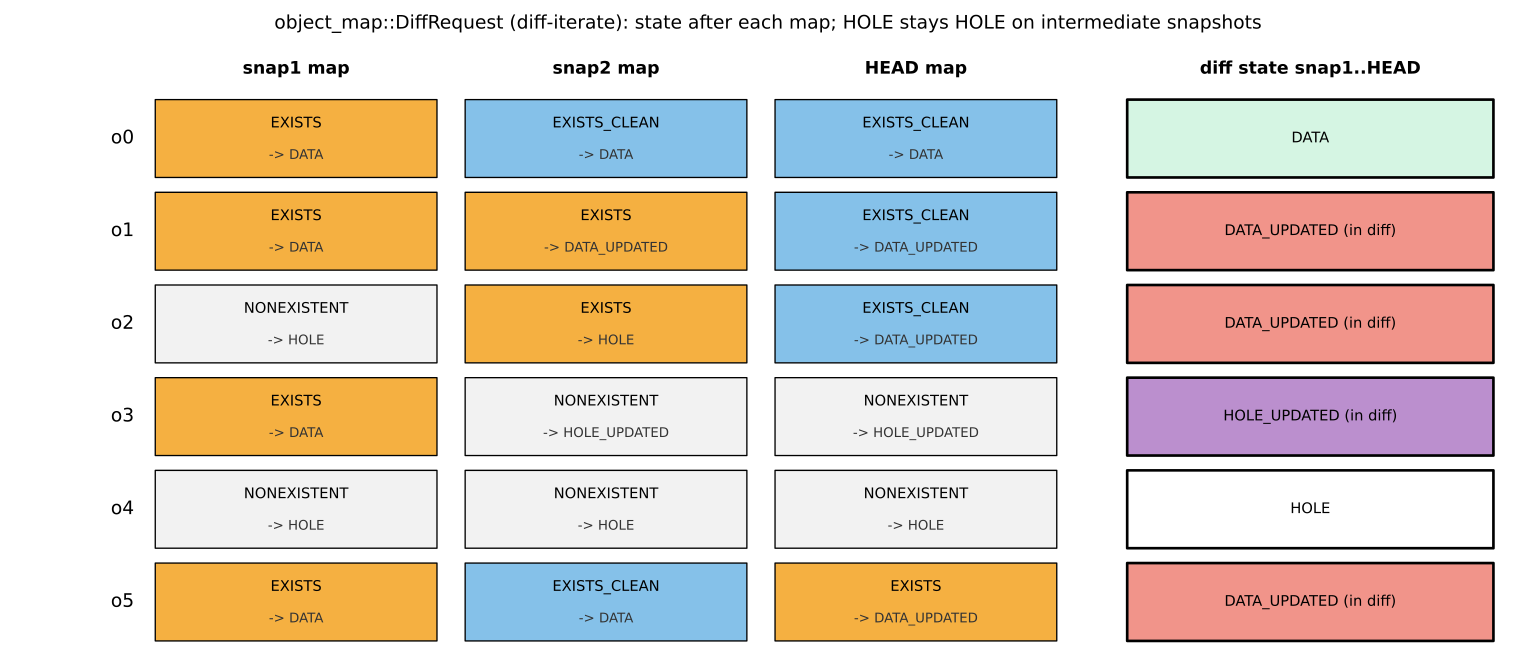
این الگوریتم به یک فرض مهم تکیه دارد: object map باید معتبر باشد. اگر کلاینتی بدون آزاد کردن قفل از کار بیفتد، ممکن است librbd پرچم «object map invalid» بگذارد. در آن حالت diff به پیمایش کامل (list-snaps روی هر شیء) برمیگردد که بسیار کندتر است. rbd object-map check و rbd object-map rebuild برای بازسازی هستند. در عمل اگر پشتیبانهای افزایشی cinder-backup ناگهان کند شدند، اولین چیزی که باید بررسی شود همین پرچم در rbd info است.
۳-۱۰-۴ QoS سمت کلاینت: سطل توکن librbd#
منبع در کد: src/common/Throttle.cc :: TokenBucketThrottle::set_limit، tokens_this_tick، add_tokens، Bucket::put، Bucket::get؛ src/librbd/io/QosImageDispatch.cc
پیچیدگی: O(۱) برای هر tick؛ O(b) برای آزاد کردن b درخواست منتظر
pseudocode
set_limit(avg, burst, burst_seconds):
tick_ms = max(1000 / avg, rbd_qos_schedule_tick_min = 50)
ticks_per_s = 1000 / tick_ms
max = (burst == 0) ? avg : burst ; capacity = max × max(burst_seconds, 1) ; remain = capacity
هر tick:
tokens = ⌊i × avg / ticks_per_s⌋ − ⌊(i−1) × avg / ticks_per_s⌋ # i = 1..ticks_per_s
remain = min(capacity, remain + tokens)
inc = tokens × (max / avg) اگر max > avg ، وگرنه tokens # در burst سریعتر پر میشود
available = min(available + inc, min(remain, max))
درخواستهای منتظر را به ترتیب ورود تا جایی که available کافی است آزاد کن
get(c): از available و remain کم کن ؛ اگر کافی نبود، درخواست در صف میماندمثال عددی. محدودیت rbd_qos_iops_limit = 30 را در نظر بگیرید. tick = max(۱۰۰۰ / ۳۰ = ۳۳، ۵۰) = ۵۰ ms، پس ۲۰ tick در ثانیه داریم. توکنهای هر tick به شکل ⌊۱.۵ i⌋ − ⌊۱.۵ (i−۱)⌋ هستند، یعنی ۱، ۲، ۱، ۲ و همینطور تا آخر. جمع آنها دقیقاً ۳۰ است. برای avg = ۱۰۰، هر tick دقیقاً ۵ توکن میگیرد. برای avg = ۷، tick برابر ⌊۱۰۰۰ / ۷⌋ = ۱۴۲ ms است و ⌊۱۰۰۰ / ۱۴۲⌋ = ۷ tick در ثانیه داریم، هر کدام یک توکن.
اکنون burst را ببینیم: avg = ۱۰۰، burst = ۳۰۰ و burst_seconds = ۲. پس max = ۳۰۰ و capacity = ۶۰۰. ضریب burst ۳۰۰ / ۱۰۰ = ۳ است و available در هر tick ۱۵ واحد بالا میرود، در حالی که remain فقط ۵ واحد پر میشود. یک کلاینت اشباع (که همیشه درخواست منتظر دارد) در شبیهسازی ما این تعداد IO را در ثانیههای پیاپی میگیرد: ۳۰۰، ۳۰۰، ۲۹۵، ۱۰۰، ۱۰۰. remain در هر tick خالص ۱۰ واحد کم میشود و بعد از حدود ۶۰ tick (سه ثانیه) تمام میشود. سپس نرخ به میانگین برمیگردد. برای کلاینتی که سه ثانیه بیکار بوده، available تا سقف ۳۰۰ پر شده است و ثانیهی نخست فعالیت ۵۸۵ IO میگیرد: ۳۰۰ از ذخیره و ۱۵ در هر یک از ۱۹ tick بعدی. توجه کنید که burst_seconds = ۲ به معنای «دقیقاً دو ثانیه burst» نیست. چون سطل در حین burst هم پر میشود، طول burst کمی بیشتر است.
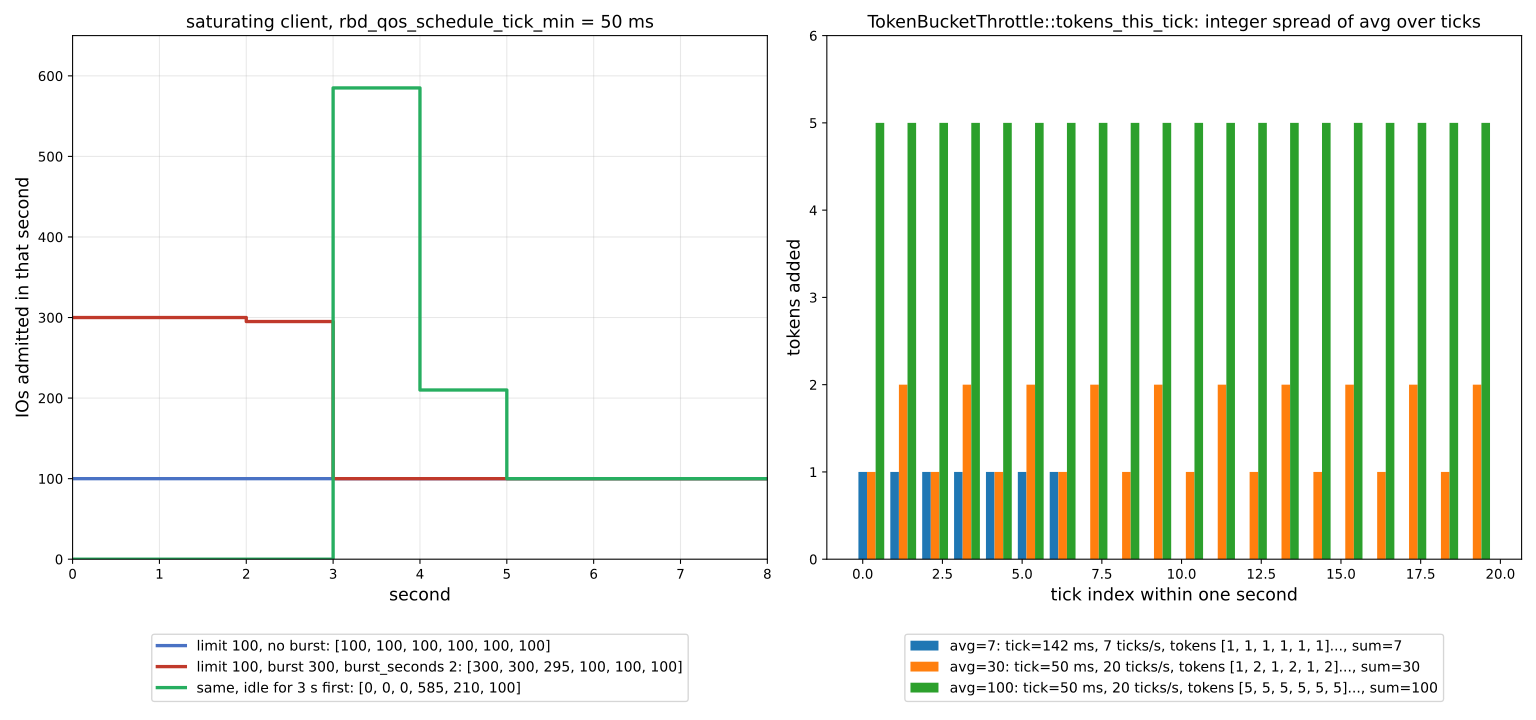
در OpenStack دو راه برای محدود کردن IO یک volume وجود دارد. QoS «front-end» در Cinder محدودیت را به libvirt میدهد (<iotune>) و QEMU آن را پیش از librbd اعمال میکند. QoS سمت librbd با گزینههای rbd_qos_* روی image یا pool تنظیم میشود (rbd config image set vol rbd_qos_iops_limit 300) و درون فرایند QEMU و در لایهی QosImageDispatch اجرا میشود. اولی را Cinder مدیریت میکند و با migrate کردن VM همراه آن میرود. دومی در فرادادهی خود image ذخیره میشود و برای هر کلاینتی که image را باز کند (حتی rbd bench) اعمال میشود. هر دو کلاینتمحور هستند و از OSDها محافظت سراسری نمیکنند. برای آن کار، mClock در OSD (فصل ۲۱) لازم است.
۳-۱۱ آزمایش سرتاسری#
۳-۱۱-۱ بوت یک ماشین از volume#
openstack volume create --image ubuntu-24.04 --size 20 --type fast vol-web01
openstack volume show vol-web01 -c status
rbd -p volumes ls -l --id cinder
rbd info volumes/volume-<uuid> --id cinder | grep parent
openstack server create --flavor m1.small --network private \
  --volume vol-web01 web01
openstack server show web01 -c status
اگر copy-on-write درست کار کند، ساختن volume بیستگیگابایتی چند ثانیه طول میکشد و خروجی rbd info یک parent در pool images نشان میدهد.
۳-۱۱-۲ اتصال volume اضافه#
openstack volume create --size 50 data01
openstack server add volume web01 data01
# داخل VM
lsblk
۳-۱۱-۳ بررسی از سمت compute#
sudo virsh list
sudo virsh dumpxml instance-0000000a | grep -A6 "protocol='rbd'"
در خروجی باید یک <source protocol='rbd' name='volumes/volume-...'> با فهرست MONها و یک <auth username='cinder'> با ارجاع به secret ببینید.
چند مشکل رایج و نشانههایشان:
ساخت volume کند است و فضای compute پر میشود: image در قالب qcow2 است یا show_image_direct_url خاموش است؛ CoW کار نمیکند و Cinder image را دانلود میکند.
VM بوت نمیشود و در لاگ libvirt خطای error connecting: Permission denied هست: UUID secret با rbd_secret_uuid یکی نیست، یا کلید داخل secret قدیمی است.
attach کار میکند اما live migration شکست میخورد: secret روی compute مقصد تعریف نشده یا UUID متفاوت است.
حذف volume با خطای «has dependent snapshots» یا «image has children» متوقف میشود: volume از snapshot یا image والد clone شده و زنجیره باید ابتدا flatten یا پاک شود. rbd children را ببینید.
ظرفیت گزارششده در Cinder با ceph df نمیخواند: Cinder ظرفیت را از MAX AVAIL و سهم pool محاسبه میکند و با thin provisioning و نسبت max_over_subscription_ratio تنظیم میشود.
۳-۱۲ فراتر از بلوک: Manila و API شیء#
۳-۱۲-۱ Manila با CephFS#
Manila سرویس اشتراک فایل OpenStack است و دو درایور برای CephFS دارد:
- CephFS بومی (native): مهمانها با کلاینت CephFS (kernel یا FUSE) مستقیم به کلاستر وصل میشوند. سریعترین مسیر، اما شبکهی Ceph باید به VMها در دسترس باشد و مهمانها باید قابلاعتماد باشند.
- CephFS از طریق NFS: Manila از طریق ماژول NFS در Ceph (NFS-Ganesha مستقرشده با cephadm) اشتراکها را صادر میکند. مهمان فقط NFS میبیند و جداسازی شبکه حفظ میشود. در نسخههای جدید Manila با ماژول
nfs در MGR کار میکند.
ceph fs volume create manila-fs
ceph auth get-or-create client.manila mon 'allow r' mgr 'allow rw'
مجوز mgr 'allow rw' برای Manila کافی است، چون Manila از طریق رابط volumes در MGR (ceph fs subvolume ...) subvolumeها و کاربرانشان را میسازد (فصل ۶).
۳-۱۲-۲ Swift و S3#
بسیاری از ابرهای OpenStack بهجای Swift از RGW استفاده میکنند و آن را در Keystone بهعنوان endpoint سرویس object-store ثبت میکنند. RGW هم API سازگار با Swift و هم S3 را ارائه میدهد و میتواند توکنهای Keystone را بپذیرد. جزئیات این یکپارچهسازی در فصل ۴ آمده است.
۳-۱۳ نکتههای production#
۳-۱۳-۱ کارایی#
- شبکهی ذخیرهسازی جداگانه برای computeها: ترافیک librbd را از ترافیک tenant جدا کنید. پهنای باند هر compute باید با تعداد VMها و نیازشان متناسب باشد.
- librbd cache و readahead: با
disk_cachemodes=network=writeback cache فعال میشود. برای بارهای ترتیبی، readahead کلاینت (rbd_readahead_*) هم اثر دارد. - QoS: Cinder میتواند QoS front-end (اعمال در QEMU) تعریف کند:
openstack volume qos create --consumer front-end --property total_iops_sec=3000 iops3k. این روش با هر backendی کار میکند و از librbd QoS برای ابر چندمستاجری قابلکنترلتر است. - توزیع pool روی device class: volumeهای پایگاه داده روی NVMe، آرشیو روی HDD.
۳-۱۳-۲ عملیات#
- ارتقای Ceph و OpenStack را جدا انجام دهید. کلاینتهای librbd روی computeها را به نسخهی سازگار برسانید. کلاینتهای جدیدتر با کلاستر قدیمیتر و برعکس در بازهی چند نسخه کار میکنند، اما پیش از روشن کردن ویژگیهای جدید (مثل
require-min-compat-client) ceph features را بررسی کنید. - پاکسازی snapshotهای یتیم: حذف ناقص در OpenStack گاهی imageها یا snapshotهایی در Ceph باقی میگذارد. دورهای فهرست imageهای pool را با فهرست volumeها و instanceهای OpenStack مقایسه کنید.
- rbd-mirror برای DR: volumeهای حساس را با mirroring حالت snapshot به سایت دوم بفرستید. Cinder از نسخههای Queens به بعد از replication در درایور RBD (
replication_device) و failover در سطح backend پشتیبانی میکند.
در بسیاری از ابرهای واقعی، دیسک compute که اشتباهاً images_type=rbd نداشته، باعث شده بخشی از VMها روی دیسک محلی باشند. وقتی آن compute خراب میشود، این VMها با دادهشان از دست میروند و evacuate کار نمیکند. پیکربندی همهی computeها را با ابزار مدیریت پیکربندی یکسان نگه دارید و با openstack server show (فیلد OS-EXT-SRV-ATTR) و بررسی XML دامنه، صحتش را آزمون کنید.
۳-۱۳-۳ امنیت#
- هر سرویس کاربر Ceph خودش را با کمترین مجوز دارد؛
client.admin هرگز روی گرههای OpenStack قرار نمیگیرد. - اگر از رمزنگاری volume در Cinder (با Barbican و LUKS) استفاده میکنید، رمزنگاری در سمت compute (dm-crypt یا LUKS در librbd در نسخههای جدید) انجام میشود و Ceph دادهی رمزشده میبیند.
- msgr2 با حالت
secure (ms_client_mode = secure) ترافیک بین compute و Ceph را رمزنگاری میکند؛ هزینهی CPU دارد، پس پیش از فعال کردن آن را بسنجید.
۳-۱۴ تکمیلی و بهروز#
- Ceph CSI و Kubernetes: امروز بسیاری از ابرهای مبتنی بر OpenStack، Kubernetes را هم روی همان Ceph سرویس میدهند. Ceph CSI (درایور RBD و CephFS) همان الگوی کاربر اختصاصی و pool جداگانه را دنبال میکند.
- Glance با چند store: Glance از چند backend همزمان پشتیبانی میکند (
enabled_backends)، مثلاً یک کلاستر Ceph در هر منطقهی دسترسپذیری، و میتواند image را بین storeها کپی کند (copy-image). این قابلیت برای ابرهای چندسایتی که هر سایت Ceph مستقل دارد، اهمیت دارد. - دروازهی NVMe-oF: برای محیطهای مختلط که کنار OpenStack، VMware هم دارند، دروازهی NVMe-oF راه ارائهی RBD به ESXi است.
- ابزار استقرار: Packstack و TripleO کنار گذاشته شدهاند؛ Kolla-Ansible و OpenStack-Ansible رایجترین گزینههای متنباز امروزند.
۳-۱۵ جمعبندی و مرور#
۳-۱۵-۱ خلاصهی فصل#
- Ceph همهی نیازهای ذخیرهسازی OpenStack را از یک کلاستر تأمین میکند: Glance، Cinder، Backup، Nova، Manila و Swift/S3.
- هر سرویس pool و کاربر Ceph خودش را دارد؛
client.cinder روی images فقط خواندنی است. - copy-on-write سرتاسری نیازمند image با قالب raw و
show_image_direct_url = True است. - QEMU کلید Ceph را از secret در libvirt میگیرد و UUID آن باید روی همهی computeها یکسان و برابر
rbd_secret_uuid باشد. -
images_type = rbd دیسکهای موقت را هم به Ceph میبرد و live migration و evacuate را ساده میکند. - Ceph را خارج از OpenStack و با cephadm مدیریت کنید؛ OpenStack فقط کلاینت باشد.
۳-۱۵-۲ اشتباهات رایج#
- آپلود imageها با قالب qcow2 و از دست دادن CoW.
- UUID متفاوت secret روی computeها و شکست live migration.
- استفاده از یک کاربر Ceph با مجوز گسترده برای همهی سرویسها.
- نگه داشتن backup روی همان کلاستر.
- computeهایی که بیسروصدا هنوز دیسک محلی دارند.
۳-۱۵-۳ تمرین عملی#
- ۱. چهار pool و سه کاربر این فصل را بسازید و با
ceph auth get مجوزها را بررسی کنید. نشان دهید client.cinder نمیتواند در pool images بنویسد (rbd --id cinder create images/test --size 1G). - ۲. با DevStack یا Kolla-Ansible یک OpenStack تکنودی بسازید و Glance، Cinder و Nova را به Ceph وصل کنید.
- ۳. یک image را یکبار با قالب qcow2 و یکبار raw آپلود کنید و زمان ساخت volume بیستگیگابایتی از هر کدام را مقایسه کنید.
- ۴. یک volume type برای NVMe و یکی برای HDD بسازید و با
rbd ls نشان دهید volumeها در pool درست ساخته میشوند. - ۵. admin socket کلاینت QEMU را فعال کنید و با
perf dump تأخیر خواندن و نوشتن یک VM را ببینید.
۳-۱۵-۴ پرسشهای مرور#
- ۱. سه دلیل اصلی که Ceph را به پشتوانهی محبوب OpenStack تبدیل کرده کداماند؟
- ۲. چرا
client.cinder روی pool images فقط مجوز خواندن دارد؟ - ۳. چه دو شرطی برای copy-on-write بین Glance و Cinder لازم است؟
- ۴. secret در libvirt چه نقشی دارد و چرا UUID آن باید روی همهی computeها یکسان باشد؟
- ۵. گزینهی
images_type = rbd در Nova چه چیزی را عوض میکند و چه مزیتی برای evacuate دارد؟ - ۶.
rbd_flatten_volume_from_snapshot و rbd_max_clone_depth چه مصالحهای را کنترل میکنند؟ - ۷. چرا backup روی همان کلاستر Ceph کافی نیست؟
- ۸. دو درایور Manila برای CephFS چه تفاوتی دارند؟
- ۹.
disk_cachemodes = "network=writeback" چرا امن است؟ - ۱۰. چرا بهتر است Ceph را مستقل از ابزار استقرار OpenStack مدیریت کنیم؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳-۱۵-۵ منابع این فصل#
- مستندات Ceph — Block Devices and OpenStack
https://docs.ceph.com/en/latest/rbd/rbd-openstack/ - مستندات Ceph — مرجع پیکربندی librbd
https://docs.ceph.com/en/latest/rbd/rbd-config-ref/ - مستندات Ceph — مدیریت کاربران
https://docs.ceph.com/en/latest/rados/operations/user-management/ - مستندات Cinder — درایور Ceph RBD
https://docs.openstack.org/cinder/latest/configuration/block-storage/drivers/ceph-rbd-volume-driver.html - مستندات Glance — پیکربندی backendها
https://docs.openstack.org/glance/latest/configuration/configuring.html - مستندات Manila — درایور CephFS
https://docs.openstack.org/manila/latest/configuration/shared-file-systems/drivers/cephfs_driver.html - مستندات Kolla-Ansible — یکپارچهسازی Ceph خارجی
https://docs.openstack.org/kolla-ansible/latest/reference/storage/external-ceph-guide.html - مستندات libvirt — secretها
https://libvirt.org/formatsecret.html