معماری کد Ceph و مسیر درخواستها از درون
حوصله ندارم این فصل در چند خط
- مخزن ceph/ceph یک monorepo بزرگ C++ با بخشهای پایتونی و submoduleهاست؛ با
do_cmake.sh، CMake و Ninja ساخته و با vstart آزموده میشود. - OSD فقط از راه
ObjectStore::Transaction با ذخیرهساز حرف میزند و BlueStore یکی از پیادهسازیهای آن است. - هیچ کار مسدودکنندهای نباید در thread پیامرسان یا هنگام نگه داشتن قفل PG انجام شود؛ ساختارها برای سازگاری با encode/decode نسخهگذاری میشوند.
- فصل یک نوشتن RADOS و یک PUT در RGW را تابعبهتابع دنبال میکند و مسیر نوشتن را با OpTracker زمانسنجی میکند.
۲۲-۱ نقشهی مخزن#
مخزن github.com/ceph/ceph یک monorepo بزرگ C++ با بخشهای پایتون است. در شاخهی main، پوشهی src/ علاوه بر کد خود Ceph، چندین زیرماژول و کتابخانهی خارجی هم دارد (rocksdb، seastar، spdk، isa-l، fmt، googletest، s3select، arrow، zstd و...). شناختن این مرز اولین قدم برای خواندن کد است: هرچه داخل این زیرماژولها است، کد Ceph نیست.
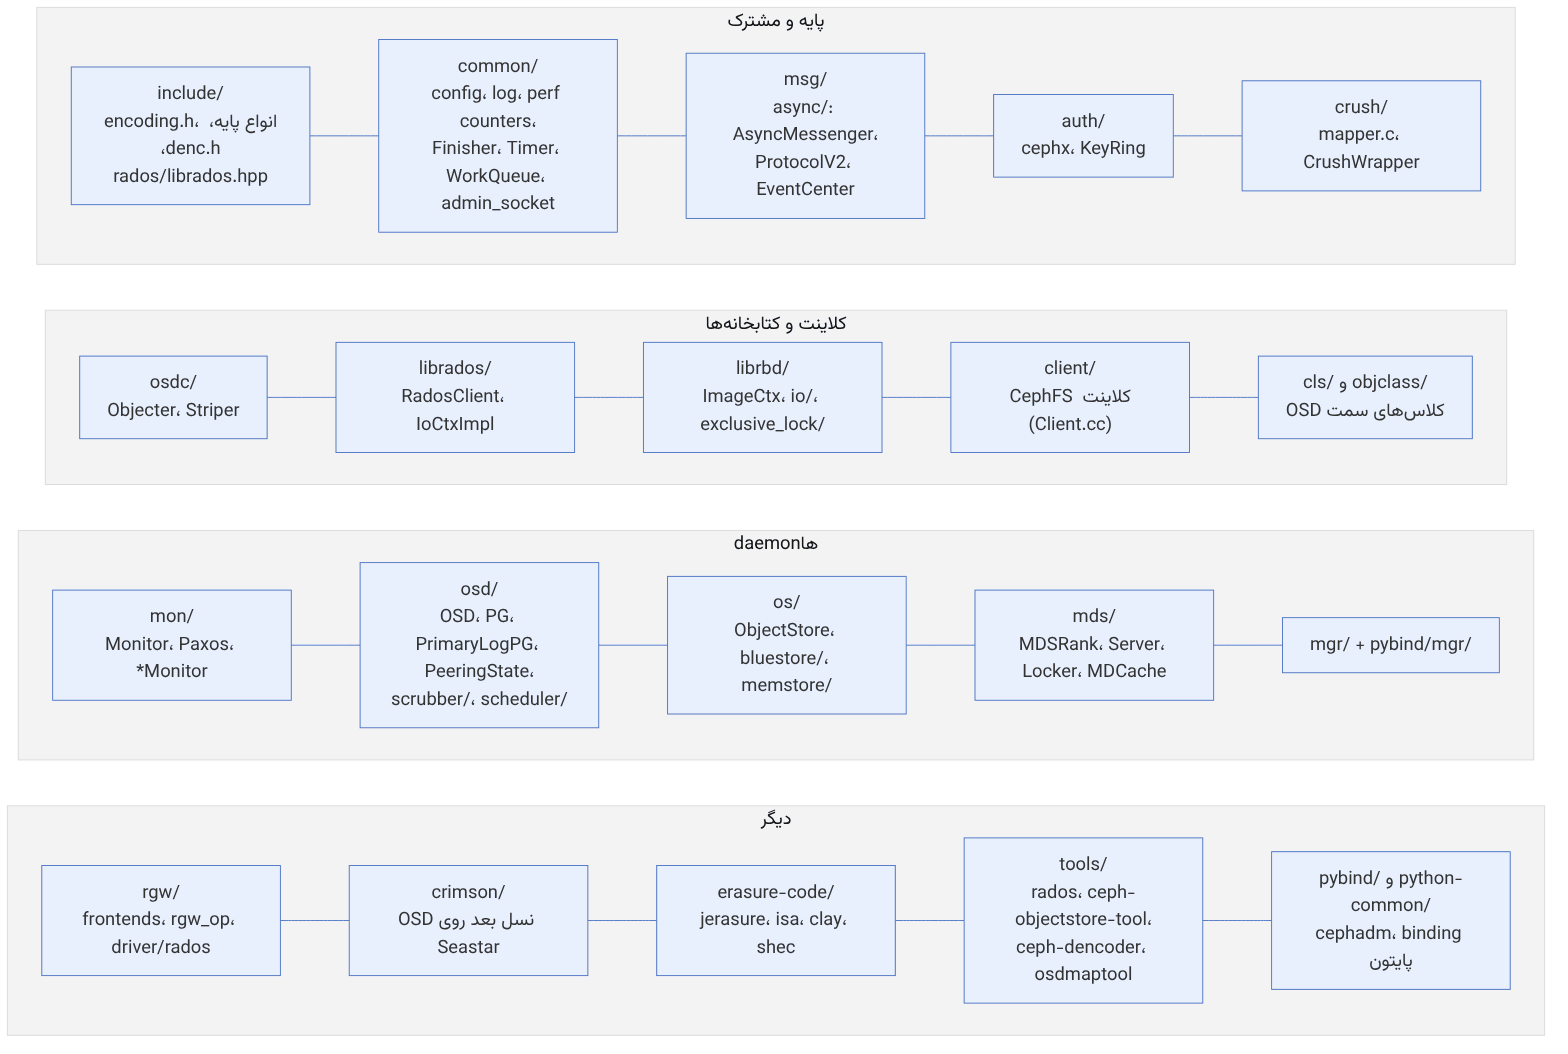
| پوشه | نقطهی شروع خواندن | چرا |
|---|---|---|
src/osd/ | OSD.cc (dispatch و شاردها)، PrimaryLogPG.cc (اجرای op)، PeeringState.cc | مسیر داده و همگرایی PG |
src/os/bluestore/ | BlueStore.cc (queue_transactions، _do_write)، bluestore_types.h | قالب روی دیسک |
src/osdc/ | Objecter.cc (op_submit، _calc_target) | مسیر کلاینت و retry |
src/mon/ | Monitor.cc، Paxos.cc، PaxosService.cc، OSDMonitor.cc | نقشهها و اجماع |
src/msg/async/ | AsyncMessenger.cc، AsyncConnection.cc، ProtocolV2.cc، Event.h | شبکه و msgr2 |
src/common/options/ | global.yaml.in، osd.yaml.in، rgw.yaml.in، mds.yaml.in، rbd.yaml.in | منبع معتبر پیشفرضها |
src/crimson/ | osd/osd.cc | بازنویسی OSD بر پایهی Seastar (shared-nothing، هر هسته یک reactor) |
برای پیدا کردن پیشفرض واقعی هر گزینه، بهجای جستوجوی وبلاگها مستقیم سراغ فایل src/common/options/*.yaml.in در tag همان نسخه بروید (مثلاً v20.2.0). همهی جدولهای پیشفرض این کتاب از همین فایلها استخراج شدهاند.
۲۲-۲ ساخت و محیط توسعه#
ساخت با CMake و Ninja انجام میشود. اسکریپت do_cmake.sh در ریشهی مخزن پوشهی build را میسازد (نام آن با متغیر BUILD_DIR قابل تغییر است) و CMake را با -GNinja اجرا میکند. پرچمهای اضافه را میتوان با متغیر ARGS پاس داد. target به نام vstart در src/CMakeLists.txt فقط چیزهایی را میسازد که برای یک کلاستر توسعهی محلی لازم است.
git clone https://github.com/ceph/ceph.git && cd ceph
git submodule update --init --recursive
./install-deps.sh
ARGS="-DCMAKE_BUILD_TYPE=Debug -DWITH_MGR_DASHBOARD_FRONTEND=OFF" ./do_cmake.sh
cd build && ninja vstart            # فقط اجزای لازم برای vstart
# کلاستر محلی: 1 MON، 3 OSD، بدون MDS
MON=1 OSD=3 MDS=0 MGR=1 ../src/vstart.sh -n -d -x --bluestore
./bin/ceph -s
../src/stop.shگزینههای vstart.sh در متن راهنمای خود اسکریپت: -n (کلاستر جدید)، -d (debug)، -x/-X (فعال/غیرفعال کردن cephx)، -l (localhost) و -b (BlueStore که پیشفرض است). تعداد daemonها با متغیرهای محیطی MON، OSD، MDS، MGR، RGW و... تعیین میشود.
ساخت کامل Ceph به دهها گیگابایت فضا و حافظهی زیاد نیاز دارد. برای خواندن کد کافی است مخزن را با --filter=blob:none و sparse-checkout فقط برای پوشههای موردنیاز بگیرید. نویسندهی این راهنما هم برای تطبیق نامها از همین روش استفاده کرده است.
۲۲-۳ کلاسها و روابط اصلی#
۲۲-۳-۱ رابط ObjectStore#
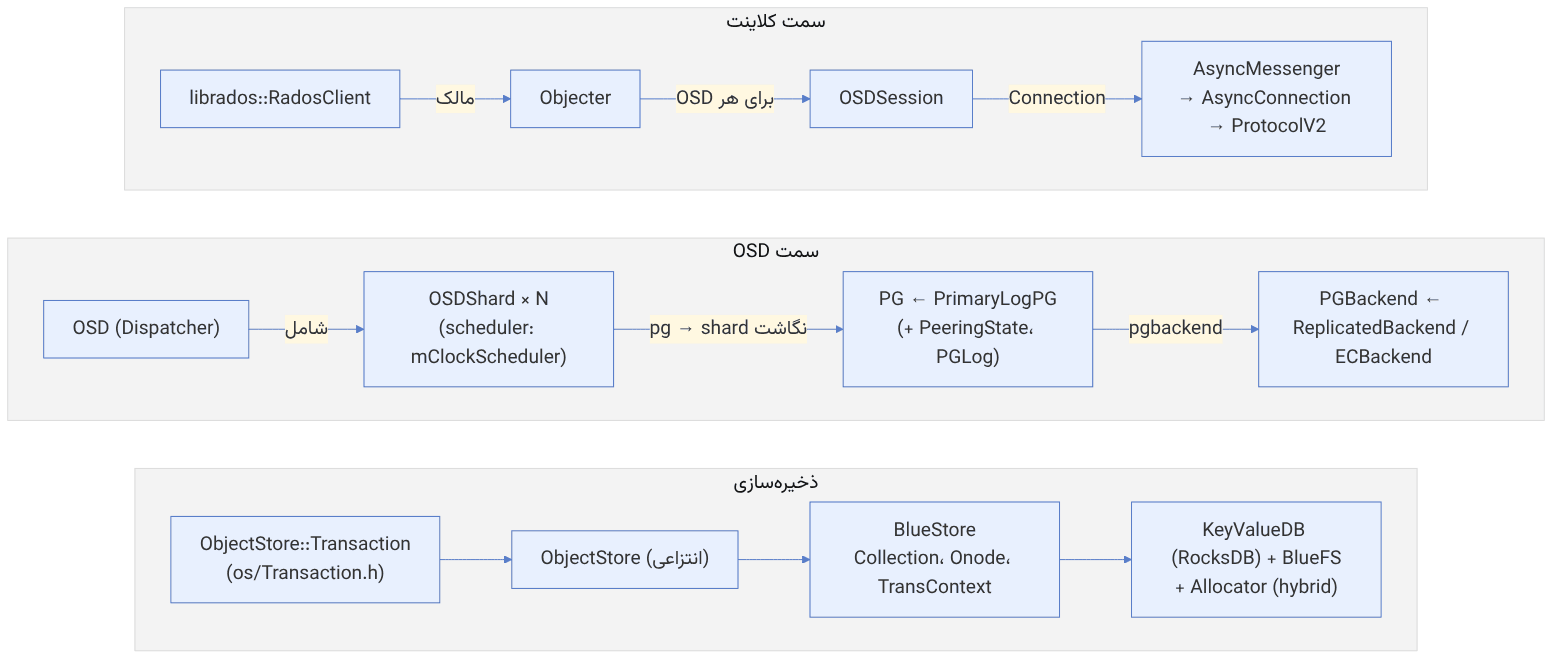
src/os/ObjectStore.h مرز بین منطق PG و ذخیرهسازی است. OSD هرگز مستقیم به دیسک نمینویسد. OSD یک ObjectStore::Transaction (تعریف در src/os/Transaction.h) میسازد که شامل فهرستی از عملیات مثل write، zero، truncate، remove، setattrs، omap_setkeys و omap_rmkeys روی collectionها است، و آن را با queue_transactions به backend میدهد. backend تضمین میکند که کل تراکنش اتمیک است. همین ویژگی دلیل این است که شیء داده و ورودی pg log همزمان پایدار میشوند. پیادهسازیهای موجود BlueStore (پیشفرض)، MemStore (آزمون) و در crimson، SeaStore و CyanStore هستند.
۲۲-۴ مدل thread#
| کلاس | فایل | نقش |
|---|---|---|
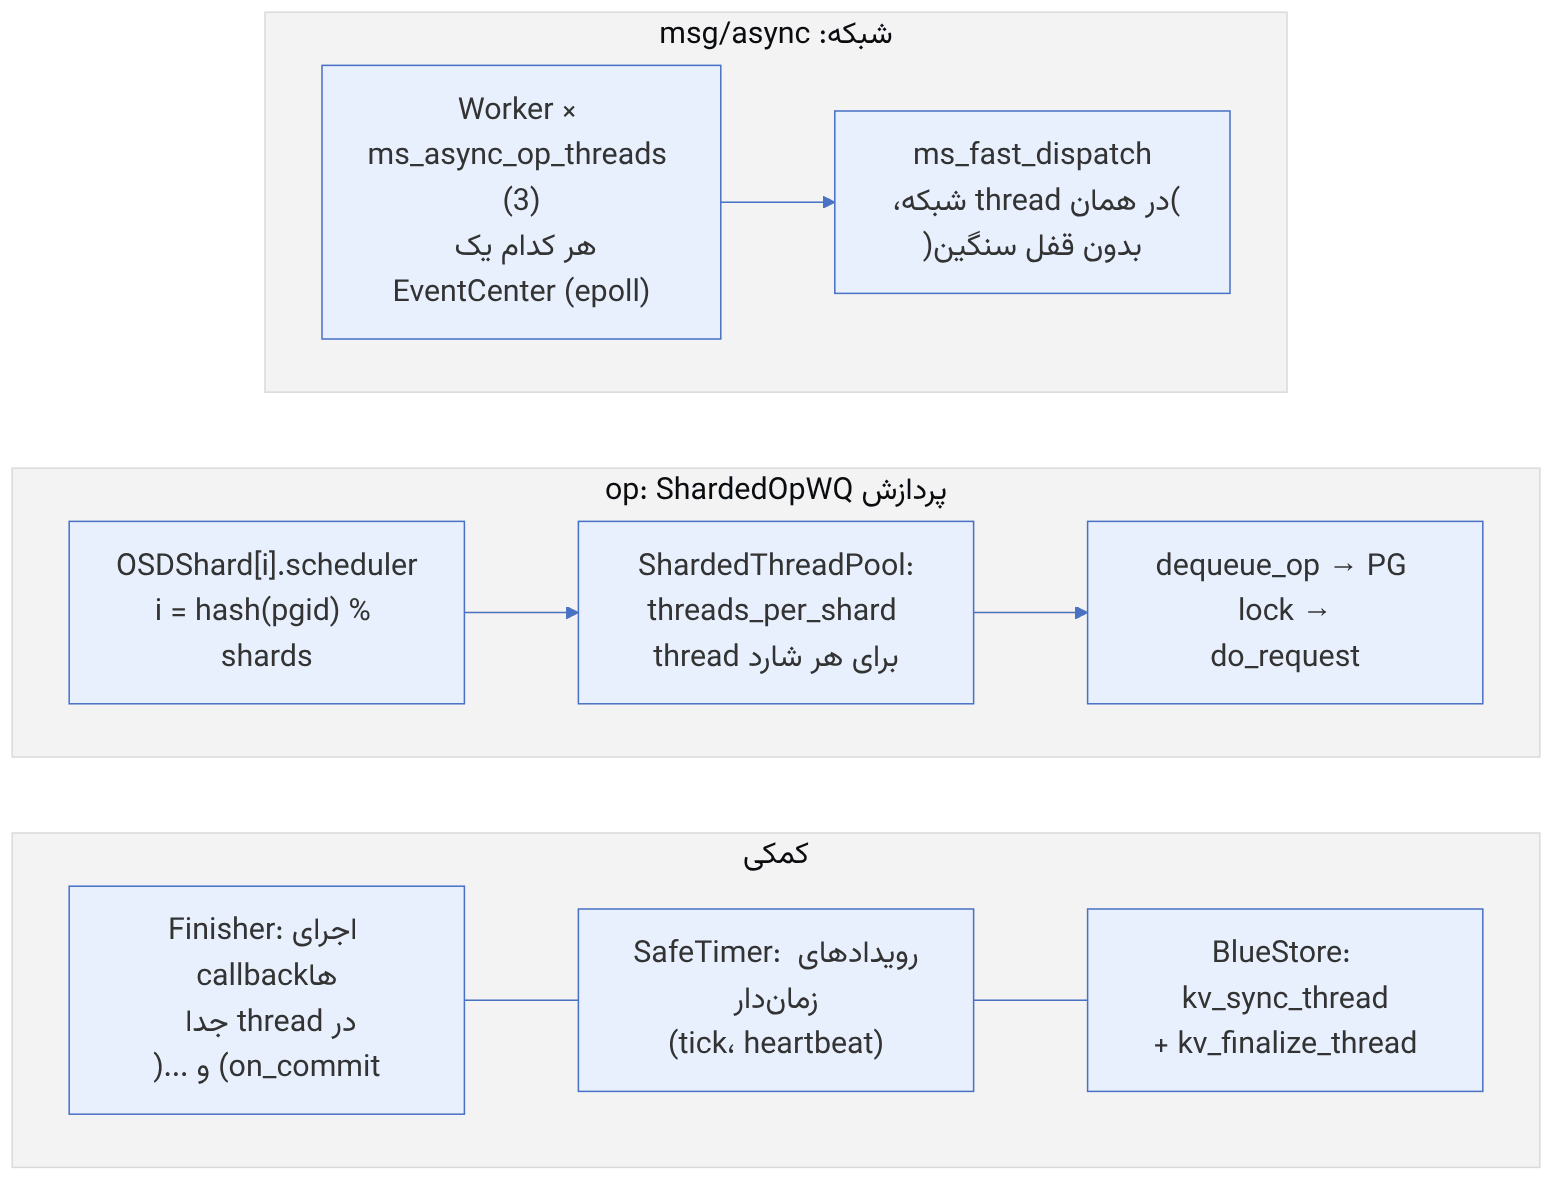
ShardedThreadPool، OSD::ShardedOpWQ | common/WorkQueue.h، osd/OSD.h | صف op شاردشده؛ ترتیب op در هر PG حفظ میشود |
OSDShard | osd/OSD.h | نگهدارندهی scheduler، PGهای شارد و قفل آن |
Finisher | common/Finisher.h | صف callback با thread اختصاصی |
SafeTimer (= CommonSafeTimer<ceph::mutex>) | common/Timer.h | زمانبندی رویداد |
Worker، NetworkStack، EventCenter | msg/async/Stack.h، msg/async/Event.h | حلقهی رویداد شبکه |
قانون طلایی در کد OSD این است که هیچ کار مسدودکنندهای (I/O همگام، قفل طولانی) نباید در thread شبکه یا هنگام نگه داشتن قفل PG انجام شود. بسیاری از «slow request»های عجیب در گذشته از نقض همین قانون بودهاند. هشدار heartbeat_map با پیام had timed out after در لاگ OSD نشانهی گیر کردن یک thread در ShardedOpWQ است.
۲۲-۵ encoding و سازگاری نسخهها#
هر ساختاری که روی شبکه یا دیسک میرود، با زیرساخت include/encoding.h یا نسخهی سریعتر آن include/denc.h سریالسازی میشود. الگوی اصلی، نسخهگذاری هر struct با دو عدد است: struct_v (نسخهی فعلی) و compat (کمترین نسخهای که decoderش میتواند این داده را بخواند). طول بلوک هم ذخیره میشود تا decoder قدیمی بتواند فیلدهای جدید انتهایی را نادیده بگیرد. ماکروها عبارتاند از ENCODE_START(v, compat, bl)، ENCODE_FINISH(bl)، DECODE_START(v, bl)، DECODE_FINISH(bl) و WRITE_CLASS_ENCODER(cl). در denc، معادلها DENC_START(v, compat, p) و WRITE_CLASS_DENC(T) هستند.
// مثال خود این راهنما (نه از کد Ceph): افزودن فیلد با حفظ سازگاری
struct demo_info_t {
uint64_t size = 0;
std::string owner; // از نسخهی 2 اضافه شد
void encode(ceph::buffer::list& bl) const {
ENCODE_START(2, 1, bl); // v=2، decoder نسخهی 1 هم میتواند بخواند
encode(size, bl);
encode(owner, bl);
ENCODE_FINISH(bl);
}
void decode(ceph::buffer::list::const_iterator& p) {
DECODE_START(2, p);
decode(size, p);
if (struct_v >= 2) decode(owner, p);
DECODE_FINISH(p); // فیلدهای ناشناختهی نسخههای بعد رد میشوند
}
};
WRITE_CLASS_ENCODER(demo_info_t)این سازوکار پایهی ارتقای غلتان است. OSD نسخهی جدید OSDMap یا MOSDOp را با فیلدهای بیشتر encode میکند و OSD قدیمی آن را با رد کردن انتهای بلوک میخواند. اگر تغییری واقعاً ناسازگار باشد، compat بالا میرود و آنگاه ارتقا به پرچمهایی مثل require_osd_release گره میخورد. ابزار ceph-dencoder در src/tools/ceph-dencoder/ همین encoderها را برای آزمون سازگاری و بازرسی دادههای واقعی در دسترس قرار میدهد.
۲۲-۶ خواندن و اشکالزدایی کد در عمل#
| ابزار | نمونه | کاربرد |
|---|---|---|
| سطح debug | ceph config set osd.3 debug_osd 20/20 | عدد اول سطح لاگ نوشتهشده و عدد دوم سطح نگهداری در حافظه برای dump هنگام crash |
| admin socket | ceph daemon osd.3 help، config show، dump_ops_in_flight | دستور مستقیم به daemon روی همان میزبان (common/admin_socket.cc) |
| OpTracker | ceph daemon osd.3 dump_historic_ops | رویدادهای زماندار هر op؛ osd_op_history_size=20 و osd_op_history_duration=600 |
| ceph-dencoder | ceph-dencoder type OSDMap import om decode dump_json | decode و نمایش ساختارهای باینری |
| ceph-objectstore-tool | --op list، --op log، dump | بازرسی آفلاین BlueStore و PG |
| gdb | gdb -p $(pidof ceph-osd) سپس thread apply all bt | تحلیل گیر کردن؛ بستههای -dbg یا debuginfod لازم است |
| tracing | jaeger_tracing_enable (پیشفرض false)، osd_blkin_trace_all | ردیابی توزیعشدهی درخواست؛ نیازمند ساخت با پشتیبانی Jaeger/OpenTelemetry |
# خواندن مسیر یک op در لاگ: tid و reqid را دنبال کنید
ceph config set osd.3 debug_osd 20 ; ceph config set osd.3 debug_bluestore 20
rados -p test put obj1 /etc/hosts
grep -E 'do_op|execute_ctx|issue_repop|_txc_state_proc' /var/log/ceph/ceph-osd.3.log | tail
ceph config rm osd.3 debug_osd ; ceph config rm osd.3 debug_bluestore
ceph-dencoder list_types | grep -i -E 'osdmap|pg_log'۲۲-۷ مسیر کامل یک نوشتن RADOS، تابع به تابع#
| گام | تابع (فایل) | چه میکند |
|---|---|---|
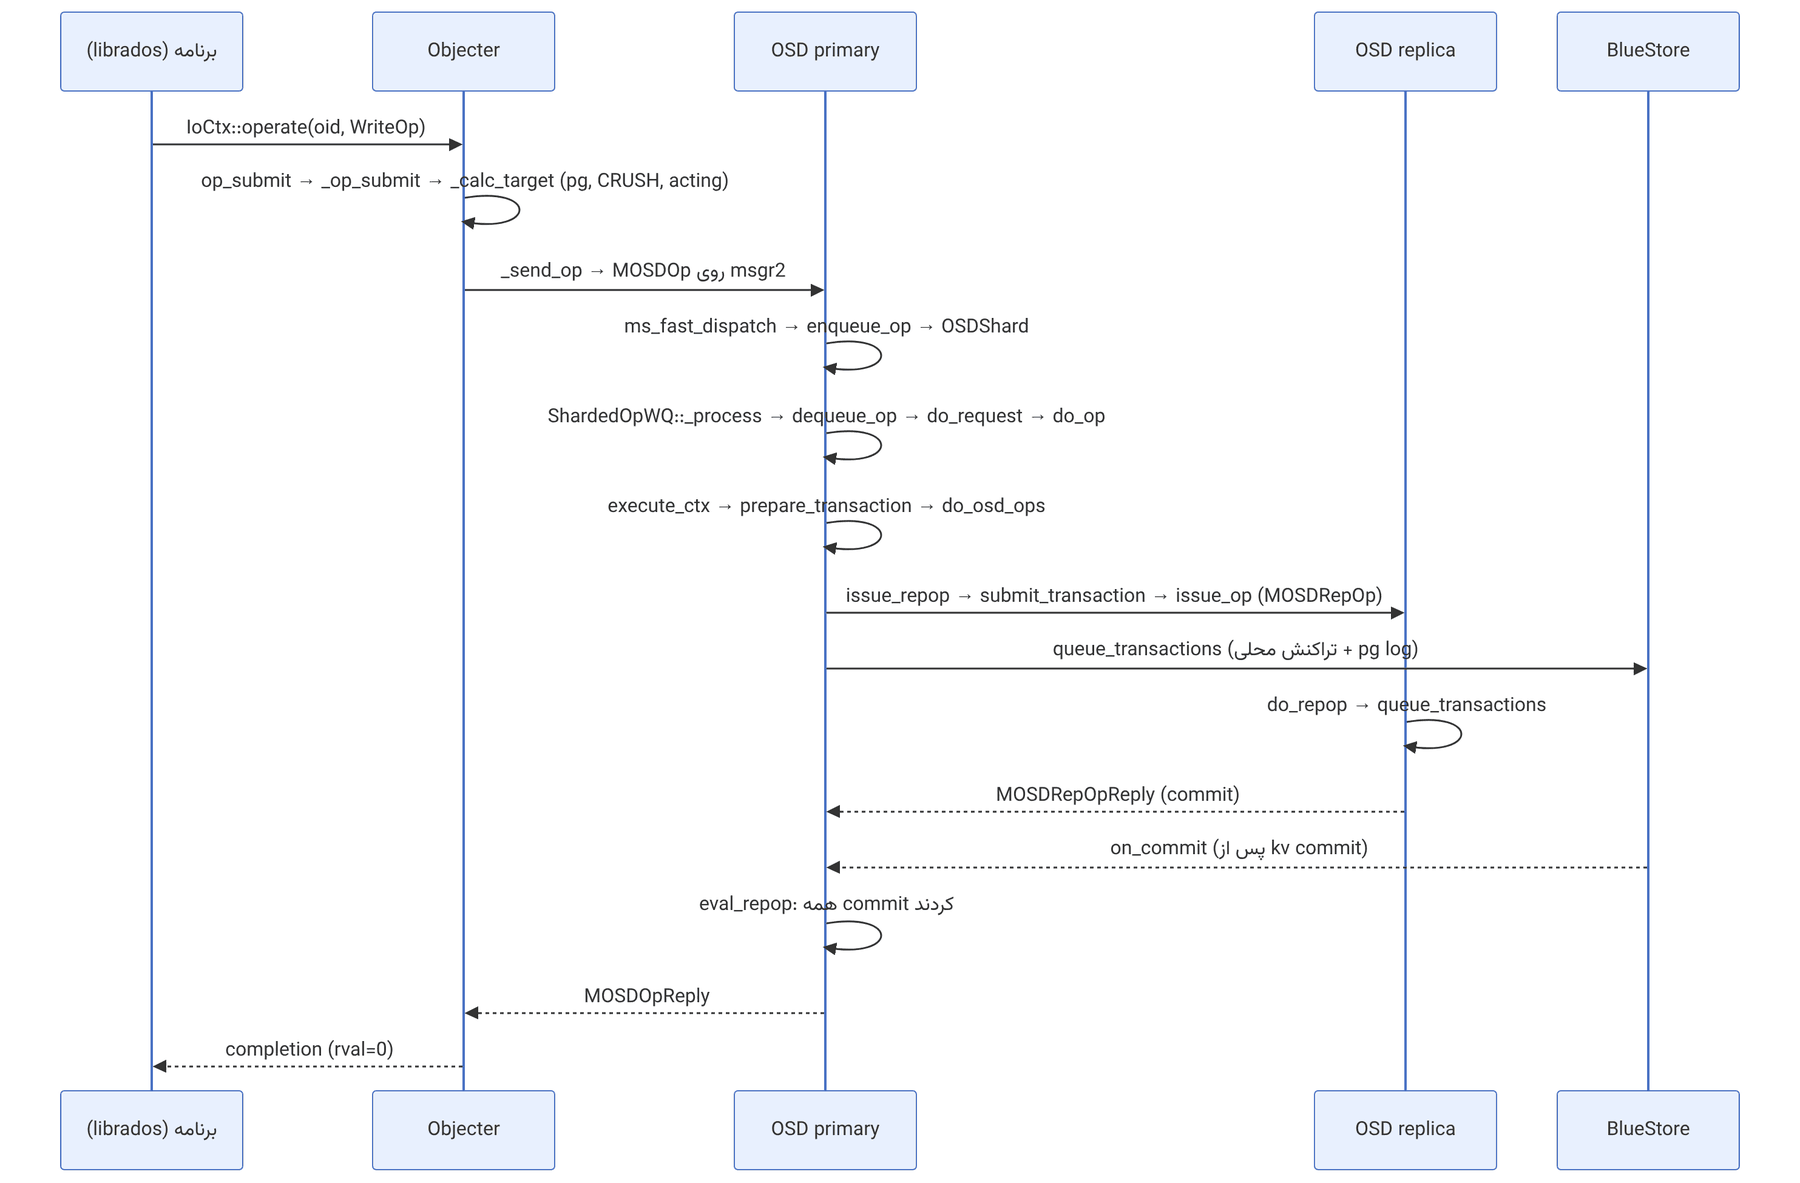
| ۱ | Objecter::op_submit → _op_submit (osdc/Objecter.cc) | بودجهی inflight (objecter_inflight_ops)، tid، انتخاب session |
| ۲ | Objecter::_calc_target | hash نام، pg، CRUSH و upmap، acting و primary؛ تشخیص نیاز به ارسال دوباره پس از تغییر نقشه |
| ۳ | Objecter::_send_op | ساخت MOSDOp با epoch نقشه؛ ارسال از طریق ProtocolV2::send_message |
| ۴ | OSD::ms_fast_dispatch (osd/OSD.cc) | تبدیل به OpRequest؛ رد op با epoch قدیمیتر؛ enqueue_op |
| ۵ | OSD::ShardedOpWQ::_process → OSD::dequeue_op | برداشتن از scheduler شارد؛ قفل PG |
| ۶ | PrimaryLogPG::do_request → do_op → do_op_impl | بررسی peering/active، cap، وجود شیء، blocklist، حالت degraded |
| ۷ | PrimaryLogPG::execute_ctx → prepare_transaction → do_osd_ops | اجرای هر OSDOp (write، omap، call کلاس cls) و ساخت Transaction و ورودی pg log |
| ۸ | PrimaryLogPG::issue_repop → ReplicatedBackend::submit_transaction → issue_op | ارسال MOSDRepOp به replicaها و queue_transactions محلی |
| ۹ | ReplicatedBackend::do_repop (روی replica) | اعمال همان تراکنش و پاسخ commit |
| ۱۰ | PrimaryLogPG::eval_repop | وقتی همه commit کردند: پاسخ MOSDOpReply |
برای EC، گام ۸ به ECBackend::submit_transaction و خط لولهی read-modify-write در ECCommon::RMWPipeline::start_rmw تبدیل میشود. در این مسیر برای نوشتن جزئی ابتدا shardهای موجود خوانده میشوند، parity محاسبه و سپس روی همهی shardها نوشته میشود.
pseudocode: do_op در primary (خلاصهی این کتاب از PrimaryLogPG.cc)
do_op(op):
if pg not active or op.epoch > osdmap: wait / requeue
if client blocklisted or cap denies: reply -EPERM/-EBLOCKLISTED
obc = get_object_context(oid) # ممکن است منتظر recovery این شیء بماند
if object degraded/missing: wait_for_degraded_object
ctx = OpContext(op, obc) ; execute_ctx(ctx)
execute_ctx(ctx):
r = prepare_transaction(ctx) # do_osd_ops: هر OSDOp → عملیات Transaction
if read-only: reply now
ctx.log += pg_log_entry_t(version = ++last_update, reqid, prior_version)
repop = new RepGather(ctx) ; issue_repop(repop, ctx)۲۲-۸ داخل BlueStore: یک TransContext#
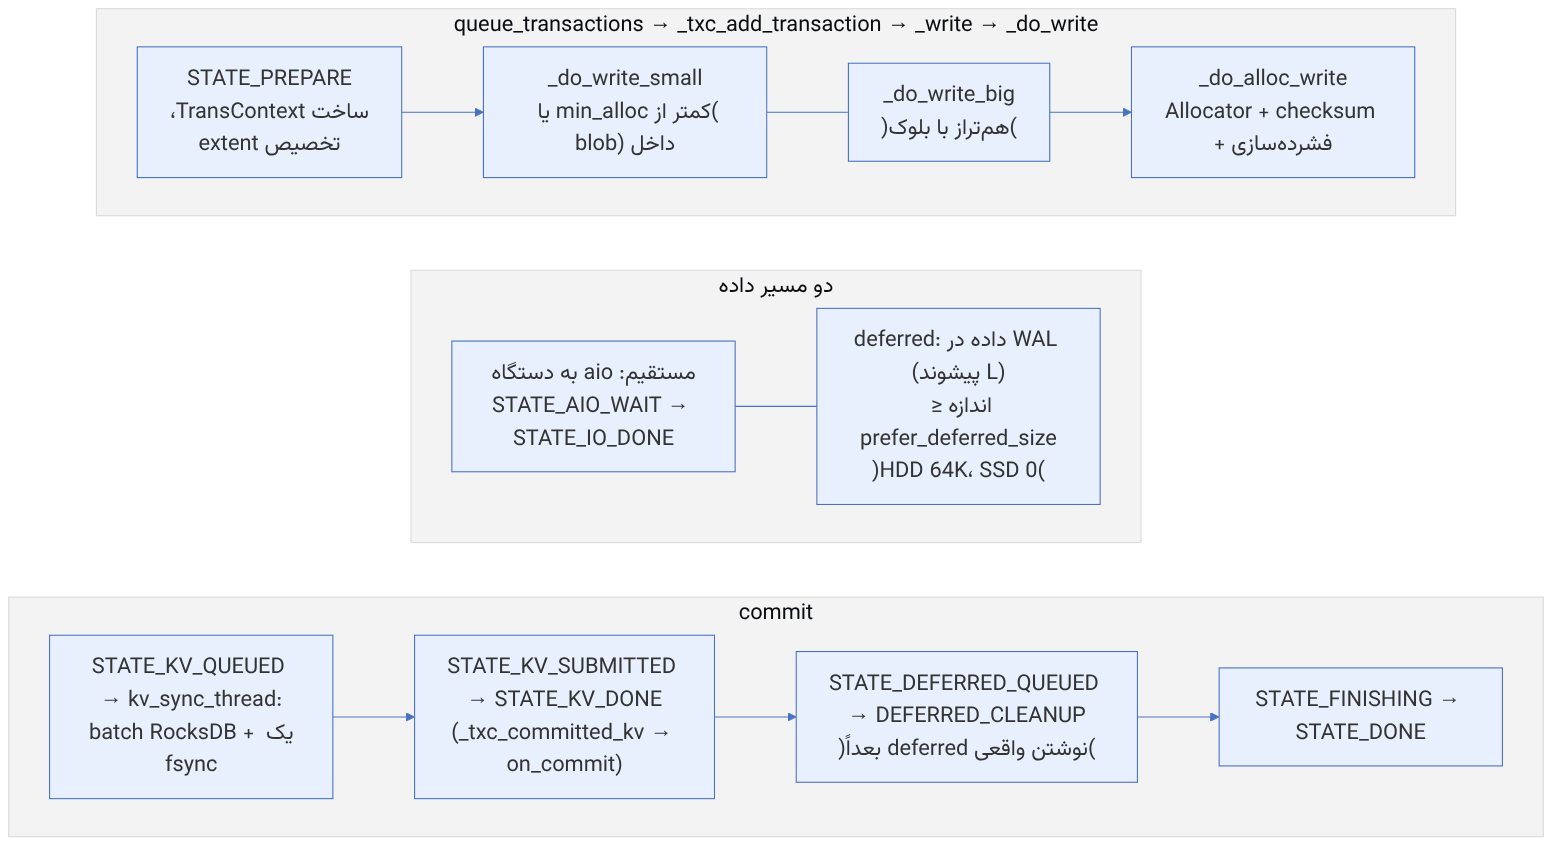
| حالت (BlueStore_components.h) | معنا |
|---|---|
| STATE_PREPARE | ساخت و تخصیص |
| STATE_AIO_WAIT / STATE_IO_DONE | انتظار برای پایان aio دادهی مستقیم |
| STATE_KV_QUEUED / STATE_KV_SUBMITTED / STATE_KV_DONE | صف، ارسال و پایداری در RocksDB |
| STATE_DEFERRED_QUEUED / STATE_DEFERRED_CLEANUP / STATE_DEFERRED_DONE | اجرای نوشتنهای deferred |
| STATE_FINISHING / STATE_DONE | آزادسازی |
چرا deferred روی HDD کمک میکند: یک نوشتن ۴K تصادفی روی HDD به یک seek کامل نیاز دارد. با deferred، داده در WAL RocksDB (که معمولاً روی NVMe است) نوشته و فوراً ack میشود، و نوشتن واقعی بعداً بهصورت دستهای انجام میشود. روی SSD این دوبار نوشتن فقط write amplification اضافه میکند و به همین دلیل پیشفرض SSD صفر است.
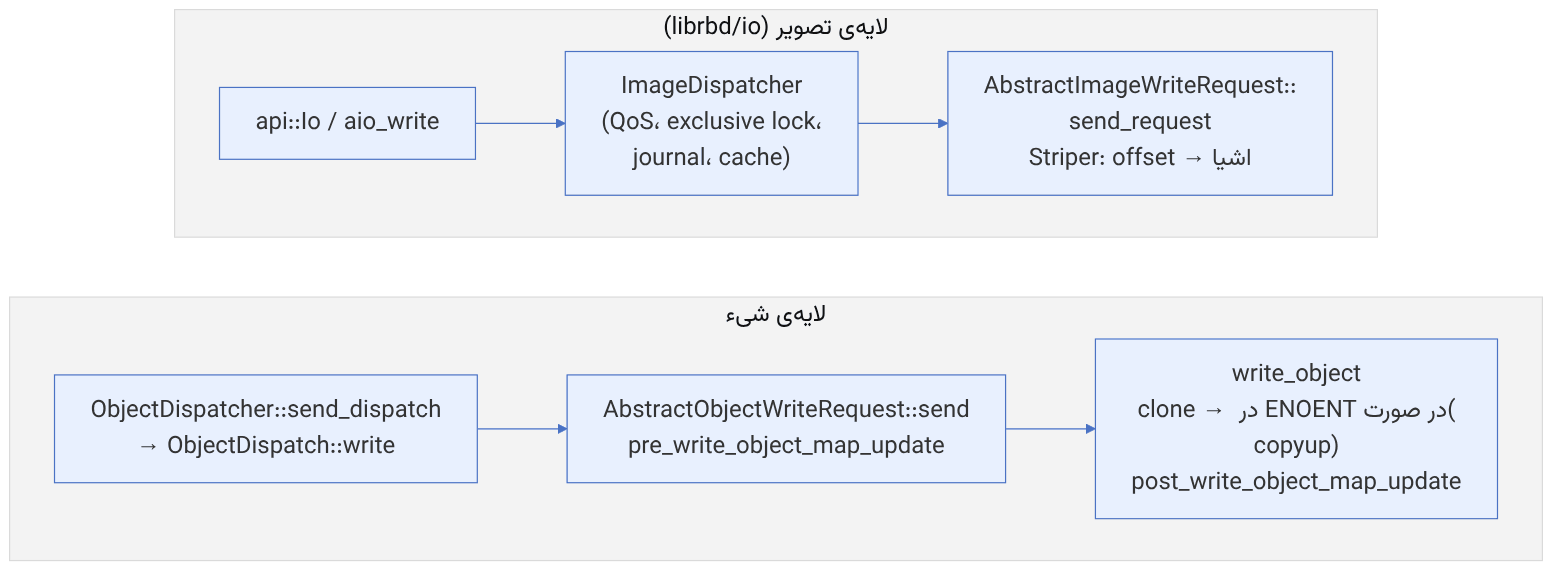
۲۲-۹ مسیر نوشتن RBD#
۲۲-۱۰ مسیر PUT در RGW#
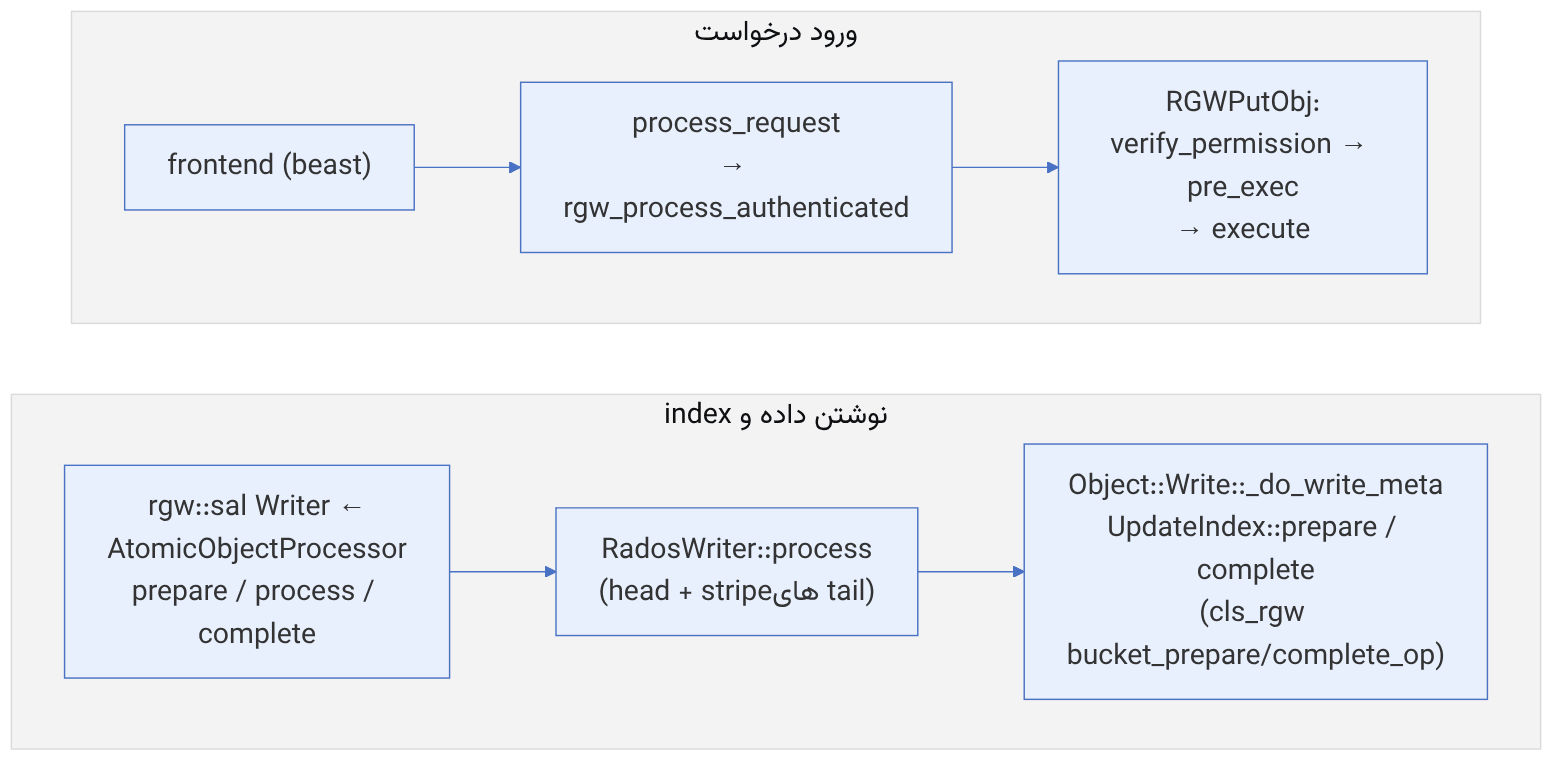
لایهی rgw::sal (Storage Abstraction Layer، در rgw_sal.h) در نسخههای اخیر RGW را از RADOS جدا کرده است تا driverهای دیگری مثل posix، dbstore یا d4n بتوانند زیر همان frontend و opها قرار بگیرند.
۲۲-۱۱ مسیر open و write در CephFS#
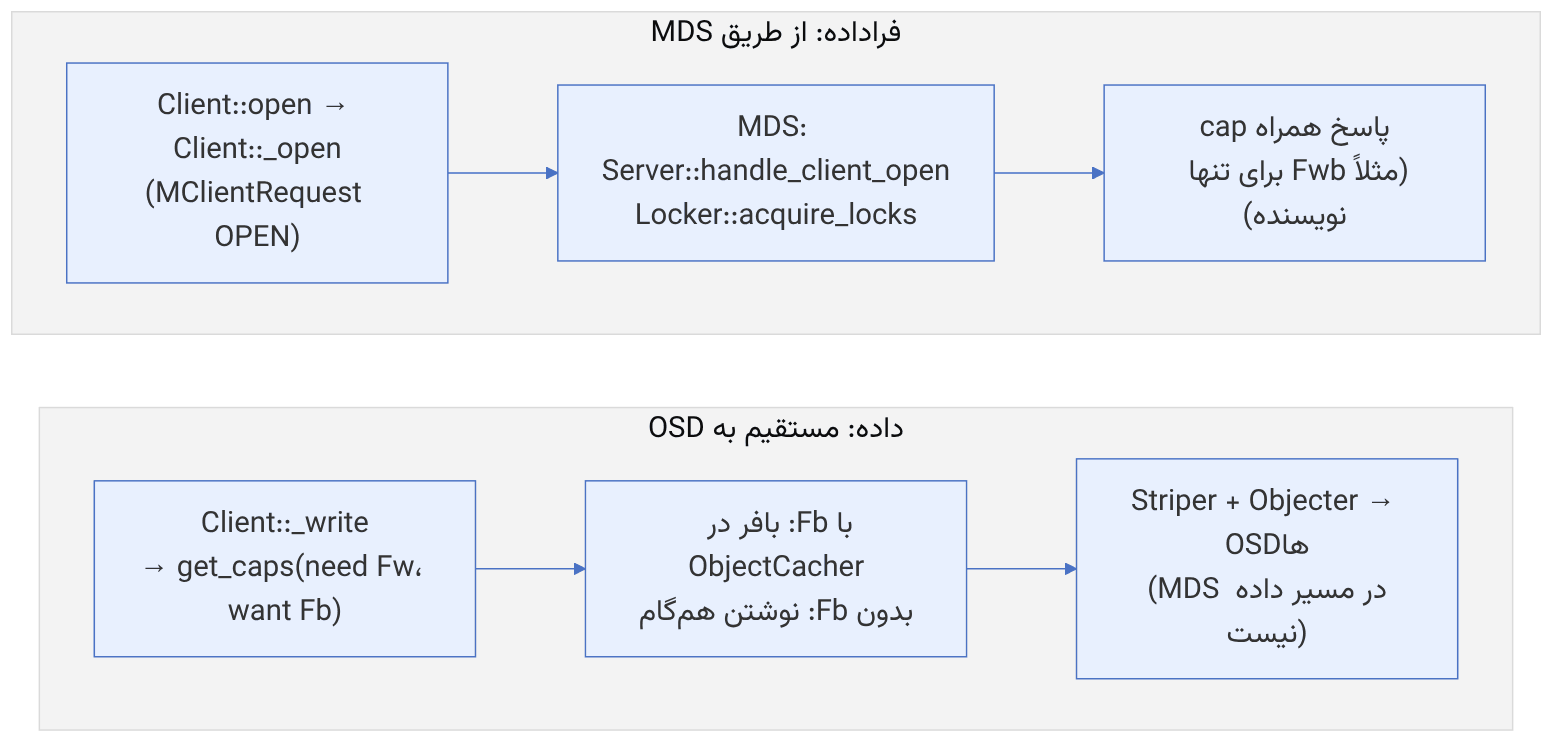
| لایه | تابع (فایل) |
|---|---|
| کلاینت | Client::_open، Client::_write، Client::get_caps، Client::handle_caps (client/Client.cc) |
| MDS | Server::handle_client_open، Server::handle_client_openc (mds/Server.cc) |
| قفل و cap | Locker::acquire_locks، Locker::handle_client_caps (mds/Locker.cc) |
۲۲-۱۲ مسیر نوشتن با زمانسنجی واقعی OpTracker#
مسیر تابعبهتابع بخش قبل را میتوان با ابزار خود OSD زمانسنجی کرد. هر OpRequest در OpTracker نقطههای زمانداری ثبت میکند. بخشی از آنها پرچمهای ثابتاند: mark_queued_for_pg، mark_reached_pg، mark_started و mark_commit_sent در src/osd/OpRequest.h. بخشی رویدادهای متنیاند: "op_commit"، "sub_op_commit_rec" و "waiting for subops from …" در src/osd/ReplicatedBackend.cc.
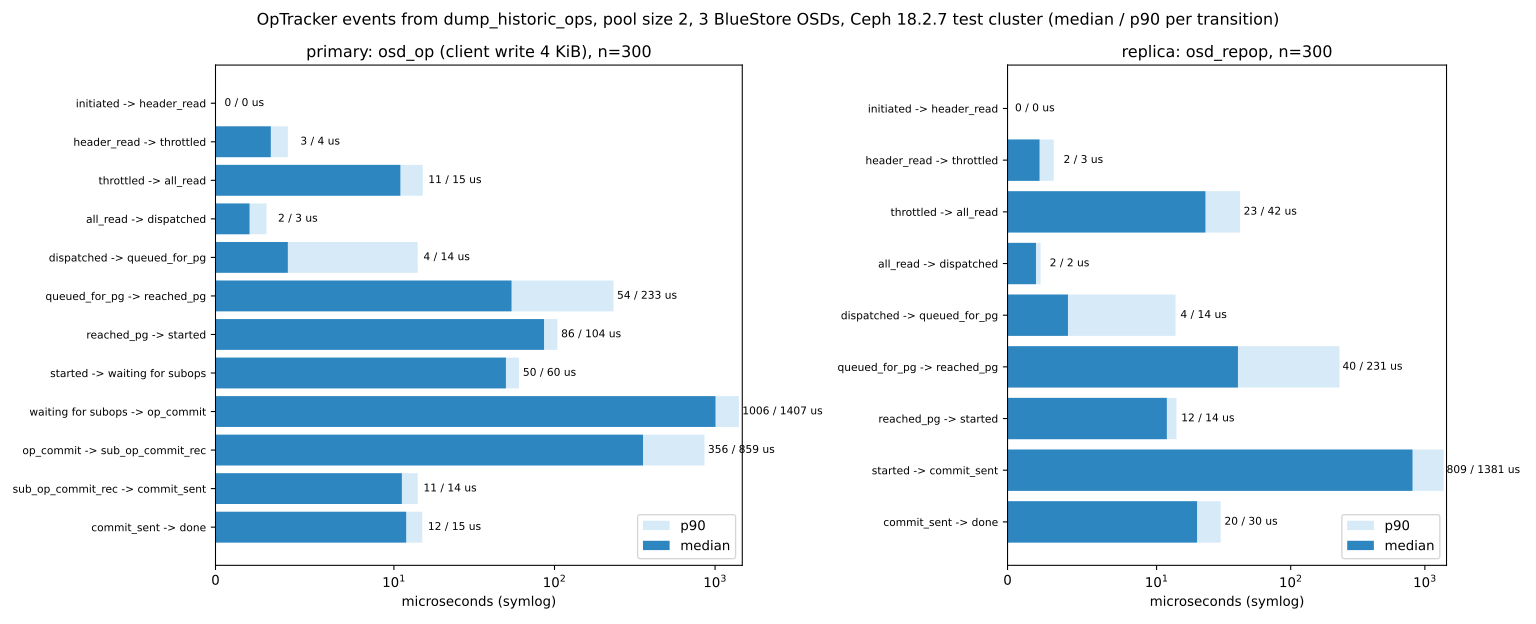
ما روی کلاستر آزمایشی سهOSDی BlueStore با Ceph 18.2.7 مقدار osd_op_history_size را ۱۰۰۰ کردیم. سپس ۳۰۰ شیء ۴ KiB را به ترتیب در pool p22 با size = ۲ نوشتیم و ceph daemon osd.N dump_historic_ops را از هر سه OSD خواندیم.
منبع در کد: TrackedOp::mark_event و OpRequest::mark_flag_point (src/common/TrackedOp.cc، src/osd/OpRequest.h)؛ ReplicatedBackend::submit_transaction و do_repop_reply
پیچیدگی: O(تعداد op × تعداد رویداد)
pseudocode
برای هر op در ops (هر سه OSD):
    اگر description با "osd_op(" شروع شود و pool = 4 ← primary ؛ اگر "osd_repop(" ← replica
    ev = [(event, time)] به ترتیب ثبت
    برای هر جفت پیاپی (a, b): stage["a → b"].append(t_b − t_a)
میانه و صدک 90 هر stage ؛ شمارش ترتیب op_commit و sub_op_commit_rec
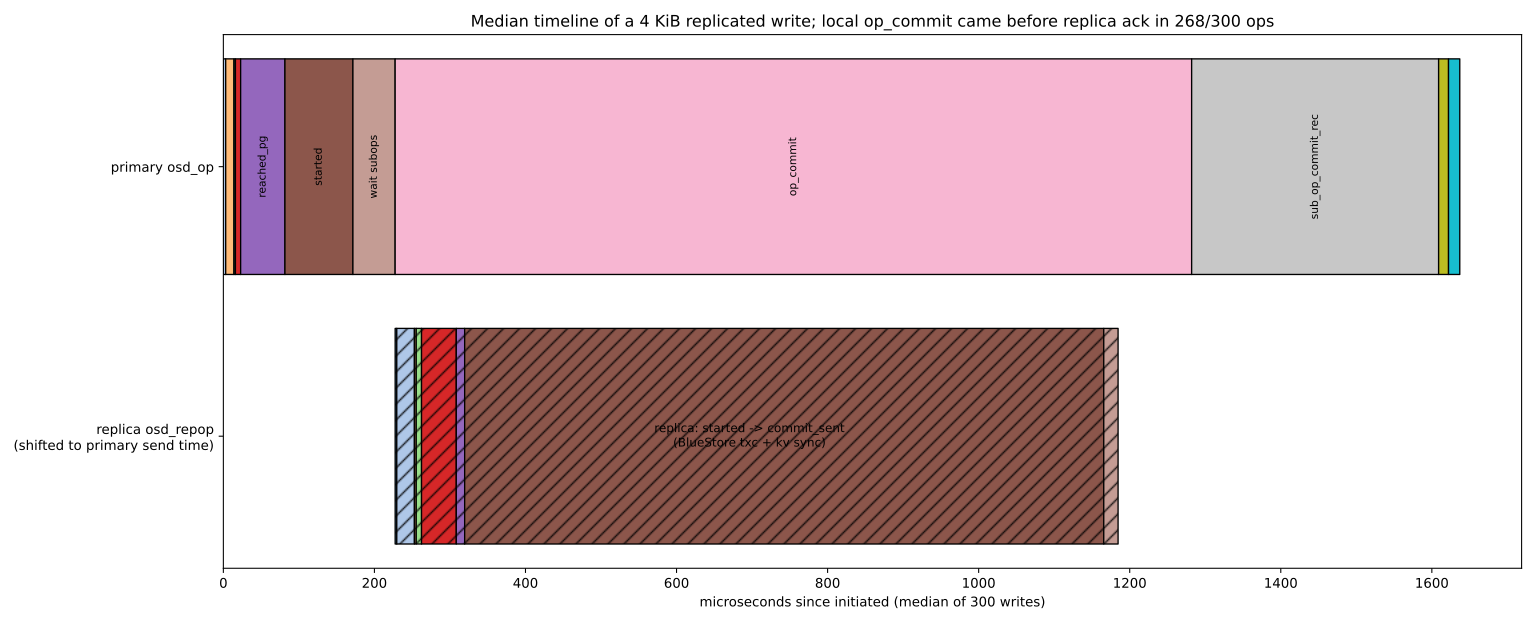
نتیجه (میانه / صدک ۹۰، میکروثانیه). کل نوشتن روی primary حدود ۱۶۳۷ میکروثانیه طول کشید. از این زمان، بیشتر در انتظار commit گذشت. در ۲۶۸ op از ۳۰۰، commit محلی (op_commit) پیش از تأیید replica رسید. فاصلهی waiting for subops تا op_commit با میانهی ۱۰۰۶ و صدک ۹۰ ۱۴۰۷ میکروثانیه بود. پس از آن، ۳۵۶ میکروثانیهی دیگر تا sub_op_commit_rec طول کشید. در ۳۲ op باقیمانده ترتیب برعکس بود.
مسیر پیش از PG ارزان است. بیشترین سهم آن صف sharded opها بود: queued_for_pg تا reached_pg با میانهی ۵۴ و صدک ۹۰ ۲۳۳. پس از آن reached_pg تا started با ۸۶ میکروثانیه میآید که زمان قفل PG و آمادهسازی op context است.
روی replica، بخش started تا commit_sent (تراکنش BlueStore و kv sync) با میانهی ۸۰۹ میکروثانیه بخش اصلی است. وقتی دو مسیر روی یک محور گذاشته شوند، replica حدود ۱۱۷۰ میکروثانیه پس از شروع کار را تمام میکند. اما primary تأیید را حدود ۱۶۰۰ میکروثانیه میبیند. این فاصلهی چندصدمیکروثانیهای هزینهی messenger بازگشت و صف شدن پاسخ است و در شبکهی واقعی بیشتر میشود.
درس عملی: در تحلیل slow op (فصل ۱۷)، ابتدا ببینید بیشترین فاصله بین کدام دو رویداد است. فاصلهی بزرگ پیش از reached_pg یعنی صف یا قفل PG. فاصلهی بزرگ بین waiting for subops و sub_op_commit_rec یعنی replica یا شبکه. فاصلهی بزرگ تا op_commit یعنی دستگاه یا BlueStore محلی.
۲۲-۱۳ تکمیلی و بهروز#
- crimson در Tentacle و Umbrella همچنان در حال بلوغ است. OSD کلاسیک (
src/osd/) و crimson (src/crimson/osd/) کد مسیر op جدا دارند ولی encoding، OSDMap و CRUSH را مشترک استفاده میکنند. پیش از استفادهی عملیاتی، یادداشتهای انتشار همان نسخه را بررسی کنید. - API ثبت متد کلاسهای cls در main به قالب typed (
ClassRegistrar) تغییر کرده است (فصل ۱۵). کد کلاسهای خارج از درخت را با tag نسخهی هدف بسازید. -
neorados (در src/neorados/) رابط C++ مدرن و ناهمگام مبتنی بر asio است و RGW و librbd بهتدریج از آن استفاده میکنند.
۲۲-۱۴ تمرین عملی#
- ۱. یک کلاستر vstart با
MON=1 OSD=3 MDS=0 بالا بیاورید، debug_osd=20 را روی یکی از OSDها فعال کنید و یک rados put اجرا کنید. ده تابع جدول «مسیر کامل یک نوشتن» را در لاگ پیدا و ترتیب آنها را یادداشت کنید. - ۲. با
ceph osd getmap -o om و ceph-dencoder type OSDMap import om decode dump_json | jq '.epoch, .pools[0]' نقشه را decode کنید. - ۳. ساختار
demo_info_t را در یک آزمون واحد کوچک کامپایل کنید. دادهای را با نسخهی ۲ encode و با decoderی که فقط فیلد size را میشناسد decode کنید. - ۴. روی OSD متوقفشده با
ceph-objectstore-tool --op log آخرین ورودی pg log را پیدا کنید و فیلدهای version، prior_version و reqid را با جدول فصل ۱ مقایسه کنید. - ۵. هنگام یک آزمون
rados bench، با gdb -p روی یک OSD دستور thread apply all bt را اجرا کنید و threadهای tp_osd_tp، msgr-worker و bstore_kv_sync را شناسایی کنید.
۲۲-۱۵ پرسشهای مرور#
- ۱. چرا OSD مستقیم روی دیسک نمینویسد و از ObjectStore::Transaction استفاده میکند؟
- ۲.
_calc_target در Objecter چه ورودیهایی دارد و چه زمانی op دوباره ارسال میشود؟ - ۳. چرا op هر PG همیشه به یک OSDShard میرود؟
- ۴. نقش
ms_fast_dispatch چیست و چه کاری نباید در آن انجام شود؟ - ۵.
ENCODE_START(v, compat, bl) چگونه ارتقای غلتان را ممکن میکند؟ - ۶. تفاوت مسیر مستقیم و deferred در BlueStore چیست و چرا پیشفرض SSD صفر است؟
- ۷. primary در replication چه زمانی به کلاینت پاسخ میدهد؟
- ۸. در RGW، کدام تابع ورودی index را از pending به complete میبرد؟
- ۹. در CephFS، چرا MDS در مسیر داده نیست و نبودِ cap Fb چه اثری دارد؟
- ۱۰. برای یافتن پیشفرض واقعی یک گزینه در یک نسخهی مشخص، به کجا مراجعه میکنید؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۲-۱۶ منابع این فصل#
- مخزن Ceph
https://github.com/ceph/ceph - راهنمای توسعهدهنده
https://docs.ceph.com/en/latest/dev/developer_guide/ - اجرای vstart
https://docs.ceph.com/en/latest/dev/dev_cluster_deployment/ - مستندات داخلی OSD
https://docs.ceph.com/en/latest/dev/osd_internals/ - encoding
https://docs.ceph.com/en/latest/dev/encoding/ - BlueStore
https://docs.ceph.com/en/latest/rados/configuration/bluestore-config-ref/ - crimson
https://docs.ceph.com/en/latest/dev/crimson/ - Weil و همکاران، «Ceph: A Scalable, High-Performance Distributed File System»، OSDI 2006
https://www.usenix.org/legacy/event/osdi06/tech/full_papers/weil/weil.pdf