لایههای پایینی (۸): Crimson و Seastar، OSD تکهستهای و SeaStore
حوصله ندارم این فصل در چند خط
- Crimson، OSD تازهای است بر پایهی Seastar: یک shard برای هر هسته، بدون قفل و فراخوانی مسدودکننده، با future و continuation.
- هر PG به یک هسته سنجاق میشود و عملیات به جای قفل PG از phaseهای مرتب pipeline عبور میکنند.
- backendها عبارتاند از BlueStore (از راه یک adaptor)، CyanStore (در حافظه) و SeaStore که ذخیرهساز log-structured برای NVMe است.
- SeaStore به جمعآوری زبالهی segmentها نیاز دارد؛ بعضی فرمانهای پایش فقط در main وجود دارند، پس نسخهی خود را بررسی کنید.
۳۰-۱ مقدمه: چرا یک OSD تازه؟#
OSD کلاسیک (فصلهای ۱۲، ۲۱ و ۲۲) در دورهای طراحی شد که دیسک چرخان چند میلیثانیه تأخیر داشت و چند ده میکروثانیه هزینهی نرمافزار در برابر آن ناچیز بود. روی NVMe امروزی، یک خواندن ۴K در حدود ۱۰ تا ۸۰ میکروثانیه تمام میشود. در همین مدت، OSD کلاسیک پیام را از یک thread شبکه به صف شارد، از آنجا به thread دیگری با قفل PG و سپس به threadهای kv_sync و finisher در BlueStore میسپارد. هر جابهجایی بین threadها هزینهی context switch، از دست رفتن cache پردازنده و رقابت قفل دارد. Crimson بازنویسی OSD روی چارچوب Seastar است تا این هزینهها حذف شوند: هر هستهی پردازنده یک reactor دارد و هر PG فقط روی یک هسته زندگی میکند.
وضعیت. طبق مستند رسمی (doc/crimson/crimson.rst در شاخهی main و doc/dev/crimson/crimson.rst در Squid و Tentacle)، Crimson در مرحلهی tech preview است و برای production مناسب نیست. فعال کردن آن به سه پرچم نیاز دارد: ویژگی آزمایشی crimson در enable_experimental_unrecoverable_data_corrupting_features، پرچم OSDMap با ceph osd set-allow-crimson --yes-i-really-mean-it و ساخت poolها با پرچم crimson (osd_pool_default_crimson). Crimson فقط PGهای poolهای crimson را میسازد. همهی مطالب این فصل برای فهم معماری است، نه توصیهی استقرار.
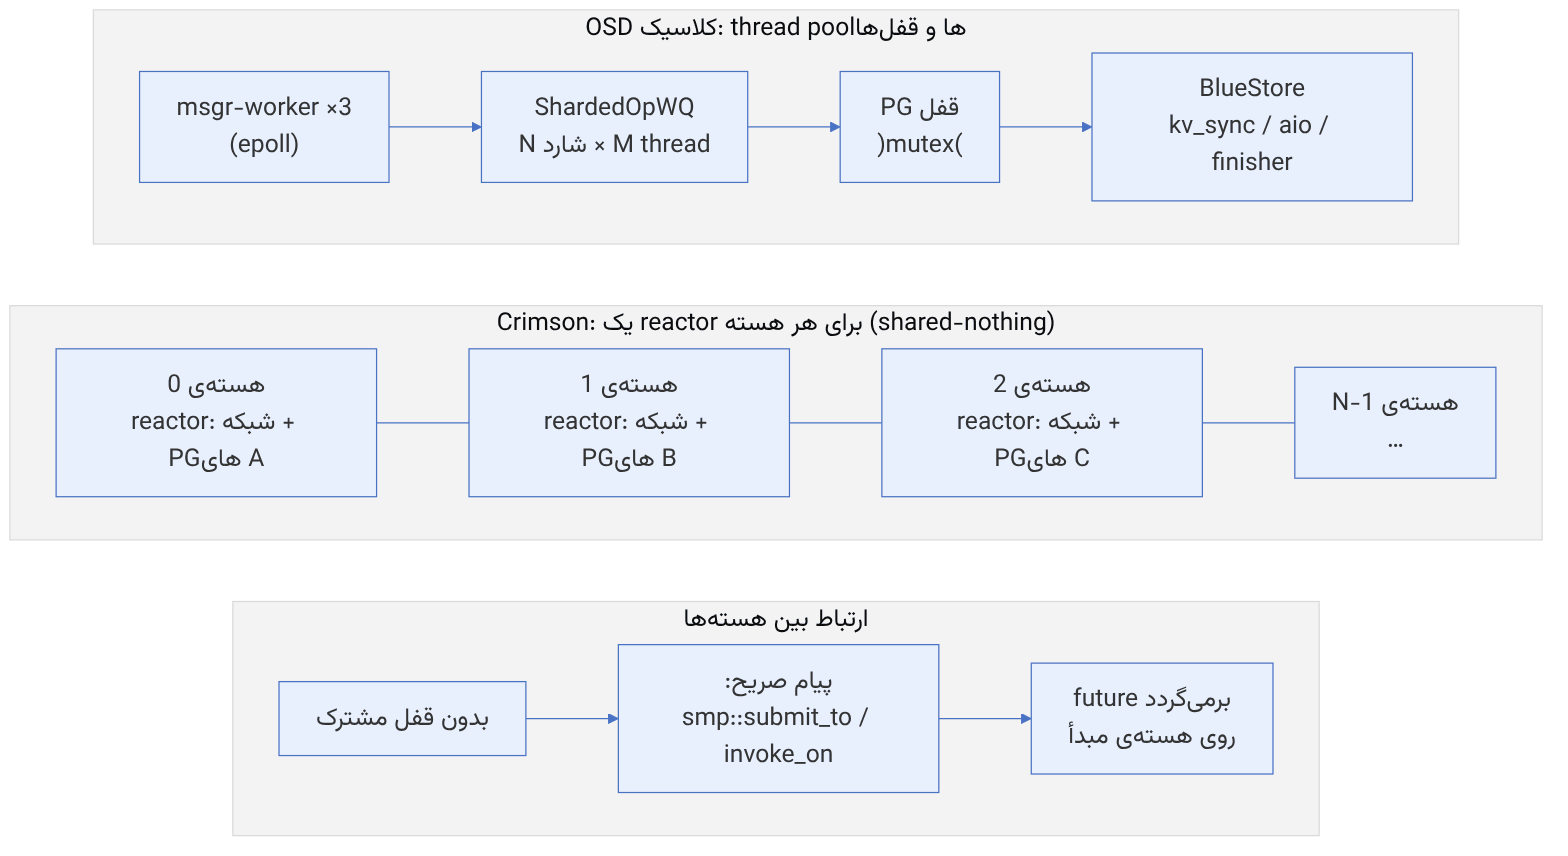
این شکل تفاوت بنیادی دو مدل را نشان میدهد. در ردیف بالا، یک درخواست دستکم چهار بار بین threadها جابهجا میشود و در هر جابهجایی دادهی آن باید از cache هستهی دیگری خوانده شود. در ردیف میانی، دادهی یک PG (log، object context، cache) فقط در حافظهی یک هسته است و هیچ قفلی لازم نیست، چون هیچ هستهی دیگری به آن دست نمیزند. بهای این سادگی آن است که هر تعامل بین هستهها باید صریح باشد، مثل پیامی که به هستهی ۰ برای پیدا کردن هستهی صاحب PG فرستاده میشود.
۳۰-۲ Seastar: future، continuation و reactor#
در Seastar هیچ تابعی بلوکه نمیشود. تابعی که کار ناهمگام دارد (خواندن از شبکه، نوشتن روی دیسک، پرسش از هستهی دیگر) بیدرنگ یک future<T> برمیگرداند. ادامهی کار با .then() به آن future وصل میشود. وقتی نتیجه آماده شد، تولیدکننده با promise.set_value() آن را آماده میکند و continuation به صف task همان reactor میرود. reactor یک حلقهی بیپایان روی هر هسته است: taskهای آماده را اجرا میکند، backend ورودی و خروجی (io_uring، linux-aio یا epoll، با گزینهی crimson_reactor_backend) را poll میکند و تایمرها را بررسی میکند.
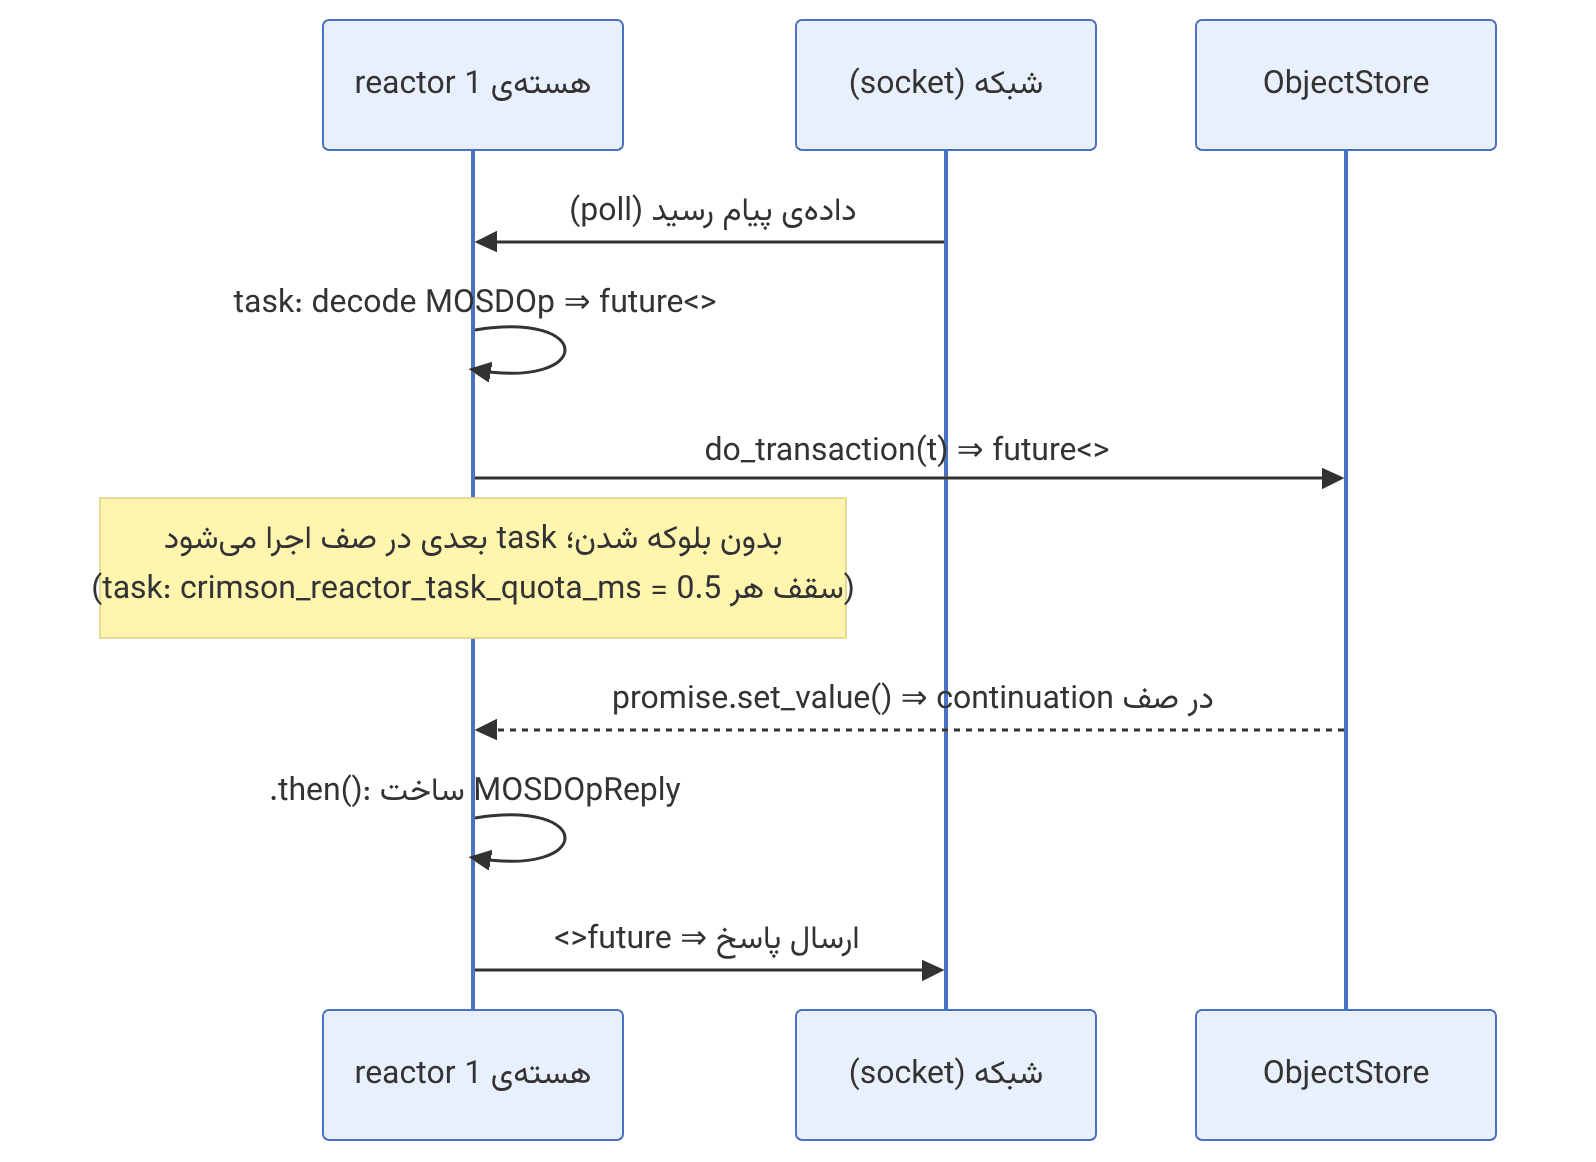
منبع در کد: seastar: reactor::run (بهکارگیری در src/crimson/osd/main.cc و گزینههای crimson_reactor_*)
پیچیدگی: هر دور O(تعداد task آماده + رویدادهای poll)؛ بدون قفل
pseudocode: یک دور reactor (مدل مفهومی، بازنویسی این کتاب)
loop forever:
t0 = now()
while ready_tasks not empty and now() - t0 < task_quota: # 0.5ms
task = ready_tasks.pop_front(); task.run() # continuationها
poll(io backend) # تکمیل io_uring/aio ⇒ promise.set_value ⇒ task جدید
poll(network) # دادهی socket ⇒ task جدید
poll(smp queues) # پیام از هستههای دیگر (submit_to)
run expired timers
if nothing to do for idle_poll_time (200us): sleep in kernel (مگر poll_mode)مثال عددی. فرض کنید هر خواندن ۴K روی reactor حدود ۱۵ میکروثانیه CPU مصرف کند (decode، جستوجوی object context، ساخت پاسخ). با سهم ۰.۵ میلیثانیه، در هر دور حدود ۳۳ درخواست اجرا میشود و سپس reactor دوباره دستگاه و شبکه را poll میکند. پس بیشینهی تأخیر اضافه برای یک تکمیل ورودی و خروجی تازه حدود ۰٫۵ میلیثانیه است. اگر یک continuation بد ۵ میلیثانیه CPU مصرف کند (مثلاً پیمایش یک omap بزرگ بدون تقسیم کار)، همهی PGهای آن هسته ۵ میلیثانیه متوقف میشوند. این همان «stall» است که Seastar در log گزارش میکند. در مدل تعاونی، کار طولانی باید با seastar::maybe_yield() یا حلقههای ناهمگام تکهتکه شود.
crimson_reactor_idle_poll_time_us=200 یعنی reactor پس از ۲۰۰ میکروثانیه بیکاری در هستهی سیستمعامل میخوابد. crimson_poll_mode=true این خواب را حذف میکند و همیشه polling انجام میدهد. در این حالت تأخیر کمتر میشود، اما هر reactor یک هسته را صددرصد مشغول نگه میدارد، حتی بدون بار. داشبوردی که osd_reactor_utilization را نشان میدهد در حالت poll همیشه نزدیک ۱۰۰ است و دیگر نشانهی اشباع نیست.
۳۰-۲-۱ shared-nothing در عمل#
دادهای که بین هستهها مشترک است فقط از سه راه جابهجا میشود: seastar::smp::submit_to(core, func) یک تابع را روی هستهی دیگر اجرا میکند و future نتیجه را برمیگرداند. sharded<T> یک نمونه از سرویس را روی هر هسته نگه میدارد و invoke_on و invoke_on_all آن را فرا میخوانند. foreign_ptr هم مالکیت شیئی را که روی هستهی دیگر ساخته شده است منتقل میکند تا آزادسازی آن روی همان هستهی سازنده انجام شود. در Crimson، PGShardMapping یک peering_sharded_service است. یعنی هر هسته یک کپی محلی از نقشهی PG به هسته دارد، ولی فقط هستهی ۰ آن را تغییر میدهد.
۳۰-۳ الگوریتم نگاشت PG به هسته#
منبع در کد: src/crimson/osd/pg_map.cc :: PGShardMapping::get_or_create_pg_mapping
پیچیدگی: جستوجو O(log P) با std::map؛ انتخاب O(C) روی C هسته؛ یک رفتوبرگشت به هستهی ۰
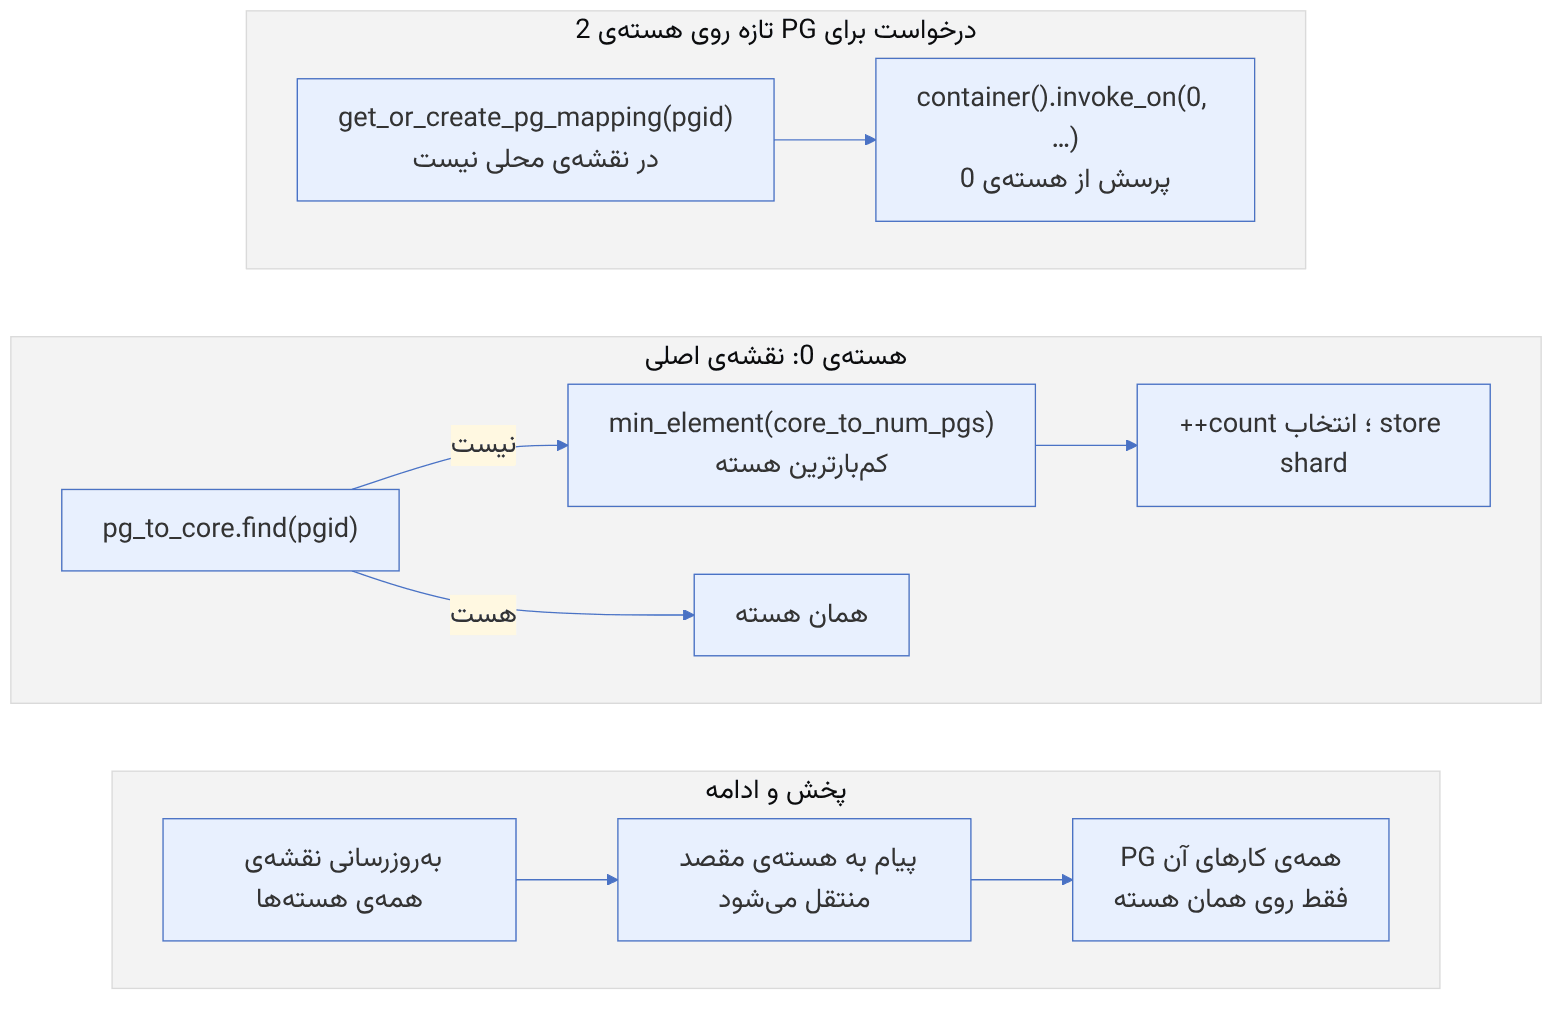
pseudocode: get_or_create_pg_mapping (خلاصهی منطق کد)
on any core:
if pgid in local.pg_to_core: return local.pg_to_core[pgid]
return invoke_on(core 0):
if pgid in primary.pg_to_core: core = that core
else:
core = argmin_c primary.core_to_num_pgs[c] # کمبارترین هسته
primary.core_to_num_pgs[core] += 1
store_index = pick least-loaded store shard on core (اگر چند shard ذخیرهساز)
primary.pg_to_core[pgid] = (core, store_index)
broadcast mapping to all cores; return (core, store_index)مثال عددی. OSD با crimson_cpu_num=4 و هستههای ۰ تا ۳ را در نظر بگیرید که بهترتیب ۳۰، ۲۹، ۳۱ و ۲۹ PG دارند. PG تازهی ۲.۱f وارد میشود. min_element اولین کمینه را برمیگرداند، پس هستهی ۱ انتخاب میشود (نه ۳) و شمارشها ۳۰، ۳۰، ۳۱ و ۲۹ میشوند. PG بعدی به هستهی ۳ میرود. این روش فقط تعداد PG را متوازن میکند، نه بار آنها را. اگر دو PG داغ RBD روی یک هسته بیفتند، آن هسته اشباع میشود و هستههای دیگر بیکار میمانند، چون در مدل shared-nothing هیچ work-stealing وجود ندارد. این یکی از تفاوتهای عملی مهم با OSD کلاسیک است که threadهای هر شارد بین PGهای متعدد آن شارد مشترکاند.
نگاشت تا پایان عمر PG روی OSD ثابت است و با ceph tell osd.N dump_store_shards قابل مشاهده است (تابع dump_store_shards در همان فایل). اگر تعداد shardهای ذخیرهساز (مثلاً SeaStore) با تعداد reactorها برابر نباشد، کد یک لایهی دوم از انتخاب کمبارترین (روی core_alien_to_num_pgs یا core_shard_to_num_pgs) اضافه میکند. گزینهی seastore_require_partition_count_match_reactor_count این حالت را محدود میکند.
۳۰-۴ pipeline عملیات#
در OSD کلاسیک، ترتیب درخواستهای یک PG با قفل PG و صف شارد حفظ میشود. Crimson بهجای قفل از phaseها استفاده میکند (src/crimson/osd/osd_operation.h). هر phase یا OrderedExclusive است، یعنی در هر لحظه فقط یک عملیات در آن است و ترتیب ورود حفظ میشود، یا OrderedConcurrent، یعنی چند عملیات همزمان در آن هستند ولی به همان ترتیب خارج میشوند.
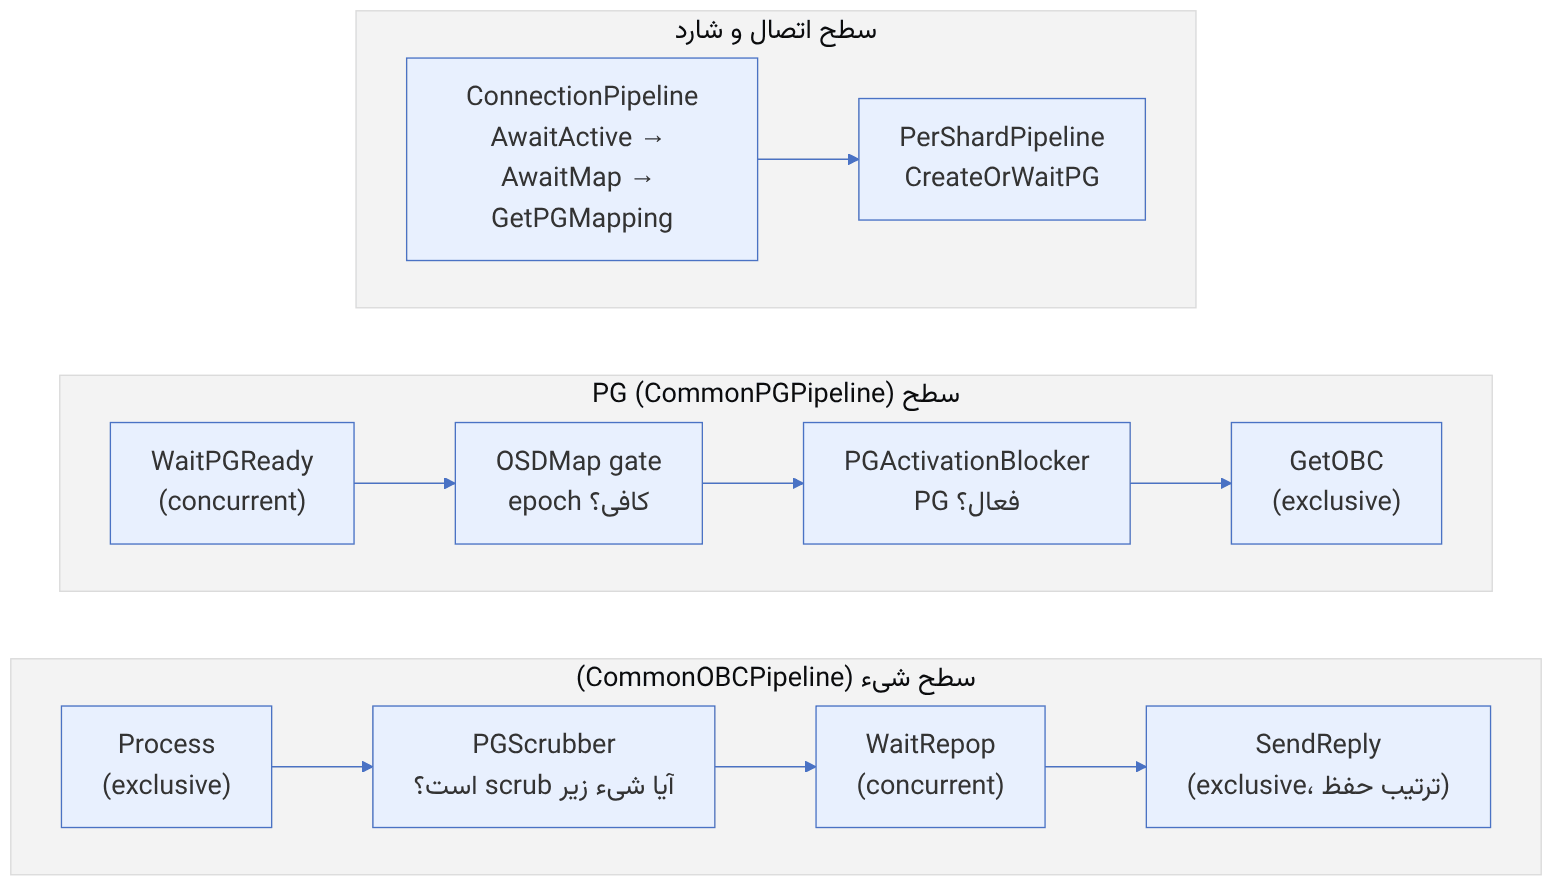
| phase | نوع | چه چیزی را تضمین میکند |
|---|---|---|
| ConnectionPipeline::AwaitActive / AwaitMap / GetPGMapping | exclusive | ترتیب پیامهای یک اتصال تا رسیدن به هستهی PG |
| PerShardPipeline::CreateOrWaitPG | exclusive | ساخت PG فقط یک بار |
| CommonPGPipeline::WaitPGReady | concurrent | انتظار برای آماده شدن PG بدون ترتیبشکنی |
| CommonPGPipeline::GetOBC | exclusive | ترتیب گرفتن object context (معادل قفل شیء) |
| CommonOBCPipeline::Process | exclusive | اجرای opها روی شیء به ترتیب ورود |
| CommonOBCPipeline::WaitRepop | concurrent | چند نوشتن همزمان منتظر ack از replicaها |
| CommonOBCPipeline::SendReply | exclusive | پاسخها به ترتیب درخواستها |
استدلال تأخیر. چون WaitRepop همزمان است، ۳۲ نوشتن متوالی روی یک شیء میتوانند همزمان منتظر replicaها باشند. اگر رفتوبرگشت تا replica 200 میکروثانیه و پردازش هر نوشتن ۲۰ میکروثانیه باشد، گذردهی یک شیء حدود ۱/۲۰µs=50K نوشتن در ثانیه است، نه ۱/۲۲۰µs. اگر Process بلوکه شود (مثلاً منتظر خواندن object context از دیسک)، کل صف شیء پشت آن میماند. به همین دلیل crimson_osd_obc_lru_size=512 (اندازهی cache مربوط به object context) برای بار تصادفی اهمیت زیادی دارد.
۳۰-۵ پشتیبانهای ذخیرهسازی در Crimson#
رابط ذخیرهسازی Crimson FuturizedStore است (src/crimson/os/futurized_store.h). هر عمل بهجای مقدار، future برمیگرداند. سه پیادهسازی در src/crimson/os/ وجود دارد:
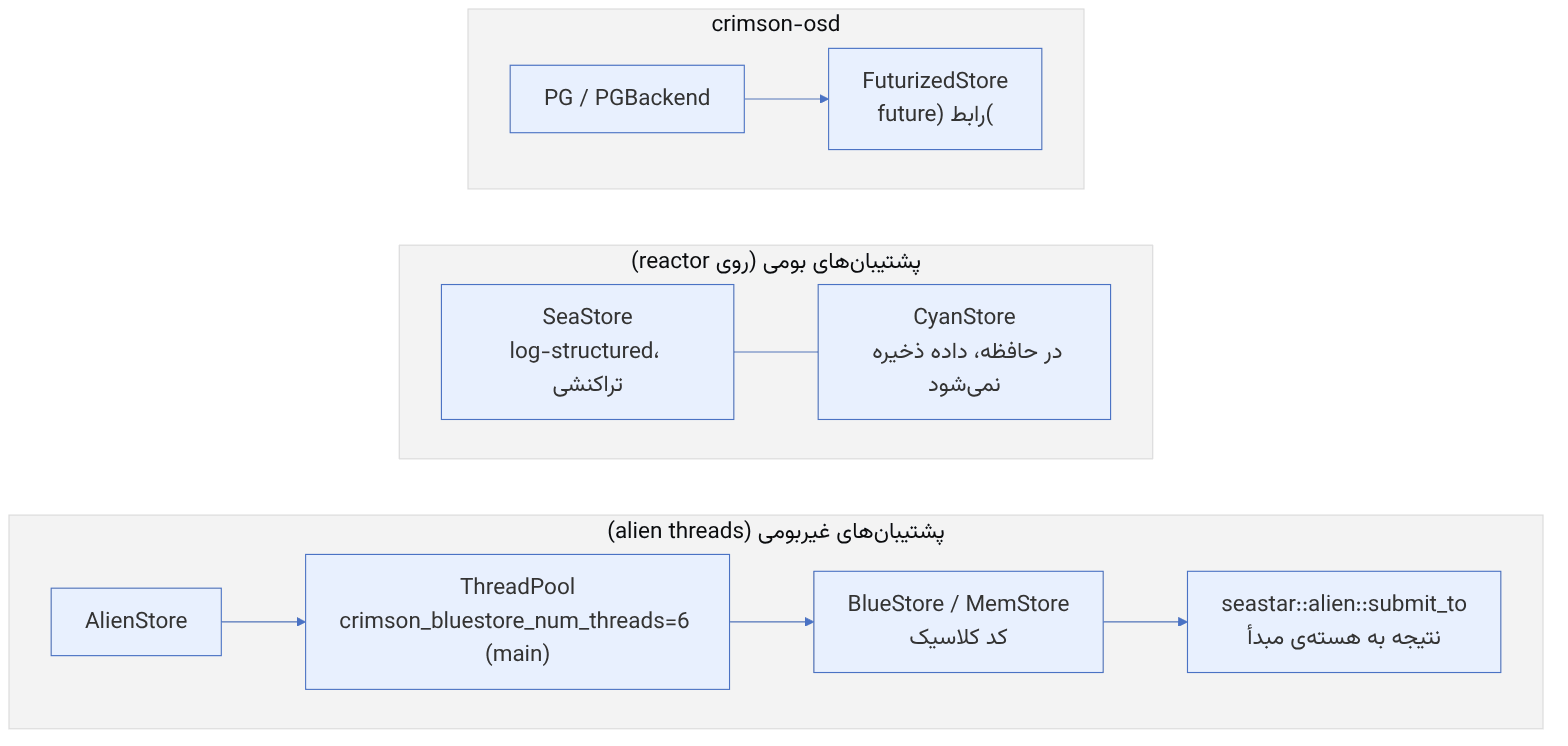
| پشتیبان | اجرا | کاربرد | وضعیت (مستند main) |
|---|---|---|---|
| SeaStore | بومی، روی reactor | طراحی تازه برای NVMe | «اولیه»، پیشفرض نیست |
| CyanStore | بومی، در حافظه | سنجش سربار خود OSD؛ داده ذخیره نمیکند | فقط آزمایش |
| AlienStore + BlueStore | thread pool بیگانه | پیشفرض؛ سازگار با HDD و SSD | پیشفرض در Crimson |
| AlienStore + MemStore | thread pool بیگانه | آزمایش و توسعه | فقط آزمایش |
در alien_store.cc، thread pool با crimson_bluestore_num_threads (پیشفرض ۶ در main) ساخته میشود. عملیات یک collection با ch->get_cid().hash_to_shard(tp->size()) همیشه به یک thread مشخص میرود تا ترتیب تراکنشهای یک PG حفظ شود. این همان نقشی است که در OSD کلاسیک صف شارد ایفا میکند.
هزینهی پنهان AlienStore. هر عمل دو بار مرز reactor و thread را میگذراند (رفت به pool و برگشت با alien::submit_to). روی NVMe سریع، این دو انتقال و کار BlueStore در threadهای خودش بخش بزرگی از سود Crimson را از بین میبرند. به همین دلیل مستند توصیه میکند مجموعهی CPU مربوط به BlueStore (crimson_bluestore_cpu_set) از هستههای reactor (crimson_cpu_set) جدا باشد تا threadهای بیگانه با reactorها رقابت نکنند.
۳۰-۶ SeaStore: معماری#
SeaStore یک ObjectStore log-structured و تراکنشی است. هیچ دادهای در جای قبلی بازنویسی نمیشود، مگر در backend مربوط به random block (RBM). هر تراکنش به یک record در journal تبدیل میشود که deltaها (تغییرات منطقی روی بلوکها) و بلوکهای تازه را در بر دارد.
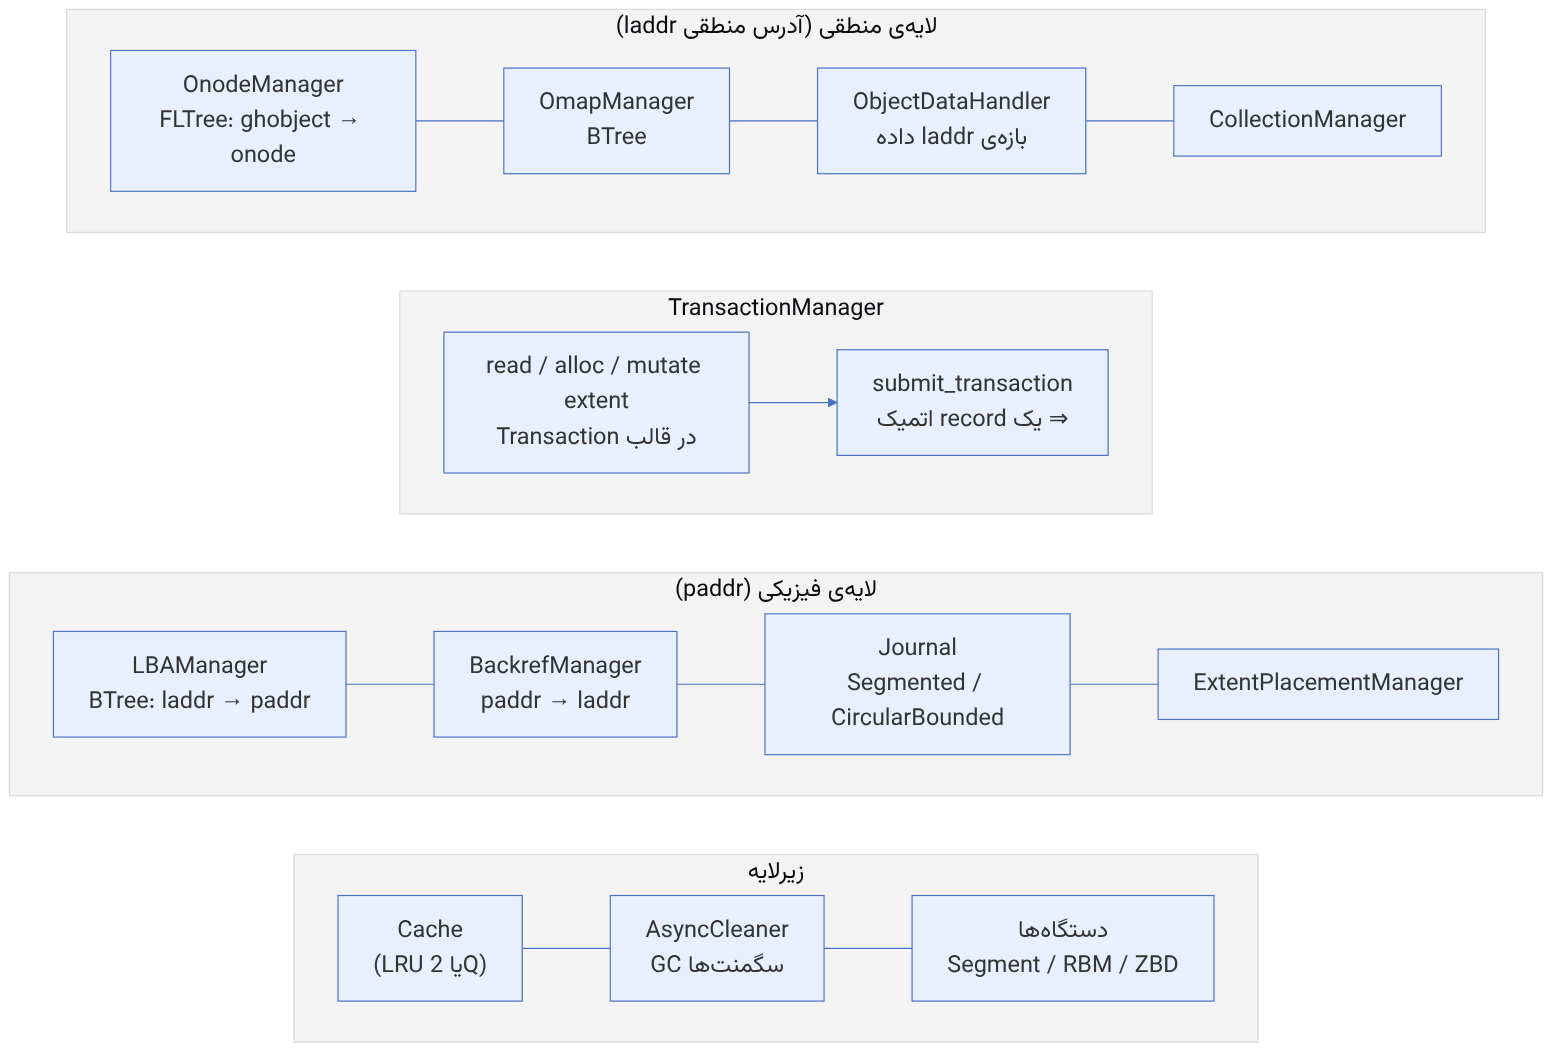
دو نوع آدرس در SeaStore وجود دارد. laddr آدرس منطقی است که onodeها و درختهای omap به آن اشاره میکنند و با جابهجایی بلوک در GC تغییر نمیکند. paddr آدرس فیزیکی است. تنها ساختاری که باید با جابهجایی بلوک بهروز شود LBA tree است. این طراحی هزینهی GC را محدود میکند: جابهجا کردن یک بلوک داده فقط یک ورودی برگ در LBA tree را عوض میکند، نه همهی اشارهگرهای به آن.
۳۰-۶-۱ paddr_t بیت به بیت#
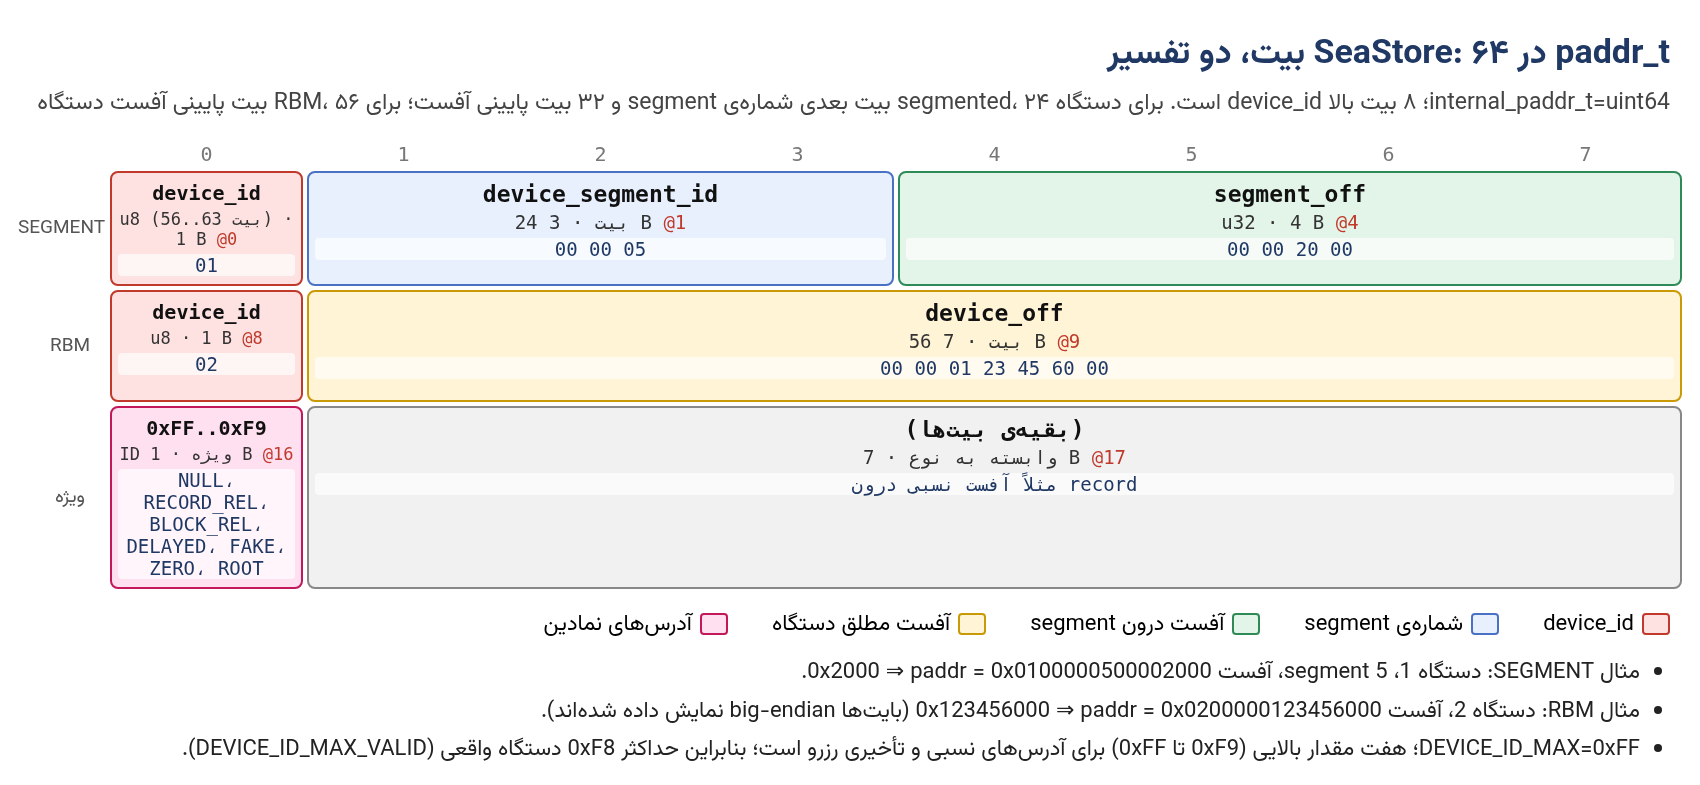
آدرسهای نسبی (DEVICE_ID_RECORD_RELATIVE و DEVICE_ID_BLOCK_RELATIVE) نکتهی ظریفی دارند. وقتی تراکنشی ساخته میشود، هنوز معلوم نیست record آن در کجای journal قرار میگیرد. پس بلوکهای تازه با آفست نسبی به ابتدای record نامگذاری میشوند و هنگام نوشتن record، این آدرسها به paddr مطلق تبدیل میشوند. DEVICE_ID_DELAYED برای بلوکهایی است که جای آنها تا لحظهی ثبت با ExtentPlacementManager تعیین نشده است (نوشتن out-of-line).
۳۰-۶-۲ record و دستهبندی در journal#
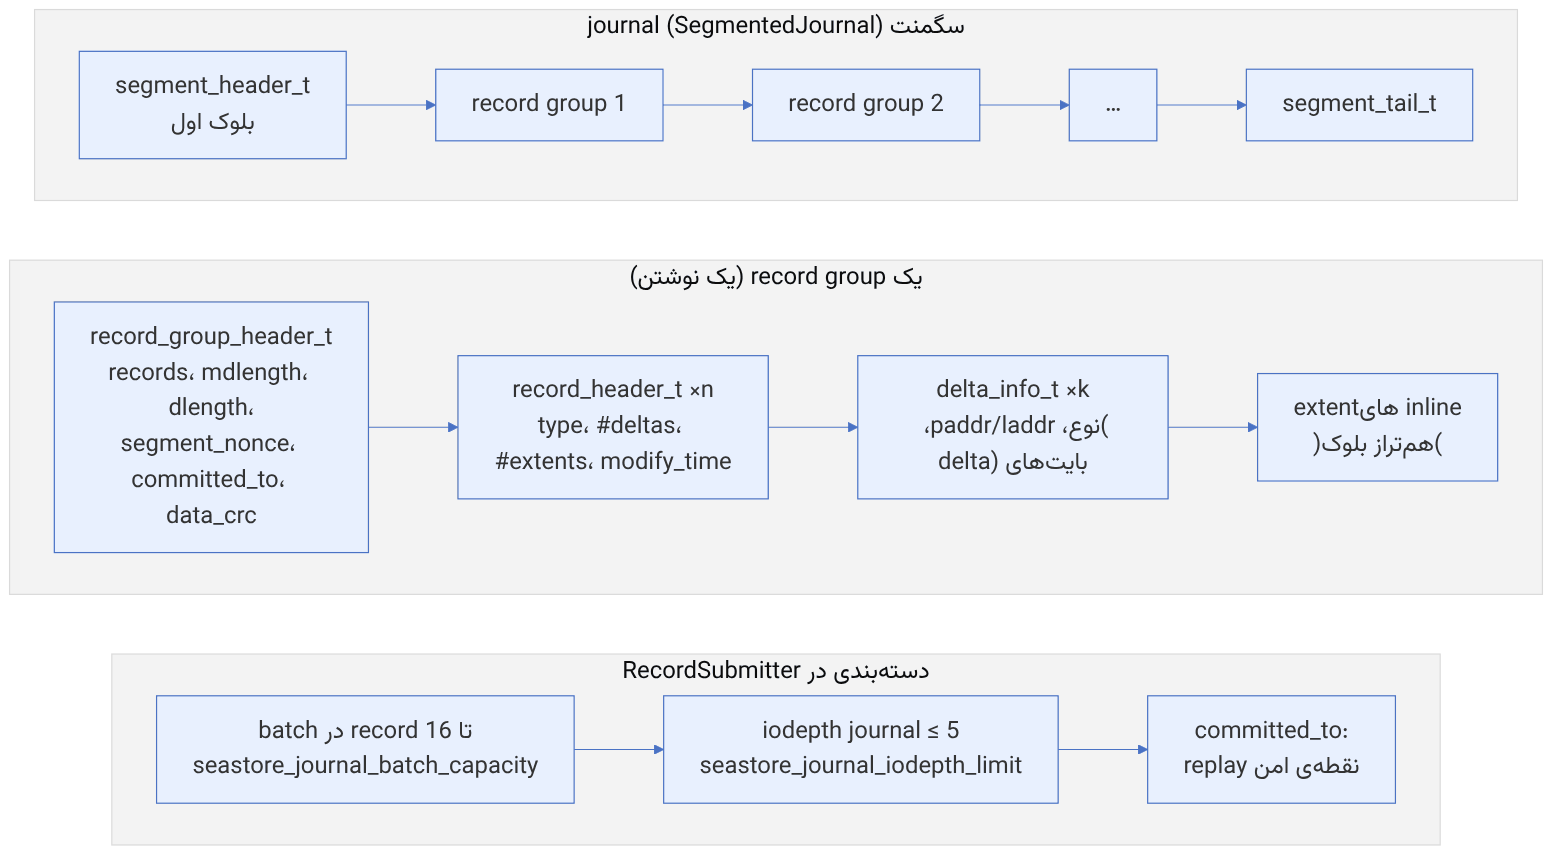
منبع در کد: src/crimson/os/seastore/journal/record_submitter.cc :: RecordSubmitter::submit / flush_current_batch
پیچیدگی: هر record O(اندازه) برای کدگذاری؛ تأخیر در بدترین حالت یک batch
pseudocode: دستهبندی journal (مدل مفهومی)
submit(record):
if current_batch can fit record and batch.size < batch_capacity(16):
current_batch.add(record)
else: flush_current_batch(); current_batch.add(record)
if outstanding_ios < iodepth_limit(5): flush_current_batch() # دیسک بیکار است: صبر نکن
else: wait (batch بزرگتر میشود تا یکی از نوشتنها تمام شود)
flush_current_batch():
header = record_group_header_t{records=n, mdlength, dlength, segment_nonce,
committed_to = آخرین نقطهای که همهی قبلیها کاملاند,
data_crc = crc(data)}
write(header + metadata + data) as ONE aligned I/Oمثال عددی. فرض کنید ۴۰ تراکنش کوچک (هرکدام یک delta روی onode و ۴K داده) همزمان میرسند و دیسک هر نوشتن را در ۲۰ میکروثانیه کامل میکند. پنج record اول هرکدام به یک نوشتن جدا تبدیل میشوند، چون صف دیسک خالی است. پس از رسیدن به سقف ۵ نوشتن همزمان، بقیه تا ۱۶ عدد در یک batch جمع میشوند. ۳۵ record باقیمانده در ۳ نوشتن (۱۶+۱۶+۳) ثبت میشوند. در مجموع ۸ نوشتن بهجای ۴۰ انجام میشود و بیشترین تأخیر اضافهی هر record کمتر از دو بار زمان یک نوشتن است. این همان مصالحهی group commit در kv_sync_thread در BlueStore است، با این تفاوت که بدون thread جداگانه و فقط با futureها پیاده شده است.
وابسته به نسخه. در Squid، seastore_max_concurrent_transactions برابر ۸ و در main برابر ۱۲۸ است. نام گزینهها هم تغییر کرده است: Squid و Tentacle از crimson_seastar_num_threads و crimson_alien_op_num_threads استفاده میکنند و main از crimson_cpu_num و crimson_bluestore_num_threads. cache در Squid با seastore_cache_lru_size=64M تنظیم میشد و در main با seastore_cachepin_size_pershard=2G و انتخاب LRU یا ۲Q. پیش از هر آزمایش، ceph config help را روی نسخهی خود اجرا کنید.
۳۰-۶-۳ حالتهای یک extent در cache#
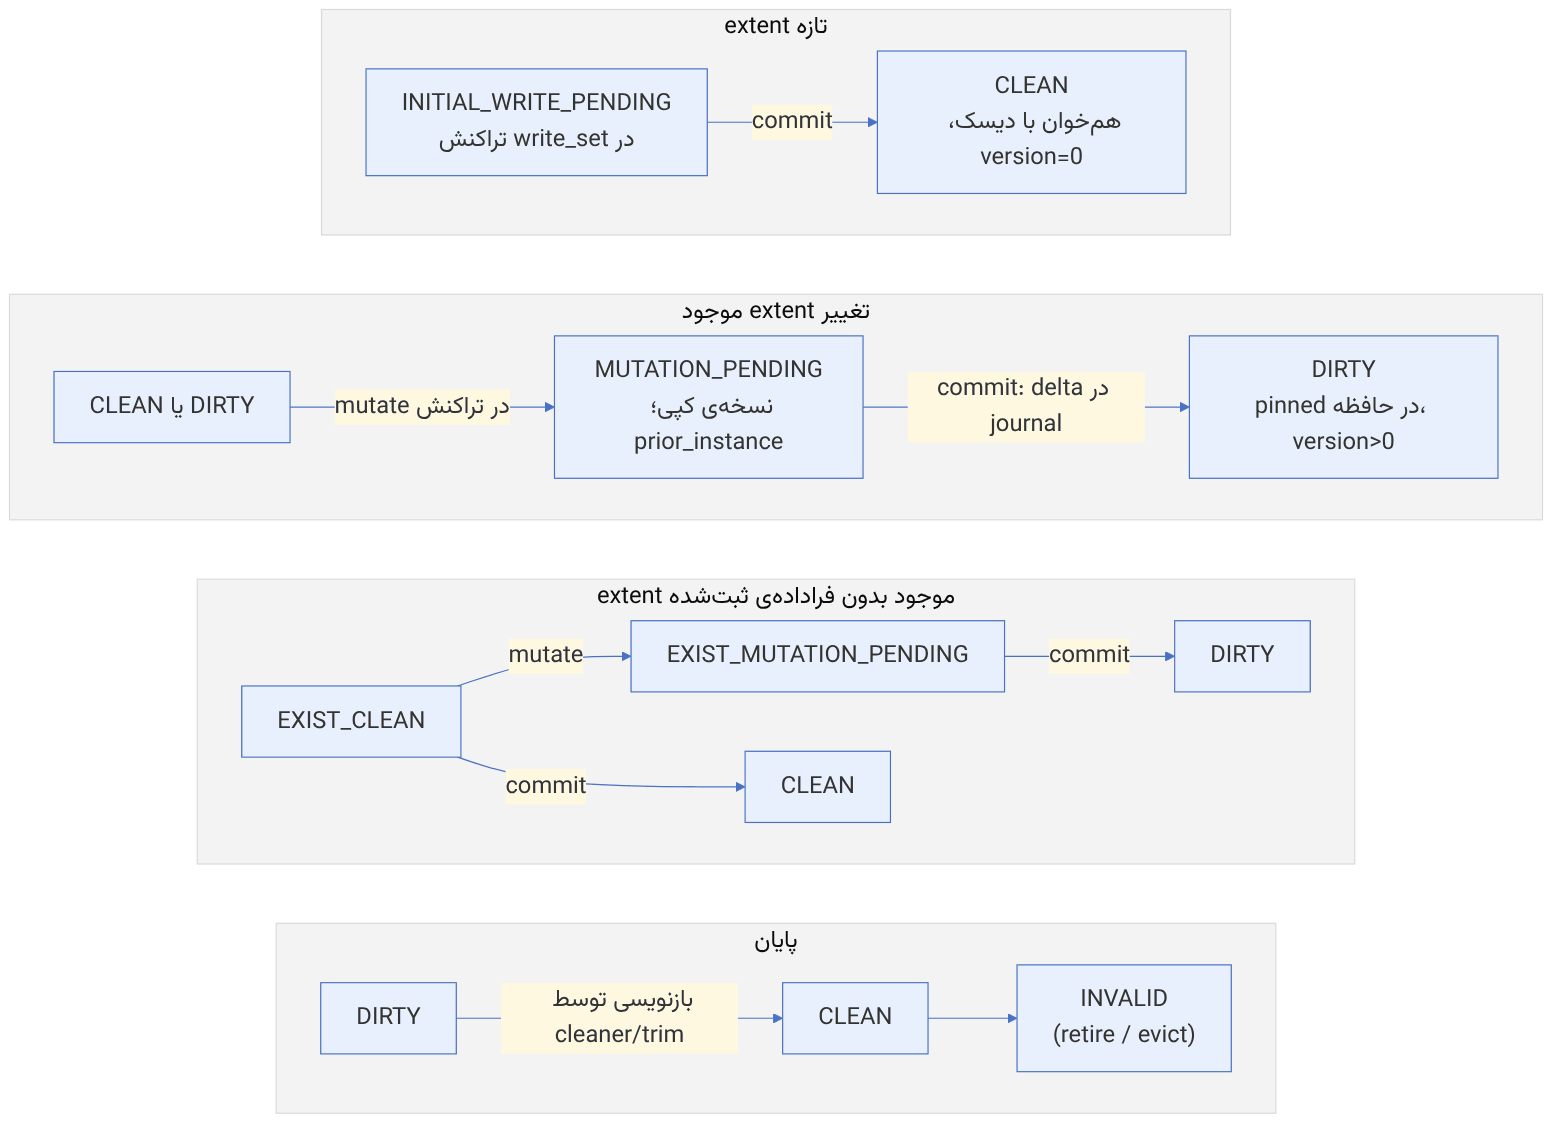
نکتهی مهم این ماشین حالت کنترل همروندی خوشبینانه است. هر تراکنش extentهایی را که خوانده در read_set نگه میدارد. اگر تراکنش دیگری پیش از commit یکی از آنها را تغییر دهد، Cache::mark_transaction_conflicted تراکنش اول را نامعتبر میکند و تراکنش باید از نو اجرا شود. مستند SeaStore یادآوری میکند که این سازوکار در بارهای نوشتن سنگین نرخ تکرار بالایی دارد و برای حذف آن برنامهریزی شده است. این یکی از دلایل وضعیت «اولیه»ی SeaStore است.
۳۰-۷ GC سگمنتها: انتخاب سگمنت قربانی#
در دستگاه segmented، هر بایتی که نوشته میشود در نهایت باید با «تمیز کردن» یک سگمنت قدیمی جبران شود: دادهی زندهی آن سگمنت به سگمنت تازه منتقل و سگمنت آزاد میشود. پرسش کلیدی این است که کدام سگمنت انتخاب شود.
منبع در کد: src/crimson/os/seastore/async_cleaner.cc :: SegmentCleaner::calc_gc_benefit_cost و get_next_reclaim_segment
پیچیدگی: O(S) روی S سگمنت بسته در هر انتخاب
pseudocode: get_next_reclaim_segment (خلاصه)
for each closed segment s:
u = live_bytes(s) / segment_size # 0 ≤ u < 1
score(s) = greedy: 1 - u
cost_benefit: (1 - u) × age(s) / (2u) # u=0 ⇒ +∞
benefit: ترکیب (1-u) با عامل سن نرمالشده
pick = argmax score; greedy_pick = argmin u
if autotune and formula ≠ greedy and (1-u_greedy) ≥ ratio(2.0) × (1-u_pick):
pick = greedy_pick # فرمول سنمحور اشتباه کرده استفرمول cost-benefit همان فرمول کلاسیک سامانههای فایل log-structured (LFS) است. سود پاک کردن سگمنت متناسب با فضای آزادشده (۱-u) و «پایداری» آن (سن) است و هزینهاش خواندن u و نوشتن u (یعنی ۲u). سگمنت قدیمی با دادهی کمزنده بهترین گزینه است، چون دادهی باقیماندهاش احتمالاً «سرد» است و دوباره به این زودی نمیمیرد.
مثال عددی. سه سگمنت بسته داریم:
| سگمنت | u (سهم زنده) | سن (ثانیه) | greedy = ۱-u | cost-benefit = |
|---|---|---|---|---|
| A | ۰.۲ | ۱۰۰ | ۰.۸ | ۲۰۰ |
| B | ۰.۵ | ۱۰۰۰ | ۰.۵ | ۵۰۰ |
| C | ۰.۹ | ۱۰۰۰۰ | ۰.۱ | ۵۵۵.۶ |
فرمول cost-benefit سگمنت C را انتخاب میکند، چون بسیار قدیمی است. اما پاک کردن C فقط ۱۰٪ فضای آزاد به دست میدهد و باید ۹۰٪ آن را جابهجا کرد. autotune این را بررسی میکند: سهم آزاد greedy (۰.۸) دستکم ۲ برابر سهم آزاد انتخاب فرمول (۰.۱) است، پس انتخاب به A برمیگردد. اگر C در کار نبود، فرمول B را با امتیاز ۵۰۰ انتخاب میکرد. نسبت ۰.۸/۰.۵=۱.۶ کمتر از ۲ است، پس انتخاب فرمول حفظ میشد. این گزینهها (seastore_segment_cleaner_gc_formula=cost_benefit، seastore_segment_cleaner_gc_autotune=true و ratio=2.0) در main هستند و در yaml مربوط به Squid و Tentacle دیده نمیشوند.
استدلال write amplification. اگر cleaner در حالت پایدار سگمنتهایی با میانگین u=0.5 را پاک کند، برای هر ۱ بایت آزادشده ۱ بایت بازنویسی لازم است و WA حدود ۲ است. با u=0.2، برای هر ۰.۸ بایت آزاد ۰.۲ بایت جابهجا میشود و WA حدود ۱.۲۵ است. پس رزرو فضای آزاد بیشتر روی دستگاه، u سگمنتهای قربانی را پایین میآورد و هم عمر NVMe و هم تأخیر نوشتن را بهتر میکند.
۳۰-۸ سنجش و پایش Crimson#
ceph tell osd.0 dump_metrics reactor_utilization # بهرهوری هر reactor (shard)
ceph tell osd.0 dump_store_shards # نگاشت PGها و store shardها به هستهها
ceph config set osd crimson_prometheus_port_base 29180 # main: osd.N روی 29180+N
curl -s http://HOST:29180/metrics | grep osd_reactor_utilization
ceph osd dump | grep -E 'allow_crimson|crimson' # پرچمهای نقشه و poolاگر یک reactor نزدیک ۱۰۰٪ و بقیه کمکار باشند، (۱) poll_mode را بررسی کنید، (۲) با dump_store_shards ببینید کدام PGها روی آن هستهاند و (۳) بار هر PG را با ceph pg dump pgs مقایسه کنید. در Crimson راهحل، توزیع PGها (افزایش pg_num یا upmap) است، نه افزایش thread.
۳۰-۹ تکمیلی و بهروز#
- در شاخهی main، مستند کاربری Crimson از
doc/dev/crimson/ به doc/crimson/crimson.rst منتقل شده و استقرار با ceph orch apply osd --osd-type crimson و برای SeaStore با --objectstore seastore شرح داده شده است. در Squid و Tentacle این فرمانها در مستند نیستند. -
crimson_cpu_num پیشفرض ندارد و پس از استقرار تغییرپذیر نیست. مستند توصیه میکند آن را کمتر از nproc تقسیم بر تعداد OSDهای میزبان بگذارید. - io_uring backend پیشفرض reactor است، اگر هسته اجازه دهد (
kernel.io_uring_disabled). در برخی توزیعهای محافظهکار باید آن را صریحاً فعال کرد. - SeaStore برای HDD مناسب نیست (طبق مستند). Crimson برای HDD و SSDهای کند همچنان BlueStore را از راه AlienStore پشتیبانی میکند.
۳۰-۱۰ تمرین عملی#
- ۱. با vstart (
MDS=0 MON=1 OSD=1 ../src/vstart.sh -n --crimson --crimson-smp 2) یک خوشهی Crimson بسازید. dump_metrics reactor_utilization را پیش و پس از rados bench مقایسه کنید. - ۲. CyanStore را با AlienStore+BlueStore با یک بار ۴K تصادفی مقایسه کنید. تفاوت تأخیر، هزینهی ذخیرهساز است و تأخیر CyanStore سربار خود OSD.
- ۳. با چهار PG در pool و دو reactor، با
dump_store_shards نگاشت را ببینید و آن را با مثال این فصل مقایسه کنید. - ۴. سه سگمنت فرضی با u و سن دلخواه بسازید و امتیاز greedy و cost-benefit و نتیجهی autotune را دستی حساب کنید.
۳۰-۱۱ پرسشهای مرور#
- ۱. چرا مدل thread pool در OSD کلاسیک روی NVMe هزینهبر است؟
- ۲. future و continuation در Seastar چگونه جایگزین بلوکه شدن میشوند؟
- ۳. crimson_reactor_task_quota_ms چه چیزی را محدود میکند و یک continuation طولانی چه اثری دارد؟
- ۴. PG تازه چگونه به یک هسته نسبت داده میشود و این روش چه ضعفی دارد؟
- ۵. تفاوت phaseهای exclusive و concurrent را با مثال WaitRepop توضیح دهید.
- ۶. AlienStore چرا لازم است و چه هزینهای دارد؟
- ۷. laddr و paddr در SeaStore چه تفاوتی دارند و چرا این جداسازی هزینهی GC را کم میکند؟
- ۸. ساختار ۶۴ بیتی paddr_t را برای segment و RBM شرح دهید.
- ۹. فرمول cost-benefit را بنویسید و autotune را با مثال توضیح دهید.
- ۱۰. سه پرچمی که برای فعال کردن Crimson لازماند کداماند؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۳۰-۱۲ منابع این فصل#
- Crimson در مستندات (main
https://github.com/ceph/ceph/blob/main/doc/crimson/crimson.rst - راهنمای توسعهدهندهی Crimson
https://github.com/ceph/ceph/blob/main/doc/dev/crimson/index.rst - طراحی SeaStore
https://github.com/ceph/ceph/blob/main/doc/dev/crimson/seastore.rst - کد Crimson
https://github.com/ceph/ceph/tree/main/src/crimson - گزینههای Crimson
https://github.com/ceph/ceph/blob/main/src/common/options/crimson.yaml.in - Seastar
https://seastar.io/ - آموزش Seastar
https://github.com/scylladb/seastar/blob/master/doc/tutorial.md - پروژهی Crimson در وبلاگ Ceph
https://ceph.io/en/news/crimson/ - Rosenblum و Ousterhout، The Design and Implementation of a Log-Structured File System (۱۹۹۲
https://people.eecs.berkeley.edu/~brewer/cs262/LFS.pdf