ذخیرهسازی شیء با RADOS Gateway
حوصله ندارم این فصل در چند خط
- RGW یک سرور HTTP بیحالت است که S3 و Swift را روی RADOS پیاده میکند؛ چند نمونه از آن را پشت سرویس ingress در cephadm اجرا کنید.
- هر شیء S3 به یک head، چند tail و یک مدخل در bucket index تبدیل میشود؛ pool ایندکس را replicated و روی SSD نگه دارید.
- user، subuser، tenant و account سطوح متفاوت هویتاند؛ برای طراحی تازه account را (از Squid به بعد) در نظر بگیرید.
- versioning، object lock، lifecycle، storage class، policy، SSE و اعلان رویداد، RGW را به سرویس کامل S3 تبدیل کردهاند؛ قانون lifecycle برای multipartهای ناتمام را فراموش نکنید و بدانید gc فضا را بعداً آزاد میکند.
۴-۱ پیش از شروع#
۴-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
ذخیرهسازی شیء سریعترین بخش در حال رشد دنیای ذخیرهسازی است: پشتیبانها، آرشیو رسانه، لاگها، دیتاستهای یادگیری ماشین، artifactهای CI و حتی «دریاچهی داده». API عملاً استاندارد این حوزه Amazon S3 است و RADOS Gateway (RGW) پیادهسازی Ceph از آن است. در این فصل:
- ذخیرهسازی شیء چه فرقی با بلوک و فایل دارد و RGW چطور آن را روی RADOS پیاده میکند؟
- چطور RGW را با cephadm مستقر و پشت load balancer قرار دهیم؟
- کاربر، کلید، subuser، tenant و account چیست و کدام را کی به کار ببریم؟
- چطور با S3 (s۳cmd و aws-cli) و Swift به RGW دسترسی داشته باشیم و DNS مجازی bucket را پیکربندی کنیم؟
- RGW را چطور با Keystone و Hadoop S3A یکپارچه کنیم؟
- قابلیتهای امروزی مثل نسخهبندی، lifecycle، object lock، سیاست bucket و اعلان رویداد چطور کار میکنند؟
۴-۱-۲ پیشنیاز#
کلاستر فصل ۱ و میزبان ceph-node4 با برچسب rgw، بهعلاوهی client-node1 برای ابزارهای کلاینت.
۴-۲ آشنایی با ذخیرهسازی شیء در Ceph#
۴-۲-۱ شیء، bucket و API#
در ذخیرهسازی شیء، هیچ درخت پوشه یا بلوک قابلبازنویسی وجود ندارد. داده در قالب شیء ذخیره میشود: یک کلید (نام)، محتوای باینری و فراداده. اشیاء در bucketها (در اصطلاح Swift: container) دستهبندی میشوند و از طریق HTTP با فعلهایی مثل PUT، GET، HEAD و DELETE دسترسی پیدا میکنند. شیء معمولاً یکجا نوشته و یکجا خوانده میشود؛ تغییر بخشی از شیء یعنی بازنویسی کل آن. همین سادگی است که مقیاس عظیم و دسترسی از هر جای اینترنت را ممکن میکند.
| ویژگی | بلوک (RBD) | فایل (CephFS) | شیء (RGW) |
|---|---|---|---|
| رابط | دستگاه بلوکی | POSIX | HTTP (S۳/Swift) |
| واحد دسترسی | بلوک | بایت در فایل | کل شیء (با range read) |
| فراداده | ندارد | مجوزها، زمانها | دلخواه، بههمراه برچسبها |
| مقیاس معمول | ترابایت در هر دیسک | میلیونها فایل | میلیاردها شیء |
| کاربرد | VM، پایگاه داده | اشتراک فایل، HPC | پشتیبان، رسانه، دادهی تحلیلی |
۴-۲-۲ RGW روی RADOS#
radosgw یک سرور HTTP بدون حالت است (frontend پیشفرض آن از Nautilus به بعد Beast مبتنی بر Boost.Asio است و frontend قدیمی civetweb کنار گذاشته شده). هر درخواست S3 یا Swift را به مجموعهای از عملیات RADOS ترجمه میکند. چون حالتی در خود RGW نگه داشته نمیشود، هر تعداد نمونه را میتوان پشت load balancer قرار داد.
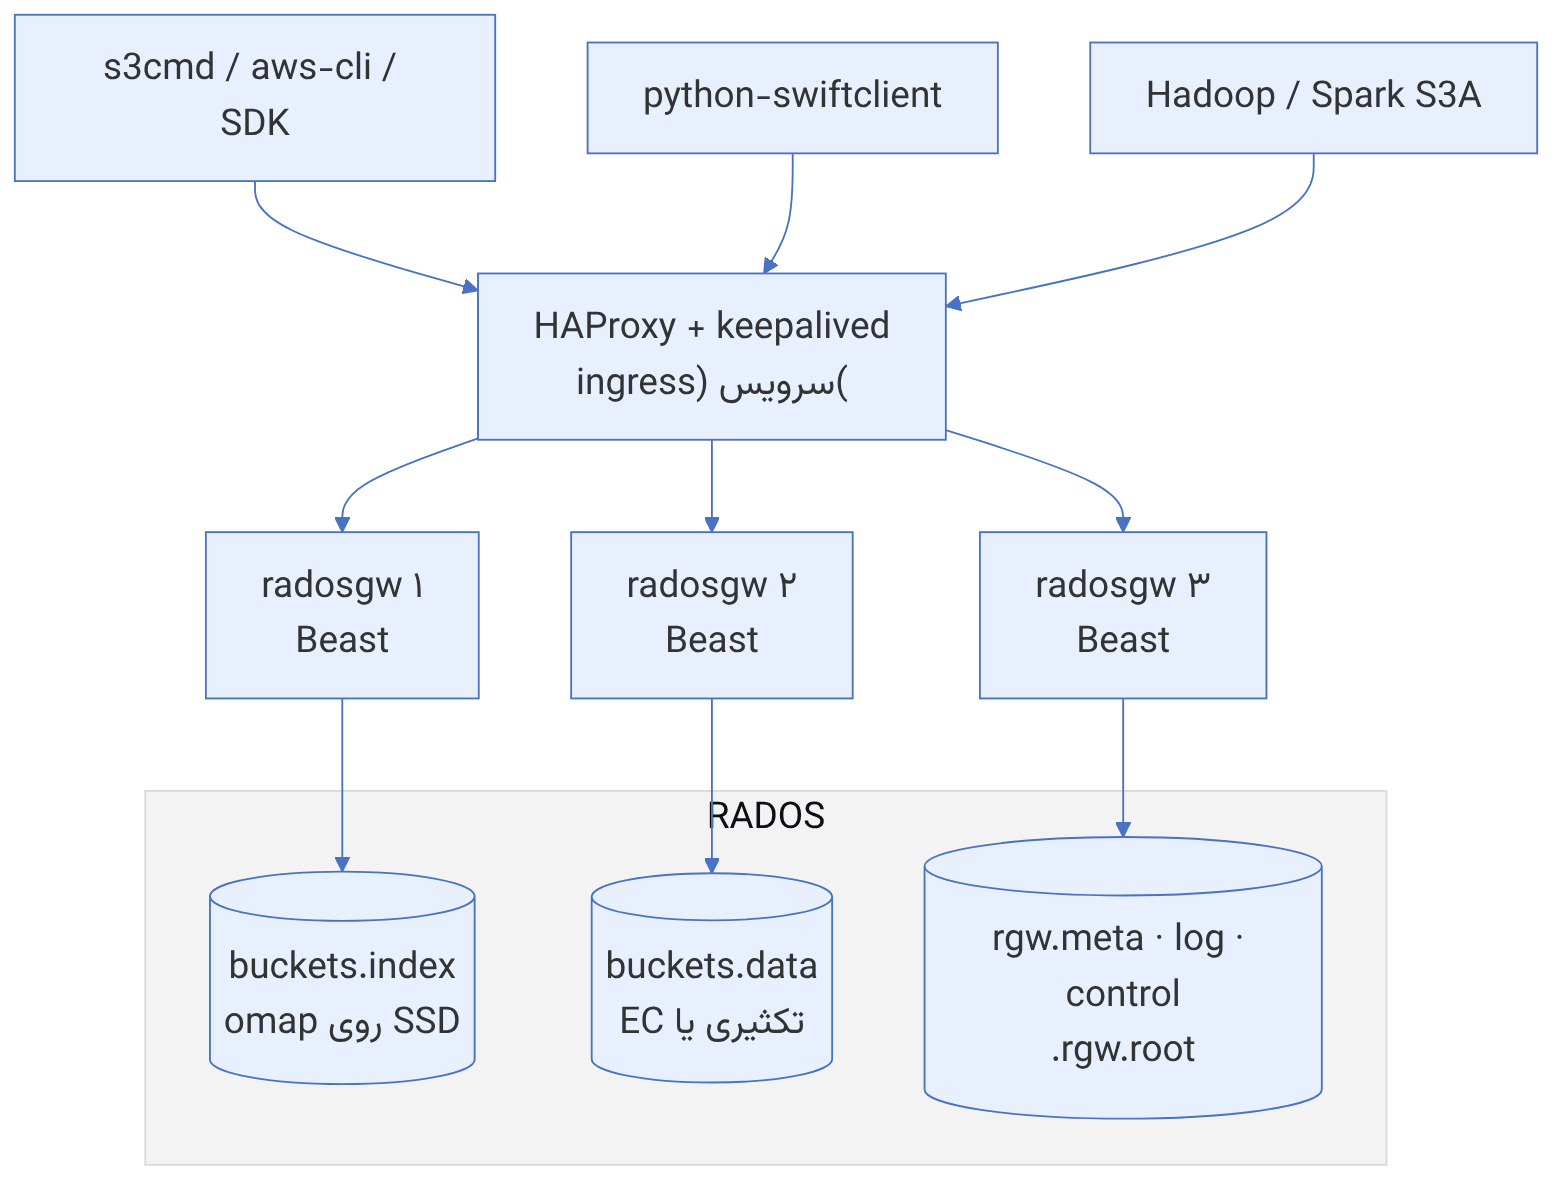
۴-۲-۳ poolهای RGW#
RGW در یک استقرار ساده (zone پیشفرض) این poolها را میسازد:
| pool | محتوا | توصیه |
|---|---|---|
.rgw.root | تعریف realm، zonegroup و zone | کوچک؛ تکثیری |
default.rgw.control | اشیای watch/notify برای هماهنگی cache بین نمونهها | کوچک |
default.rgw.meta | فرادادهی کاربران و bucketها | روی SSD در صورت امکان |
default.rgw.log | لاگهای همگامسازی، lifecycle، usage | کوچک تا متوسط |
default.rgw.buckets.index | index هر bucket در omap | حتماً روی SSD/NVMe و تکثیری |
default.rgw.buckets.data | دادهی اشیاء | تکثیری یا EC؛ بزرگترین pool |
default.rgw.buckets.non-ec | فرادادهی بارگذاری چندبخشی | تکثیری |
pool index را هرگز erasure-coded نکنید (EC از omap پشتیبانی نمیکند) و آن را روی HDD نگذارید. هر PUT و DELETE یک بهروزرسانی omap در index است و index کند یعنی کل RGW کند. یک قاعدهی CRUSH مبتنی بر device class برای index روی NVMe یکی از مؤثرترین بهینهسازیهای RGW است.
۴-۲-۴ شیء S3 در RADOS#
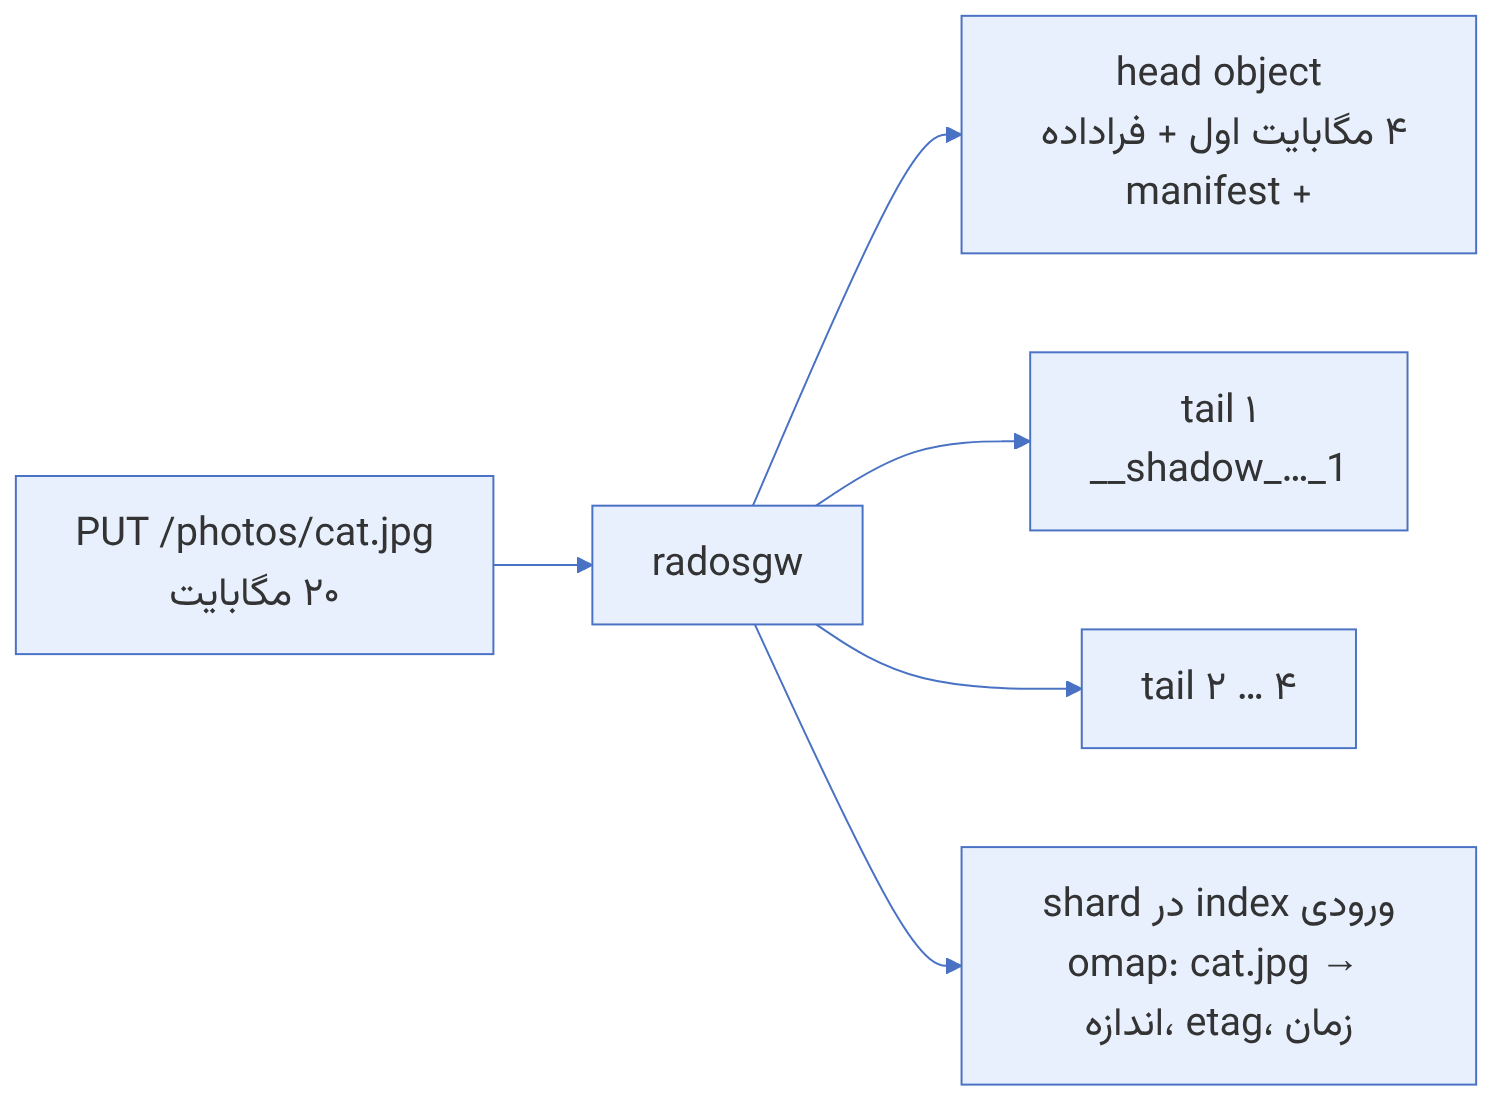
- head object: نخستین بخش داده (بهطور پیشفرض تا ۴ مگابایت؛
rgw_max_chunk_size) بههمراه فرادادهی شیء در xattr و یک manifest که فهرست بقیهی قطعات را دارد. - tail objects: بقیهی داده در اشیای جداگانه (نامهایی با پیشوند
__shadow_ یا در بارگذاری چندبخشی __multipart_). - ورودی index: یک کلید در omap یکی از shardهای index bucket؛ برای فهرستگیری (ListObjects) استفاده میشود.
چون index هر bucket در omap اشیای RADOS است، یک bucket با صدها میلیون شیء اگر shard نشود، یک شیء omap غولپیکر میسازد که scrub، بازیابی و حتی عملیات عادی را کند میکند و هشدار LARGE_OMAP_OBJECTS میدهد. resharding پویا (پیشفرض از Luminous) با رسیدن تعداد اشیاء هر shard به آستانهی rgw_max_objs_per_shard (پیشفرض ۱۰۰٬۰۰۰) تعداد shardها را خودکار افزایش میدهد. در Tentacle بیشتر پردازش reshard پیش از قفل کردن نوشتنها انجام میشود تا اثرش بر کلاینتها کمتر شود.
۴-۳ استقرار و پیکربندی RADOS Gateway#
۴-۳-۱ استقرار با cephadm#
در گذشته RGW را دستی با بستهها و ceph-deploy روی یک node جداگانه نصب میکردند. با cephadm یک دستور کافی است:
ceph orch host label add ceph-node4 rgw
ceph orch host label add ceph-node3 rgw
ceph orch apply rgw objstore --placement="label:rgw count-per-host:1" --port=8080
ceph orch ls rgw
ceph orch ps --daemon-type rgw
curl http://ceph-node4:8080
پاسخ خالی ListAllMyBucketsResult با کاربر anonymous یعنی RGW بالاست. برای کنترل بیشتر، از spec به زبان YAML استفاده کنید:
service_type: rgw
service_id: objstore
placement:
  label: rgw
  count_per_host: 2
networks:
  - 192.168.56.0/24
spec:
  rgw_frontend_port: 8080
  rgw_frontend_type: beast
۴-۳-۲ load balancer با سرویس ingress#
cephadm یک سرویس ingress دارد که HAProxy و keepalived را مستقر میکند و یک IP مجازی جلوی نمونههای RGW قرار میدهد:
service_type: ingress
service_id: rgw.objstore
placement:
  hosts: [ceph-node3, ceph-node4]
spec:
  backend_service: rgw.objstore
  virtual_ip: 192.168.56.100/24
  frontend_port: 443
  monitor_port: 1967
ssl: trueceph orch apply -i ingress.yaml
ceph orch ls ingressدر نسخههای جدید (Tentacle و Umbrella) زیرسیستم certmgr در cephadm گواهیهای امضاشده توسط cephadm را برای چنین سرویسهایی خودکار تولید و تمدید میکند، یا گواهی شما را میپذیرد و برای گواهیهای در آستانهی انقضا هشدار سلامت میدهد.
در production، TLS را یا در load balancer پایان دهید یا در خود Beast (با rgw_frontend_ssl_certificate). اگر در HAProxy پایان میدهید، مطمئن شوید RGW نشانی واقعی کلاینت را از هدر X-Forwarded-For میخواند (rgw_remote_addr_param = http_x_forwarded_for)؛ وگرنه سیاستهای مبتنی بر IP و لاگها نشانی load balancer را میبینند.
اگر پس از apply نمونهای از RGW بالا نیامد، ceph orch ps --daemon-type rgw و ceph health detail را ببینید. شایعترین دلیل در کلاسترهای کوچک، هشدار TOO_MANY_PGS یا خطای ساخت pool به دلیل رسیدن به mon_max_pg_per_osd است، چون RGW چند pool تازه میسازد. راه دیگر بررسی، cephadm logs --name rgw.objstore.ceph-node4.xxxx روی میزبان است.
۴-۴ کاربران، کلیدها و مستاجرها#
۴-۴-۱ ساختن کاربر radosgw#
کاربران RGW مستقل از کاربران cephx هستند و در pool فرادادهی RGW نگه داشته میشوند. ابزار مدیریت آنها radosgw-admin است:
radosgw-admin user create --uid=alice --display-name="Alice" --email=alice@example.com
radosgw-admin user info --uid=alice
radosgw-admin user list
radosgw-admin key create --uid=alice --key-type=s3 --gen-access-key --gen-secret
radosgw-admin user suspend --uid=alice
radosgw-admin user enable --uid=alice
خروجی user create یک جفت access_key و secret_key دارد که کلاینت S3 برای امضای درخواستها (AWS Signature v4) استفاده میکند.
خروجی radosgw-admin user info کلید محرمانه را بهصورت متن ساده نشان میدهد. آن را در تیکت، چت یا لاگ CI کپی نکنید. برای تحویل کلید به تیمها از یک سامانهی مدیریت رمز (مثلاً Vault) استفاده کنید و کلیدهای قدیمی را دورهای چرخش دهید (key create و سپس key rm).
۴-۴-۲ سهمیه و محدودیت نرخ#
radosgw-admin quota set --quota-scope=user --uid=alice --max-size=500G --max-objects=10000000
radosgw-admin quota enable --quota-scope=user --uid=alice
radosgw-admin quota set --quota-scope=bucket --uid=alice --max-objects=5000000
radosgw-admin quota enable --quota-scope=bucket --uid=alice
radosgw-admin ratelimit set --ratelimit-scope=user --uid=alice --max-read-ops=1000 --max-write-ops=200
radosgw-admin ratelimit enable --ratelimit-scope=user --uid=alice
محدودیت نرخ از Quincy اضافه شده است و در Umbrella پاسخ محدودیت نرخ هدر Retry-After هم دارد که کلاینتهای خوشرفتار برای عقبنشینی از آن استفاده میکنند.
۴-۴-۳ subuser و کلید Swift#
API Swift از مفهوم subuser استفاده میکند: هویتی زیرمجموعهی یک کاربر با سطح دسترسی مشخص و کلید مخصوص Swift.
radosgw-admin subuser create --uid=alice --subuser=alice:swift --access=full
radosgw-admin key create --subuser=alice:swift --key-type=swift --gen-secret
۴-۴-۴ tenant و account#
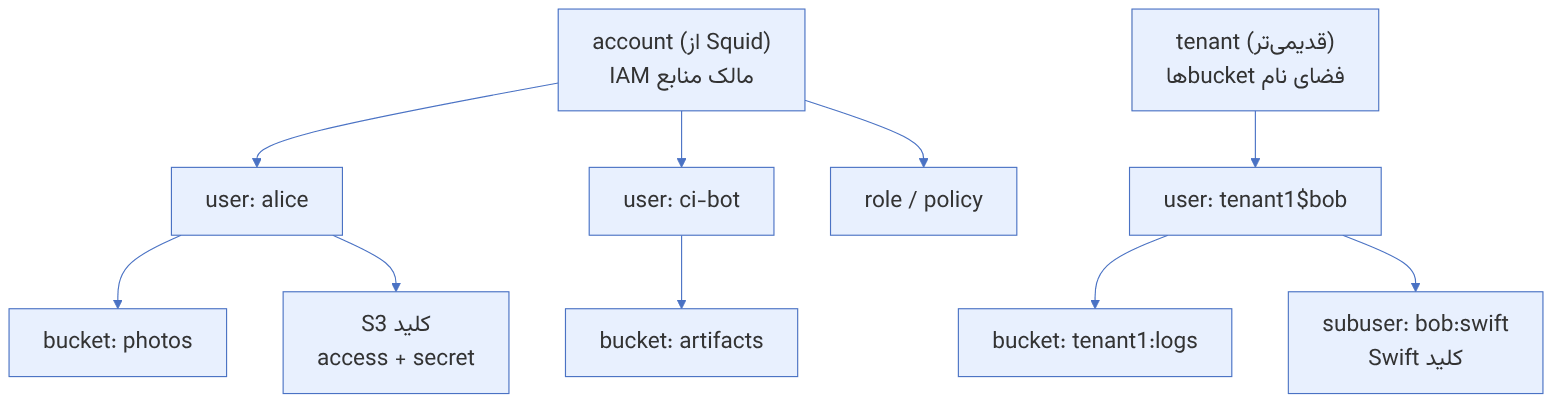
در RGW نام bucketها بهطور پیشفرض در کل کلاستر یکتاست. tenant یک فضای نام جداگانه میسازد تا دو مشتری بتوانند bucket همنام داشته باشند:
radosgw-admin user create --tenant=acme --uid=bob --display-name="Bob at ACME"
# نام کامل کاربر: acme$bob ، و bucketها در فضای acme
از Squid، account مفهومی شبیه حساب AWS اضافه کرده است: یک account مالک کاربران، گروهها، نقشها و سیاستهاست و «کاربر ریشه»ی آن میتواند از طریق APIهای سازگار با IAM، بدون دخالت مدیر کلاستر، کاربران و کلیدها را مدیریت کند.
radosgw-admin account create --account-name=acme --email=ops@acme.example
radosgw-admin user create --uid=acme-root --display-name="ACME root" \
  --account-id=<account-id> --account-root --gen-secret --gen-access-key
radosgw-admin quota set --quota-scope=account --account-id=<account-id> --max-size=10T
radosgw-admin quota enable --quota-scope=account --account-id=<account-id>یادداشتهای انتشار Tentacle اعلام میکنند که قابلیتهای IAM مبتنی بر tenant (مانند CreateRole و PutUserPolicy در سطح tenant و STS Lite) به نفع account منسوخ شدهاند و زودتر از نسخهی V حذف نخواهند شد. خود tenant برای جداسازی فضای نام باقی میماند. برای طراحی تازهی چندمستاجری، از account شروع کنید.
۴-۵ دسترسی با API سازگار با S3#
۴-۵-۱ DNS و دسترسی virtual-host#
S3 دو سبک نشانیدهی دارد: path-style (https://s3.example.com/bucket/key) و virtual-hosted-style (https://bucket.s3.example.com/key). بسیاری از SDKهای جدید پیشفرض را سبک دوم گذاشتهاند. برای پشتیبانی از آن:
- ۱. یک رکورد wildcard در DNS بسازید:
*.s3.example.com به IP مجازی load balancer. - ۲. به RGW بگویید نام دامنهاش چیست:
ceph config set client.rgw rgw_dns_name s3.example.com
ceph orch restart rgw.objstore
در استقرار چند zonegroup، نامهای میزبان در فیلد hostnames تعریف zonegroup قرار میگیرند (فصل ۵). گواهی TLS هم باید wildcard (*.s3.example.com) باشد.
۴-۵-۲ s3cmd#
sudo dnf install -y s3cmd      # یا pip install s3cmd
s3cmd --configure              # access key، secret key و endpoint
# یا مستقیم در ~/.s3cfg:
cat > ~/.s3cfg <<'C'
[default]
access_key = <ACCESS>
secret_key = <SECRET>
host_base = s3.example.com
host_bucket = %(bucket)s.s3.example.com
use_https = True
C
s3cmd mb s3://photos
s3cmd put cat.jpg s3://photos/
s3cmd ls s3://photos
s3cmd get s3://photos/cat.jpg /tmp/cat.jpg
s3cmd info s3://photos/cat.jpg
۴-۵-۳ aws-cli و SDKها#
aws configure --profile ceph                      # کلیدها
aws --profile ceph --endpoint-url https://s3.example.com s3 mb s3://backups
aws --profile ceph --endpoint-url https://s3.example.com s3 cp ./db.dump s3://backups/
aws --profile ceph --endpoint-url https://s3.example.com s3api list-objects-v2 --bucket backups
aws --profile ceph --endpoint-url https://s3.example.com s3 presign s3://backups/db.dump --expires-in 3600برخی نسخههای جدید SDKهای AWS بهطور پیشفرض checksumهای جدید یکپارچگی داده (مثل CRC32 در هدرهای x-amz-checksum-*) را برای هر PUT میفرستند. پشتیبانی RGW از این قابلیتها در نسخههای مختلف متفاوت است؛ اگر پس از ارتقای SDK خطای امضا یا «InvalidArgument» دیدید، یادداشتهای انتشار نسخهی RGW خود را بررسی کنید و در صورت لزوم در پیکربندی کلاینت، ارسال checksum را به حالت «فقط وقتی لازم است» برگردانید. یادداشتهای Umbrella هم یک رگرسیون SigV4 در نسخههای ۱۹.۲.۶ و ۲۰.۲.۴ را گزارش میکنند که بارگذاریهای presigned PUT با Content-Type امضانشده را رد میکرد و اصلاح شده است.
۴-۵-۴ بارگذاری چندبخشی#
برای اشیای بزرگ (معمولاً بالای ۱۰۰ مگابایت) از multipart upload استفاده کنید؛ aws-cli و s3cmd خودکار این کار را انجام میدهند. بارگذاریهای نیمهکاره فضا اشغال میکنند و در فهرست اشیاء دیده نمیشوند. یک قاعدهی lifecycle برای پاک کردنشان اضافه کنید (AbortIncompleteMultipartUpload) و گاهی با radosgw-admin bucket list --bucket=<b> یا aws s3api list-multipart-uploads بررسیشان کنید.
۴-۶ دسترسی با API Swift#
pip install python-swiftclient
swift -A http://s3.example.com:8080/auth/1.0 -U alice:swift -K '<SWIFT_SECRET>' stat
swift -A http://s3.example.com:8080/auth/1.0 -U alice:swift -K '<SWIFT_SECRET>' post container01
swift -A http://s3.example.com:8080/auth/1.0 -U alice:swift -K '<SWIFT_SECRET>' upload container01 report.pdf
swift -A http://s3.example.com:8080/auth/1.0 -U alice:swift -K '<SWIFT_SECRET>' list container01bucketها در S3 و containerها در Swift یک چیزند: فایلی که با Swift بارگذاری شده با S3 هم دیده میشود (به شرطی که کاربر یکی باشد).
۴-۷ یکپارچهسازی با OpenStack Keystone#
در ابرهای OpenStack معمولاً میخواهیم کاربران با همان هویت Keystone به ذخیرهسازی شیء دسترسی داشته باشند و RGW در catalog بهعنوان سرویس object-store ثبت شود.
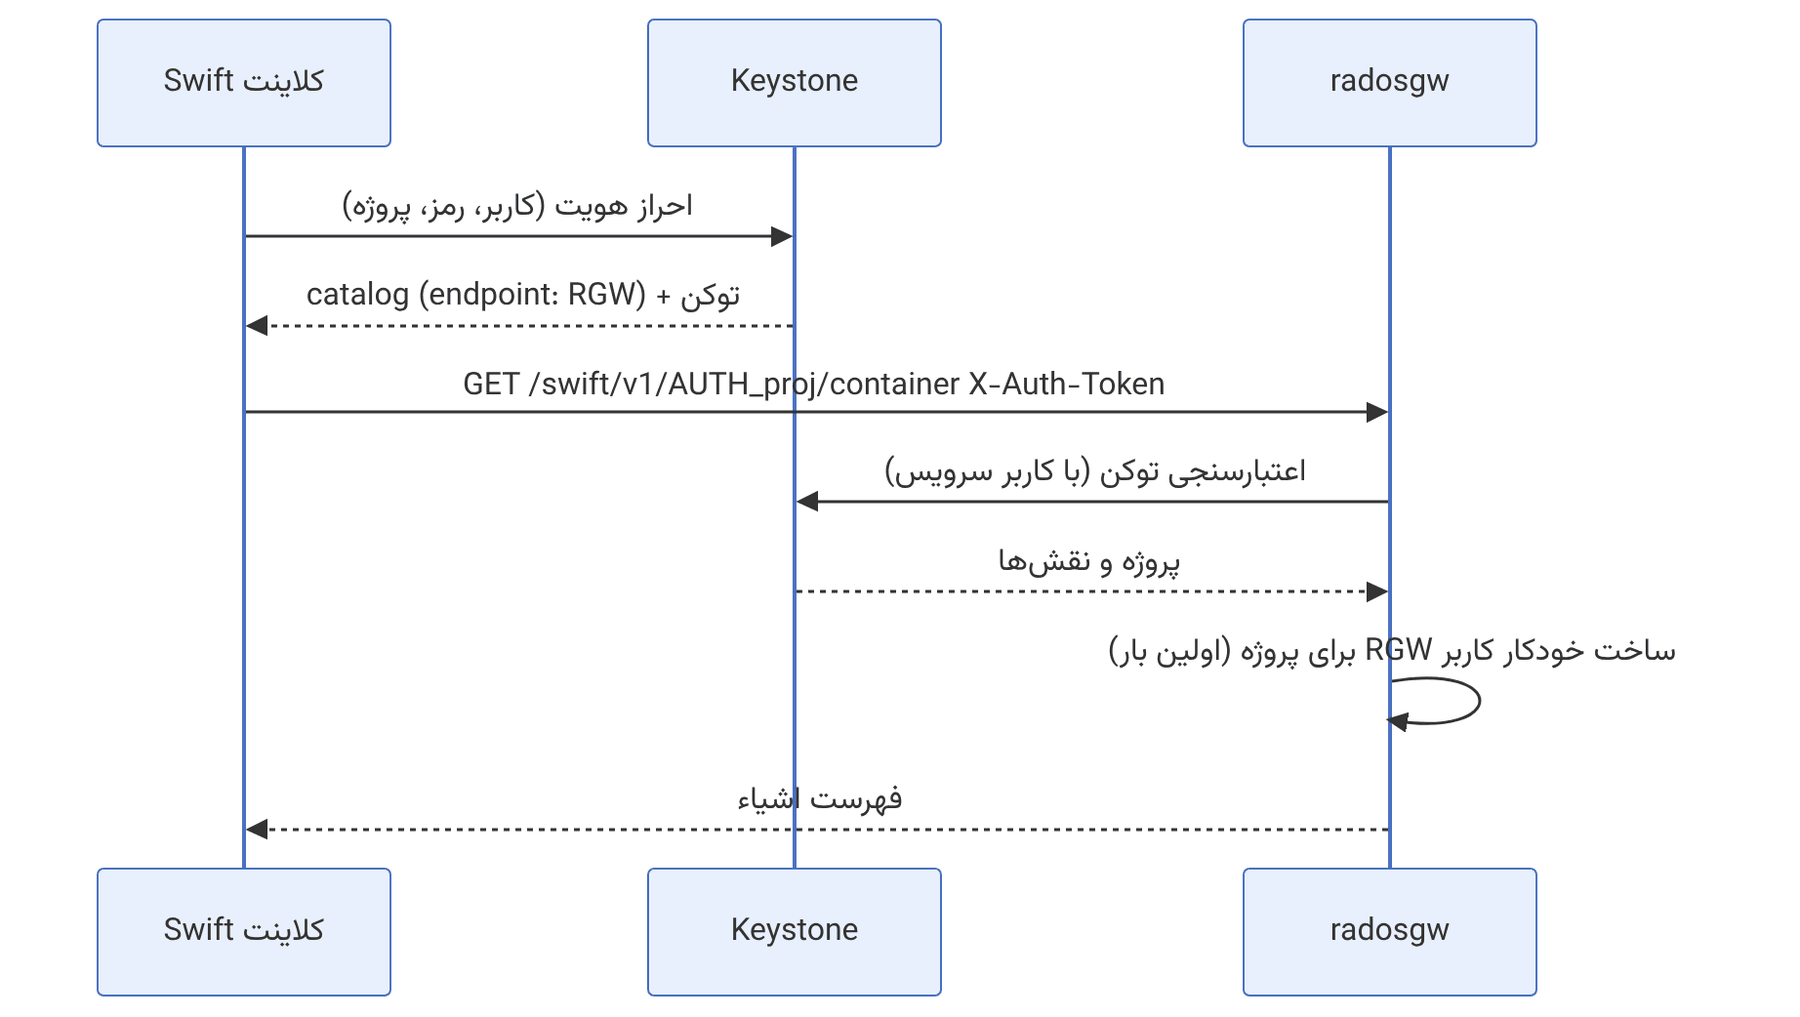
# در Keystone
openstack service create --name swift --description "Ceph RGW" object-store
openstack endpoint create --region RegionOne object-store public \
  "https://s3.example.com/swift/v1/AUTH_%(project_id)s"
# در Ceph
ceph config set client.rgw rgw_keystone_url https://keystone.example.com:5000
ceph config set client.rgw rgw_keystone_api_version 3
ceph config set client.rgw rgw_keystone_admin_user rgw
ceph config set client.rgw rgw_keystone_admin_password_path /etc/ceph/keystone.pass
ceph config set client.rgw rgw_keystone_admin_domain Default
ceph config set client.rgw rgw_keystone_admin_project service
ceph config set client.rgw rgw_keystone_accepted_roles "member,admin"
ceph config set client.rgw rgw_keystone_implicit_tenants true
ceph config set client.rgw rgw_swift_account_in_url true
ceph config set client.rgw rgw_s3_auth_use_keystone trueمستندات RGW گزینهی rgw_keystone_admin_password_path را به گذاشتن رمز بهصورت متن ساده در پیکربندی ترجیح میدهند. با cephadm میتوانید فایل را از طریق extra_container_args/mount یا ceph config-key در اختیار کانتینر بگذارید. rgw_s3_auth_use_keystone امکان استفاده از اعتبارنامههای EC2 در Keystone (openstack ec2 credentials create) برای S3 را فراهم میکند. در Umbrella، الزام قدیمی admin token برای Keystone حذف شده و نقشهای Keystone به محیط ارزیابی سیاست IAM تزریق میشوند.
۴-۸ یکپارچهسازی با Hadoop و Spark از طریق S3A#
اکوسیستم Hadoop از طریق کانکتور S3A به هر سرویس سازگار با S3 وصل میشود. این یعنی میتوانید HDFS را برای ذخیرهسازی سرد یا حتی اصلی با RGW جایگزین کنید و محاسبه و ذخیرهسازی را از هم جدا مقیاس دهید.
<!-- core-site.xml -->
<property><name>fs.s3a.endpoint</name><value>https://s3.example.com</value></property>
<property><name>fs.s3a.path.style.access</name><value>true</value></property>
<property><name>fs.s3a.access.key</name><value>ACCESS</value></property>
<property><name>fs.s3a.secret.key</name><value>SECRET</value></property>
<property><name>fs.s3a.connection.ssl.enabled</name><value>true</value></property>
<property><name>fs.s3a.committer.name</name><value>magic</value></property>hadoop fs -mkdir s3a://analytics/raw
hadoop fs -put events.parquet s3a://analytics/raw/
spark-submit --conf spark.hadoop.fs.s3a.endpoint=https://s3.example.com job.pyنوشتن خروجی کارهای Spark روی ذخیرهسازی شیء چالش «rename» دارد: commit سنتی Hadoop پوشهی موقت را rename میکند که در S3 یعنی کپی و حذف همهی اشیاء. S3A committers (مثل directory و magic) این مشکل را با بارگذاری چندبخشی که فقط در لحظهی commit نهایی میشود حل میکنند. برای بارهای سنگین تحلیلی روی RGW حتماً یکی از این committerها را فعال کنید. اسناد خود Hadoop دربارهی پیشنیازهای سازگاری (مثلاً پشتیبانی از multipart و فهرستگیری سازگار) راهنمای خوبی است؛ RGW سازگاری قوی read-after-write دارد.
۴-۹ از درون کد: bucket index، manifest و مسیر PUT در RGW#
۴-۹-۱ دو جای جدا برای یک شیء S3#
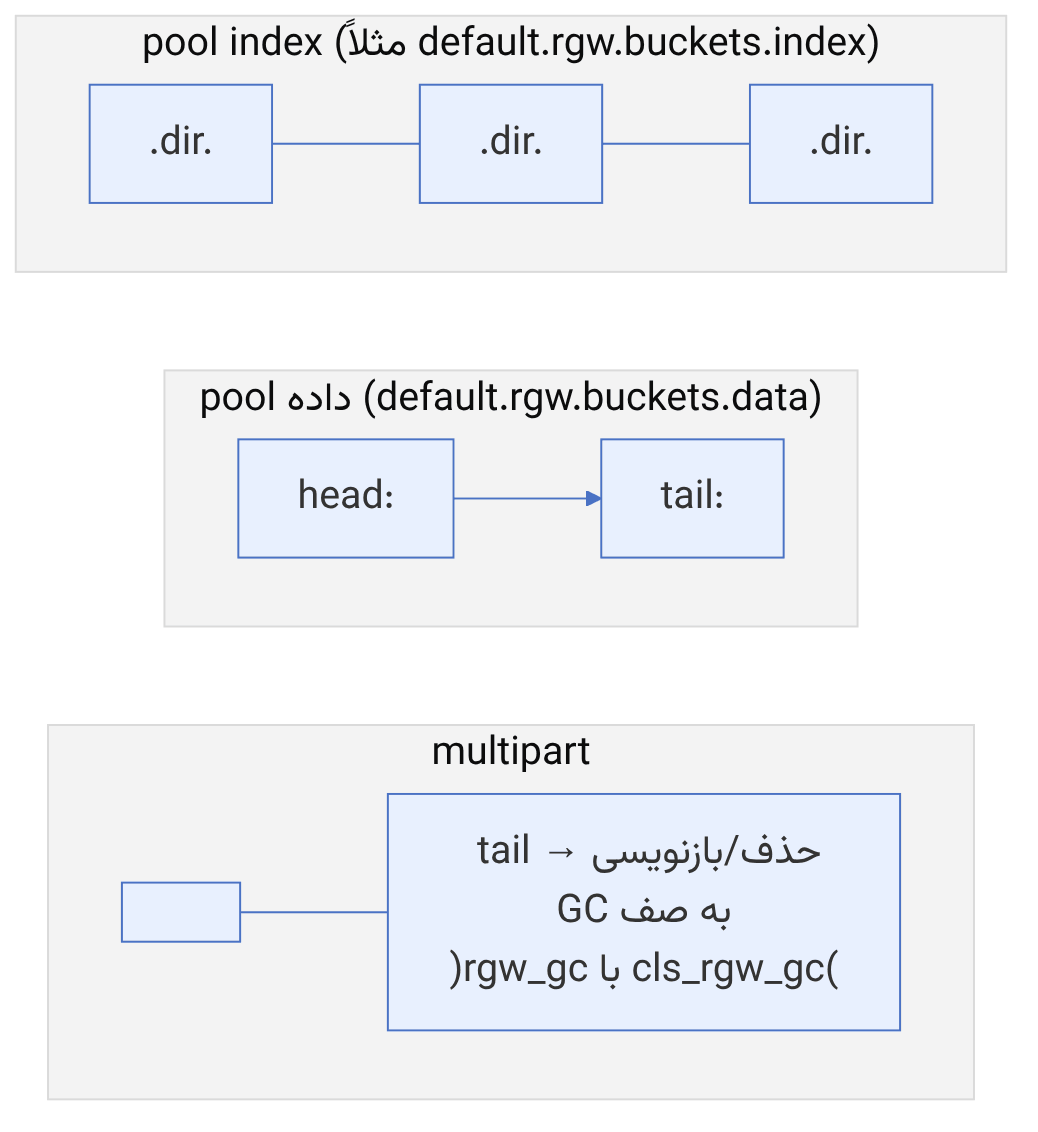
RGW هر شیء S3 را در دو مکان مستقل ثبت میکند. یکی ورودی bucket index است که در omap اشیای شارد در pool index قرار دارد و برای List و آمار bucket استفاده میشود. دیگری خود داده است که در pool داده به شکل یک head و صفر یا چند tail ذخیره میشود. هماهنگ نگه داشتن این دو، بدون تراکنش توزیعشده، با یک پروتکل دومرحلهای سبک روی کلاس cls_rgw انجام میشود.
| ثابت/گزینه | مقدار (main) | منبع |
|---|---|---|
| پیشوند شیء شارد index | .dir. | rgw/services/svc_bi_rados.cc |
| تعداد شارد پیشفرض bucket جدید | ۱۱ | default_bucket_index_max_shards در rgw_zone_types.h |
| rgw_override_bucket_index_max_shards | ۰ (یعنی مقدار zonegroup) | rgw.yaml.in |
| rgw_dynamic_resharding | true | rgw.yaml.in |
| rgw_max_objs_per_shard | ۱۰۰۰۰۰ | آستانهی resharding پویا |
| rgw_safe_max_objects_per_shard | ۱۰۲۴۰۰ | آستانهی هشدار bucket limit check |
| rgw_max_chunk_size | ۴_M | بیشینهی داده در head |
| rgw_obj_stripe_size | ۴_M | اندازهی هر stripe در tail |
| rgw_bucket_index_max_aio | ۱۲۸ | موازیسازی عملیات روی شاردها |
حالتهای ورودی index در cls_rgw_types.h: CLS_RGW_STATE_PENDING_MODIFY = 0، CLS_RGW_STATE_COMPLETE = 1، CLS_RGW_STATE_UNKNOWN = 2.
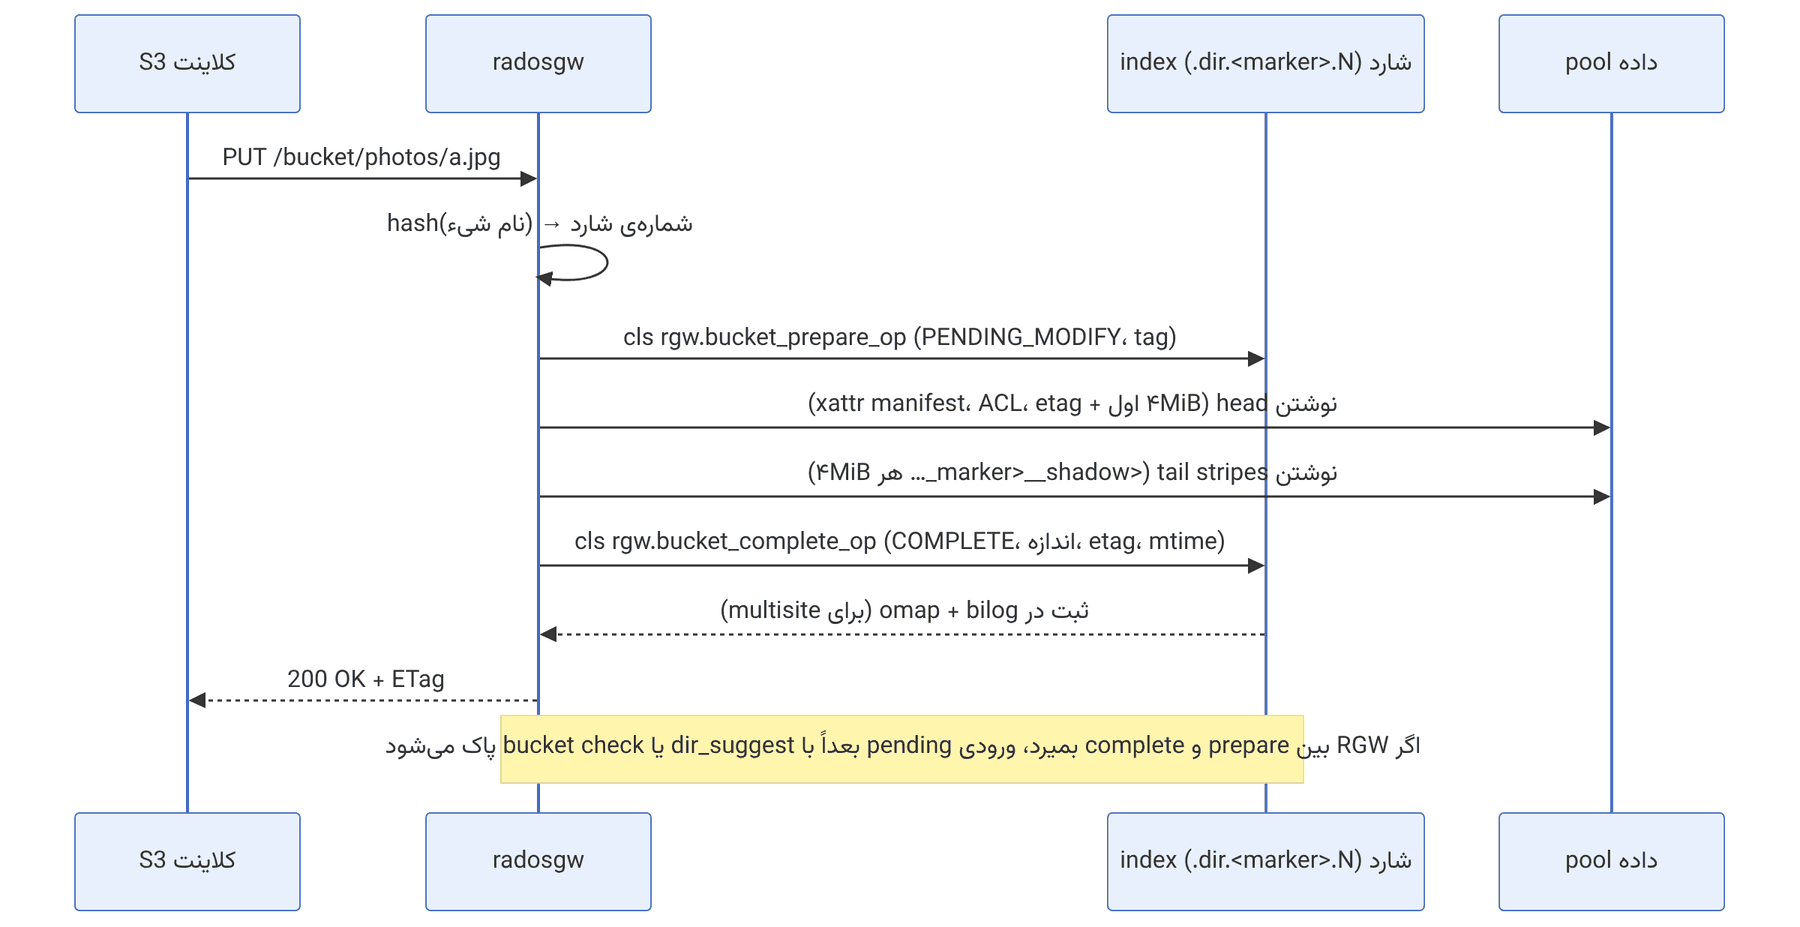
pseudocode: put_obj (خلاصهی این کتاب از rgw_rados.cc و cls_rgw.cc)
shard = hash(key) % num_shards
tag = unique_op_tag()
cls_call(index[shard], "rgw.bucket_prepare_op", {key, tag, op=ADD})
write head oid="<marker>_<key>" data[0:4MiB], xattrs{manifest, acl, etag}
for i, chunk in stripes(data[4MiB:], 4MiB):
write tail oid="<marker>__shadow_<prefix>_<i>"
cls_call(index[shard], "rgw.bucket_complete_op", {key, tag, size, etag, mtime})
# درون OSD: ورودی COMPLETE + بهروزرسانی header آمار + bilog entry
if old version existed: enqueue old tail to GCچرا bucketهای بسیار بزرگ کند میشوند: List با ترتیب الفبایی باید از همهی شاردها بخواند و نتایج را merge کند؛ هزینهی آن با تعداد شارد رشد میکند. از طرف دیگر، شارد بیش از حد بزرگ (میلیونها کلید omap) باعث کندی compaction در RocksDB، scrub طولانی و هشدار LARGE_OMAP_OBJECTS میشود. dynamic resharding تعادل این دو را خودکار برقرار میکند، ولی در multisite فقط وقتی کار میکند که zone feature به نام resharding در zonegroup فعال باشد (ثابت آن در rgw/rgw_zone_features.h تعریف شده است؛ بررسی: radosgw-admin zonegroup get | jq .enabled_features).
فرمانهای بررسی:
radosgw-admin bucket stats --bucket=photos | jq '.num_shards, .usage'
radosgw-admin bucket limit check | jq '.[].buckets[] | select(.fill_status!="OK")'
radosgw-admin reshard list ; radosgw-admin reshard status --bucket=photos
radosgw-admin object stat --bucket=photos --object=a.jpg | jq '.manifest'
radosgw-admin bucket check --bucket=photos --check-objects   # بدون --fix فقط گزارش
radosgw-admin gc list --include-all | jq length
ceph health detail | grep -A3 LARGE_OMAPPUT و multipart در RGW
یک کلید و اندازه بدهید و یک PUT ی S3 را از radosgw تا bucket index و data pool، همراه با شیءهای RADOS که میسازد، دنبال کنید.
- PUT کلاینت PUT /bucket/photos/2026/11/img_0001.jpg را با ۱۰ MiB داده میفرستد؛ RGWPutObj::execute آغاز میشود.
RGWPutObj::execute (rgw_op.cc) - احراز هویت امضای AWS (اینجا v4) بررسی و مجوزهای کاربر روی bucket ارزیابی میشود.
rgw::auth::s3::AWSAuthStrategy, AWSv4ComplSingle (rgw_auth_s3.cc) - stripeهای دُم همزمان با رسیدن بدنه، processor تعداد ۲ شیء دُم ۴ MiB در data pool مینویسد.
AtomicObjectProcessor::process, RadosWriter::process - آمادهسازی index rgw_bucket_prepare_op یک ورودی معلق برای photos/2026/11/img_0001.jpg روی shard ۵ از ۱۱ میگذارد تا اگر همین حالا crash رخ دهد ردی برای پاکسازی بماند.
RGWRados::Bucket::UpdateIndex::prepare, cls_rgw rgw_bucket_prepare_op - نوشتن head شیء head با یک write_full همراه ۴ MiB نخست، manifest و attributeها (ETag، ACL و content type) نوشته میشود.
RGWRados::Object::Write::_do_write_meta (write_full + xattrs) - تکمیل index rgw_bucket_complete_op ورودی معلق را به شیئی فهرستشده روی shard ۵ تبدیل میکند و برای همگامسازی به bucket index log میافزاید.
UpdateIndex::complete, rgw_bucket_complete_op (+ bilog) - 200 OK radosgw با 200 و ETag پاسخ میدهد؛ شیء حالا در فهرستها دیده میشود.
RGWPutObj_ObjStore_S3::send_response (rgw_rest_s3.cc)
شیءهای RADOS این بارگذاری
- MARKER_photos/2026/11/img_0001.jpg۴ MiB + xattrs
- MARKER__shadow_.RAND32_1۴ MiB
- MARKER__shadow_.RAND32_2۲ MiB
اندازههای پیشفرض: head تا ۴ MiB (rgw_max_chunk_size)، stripeها ۴ MiB (rgw_obj_stripe_size) و هر part دستکم ۵ MiB (rgw_multipart_min_part_size).
مطابق با:
src/rgw/rgw_op.cc :: RGWPutObj::execute, RGWCompleteMultipart::executeعملیات PUT و تکمیل multipartsrc/rgw/driver/rados/rgw_putobj_processor.cc :: AtomicObjectProcessor, MultipartObjectProcessorنوشتن head، stripeها و partهاsrc/rgw/driver/rados/rgw_rados.cc :: Object::Write::_do_write_meta, Bucket::UpdateIndex::prepare / completeنوشتن head و بهروزرسانی indexsrc/cls/rgw/cls_rgw.cc :: rgw_bucket_prepare_op, rgw_bucket_complete_opدو عملیات index روی OSDsrc/rgw/services/svc_bi_rados.h :: bucket_shard_index; src/common/ceph_hash.cc :: ceph_str_hash_linuxهر کلید به کدام shard ی bucket index میرودsrc/rgw/driver/rados/rgw_obj_manifest.cc :: RGWObjManifest (head, stripes, rgw_obj_stripe_size 4M)چیدمان شیء در RADOS
۴-۱۰ RGW با عدد: shard ایندکس، reshard، فهرستگیری و manifest#
چهار الگوریتم این بخش تعیین میکنند یک شیء S3 در کدام شیء ایندکس ثبت شود، bucket کی و به چند shard تقسیم شود، فهرستگیری مرتب از bucket چقدر داده از OSDها میخواند و بایتهای خود شیء در چه شیءهای RADOS با چه نامی ذخیره شوند. همهی ارجاعها به main در نوامبر ۲۰۲۶ است و عددها با بازپیادهسازی پایتونی همان توابع حساب شدهاند. منطق کاهش shard در reshard پویا و جزئیات چند ضریب در نسخههای اخیر اضافه یا عوض شدهاند. پیش از تکیه بر آنها، کد نسخهی خود را بررسی کنید.
۴-۱۰-۱ انتخاب shard ایندکس#
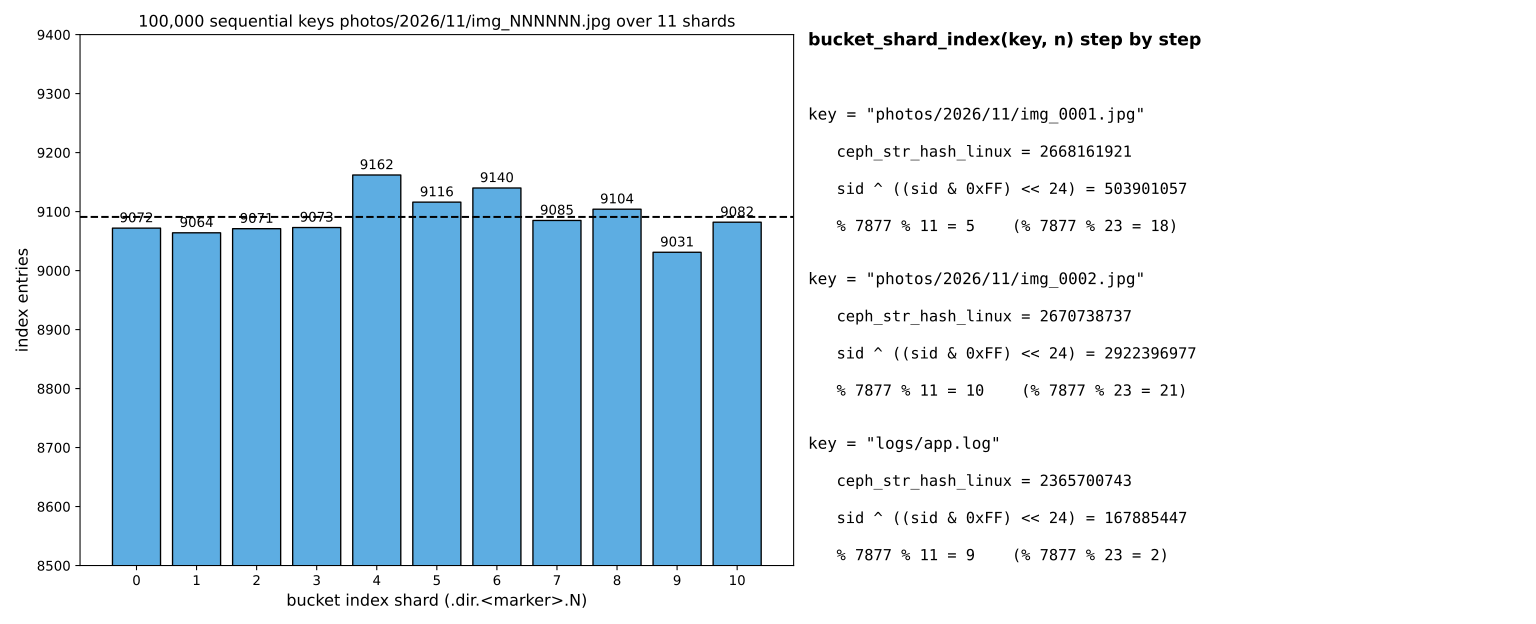
منبع در کد: src/rgw/services/svc_bi_rados.h :: RGWSI_BucketIndex_RADOS::bucket_shard_index؛ src/rgw/driver/rados/rgw_tools.h :: rgw_shards_mod؛ src/common/ceph_hash.cc :: ceph_str_hash_linux
پیچیدگی: O(طول کلید)
pseudocode
key = نام شیء (برای قطعههای multipart: کلید شیء نهایی، تا همهی قطعهها در یک shard باشند)
sid = ceph_str_hash_linux(key) # hash = (hash + (c<<4) + (c>>4)) × 11 برای هر بایت
sid2 = sid XOR ((sid AND 0xFF) << 24) # بیتهای کمارزش را به بالا میبرد
shard = n ≤ 7877 ? sid2 mod 7877 mod n : sid2 mod 65521 mod n
oid ایندکس = ".dir." + bucket_marker + "." + shard (با نسل لایه، ".dir.<marker>.<gen>.<shard>")مثال عددی. برای کلید photos/2026/11/img_0001.jpg، مقدار ceph_str_hash_linux عدد ۲۶۶۸۱۶۱۹۲۱ است. بایت پایین آن ۰x81 است و پس از XOR با ۰x81000000 عدد ۵۰۳۹۰۱۰۵۷ به دست میآید. ۵۰۳۹۰۱۰۵۷ mod 7877 mod 11 = ۵، پس با ۱۱ shard (پیشفرض zonegroup برای bucket تازه) ورودی در .dir.<marker>.5 مینشیند. کلید بعدی، img_0002.jpg، به shard ۱۰ میرود و logs/app.log به shard ۹. اگر bucket به ۲۳ shard برود، همین سه کلید به shardهای ۱۸، ۲۱ و ۲ جابهجا میشوند. به همین دلیل reshard باید همهی ورودیها را بازنویسی کند. برای ۱۰۰۰۰۰ کلید پشتسرهم با الگوی img_NNNNNN.jpg، کمترین shard ۹۰۳۱ و بیشترین ۹۱۶۲ ورودی گرفت، یعنی ±۱ درصد حول میانگین ۹۰۹۱. این hash ضعیف است، اما برای نامهای معمولی پخش خوبی میدهد.
۴-۱۰-۲ reshard پویا: کی و به چند shard؟#
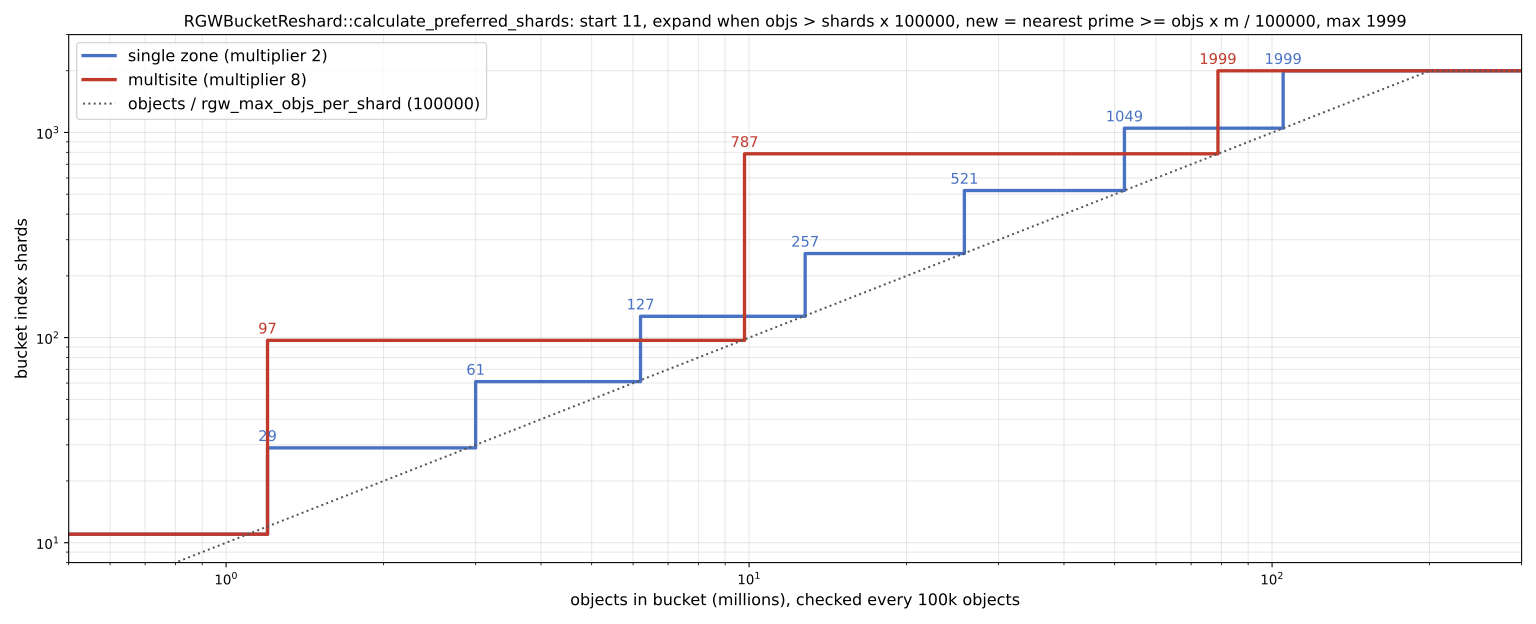
منبع در کد: src/rgw/driver/rados/rgw_reshard.cc :: RGWBucketReshard::calculate_preferred_shards، nearest_prime
پیچیدگی: O(log P) برای جستوجو در فهرست ۳۰۴ عدد اول تا ۱۹۹۹
pseudocode
max_objs = rgw_max_objs_per_shard (100000) ; max_dyn = rgw_max_dynamic_shards (1999) ; min_dyn = 11
min_objs = min(10000, ceil(max_objs / 100)) # آستانهی کاهش: 1000
if cur < max_dyn and objs > cur × max_objs: افزایش
elif cur > min_dyn and objs < cur × min_objs: کاهش (اگر rgw_dynamic_resharding_may_reduce، با تأخیر)
else: کاری نکن
m = multisite ? 8 : 2
new = clamp(objs × m / max_objs, min_dyn, max_dyn) ; new = کوچکترین عدد اول ≥ new در فهرست
new = min(max_dyn, max(new, min_dyn, min_layout_shards))مثال عددی. bucket با ۱۱ shard شروع میکند. فرض کنید هر ۱۰۰۰۰۰ شیء یک بار بررسی شود. در ۱.۲ میلیون شیء، شرط ۱۲۰۰۰۰۰ > ۱۱ × ۱۰۰۰۰۰ برقرار است. new = ۱۲۰۰۰۰۰ × ۲ / ۱۰۰۰۰۰ = ۲۴ و نزدیکترین عدد اول بزرگتر یا مساوی ۲۹ است. مسیر رشد در یک zone این است: ۱۱ → ۲۹ (۱.۲ میلیون) → ۶۱ (۳ میلیون) → ۱۲۷ (۶.۲ میلیون) → ۲۵۷ (۱۲.۸ میلیون) → ۵۲۱ (۲۵.۸ میلیون) → ۱۰۴۹ (۵۲.۲ میلیون) → ۱۹۹۹ (۱۰۵ میلیون). در multisite با ضریب ۸ فقط سه reshard لازم است: ۱۱ → ۹۷ → ۷۸۷ → ۱۹۹۹. هدف ضریب بزرگتر کاهش تعداد reshardها است، چون هر reshard در multisite یک نسل تازهی bilog میسازد و همگامسازی باید از آن عبور کند. کاهش هم ممکن است. اگر bucketی با ۱۰۱ shard به ۹۰۰۰۰ شیء برسد، ۹۰۰۰۰ < ۱۰۱ × ۱۰۰۰ است و پیشنهاد ۱۱ shard داده میشود. پیشفرض rgw_dynamic_resharding_reduction_wait در main ۱۲۰ ساعت است، تا bucketی که موقتاً خالی شده بلافاصله کوچک نشود.
۴-۱۰-۳ فهرستگیری مرتب: چند ورودی از هر shard؟#
منبع در کد: src/rgw/driver/rados/rgw_rados.cc :: RGWRados::calc_ordered_bucket_list_per_shard، cls_bucket_list_ordered
پیچیدگی: هر صفحه O(s × k) ورودی از s shard و ادغام O(n log s)
pseudocode
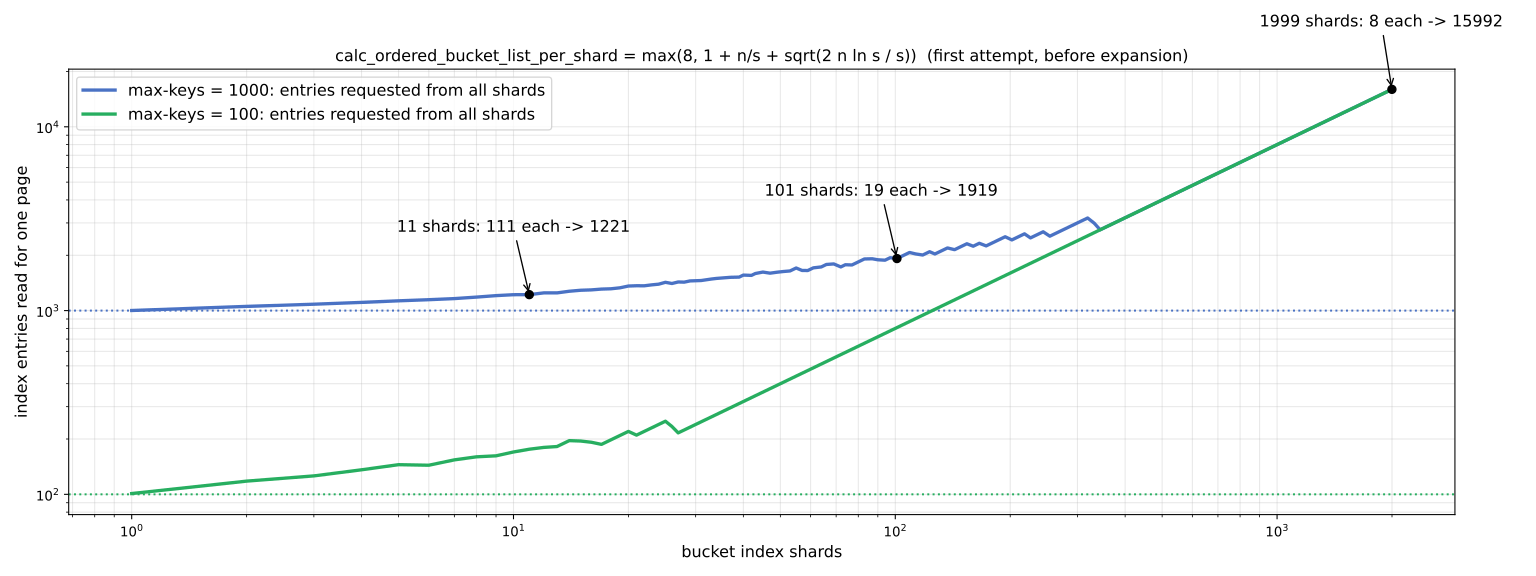
per_shard(n, s) = max(8, 1 + ⌊n / s⌋ + sqrt(2 n ln s / s)) # تحلیل «توپ در سطل» Raab و Steger
k = per_shard(max_keys, shards)
از هر shard تا k ورودی بعد از marker بخوان (بهصورت موازی)
ادغام مرتب ؛ اگر یک shard زودتر تمام شد و n ورودی نرسید: تلاش دوباره با k × 2^(expansion − 1) (حداکثر 1024 برابر)مثال عددی. صفحهی پیشفرض S3 هزار کلید است (max-keys = ۱۰۰۰). با ۱۱ shard: ⌊۱۰۰۰ / ۱۱⌋ = ۹۰ و sqrt(۲۰۰۰ × ln 11 / ۱۱) ≈ ۲۰.۹، پس k = ۱۱۱ و کل ورودیهای خواندهشده ۱۲۲۱ است، یعنی ۲۲ درصد اضافه. با ۱۰۱ shard: k = ۱ + ۹ + ۹.۶ ≈ ۱۹ و کل ۱۹۱۹. با ۱۹۹۹ shard، ⌊۱۰۰۰ / ۱۹۹۹⌋ = ۰ و ریشه حدود ۲.۸ است، اما حداقل ۸ اعمال میشود و کل ۱۵۹۹۲ ورودی، یعنی ۱۶ برابر نیاز، از ۱۹۹۹ شیء ایندکس خوانده میشود. هر shard هم یک فراخوانی cls جداگانه است. پس bucket با ۱۹۹۹ shard برای هر صفحهی ۱۰۰۰ کلیدی ۱۹۹۹ عملیات cls به OSDها میفرستد. اگر برنامه فقط به فهرست نامرتب نیاز دارد (مثلاً پاکسازی یا پشتیبانگیری)، allow-unordered=true در API یا --allow-unordered در radosgw-admin این هزینه را حذف میکند.
۴-۱۰-۴ نام شیءهای RADOS: head، tail و multipart#
منبع در کد: src/rgw/rgw_obj_manifest.cc :: RGWObjManifest::get_implicit_location؛ src/rgw/driver/rados/rgw_putobj_processor.cc :: AtomicObjectProcessor::prepare؛ src/rgw/driver/rados/rgw_obj_manifest.cc :: RGWObjManifest::generator::create_begin
پیچیدگی: O(size / stripe) شیء برای هر PUT
pseudocode
head_max = rgw_max_chunk_size (4 MiB) # اگر placement دادهی inline دارد و tail در همان pool است، وگرنه 0
stripe = rgw_obj_stripe_size (4 MiB، همتراز با alignment pool)
prefix = "." + rand_alnum(32) + "_" (PUT عادی) ؛ name + "." + upload_id (multipart)
location(part, stripe_no, ofs):
part == 0 and ofs < head_max: شیء head = "<marker>_<name>"
part == 0: ns shadow "<marker>__shadow_" + prefix + stripe_no
part > 0 and stripe_no == 0: ns multipart "<marker>__multipart_" + prefix + "." + part
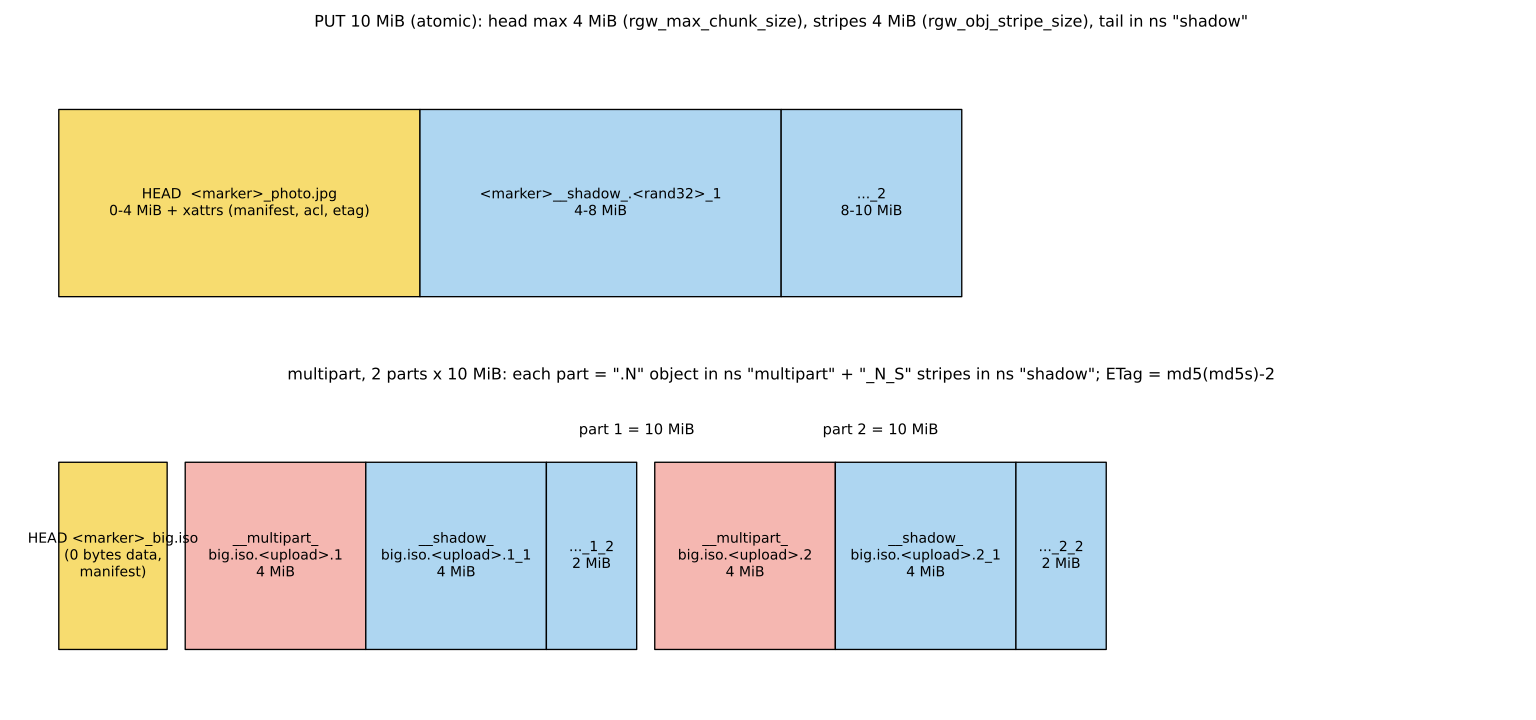
part > 0: ns shadow "<marker>__shadow_" + prefix + "." + part + "_" + stripe_noمثال عددی. PUT یک فایل ۱۰ MiB به نام photo.jpg در pool پیشفرض سه شیء RADOS میسازد. head با نام <marker>_photo.jpg چهار مگابایت اول داده را همراه xattrهای manifest، ACL و ETag نگه میدارد. دو شیء tail با نامهای <marker>__shadow_.<rand32>_1 (۴ MiB) و ..._2 (۲ MiB) بقیه را دارند. یک آپلود multipart با دو قطعهی ۱۰ مگابایتی برای big.iso اینها را میسازد: head بدون داده با manifest، و برای هر قطعه یک شیء __multipart_big.iso.<upload>.N با ۴ MiB اول آن قطعه و دو stripe در ns shadow با نامهای big.iso.<upload>.N_1 و .N_2. کل یک شیء S3 بیست مگابایتی هفت شیء RADOS است. ETag چنین شیئی md5 الحاق md5 دودویی قطعهها و پسوند «-۲» است، نه md5 کل فایل. حذف شیء فوری فقط head را پاک میکند. tailها به صف GC (radosgw-admin gc list) میروند و بعد از rgw_gc_obj_min_wait پاک میشوند. به همین دلیل فضای pool پس از حذف انبوه بلافاصله آزاد نمیشود.
۴-۱۱ قابلیتهای پیشرفتهی S3 در RGW#
۴-۱۱-۱ نسخهبندی و object lock#
با فعال کردن versioning روی bucket، هر بازنویسی یا حذف یک نسخهی تازه میسازد و نسخههای قبلی قابل بازیابیاند. object lock یک گام جلوتر میرود: نسخهها را برای مدت مشخص غیرقابلحذف و غیرقابلتغییر (WORM) میکند؛ قابلیتی کلیدی برای حفاظت پشتیبانها در برابر باجافزار و الزامات قانونی نگهداری داده.
EP="--endpoint-url https://s3.example.com --profile ceph"
aws $EP s3api create-bucket --bucket vault --object-lock-enabled-for-bucket
aws $EP s3api put-object-lock-configuration --bucket vault \
  --object-lock-configuration '{"ObjectLockEnabled":"Enabled","Rule":{"DefaultRetention":{"Mode":"COMPLIANCE","Days":30}}}'
aws $EP s3 cp backup-2026-11-15.tar s3://vault/
aws $EP s3api list-object-versions --bucket vault
aws $EP s3api get-object-retention --bucket vault --key backup-2026-11-15.tar| حالت | رفتار | چه کسی میتواند زودتر حذف کند؟ |
|---|---|---|
| GOVERNANCE | نسخه تا پایان مهلت قفل است | کاربری با مجوز s3:BypassGovernanceRetention |
| COMPLIANCE | نسخه تا پایان مهلت قفل است | هیچ کاربر S3ای، حتی مالک |
| Legal Hold | قفل بدون تاریخ پایان | تا وقتی برداشته نشود |
object lock در حالت COMPLIANCE از دید API S3 قطعی است، اما مدیر کلاستر با دسترسی radosgw-admin یا RADOS هنوز از نظر فنی میتواند داده را حذف کند. حفاظت واقعی در برابر مهاجمی که به اعتبارنامهی مدیر کلاستر رسیده، نیازمند جداسازی دسترسیها، پایش و نسخهی خارج از سایت است. همچنین bucketی که با object lock ساخته شده را نمیتوان بعداً بدون آن کرد؛ مدت پیشفرض را با دقت انتخاب کنید.
۴-۱۱-۲ lifecycle، storage class و placement#
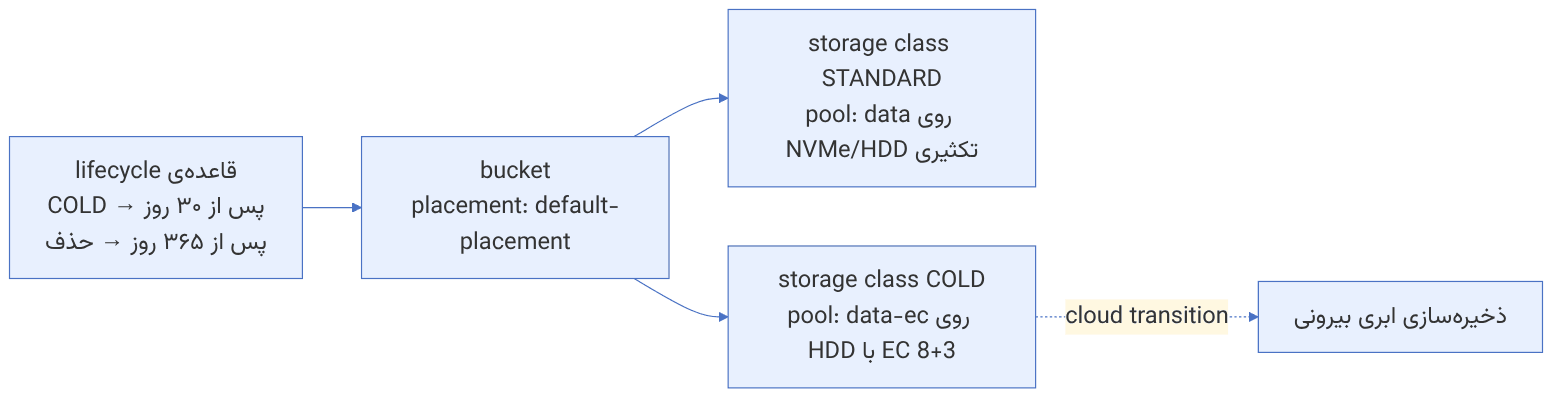
placement target تعیین میکند داده و index یک bucket در کدام poolها باشند. هر placement میتواند چند storage class داشته باشد که هر کدام به pool دادهی متفاوتی اشاره میکند. قاعدههای lifecycle اشیاء را پس از مدتی به کلاس دیگر منتقل یا حذف میکنند.
# تعریف کلاس COLD در zonegroup و zone پیشفرض
radosgw-admin zonegroup placement add --rgw-zonegroup default \
--placement-id default-placement --storage-class COLD
radosgw-admin zone placement add --rgw-zone default \
--placement-id default-placement --storage-class COLD \
--data-pool default.rgw.cold.data --compression lz4
radosgw-admin period update --commit # فقط اگر realm تعریف شده باشد{"Rules":[{"ID":"tiering","Status":"Enabled","Filter":{"Prefix":"logs/"},
"Transitions":[{"Days":30,"StorageClass":"COLD"}],
"Expiration":{"Days":365},
"AbortIncompleteMultipartUpload":{"DaysAfterInitiation":7}}]}aws $EP s3api put-bucket-lifecycle-configuration --bucket logs-bucket --lifecycle-configuration file://lc.json
radosgw-admin lc list
radosgw-admin lc process --bucket logs-bucket # اجرای دستی برای آزمایشدر آزمایشگاه برای دیدن اثر lifecycle بدون صبر چندروزه، rgw_lc_debug_interval را مثلاً ۶۰ بگذارید تا هر «روز» lifecycle شصت ثانیه حساب شود. این گزینه را هرگز در production روشن نگذارید.
در نسخههای جدید، lifecycle میتواند اشیاء را به یک ذخیرهسازی ابری سازگار با S3 هم منتقل کند (cloud transition) و در Umbrella بازگرداندن از Glacier یا نوار (cloud restore) با ابزارهای مدیریتی و اعلان رویداد کاملتر شده است.
۴-۱۱-۳ سیاست bucket و IAM#
RGW زبان سیاست AWS را پشتیبانی میکند. نمونهی زیر به کاربر ci-bot اجازه میدهد فقط در پیشوند artifacts/ بنویسد:
{"Version":"2012-10-17","Statement":[{
  "Effect":"Allow",
  "Principal":{"AWS":["arn:aws:iam:::user/ci-bot"]},
  "Action":["s3:PutObject","s3:GetObject"],
"Resource":["arn:aws:s3:::builds/artifacts/*"]}]}aws $EP s3api put-bucket-policy --bucket builds --policy file://policy.jsonبا account (از Squid) میتوان همین سیاستها را روی کاربران و گروهها هم با APIهای IAM گذاشت و از STS برای اعتبارنامهی موقت و AssumeRoleWithWebIdentity (OIDC) استفاده کرد.
۴-۱۱-۴ رمزنگاری سمت سرور#
RGW از SSE-C (کلید از کلاینت)، SSE-KMS (کلید از Vault یا KMIP یا Barbican) و SSE-S3 پشتیبانی میکند. در Umbrella رمزنگاری AES-256-GCM اضافه شده و CopyObject برای اشیای رمزشده هم کار میکند.
SSE-C و SSE-KMS فقط روی اتصال HTTPS مجازند. اگر TLS را در load balancer پایان میدهید، به RGW بگویید درخواستها امن رسیدهاند (rgw_trust_forwarded_https = true) و فقط وقتی این را روشن کنید که مطمئنید load balancer همیشه این هدر را خودش تنظیم یا پاک میکند.
۴-۱۱-۵ اعلان رویداد و لاگ bucket#
RGW میتواند رویدادهایی مثل ساخت یا حذف شیء را به Kafka، AMQP (RabbitMQ) یا HTTP بفرستد؛ پایهای برای پردازش رویدادمحور (مثلاً تولید thumbnail پس از آپلود عکس):
aws $EP sns create-topic --name uploads \
  --attributes '{"push-endpoint":"kafka://kafka.example.com:9092","persistent":"true"}'
aws $EP s3api put-bucket-notification-configuration --bucket photos \
--notification-configuration '{"TopicConfigurations":[{"Id":"n1","TopicArn":"arn:aws:sns:default::uploads","Events":["s3:ObjectCreated:*"]}]}'Bucket logging (ثبت درخواستهای هر bucket در bucket دیگر) طبق مستندات از Tentacle اضافه شده و در Umbrella حالت journal، پشتیبانی از pool EC و دستورهای مدیریتی گرفته است.
۴-۱۲ عملیات روزمرهی RGW#
۴-۱۲-۱ دستورهای پرکاربرد#
radosgw-admin bucket list
radosgw-admin bucket stats --bucket=photos
radosgw-admin bucket limit check            # shardهای نزدیک آستانه
radosgw-admin reshard list
radosgw-admin reshard add --bucket=photos --num-shards=101
radosgw-admin gc list --include-all | head
radosgw-admin gc process
radosgw-admin usage show --uid=alice --start-date=2026-11-01
radosgw-admin bucket check --bucket=photos --check-objects --fixحذف شیء در RGW فوری فضا آزاد نمیکند. head object حذف میشود اما اشیای tail به garbage collector سپرده میشوند و پس از rgw_gc_obj_min_wait (پیشفرض دو ساعت) پاک میشوند. اگر حذف انبوه انجام دادید و ceph df تغییری نکرد، صف gc را ببینید. در کلاسترهای پرتراکنش ممکن است نیاز باشد پارامترهای rgw_gc_max_concurrent_io و rgw_gc_processor_period را تنظیم کنید.
۴-۱۲-۲ عیبیابی#
نشانهها و راه بررسی:
خطای SignatureDoesNotMatch: اختلاف ساعت کلاینت و سرور بیش از ۱۵ دقیقه، یا load balancer که هدر Host را تغییر میدهد، یا path-style در برابر virtual-host اشتباه.
خطای NoSuchBucket با وجود bucket: کلاینت virtual-host استفاده میکند ولی rgw_dns_name یا hostnames در zonegroup تنظیم نشده و RGW نام bucket را از Host تشخیص نمیدهد.
فهرستگیری بسیار کند: index روی HDD، bucket بدون shard کافی، یا میلیونها نسخهی حذفشده در bucket نسخهبندیشده.
هشدار LARGE_OMAP_OBJECTS: shardهای index بزرگ؛ با radosgw-admin bucket limit check bucket مقصر را پیدا کنید.
برای دیدن جزئیات یک درخواست، موقتاً debug_rgw را بالا ببرید: ceph config set client.rgw debug_rgw 20 و پس از بازتولید مشکل، برگردانید.
۴-۱۳ تکمیلی و بهروز#
- ingress و certmgr در cephadm: load balancer و گواهیها حالا بخشی از ارکستراتورند.
- account و IAM (Squid به بعد): مدیریت سلفسرویس کاربران، گروهها، نقشها و سیاستها؛ در Umbrella GetAccountSummary، PublicAccessBlock در سطح account، APIهای مدیریتی سهمیهی account و S3 Object Ownership (غیرفعالسازی ACL) اضافه شدهاند.
- S3 GetObjectAttributes در Tentacle اضافه شده و برای سازگاری با AWS، زمان LastModified به ثانیه گرد میشود.
- dedup کامل اشیاء در Umbrella بهصورت پیشنمایش فنی آمده است.
- cache D4N مبتنی بر Redis در حال توسعه است.
- اسکریپت Lua: RGW اجازه میدهد در مراحل مختلف پردازش درخواست، اسکریپت Lua اجرا شود (مثلاً برای لاگ سفارشی یا تغییر رفتار)؛ Umbrella hook جدید
postAuth را اضافه کرده است.
۴-۱۴ جمعبندی و مرور#
۴-۱۴-۱ خلاصهی فصل#
- RGW سرور HTTP بدون حالت است که S3 و Swift را روی RADOS پیاده میکند؛ با cephadm و سرویس ingress بهسادگی مقیاس افقی میگیرد.
- هر شیء S3 یک head object، تعدادی tail و یک ورودی در index bucket دارد؛ index باید روی SSD و تکثیری باشد.
- کاربر، subuser، tenant و account سطوح مختلف هویت و چندمستاجریاند؛ برای طراحی تازه account را در نظر بگیرید.
- virtual-host نیازمند DNS wildcard،
rgw_dns_name و گواهی wildcard است. - Keystone و S3A اتصال RGW به OpenStack و اکوسیستم داده را ممکن میکنند.
- versioning، object lock، lifecycle، storage class، سیاستها، SSE و اعلان رویداد RGW را به یک سرویس S3 کامل تبدیل کردهاند.
۴-۱۴-۲ اشتباهات رایج#
- pool index روی HDD یا EC.
- اجرای یک نمونهی RGW بدون load balancer.
- فراموش کردن lifecycle برای بارگذاریهای چندبخشی نیمهکاره.
- انتظار آزاد شدن فوری فضا پس از حذف (بیاطلاعی از gc).
- ساخت bucket با object lock در حالت COMPLIANCE با مدت طولانی برای آزمایش.
- اختلاف ساعت بین کلاینتها و RGW.
۴-۱۴-۳ تمرین عملی#
- ۱. RGW را با دو نمونه و یک سرویس ingress مستقر کنید و با متوقف کردن یک نمونه نشان دهید سرویس قطع نمیشود.
- ۲. یک کاربر با سهمیهی ۱ گیگابایت بسازید و رفتار RGW را هنگام عبور از سهمیه ببینید.
- ۳. یک bucket با versioning بسازید، فایلی را سه بار بازنویسی و سپس حذف کنید و با
list-object-versions همهی نسخهها و delete marker را ببینید. نسخهی دوم را بازیابی کنید. - ۴. یک storage class سرد روی pool EC بسازید و با lifecycle و
rgw_lc_debug_interval انتقال اشیاء را در آزمایشگاه مشاهده کنید. - ۵. ۱۰۰٬۰۰۰ شیء کوچک در یک bucket بنویسید (مثلاً با
s3-benchmark یا یک اسکریپت موازی) و با bucket limit check و reshard list رفتار resharding پویا را ببینید.
۴-۱۴-۴ پرسشهای مرور#
- ۱. چرا RGW را «بدون حالت» مینامیم و این چه اثری بر طراحی دسترسپذیری بالا دارد؟
- ۲. یک شیء S3 بیستمگابایتی در RADOS به چه اشیایی تبدیل میشود؟
- ۳. چرا pool index نباید EC یا روی HDD باشد؟
- ۴. resharding پویا چه مشکلی را حل میکند و آستانهی پیشفرض آن چیست؟
- ۵. تفاوت tenant و account چیست؟
- ۶. برای دسترسی virtual-hosted-style چه پیکربندیهایی لازم است؟
- ۷. دو حالت GOVERNANCE و COMPLIANCE در object lock چه فرقی دارند؟
- ۸. چرا پس از حذف انبوه اشیاء، فضای کلاستر فوراً آزاد نمیشود؟
- ۹. گزینهی
rgw_s3_auth_use_keystone چه امکانی فراهم میکند؟ - ۱۰. چرا S3A committers برای Spark روی RGW مهماند؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۴-۱۴-۵ منابع این فصل#
- مستندات Ceph — Ceph Object Gateway
https://docs.ceph.com/en/latest/radosgw/ - مستندات cephadm — سرویس RGW و ingress
https://docs.ceph.com/en/latest/cephadm/services/rgw/ - مستندات Ceph — مدیریت RGW با radosgw-admin
https://docs.ceph.com/en/latest/radosgw/admin/ - مستندات Ceph — User Accounts
https://docs.ceph.com/en/latest/radosgw/account/ - مستندات Ceph — یکپارچهسازی Keystone
https://docs.ceph.com/en/latest/radosgw/keystone/ - مستندات Ceph — placement و storage class
https://docs.ceph.com/en/latest/radosgw/placement/ - مستندات Ceph — resharding پویا
https://docs.ceph.com/en/latest/radosgw/dynamicresharding/ - مستندات Ceph — اعلان رویداد bucket
https://docs.ceph.com/en/latest/radosgw/notifications/ - مستندات Ceph — رمزنگاری سمت سرور
https://docs.ceph.com/en/latest/radosgw/encryption/ - مستندات Ceph — سازگاری API S3
https://docs.ceph.com/en/latest/radosgw/s3/ - مستندات Apache Hadoop — کانکتور S3A
https://hadoop.apache.org/docs/stable/hadoop-aws/tools/hadoop-aws/index.html - مستندات AWS — S3 Object Lock
https://docs.aws.amazon.com/AmazonS3/latest/userguide/object-lock.html