لایههای پایینی (۶): CRUSH در سطح بیت، از rjenkins تا upmap
حوصله ندارم این فصل در چند خط
- CRUSH قطعی است: hash از نوع rjenkins روی ورودی، شناسهی bucket و شمارهی replica هر انتخاب را میسازد.
- straw2 برای هر عضو یک «نی» وزندار میکشد و بلندترین را برمیدارد، پس تغییر وزن فقط دادهی مربوط به همان عضو را جابهجا میکند.
- firstn برای replication و indep برای erasure coding مناسب است، چون جای shardها نباید جابهجا شود؛ bucketهای uniform، list و tree دادهی بیشتری جابهجا میکنند.
- مدخلهای upmap در OSDMap برای تکتک PGها CRUSH را کنار میزنند و balancer از آنها استفاده میکند.
۲۸-۱ مقدمه: CRUSH چگونه «حساب» میکند؟#
در فصلهای ۱ و ۸ CRUSH را بهعنوان الگوریتمی دیدیم که بدون جدول مرکزی جای هر PG را تعیین میکند. این فصل تا سطح بیت پایین میرود: hashهای rjenkins که هر تصمیم را تعیینپذیر میکنند، الگوریتم straw2 با جدول لگاریتم fixed-point، اجرای گامبهگام crush_do_rule، تلاشهای مجدد هنگام تصادم، و در پایان اینکه choose_args، weight-set و upmap نتیجهی خام CRUSH را چگونه اصلاح میکنند. یک مثال کامل را از نام شیء تا انتخاب host با اعدادی دنبال میکنیم که با کامپایل همان کد C مربوط به Ceph (src/crush/hash.c و mapper.c، LGPL) در یک برنامهی آزمایشی کوچک محاسبه شدهاند.
- نام شیء با
ceph_str_hash_rjenkins hash میشود. ceph_stable_mod آن را به یک PG نگاشت میکند و با HASHPSPOOL، ورودی CRUSH برابر crush_hash32_2(ps, pool) است. - straw2 برای هر آیتم یک «قرعه» محاسبه میکند: draw = ln(u) / w، که u یک hash شانزدهبیتی است و ln از جدول fixed-point به دست میآید. بیشترین draw برنده است. احتمال برنده شدن هر آیتم دقیقاً با وزنش متناسب است.
- تصادم (انتخاب تکراری) با افزایش r حل میشود (r = rep + ftotal) تا
choose_total_tries=50. -
reweight با is_out احتمالی کار میکند. weight-set در choose_args وزن جایگزین برای CRUSH است و upmap نتیجه را پس از CRUSH صریحاً جایگزین میکند.
۲۸-۲ از نام شیء تا x#
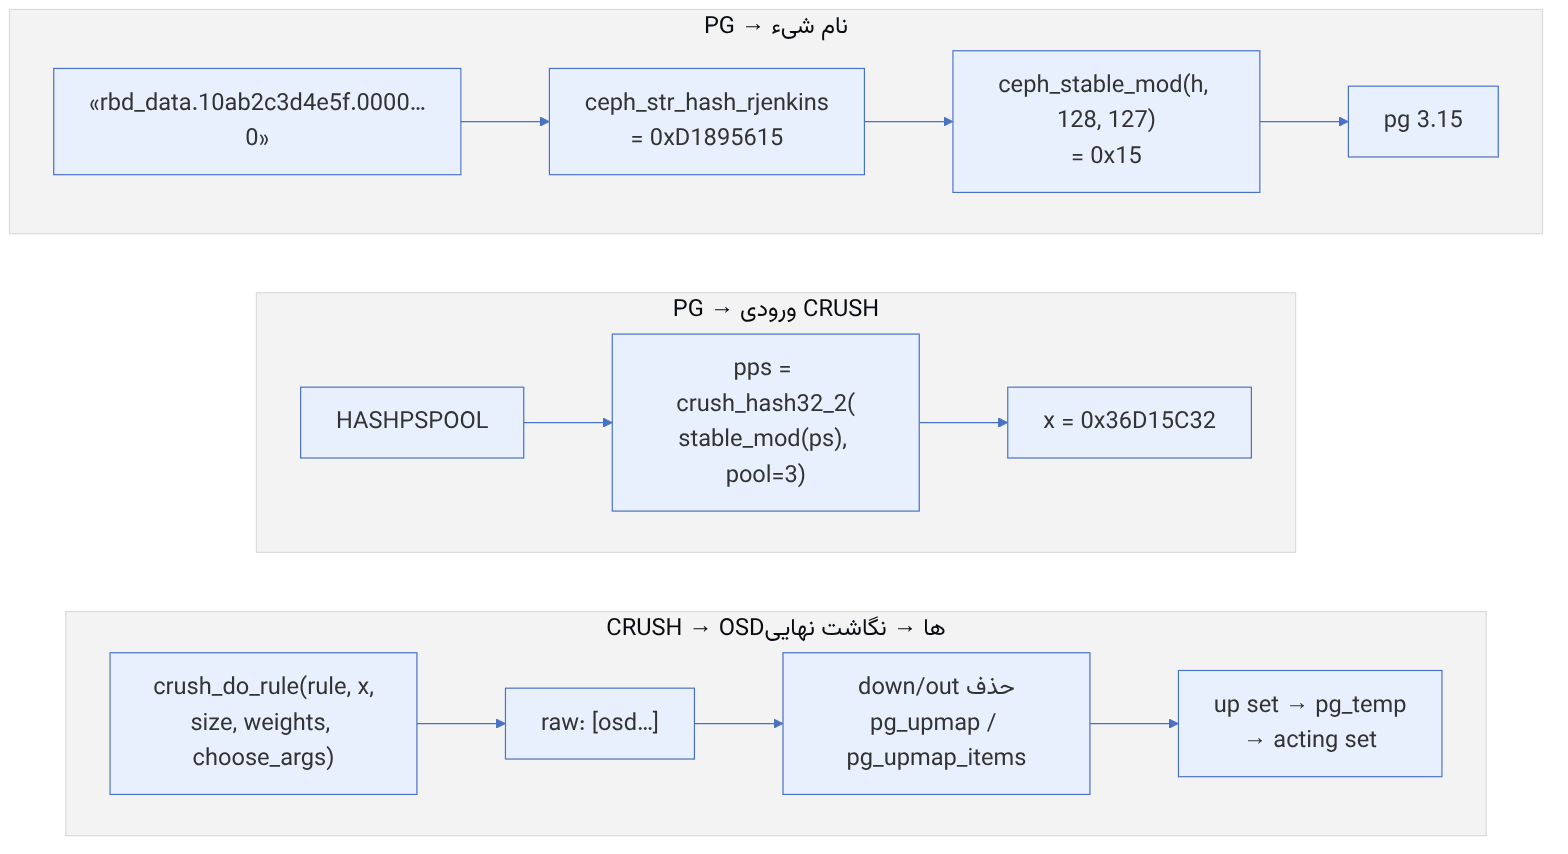
ceph_stable_mod(x, b, bmask) در include/rados.h تعریف شده است: اگر x & bmask کمتر از b باشد، همان را برمیگرداند، وگرنه x & (bmask >> 1). این تابع «پایدار» است، چون وقتی pg_num از ۱۲۸ به ۱۹۲ افزایش مییابد، فقط PGهایی که بیت جدید را دارند جابهجا میشوند (split) و بقیه همان شماره را نگه میدارند. این دلیل ریاضی آن است که split فقط بخشی از داده را حرکت میدهد.
| گام | مقدار در مثال | تابع |
|---|---|---|
| hash نام | ۰xD1895615 | ceph_str_hash_rjenkins (common/ceph_hash.cc) |
| ps | ۰x15 (= ۰xD۱۸۹۵۶۱۵ & ۱۲۷) | ceph_stable_mod(h, 128, 127) |
| PG | ۳.۱۵ | pg_t(ps, pool) |
| x (pps) | ۰x36D15C32 | crush_hash32_2(RJENKINS1, ps, 3) در pg_pool_t::raw_pg_to_pps |
۲۸-۲-۱ hash مربوط به rjenkins#
crush_hashmix(a, b, c) نُه دور تفریق، XOR و شیفت روی سه کلمهی ۳۲ بیتی است، برگرفته از تابع ترکیب Bob Jenkins. نسخهی سهورودی crush_hash32_rjenkins1_3(a, b, c) با hash = 1315423911 ^ a ^ b ^ c (ثابت crush_hash_seed) شروع میکند و پنج بار mix را با ثابتهای x = 231232 و y = 1232 اجرا میکند. ویژگی مهم آن تعیینپذیری کامل روی همهی معماریها است: فقط عملیات صحیح بدون علامت ۳۲ بیتی دارد، بدون اعشار. به همین دلیل کلاینت هستهی لینوکس (که همین فایل را در net/ceph/crush/ دارد) و librados دقیقاً همان نتیجه را میگیرند.
هر تغییری در این توابع، در جدول لگاریتم یا در tunableها (مثل chooseleaf_stable) نگاشت تقریباً همهی PGها را عوض میکند. به همین دلیل tunableها پروفایلهای نامدار دارند (ceph osd crush tunables optimal) و تغییر آنها روی خوشهی پر، حرکت دادهی عظیمی ایجاد میکند.
۲۸-۳ straw2: قرعهکشی نمایی#
فرض کنید هر آیتم i با وزن w_i یک متغیر تصادفی نمایی با نرخ w_i بکشد. احتمال اینکه آیتم i کمترین مقدار را داشته باشد، دقیقاً است. straw2 همین را بدون عدد اعشاری پیاده میکند:
straw2 (منطق mapper.c، LGPL؛ نمایش سادهشده از این کتاب)
for each item i in bucket:
u = crush_hash32_3(bucket.hash, x, id_i, r) & 0xFFFF # 16 بیت
ln = crush_ln(u) − 2^48 # ≈ 2^44 · log2((u+1)/2^16) ≤ 0
draw = ln / weight_i # weight در 16.16 fixed-point
return item with max draw # کمترین −ln/w = نمایی با نرخ wcrush_ln(x) مقدار را با دو جدول __RH_LH_tbl و __LL_tbl (در crush_ln_table.h) و فقط با عملیات صحیح محاسبه میکند. ابتدا ورودی را نرمال میکند (توان)، سپس با ۸ بیت بالای mantissa در جدول اول (تقریب ۱/x و log2) و با ۸ بیت بعدی در جدول دوم (تصحیح) جستوجو میکند. نتیجهها در برنامهی آزمایشی ما: crush_ln(0) = 0، crush_ln(0x7FFF) = 0xF00000000000 (یعنی ) و crush_ln(0xFFFF) = 0xFFFFF0000000 (تقریباً ).
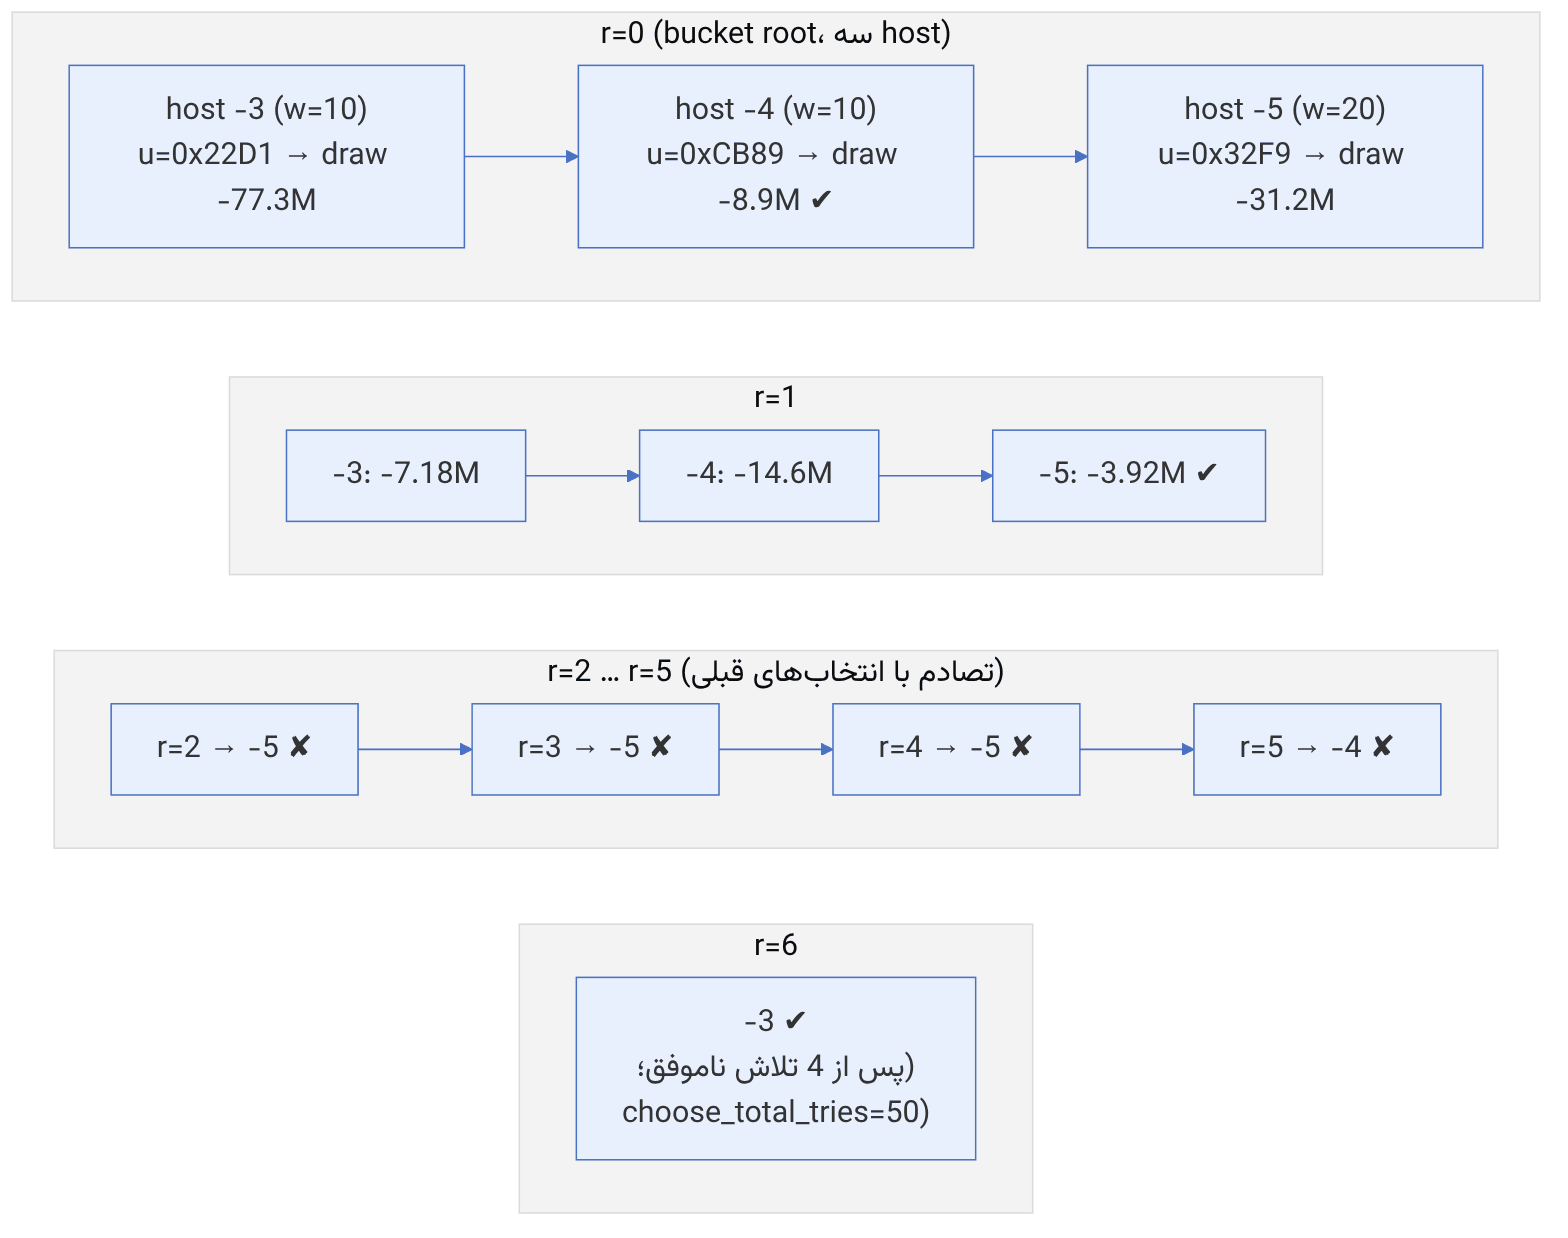
| r | draw(-۳) | draw(-۴) | draw(-۵) | برنده |
|---|---|---|---|---|
| ۰ | −۷۷,۲۵۹,۳۸۸ | −۸,۸۸۰,۳۶۱ | −۳۱,۲۴۸,۹۸۵ | -۴ |
| ۱ | −۷,۱۷۷,۹۸۱ | −۱۴,۵۸۲,۲۸۷ | −۳,۹۱۸,۶۳۵ | -۵ |
| ۲ | −۱۱,۸۵۴,۳۸۴ | −۵۹,۷۶۰,۶۹۳ | −۲,۴۱۳,۶۲۹ | -۵ (تکراری) |
| ۳ | −۶۳,۸۷۸,۱۳۸ | −۱۲۵,۳۴۹,۲۵۸ | −۱۴,۷۰۱,۳۰۰ | -۵ (تکراری) |
بررسی توزیع: در همان برنامه، با سه آیتم با وزنهای ۱، ۱ و ۲ و ۳۰۰٬۰۰۰ مقدار x، شمارش برندهها ۷۵,۲۷۴، ۷۴,۷۵۳ و ۱۴۹,۹۷۳ بود، یعنی ۲۵٪، ۲۵٪ و ۵۰٪، همانطور که نظریه پیشبینی میکند.
چرا straw2 و نه straw؟ در straw قدیمی، «طول نی» هر آیتم از روی وزنها بهصورت نسبی و وابسته به سایر آیتمها محاسبه میشد. بنابراین تغییر وزن یک آیتم، draw آیتمهای دیگر را هم تغییر میداد و داده بین آیتمهایی جابهجا میشد که وزنشان تغییر نکرده بود. در straw2، draw هر آیتم فقط به (x، id، r، وزن خودش) بستگی دارد. اگر وزن آیتم A زیاد شود، فقط برخی xها از سایر آیتمها به A منتقل میشوند و هیچ دادهای بین B و C جابهجا نمیشود. این خاصیت حداقل حرکت (optimal reorganization) است.
۲۸-۴ crush_do_rule گامبهگام#
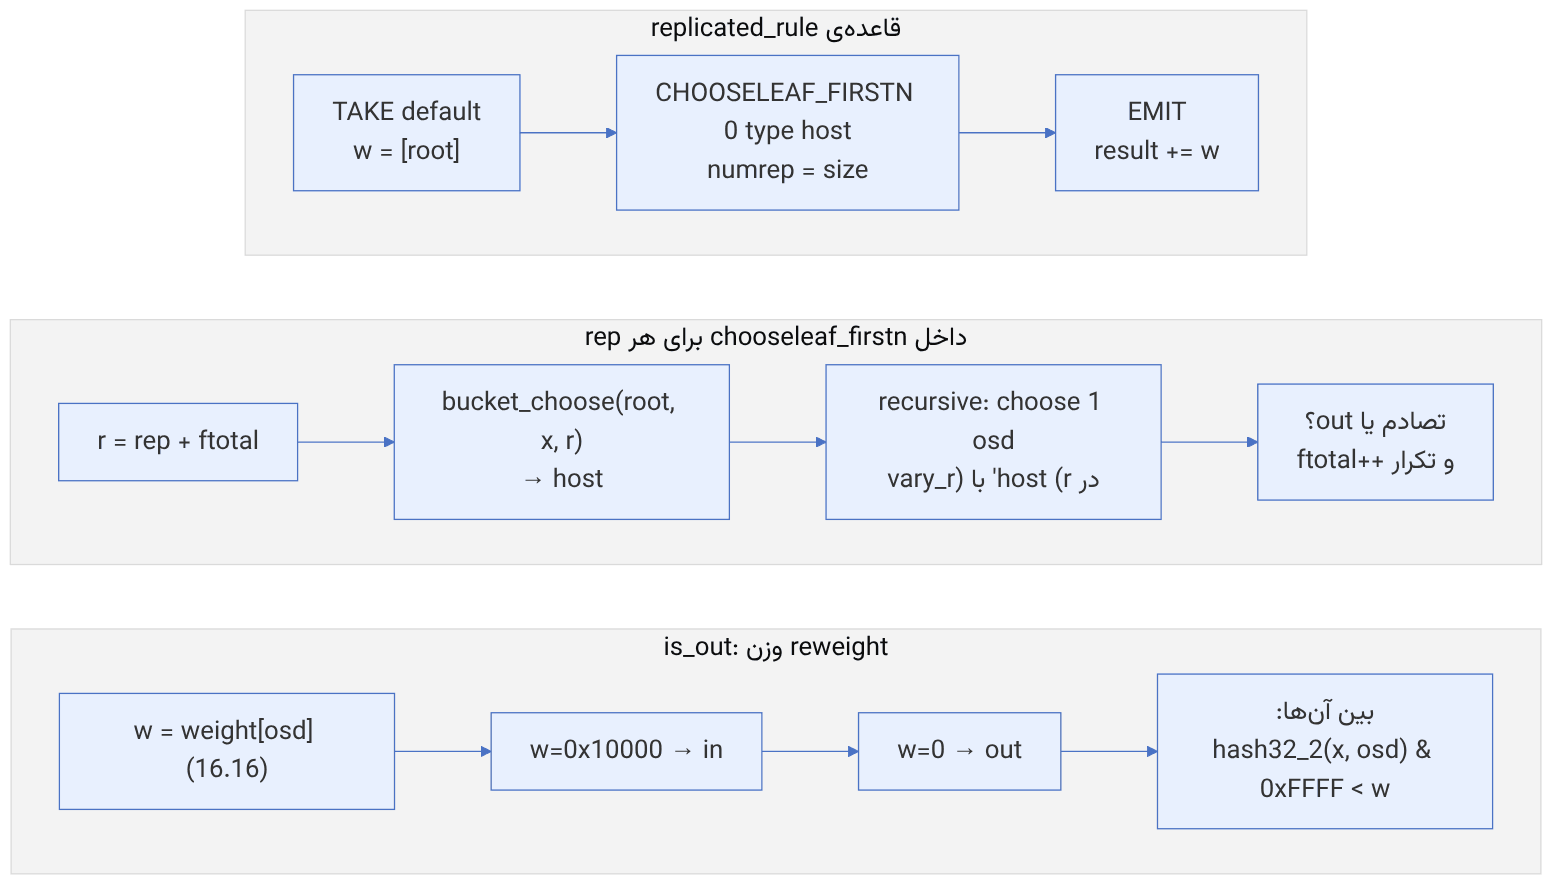
یک قاعده آرایهای از گامهاست (crush_rule_step با op، arg1 و arg2). crush_do_rule یک بردار کاری w و یک بردار خروجی o دارد:
| op | مقدار | عمل |
|---|---|---|
TAKE | ۱ | w = [arg1] (مثلاً id ریشه یا یک device class در shadow tree) |
CHOOSE_FIRSTN | ۲ | از هر bucket در w، arg1 آیتم از نوع arg2 انتخاب کن (برای replicated) |
CHOOSE_INDEP | ۳ | همان، با جایگاههای ثابت (برای EC؛ shard گمشده جای خالی میماند) |
EMIT | ۴ | o += w؛ w خالی میشود |
CHOOSELEAF_FIRSTN / _INDEP | ۶ / ۷ | انتخاب bucket از نوع arg2 و سپس یک leaf (OSD) در آن |
SET_CHOOSE_TRIES و موارد مشابه | ۸–۱۳ | override کردن tunableها برای همین قاعده |
SET_MSR_DESCENTS / SET_MSR_COLLISION_TRIES / CHOOSE_MSR | ۱۴ / ۱۵ / ۱۶ | قواعد MSR (چند OSD در هر failure domain) — در Squid و بالاتر، نه در Reef |
numrep: اگر arg1 ≤ ۰ باشد، numrep = result_max + arg1. پس 0 یعنی «به تعداد size» و -1 یعنی «size منهای یک». این برای قواعدی مثل «یکی در DC اول، بقیه در DC دوم» استفاده میشود.
۲۸-۴-۱ firstn در برابر indep#
در firstn، ترتیب مهم نیست. اگر replica دوم ناموجود شود، replica سوم جایش را میگیرد و همهچیز یک خانه به جلو میرود. برای replication این بهینه است، چون فقط یک کپی تازه لازم است. در indep، جایگاه r ام همیشه shard r ام است. اگر OSD یک shard از دست برود، فقط همان جایگاه با r تازه (r + numrep · ftotal) دوباره انتخاب میشود و بقیهی shardها جابهجا نمیشوند. برای EC این حیاتی است، چون shardها قابلجابهجایی نیستند.
| tunable (پروفایل jewel/optimal) | مقدار | اثر |
|---|---|---|
choose_local_tries | ۰ | تلاش محلی قدیمی خاموش |
choose_local_fallback_tries | ۰ | خاموش |
choose_total_tries | ۵۰ | سقف تلاشها؛ در مثال ما ۴ تلاش ناموفق داشتیم |
chooseleaf_descend_once | ۱ | در chooseleaf، یک بار پایین برو و اگر شکست خورد از بالا تلاش کن |
chooseleaf_vary_r | ۱ | r در زیرانتخاب leaf به r والد وابسته است تا تلاشهای مجدد نتیجهی متفاوت بدهند |
chooseleaf_stable | ۱ | با out شدن یک OSD، replicaهای دیگر جابهجا نمیشوند |
straw_calc_version | ۱ | اصلاح محاسبهی straw قدیمی |
تصادمها وقتی تعداد failure domainها به size نزدیک است زیاد میشوند. در مثال ما با سه host و size=3، replica سوم پس از ۴ تلاش پیدا شد. اگر یکی از hostها وزن بسیار کمی داشته باشد، ممکن است ۵۰ تلاش هم کافی نباشد و PG با کمتر از size عضو در وضعیت undersized بماند. crushtool --test --show-bad-mappings همین را آزمایش میکند.
ceph osd getcrushmap -o cm.bin && crushtool -d cm.bin -o cm.txt
crushtool -i cm.bin --test --rule 0 --num-rep 3 --min-x 0 --max-x 1023 --show-utilization
crushtool -i cm.bin --test --rule 0 --num-rep 3 --x 0x36d15c32 --show-mappings
crushtool -i cm.bin --test --show-bad-mappings --rule 0 --num-rep 3
ceph osd map rbd rbd_data.10ab2c3d4e5f.0000000000000000 # pg و up/acting۲۸-۵ choose_args، weight-set و upmap#
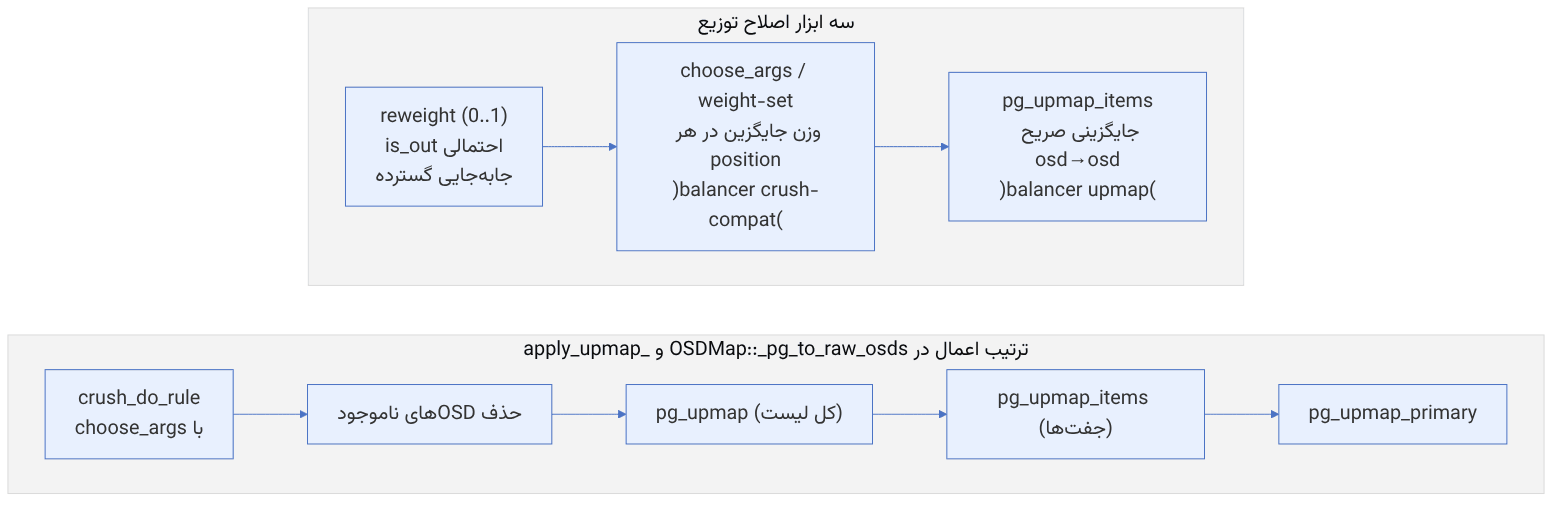
choose_args: در bucket_straw2_choose، تابع get_choose_arg_weights اگر weight_set موجود باشد، بهجای item_weights از weight_set[position] استفاده میکند. position شمارهی replica در حال انتخاب است. این امکان اصلاح یک مشکل ظریف را میدهد: در straw2 با وزنهای نابرابر، replica دوم و سوم کمی از نسبت وزن منحرف میشوند، چون انتخابهای قبلی کنار گذاشته شدهاند. weight-set برای هر position وزن کمی متفاوتی میدهد. ids جایگزین هم وجود دارد، تا بتوان hash را بدون تغییر شناسهی واقعی bucket عوض کرد.
upmap: OSDMap::_apply_upmap ابتدا pg_upmap (جایگزینی کل فهرست) را بررسی میکند، سپس pg_upmap_items (جفتهای from→to) و در پایان pg_upmap_primaries (فقط تعیین primary، برای read balancer). upmapهایی که قاعدهی CRUSH را نقض کنند (مثلاً دو replica در یک host) توسط mon بررسی و حذف میشوند (clean_pg_upmaps).
| حالت balancer | مکانیزم | نسخه |
|---|---|---|
crush-compat | weight-set در choose_args | از Luminous؛ برای کلاینتهای قدیمی |
upmap | pg_upmap_items | پیشفرض؛ نیازمند require-min-compat-client luminous |
read | pg_upmap_primaries (فقط primary) | Reef و بالاتر (طبق مستندات) |
upmap-read | هر دو | Reef و بالاتر |
ceph osd pg-upmap-items 3.15 4 11        # جایگزینی osd.4 با osd.11 برای PG 3.15
ceph osd rm-pg-upmap-items 3.15
ceph osd crush weight-set ls
ceph balancer status && ceph balancer eval
ceph osd dump | grep -E '^pg_upmap(_items|_primary)?' | head۲۸-۶ is_out و reweight: یک مثال عددی#
is_out در mapper.c وزن reweight یک OSD (عددی ۱۶.۱۶ بین ۰ و ۰x10000) را اینطور تفسیر میکند: اگر وزن کامل باشد، OSD داخل است. اگر صفر باشد، بیرون است. در غیر این صورت، crush_hash32_2(x, osd) & 0xFFFF با وزن مقایسه میشود و اگر کمتر باشد، OSD برای این x داخل است. پس reweight برابر ۰.۵ یعنی تقریباً نیمی از PGهایی که CRUSH به این OSD داده بود، رد میشوند و با تلاش مجدد به جای دیگری میروند.
| مثال | مقدار |
|---|---|
| x | ۰x36D15C32 (همان PG 3.15) |
| osd | ۷ |
crush_hash32_2(x, 7) & 0xFFFF | ۰xC425 |
| reweight 0.5 (۰x۸۰۰۰) | ۰xC425 ≥ ۰x8000 → out برای این PG |
| reweight 0.9 (۰xE۶۶۶) | ۰xC425 < ۰xE666 → in |
| نسبت in با reweight 0.5 در ۱۰۰٬۰۰۰ x | ۵۰,۰۶۹ (≈ ۵۰٪) |
تفاوت ceph osd reweight (همین is_out احتمالی، که پس از انتخاب straw2 اعمال میشود) با ceph osd crush reweight (وزن straw2 در خود bucket) مهم است. reweight کردن با is_out باعث تلاشهای مجدد بیشتر و انحراف ظریف توزیع میشود، به همین دلیل balancer مبتنی بر upmap جایگزین بهتری است. مقادیر نزدیک ۱ (مثلاً ۰.۹۵) جابهجایی کمی ایجاد میکنند، ولی مقادیر کوچک (مثلاً ۰.۳) میتوانند تلاشها را به سقف ۵۰ نزدیک کنند.
۲۸-۷ device class و shadow tree#
وقتی OSDها کلاس دارند (hdd، ssd، nvme)، CrushWrapper برای هر bucket و هر کلاس یک «سایه» با id منفی جدید و نامی مثل default~ssd میسازد که فقط OSDهای آن کلاس را دارد. قاعدهای مثل step take default class ssd در واقع TAKE روی id سایه است. چون سایهها idهای خودشان را دارند، hash مربوط به straw2 (که id آیتم در آن دخیل است) برای سایهها مستقل از درخت اصلی است. افزودن یک OSD از نوع hdd هیچ PGی را در poolهای ssd جابهجا نمیکند.
ceph osd crush tree --show-shadow
ceph osd crush rule create-replicated fast default host ssd
ceph osd crush class ls-osd ssdچرا idهای سایه پایدار میمانند؟ نگاشت کلاس به id سایه در خود CRUSH map ذخیره میشود (class_bucket). بنابراین بازسازی سایهها پس از افزودن OSD یا تغییر وزن، همان idها را نگه میدارد. اگر این idها تغییر میکردند، x مربوط به همهی PGهای poolهای وابسته به آن کلاس hash متفاوتی میگرفت و کل داده جابهجا میشد. ابزار crushtool --reclassify برای تبدیل نقشههای قدیمی (با ریشههای جداگانه برای ssd) به کلاسها، دقیقاً همین idها را طوری تنظیم میکند که نگاشت تغییر نکند.
۲۸-۸ سه نوع bucket دیگر: uniform، list و tree#
straw2 امروز پیشفرض است، اما CRUSH از ابتدا پنج الگوریتم bucket داشت: uniform، list، tree، straw و straw2. هرکدام مصالحهای میان سرعت انتخاب و میزان جابهجایی داده هنگام تغییر است. نگاشتهای قدیمی و نقشههای دستساز هنوز ممکن است آنها را داشته باشند. برای فهم اینکه چرا straw2 برنده شد، هر سه را با hash واقعی rjenkins اجرا کردهایم. همهی اعداد این بخش با یک برنامهی کوچک C که hash.c و crush_ln را از کد Ceph میگیرد محاسبه شدهاند.
۲۸-۸-۱ uniform: جایگشت شبهتصادفی#
منبع در کد: src/crush/mapper.c :: bucket_perm_choose و bucket_uniform_choose
پیچیدگی: r=0 در O(۱)؛ r=k در O(k)؛ کار مشترک در crush_work_bucket.perm
pseudocode (برگرفته از bucket_perm_choose)
pr = r mod size
if x changed:
if pr == 0: return items[hash3(x, bucket_id, 0) mod size] # میانبر رایج
perm = [0..size-1]; perm_n = 0
while perm_n ≤ pr: # Fisher–Yates تدریجی با hash بهجای random
p = perm_n
if p < size-1:
i = hash3(x, bucket_id, p) mod (size − p)
swap(perm[p], perm[p+i])
perm_n += 1
return items[perm[pr]]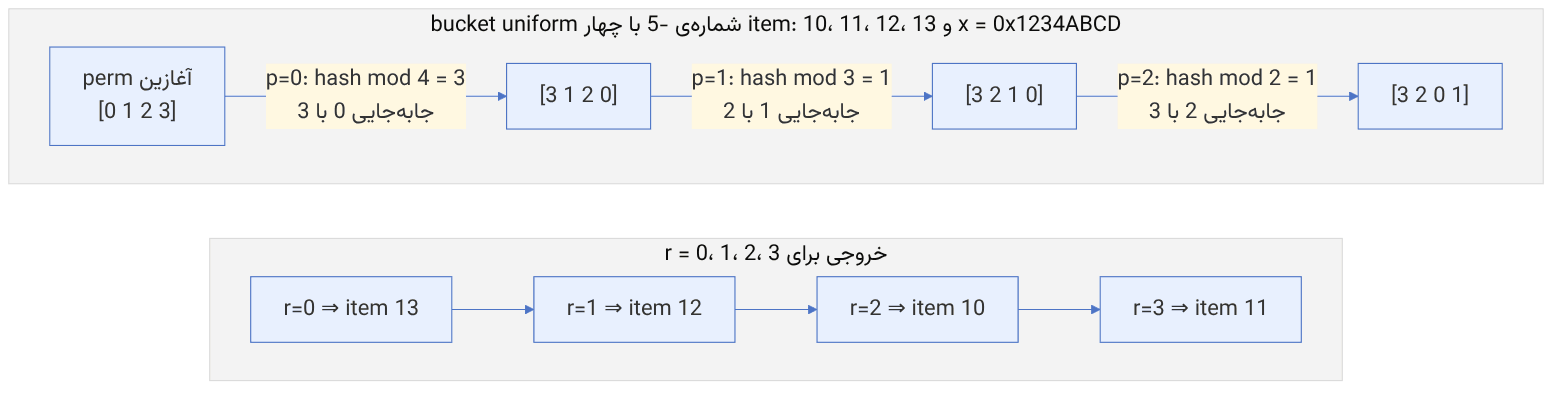
uniform فقط وقتی درست کار میکند که همهی itemها وزن برابر داشته باشند، چون وزن اصلاً در محاسبه نیست. مشکل بزرگتر این است که تغییر size پیمانهی همهی hashها را عوض میکند. شبیهسازی ما نشان میدهد افزودن item پنجم به چهار item، ۸۰٪ ورودیها را جابهجا میکند، در حالی که حداقل لازم ۲۰٪ است. این bucket برای سختافزاری طراحی شد که همیشه یکجا و هماندازه خریده و جایگزین میشود.
۲۸-۸-۲ list: پیمایش از آخر#
منبع در کد: src/crush/mapper.c :: bucket_list_choose
پیچیدگی: O(n) در بدترین حالت؛ افزودن به انتها بهینه است
for i = size-1 down to 0:
    h = hash4(x, items[i], r, bucket_id) & 0xFFFF                   # عدد 16 بیتی
    if (h × sum_weights[i]) >> 16 < item_weights[i]: return items[i]
return items[0]
# sum_weights[i] = Σ_{j ≤ i} item_weights[j]  ⇒ احتمال انتخاب i به شرط رسیدن به آن = w_i / sum_i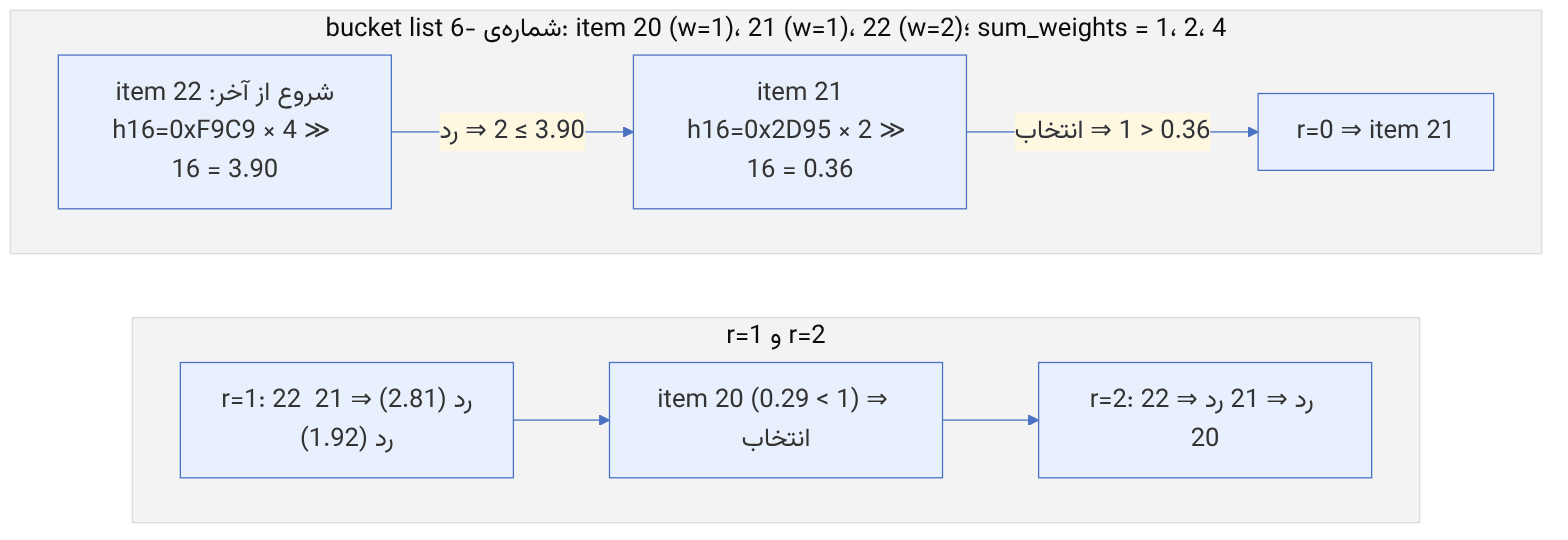
چرا درست است؟ احتمال انتخاب item آخر w₂/(w₀+w₁+w₂) = ۲/۴ است. اگر رد شود، احتمال item میانی w₁/(w₀+w₁) = ۱/۲ است. پس P(۲۱) = (۱ − ۱/۲) × ۱/۲ = ۱/۴ و P(۲۰) = ۱/۴. شمارش روی ۴۰۰ هزار ورودی همین نسبت ۱:۱:۲ را داد (۱۰۰۳۳۶، ۹۹۹۷۰، ۱۹۹۶۹۴). افزودن item به انتها فقط دادهی لازم را جابهجا میکند (۲۰٫۱٪). اما حذف یک item از میانه ترتیب را میشکند (در شبیهسازی ما ۳۶٪ بهجای ۲۵٪).
۲۸-۸-۳ tree: درخت دودویی وزندار#
منبع در کد: src/crush/mapper.c :: bucket_tree_choose؛ src/crush/builder.c :: crush_make_tree_bucket
پیچیدگی: O(log n)؛ شمارهی گرهها با افزودن item ثابت میماند
node(i) = 2(i+1) − 1 (برگها فرد)؛ height(n) = تعداد صفرهای انتهایی n
n = num_nodes / 2 # ریشه
while n is even: # گره داخلی
t = (hash4(x, n, r, bucket_id) × node_weights[n]) >> 32 # عدد یکنواخت در [0, w)
n = t < node_weights[left(n)] ? left(n) : right(n)
return items[n >> 1]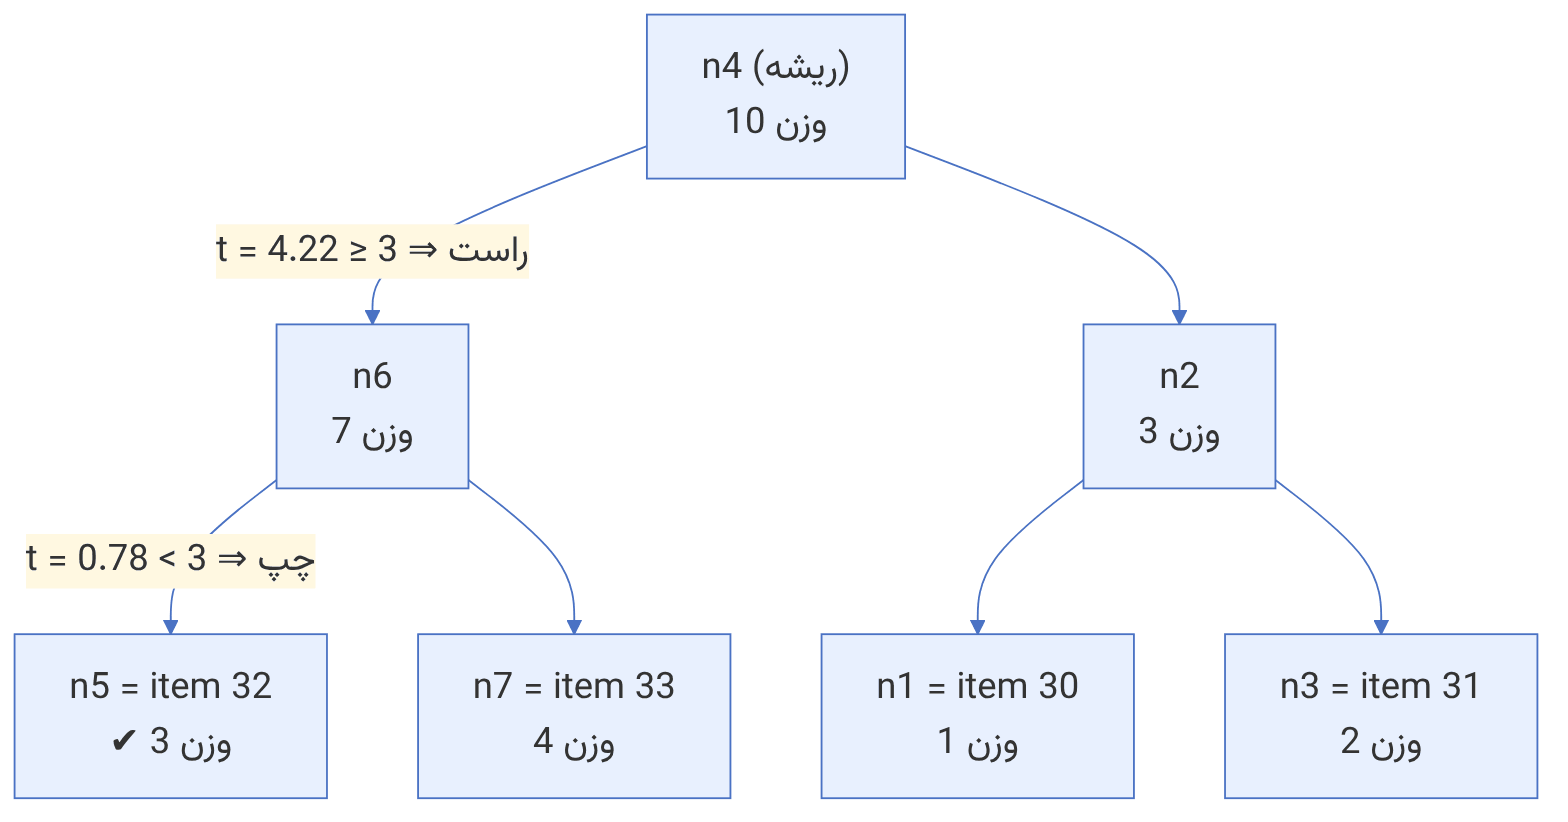
ترفند زیبای tree شمارهگذاری گرههاست. چون hash به شمارهی گره وابسته است و شمارهی گرههای موجود با بزرگ شدن درخت تغییر نمیکند (ریشهی قدیم n4 در درخت هشتبرگی فرزند چپ n8 میشود)، افزودن item پنجم دقیقاً ۲۰٪ داده را جابهجا کرد. اما حذف از میانه و بازسازی درخت، چیدمان برگها را عوض میکند و در شبیهسازی ما ۵۴٪ جابهجایی داشت.
۲۸-۸-۴ مقایسهی جابهجایی#
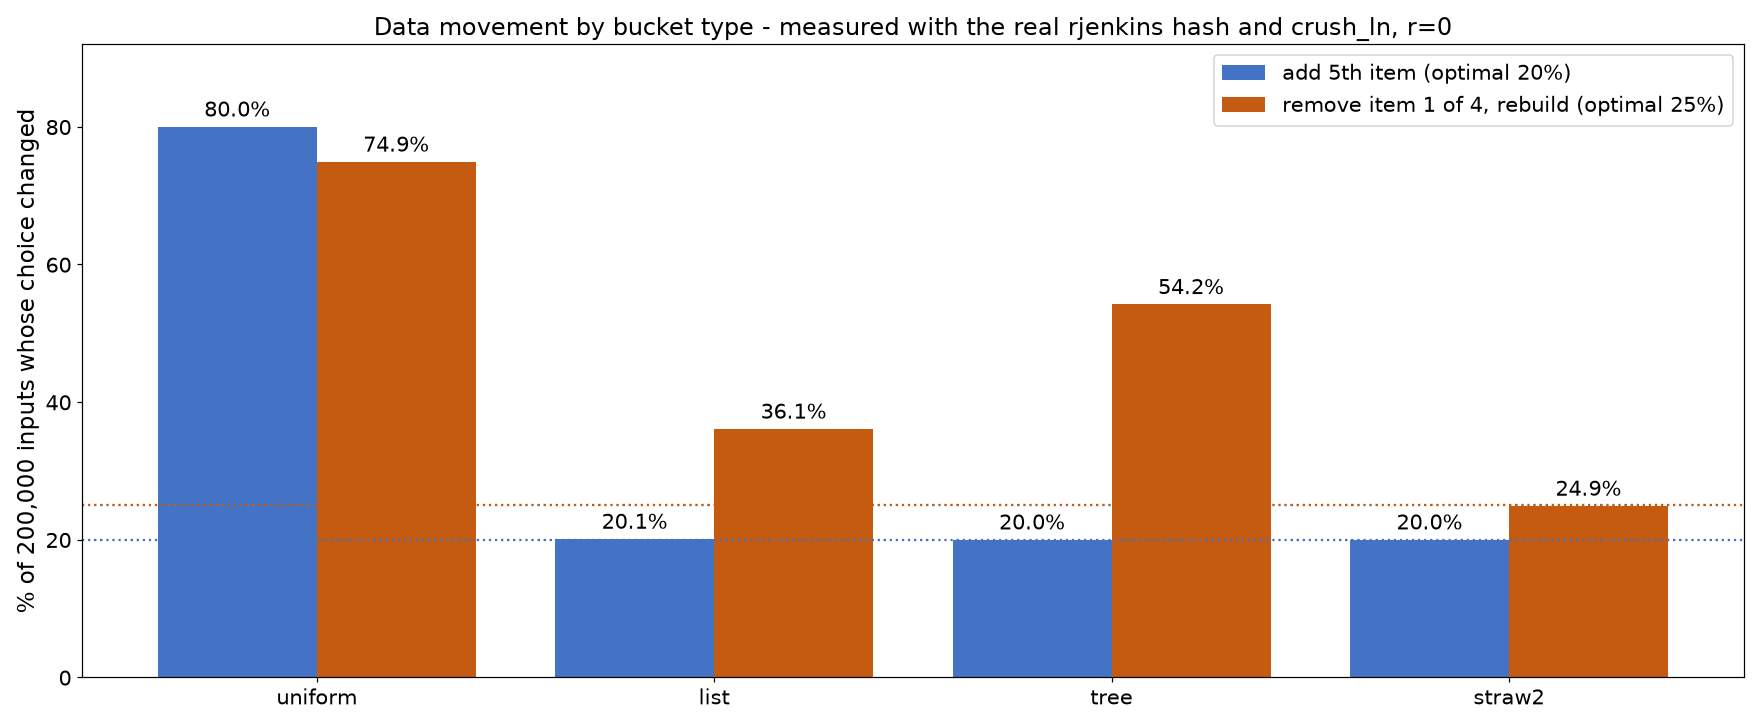
| نوع bucket | هزینهی انتخاب | افزودن | حذف یا تغییر وزن | کاربرد امروز |
|---|---|---|---|---|
| uniform | O(۱) | بد (۸۰٪ در شبیهسازی) | بد | تقریباً هیچ |
| list | O(n) | بهینه اگر در انتها | بد در میانه | خوشههای فقطرشدی قدیمی |
| tree | O(log n) | بهینه | متوسط | bucketهای خیلی بزرگ قدیمی |
| straw | O(n) | تقریباً بهینه | تقریباً بهینه، با خطای شناختهشده در وزنها | منسوخ، جایگزینش straw2 |
| straw2 | O(n) | بهینه | بهینه (فقط جابهجایی به/از item تغییرکرده) | پیشفرض |
شبیهسازی حذف، bucket را بدون item حذفشده از نو میسازد. در عمل، با ceph osd crush reweight به صفر یا crush remove، رفتار به نوع bucket و جای item بستگی دارد. برای straw2، صفر کردن وزن همان اثر حذف را دارد، چون هر item قرعهی مستقل خودش را میکشد.
زمین بازی CRUSH
یک root، چند host و OSD بسازید، قاعده را انتخاب کنید و ببینید straw2 هر PG را کجا میگذارد؛ یک OSD را out یا down کنید یا وزنش را تغییر دهید و ببینید کدام PGها جابهجا میشوند.
تغییر آخر: osd.4 out شد. shardهای جابهجاشده در فهرست برجسته شدهاند.
PG ← مجموعهٔ up (۶۴ PG؛ primary زیرخطدار)
- 1.0[0,6,5]
- 1.1[7,4,0]
- 1.2[4,7,0]
- 1.3[4,8,2]
- 1.4[1,8,5]
- 1.5[4,8,0]
- 1.6[6,4,2]
- 1.7[1,7,5]
- 1.8[6,0,4]
- 1.9[8,4,2]
- 1.a[1,5,7]
- 1.b[1,8,5]
- 1.c[6,5,2]
- 1.d[7,4,2]
- 1.e[1,8,4]
- 1.f[6,2,4]
- 1.10[5,2,8]
- 1.11[4,8,0]
- 1.12[0,6,5]
- 1.13[4,6,1]
- 1.14[5,8,1]
- 1.15[8,5,2]
- 1.16[5,0,6]
- 1.17[8,0,5]
- 1.18[6,2,4]
- 1.19[6,0,4]
- 1.1a[4,2,8]
- 1.1b[8,1,4]
- 1.1c[8,4,1]
- 1.1d[6,0,5]
- 1.1e[8,4,0]
- 1.1f[8,5,2]
- 1.20[2,6,5]
- 1.21[6,0,4]
- 1.22[2,4,6]
- 1.23[0,5,7]
- 1.24[0,4,6]
- 1.25[8,5,0]
- 1.26[1,4,6]
- 1.27[1,7,5]
- 1.28[5,7,0]
- 1.29[8,2,4]
- 1.2a[5,2,6]
- 1.2b[8,0,4]
- 1.2c[7,0,4]
- 1.2d[2,7,4]
- 1.2e[6,2,4]
- 1.2f[0,4,6]
- 1.30[6,5,0]
- 1.31[0,6,4]
- 1.32[0,6,4]
- 1.33[4,6,2]
- 1.34[8,0,5]
- 1.35[8,2,4]
- 1.36[7,0,4]
- 1.37[4,7,0]
- 1.38[6,4,2]
- 1.39[0,5,6]
- 1.3a[0,8,4]
- 1.3b[4,1,6]
- 1.3c[5,6,0]
- 1.3d[5,8,2]
- 1.3e[5,1,7]
- 1.3f[7,4,1]
مطابق با:
src/crush/mapper.c :: crush_do_ruleاجرای گامهای قاعده (take، chooseleaf، emit)src/crush/mapper.c :: crush_choose_firstn, crush_choose_indepحلقههای انتخاب replicated (firstn) و EC (indep) با تلاش دوبارهsrc/crush/mapper.c :: bucket_straw2_choose, generate_exponential_distribution, crush_lnstraw2: بزرگترین ln(hash)/weight برنده استsrc/crush/mapper.c :: is_outبررسی reweight که OSD خارجشده را رد میکندsrc/crush/hash.c :: crush_hash32_rjenkins1_2, _3hash جنکینز که CRUSH به کار میبردsrc/osd/osd_types.cc :: pg_pool_t::raw_pg_to_pps, hash_keyبذر PG که وارد CRUSH میشودsrc/include/rados.h :: ceph_stable_modنگاشت hash شیء به PG وقتی pg_num توانی از ۲ نیستsrc/common/ceph_hash.cc :: ceph_str_hash_rjenkinshash نام شیءsrc/osd/OSDMap.cc :: _pg_to_raw_osds, _raw_to_up_osdsاز مجموعهٔ خام تا مجموعهٔ up (OSDهای down حذف یا NONE میشوند)src/crush/CrushWrapper.cc :: add_simple_rule_at, insert_item; CrushWrapper.h :: set_tunables_jewelقاعدهای که ceph osd pool create میسازد و tunables نسخهٔ jewel
۲۸-۹ balancer در حالت upmap: calc_pg_upmaps#
balancer مربوط به mgr در حالت upmap (فصل ۱۹) کار اصلی را به OSDMap::calc_pg_upmaps در C++ میسپارد. این تابع یک کپی از OSDMap میسازد، با جفتهای pg_upmap_items آزمایش میکند و نتیجه را در یک Incremental برمیگرداند.
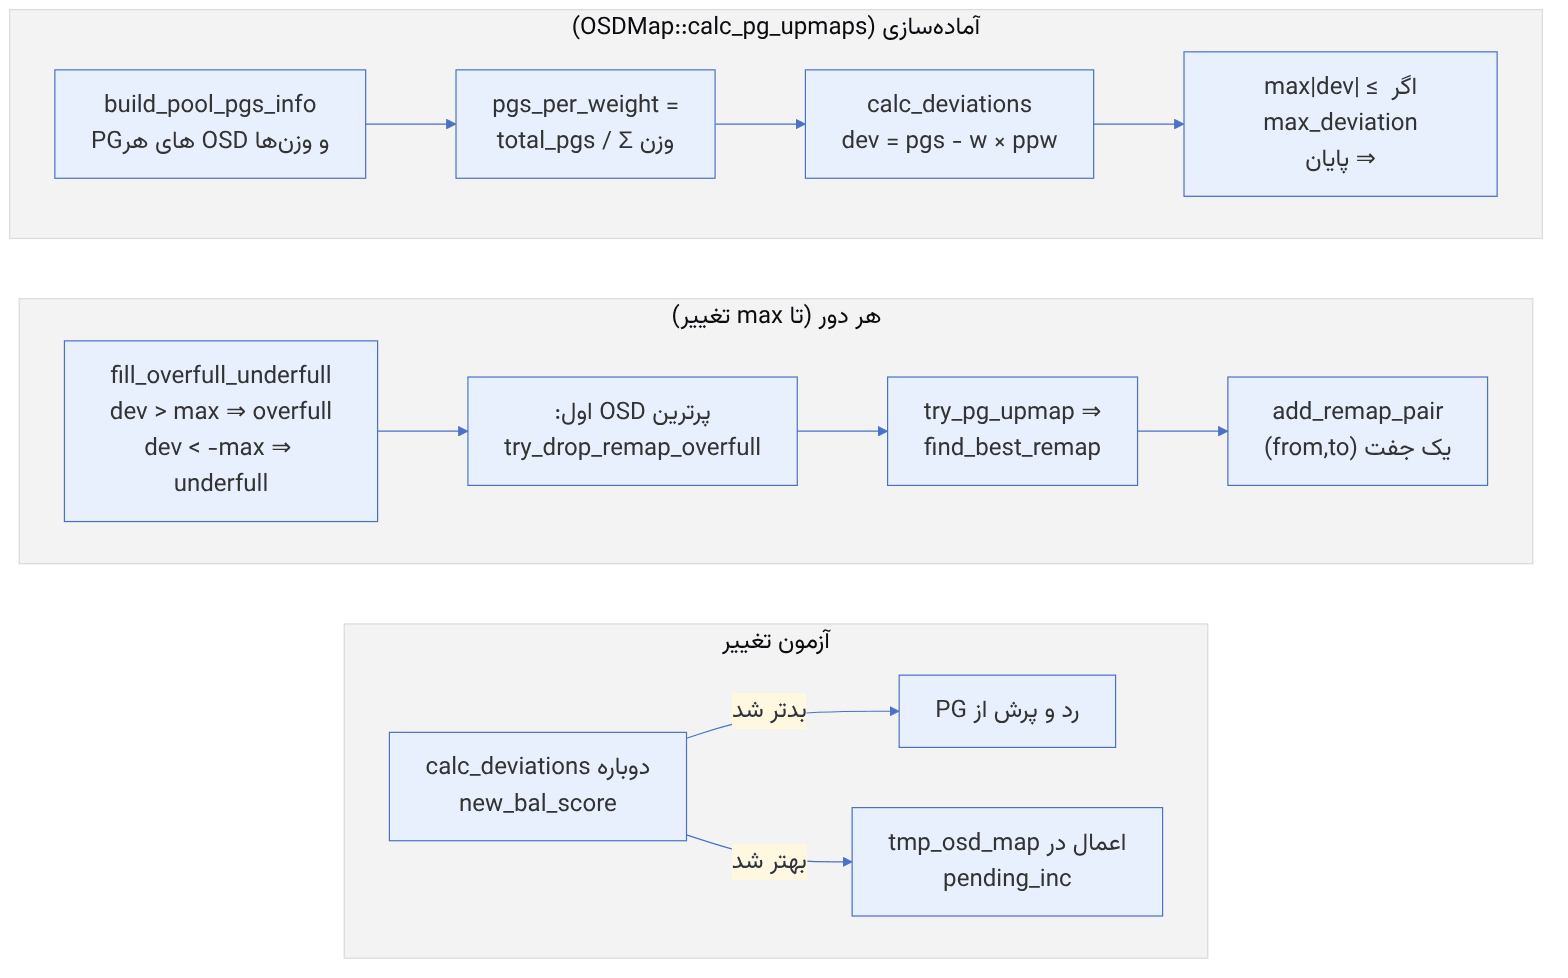
منبع در کد: src/osd/OSDMap.cc :: OSDMap::calc_pg_upmaps، calc_deviations، fill_overfull_underfull، try_pg_upmap، find_best_remap
پیچیدگی: هر دور O(OSD × PG) برای پیمایش و یک محاسبهی CRUSH برای هر نامزد؛ حداکثر max دور
ppw = total_pgs / Σ weight
dev(osd) = pgs(osd) − weight(osd) × ppw
bal_score = Σ weight × (dev / target)²                  # 0 یعنی کامل
repeat up to max times:
    overfull  = {dev > max_deviation};   more_overfull  = {0 < dev ≤ max_deviation}
    underfull = {dev < −max_deviation};  more_underfull = {−max_deviation ≤ dev < 0}
    if overfull and underfull both empty: break
    for osd in OSDs by dev descending (dev > max_deviation):
        if try_drop_remap_overfull(osd): goto test       # اول upmapهای قدیمی را پس بگیر
        for pg on osd (بدون pg_upmap دستی):
            out = try_pg_upmap(pg, overfull, underfull)   # CRUSH را با وزن صفر برای overfullها دوباره اجرا کن
            pos = find_best_remap(orig, out)            # بهترین یک جایگزینی
            if pos ≥ 0: add pair (orig[pos] → out[pos]); goto test
    for osd in underfull: try_drop_remap_underfull(osd) → test
    break
test: if new_bal_score > bal_score: reject (پرش از آن PG)  else: apply
مثال عددی. چهار OSD هموزن، یک pool با ۶۴ PG و size=3، پس ۱۹۲ نسخه و هدف ۴۸ برای هر OSD. شمارشها [۵۶، ۵۰، ۴۴، ۴۲] و انحرافها [+۸، +۲، −۴، −۶] است. با upmap_max_deviation=5 (پیشفرض ماژول balancer): overfull={osd.0}، underfull={osd.3}. امتیاز = (۶۴ + ۴ + ۱۶ + ۳۶)/۴۸² = ۰.۰۵۲۱.
| گام | جفت upmap | شمارشها | انحرافها | bal_score |
|---|---|---|---|---|
| ۰ | — | ۵۶، ۵۰، ۴۴، ۴۲ | +۸، +۲، −۴، −۶ | ۰.۰۵۲۱ |
| ۱ | (۰ → ۳) | ۵۵، ۵۰، ۴۴، ۴۳ | +۷، +۲، −۴، −۵ | ۰.۰۴۰۸ |
| ۲ | (۰ → ۳) برای PG دیگر | ۵۴، ۵۰، ۴۴، ۴۴ | +۶، +۲، −۴، −۴ | ۰.۰۳۱۳ |
| ۳ | (۰ → ۲) | ۵۳، ۵۰، ۴۵، ۴۴ | +۵، +۲، −۳، −۴ | ۰.۰۲۳۴ |
پس از گام ۳، هیچ OSDی بیش از ۵ انحراف ندارد، پس overfull و underfull خالیاند و حلقه پایان مییابد. از گام ۲ به بعد underfull خالی است و جایگزینها از more_underfull میآیند. سه ورودی pg_upmap_items در OSDMap ثبت میشوند. هر تغییر فقط یک جفت اضافه میکند. توضیح کد میگوید این کار عمداً «آرام» است تا هر گام کوچک توزیع را واقعاً به سمت حالت کامل ببرد. فرض این مثال آن است که قانون CRUSH اجازهی این جایگزینیها را بدهد (مثلاً OSDها در hostهای متفاوت باشند). اگر جایگزینی قانون failure domain را بشکند، try_pg_upmap آن را رد میکند.
osd_calc_pg_upmaps_aggressively (و نسخهی fast آن) فهرست PGها را مخلوط و جستوجوی جامعتری میکند. در main، bal_score با double جمع میشود. توضیح کد میگوید در float، تغییر یک PG در خوشههای بزرگ ممکن بود کمتر از دقت مجموع باشد و balancer متوقف شود.
۲۸-۱۰ قانونهای MSR: چند OSD در هر failure domain#
در EC با k+m بزرگتر از تعداد hostها (مثلاً ۴+۲ روی سه host)، قانون کلاسیک choose indep 3 type host و سپس chooseleaf indep 2 type osd یک مشکل دارد. اگر یک OSD out شود، مرحلهی دوم فقط در همان host دنبال جایگزین میگردد. اگر آن host OSD سالم دیگری نداشته باشد، shard بیجا میماند، چون CRUSH کلاسیک نمیتواند به مرحلهی قبل برگردد. قانونهای MSR (Multi-Step Retry) از Squid با نوعهای msr_firstn و msr_indep و گام choosemsr این را حل میکنند: کل نزول از ریشه دوباره تلاش میشود.
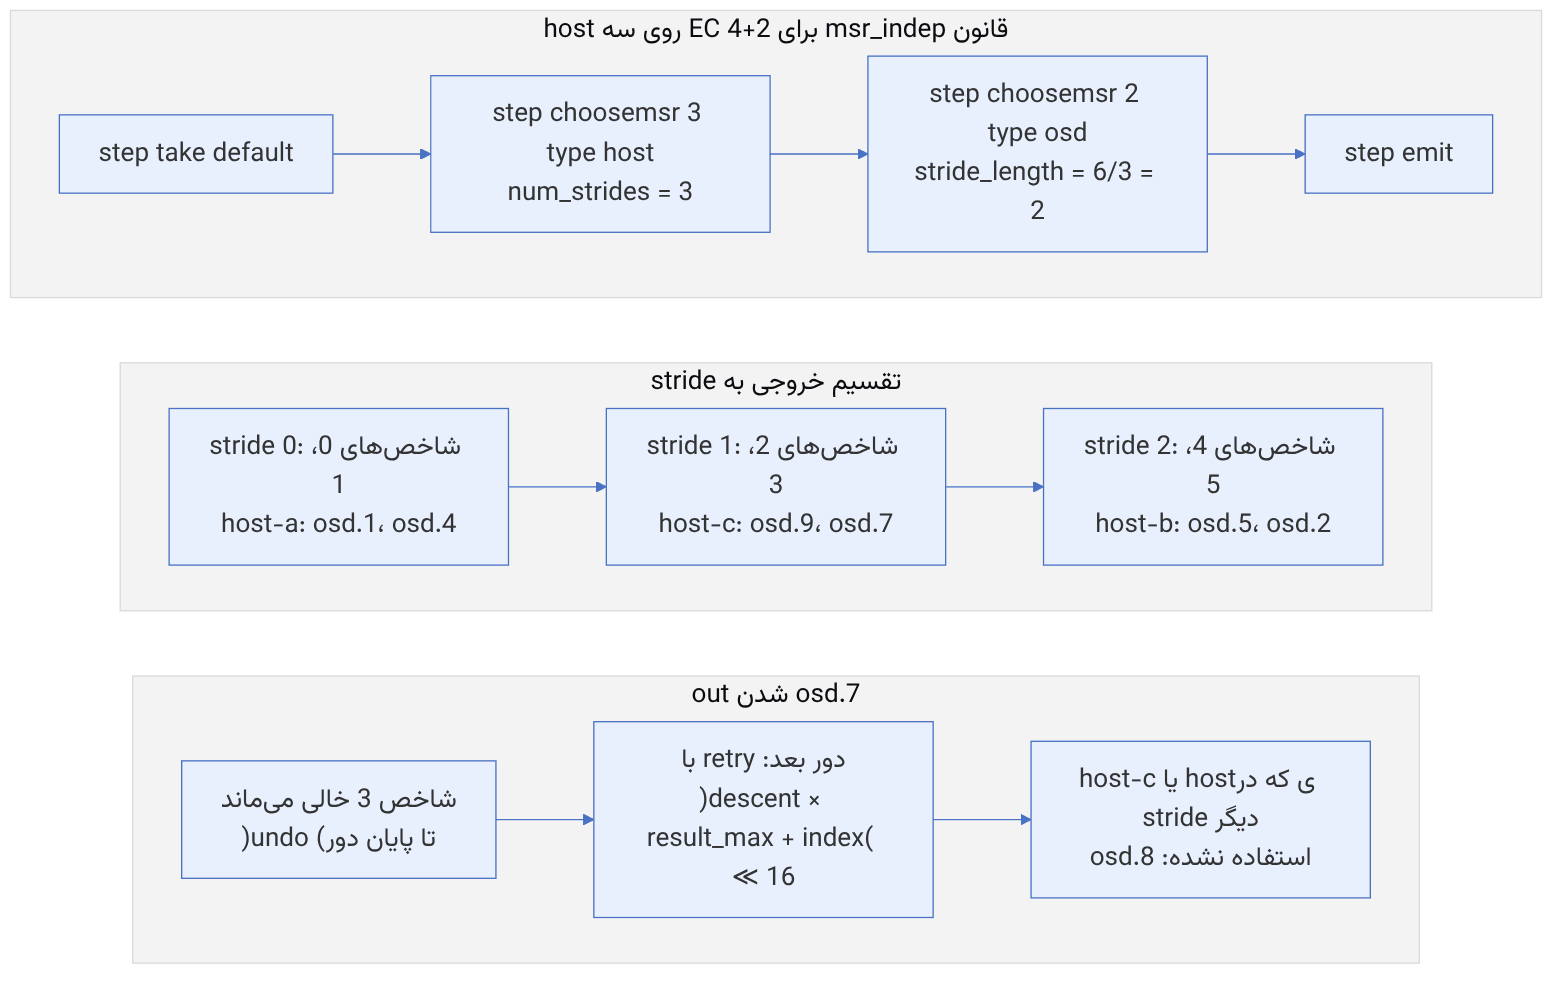
منبع در کد: src/crush/mapper.c :: crush_msr_do_rule، crush_msr_choose، crush_msr_descend، crush_msr_get_retry_value
پیچیدگی: O(msr_descents × result_max × عمق × اندازهی bucket) در بدترین حالت؛ پیشفرض msr_descents = msr_collision_tries = ۱۰۰
pseudocode
total = Π(arg1 of choosemsr steps) # مثلاً 3 × 2 = 6
for descent in 0 .. msr_descents-1 while خروجی کامل نیست:
crush_msr_choose(root, [0, total), step0, tryno = descent)
crush_msr_choose(bucket, [start, end), step):
num_strides = step.arg1 (یا result_max اگر 0)
stride_length = (end − start) / num_strides
for each stride:
if همهی شاخصهای stride پر شدهاند: continue
for local_try in 0 .. msr_collision_tries-1:
r = ((descent × result_max + index) << 16) + local_try
cand = crush_msr_descend(bucket, step.type, r) # straw2 و ... تا نوع هدف
if cand در stride دیگری استفاده شده (collision): continue
if آخرین گام: اگر OSD out است ⇒ شاخص خالی بماند (undo پس از دور)
else: crush_msr_choose(cand, [stride], step+1) برای سطح بعدمثال عددی. با choosemsr 3 host و choosemsr 2 osd، total_descendants = ۶، num_strides = ۳ و stride_length = ۲. در فراخوانی بازگشتی برای هر host، total_descendants = ۲ و stride_length = ۱ است (اینها همان اعداد توضیح بالای crush_msr_choose در کد هستند). مقدار تلاش برای descent=1، result_max=6، index=3 و local_try=0 برابر ((۱×۶+۳) ≪ ۱۶) + ۰ = ۹ × ۶۵۵۳۶ = ۵۸۹۸۲۴ است. پس hashها در هر دور کاملاً متفاوتاند. تضمین گام choosemsr 3 host «دستکم» سه host است، نه «دقیقاً» سه: یک stride ممکن است پس از out شدن یک OSD از دو host استفاده کند، به شرط آنکه آن hostها در strideهای دیگر نباشند.
قانونهای MSR به ویژگی CRUSH_MSR (بیت ۳۸ در ceph_features.h) نیاز دارند و فقط کلاینتها و OSDهایی که آن را میشناسند (Squid و بالاتر) میتوانند نگاشت را حساب کنند. در زمان نگارش، net/ceph/crush/mapper.c در شاخهی اصلی هستهی لینوکس هیچ پیادهسازی MSR ندارد، پس krbd و ceph.ko نمیتوانند از poolی با قانون MSR استفاده کنند. پیش از ساختن قانون MSR، ceph features را بررسی کنید.
۲۸-۱۱ تکمیلی و بهروز#
- قواعد MSR (
CRUSH_RULE_CHOOSE_MSR و انواع CRUSH_RULE_TYPE_MSR_FIRSTN و MSR_INDEP) در کد Squid و main وجود دارند و در Reef نیستند. هدف آنها قرار دادن چند shard در یک failure domain با کنترل دقیق است (مثلاً EC 8+6 روی ۴ rack). - هستهی لینوکس همین
mapper.c، hash.c و crush_ln_table.h را در net/ceph/crush/ دارد. پشتیبانی آن از قابلیتهای جدید CRUSH (مثل MSR) به نسخهی هسته بستگی دارد و قابلیتهای خوشه باید با ceph osd set-require-min-compat-client هماهنگ شود.
۲۸-۱۲ تمرین عملی#
- ۱. برنامهی آزمایشی این فصل را بازسازی کنید: فایلهای
hash.c و crush_ln_table.h را از کد Ceph بردارید و bucket_straw2_choose را برای bucketی با پنج آیتم و وزنهای دلخواه اجرا کنید. توزیع را برای یک میلیون x بسنجید. - ۲. با
ceph osd map چند شیء را نگاشت کنید و ps را با محاسبهی دستی ceph_stable_mod تطبیق دهید. - ۳. وزن یک host را در یک نقشهی آزمایشی ۱۰٪ زیاد کنید و با
crushtool --compare تعداد PGهای جابهجاشده و مقصد آنها را ببینید (باید فقط به همان host منتقل شوند). - ۴. یک pg-upmap-items دستی بسازید که دو replica را در یک host قرار دهد و ببینید mon با آن چه میکند.
۲۸-۱۳ پرسشهای مرور#
- ۱. ceph_stable_mod چگونه حرکت داده را هنگام افزایش pg_num محدود میکند؟
- ۲. چرا HASHPSPOOL لازم است؟
- ۳. چرا CRUSH فقط از عملیات صحیح استفاده میکند؟
- ۴. در straw2، draw چگونه محاسبه میشود و چرا بیشترین draw برنده است؟
- ۵. crush_ln چه چیزی را با چه دقتی برمیگرداند؟
- ۶. چرا straw2 حرکت حداقلی دارد و straw قدیمی نداشت؟
- ۷. تصادم در firstn چگونه حل میشود و سقف آن چیست؟
- ۸. تفاوت firstn و indep برای EC چیست؟
- ۹. weight-set در choose_args چه مشکلی را حل میکند؟
- ۱۰. ترتیب اعمال upmapها چیست و mon با upmap نامعتبر چه میکند؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۲۸-۱۴ منابع این فصل#
- مقالهی CRUSH (Weil و همکاران، SC 2006
https://ceph.io/assets/pdfs/weil-crush-sc06.pdf - mapper.c
https://github.com/ceph/ceph/blob/main/src/crush/mapper.c - hash.c
https://github.com/ceph/ceph/blob/main/src/crush/hash.c - CRUSH maps
https://docs.ceph.com/en/latest/rados/operations/crush-map/ - ویرایش CRUSH map
https://docs.ceph.com/en/latest/rados/operations/crush-map-edits/ - upmap
https://docs.ceph.com/en/latest/rados/operations/upmap/ - balancer
https://docs.ceph.com/en/latest/rados/operations/balancer/ - crushtool
https://docs.ceph.com/en/latest/man/8/crushtool/ - تابع hash مربوط به Bob Jenkins
https://burtleburtle.net/bob/hash/doobs.html