استقرار Ceph: آزمایشگاه، cephadm، Ansible و Rook
حوصله ندارم این فصل در چند خط
- هر تغییر مهم را اول در آزمایشگاهی ارزان و قابل بازسازی امتحان کنید.
- cephadm اعلانی است و کلاستر را به سمت specهایی که اعمال کردهاید همگرا میکند؛ ceph-ansible دستوری بود.
- کل کلاستر را در یک فایل spec توصیف کنید، آن را در Git نگه دارید و پیشنیازهای میزبانها را با cephadm-ansible آماده کنید.
- Rook، Ceph را از روی CRDها درون Kubernetes اجرا میکند و ceph-csi حجمهای RBD و CephFS را میدهد؛ پیش از bootstrap واقعی فهرست آمادگی محیط عملیاتی را مرور کنید.
۱۱-۱ پیش از شروع#
۱۱-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
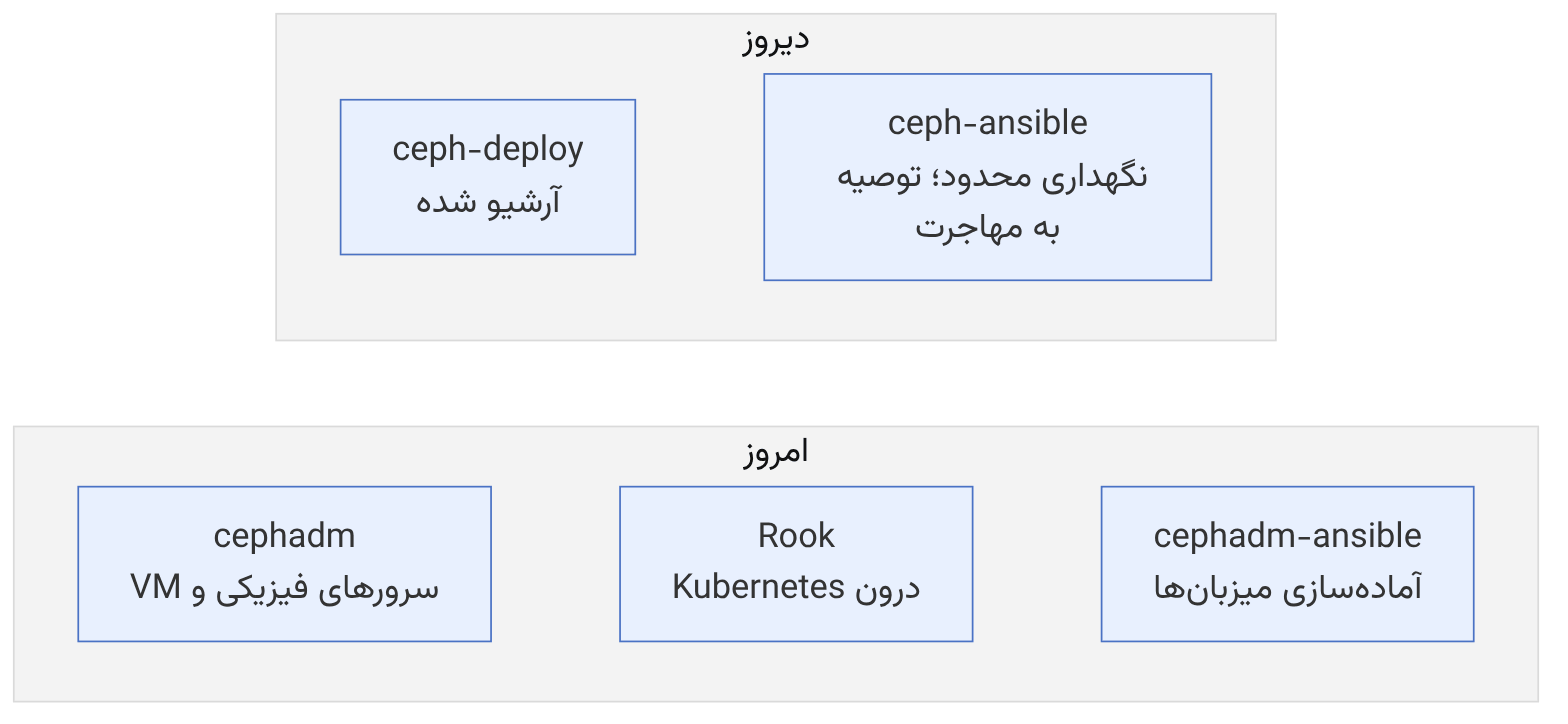
تا چند سال پیش استقرار معمولاً با سه ابزار انجام میشد: Vagrant و VirtualBox برای آزمایشگاه، ceph-deploy برای نصب دستی و ceph-ansible برای خودکارسازی. از آن زمان هر سه لایه تغییر کردهاند: مخزن ceph-deploy آرشیو شده است، README خود ceph-ansible میگوید پروژه «فعلاً» نگهداری میشود اما مهاجرت به cephadm را توصیه میکند، و ابزار رسمی استقرار، cephadm (روی سرور و VM) و Rook (درون Kubernetes) است. این فصل همان اهداف را با ابزار امروزی دنبال میکند:
- یک آزمایشگاه تکرارپذیر Ceph را چطور بسازیم؟
- ابزارهای استقرار چه سیری داشتهاند و امروز کدام را انتخاب کنیم؟
- استقرار اعلانی با specهای cephadm چطور کار میکند؟
- Ansible امروز چه نقشی دارد؟
- Rook چه زمانی انتخاب درستی است؟
- مدیریت تغییر و پیکربندی را چطور با GitOps منظم کنیم؟
۱۱-۲ آزمایشگاه تکرارپذیر#
۱۱-۲-۱ چرا آزمایشگاه؟#
هیچ تغییر مهمی (ارتقا، تغییر CRUSH، تعویض دیسک، آزمایش خرابی) نباید اولین بار روی کلاستر واقعی امتحان شود. آزمایشگاه باید ارزان، سریع و قابل بازسازی باشد: اگر خرابش کردید، در چند دقیقه دوباره بسازید.
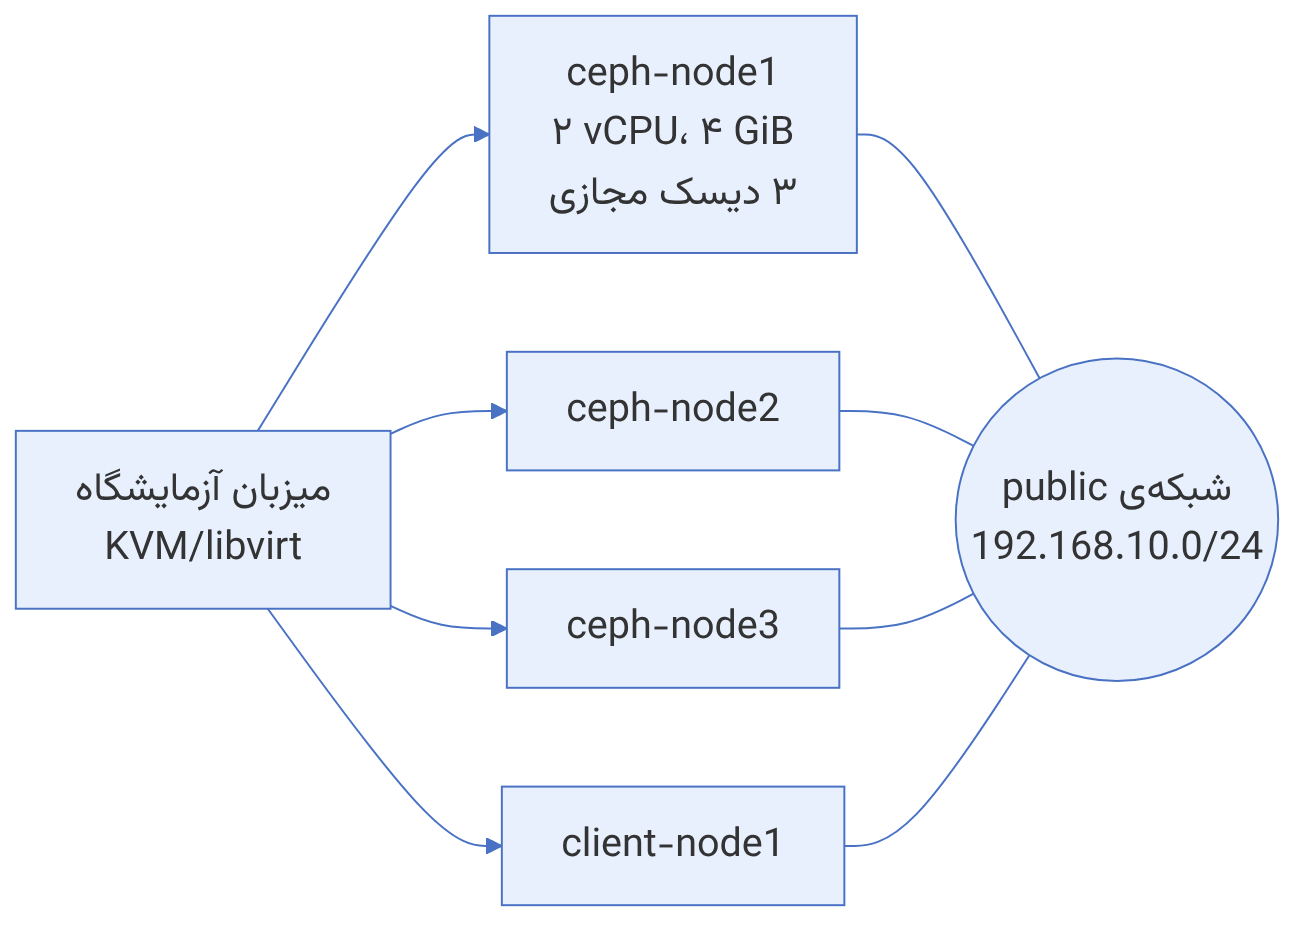
۱۱-۲-۲ منابع#
| نقش | vCPU | حافظه | دیسک |
|---|---|---|---|
| هر گره Ceph (۳ عدد) | ۲ تا ۴ | ۴ تا ۸ گیگابایت | یک دیسک سیستمعامل ۲۰ گیگابایت و ۲ تا ۳ دیسک ۲۰ گیگابایتی برای OSD |
| کلاینت | ۱ تا ۲ | ۲ گیگابایت | ۲۰ گیگابایت |
اعداد بالا برای یادگیری کافیاند، نه برای سنجش کارایی. با ۴ گیگابایت حافظه، cephadm با autotune حافظهی OSDها را پایین میآورد؛ اگر OSDها مدام restart میشوند (OOM)، حافظهی گره را بیشتر کنید یا osd_memory_target را دستی پایین بیاورید.
۱۱-۲-۳ ابزار ساخت VM#
Vagrant هنوز ابزار مفیدی برای تعریف VMها در قالب کد است، اما VirtualBox روی لینوکس برای این کار انتخاب اول نیست: KVM و libvirt سریعترند و با Vagrant (پلاگین vagrant-libvirt) یا ابزارهایی مثل virt-install و cloud-init کار میکنند. نمونهی یک Vagrantfile با libvirt:
# Vagrantfile
NODES = 3
Vagrant.configure("2") do |config|
  config.vm.box = "generic/rocky9"
  (1..NODES).each do |i|
    config.vm.define "ceph-node#{i}" do |n|
      n.vm.hostname = "ceph-node#{i}"
      n.vm.network :private_network, ip: "192.168.10.1#{i}"
      n.vm.provider :libvirt do |lv|
        lv.cpus = 2
        lv.memory = 6144
        3.times { |d| lv.storage :file, size: "20G" }
      end
    end
  end
  config.vm.define "client-node1" do |c|
    c.vm.hostname = "client-node1"
    c.vm.network :private_network, ip: "192.168.10.21"
  end
endvagrant up --provider=libvirt
vagrant ssh ceph-node1 -c "lsblk"
vagrant destroy -f # پاک کردن کامل آزمایشگاهاگر Umbrella را آزمایش میکنید، دقت کنید imageهای آن به CPU با سطح x86-64-v3 نیاز دارند. در libvirt، مدل CPU را host-passthrough بگذارید؛ مدلهای CPU عمومی و قدیمی ممکن است این سطح را اعلام نکنند و کانتینرها اجرا نشوند. Umbrella همچنین مبتنی بر el10 است و cephadm به پایتون ۳.۹ یا جدیدتر روی میزبان نیاز دارد.
۱۱-۲-۴ کلاستر تکگره#
برای آزمایش سریع رابطها (نه خرابی)، cephadm حالت تکمیزبانی دارد. گزینهی --single-host-defaults تنظیماتی را اعمال میکند که روی یک میزبان معنا دارند، مثلاً دامنهی خرابی OSD به جای host:
cephadm bootstrap --mon-ip 192.168.10.11 --single-host-defaults
ceph orch apply osd --all-available-devices
ceph -sکلاستر تکگره هیچ حفاظتی در برابر خرابی میزبان ندارد و رفتار آن در خرابی با کلاستر واقعی فرق دارد. برای تمرین تعویض دیسک، نگهداری میزبان و ارتقا، از سه گره استفاده کنید.
۱۱-۳ سیر ابزارهای استقرار#
| ابزار | وضعیت | کاربرد امروز |
|---|---|---|
| ceph-deploy | مخزن آرشیو شده؛ با نسخههای جدید کار نمیکند | فقط برای فهم منابع قدیمی |
| ceph-ansible | فعلاً نگهداری میشود؛ توصیهی رسمی مهاجرت به cephadm | کلاسترهای قدیمی که هنوز مهاجرت نکردهاند |
| cephadm | ابزار رسمی استقرار و چرخهی عمر روی میزبانها | انتخاب پیشفرض برای سرور و VM |
| cephadm-ansible | playbookهای کمکی برای آمادهسازی میزبانها و کارهای پیرامونی | ترکیب با cephadm در سازمانهایی که Ansible دارند |
| Rook | operator رسمی Ceph در Kubernetes (پروژهی CNCF) | وقتی Ceph در خدمت Kubernetes است |
تفاوت فلسفی ceph-ansible و cephadm مهم است. ceph-ansible دستوری است: هر بار playbook را اجرا میکنید، مراحل را از اول اجرا میکند و وضعیت فقط در لحظهی اجرا اصلاح میشود. cephadm اعلانی و پیوسته است: وضعیت مطلوب درون خود کلاستر (در MGR) ذخیره میشود و orchestrator مدام وضعیت واقعی را با آن مقایسه و اختلاف را برطرف میکند. اگر یک daemon حذف شود، cephadm بدون دخالت شما آن را برمیگرداند. این همان مدلی است که Kubernetes و Rook هم دارند.
۱۱-۴ استقرار اعلانی با cephadm#
۱۱-۴-۱ چرخهی تطبیق#
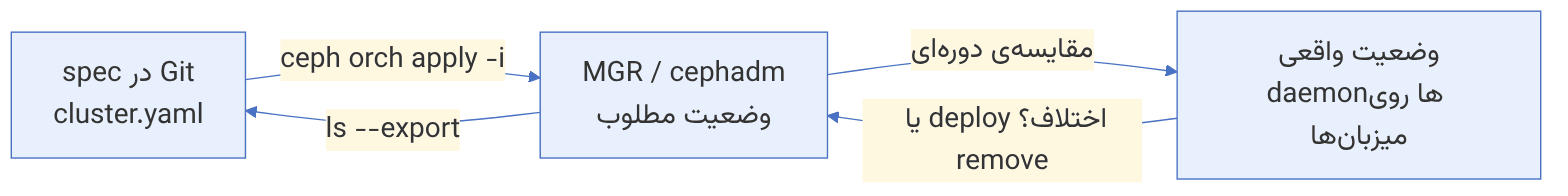
در فصل ۱ کلاستر را دستور به دستور ساختیم. در محیط واقعی بهتر است کل کلاستر را در یک فایل spec توصیف کنید و همان را در bootstrap یا بعد از آن اعمال کنید. مزیتها: تکرارپذیری، بازبینی در Git و امکان بازسازی سریع آزمایشگاه با همان پیکربندی production.
۱۱-۴-۲ فایل spec کامل#
# cluster.yaml
service_type: host
hostname: ceph-node1
addr: 192.168.10.11
labels: [_admin, mon, mgr, osd]
location: {root: default, rack: rack1}
---
service_type: host
hostname: ceph-node2
addr: 192.168.10.12
labels: [mon, mgr, osd, rgw]
location: {root: default, rack: rack2}
---
service_type: host
hostname: ceph-node3
addr: 192.168.10.13
labels: [mon, osd, mds, rgw]
location: {root: default, rack: rack3}
---
service_type: mon
placement:
  label: mon
---
service_type: mgr
placement:
  label: mgr
---
service_type: osd
service_id: hdd-with-ssd-db
placement:
  label: osd
spec:
  data_devices:
    rotational: 1
  db_devices:
    rotational: 0
  encrypted: true
---
service_type: rgw
service_id: objstore
placement:
  label: rgw
  count_per_host: 1
spec:
  rgw_frontend_port: 8080
---
service_type: mds
service_id: fs01
placement:
label: mds# روی گره اول، پس از کپی کلید SSH عمومی cephadm به گرههای دیگر
cephadm bootstrap --mon-ip 192.168.10.11 --cluster-network 192.168.20.0/24 --apply-spec cluster.yaml
# یا روی کلاستر موجود
ceph orch apply -i cluster.yaml --dry-run
ceph orch apply -i cluster.yamlهمیشه پیش از اعمال، --dry-run اجرا کنید. خروجی آن نشان میدهد کدام OSDها روی کدام دیسکها ساخته میشوند. اشتباه رایج: فیلتر rotational: 0 در محیطهای مجازی، چون دیسکهای مجازی ممکن است خود را چرخان یا غیرچرخان معرفی کنند بدون ارتباط با سختافزار واقعی. در چنین مواردی از فیلترهای size، model یا paths استفاده کنید.
۱۱-۴-۳ فیلترهای دستگاه#
| فیلتر | مثال | کاربرد |
|---|---|---|
| rotational | rotational: 1 | تفکیک HDD و SSD |
| size | size: '10T:' | دیسکهای بزرگتر از ۱۰ ترابایت |
| model / vendor | model: 'MZ7L3' | یک مدل مشخص |
| paths | paths: [/dev/sdb, /dev/sdc] | مسیر صریح (برای میزبانهای ناهمگون) |
| limit | limit: 2 | حداکثر تعداد دیسک از این نوع |
فیلترهای کلی مثل all: true یا --all-available-devices هر دیسک خالی تازه را OSD میکنند، از جمله دیسکی که برای کار دیگری به میزبان اضافه کردهاید. در production، spec OSD را با فیلترهای مشخص تعریف کنید و اگر لازم است، موقتاً unmanaged: true بگذارید تا ساخت خودکار OSD متوقف شود.
۱۱-۴-۴ نگهداری spec#
ceph orch ls --export > cluster-current.yaml
diff -u cluster.yaml cluster-current.yaml
ceph orch ls osd --export
ceph orch rm rgw.objstore # حذف یک سرویس (daemonهایش هم حذف میشوند)۱۱-۵ Ansible در کنار cephadm#
۱۱-۵-۱ تقسیم کار#
cephadm به میزبانهایی نیاز دارد که پیشنیازها را داشته باشند: موتور کانتینر (podman یا docker)، lvm2، همگامسازی زمان، پایتون مناسب و کلید SSH کلاستر. این کارها تکراریاند و Ansible برای آنها ابزار خوبی است. پروژهی cephadm-ansible playbookهای آماده برای همین کارهای پیرامونی دارد (آمادهسازی میزبان، توزیع فایلهای پیکربندی و کلیدها، پاکسازی). تقسیم کار پیشنهادی:
- Ansible: سیستمعامل، بستهها، شبکه و MTU، chrony، کاربران، فایروال، کلید SSH، تنظیمات هسته.
- cephadm: همهچیز درون Ceph؛ daemonها، specها، ارتقا.
۱۱-۵-۲ یک playbook ساده برای آمادهسازی#
# inventory.ini
[ceph]
ceph-node1 ansible_host=192.168.10.11
ceph-node2 ansible_host=192.168.10.12
ceph-node3 ansible_host=192.168.10.13

[ceph:vars]
ansible_user=root# prepare-hosts.yml
- hosts: ceph
become: true
tasks:
- name: Required packages
ansible.builtin.package:
name: [podman, lvm2, chrony, python3]
state: present
- name: Time sync running
ansible.builtin.service:
name: chronyd
state: started
enabled: true
- name: Cluster SSH public key for cephadm
ansible.posix.authorized_key:
user: root
key: "{{ lookup('file', 'files/ceph.pub') }}"
- name: Jumbo frames on storage NIC
community.general.nmcli:
conn_name: storage
mtu: 9000
state: presentansible -i inventory.ini ceph -m ping
ansible-playbook -i inventory.ini prepare-hosts.yml --check --diff
ansible-playbook -i inventory.ini prepare-hosts.ymlنام دقیق رابط شبکه و اتصال NetworkManager در هر محیط فرق دارد؛ تکهی MTU بالا فقط الگوست. فایل ceph.pub را از /etc/ceph/ceph.pub روی گره bootstrap بردارید؛ این فقط کلید عمومی است و قرار دادنش در مخزن Ansible اشکالی ندارد، اما کلید خصوصی SSH کلاستر هرگز نباید در مخزن قرار گیرد.
۱۱-۵-۳ مهاجرت از ceph-ansible#
اگر کلاستری دارید که با ceph-ansible ساخته شده، مسیر مستند adopt وجود دارد: cephadm daemonهای موجود را یکییکی «تحویل» میگیرد و به کانتینرهای مدیریتشدهی خودش تبدیل میکند. ceph-ansible هم playbook مخصوص این کار (cephadm-adopt) دارد.
cephadm ls                                   # daemonهای موجود و نوع استقرارشان (legacy یا cephadm)
cephadm adopt --style legacy --name mon.ceph-node1مهاجرت را ابتدا در آزمایشگاهی که همان نسخه و همان روش استقرار را دارد تمرین کنید. پیش از شروع، کلاستر باید سالم باشد، و پس از adopt شدن MONها و MGRها، باید ماژول cephadm فعال و کلید SSH توزیع شود تا بقیهی daemonها از طریق orchestrator قابل مدیریت شوند.
۱۱-۶ از آزمایشگاه به production#
۱۱-۶-۱ فهرست بررسی پیش از استقرار#
پیش از bootstrap کلاستر واقعی، این موارد را یکییکی تأیید و نتیجه را مستند کنید. بیشتر مشکلات ماههای اول یک کلاستر به همین فهرست برمیگردد:
| حوزه | بررسی | ابزار یا دستور |
|---|---|---|
| سختافزار | همهی گرههای یک نقش، سختافزار و firmware یکسان دارند | lshw، nvme list، ابزار سازنده |
| دیسک | SSDهای DB/WAL یا OSD حفاظت در برابر قطع برق دارند؛ cache نوشتن کنترلر مناسب تنظیم شده | fio با sync (فصل ۱۰) |
| شبکه | MTU سرتاسری، پهنای باند هر لینک، افزونگی bond و سوئیچ | iperf3، ping -M do |
| زمان | همهی گرهها با chrony همگاماند | chronyc tracking |
| DNS | نام کوتاه میزبانها با hostname یکسان و قابل resolve است | hostname، getent hosts |
| سیستمعامل | توزیع و هسته در فهرست پشتیبانی نسخهی Ceph؛ SELinux/AppArmor مطابق مستندات | cat /etc/os-release |
| فایروال | درگاههای MON (۳۳۰۰ و ۶۷۸۹)، OSD/MGR/MDS (۶۸۰۰ تا ۷۳۰۰) و سرویسها باز است | firewall-cmd --list-all |
| پشتیبان | کلیدهای admin و فایلهای spec در مخزن امن و خارج از کلاستر | — |
نام میزبان نکتهی ظریفی دارد: cephadm بهطور پیشفرض انتظار دارد نامی که در ceph orch host add میدهید با خروجی hostname روی همان میزبان یکسان باشد. ترکیب نام کوتاه روی یک گره و FQDN روی گره دیگر، بعدها در ارتقا و بررسیهای میزبان دردسر میسازد. یک قرارداد انتخاب کنید و همهجا رعایت کنید.
۱۱-۶-۲ محیط ایزوله (بدون اینترنت)#
بسیاری از کلاسترهای ذخیرهسازی به اینترنت دسترسی ندارند. cephadm برای این حالت از یک registry محلی پشتیبانی میکند: همهی imageها (Ceph، Prometheus، Grafana، Alertmanager، node-exporter و ...) را در registry داخلی قرار میدهید و cephadm را به آن ارجاع میدهید.
# روی ماشینی با دسترسی اینترنت: image را بکشید و به registry داخلی بفرستید
podman pull quay.io/ceph/ceph:v20.2.5
podman tag quay.io/ceph/ceph:v20.2.5 registry.internal:5000/ceph/ceph:v20.2.5
podman push registry.internal:5000/ceph/ceph:v20.2.5
# bootstrap با image داخلی
cephadm --image registry.internal:5000/ceph/ceph:v20.2.5 bootstrap --mon-ip 192.168.10.11 \
--registry-json /root/registry.json
# ارجاع imageهای پایش به registry داخلی
ceph config set mgr mgr/cephadm/container_image_prometheus registry.internal:5000/prometheus/prometheus:<tag>
ceph config set mgr mgr/cephadm/container_image_grafana registry.internal:5000/ceph/grafana:<tag>فایل registry.json نام کاربری و رمز registry را دارد؛ مجوز آن را 600 بگذارید و پس از bootstrap حذفش کنید (cephadm اعتبارنامه را درون کلاستر نگه میدارد). برچسب دقیق imageهای پایش را از مستندات نسخهی خودتان یا از خروجی ceph config get mgr mgr/cephadm/container_image_prometheus روی یک کلاستر آزمایشی همنسخه بردارید، نه از حدس.
۱۱-۶-۳ پس از bootstrap#
ceph -s
ceph orch host ls
ceph orch device ls --wide
ceph cephadm check-host ceph-node2
ceph health mute CEPHADM_STRAY_DAEMON 1h # فقط اگر علت را میدانید و موقتی است
ceph orch ls --export > /srv/ceph-gitops/specs/cluster.yamlنخستین خروجی ceph orch ls --export را بلافاصله در Git ثبت کنید. این «خط مبنا» است و همهی تغییرات بعدی باید از آن طریق بازبینی شوند.
۱۱-۷ از درون کد: حلقهی serve در cephadm و spec اوسدی#
۱۱-۷-۱ orchestrator اعلانی#
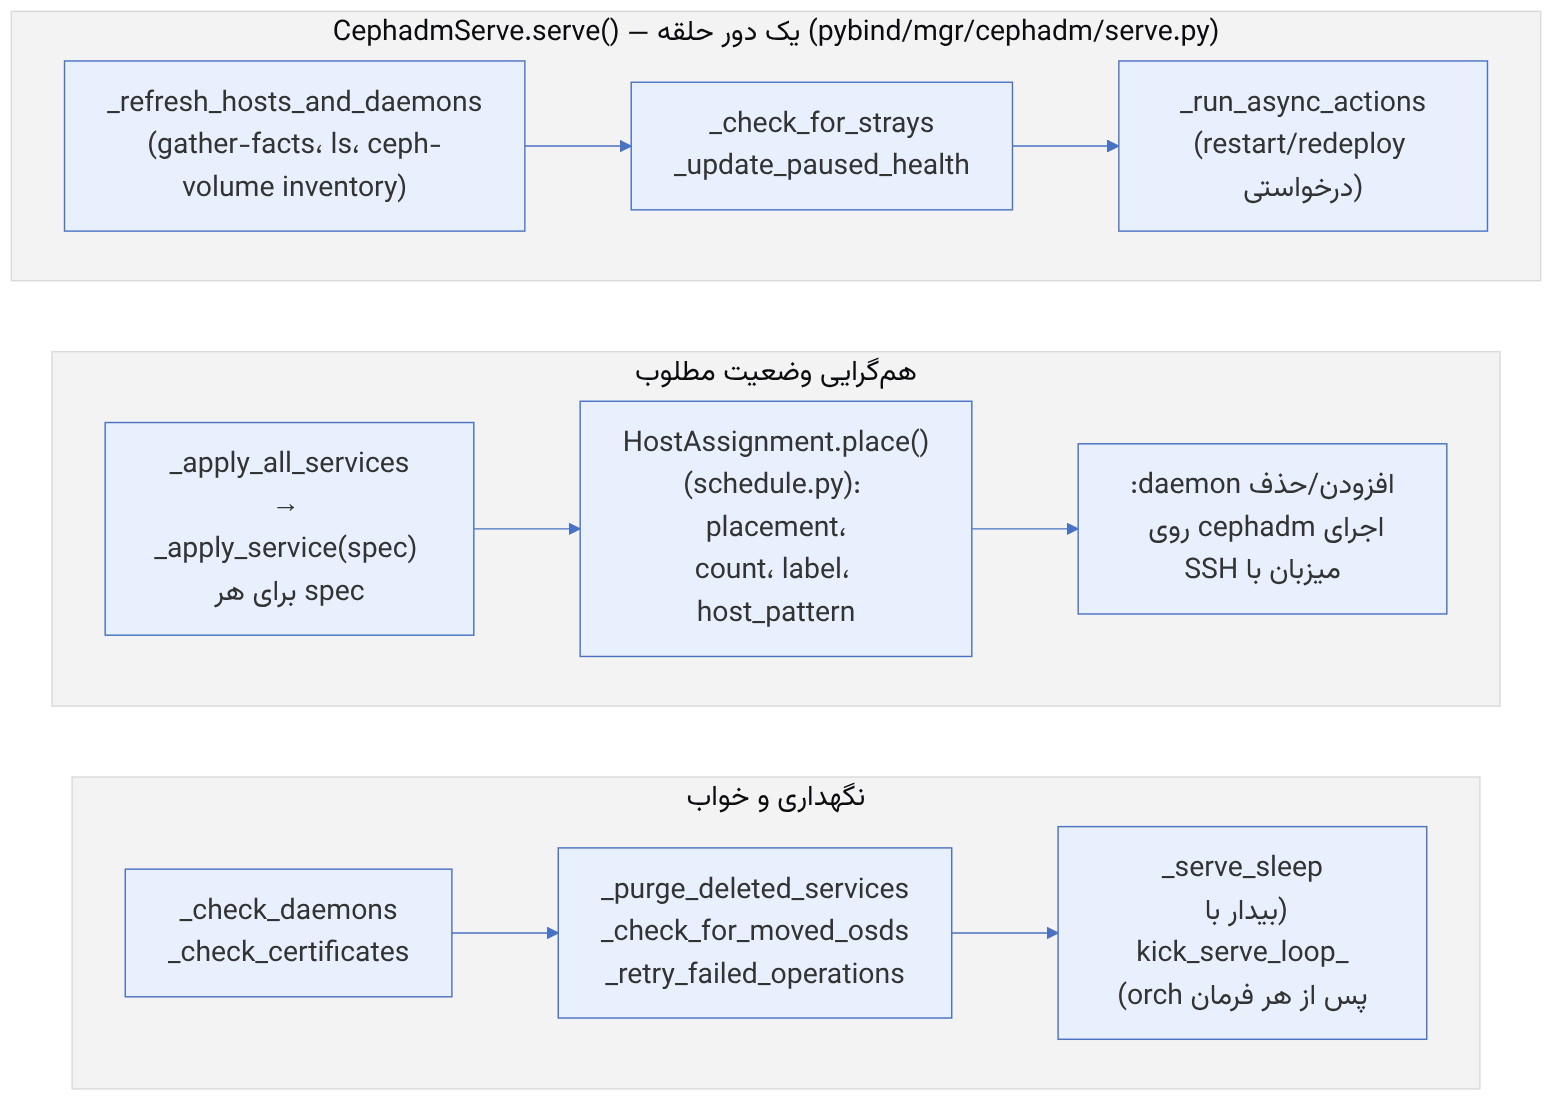
cephadm یک ماژول mgr است (src/pybind/mgr/cephadm/). قلب آن کلاس CephadmServe در serve.py است که یک حلقهی همگرایی (reconcile loop) را اجرا میکند و به همین دلیل از نظر ایده به کنترلرهای Kubernetes شبیه است. وضعیت مطلوب specهایی است که با ceph orch apply ذخیره شدهاند. وضعیت واقعی کشی از اطلاعات میزبانها است که با اجرای باینری cephadm از طریق SSH روی هر میزبان جمعآوری میشود.
| گزینهی ماژول (module.py) | پیشفرض | نقش |
|---|---|---|
| device_cache_timeout | ۱۸۰۰ ثانیه | تازهسازی inventory دستگاهها |
| daemon_cache_timeout | ۶۰۰ ثانیه | تازهسازی فهرست daemonها |
| facts_cache_timeout | ۶۰۰ ثانیه | تازهسازی gather-facts |
| host_check_interval | ۶۰۰ ثانیه | بررسی دسترسی SSH و سلامت میزبان |
| max_count_per_host | ۱۰ | سقف daemon از یک نوع روی یک میزبان |
به همین دلیل یک دیسک تازه نصبشده ممکن است تا ۳۰ دقیقه در ceph orch device ls دیده نشود. برای تازهسازی فوری از ceph orch device ls --refresh استفاده کنید.
۱۱-۷-۲ spec اوسدی و DriveSelection#
spec اوسدی کلاس DriveGroupSpec در src/python-common/ceph/deployment/drive_group.py است که از ServiceSpec ارث میبرد. فیلترهای دستگاه (DeviceSelection: rotational، size، model، vendor، paths، limit، all) برای سه نقش data، db و wal تعریف میشوند و DriveSelection در drive_selection/selector.py آنها را روی inventory هر میزبان اعمال میکند. ویژگیهایی مانند encrypted، tpm2، osds_per_device، block_wal_size و osd_id_claims در _supported_features همین کلاس فهرست شدهاند.
# osd-hybrid.yaml — مثال این کتاب: HDD برای داده، NVMe مشترک برای DB
service_type: osd
service_id: hybrid-hdd-nvme
placement:
  label: osd
spec:
  data_devices:
    rotational: 1
    size: '8T:'
  db_devices:
    rotational: 0
    model: 'MZ'          # پیشوند مدل NVMe
    limit: 2
  encrypted: true
objectstore: bluestorepseudocode: اعمال spec اوسدی (خلاصهی این کتاب از serve.py و services/osd.py)
for host in HostAssignment(spec).place():
devs = DriveSelection(spec, inventory[host]) # data/db/wal فیلترشده
cmds = translate to ceph-volume lvm batch ... # بدون دستگاههای در حال استفاده
out = run cephadm ceph-volume --report (dry-run) سپس اجرای واقعی
deploy osd daemons for new osd idsspec اوسدی «پایدار» است: پس از apply، هر دیسک خالی منطبق با فیلتر که بعداً به میزبان اضافه شود، خودکار OSD میشود. اگر این را نمیخواهید، unmanaged: true بگذارید. همیشه ابتدا --dry-run اجرا کنید.
فرمانها:
ceph orch apply -i osd-hybrid.yaml --dry-run
ceph orch ls osd --export
ceph orch device ls --refresh --wide
ceph log last cephadm 50 # رویدادهای حلقهی serve
ceph config set mgr mgr/cephadm/log_to_cluster_level debug
ceph mgr fail # failover؛ حلقه روی mgr جدید از نو شروع میشود۱۱-۸ استقرار با عدد: چهار الگوریتم cephadm و ceph-volume#
cephadm در ظاهر فقط «spec» را میگیرد و daemon میسازد. در عمل، چند الگوریتم کوچک تصمیم میگیرند هر daemon روی کدام میزبان برود، دیسک سریع چطور میان OSDها تقسیم شود و هنگام ارتقا چند OSD همزمان متوقف شوند. این بخش چهار الگوریتم را از کد main (بررسیشده در نوامبر ۲۰۲۶) با مثال عددی دنبال میکند. خروجی همهی مثالها با اجرای همان منطق در پایتون به دست آمده است. جزئیات این توابع در نسخههای مختلف تغییر کردهاند (مثلاً منطق «سرویس مرتبط» برای ingress جدیدتر است)، پس پیش از تکیه بر جزئیات، کد نسخهی خود را بخوانید.
۱۱-۸-۱ انتخاب میزبان: HostAssignment#
منبع در کد: src/pybind/mgr/cephadm/schedule.py :: HostAssignment.place، get_candidates
پیچیدگی: O(H log H) برای مرتبسازی و shuffle؛ O(D × H) برای تطبیق D daemon موجود با H شکاف
pseudocode
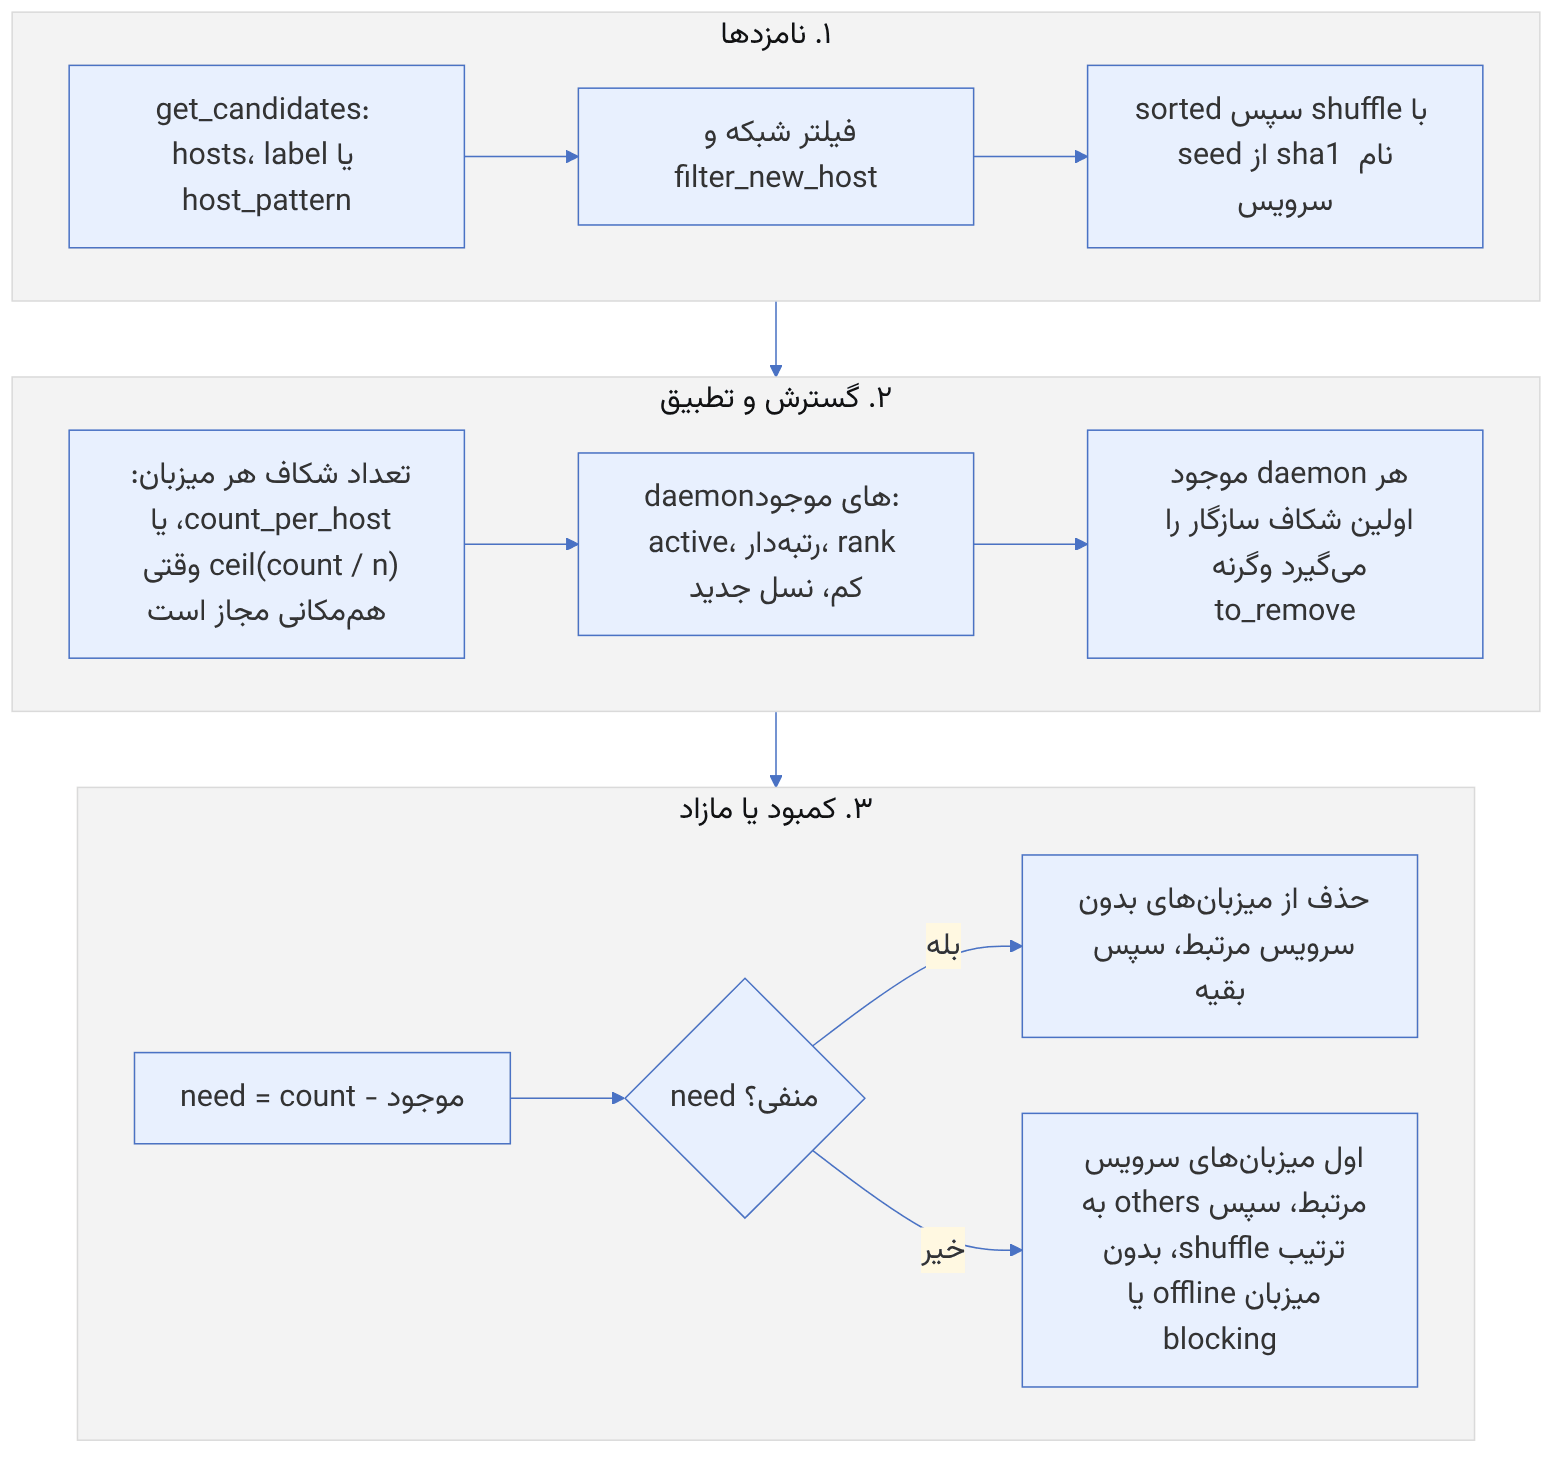
candidates = میزبانهایی که با hosts یا label یا host_pattern در placement میخوانند
candidates = فیلتر شبکه (networks یا ip_addrs) و filter_new_host
seed = int(sha1(service_name), 16) mod 2^32
candidates = shuffle(sorted(candidates), Random(seed)) # قطعی برای هر نام سرویس
slots = count_per_host شکاف برای هر میزبان یا ceil(count / |candidates|) اگر هممکانی مجاز است
daemons = مرتب بر اساس (active اول، رتبهدار اول، rank کمتر، نسل جدیدتر)
for d in daemons: اگر شکافی با d سازگار است ⇒ existing ، وگرنه to_remove
need = count − |existing|
if need < 0: حذف از انتهای existing (اول از میزبانهای بدون سرویس مرتبط)
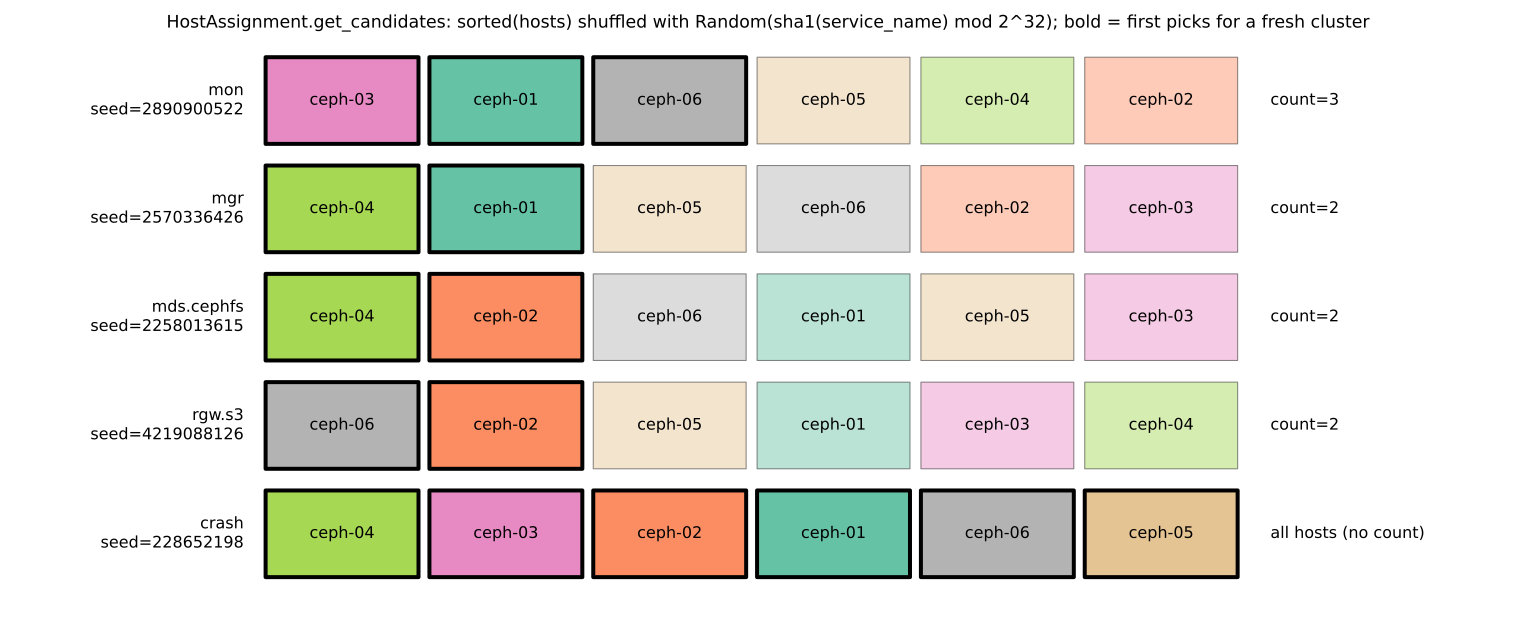
else: ابتدا میزبانهای دارای سرویس مرتبط، سپس others به همان ترتیب shuffle، بدون میزبان offline یا blockingمثال عددی. کلاستر تازهای با شش میزبان ceph-01 تا ceph-06 داریم و هیچ daemon موجودی نیست. برای سرویس mon، مقدار sha1 به seed = ۲۸۹۰۹۰۰۵۲۲ میرسد و ترتیب shuffle این است: ceph-03، ceph-01، ceph-06، ceph-05، ceph-04، ceph-02. با count: 3، سه monitor روی ceph-03، ceph-01 و ceph-06 میروند. سرویس mgr با seed = ۲۵۷۰۳۳۶۴۲۶ ترتیب دیگری دارد: ceph-04، ceph-01، ceph-05 و بقیه. پس با count: 2 دو mgr روی ceph-04 و ceph-01 مینشینند.
این دو ویژگی مهماند. اول، قطعی است: اگر mgr فعال عوض شود یا cephadm دوباره اجرا شود، همان نتیجه به دست میآید و daemonها بیدلیل جابهجا نمیشوند. دوم، برای هر سرویس متفاوت است: همهی سرویسها روی میزبان اول جمع نمیشوند. اگر بعداً ceph-03 حذف شود، monitor روی آن به to_remove میرود. اولین میزبان آزاد بعدی در ترتیب shuffle (ceph-۰۵) جای آن را میگیرد، و دو monitor دیگر دست نمیخورند.
۱۱-۸-۲ تقسیم NVMe میان OSDها: ceph-volume batch#
منبع در کد: src/ceph-volume/ceph_volume/devices/lvm/batch.py :: Batch.fast_allocations، get_physical_fast_allocs
پیچیدگی: O(F × S) برای F دستگاه سریع و S شکاف
pseudocode
fast_slots_per_device = ceil((OSDهای خواستهشده − LVهای سریع آماده) / max(1, دستگاههای سریع فیزیکی))
requested_slots = db_slots از spec (اگر کمتر بود نادیده و برابر fast_slots_per_device)
requested_size = block_db_size از spec یا ceph.conf (پیشفرض 0 یعنی خودکار)
برای هر دستگاه سریع:
abs_size = vg_size / slots_for_vg
اگر abs_size > vg_free: abs_size = vg_free / fast_slots_per_device # VG نیمهپر
اگر requested_size ≤ abs_size: abs_size = requested_size
اگر requested_size تا 1٪ بزرگتر است: همان abs_size (خطای همترازی PE)
وگرنه: خطا و خروج
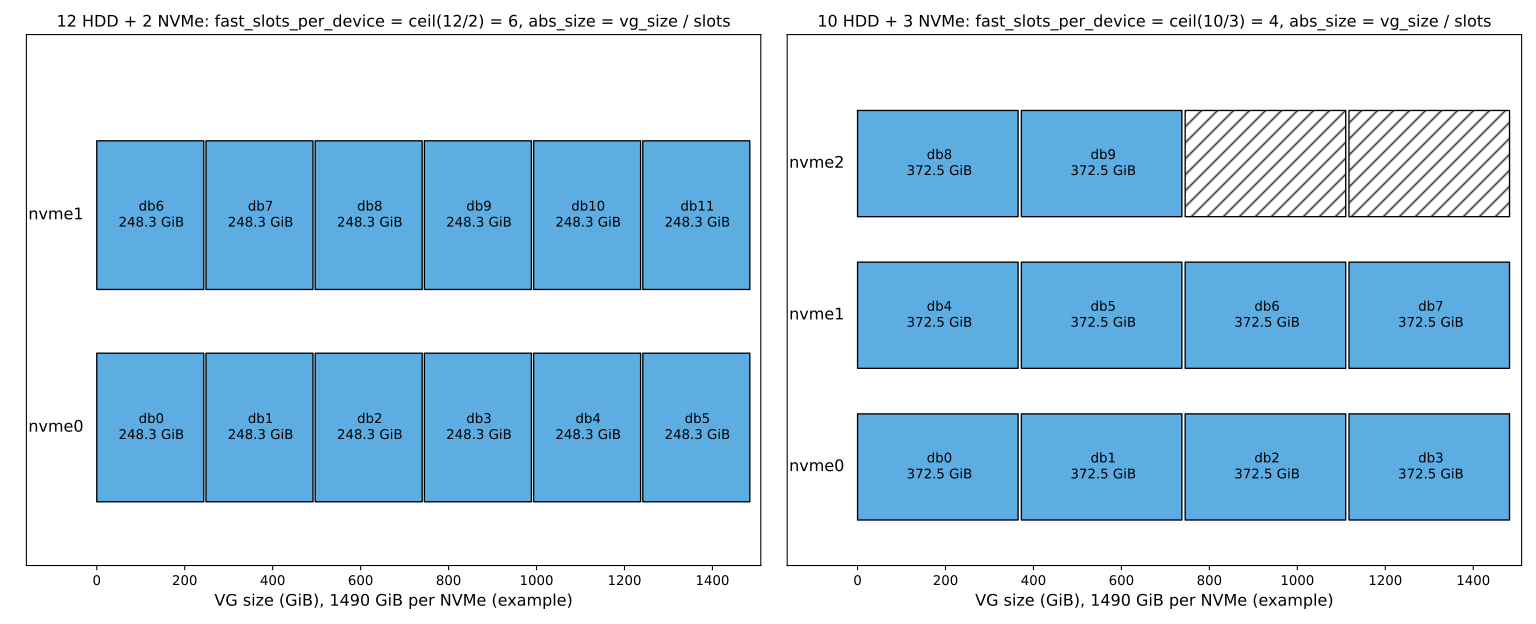
تا وقتی جا هست و OSD کم است و شکافها پر نشدهاند: یک LV با abs_size بسازمثال عددی. یک میزبان ۱۲ HDD و ۲ NVMe دارد. فرض کنید VG هر NVMe پس از همترازی LVM حدود ۱۴۹۰ GiB باشد (عدد مثال است، نه اندازهگیری). fast_slots_per_device = ⌈۱۲ / ۲⌉ = ۶، پس هر DB برابر ۱۴۹۰ / ۶ ≈ ۲۴۸.۳ GiB است و هر NVMe دقیقاً شش DB میگیرد. حالا ۱۰ HDD و ۳ NVMe را در نظر بگیرید. fast_slots_per_device = ⌈۱۰ / ۳⌉ = ۴ و هر DB برابر ۱۴۹۰ / ۴ = ۳۷۲.۵ GiB است. NVMe اول و دوم هر کدام چهار DB میگیرند و NVMe سوم فقط دو DB، چون شرط len(ret) < new_osds پس از ده DB متوقف میشود. نیمی از NVMe سوم خالی میماند. اگر تقسیم متوازن میخواهید (مثلاً سه NVMe با ۴، ۳ و ۳ DB)، باید db_slots یا block_db_size را صریح بدهید، یا تعداد HDDها را مضربی از NVMeها بگیرید. اندازهی DB تنها عامل مهم نیست. با عدد بالا و جایگذاری RocksDB که در فصل ۱۶ دیدیم، ۲۴۸ GiB فضای کافی برای سطوح سریع میدهد.
۱۱-۸-۳ ارتقای مرحلهای: ترتیب daemonها#
منبع در کد: src/pybind/mgr/cephadm/utils.py :: CEPH_UPGRADE_ORDER؛ src/pybind/mgr/cephadm/upgrade.py :: CephadmUpgrade._do_upgrade، _to_upgrade
پیچیدگی: O(T × D) برای T نوع daemon و D daemon؛ هر OSD با یک بررسی ok-to-stop
pseudocode
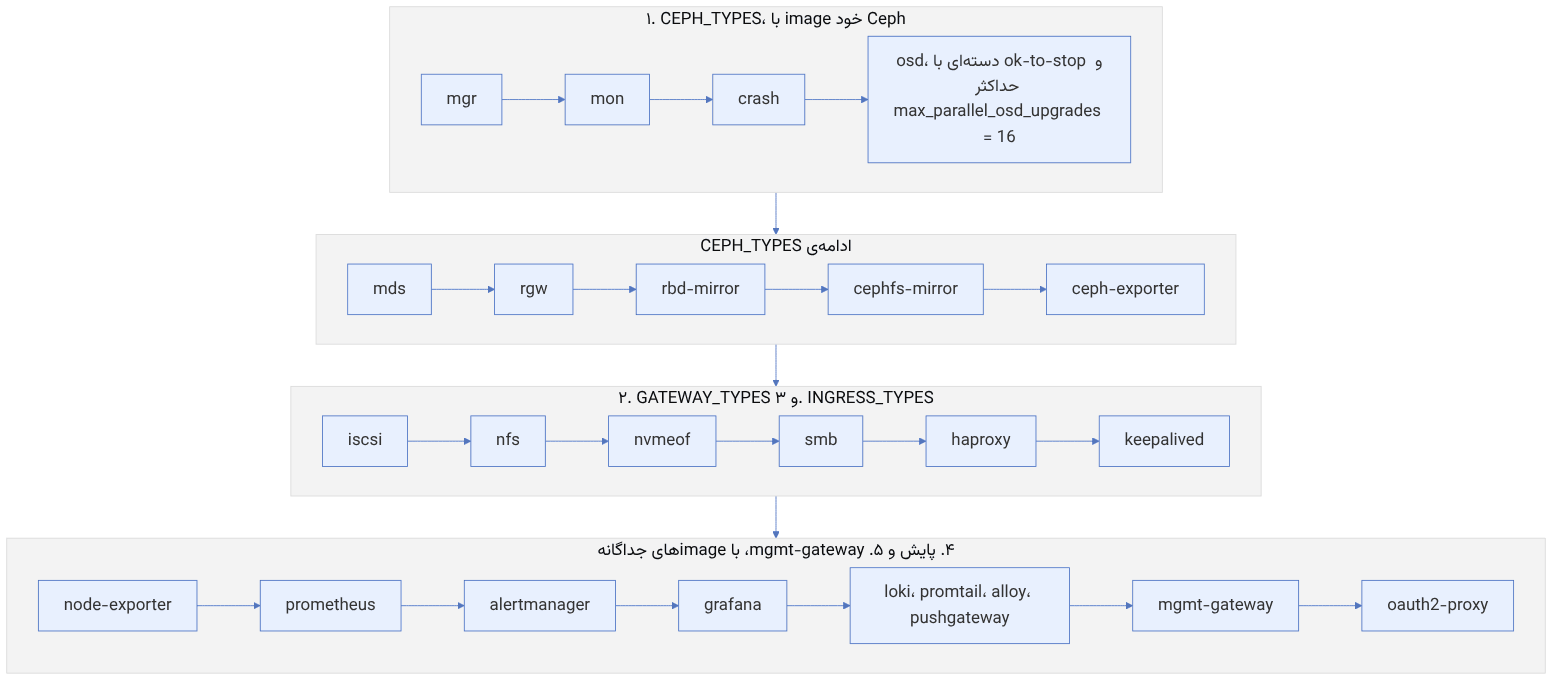
ORDER = [mgr, mon, crash, osd, mds, rgw, rbd-mirror, cephfs-mirror, ceph-exporter] # CEPH_TYPES
+ [iscsi, nfs, nvmeof, smb] + [haproxy, keepalived]
+ [node-exporter, prometheus, alertmanager, grafana, loki, promtail, alloy, pushgateway]
+ [mgmt-gateway, oauth2-proxy]
for type in ORDER (یا زیرمجموعهی --daemon-types / --services):
for d in daemonهای آن نوع که image قدیمی دارند:
mon: فقط اگر monmap بیش از 2 monitor دارد، ok-to-stop بپرس
osd: یک دسته با «osd ok-to-stop … --max max_parallel_osd_upgrades (16)»
mgr: ابتدا mgr آمادهبهکار ارتقا مییابد و سپس failover
redeploy با image جدید ؛ منتظر بمان تا daemon بالا بیایدمثال عددی. کلاستری با ۳ mon، ۲ mgr، ۳۶ OSD (سه میزبان، دوازده OSD در هر میزبان، replicated size 3 و failure domain = host) و ۲ RGW داریم. ترتیب: mgr آمادهبهکار و failover، سپس mgr دیگر. بعد سه mon یکییکی. سپس OSDها در دستههای حداکثر ۱۶ تایی. چون الگوریتم ok-to-stop (بخش بعد) هر دسته را درون یک میزبان نگه میدارد، هر دسته ۱۲ OSD است و سه دسته لازم است. آخر هم RGWها. در هر لحظه حداکثر یک میزبان OSD متوقف است و هیچ PG زیر min_size نمیرود.
۱۱-۸-۴ چند OSD را میتوان همزمان خاموش کرد؟#
منبع در کد: src/mgr/DaemonServer.cc :: DaemonServer::_maximize_ok_to_stop_set، _check_offlines_pgs
پیچیدگی: هر آزمایش O(P × r) برای P PG با r عضو؛ حداکثر O(N) آزمایش برای N OSD
pseudocode
check(S): برای هر PG که عضوی در S دارد:
acting' = acting − S (اگر degraded: فقط عضوهای بدون missing)
اگر PG فعال نیست یا pool ندارد یا |acting'| < min_size ⇒ not_ok
maximize(S0, max):
اگر check(S0) ناامن ⇒ پایان ؛ اگر |S0| ≥ max ⇒ پایان
parent = نخستین OSD در S0
loop:
parent = والد بیواسطهی parent در CRUSH (host، سپس rack، … ، root)
برای هر OSD بالای (up) زیر parent به ترتیب شناسه:
S += o ؛ اگر check(S) ناامن ⇒ S −= o ، failed++
اگر |S| == max ⇒ پایان
اگر failed > 0 ⇒ پایان (با آنچه تا اینجا امن بوده)مثال عددی. شبیهسازی ما ۴ میزبان با ۳ OSD در هر کدام دارد، و ۱۲۸ PG با size = ۳ و min_size = ۲ که هر PG روی سه میزبان متفاوت است. از osd.0 شروع میکنیم. والد اول host-a است: osd.1 و osd.2 اضافه میشوند، چون هیچ PG دو عضو روی یک میزبان ندارد و هر PG با از دست دادن یک میزبان دو عضو باقی دارد. والد بعدی root است. افزودن osd.3 روی host-b هجده PG را به یک عضو میرساند، پس رد میشود. همهی OSDهای دیگر هم با ۱۵ تا ۲۸ PG ناامن رد میشوند. چون failed > ۰ است، نتیجه {۰، ۱، ۲} است، یعنی دقیقاً یک میزبان. برای pool با EC 4+2 روی شش میزبان (دو OSD در هر میزبان)، با min_size پیشفرض k + ۱ = ۵ فقط OSDهای یک میزبان مجازند. اگر min_size را به k = ۴ کم کنیم، دو میزبان مجاز میشوند، اما در آن حالت هر خرابی دیگری PG را غیرفعال میکند و دادهی تازه بدون هیچ افزونگی نوشته میشود.
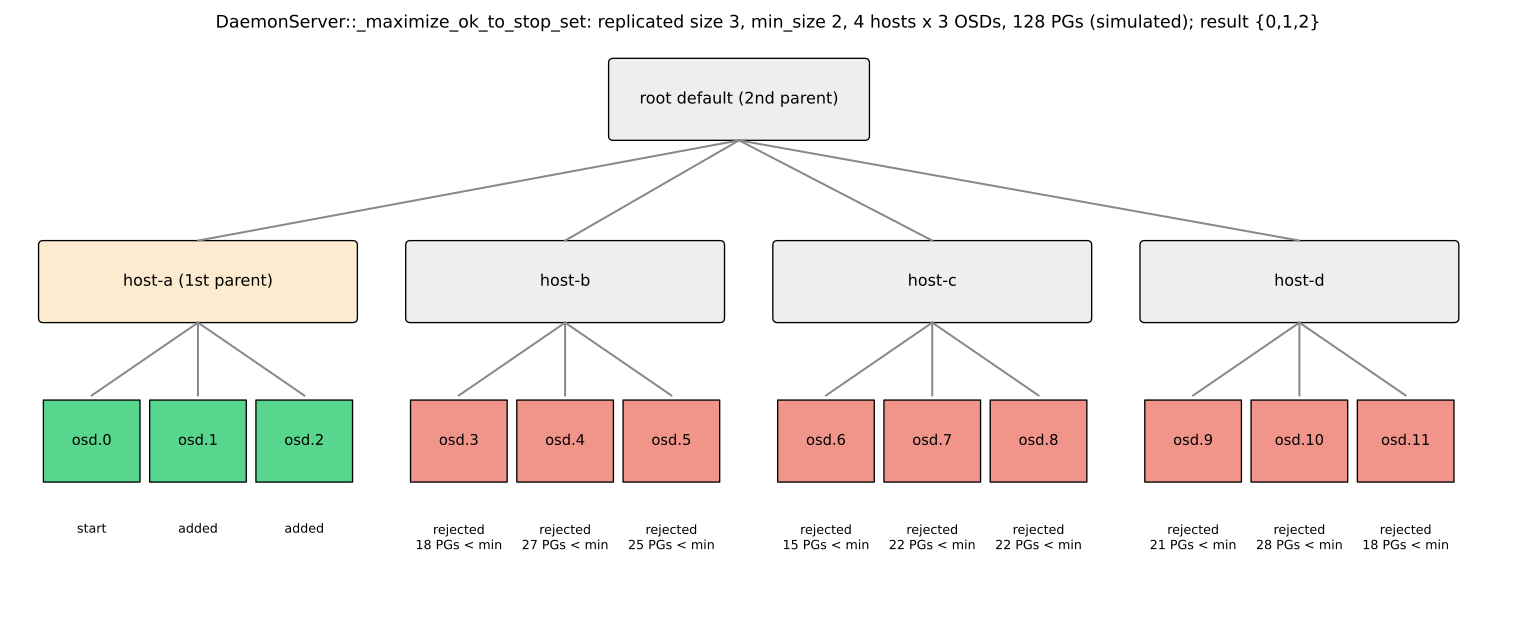
این الگوریتم حریصانه است، نه بهینه. ممکن است مجموعهی بزرگتری وجود داشته باشد که از OSD دیگری شروع شود، اما الگوریتم آن را پیدا نمیکند. ترتیب پیمایش بر اساس شناسهی عددی OSD است، نه بر اساس ساختار درخت. نکتهی عملی: اگر کلاستری PG degraded داشته باشد، check فقط عضوهای «بدون missing» را میشمارد. بنابراین در کلاستر نیمهسالم، ارتقا ممکن است هر بار فقط یک OSD را متوقف کند یا اصلاً پیش نرود. پیام upgrade: waiting for ok-to-stop در ceph orch upgrade status معمولاً همین است و راهحلش رسیدن به HEALTH_OK پیش از ارتقاست، نه بالا بردن max_parallel_osd_upgrades.
۱۱-۹ Ceph درون Kubernetes با Rook#
۱۱-۹-۱ معماری#
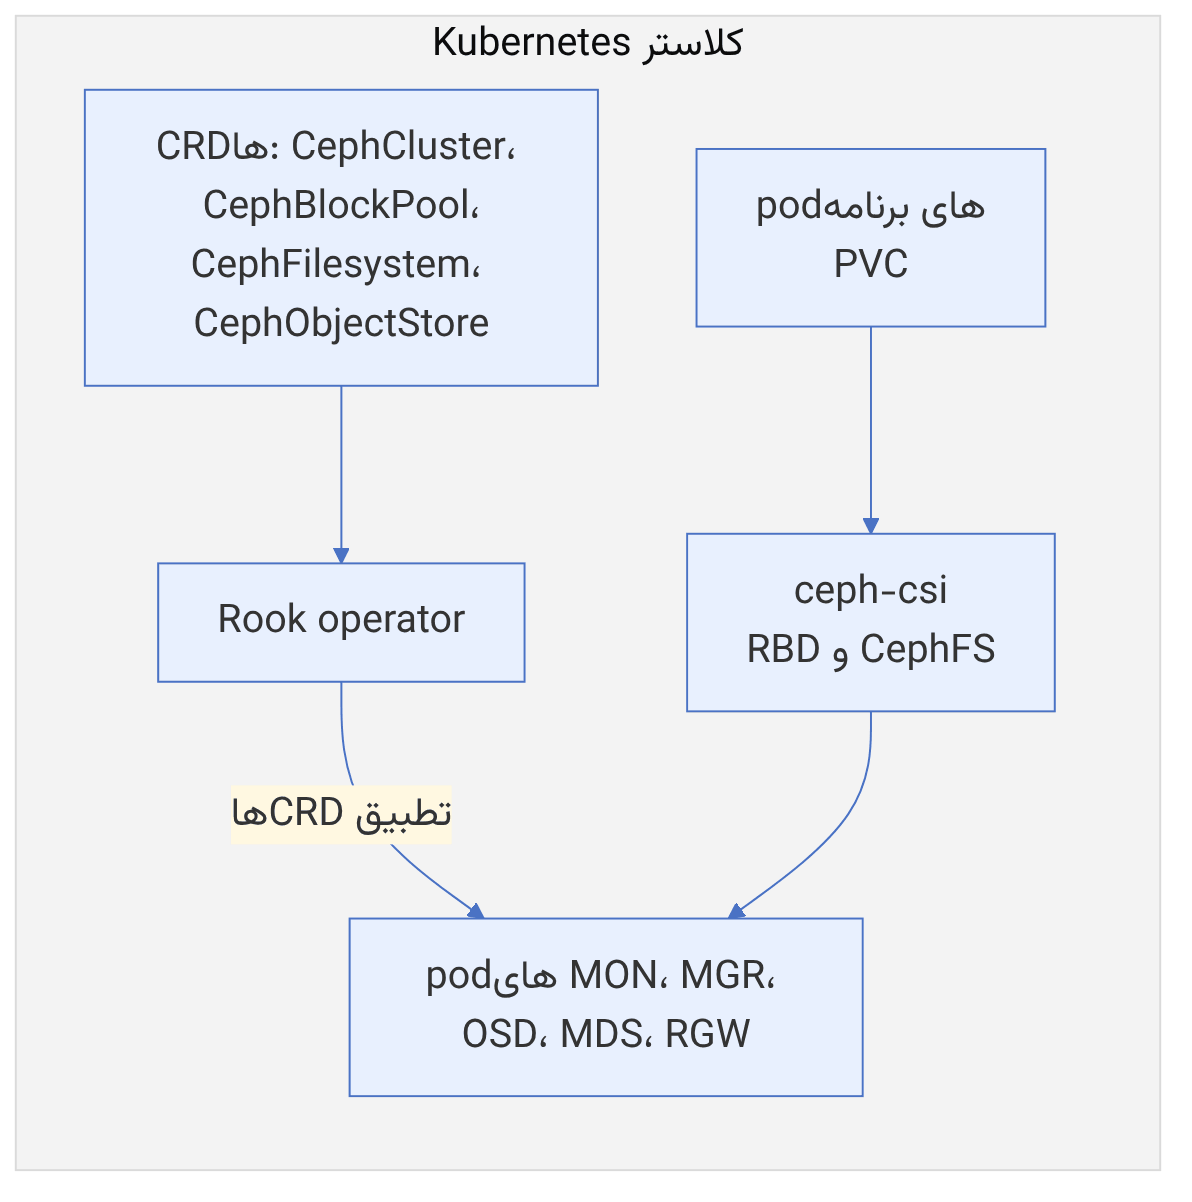
Rook یک operator در Kubernetes است که کلاستر Ceph را از روی منابع سفارشی (CRD) میسازد و نگه میدارد. همان ایدهی اعلانی cephadm، این بار با ابزارهای بومی Kubernetes: kubectl apply، Helm و GitOps. درایور ceph-csi هم PVCهای RBD (ReadWriteOnce) و CephFS (ReadWriteMany) را برای podها فراهم میکند.
۱۱-۹-۲ چه زمانی Rook؟#
| معیار | cephadm | Rook |
|---|---|---|
| مصرفکنندهی اصلی | VMها، OpenStack، سرویسهای عمومی | بارهای Kubernetes |
| وابستگی | فقط سیستمعامل و موتور کانتینر | کلاستر Kubernetes سالم و پایدار |
| دامنهی خرابی | مستقل از لایهی بالاتر | خرابی Kubernetes بر مدیریت Ceph اثر دارد |
| تجربهی تیم | مدیر سامانه و ذخیرهسازی | تیم پلتفرم Kubernetes |
Ceph درون همان کلاستر Kubernetesی که برنامهها را اجرا میکند (hyperconverged) وابستگی چرخهای میسازد: اگر Kubernetes به مشکل بخورد، ذخیرهسازی هم مختل میشود و برعکس. برای کلاسترهای بزرگ، گرههای ذخیرهسازی را با taint و label جدا کنید یا Ceph را بیرون از Kubernetes با cephadm مستقر و از Rook در حالت external cluster فقط برای اتصال استفاده کنید.
۱۱-۹-۳ نصب پایه#
helm repo add rook-release https://charts.rook.io/release
helm install --create-namespace --namespace rook-ceph rook-ceph rook-release/rook-ceph
kubectl -n rook-ceph get pods# cluster.yaml (خلاصه)
apiVersion: ceph.rook.io/v1
kind: CephCluster
metadata:
name: rook-ceph
namespace: rook-ceph
spec:
cephVersion:
image: quay.io/ceph/ceph:v20.2.4
dataDirHostPath: /var/lib/rook
mon:
count: 3
allowMultiplePerNode: false
dashboard:
enabled: true
storage:
useAllNodes: false
useAllDevices: false
nodes:
- name: k8s-storage-1
devices: [{name: sdb}, {name: sdc}]
- name: k8s-storage-2
devices: [{name: sdb}, {name: sdc}]
- name: k8s-storage-3
devices: [{name: sdb}, {name: sdc}]kubectl apply -f cluster.yaml
kubectl -n rook-ceph get cephcluster
kubectl -n rook-ceph exec deploy/rook-ceph-tools -- ceph -s # نیازمند استقرار toolboxنسخهی image بالا همان چیزی است که مثال رسمی مستندات Rook در زمان نگارش استفاده میکند. هنگام استفاده، جدول نسخههای پشتیبانیشدهی Ceph در مستندات نسخهی Rook خود را بررسی کنید. useAllDevices: true در production خطرناک است؛ دیسکها را صریحاً نام ببرید یا با فیلتر مشخص کنید.
۱۱-۱۰ مدیریت تغییر و پیکربندی#
۱۱-۱۰-۱ GitOps برای ذخیرهسازی#
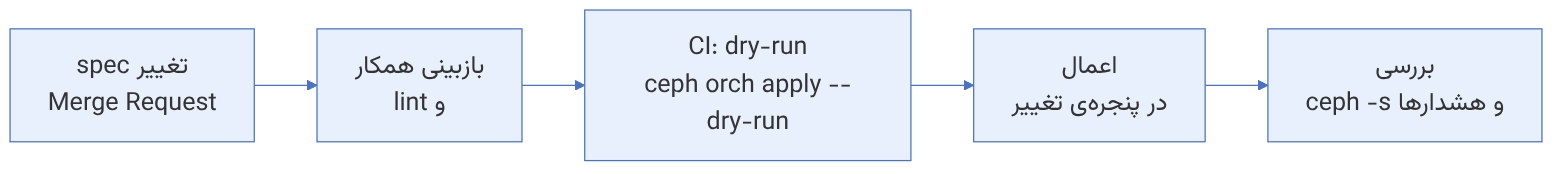
ذخیرهسازی جایی نیست که «تغییر سریع در کنسول» قابل قبول باشد. اصولی که پیشنهاد میکنیم:
- یک منبع حقیقت: specهای cephadm (یا CRDهای Rook) و خروجی
ceph config dump در Git. - بازبینی همتا: هر تغییر از طریق Merge Request با توضیح انگیزه، ریسک و روش بازگشت.
- dry-run خودکار: CI خروجی
ceph orch apply --dry-run را به Merge Request پیوست کند. - پنجرهی تغییر: تغییرات پرخطر (CRUSH، tunable، EC profile، ارتقا) در ساعات کمبار و با اپراتور آماده.
- بررسی پس از تغییر:
ceph -s، هشدارها و نمودارهای تأخیر تا دستکم یک ساعت. - تشخیص drift: کار زمانبندیشدهای که
ceph orch ls --export و ceph config dump را با Git مقایسه کند و اختلاف را گزارش دهد.
#!/usr/bin/env bash
# drift-check.sh: مقایسهی وضعیت کلاستر با مخزن
set -euo pipefail
cd /srv/ceph-gitops
ceph orch ls --export > /tmp/live-specs.yaml
ceph config dump --format json | jq -S 'sort_by(.section, .name)' > /tmp/live-config.json
diff -u specs/cluster.yaml /tmp/live-specs.yaml || echo "SPEC DRIFT"
diff -u config/config.json /tmp/live-config.json || echo "CONFIG DRIFT"drift همیشه بد نیست: تعویض دیسک یا autotune حافظه ممکن است تغییراتی ایجاد کنند. هدف این است که هر اختلاف یا آگاهانه به Git برگردد یا در کلاستر اصلاح شود، نه اینکه بیصدا انباشته شود.
- آزمایشگاه سهگرهای قابل بازسازی، با همان نسخه و روش استقرار production.
- cephadm برای میزبانها، Rook برای Kubernetes؛ ceph-deploy را کنار بگذارید.
- کل کلاستر در spec؛ همیشه
--dry-run پیش از apply. - فیلتر دستگاه مشخص؛ از
all-available-devices در production پرهیز کنید. - Ansible برای سیستمعامل، cephadm برای Ceph.
- مهاجرت از ceph-ansible با adopt و پس از تمرین در آزمایشگاه.
- Git منبع حقیقت؛ drift را پایش کنید.
۱۱-۱۱ تکمیلی و بهروز#
- ceph-deploy: مخزن در GitHub آرشیو شده است.
- ceph-ansible: طبق README خود پروژه فعلاً نگهداری میشود، اما مهاجرت به cephadm توصیه شده است؛ playbook
cephadm-adopt.yml برای همین کار وجود دارد. - cephadm-ansible: playbookهای کمکی برای آمادهسازی میزبانها.
- Umbrella: imageهای el10، نیاز به CPU x86-64-v3 و پایتون ۳.۹ یا جدیدتر برای cephadm.
- Rook: نسخهی v1.21.2 در زمان نگارش؛ مثال رسمی CephCluster از image Tentacle استفاده میکند.
۱۱-۱۲ تمرین عملی#
- ۱. با Vagrant و libvirt (یا ابزار دلخواه) سه گره و یک کلاینت بسازید، سپس با
vagrant destroy پاک و دوباره بسازید و زمان کل را یادداشت کنید. - ۲. فایل
cluster.yaml این فصل را با نام میزبانها و دیسکهای خود تطبیق دهید و با --apply-spec در bootstrap اعمال کنید. - ۳. با
--dry-run دو spec OSD متفاوت (بر اساس rotational و بر اساس size) را مقایسه کنید. - ۴. playbook آمادهسازی را با
--check --diff اجرا کنید و سپس واقعاً اعمال کنید. - ۵. در یک کلاستر Kubernetes آزمایشی (مثلاً با سه VM)، Rook را نصب و یک PVC از نوع RBD ایجاد کنید.
- ۶. اسکریپت drift-check را اجرا کنید، سپس یک تنظیم را دستی تغییر دهید و ببینید drift گزارش میشود.
۱۱-۱۳ پرسشهای مرور#
- ۱. چرا ceph-deploy دیگر گزینهی مناسبی نیست؟
- ۲. تفاوت فلسفی ceph-ansible و cephadm چیست؟
- ۳. چرا برای آزمایشگاه Umbrella باید مدل CPU مجازی را بررسی کرد؟
- ۴. گزینهی
--single-host-defaults چه کاری میکند و محدودیت کلاستر تکگره چیست؟ - ۵. چرا
--dry-run پیش از اعمال spec OSD مهم است؟ - ۶. چرا فیلتر
rotational در محیط مجازی ممکن است گمراهکننده باشد؟ - ۷. تقسیم کار پیشنهادی بین Ansible و cephadm چیست؟
- ۸. مسیر مهاجرت از ceph-ansible به cephadm چیست؟
- ۹. ریسک اجرای Ceph درون همان کلاستر Kubernetes برنامهها چیست و راه کاهش آن کدام است؟
- ۱۰. تشخیص drift چه فایدهای دارد؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۱-۱۴ منابع این فصل#
- Deploying a new cluster (cephadm
https://docs.ceph.com/en/latest/cephadm/install/ - Host management
https://docs.ceph.com/en/latest/cephadm/host-management/ - OSD service specs
https://docs.ceph.com/en/latest/cephadm/services/osd/ - Service management
https://docs.ceph.com/en/latest/cephadm/services/ - Converting an existing cluster to cephadm
https://docs.ceph.com/en/latest/cephadm/adoption/ - ceph-ansible
https://github.com/ceph/ceph-ansible - cephadm-ansible
https://github.com/ceph/cephadm-ansible - ceph-deploy (archived
https://github.com/ceph/ceph-deploy - Rook documentation
https://rook.io/docs/rook/latest-release/ - Rook CephCluster CRD
https://rook.io/docs/rook/latest-release/CRDs/Cluster/ceph-cluster-crd/ - vagrant-libvirt
https://vagrant-libvirt.github.io/vagrant-libvirt/ - Umbrella release notes
https://docs.ceph.com/en/latest/releases/umbrella/