لایهبندی ذخیرهسازی: از Cache Tiering تا Device Class و Storage Class
حوصله ندارم این فصل در چند خط
- cache tiering یک pool سریع را جلوی pool پایه میگذارد، اما از Reef منسوخ شده است.
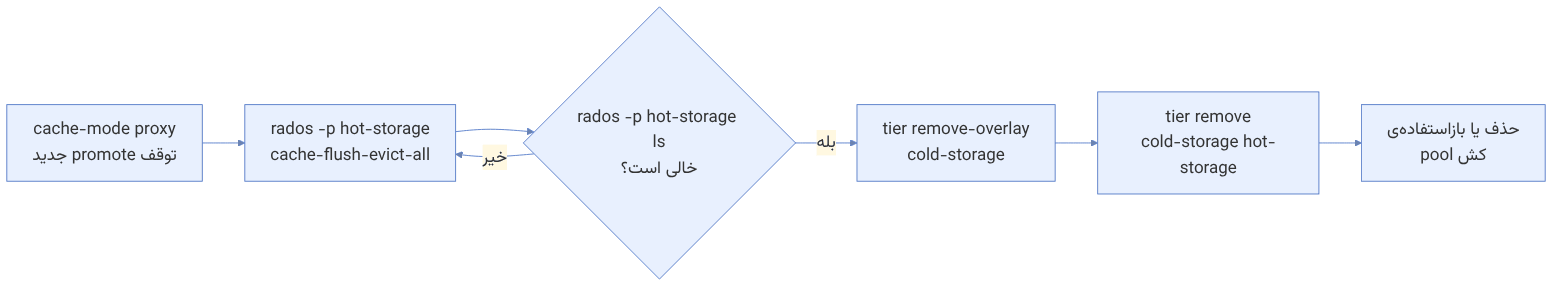
- cache tier موجود را با احتیاط بردارید: فضای آزاد pool پایه را بررسی کنید، flush و evict کنید و بعد overlay را حذف کنید.
- جایگزینهای امروز: device class و قانون CRUSH برای هر pool، جدا کردن دادهی داغ و سرد در خود برنامه، و storage class در RGW با انتقالهای lifecycle.
- دادهی RocksDB هم درون BlueStore میان دستگاه سریع و کند تقسیم میشود.
۱۶-۱ پیش از شروع#
۱۶-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
هر کلاستر بزرگی دیر یا زود با این پرسش روبهرو میشود: چطور دادهی داغ را روی رسانهی سریع و گران و دادهی سرد را روی رسانهی ارزان و پرظرفیت نگه داریم؟ Ceph سالها پاسخ «رسمی» به این پرسش داشت: Cache Tiering. امروز وضعیت متفاوت است. مستندات رسمی صریحاً میگوید cache tiering در Reef منسوخ (deprecated) شده، مدتهاست نگهدارنده ندارد و ممکن است در نسخهای آینده بدون اطلاع قبلی حذف شود؛ نباید cache tier جدید ساخت و استقرارهای موجود باید هرچه زودتر مهاجرت کنند. این فصل هر دو روی سکه را پوشش میدهد:
- cache tiering چگونه کار میکرد و چرا برای بیشتر بارها کارایی را کاهش میداد؟
- عامل کش (tier agent) درون OSD با چه الگوریتمی flush و evict میکرد؟
- اگر هنوز cache tier دارید، چگونه آن را بیخطر حذف کنید؟
- جایگزینهای امروزی کداماند: device class و قانونهای CRUSH، block.db روی NVMe، storage class و lifecycle در RGW؟
۱۶-۲ Cache Tiering: معماری#
۱۶-۲-۱ overlay و pool کش#
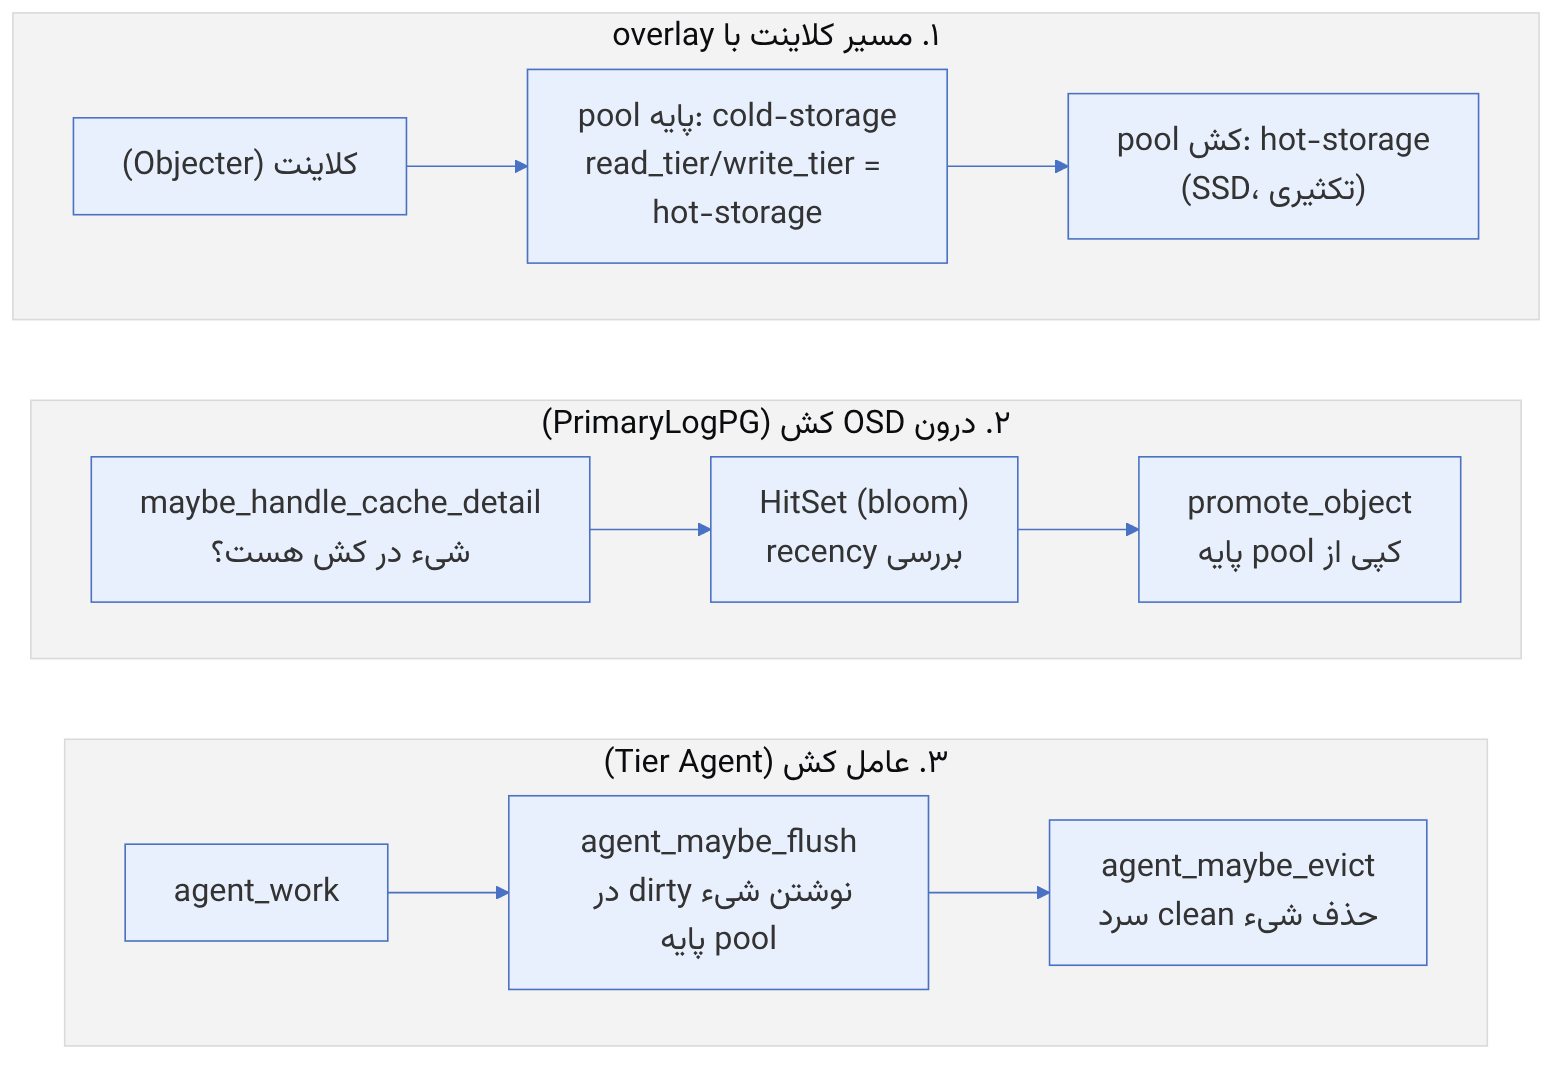
در cache tiering، یک pool سریع (کش) جلوی یک pool پایه (backing) قرار میگیرد. با set-overlay، OSDMap برای pool پایه فیلدهای read_tier و write_tier را به pool کش اشاره میدهد. Objecter کلاینت این فیلدها را میبیند و درخواستها را بهطور شفاف به pool کش میفرستد؛ کلاینت لازم نیست چیزی دربارهی کش بداند.
# فقط برای درک یا آزمایشگاه؛ در کلاستر تولیدی cache tier جدید نسازید
ceph osd tier add cold-storage hot-storage
ceph osd tier cache-mode hot-storage writeback
ceph osd tier set-overlay cold-storage hot-storage
ceph osd pool set hot-storage hit_set_type bloom
ceph osd pool set hot-storage hit_set_count 12
ceph osd pool set hot-storage hit_set_period 14400
ceph osd pool set hot-storage target_max_bytes 1099511627776| حالت کش | رفتار |
|---|---|
| writeback | نوشتن در کش و ack فوری؛ عامل بعداً flush میکند؛ خواندنها promote میشوند |
| readproxy | اشیای موجود در کش استفاده میشوند؛ اشیای غایب بدون promote از پایه proxy میشوند |
| readonly | promote فقط روی خواندن؛ نوشتن مستقیم به پایه؛ دادهی کش ممکن است کهنه باشد |
| proxy | همهی عملیات به پایه proxy میشود؛ برای تخلیهی کش writeback |
| none | کش کاملاً غیرفعال |
حالت readonly سازگاری را تضمین نمیکند: پس از نوشتن در pool پایه، نسخهی قدیمی در کش ممکن است همچنان خوانده شود. فقط برای دادهی تغییرناپذیر مناسب بود.
۱۶-۲-۲ HitSet: کدام شیء داغ است؟#
OSD کش برای تصمیم promote باید بداند شیء اخیراً دسترسی داشته یا نه. هر PG در هر بازهی hit_set_period ثانیه یک HitSet میسازد: مجموعهای از اشیایی که در آن بازه دسترسی داشتهاند. نوع پیشنهادی bloom است (src/osd/BloomHitSet.h): فیلتر Bloom با حافظهی کم و احتمال خطای مثبت کنترلشده. انواع دیگر explicit_hash و explicit_object حافظهی بیشتری مصرف میکنند. hit_set_count تعداد HitSetهای نگهداشتهشده و min_read_recency_for_promote تعداد HitSetهای اخیری است که شیء باید در آنها دیده شده باشد تا روی خواندن promote شود؛ مقدار ۰ یعنی همیشه promote.
pseudocode: تصمیم promote (خلاصهی این کتاب از maybe_handle_cache_detail)
if object in cache pool: serve locally
elif mode == writeback/readproxy:
recent = count(h in last min_read_recency HitSets if obj in h)
if recent >= min_read_recency_for_promote: promote_object(obj) # کپی از پایه
else: proxy_read(obj) # خواندن مستقیم از پایهHitSetها خودشان به صورت اشیای مخفی در همان PG کش ذخیره میشوند (hit_set_persist() در PrimaryLogPG.cc) و با hit_set_trim() کوتاه میشوند. این یعنی کش برای ردیابی داغی هم I/O اضافه دارد. هر promote هم یک خواندن از pool پایه و یک نوشتن در کش است؛ اگر الگوی دسترسی پراکنده باشد (بیشتر بارهای RBD)، کش دائماً در حال promote و evict است و کارایی از pool بدون کش هم بدتر میشود. مستندات رسمی همین را صریحاً میگوید: cache tiering برای بیشتر بارها کارایی را کاهش میدهد و فقط وقتی مؤثر است که دسترسیها به مجموعهی کوچکی از اشیا متمرکز باشد (مثلاً RGW با خواندن عمدتاً اشیای تازهنوشته).
۱۶-۳ از درون کد: عامل کش#
۱۶-۳-۱ agent_choose_mode: سنجش پری و کثیفی#
عامل کش در هر PG کش با agent_setup() فعال میشود و OSD در یک thread جدا، agent_work() را روی PGهای فعال اجرا میکند (حداکثر عملیات همزمان با osd_agent_max_ops کنترل میشود که در کد جاری پیشفرضش ۴ است). تصمیم اصلی در PrimaryLogPG::agent_choose_mode() گرفته میشود. نکتهی جالب این است که اهداف کل pool (مثلاً target_max_bytes) با یک «مقسومعلیه» به سهم هر PG تبدیل میشوند: pg_pool_t::get_pg_num_divisor() تعداد PGها را با در نظر گرفتن تقسیم ناتمام (وقتی pg_num توان ۲ نیست) برمیگرداند. همهی نسبتها با واحد میکرو (یکمیلیونیم) و عدد صحیح محاسبه میشوند تا از ممیز شناور پرهیز شود.
pseudocode: agent_choose_mode (بازنویسی این کتاب از PrimaryLogPG.cc)
divisor = pool.get_pg_num_divisor(pgid) # سهم این PG از هدف pool
avg_size = user_bytes / user_objects
dirty_µ = dirty_objs * avg_size * 1e6 / (target_max_bytes / divisor)
full_µ = user_objs * avg_size * 1e6 / (target_max_bytes / divisor)
if target_max_objects: # هر کدام بزرگتر باشد
dirty_µ = max(dirty_µ, dirty_objs * 1e6 / (target_max_objects / divisor))
full_µ = max(full_µ, user_objs * 1e6 / (target_max_objects / divisor))
slop = target * osd_agent_slop # هیسترزیس (پیشفرض 0.02)
target' = target + slop if currently IDLE else target - slop
flush_mode = HIGH if dirty_µ > dirty_high' else LOW if dirty_µ > dirty' else IDLE
if full_µ > 1e6: evict_mode = FULL; effort = 1e6 # هر شیء clean را بیرون کن
elif full_µ > full': evict_mode = SOME
effort = max((full_µ - full') * 1e6 / (1e6 - full'), osd_agent_min_evict_effort)
effort = quantize(effort, osd_agent_quantize_effort) # کاهش جابهجایی در صف عامل
else: evict_mode = IDLE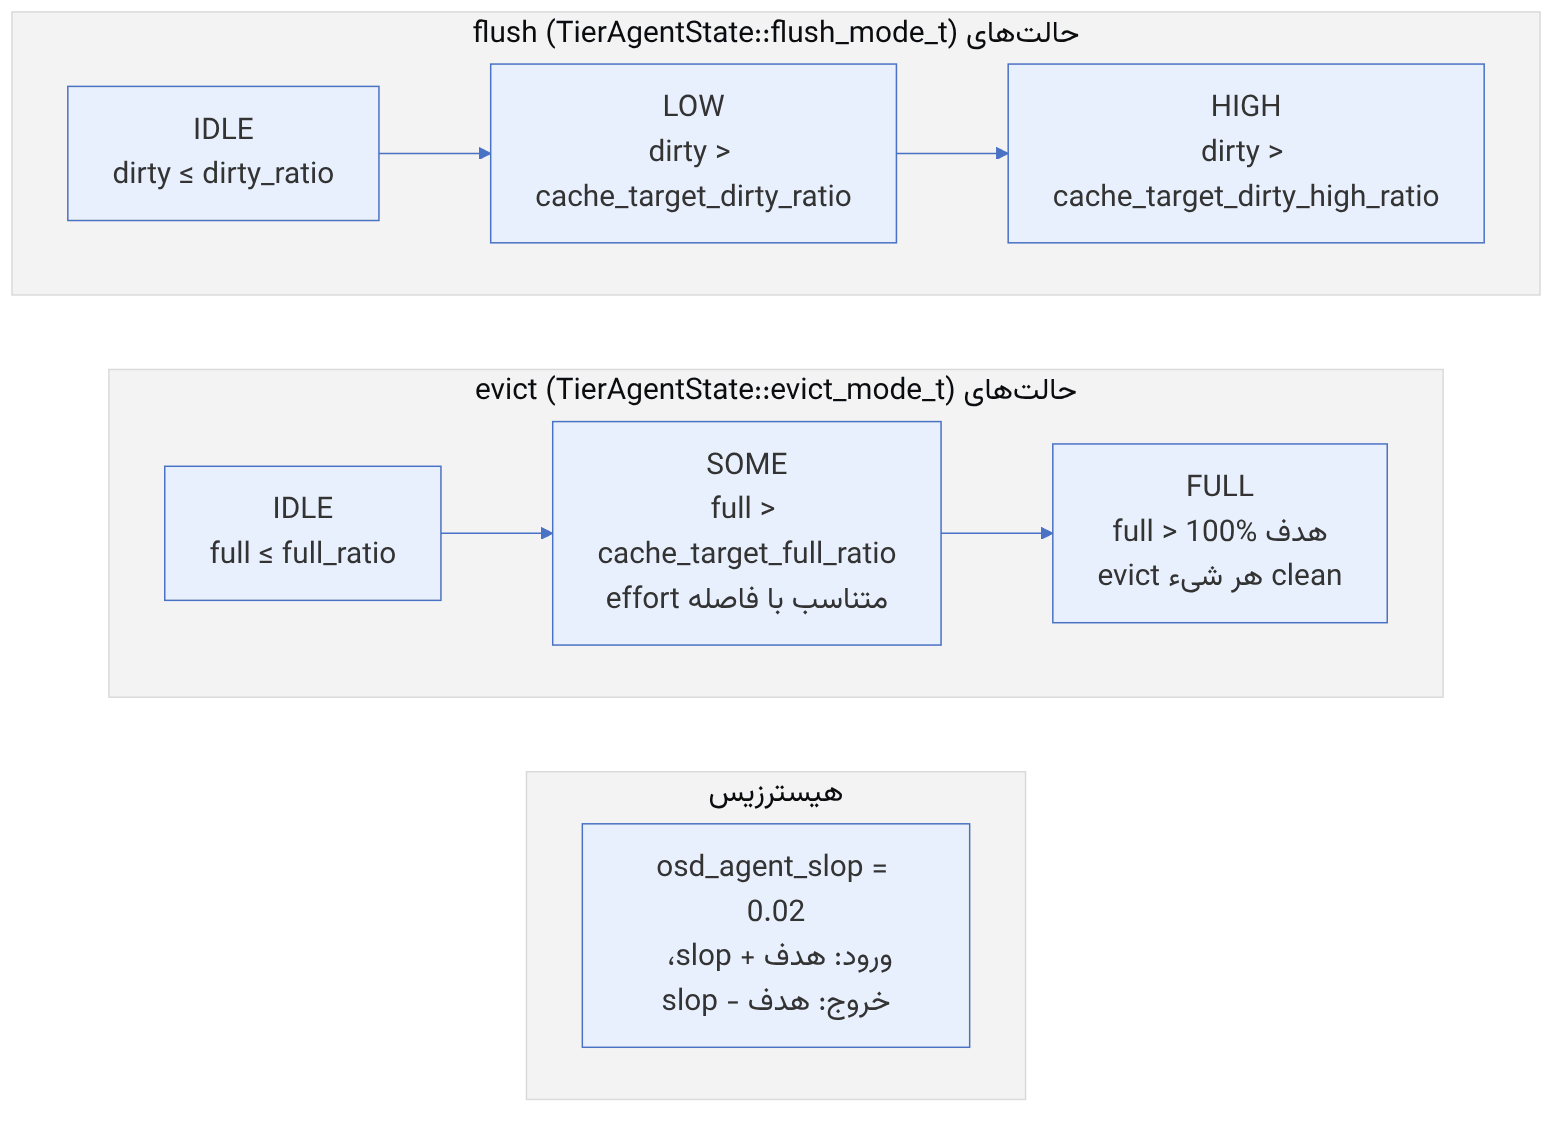
۱۶-۳-۲ انتخاب قربانی: دمای شیء#
در حالت SOME، agent_maybe_evict() برای هر شیء clean «دما»ی آن را با agent_estimate_temp() از روی HitSetهای اخیر تخمین میزند (برای هر HitSet که شیء در آن هست، وزن pool.info.get_grade(i) جمع میشود؛ وزنها با hit_set_grade_decay_rate برای HitSetهای قدیمیتر کاهش مییابند و شیئی که در HitSet جاری باشد دمای بیشینه میگیرد) و آن را در یک هیستوگرام (temp_hist) قرار میدهد. سپس جایگاه شیء در توزیع دما (get_position_micro) را با evict_effort مقایسه میکند: نیت طراحی این است که شیء داغ نگه داشته شود، اما شرط واقعی کد main وارونه است (بخش «دما با عدد» را ببینید). بنابراین evict یک LRU دقیق نیست، بلکه نمونهگیری آماری روی دما است که هزینهی حافظهی کم دارد.
pseudocode: agent_maybe_evict (خلاصه)
if obj dirty or in use or age < cache_min_evict_age: skip
if evict_mode != FULL:
temp = estimate_temp(obj, hitsets) # مجموع وزندار حضور در HitSetها
hist.add(temp); (lower, upper) = hist.position_µ(temp)
if 1e6 - upper >= evict_effort: keep # شرط لفظی کد؛ معنایش در بخش «دما با عدد» بررسی شده است
evict(obj) # حذف از کش؛ نسخهی معتبر در pool پایه استflush در agent_maybe_flush() و start_flush() انجام میشود: شیء dirty (همراه snapshotهایش) با عملیات copy-from به pool پایه نوشته میشود و پس از تأیید، پرچم dirty پاک میشود. cache_min_flush_age جلوی flush شیئی را که تازه نوشته شده میگیرد. اگر کش به target_max_bytes یا target_max_objects برسد و عامل نتواند به اندازهی کافی flush و evict کند، OSD درخواستهای کلاینت را مسدود میکند؛ این یکی از رایجترین علتهای قطع سرویس در کلاسترهای دارای کش بود.
اگر هیچکدام از target_max_bytes و target_max_objects تنظیم نشده باشد، نسبتهای پری صفر محاسبه میشوند و عامل هرگز بر اساس پری evict نمیکند؛ کش تا پر شدن OSDها رشد میکند. در شبهکد بالا هم دیدید که پری فقط وقتی محاسبه میشود که این اهداف تنظیم شده باشند.
۱۶-۴ مهاجرت: حذف بیخطر cache tier#
# ۱. وضعیت فعلی
ceph osd pool ls detail | grep -E "tier|cache_mode|read_tier|write_tier"
ceph df detail
# ۲. توقف promote و نوشتن در کش
ceph osd tier cache-mode hot-storage proxy
# ۳. تخلیه (ممکن است ساعتها طول بکشد؛ پیشرفت را پایش کنید)
rados -p hot-storage cache-flush-evict-all
rados -p hot-storage ls | head
# ۴. حذف overlay و tier
ceph osd tier remove-overlay cold-storage
ceph osd tier remove cold-storage hot-storageپیش از شروع، ظرفیت آزاد pool پایه را بررسی کنید: همهی اشیای dirty باید آنجا نوشته شوند. اگر pool پایه EC روی HDD است، flush انبوه بار سنگینی میسازد؛ در ساعات کمبار انجام دهید و ceph -s و تأخیر کلاینت را پایش کنید.
مستندات رسمی برای ارتقاهای قدیمی (۱۴.۲.۶ به ۱۴.۲.۷) موردی از اشیای unfound پس از راهاندازی دوبارهی OSDها در pool کش را ثبت کرده است. اگر پس از ارتقا یا راهاندازی دوباره چنین چیزی دیدید، پیش از هر اقدام ceph pg <pgid> list_unfound را بررسی کنید و راهنمای همان صفحه را دنبال کنید.
۱۶-۴-۱ اگر pool پایه EC است#
دلیل تاریخی بسیاری از cache tierها این بود که پیش از Luminous، pool EC از overwrite پشتیبانی نمیکرد و RBD یا CephFS نمیتوانستند مستقیم روی آن کار کنند. امروز با allow_ec_overwrites (و در Tentacle، بهینهسازیهای FastEC؛ فصل ۱۳) این محدودیت برطرف شده است: فراداده در pool تکثیری و داده در pool EC قرار میگیرد (rbd create --data-pool، یا افزودن data pool EC به CephFS).
۱۶-۵ لایهبندی در سطح بایت: storage class در RGW و lifecycle#
در بخشهای قبل دیدیم cache tiering از Reef منسوخ اعلام شده است (هشدار ابتدای مستند cache-tiering.rst) و جایگزینهای امروزی، یعنی device class، pool جدا برای داده و فراداده و storage class در RGW، چیست. این بخش نشان میدهد یک شیء S3 هنگام «جابهجایی بین لایهها» واقعاً در RADOS چه تغییری میکند.
۱۶-۵-۱ چیدمان یک شیء RGW#
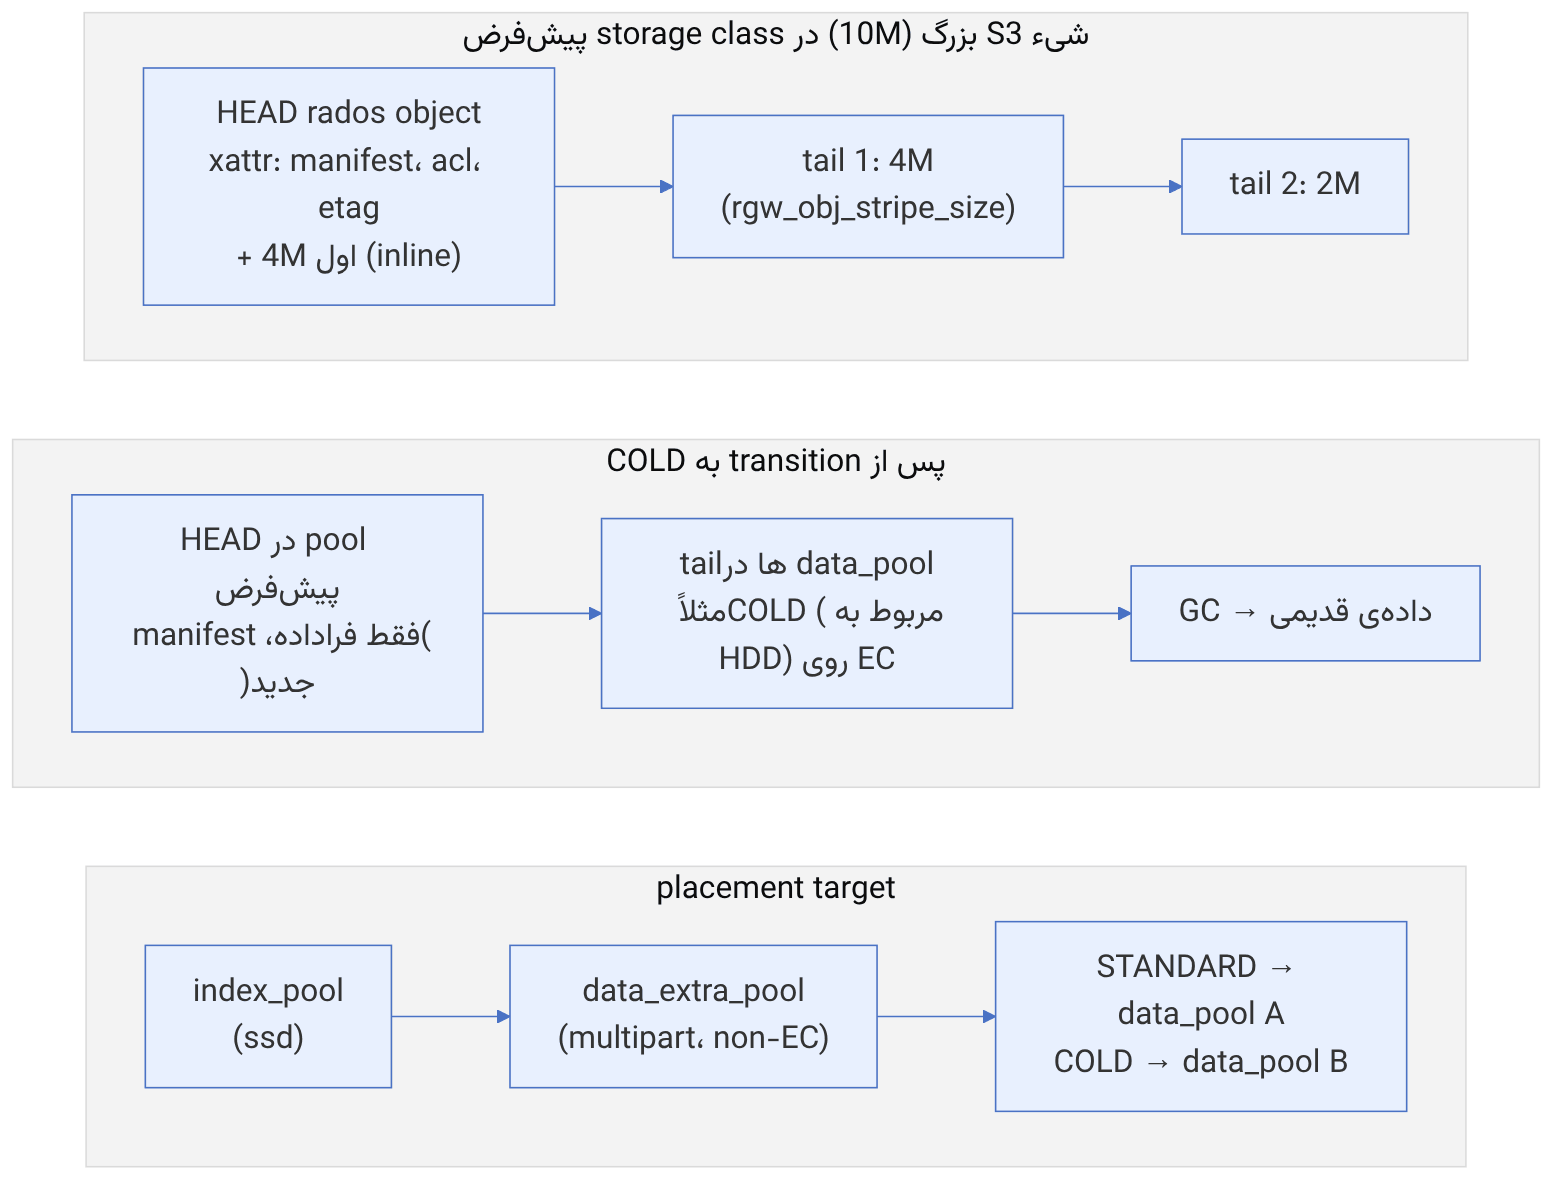
manifest (در xattr با نام user.rgw.manifest) نقشهی شیء منطقی به اشیای RADOS است: اندازهی head، اندازهی stripe، prefix اشیای tail و قواعد نامگذاری آنها. این توضیح میدهد چرا transition «ارزان» به نظر میرسد ولی در واقع کپی کامل داده است: RGW داده را از tailهای قدیمی میخواند، در pool کلاس جدید مینویسد، manifest را بهروز میکند و اشیای قدیمی را برای حذف به GC میدهد. پهنای باند lifecycle همان پهنای باند خوشه است.
| گزینه / ویژگی | مقدار (main) | اثر |
|---|---|---|
rgw_max_chunk_size | ۴_M | اندازهی تکهی head و واحد خواندن و نوشتن RGW |
rgw_obj_stripe_size | ۴_M | اندازهی اشیای tail |
--placement-inline-data | true (پیشفرض) | دادهی اول در head؛ طبق مستندات، inline فقط در کلاس پیشفرض انجام میشود |
data_extra_pool | مثلاً default.rgw.buckets.non-ec | فرادادهی multipart ناتمام؛ باید replicated باشد (omap) |
index_pool | مثلاً default.rgw.buckets.index | bucket index (فقط omap)؛ بهترین جا برای SSD یا NVMe |
طبق مستند placement.rst، اگر DB مربوط به BlueStore روی دستگاه سریعتر از دادهی bucket باشد، خاموش کردن inline (--placement-inline-data=false) میتواند حذفهای کلاینت را سریعتر کند، چون RGW هنگام DELETE دیگر لازم نیست همگام به دستگاه کند دست بزند و داده بعداً توسط GC حذف میشود. بدهبستان آن یک رفتوبرگشت اضافه برای خواندن و نوشتن اشیای کوچک است.
۱۶-۵-۲ lifecycle چگونه اجرا میشود؟#
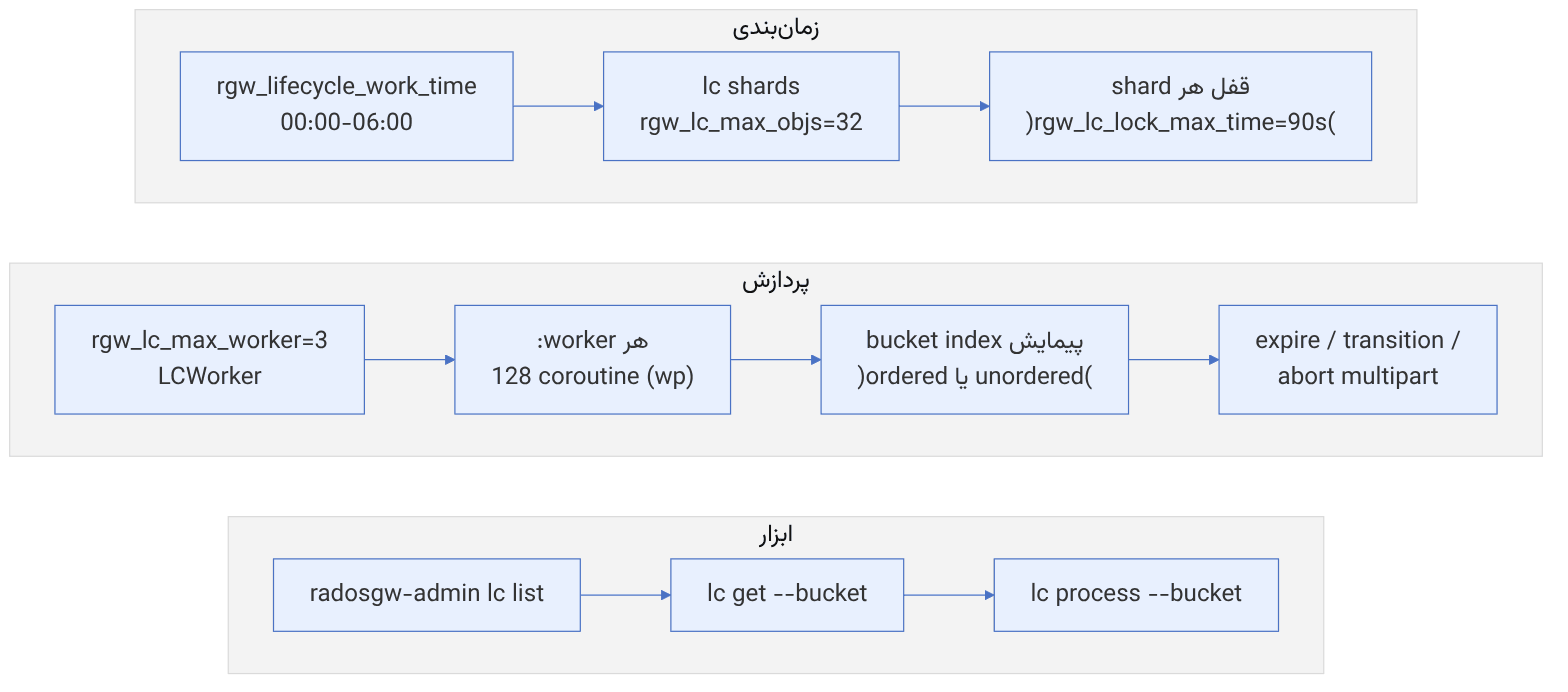
radosgw-admin lc list                          # وضعیت هر bucket: UNINITIAL / PROCESSING / COMPLETE
radosgw-admin lc get --bucket photos
radosgw-admin lc process --bucket photos       # اجرای دستی (خارج از پنجره)
radosgw-admin gc list --include-all | head
ceph config set client.rgw rgw_lifecycle_work_time "00:00-23:59" # فقط برای آزمایشمحاسبهی ظرفیت: با ۳ worker و ۱۲۸ coroutine، در هر لحظه تا حدود ۳۸۴ شیء همزمان پردازش میشود. اگر هر شب ۵۰ ترابایت باید از STANDARD به COLD برود و پنجرهی کار ۶ ساعت باشد، خوشه باید حدود ۵۰ TB / ۲۱۶۰۰ s ≈ ۲.۳ GB/s خواندن و همان اندازه نوشتن (بهعلاوهی سربار EC یا replication) را علاوه بر بار عادی تحمل کند. در غیر این صورت lifecycle هر شب عقب میافتد و صف آن رشد میکند. پیش از تعریف قواعد transition، این عدد را حساب کنید.
۱۶-۵-۳ لایهبندی داخل یک OSD#
لایهبندی فقط بین poolها نیست. یک OSD با دستگاههای block.db و block.wal سه لایه دارد. فصل ۲۵ نشان داد BlueFS سطوح RocksDB را با سیاست use_some_extra بین WAL، DB و دستگاه کند پخش میکند. فصل ۲۴ نشان داد deferred writeهای کوچکتر از bluestore_prefer_deferred_size (در HDD برابر ۶۴K) ابتدا در WAL مربوط به RocksDB (یعنی روی دستگاه سریع) نوشته و بعداً به HDD منتقل میشوند. این عملاً یک write-back cache کوچک برای نوشتنهای کوچک روی HDD است، بدون پیچیدگیهای cache tiering. فصل ۲۸ هم نشان داد device classها با shadow treeهای جداگانه تضمین میکنند افزودن دستگاه به یک کلاس هیچ دادهای را در poolهای کلاس دیگر جابهجا نکند.
| لایه | سازوکار | فصل |
|---|---|---|
| PG→دستگاه | device class + قاعدهی CRUSH | ۸ و ۲۸ |
| فرادادهی RGW | index_pool و data_extra_pool روی SSD | ۴ و همین فصل |
| دادهی سرد | storage class و lifecycle transition | همین فصل |
| فرادادهی OSD | block.db و block.wal (BlueFS) | ۱۲، ۲۴ و ۲۵ |
| نوشتن کوچک روی HDD | deferred write | ۱۲ و ۲۴ |
| فرادادهی RBD | pool دادهی جدا (--data-pool) روی EC | ۲ و ۱۳ |
۱۶-۶ لایهبندی با عدد: شش الگوریتم از کد#
این بخش سازوکارهای لایهبندی را که بالاتر توصیف شدند، با کد و عدد بررسی میکند. سه الگوریتم مربوط به cache tiering است (منسوخ، اما هنوز در کد main)، دو الگوریتم به lifecycle در RGW، و یکی به جایگذاری دادهی RocksDB میان دستگاه سریع و کند درون OSD.
۱۶-۶-۱ اندازهی HitSet#
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::hit_set_create؛ src/osd/BloomHitSet.h :: BloomHitSet
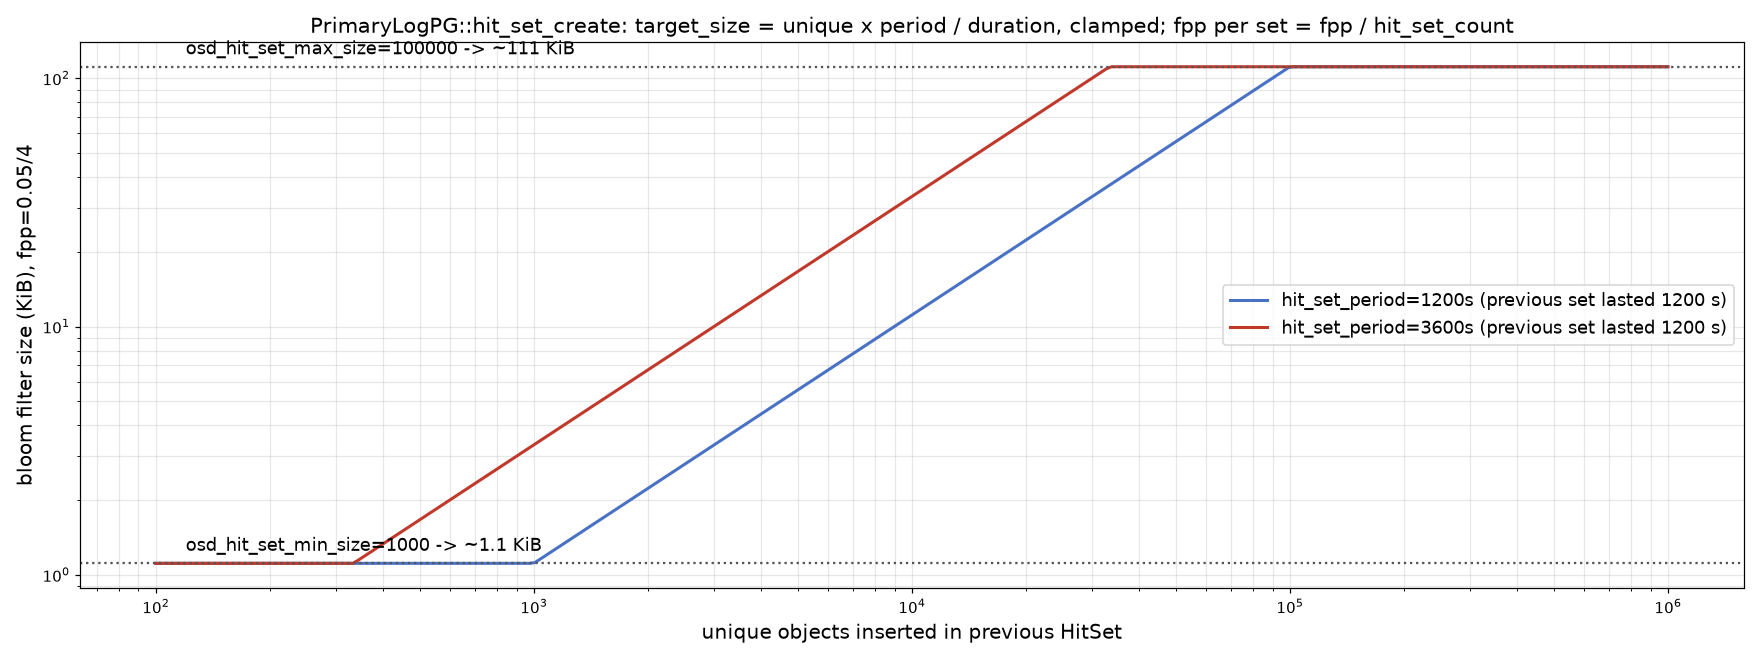
پیچیدگی: O(۱) برای تعیین اندازه؛ حافظه −n·ln(p)/(ln 2)² بیت
pseudocode
p = fpp_pool / hit_set_count ; if p ≤ 0: p = 0.01
if target_size == 0 and hit_set قبلی هست:
    target_size = unique_inserts(قبلی) × hit_set_period / مدت واقعی قبلی
target_size = clamp(target_size, osd_hit_set_min_size = 1000, osd_hit_set_max_size = 100000)
seed = now.sec ; BloomHitSet(target_size, p, seed)
مثال عددی. با پیشفرضهای osd_tier_default_cache_* که ceph osd tier add-cache اعمال میکند (bloom، hit_set_count = ۴، hit_set_period = ۱۲۰۰ s) و osd_pool_default_hit_set_bloom_fpp = 0.05، نرخ مثبت کاذب هر مجموعه ۰.۰۵/۴ = ۰.۰۱۲۵ است. اگر HitSet قبلی در ۱۲۰۰ ثانیه ۳۰۰۰۰ شیء یکتا دیده باشد، target_size = ۳۰۰۰۰ و فیلتر حدود بیت (حدود ۳۳ KiB) با ۶ تابع hash است. سقف ۱۰۰۰۰۰ شیء فیلتری حدود ۱۱۱ KiB میدهد و کف ۱۰۰۰ حدود ۱.۱ KiB. دلیل تقسیم fpp بر تعداد مجموعهها این است که دما از جمع حضور در چند مجموعه به دست میآید و خطای هر مجموعه جمع میشود.
۱۶-۶-۲ دما با عدد#
منبع در کد: src/osd/osd_types.h :: pg_pool_t::calc_grade_table، get_grade؛ src/osd/PrimaryLogPG.cc :: agent_estimate_temp، agent_maybe_evict؛ src/common/histogram.h :: pow2_hist_t::get_position_micro
پیچیدگی: O(hit_set_count) برای هر شیء؛ هیستوگرام توانی O(log temp)
pseudocode
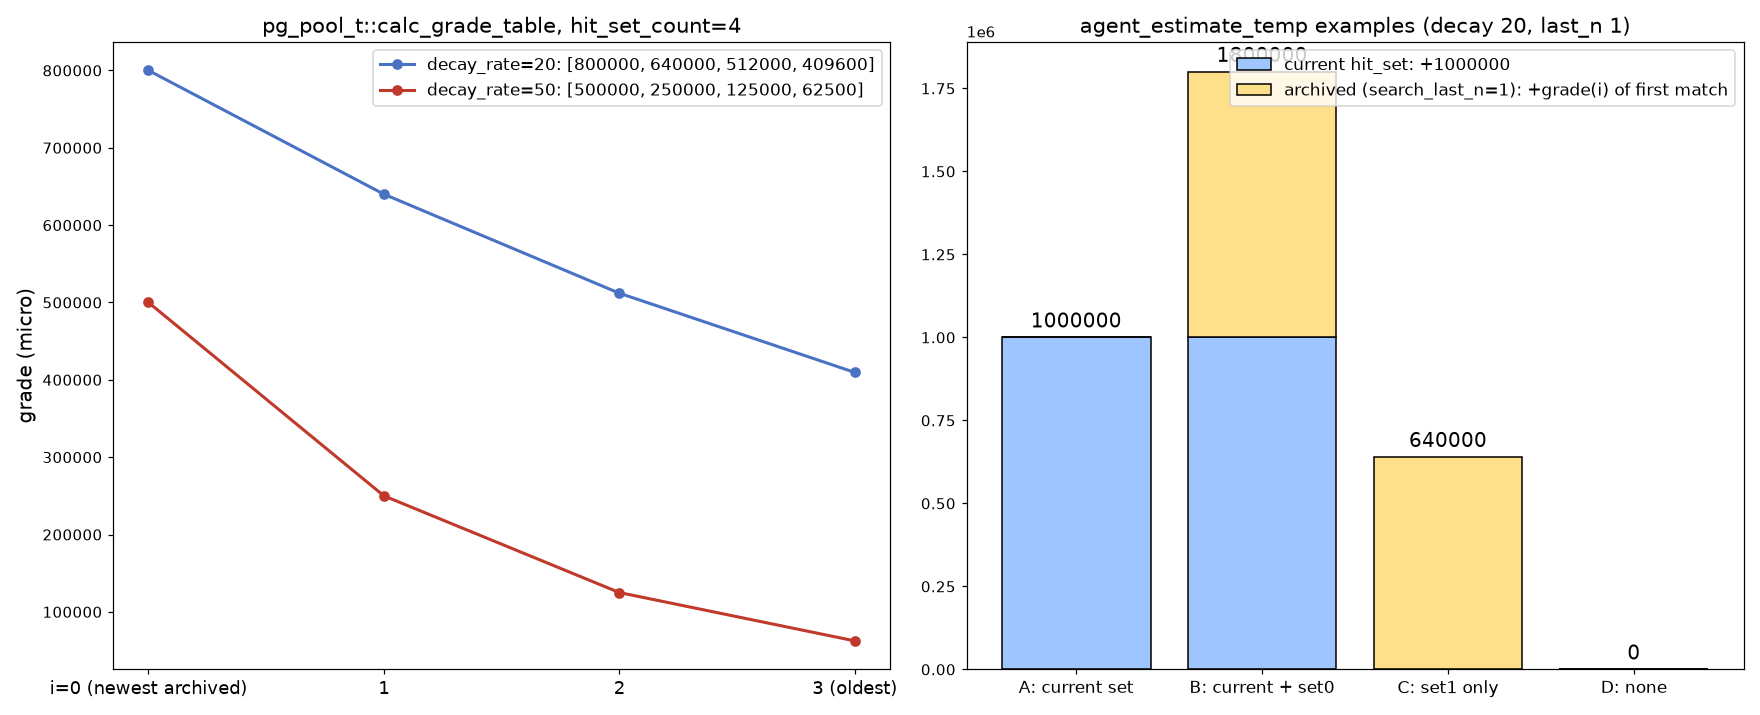
calc_grade_table: v = 10^6 ; for i < count: v = v × (1 − decay/100) ; grade[i] = v
estimate_temp(o): t = (o ∈ current) ? 10^6 : 0
    for i, set in archived (جدید به قدیم) while last_n > 0: if o ∈ set: t += grade[i] ; last_n−−
agent_maybe_evict (حالت SOME):
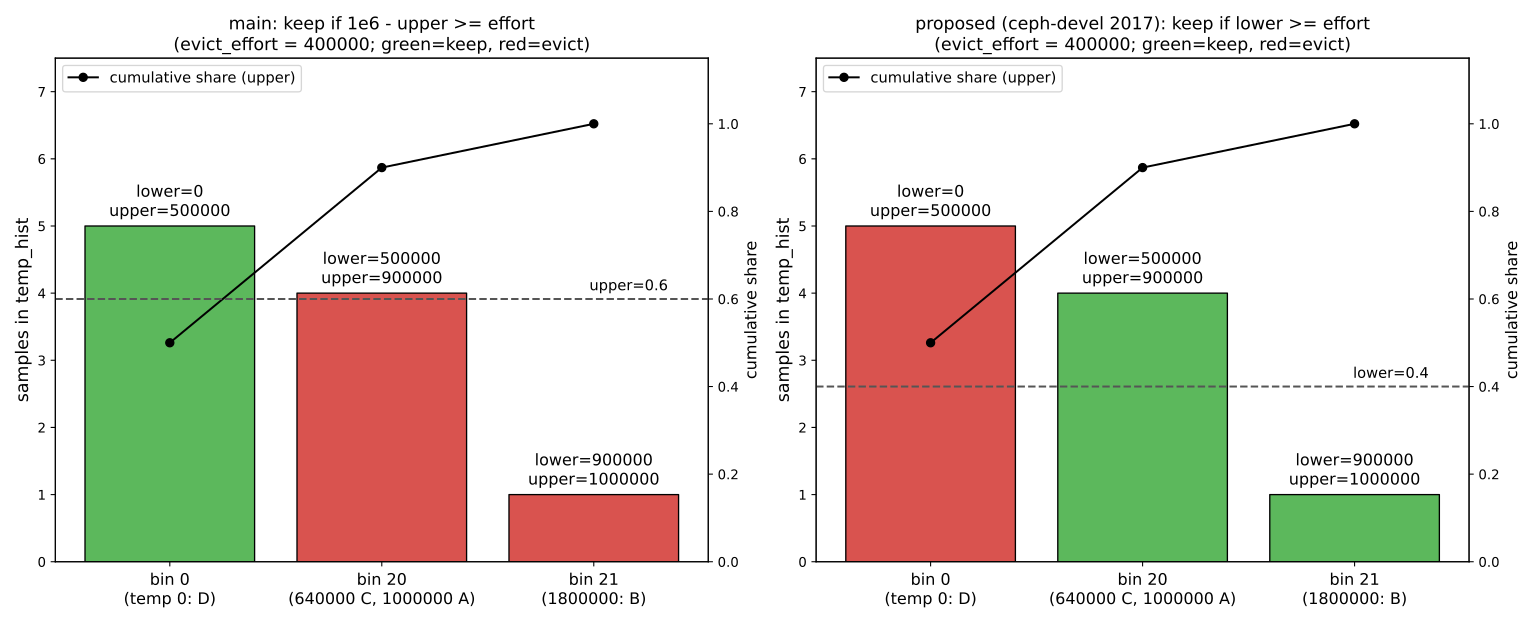
    hist.add(t) ; (lower, upper) = hist.position_µ(t)   # upper = سهم اشیای با bin ≤ bin(t)
    if 10^6 − upper ≥ evict_effort: نگه دار  else: evict   # شرط لفظی main؛ نسبت به نیت «سرد را بیرون کن» وارونه است
مثال عددی. با پیشفرضهای osd_tier_default_cache_* (decay_rate = ۲۰، search_last_n = ۱)، جدول درجه ۸۰۰۰۰۰، ۶۴۰۰۰۰، ۵۱۲۰۰۰ و ۴۰۹۶۰۰ است. چهار شیء نمونه:
- A فقط در مجموعهی جاری است: دما ۱۰۰۰۰۰۰.
- B در جاری و در مجموعهی ۰ است: ۱۸۰۰۰۰۰.
- C فقط در مجموعهی ۱ است: ۶۴۰۰۰۰.
- D در هیچ مجموعهای نیست: ۰.
اکنون معنای شرط کد: get_position_micro مقدار upper را برابر سهم اشیایی میگذارد که bin توانی دمایشان (cbits(temp)، یعنی شمارهی بالاترین بیت یک) کوچکتر یا مساوی bin این شیء است، و lower را سهم اشیای bin کوچکتر. یک هیستوگرام دهنمونهای بسازیم: پنج نمونه با دمای ۰ (bin 0)، دو نمونه ۶۴۰۰۰۰ و دو نمونه ۱۰۰۰۰۰۰ (هر دو bin 20) و یک نمونه ۱۸۰۰۰۰۰ (bin 21). با evict_effort = ۴۰۰۰۰۰ نتیجه این است:
| شیء | دما | bin | lower | upper | | تصمیم کد main | تصمیم با اصلاح پیشنهادی (lower ≥ effort ⇒ نگه دار) |
|---|---|---|---|---|---|---|---|
| D | ۰ | ۰ | ۰ | ۵۰۰۰۰۰ | ۵۰۰۰۰۰ | نگه میدارد | بیرون میکند |
| C | ۶۴۰۰۰۰ | ۲۰ | ۵۰۰۰۰۰ | ۹۰۰۰۰۰ | ۱۰۰۰۰۰ | بیرون میکند | نگه میدارد |
| A | ۱۰۰۰۰۰۰ | ۲۰ | ۵۰۰۰۰۰ | ۹۰۰۰۰۰ | ۱۰۰۰۰۰ | بیرون میکند | نگه میدارد |
| B | ۱۸۰۰۰۰۰ | ۲۱ | ۹۰۰۰۰۰ | ۱۰۰۰۰۰۰ | ۰ | بیرون میکند | نگه میدارد |
این عددها با یک بازپیادهسازی پایتونی از pow2_hist_t::get_position_micro به دست آمدهاند. پس شرط کد main واقعاً وارونه است: سردترین شیء (D) میماند و داغها بیرون میروند. این وارونگی سابقهی مستند دارد. پیش از Jewel، عامل بهجای دما از «فاصله از آخرین دسترسی» (atime) استفاده میکرد که برای دادهی سرد بزرگتر است، و شرط 1000000 − atime_upper ≥ evict_effort ⇒ نگه دار با آن معنا درست بود. PR شمارهی ۴۷۳۷ (شاخهی wip-temp-based-object-eviction) معیار را به دما تغییر داد، که برای دادهی سرد کوچکتر است، اما فقط نام متغیر را در شرط عوض کرد. در نوامبر ۲۰۱۷ در فهرست ceph-devel (رشتهی «About the "temperature histogram" of tier-agent») همین مسئله گزارش شد و Sage Weil آن را برای بررسی به نویسندگان آن PR ارجاع داد. پیشنهاد شد شرط به temp_upper ≥ evict_effort یا temp_lower ≥ evict_effort تغییر کند، اما در کد main امروز (بررسیشده در نوامبر ۲۰۲۶) شرط همچنان همان شکل قدیمی را دارد. در حالت EVICT_MODE_FULL این شرط اصلاً اجرا نمیشود و هر شیء clean و واجد شرایط بیرون میرود؛ پس اثر وارونگی فقط در حالت SOME دیده میشود. این یکی دیگر از دلیلهایی است که cache tiering (که از Reef منسوخ اعلام شده است) نباید برای کارهای تازه انتخاب شود.
۱۶-۶-۳ evict_effort با عدد#
منبع در کد: src/osd/PrimaryLogPG.cc :: PrimaryLogPG::agent_choose_mode
پیچیدگی: O(۱) برای هر PG در هر اجرای عامل
pseudocode
target = cache_target_full_ratio × 10^6 ; slop = target × osd_agent_slop (0.02)
target = (IDLE یا restart) ? target + slop : target − slop        # هیسترزیس
if full_µ > 10^6: FULL ; effort = 10^6
elif full_µ > target: SOME
    effort = max((full_µ − target) × 10^6 / (10^6 − target), 0.1 × 10^6)
    effort −= effort % (0.1 × 10^6) ; effort = max(effort, 0.1 × 10^6)
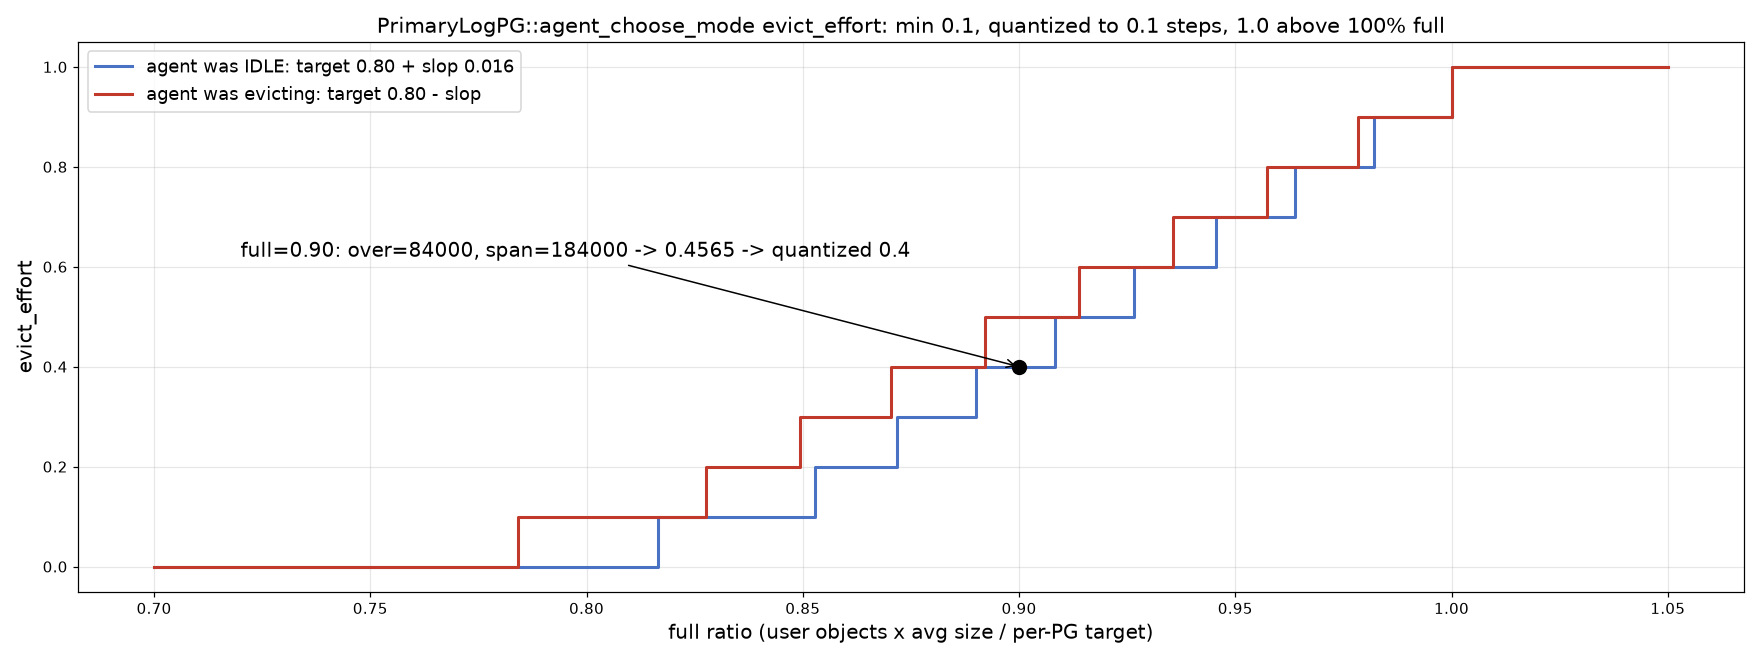
مثال عددی. cache_target_full_ratio = ۰.۸ (پیشفرض)، پس target = ۸۰۰۰۰۰ و slop = ۱۶۰۰۰. عامل از IDLE شروع میکند، پس آستانه ۸۱۶۰۰۰ است. با full = ۰.۹۰: over = ۸۴۰۰۰، span = ۱۸۴۰۰۰ و effort خام ۴۵۶۵۲۱ است که به ۴۰۰۰۰۰ گرد میشود. وقتی پری به ۰.۸۰ برمیگردد، آستانهی خروج ۷۸۴۰۰۰ است. پس عامل تا full ≤ ۰.۷۸۴ در SOME میماند. فاصلهی ۳.۲ درصدی میان ورود و خروج از رفتوبرگشت سریع جلوگیری میکند. گرد کردن به گامهای ۰.۱ هم ترتیب صف عامل در OSD را پایدار نگه میدارد.
۱۶-۶-۴ شارد lifecycle و انتخاب شیء lc.N#
منبع در کد: src/rgw/rgw_lc.cc :: get_lc_index، get_bucket_lc_key، random_sequence، RGWLC::process؛ src/common/ceph_hash.cc :: ceph_str_hash_linux
پیچیدگی: hash O(طول کلید)؛ هر کارگر O(rgw_lc_max_objs) شارد در هر دور
pseudocode
key = tenant + ":" + bucket + ":" + marker
h = 0 ; for c in key: h = (h + (c ≪ 4) + (c ≫ 4)) × 11 (mod 2^32)
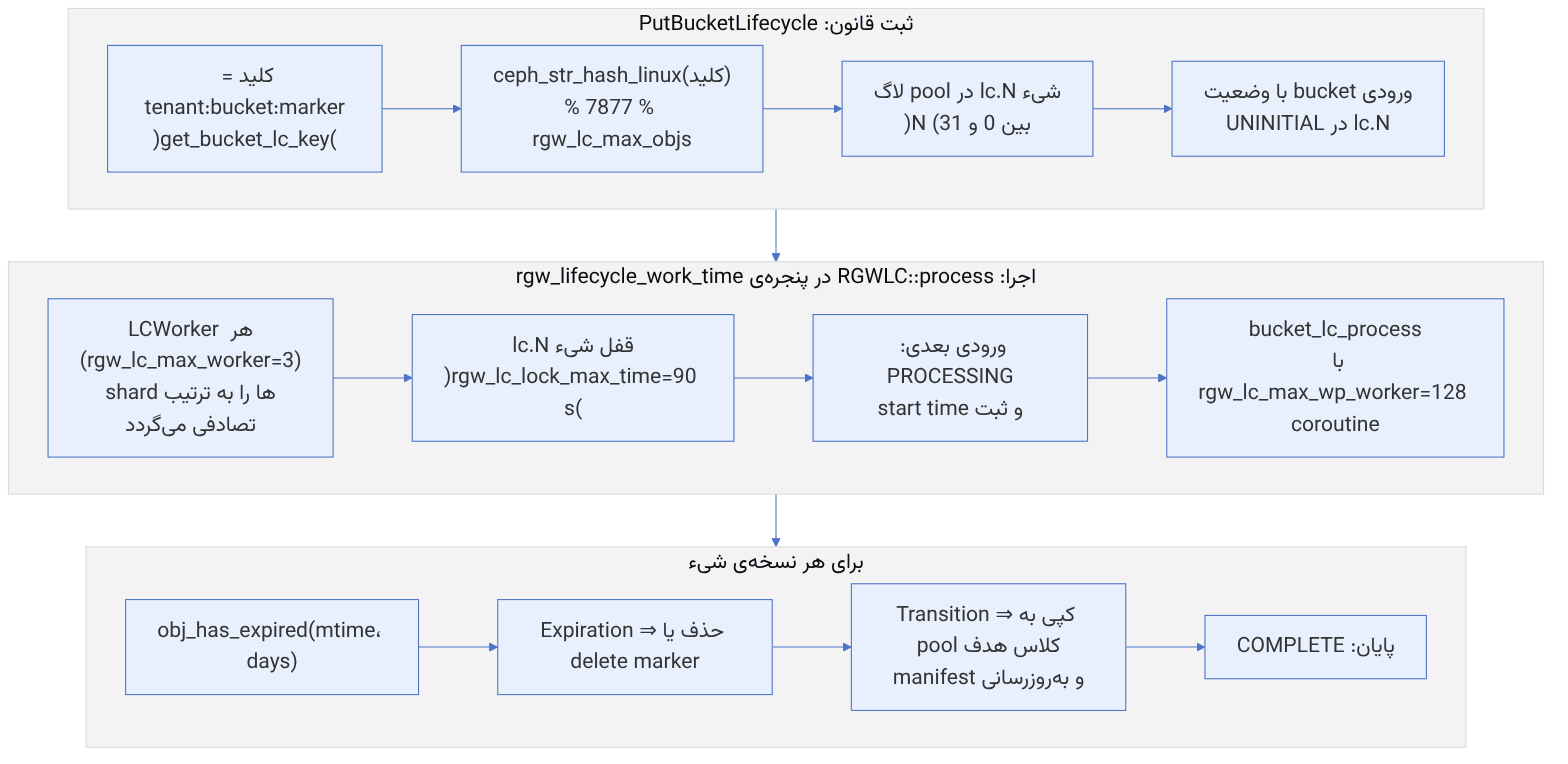
index = h % 7877 % min(rgw_lc_max_objs, 7877) # پیشفرض 32 ⇒ lc.0 .. lc.31
RGWLC::process(worker): for shard in shuffle(0..31):
lock lc.shard (حداکثر rgw_lc_lock_max_time = 90 s) ; ورودی بعدی را PROCESSING کن ; unlock
bucket_lc_process(bucket) با استخر rgw_lc_max_wp_worker coroutineمثال عددی. marker یک bucket در RADOS هنگام ساخت با RGWRados::create_bucket_id ساخته میشود و قالب آن <zone id>.<instance id>.<شمارنده> است: شناسهی zone (یک UUID)، شناسهی نمونهی کلاینت RADOS آن radosgw و یک شمارندهی افزایشی. marker زیر قالب واقعی را دارد، اما UUID و دو عدد آن مثال هستند و از کلاستر واقعی نیامدهاند. برای bucket با نام photos، tenant خالی و marker 3f6e1c2a-77b1-4e0b-9d2c-1a2b3c4d5e6f.4137.1، کلید (که get_bucket_lc_key با جداکنندهی «:» میسازد) :photos:3f6e…4137.1 است. ceph_str_hash_linux عدد ۲۹۹۷۴۶۰۱۰۹ را میدهد. ۲۹۹۷۴۶۰۱۰۹ mod 7877 = ۱۶۶۸ و ۱۶۶۸ mod 32 = ۴، پس ورودی این bucket در شیء lc.4 نوشته میشود. سه کارگر (rgw_lc_max_worker) شاردها را به ترتیب تصادفی میگردند تا همه همزمان سراغ lc.0 نروند. چون hash ضعیف است و فقط ۳۲ شارد وجود دارد، چند bucket بزرگ ممکن است در یک شارد بیفتند و پشت هم پردازش شوند. radosgw-admin lc list وضعیت هر bucket را نشان میدهد.
۱۶-۶-۵ چه روزی یک شیء منقضی میشود؟#
منبع در کد: src/rgw/rgw_lc.cc :: obj_has_expired؛ src/include/utime.h :: utime_t::round_to_day
پیچیدگی: O(۱) برای هر نسخهی شیء
pseudocode
if rgw_lc_debug_interval ≤ 0:
cmp = days × 86400 ; base = round_to_day(now) # نیمهشب محلی امروز (localtime_r/mktime)
else: cmp = days × rgw_lc_debug_interval ; base = now # حالت آزمایشی: هر «روز» چند ثانیه
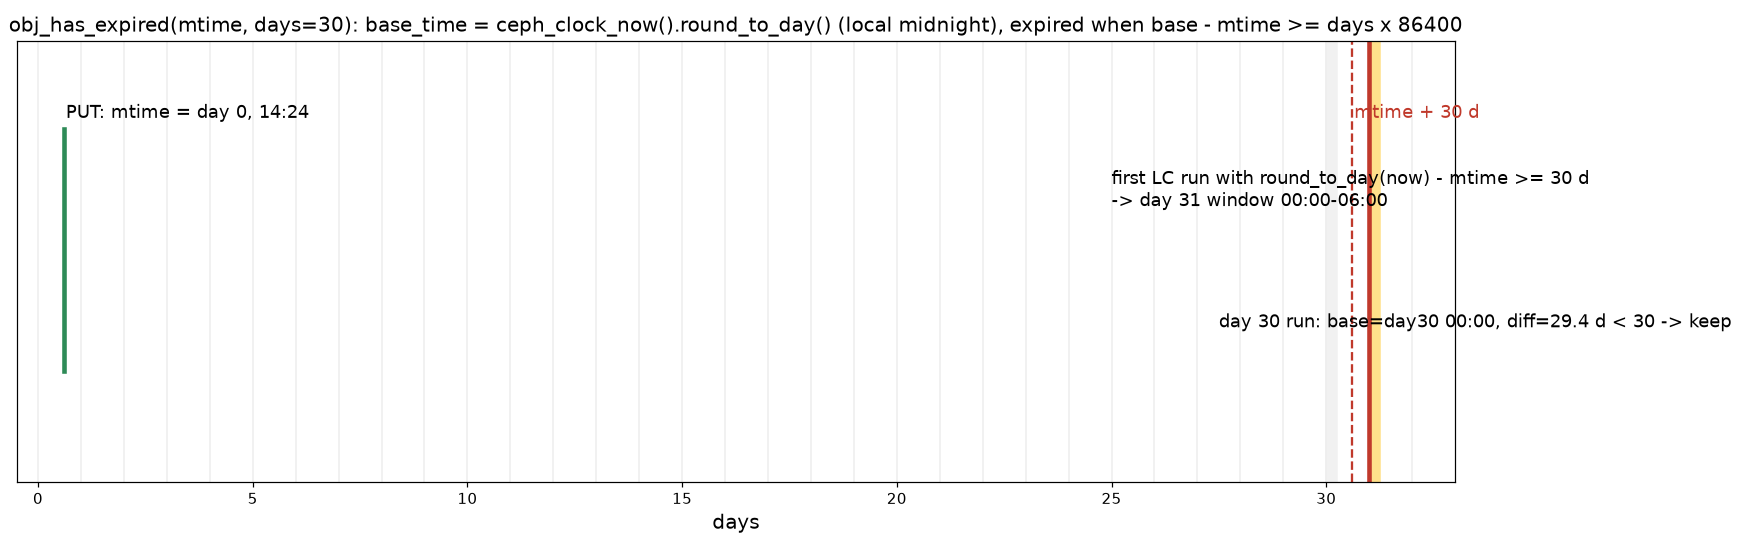
expired = (base − mtime) ≥ cmp ; expire_time = mtime + cmpمثال عددی. شیئی در روز ۰ ساعت ۱۴:۲۴ نوشته شده و قانون Expiration با Days = ۳۰ دارد. اجرای روز ۳۰: base = نیمهشب روز ۳۰، فاصله ۲۹.۴ روز است و کمتر از ۳۰، پس میماند. اجرای روز ۳۱: فاصله ۳۰.۴ روز است، پس حذف میشود. پس شیء عملاً بین ۳۰.۴ تا ۳۱.۲۵ روز (بسته به زمان اجرای کارگر در پنجره) زنده میماند. چون base از ساعت محلی سرور RGW میآید، دو RGW با منطقهی زمانی متفاوت ممکن است یک روز با هم اختلاف داشته باشند. با rgw_lc_debug_interval = 10 هر روز قانون ۱۰ ثانیه است و Days = ۳۰ یعنی ۳۰۰ ثانیه، که برای آزمودن قانونها در آزمایشگاه کاربرد دارد.
۱۶-۶-۶ جایگذاری سطوح RocksDB میان DB و دستگاه کند#
منبع در کد: src/os/bluestore/BlueFS.h :: RocksDBBlueFSVolumeSelector (سازنده، get_extra_level، get_hint_by_dir)؛ src/os/bluestore/BlueStore.cc :: BlueStore::_open_bluefs (ساخت vselector)
پیچیدگی: O(log_multiplier(DB/base)) برای حلقهی سطوح، یکبار هنگام mount
pseudocode
db_total = 0.95 × اندازهی DB ; L0 = write_buffer_size × max_write_buffer_number
if bluestore_volume_selection_reserved == 0:
prev = L0 ; cur = base ; extra_level = 1
loop: next = cur × mult ; extra_level++
if db_total ≤ prev + cur + next:
db_avail4slow = max(0, db_total − (prev + cur × reserved_factor)) ; break
prev += cur ; cur = next
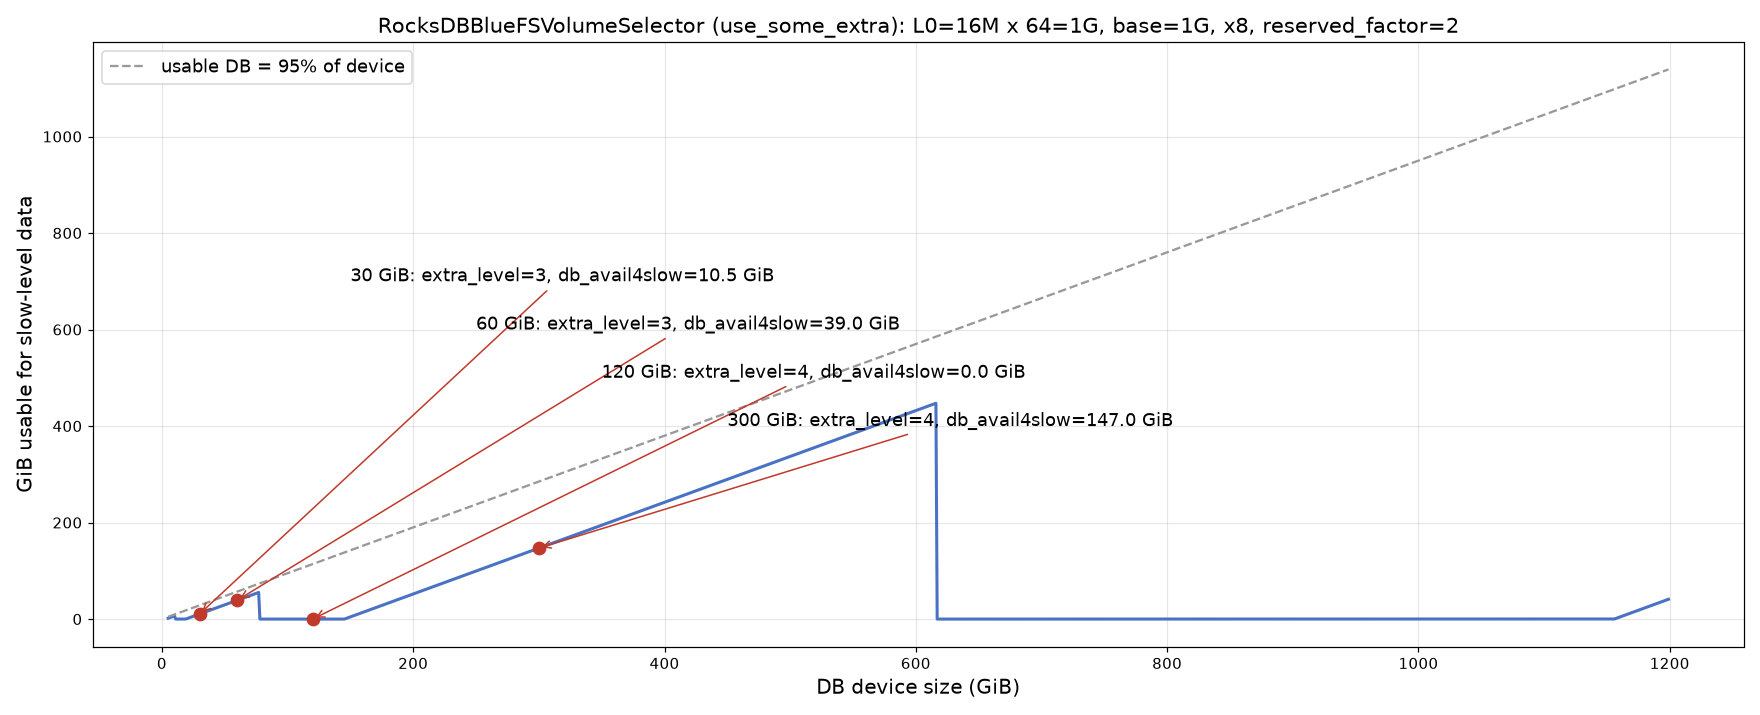
else: db_avail4slow = max(0, db_total − reserved) ; extra_level = 0مثال عددی (پیشفرضهای Ceph: L0 = ۱۶ MiB × ۶۴ = ۱ GiB، base = ۱ GiB، mult = ۸، reserved_factor = ۲).
- DB سی گیگابایتی (۲۸.۵ GiB قابل استفاده): حلقه در آستانهی ۲ + ۸ + ۶۴ متوقف میشود و cur_threshold = ۲ + ۸×۲ = ۱۸، پس ۱۰.۵ GiB برای دادهی سطح کند روی DB میماند.
- DB شصت گیگابایتی: ۵۷ − ۱۸ = ۳۹ GiB.
- DB صد و بیست گیگابایتی (۱۱۴ GiB): حلقه یک سطح جلوتر میرود (آستانه ۱۰ + ۶۴ + ۵۱۲). cur_threshold = ۱۰ + ۶۴×۲ = ۱۳۸ از ۱۱۴ بزرگتر است، پس db_avail4slow = ۰.
- DB سیصد گیگابایتی: ۲۸۵ − ۱۳۸ = ۱۴۷ GiB.
پس DB بزرگتر همیشه فضای اضافهی بیشتری نمیدهد. اندازههایی که درست پس از یک مرز سطح قرار میگیرند، کمترین بهره را دارند. این همان دلیل توصیههای قدیمی «DB را ۳۰، ۳۰۰ یا ۳۰۰۰ گیگابایت بگیرید» است. سیاست fit_to_fast این محاسبه را کنار میگذارد و تا ۹۵٪ دستگاه سریع را پر میکند.
این محاسبه فقط تعیین میکند BlueFS فایلهای سطحهای بالا را ترجیحاً کجا بگذارد. اگر DB پر شود، BlueFS باز هم به دستگاه کند میریزد (spillover) و هشدار BLUEFS_SPILLOVER در ceph health ظاهر میشود. ceph daemon osd.N bluefs stats توزیع واقعی هر سطح را میان WAL، DB و SLOW نشان میدهد.
۱۶-۷ جایگزینهای امروزی#
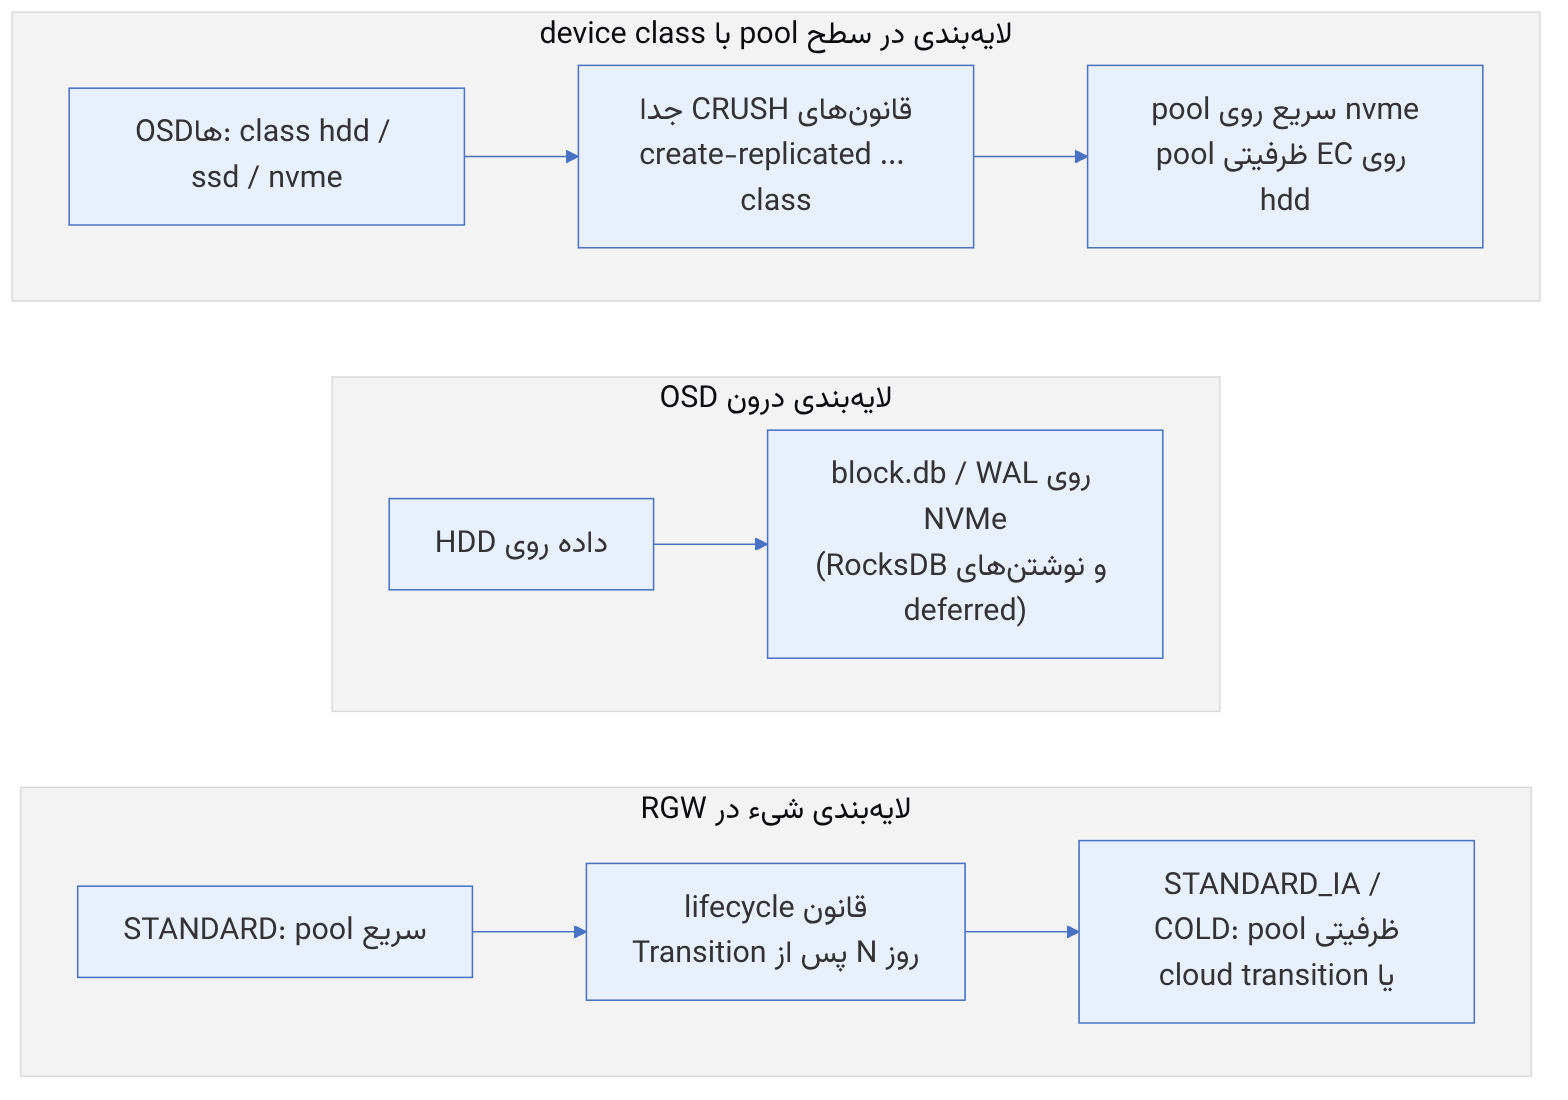
۱۶-۷-۱ ۱. device class و pool جدا برای هر لایه#
سادهترین و قابلپیشبینیترین روش: دادهی داغ و سرد را در سطح برنامه جدا کنید و هر کدام را در pool مناسب بگذارید. از Luminous، هر OSD یک device class (hdd، ssd، nvme یا نام دلخواه) دارد و قانون CRUSH میتواند فقط OSDهای یک کلاس را انتخاب کند.
ceph osd crush class ls
ceph osd crush rule create-replicated fast-rule default host nvme
ceph osd erasure-code-profile set cold-ec k=4 m=2 crush-failure-domain=host crush-device-class=hdd
ceph osd pool create vm-fast 128 128 replicated fast-rule
ceph osd pool create archive 256 256 erasure cold-ec
ceph osd pool set archive allow_ec_overwrites true
# RBD با فراداده روی pool سریع و داده روی EC
rbd create --size 1T --data-pool archive vm-fast/backup01انتقال یک pool به لایهی دیگر فقط با تغییر قانون CRUSH ممکن است: ceph osd pool set <pool> crush_rule fast-rule. Ceph داده را با backfill جابهجا میکند؛ با osd_max_backfills و برنامهریز mclock (فصل ۲۱) اثرش را روی کلاینت محدود کنید.
۱۶-۷-۲ ۲. لایهبندی درون OSD با BlueStore#
برای OSDهای HDD، قرار دادن block.db (RocksDB) و WAL روی NVMe بیشترین اثر را در ازای کمترین پیچیدگی دارد: فراداده، omap و نوشتنهای کوچک deferred (فصل ۱۲؛ bluestore_prefer_deferred_size_hdd=64K) روی رسانهی سریع انجام میشوند و HDD فقط نوشتنهای بزرگ و ترتیبی را میبیند. در cephadm با مشخصات سرویس OSD:
service_type: osd
service_id: hdd-with-nvme-db
placement:
  host_pattern: 'stor-*'
spec:
  data_devices:
    rotational: 1
  db_devices:
    rotational: 0
۱۶-۷-۳ ۳. storage class و lifecycle در RGW#
برای ذخیرهسازی شیء، الگوی S3 یعنی storage class و انتقال با lifecycle، نزدیکترین جایگزین «کش» است با این تفاوت مهم که تصمیمها قطعی و قابل حسابرسیاند، نه آماری.
radosgw-admin zonegroup placement add --rgw-zonegroup default \
    --placement-id default-placement --storage-class COLD
radosgw-admin zone placement add --rgw-zone default \
    --placement-id default-placement --storage-class COLD \
--data-pool default.rgw.cold.data --compression lz4{ "Rules": [ { "ID": "to-cold-after-30d", "Status": "Enabled",
"Filter": { "Prefix": "logs/" },
"Transitions": [ { "Days": 30, "StorageClass": "COLD" } ] } ] }aws --endpoint-url https://s3.example.internal s3api put-bucket-lifecycle-configuration \
--bucket app-logs --lifecycle-configuration file://lc.json
radosgw-admin lc listRGW از cloud transition هم پشتیبانی میکند: storage class از نوع cloud-s3 که اشیا را به یک endpoint S3 بیرونی منتقل میکند (صفحهی Cloud Transition در مستندات). این برای بایگانی بلندمدت در فضای دیگر مناسب است.
۱۶-۷-۴ ۴. سایر ابزارها#
- primary affinity: با
ceph osd primary-affinity <osd> <weight> میتوان احتمال primary شدن OSDهای کند را کم کرد تا خواندنها بیشتر از OSDهای سریع سرویس شوند (در pool تکثیری با OSDهای ترکیبی). - read balancer (از Reef): توزیع primaryها برای متوازن کردن بار خواندن؛ صفحهی Read Balancer در مستندات.
- کش سمت کلاینت: کش librbd، کش persistent write-back در librbd (PWL) و fscache برای CephFS هسته.
| نیاز | راه پیشنهادی امروز |
|---|---|
| VMهای حساس به تأخیر | pool تکثیری روی nvme با device class |
| بایگانی و پشتیبان | pool EC روی hdd، RBD با --data-pool |
| OSD HDD با بار ترکیبی | block.db/WAL روی NVMe |
| دادهی شیء با عمر مشخص | storage class و lifecycle در RGW |
| بایگانی خارج از کلاستر | cloud transition در RGW |
- cache tier جدید نسازید؛ از Reef منسوخ است و ممکن است بدون اطلاع حذف شود.
- پیش از ارتقای کلاستر دارای cache tier، مهاجرت را کامل کنید.
- برای حذف tier writeback: proxy، flush-evict-all، remove-overlay، remove.
- لایهبندی را در سطح pool و برنامه انجام دهید؛ رفتار قابل پیشبینی است.
- برای OSDهای HDD، block.db روی NVMe بزرگترین بهبود ارزان است.
۱۶-۸ تکمیلی و بهروز#
- از ۲۰۱۹ تاکنون، مهمترین تغییر این حوزه منسوخ شدن cache tiering در Reef است؛ مستندات latest همچنان این هشدار را دارد.
- overwrite در pool EC از Luminous و FastEC در Tentacle، دلیل اصلی تاریخی cache tier جلوی pool EC را از میان برده است.
- RGW storage class، lifecycle و cloud transition مسیر رسمی لایهبندی شیء هستند.
- کد عامل کش (
agent_* در PrimaryLogPG.cc و TierAgentState.h) هنوز در شاخهی main وجود دارد، اما بدون نگهدارنده است.
۱۶-۹ تمرین عملی#
- ۱. در کلاستر آزمایشی یک cache tier writeback بسازید، با
rados bench بار تصادفی بدهید و تأخیر را با pool بدون کش مقایسه کنید. - ۲.
target_max_bytes را کوچک بگذارید و انتقال حالت flush و evict را در log OSD (سطح ۲۰) دنبال کنید. - ۳. روال حذف tier را کامل اجرا کنید و تأیید کنید هیچ شیئی از دست نرفته است.
- ۴. دو قانون CRUSH با device class بسازید و یک pool را با تغییر crush_rule بین لایهها جابهجا کنید.
- ۵. یک storage class COLD در RGW بسازید و با lifecycle یک روزه انتقال را آزمایش کنید (برای آزمایش،
rgw_lc_debug_interval را در محیط آزمایشی تنظیم کنید). - ۶.
agent_choose_mode را در کد بخوانید و برای یک pool با ۱۲۸ PG و target_max_bytes یک ترابایت، سهم هر PG را حساب کنید.
۱۶-۱۰ پرسشهای مرور#
- ۱. وضعیت رسمی cache tiering در نسخههای جاری چیست؟
- ۲. overlay چگونه درخواست کلاینت را به pool کش میبرد؟
- ۳. HitSet نوع bloom چه مزیتی دارد و min_read_recency_for_promote چه میکند؟
- ۴. چرا cache tiering برای بیشتر بارهای RBD کارایی را کاهش میداد؟
- ۵. عامل کش چگونه هدف کل pool را به سهم هر PG تبدیل میکند؟
- ۶. نقش osd_agent_slop چیست؟
- ۷. evict در حالت SOME چگونه قربانی را انتخاب میکند؟
- ۸. مراحل حذف یک cache tier writeback را بنویسید.
- ۹. چه چیزی دلیل تاریخی cache tier جلوی pool EC را از بین برد؟
- ۱۰. برای دادهی شیء با عمر مشخص چه جایگزینی پیشنهاد میشود؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۶-۱۱ منابع این فصل#
- Cache Tiering (deprecation notice
https://docs.ceph.com/en/latest/rados/operations/cache-tiering/ - CRUSH maps and device classes
https://docs.ceph.com/en/latest/rados/operations/crush-map/ - Read balancer
https://docs.ceph.com/en/latest/rados/operations/read-balancer/ - RGW placement and storage classes
https://docs.ceph.com/en/latest/radosgw/placement/ - RGW cloud transition
https://docs.ceph.com/en/latest/radosgw/cloud-transition/ - Erasure code (overwrites
https://docs.ceph.com/en/latest/rados/operations/erasure-code/ - Source: src/osd/PrimaryLogPG.cc (agent_*, hit_set_*
https://github.com/ceph/ceph/blob/main/src/osd/PrimaryLogPG.cc - Source: src/osd/TierAgentState.h
https://github.com/ceph/ceph/blob/main/src/osd/TierAgentState.h - Source: src/osd/HitSet.h
https://github.com/ceph/ceph/blob/main/src/osd/HitSet.h - ceph-devel (۲۰۱۷-۱۱), «About the "temperature histogram" of tier-agent»
https://www.spinics.net/lists/ceph-devel/msg39274.html