برنامهنویسی با librados
حوصله ندارم این فصل در چند خط
- librados رابط بومی RADOS است (C، C++، Python و bindingهای جامعه): وصل شوید، روی یک pool یک IoCtx باز کنید و اشیا، xattrها و omap را بخوانید و بنویسید.
- عملیات روی یک شیء اتمی است: نوشتن داده، xattr، بهروزرسانی omap و شرطها را در یک عملیات جمع کنید.
- watch/notify کانال اعلان سبکی روی یک شیء است؛ RBD با آن تغییرات image را به کلاینتها خبر میدهد.
- Objecter در سمت کلاینت مقصد را محاسبه میکند، نشست هر OSD را نگه میدارد، با تغییر نقشه opها را دوباره میفرستد و کار در جریان را محدود میکند؛ به
osd_max_object_size احترام بگذارید و دادهی بزرگ را تکهتکه کنید.
۱۴-۱ پیش از شروع#
۱۴-۱-۱ این فصل به چه سؤالهایی جواب میدهد؟#
RBD، RGW و CephFS همه در نهایت مشتریهای librados هستند: کتابخانهای که دسترسی مستقیم به اشیای RADOS را فراهم میکند. وقتی هیچکدام از رابطهای آماده با نیاز شما جور نیست (مثلاً یک صف پیام، یک سامانهی قفل توزیعشده یا ذخیرهی کلید-مقدار با تضمین اتمی)، میتوانید مستقیماً روی RADOS برنامه بنویسید. این فصل librados را از سه زاویه بررسی میکند: API، الگوهای کاربردی (عملیات اتمی، watch/notify) و درون کتابخانه (Objecter).
- librados چیست و در کجای پشته قرار دارد؟
- اتصال، IoCtx، namespace و عملیات پایه چطور انجام میشوند؟
- عملیات مرکب و اتمی چه تضمینی دارند؟
- watch/notify چطور کار میکند و برای چه مناسب است؟
- Objecter چطور هدف هر درخواست را محاسبه و تغییرات نقشه را مدیریت میکند؟
- چه دامهایی در برنامهنویسی RADOS هست؟
۱۴-۲ librados چیست؟#
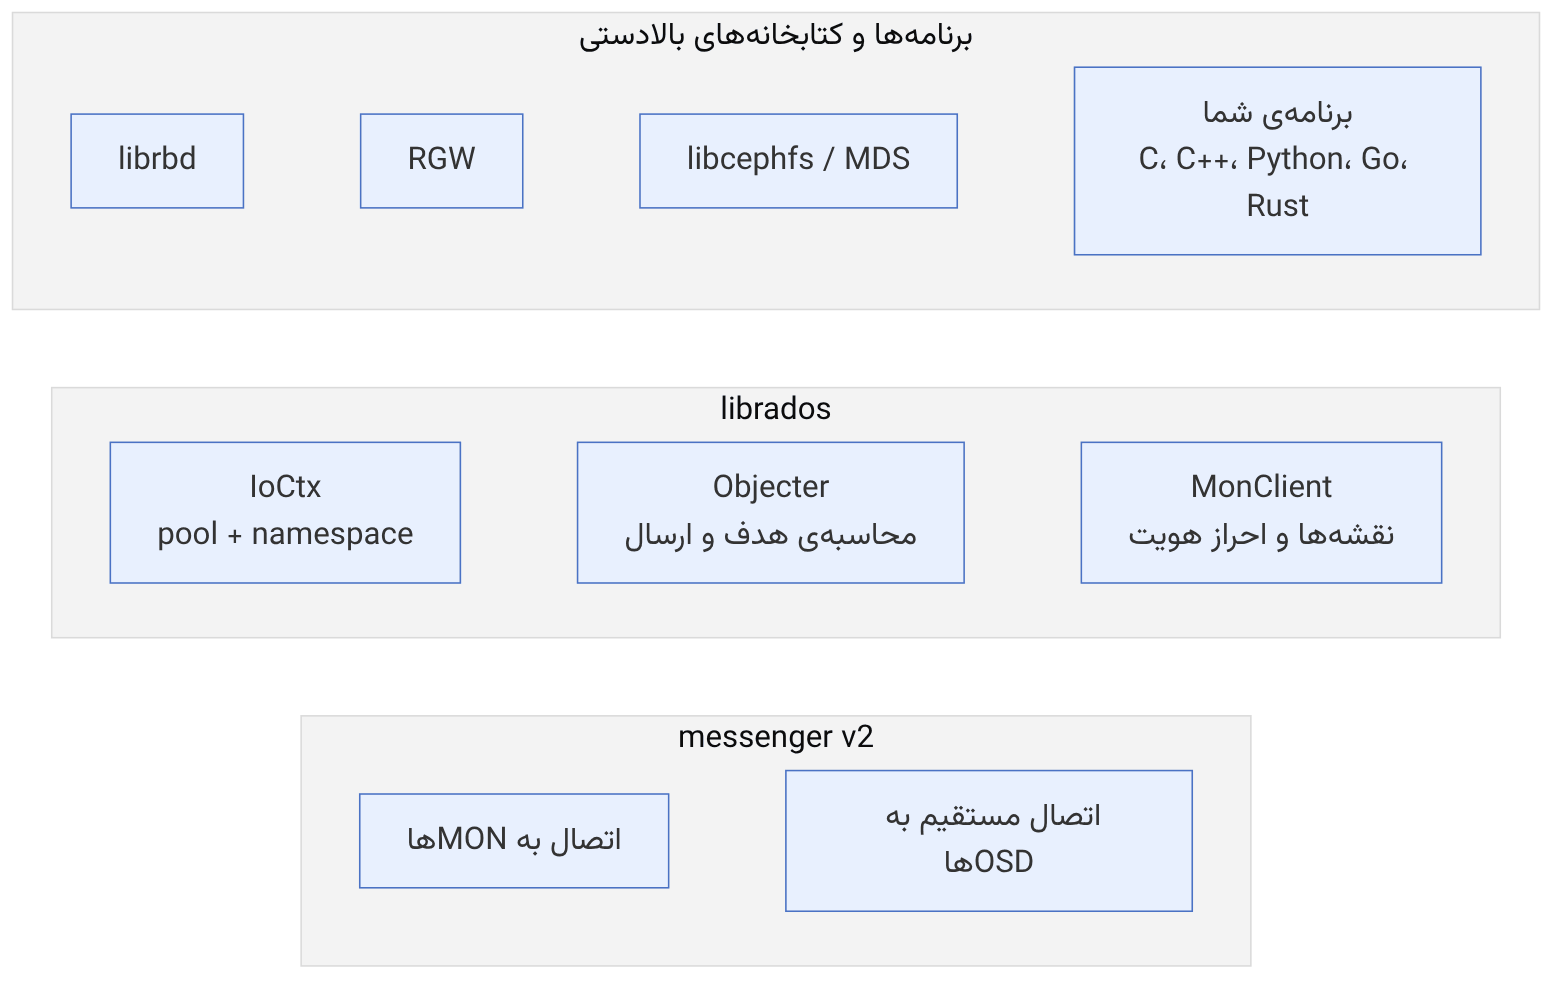
librados رابط بومی RADOS است و در چند زبان در دسترس است: C (librados.h)، C++ (librados.hpp)، Python (ماژول rados)، و از طریق bindingهای جامعه در Go و Rust. مفاهیم پایه:
| مفهوم | معنی |
|---|---|
| Rados / cluster handle | اتصال به کلاستر با هویت cephx و فایل پیکربندی |
| IoCtx | زمینهی I/O روی یک pool (و اختیاری یک namespace)؛ همهی عملیات شیء از طریق آن |
| شیء | نام (رشتهی دلخواه)، دادهی بایتی، xattrها و omap (کلید-مقدار مرتب) |
| namespace | زیرفضای نام درون pool برای جداسازی مستأجران بدون pool جدا |
| locator key | کلید جایگزین برای محاسبهی PG، تا اشیای مرتبط در یک PG قرار گیرند |
| snap context | برای snapshotهای self-managed (روشی که RBD استفاده میکند) |
یک شیء RADOS سه بخش مستقل دارد: داده (مانند فایل، با offset)، xattr (چند ویژگی کوچک) و omap (کلید-مقدار مرتب، در RocksDB زیر BlueStore). omap برای شاخصها و فراداده عالی است، اما در pool EC پشتیبانی نمیشود و omapهای بسیار بزرگ (میلیونها کلید در یک شیء) مشکلاتی مثل scrub طولانی و هشدار LARGE_OMAP_OBJECTS ایجاد میکنند.
۱۴-۳ شروع کار#
۱۴-۳-۱ آمادهسازی#
sudo dnf install -y python3-rados librados-devel     # یا apt install python3-rados librados-dev
ceph osd pool create devpool 32
ceph osd pool application enable devpool myapp
ceph auth get-or-create client.devapp mon 'allow r' osd 'allow rwx pool=devpool' \
-o /etc/ceph/ceph.client.devapp.keyringپرچم x در capability OSD برای فراخوانی متدهای کلاس RADOS (exec) لازم است (فصل ۱۵). اگر برنامهی شما فقط داده میخواند و مینویسد، rw کافی است؛ کمترین دسترسی لازم را بدهید.
۱۴-۳-۲ یک برنامهی پایتونی ساده#
#!/usr/bin/env python3
import rados

with rados.Rados(conffile='/etc/ceph/ceph.conf', name='client.devapp') as cluster:
    print("fsid:", cluster.get_fsid())
    with cluster.open_ioctx('devpool') as io:
        io.set_namespace('tenant-a')
        io.write_full('greeting', b'salam donya')
        io.set_xattr('greeting', 'lang', b'fa')
        print(io.read('greeting'))
        print(dict(io.get_xattrs('greeting')))
        # omap با WriteOp
        with rados.WriteOpCtx() as op:
            io.set_omap(op, ('k1', 'k2'), (b'v1', b'v2'))
            io.operate_write_op(op, 'index')
        with rados.ReadOpCtx() as op:
            it, ret = io.get_omap_vals(op, "", "", 100)
            io.operate_read_op(op, 'index')
            print(dict(it))
        for obj in io.list_objects():
            print(obj.nspace, obj.key)
۱۴-۳-۳ همان در C++#
// my_app.cc — نمونهی نوشتهشده برای این فصل
#include <rados/librados.hpp>
#include <iostream>
int main() {
librados::Rados cluster;
cluster.init2("client.devapp", "ceph", 0);
cluster.conf_read_file("/etc/ceph/ceph.conf");
if (int r = cluster.connect(); r < 0) { std::cerr << "connect: " << r << "\n"; return 1; }
librados::IoCtx io;
cluster.ioctx_create("devpool", io);
io.set_namespace("tenant-a");
librados::bufferlist bl;
bl.append("salam donya");
io.write_full("greeting", bl);
librados::bufferlist out;
io.read("greeting", out, 0, 0);
std::cout << out.to_str() << "\n";
cluster.shutdown();
}g++ -std=c++20 my_app.cc -lrados -o my_app && ./my_app۱۴-۳-۴ ناهمگام (aio)#
برای توان بالا، عملیات را ناهمگام بفرستید تا چند درخواست همزمان در جریان باشد:
import rados, threading
done = threading.Semaphore(0)
def on_complete(completion):
    done.release()
with rados.Rados(conffile='/etc/ceph/ceph.conf', name='client.devapp') as c, c.open_ioctx('devpool') as io:
    N = 64
    for i in range(N):
        io.aio_write_full(f'obj-{i}', b'x' * 65536, oncomplete=on_complete)
    for _ in range(N):
done.acquire()در حلقههای ناهمگام، تعداد درخواستهای در جریان را محدود کنید (مثلاً با semaphore). فرستادن صدها هزار درخواست همزمان حافظهی کلاینت را پر میکند و throttleهای Objecter (objecter_inflight_ops و objecter_inflight_op_bytes) درخواستها را معطل میکنند.
۱۴-۴ عملیات اتمی#
۱۴-۴-۱ عملیات مرکب#
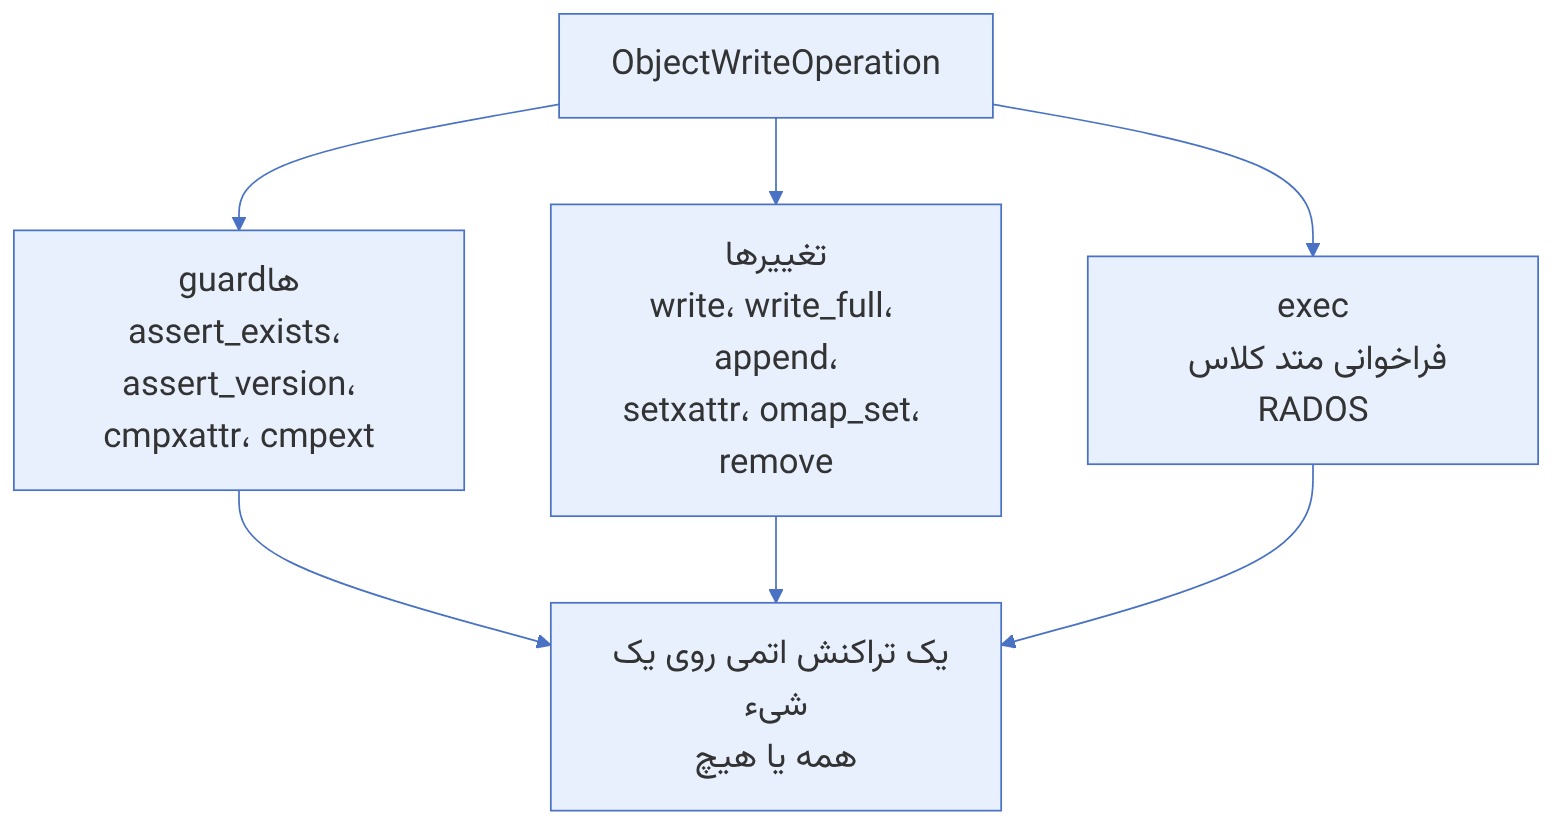
RADOS روی یک شیء تراکنش اتمی میدهد: چند عملیات (نوشتن داده، تغییر xattr، بهروزرسانی omap، شرطها) را در یک ObjectWriteOperation جمع میکنید و OSD همه را با هم اجرا میکند یا هیچکدام را. اگر یکی از guardها (شرطها) شکست بخورد، هیچ تغییری اعمال نمیشود. تراکنش بین چند شیء وجود ندارد؛ این مهمترین محدودیت طراحی روی RADOS است.
۱۴-۴-۲ الگوی compare-and-swap با نسخه#
هر شیء یک user_version دارد که با هر تغییر افزایش مییابد. با assert_version میتوان «فقط اگر از وقتی خواندم کسی تغییرش نداده» نوشت:
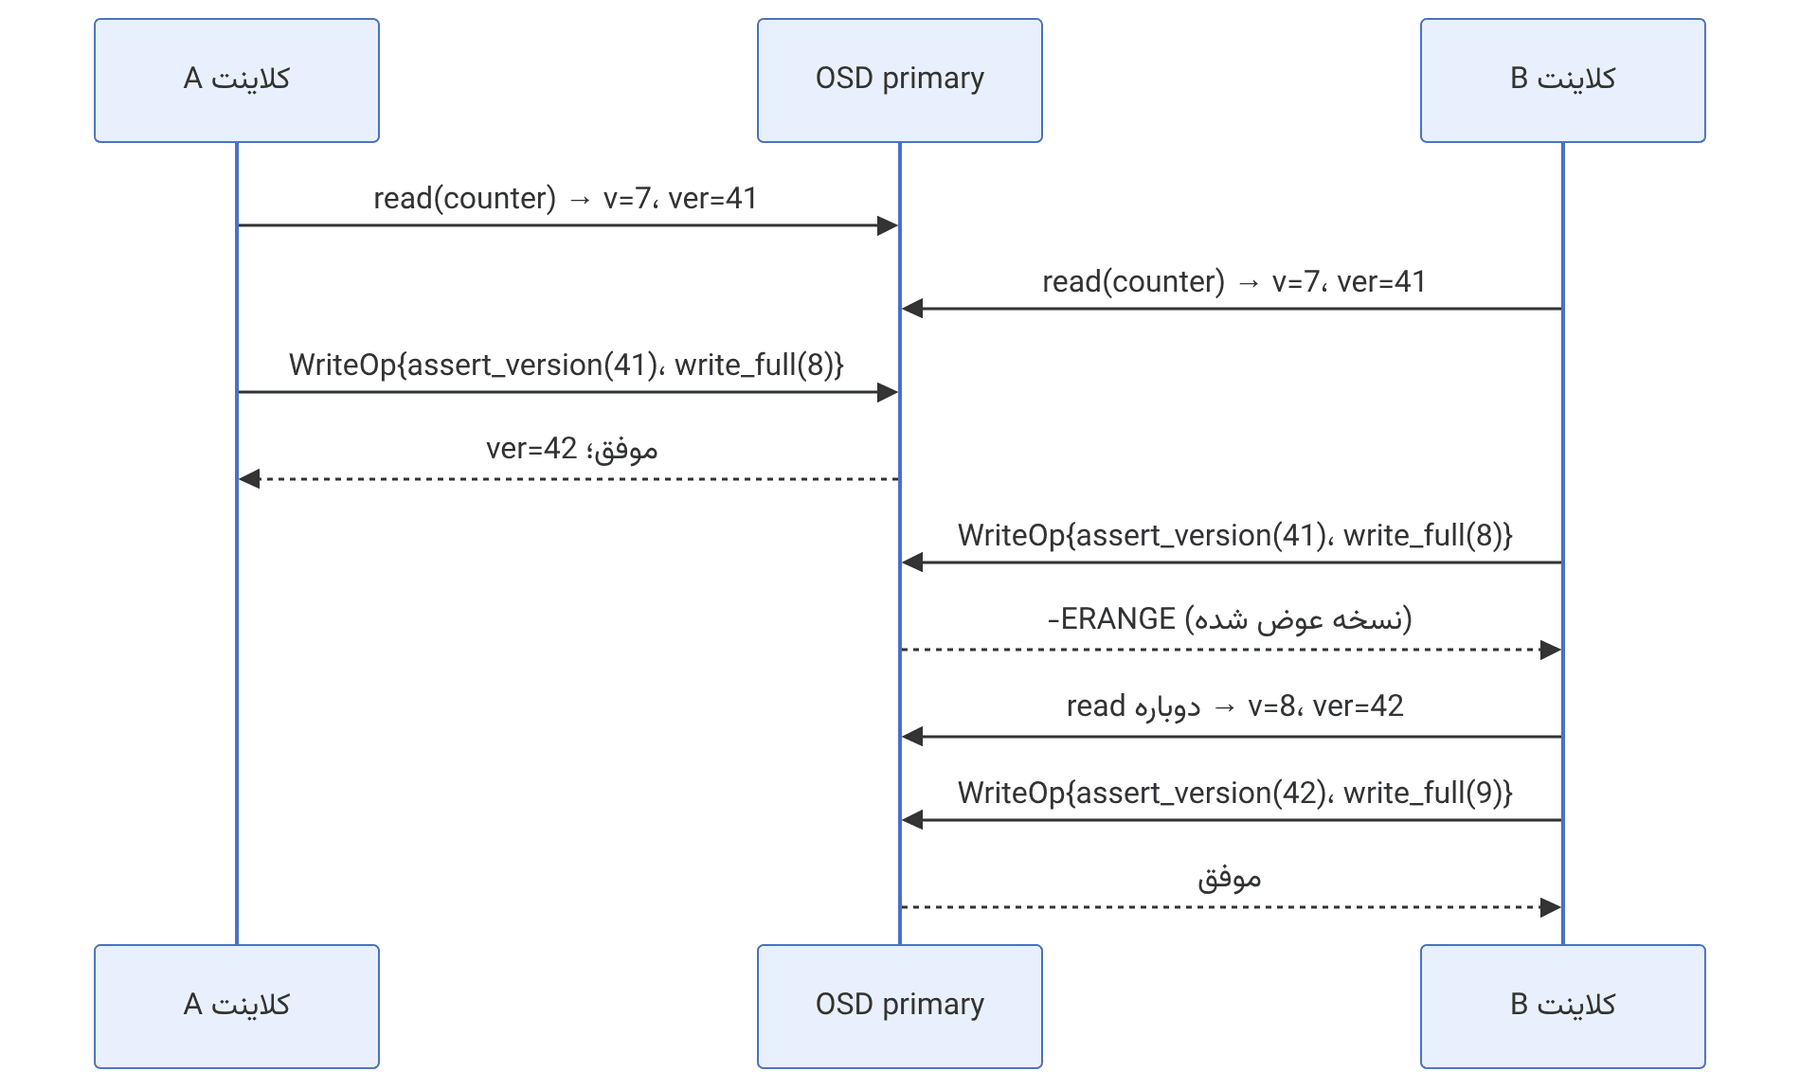
import rados, errno
def increment(io, oid):
while True:
try:
data = io.read(oid, length=64) # پیشفرض length در binding برابر 8192 است
ver = io.get_last_version()
except rados.ObjectNotFound:
data, ver = b'0', None
new = str(int(data) + 1).encode()
with rados.WriteOpCtx() as op:
if ver is None:
op.new(rados.LIBRADOS_CREATE_EXCLUSIVE) # فقط اگر وجود ندارد
else:
op.assert_version(ver)
op.write_full(new)
try:
io.operate_write_op(op, oid)
return int(new)
except (rados.OSError, rados.ObjectExists) as e:
continue # کسی زودتر نوشت؛ دوبارهدر OSD، این بررسی در PrimaryLogPG::do_osd_ops انجام میشود:
// from ceph/ceph, LGPL — src/osd/PrimaryLogPG.cc (excerpt)
case CEPH_OSD_OP_ASSERT_VER:
  ...
  if (!ver) {
    result = -EINVAL;
  } else if (ver < oi.user_version) {
    result = -ERANGE;
  } else if (ver > oi.user_version) {
    result = -EOVERFLOW;
  }
پس نسخهی کهنه -ERANGE و نسخهای که هنوز وجود ندارد -EOVERFLOW برمیگرداند. guardهای دیگر: cmpxattr (مقایسهی یک xattr)، cmpext (مقایسهی بخشی از داده)، assert_exists و omap_cmp.
۱۴-۴-۳ قفل توزیعشده#
librados قفلهای مشورتی (advisory) روی اشیا دارد که با کلاس lock در OSD پیاده شدهاند؛ RBD برای exclusive-lock از همین استفاده میکند:
io.lock_exclusive('jobs', 'scheduler', cookie='node-a', desc='leader', duration=30)
# ... کار ...
io.unlock('jobs', 'scheduler', 'node-a')قفل مشورتی فقط وقتی کار میکند که همهی کلاینتها آن را رعایت کنند. با duration، قفل کلاینتی که مرده خودبهخود منقضی میشود؛ اما کلاینتی که فقط کند شده هم ممکن است قفلش را از دست بدهد و بیخبر ادامه دهد. برای ایمنی واقعی، قفل را با guard در عملیات نوشتن ترکیب کنید (مثلاً assert_locked در کلاس lock) یا مانند RBD، کلاینت قبلی را blocklist کنید.
۱۴-۵ watch و notify#
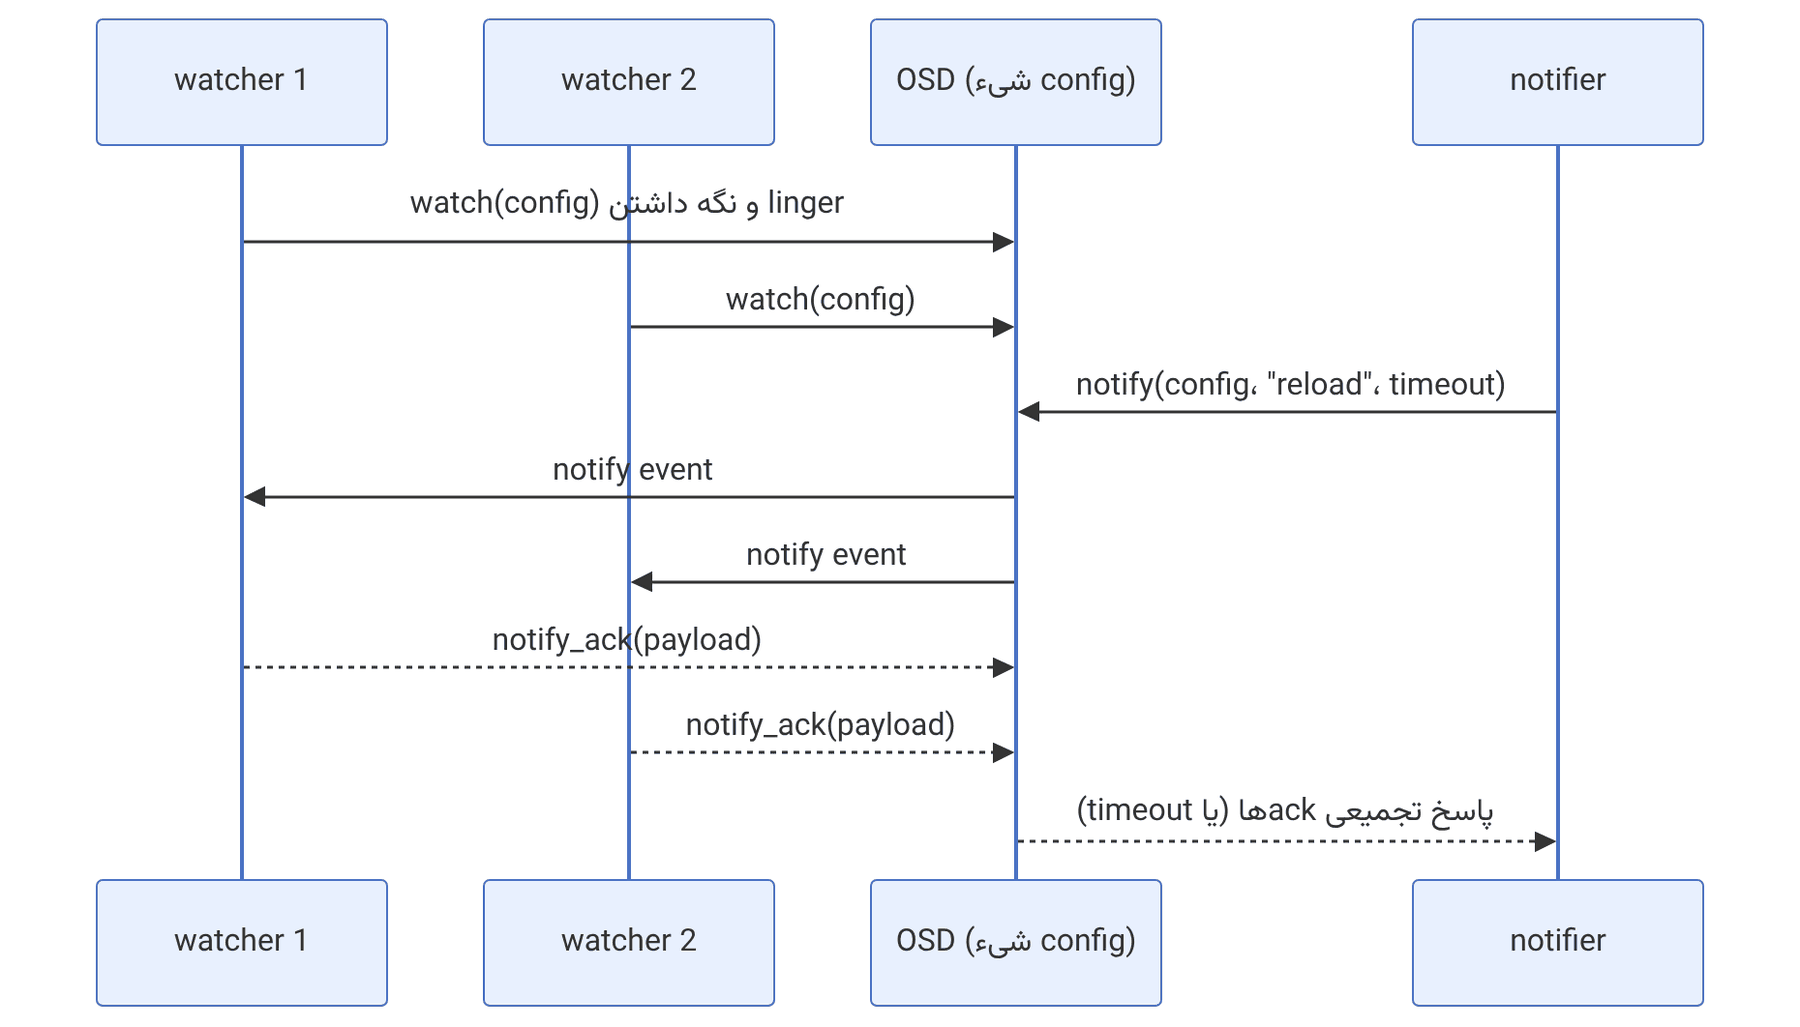
watch/notify یک کانال اعلان سبک روی یک شیء است: هر کلاینت روی شیء watch ثبت میکند و هر کلاینتی میتواند notify بفرستد که به همهی watcherها میرسد. RBD از آن برای اطلاعرسانی تغییر header image (مثلاً resize یا snapshot) به همهی کلاینتهایی که image را باز کردهاند استفاده میکند. RGW هم برای همگامسازی cache بین نمونهها از آن بهره میبرد.
# watcher.py
import rados, time
def on_notify(notify_id, notifier_id, watch_id, data):
print("got:", data)
return b'ok' # payload پاسخ (در نسخههای جدید binding)
def on_error(err):
print("watch error:", err) # باید watch را دوباره ثبت کنید
with rados.Rados(conffile='/etc/ceph/ceph.conf', name='client.devapp') as c, c.open_ioctx('devpool') as io:
io.write_full('config', b'v1')
with io.watch('config', on_notify, on_error):
time.sleep(600)# notifier.py
with rados.Rados(conffile='/etc/ceph/ceph.conf', name='client.devapp') as c, c.open_ioctx('devpool') as io:
io.notify('config', 'reload', timeout_ms=5000)watch در کلاینت به شکل یک عملیات linger در Objecter پیاده شده است: درخواستی که «تمام نمیشود» و Objecter هر بار که نقشه تغییر کند یا اتصال قطع شود، آن را دوباره به primary فعلی شیء میفرستد (Objecter::_recalc_linger_op_target). در OSD، watch بخشی از وضعیت شیء است و با ping دورهای زنده نگه داشته میشود؛ اگر کلاینت در مهلت ping نکند، watch حذف میشود و callback خطای کلاینت باید watch را دوباره بسازد. notify اگر همهی watcherها در مهلت ack ندهند، با timeout تمام میشود و فهرست watcherهای بیپاسخ را برمیگرداند؛ مهلت پیشفرض سمت OSD osd_default_notify_timeout است (در کد جاری ۳۰ ثانیه).
watch/notify برای اعلان است، نه انتقال دادهی حجیم یا صف قابل اتکا: اگر watcher در لحظهی notify قطع باشد، پیام را از دست میدهد. الگوی درست: دادهی واقعی را در شیء (یا omap) بنویسید و notify فقط بگوید «چیزی تغییر کرد، دوباره بخوان». watcher پس از اتصال دوباره هم باید یک بار وضعیت را بخواند.
۱۴-۶ زیر librados: پیام MOSDOp، session و backoff#
بخش «از درون کد: Objecter» در ادامهی همین فصل نشان میدهد librados چگونه یک op را به Objecter میدهد. اینجا یک لایه پایینتر میرویم: پیامی که روی سیم میرود دقیقاً چه چیزی دارد، Objecter چگونه opها را بر اساس OSD در sessionها نگه میدارد، و OSD چگونه میتواند به کلاینت بگوید «فعلاً نفرست» (backoff). همهی ساختارها از main هستند (src/osdc/Objecter.cc، src/messages/MOSDOp.h و src/include/rados.h).
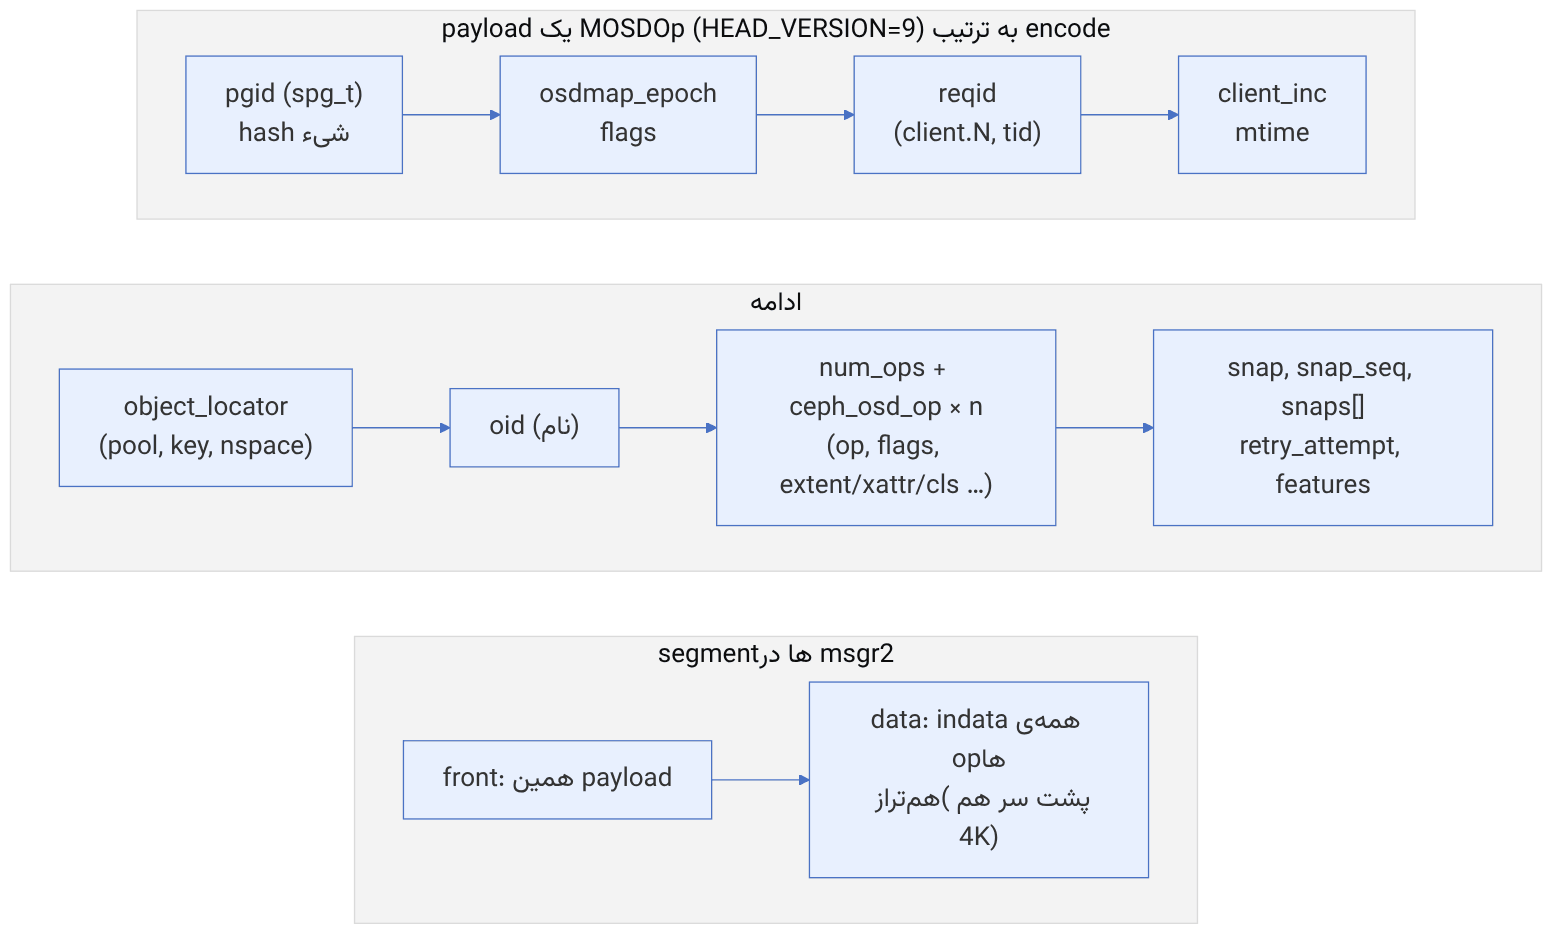
۱۴-۶-۱ چرا pgid پیش از نام شیء میآید؟#
OSD پیام را در دو مرحله decode میکند (partial_decode_needed و final_decode_needed در کلاس). در مرحلهی اول فقط pgid، hash، epoch و flags خوانده میشوند. این کافی است تا پیام بدون decode کامل به shard درست صف عملیاتی (OSDShard) فرستاده شود. decode کامل (نام، opها و snapها) بعداً در thread همان shard انجام میشود. این طراحی، کار thread مربوط به messenger را کم و موازیسازی را بیشتر میکند. به همین دلیل MOSDOp از MOSDFastDispatchOp ارث میبرد.
| فیلد | نقش در OSD |
|---|---|
osdmap_epoch | اگر از epoch فعلی OSD جدیدتر باشد، OSD ابتدا نقشه را میگیرد. اگر قدیمیتر باشد و PG جابهجا شده باشد، op دور ریخته میشود و کلاینت با نقشهی جدید دوباره میفرستد. |
reqid (client.N:tid) | کلید تشخیص تکرار. OSD در pg log آن را جستوجو میکند و برای op تکراری (پس از resend) پاسخ قبلی را برمیگرداند. |
flags | مثلاً ONDISK، READ، WRITE، BALANCE_READS، LOCALIZE_READS، FULL_TRY |
retry_attempt | شمارندهی ارسال مجدد؛ در لاگ OSD و dump_ops_in_flight دیده میشود |
snap_seq، snaps | SnapContext نویسنده برای COW snapshot (فصل ۲) |
۱۴-۶-۲ sessionها و op «بیخانمان»#
Objecter برای هر OSD یک OSDSession دارد که opهای در جریان آن OSD را با tid نگه میدارد. هر op در _calc_target به یک OSD نگاشت میشود. اگر هدفی وجود نداشته باشد (pool حذف شده، PG بدون primary یا نقشه هنوز نرسیده)، op به homeless_session منتقل میشود. با هر نقشهی جدید، Objecter همهی opها را دوباره هدفیابی میکند و آنهایی را که هدفشان تغییر کرده، به session تازه منتقل و دوباره ارسال میکند.
| گزینه | پیشفرض | اثر |
|---|---|---|
objecter_inflight_ops | ۱_K | سقف opهای در جریان؛ بیش از آن، op_submit بلوک میشود (throttle بودجه) |
objecter_inflight_op_bytes | ۱۰۰_M | سقف بایتهای در جریان |
objecter_tick_interval | ۵ | ثانیه؛ بررسی opهای کند و ارسال keepalive |
objecter_timeout | ۱۰ | ثانیه؛ پس از آن، برای sessionهای بیپاسخ درخواست نقشه یا ping |
rados_osd_op_timeout | ۰ | ۰ یعنی بدون timeout؛ مقدار مثبت خطای ETIMEDOUT میدهد |
objecter_completion_locks_per_session | ۳۲ | قفلهای شاردشده برای ترتیب completionها |
objecter_inflight_ops=1024 برای برنامهای که با aio_write هزاران op همزمان میفرستد، یک گلوگاه پنهان است: فراخوانی aio_* بلوک میشود تا بودجه آزاد شود. اگر callbackهای completion در همان thread منتظر باشند، بنبست ایجاد میشود. عمق صف را در برنامه کنترل کنید یا گزینه را آگاهانه افزایش دهید.
۱۴-۷ backoff: OSD میگوید «صبر کن»#
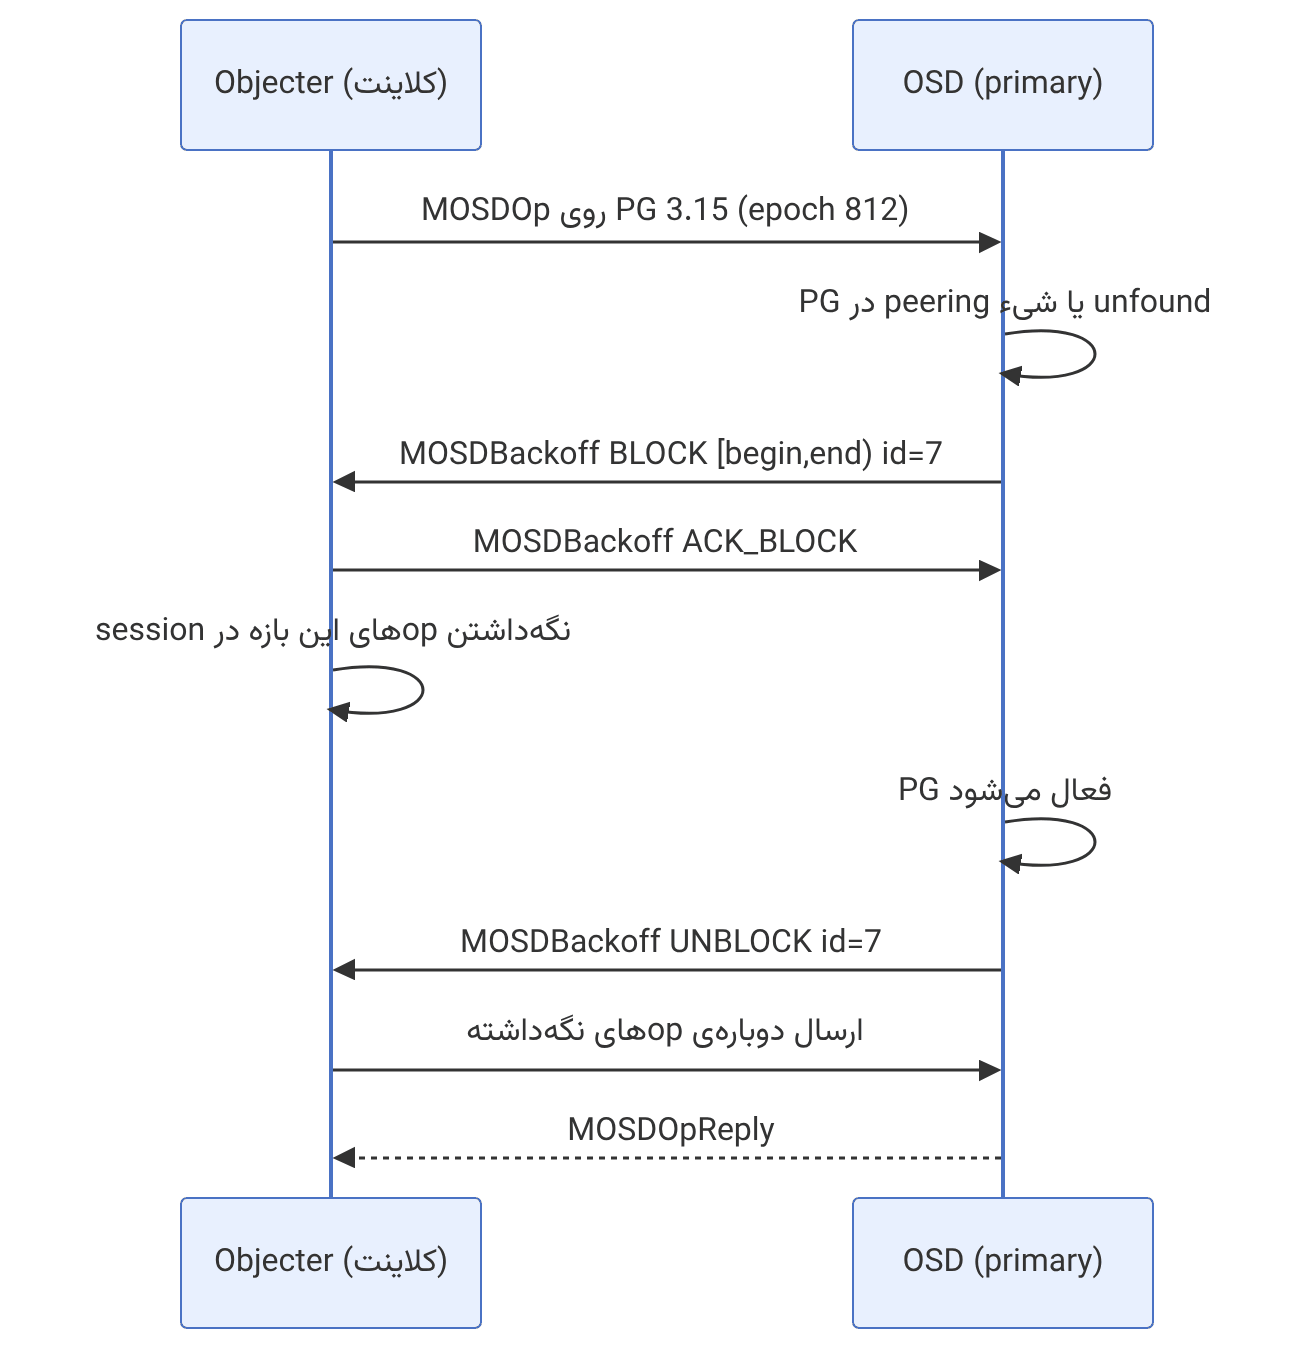
عملها در rados.h عبارتاند از CEPH_OSD_BACKOFF_OP_BLOCK=1، ACK_BLOCK=2 و UNBLOCK=3. پیشفرضهای OSD (در main): osd_backoff_on_unfound=true، osd_backoff_on_degraded=false و osd_backoff_on_peering=false. پس بهطور پیشفرض فقط برای اشیای unfound، backoff فرستاده میشود. در حالتهای دیگر op در OSD صف میشود. backoff به ویژگی RADOS_BACKOFF در کلاینت نیاز دارد که کلاینتهای Luminous به بعد آن را دارند.
ceph daemon osd.4 dump_blocked_ops
ceph daemon client.admin.<pid>.<cookie> objecter_requests     # از admin socket کلاینت
ceph tell osd.4 config get osd_backoff_on_peering۱۴-۸ SplitOp (فقط main)#
شاخهی main یک کلاس تازه به نام SplitOp در src/osdc/ دارد (مجوز LGPL 2.1، ۲۰۲۵). توضیح خود کد آن را «پایهای برای تقسیم عملیات بین چند OSD برای کارایی بهتر» معرفی میکند: در poolهای EC، یک خواندن بزرگ مستقیم به shardهای داده فرستاده میشود، و در poolهای replicated، یک خواندن بزرگ بین replicaها تقسیم میشود. سپس پاسخها در کلاینت به هم وصل میشوند. شمارندهای با توضیح «Client read ops split by SplitOp» هم به Objecter اضافه شده است. این کلاس در شاخهی Tentacle نیست (فایل آن در آن شاخه وجود ندارد). پس این قابلیت مربوط به انتشار بعدی است و جزئیات، گزینهها و پیشفرضهایش ممکن است پیش از انتشار تغییر کند.
چرا خواندن مستقیم از shard در EC ممکن شد؟ در EC قدیمی، کلاینت همیشه به primary میفرستاد و primary از k shard میخواند و decode میکرد. با FLAG_EC_PLUGIN_PARTIAL_READ_OPTIMIZATION (فصل ۲۷)، دادهی یک بازه دقیقاً در یک shard داده قرار دارد. اگر کلاینت چیدمان stripe را بداند (stripe_unit و k از پروفایل pool)، میتواند بازه را خودش به shardها نگاشت کند و یک رفتوبرگشت شبکه (کلاینت→primary→shard) حذف شود. ترکیب این با SplitOp، پایهی خواندنهای سریعتر از EC در نسخههای آینده است.
۱۴-۹ Objecter با عدد: بودجهی op، سقف در جریان، زندهبودن watch و timeout notify#
این بخش چهار سازوکار کوچک در کلاینت RADOS را بررسی میکند که در برنامههای واقعی رفتار غیرمنتظره ایجاد میکنند. ارجاعها به main در نوامبر ۲۰۲۶ است. همهی پیشفرضها از فایلهای src/common/options خوانده شدهاند.
۱۴-۹-۱ بودجهی هر op#
منبع در کد: src/osdc/Objecter.cc :: Objecter::calc_op_budget، _throttle_op؛ src/common/Throttle.h :: Throttle::_should_wait
پیچیدگی: O(تعداد زیرعملیات op)
pseudocode
budget = 0
برای هر زیرعملیات:
if حالت WR: budget += طول indata
elif حالت RD و از extent استفاده میکند (READ، SPARSE_READ، CMPEXT…): budget += extent.length
elif RD و نوع ATTR: budget += name_len + value_len
# بقیه (STAT، OMAPGETVALS، CALL با حالت RD|EXEC…) صفر
op_throttle_bytes.get(budget) # سقف objecter_inflight_op_bytes = 100 MiB
op_throttle_ops.get(1) # سقف objecter_inflight_ops = 1024
_should_wait(c) = (c ≤ max و cur + c > max) یا (c ≥ max و cur > max)| عملیات | budget بایت | توضیح |
|---|---|---|
| write ۴ KiB | ۴۰۹۶ | طول داده |
| writefull ۴ MiB | ۴۱۹۴۳۰۴ | ۲۵تا از آن کل سقف ۱۰۰ MiB را پر میکند |
| read ۶۴ KiB | ۶۵۵۳۶ | طول extent، نه طول پاسخ واقعی |
| getxattr «user.x» با مقدار ۱۰۰ بایتی | ۱۰۶ | طول نام و مقدار |
| omap_get_vals | ۰ | فقط یک واحد از سقف ۱۰۲۴ تایی |
| omap_set_vals با ۱ MiB کلید و مقدار | ۱۰۴۸۵۷۶ | حالت WR، پس indata شمرده میشود |
| CALL (کلاس) با ورودی ۱۰ MiB | ۰ | حالت CALL فقط RD است، پس ورودی شمرده نمیشود |
نتیجه. سقف بایت برای opهای بزرگ و سقف تعداد برای opهای کوچک تعیینکننده است. op بزرگتر از ۱۰۰ MiB قفل نمیشود. اگر cur ≤ max باشد، بیدرنگ رد میشود، اما بعد از آن cur > max است و همهی opهای بعدی صبر میکنند تا آن op تمام شود. فراخوانی کلاس با ورودی حجیم عملاً throttle بایتی ندارد. برنامهای که با aio_exec بلاکهای بزرگ میفرستد باید خودش محدودیت بگذارد.
۱۴-۹-۲ سقف در جریان و قانون Little#
منبع در کد: src/osdc/Objecter.cc :: _throttle_op (با پیشفرضهای objecter_inflight_ops و objecter_inflight_op_bytes)
پیچیدگی: O(۱)
pseudocode
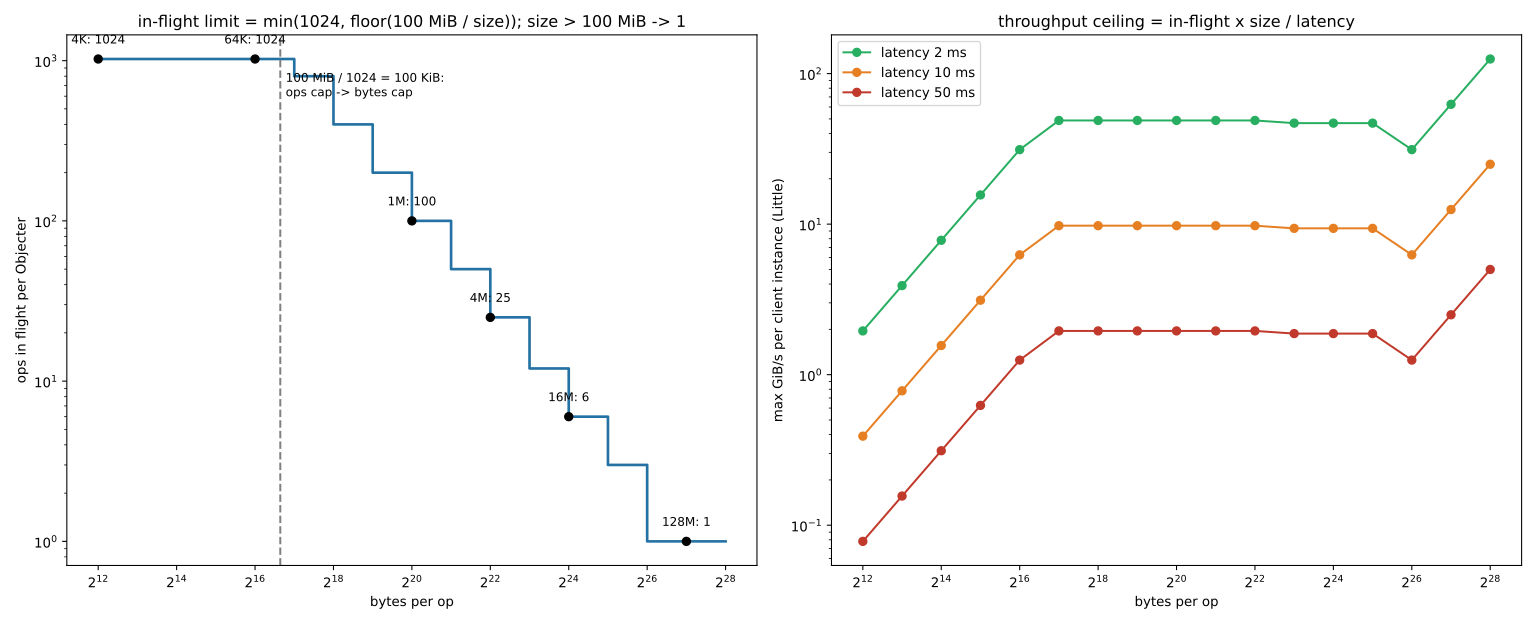
N(s) = s > 100 MiB ? 1 : min(1024, ⌊104857600 / s⌋) # op همزمان با اندازهی s
throughput ≤ N(s) × s / latency
IOPS ≤ N(s) / latency
نقطهی تغییر: s = 104857600 / 1024 = 102400 بایت (100 KiB)مثال عددی. برای op چهار کیلوبایتی N = ۱۰۲۴ است. با تأخیر ۲ میلیثانیه، سقف ۵۱۲۰۰۰ IOPS (۲ GiB/s) است و با ۱۰ میلیثانیه، ۱۰۲۴۰۰ IOPS. برای op ۱۲۸ KiB، N = ۸۰۰ است. برای ۴ MiB N = ۲۵ است: با تأخیر ۱۰ میلیثانیه حدود ۹.۸ GiB/s و با ۵۰ میلیثانیه (EC روی HDD زیر بار) فقط ۱.۹۵ GiB/s برای کل یک نمونهی librados، صرفنظر از تعداد threadها. برای ۱۶ MiB، N = ۶ است. این سقف برای هر نمونهی Rados/Objecter است. پس یا آن را با objecter_inflight_op_bytes بالا ببرید، یا چند نمونهی مستقل بسازید. در فرایندهای QEMU یا rbd-nbd، تنظیم معادل در بخش [client] قرار میگیرد.
۱۴-۹-۳ زندهبودن watch#
منبع در کد: src/osdc/Objecter.cc :: Objecter::tick، _send_linger_ping؛ src/osd/PrimaryLogPG.cc (CEPH_OSD_WATCH_OP_WATCH)؛ src/osd/Watch.cc
پیچیدگی: O(sessionها + linger opها) در هر tick
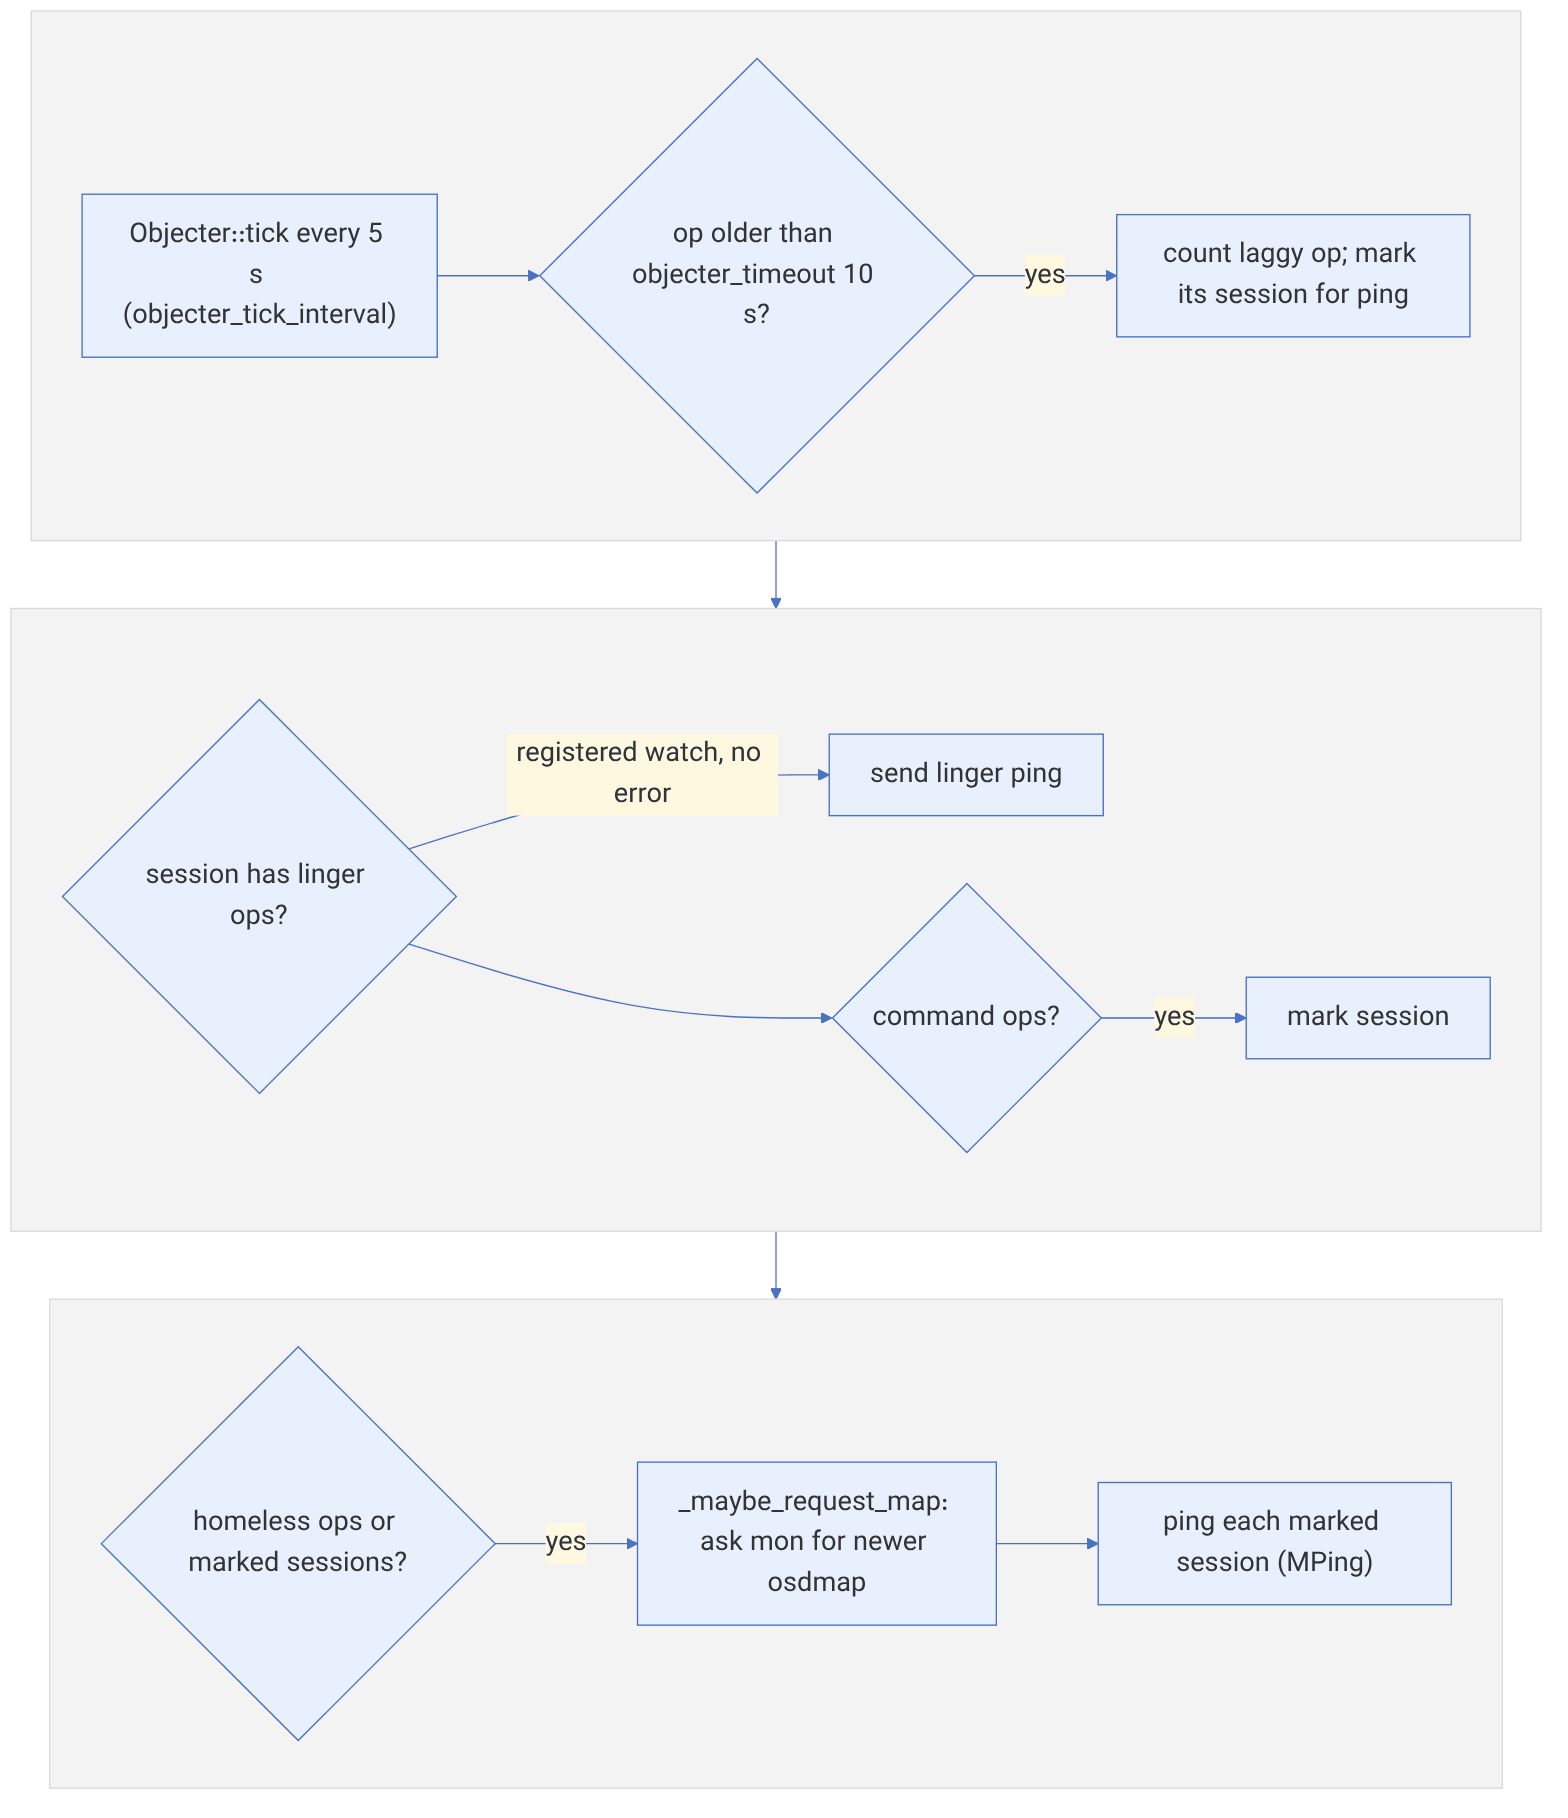
pseudocode
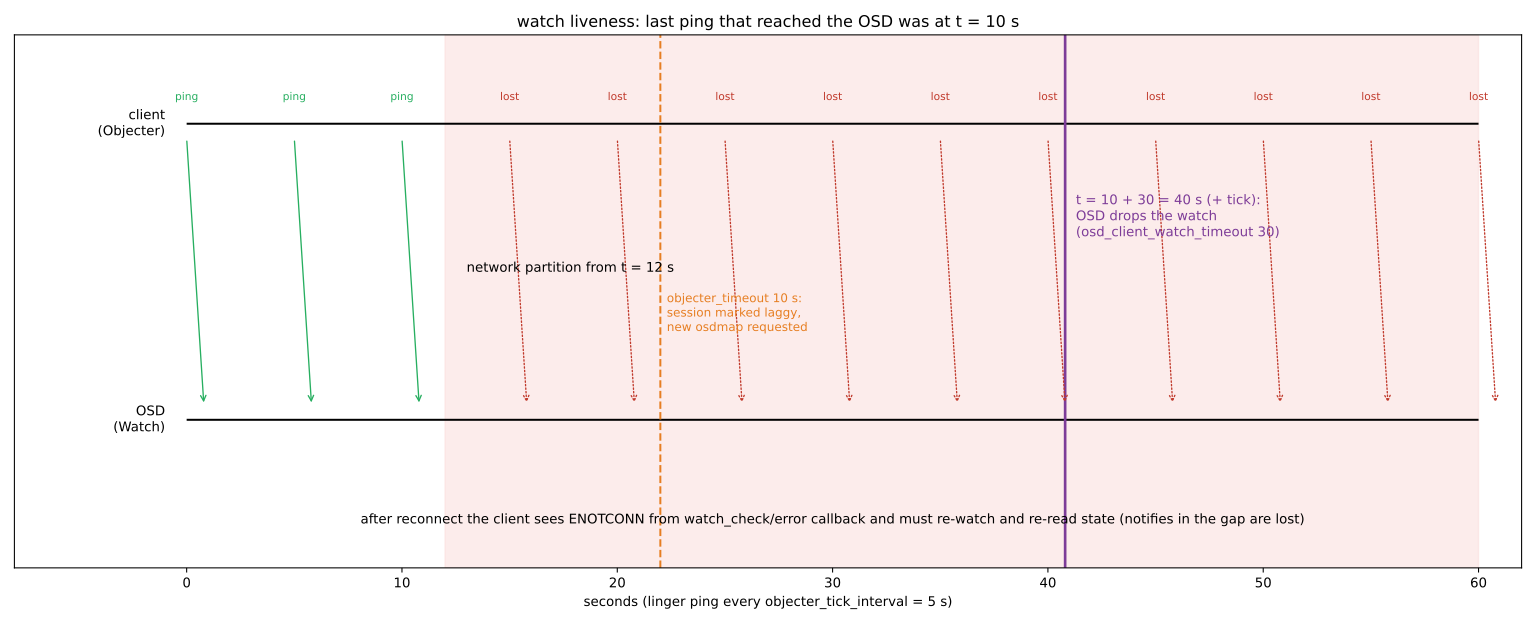
Objecter::tick هر objecter_tick_interval (5 s):
opهای قدیمیتر از objecter_timeout (10 s) ← session «laggy» ← MPing و درخواست osdmap تازه
برای هر watch ثبتشده و بیخطا: _send_linger_ping
OSD: watch_info_t(cookie, timeout = op.watch.timeout یا osd_client_watch_timeout (30 s))
هر ping تایمر را تازه میکند ؛ اگر timeout بگذرد: watch حذف میشود
کلاینت پس از وصل شدن دوباره: watch_check یا callback خطا ← ENOTCONN ← watch دوباره و خواندن دوبارهی وضعیتمثال عددی. آخرین ping موفق در ثانیهی ۱۰ به OSD میرسد و از ثانیهی ۱۲ شبکه قطع میشود. حدود ثانیهی ۴۰، یعنی ۳۰ ثانیه پس از آخرین ping، OSD watch را حذف میکند. هر notify که در این فاصله به آن شیء فرستاده شود به این کلاینت نمیرسد و در فهرست timeout یا missed notify ثبت میشود. برنامهی درست (مانند exclusive-lock در RBD) پس از خطای watch، وضعیت را دوباره از خود شیء میخواند و به notifyهای گذشته اعتماد نمیکند.
۱۴-۹-۴ timeout notify: گرد شدن به ثانیه#
منبع در کد: src/librados/IoCtxImpl.cc :: IoCtxImpl::notify، aio_notify؛ src/osd/PrimaryLogPG.cc (CEPH_OSD_OP_NOTIFY)
پیچیدگی: O(۱)
pseudocode
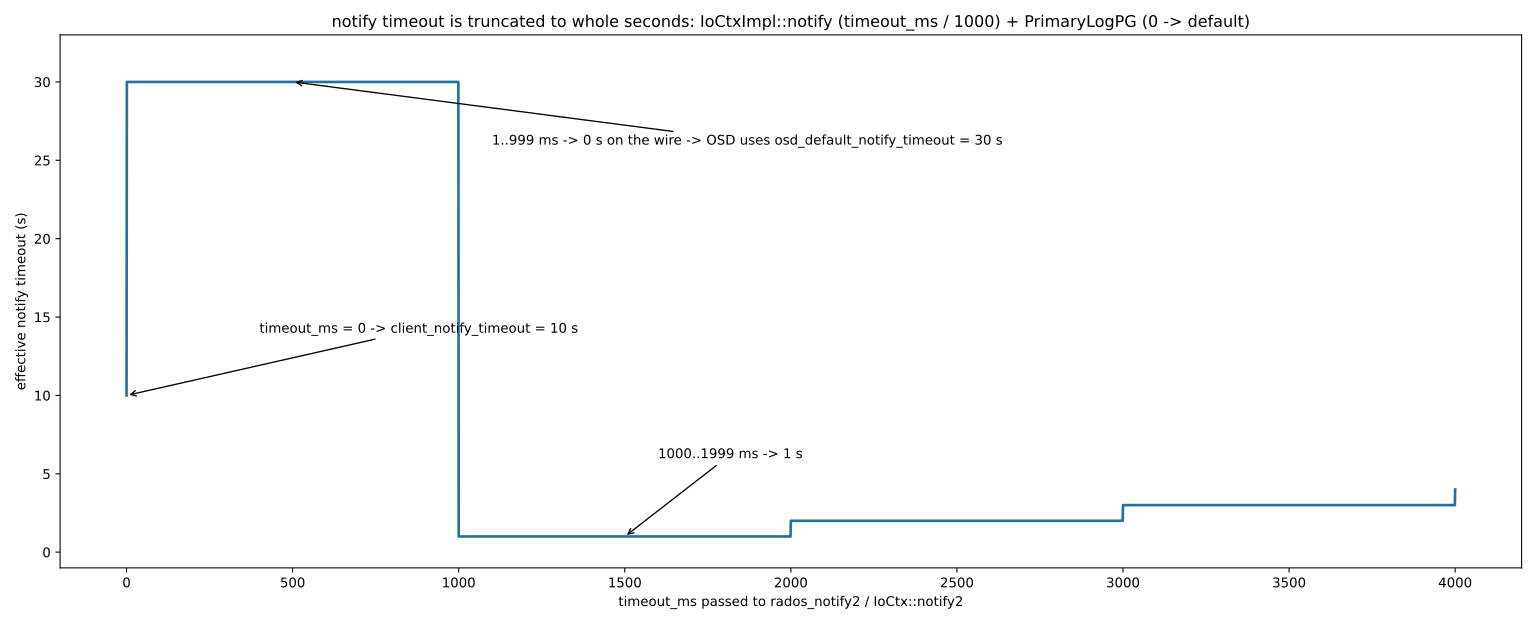
timeout = notify_timeout # client_notify_timeout، پیشفرض 10 s
if timeout_ms: timeout = timeout_ms / 1000 # تقسیم صحیح
روی سیم: timeout (ثانیه)
OSD: if timeout == 0: timeout = osd_default_notify_timeout # 30 sمثال عددی. timeout_ms برابر ۰ یعنی ۱۰ ثانیه. ۱۵۰۰ میلیثانیه به ۱ ثانیه تبدیل میشود. اما ۵۰۰ میلیثانیه به ۰ تبدیل میشود و OSD آن را «پیشفرض» تعبیر میکند، پس notify تا ۳۰ ثانیه منتظر ack میماند، یعنی ۶۰ برابر چیزی که برنامهنویس خواسته بود. برای timeoutهای کمتر از یک ثانیه، از timeout خود notify استفاده نکنید و در برنامه تایمر جداگانه بگذارید.
۱۴-۱۰ از درون کد: Objecter#
۱۴-۱۰-۱ نقش Objecter#
Objecter (src/osdc/Objecter.cc) قلب سمت کلاینت librados است: هر عملیات را به یک Op تبدیل میکند، هدفش (PG و OSD primary) را محاسبه و ارسال میکند، پاسخ را به درخواستکننده برمیگرداند و مهمتر از همه، با هر تغییر نقشه، درخواستهای در جریان را بازبینی و در صورت نیاز دوباره ارسال میکند. librbd، RGW و ceph-fuse همه از همین کلاس استفاده میکنند.
| تابع در Objecter.cc | کار |
|---|---|
| _op_submit() | ثبت Op، محاسبهی هدف، اعمال throttle و ارسال |
| _calc_target() | محاسبهی PG و acting primary بر اساس نقشهی فعلی |
| _send_op() | ساخت پیام MOSDOp و ارسال روی اتصال OSD |
| handle_osd_map() | دریافت نقشهی جدید و بازبینی همهی Opها و lingerها |
| _recalc_linger_op_target() | محاسبهی دوبارهی هدف برای watchها |
۱۴-۱۰-۲ محاسبهی هدف#
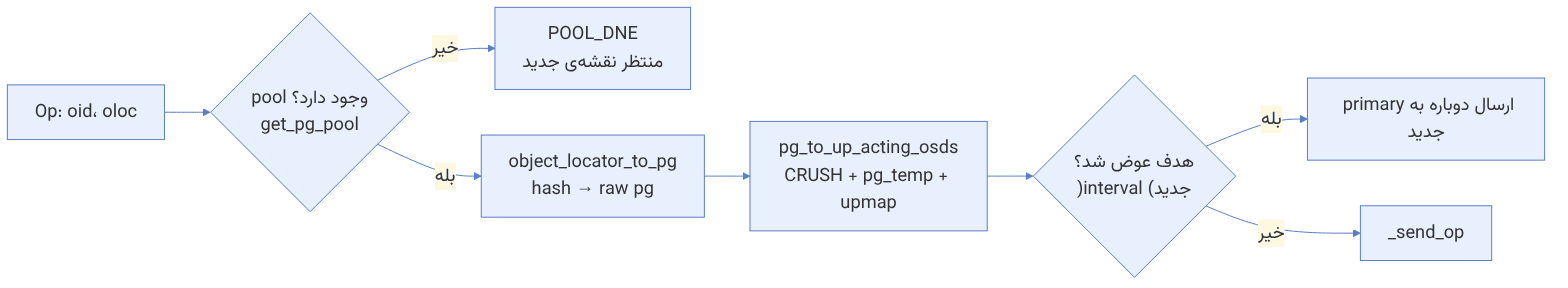
خلاصهی منطق Objecter::_calc_target():
- ۱. epoch نقشهی فعلی در هدف ثبت میشود.
- ۲.
osdmap->get_pg_pool(): اگر pool وجود ندارد، نتیجه RECALC_OP_TARGET_POOL_DNE است و Op منتظر نقشهی جدیدتر میماند (شاید pool تازه ساخته شده و کلاینت هنوز نقشهاش را ندارد). - ۳. اگر pool خراب یا با پرچم EIO است،
RECALC_OP_TARGET_POOL_EIO. - ۴.
osdmap->object_locator_to_pg(): hash نام شیء (یا locator key) و نگاشت به PG. - ۵. محاسبهی up و acting و primary (CRUSH، pg_temp، upmap؛ فصل ۸).
- ۶. مقایسه با هدف قبلی: اگر primary، acting، اندازهی pool یا تقسیم PG تغییر کرده باشد (interval جدید)، Op باید دوباره ارسال شود.
on new osdmap (handle_osd_map):
for op in inflight_ops:
r = calc_target(op.target)
if r == NEED_RESEND: cancel on old session; send to new primary
if r == POOL_DNE and map is new enough: fail op with -ENOENT
for linger in watches: recalc_linger_op_target(linger) # watch دوباره ثبت میشودچرا ارسال دوباره ایمن است؟ هر Op یک شناسهی یکتا (reqid: شناسهی کلاینت و tid) دارد. OSD در log هر PG شناسهی درخواستهای اخیر را نگه میدارد؛ اگر نوشتنی که قبلاً اعمال شده دوباره برسد (مثلاً چون ack در راه گم شده)، OSD آن را تکراری تشخیص میدهد و همان نتیجه را بدون اجرای دوباره برمیگرداند. این idempotency است که بازارسال پس از تغییر نقشه را بیخطر میکند.
۱۴-۱۰-۳ throttle و پیکربندی کلاینت#
ceph config get client objecter_inflight_ops
ceph config get client objecter_inflight_op_bytes
ceph config set client.devapp rados_osd_op_timeout 30 # بدون این، Op ممکن است بینهایت منتظر بماندپیشفرضهای کد جاری: objecter_inflight_ops=1_K، objecter_inflight_op_bytes=100_M، rados_osd_op_timeout=0 (یعنی بدون timeout) و osd_max_object_size=128_M.
پیشفرض librados این است که Op را تا ابد منتظر نگه دارد تا PG دوباره active شود؛ این برای ذخیرهسازی درست است (داده از دست نمیرود) اما برنامهی شما ممکن است بیپاسخ بماند. اگر برنامه باید سریع خطا بدهد (مثلاً یک API با SLA)، rados_osd_op_timeout و rados_mon_op_timeout را تنظیم کنید و خطای -ETIMEDOUT را مدیریت کنید.
۱۴-۱۱ دامها و الگوهای طراحی#
| دام | پیامد | راه درست |
|---|---|---|
| شیء خیلی بزرگ (گیگابایتها) | بازیابی و scrub کند؛ محدودیت osd_max_object_size | شکستن به اشیای چندمگابایتی (مانند striper یا RBD) |
| omap خیلی بزرگ در یک شیء | LARGE_OMAP_OBJECTS، تأخیر deep-scrub | shard کردن شاخص روی چند شیء (مانند bucket index در RGW) |
| یک شیء «داغ» | همهی بار روی یک PG و یک OSD | توزیع کلیدها روی چند شیء |
| فهرستگیری مکرر pool | پیمایش همهی PGها؛ بسیار کند | نگه داشتن شاخص خودتان در omap |
| فرض تراکنش چندشیئی | ناسازگاری پس از خرابی میانهی کار | طراحی idempotent یا journal در یک شیء |
اندازهی بیشینهی شیء با osd_max_object_size محدود است. برای دادهی بزرگ از libradosstriper یا الگوی خودتان برای شکستن به اشیای ۴ مگابایتی استفاده کنید؛ RBD و CephFS دقیقاً همین کار را میکنند.
- برای هر برنامه کاربر cephx جدا با دسترسی به pool یا namespace خودش.
- عملیات مرکب فقط روی یک شیء اتمی است.
- برای همزمانی از assert_version، cmpxattr یا قفل همراه blocklist استفاده کنید.
- watch/notify برای اعلان است، نه انتقال قابل اتکای داده.
- timeout کلاینت را برای برنامههای تعاملی تنظیم کنید.
- اشیا و omapها را کوچک و توزیعشده نگه دارید.
۱۴-۱۲ تکمیلی و بهروز#
- watch2/notify2 (C++) و
watch3 (C) نسخههای جدیدتر با مدیریت خطای بهتر هستند؛ نسخههای قدیمی watch در API باقی ماندهاند. - در
librados.hpp کد جاری، شکل نوعدار exec(const ClsMethod<...>&, ...) برای فراخوانی متدهای کلاس دیده میشود (علاوه بر شکل رشتهای قدیمی). - binding پایتون از
aio_*، WriteOp/ReadOp، omap، watch و قفل پشتیبانی میکند. - msgr2 با حالت secure ترافیک librados را رمزنگاری میکند (فصل ۸).
۱۴-۱۳ تمرین عملی#
- ۱. برنامهی پایتونی این فصل را اجرا کنید و با
rados -p devpool --namespace tenant-a ls اشیا را ببینید. - ۲. شمارندهی اتمی را با ده فرایند همزمان اجرا کنید و تأیید کنید مقدار نهایی درست است. سپس guard را حذف کنید و نتیجه را مقایسه کنید.
- ۳. یک watcher و یک notifier بنویسید؛ watcher را قطع و وصل کنید و ببینید چه زمانی پیام از دست میرود.
- ۴. با
rados_osd_op_timeout رفتار برنامه را هنگام توقف OSDهای یک PG آزمایش کنید. - ۵. ده هزار کلید omap در یک شیء بنویسید و زمان
rados listomapkeys را اندازه بگیرید؛ سپس روی ده شیء shard کنید. - ۶. در کد Objecter، جایی که
RECALC_OP_TARGET_POOL_DNE مدیریت میشود را پیدا کنید و رفتار را توضیح دهید.
۱۴-۱۴ پرسشهای مرور#
- ۱. سه بخش مستقل یک شیء RADOS کداماند؟
- ۲. namespace چه فرقی با pool دارد و چه زمانی مفید است؟
- ۳. چرا omap در pool EC پشتیبانی نمیشود و چه پیامدی برای طراحی دارد؟
- ۴. عملیات مرکب چه تضمینی میدهد و چه تضمینی نمیدهد؟
- ۵. assert_version در چه حالتهایی ERANGE و EOVERFLOW برمیگرداند؟
- ۶. چرا قفل مشورتی به تنهایی برای ایمنی کافی نیست؟
- ۷. watch در Objecter چگونه پس از تغییر نقشه حفظ میشود؟
- ۸. چرا بازارسال Op پس از تغییر نقشه ایمن است؟
- ۹. چه زمانی باید rados_osd_op_timeout را تنظیم کرد؟
- ۱۰. برای ذخیرهی دادهی چندگیگابایتی روی RADOS چه الگویی مناسب است؟
پاسخ این پرسشها در پیوست ه: پاسخ پرسشها آمده است. پاسخ پرسشهای این فصل →
۱۴-۱۵ منابع این فصل#
- librados introduction
https://docs.ceph.com/en/latest/rados/api/librados-intro/ - librados C API
https://docs.ceph.com/en/latest/rados/api/librados/ - librados C++ API
https://docs.ceph.com/en/latest/rados/api/libradospp/ - librados Python API
https://docs.ceph.com/en/latest/rados/api/python/ - Objclass and RADOS classes
https://docs.ceph.com/en/latest/rados/api/objclass-sdk/ - Source: src/include/rados/librados.h, librados.hpp
https://github.com/ceph/ceph/tree/main/src/include/rados - Source: src/osdc/Objecter.cc
https://github.com/ceph/ceph/blob/main/src/osdc/Objecter.cc - Source: src/pybind/rados/rados.pyx
https://github.com/ceph/ceph/blob/main/src/pybind/rados/rados.pyx - Source: src/osd/PrimaryLogPG.cc
https://github.com/ceph/ceph/blob/main/src/osd/PrimaryLogPG.cc - Weil et al., "RADOS: A Scalable, Reliable Storage Service for Petabyte-scale Storage Clusters" (PDSW ۲۰۰۷
https://ceph.io/assets/pdfs/weil-rados-pdsw07.pdf